
Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
W skrócieZapytanie SQL od ChatGPT jest dobre wtedy, gdy model dostaje opis schematu bazy, dialekt z wersją serwera i reguły liczenia. Bez schematu wymyśla tabele i kolumny. Pokazujemy, jak przygotować opis schematu jednym zapytaniem, jak wymusić dialekt i jak sprawdzić wynik niezależnym zapytaniem.
To część 1 z 8 przewodnika AI w SQL. Wszystkie przykłady powstały na bazie DemoShop w SQL Server 2022: fikcyjnym sklepie internetowym z 2,4 mln zamówień. Polecenia wpisujemy do ChatGPT, ale te same możesz podać Microsoft Copilotowi, Claude albo Gemini. Przy skryptach korzystających z mechanizmów serwera w małej szarej ramce znajdziesz ich odpowiedniki dla Oracle i PostgreSQL.
Z tej części dowiesz się:
Pliki do tej części
Skrypt bazy uruchamiasz w SSMS na serwerze SQL Server 2019 lub nowszym. Tworzy bazę DemoShop, na której powstały wszystkie przykłady.
Zacznijmy od tego, co robi większość osób przy pierwszym kontakcie z AI: wpisuje pytanie biznesowe tak, jak zadałaby je koledze. Chcemy dziesięciu klientów, którzy w 2025 roku wydali najwięcej.
Napisz zapytanie SQL, które pokaże 10 klientów, którzy w 2025 roku wydali u nas najwięcej. Chcę widzieć imię i nazwisko, liczbę zamówień i łączną kwotę zakupów.
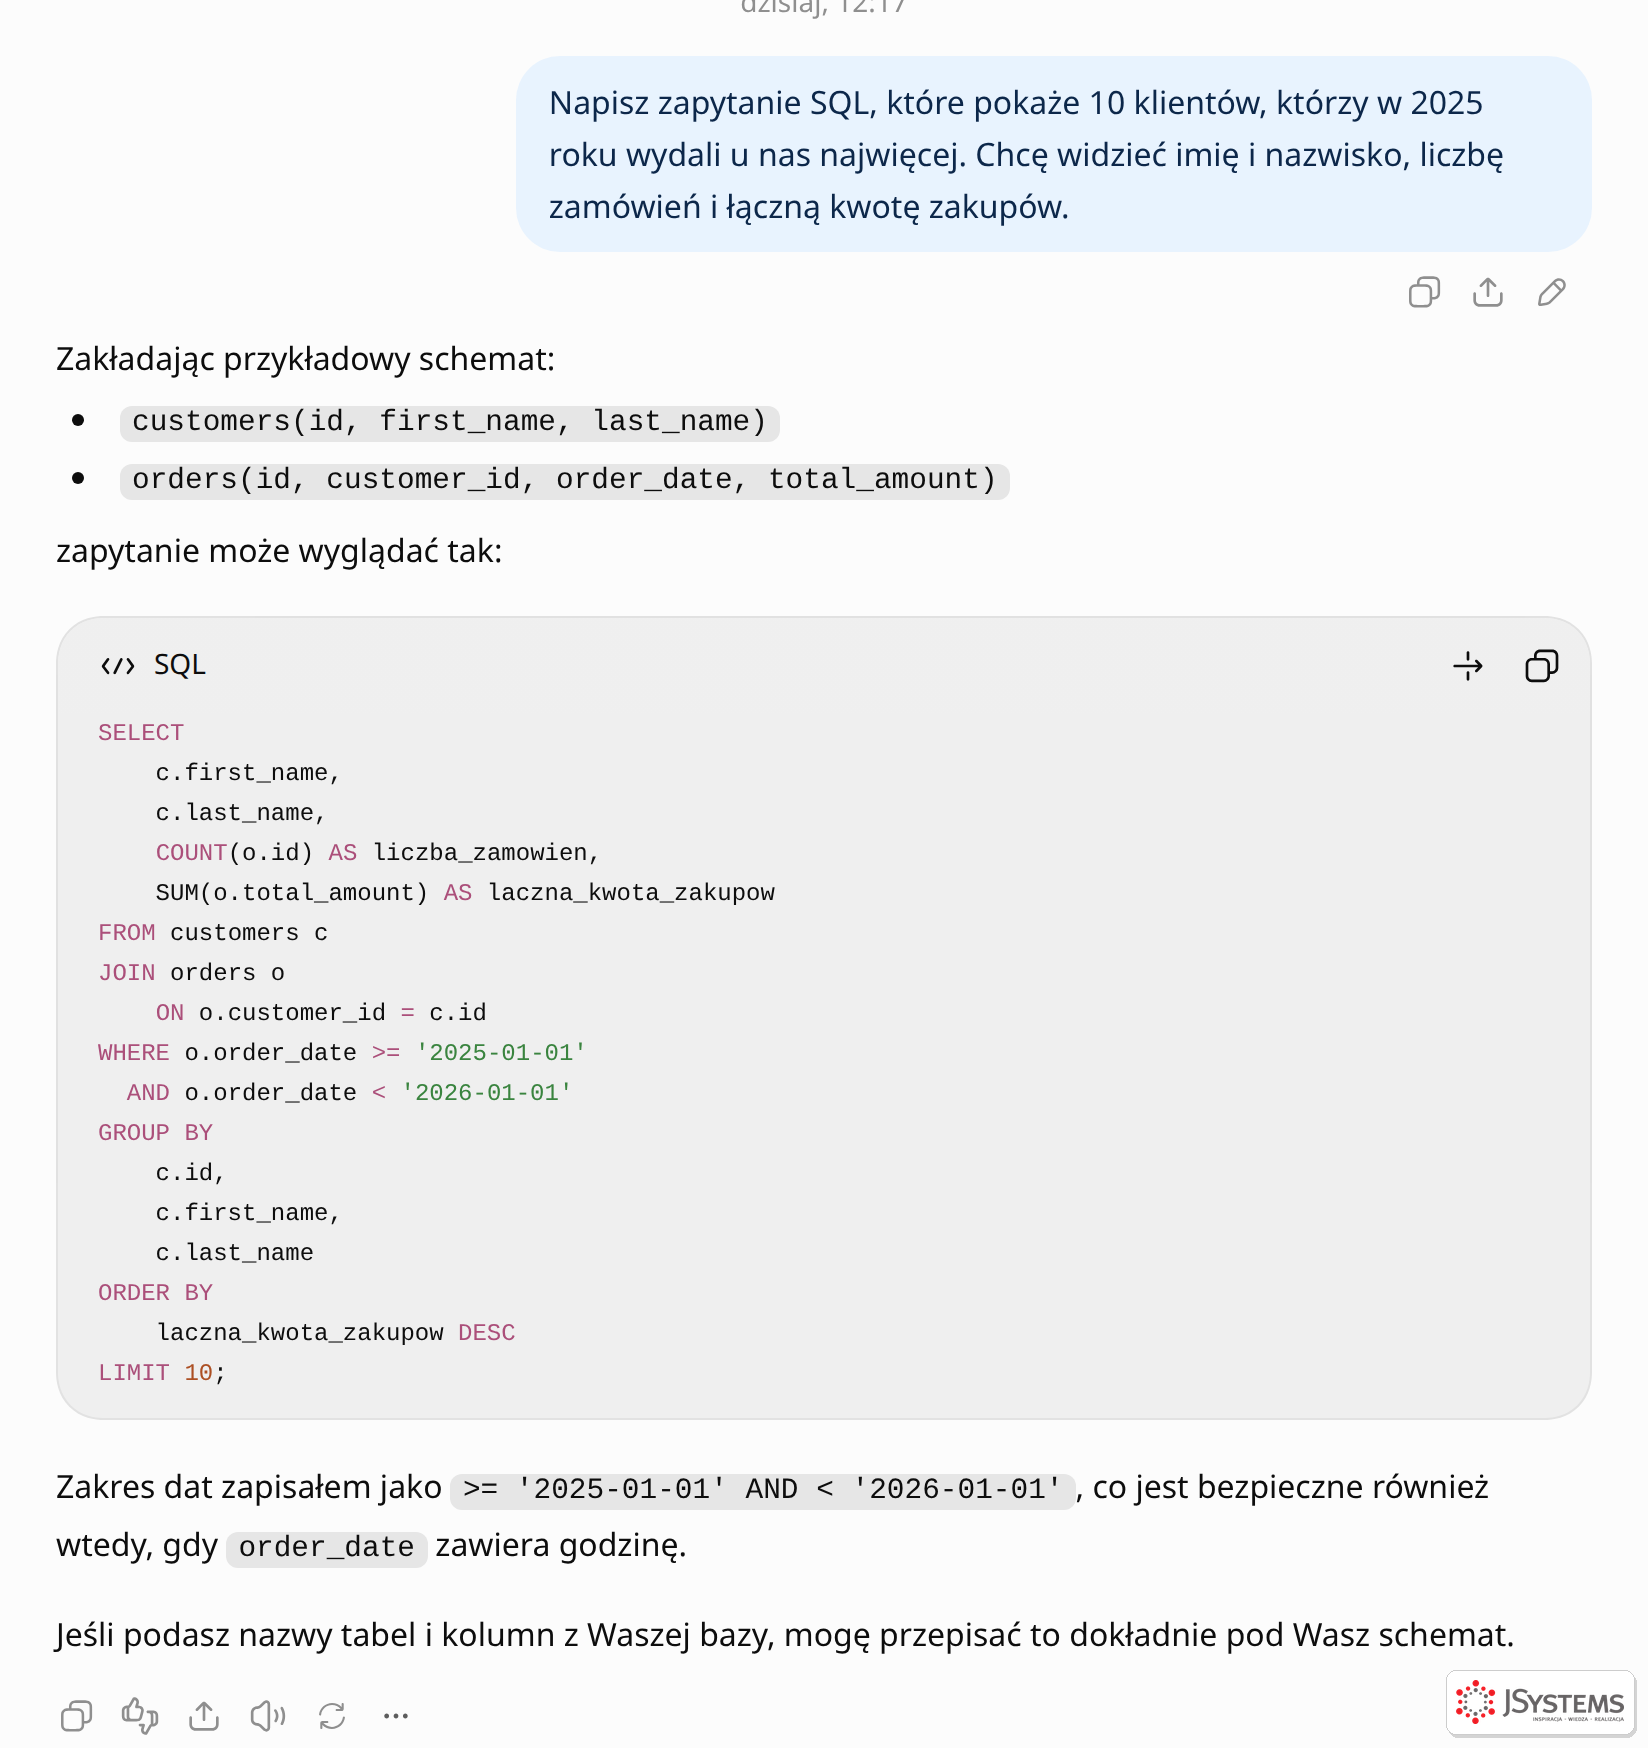
Odpowiedź wygląda profesjonalnie: zakres dat zapisany jako przedział zamiast funkcji na kolumnie, grupowanie po identyfikatorze klienta, sortowanie malejące. Problem w tym, że w DemoShop nie ma tabeli customers z kolumną id, nie ma kolumny total_amount, a wartość zamówienia trzeba policzyć z pozycji. Do tego LIMIT 10 to składnia MySQL i PostgreSQL. Wklejamy kod do SSMS i uruchamiamy klawiszem F5:
SELECT
    c.first_name,
    c.last_name,
    COUNT(o.id) AS liczba_zamowien,
    SUM(o.total_amount) AS laczna_kwota_zakupow
FROM customers c
JOIN orders o
    ON o.customer_id = c.id
WHERE o.order_date >= '2025-01-01'
  AND o.order_date < '2026-01-01'
GROUP BY
    c.id,
    c.first_name,
    c.last_name
ORDER BY
    laczna_kwota_zakupow DESC
LIMIT 10;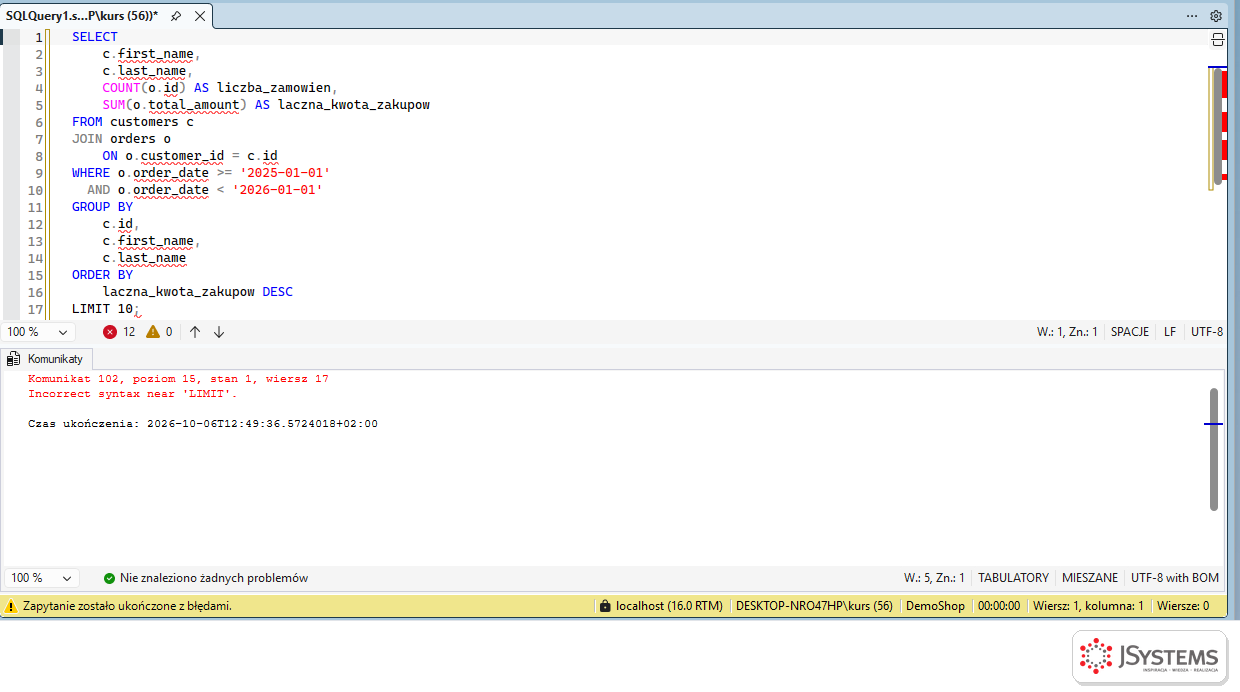
Ten błąd jest akurat niegroźny, bo widać go od razu. Groźniejszy scenariusz to baza, w której przypadkiem istnieje tabela orders z kolumną total_amount, ale liczoną inaczej, niż myślisz (na przykład z kosztem dostawy albo z zamówieniami anulowanymi). Wtedy zapytanie wykona się bez błędu i zwróci liczby, które wyglądają wiarygodnie. Dlatego zanim poprosisz AI o zapytanie, daj mu cztery rzeczy: dialekt i wersję serwera, opis schematu, reguły liczenia i instrukcję, co ma zrobić, gdy czegoś brakuje.
W poleceniu poniżej obok wersji serwera znajduje się poziom zgodności (compatibility level). To ustawienie samej bazy, które mówi, z którą wersją SQL Server baza ma się zachowywać zgodnie: 160 oznacza SQL Server 2022, 150 to SQL Server 2019, 140 to SQL Server 2017. Od poziomu zgodności zależy, które funkcje języka są dostępne i jak optymalizator buduje plany. Serwer bywa nowszy od bazy: baza przeniesiona na SQL Server 2022 często ma dalej poziom 150, żeby stare zapytania działały jak wcześniej. Dlatego AI powinno znać oba parametry. Poziom zgodności swojej bazy sprawdzisz zapytaniem SELECT name, compatibility_level FROM sys.databases;.
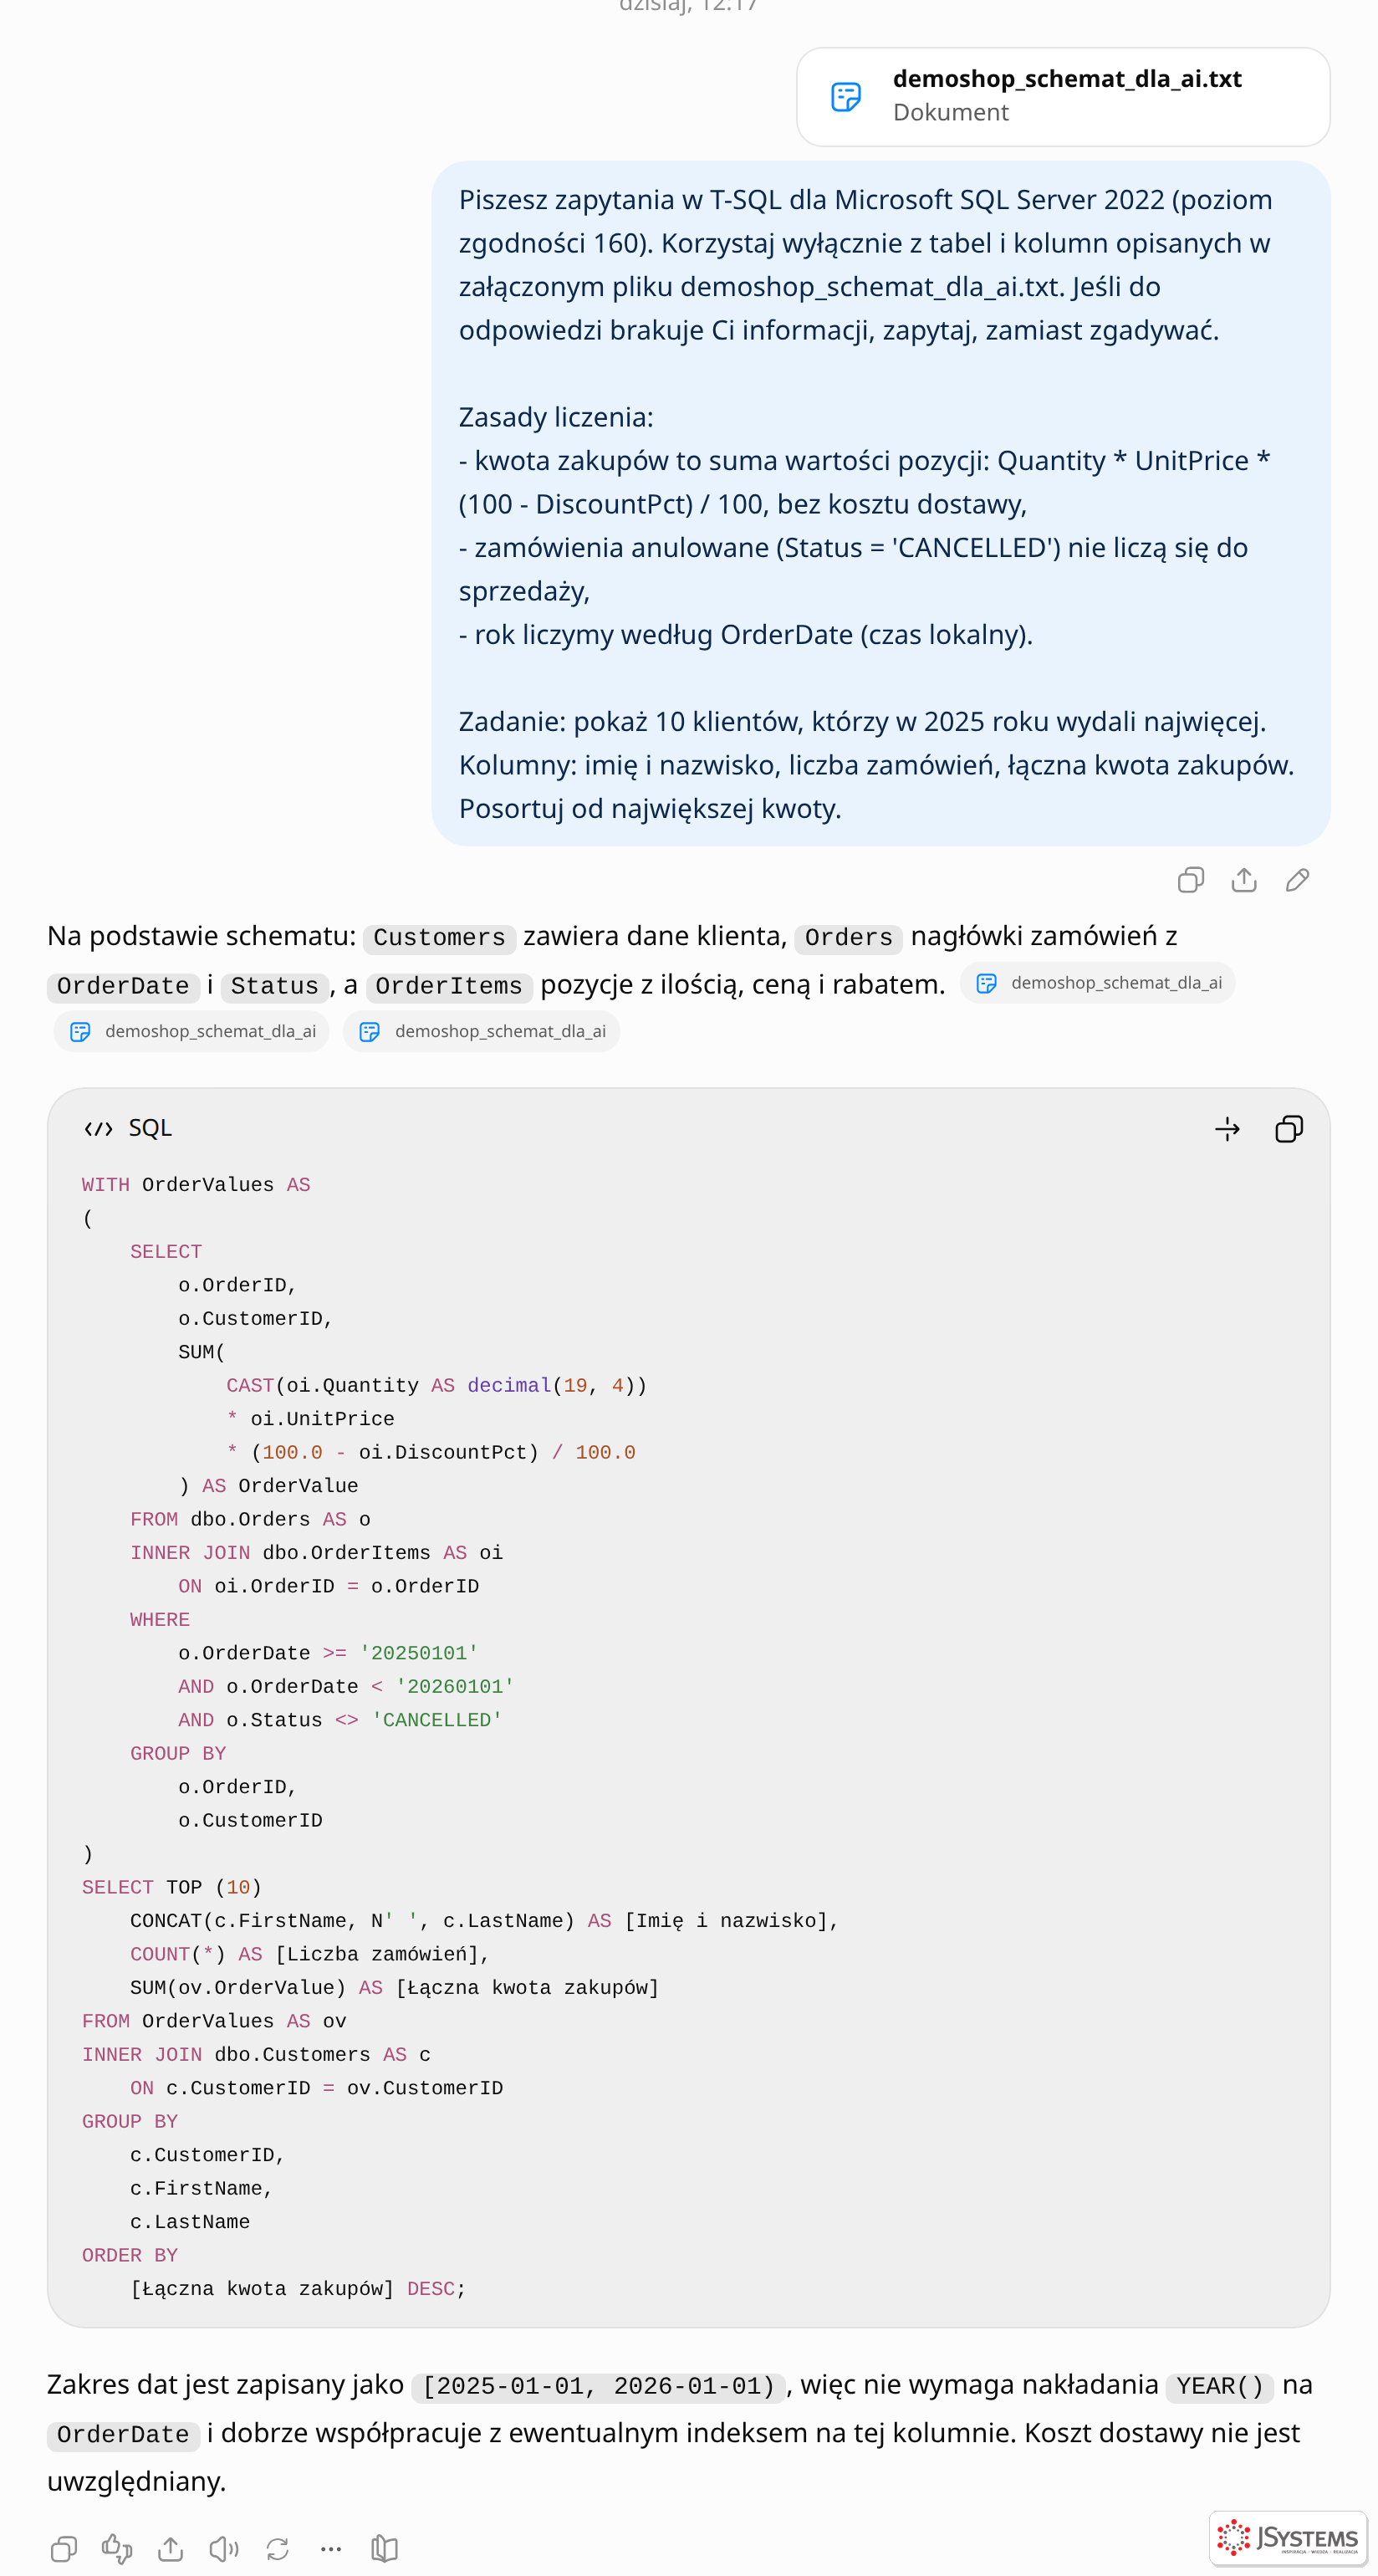
Piszesz zapytania w T-SQL dla Microsoft SQL Server 2022 (poziom zgodności 160). Korzystaj wyłącznie z tabel i kolumn opisanych w załączonym pliku demoshop_schemat_dla_ai.txt. Jeśli do odpowiedzi brakuje Ci informacji, zapytaj, zamiast zgadywać.
Zasady liczenia:
- kwota zakupów to suma wartości pozycji: Quantity * UnitPrice * (100 - DiscountPct) / 100, bez kosztu dostawy,
- zamówienia anulowane (Status = 'CANCELLED') nie liczą się do sprzedaży,
- rok liczymy według OrderDate (czas lokalny).
Zadanie: pokaż 10 klientów, którzy w 2025 roku wydali najwięcej. Kolumny: imię i nazwisko, liczba zamówień, łączna kwota zakupów. Posortuj od największej kwoty.
Plik demoshop_schemat_dla_ai.txt to opis wszystkich tabel bazy w 85 linijkach: kolumny z typami, klucze główne i obce, dopuszczalne wartości i opisy kolumn. Dla bazy DemoShop plik jest gotowy do pobrania. Dla własnej bazy wygenerujesz taki sam opis jednym zapytaniem: uruchamiasz w SSMS gotowy skrypt schemat_dla_ai.sql na swojej bazie, kopiujesz wynik i zapisujesz go do pliku .txt. Krok po kroku pokazujemy to w części Zwięzły opis schematu dla AI jednym zapytaniem, a opisy kolumn, które trafiają do pliku, dodajesz tak, jak w części Opisy kolumn w bazie. Odpowiedź ChatGPT ze schematem wygląda zupełnie inaczej:
Całe zapytanie od ChatGPT do skopiowania i uruchomienia w SSMS na bazie DemoShop:
WITH OrderValues AS
(
    SELECT
        o.OrderID,
        o.CustomerID,
        SUM(
            CAST(oi.Quantity AS decimal(19, 4))
            * oi.UnitPrice
            * (100.0 - oi.DiscountPct) / 100.0
        ) AS OrderValue
    FROM dbo.Orders AS o
    INNER JOIN dbo.OrderItems AS oi
        ON oi.OrderID = o.OrderID
    WHERE
        o.OrderDate >= '20250101'
        AND o.OrderDate < '20260101'
        AND o.Status <> 'CANCELLED'
    GROUP BY
        o.OrderID,
        o.CustomerID
)
SELECT TOP (10)
    CONCAT(c.FirstName, N' ', c.LastName) AS [Imię i nazwisko],
    COUNT(*) AS [Liczba zamówień],
    SUM(ov.OrderValue) AS [Łączna kwota zakupów]
FROM OrderValues AS ov
INNER JOIN dbo.Customers AS c
    ON c.CustomerID = ov.CustomerID
GROUP BY
    c.CustomerID,
    c.FirstName,
    c.LastName
ORDER BY
    [Łączna kwota zakupów] DESC;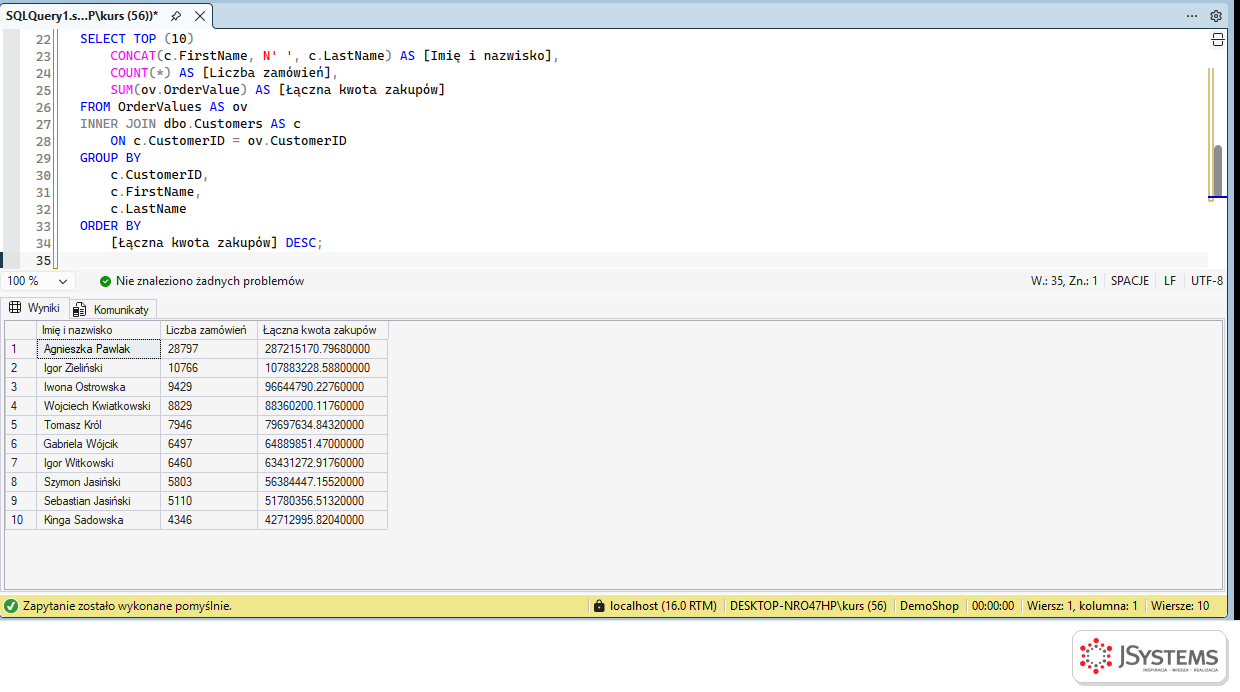
Zwróć uwagę na dwa szczegóły, które świadczą o tym, że AI przeczytało schemat, a nie zgadywało. Po pierwsze najpierw sumuje wartość każdego zamówienia w CTE, a dopiero potem liczy zamówienia klienta przez COUNT(*). Gdyby połączyło klientów od razu z pozycjami, każde zamówienie policzyłoby się tyle razy, ile ma pozycji (to błąd 1 z naszej listy dwudziestu typowych błędów: JOIN, który mnoży wiersze). Po drugie grupuje po CustomerID, a nie tylko po imieniu i nazwisku. To nie jest pedanteria: w DemoShop jest 40 klientów o imieniu i nazwisku Agnieszka Pawlak, w tym ta z pierwszego miejsca rankingu. Grupowanie po samym imieniu i nazwisku zsumowałoby ich zakupy w jedną pozycję. Jak bardzo zmienia to wynik, zobaczysz za chwilę w zapytaniu kontrolnym.
Sam fakt, że zapytanie się wykonało, niczego jeszcze nie dowodzi. Wynik sprawdzamy niezależną drogą: osobnym, prostszym zapytaniem, które liczy to samo inaczej. Obie liczby dla sprawdzanego klienta muszą się zgadzać co do grosza. Takie zapytanie kontrolne też możesz zamówić u ChatGPT. W nowej rozmowie załączamy ten sam plik ze schematem, wklejamy zapytanie z rankingu i liczby z pierwszego wiersza wyniku:
Piszesz zapytania w T-SQL dla Microsoft SQL Server 2022 (poziom zgodności 160). Korzystaj wyłącznie z tabel i kolumn opisanych w załączonym pliku demoshop_schemat_dla_ai.txt. Jeśli do odpowiedzi brakuje Ci informacji, zapytaj, zamiast zgadywać.
Zasady liczenia:
- kwota zakupów to suma wartości pozycji: Quantity * UnitPrice * (100 - DiscountPct) / 100, bez kosztu dostawy,
- zamówienia anulowane (Status = 'CANCELLED') nie liczą się do sprzedaży,
- rok liczymy według OrderDate (czas lokalny).
To zapytanie zwróciło 10 klientów, którzy w 2025 roku wydali najwięcej:
WITH OrderValues AS
(
    SELECT
        o.OrderID,
        o.CustomerID,
        SUM(
            CAST(oi.Quantity AS decimal(19, 4))
            * oi.UnitPrice
            * (100.0 - oi.DiscountPct) / 100.0
        ) AS OrderValue
    FROM dbo.Orders AS o
    INNER JOIN dbo.OrderItems AS oi
        ON oi.OrderID = o.OrderID
    WHERE
        o.OrderDate >= '20250101'
        AND o.OrderDate < '20260101'
        AND o.Status <> 'CANCELLED'
    GROUP BY
        o.OrderID,
        o.CustomerID
)
SELECT TOP (10)
    CONCAT(c.FirstName, N' ', c.LastName) AS [Imię i nazwisko],
    COUNT(*) AS [Liczba zamówień],
    SUM(ov.OrderValue) AS [Łączna kwota zakupów]
FROM OrderValues AS ov
INNER JOIN dbo.Customers AS c
    ON c.CustomerID = ov.CustomerID
GROUP BY
    c.CustomerID,
    c.FirstName,
    c.LastName
ORDER BY
    [Łączna kwota zakupów] DESC;
W pierwszym wierszu wyniku jest Agnieszka Pawlak: 28 797 zamówień i 287 215 170,80 zł. Napisz niezależne zapytanie kontrolne, które policzy te dwie liczby dla tego klienta inną drogą: bez CTE i bez rankingu, bezpośrednio z pozycji zamówień. Nie powielaj logiki zapytania powyżej.
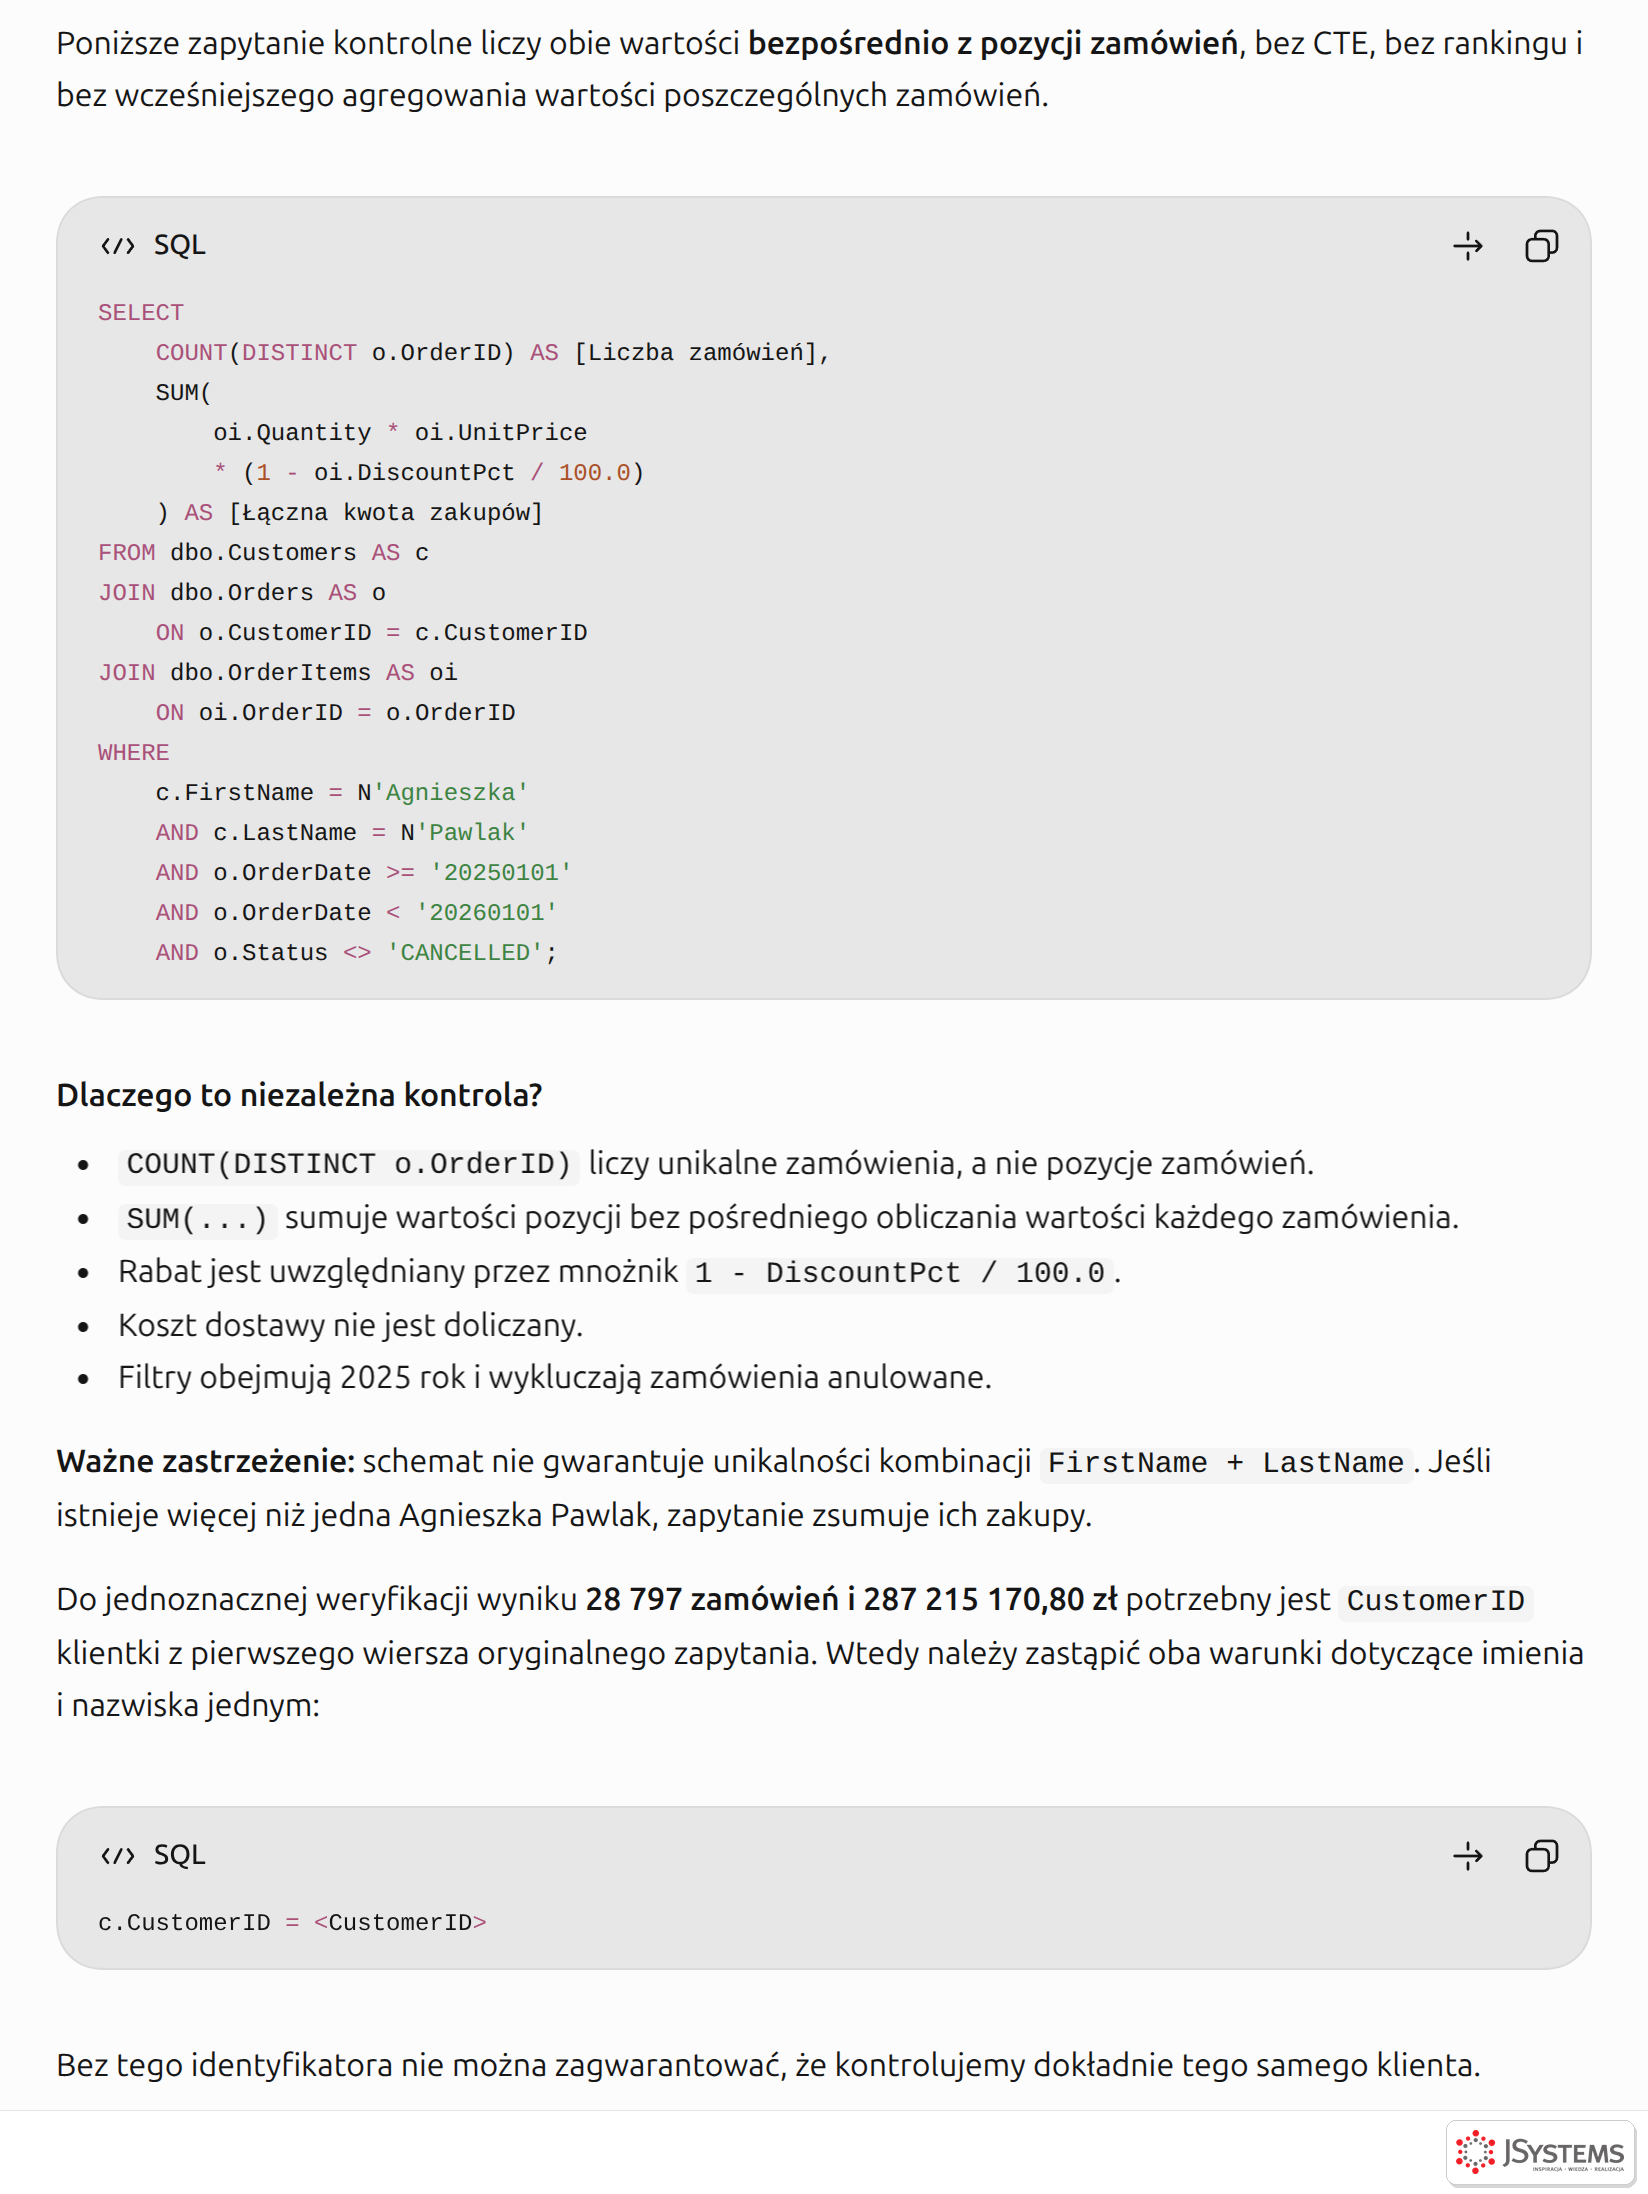
Zapytanie kontrolne od ChatGPT do skopiowania:
SELECT
    COUNT(DISTINCT o.OrderID) AS [Liczba zamówień],
    SUM(
        oi.Quantity * oi.UnitPrice
        * (1 - oi.DiscountPct / 100.0)
    ) AS [Łączna kwota zakupów]
FROM dbo.Customers AS c
JOIN dbo.Orders AS o
    ON o.CustomerID = c.CustomerID
JOIN dbo.OrderItems AS oi
    ON oi.OrderID = o.OrderID
WHERE
    c.FirstName = N'Agnieszka'
    AND c.LastName = N'Pawlak'
    AND o.OrderDate >= '20250101'
    AND o.OrderDate < '20260101'
    AND o.Status <> 'CANCELLED';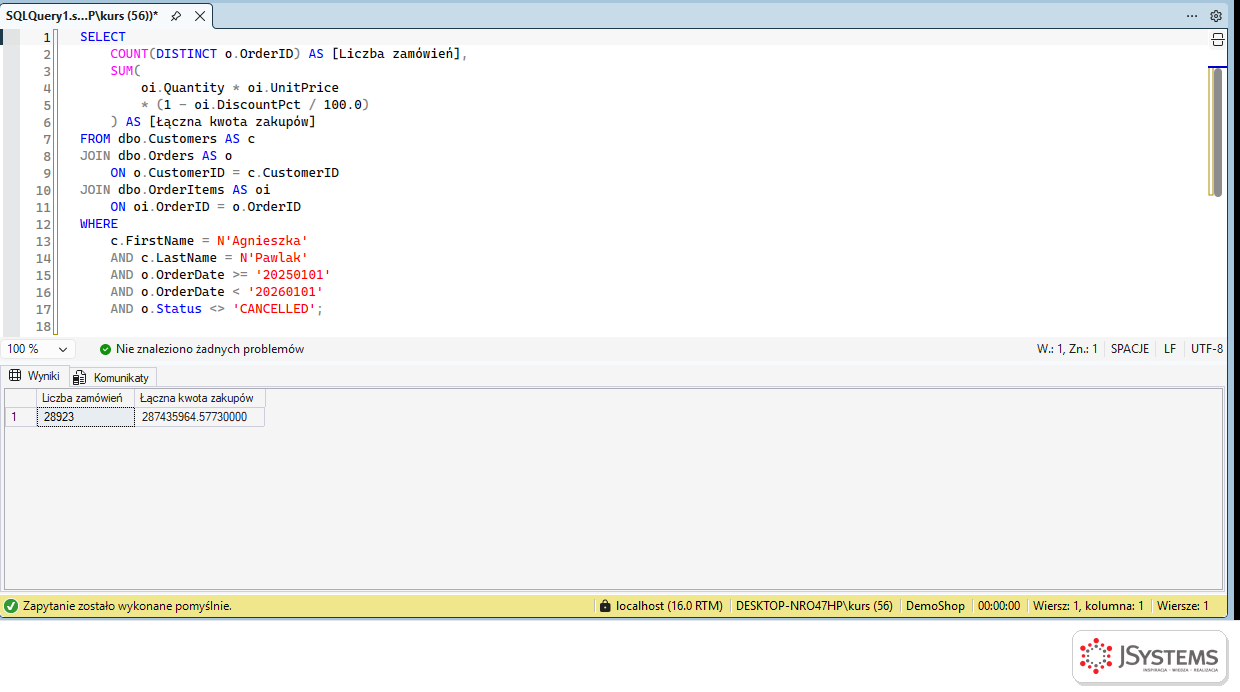
Liczby się nie zgadzają i właśnie po to robi się kontrolę. Zastrzeżenie ChatGPT było trafne: zapytanie z filtrem po imieniu i nazwisku zsumowało zakupy wszystkich 40 klientek o imieniu i nazwisku Agnieszka Pawlak, a ranking liczył jedną z nich, bo grupuje po CustomerID. Wracamy z prawdziwym wynikiem do tej samej rozmowy:
Uruchomiłem Twoje zapytanie kontrolne w SSMS: 28 923 zamówienia i 287 435 964,58 zł, czyli więcej niż w rankingu. Masz rację, w bazie jest 40 klientów o imieniu i nazwisku Agnieszka Pawlak. Popraw zapytanie kontrolne tak, żeby jednoznacznie sprawdzało klientkę z pierwszego wiersza rankingu.
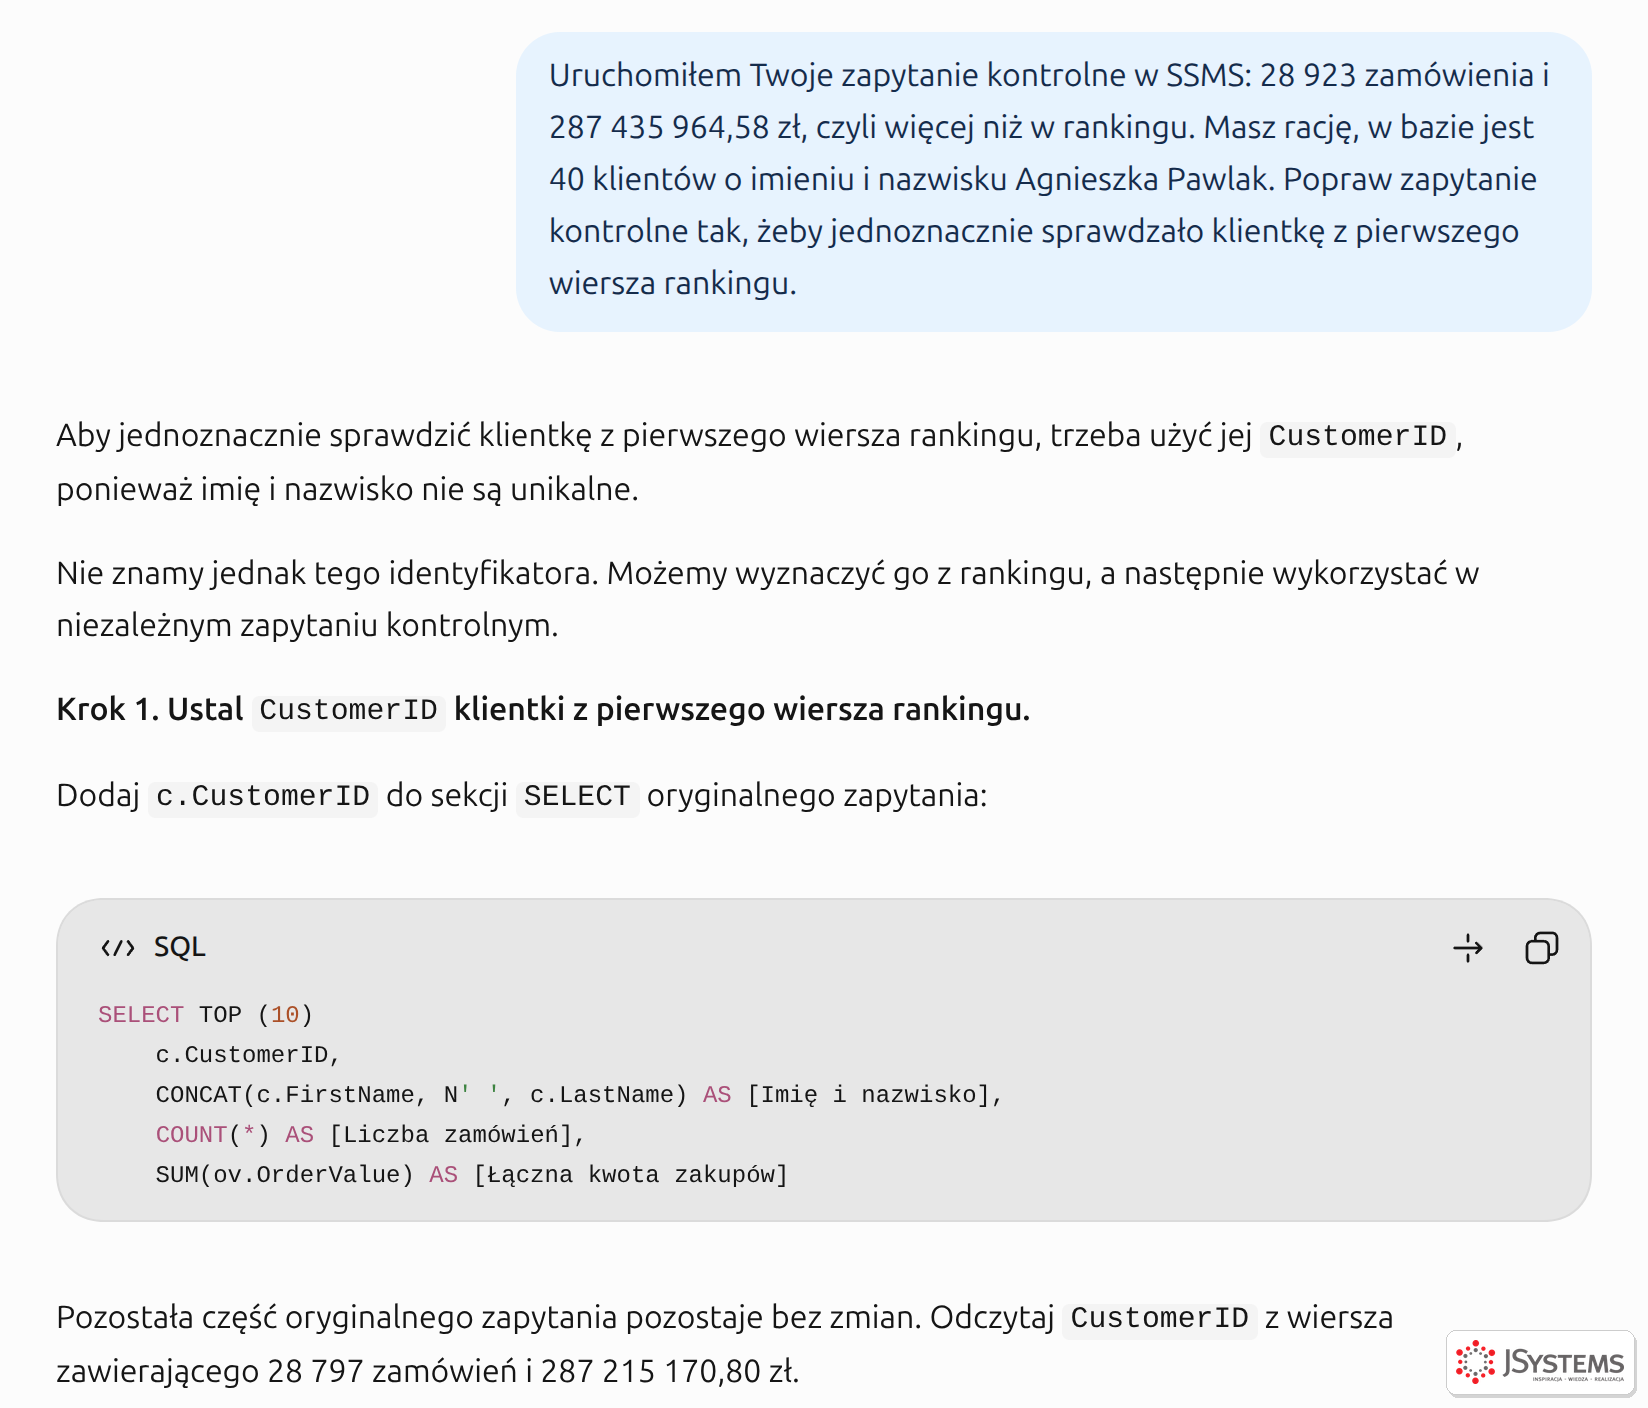
c.CustomerID do listy kolumn rankingu i odczytać identyfikator z wiersza z 28 797 zamówieniami.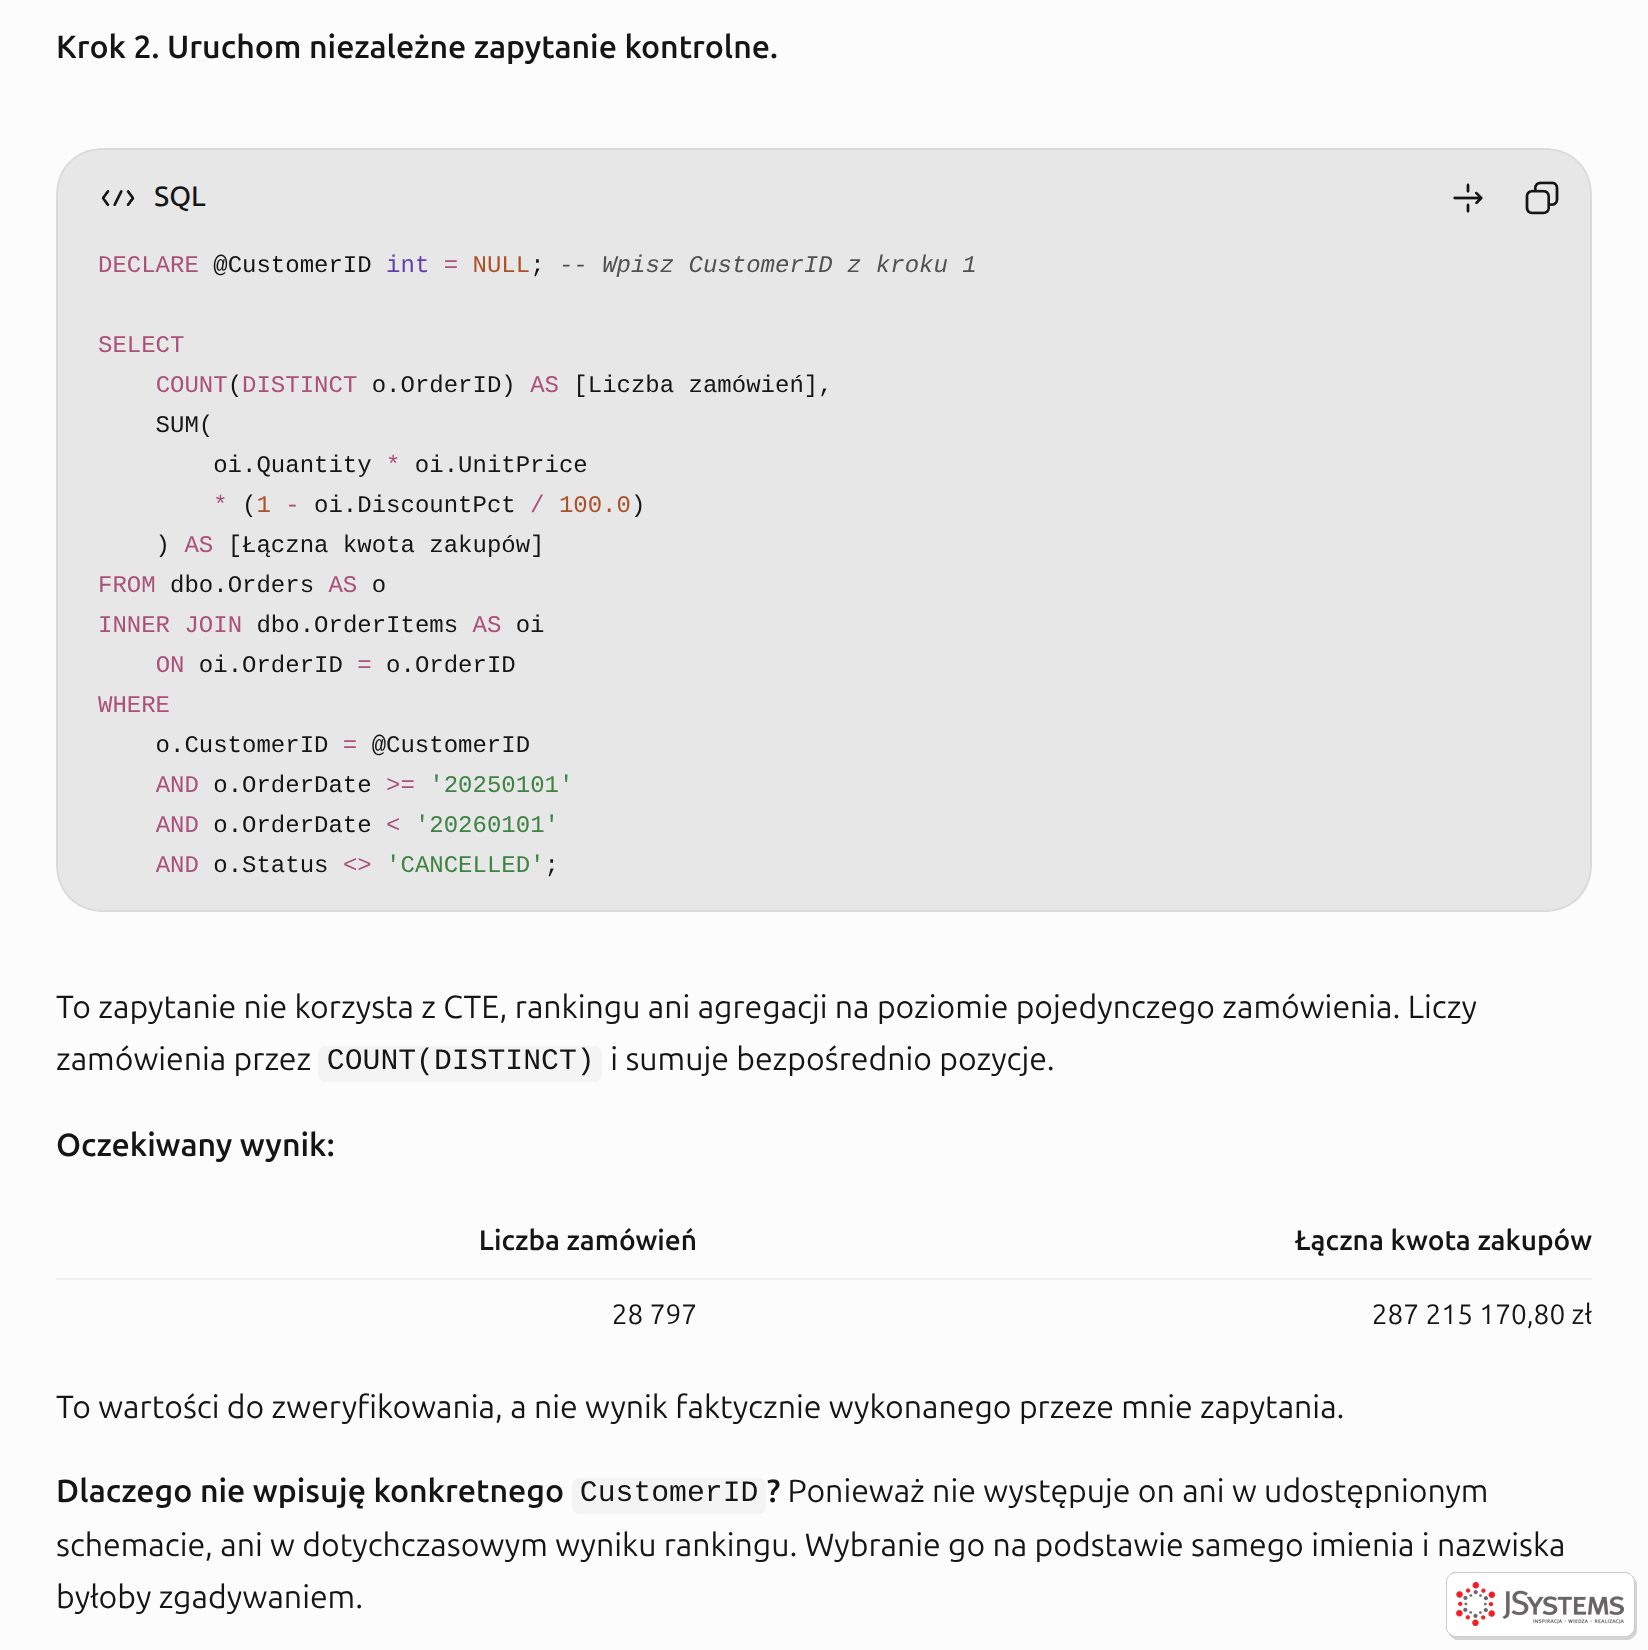
CustomerID. ChatGPT nie wpisuje identyfikatora sam, bo nie ma go ani w schemacie, ani w wyniku rankingu, i zaznacza, że oczekiwany wynik trzeba dopiero sprawdzić.Robimy oba kroki. Do rankingu dopisujemy c.CustomerID zaraz pod SELECT TOP (10), resztę zapytania zostawiamy bez zmian:
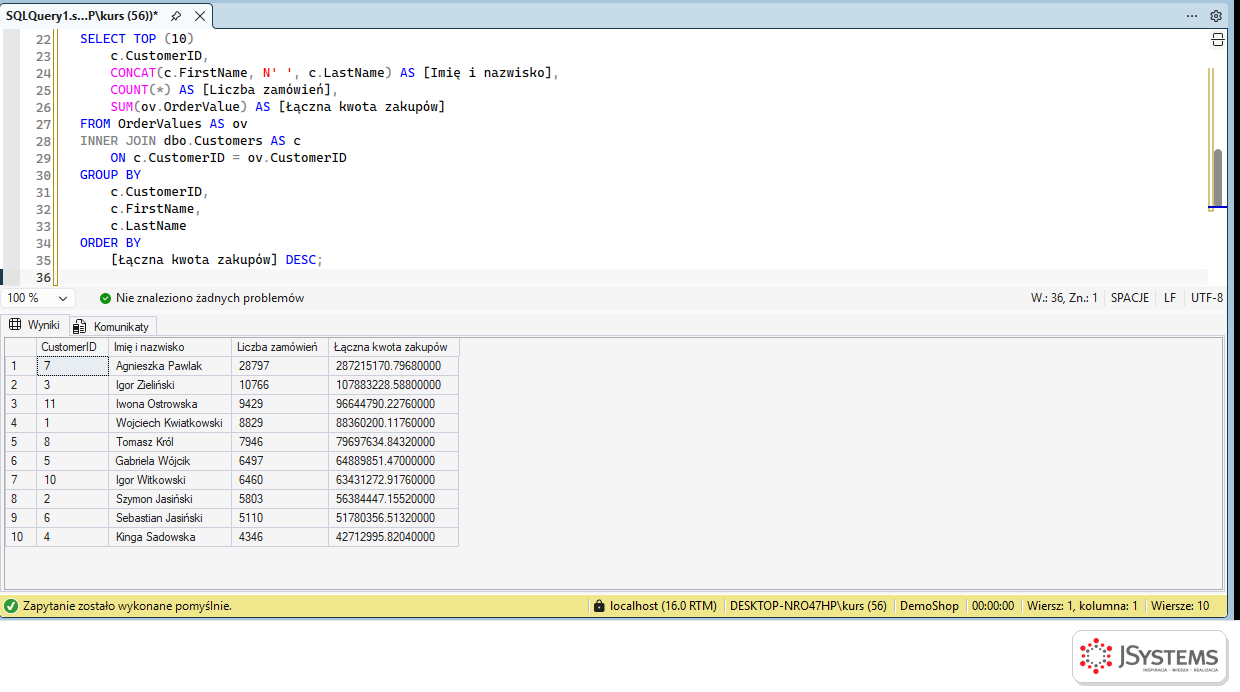
CustomerID: Agnieszka Pawlak z pierwszego wiersza to klientka nr 7.Identyfikator 7 wpisujemy do zapytania kontrolnego z kroku 2:
DECLARE @CustomerID int = 7; -- CustomerID z kroku 1

SELECT
    COUNT(DISTINCT o.OrderID) AS [Liczba zamówień],
    SUM(
        oi.Quantity * oi.UnitPrice
        * (1 - oi.DiscountPct / 100.0)
    ) AS [Łączna kwota zakupów]
FROM dbo.Orders AS o
INNER JOIN dbo.OrderItems AS oi
    ON oi.OrderID = o.OrderID
WHERE
    o.CustomerID = @CustomerID
    AND o.OrderDate >= '20250101'
    AND o.OrderDate < '20260101'
    AND o.Status <> 'CANCELLED';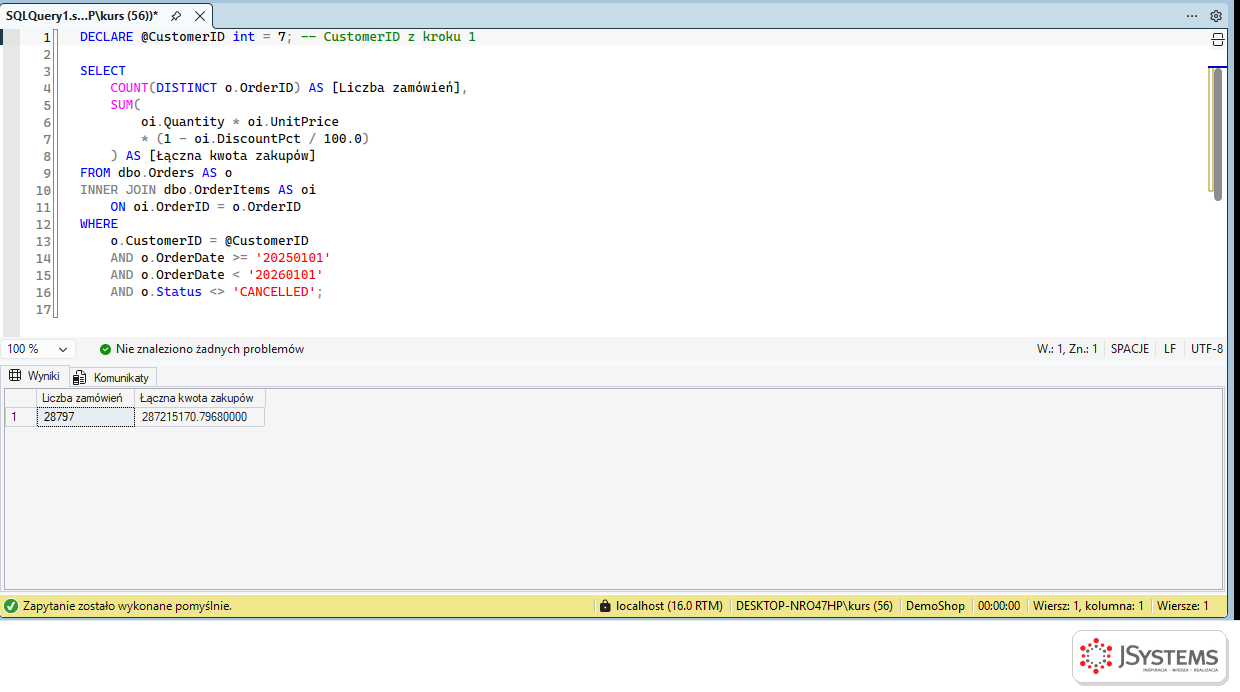
CustomerID = 7: 28 797 zamówień i 287 215 170,7968 zł, czyli po zaokrągleniu 287 215 170,80 zł. Dokładnie tyle samo co w rankingu.Teraz obie drogi dają ten sam wynik co do grosza, więc ranking jest potwierdzony. Ten przykład pokazuje dwie rzeczy naraz. Zapytanie kontrolne musi sprawdzać dokładnie ten sam obiekt, co zapytanie sprawdzane, czyli identyfikator, a nie nazwę. A rozbieżność w kontroli nie zawsze oznacza błąd w sprawdzanym zapytaniu: tutaj błąd był w kontroli i wyszedł dzięki temu, że wynik porównaliśmy z liczbą, a nie przyjęliśmy na wiarę. Tę technikę stosujemy w całym przewodniku i rozwijamy w sekcji o testach SQL.
Każda baza mówi trochę innym dialektem SQL. Najczęstsze różnice dotyczą ograniczania liczby wierszy, łączenia tekstu, literałów dat, funkcji na datach i typów danych. AI bez wskazówki wybiera dialekt, który najczęściej widziało w danych treningowych, i zwykle jest to składnia MySQL albo PostgreSQL. Wymuszenie dialektu jest proste: nazwij silnik i wersję w pierwszym zdaniu polecenia. Jeśli pracujesz z kilkoma bazami, poproś o wszystkie wersje naraz i o tabelę różnic, która od razu uczy, na co uważać.
Na podstawie schematu z załączonego pliku demoshop_schemat_dla_ai.txt napisz to samo zestawienie w czterech dialektach: Microsoft SQL Server 2022, PostgreSQL 16, Oracle Database 23ai i MySQL 8.0.
Zestawienie: 10 klientów z najwyższą kwotą zakupów w 2025 roku (imię i nazwisko, liczba zamówień, kwota).
Zasady liczenia:
- kwota zakupów to suma wartości pozycji: Quantity * UnitPrice * (100 - DiscountPct) / 100, bez kosztu dostawy,
- zamówienia anulowane (Status = 'CANCELLED') nie liczą się do sprzedaży,
- rok liczymy według OrderDate (czas lokalny).
Każdą wersję podaj w osobnym bloku kodu z nazwą dialektu w nagłówku. Pod blokami wypisz w tabeli, czym różni się składnia: ograniczenie liczby wierszy, łączenie tekstu i literały dat.
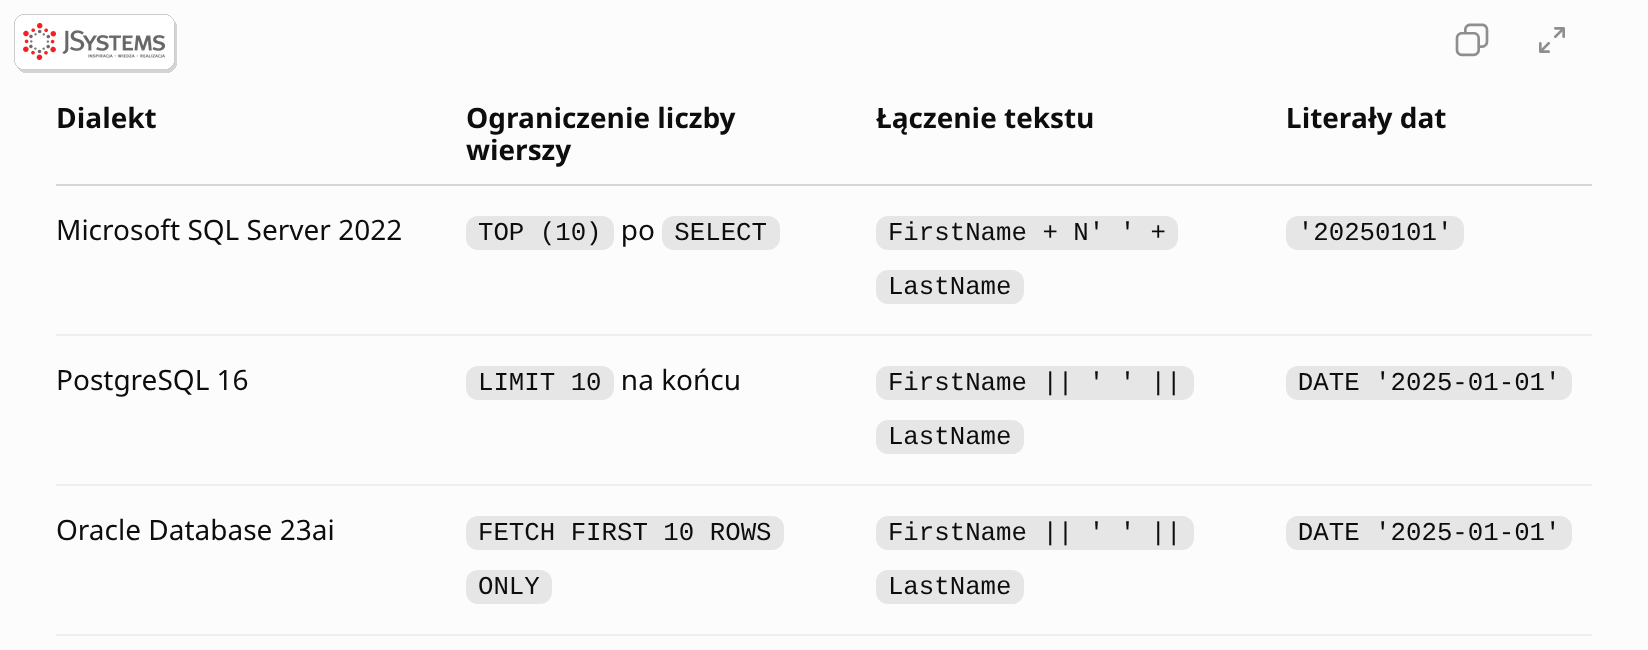
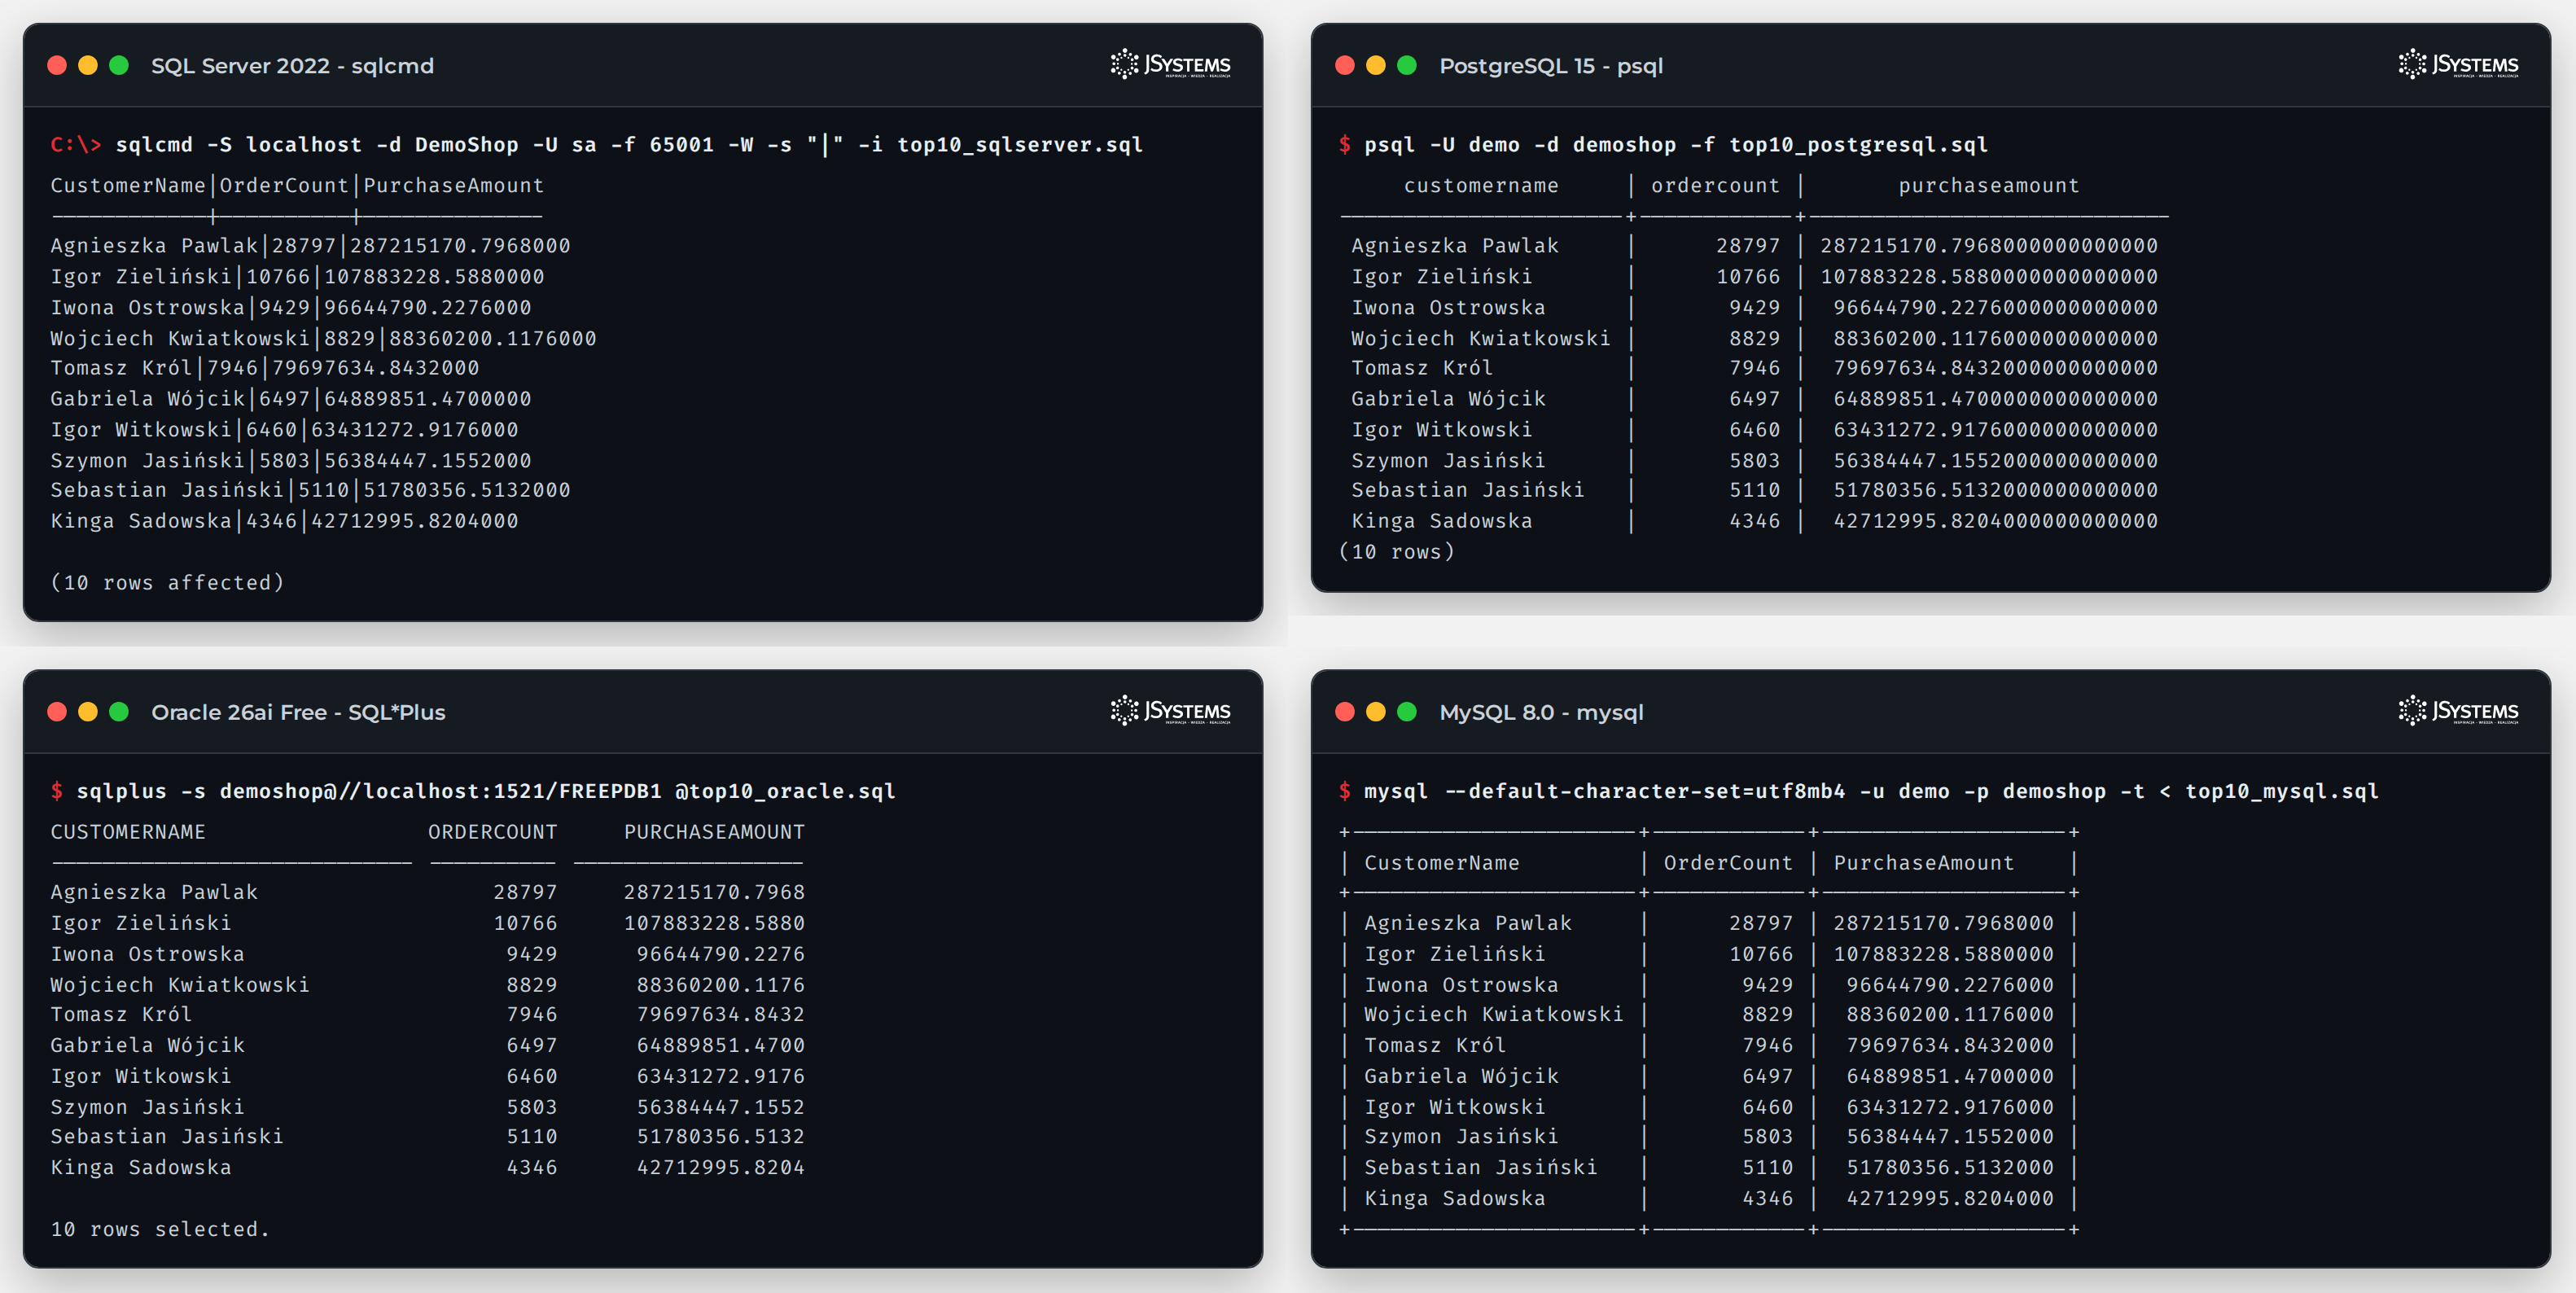
Wersje różnią się dokładnie tam, gdzie powinny. Teoria to jednak za mało, więc każdą z czterech wersji uruchomiliśmy w jej własnym silniku i jego własnym kliencie wiersza poleceń, na tych samych danych z 2025 roku: SQL Server 2022 (sqlcmd), PostgreSQL 15 (psql), Oracle AI Database 26ai Free (SQL*Plus) i MySQL 8.0. AI pisało dla PostgreSQL 16 i Oracle 23ai, ale użyta składnia jest w tych wersjach taka sama. Wszystkie cztery zwróciły tych samych dziesięciu klientów z identycznymi liczbami zamówień i kwotami. Jedyna różnica widoczna na ekranie to nagłówki w PostgreSQL: customername zamiast CustomerName. PostgreSQL zamienia na małe litery każdą nazwę zapisaną bez cudzysłowów, także nazwy tabel. Zapytanie od AI zadziałało, bo tabele w PostgreSQL też utworzyliśmy bez cudzysłowów; przy tabelach założonych jako "Customers" skończyłoby się błędem „relation does not exist”. Tę i inne pułapki przenoszenia kodu między bazami opisujemy w sekcji o konwersji dialektów.
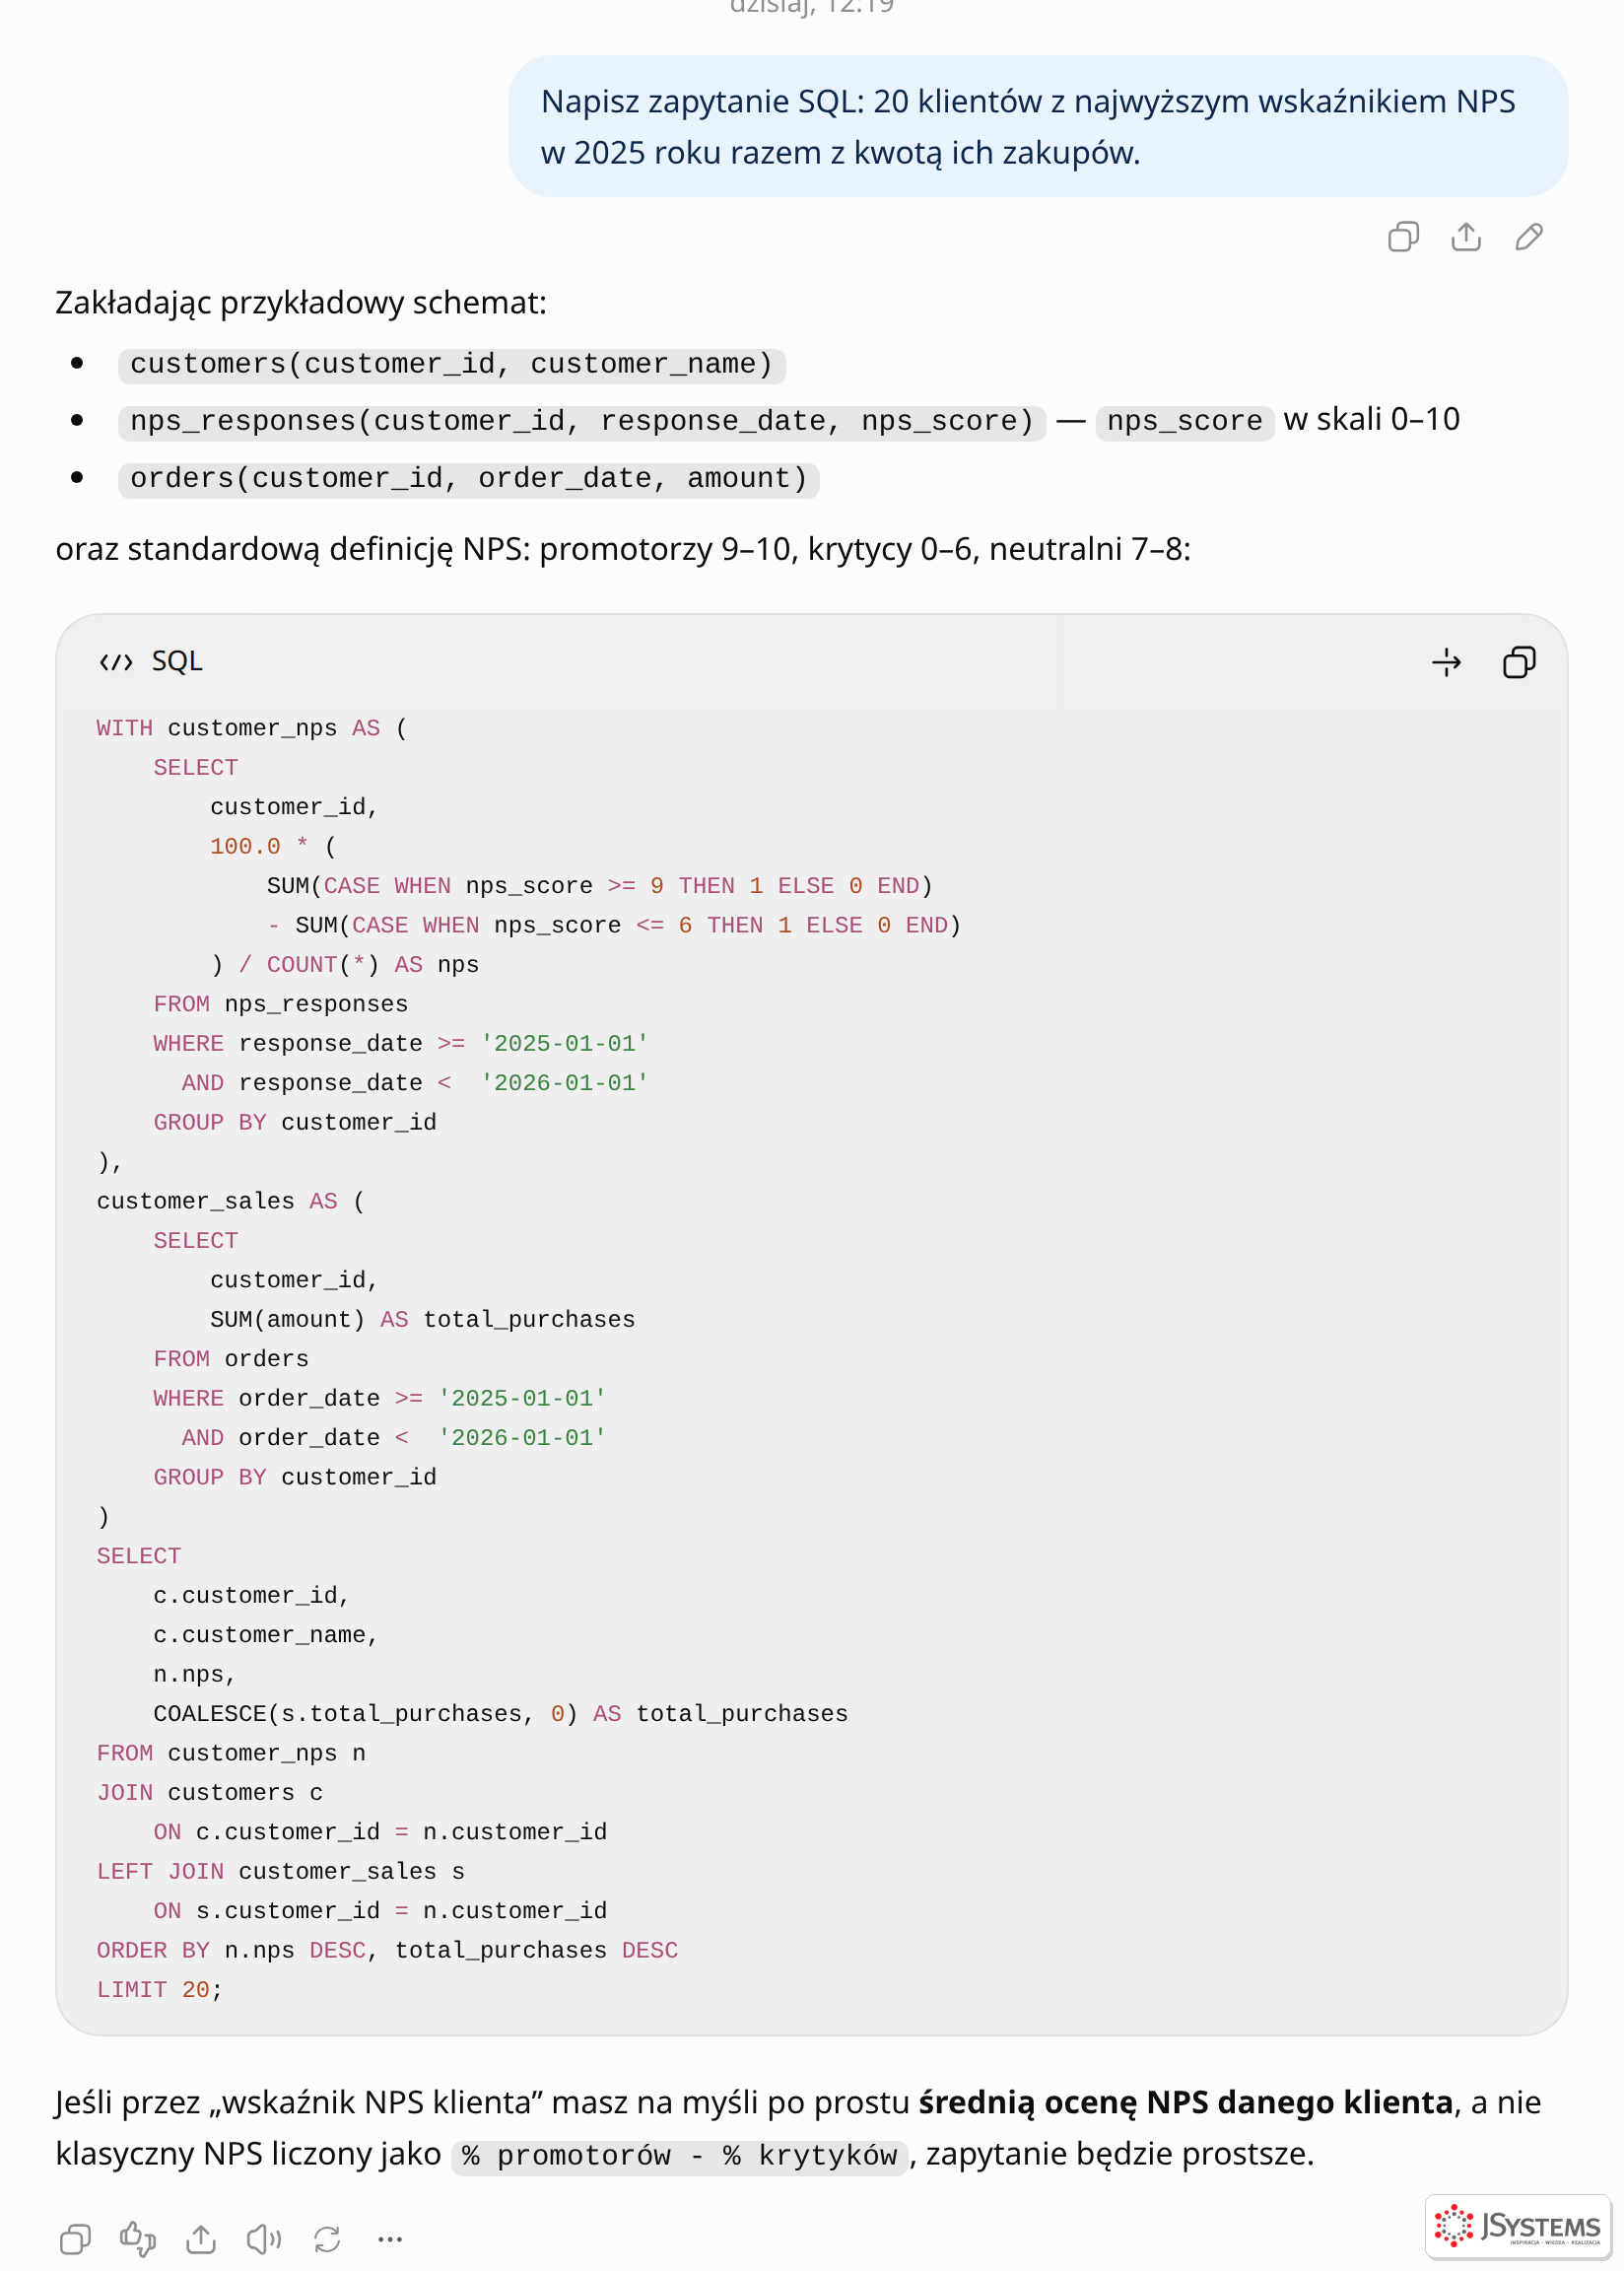
Model językowy zawsze coś odpowie. Jeśli zapytasz o dane, których w bazie nie ma, nie powie sam z siebie „takiej tabeli nie ma”, tylko dopisze ją do odpowiedzi. Sprawdziliśmy to na wskaźniku NPS (Net Promoter Score, wynik ankiety „czy polecisz nas znajomym” w skali 0-10). W DemoShop nie ma żadnych danych z ankiet. Najpierw zwykłe polecenie, bez schematu i bez zasad:
Napisz zapytanie SQL: 20 klientów z najwyższym wskaźnikiem NPS w 2025 roku razem z kwotą ich zakupów.
Teraz to samo zadanie z czterema elementami, które w praktyce wystarczają, żeby AI przestało wymyślać: listą dozwolonych tabel (plik ze schematem), zakazem używania czegokolwiek spoza niej, prośbą o wypisanie użytych kolumn przed napisaniem kodu i zgodą na odpowiedź „nie da się”.
Piszesz zapytania w T-SQL dla Microsoft SQL Server 2022 (poziom zgodności 160). Korzystaj wyłącznie z tabel i kolumn opisanych w załączonym pliku demoshop_schemat_dla_ai.txt. Jeśli do odpowiedzi brakuje Ci informacji, zapytaj, zamiast zgadywać. Zanim napiszesz zapytanie, wypisz listę tabel i kolumn, których użyjesz. Jeśli czegoś nie ma w schemacie, napisz to wprost.
Zadanie: 20 klientów z najwyższym wskaźnikiem NPS w 2025 roku razem z kwotą ich zakupów.
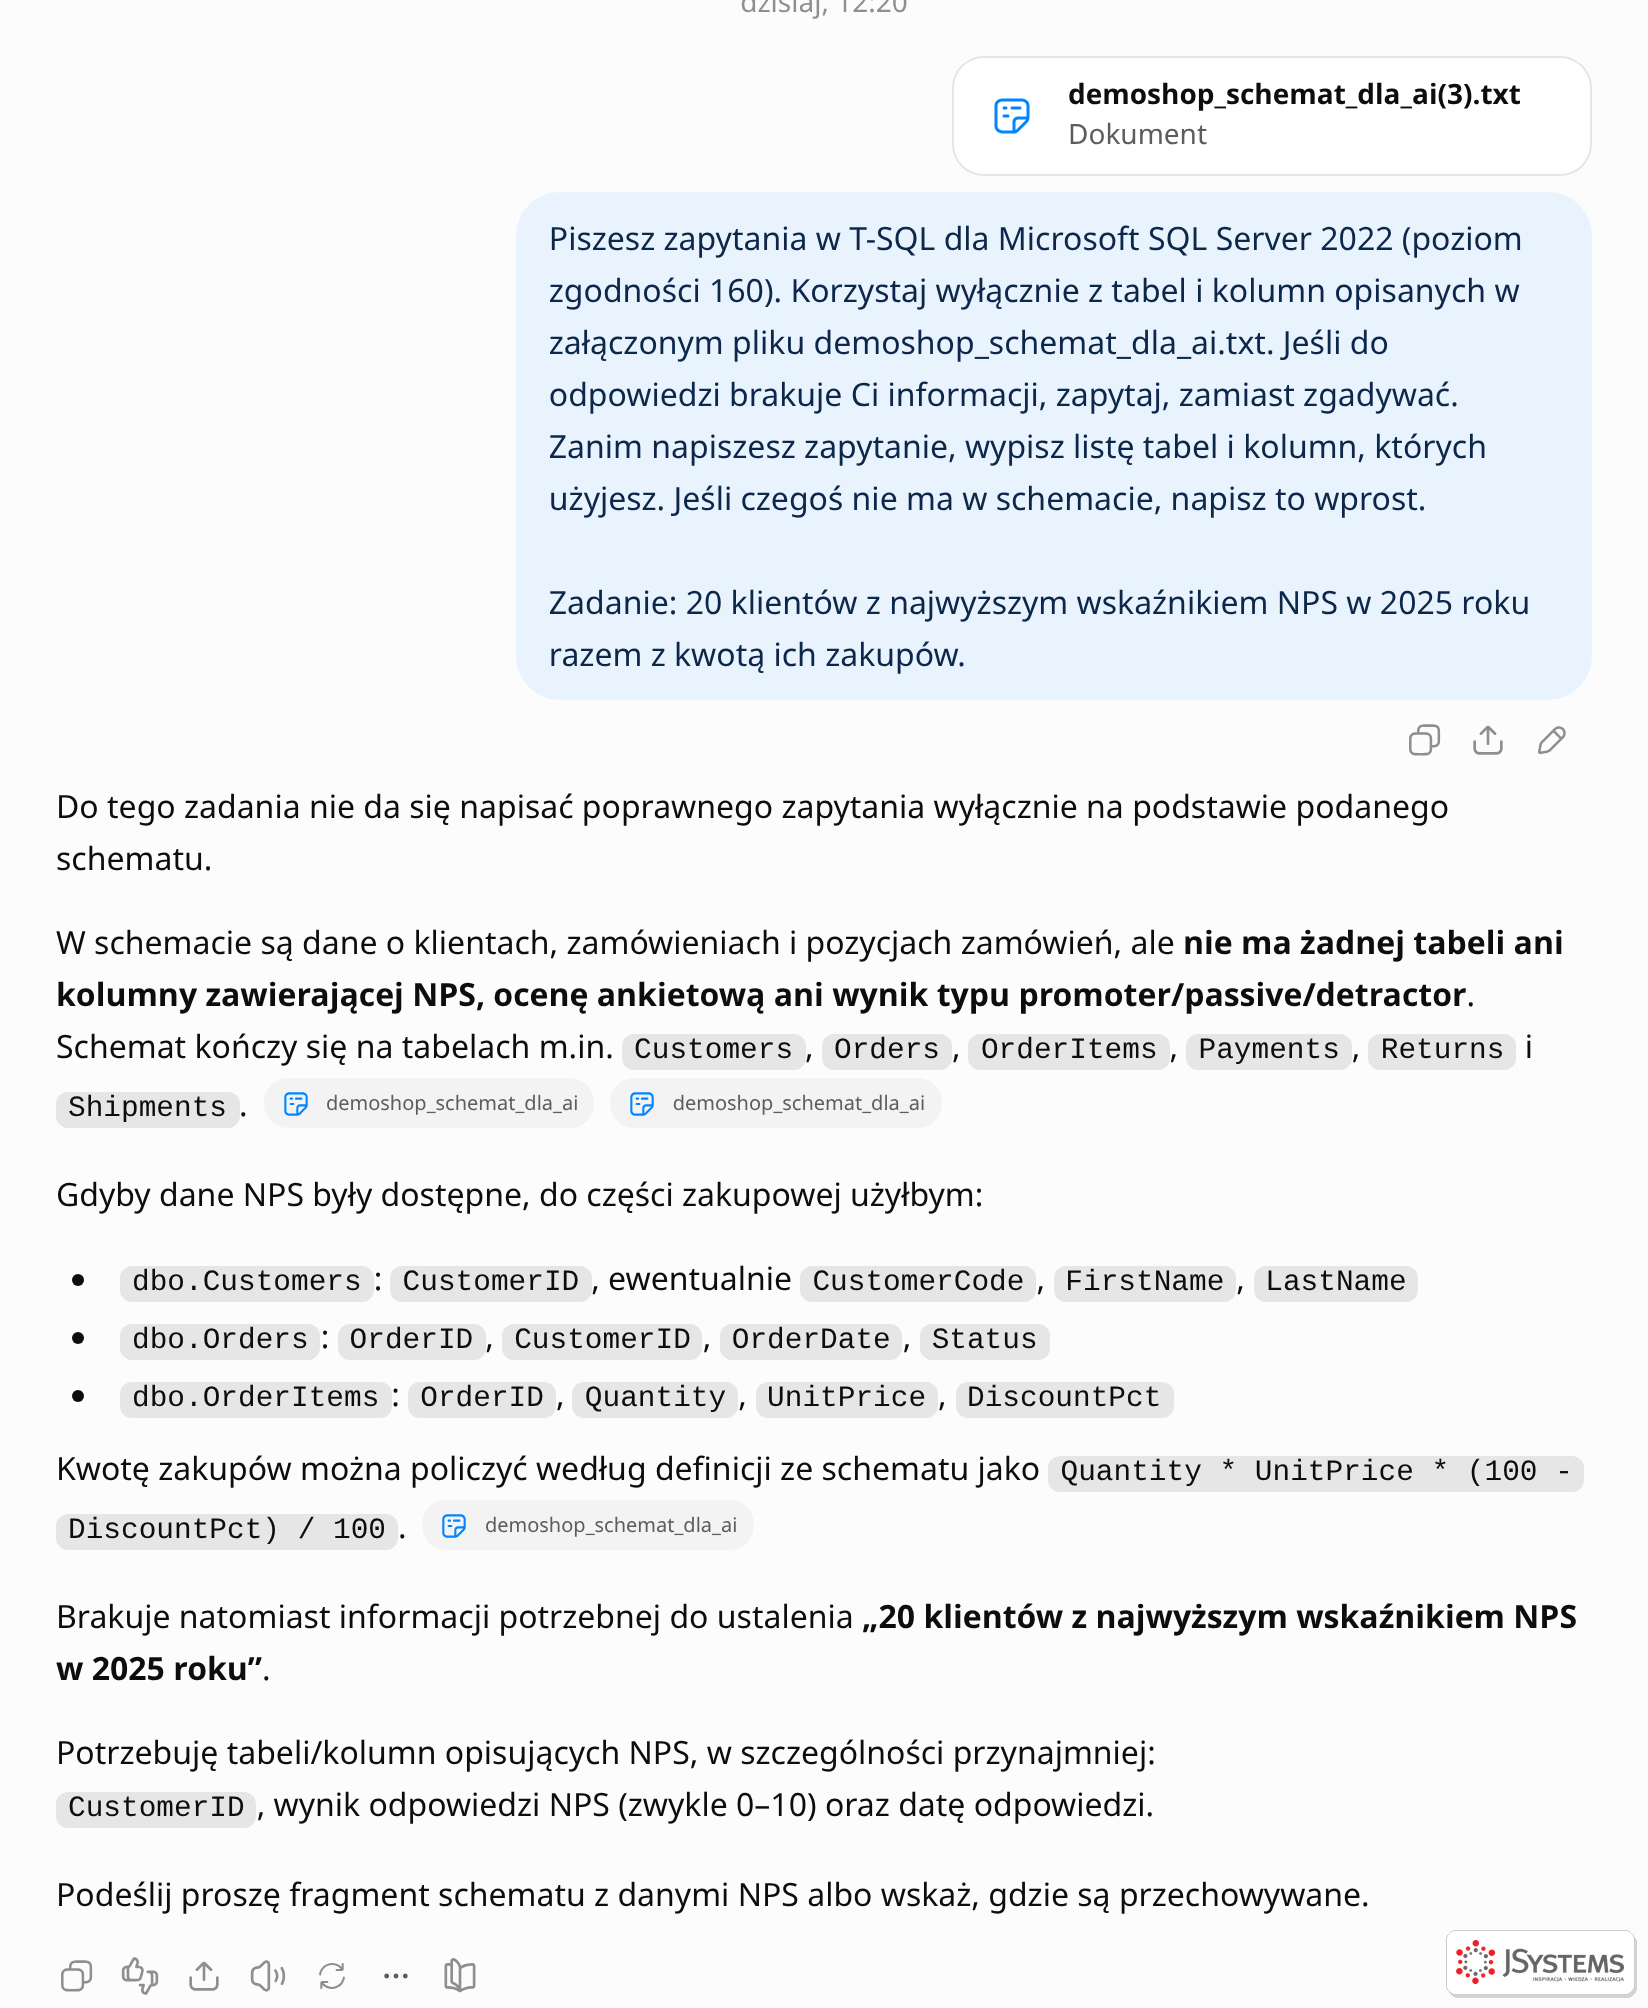
Zdanie „jeśli czegoś nie ma w schemacie, napisz to wprost” kosztuje kilka sekund, a zamienia zgadywanie w pytanie. Ta sama reguła przydała się nam w sekcji o JOIN-ach, gdzie ChatGPT dwa razy zamiast pisać kod dopytał, jak rozumieć polecenie.
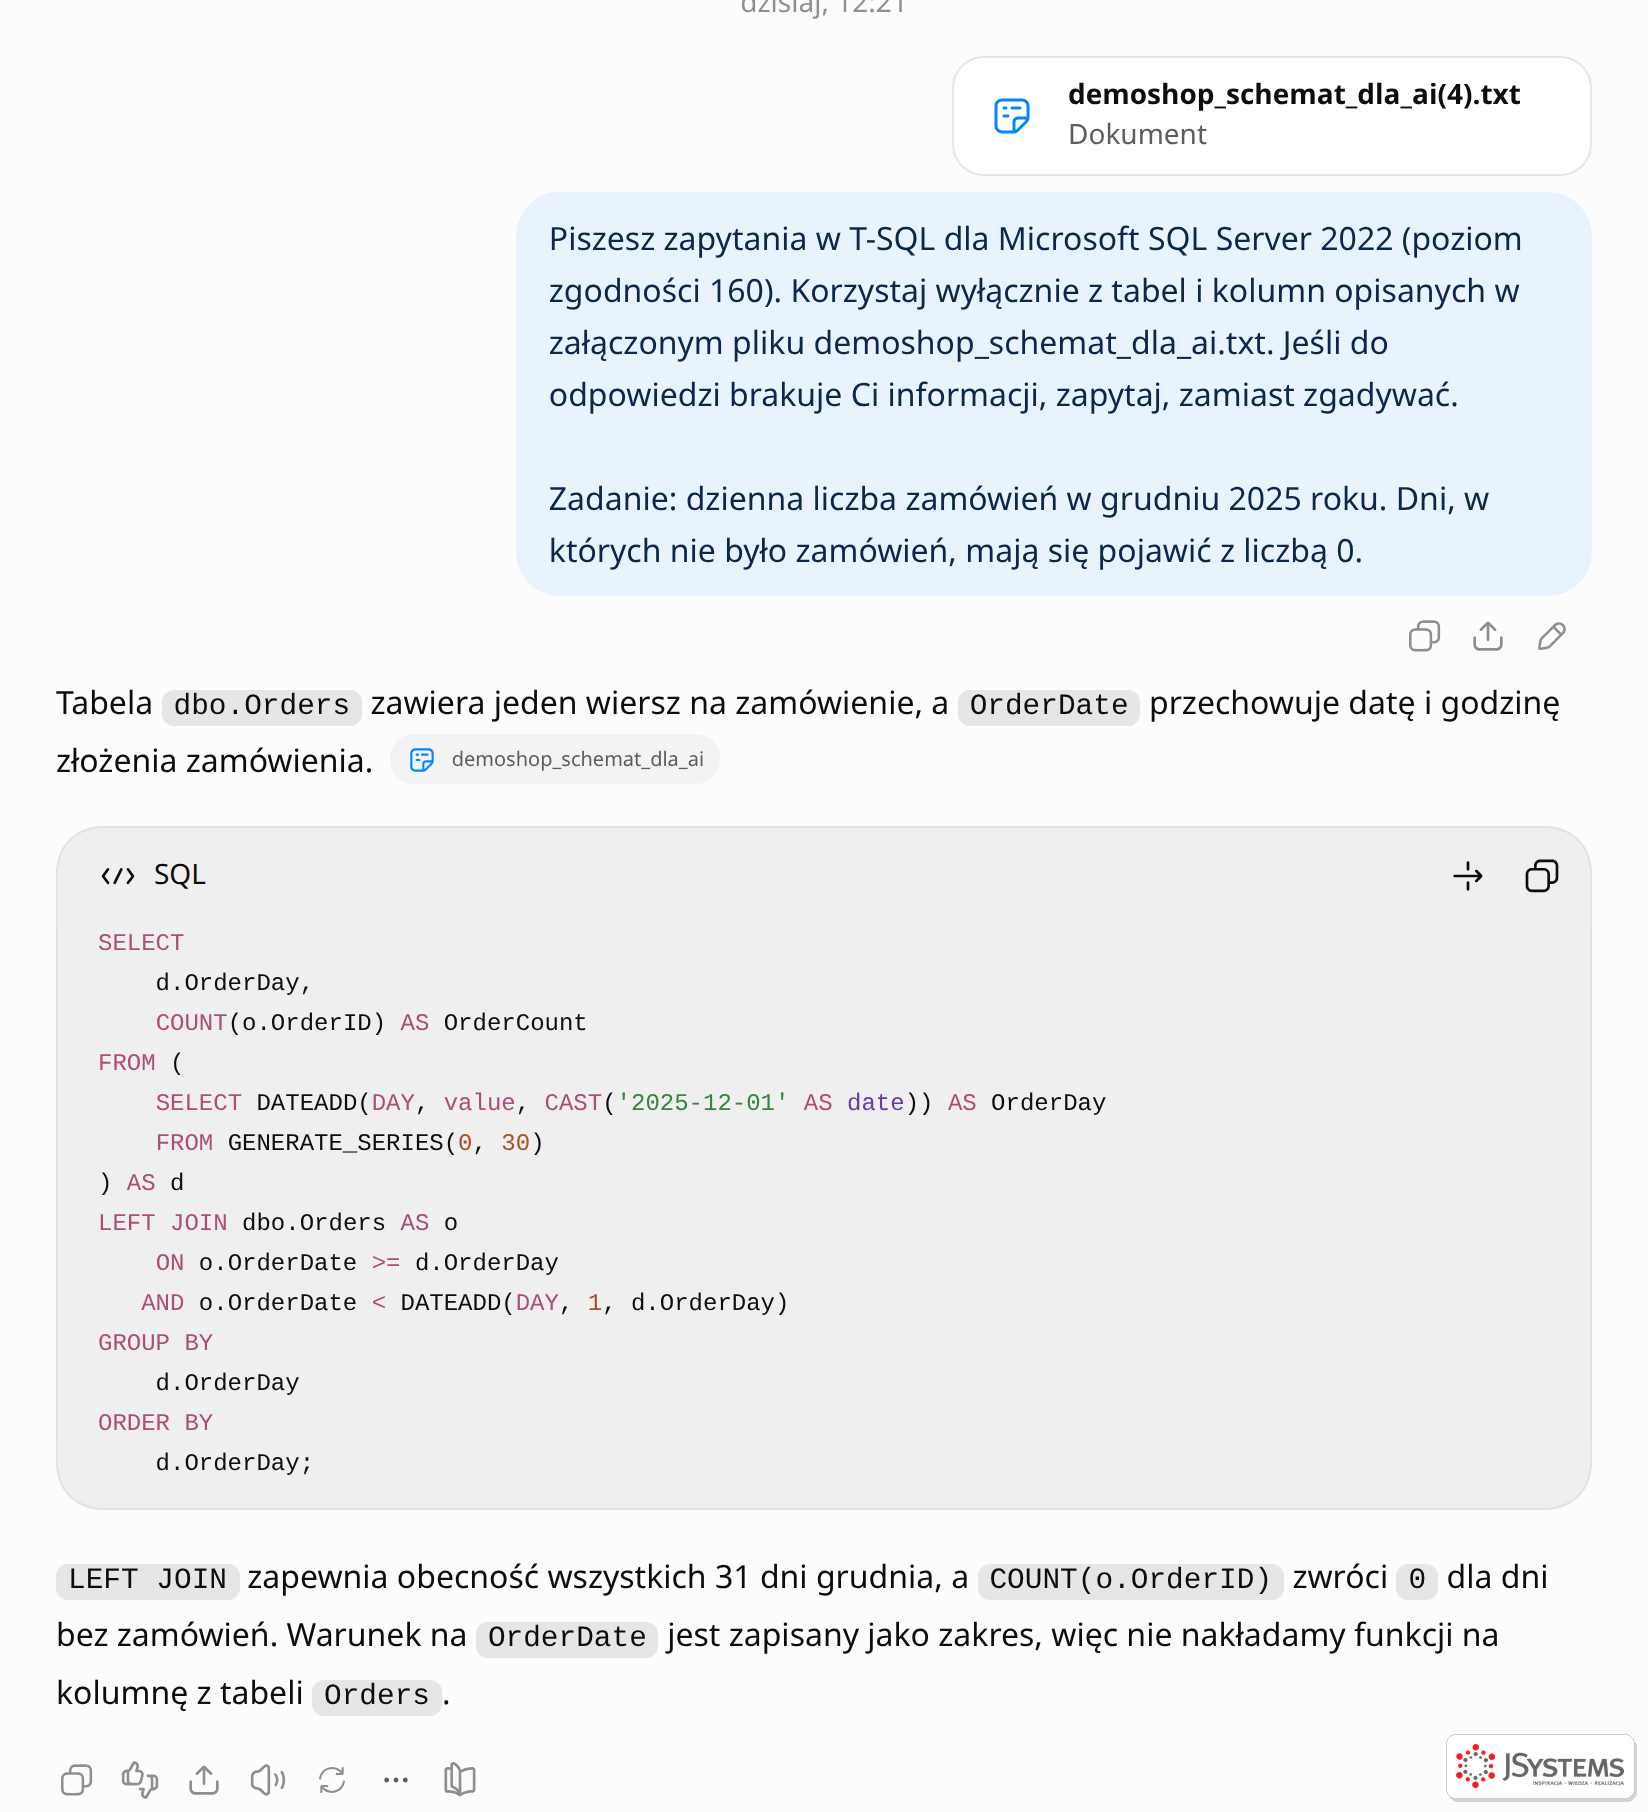
Ostatnia pułapka przy pisaniu zapytań z AI to wersja serwera. Model zna najnowsze funkcje i chętnie ich używa, a w firmach wciąż pracują serwery sprzed kilku lat. Prosimy o dzienną liczbę zamówień w grudniu 2025 roku, z zerami w dniach bez zamówień. W naszym poleceniu znajduje się „SQL Server 2022, poziom zgodności 160”, więc ChatGPT sięga po funkcję GENERATE_SERIES, która generuje ciąg liczb, tu numery dni:
Teraz symulujemy produkcję: bazę na poziomie zgodności 150, czyli takim, jak w SQL Server 2019. Jak pisaliśmy wyżej, o dostępnych funkcjach decyduje poziom zgodności bazy, a nie sama wersja serwera. Uruchamiamy ten sam kod:
-- serwer produkcyjny to SQL Server 2019: ustawiamy ten sam poziom zgodności
ALTER DATABASE DemoShop SET COMPATIBILITY_LEVEL = 150;
GO
SELECT
    d.OrderDay,
    COUNT(o.OrderID) AS OrderCount
FROM (
    SELECT DATEADD(DAY, value, CAST('2025-12-01' AS date)) AS OrderDay
    FROM GENERATE_SERIES(0, 30)
) AS d
LEFT JOIN dbo.Orders AS o
    ON o.OrderDate >= d.OrderDay
   AND o.OrderDate < DATEADD(DAY, 1, d.OrderDay)
GROUP BY
    d.OrderDay
ORDER BY
    d.OrderDay;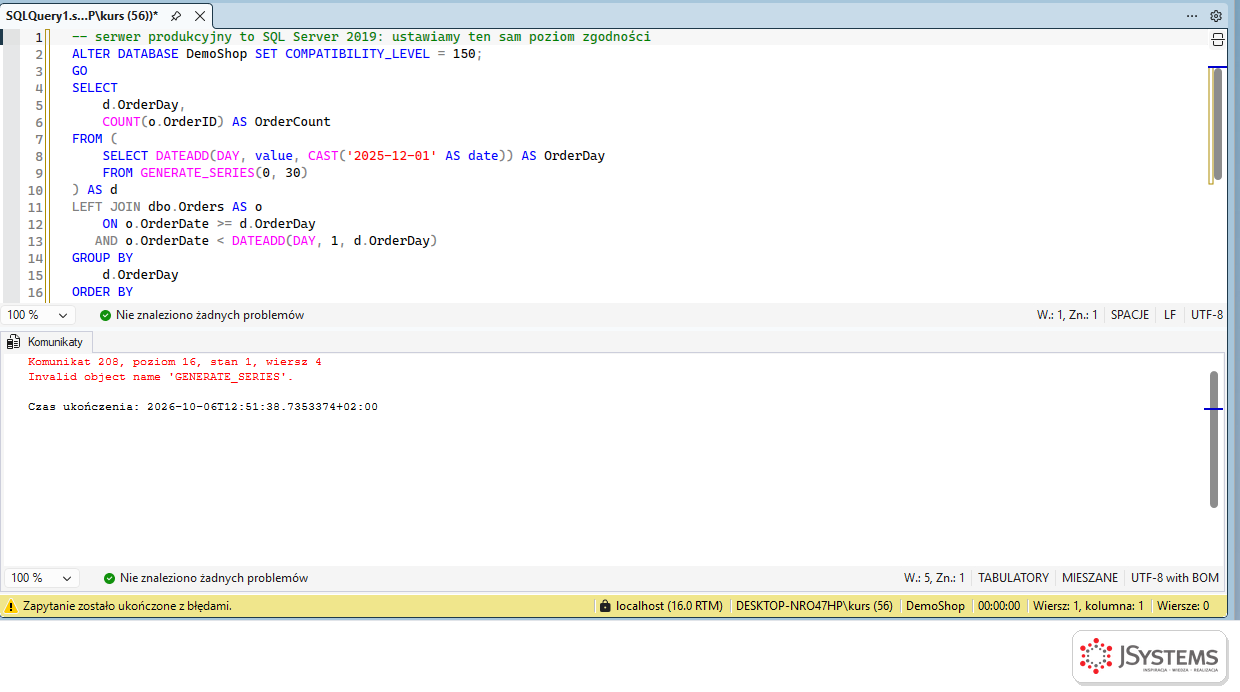
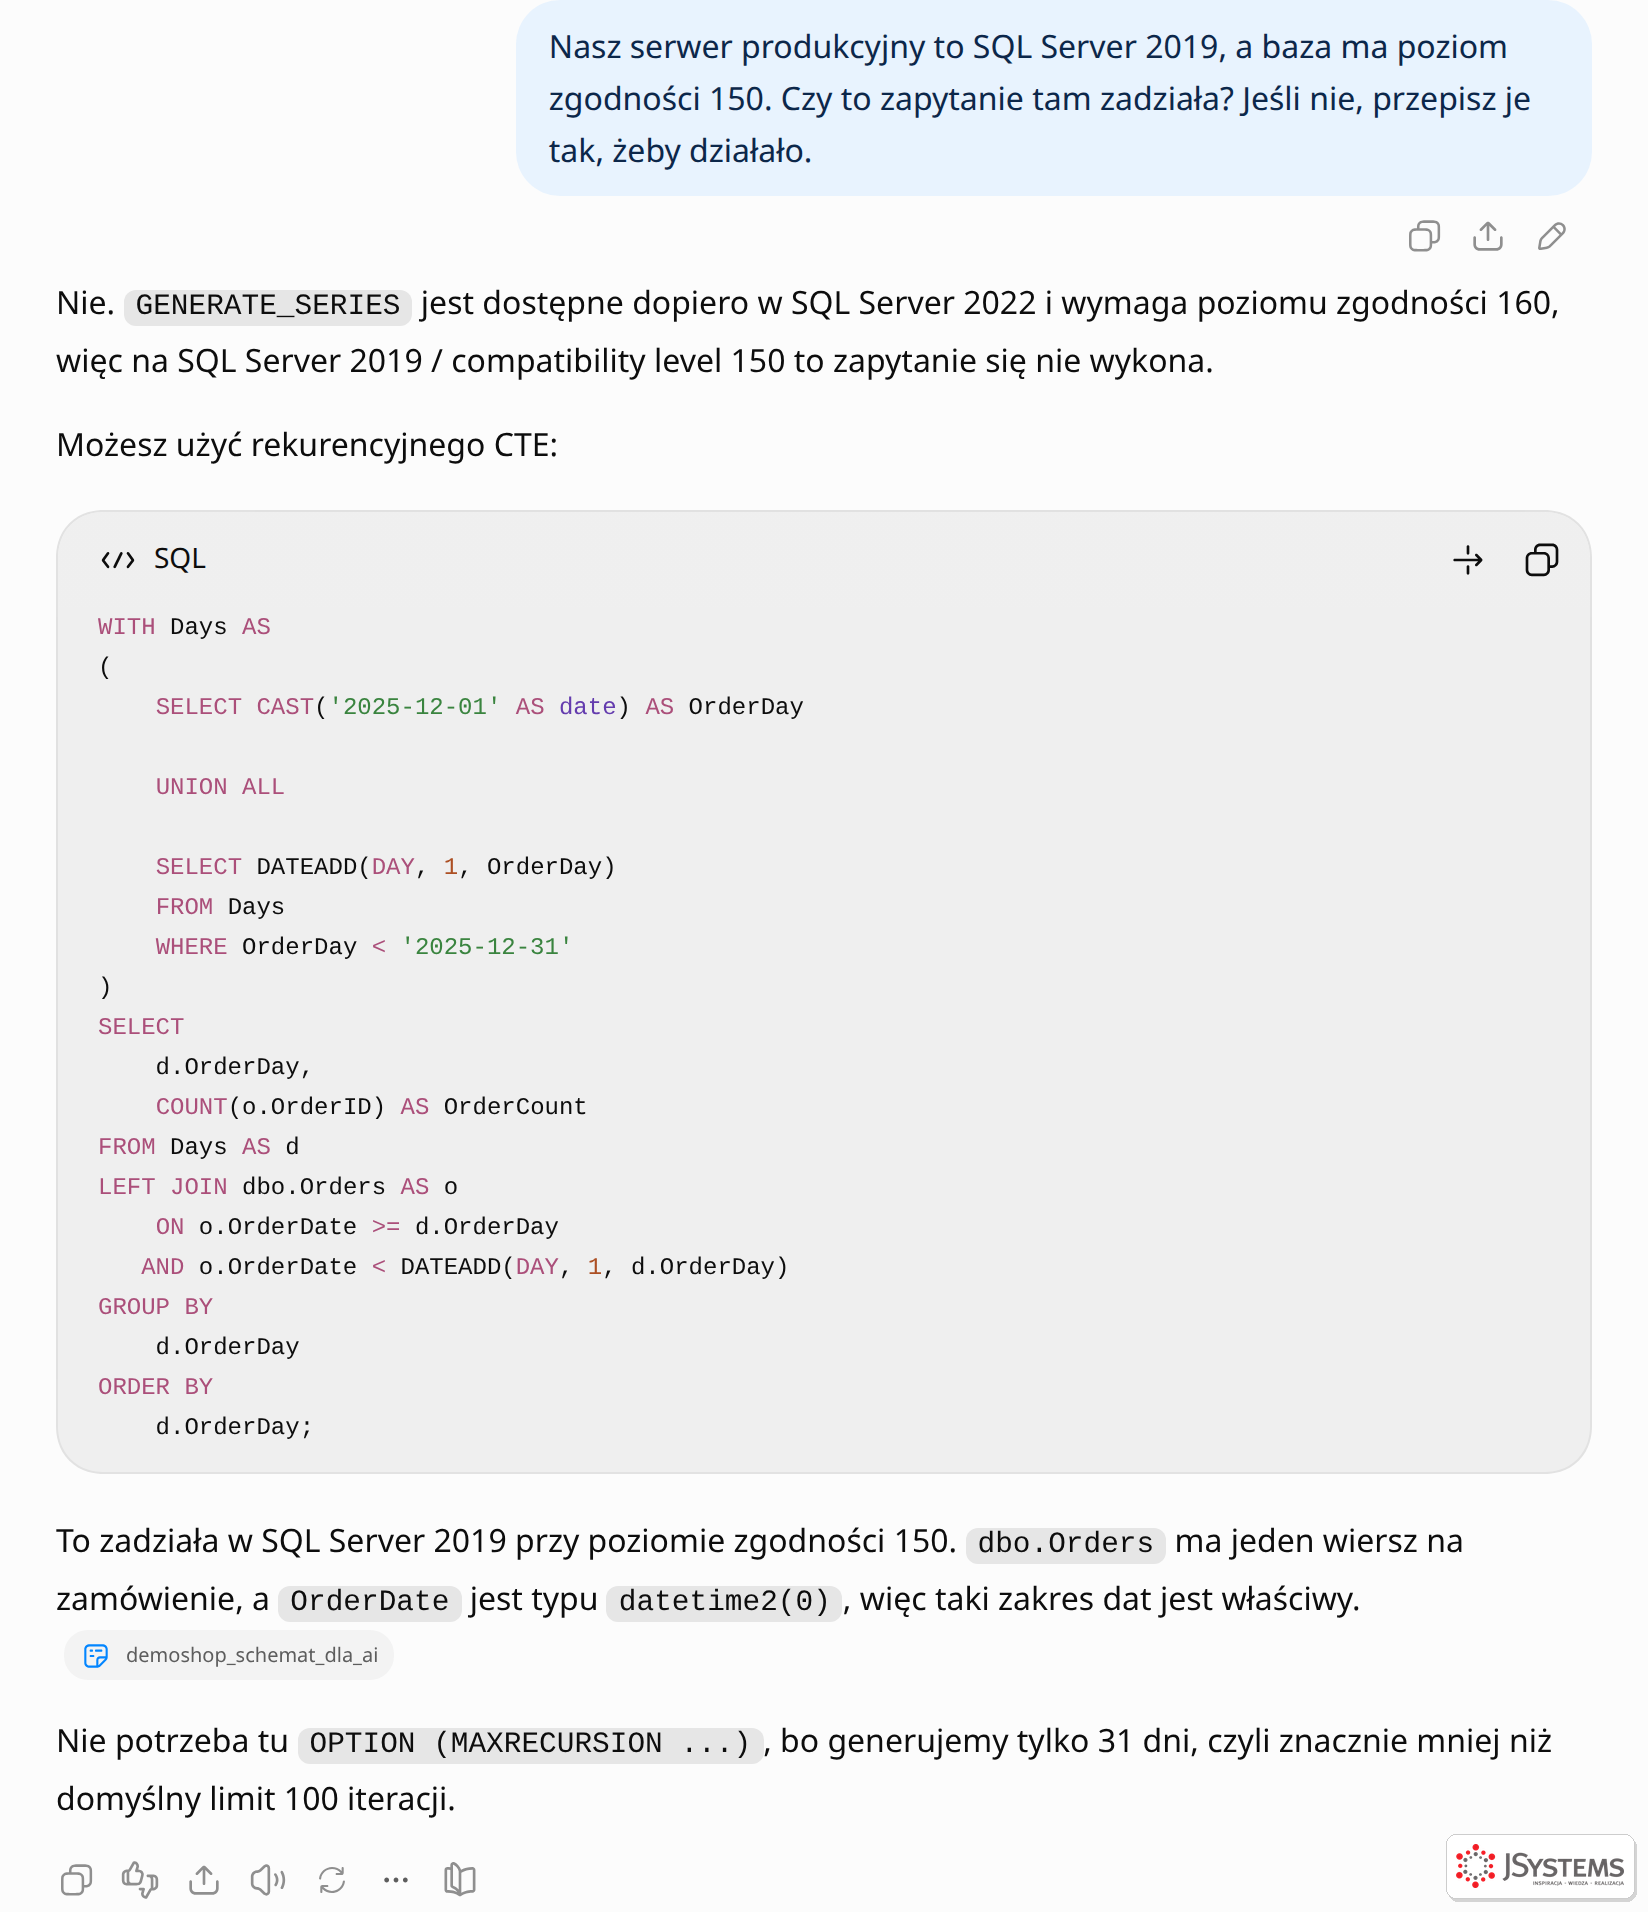
Nasz serwer produkcyjny to SQL Server 2019, a baza ma poziom zgodności 150. Czy to zapytanie tam zadziała? Jeśli nie, przepisz je tak, żeby działało.
WITH Days AS
(
    SELECT CAST('2025-12-01' AS date) AS OrderDay

    UNION ALL

    SELECT DATEADD(DAY, 1, OrderDay)
    FROM Days
    WHERE OrderDay < '2025-12-31'
)
SELECT
    d.OrderDay,
    COUNT(o.OrderID) AS OrderCount
FROM Days AS d
LEFT JOIN dbo.Orders AS o
    ON o.OrderDate >= d.OrderDay
   AND o.OrderDate < DATEADD(DAY, 1, d.OrderDay)
GROUP BY
    d.OrderDay
ORDER BY
    d.OrderDay;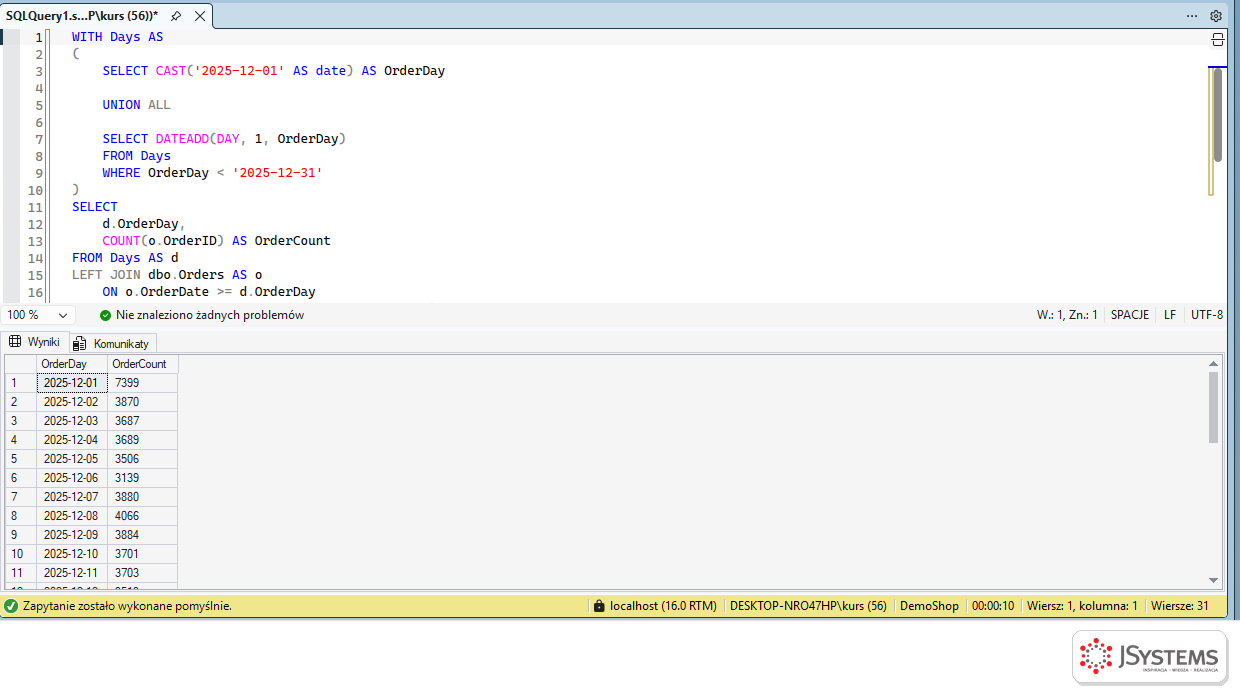
Wniosek praktyczny: w każdym poleceniu, które ma trafić na produkcję, podawaj wersję serwera i poziom zgodności bazy. Oba sprawdzisz jednym zapytaniem: SELECT @@VERSION, compatibility_level FROM sys.databases WHERE name = DB_NAME();.
Schemat to dla AI to samo, co mapa dla kierowcy. Bez niego model zgaduje nazwy kolumn i ścieżki złączeń, z nim pisze zapytania pod Twoją bazę. Zanim jednak cokolwiek wyślesz, warto samemu zobaczyć, jak tabele wyglądają i jak są ze sobą powiązane. SQL Server daje na to kilka dróg. Pokazujemy je od najprostszej do najbardziej przydatnej przy pracy z AI.
W SSMS po lewej stronie jest Eksplorator obiektów (Object Explorer, skrót F8). Rozwijasz kolejno: serwer, Bazy danych, DemoShop, Tabele, wybraną tabelę i folder Kolumny. Przy każdej kolumnie SSMS pokazuje typ danych, informację, czy dopuszcza NULL, i oznaczenia kluczy: PK to klucz główny (unikalny identyfikator wiersza), FK to klucz obcy, czyli kolumna wskazująca na wiersz w innej tabeli. Klucze obce to dla AI najważniejsza informacja, bo mówią, po czym łączyć tabele.
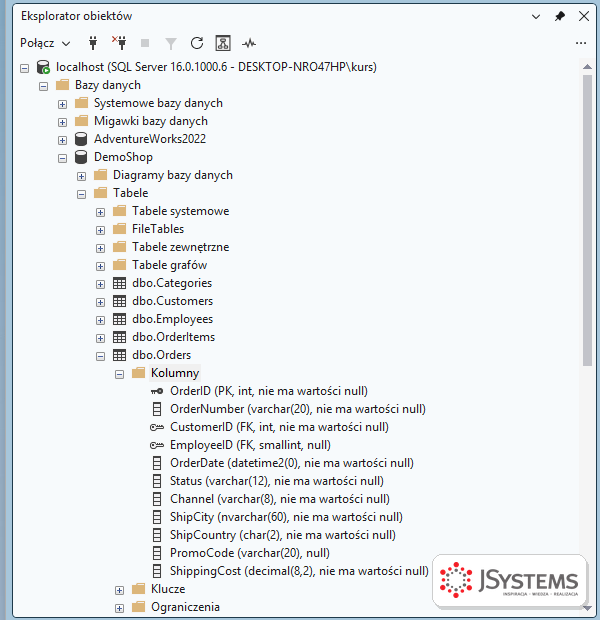
Foldery Klucze, Ograniczenia i Indeksy pod tą samą tabelą pokazują nazwy kluczy obcych (z nazwy zwykle widać, dokąd prowadzą), ograniczenia CHECK, czyli reguły dopuszczalnych wartości, oraz indeksy, które mają znaczenie przy optymalizacji.
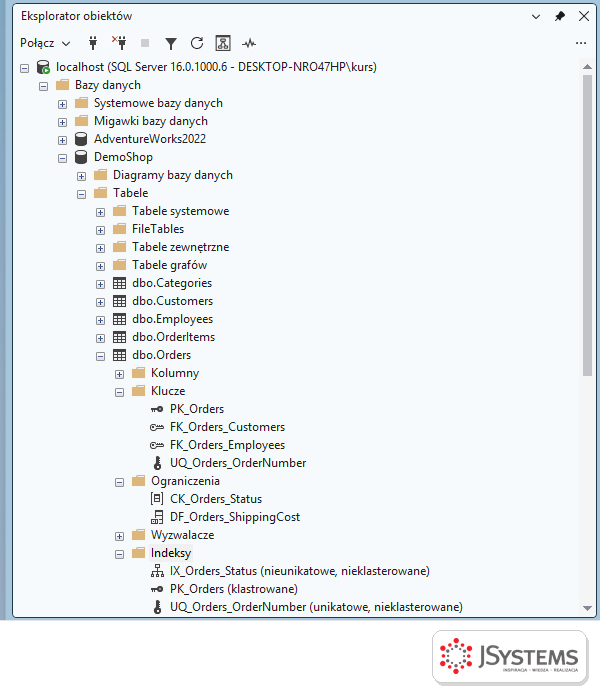
Klikanie po drzewie jest wygodne dla jednej tabeli, ale wolne dla dziesięciu. Procedura systemowa sp_help zwraca wszystko naraz: kolumny z typami i długościami, kolumnę IDENTITY (automatycznie numerowaną), indeksy, ograniczenia, a na końcu listę tabel, które wskazują na tę tabelę swoimi kluczami obcymi.
EXEC sp_help 'dbo.Orders';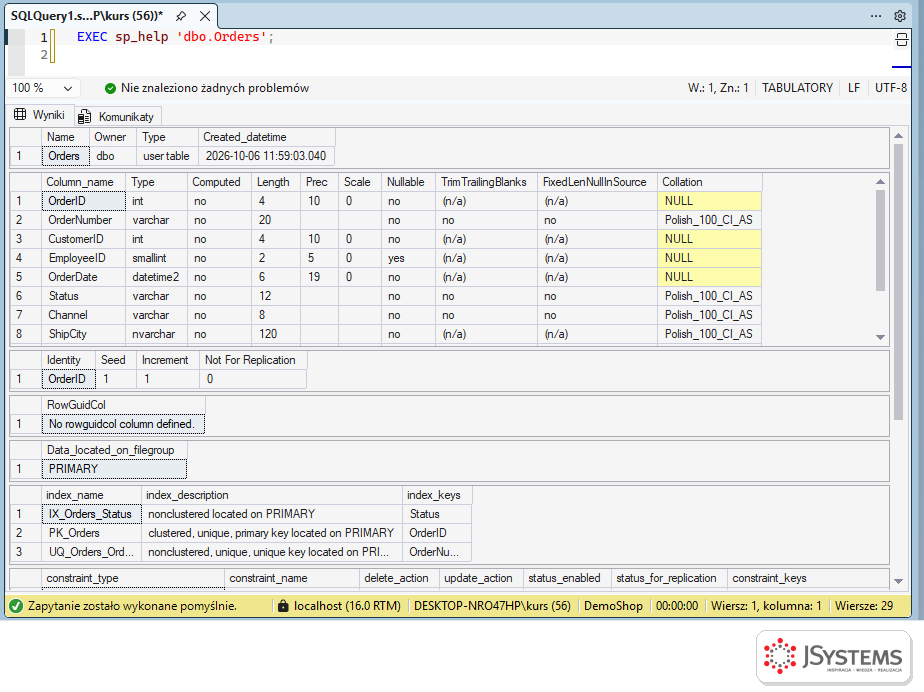
Do pisania złączeń AI potrzebuje pełnej mapy: która kolumna w której tabeli wskazuje na którą. Tę mapę zwracają widoki systemowe sys.foreign_keys i sys.foreign_key_columns. Poniższe zapytanie wypisuje wszystkie relacje w bazie, po jednej w wierszu:
/* Wszystkie relacje (klucze obce) w bazie: kto na kogo wskazuje */
SELECT fk.name                                   AS ForeignKey,
       OBJECT_SCHEMA_NAME(fk.parent_object_id) + '.' + OBJECT_NAME(fk.parent_object_id)
           + '.' + pc.name                       AS ChildColumn,
       OBJECT_SCHEMA_NAME(fk.referenced_object_id) + '.' + OBJECT_NAME(fk.referenced_object_id)
           + '.' + rc.name                       AS ParentColumn,
       fk.delete_referential_action_desc         AS OnDelete
FROM sys.foreign_keys AS fk
JOIN sys.foreign_key_columns AS fkc ON fkc.constraint_object_id = fk.object_id
JOIN sys.columns AS pc ON pc.object_id = fkc.parent_object_id
                      AND pc.column_id = fkc.parent_column_id
JOIN sys.columns AS rc ON rc.object_id = fkc.referenced_object_id
                      AND rc.column_id = fkc.referenced_column_id
ORDER BY ParentColumn, ChildColumn;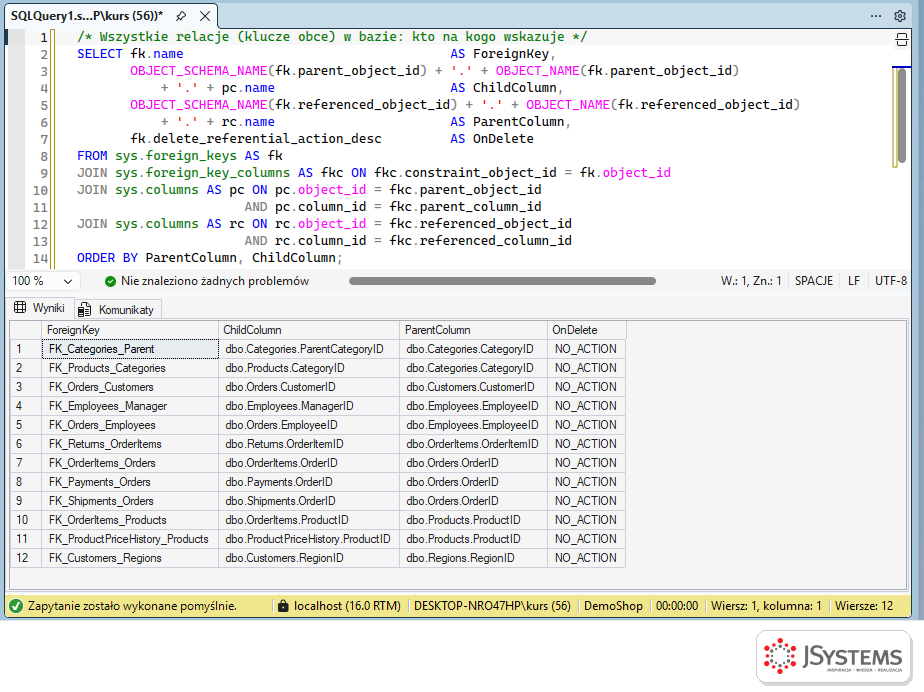
Jeśli wolisz obraz, SSMS narysuje diagram relacji. W Eksploratorze obiektów kliknij prawym przyciskiem folder Diagramy bazy danych pod bazą i wybierz Nowy diagram bazy danych. Przy pierwszym użyciu SSMS zapyta o zainstalowanie obsługi diagramów, czyli kilku obiektów systemowych w bazie; na bazie produkcyjnej uzgodnij to z administratorem.
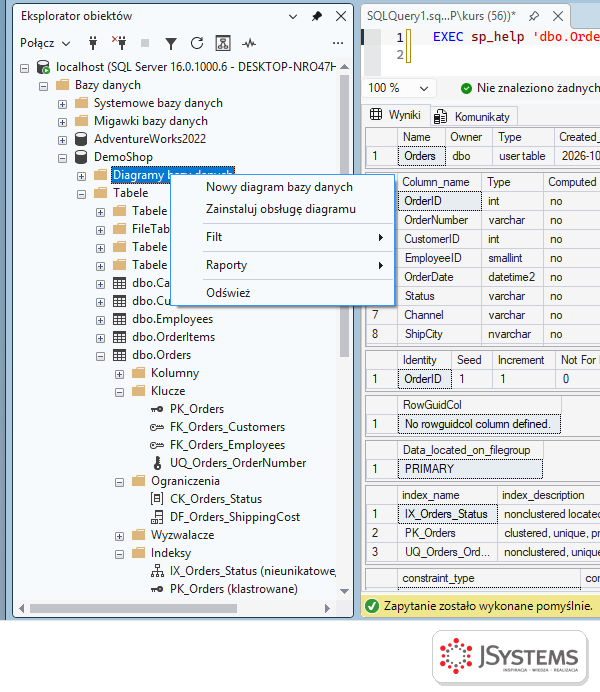
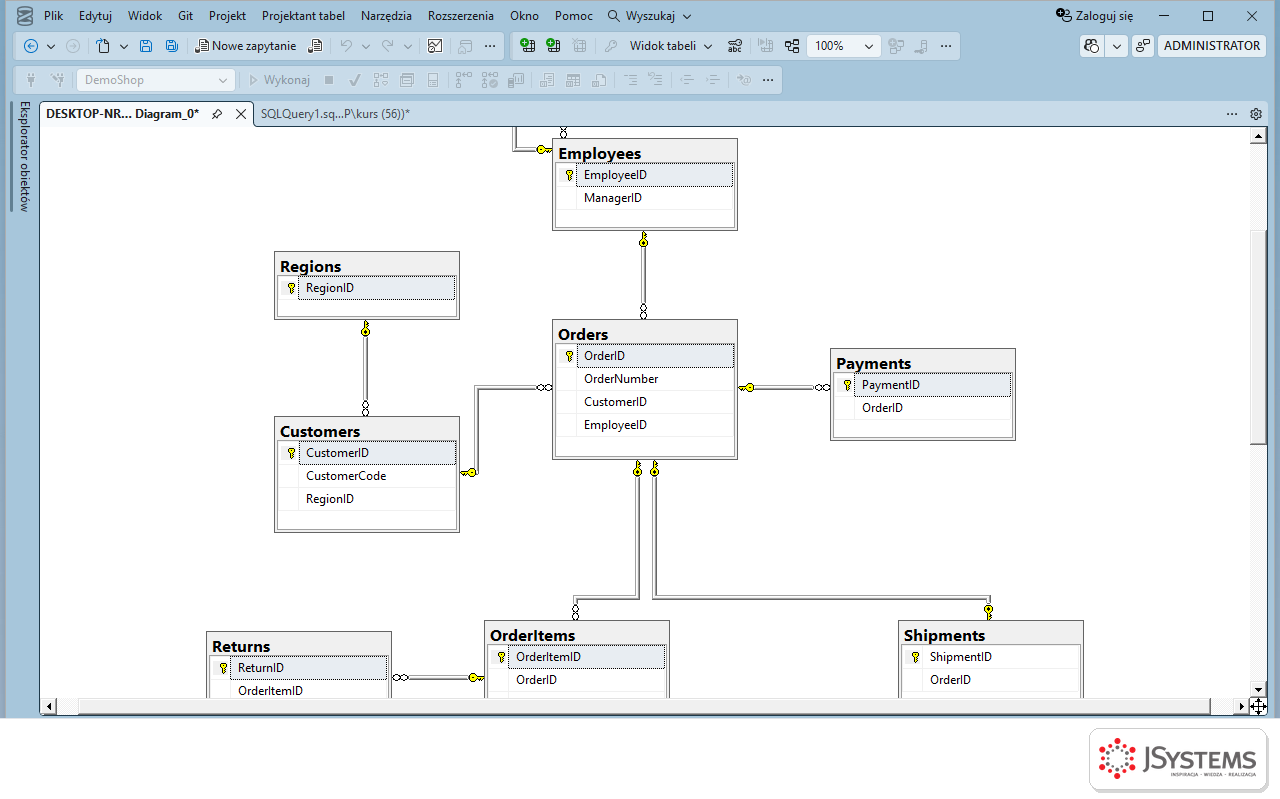
Diagram świetnie się nadaje do zrozumienia bazy przez człowieka. Dla AI zrzut diagramu to gorszy wybór niż tekst: model musi odczytać nazwy z obrazka, a przy kilkudziesięciu tabelach linie się krzyżują. Tekst jest jednoznaczny i zajmuje mniej miejsca w rozmowie.
Najdokładniejszy opis tabeli to jej definicja w SQL. Kliknij tabelę prawym przyciskiem i wybierz Tabela skryptu jako, UTWÓRZ, Nowe okno edytora zapytań.
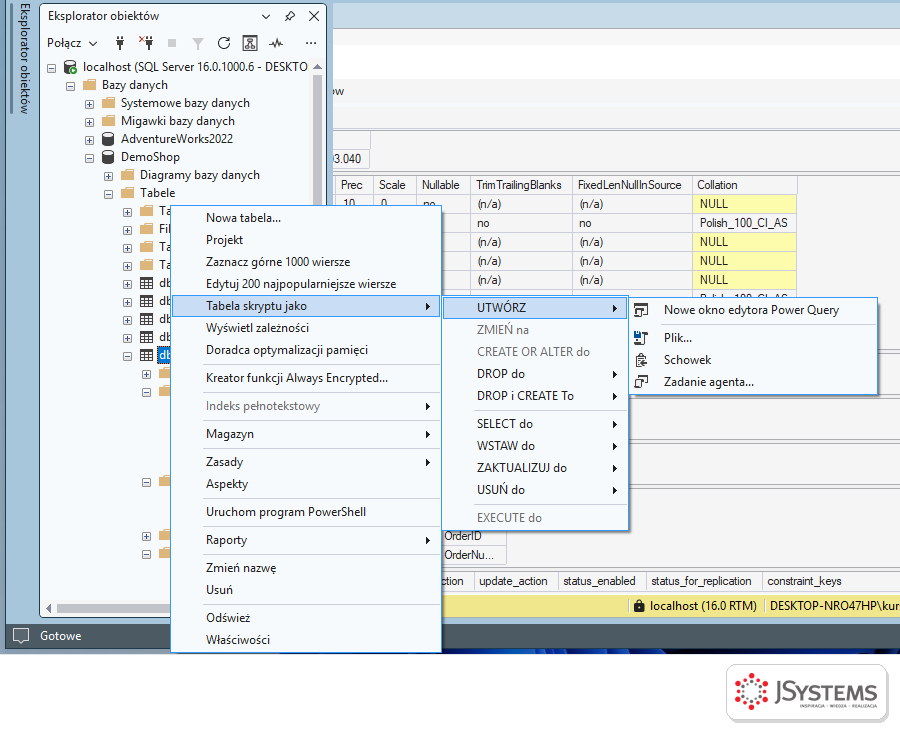
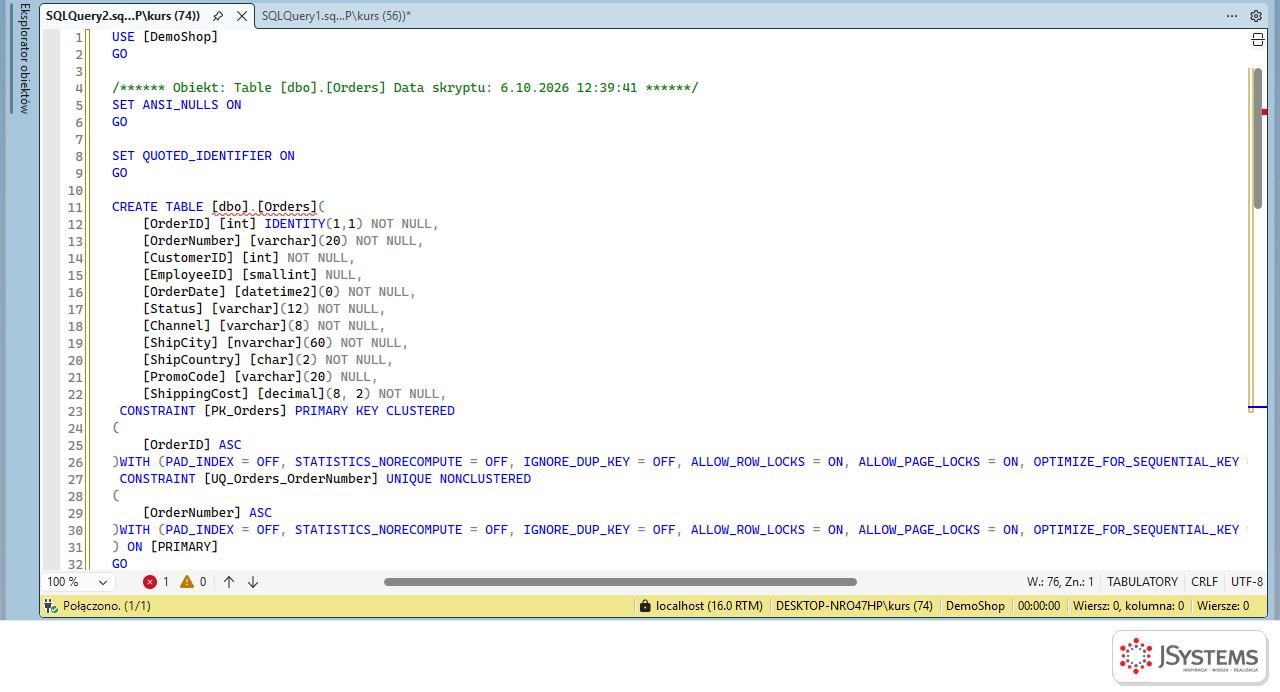
Dla całej bazy użyj kreatora: prawy przycisk na bazie, Zadania, Wygeneruj skrypty. W kroku Wybierz obiekty zaznacz tabele, które mają trafić do AI. Nie wysyłaj wszystkiego z przyzwyczajenia: tabele techniczne, archiwalne i nieużywane w danym zadaniu tylko rozpraszają model.
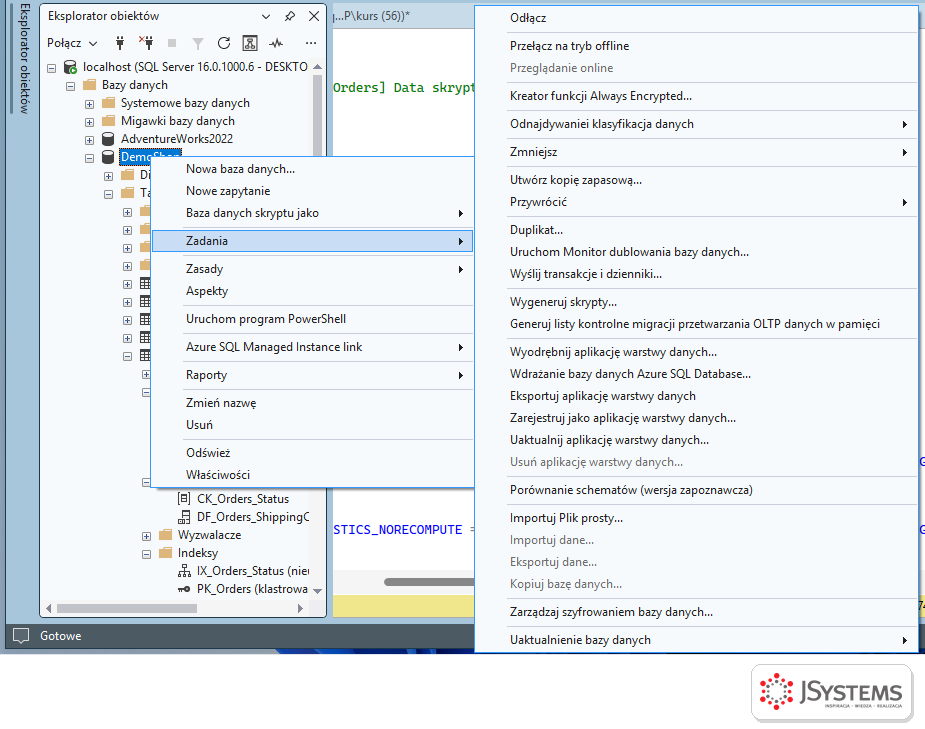
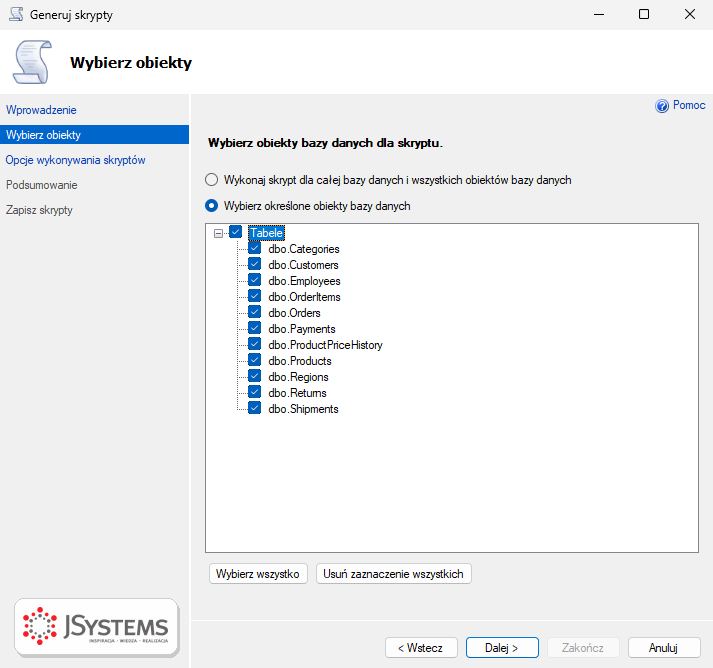
W kroku Opcje wykonywania skryptów kliknij Zaawansowane i sprawdź opcję Typy danych do skryptu. Musi być ustawiona na Tylko schemat. Wartość „Schemat i dane” dopisałaby do pliku polecenia INSERT ze wszystkimi wierszami, czyli do AI trafiłaby zawartość bazy, a nie jej struktura.
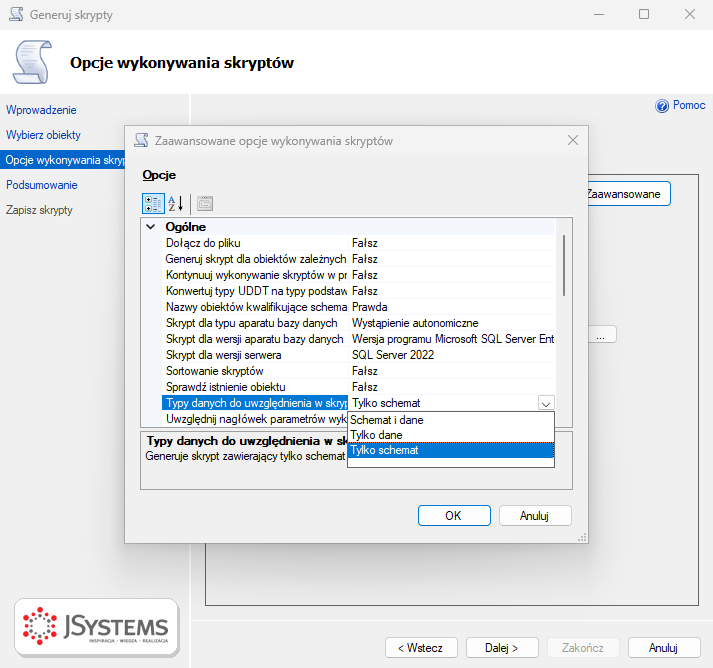
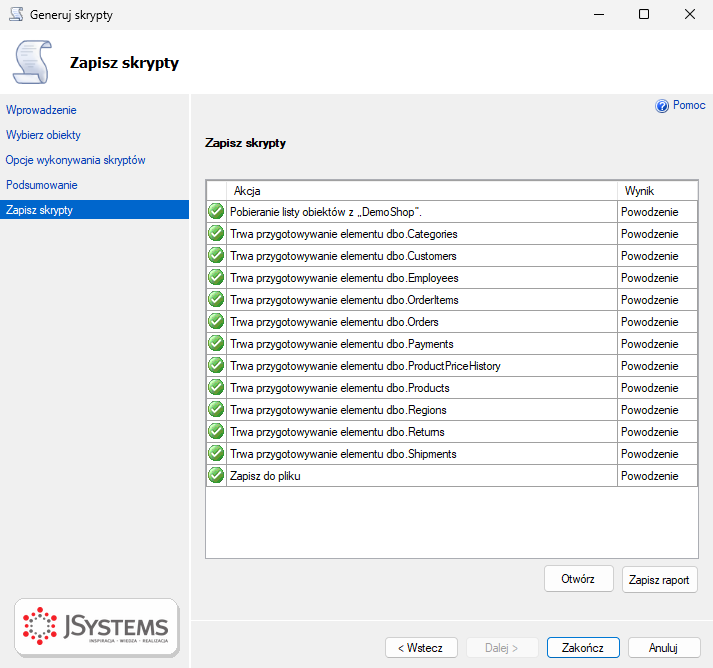
Skrypty CREATE są kompletne, ale rozwlekłe. Dlatego do rozmów z AI przygotowaliśmy zapytanie, które składa opis w formie, jaką model czyta najłatwiej: nagłówek tabeli z liczbą wierszy i opisem, a pod nim kolumny z typem, informacją o NULL, kluczach i dokąd prowadzi klucz obcy, oraz dopuszczalne wartości z ograniczeń CHECK. Zapytanie jest do pobrania jako schemat_dla_ai.sql. Czyta wyłącznie widoki systemowe, więc niczego w bazie nie zmienia i możesz je uruchomić także na produkcji.
/* Opis schematu bazy dla AI: tabele, kolumny, typy, klucze, relacje,
   dopuszczalne wartości (CHECK) i opisy kolumn (MS_Description). */
WITH t AS (
    SELECT t.object_id,
           TableName = SCHEMA_NAME(t.schema_id) + N'.' + t.name,
           RowCnt    = (SELECT SUM(p.rows) FROM sys.partitions AS p
                        WHERE p.object_id = t.object_id AND p.index_id IN (0, 1)),
           Descr     = (SELECT CAST(ep.value AS nvarchar(400)) FROM sys.extended_properties AS ep
                        WHERE ep.major_id = t.object_id AND ep.minor_id = 0 AND ep.name = N'MS_Description')
    FROM sys.tables AS t
    WHERE t.is_ms_shipped = 0
      AND NOT EXISTS (SELECT 1 FROM sys.extended_properties AS x   -- pomijamy np. dbo.sysdiagrams
                      WHERE x.major_id = t.object_id AND x.name = N'microsoft_database_tools_support')
)
SELECT SchemaForAI
FROM (
    /* nagłówek tabeli: nazwa, liczba wierszy, opis */
    SELECT t.TableName, Ord = 0,
           SchemaForAI = t.TableName + N' (' + REPLACE(FORMAT(t.RowCnt, N'N0', N'en-US'), N',', N' ')
                         + N' wierszy)' + ISNULL(N': ' + t.Descr, N'')
    FROM t
    UNION ALL
    /* kolumny: typ, NULL, klucz główny, klucz obcy, opis */
    SELECT t.TableName, Ord = c.column_id,
           SchemaForAI = N'    ' + c.name + N' ' + TYPE_NAME(c.user_type_id)
             + CASE WHEN TYPE_NAME(c.user_type_id) IN (N'varchar', N'char')
                         THEN N'(' + IIF(c.max_length = -1, N'max', CAST(c.max_length AS nvarchar(10))) + N')'
                    WHEN TYPE_NAME(c.user_type_id) IN (N'nvarchar', N'nchar')
                         THEN N'(' + IIF(c.max_length = -1, N'max', CAST(c.max_length / 2 AS nvarchar(10))) + N')'
                    WHEN TYPE_NAME(c.user_type_id) IN (N'decimal', N'numeric')
                         THEN N'(' + CAST(c.precision AS nvarchar(3)) + N',' + CAST(c.scale AS nvarchar(3)) + N')'
                    WHEN TYPE_NAME(c.user_type_id) IN (N'datetime2', N'datetimeoffset', N'time')
                         THEN N'(' + CAST(c.scale AS nvarchar(3)) + N')'
                    ELSE N'' END
             + IIF(c.is_nullable = 1, N' NULL', N' NOT NULL')
             + IIF(c.is_identity = 1, N' IDENTITY', N'')
             + IIF(EXISTS (SELECT 1 FROM sys.indexes AS i
                           JOIN sys.index_columns AS ic ON ic.object_id = i.object_id AND ic.index_id = i.index_id
                           WHERE i.object_id = c.object_id AND i.is_primary_key = 1 AND ic.column_id = c.column_id),
                   N' PK', N'')
             + ISNULL((SELECT TOP (1) N' FK -> ' + OBJECT_SCHEMA_NAME(fkc.referenced_object_id) + N'.'
                              + OBJECT_NAME(fkc.referenced_object_id) + N'.' + rc.name
                       FROM sys.foreign_key_columns AS fkc
                       JOIN sys.columns AS rc ON rc.object_id = fkc.referenced_object_id
                                             AND rc.column_id = fkc.referenced_column_id
                       WHERE fkc.parent_object_id = c.object_id AND fkc.parent_column_id = c.column_id), N'')
             + ISNULL((SELECT N'  -- ' + CAST(ep.value AS nvarchar(400)) FROM sys.extended_properties AS ep
                       WHERE ep.major_id = c.object_id AND ep.minor_id = c.column_id
                         AND ep.name = N'MS_Description'), N'')
    FROM t
    JOIN sys.columns AS c ON c.object_id = t.object_id
    UNION ALL
    /* dopuszczalne wartości z ograniczeń CHECK */
    SELECT t.TableName, Ord = 1000 + ROW_NUMBER() OVER (PARTITION BY t.TableName ORDER BY cc.name),
           SchemaForAI = N'    CHECK ' + cc.definition
    FROM t
    JOIN sys.check_constraints AS cc ON cc.parent_object_id = t.object_id
) AS x
ORDER BY x.TableName, x.Ord;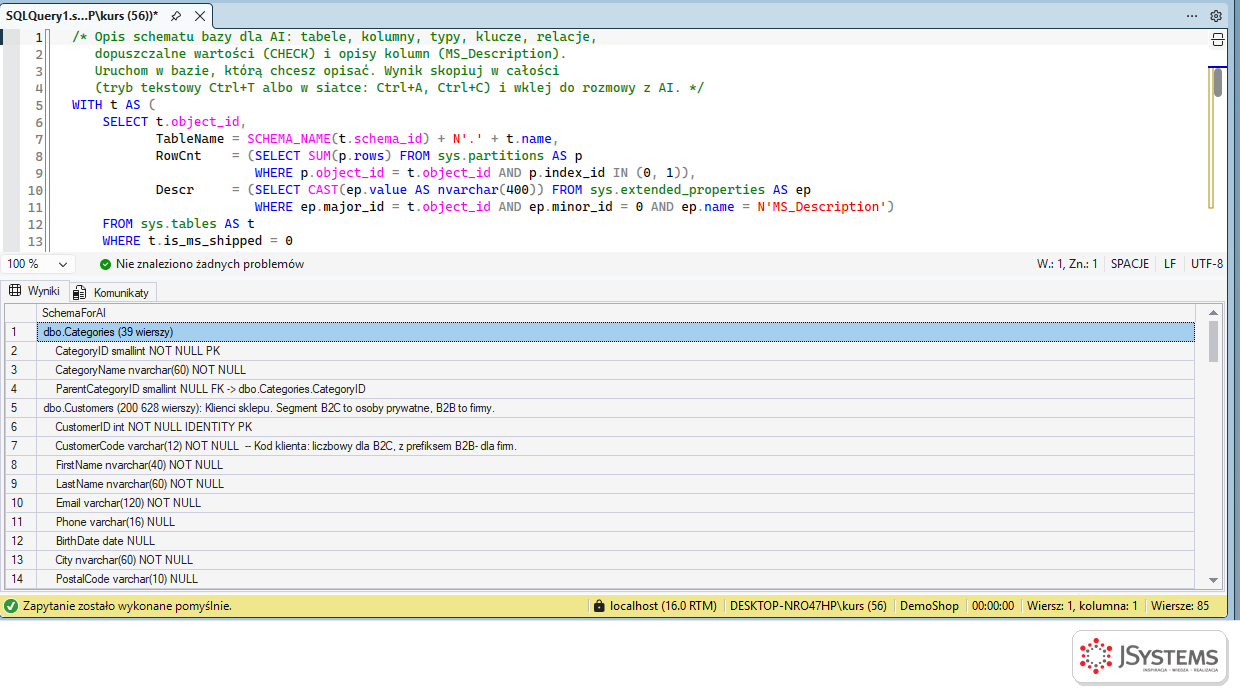
Cały opis DemoShop zajmuje 85 linijek i niecałe 5 KB, a mimo to zawiera wszystko, czego AI potrzebuje do pisania złączeń: jedenaście tabel, ich rozmiar, kolumny, klucze i relacje. Wynik najwygodniej skopiować w trybie tekstowym (Ctrl+T przed uruchomieniem zapytania) albo zaznaczyć w siatce i skopiować Ctrl+C, a potem zapisać do pliku .txt i załączyć do rozmowy. Plik, którego używaliśmy we wszystkich przykładach, jest do pobrania: demoshop_schemat_dla_ai.txt.
Typ varchar(12) nie powie AI, że to kod klienta, który dla firm ma prefiks „B2B-”. Takie znaczenie najlepiej zapisać w samej bazie jako właściwość rozszerzoną MS_Description. SSMS pokazuje ją we właściwościach kolumny, a nasze zapytanie dokleja ją do opisu po znakach --. Dopisanie opisu to jedno wywołanie procedury:
/* Opis kolumny zapisany w samej bazie - trafi do AI razem ze schematem */
EXEC sys.sp_addextendedproperty
     @name = N'MS_Description',
     @value = N'Kod promocji użyty w zamówieniu. NULL = zamówienie bez promocji.',
     @level0type = N'SCHEMA', @level0name = N'dbo',
     @level1type = N'TABLE',  @level1name = N'Orders',
     @level2type = N'COLUMN', @level2name = N'PromoCode';

SELECT c.name AS ColumnName,
       CAST(ep.value AS nvarchar(200)) AS Description
FROM sys.extended_properties AS ep
JOIN sys.columns AS c ON c.object_id = ep.major_id AND c.column_id = ep.minor_id
WHERE ep.major_id = OBJECT_ID(N'dbo.Orders') AND ep.name = N'MS_Description'
ORDER BY c.column_id;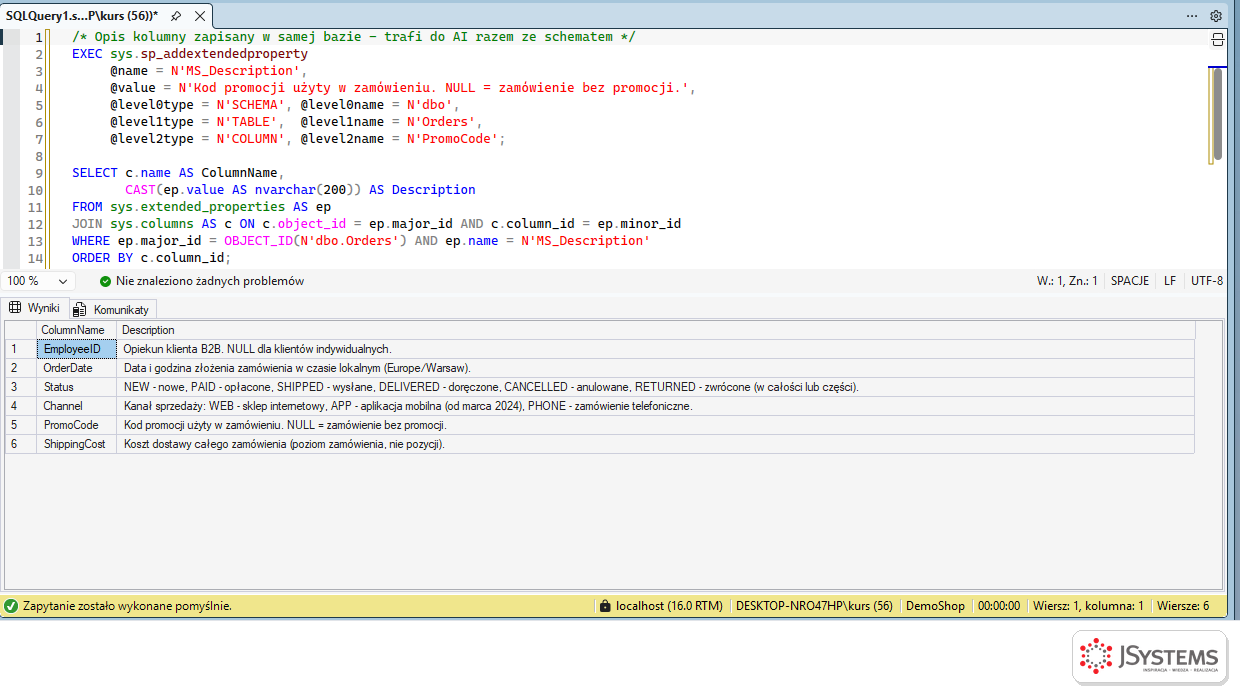
Opisy warto dodawać przede wszystkim tam, gdzie nazwa kolumny wprowadza w błąd albo kryje regułę: statusy i ich znaczenie, jednostki i waluty, strefy czasowe, pola, w których NULL coś oznacza, kolumny „IsActive”, które nie znaczą tego, co sugeruje nazwa. W DemoShop opis Customers.IsActive mówi wprost: „1 = konto nieusunięte i niezablokowane. To NIE oznacza, że klient ostatnio coś kupił”. Bez tego zdania AI zapytane o aktywnych klientów policzyłoby konta, a nie kupujących.
Sprawdźmy opis w akcji na zadaniu, które wymaga czterech tabel i jednej reguły biznesowej: przychód w podziale na województwo klienta i kanał sprzedaży, z osobną grupą dla klientów bez województwa.
Piszesz zapytania w T-SQL dla Microsoft SQL Server 2022 (poziom zgodności 160). Korzystaj wyłącznie z tabel i kolumn opisanych w załączonym pliku demoshop_schemat_dla_ai.txt. Jeśli do odpowiedzi brakuje Ci informacji, zapytaj, zamiast zgadywać.
Zasady liczenia:
- kwota zakupów to suma wartości pozycji: Quantity * UnitPrice * (100 - DiscountPct) / 100, bez kosztu dostawy,
- zamówienia anulowane (Status = 'CANCELLED') nie liczą się do sprzedaży,
- rok liczymy według OrderDate (czas lokalny).
Zadanie: przychód w 2025 roku w podziale na województwo klienta i kanał sprzedaży. Klienci spoza Polski i bez województwa w osobnej grupie „brak województwa”. Posortuj malejąco według przychodu.
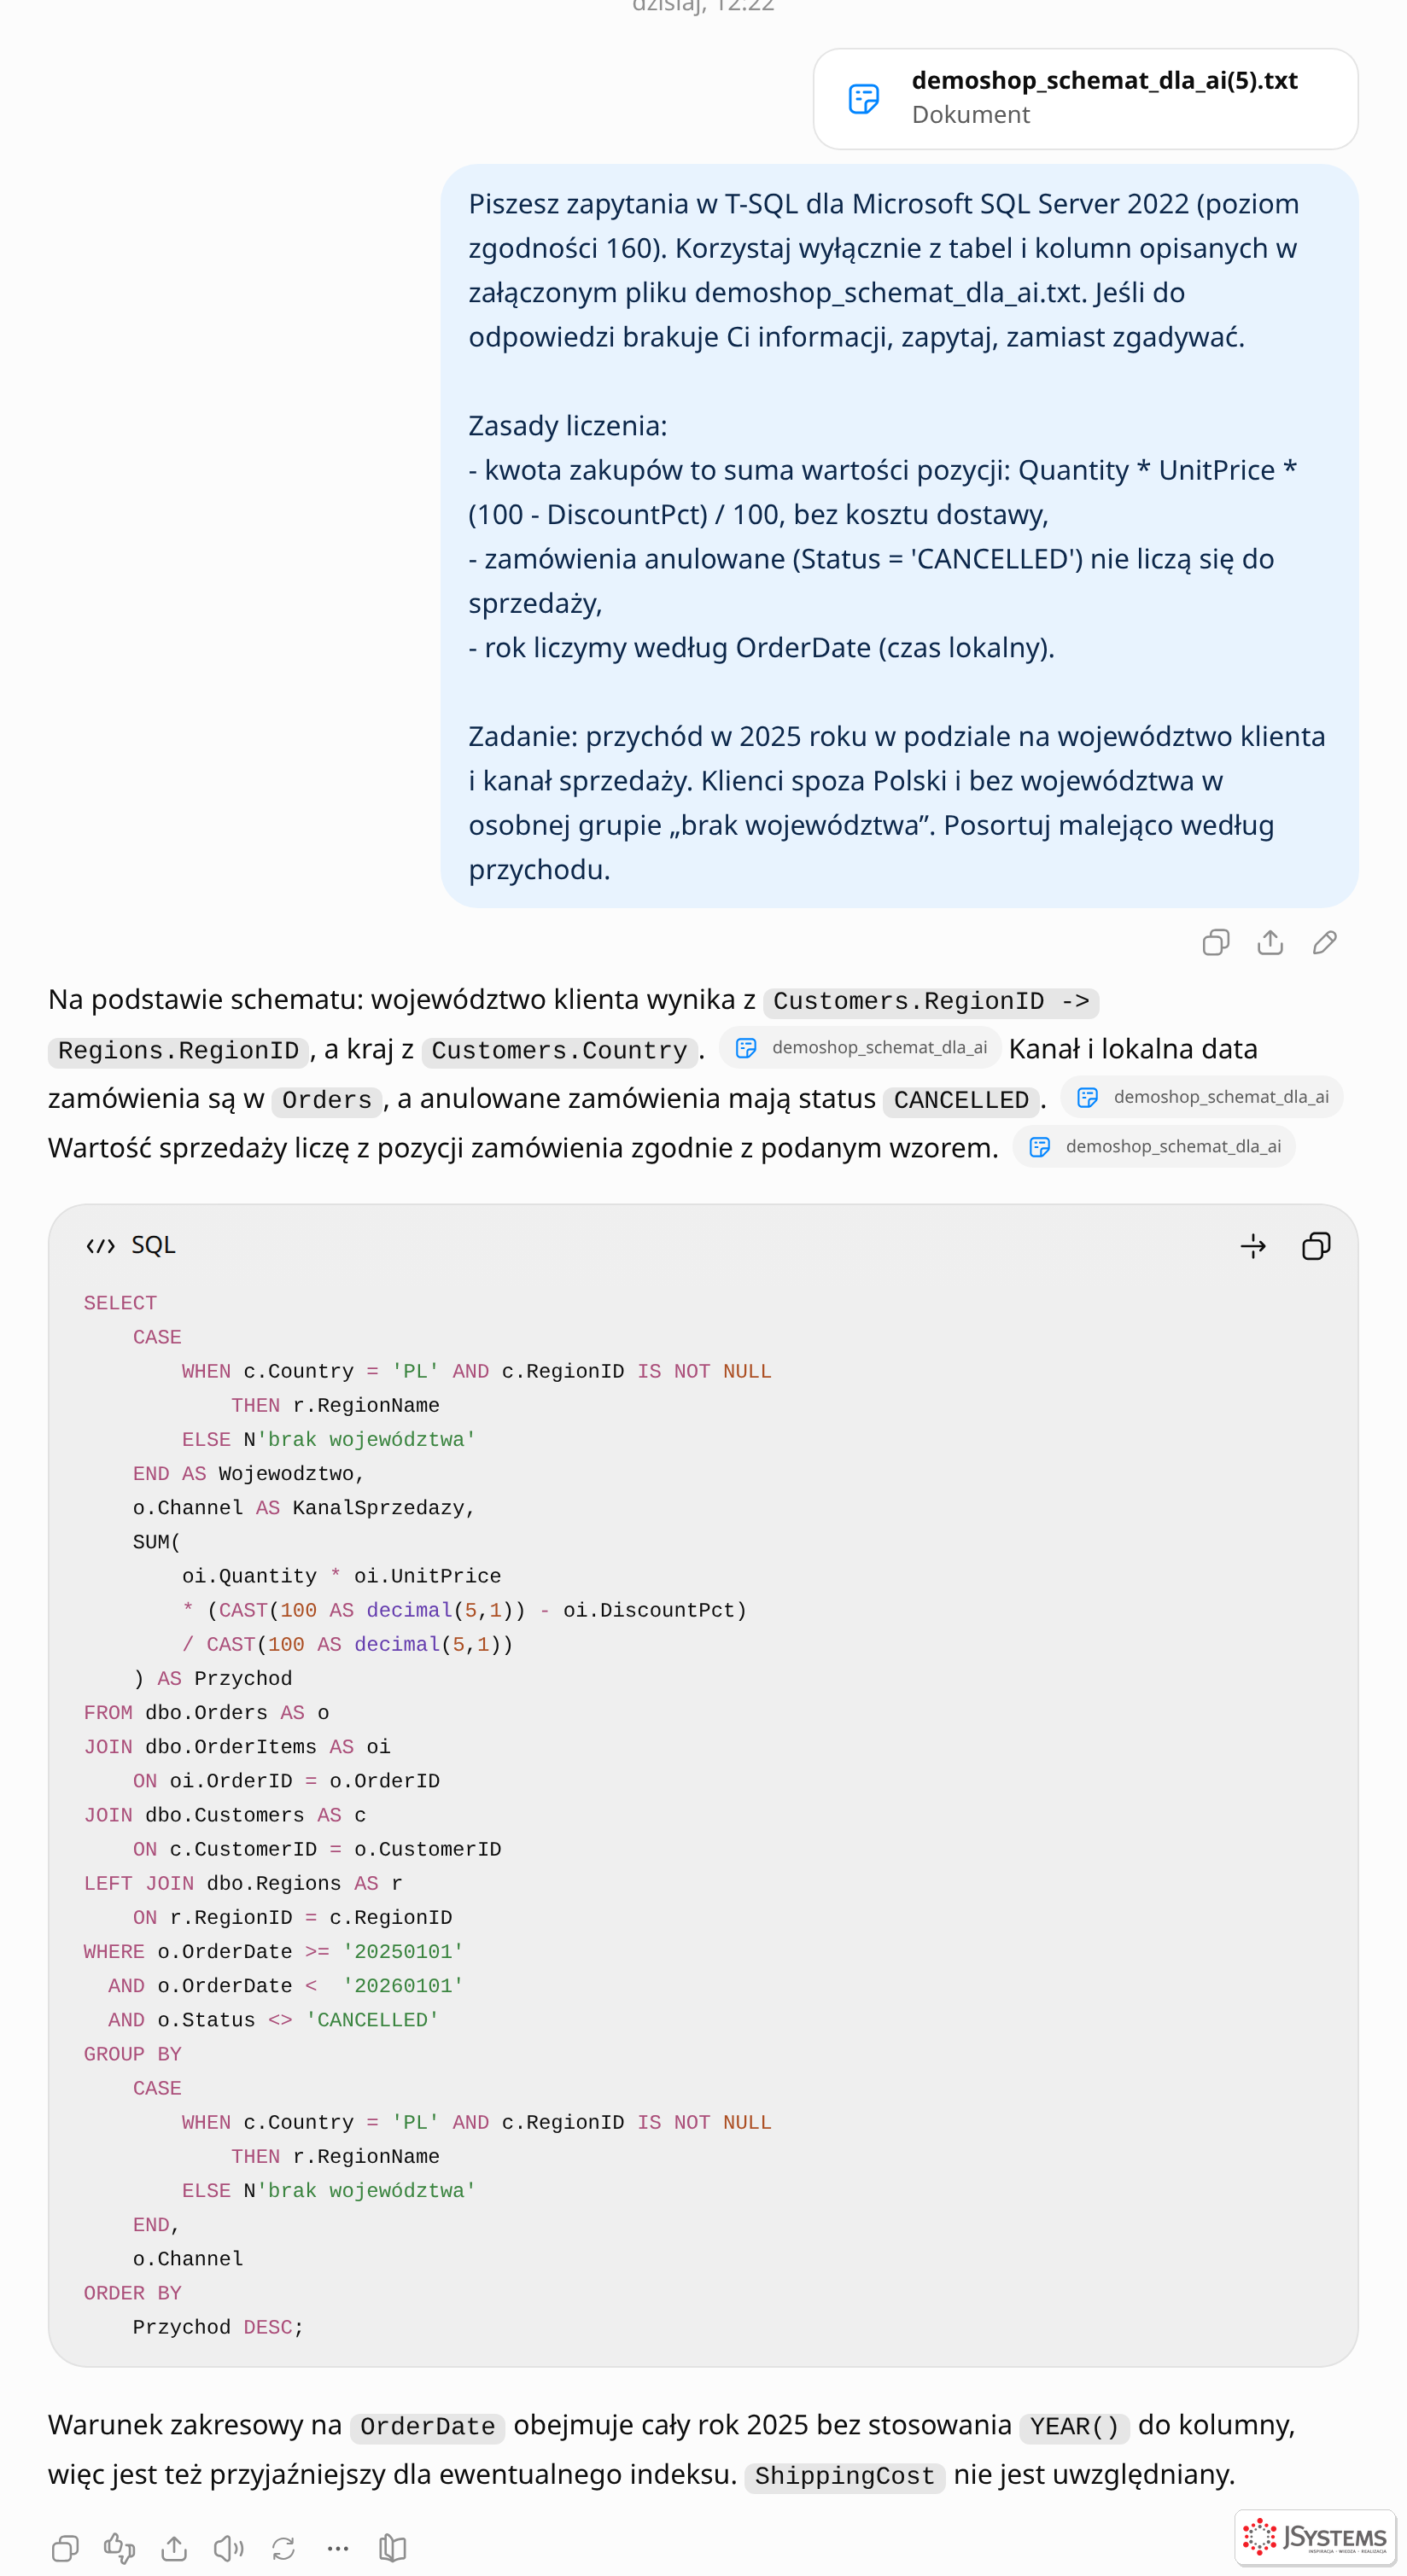
Najważniejszy szczegół to LEFT JOIN dbo.Regions. Złączenie wewnętrzne (INNER JOIN) wyrzuciłoby z wyniku wszystkich klientów bez województwa, a więc całą grupę, o którą prosiliśmy, i część przychodu. AI wybrało poprawnie, bo opis schematu mówi, że RegionID dopuszcza NULL. Wynik w SSMS:
SELECT
    CASE
        WHEN c.Country = 'PL' AND c.RegionID IS NOT NULL
            THEN r.RegionName
        ELSE N'brak województwa'
    END AS Wojewodztwo,
    o.Channel AS KanalSprzedazy,
    SUM(
        oi.Quantity * oi.UnitPrice
        * (CAST(100 AS decimal(5,1)) - oi.DiscountPct)
        / CAST(100 AS decimal(5,1))
    ) AS Przychod
FROM dbo.Orders AS o
JOIN dbo.OrderItems AS oi
    ON oi.OrderID = o.OrderID
JOIN dbo.Customers AS c
    ON c.CustomerID = o.CustomerID
LEFT JOIN dbo.Regions AS r
    ON r.RegionID = c.RegionID
WHERE o.OrderDate >= '20250101'
  AND o.OrderDate <  '20260101'
  AND o.Status <> 'CANCELLED'
GROUP BY
    CASE
        WHEN c.Country = 'PL' AND c.RegionID IS NOT NULL
            THEN r.RegionName
        ELSE N'brak województwa'
    END,
    o.Channel
ORDER BY
    Przychod DESC;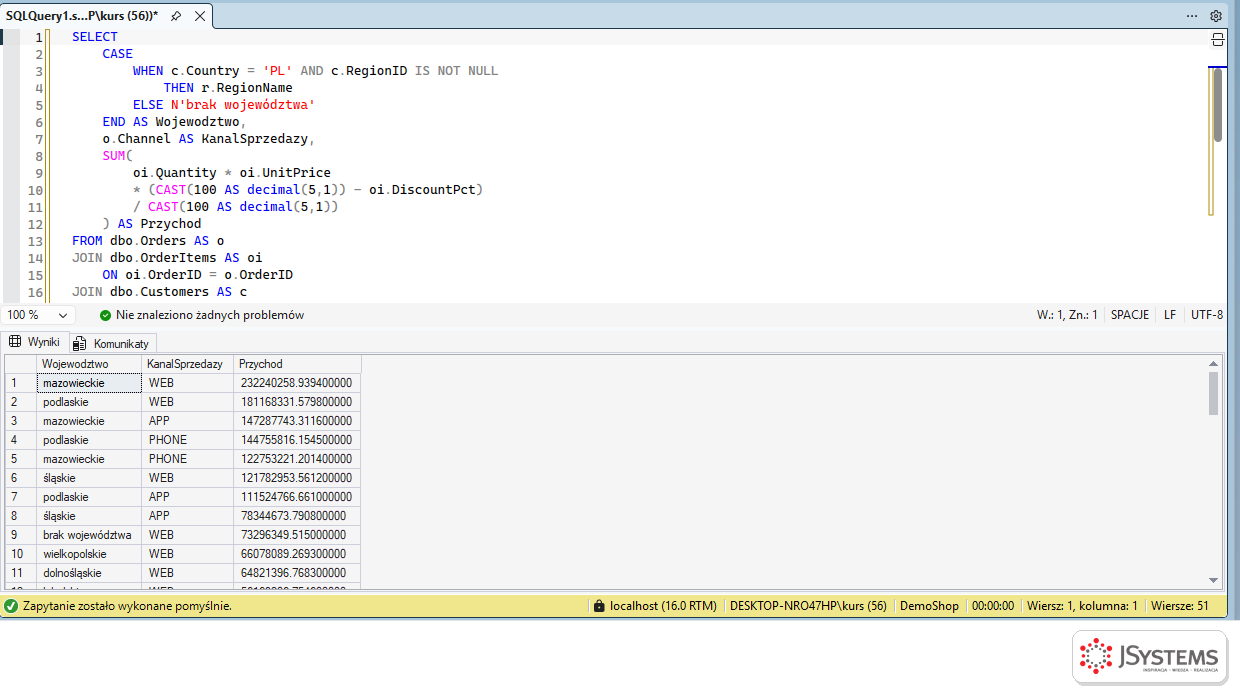
Poniższa lista to wszystko, co w tym przewodniku okazało się potrzebne, żeby AI pisało zapytania poprawne za pierwszym razem. Nie każde zadanie wymaga wszystkiego, ale każdy z tych punktów był przyczyną przynajmniej jednej złej odpowiedzi, gdy go zabrakło.
| Informacja | Po co AI | Skąd ją wziąć w SQL Server |
|---|---|---|
| Silnik, wersja i poziom zgodności | Dobór składni i funkcji (TOP czy LIMIT, GENERATE_SERIES czy CTE) | SELECT @@VERSION, sys.databases.compatibility_level |
| Tabele, kolumny i typy | Brak wymyślonych nazw, poprawne konwersje typów | Zapytanie schemat_dla_ai.sql, Wygeneruj skrypty |
| Klucze główne i obce | Ścieżki złączeń, unikanie złączeń po złych kolumnach | sys.foreign_keys, diagram |
| Liczności relacji (1:1, 1:N) | Ochrona przed mnożeniem wierszy w złączeniach | Opis tabeli („jedno zamówienie = najwyżej jedna wysyłka”) |
| Dopuszczalne wartości | Poprawne filtry statusów i kodów | Ograniczenia CHECK, tabele słownikowe |
| Znaczenie kolumn i reguły biznesowe | Właściwe definicje: co jest sprzedażą, co jest aktywnym klientem | MS_Description, polecenie („Zasady liczenia”) |
| Strefy czasowe, waluty, jednostki | Poprawne granice dni i sumy | Opisy kolumn (OrderDate lokalnie, PaidAtUtc w UTC) |
| Rozmiar tabel i istniejące indeksy | Rozwiązania skalujące się do milionów wierszy | sys.partitions, sys.indexes |
| Znane osobliwości danych | Obsługa NULL i wyjątków | Opis („Country = NULL w kontach ze starego systemu”) |
| Przykładowe wiersze (zanonimizowane) | Format wartości, przykłady do testów | Próbka z sekcji o anonimizacji |
| Czego nie robić | Bezpieczeństwo: tylko SELECT, bez zmian w danych | Polecenie i uprawnienia loginu |
Proste zapytanie AI napisze zawsze. Ciekawie robi się przy konstrukcjach, które sprawiają kłopot także ludziom: złączeniach wielu tabel, podzapytaniach z NOT EXISTS, CTE (czyli nazwanych podzapytaniach w klauzuli WITH), funkcjach okienkowych liczonych „obok” grupowania i zapytaniach rekurencyjnych. Daliśmy ChatGPT sześć takich zadań w jednej rozmowie. Pierwsze polecenie zawierało ten sam wstęp co wcześniej (dialekt, plik ze schematem, zasady liczenia), kolejne już tylko treść zadania. Każdy wynik sprawdziliśmy niezależnym zapytaniem.
Pierwsze zadanie: liczba klientów zarejestrowanych w 2025 roku, którzy do dziś nie złożyli ani jednego zamówienia, w podziale na miesiąc rejestracji.
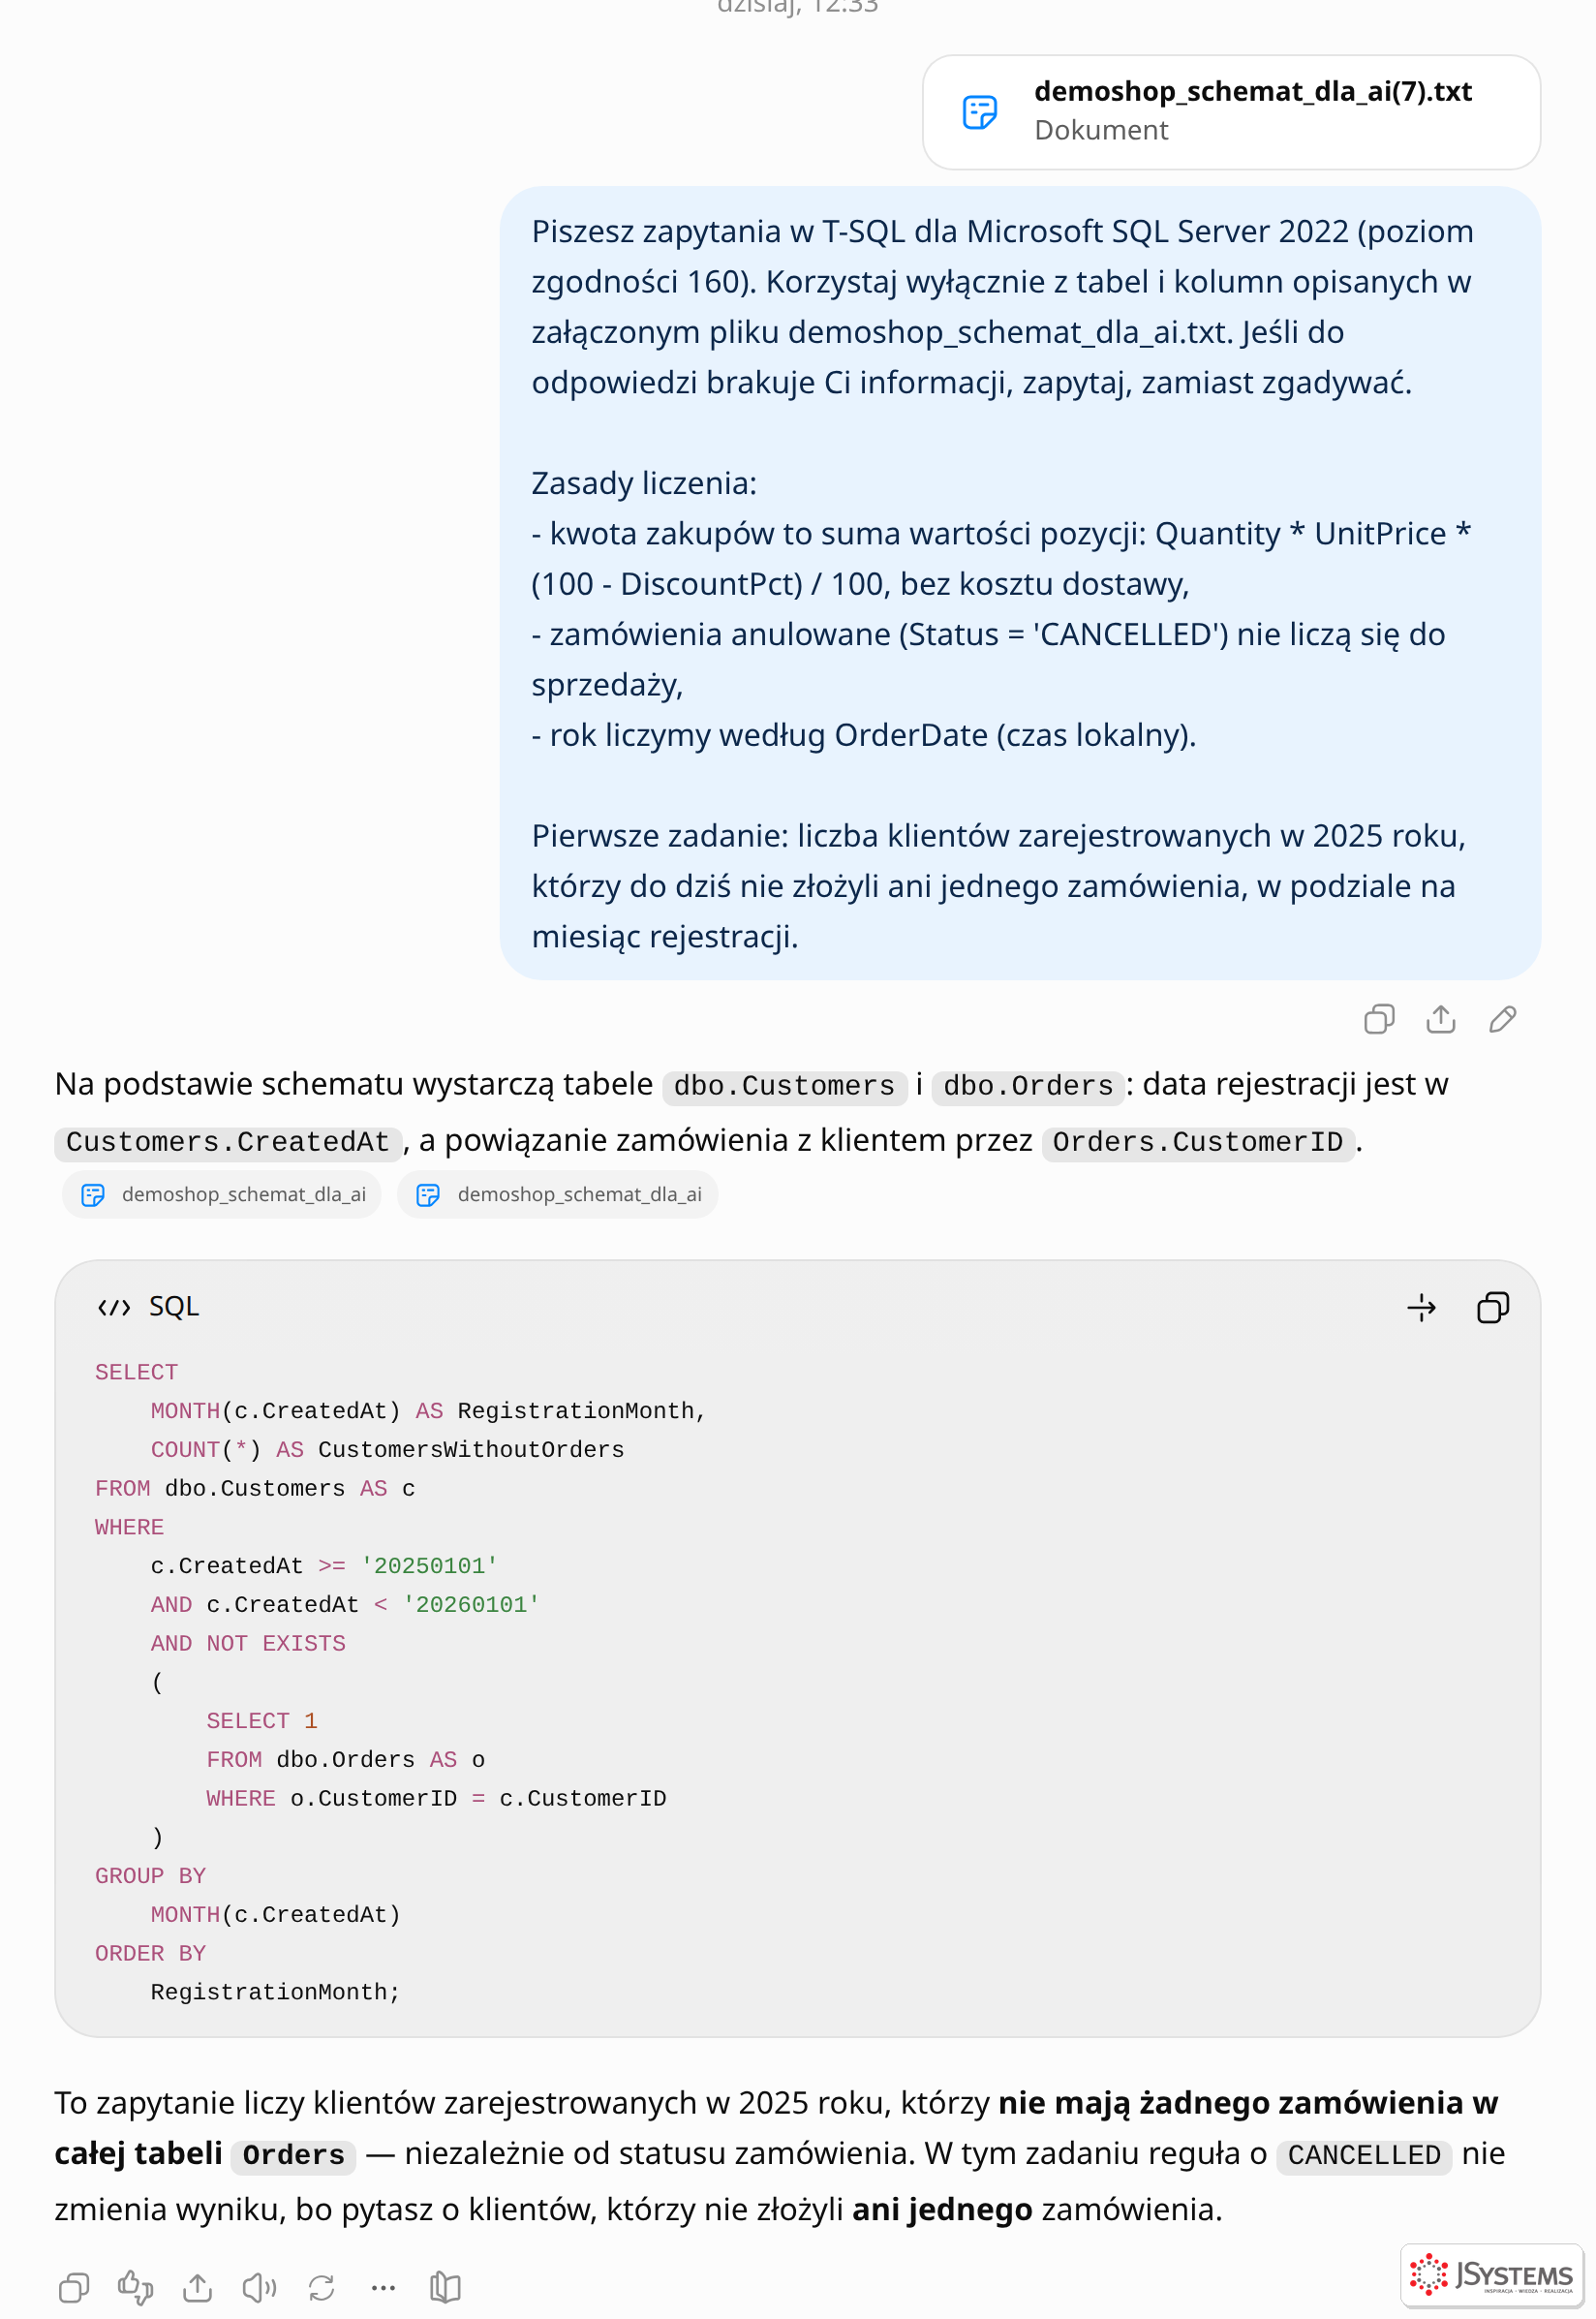
SELECT
    MONTH(c.CreatedAt) AS RegistrationMonth,
    COUNT(*) AS CustomersWithoutOrders
FROM dbo.Customers AS c
WHERE
    c.CreatedAt >= '20250101'
    AND c.CreatedAt < '20260101'
    AND NOT EXISTS
    (
        SELECT 1
        FROM dbo.Orders AS o
        WHERE o.CustomerID = c.CustomerID
    )
GROUP BY
    MONTH(c.CreatedAt)
ORDER BY
    RegistrationMonth;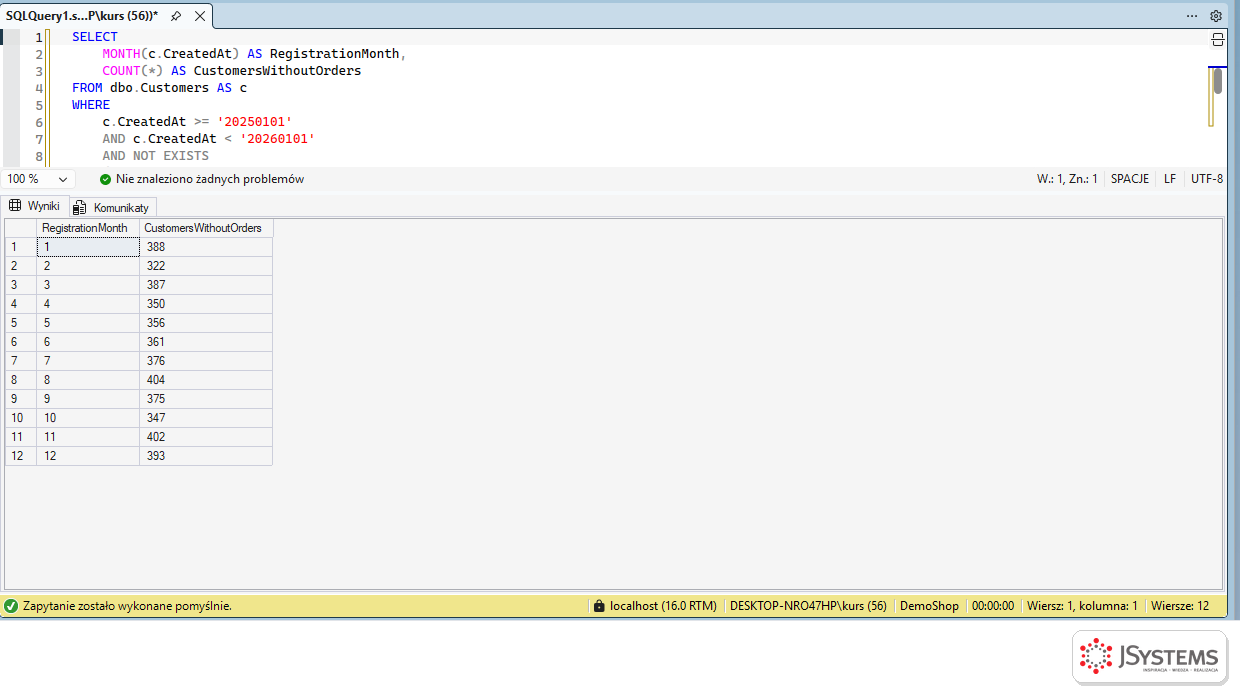
Wybór NOT EXISTS zamiast NOT IN to dobry odruch. Tutaj obie wersje dają ten sam wynik, bo Orders.CustomerID nie dopuszcza NULL. Gdyby dopuszczała i choć jeden wiersz miał NULL, NOT IN zwróciłoby zero wierszy. Ten błąd pokazujemy na żywo w sekcji 20 błędów.
Kolejne zadanie: produkty droższe od średniej ceny katalogowej w swojej kategorii. Pokaż nazwę produktu, kategorię, cenę, średnią kategorii i o ile procent produkt jest droższy. Tylko aktywne produkty, 15 największych różnic procentowych.
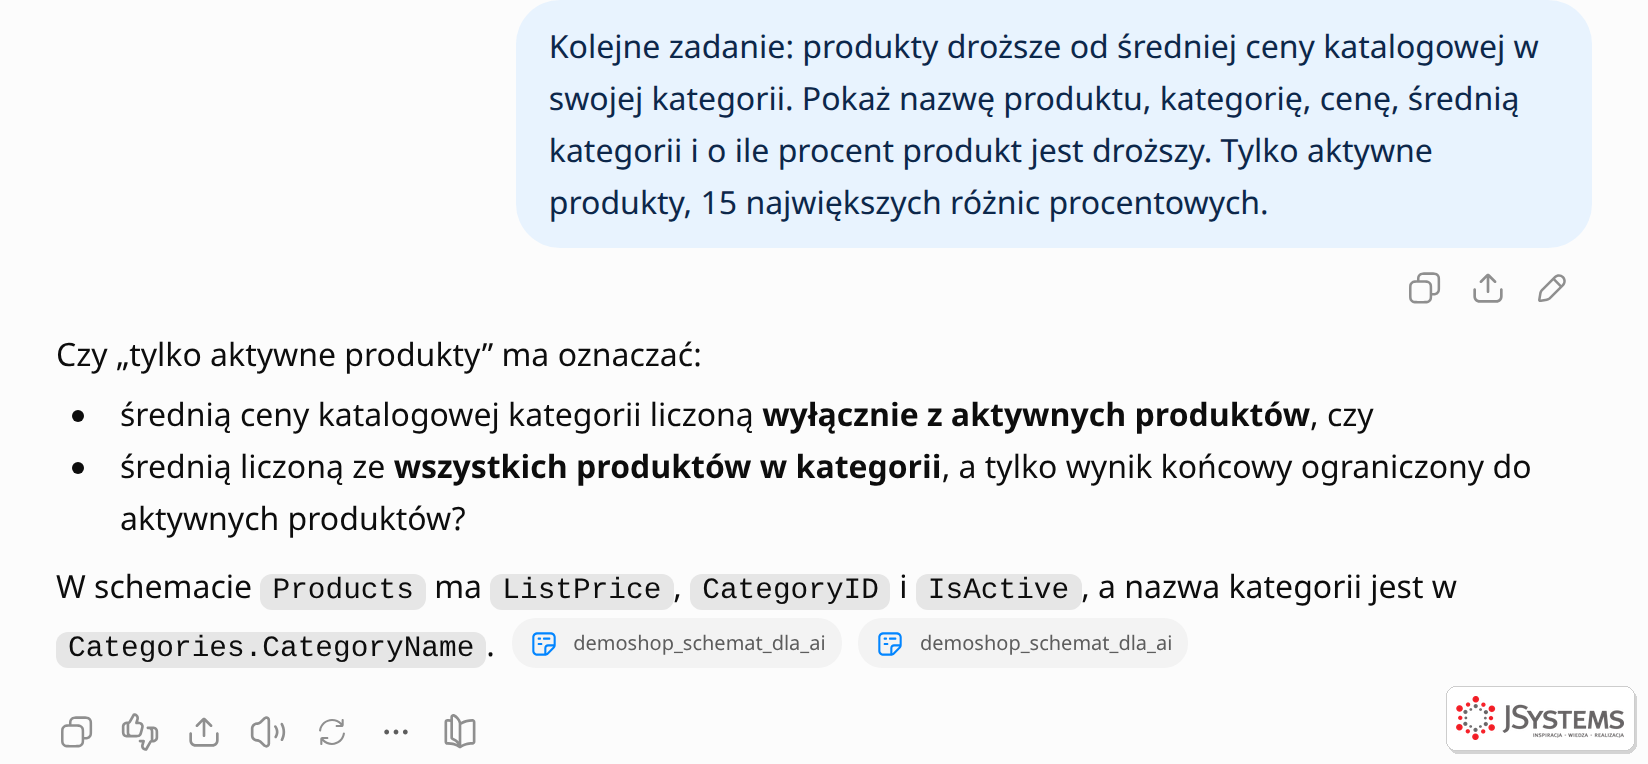
To efekt jednego zdania ze wstępu: „Jeśli do odpowiedzi brakuje Ci informacji, zapytaj, zamiast zgadywać”. Pytanie jest trafne: w 17 kategoriach DemoShop są produkty wycofane, więc obie średnie się różnią, na przykład w kamerach monitoringu 527,15 zł liczone z aktywnych i 487,93 zł liczone ze wszystkich. Odpowiadamy:
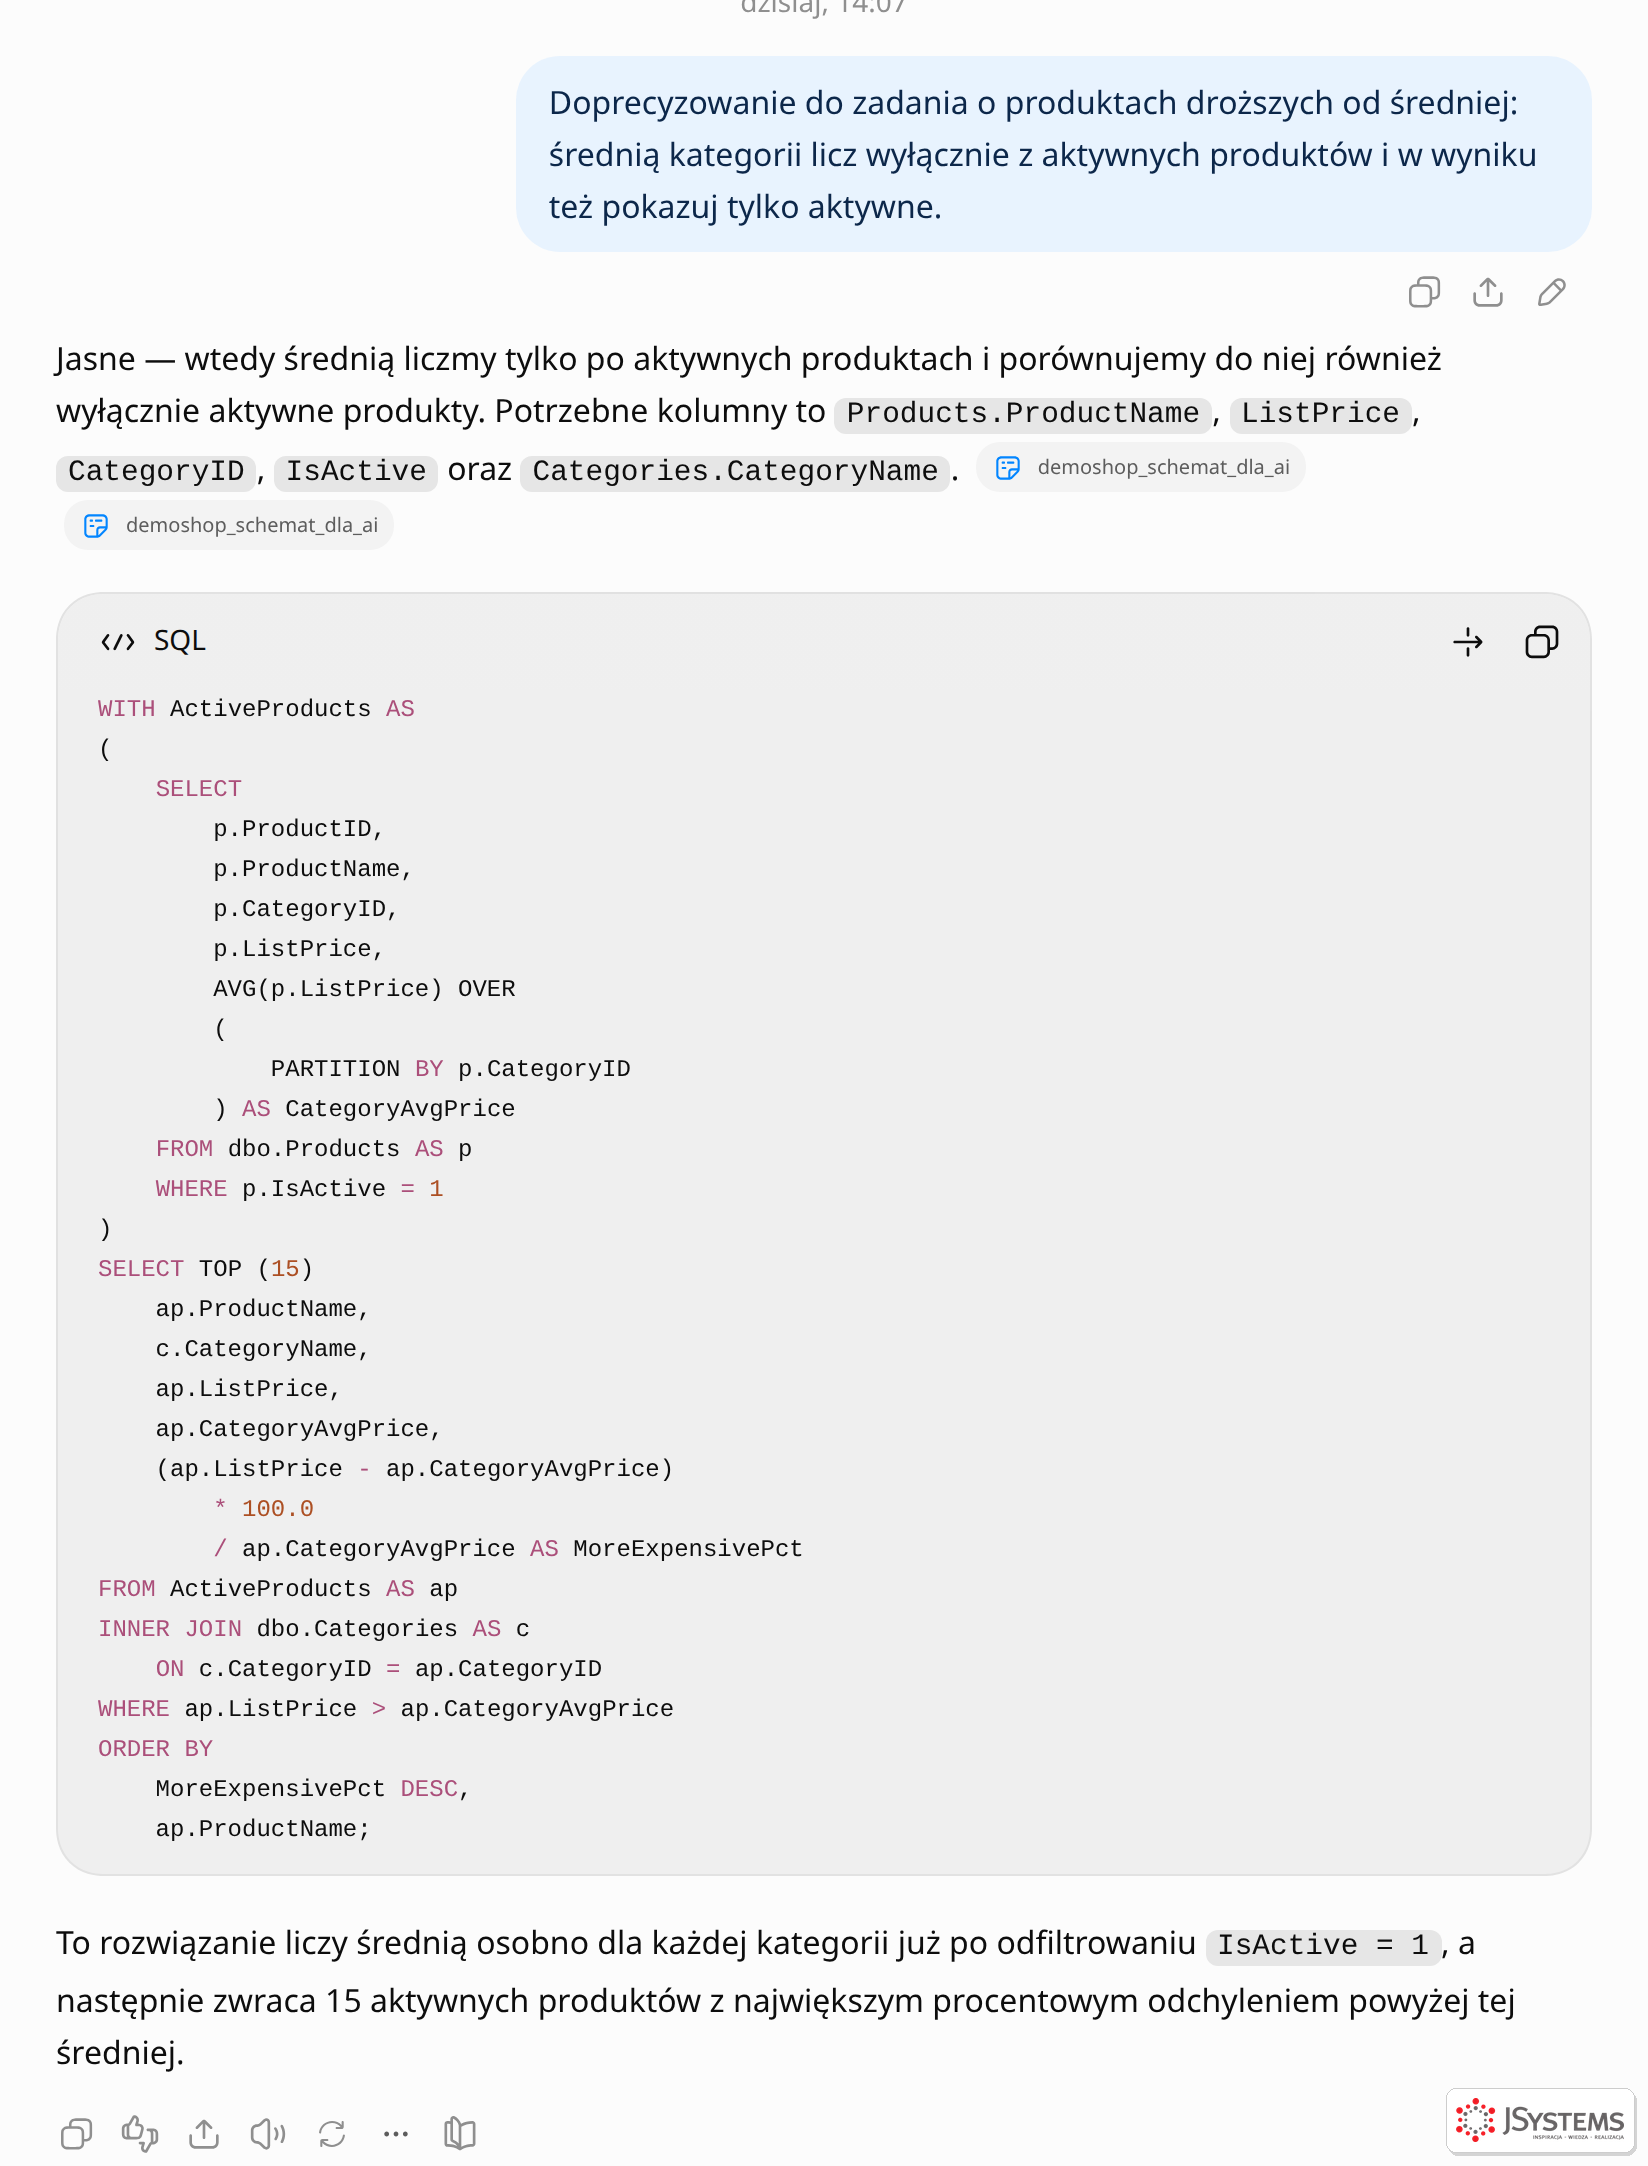
Doprecyzowanie do zadania o produktach droższych od średniej: średnią kategorii licz wyłącznie z aktywnych produktów i w wyniku też pokazuj tylko aktywne.
WITH ActiveProducts AS
(
    SELECT
        p.ProductID,
        p.ProductName,
        p.CategoryID,
        p.ListPrice,
        AVG(p.ListPrice) OVER
        (
            PARTITION BY p.CategoryID
        ) AS CategoryAvgPrice
    FROM dbo.Products AS p
    WHERE p.IsActive = 1
)
SELECT TOP (15)
    ap.ProductName,
    c.CategoryName,
    ap.ListPrice,
    ap.CategoryAvgPrice,
    (ap.ListPrice - ap.CategoryAvgPrice)
        * 100.0
        / ap.CategoryAvgPrice AS MoreExpensivePct
FROM ActiveProducts AS ap
INNER JOIN dbo.Categories AS c
    ON c.CategoryID = ap.CategoryID
WHERE ap.ListPrice > ap.CategoryAvgPrice
ORDER BY
    MoreExpensivePct DESC,
    ap.ProductName;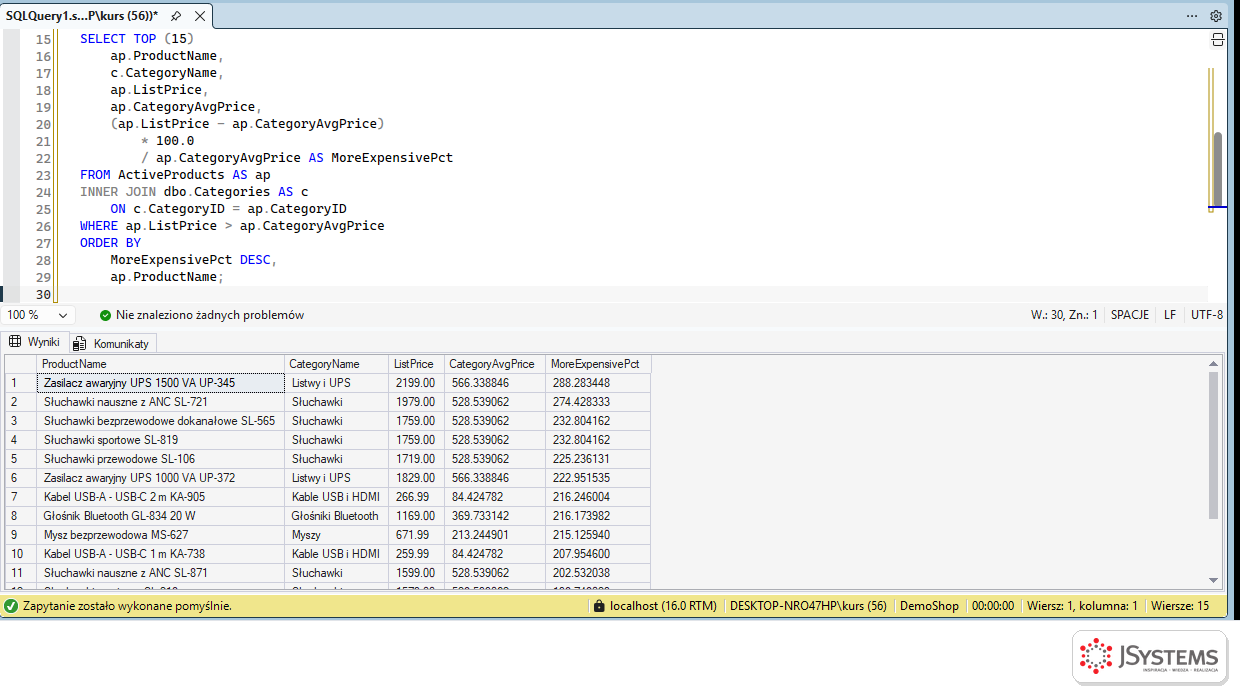
Funkcja okienkowa to tutaj najczystsze rozwiązanie. Klasyczna alternatywa, czyli podzapytanie skorelowane z AVG dla każdej kategorii albo złączenie z pogrupowaną kopią tabeli, daje ten sam wynik, ale jest dłuższa i łatwiej w niej o pomyłkę w warunku złączenia.
Kolejne zadanie: dla klientów indywidualnych (B2C) policz, ile dni średnio mija między pierwszym a drugim zamówieniem, w podziale na rok pierwszego zamówienia. Użyj CTE.
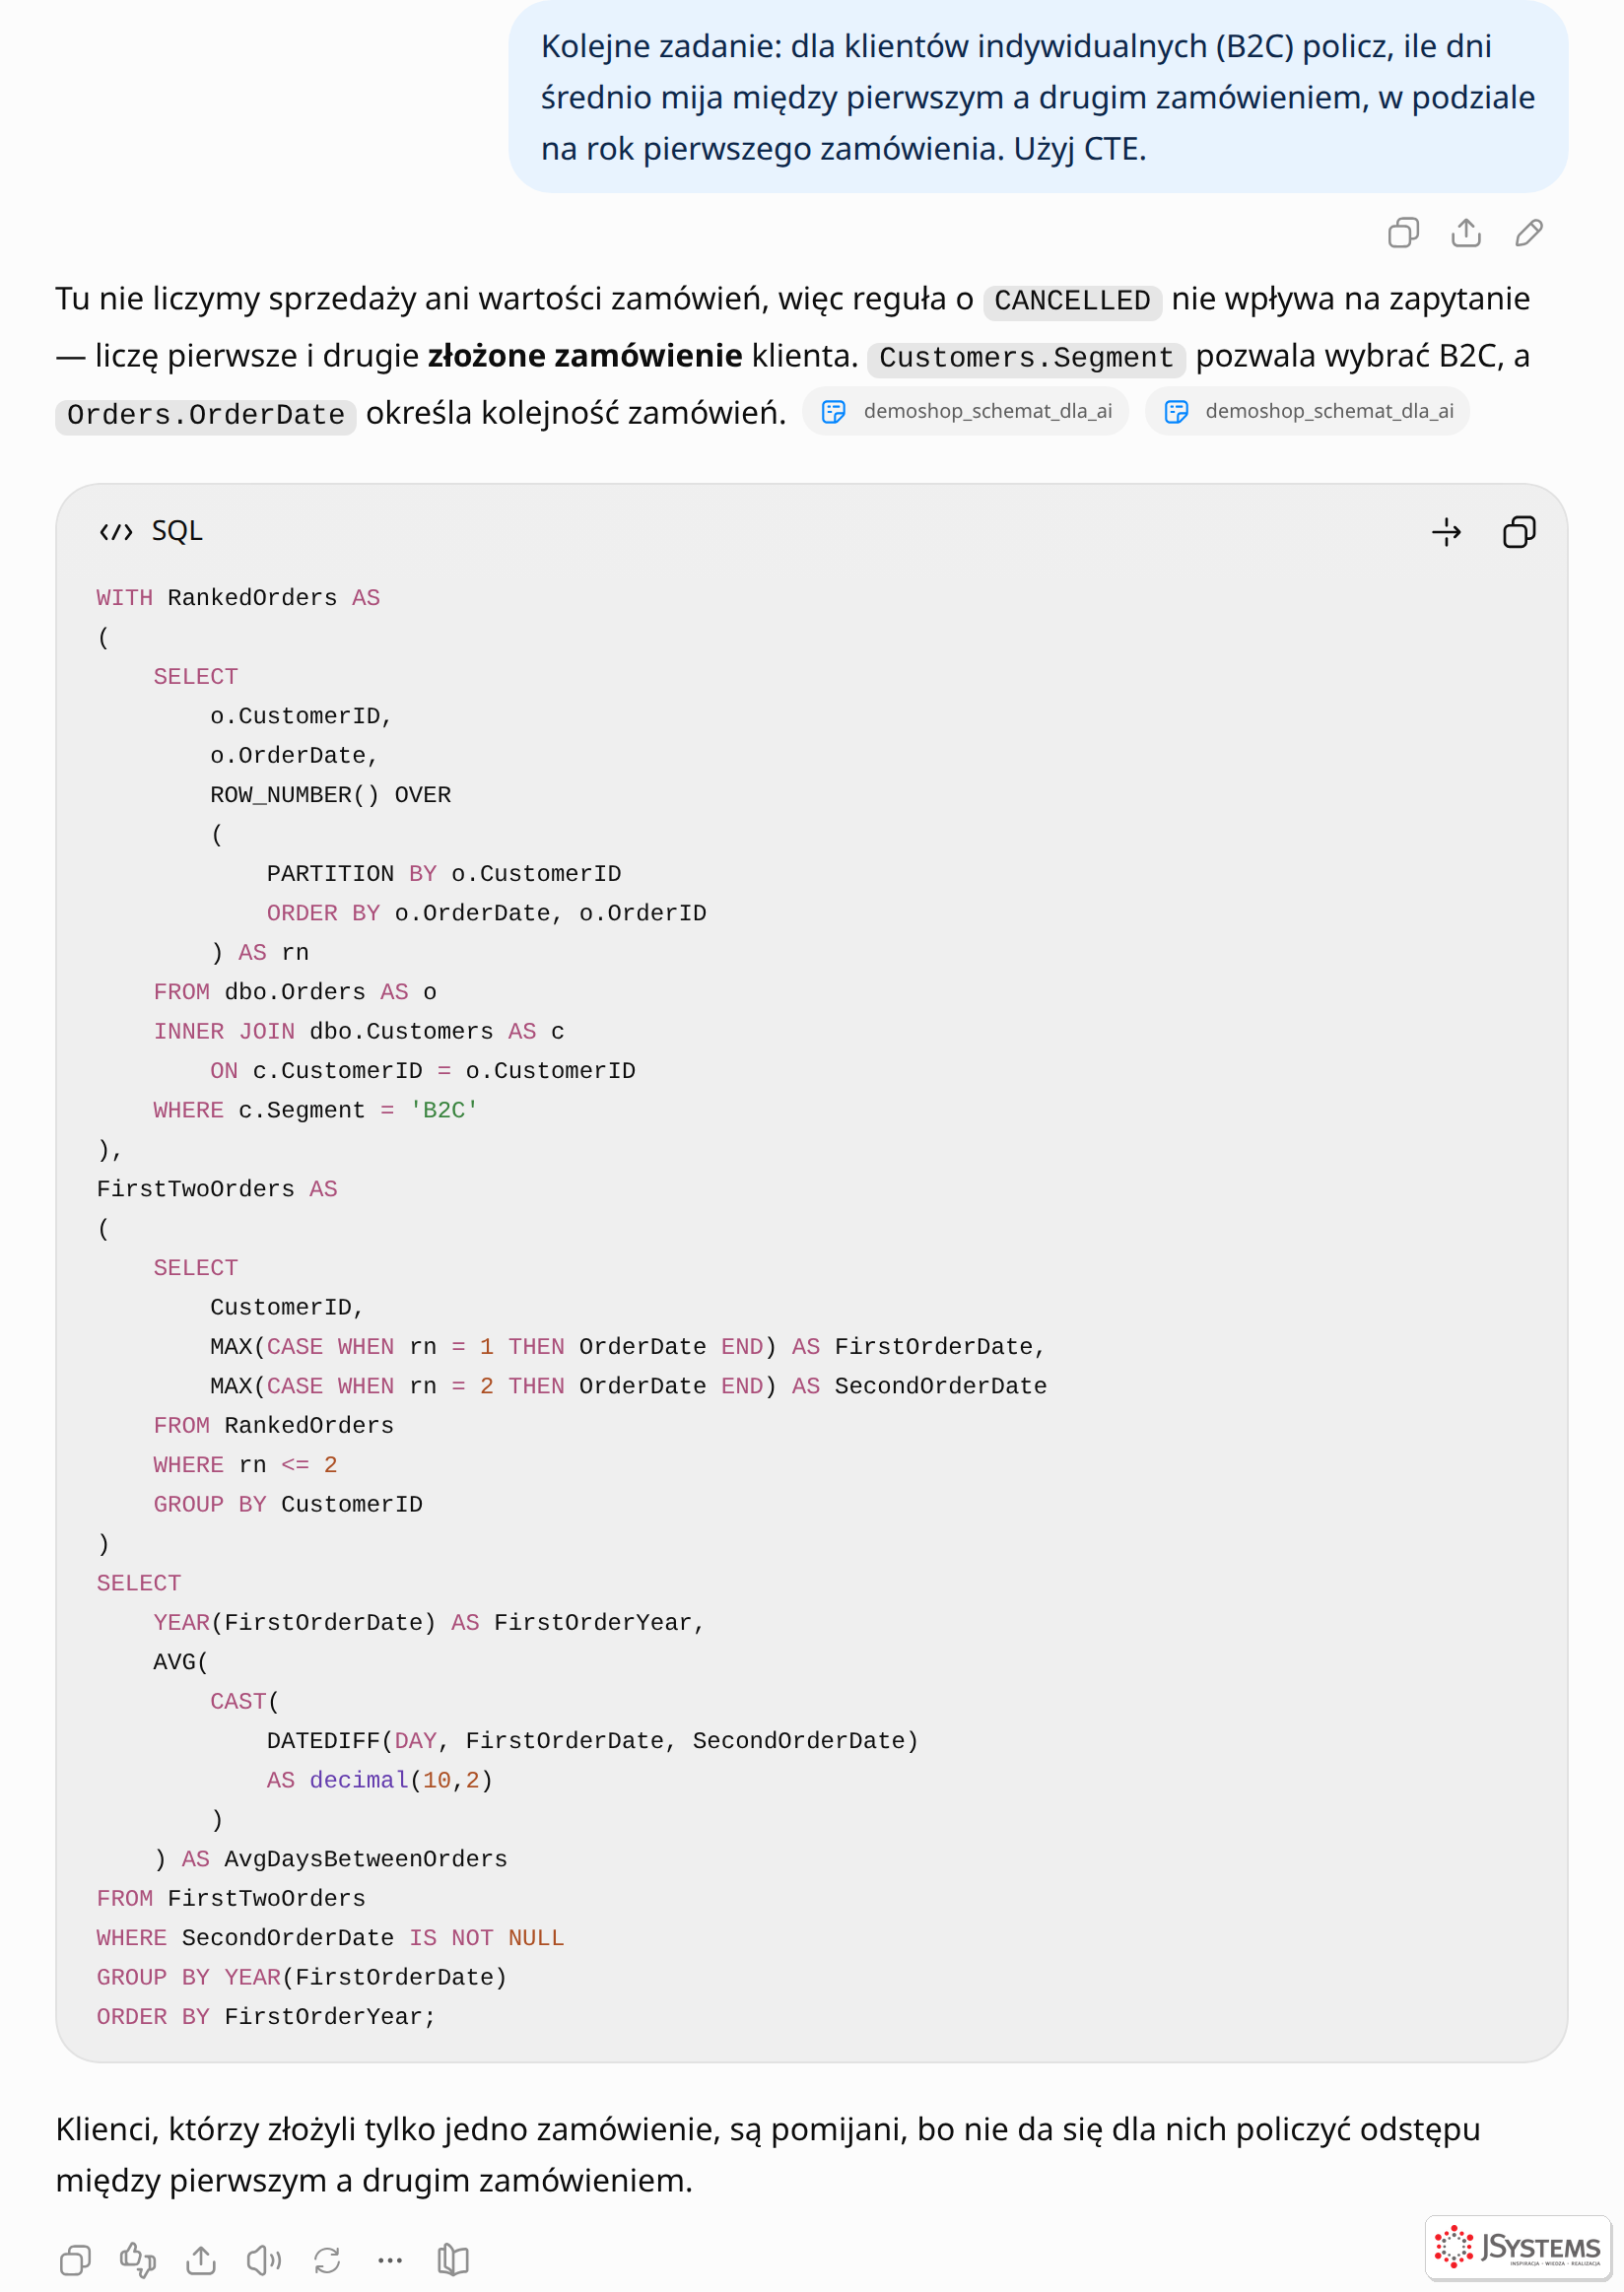
WITH RankedOrders AS
(
    SELECT
        o.CustomerID,
        o.OrderDate,
        ROW_NUMBER() OVER
        (
            PARTITION BY o.CustomerID
            ORDER BY o.OrderDate, o.OrderID
        ) AS rn
    FROM dbo.Orders AS o
    INNER JOIN dbo.Customers AS c
        ON c.CustomerID = o.CustomerID
    WHERE c.Segment = 'B2C'
),
FirstTwoOrders AS
(
    SELECT
        CustomerID,
        MAX(CASE WHEN rn = 1 THEN OrderDate END) AS FirstOrderDate,
        MAX(CASE WHEN rn = 2 THEN OrderDate END) AS SecondOrderDate
    FROM RankedOrders
    WHERE rn <= 2
    GROUP BY CustomerID
)
SELECT
    YEAR(FirstOrderDate) AS FirstOrderYear,
    AVG(
        CAST(
            DATEDIFF(DAY, FirstOrderDate, SecondOrderDate)
            AS decimal(10,2)
        )
    ) AS AvgDaysBetweenOrders
FROM FirstTwoOrders
WHERE SecondOrderDate IS NOT NULL
GROUP BY YEAR(FirstOrderDate)
ORDER BY FirstOrderYear;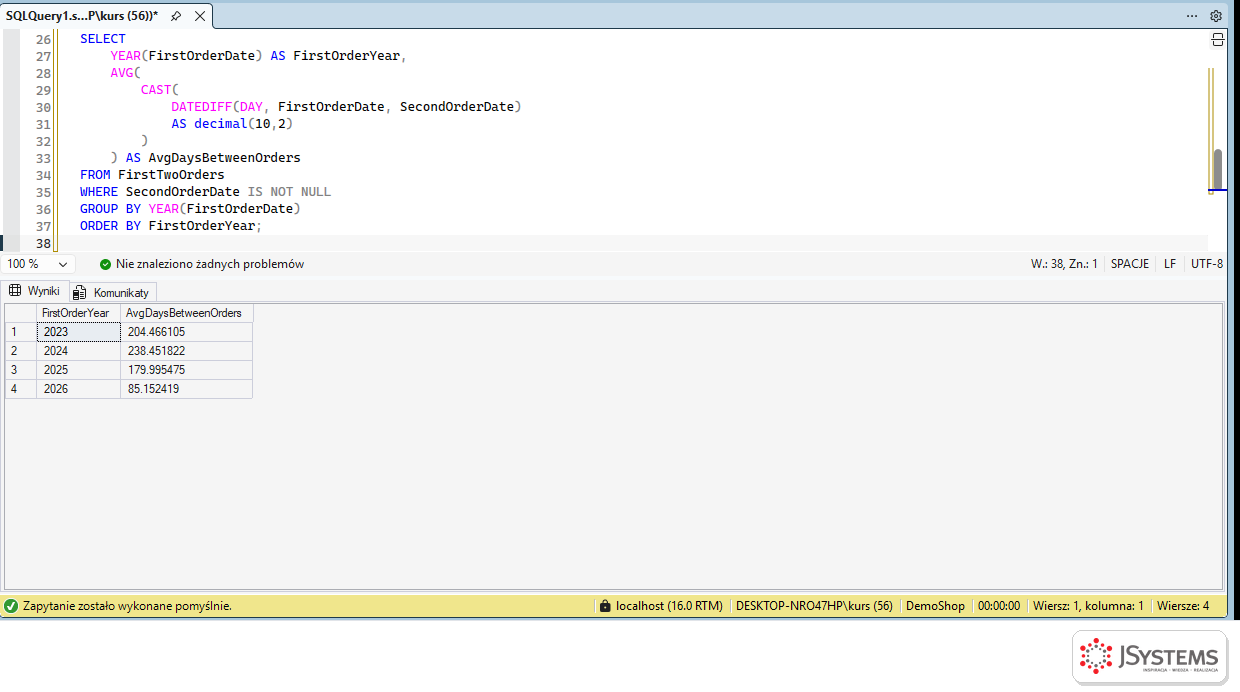
Zapytanie jest poprawne, ale wynik wymaga komentarza, którego AI nie dodało. Liczba 85,2 dnia dla 2026 roku nie znaczy, że klienci nagle zaczęli wracać szybciej. Dane kończą się we wrześniu 2026, więc w tej grupie są tylko klienci, którzy zdążyli złożyć drugie zamówienie w ciągu kilku miesięcy. Ci, którzy wrócą później, jeszcze się nie policzyli. Statystycy nazywają to obcięciem obserwacji. AI napisało dobre SQL, ale interpretacja wyniku to wciąż Twoja praca. Warto zawsze dopytać: „Czy któryś okres w wyniku jest niepełny albo nieporównywalny z pozostałymi?”.
Kolejne zadanie: 3 najlepiej sprzedające się produkty według kwoty sprzedaży w każdej kategorii głównej w 2025 roku. Kategoria główna to kategoria bez rodzica. Przy remisie pokaż oba produkty.
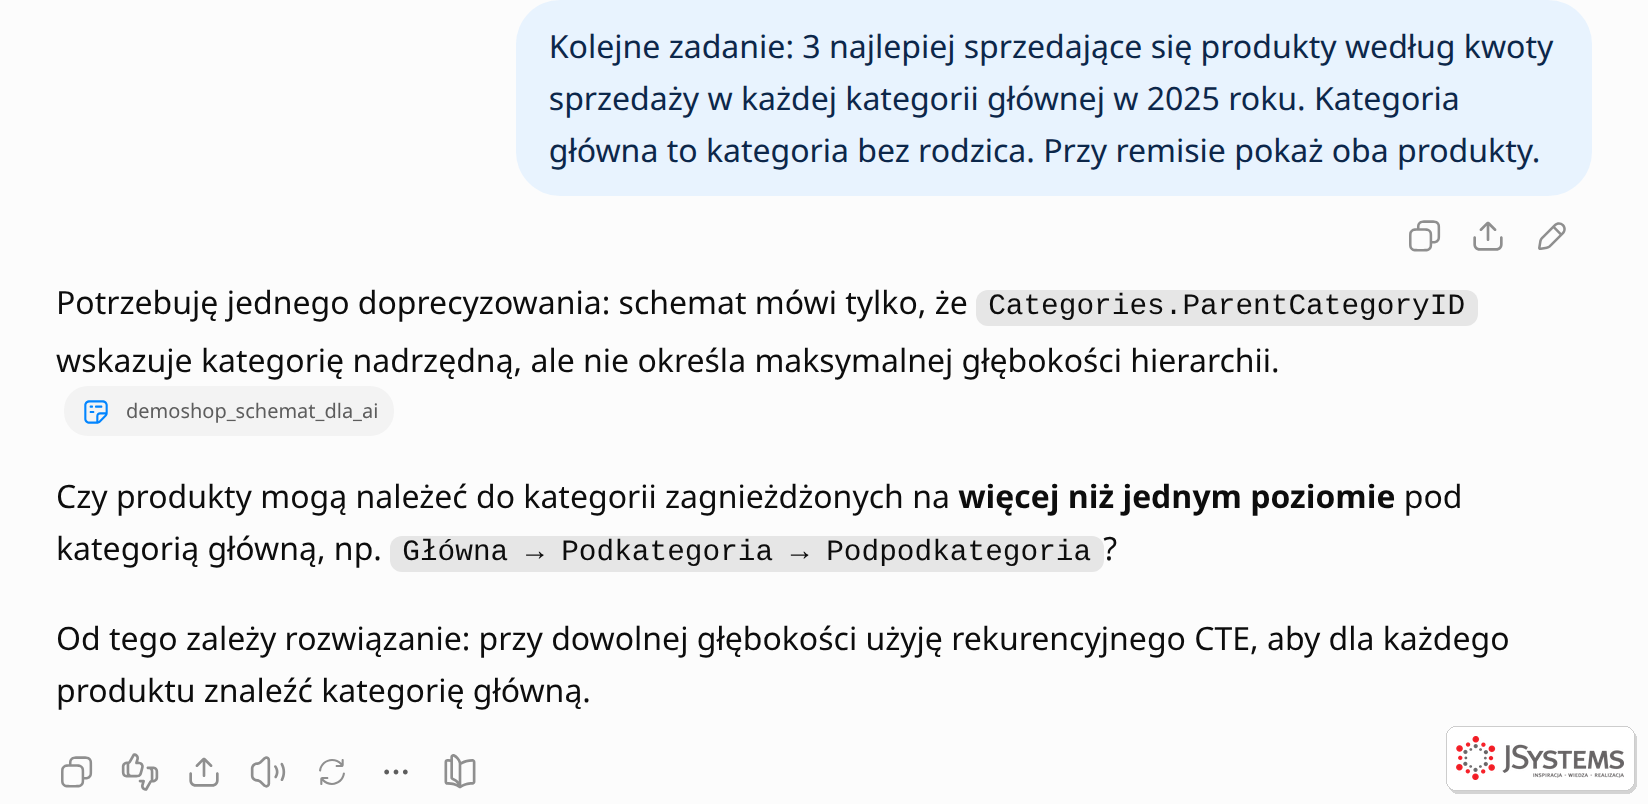
Doprecyzowanie do zadania o 3 najlepszych produktach: hierarchia kategorii ma dokładnie dwa poziomy - kategoria główna i podkategoria. Każdy produkt jest przypisany do podkategorii.
WITH ProductSales AS
(
    SELECT
        main.CategoryID AS MainCategoryID,
        main.CategoryName AS MainCategoryName,
        p.ProductID,
        p.ProductName,
        SUM(
            CAST(oi.Quantity AS decimal(18,2))
            * oi.UnitPrice
            * (100 - oi.DiscountPct) / 100
        ) AS SalesAmount
    FROM dbo.Orders AS o
    INNER JOIN dbo.OrderItems AS oi
        ON oi.OrderID = o.OrderID
    INNER JOIN dbo.Products AS p
        ON p.ProductID = oi.ProductID
    INNER JOIN dbo.Categories AS sub
        ON sub.CategoryID = p.CategoryID
    INNER JOIN dbo.Categories AS main
        ON main.CategoryID = sub.ParentCategoryID
    WHERE
        o.OrderDate >= '20250101'
        AND o.OrderDate < '20260101'
        AND o.Status <> 'CANCELLED'
        AND main.ParentCategoryID IS NULL
    GROUP BY
        main.CategoryID,
        main.CategoryName,
        p.ProductID,
        p.ProductName
),
RankedProducts AS
(
    SELECT
        MainCategoryID,
        MainCategoryName,
        ProductID,
        ProductName,
        SalesAmount,
        DENSE_RANK() OVER
        (
            PARTITION BY MainCategoryID
            ORDER BY SalesAmount DESC
        ) AS SalesRank
    FROM ProductSales
)
SELECT
    MainCategoryName,
    ProductName,
    SalesAmount,
    SalesRank
FROM RankedProducts
WHERE SalesRank <= 3
ORDER BY
    MainCategoryName,
    SalesRank,
    ProductName;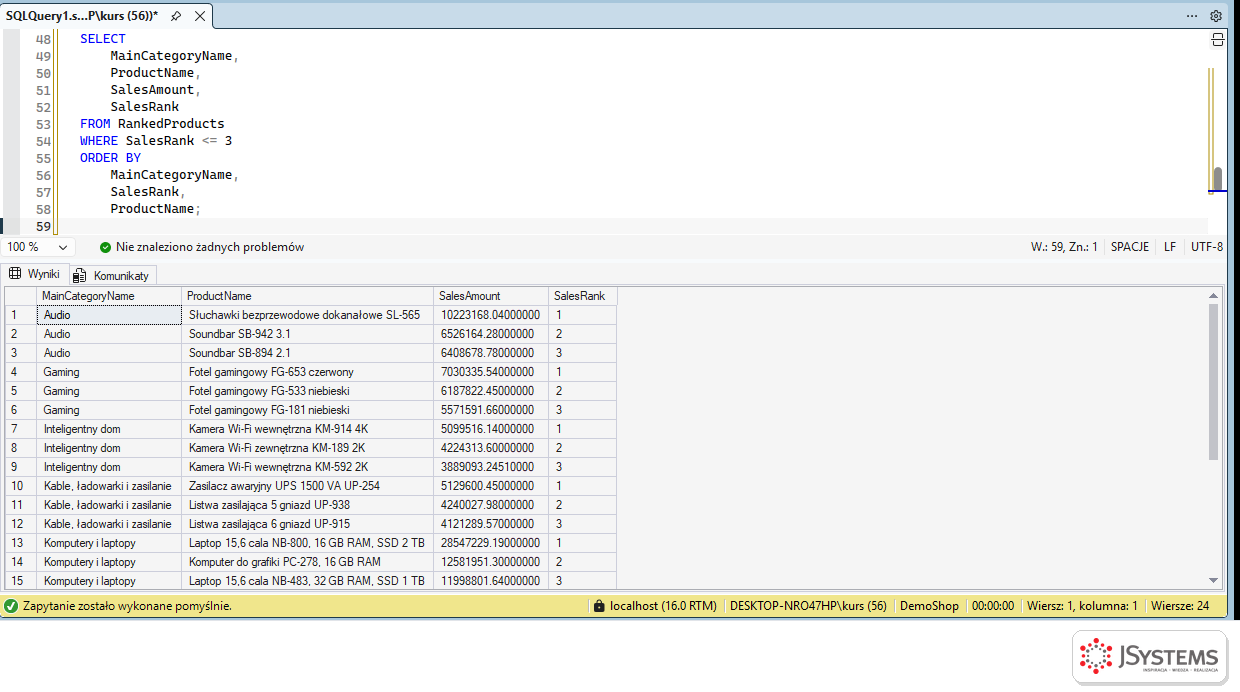
Tu warto zatrzymać się przy jednym słowie. AI użyło DENSE_RANK, a nie RANK. Przy remisie na pierwszym miejscu DENSE_RANK nada kolejnemu produktowi numer 2, więc w wyniku mogą się znaleźć cztery produkty z kategorii. RANK przeskoczy do numeru 3 i zwróci trzy. W naszych danych remisów nie ma i obie wersje dają te same 24 wiersze, ale na innych danych różnica wyjdzie. Jeśli ranking ma znaczenie biznesowe (premie, wyróżnienia), dopytaj AI wprost: „Czym różni się tu RANK, DENSE_RANK i ROW_NUMBER i którą wybrałeś?”.
Kolejne zadanie: sprzedaż miesięczna w 2025 roku. Kwota w miesiącu, suma narastająco od początku roku i zmiana procentowa względem poprzedniego miesiąca.
WITH MonthlySales AS
(
    SELECT
        DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1) AS SalesMonth,
        SUM(
            CAST(oi.Quantity AS decimal(18,2))
            * oi.UnitPrice
            * (100 - oi.DiscountPct) / 100
        ) AS MonthlyAmount
    FROM dbo.Orders AS o
    INNER JOIN dbo.OrderItems AS oi
        ON oi.OrderID = o.OrderID
    WHERE
        o.OrderDate >= '20250101'
        AND o.OrderDate < '20260101'
        AND o.Status <> 'CANCELLED'
    GROUP BY
        DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1)
),
WithPrevious AS
(
    SELECT
        SalesMonth,
        MonthlyAmount,
        SUM(MonthlyAmount) OVER
        (
            ORDER BY SalesMonth
            ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
        ) AS YtdAmount,
        LAG(MonthlyAmount) OVER
        (
            ORDER BY SalesMonth
        ) AS PreviousMonthAmount
    FROM MonthlySales
)
SELECT
    SalesMonth,
    MonthlyAmount,
    YtdAmount,
    CASE
        WHEN PreviousMonthAmount IS NULL
             OR PreviousMonthAmount = 0
            THEN NULL
        ELSE
            (MonthlyAmount - PreviousMonthAmount)
            * 100.0
            / PreviousMonthAmount
    END AS MoMChangePct
FROM WithPrevious
ORDER BY SalesMonth;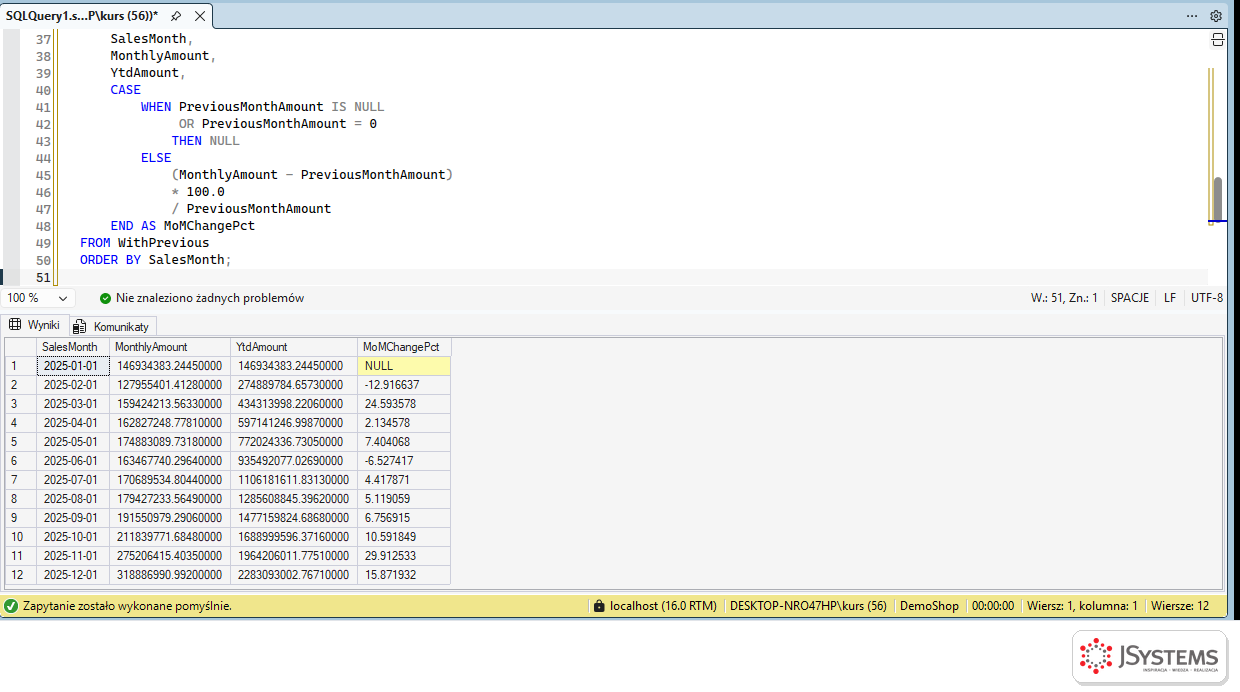
Na uwagę zasługuje ramka ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW. Gdyby jej nie było, SQL Server przyjąłby domyślnie ramkę RANGE, która przy powtarzających się wartościach w ORDER BY dolicza cały „remis” naraz. Tutaj miesiące się nie powtarzają, więc wynik byłby ten sam, ale przy sumie narastającej po dniu albo po kwocie już nie. Różnicę na danych pokazujemy w błędzie 17 z listy dwudziestu typowych błędów.
Ostatnie zadanie: struktura organizacyjna z tabeli dbo.Employees jako drzewo. Poziom w hierarchii, imię i nazwisko, stanowisko i pełna ścieżka przełożonych od prezesa.
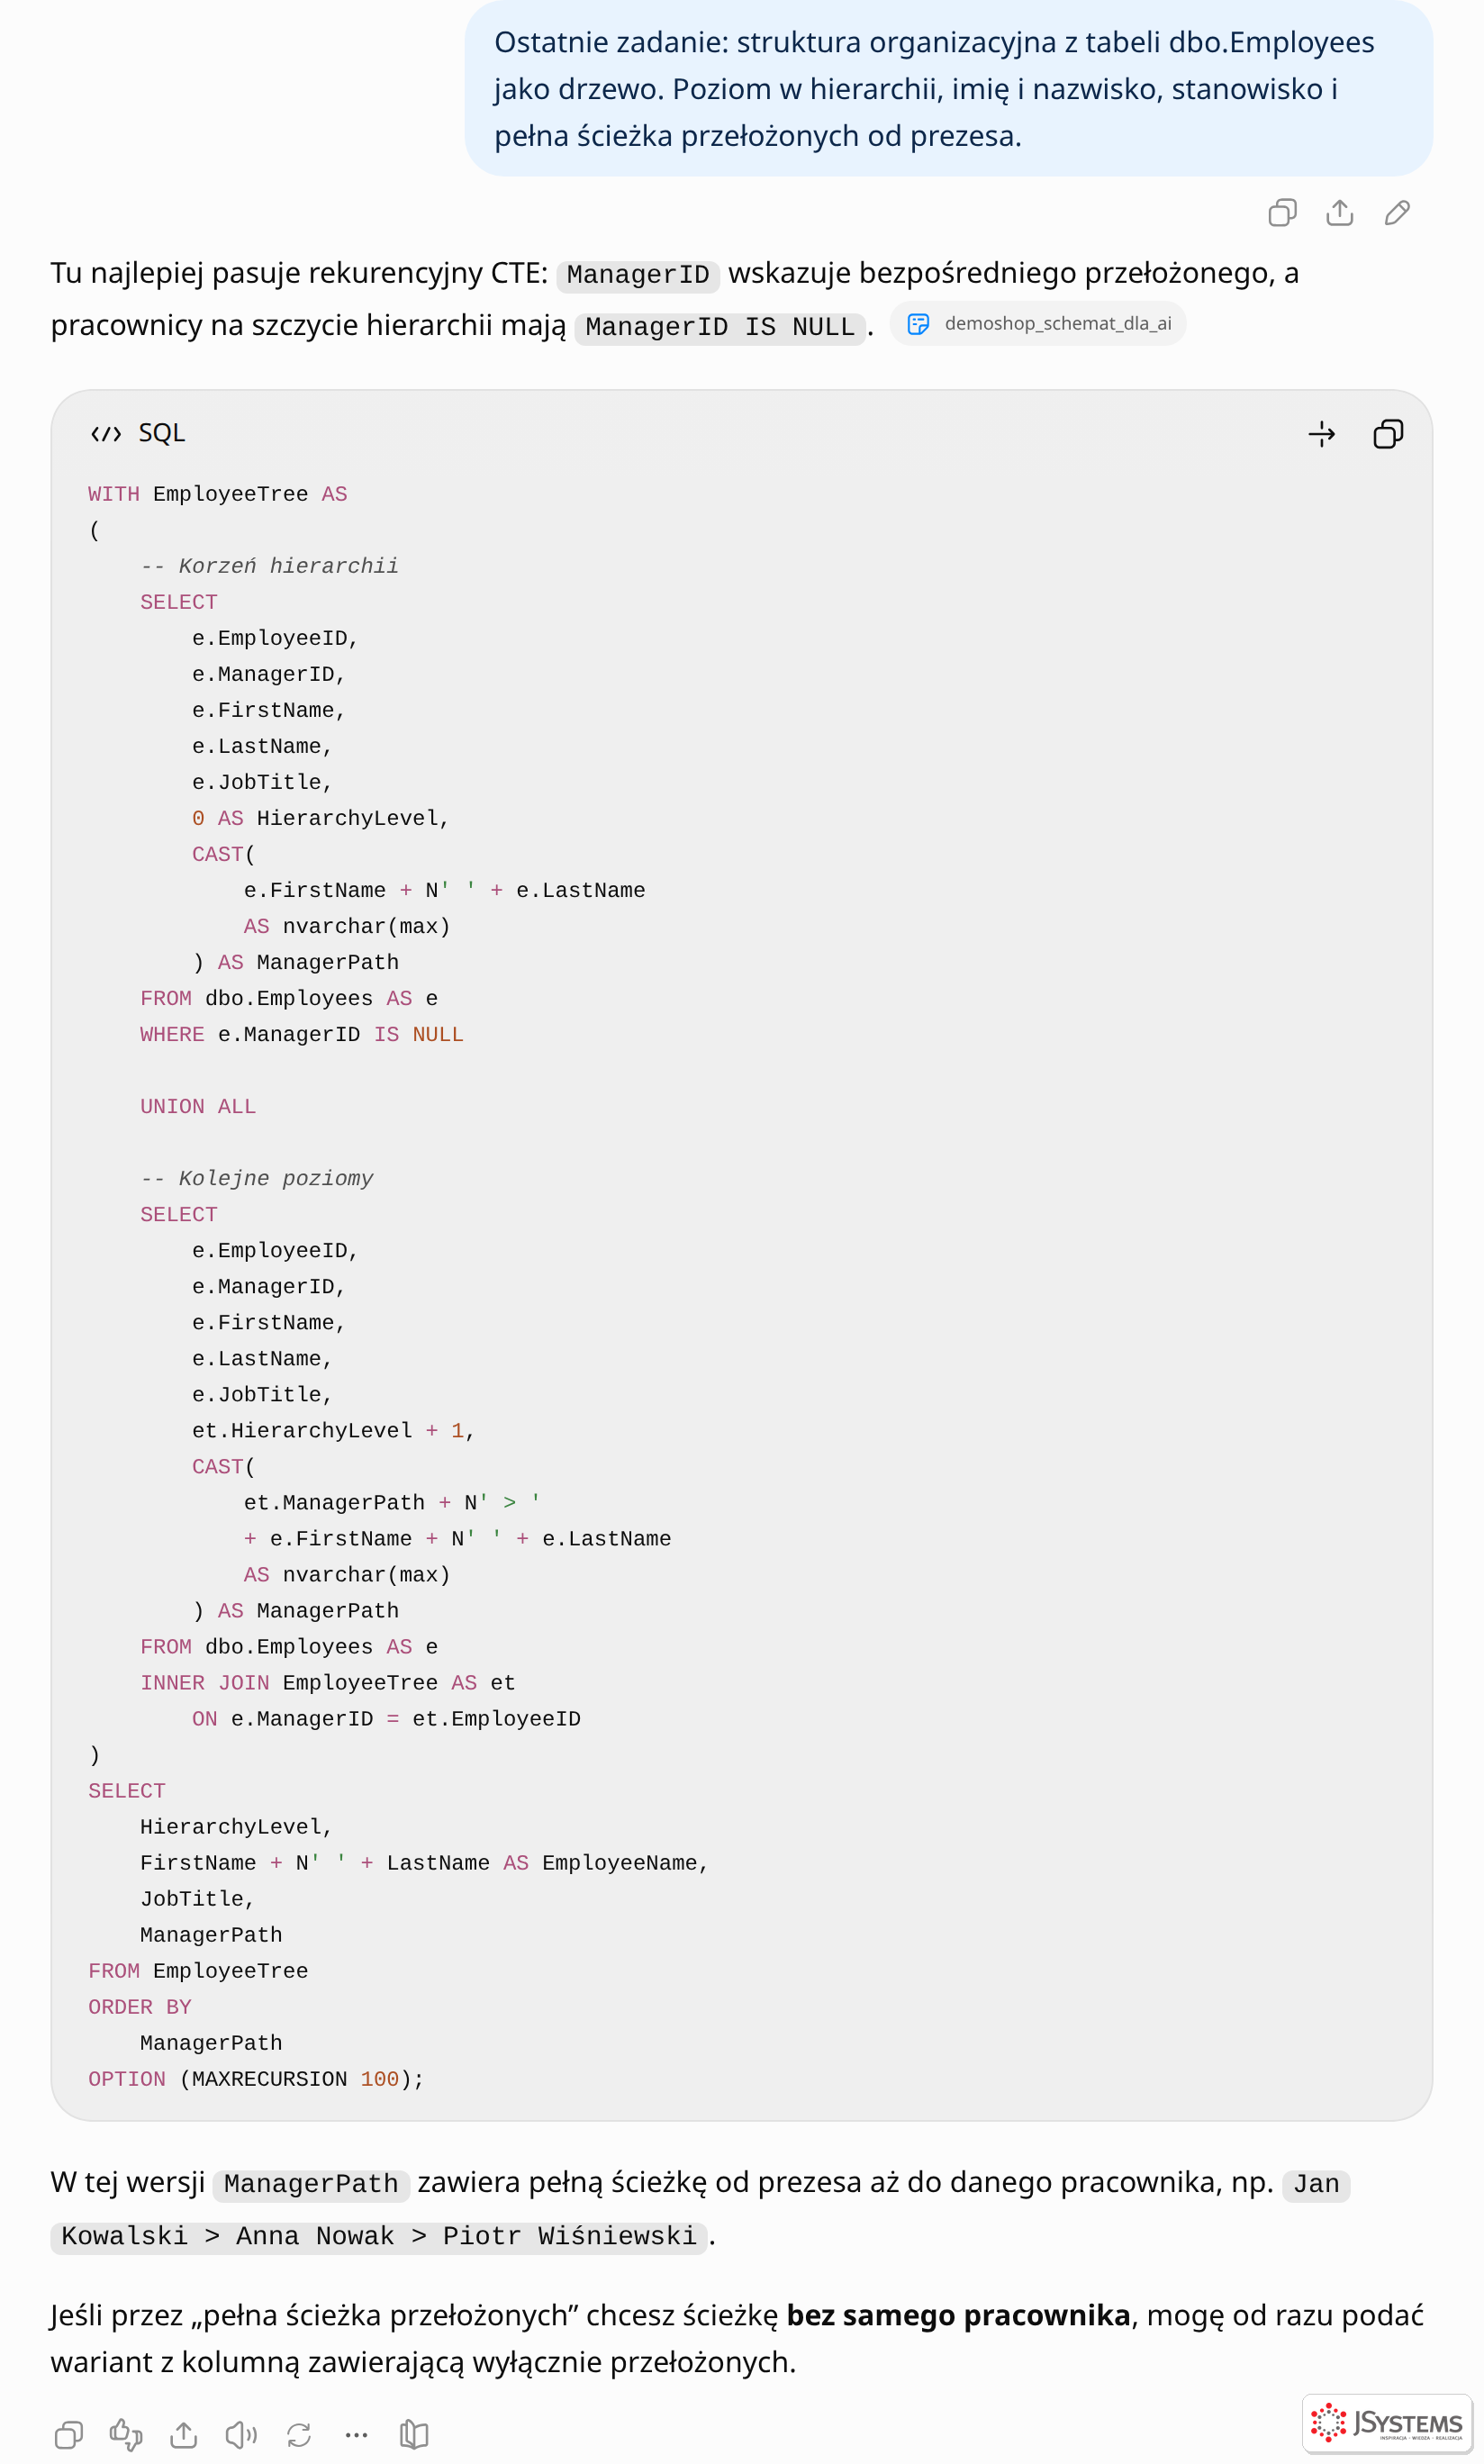
WITH EmployeeTree AS
(
    -- Korzeń hierarchii
    SELECT
        e.EmployeeID,
        e.ManagerID,
        e.FirstName,
        e.LastName,
        e.JobTitle,
        0 AS HierarchyLevel,
        CAST(
            e.FirstName + N' ' + e.LastName
            AS nvarchar(max)
        ) AS ManagerPath
    FROM dbo.Employees AS e
    WHERE e.ManagerID IS NULL

    UNION ALL

    -- Kolejne poziomy
    SELECT
        e.EmployeeID,
        e.ManagerID,
        e.FirstName,
        e.LastName,
        e.JobTitle,
        et.HierarchyLevel + 1,
        CAST(
            et.ManagerPath + N' > '
            + e.FirstName + N' ' + e.LastName
            AS nvarchar(max)
        ) AS ManagerPath
    FROM dbo.Employees AS e
    INNER JOIN EmployeeTree AS et
        ON e.ManagerID = et.EmployeeID
)
SELECT
    HierarchyLevel,
    FirstName + N' ' + LastName AS EmployeeName,
    JobTitle,
    ManagerPath
FROM EmployeeTree
ORDER BY
    ManagerPath
OPTION (MAXRECURSION 100);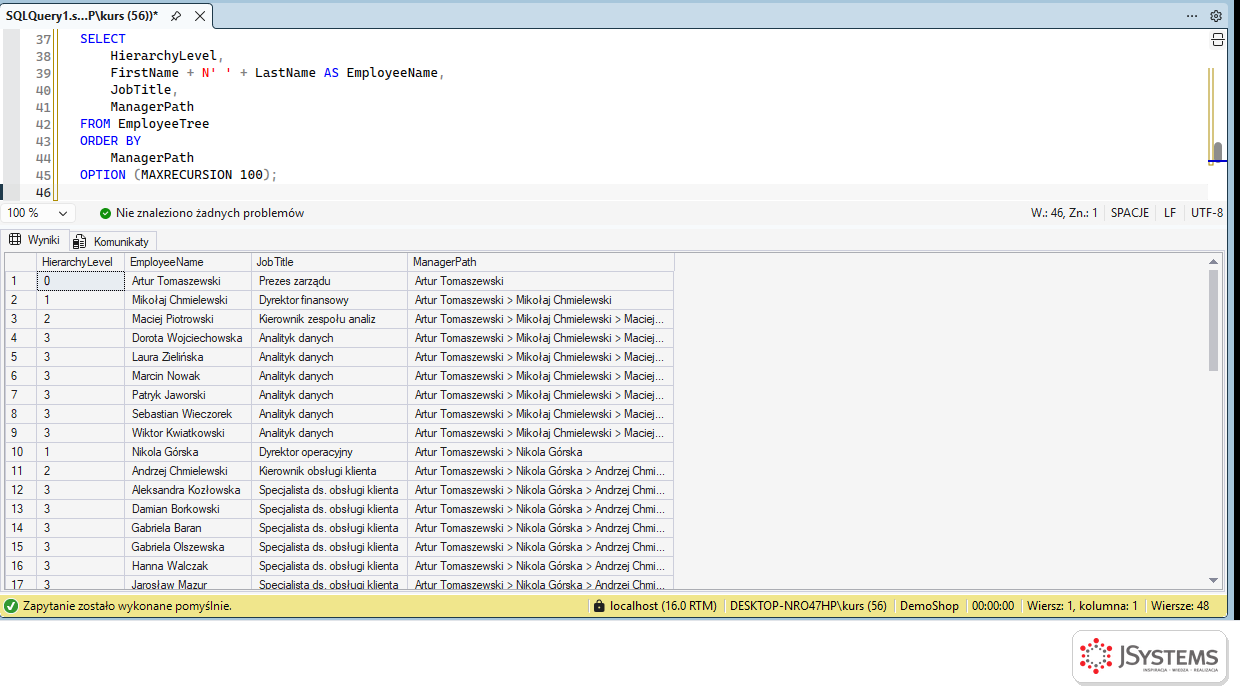
Po sześciu zadaniach widać wzorzec. Z dobrym kontekstem AI pisze poprawne i nowoczesne SQL: funkcje okienkowe zamiast samozłączeń, zakresy dat zamiast funkcji na kolumnach, jawne ramki okien. Dwa razy zadało pytanie, zamiast zgadywać. Słabym punktem nie była składnia, tylko to, czego w poleceniu nie było: interpretacja niepełnego roku i świadomy wybór między rodzajami rankingu.
Część 1 z 8 przewodnika AI w SQL


Komentarze (0)
Brak komentarzy...