
Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
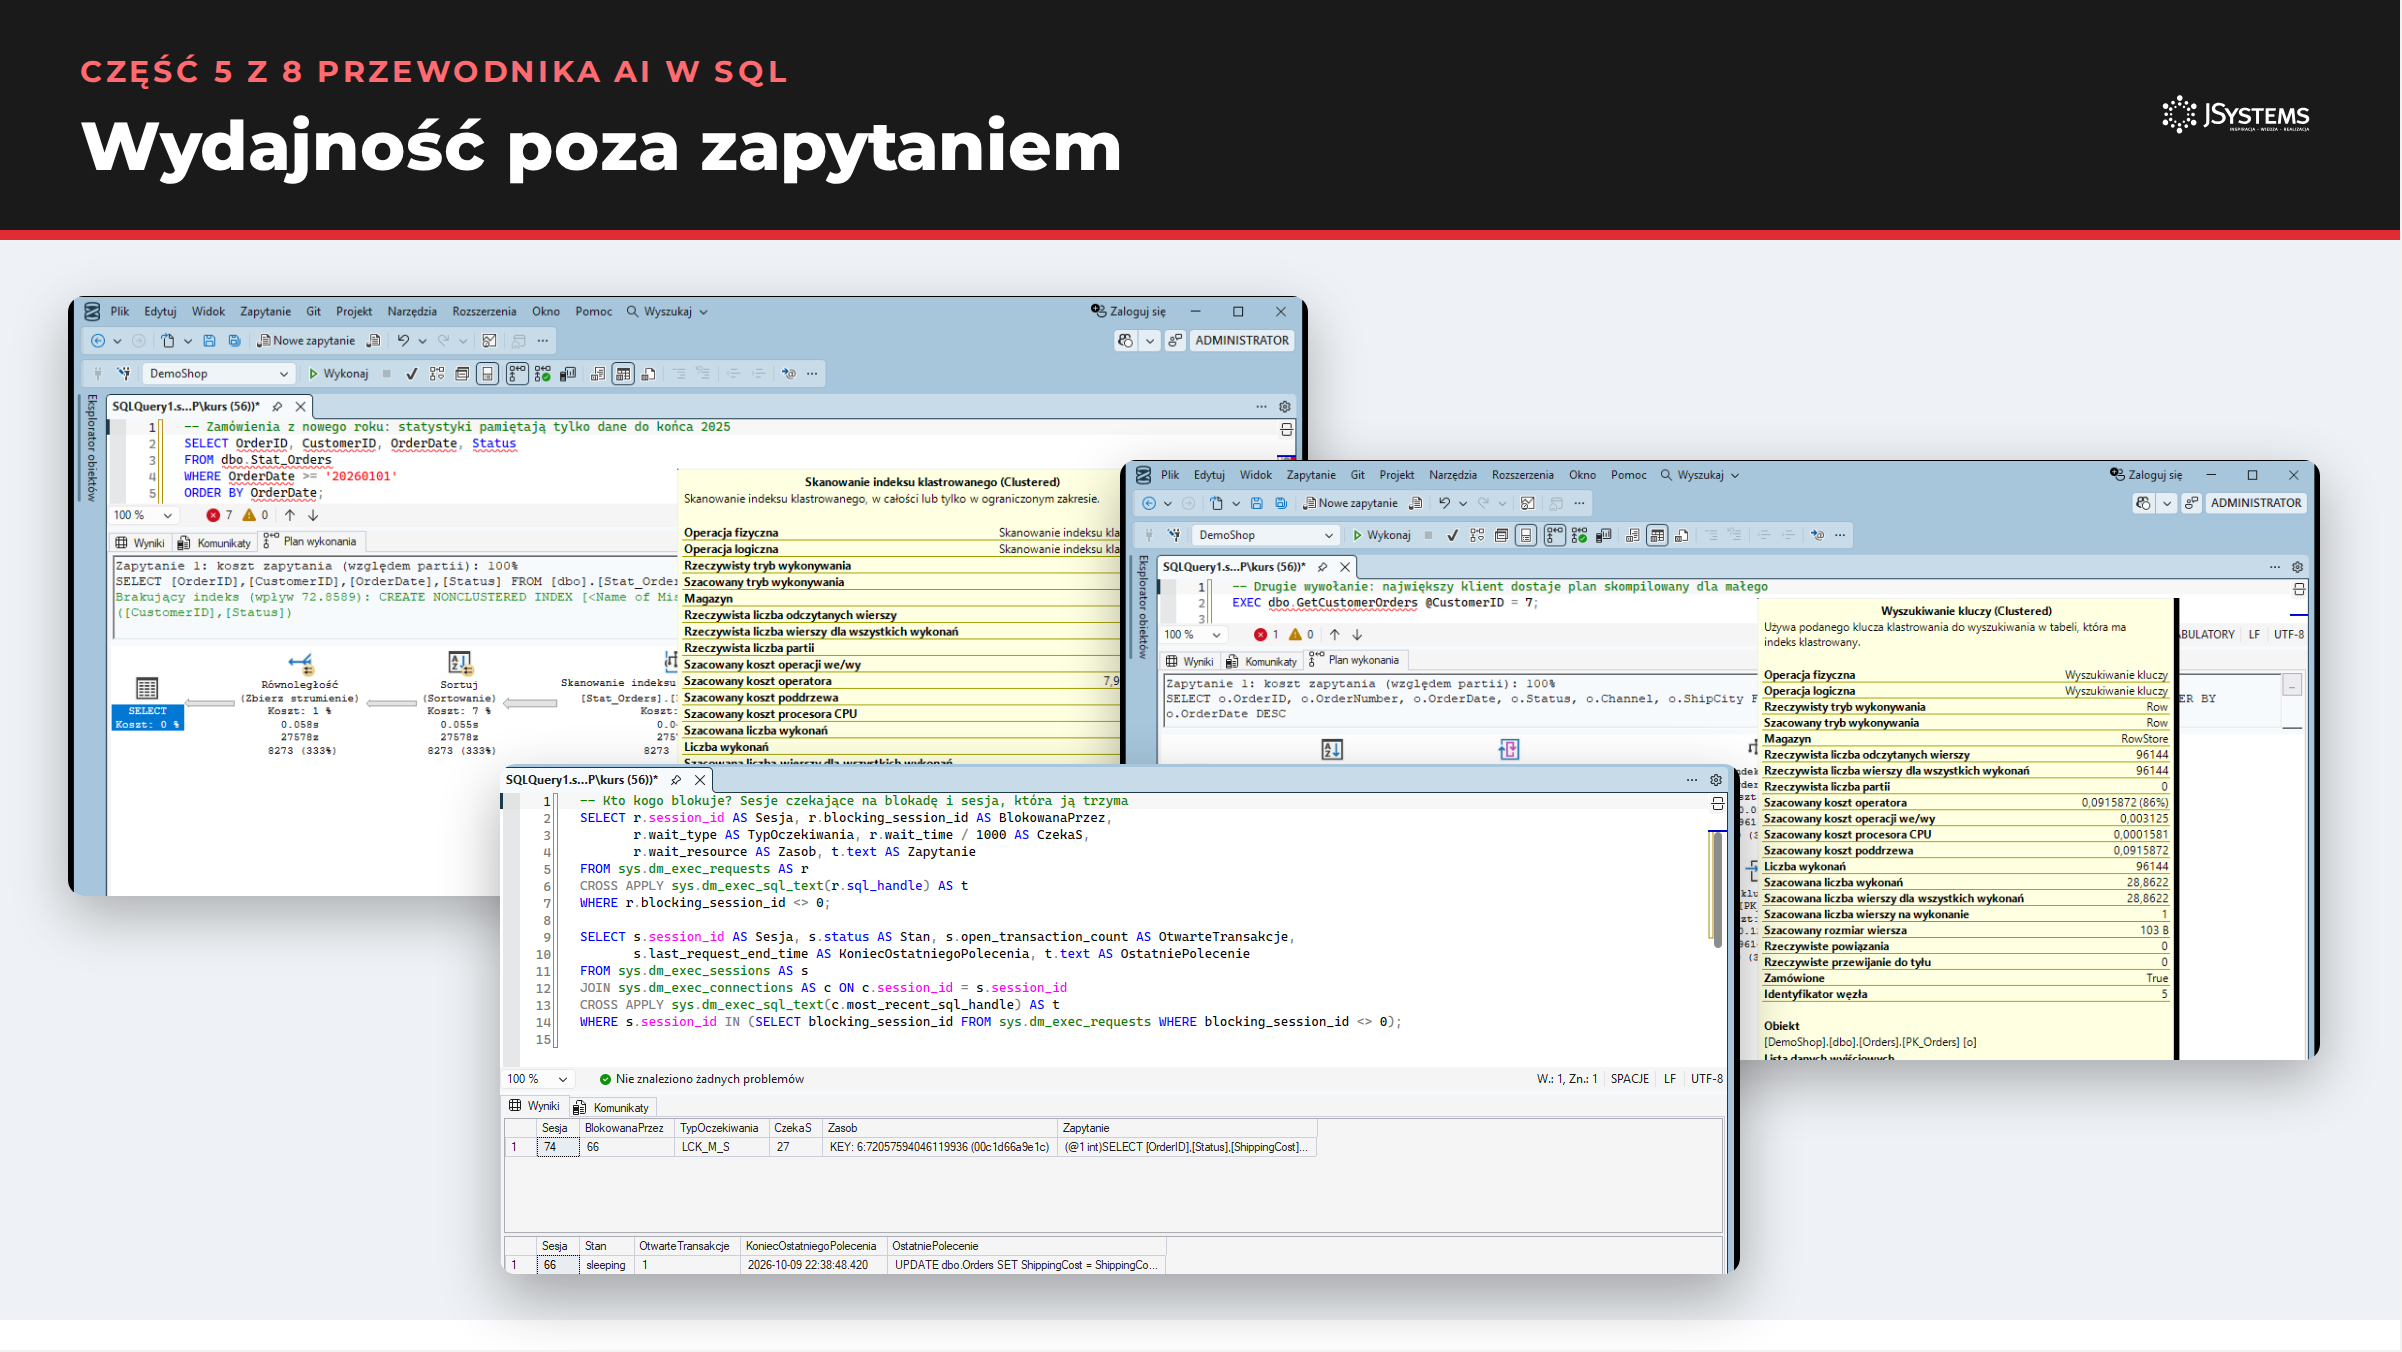
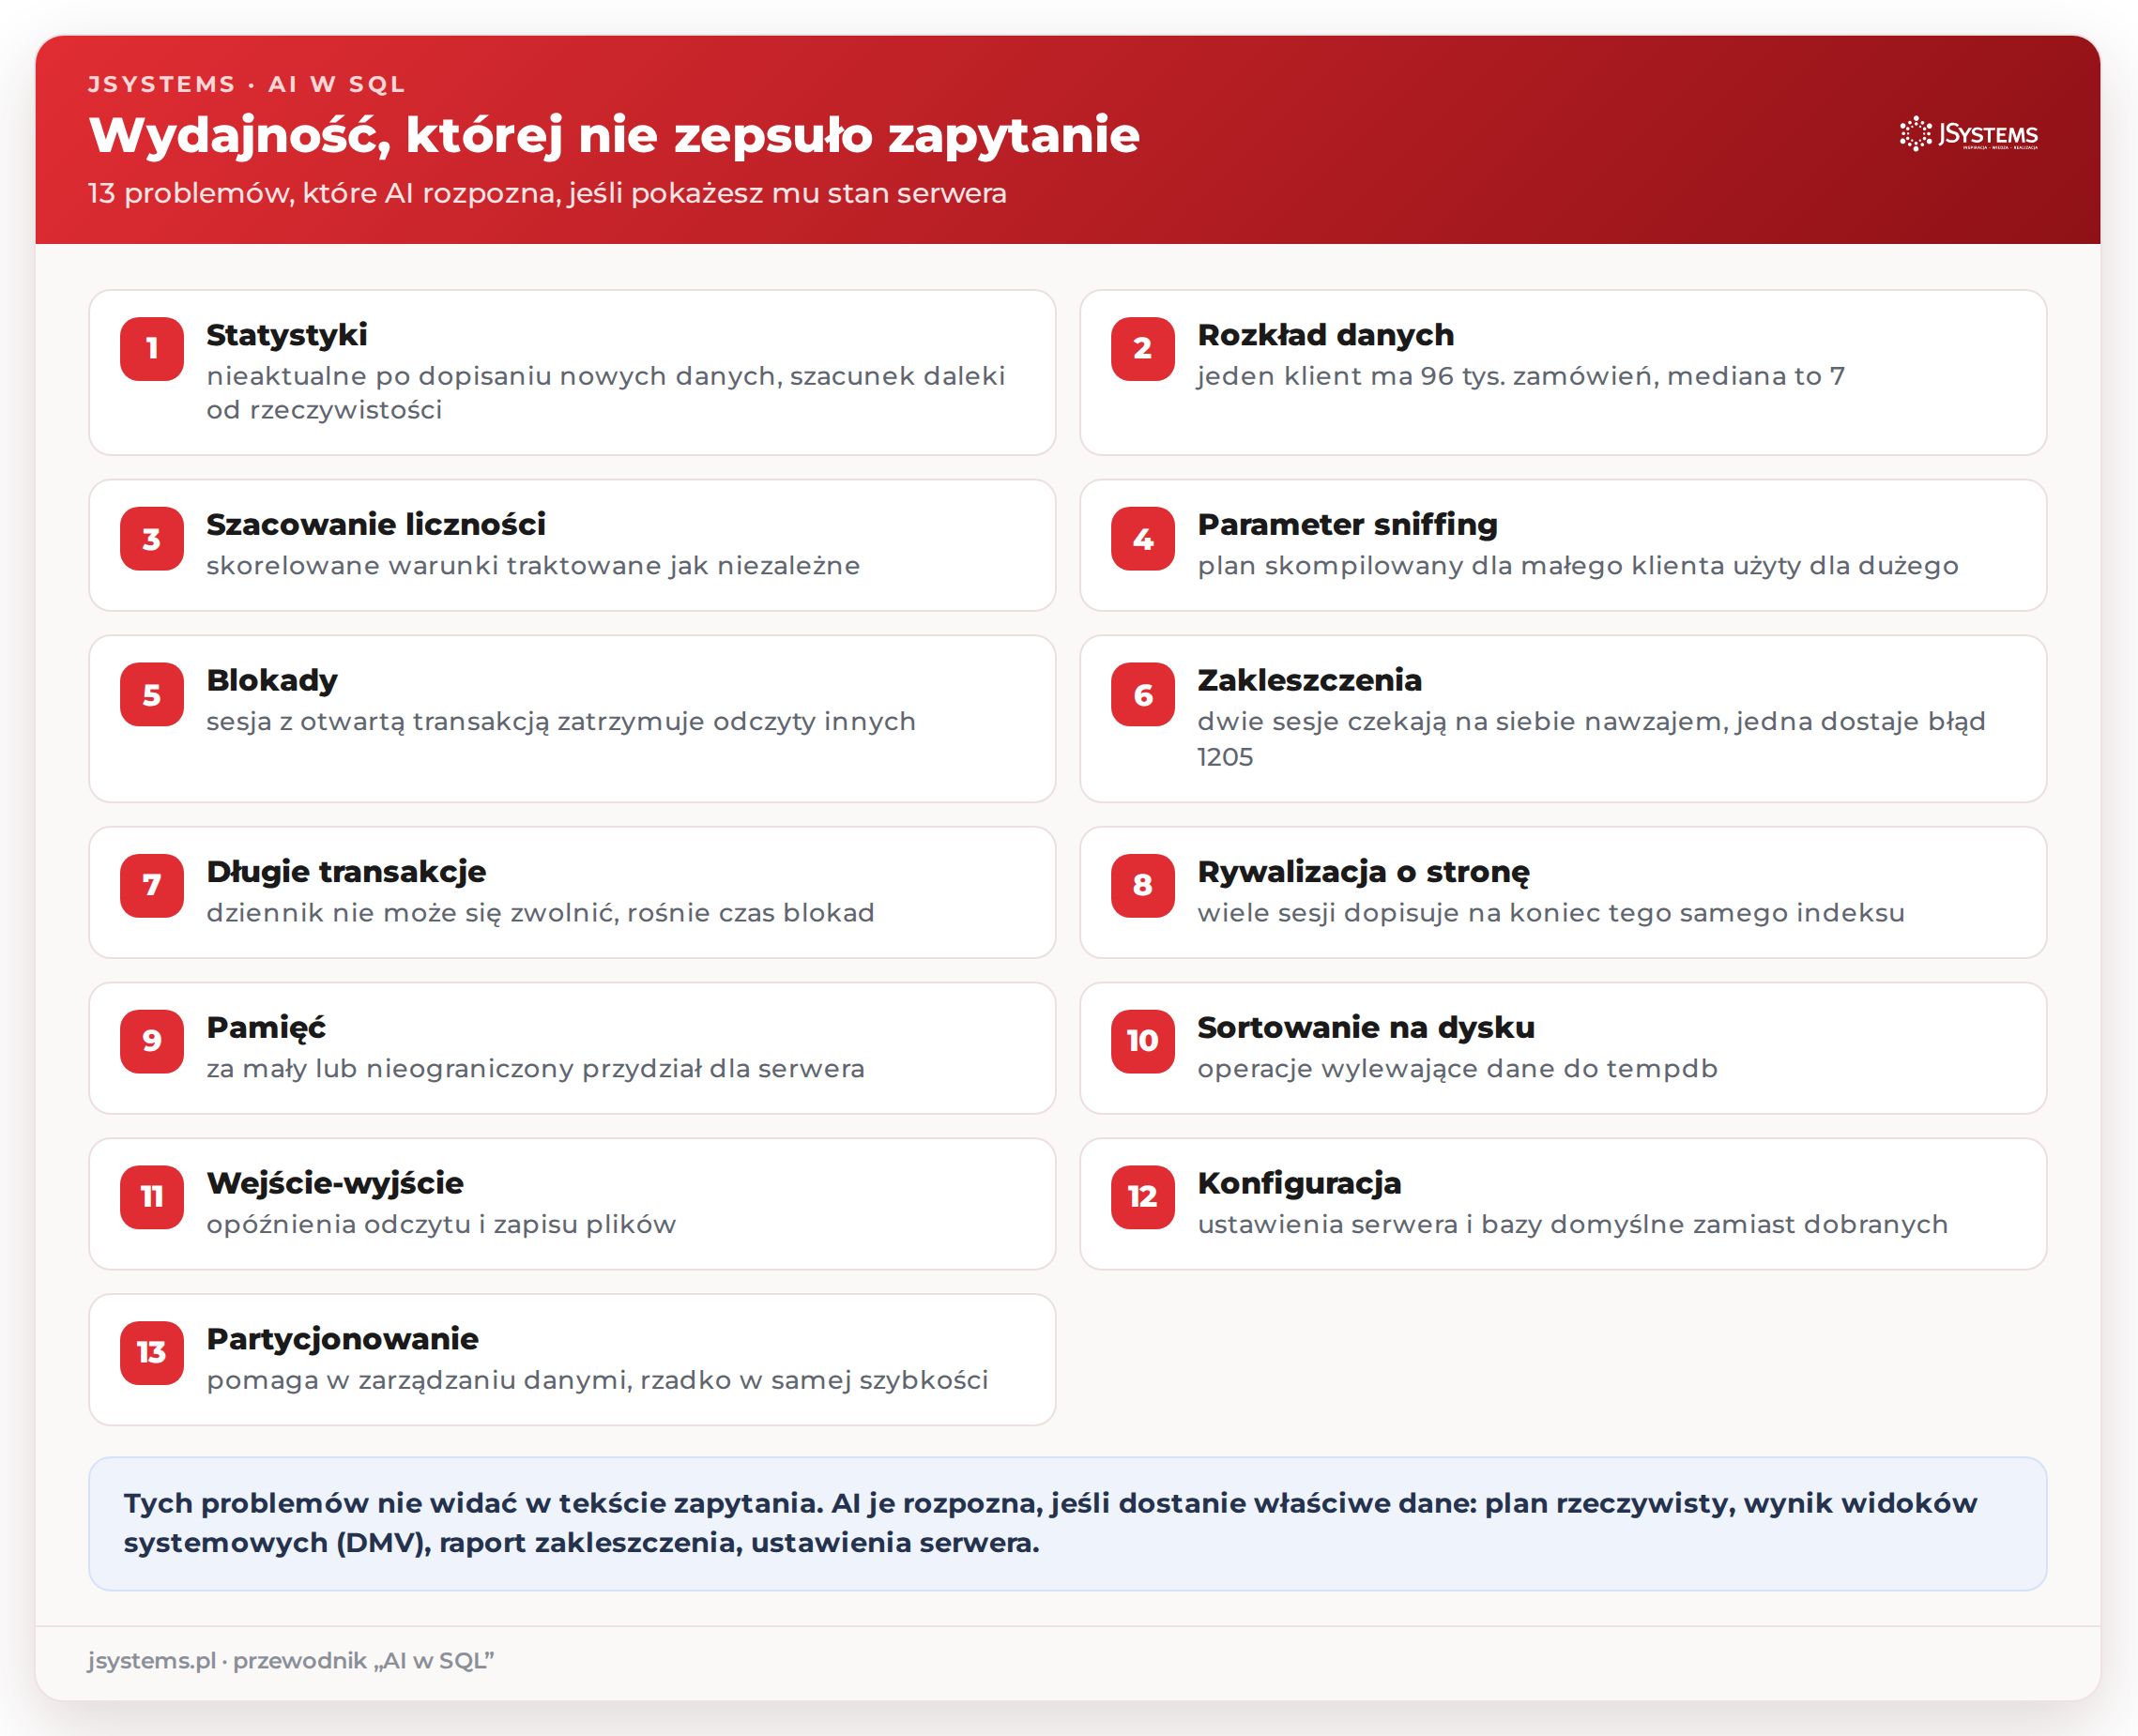
W skrócieCzęść problemów z wydajnością SQL Server nie wynika z treści zapytania, tylko ze statystyk, rozkładu danych, innych sesji, pamięci, dysku albo konfiguracji. Pokazujemy 13 takich problemów na bazie DemoShop, dla każdego zapytanie diagnostyczne, które daje AI właściwe dane, i ocenę odpowiedzi ChatGPT.
To część 5 z 8 przewodnika AI w SQL. Wszystkie przykłady powstały na bazie DemoShop w SQL Server 2022: fikcyjnym sklepie internetowym z 2,4 mln zamówień. Polecenia wpisujemy do ChatGPT, ale te same możesz podać Microsoft Copilotowi, Claude albo Gemini. Przy skryptach korzystających z mechanizmów serwera w małej szarej ramce znajdziesz ich odpowiedniki dla Oracle i PostgreSQL.
Z tej części dowiesz się:
Pliki do tej części
Skrypt bazy uruchamiasz w SSMS na serwerze SQL Server 2019 lub nowszym. Tworzy bazę DemoShop, na której powstały wszystkie przykłady.
Do tej pory przyczyna wolnego działania siedziała w tekście zapytania: funkcja na kolumnie, brakujący indeks, zbędne sortowanie. Często jednak zapytanie jest napisane dobrze, a mimo to działa źle. Przyczyną są wtedy statystyki, rozkład danych, inne sesje, pamięć, dysk albo konfiguracja serwera. Takich problemów nie znajdzie AI, które dostało tylko kod. Znajdzie je, jeśli dostanie właściwe dane: rzeczywisty plan wykonania, wynik widoków systemowych z chwili problemu, raport zakleszczenia albo ustawienia serwera. Każdy z trzynastu problemów poniżej odtworzyliśmy na bazie DemoShop, a wynik diagnostyki przekazaliśmy ChatGPT jako plik.
Dane, o których mówią polecenia w tej sekcji (stan statystyk, statystyki procedury, liczniki pamięci, opóźnienia plików, konfiguracja), to wyniki zapytań do widoków systemowych. Każde zapytanie pokazujemy nad jego zrzutem, a wszystkie razem, z przygotowaniem obiektów do dem i sprzątaniem po nich, są w pliku wydajnosc_poza_zapytaniem.sql. Wynik kopiujesz razem z nagłówkami kolumn: najprościej przełączyć wyniki na tekst (Ctrl+T przed uruchomieniem) albo w siatce zaznaczyć wszystko (Ctrl+A) i skopiować skrótem Ctrl+Shift+C. Skopiowany wynik wklejasz pod poleceniem albo zapisujesz do pliku .txt i załączasz do rozmowy.
Optymalizator wybiera plan na podstawie statystyk, czyli histogramu wartości w kolumnie. Gdy do tabeli dochodzą nowe dane na końcu zakresu (kolejne daty, kolejne numery), histogram ich nie zna, dopóki statystyki nie zostaną zaktualizowane. Automatyczna aktualizacja włącza się dopiero po przekroczeniu progu zmian. Odtworzyliśmy to na kopii zamówień do końca 2025 roku, do której dopisaliśmy pierwsze dwa tygodnie 2026 roku, 27 578 zamówień:
-- Zamówienia z nowego roku: statystyki pamiętają tylko dane do końca 2025
SELECT OrderID, CustomerID, OrderDate, Status
FROM dbo.Stat_Orders
WHERE OrderDate >= '20260101'
ORDER BY OrderDate;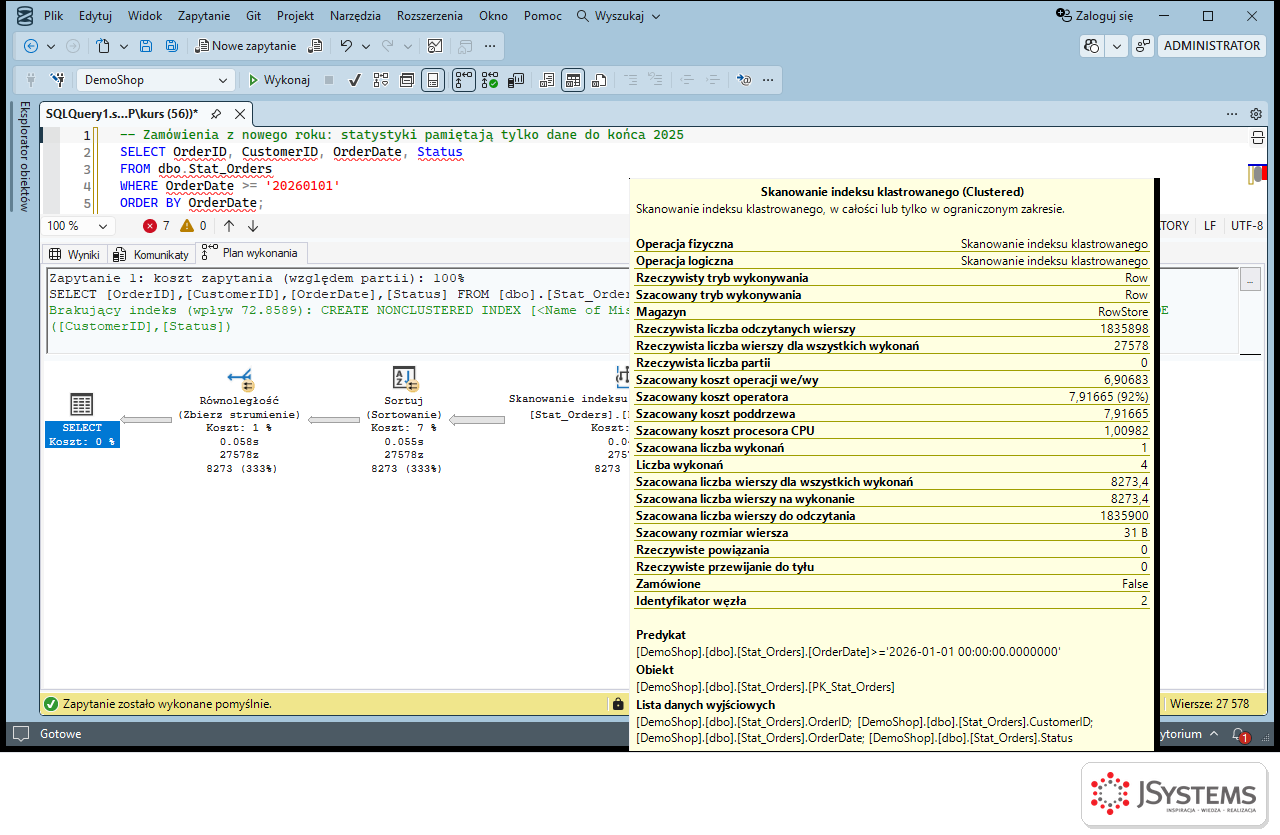
-- Stan statystyk: kiedy aktualizowane, ile zmian od tego czasu, jaki próg automatycznej aktualizacji
SELECT s.name AS Statystyka, sp.last_updated AS Aktualizacja, sp.rows AS Wiersze,
       sp.modification_counter AS ZmianyOdAktualizacji,
       CAST(SQRT(1000.0 * sp.rows) AS int) AS ProgAutoAktualizacji
FROM sys.stats AS s
CROSS APPLY sys.dm_db_stats_properties(s.object_id, s.stats_id) AS sp
WHERE s.object_id = OBJECT_ID('dbo.Stat_Orders');

SELECT TOP (3) step_number AS Krok, range_high_key AS GornaGranica, equal_rows AS WierszeRowne
FROM sys.dm_db_stats_histogram(OBJECT_ID('dbo.Stat_Orders'),
     (SELECT stats_id FROM sys.stats WHERE name = 'IX_Stat_Orders_OrderDate'))
ORDER BY step_number DESC;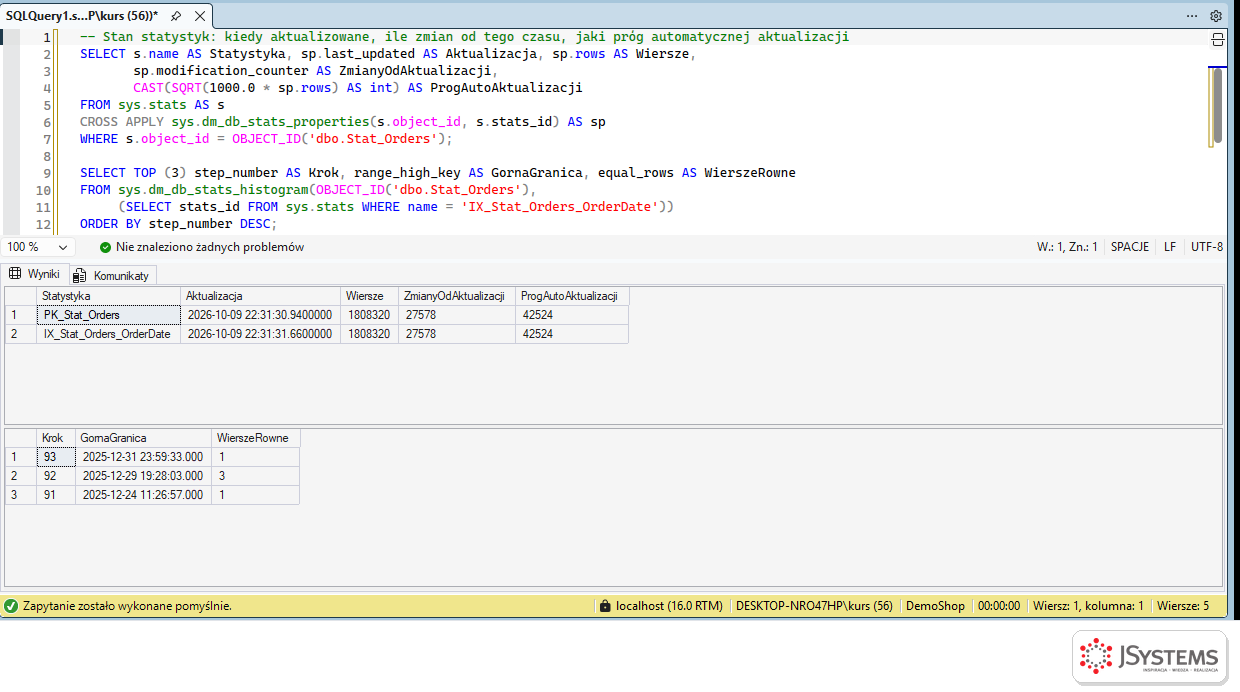
Zapytanie o zamówienia od 1 stycznia 2026 w tabeli dbo.Stat_Orders (SQL Server 2022) działa wolniej, niż powinno. Załączam rzeczywisty plan wykonania i stan statystyk tabeli. Co jest przyczyną, jak to potwierdzić i jak naprawić teraz oraz na przyszłość, skoro codziennie dochodzą nowe zamówienia?
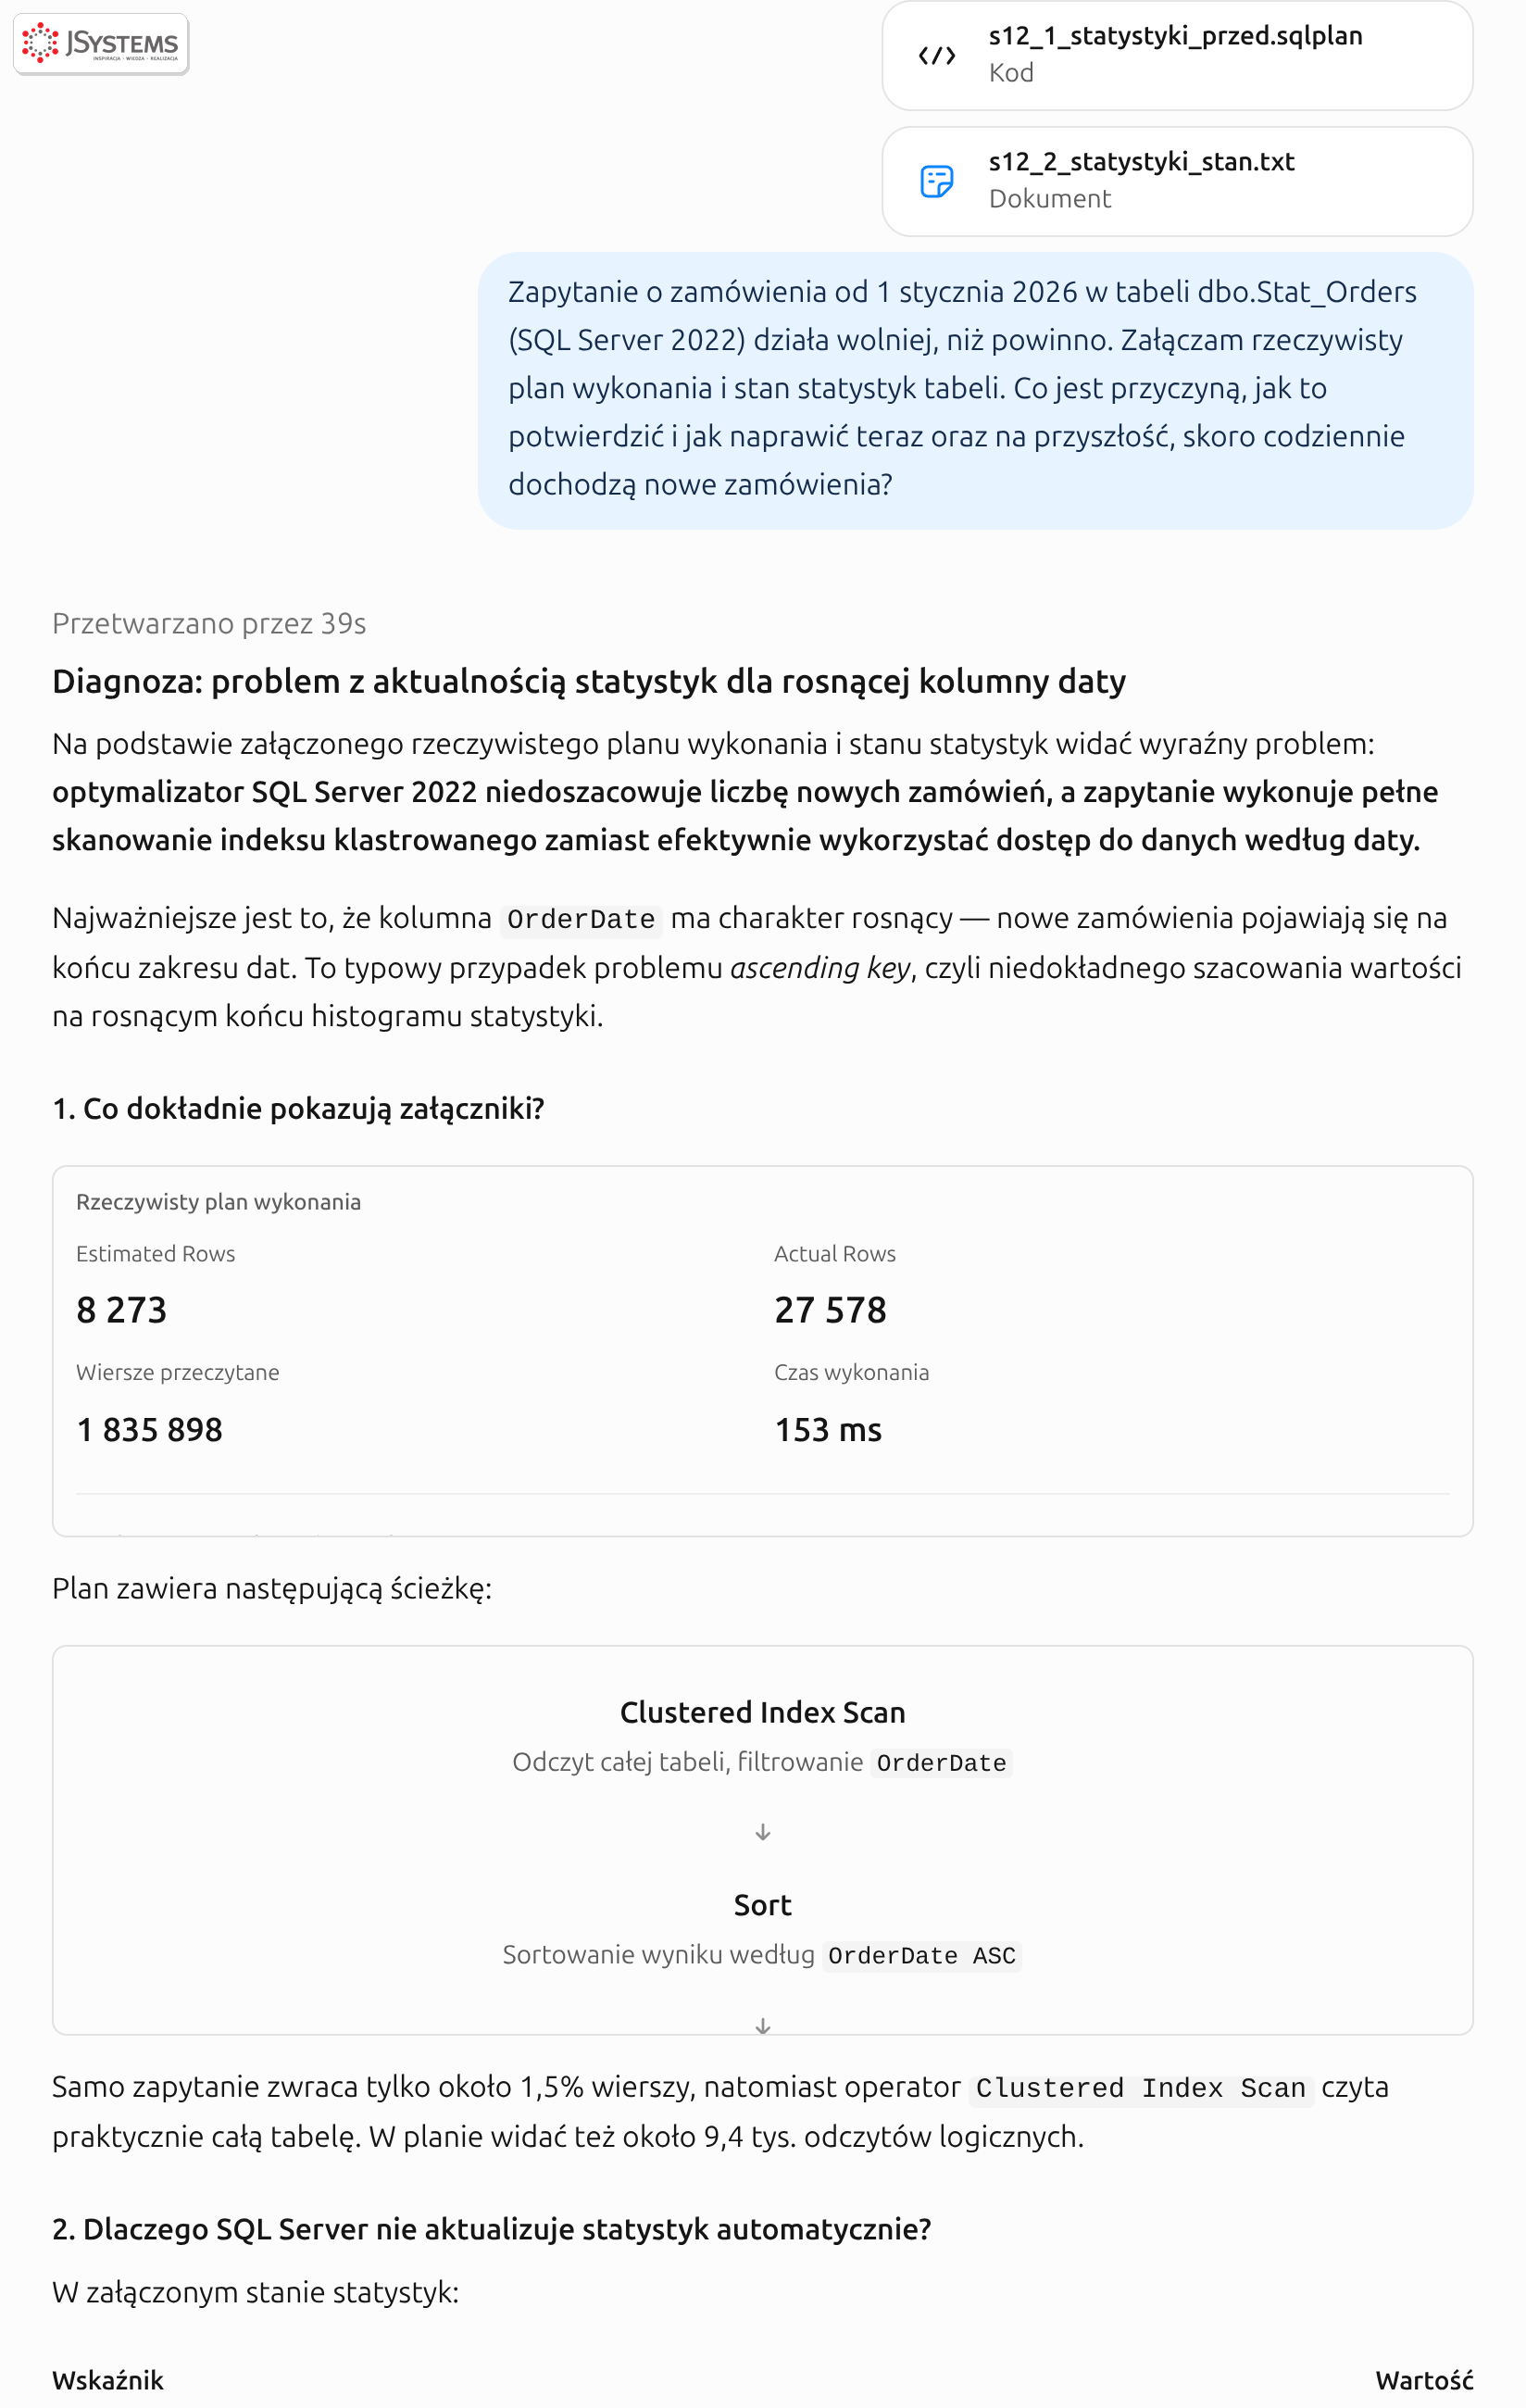
Najcenniejsze w tej odpowiedzi jest jedno zastrzeżenie: AI napisało, że odświeżenie statystyk poprawi szacunek, ale nie gwarantuje lepszego planu, bo wybór skanu może wynikać z tego, że indeks na dacie nie zawiera pozostałych kolumn. Sprawdziliśmy to:
UPDATE STATISTICS dbo.Stat_Orders IX_Stat_Orders_OrderDate WITH FULLSCAN;

-- To samo zapytanie po UPDATE STATISTICS ... WITH FULLSCAN
SELECT OrderID, CustomerID, OrderDate, Status
FROM dbo.Stat_Orders
WHERE OrderDate >= '20260101'
ORDER BY OrderDate;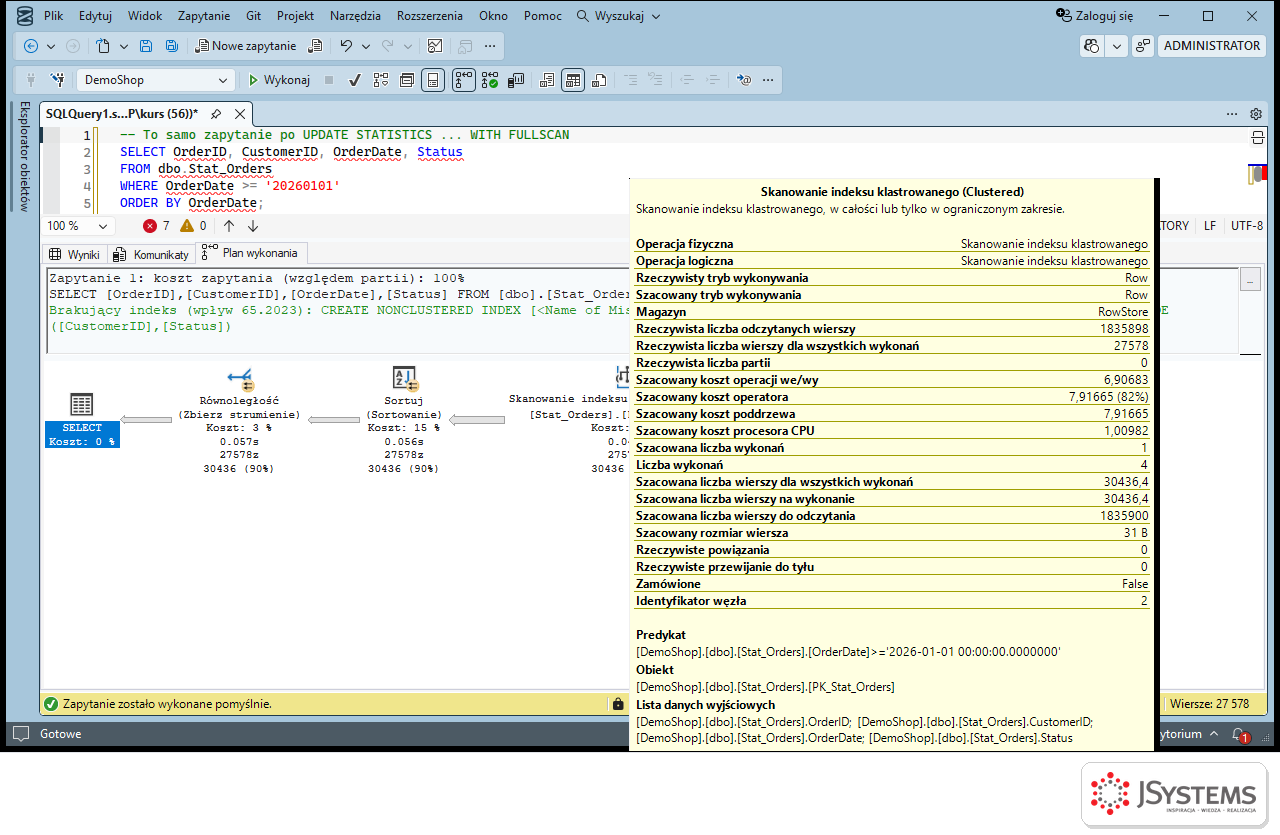
Przewidywanie AI okazało się trafne. Statystyki naprawiły szacunek, ale nie wydajność. Kolejnym krokiem jest to, co AI zaproponowało jako drugi: indeks na dacie z dołączonymi kolumnami. Na przyszłość pomaga zadanie aktualizujące statystyki często zmienianych tabel w nocy, a przy dużych tabelach także opcja AUTO_UPDATE_STATISTICS_ASYNC, dzięki której zapytanie nie czeka na odświeżenie.
Statystyki opisują dane średnio, a dane bywają skrajnie nierówne. W DemoShop mediana to 7 zamówień na klienta, a największy klient ma ich 96 144:
-- Nierówny rozkład danych: ile zamówień mają klienci
WITH Liczby AS (SELECT CustomerID, COUNT(*) AS Zamowienia FROM dbo.Orders GROUP BY CustomerID)
SELECT DISTINCT
       PERCENTILE_DISC(0.5)  WITHIN GROUP (ORDER BY Zamowienia) OVER () AS Mediana,
       PERCENTILE_DISC(0.99) WITHIN GROUP (ORDER BY Zamowienia) OVER () AS Percentyl99,
       MAX(Zamowienia) OVER () AS Maksimum
FROM Liczby;

SELECT TOP (5) CustomerID, COUNT(*) AS Zamowienia
FROM dbo.Orders GROUP BY CustomerID ORDER BY Zamowienia DESC;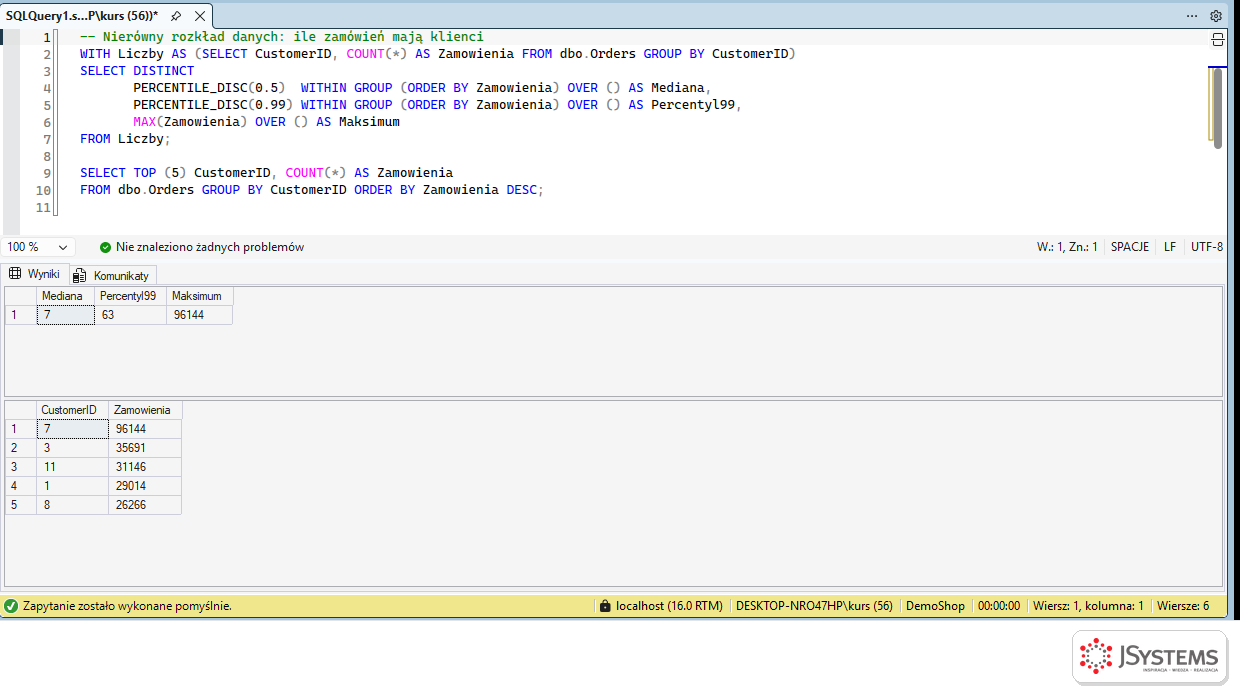
Taki rozkład sam w sobie nie jest błędem, ale jest źródłem dwóch kolejnych problemów: złych szacunków i parameter sniffing. Warto go pokazywać AI przy każdym pytaniu o wydajność zapytań filtrowanych po kliencie, produkcie czy innej kolumnie, w której kilka wartości ma większość danych.
Gdy zapytanie ma kilka warunków, optymalizator szacuje, ile wierszy spełni je łącznie. Nie wie jednak, że warunki zależą od siebie. Każdy klient z Warszawy jest z województwa mazowieckiego, więc drugi warunek niczego nie odfiltrowuje:
-- Dwa skorelowane warunki: każdy klient z Warszawy jest z województwa mazowieckiego
SELECT CustomerID, FirstName, LastName
FROM dbo.Customers
WHERE City = N'Warszawa'
  AND RegionID = 14;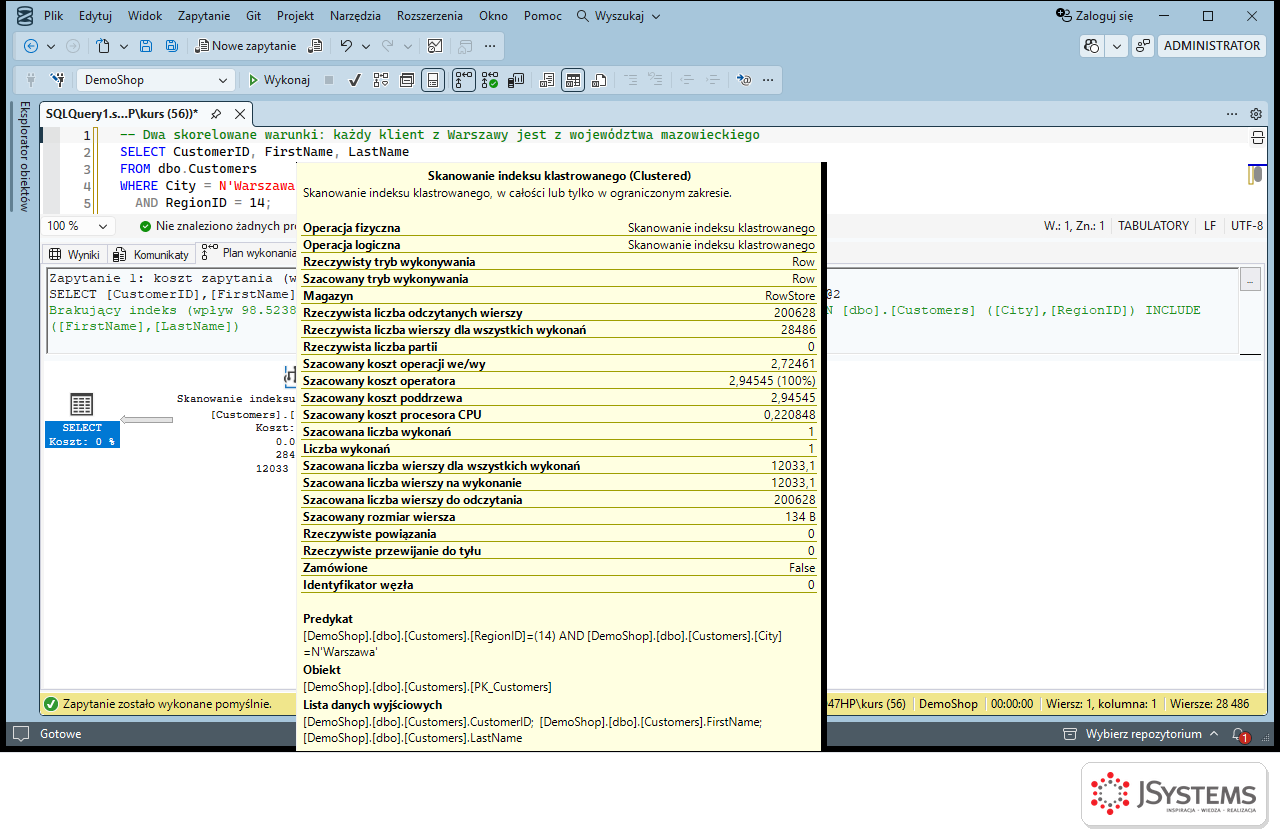
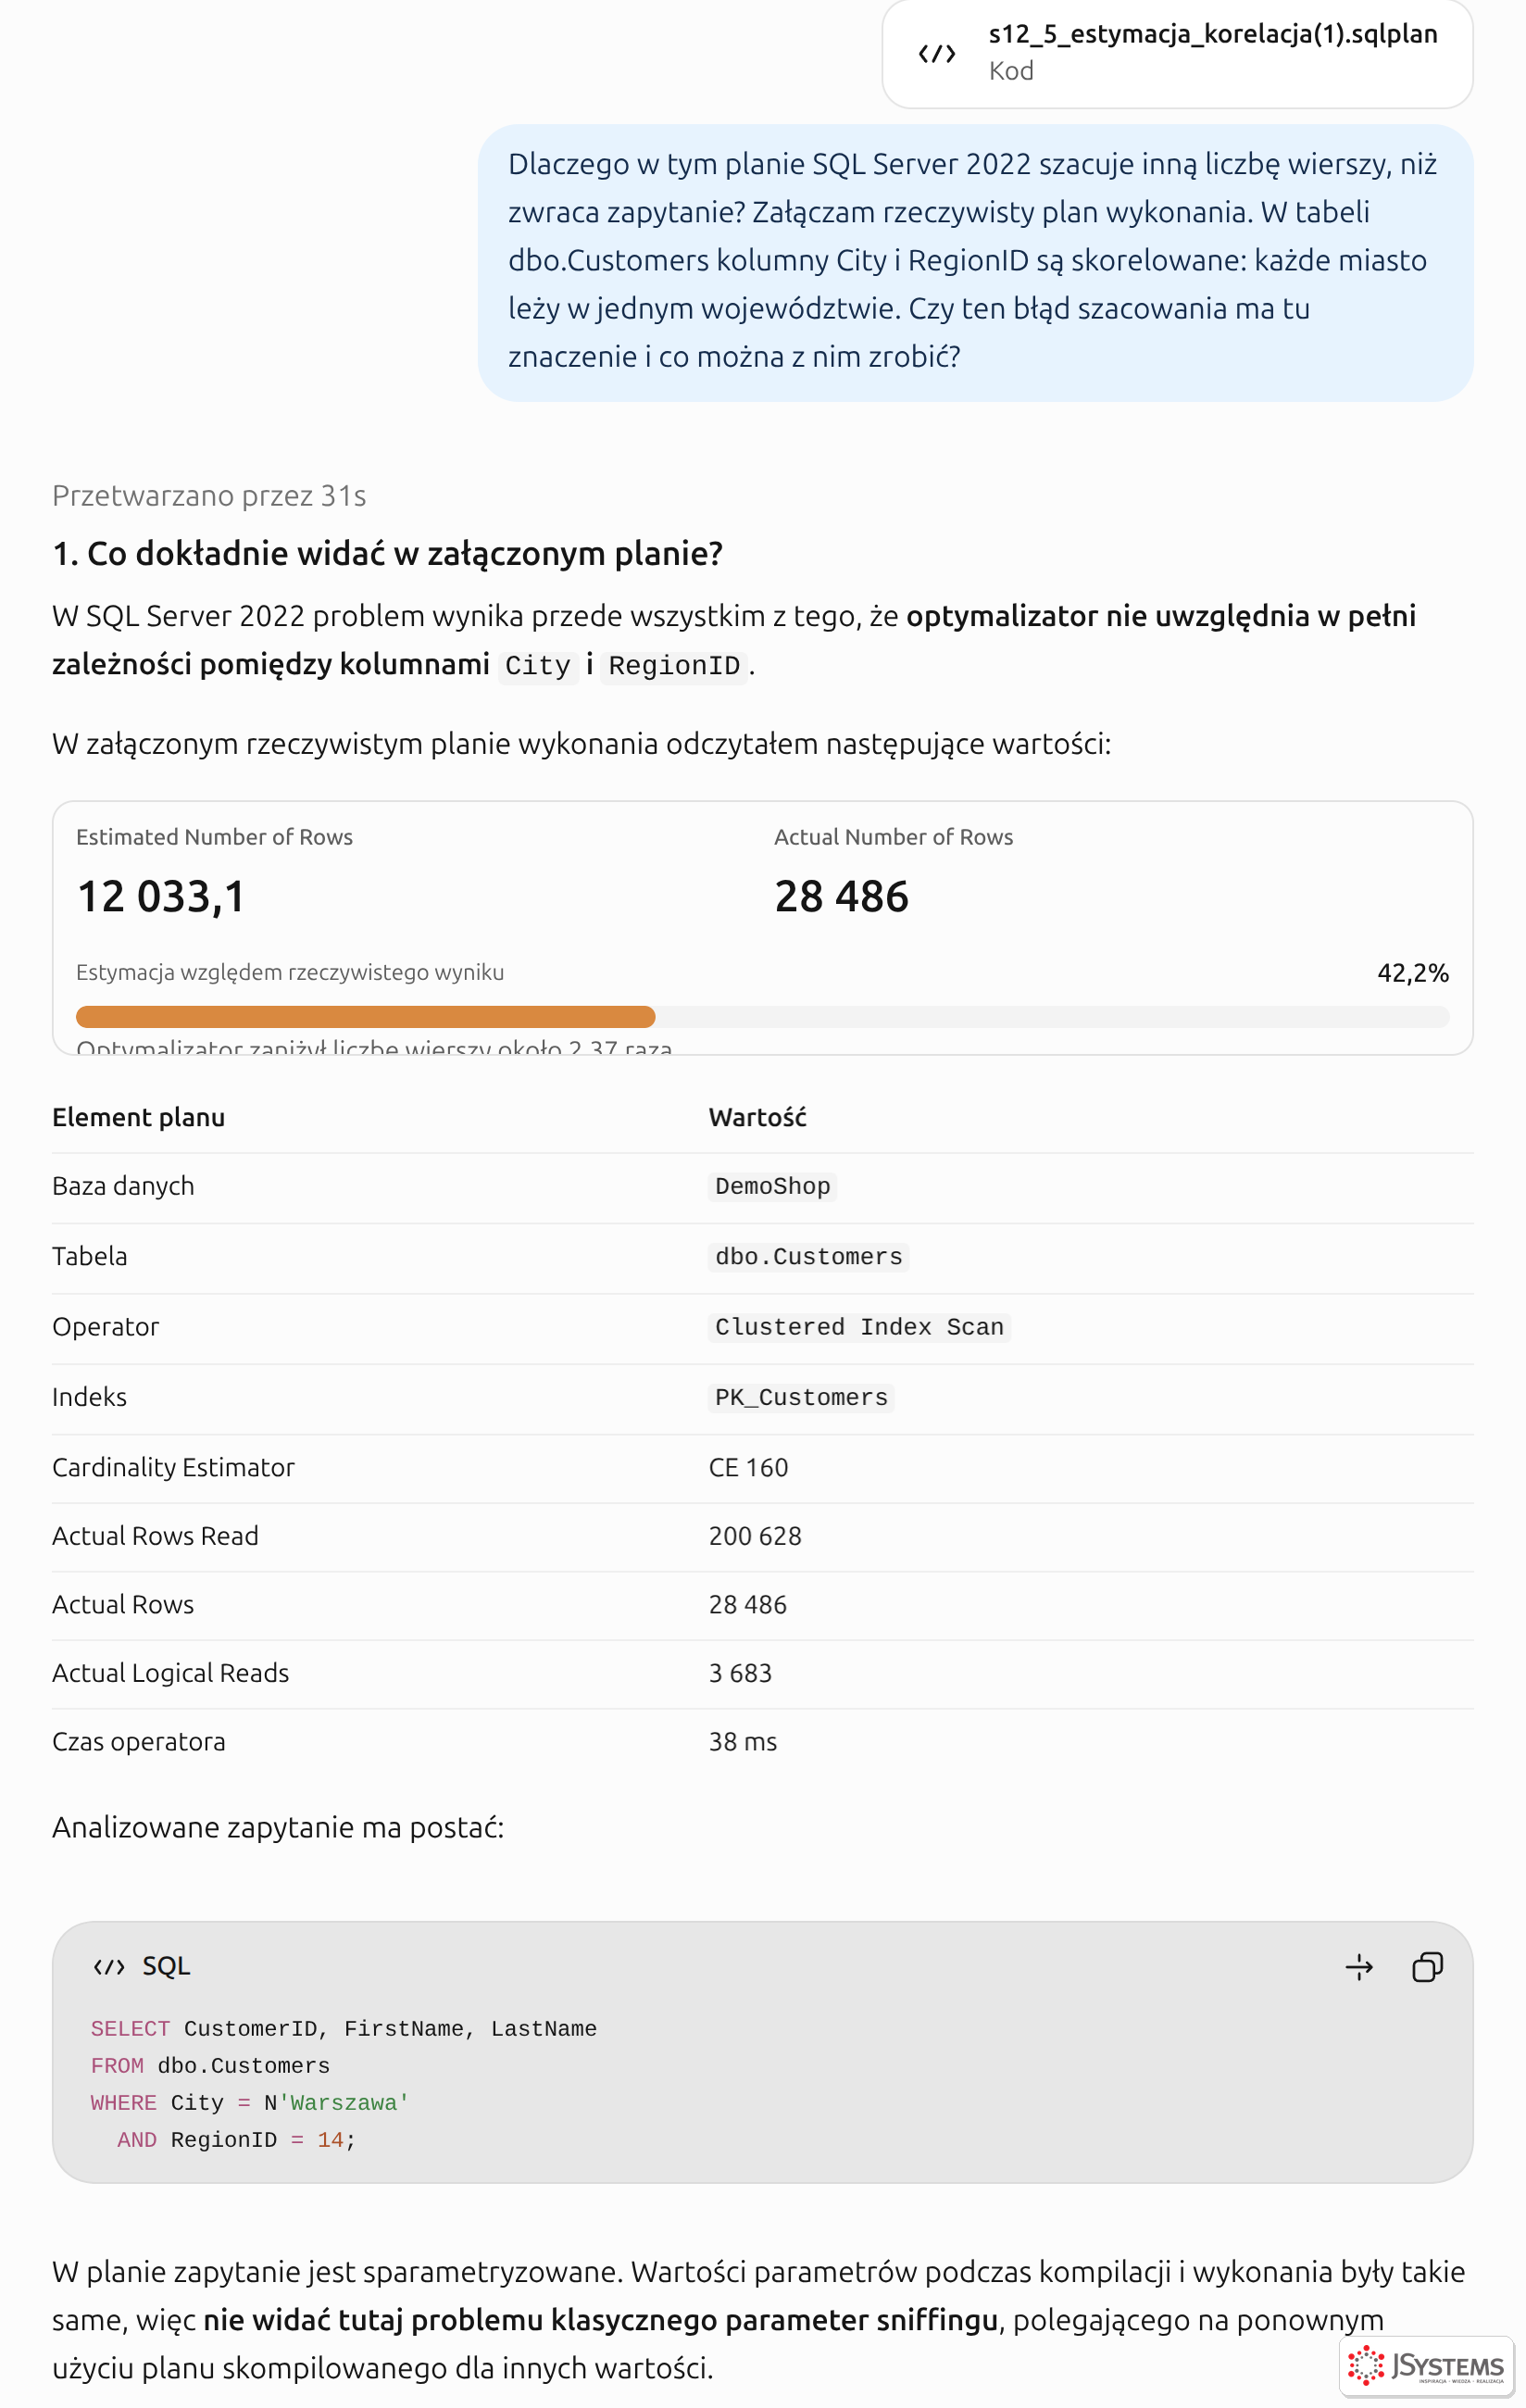
Dobra odpowiedź nie kończy się na diagnozie. AI zaproponowało statystyki wielokolumnowe CREATE STATISTICS ... (City, RegionID) i wskazówkę ASSUME_MIN_SELECTIVITY_FOR_FILTER_ESTIMATES do testu, ale dodało, że w tym konkretnym zapytaniu nie ma czego naprawiać: skan 200 tysięcy klientów trwa kilkadziesiąt milisekund, a błąd szacunku na nic nie wpływa. Umiejętność powiedzenia „to nie jest problem” jest równie ważna jak znajdowanie problemów.
Procedura składowana kompiluje się przy pierwszym wywołaniu dla wartości parametru, z którą została wywołana, a potem ten plan obsługuje wszystkie kolejne wywołania. Jeśli pierwszy był mały klient, duży klient dostanie plan dla małego:
CREATE OR ALTER PROCEDURE dbo.GetCustomerOrders @CustomerID int
AS
SELECT o.OrderID, o.OrderNumber, o.OrderDate, o.Status, o.Channel, o.ShipCity
FROM dbo.Orders AS o
WHERE o.CustomerID = @CustomerID
ORDER BY o.OrderDate DESC;
-- Pierwsze wywołanie po kompilacji: mały klient, plan dobrany do 12 zamówień
EXEC sp_recompile N'dbo.GetCustomerOrders';
EXEC dbo.GetCustomerOrders @CustomerID = 2130;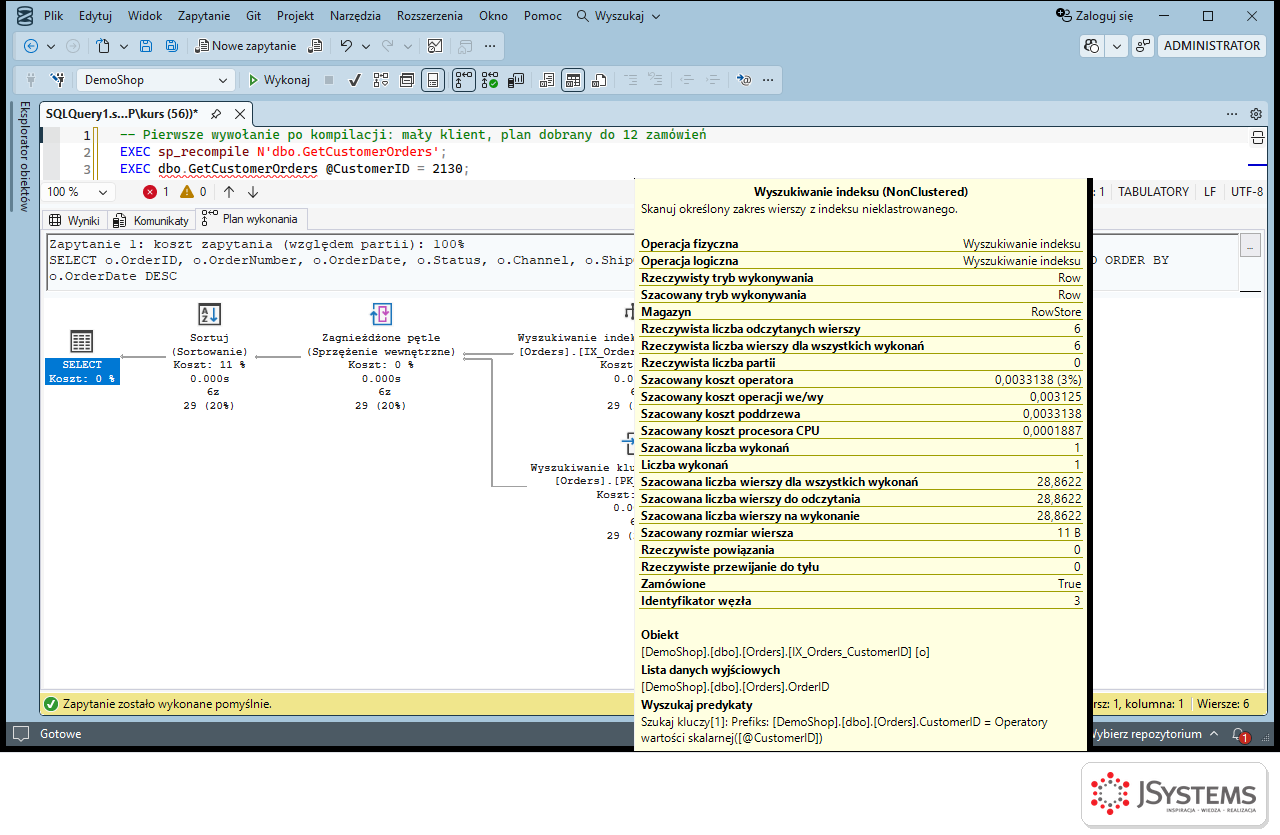
-- Drugie wywołanie: największy klient dostaje plan skompilowany dla małego
EXEC dbo.GetCustomerOrders @CustomerID = 7;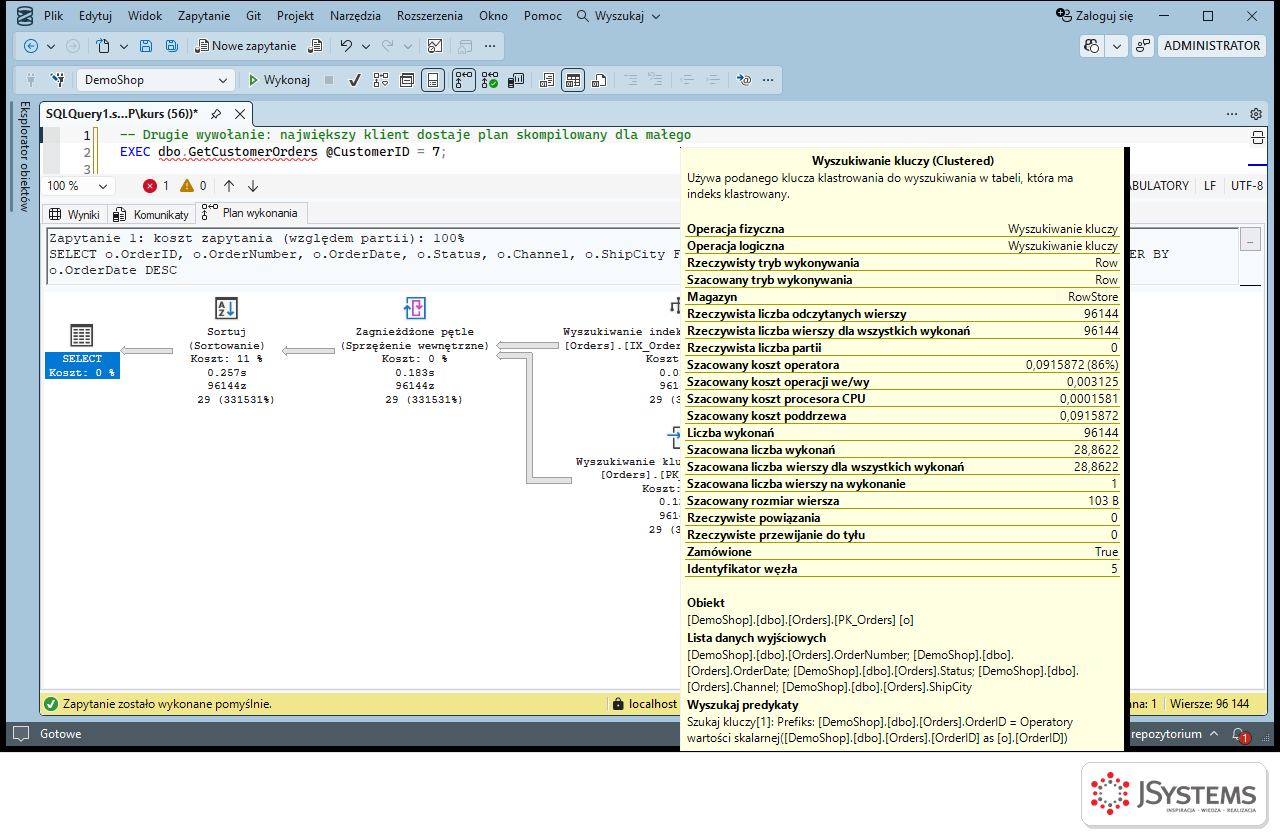
-- Ten sam plan, skrajnie różne koszty wykonań i wartość, dla której go skompilowano
SELECT ps.execution_count AS Wykonania,
       ps.min_logical_reads AS MinOdczyty, ps.max_logical_reads AS MaxOdczyty,
       ps.min_elapsed_time / 1000 AS MinMs, ps.max_elapsed_time / 1000 AS MaxMs,
       qp.query_plan.value('declare namespace p="http://schemas.microsoft.com/sqlserver/2004/07/showplan";
         (//p:ColumnReference[@Column="@CustomerID"]/@ParameterCompiledValue)[1]', 'nvarchar(20)')
         AS PlanSkompilowanyDla
FROM sys.dm_exec_procedure_stats AS ps
CROSS APPLY sys.dm_exec_query_plan(ps.plan_handle) AS qp
WHERE ps.object_id = OBJECT_ID('dbo.GetCustomerOrders');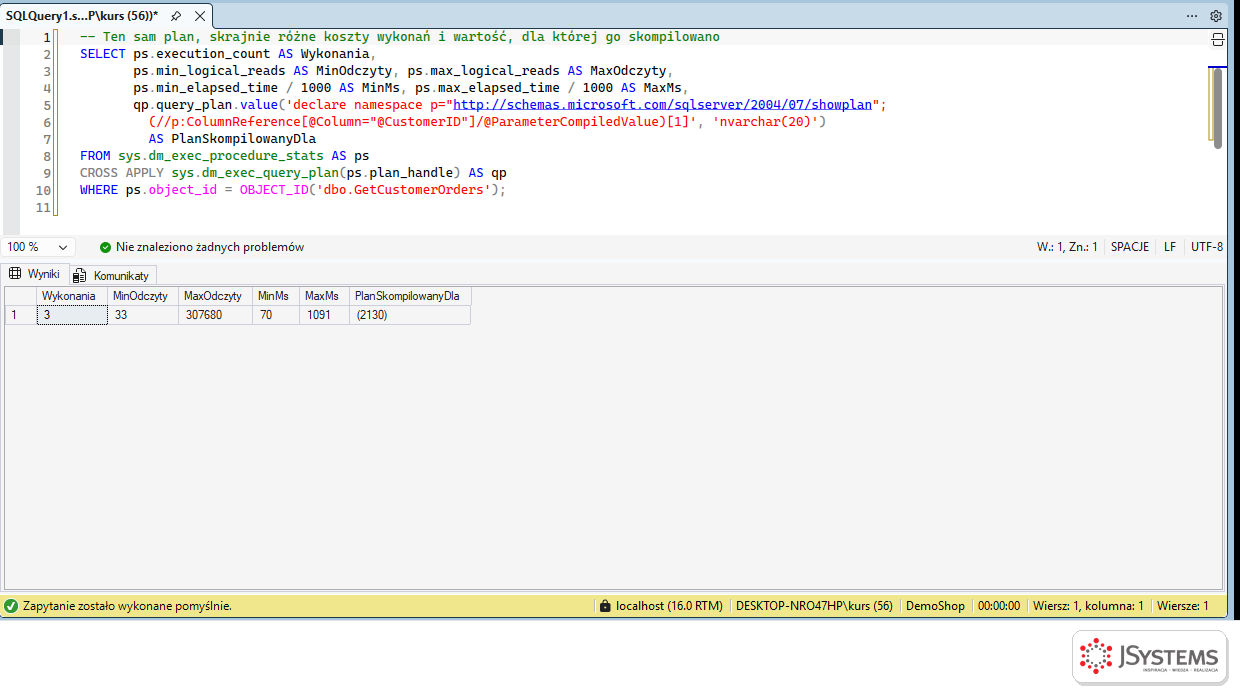
Procedura dbo.GetCustomerOrders (kod niżej) raz działa w milisekundy, a raz bardzo wolno. Załączam rzeczywisty plan wolnego wywołania (klient nr 7), statystyki procedury z sys.dm_exec_procedure_stats i rozkład liczby zamówień na klienta. Wyjaśnij, co się dzieje, i porównaj rozwiązania dostępne w SQL Server 2022 razem z ich wadami.
[kod procedury]
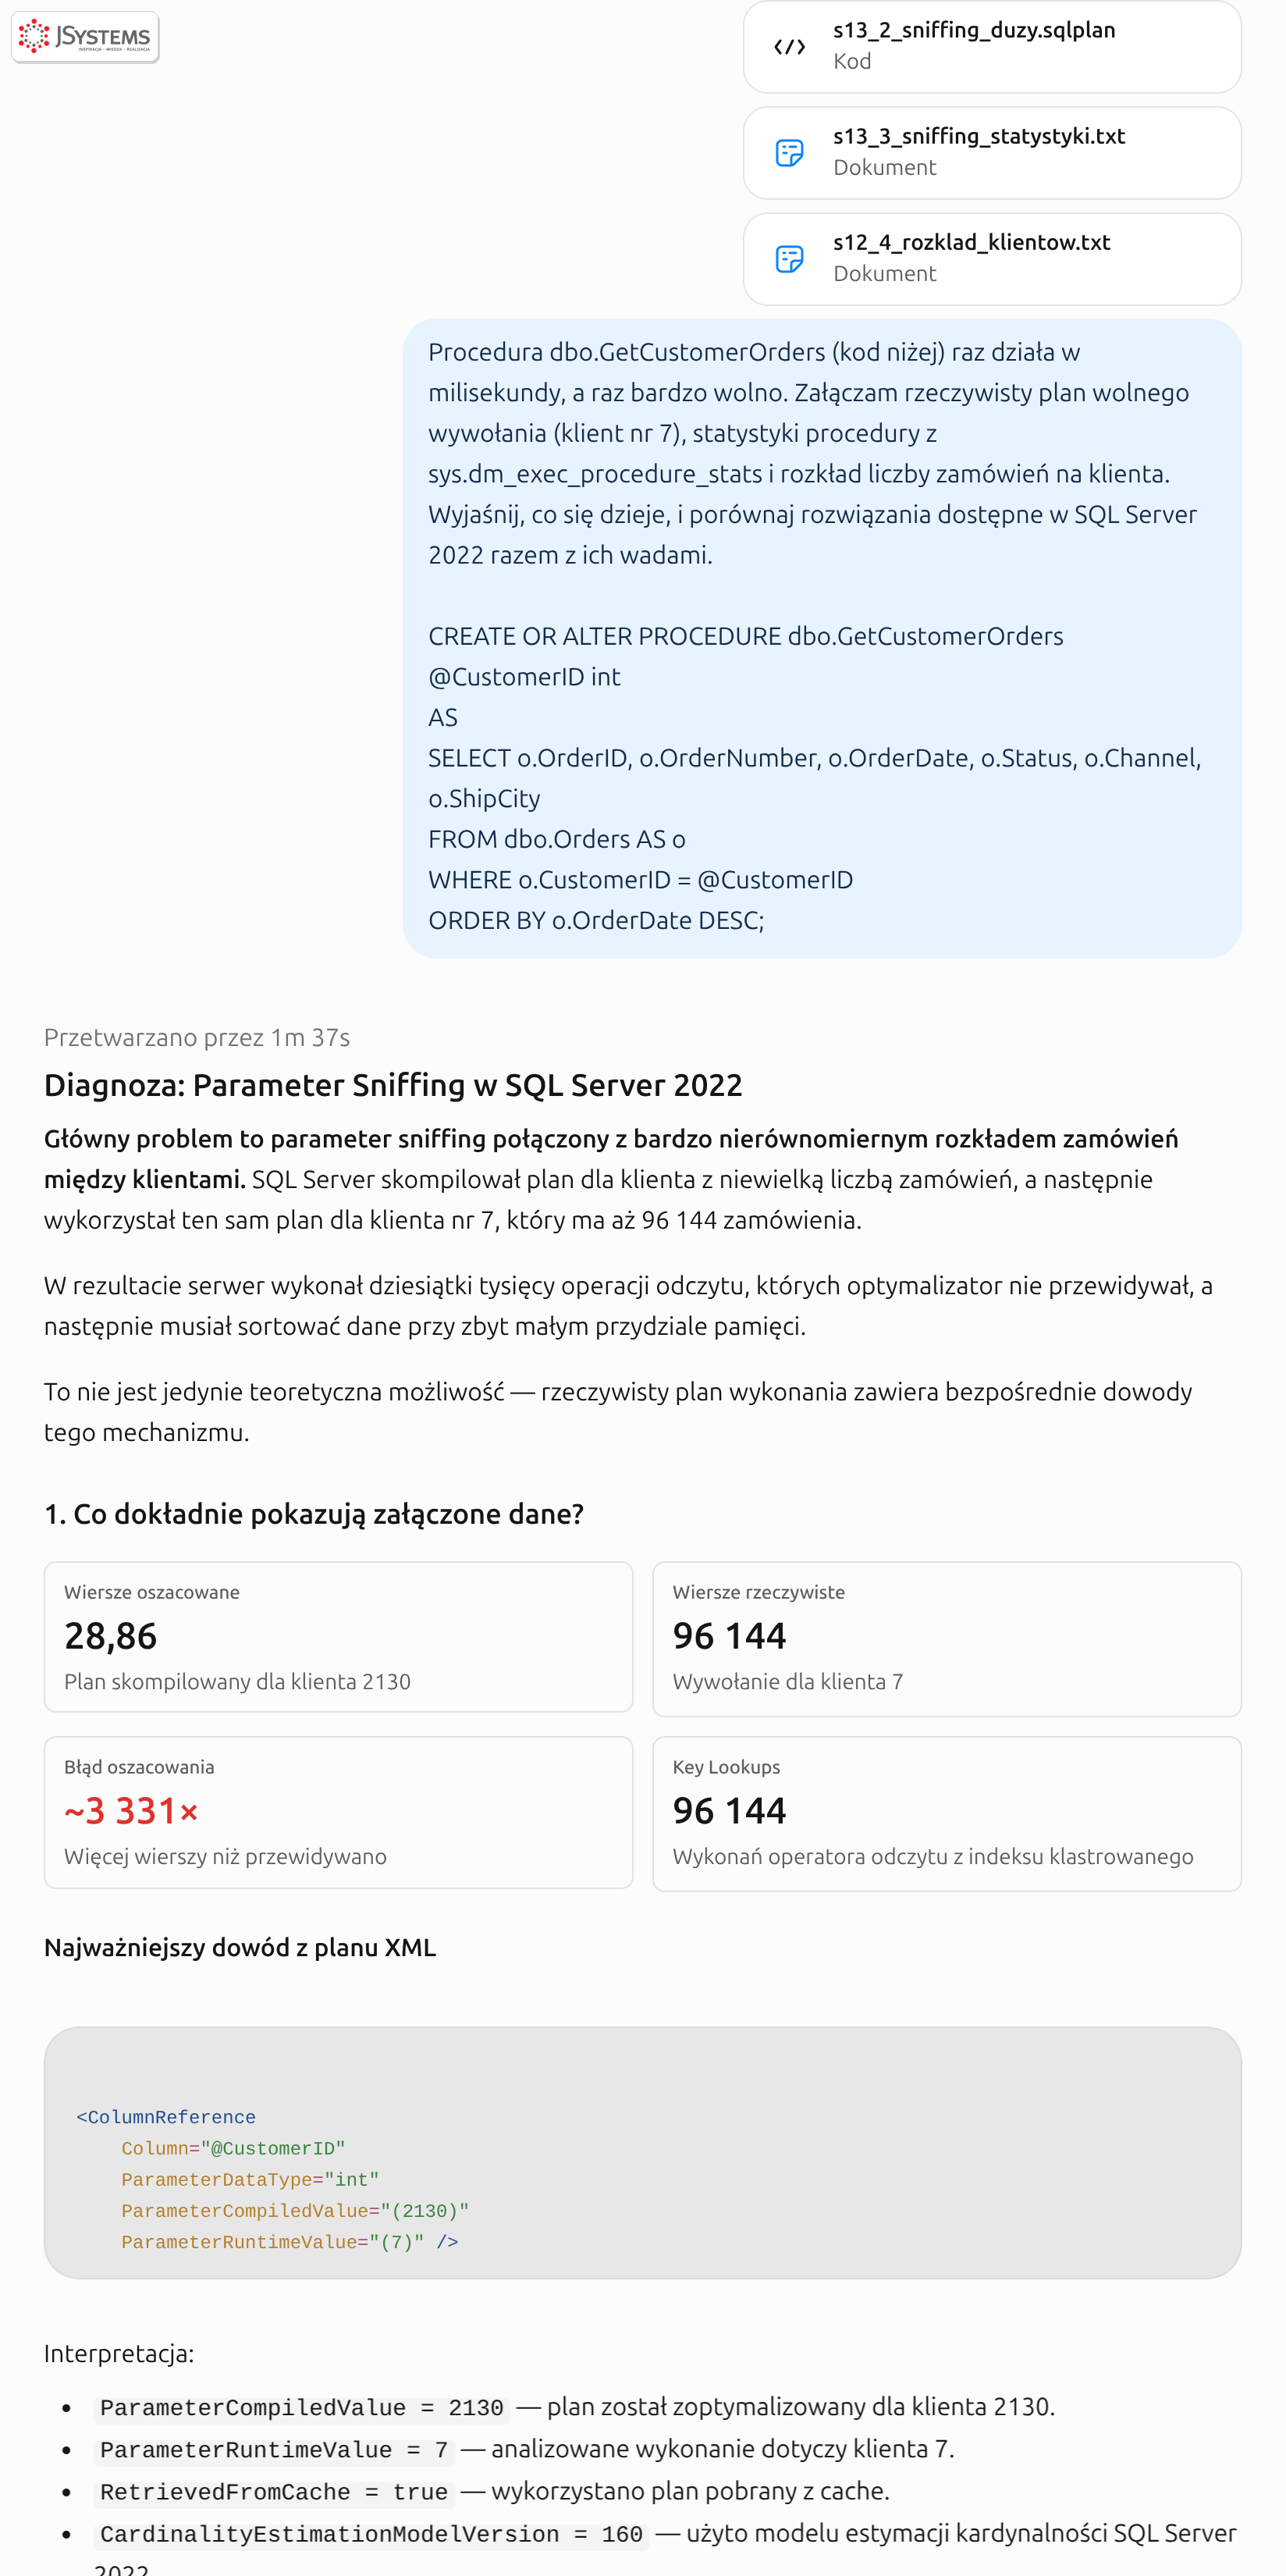
Z odpowiedzi warto zapamiętać dwie rzeczy. AI zauważyło w planie coś, czego nie widać w dymku: sortowanie dostało pamięć na kilkadziesiąt wierszy i wylało dane do tempdb (w pliku planu SpillLevel="2"). To przykład problemu „sortowanie na dysku”, który bierze się z błędnego szacunku, a nie z braku pamięci serwera. Druga rzecz to porównanie rozwiązań:
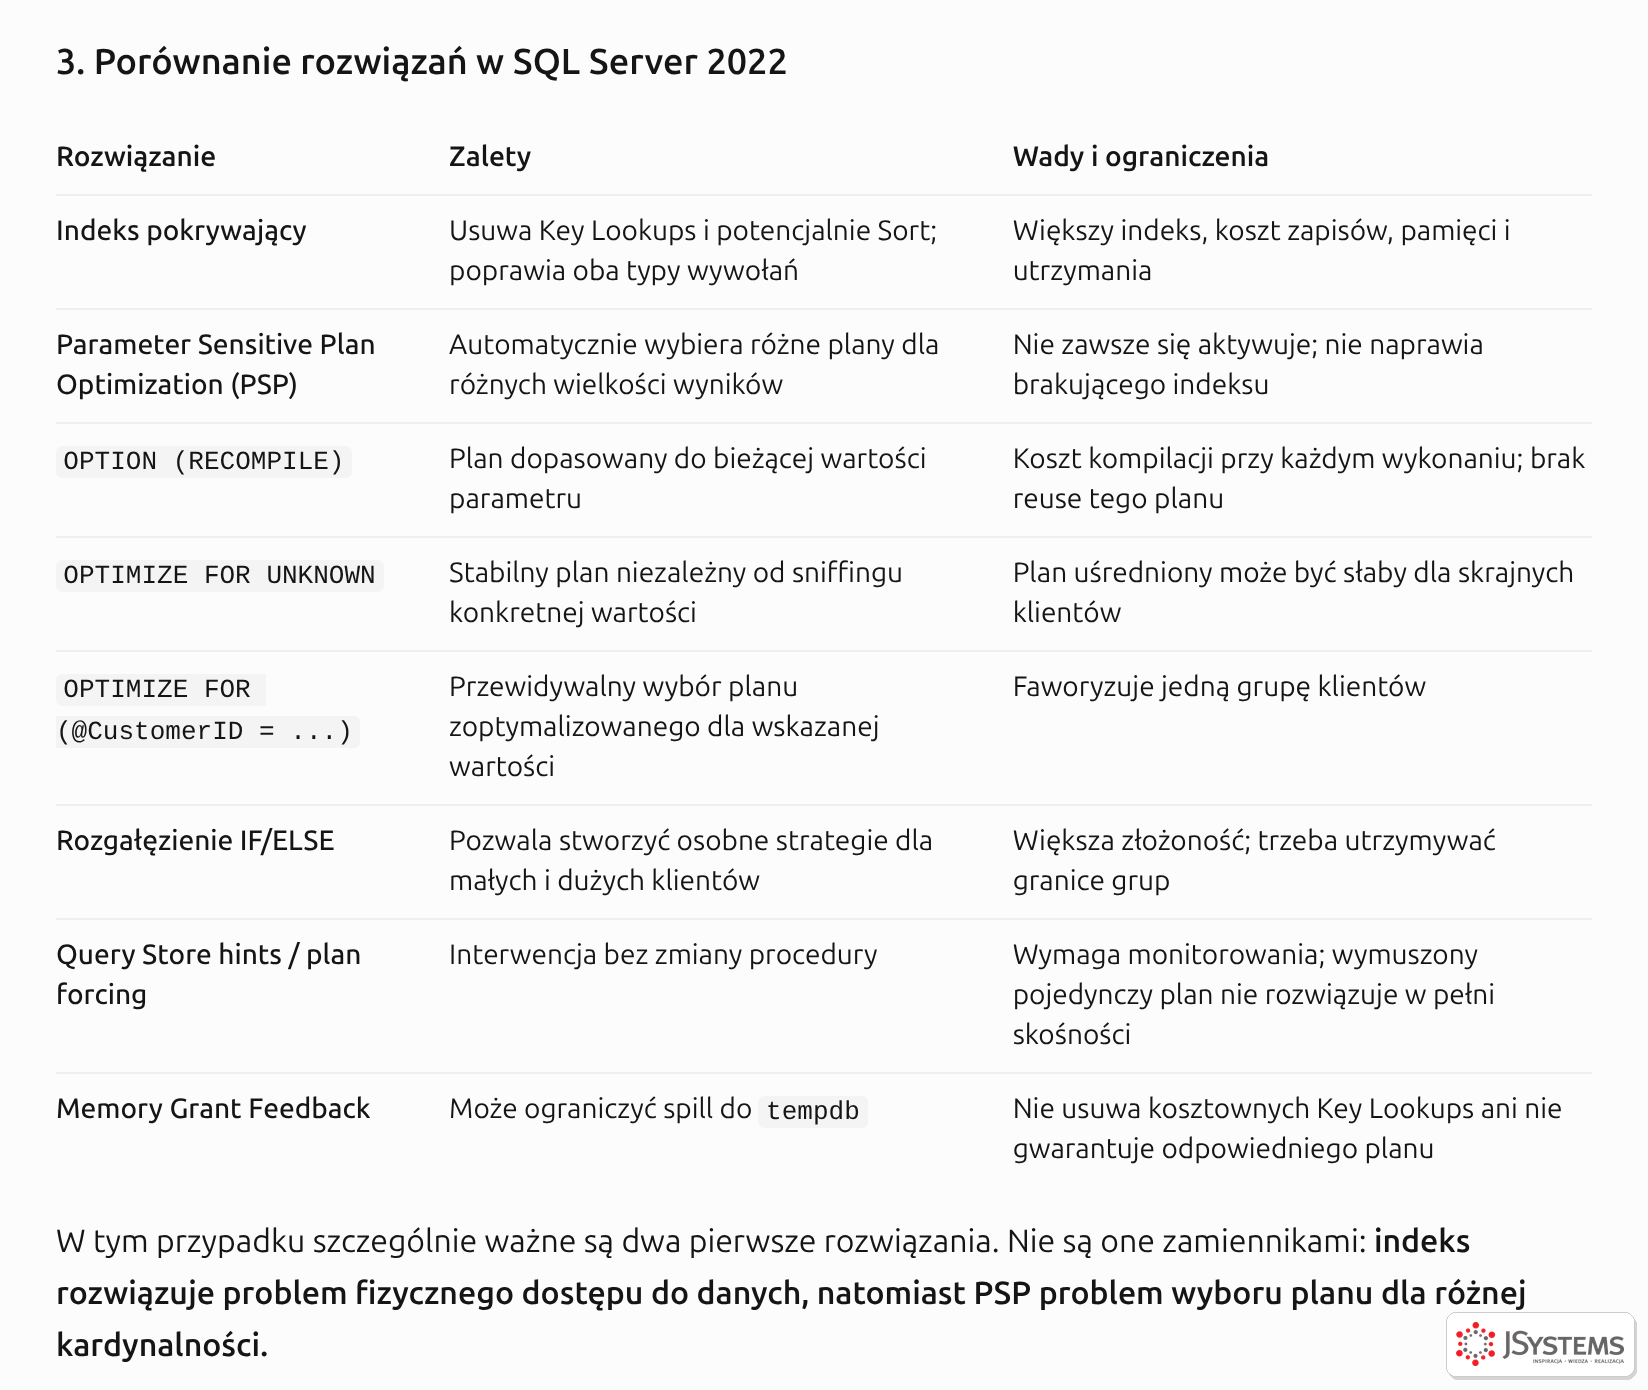
Zwróć uwagę na wiersz o PSP (Parameter Sensitive Plan Optimization): to mechanizm SQL Server 2022, który sam przechowuje kilka planów dla różnych wielkości wyników. AI uczciwie zaznaczyło, że nie zawsze się uruchamia. W naszym teście na poziomie zgodności 160 się nie uruchomił, co widać na zrzutach powyżej. Najtrwalszym rozwiązaniem w tym przypadku jest indeks pokrywający z sygnału 6, który usuwa doczytania dla wszystkich klientów naraz.
Ekran zamówienia „wisi”, choć zapytanie jest proste. Najczęstsza przyczyna: inna sesja zmieniła dane w transakcji, której nie zakończyła. Odtworzyliśmy to dwiema sesjami: pierwsza zmienia koszt wysyłki zamówienia i nie zatwierdza transakcji, druga próbuje to zamówienie odczytać. W SSMS pytamy widoki systemowe, kto kogo blokuje:
-- Kto kogo blokuje? Sesje czekające na blokadę i sesja, która ją trzyma
SELECT r.session_id AS Sesja, r.blocking_session_id AS BlokowanaPrzez,
       r.wait_type AS TypOczekiwania, r.wait_time / 1000 AS CzekaS,
       r.wait_resource AS Zasob, t.text AS Zapytanie
FROM sys.dm_exec_requests AS r
CROSS APPLY sys.dm_exec_sql_text(r.sql_handle) AS t
WHERE r.blocking_session_id <> 0;

SELECT s.session_id AS Sesja, s.status AS Stan, s.open_transaction_count AS OtwarteTransakcje,
       s.last_request_end_time AS KoniecOstatniegoPolecenia, t.text AS OstatniePolecenie
FROM sys.dm_exec_sessions AS s
JOIN sys.dm_exec_connections AS c ON c.session_id = s.session_id
CROSS APPLY sys.dm_exec_sql_text(c.most_recent_sql_handle) AS t
WHERE s.session_id IN (SELECT blocking_session_id FROM sys.dm_exec_requests WHERE blocking_session_id <> 0);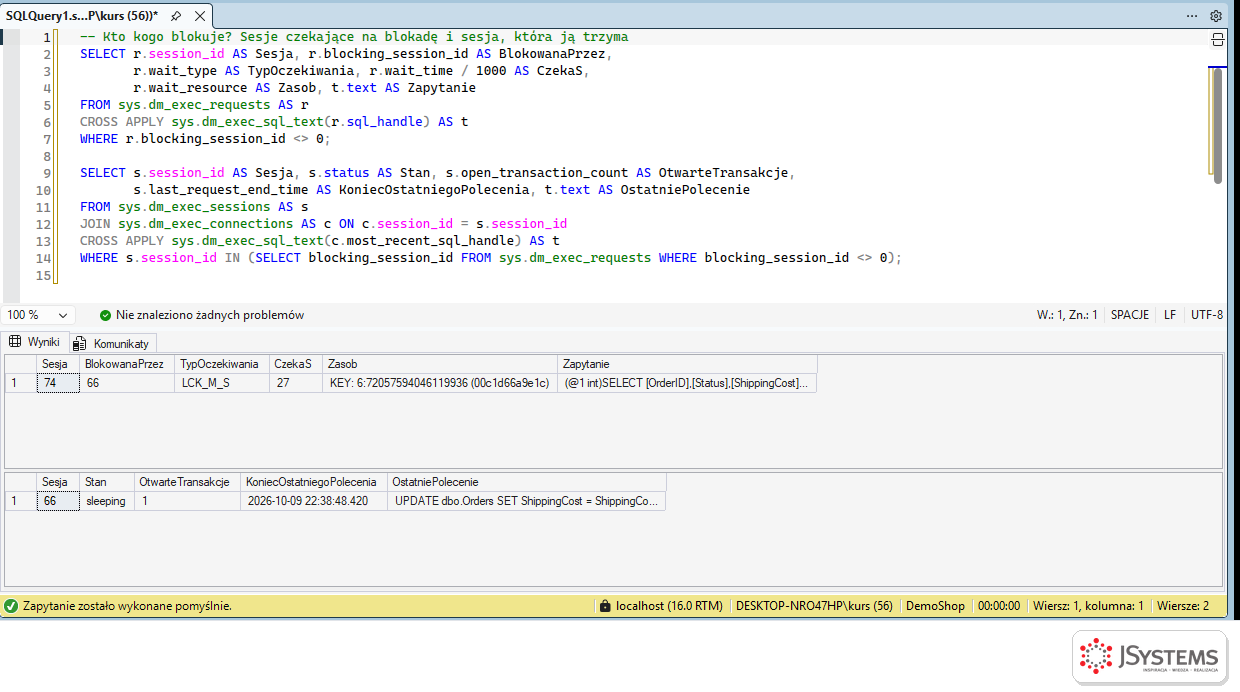
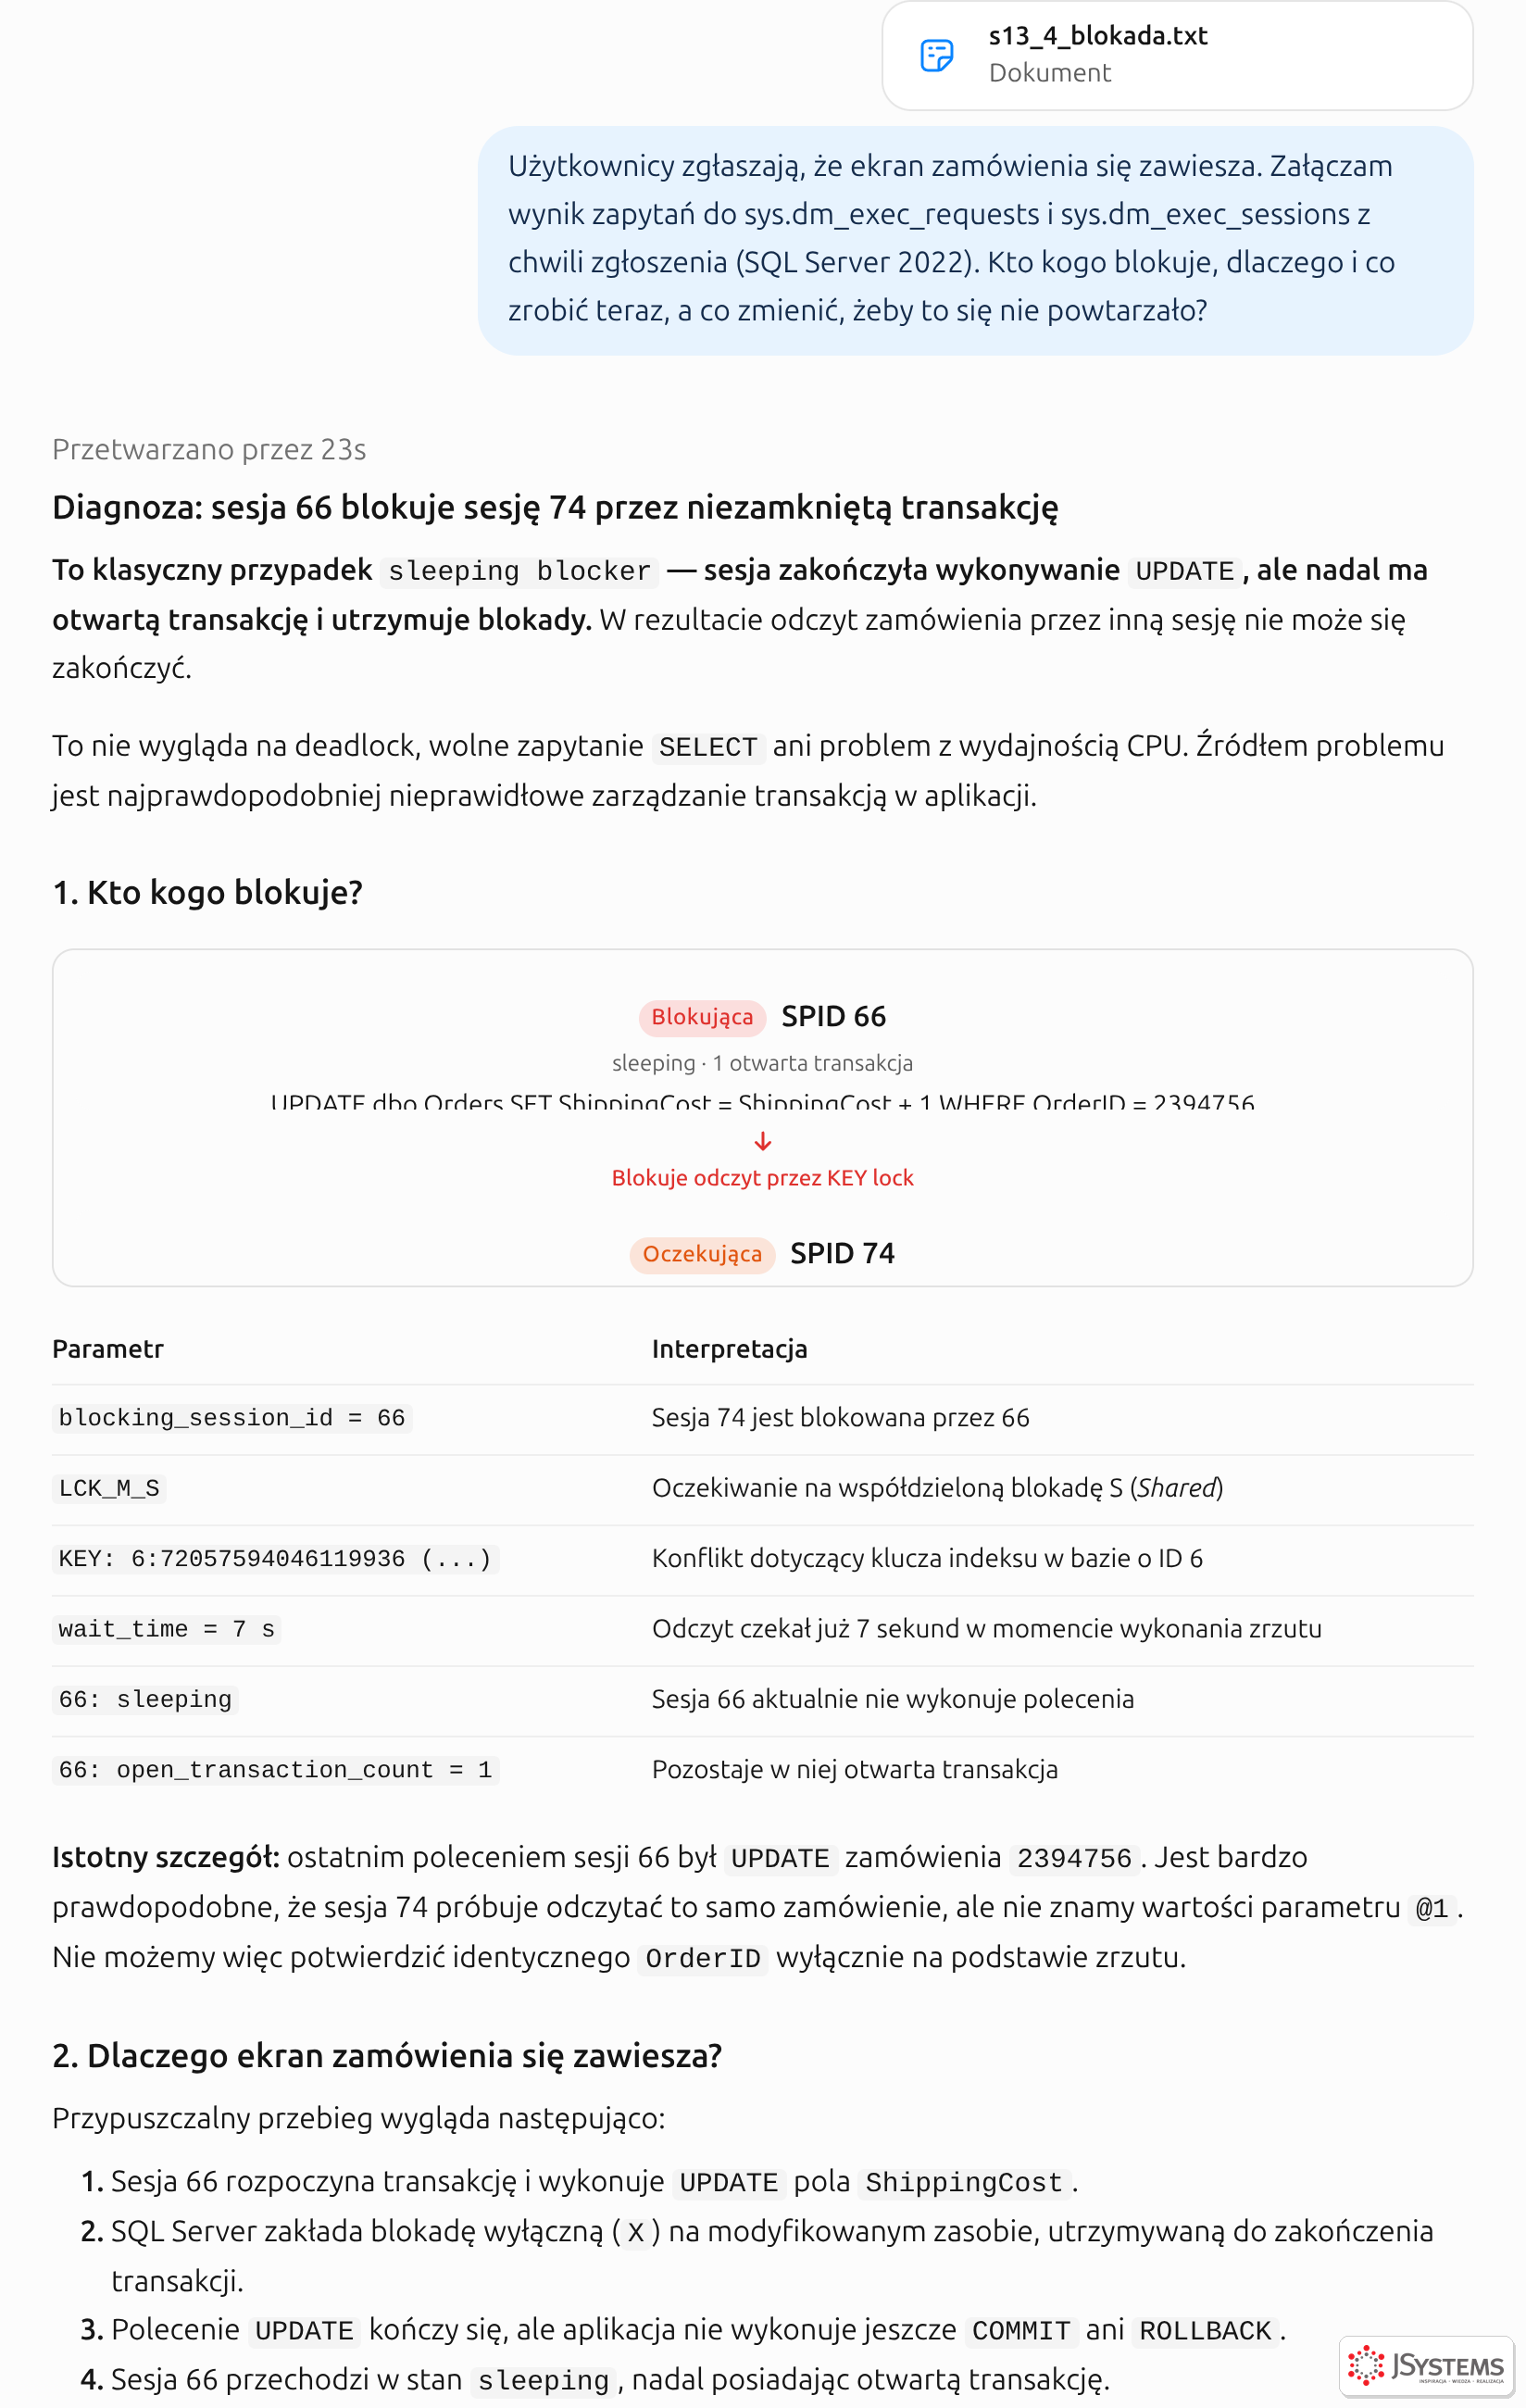
AI odradza zabijanie sesji na ślepo: zrzut jest historyczny, więc przed KILL trzeba sprawdzić, czy ten numer sesji nadal należy do tego samego połączenia, i ustalić, która aplikacja zostawiła otwartą transakcję. Na przyszłość proponuje porządek w obsłudze transakcji w aplikacji (zatwierdzanie albo wycofywanie w każdej ścieżce kodu, także po błędzie, oraz SET XACT_ABORT ON) i rozważenie izolacji migawkowej (READ_COMMITTED_SNAPSHOT), przy której odczyt nie czeka na zapis. To samo zagadnienie w PostgreSQL opisujemy w artykule Zapytanie wisi zablokowane - jak znaleźć blokującą sesję.
Jedna ciekawostka z przygotowania tego przykładu: pierwsza wersja testu zmieniała koszt wysyłki na tę samą wartość (ShippingCost = ShippingCost + 0) i blokada się nie pojawiła. SQL Server pozwala odczytowi ominąć blokadę wiersza, gdy strona nie zawiera niezatwierdzonych zmian. Dopiero prawdziwa zmiana wartości dała blokadę, którą widać na zrzucie.
Zakleszczenie (deadlock) to sytuacja, w której dwie sesje czekają na siebie nawzajem. SQL Server wykrywa je sam, wybiera jedną z sesji jako ofiarę, wycofuje jej transakcję i zwraca błąd 1205. Raport z każdego zakleszczenia zapisuje sesja zdarzeń system_health, włączona domyślnie:
-- Ostatnie zakleszczenie zapisane przez sesję zdarzeń system_health
SELECT TOP (1)
       CAST(event_data AS xml).value('(event/@timestamp)[1]', 'datetime2(0)') AS CzasUTC,
       CAST(event_data AS xml).query('(event/data/value/deadlock)[1]') AS RaportZakleszczenia
FROM sys.fn_xe_file_target_read_file('system_health*.xel', NULL, NULL, NULL)
WHERE object_name = 'xml_deadlock_report'
ORDER BY CzasUTC DESC;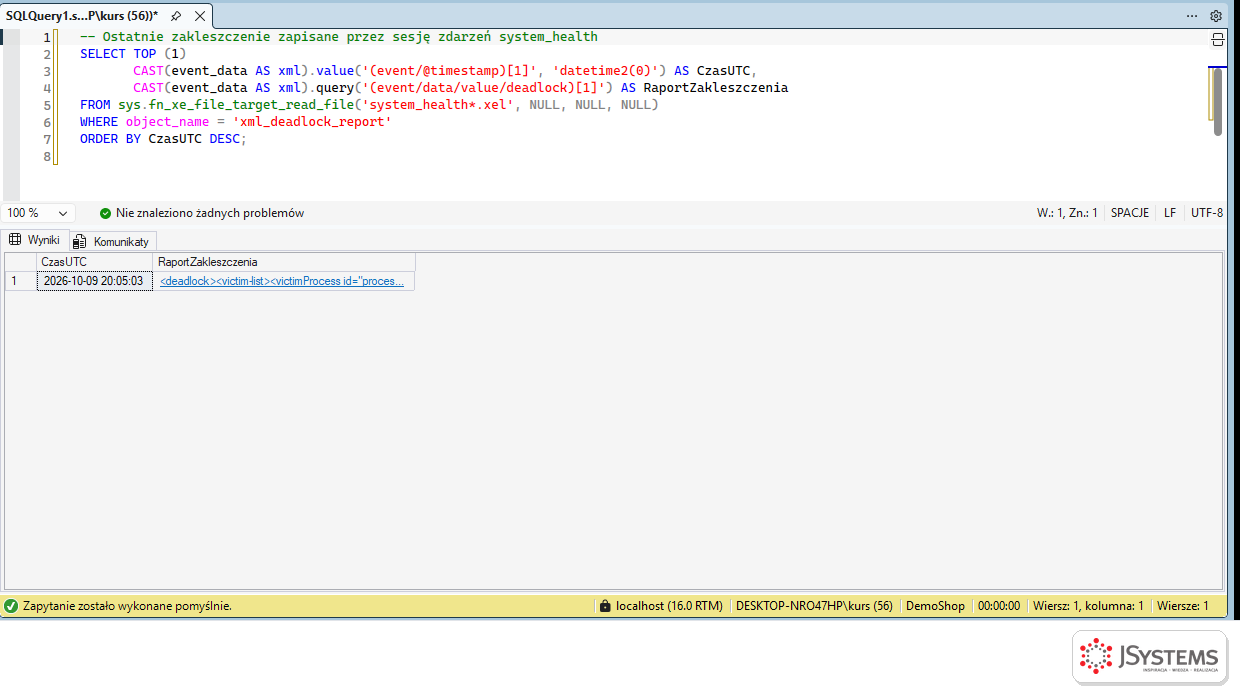
Raport XML przekazujemy AI bez zmian. Zakleszczenie wywołały dwie sesje, które zmieniały te same dwa zamówienia w odwrotnej kolejności:
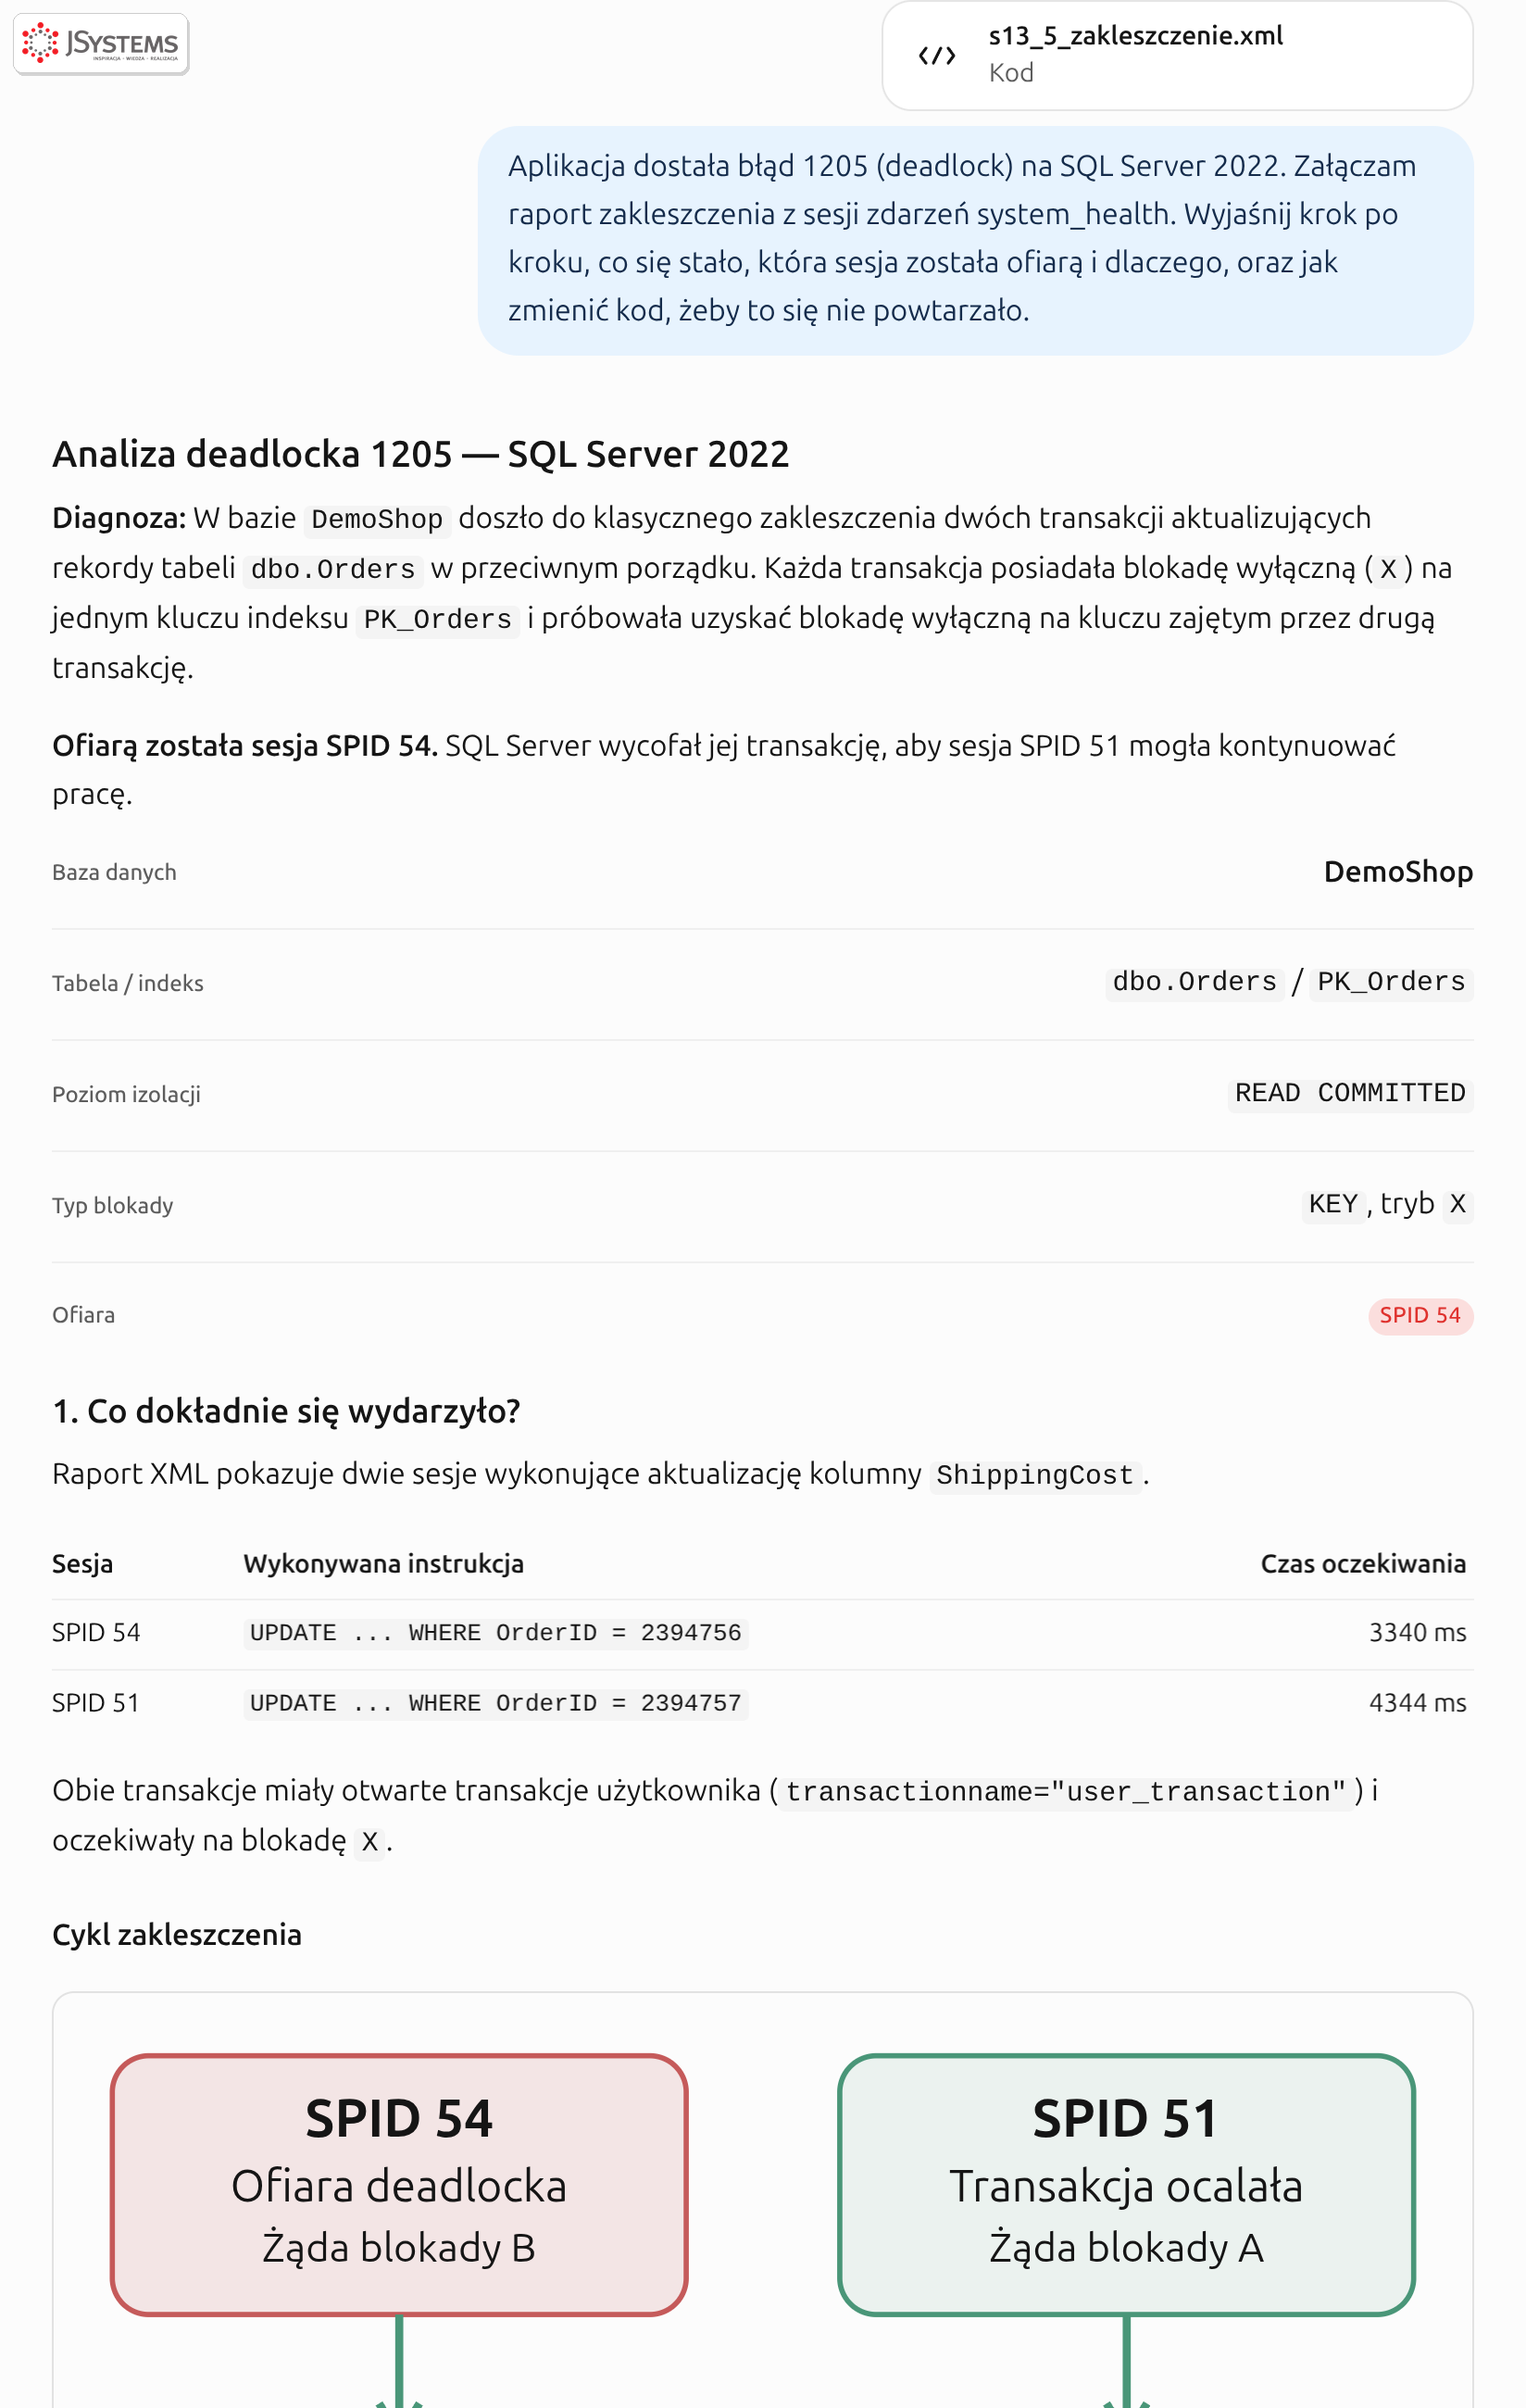
Zalecenie AI jest standardowe i słuszne: spójna kolejność aktualizacji (na przykład zawsze rosnąco po OrderID), krótkie transakcje i ponawianie całej operacji po błędzie 1205. AI dodało też uczciwie, że to usunie ten konkretny wzorzec, ale nie wszystkie możliwe zakleszczenia.
Transakcja, która trwa długo, trzyma blokady i nie pozwala zwolnić części dziennika transakcji. Pokazaliśmy to na sesji, która zmieniła 50 tysięcy pozycji zamówień i nie zakończyła transakcji:
-- Otwarte transakcje użytkowników: jak długo trwają i ile dziennika zajmują
SELECT s.session_id AS Sesja, s.program_name AS Program, at.transaction_begin_time AS Poczatek,
       DATEDIFF(SECOND, at.transaction_begin_time, SYSDATETIME()) AS TrwaS,
       dt.database_transaction_log_record_count AS RekordyDziennika,
       dt.database_transaction_log_bytes_used / 1024 AS DziennikKB,
       s.status AS StanSesji
FROM sys.dm_tran_active_transactions AS at
JOIN sys.dm_tran_session_transactions AS st ON st.transaction_id = at.transaction_id
JOIN sys.dm_tran_database_transactions AS dt
     ON dt.transaction_id = at.transaction_id AND dt.database_id = DB_ID()
JOIN sys.dm_exec_sessions AS s ON s.session_id = st.session_id
WHERE st.is_user_transaction = 1
ORDER BY at.transaction_begin_time;

SELECT name AS Baza, log_reuse_wait_desc AS DlaczegoDziennikNieMozeByc_Uzyty FROM sys.databases WHERE name = 'DemoShop';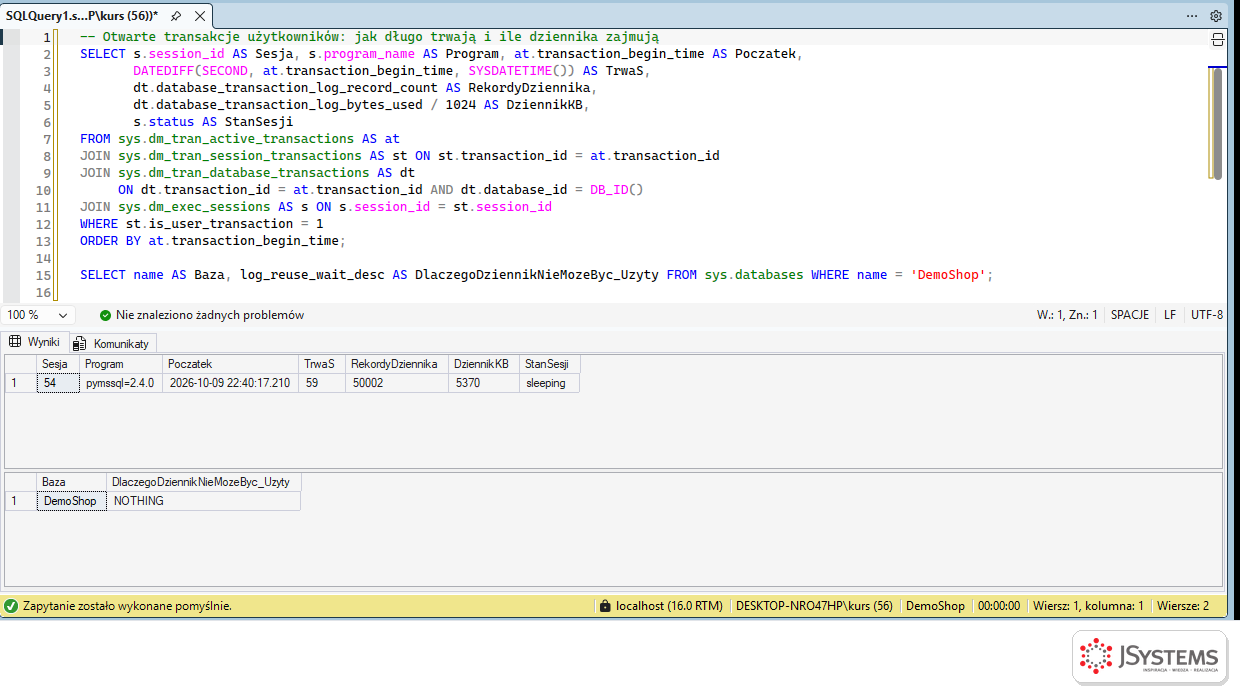
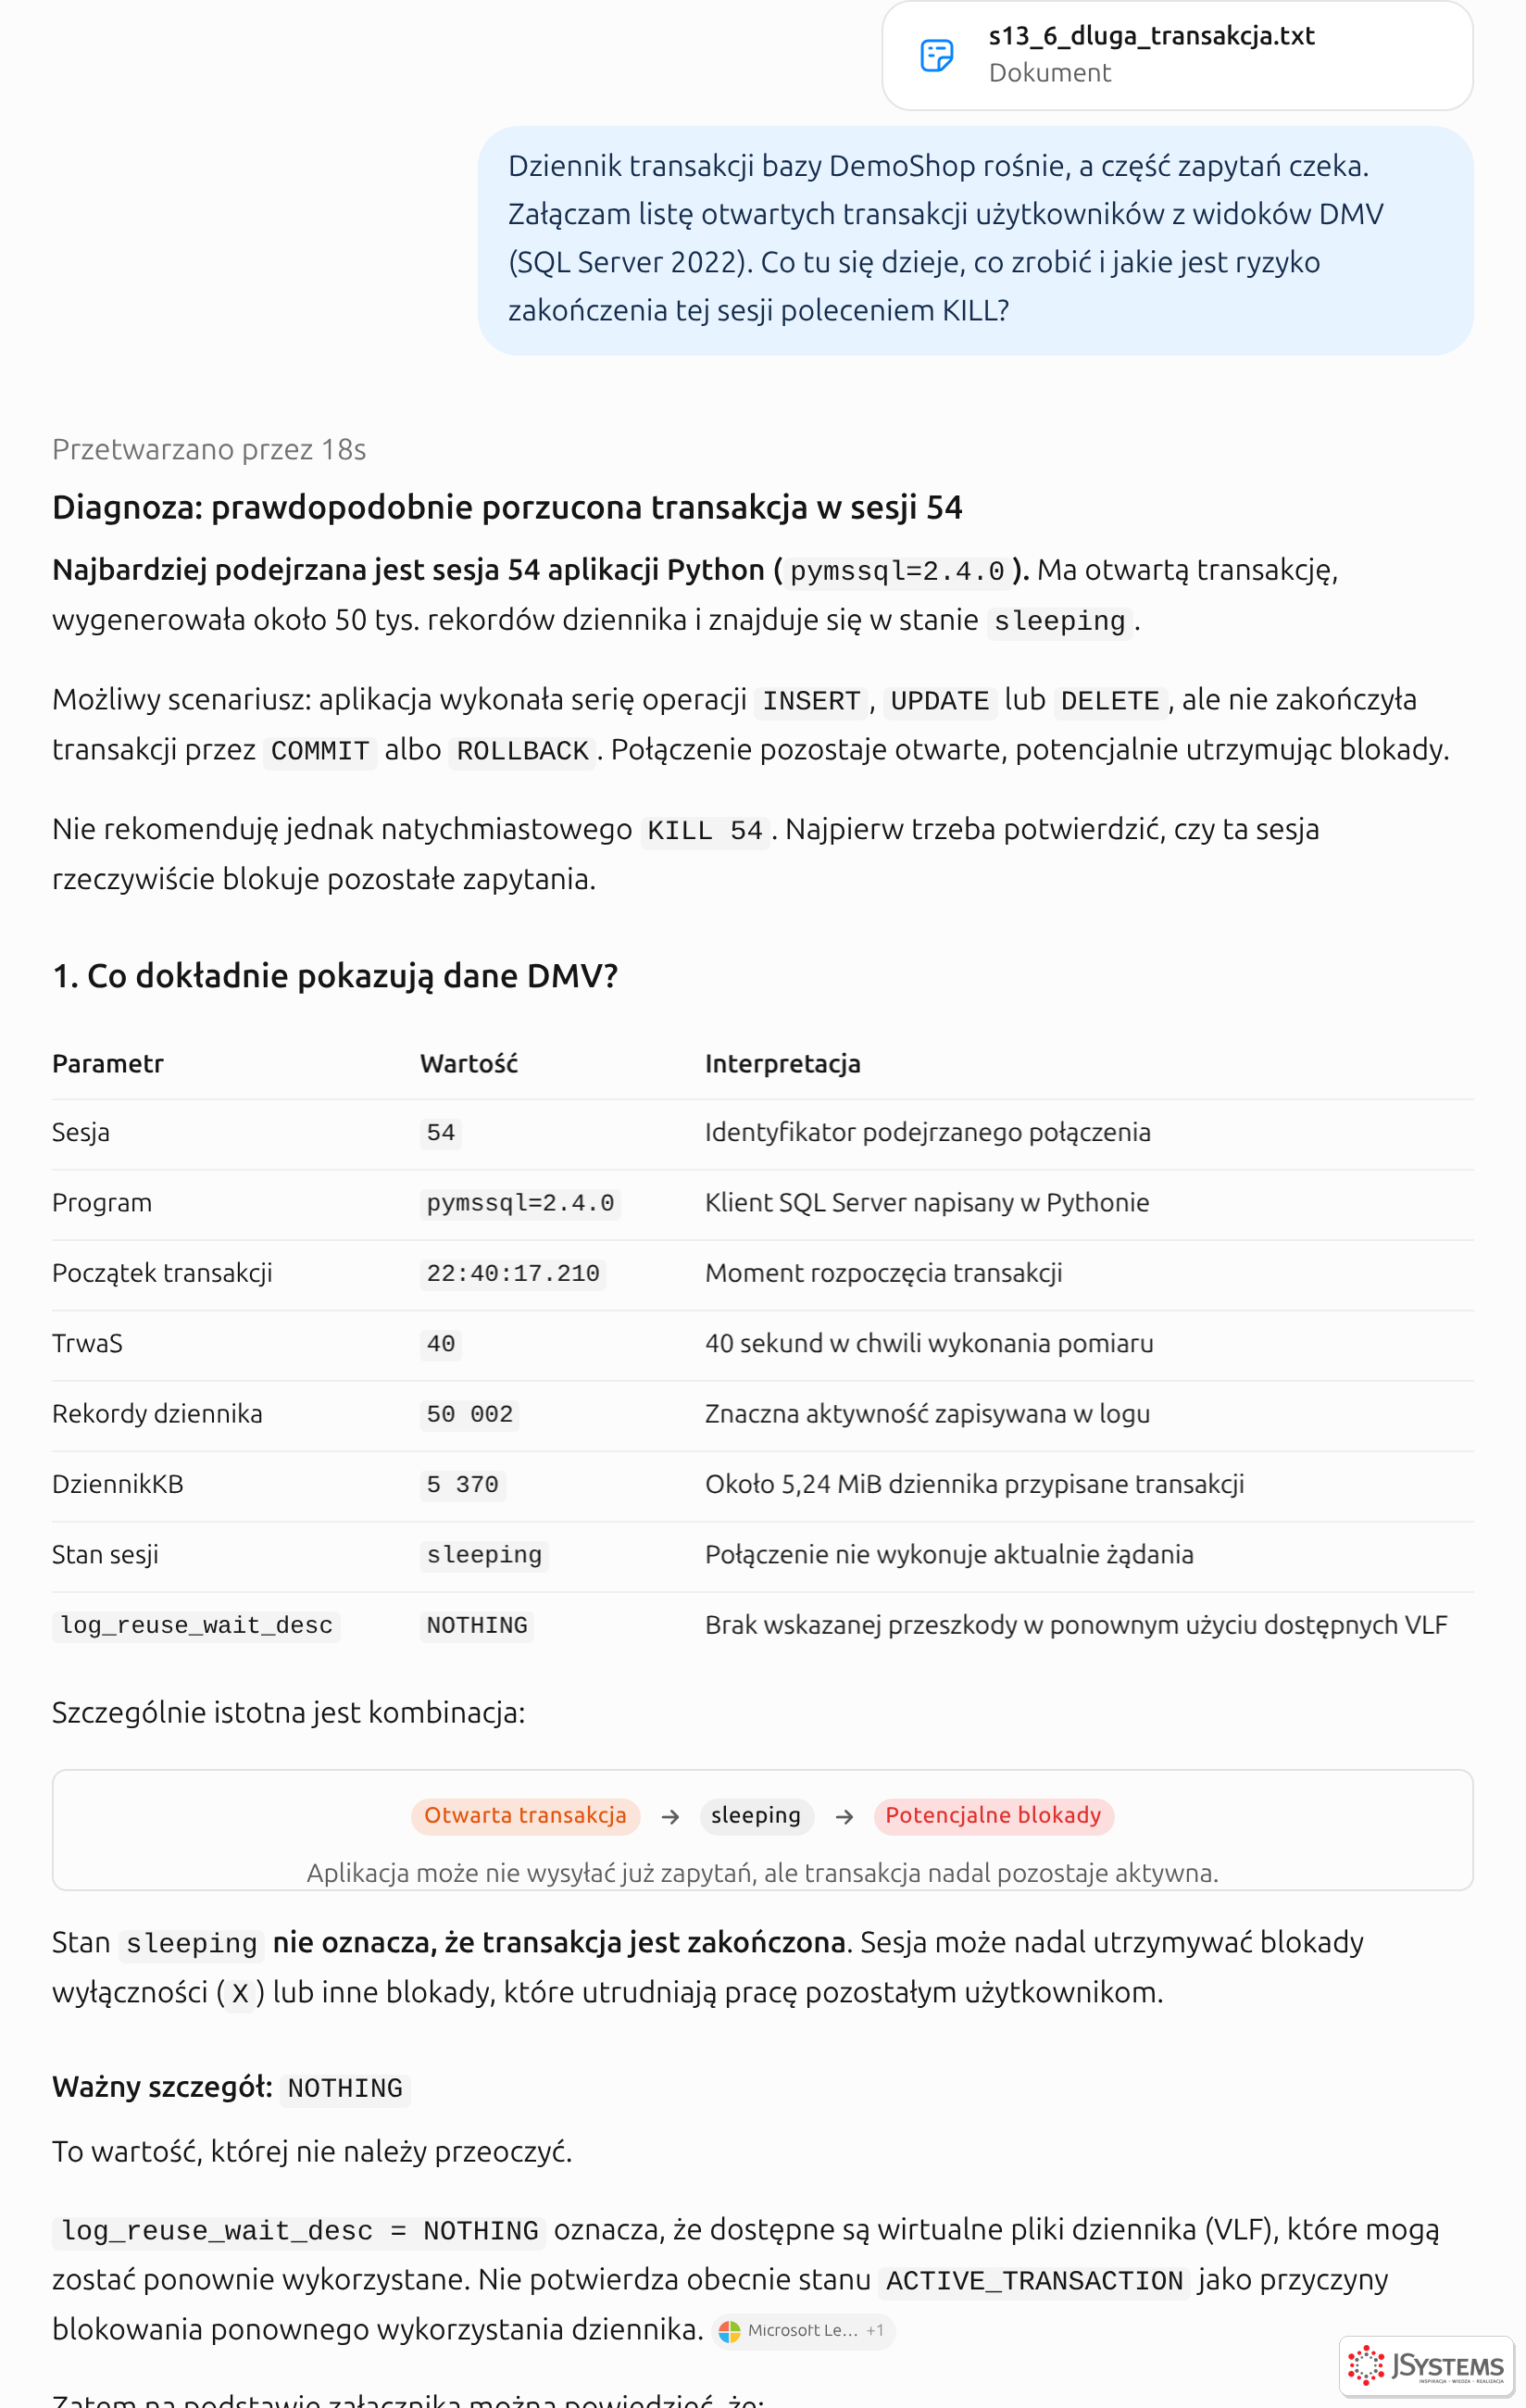
Ta odpowiedź zawiera korektę naszego polecenia. Napisaliśmy w nim, że dziennik transakcji rośnie, a AI zauważyło, że w danych tego nie widać: stan log_reuse_wait_desc = NOTHING nie wskazuje, żeby ta transakcja blokowała ponowne użycie dziennika. Baza ma model odtwarzania SIMPLE i przy tej wielkości transakcji dziennik nie musiał rosnąć. Takie sprostowanie jest cenniejsze od odpowiedzi, która bezkrytycznie przyjmuje założenie z pytania. AI przypomniało też, że KILL nie kończy transakcji natychmiast, tylko ją wycofuje, co przy dużych zmianach potrafi trwać dłużej niż sama zmiana, a postęp widać w KILL ... WITH STATUSONLY.
Tabela z kluczem IDENTITY dopisuje każdy nowy wiersz na koniec indeksu. Gdy robi to jednocześnie wiele sesji, wszystkie walczą o tę samą stronę pamięci. W SSMS widać to jako oczekiwania PAGELATCH_EX i PAGELATCH_SH (krótkie blokady strony w pamięci na czas zapisu i odczytu) na jednej stronie:
-- 32 sesje dopisują wiersze do tabeli z kluczem IDENTITY: na co czekają?
SELECT wt.wait_type AS TypOczekiwania,
       LEFT(wt.resource_description, CHARINDEX(' ', wt.resource_description + ' ') - 1) AS Strona,
       COUNT(*) AS CzekajaceSesje, MAX(wt.wait_duration_ms) AS MaxCzekanieMs
FROM sys.dm_os_waiting_tasks AS wt
JOIN sys.dm_exec_sessions AS s ON s.session_id = wt.session_id
WHERE s.is_user_process = 1
GROUP BY wt.wait_type, LEFT(wt.resource_description, CHARINDEX(' ', wt.resource_description + ' ') - 1)
ORDER BY CzekajaceSesje DESC;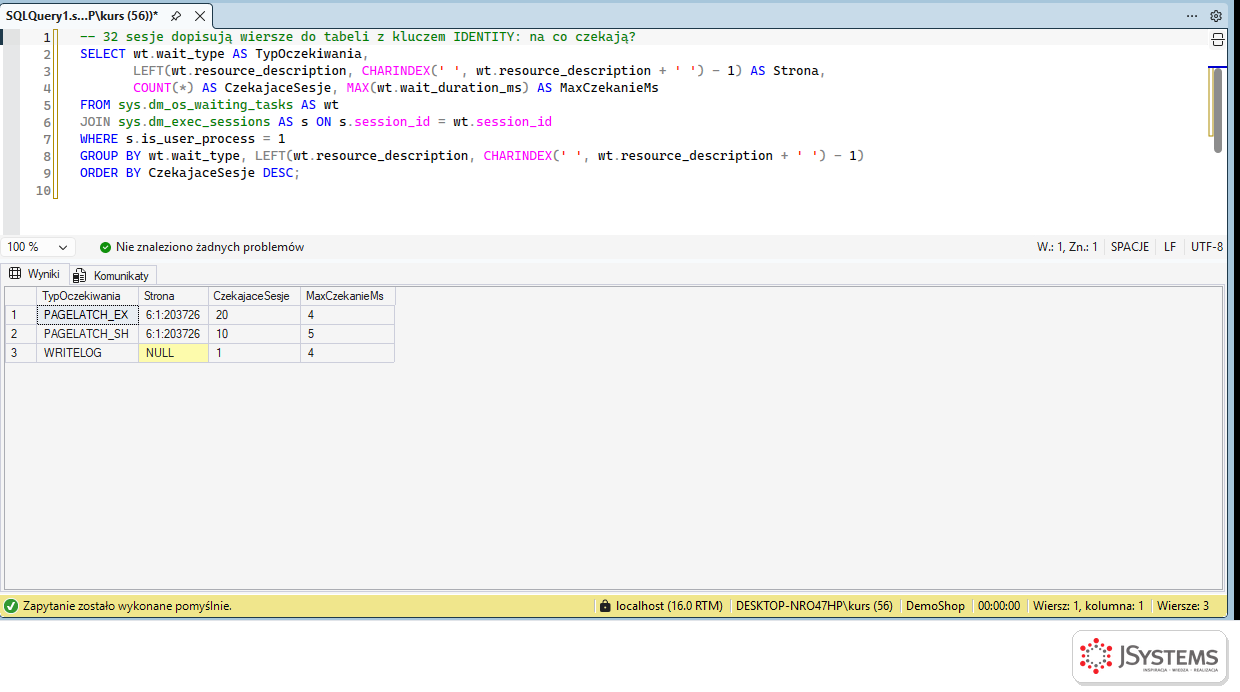
SQL Server 2019 i nowsze mają na ten problem opcję indeksu OPTIMIZE_FOR_SEQUENTIAL_KEY. Zmierzyliśmy ją: 32 sesje dopisywały wiersze przez 30 sekund, po 20 wierszy w transakcji, trzy przebiegi z opcją i trzy bez niej:
| Przebieg | OPTIMIZE_FOR_SEQUENTIAL_KEY | Wiersze w 30 s | Wierszy na sekundę | Oczekiwania PAGELATCH_EX |
|---|---|---|---|---|
| 1 | OFF | 298 340 | 9 945 | 305 178 |
| 2 | ON | 410 560 | 13 685 | 121 492 |
| 3 | OFF | 273 840 | 9 128 | 263 758 |
| 4 | ON | 417 300 | 13 910 | 116 822 |
| 5 | OFF | 320 120 | 10 671 | 280 476 |
| 6 | ON | 407 600 | 13 587 | 104 893 |
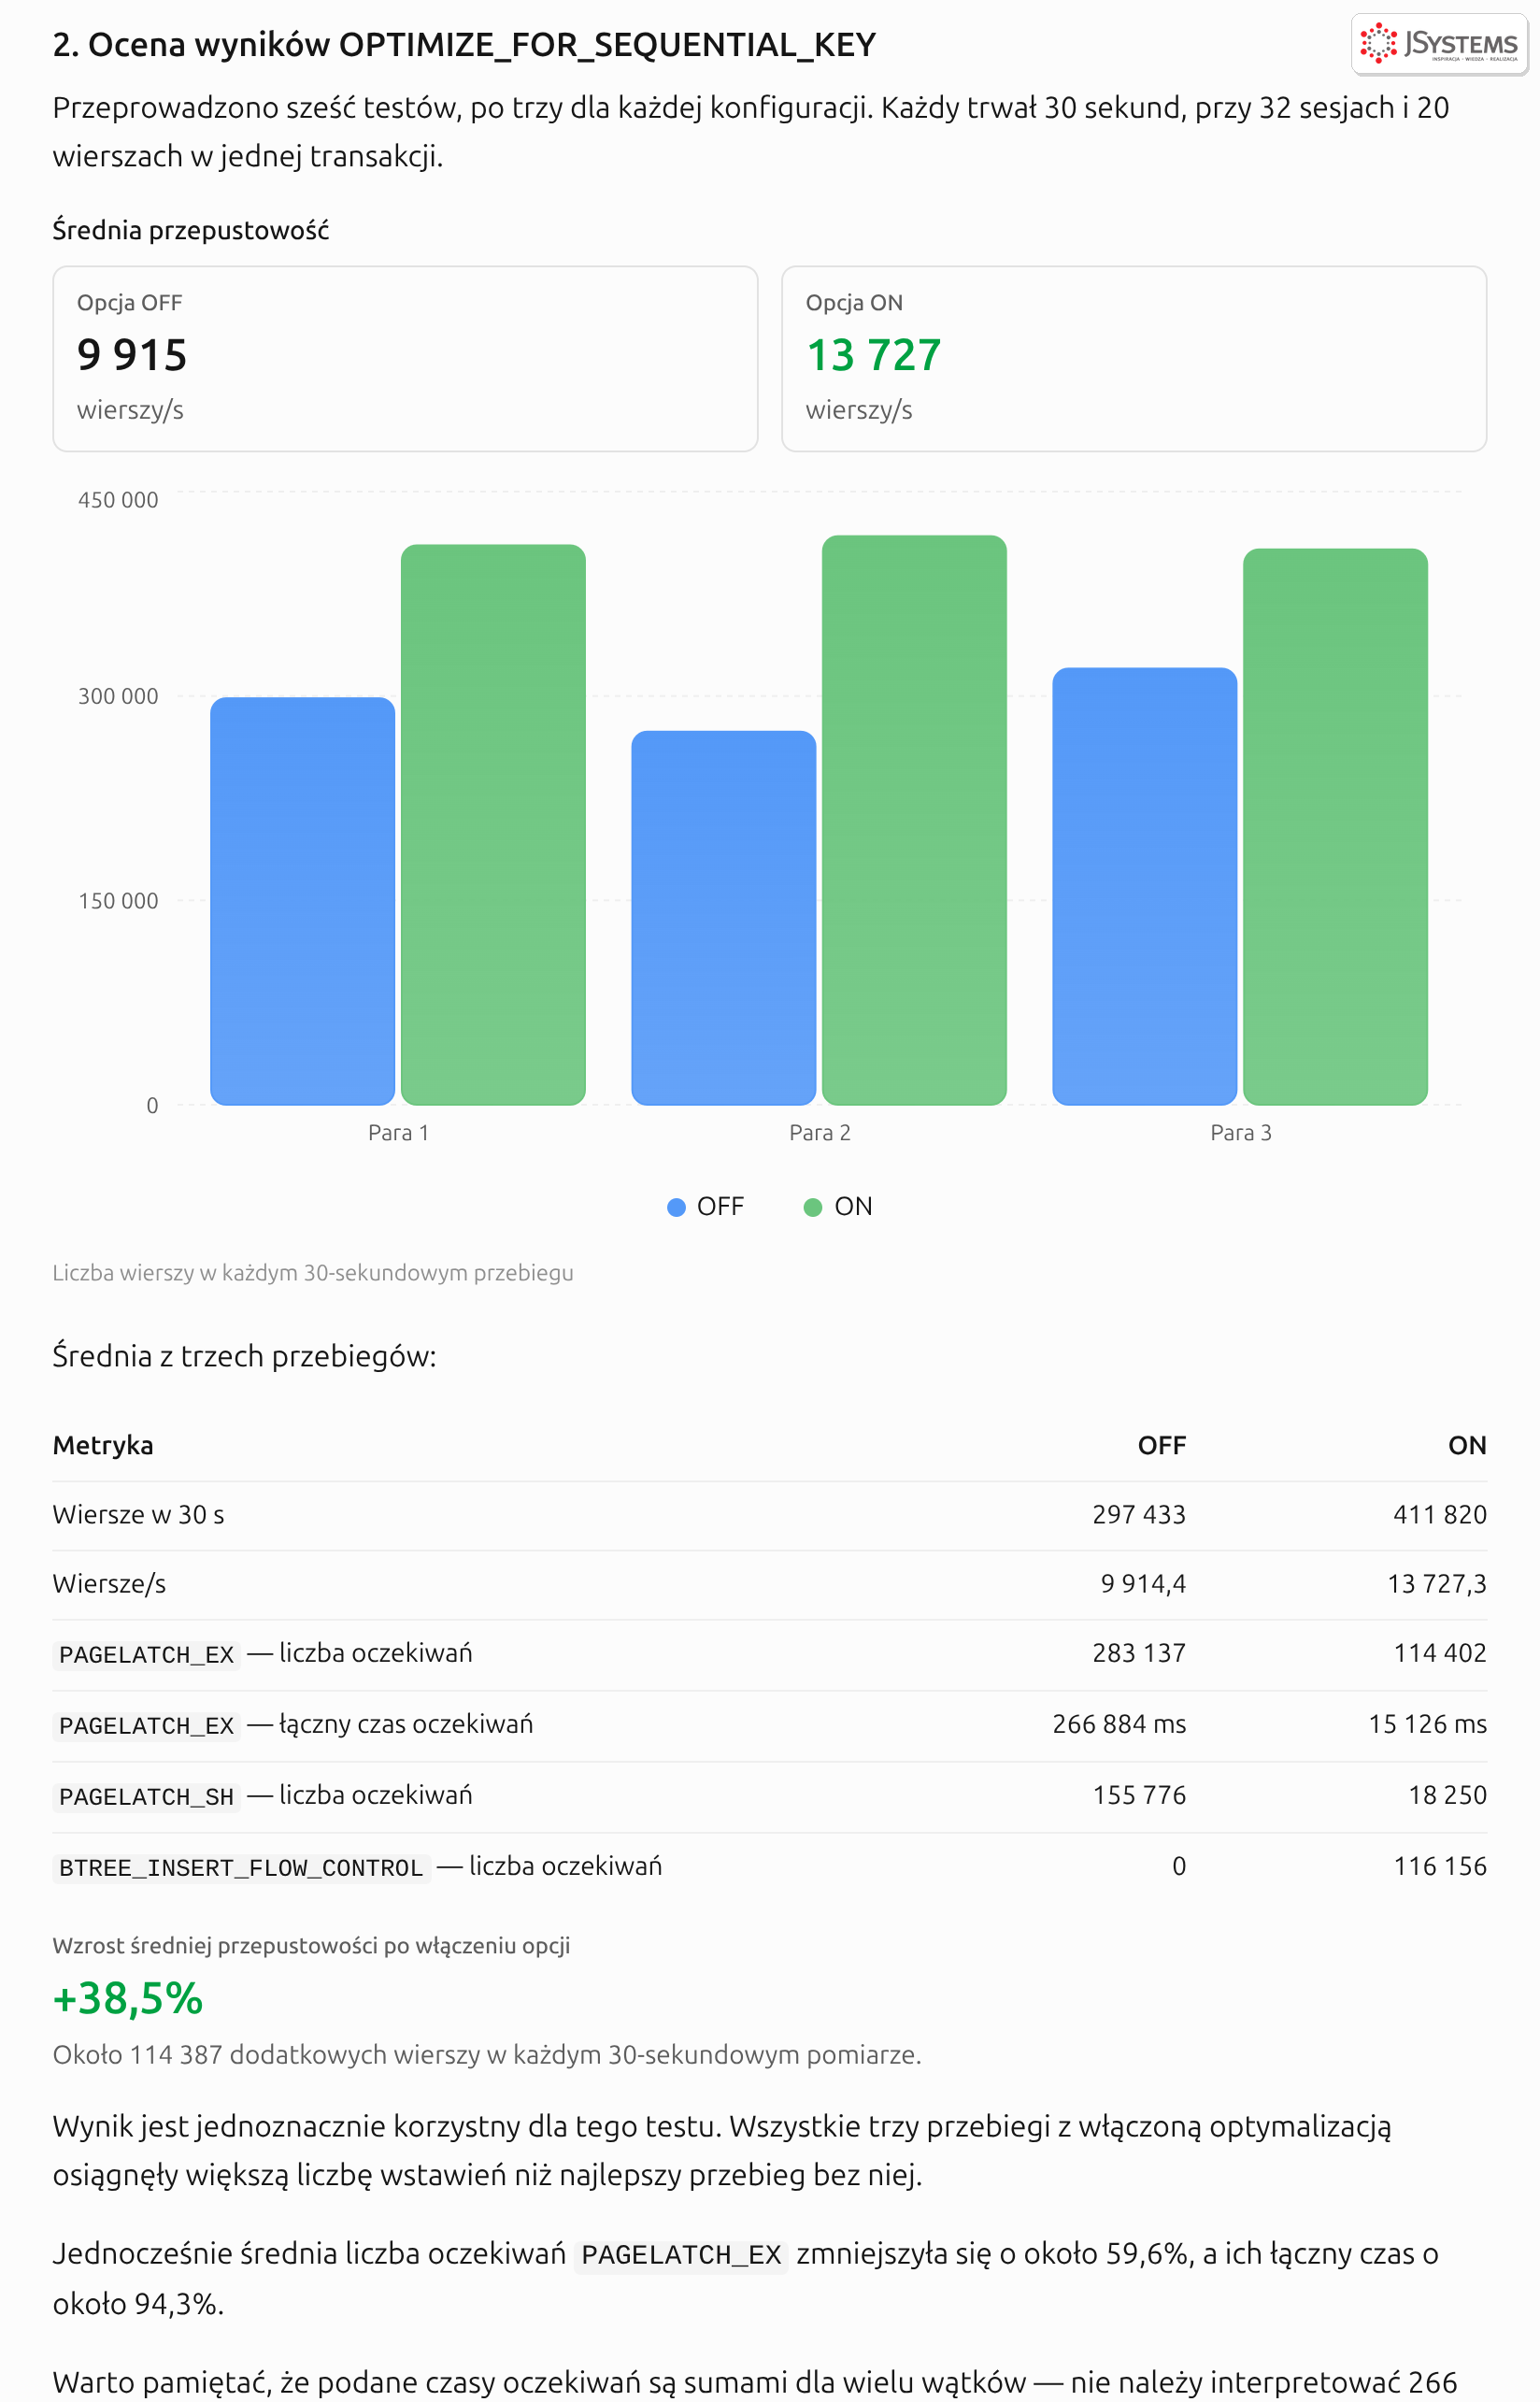
Na początku odpowiedzi ChatGPT rozpoznał w danych rywalizację o ostatnią stronę indeksu (last page insert contention). Wszystkie jego wyliczenia przeliczyliśmy: średnio 9 914 i 13 727 wierszy na sekundę, czyli o 38,5% więcej, a łączny czas oczekiwań PAGELATCH_EX spadł o 94,3%. AI poprawnie zinterpretowało też nowy typ oczekiwania BTREE_INSERT_FLOW_CONTROL, który pojawia się po włączeniu opcji: to znak, że mechanizm działa, a nie że coś się zepsuło. Dodało też ważną uwagę o czytaniu takich liczb: czas oczekiwań to suma po wszystkich wątkach, a nie czas zegarowy testu.
Te trzy problemy diagnozuje się razem, bo zwykle się przenikają. Za mało pamięci oznacza więcej odczytów z dysku, a wolny dysk wydłuża każde wylanie sortowania do tempdb. Zebraliśmy trzy zestawy danych: liczniki pamięci SQL Server, opóźnienia odczytu i zapisu plików bazy i tempdb oraz konfigurację serwera i bazy:
-- Pamięć serwera: ile SQL Server ma, ile chce, czy zapytania czekają na przydział
SELECT RTRIM(counter_name) AS Licznik, cntr_value AS Wartosc
FROM sys.dm_os_performance_counters
WHERE (object_name LIKE '%Buffer Manager%' AND counter_name = 'Page life expectancy')
   OR (object_name LIKE '%Memory Manager%' AND counter_name IN
       ('Total Server Memory (KB)', 'Target Server Memory (KB)', 'Memory Grants Pending', 'Memory Grants Outstanding'));

SELECT total_physical_memory_kb / 1024 AS PamiecSystemuMB, available_physical_memory_kb / 1024 AS WolnaMB,
       system_memory_state_desc AS StanPamieci FROM sys.dm_os_sys_memory;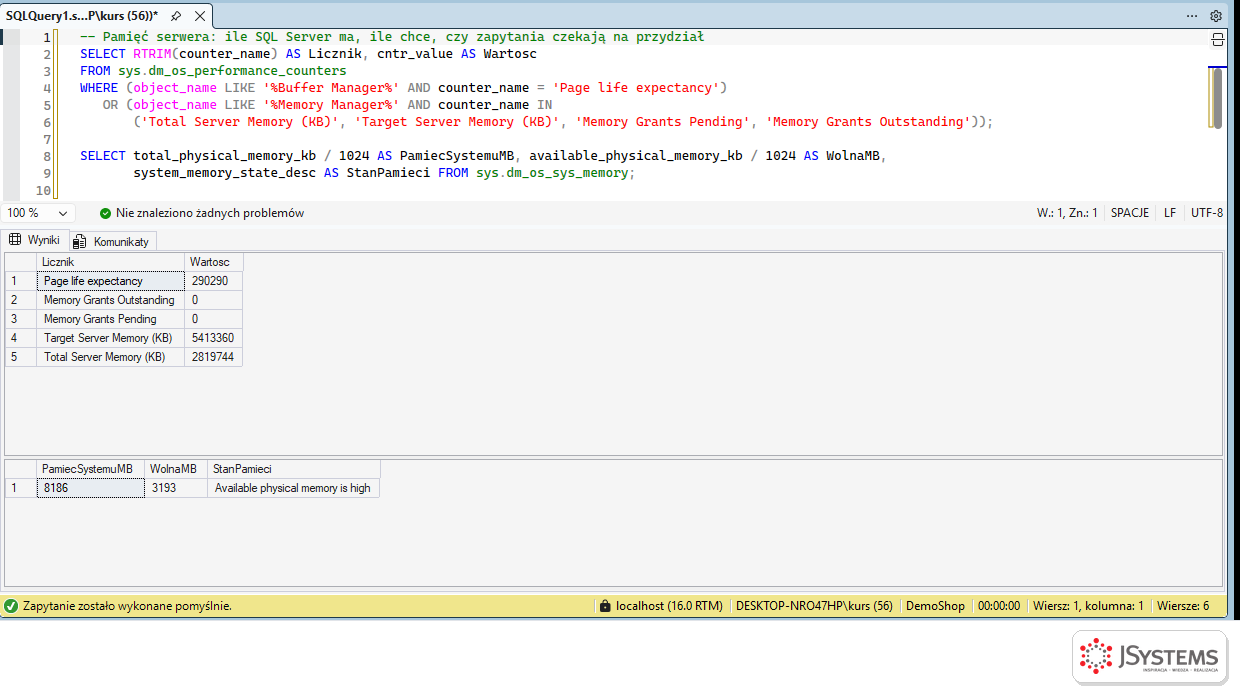
-- Opóźnienia odczytu i zapisu dla plików bazy i tempdb od startu serwera
SELECT DB_NAME(vfs.database_id) AS Baza, mf.name AS Plik, mf.type_desc AS Typ,
       vfs.num_of_reads AS Odczyty,
       CAST(1.0 * vfs.io_stall_read_ms / NULLIF(vfs.num_of_reads, 0) AS decimal(10, 1)) AS SrOdczytMs,
       vfs.num_of_writes AS Zapisy,
       CAST(1.0 * vfs.io_stall_write_ms / NULLIF(vfs.num_of_writes, 0) AS decimal(10, 1)) AS SrZapisMs
FROM sys.dm_io_virtual_file_stats(NULL, NULL) AS vfs
JOIN sys.master_files AS mf ON mf.database_id = vfs.database_id AND mf.file_id = vfs.file_id
WHERE vfs.database_id IN (DB_ID('DemoShop'), DB_ID('tempdb'))
ORDER BY SrOdczytMs DESC;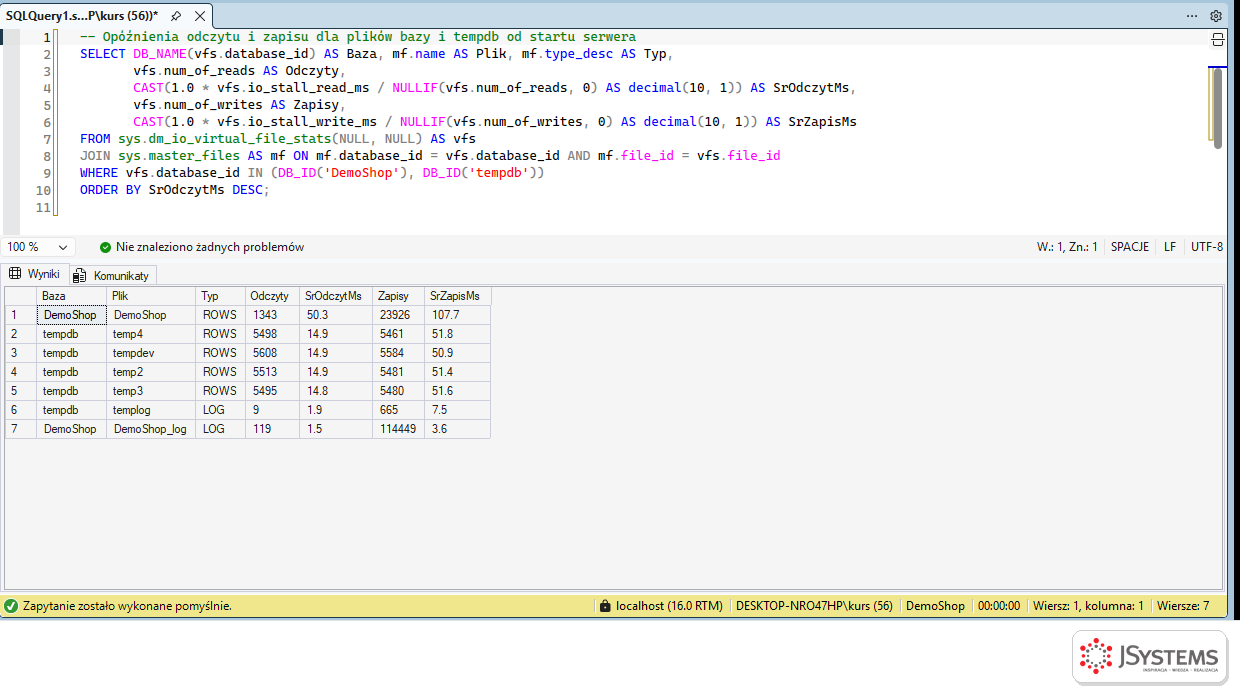
-- Konfiguracja serwera i bazy, którą warto pokazać AI
SELECT name AS Ustawienie, CAST(value_in_use AS int) AS Wartosc
FROM sys.configurations
WHERE name IN ('max server memory (MB)', 'min server memory (MB)', 'cost threshold for parallelism',
               'max degree of parallelism', 'optimize for ad hoc workloads', 'backup compression default');

SELECT name AS Baza, recovery_model_desc AS Odtwarzanie, compatibility_level AS Zgodnosc,
       is_read_committed_snapshot_on AS RCSI, is_auto_update_stats_async_on AS StatystykiAsync
FROM sys.databases WHERE name = 'DemoShop';

SELECT name AS Plik, physical_name AS Sciezka, size / 128 AS RozmiarMB, growth / 128 AS PrzyrostMB
FROM sys.database_files;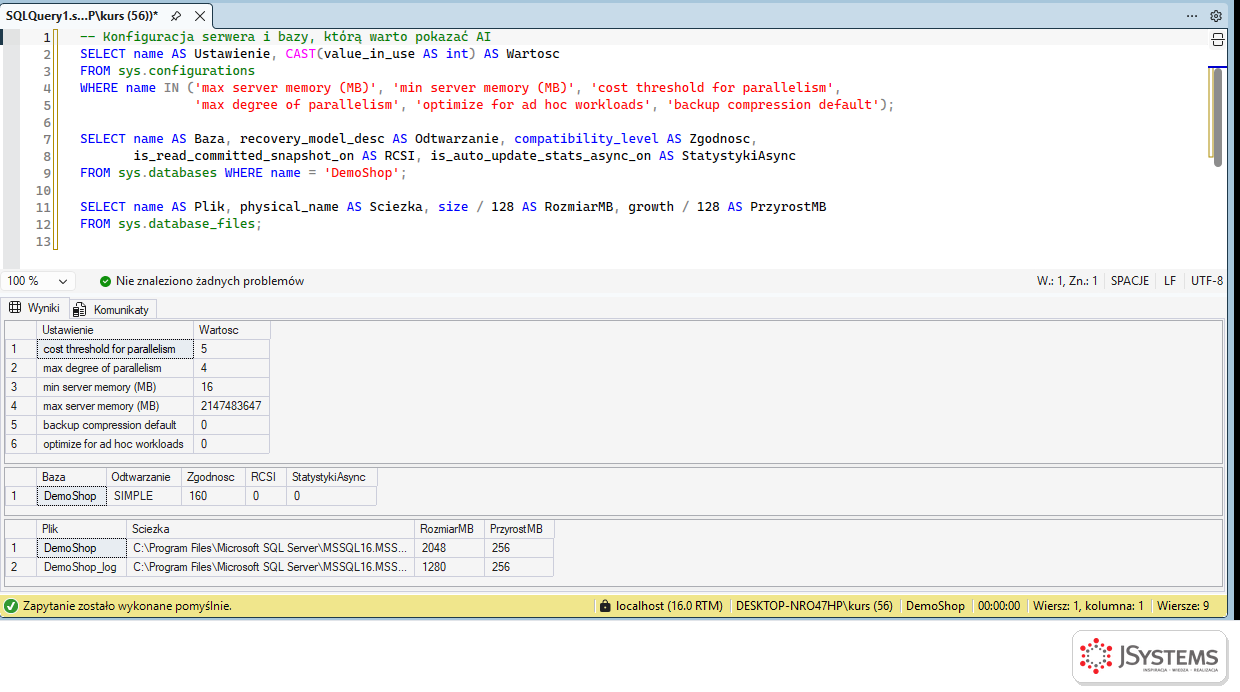
Wyniki trzech zapytań powyżej kopiujemy z nagłówkami i wklejamy do rozmowy pod poleceniem:
Zrób przegląd konfiguracji i stanu serwera SQL Server 2022 Developer na maszynie wirtualnej z 4 rdzeniami i 8 GB pamięci. Załączam liczniki pamięci, opóźnienia odczytu i zapisu plików oraz ustawienia serwera i bazy. Wskaż problemy od najważniejszego, z konkretną zmianą i uzasadnieniem. Zaznacz, które zmiany wymagają restartu albo okna serwisowego.
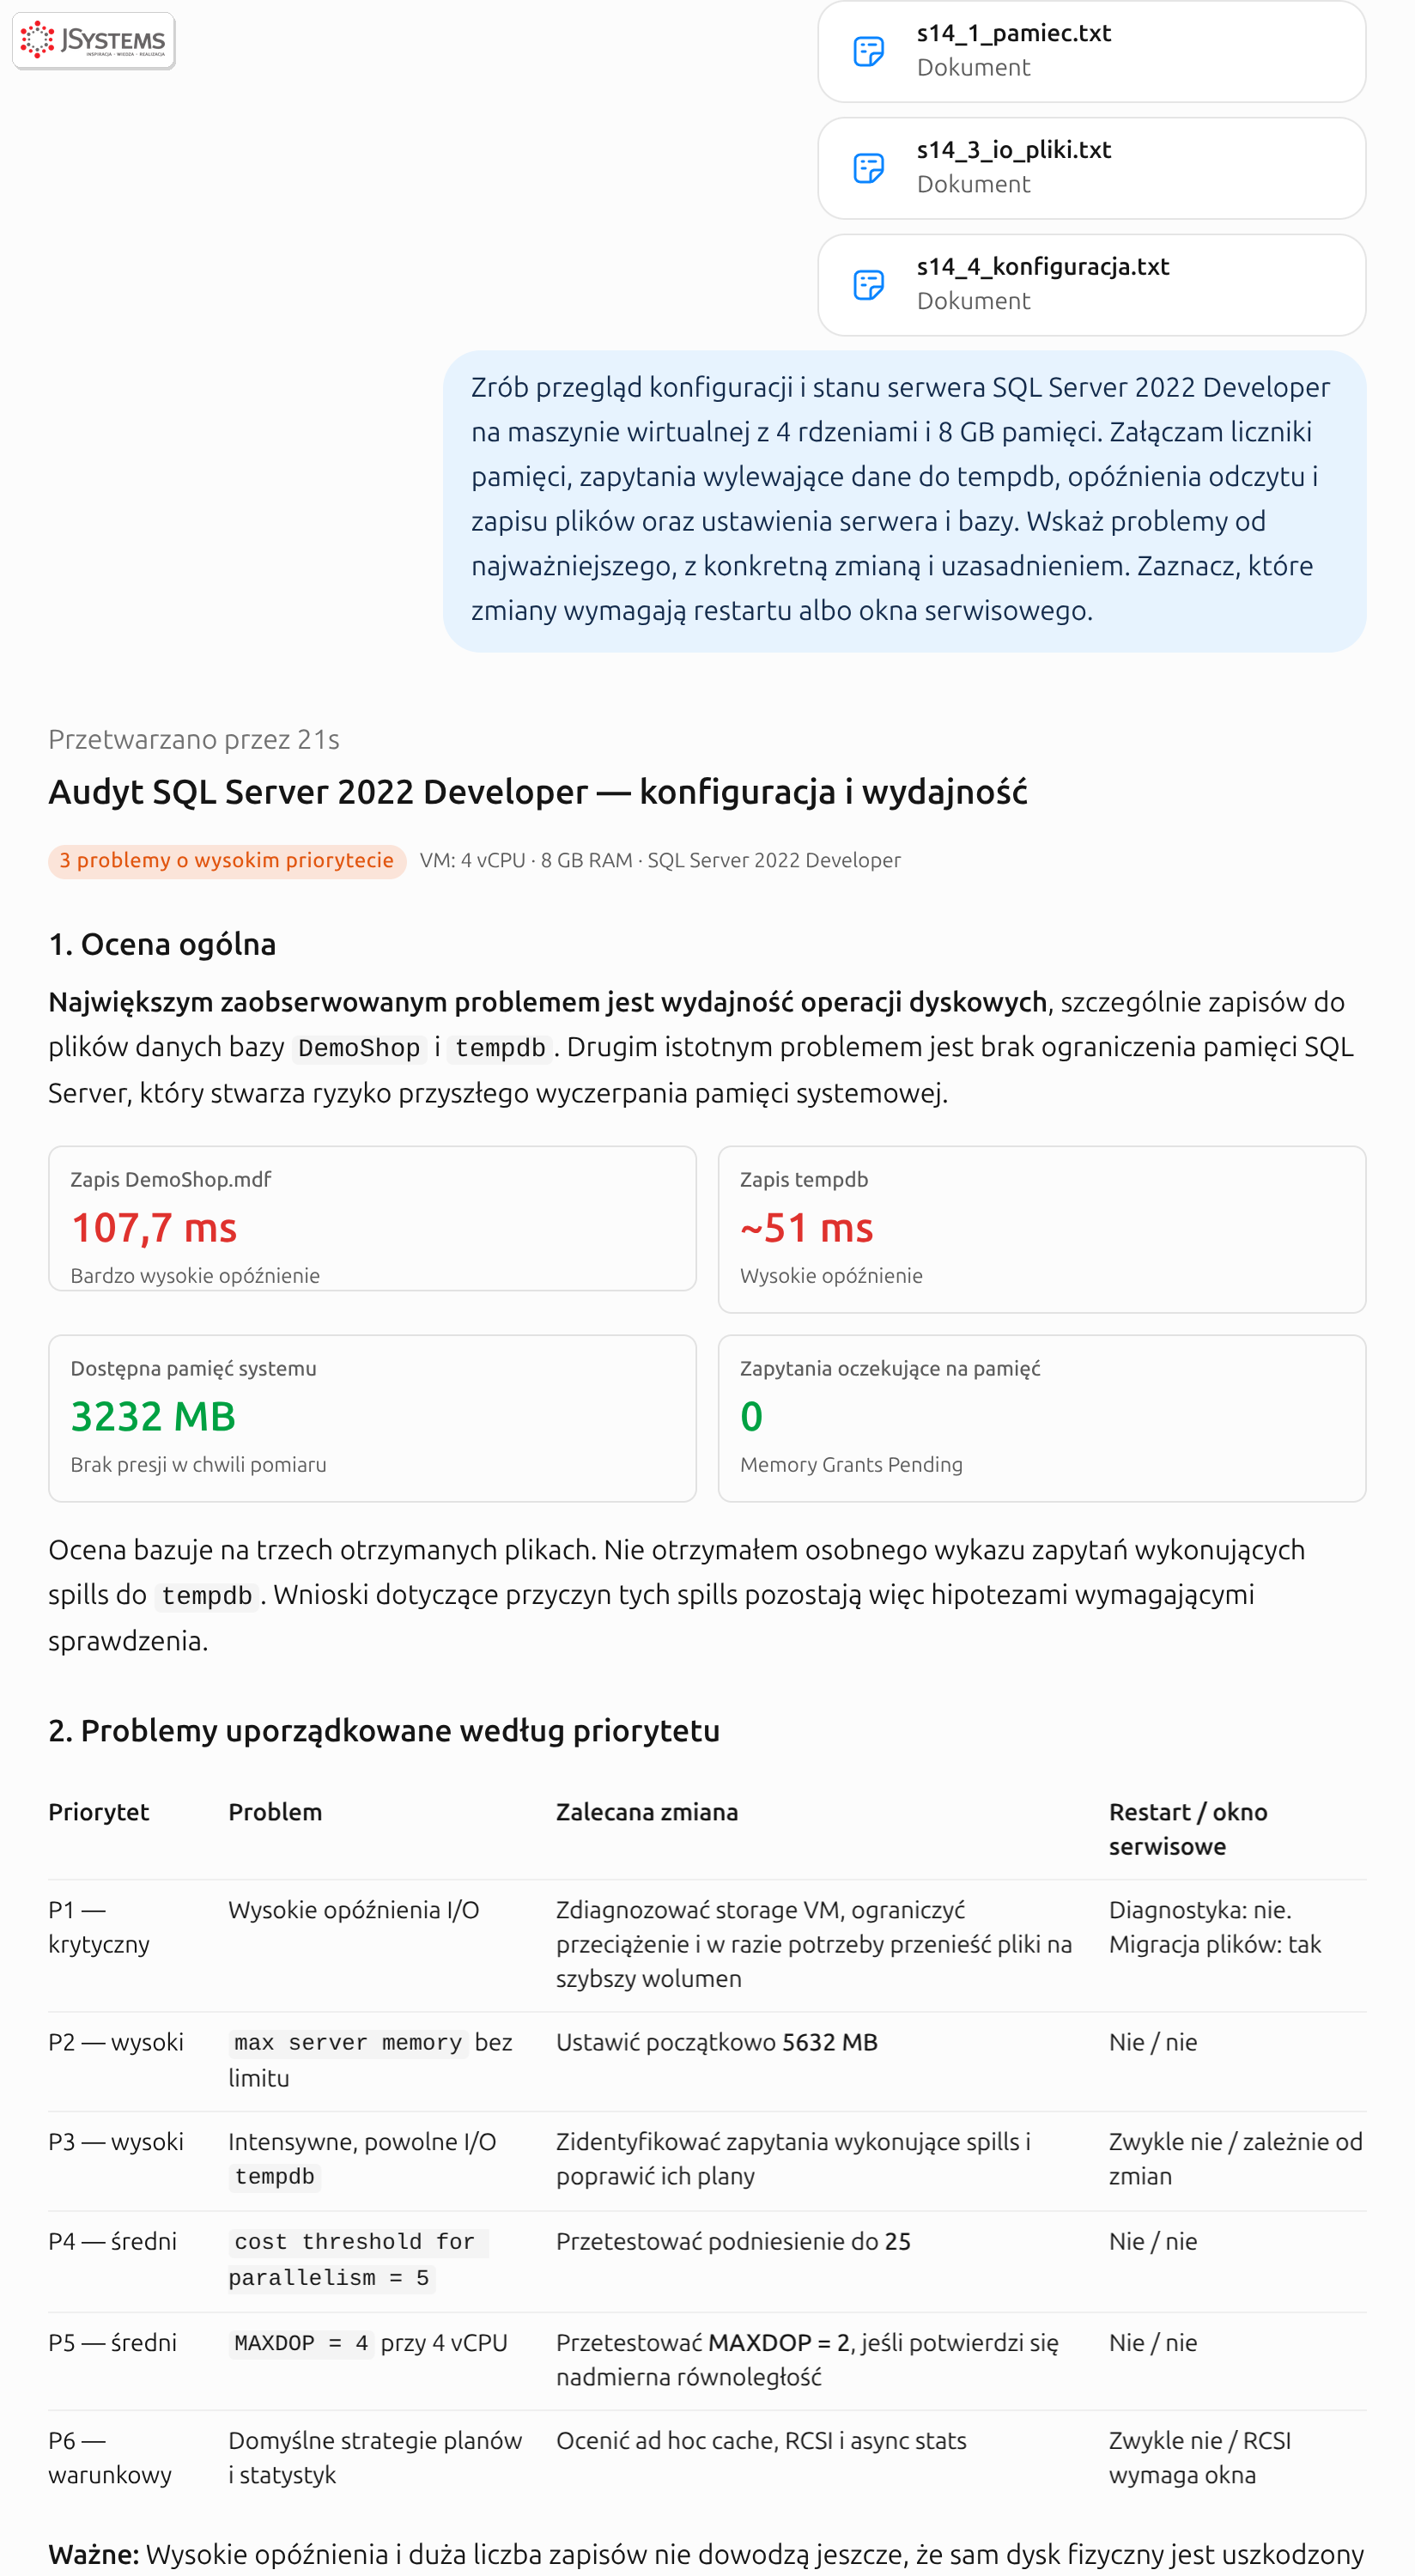
Kolejność priorytetów jest trafna: na tej maszynie wolny dysk jest problemem numer jeden i żadna zmiana w zapytaniach go nie usunie. Drugi priorytet, limit pamięci SQL Server, to klasyczny błąd domyślnej instalacji: bez niego serwer potrafi zabrać systemowi operacyjnemu tyle pamięci, że cierpi cała maszyna. AI dobrze oddzieliło fakty od przypuszczeń: przy dysku zaznaczyło, że wysokie opóźnienia nie dowodzą jeszcze, że sam dysk jest wadliwy, bo przyczyną mogą być współdzielony magazyn, limity operacji albo automatyczny przyrost plików. Każdą z tych zmian i tak trzeba sprawdzić na kopii środowiska, a przy pamięci i równoległości zmierzyć obciążenie przed i po.
Partycjonowanie dzieli tabelę na części według wartości kolumny, zwykle daty. Często pada pytanie, czy przyspieszy zapytania. Zbudowaliśmy kopię tabeli zamówień podzieloną na partycje według roku i zapytaliśmy o rok 2025:
-- Tabela podzielona na partycje według roku: ile partycji odczyta zapytanie o 2025?
SELECT COUNT(*) AS Zamowienia, SUM(ShippingCost) AS KosztyWysylki
FROM dbo.Orders_Part
WHERE OrderDate >= '20250101' AND OrderDate < '20260101';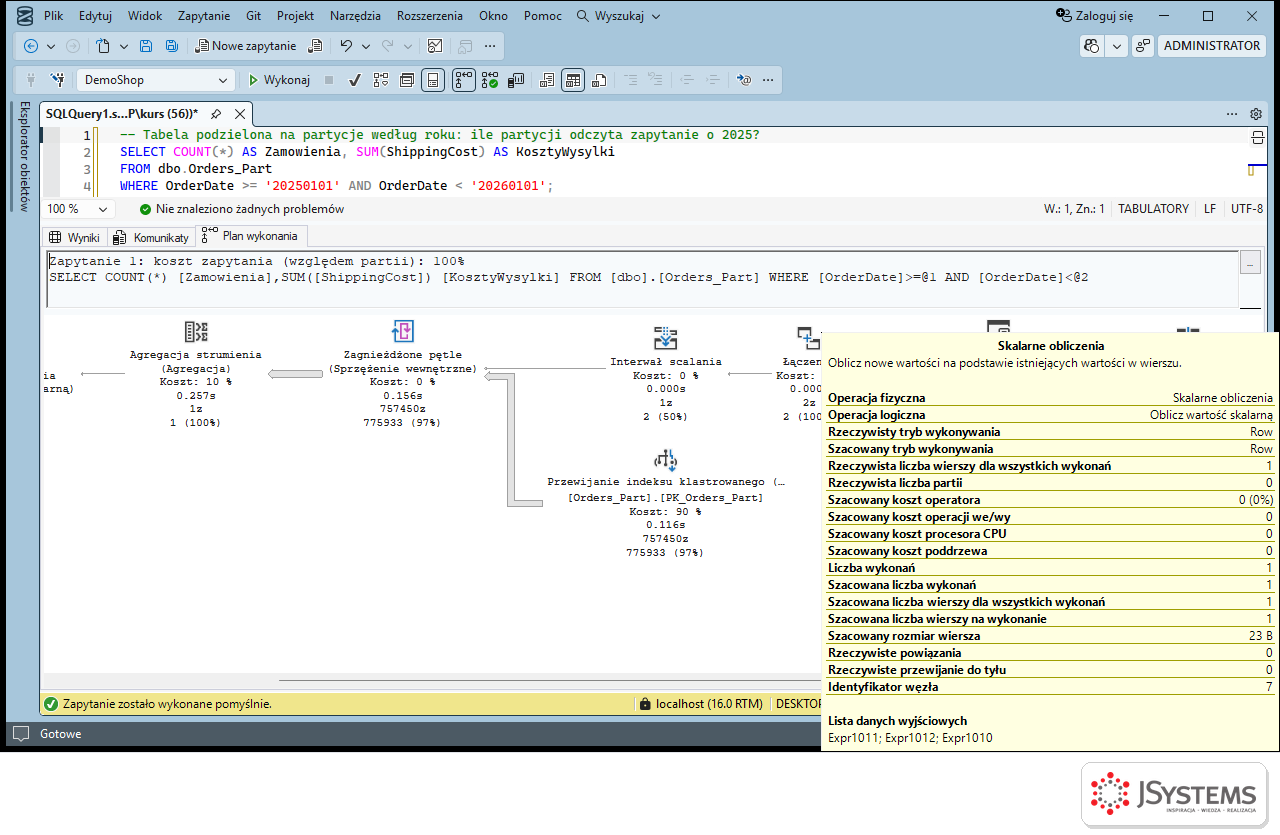
Rozważamy podział tabeli zamówień (2,4 mln wierszy, przybywa ok. 750 tys. rocznie) na partycje według roku w SQL Server 2022. Załączam plan zapytania o rok 2025 na tabeli testowej podzielonej na partycje. Czy partycjonowanie przyspieszy nasze zapytania? Kiedy ma sens, a kiedy szkodzi?
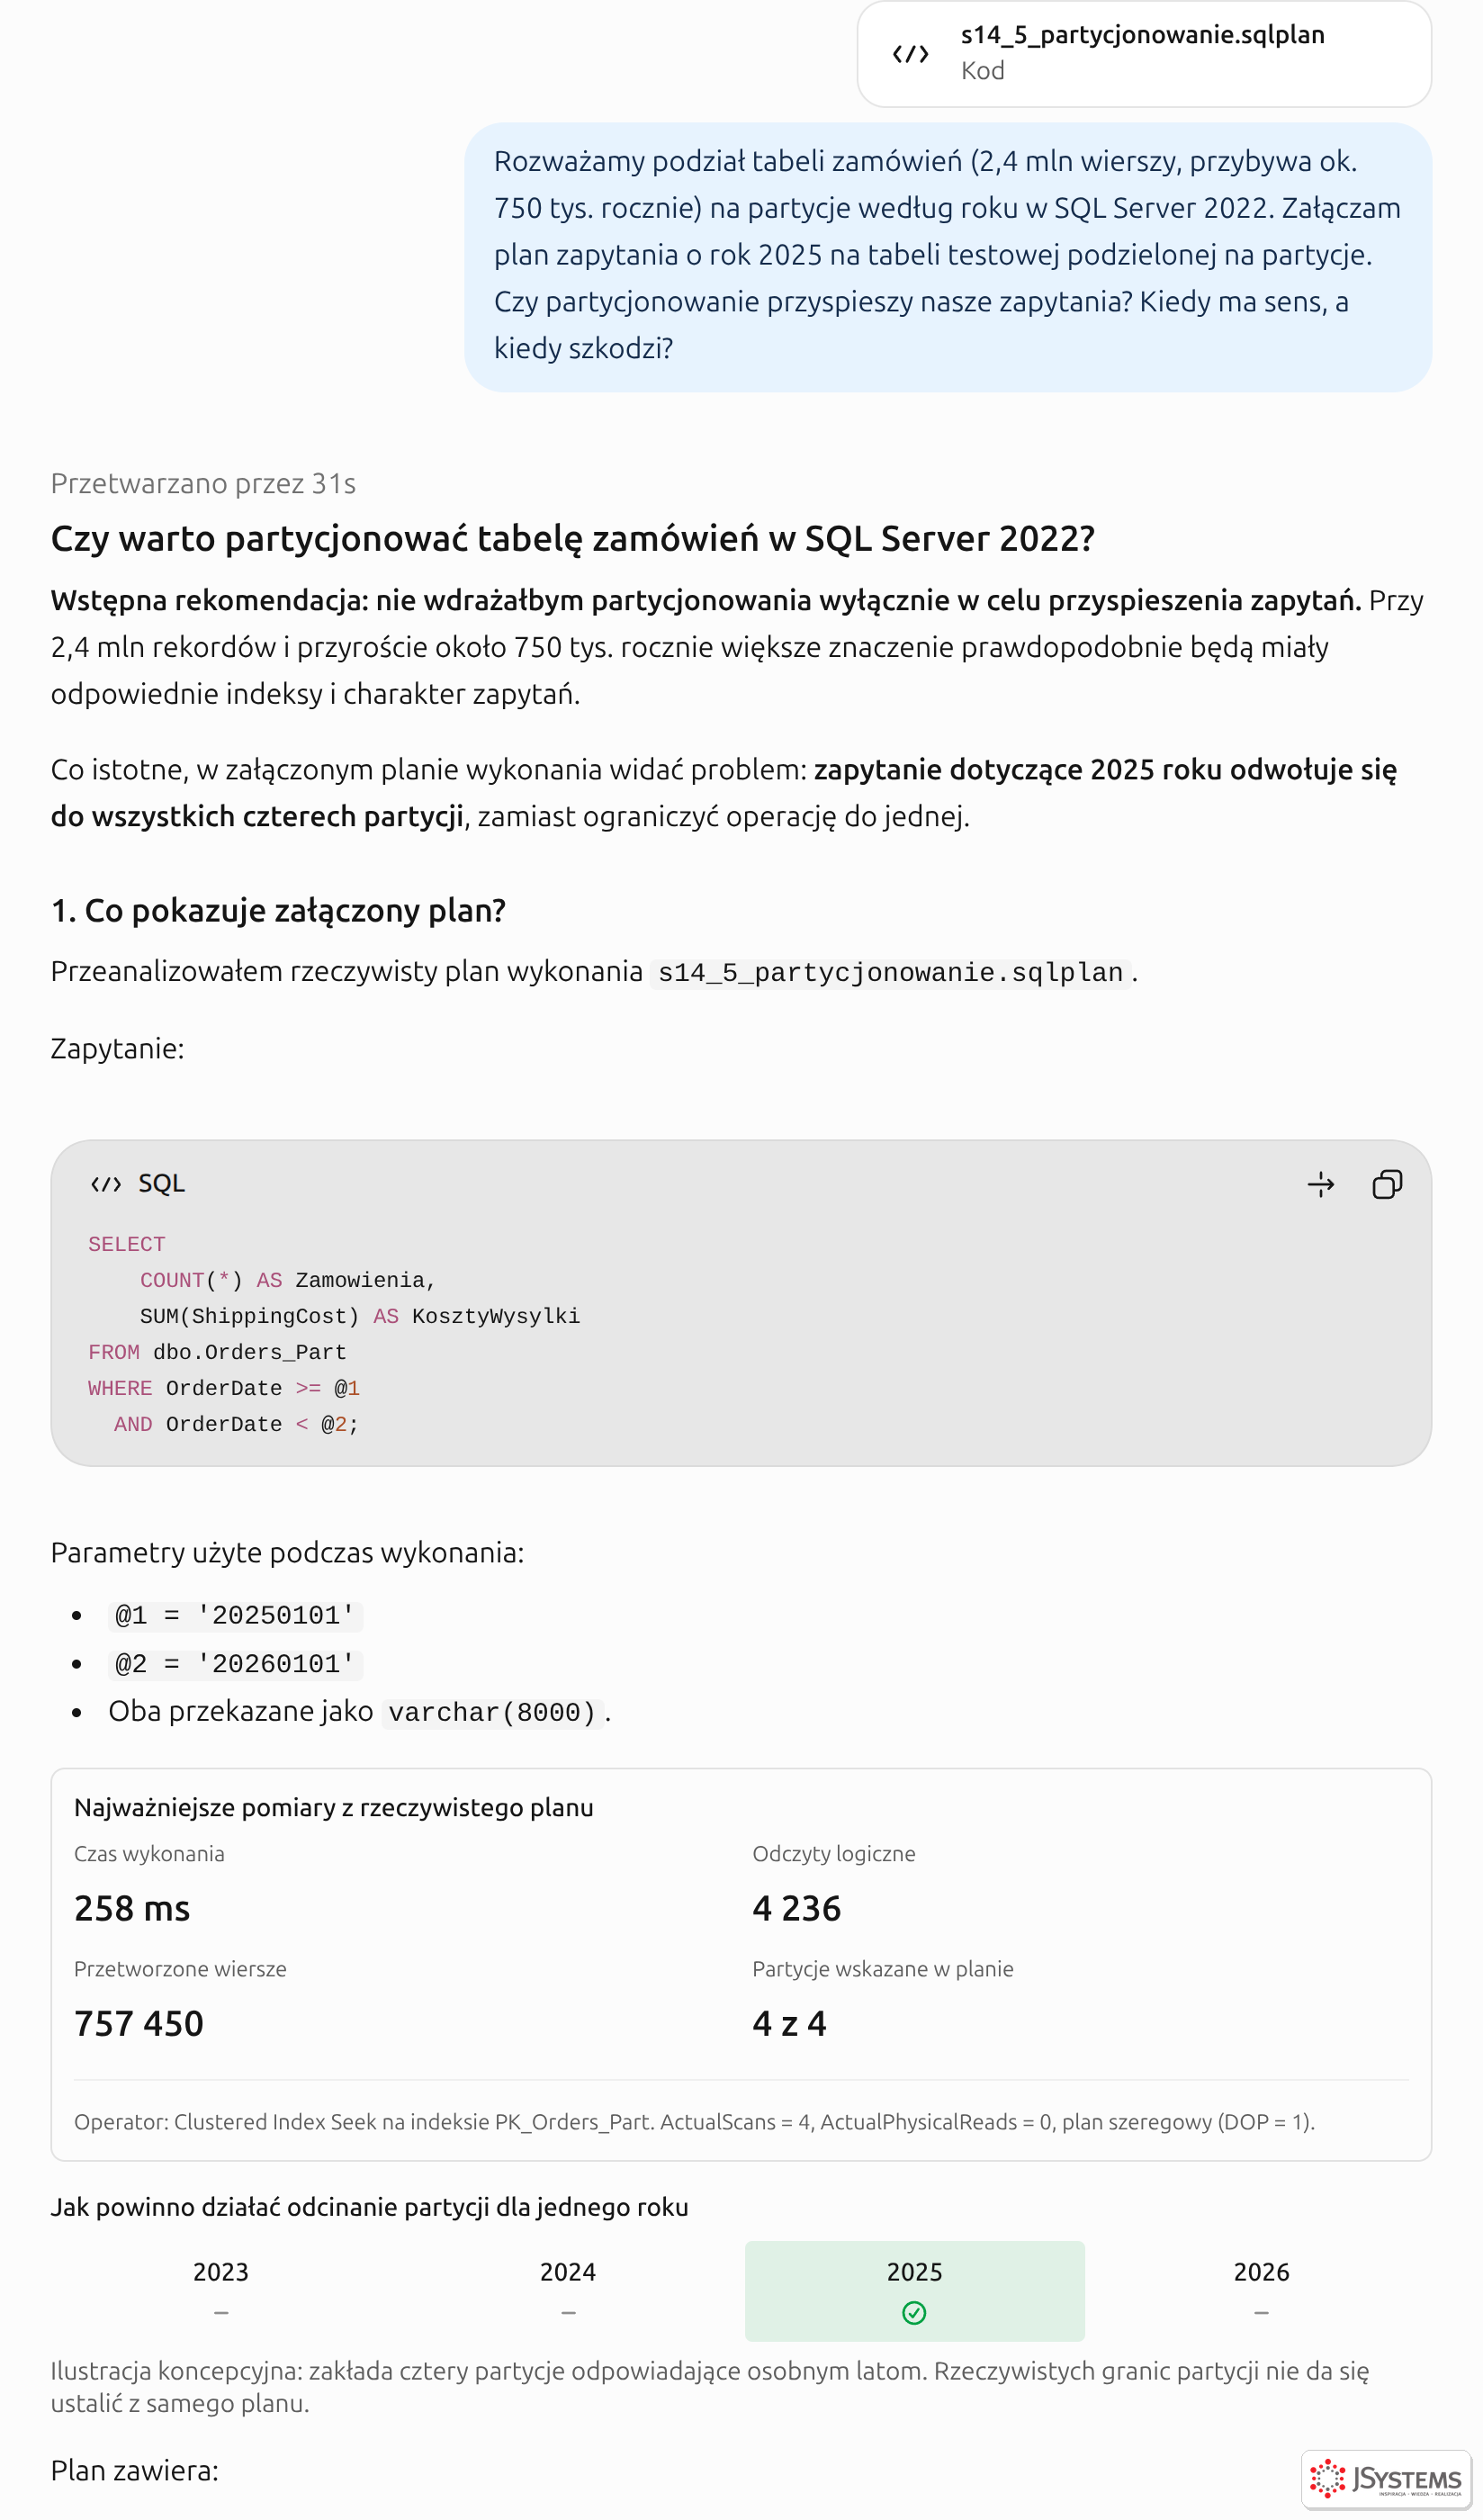
AI wyłapało błąd w naszym własnym demie. Spodziewaliśmy się, że zapytanie o jeden rok odczyta jedną partycję, a plan pokazuje cztery. Przyczyną są daty zapisane jako tekst: SQL Server sparametryzował zapytanie z parametrami typu varchar(8000) i przy kompilacji nie mógł z góry wykluczyć partycji. Gdy podaliśmy daty w typie kolumny, zapytanie odczytało dwie partycje:
-- To samo zapytanie z datami w typie kolumny (datetime2(0)) zamiast tekstu
DECLARE @Od datetime2(0) = '20250101', @Do datetime2(0) = '20260101';
SELECT COUNT(*) AS Zamowienia, SUM(ShippingCost) AS KosztyWysylki
FROM dbo.Orders_Part
WHERE OrderDate >= @Od AND OrderDate < @Do;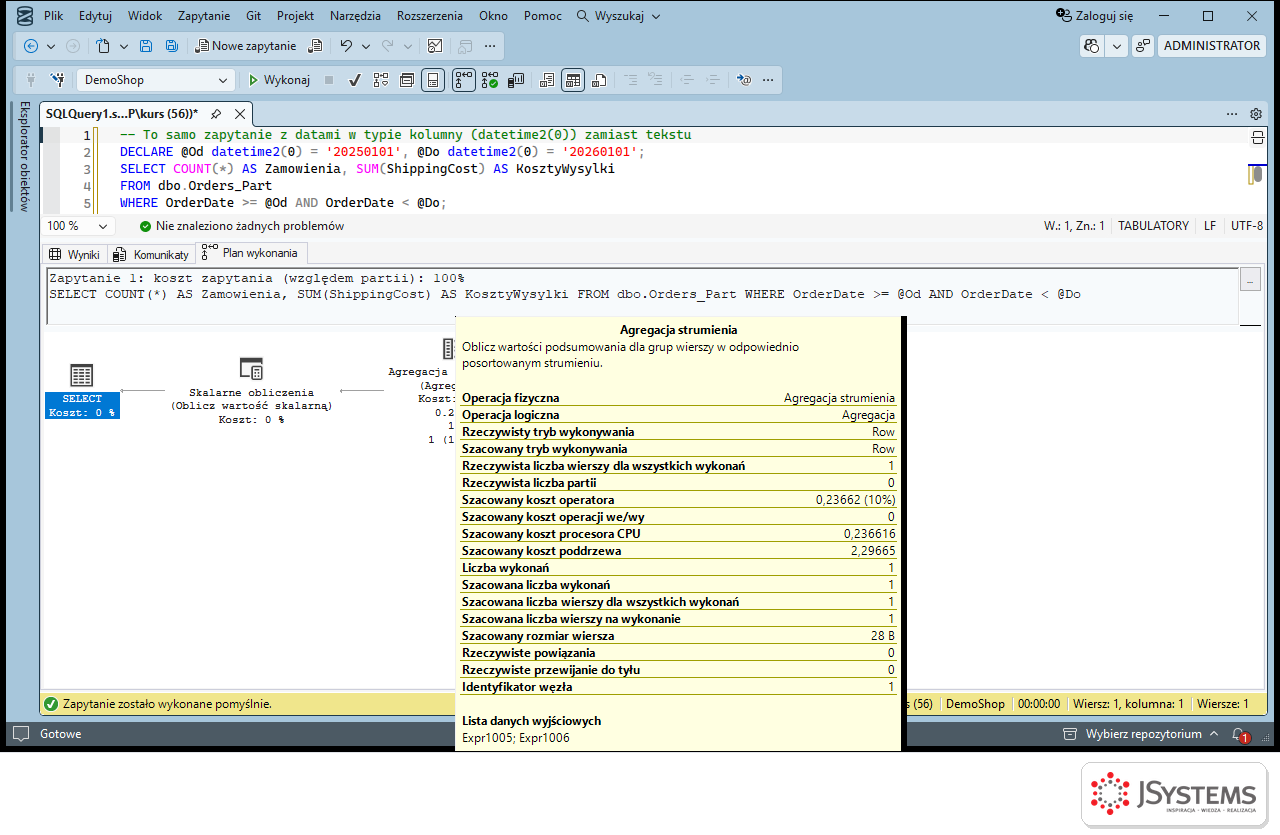
Wniosek widać w liczbach: odczyty spadły z 4 236 do 4 228. Indeks klastrowy zaczynający się od daty i tak czyta wyłącznie wiersze z 2025 roku, niezależnie od tego, ile partycji formalnie dotyka. Dokładnie to przewidziało AI: przy kilku milionach wierszy partycjonowanie nie przyspieszy zapytań, które mają dobry indeks. Ma sens przy zarządzaniu dużymi danymi: szybkim usuwaniu albo archiwizacji całych lat, utrzymaniu indeksów po kawałku i ładowaniu danych przez przełączanie partycji.
.sqlplan; wynik widoków systemowych z chwili problemu (sys.dm_exec_requests, sys.dm_os_waiting_tasks, sys.dm_tran_active_transactions), a nie z chwili, gdy problem już minął; raport zakleszczenia z system_health; stan statystyk z sys.dm_db_stats_properties; konfigurację serwera i opóźnienia plików. Do tego zawsze wersja serwera, sprzęt i opis, co użytkownicy widzą. Każde zalecenie AI dotyczące konfiguracji sprawdź na kopii środowiska, zanim trafi na produkcję.Część 5 z 8 przewodnika AI w SQL


Komentarze (0)
Brak komentarzy...