
Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
W skrócieChatGPT dobrze tłumaczy cudze zapytanie SQL linia po linii, wyjaśnia kolejność logicznego wykonywania i czyta plan wykonania prostym językiem. Pokazujemy siedem takich rozmów na jednym zapytaniu z bazy DemoShop i to, jak sprawdzić na bazie, czy prostsza wersja od AI daje ten sam wynik.
To część 2 z 8 przewodnika AI w SQL. Wszystkie przykłady powstały na bazie DemoShop w SQL Server 2022: fikcyjnym sklepie internetowym z 2,4 mln zamówień. Polecenia wpisujemy do ChatGPT, ale te same możesz podać Microsoft Copilotowi, Claude albo Gemini. Przy skryptach korzystających z mechanizmów serwera w małej szarej ramce znajdziesz ich odpowiedniki dla Oracle i PostgreSQL.
Z tej części dowiesz się:
Pliki do tej części
Skrypt bazy uruchamiasz w SSMS na serwerze SQL Server 2019 lub nowszym. Tworzy bazę DemoShop, na której powstały wszystkie przykłady.
Nie zawsze piszesz SQL od zera. Częściej dostajesz zapytanie po kimś, kto już nie pracuje w firmie, albo raport, który „zawsze działał”, i musisz zrozumieć, co właściwie liczy. To zadanie, w którym AI sprawdza się wyjątkowo dobrze, bo cała potrzebna informacja jest w samym kodzie. Wzięliśmy zapytanie, które dla kogoś znającego tylko podstawy SELECT jest już trudne: cztery tabele, złączenia zewnętrzne z warunkami w ON, COUNT(DISTINCT), HAVING i ranking funkcją okienkową.
SELECT r.RegionName,
       c.Segment,
       COUNT(DISTINCT c.CustomerID)                                   AS Customers,
       COUNT(DISTINCT o.OrderID)                                      AS Orders2025,
       SUM(oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100) AS Revenue2025,
       RANK() OVER (PARTITION BY c.Segment
                    ORDER BY SUM(oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100) DESC) AS RankInSegment
FROM dbo.Customers AS c
JOIN dbo.Regions AS r ON r.RegionID = c.RegionID
LEFT JOIN dbo.Orders AS o
       ON o.CustomerID = c.CustomerID
      AND o.OrderDate >= '20250101' AND o.OrderDate < '20260101'
      AND o.Status <> 'CANCELLED'
LEFT JOIN dbo.OrderItems AS oi ON oi.OrderID = o.OrderID
WHERE c.Country = 'PL'
GROUP BY r.RegionName, c.Segment
HAVING COUNT(DISTINCT o.OrderID) > 0
ORDER BY c.Segment, RankInSegment;
Prowadzimy jedną rozmowę z siedmioma pytaniami, od ogólnego wyjaśnienia po plan wykonania. Świadomie nie załączamy schematu, bo tak zwykle wygląda prośba o wyjaśnienie: wklejasz sam kod.
Wyjaśnij mi to zapytanie linia po linii, prostym językiem. Znam podstawy SELECT, ale nie znam funkcji okienkowych. Baza to SQL Server 2022.
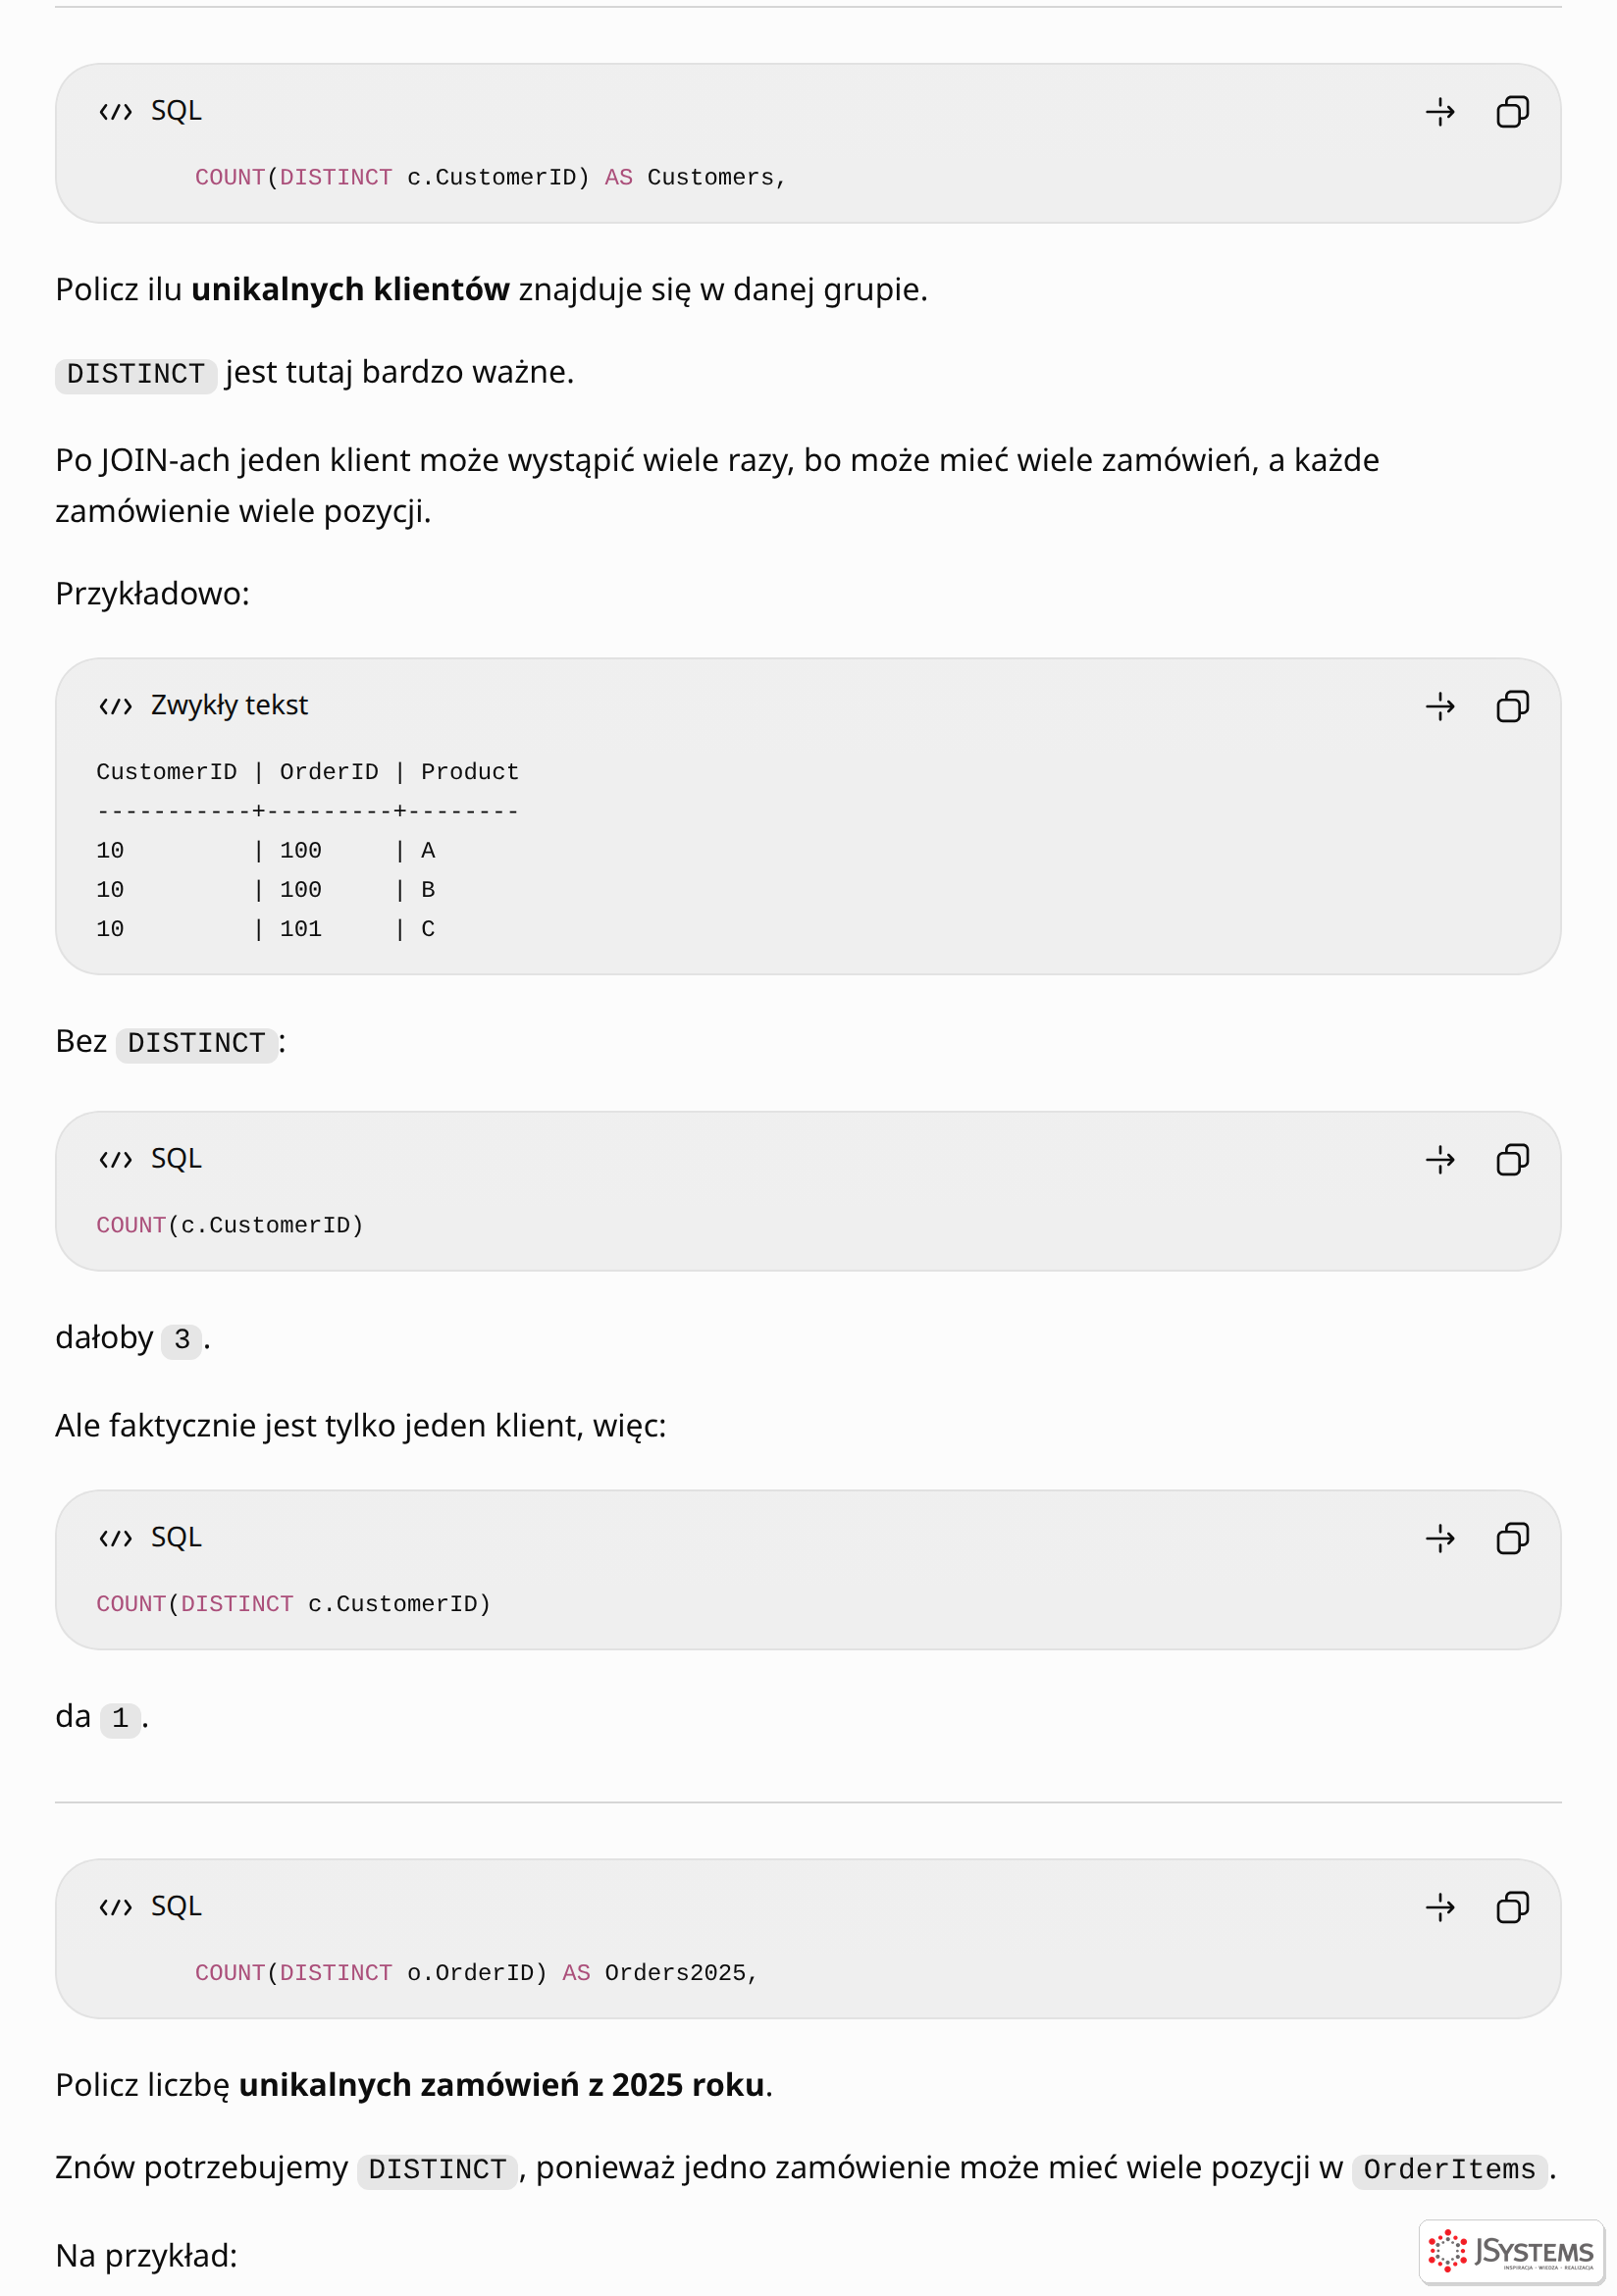
Wyjaśnienie jest dobre dydaktycznie: krótkie tabelki z trzema wierszami pokazują, skąd biorą się duplikaty po złączeniu i po co jest DISTINCT. Jest w nim jednak drobiazg, który dobrze ilustruje granice AI bez schematu. Opisując kolumnę Segment, ChatGPT podaje przykładowe wartości „SMB, Enterprise, Consumer”. W DemoShop segmenty to B2C i B2B. Model nie miał skąd tego wiedzieć, więc wymyślił typowe wartości i uczciwie oznaczył je jako przykładowe. W wyjaśnieniu to nie szkodzi, ale gdybyś na tej podstawie napisał filtr WHERE c.Segment = 'Enterprise', dostałbyś pusty wynik.
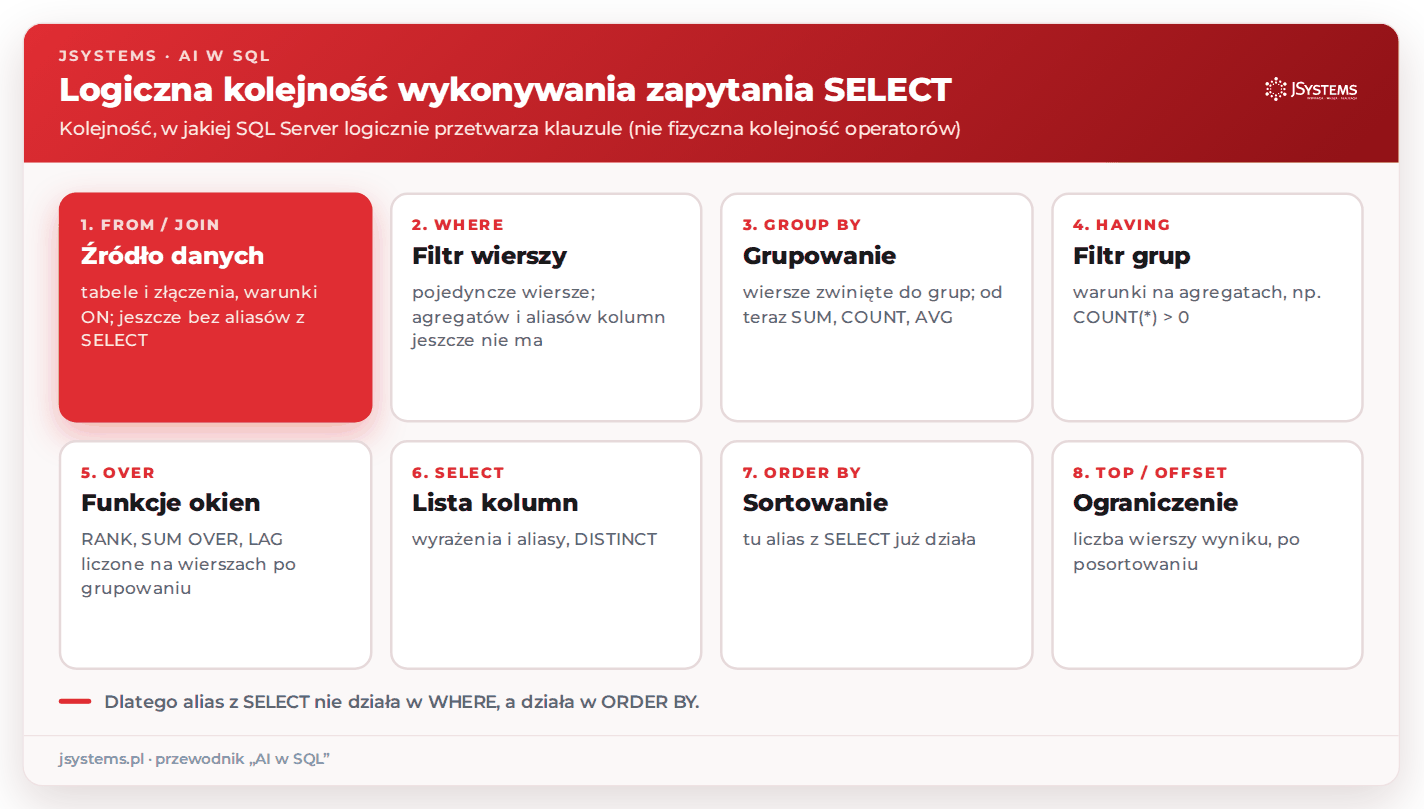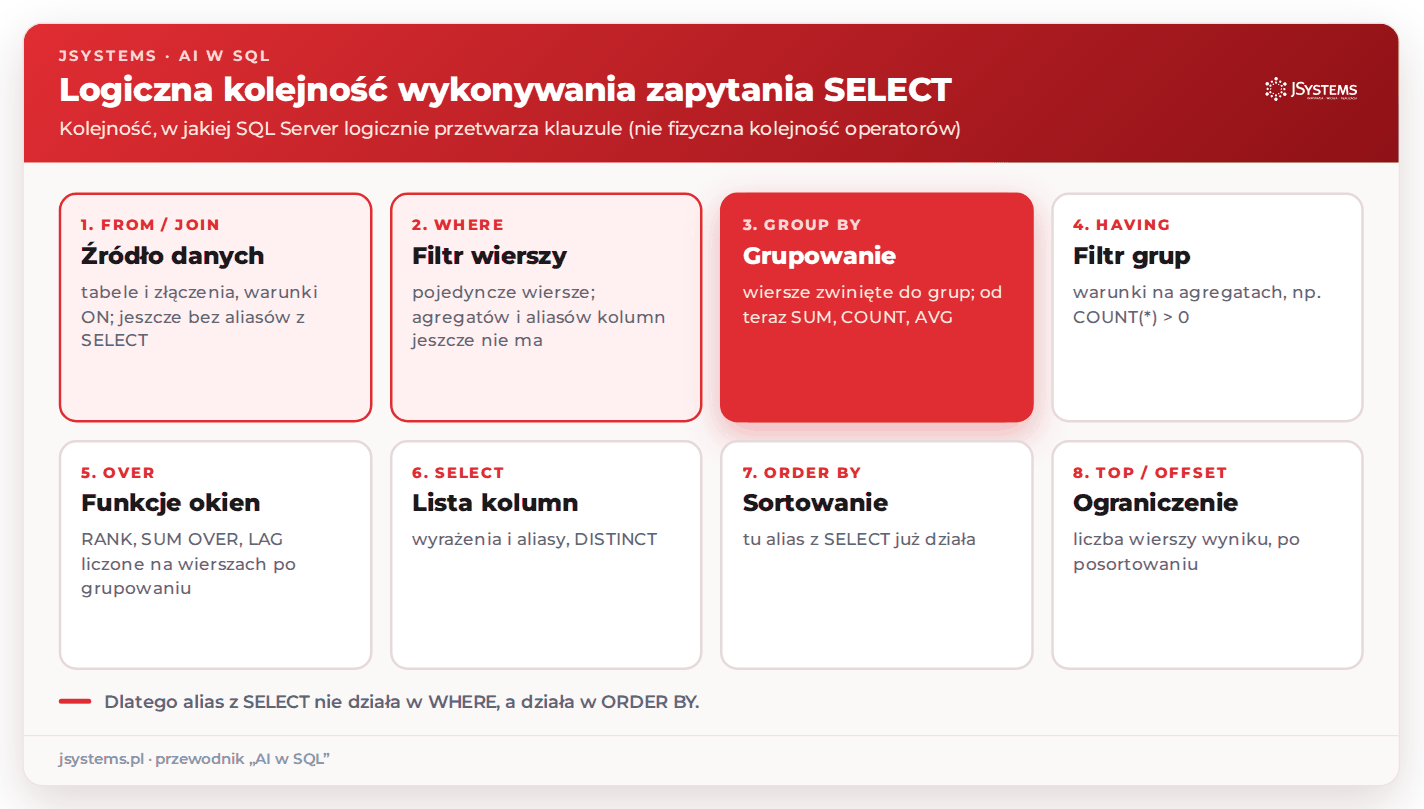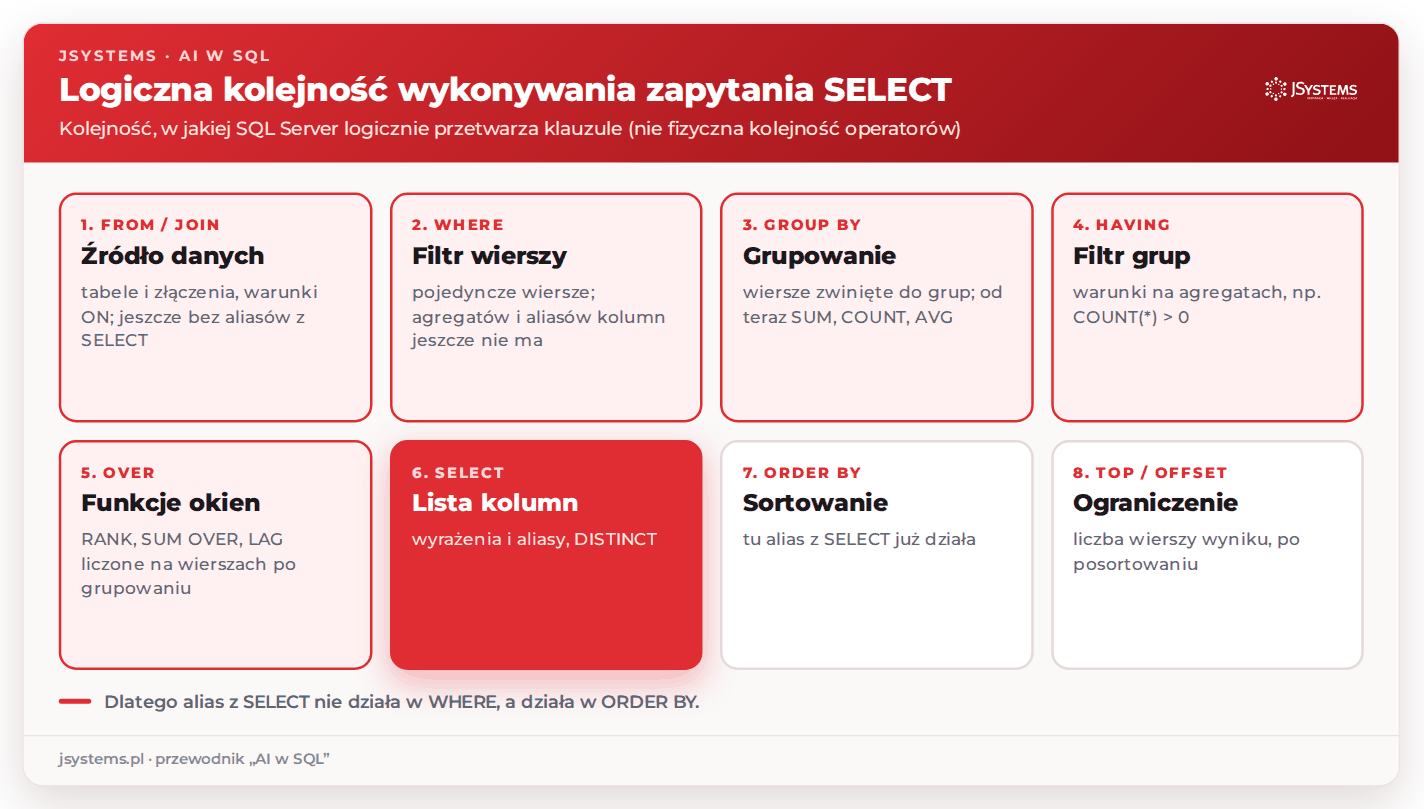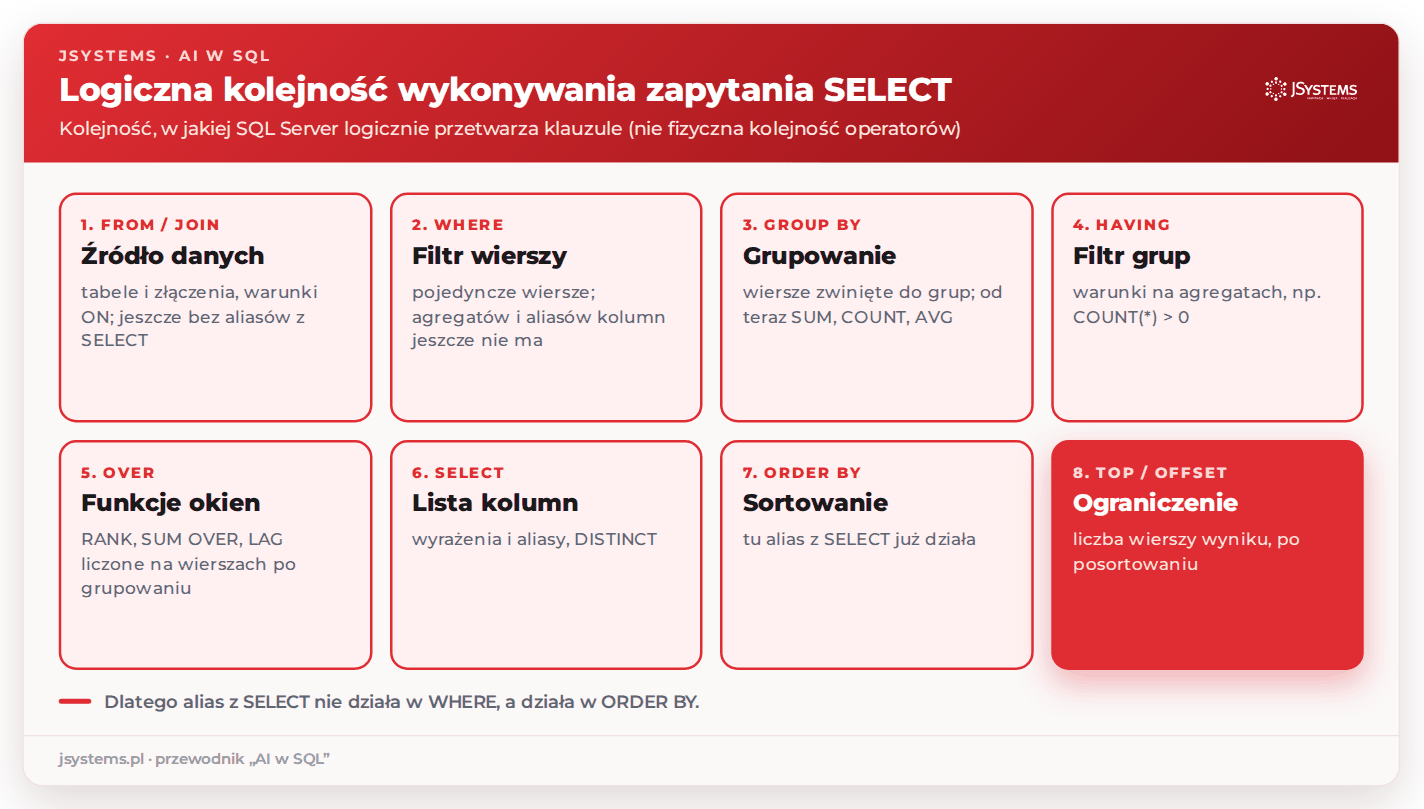
Najczęstsze źródło niezrozumienia SQL to przekonanie, że zapytanie wykonuje się w kolejności, w jakiej je czytamy, od SELECT. Logicznie jest inaczej: najpierw powstaje źródło danych z FROM i złączeń, potem działają filtry, grupowanie, funkcje okienkowe, a dopiero na końcu lista kolumn i sortowanie.
Pokaż kolejność logicznego wykonywania tego zapytania: w jakiej kolejności SQL Server przetwarza klauzule i co jest dostępne na każdym etapie.
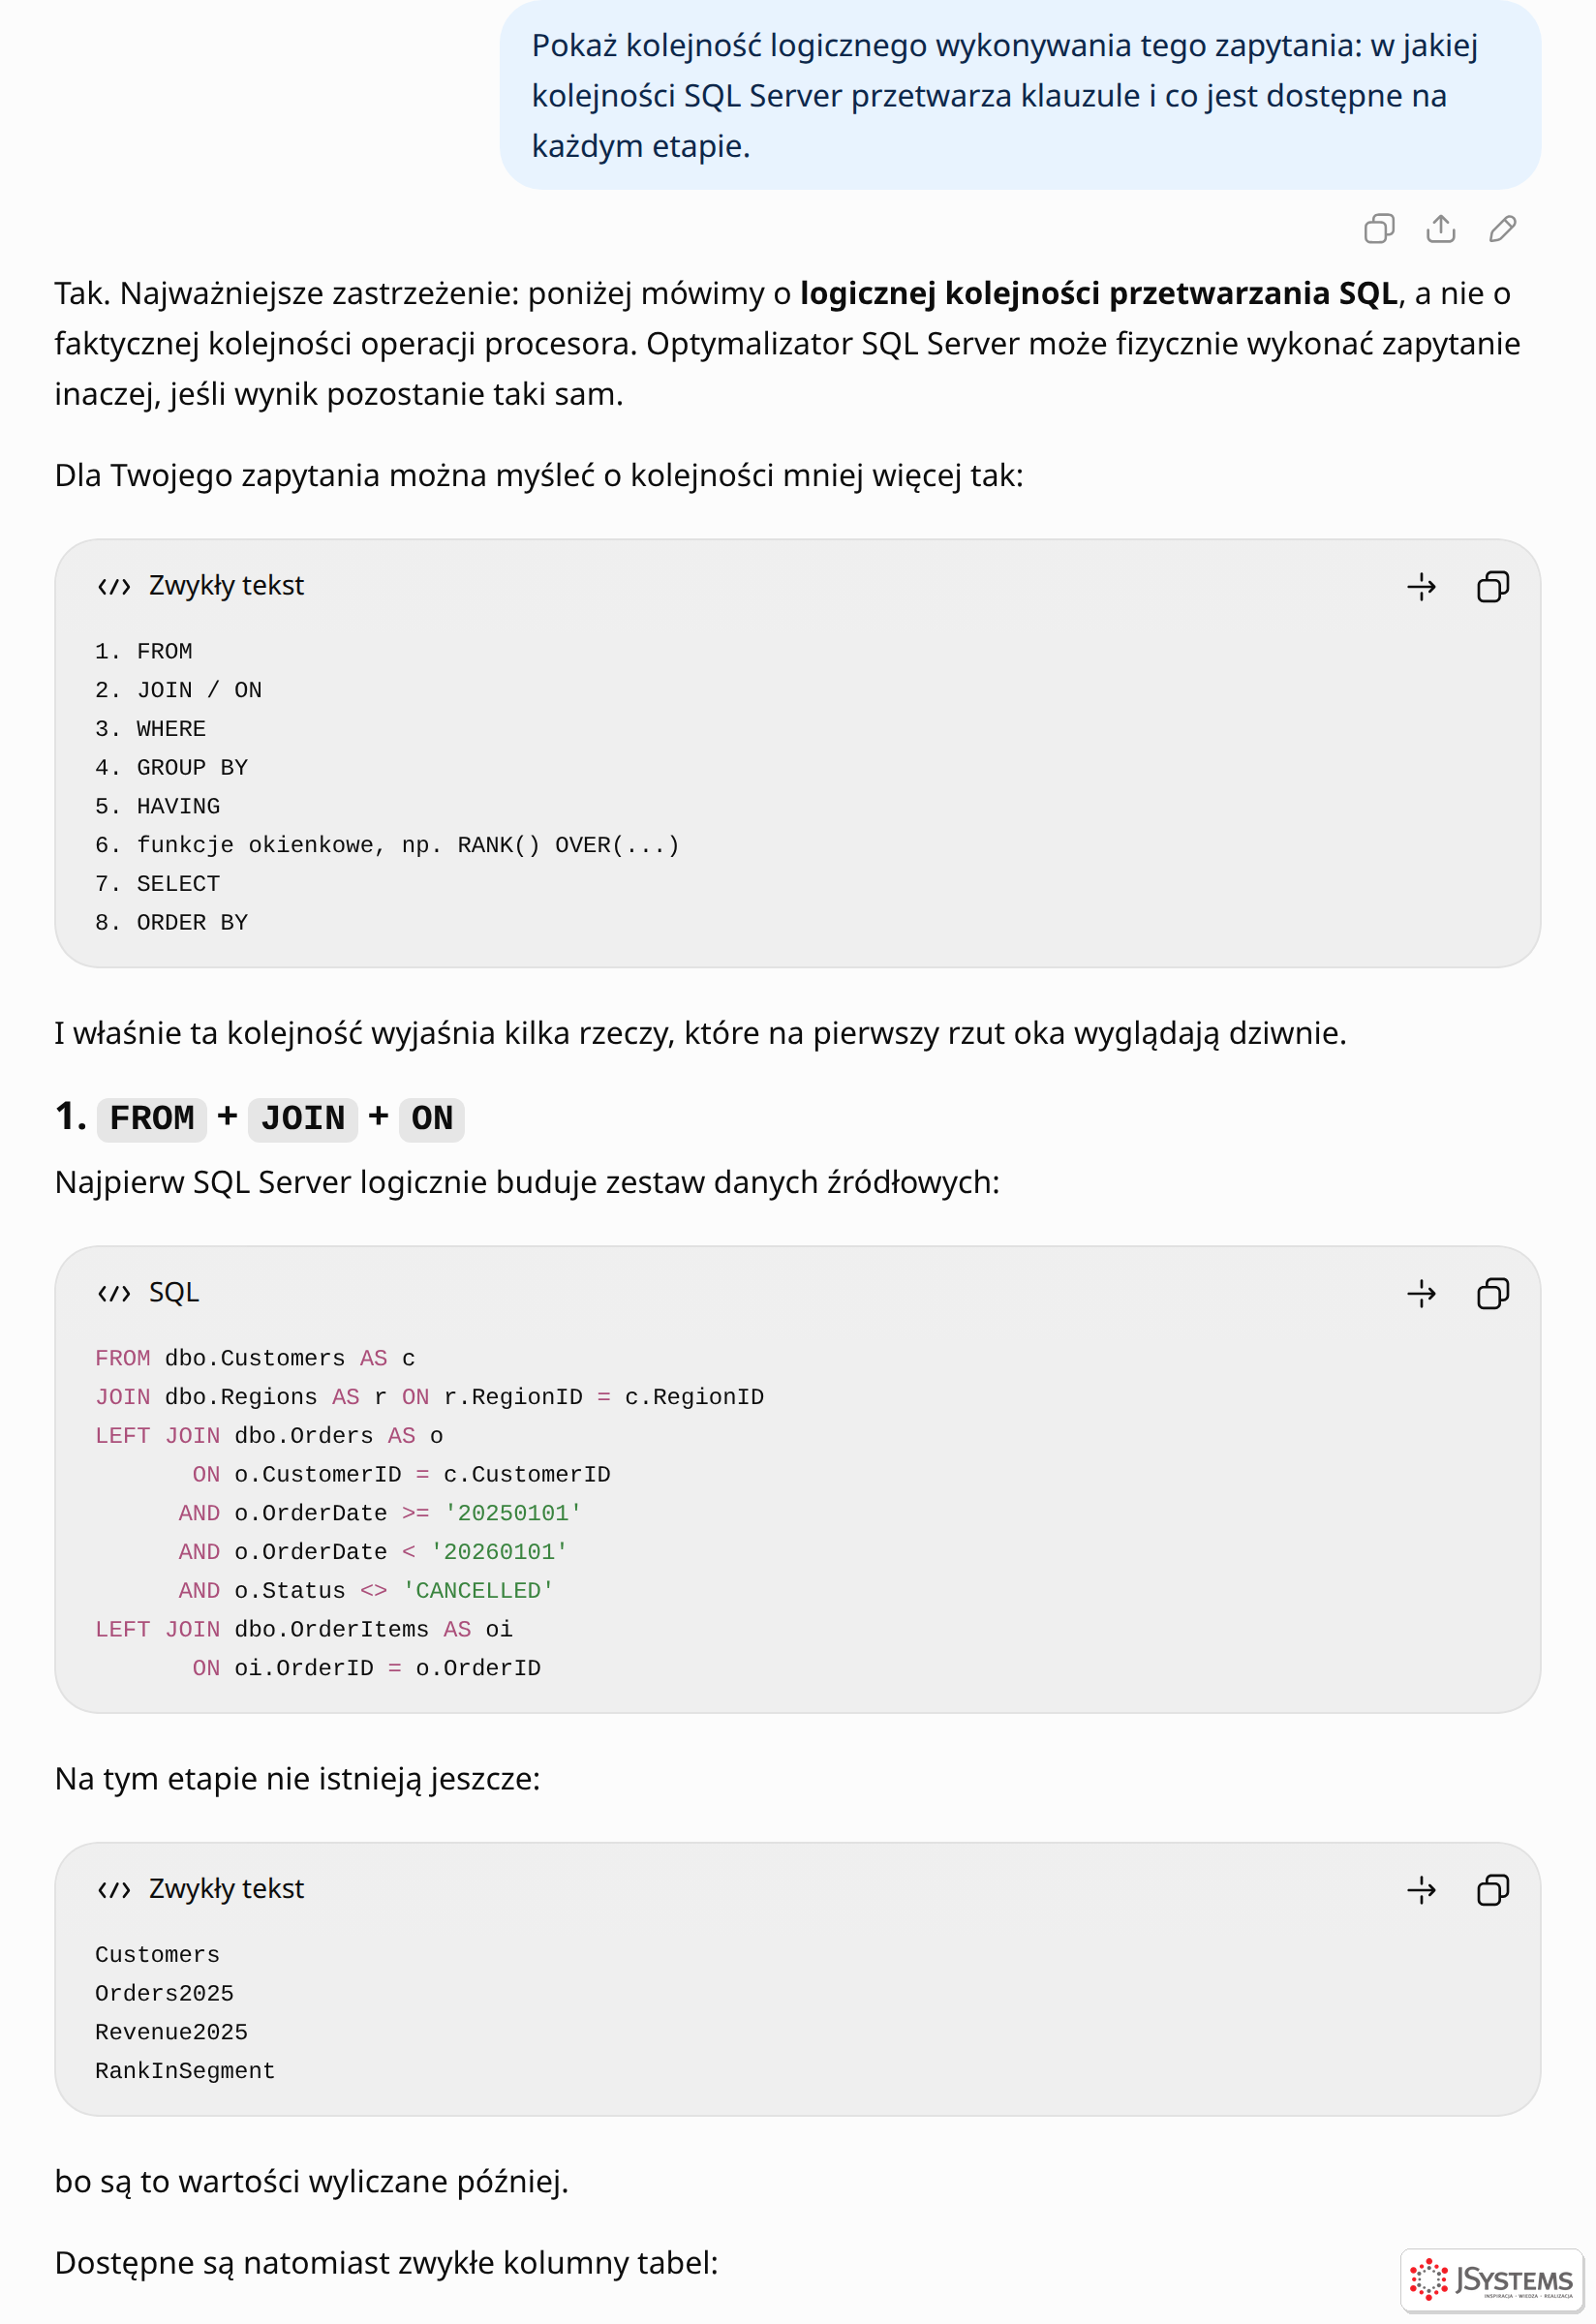
Najbardziej wartościowa część odpowiedzi to przykłady tego, czego nie da się zrobić na danym etapie, na przykład WHERE Revenue2025 > 100000. Alias Revenue2025 powstaje dopiero w SELECT, a suma dopiero po GROUP BY, więc taki warunek musi trafić do HAVING. Tę samą regułę pokazujemy w praktyce w sekcji o błędach składniowych, gdzie alias użyty w WHERE kończy się błędem 207.
Dlaczego jest tu LEFT JOIN do dbo.Orders, a nie INNER JOIN? Co by się zmieniło w wyniku, gdyby warunki o dacie i statusie przenieść z ON do WHERE?
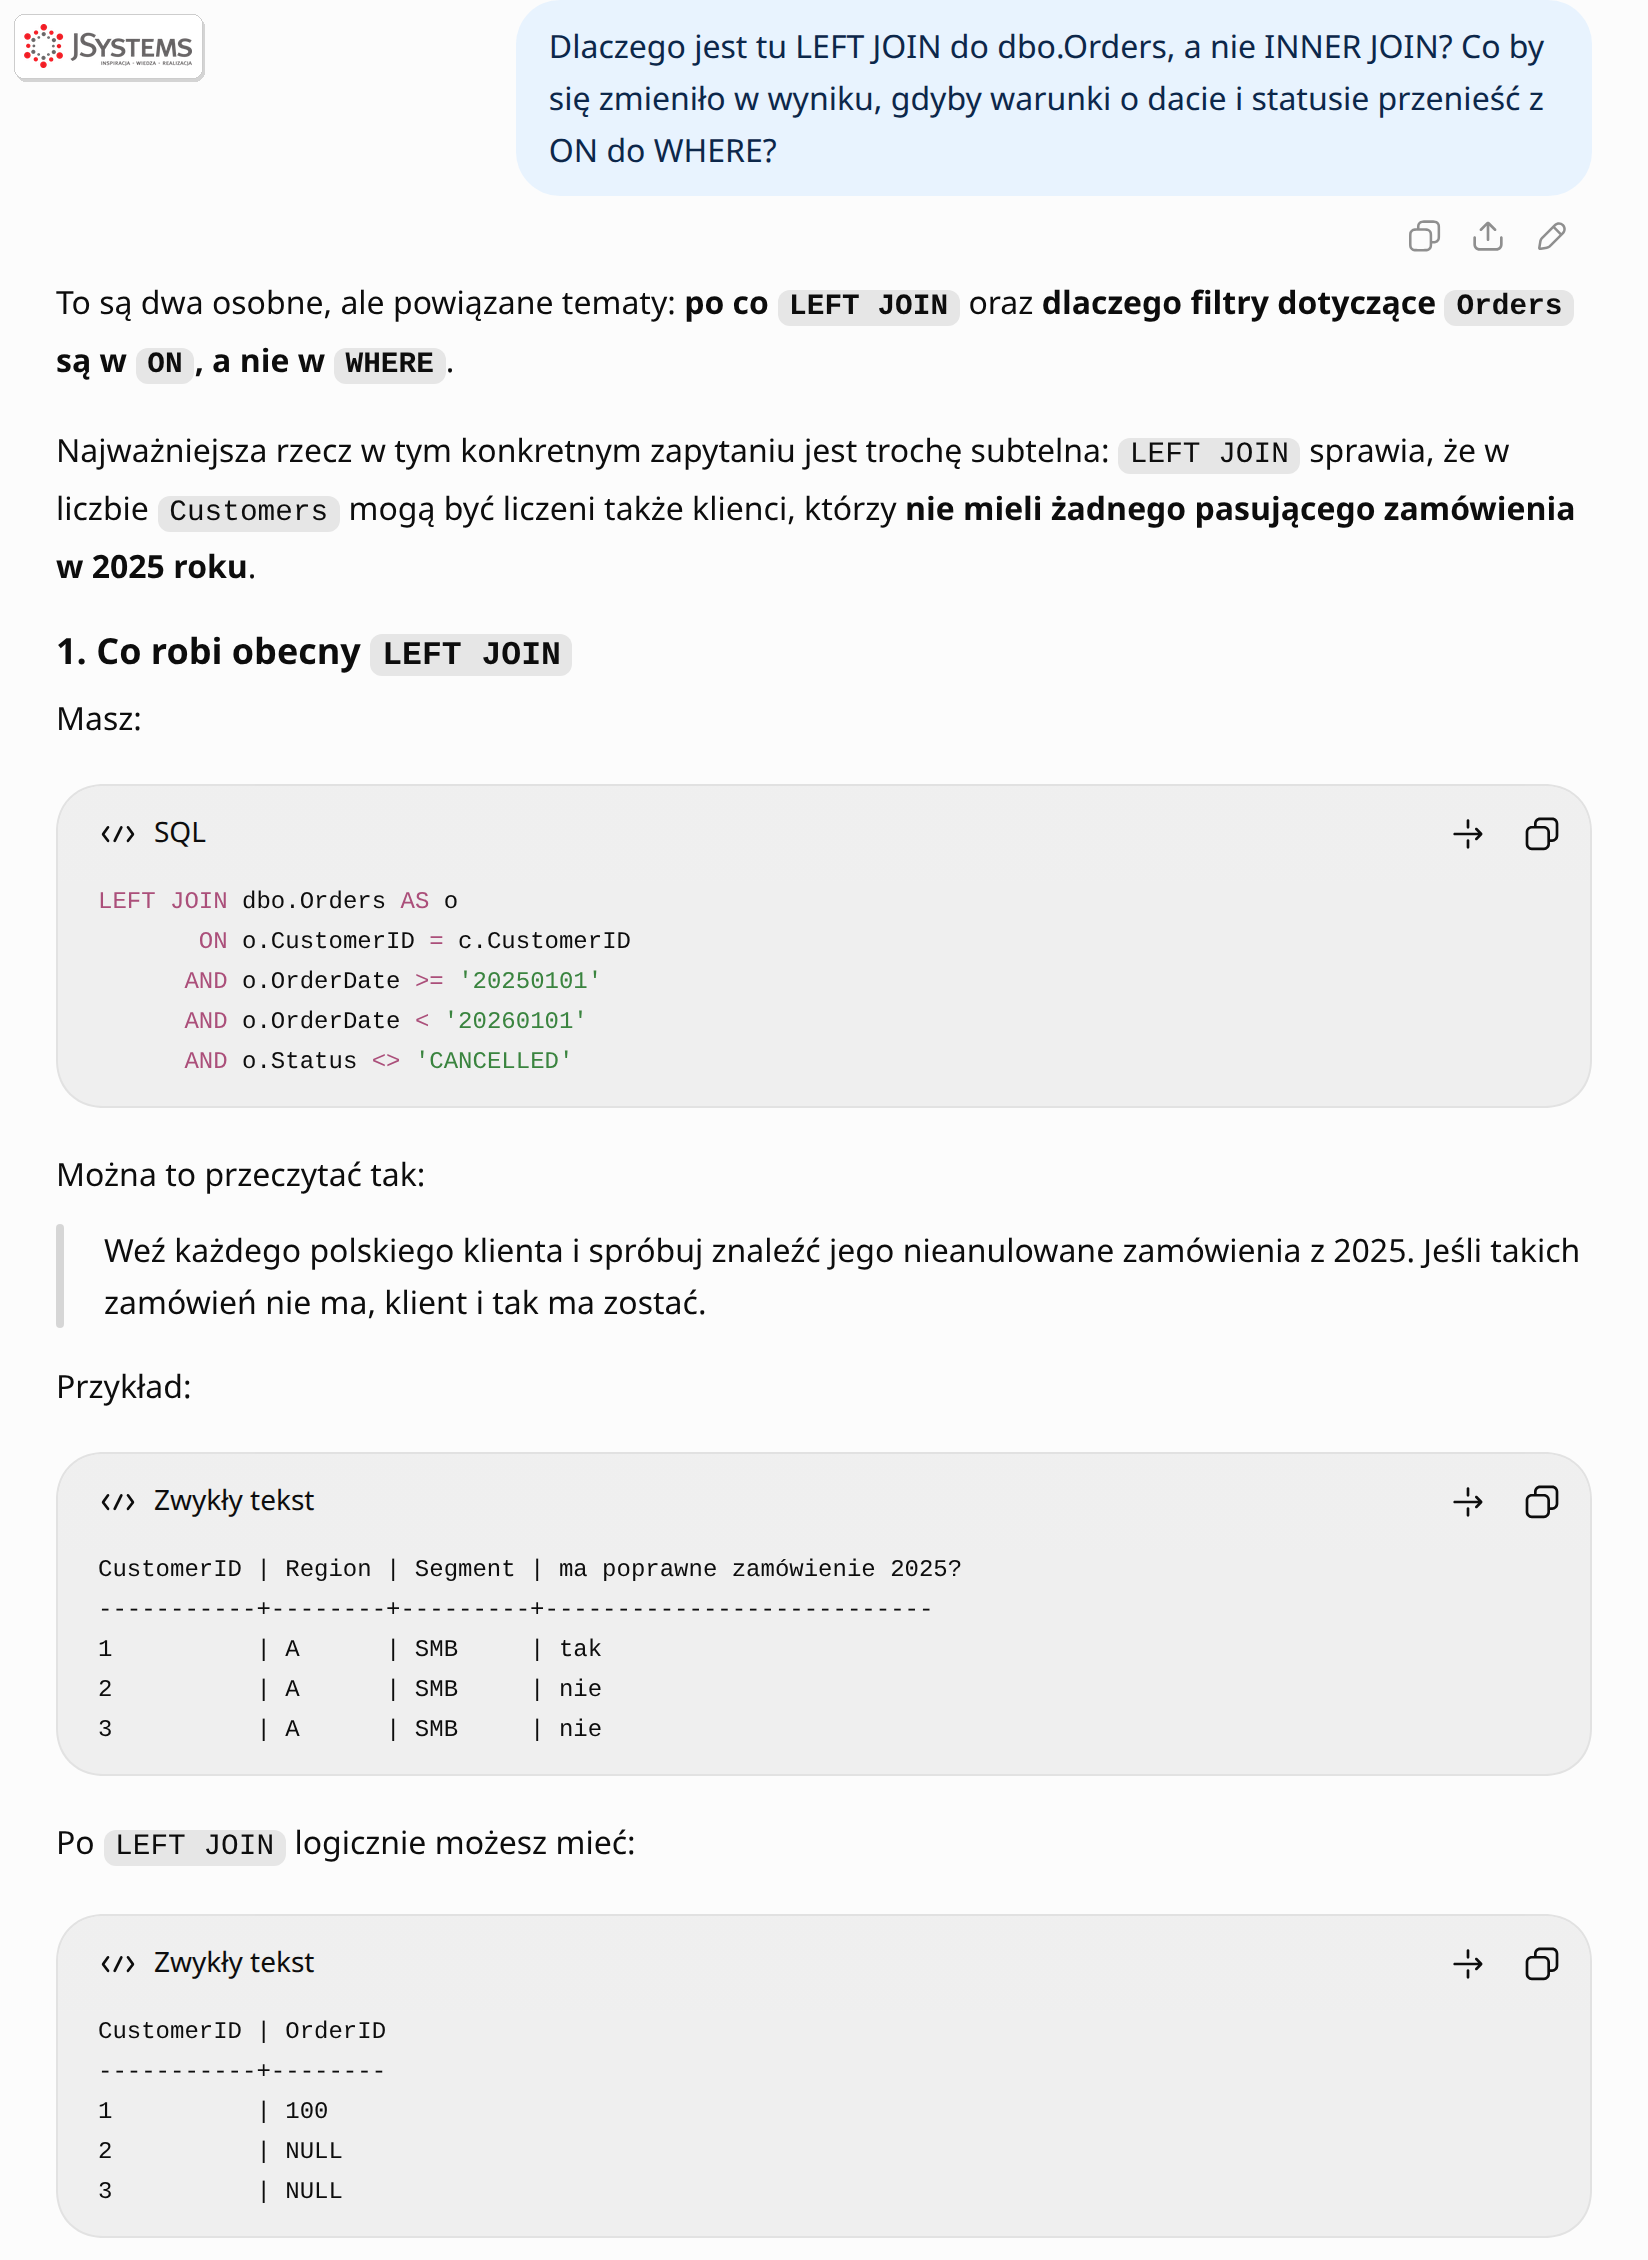
To odpowiedź, która zmienia sposób czytania raportu. Kolumna Customers nie oznacza „klientów, którzy kupili w 2025 roku”, tylko „wszystkich polskich klientów w grupie, o ile w grupie było choć jedno zamówienie”. Jeśli raport trafia do zarządu podpisany „liczba klientów 2025”, to podpis kłamie. Takie odkrycia są najcenniejszym efektem rozmowy z AI o cudzym kodzie: nie składnia, tylko znaczenie liczb.
Pokaż prostszą wersję tego zapytania, która zwraca dokładnie ten sam wynik.
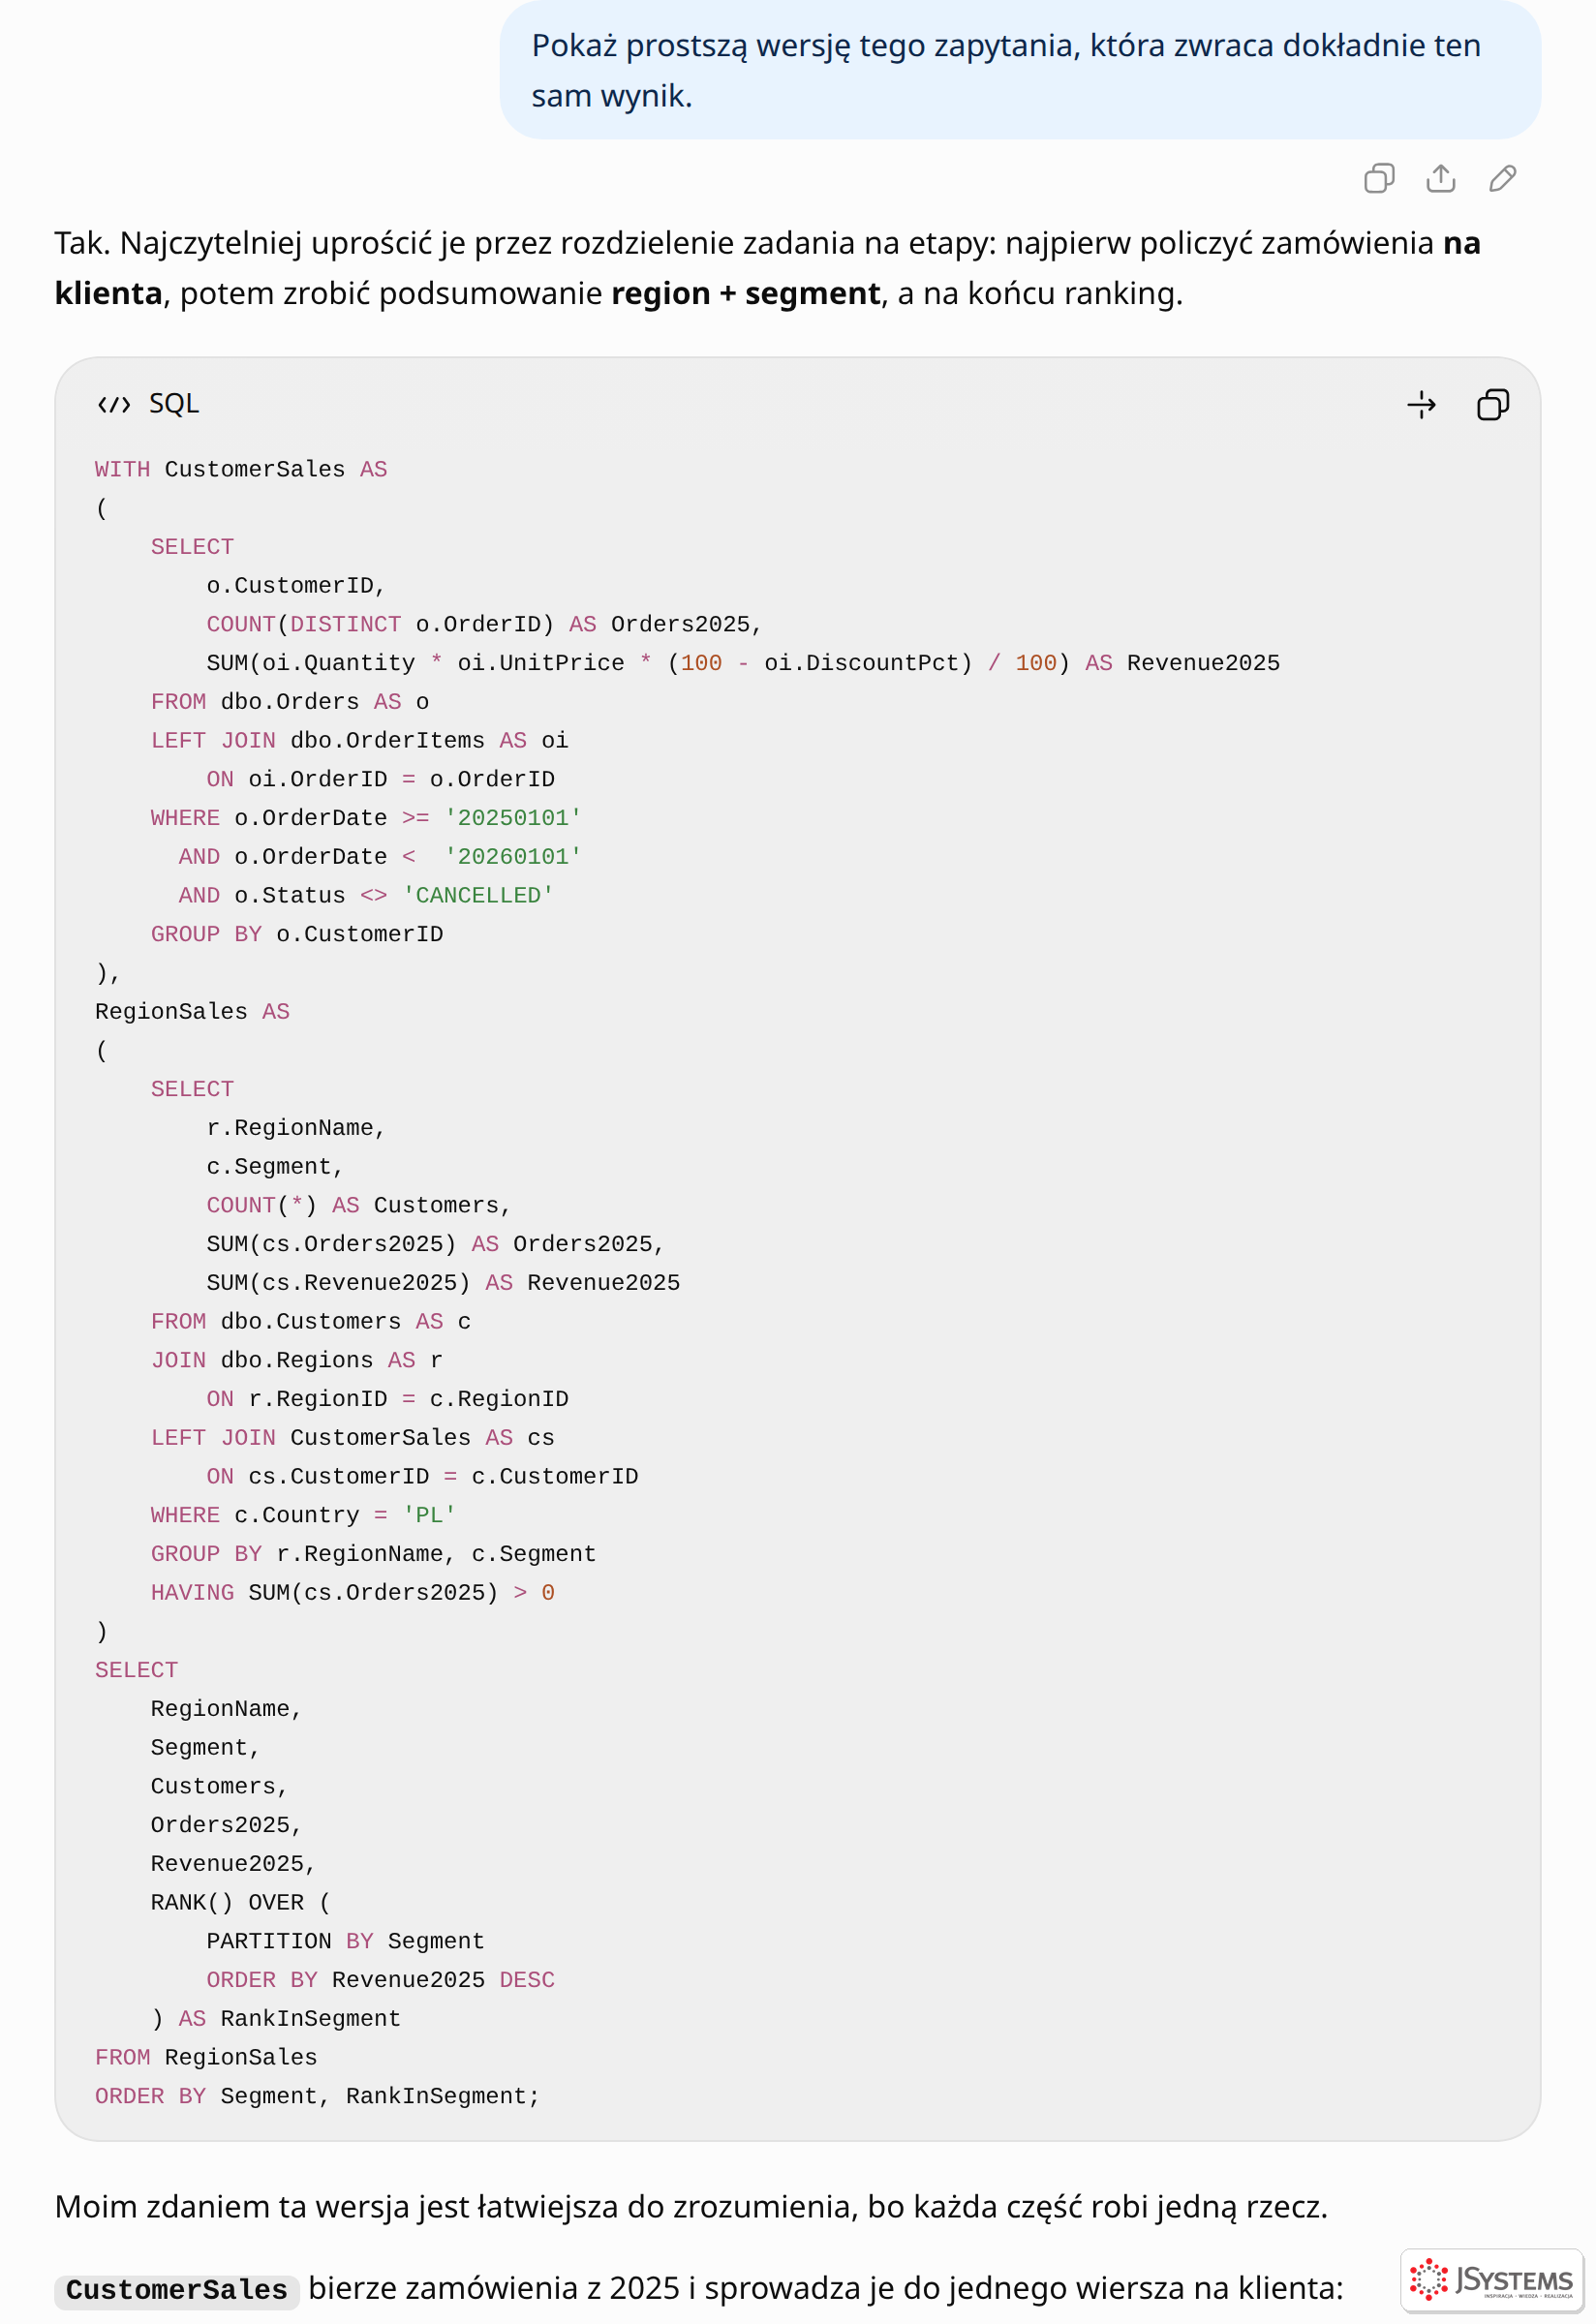
„Zwraca dokładnie ten sam wynik” to obietnica, którą trzeba sprawdzić, a nie przyjąć. Najprostszy dowód w SQL Server to operator EXCEPT użyty w obie strony: wiersze, które są w pierwszym wyniku, a nie ma ich w drugim, plus wiersze, które są w drugim, a nie ma ich w pierwszym. Zero wierszy oznacza, że oba wyniki są identyczne jako zbiory.
/* Szablon: dowód równoważności dwóch zapytań */
WITH Oryginal AS ( /* stare zapytanie bez ORDER BY */ ),
     Nowe     AS ( /* nowe zapytanie bez ORDER BY */ )
SELECT 'tylko w oryginale' AS Gdzie, * FROM (SELECT * FROM Oryginal EXCEPT SELECT * FROM Nowe) AS x
UNION ALL
SELECT 'tylko w nowej wersji', * FROM (SELECT * FROM Nowe EXCEPT SELECT * FROM Oryginal) AS y;
/* Dowód równoważności: wiersze, które są tylko w jednej z wersji */
WITH CustomerSales AS
(
SELECT
o.CustomerID,
COUNT(DISTINCT o.OrderID) AS Orders2025,
SUM(oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100) AS Revenue2025
FROM dbo.Orders AS o
LEFT JOIN dbo.OrderItems AS oi
ON oi.OrderID = o.OrderID
WHERE o.OrderDate >= '20250101'
AND o.OrderDate < '20260101'
AND o.Status <> 'CANCELLED'
GROUP BY o.CustomerID
),
RegionSales AS
(
SELECT
r.RegionName,
c.Segment,
COUNT(*) AS Customers,
SUM(cs.Orders2025) AS Orders2025,
SUM(cs.Revenue2025) AS Revenue2025
FROM dbo.Customers AS c
JOIN dbo.Regions AS r
ON r.RegionID = c.RegionID
LEFT JOIN CustomerSales AS cs
ON cs.CustomerID = c.CustomerID
WHERE c.Country = 'PL'
GROUP BY r.RegionName, c.Segment
HAVING SUM(cs.Orders2025) > 0
),
Nowe AS (
SELECT
RegionName,
Segment,
Customers,
Orders2025,
Revenue2025,
RANK() OVER (
PARTITION BY Segment
ORDER BY Revenue2025 DESC
) AS RankInSegment
FROM RegionSales
),
Oryginal AS (
SELECT r.RegionName,
c.Segment,
COUNT(DISTINCT c.CustomerID) AS Customers,
COUNT(DISTINCT o.OrderID) AS Orders2025,
SUM(oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100) AS Revenue2025,
RANK() OVER (PARTITION BY c.Segment
ORDER BY SUM(oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100) DESC) AS RankInSegment
FROM dbo.Customers AS c
JOIN dbo.Regions AS r ON r.RegionID = c.RegionID
LEFT JOIN dbo.Orders AS o
ON o.CustomerID = c.CustomerID
AND o.OrderDate >= '20250101' AND o.OrderDate < '20260101'
AND o.Status <> 'CANCELLED'
LEFT JOIN dbo.OrderItems AS oi ON oi.OrderID = o.OrderID
WHERE c.Country = 'PL'
GROUP BY r.RegionName, c.Segment
HAVING COUNT(DISTINCT o.OrderID) > 0
)
SELECT 'tylko w oryginale' AS Gdzie, * FROM (SELECT * FROM Oryginal EXCEPT SELECT * FROM Nowe) AS x
UNION ALL
SELECT 'tylko w nowej wersji', * FROM (SELECT * FROM Nowe EXCEPT SELECT * FROM Oryginal) AS y;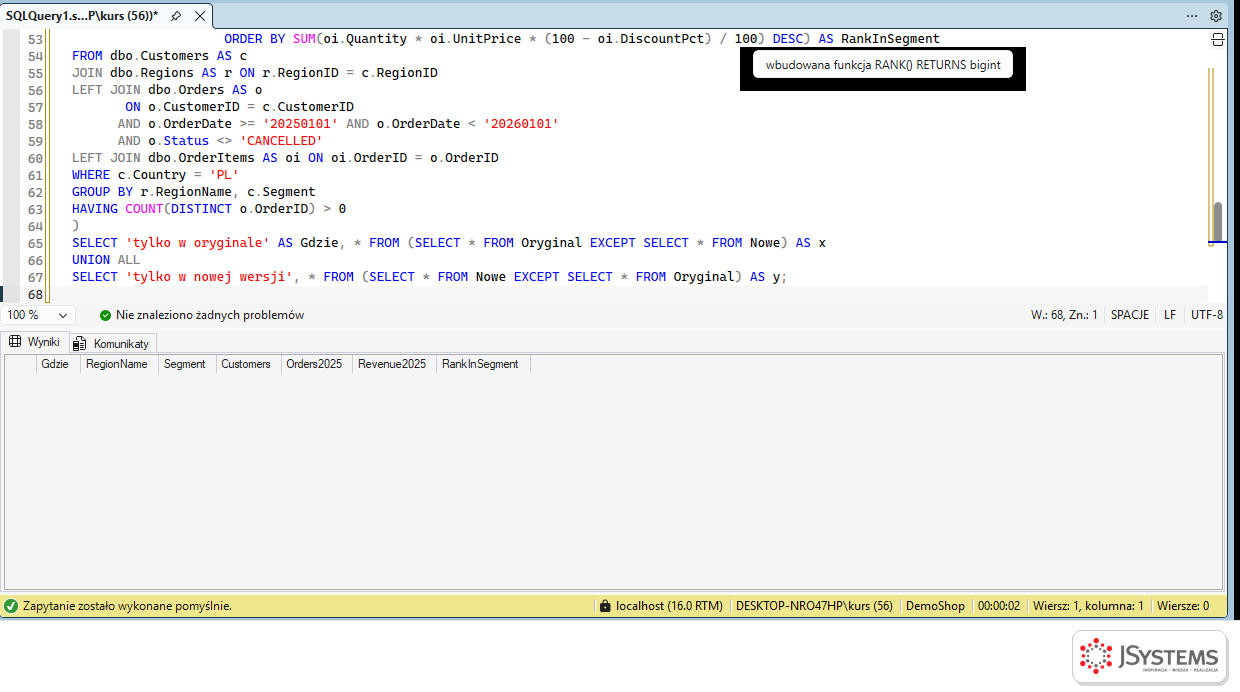
EXCEPT porównuje zbiory, więc nie zauważy, że jedna wersja zwraca wiersz dwa razy, a druga raz. Jeśli to możliwe w Twoim zapytaniu, porównaj dodatkowo liczbę wierszy obu wersji albo dodaj do obu kolumnę COUNT(*) OVER (PARTITION BY ...). Sumy kontrolne tego typu rozwijamy w sekcji o refaktoryzacji.Narysuj zależności między tabelami użytymi w tym zapytaniu jako diagram Mermaid (erDiagram) z kluczami i licznościami relacji.
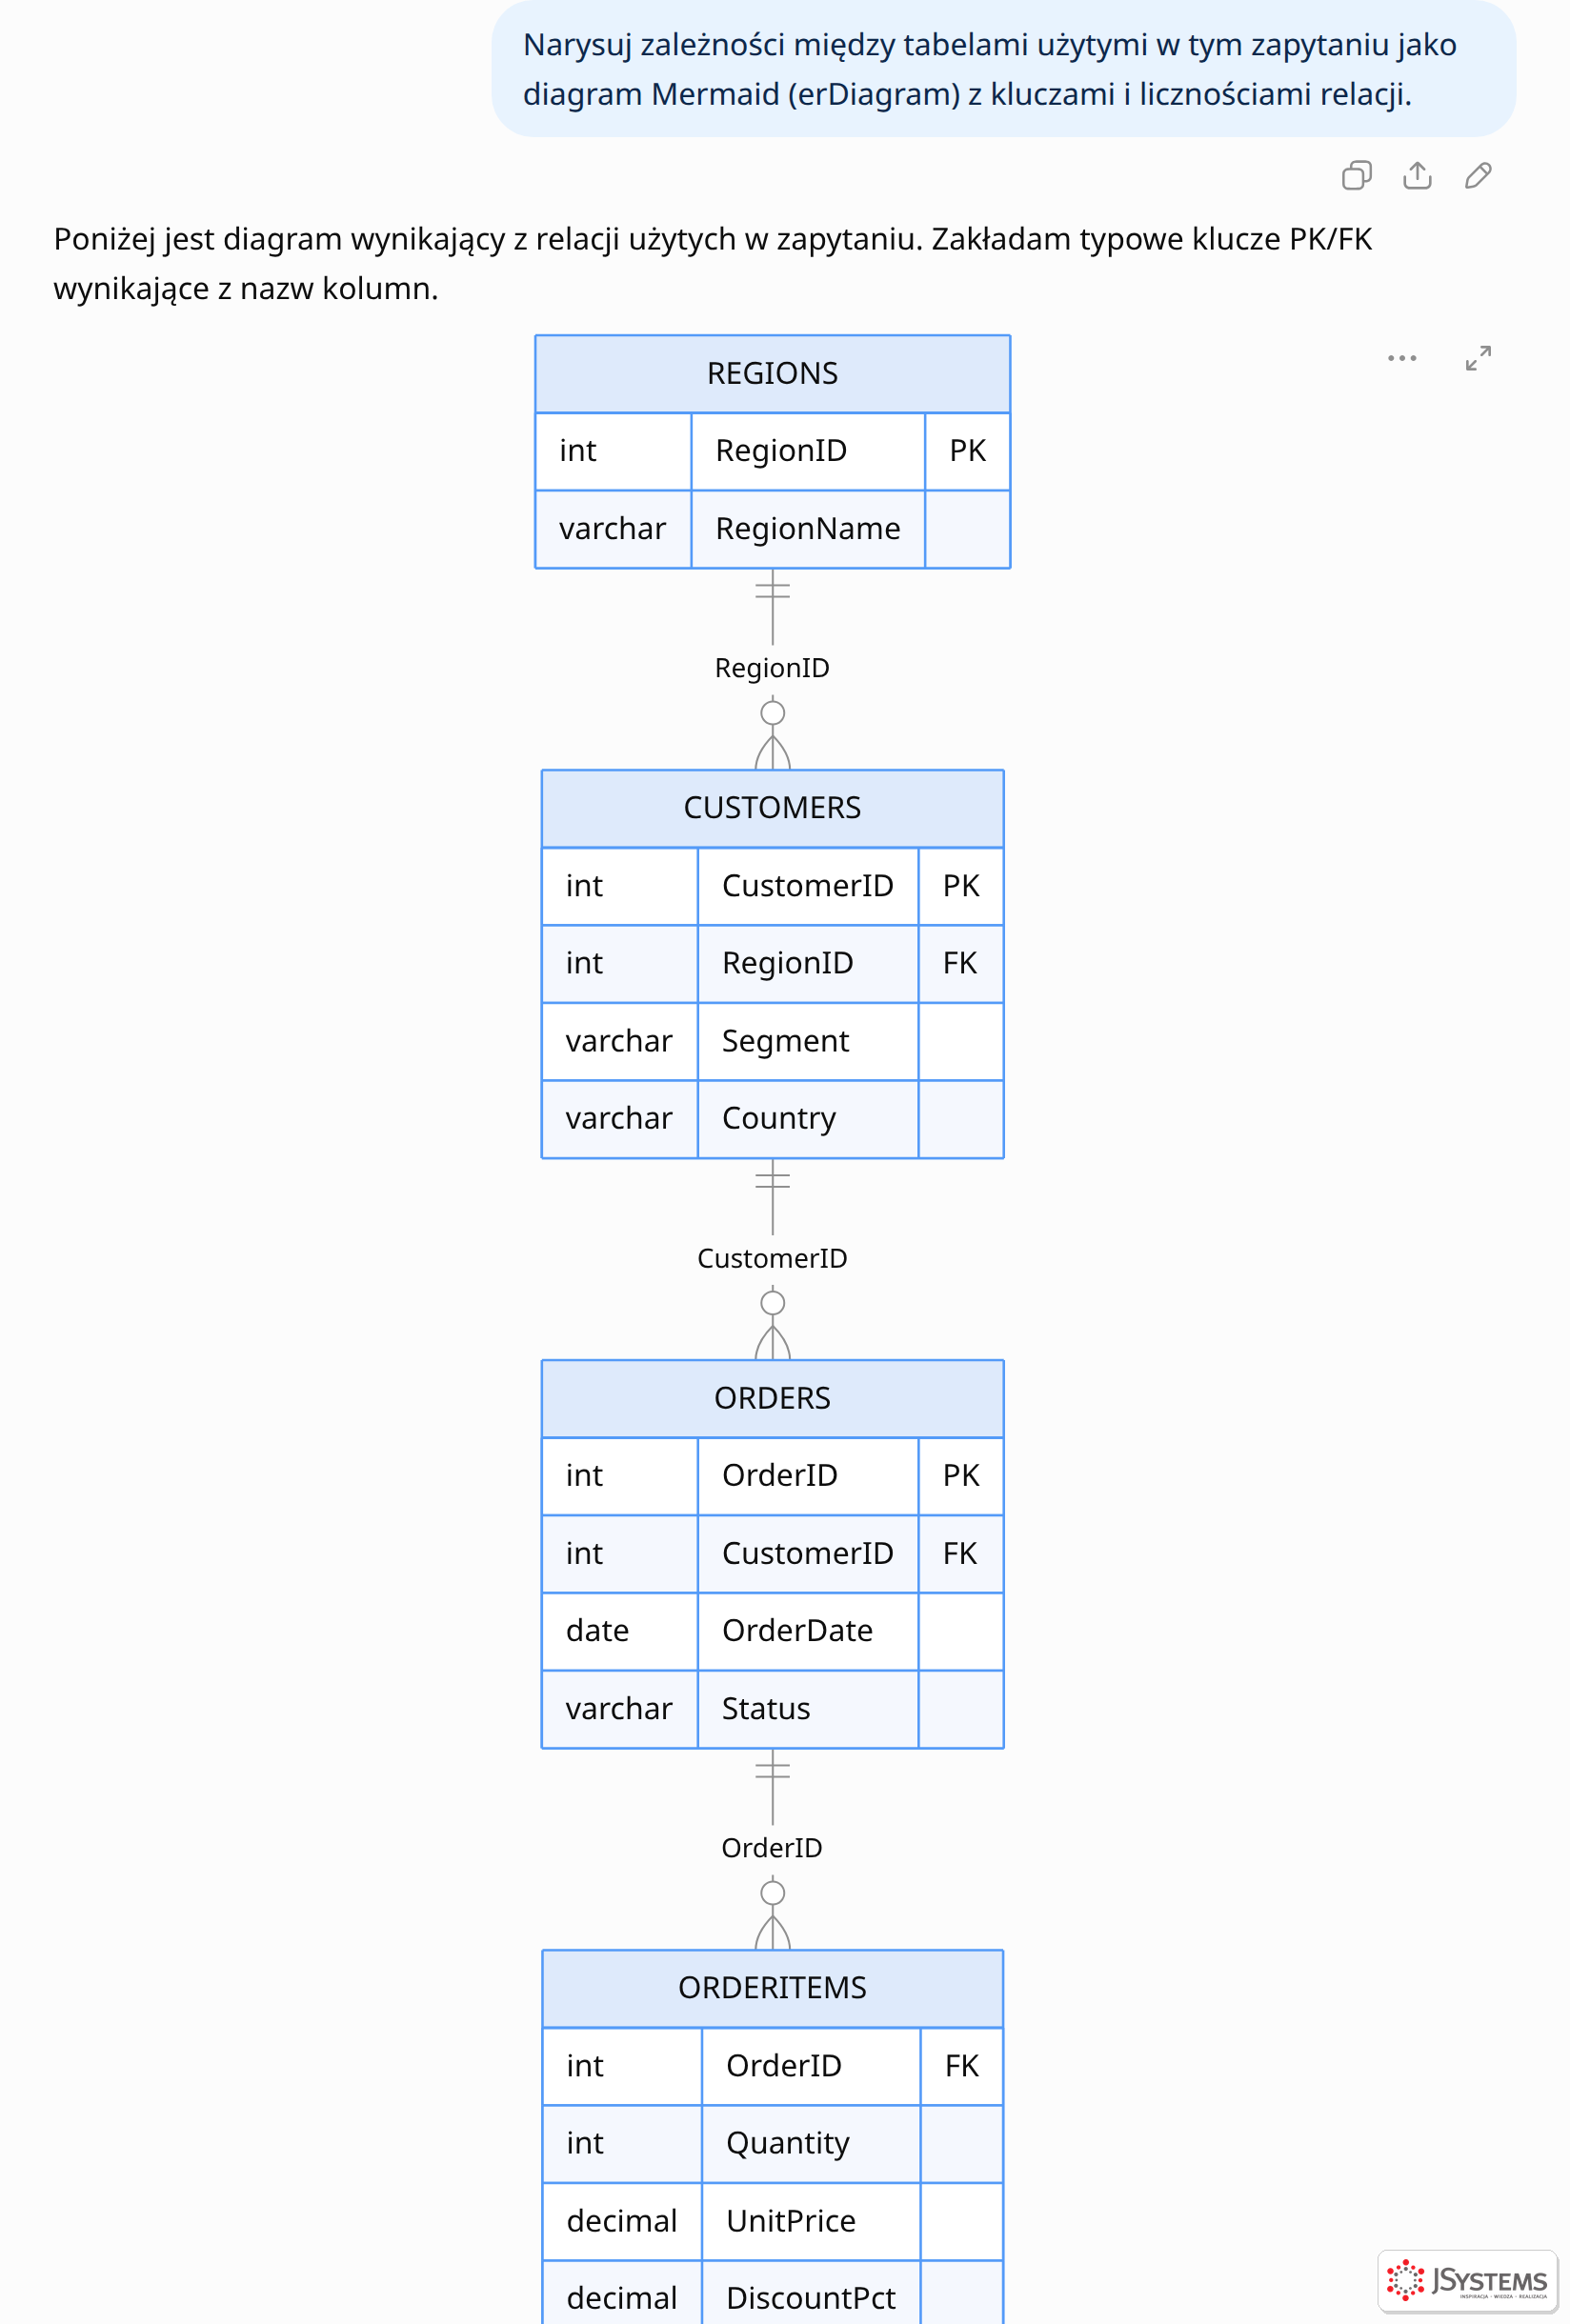
Diagram jest poprawny co do relacji, bo te wynikają z warunków złączeń w kodzie. Typy kolumn AI dopisało z założenia i samo o tym uprzedza w odpowiedzi („zakładam typowe klucze”). Jeśli diagram ma trafić do dokumentacji, poproś o niego z załączonym opisem schematu, a nie z samego zapytania.
Przepisz to zapytanie z użyciem CTE tak, żeby każdy etap obliczeń był osobnym, nazwanym krokiem z komentarzem.
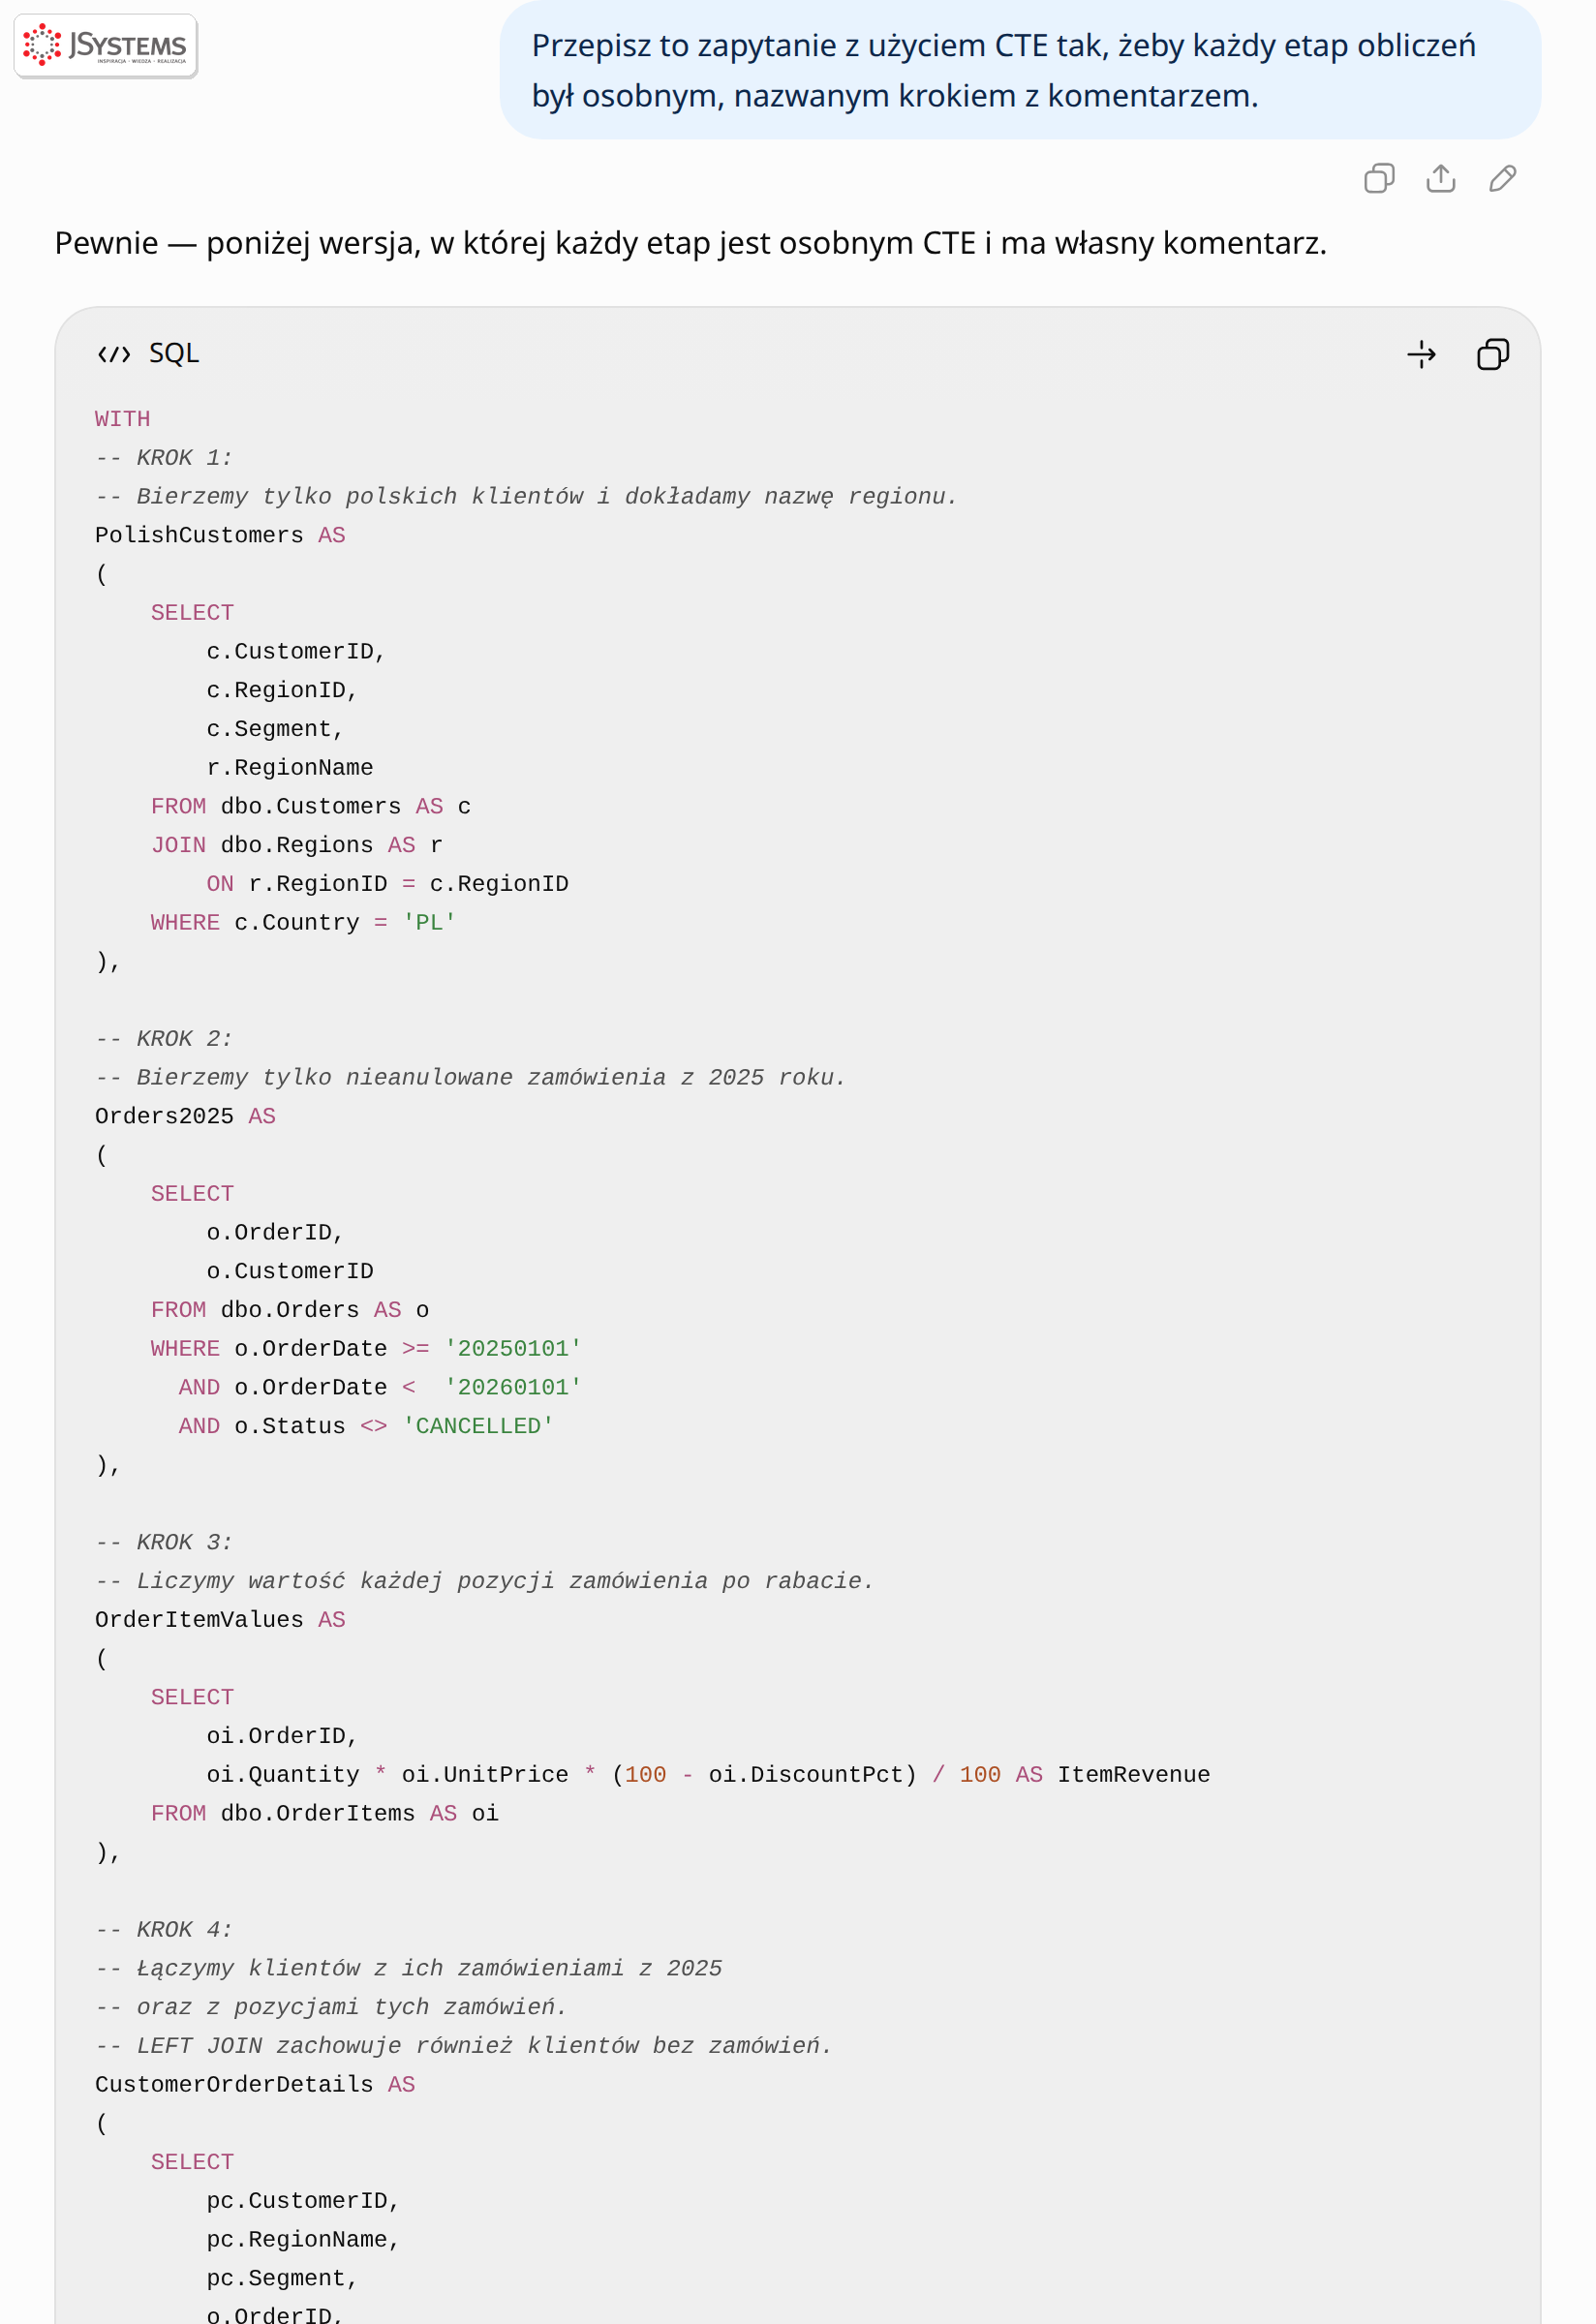
Wersję z CTE przepuściliśmy przez ten sam test EXCEPT. Wynik: zero różnic. Takie przepisanie to dobry pierwszy krok przy przejmowaniu cudzego kodu. Każdy etap możesz uruchomić osobno (zamieniając końcowe SELECT na SELECT * FROM NazwaKroku) i zobaczyć dane pośrednie.
Ostatnie pytanie dotyczy już nie tego, co zapytanie liczy, ale jak serwer to robi. Plan wykonania to opis operacji, które SQL Server wykonuje, żeby zwrócić wynik. Jak go pobrać i zapisać do pliku, pokazujemy szczegółowo w sekcji o planie wykonania. Tu załączamy gotowy plik .sqlplan z rzeczywistego wykonania zapytania.
Załączam plik z rzeczywistym planem wykonania tego zapytania (raport_regiony_2025.sqlplan, zapisany w SSMS). Wyjaśnij go po ludzku: co serwer robi krok po kroku, który operator kosztuje najwięcej i dlaczego, i czy coś w planie jest niepokojące.
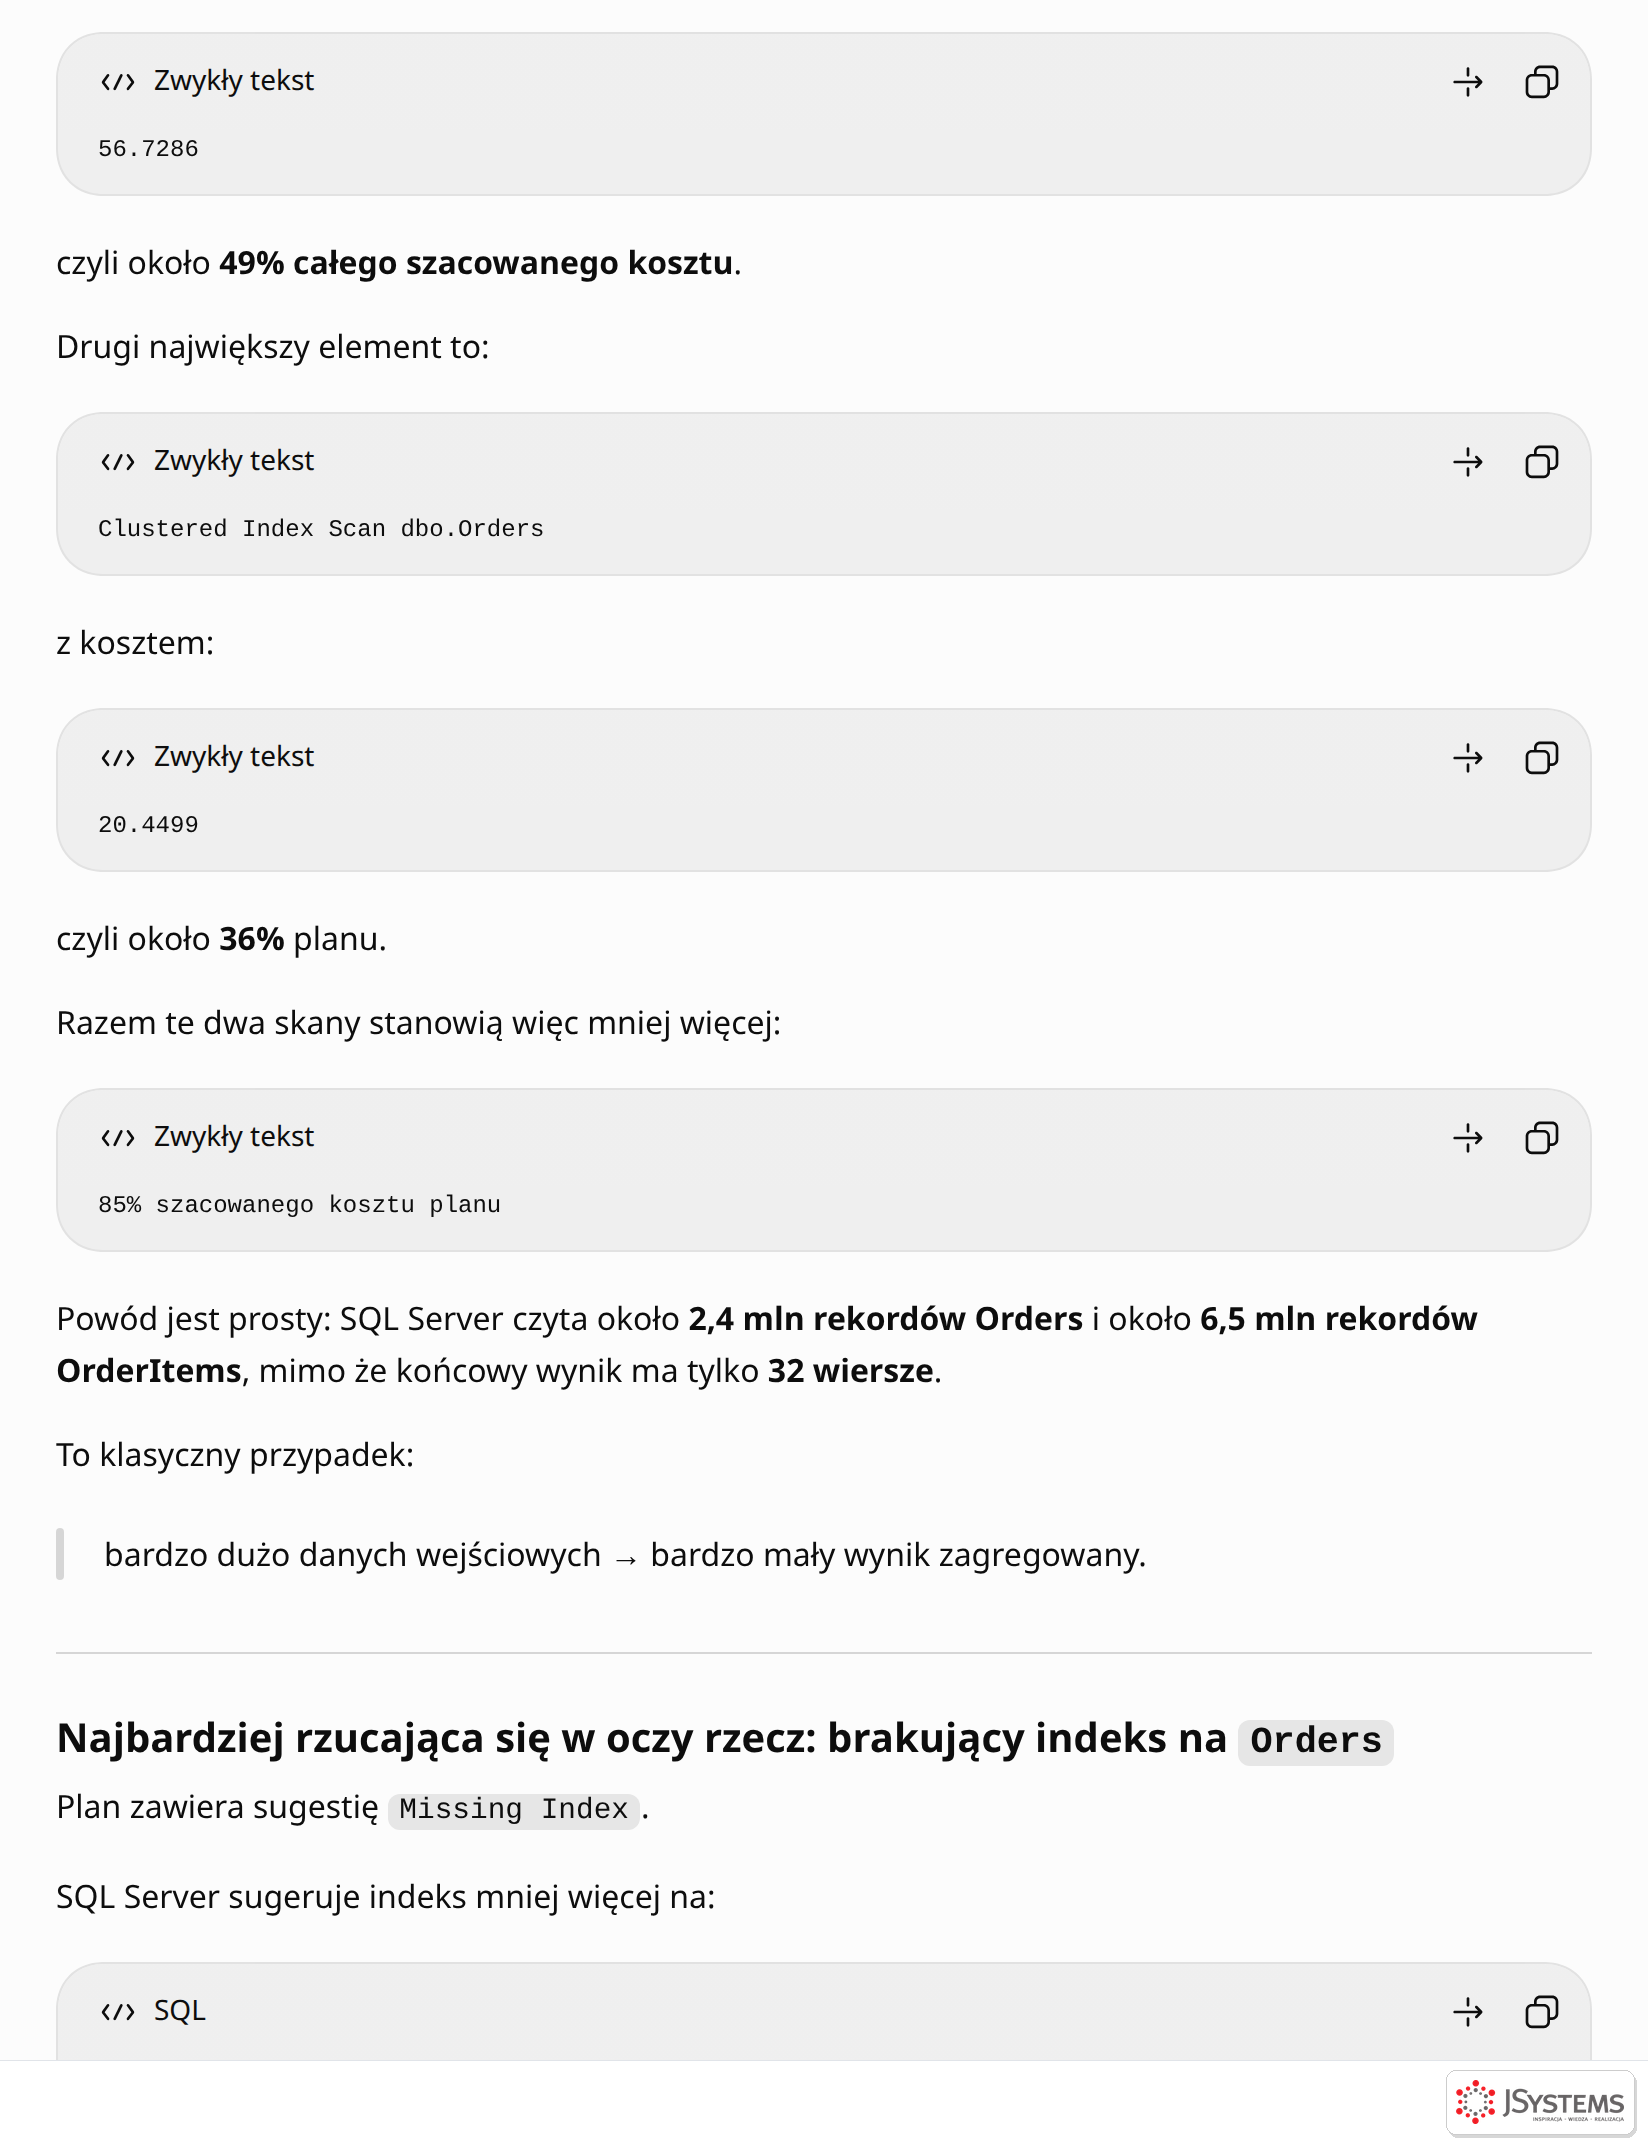
Każdą liczbę z tej odpowiedzi porównaliśmy z plikiem planu i wszystkie się zgadzają: stopień równoległości 4, 696 ms czasu i 2697 ms czasu procesora, 723 421 z 2,4 mln zamówień po filtrze, 1 960 873 wiersze po złączeniu z pozycjami, 994 MB przydzielonej pamięci przy 116 MB użytych. Co ważne, ChatGPT nie poprzestał na słowie „skan”, tylko policzył, jaką część kosztu planu stanowi każdy operator, i zaznaczył, że sugestii brakującego indeksu nie należy kopiować bez sprawdzenia innych zapytań. To dokładnie ten sposób pracy, który rozwijamy w części o optymalizacji.
Część 2 z 8 przewodnika AI w SQL


Komentarze (0)
Brak komentarzy...