
Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
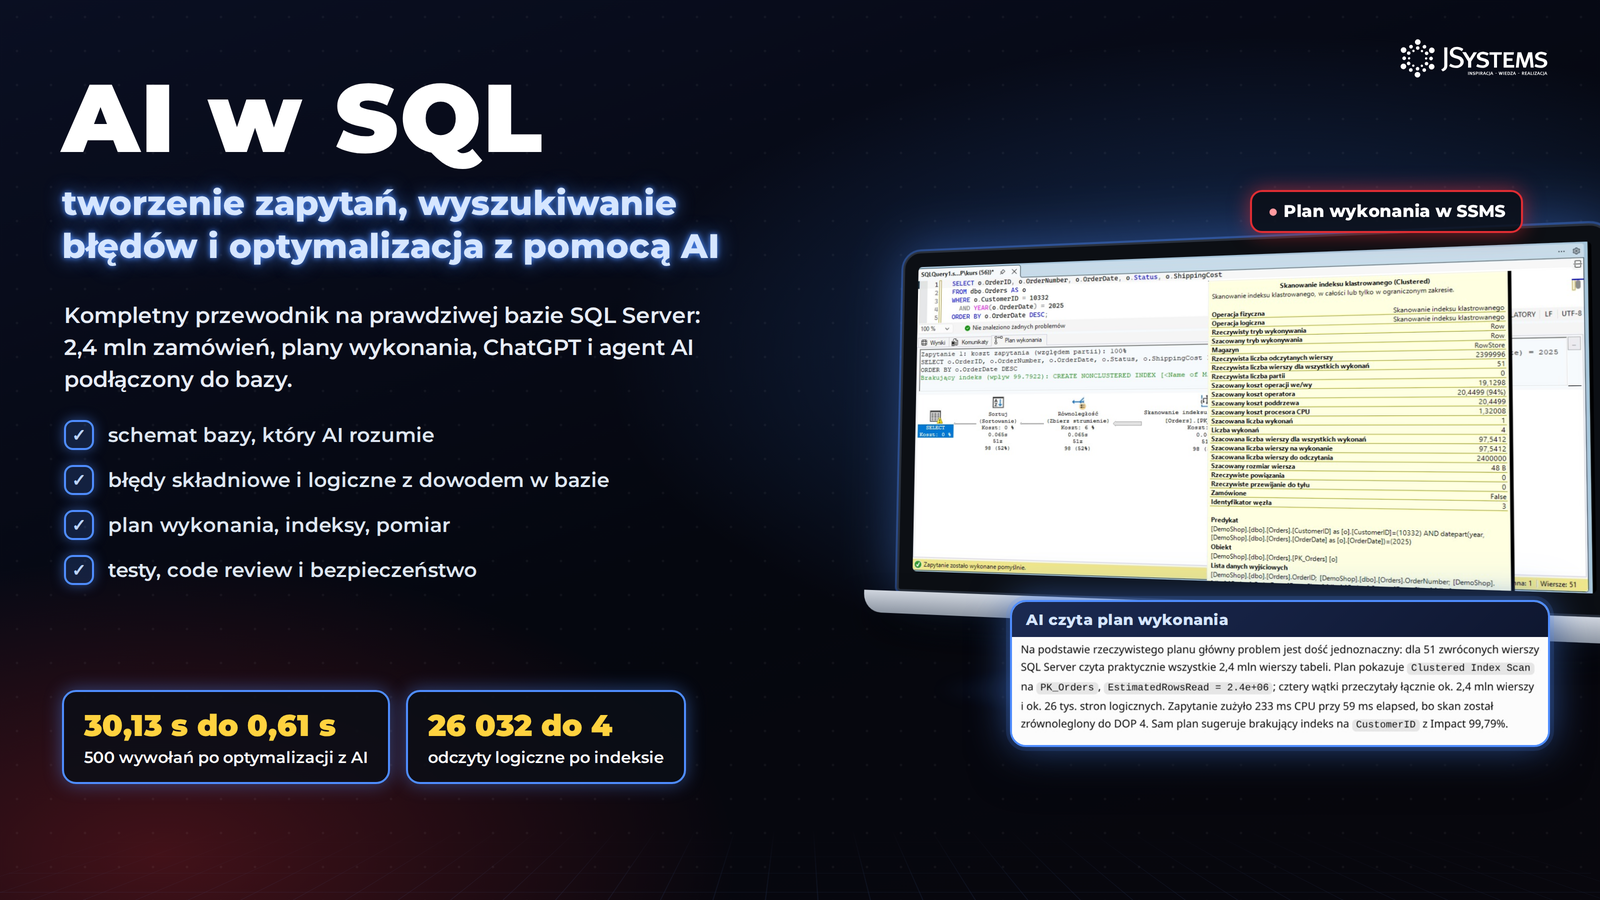
W skrócieAI przyspiesza pisanie, czytanie, poprawianie i optymalizację zapytań SQL, ale tylko wtedy, gdy dostaje kontekst: schemat bazy, dialekt, wersję serwera, reguły liczenia i plan wykonania. Każdą propozycję AI sprawdzasz na bazie: wynikiem, planem i pomiarem czasu. Pokazujemy to na 2,4 mln zamówień w SQL Server.
W tym przewodniku nie ma ani jednego przykładu „na sucho”. Każde polecenie, które wpisujemy do ChatGPT, każda odpowiedź i każdy wynik w SQL Server Management Studio pochodzą z prawdziwych sesji, które przeprowadziliśmy na potrzeby tego tekstu. Pracujemy na bazie DemoShop: fikcyjnym sklepie internetowym z 200 tysiącami klientów, 2,4 mln zamówień z lat 2023-2026, 6,5 mln pozycji zamówień, płatnościami, wysyłkami i zwrotami. Taki rozmiar wystarcza, żeby złe zapytanie było naprawdę wolne, a zły plan wykonania był widoczny gołym okiem. Skrypt tworzący identyczną bazę udostępniamy do pobrania, więc każdy wynik możesz odtworzyć u siebie co do wiersza.
Narzędzia są zwyczajne i dostępne dla każdego: SQL Server 2022 w darmowej edycji Developer, SQL Server Management Studio 22 (dalej SSMS) w polskiej wersji językowej i ChatGPT w planie Business, czyli takim, jaki firmy kupują pracownikom. Używamy ChatGPT, ale identyczne polecenia możesz podać na przykład Microsoft Copilotowi, Claude albo Gemini: kopiujesz treść z ramki „do skopiowania” i załączasz te same pliki. Odpowiedzi będą sformułowane inaczej, ale sedno nie leży w wyborze modelu, tylko w tym, co modelowi podajesz i jak sprawdzasz to, co odda.
Przykłady uruchamiamy w SQL Server, a przy każdym skrypcie, który korzysta z mechanizmów samego serwera (opis schematu, plan wykonania, statystyki, blokady, uprawnienia, maskowanie), w małej szarej ramce znajdziesz jego odpowiednik dla Oracle i PostgreSQL. Te skrypty sprawdziliśmy na Oracle AI Database 26ai Free i PostgreSQL 15.
Z tego przewodnika dowiesz się (każdy punkt prowadzi do właściwej części):
Przewodnik podzieliliśmy na osiem części. Każdą możesz czytać osobno, a ta strona zbiera to, co dotyczy całości: co AI potrafi przy SQL, kiedy się myli i 20 gotowych poleceń.
Pliki do pobrania
Każda część ma też własną ramkę z plikami, których w niej używamy.
Wszystko, czego używamy w przykładach. Skrypt bazy uruchamiasz w SSMS na pustym serwerze SQL Server 2019 lub nowszym; tworzy bazę DemoShop z kompletem tabel, kluczy, opisów kolumn i danych.
Duży model językowy, czyli silnik ChatGPT, Copilota czy Claude, nauczył się SQL z ogromnej ilości kodu, dokumentacji i dyskusji programistów. Dzięki temu bardzo dobrze zna składnię wszystkich popularnych baz, typowe wzorce zapytań i typowe pułapki. Nie zna natomiast Twojej bazy: nazw tabel, znaczenia kolumn, reguł, według których firma liczy sprzedaż, rozkładu danych ani konfiguracji serwera. Wszystko, co w odpowiedzi zależy od tych rzeczy, AI musi albo dostać od Ciebie, albo zgadnąć. Większość złych doświadczeń z AI przy SQL to właśnie skutek zgadywania.
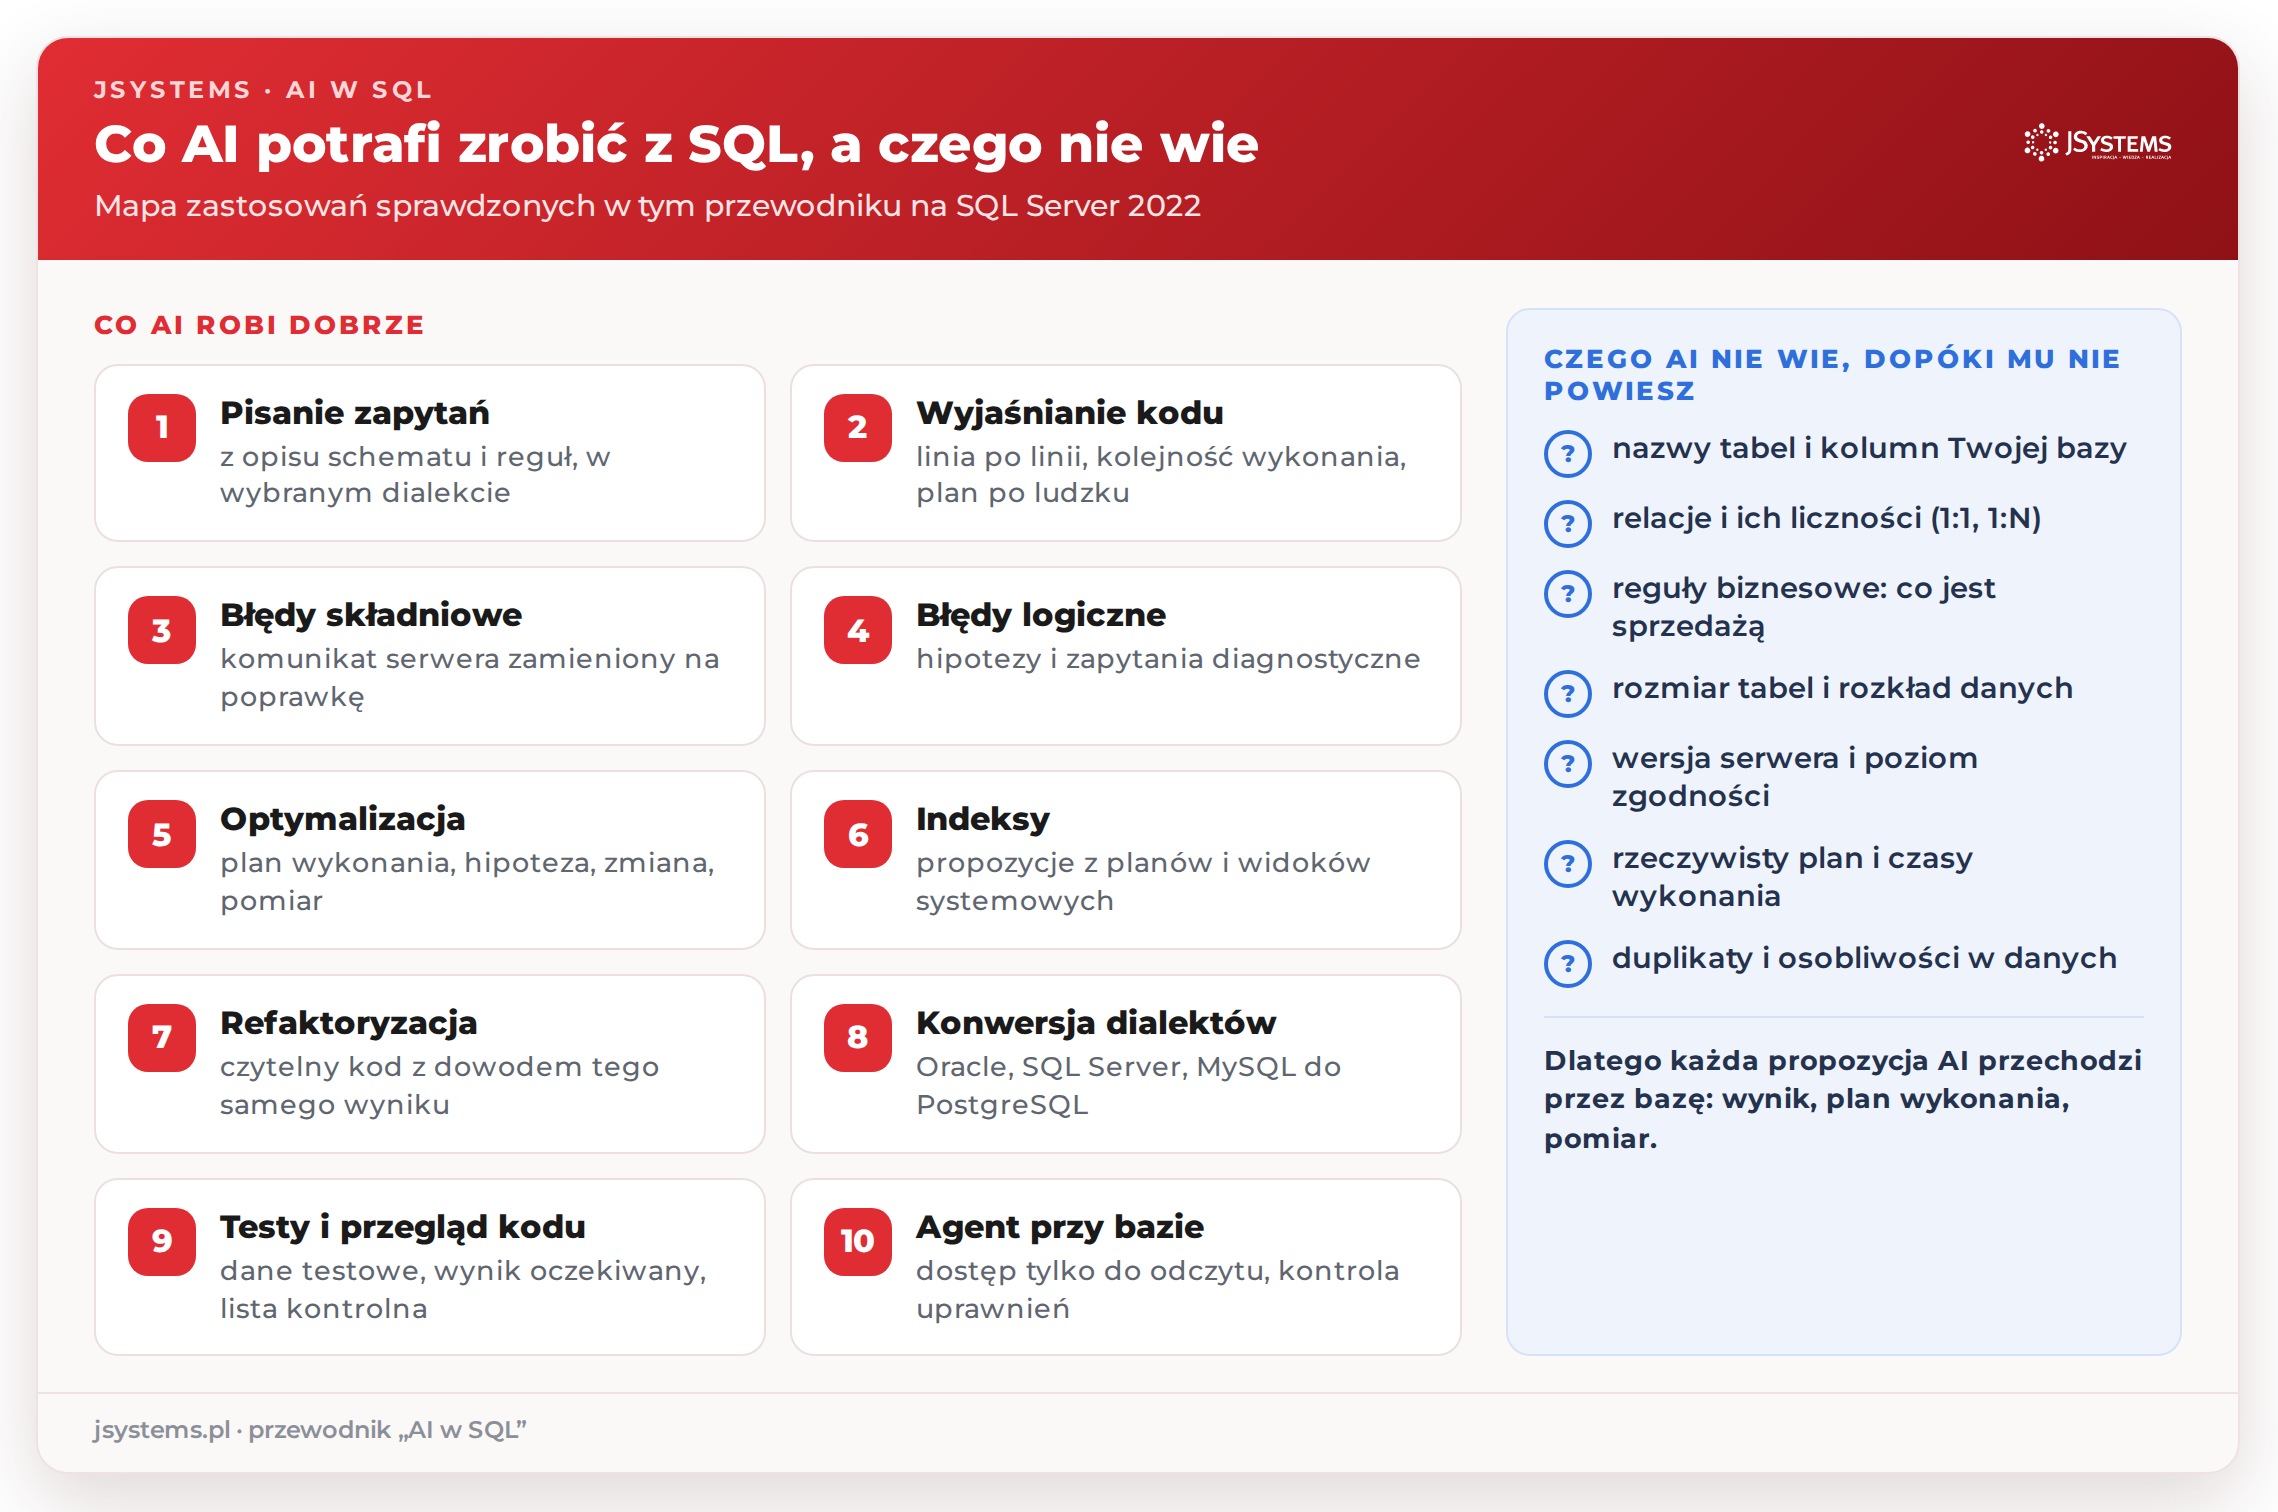
Z naszych prób na bazie DemoShop wychodzi prosty podział. AI radzi sobie świetnie z zadaniami, w których cała potrzebna wiedza jest w poleceniu: napisaniem zapytania, gdy zna schemat i reguły, przetłumaczeniem go na inny dialekt, wyjaśnieniem cudzego kodu, znalezieniem błędu na podstawie komunikatu serwera, wskazaniem podejrzanych miejsc w planie wykonania. Gorzej idzie mu tam, gdzie odpowiedź zależy od faktów, których w poleceniu nie było: czy w danych są duplikaty, ile wierszy ma tabela, czy indeks w ogóle istnieje, co znaczy status „PAID”. Wtedy AI odpowiada równie pewnym tonem, ale opiera się na założeniach, a te bywają błędne.
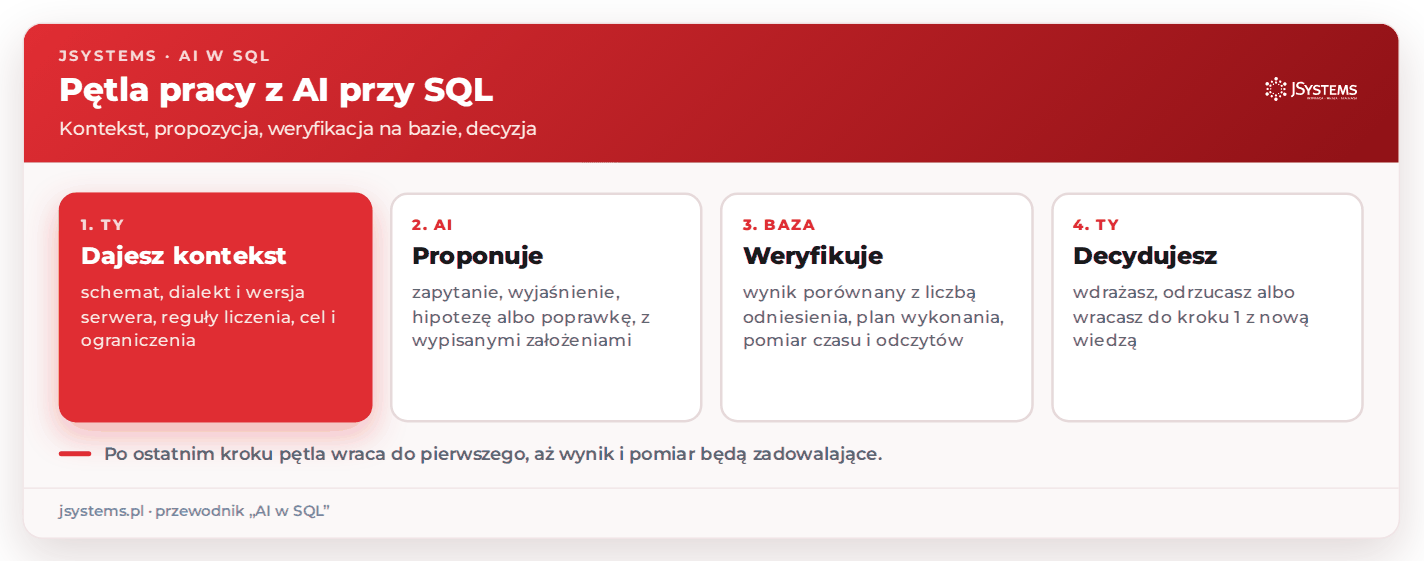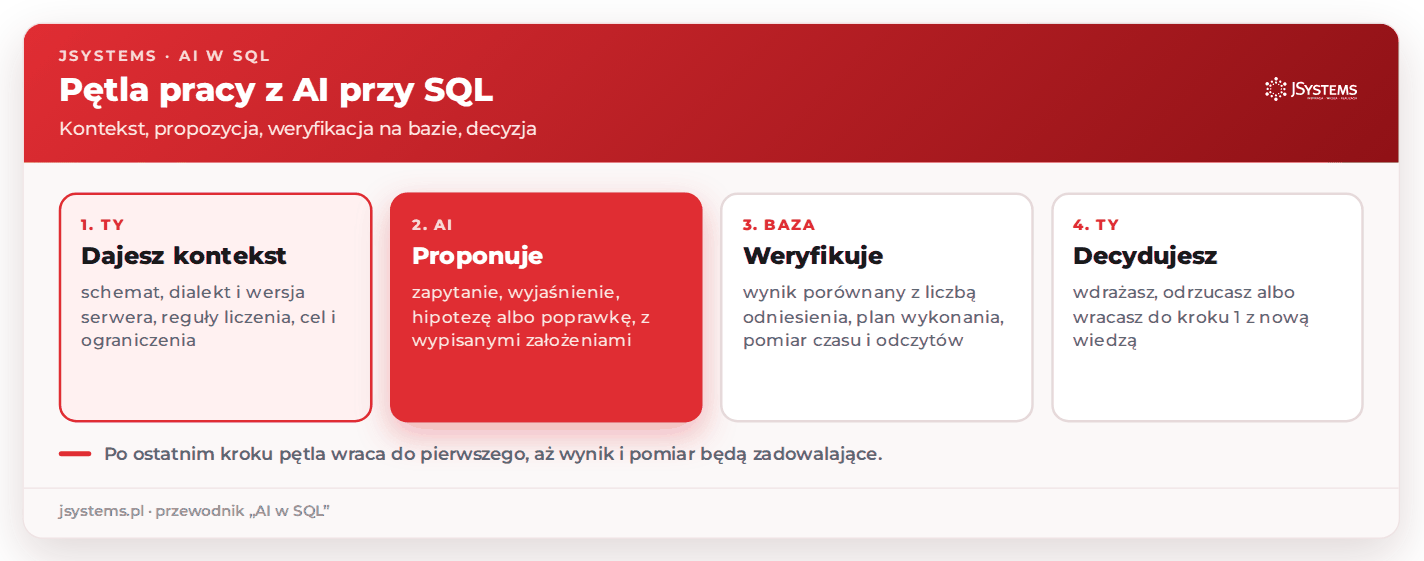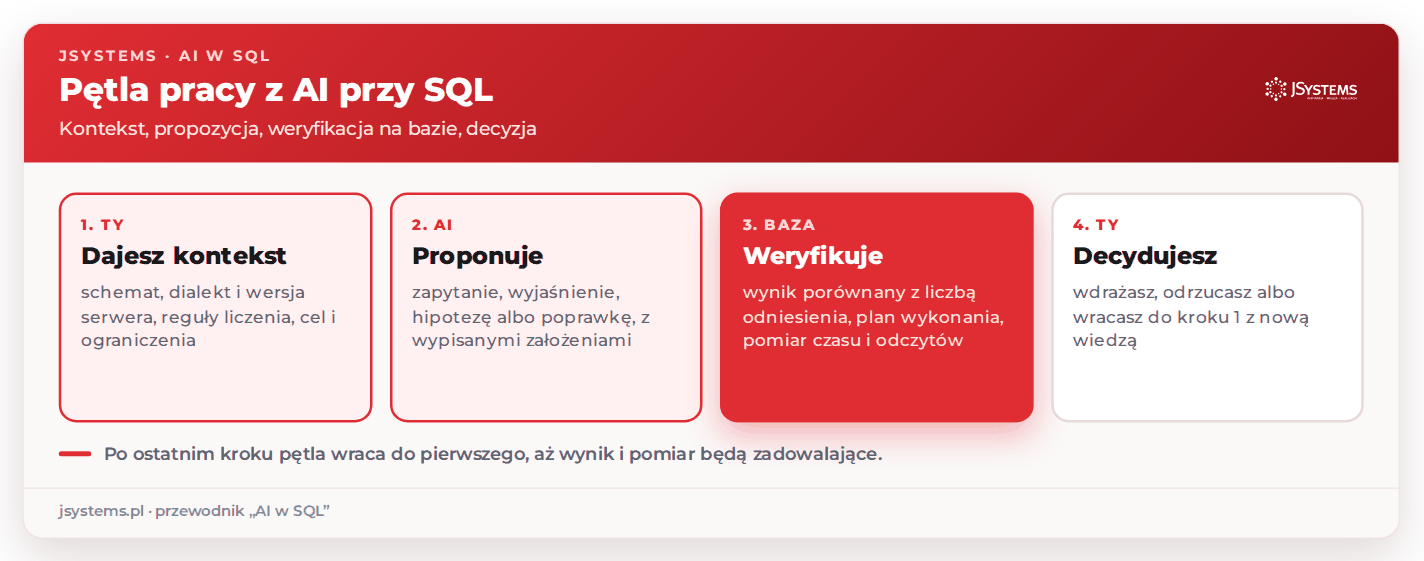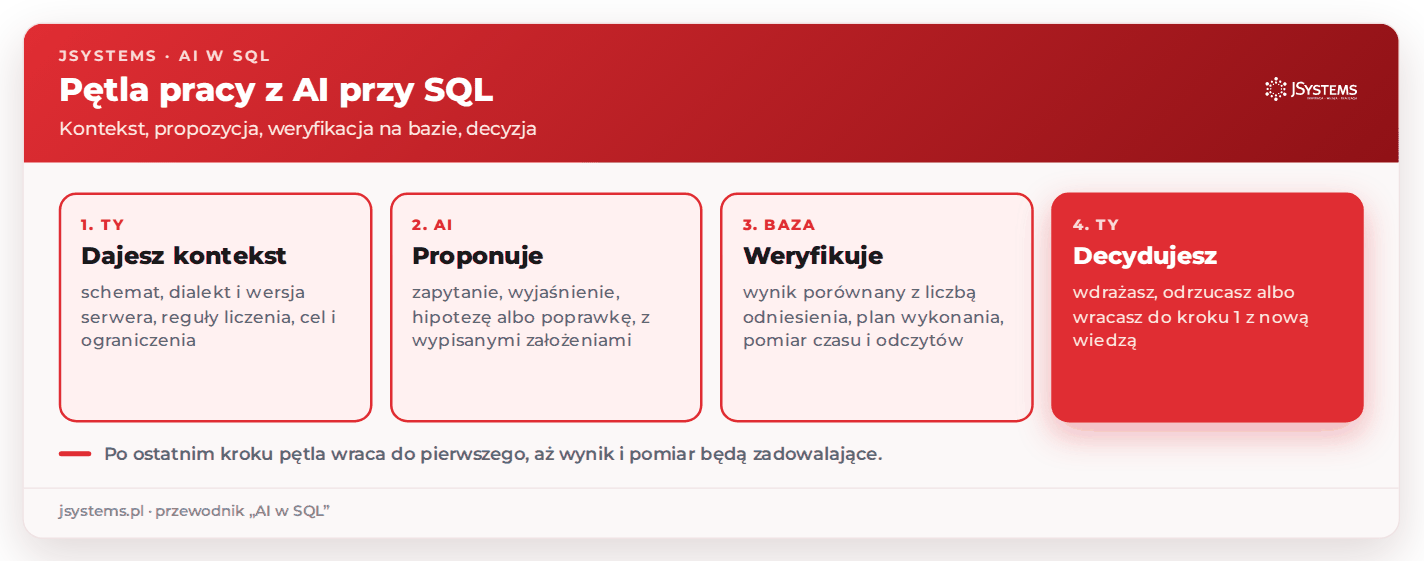
Dlatego w całym przewodniku pracujemy w jednej pętli. Ty dajesz kontekst, AI proponuje, baza danych weryfikuje, a Ty decydujesz. Ostatnie słowo zawsze ma serwer: wynik zapytania, plan wykonania i pomiar czasu, nie pewność siebie modelu.
| Zadanie | Co AI robi dobrze | Czego AI nie wie, dopóki mu nie powiesz |
|---|---|---|
| Pisanie zapytań | Składnia, JOIN-y, CTE, funkcje okienkowe, warunki zakresowe na datach | Nazwy tabel i kolumn, reguły biznesowe (co jest sprzedażą), wersja serwera |
| Błędy składniowe | Interpretacja komunikatu serwera, wskazanie miejsca i poprawki | Który dialekt i wersja, jakie kolumny naprawdę istnieją |
| Błędy logiczne | Typowe pułapki: NULL, mnożenie wierszy przez JOIN, granice dat, funkcje okienkowe | Jakie liczby są prawidłowe, czy w danych są duplikaty, jak wygląda relacja 1:N |
| Optymalizacja | Czytanie planu, hipotezy, przepisanie zapytania, propozycje indeksów | Rzeczywisty plan, liczba wierszy, obciążenie zapisem, czas wykonania |
| Refaktoryzacja i konwersja | Czytelny kod, CTE, przekład między dialektami | Czy wynik po zmianie jest identyczny (to sprawdza baza) |
W trakcie pisania tego przewodnika AI rozwiązało poprawnie zdecydowaną większość zadań: pisało zapytania, które dawały zgodne wyniki w czterech bazach, czytało plany wykonania, znajdowało błędy logiczne i podatności. Pomyłki też były i właśnie one są najbardziej pouczające, bo układają się w kilka powtarzalnych wzorców. Kto je zna, wie, gdzie sprawdzać.
| Nr | Sytuacja | Co zrobiło AI | Jak to wyłapać | Gdzie |
|---|---|---|---|---|
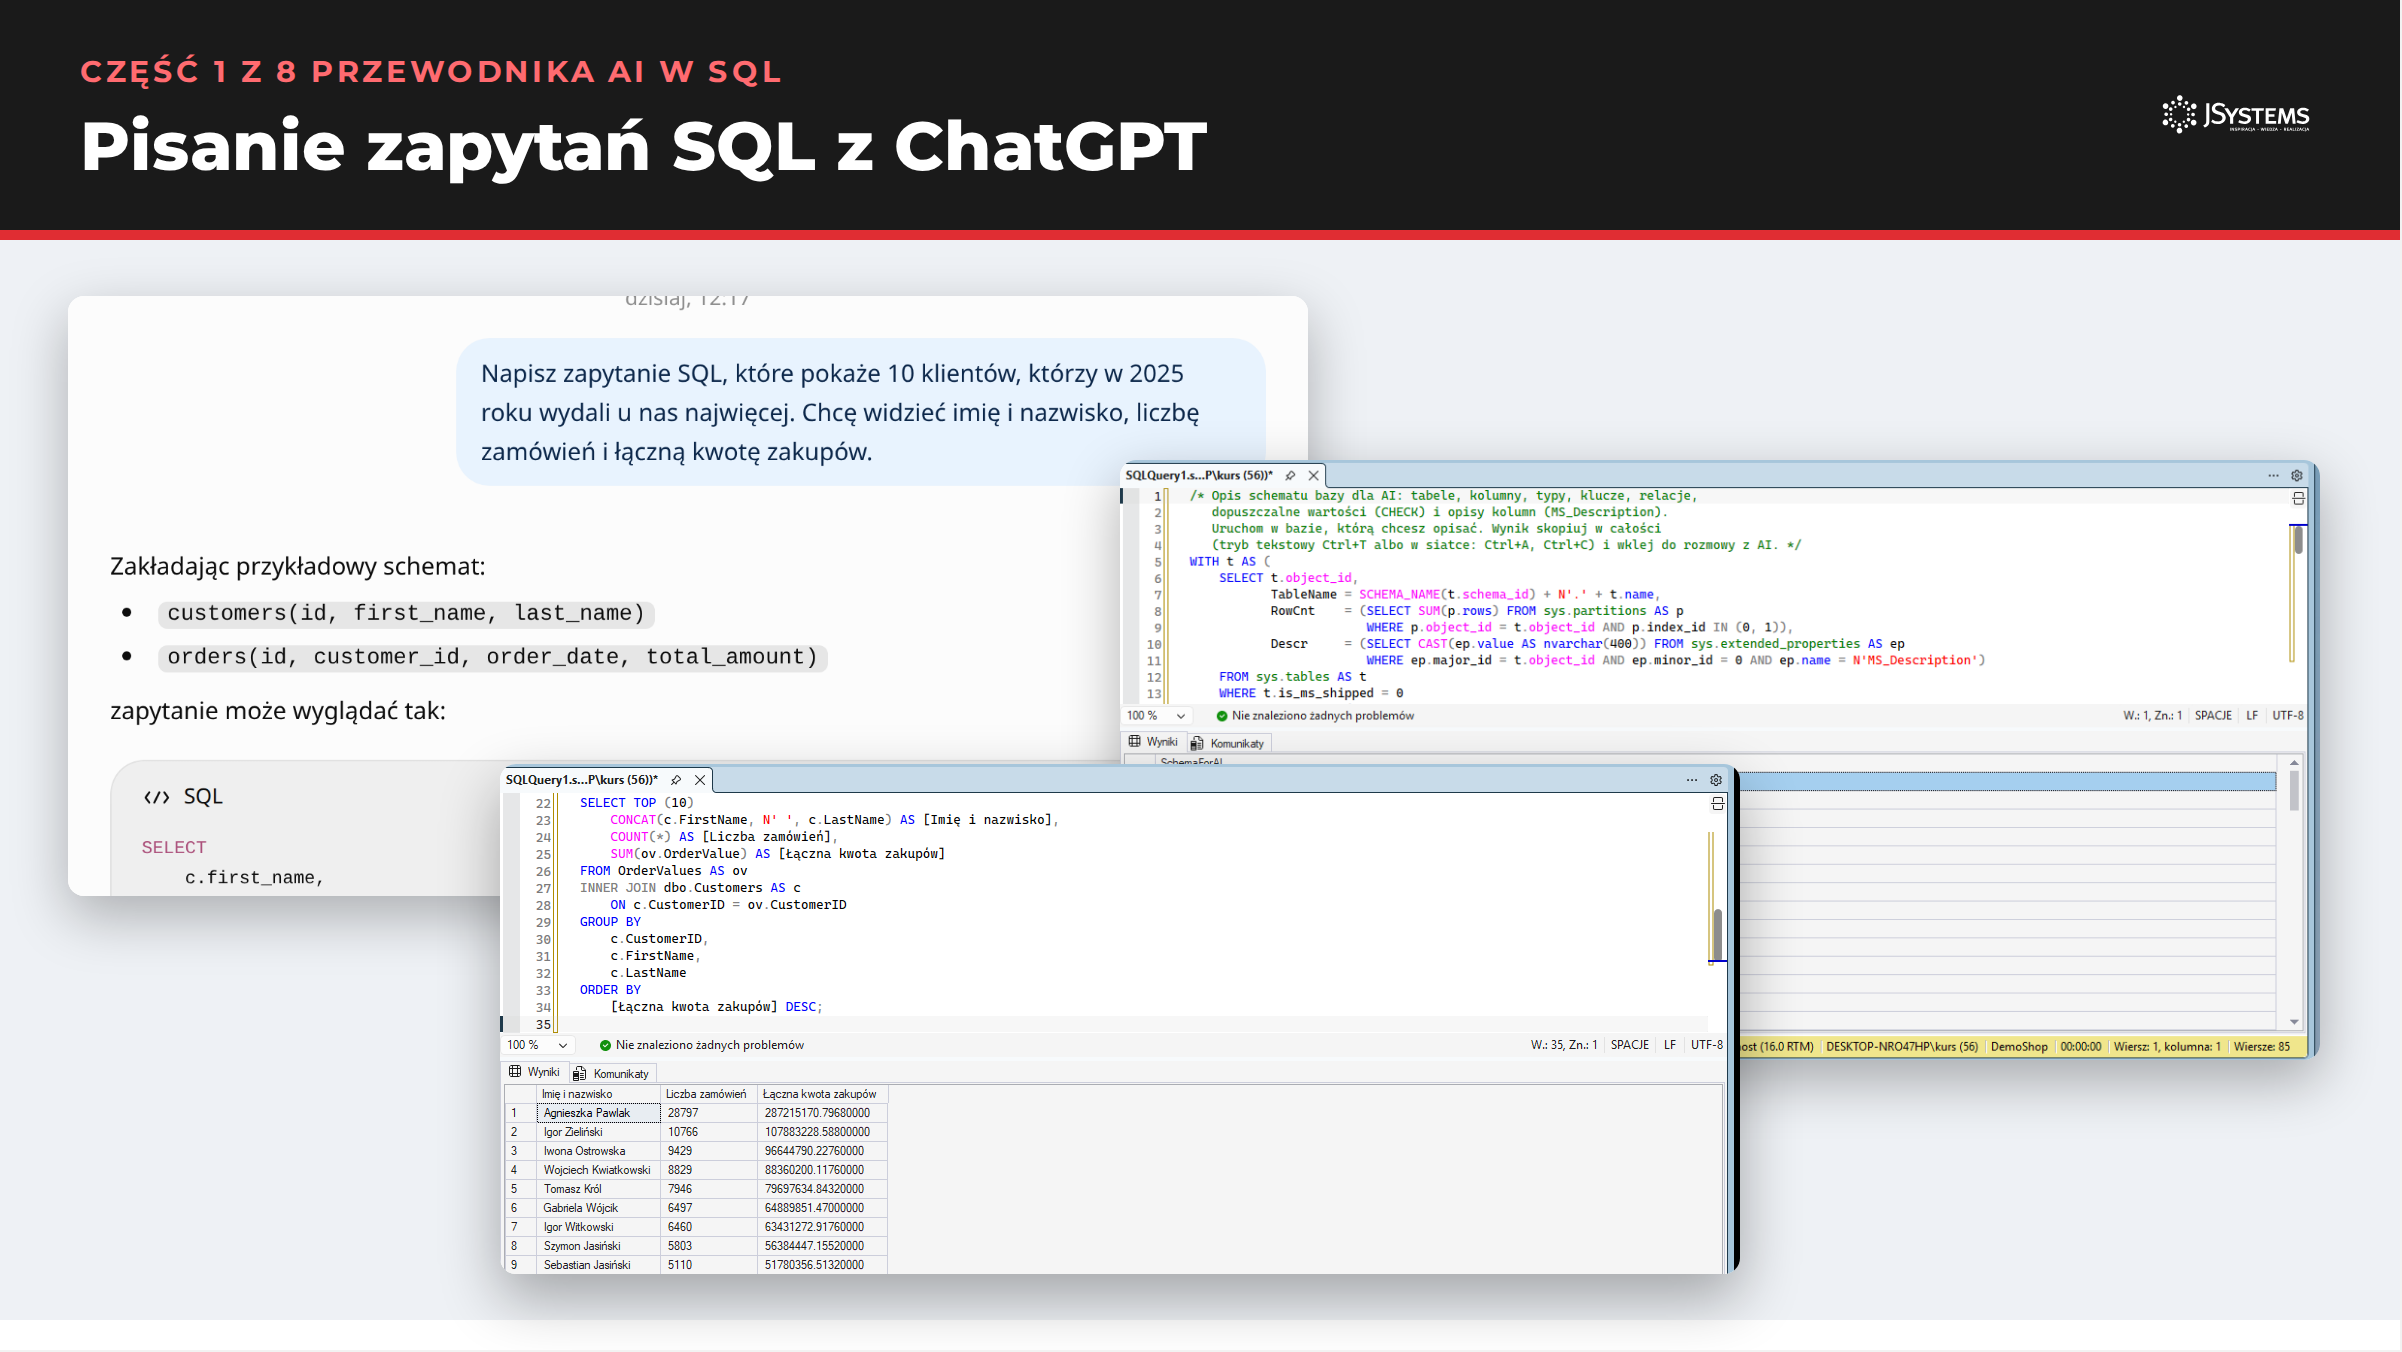
| 1 | Polecenie bez schematu | Założyło tabele customers i orders, kolumnę total_amount i klauzulę LIMIT, której nie ma w T-SQL | Zawsze dołączaj schemat i nazwę silnika | Pisanie zapytań |
| 2 | Pytanie o dane, których w bazie nie ma | Dopisało tabelę nps_responses i napisało do niej zapytanie | Zasada „jeśli czegoś nie ma w schemacie, powiedz to” w poleceniu | Wymyślone tabele |
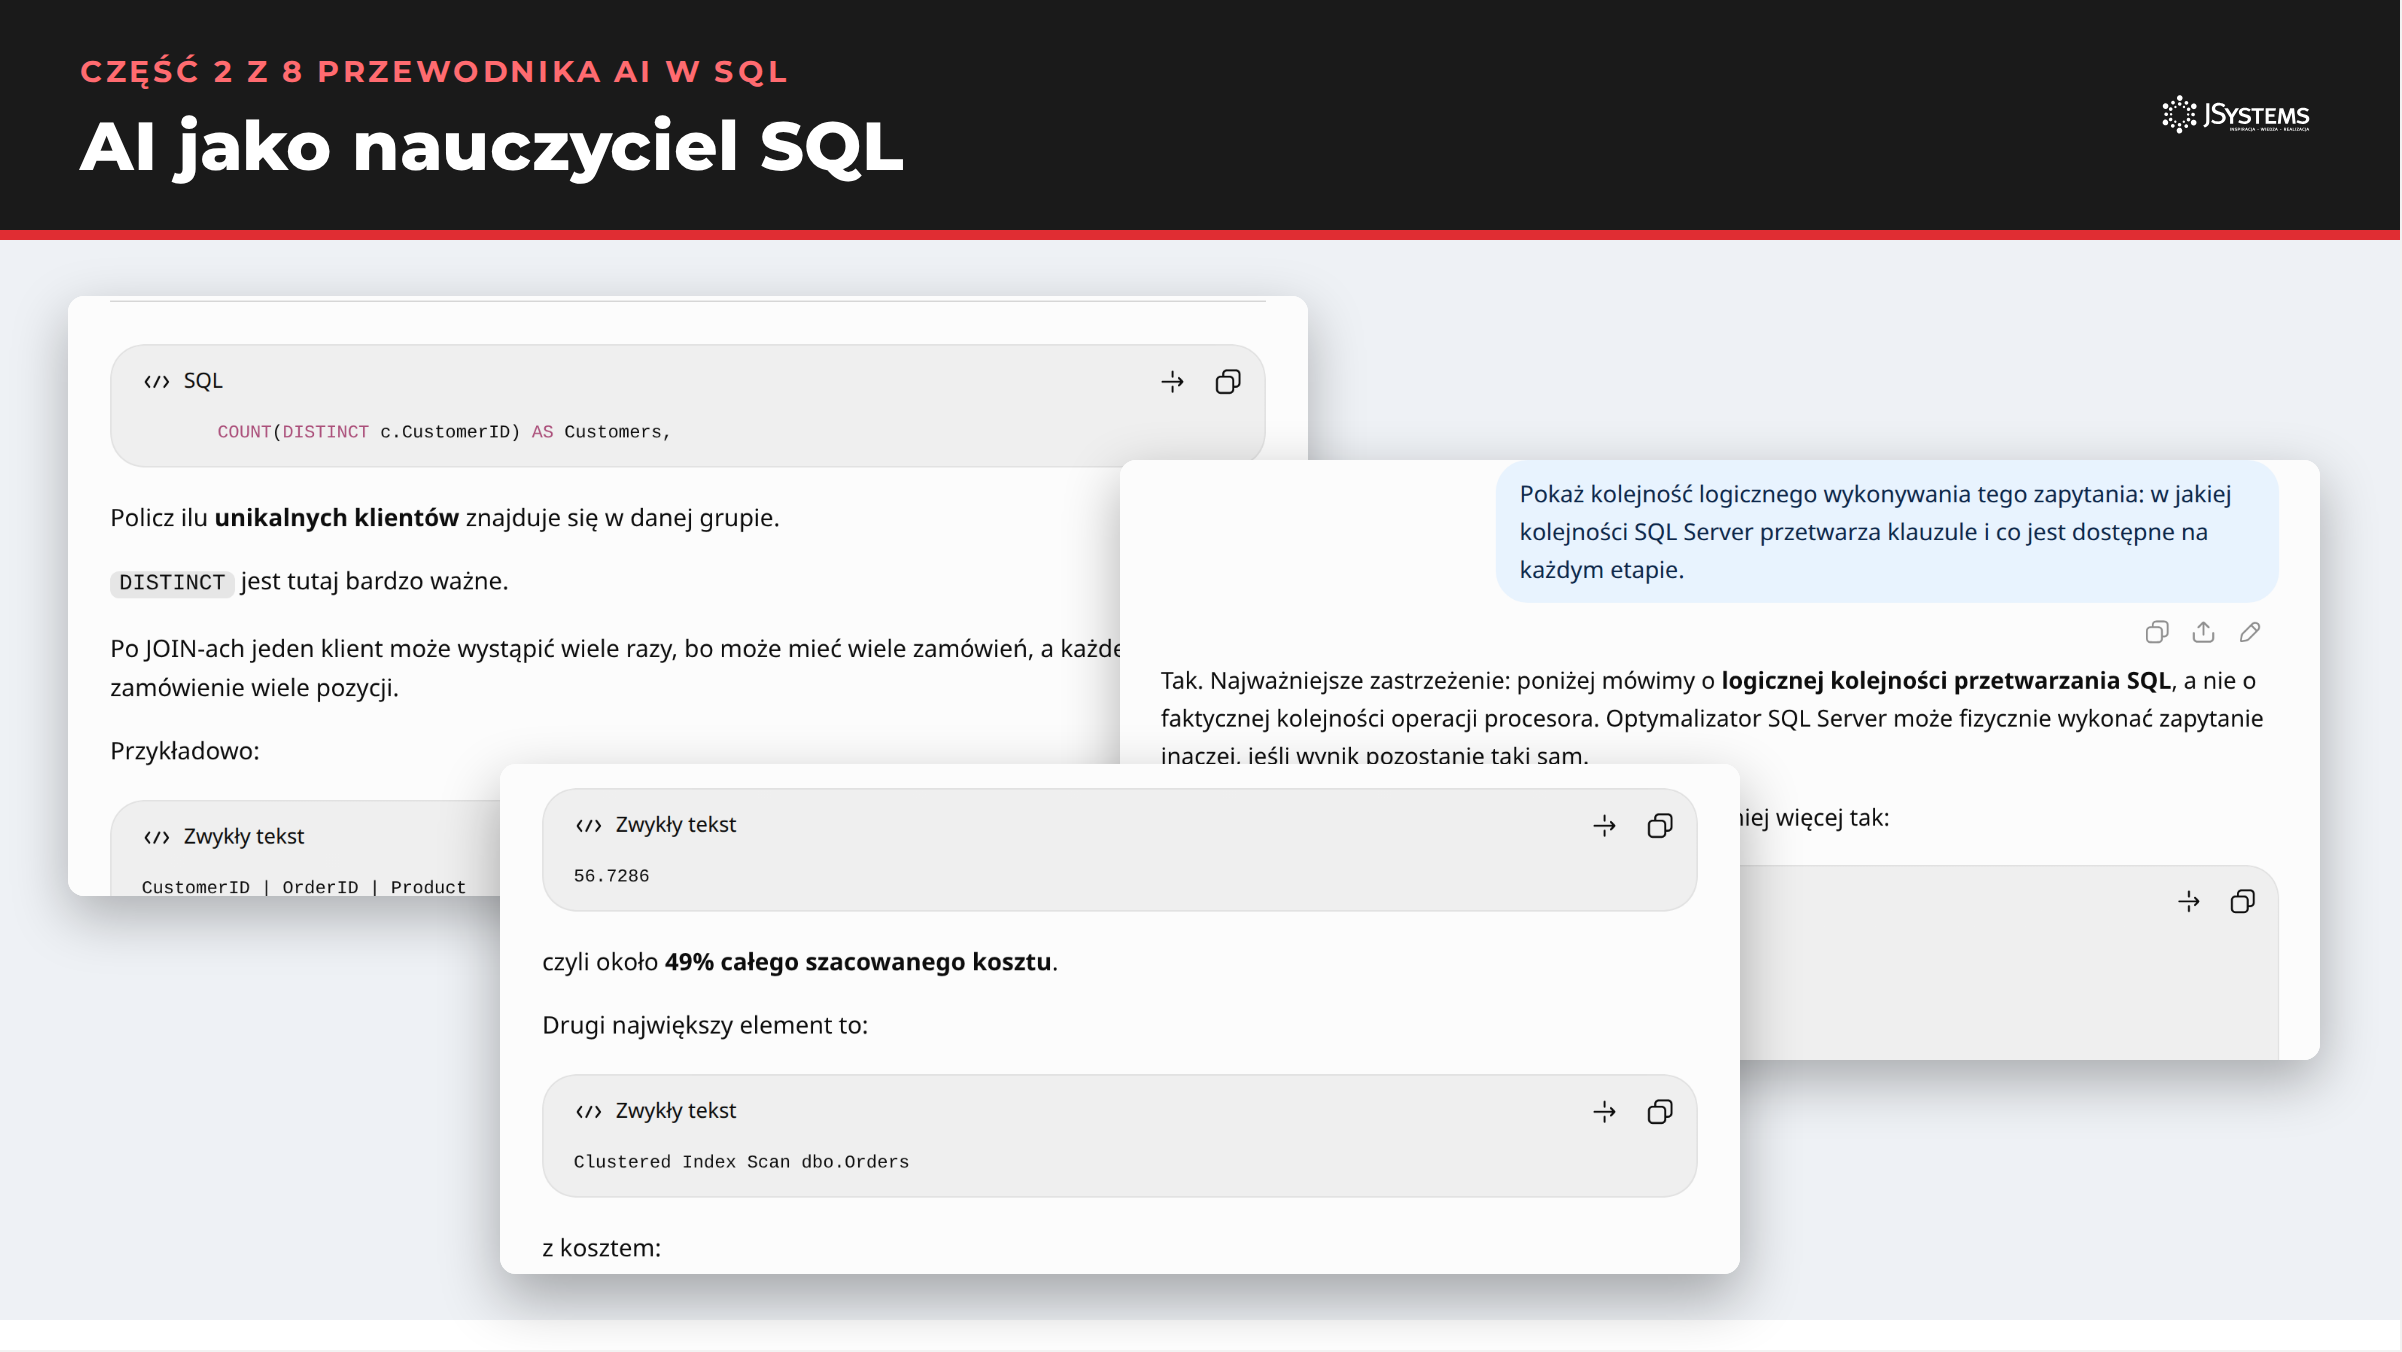
| 3 | Wyjaśnianie kolumny bez znajomości danych | Podało przykładowe segmenty „SMB, Enterprise, Consumer”, a w bazie są B2C i B2B | Wartości słownikowe sprawdzaj zapytaniem SELECT DISTINCT | AI jako nauczyciel |
| 4 | Diagram relacji | Liczności poprawne, typy kolumn zgadnięte (int, varchar, date zamiast datetime2 i nvarchar) | Diagram traktuj jako szkic, typy bierz ze schematu | AI jako nauczyciel |
| 5 | Dane z niepełnego okresu | Policzyło średnią dla 2026 roku bez uwagi, że dane kończą się we wrześniu i wynik jest zaniżony | Pytaj wprost: „czy któraś grupa ma niepełne dane?” | JOIN i CTE |
| 6 | Ranking z remisami | Wybrało DENSE_RANK bez wyjaśnienia, czym różni się od RANK przy remisach | Dopytaj o wybór funkcji, gdy ranking ma skutki biznesowe | JOIN i CTE |
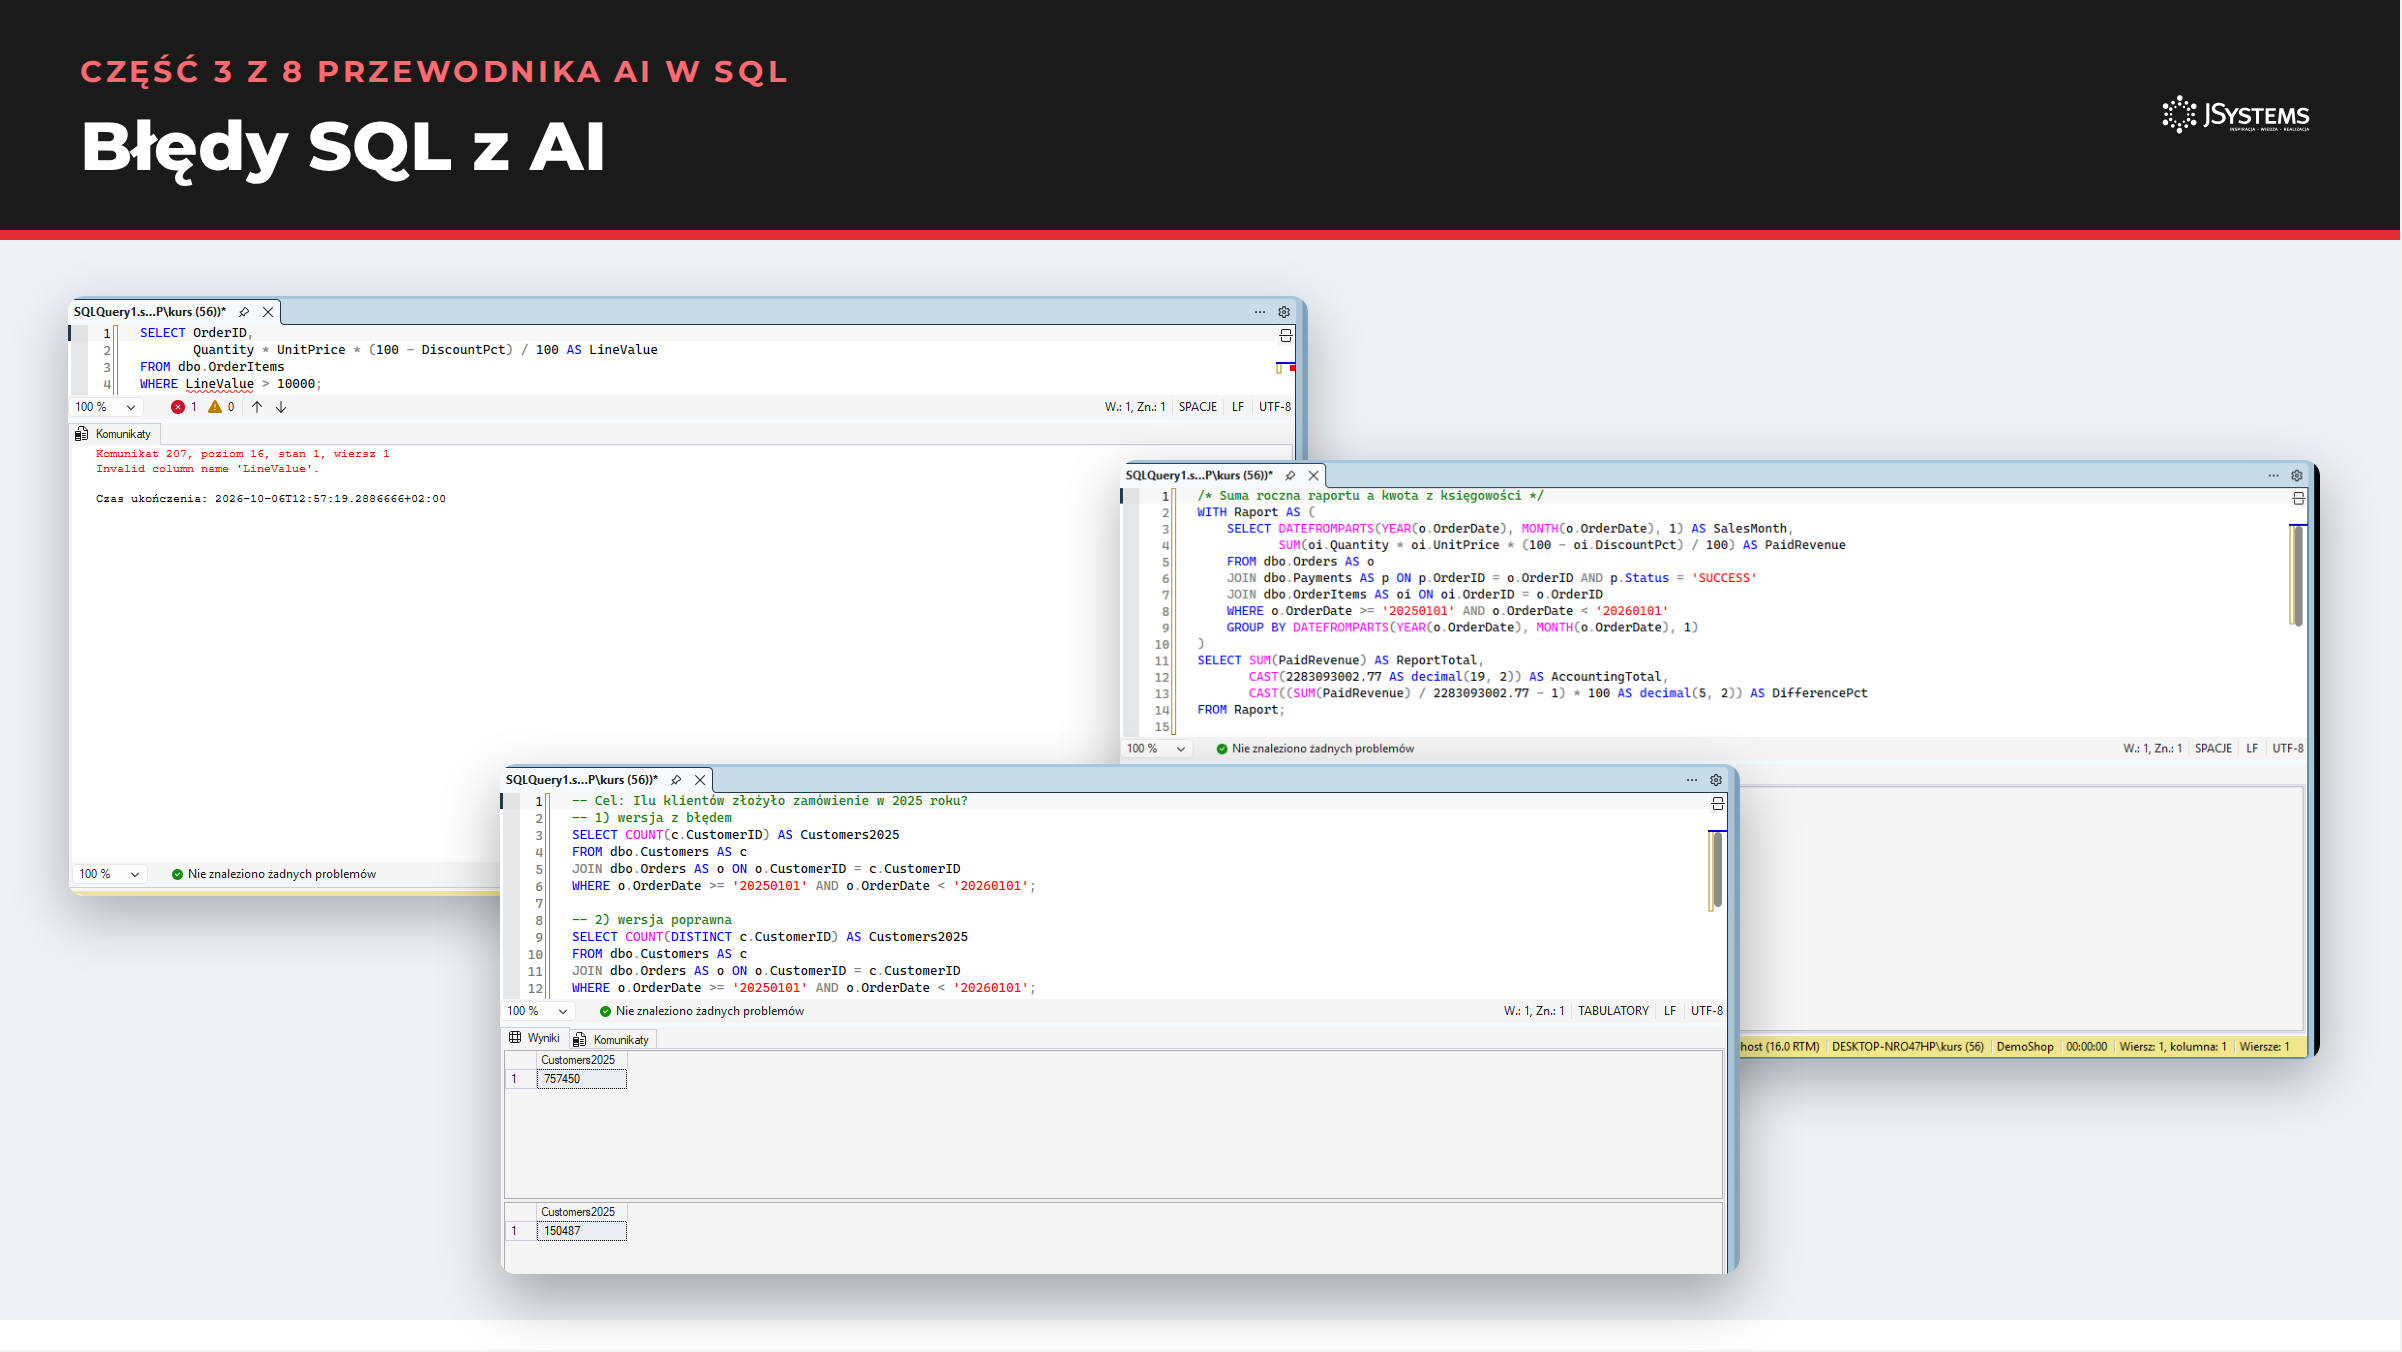
| 7 | Zapytanie kontrolne do raportu | Napisało kontrolę, która z definicji zawsze daje zero różnicy, bo liczy obie strony z tego samego założenia | Kontrola musi porównać rzeczywiste wyniki z wartością policzoną inną drogą | Błędy logiczne |
| 8 | Duplikaty w danych | Zinterpretowało „osoby” jako klientów indywidualnych; zduplikowanych kont nie mogło zobaczyć, bo nie widziało danych | Proś o zapytania kontrolne na danych, nie tylko o przegląd kodu | 20 błędów SQL |
| 9 | Refaktoryzacja według listy wymagań | Spełniło wymagania poza jednym: powtarzające się wyrażenie zostało w dwóch krokach | Po odpowiedzi przejdź listę wymagań punkt po punkcie | Refaktoryzacja |
| 10 | Długi skrypt testów | Wstawiło linie oddzielające bez znaków komentarza; skrypt nie przeszedł analizy składni (błąd 102) | Uruchom kod przed oceną; AI go nie wykonuje | Testy SQL |
| 11 | Agent czyta dane z wstrzykniętym poleceniem | Nie wykonał polecenia, ale w podsumowaniu przemilczał podejrzany wpis; w innym przebiegu ostrzegł | Bezpieczeństwo w uprawnieniach, nie w czujności modelu | Agent i MCP |
| 12 | Odpowiedź o odrzuconym poleceniu | Agent napisał, że polecenie odrzucił „serwer”, choć odrzucił je serwer MCP, a nie SQL Server | Sprawdzaj źródło komunikatu w surowej odpowiedzi narzędzia | Agent i MCP |
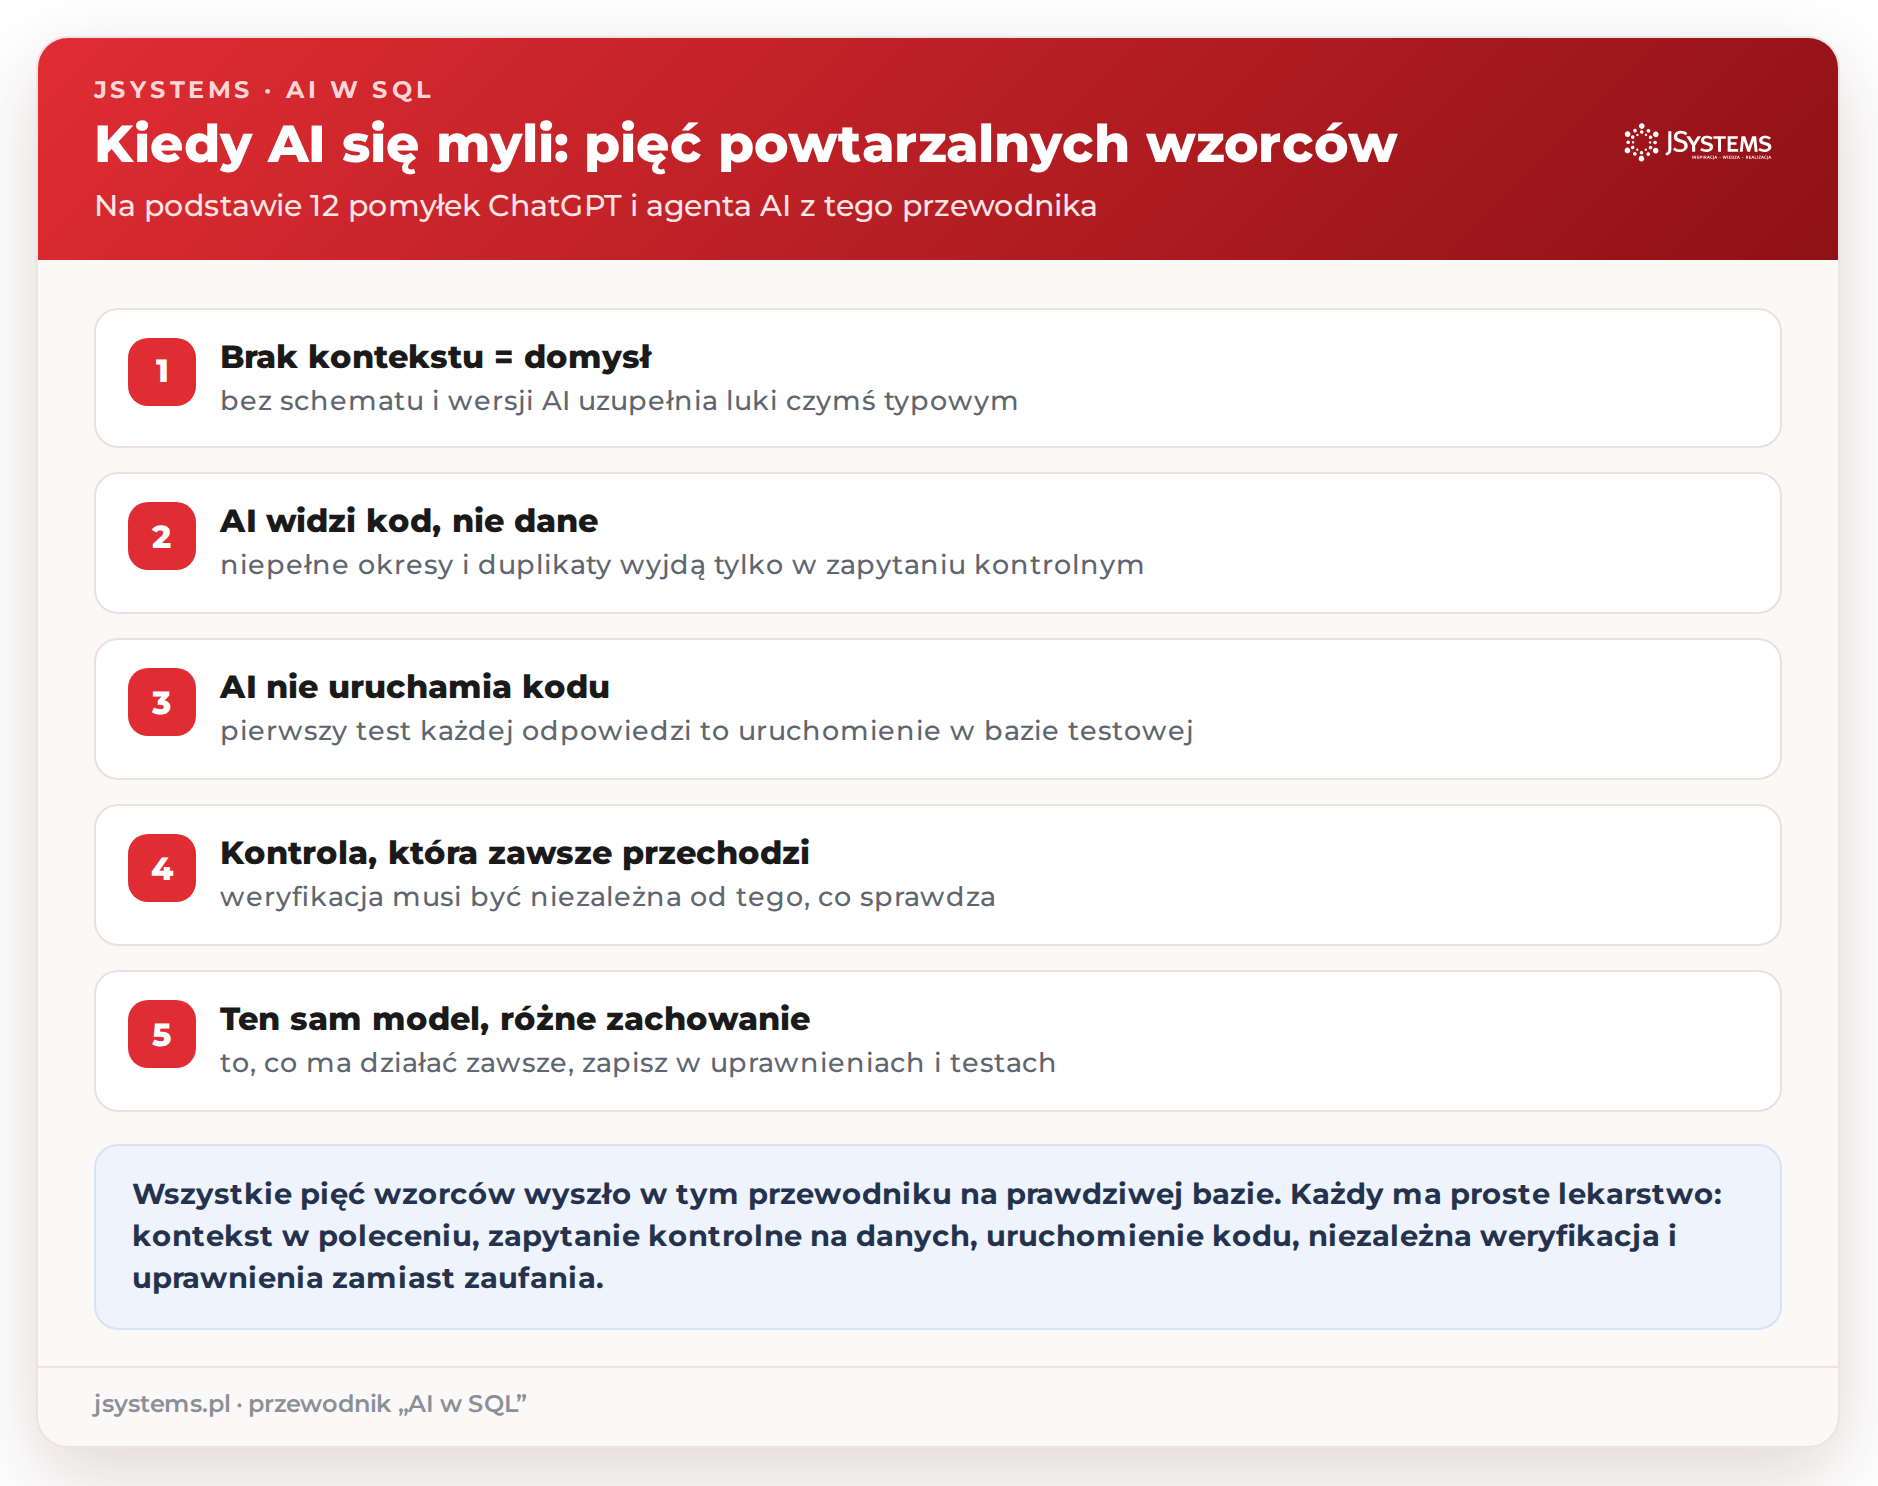
1. Brak kontekstu zamienia się w domysł. Pomyłki 1-4 mają wspólną przyczynę: AI nie dostało informacji, więc uzupełniło lukę czymś typowym. Robi to płynnie i bez wahania, czasem z dopiskiem „przykładowe”. Lekarstwem jest schemat, wersja serwera i reguła „nie zgaduj, zapytaj” w poleceniu.
2. AI widzi kod, a nie dane. Pomyłki 5 i 8 wynikają z cech danych: niepełnego roku i zduplikowanych kont. Żadne czytanie kodu ich nie znajdzie. Znajdzie je zapytanie kontrolne na danych, a AI świetnie takie zapytania pisze, jeśli o nie poprosisz.
3. AI nie uruchamia swojego kodu. Pomyłka 10 była banalna i zablokowała cały skrypt. Czat z AI pisze kod, ale go nie wykonuje, więc pierwszym testem każdej odpowiedzi jest uruchomienie jej w bazie testowej.
4. Pewność siebie w weryfikacji. Pomyłka 7 jest najgroźniejsza, bo wygląda jak dowód. Zapytanie kontrolne, które liczy obie strony z tego samego założenia, zawsze potwierdzi to założenie. Zasada: kontrola musi być niezależna od tego, co sprawdza.
5. Ten sam model, różne zachowanie. Pomyłka 11 pokazała, że przy identycznym poleceniu agent raz ostrzega przed podejrzanym wpisem, a raz go przemilcza. Odpowiedzi AI nie są powtarzalne, więc wszystko, co ma działać zawsze, musi być zapisane w uprawnieniach, testach i konfiguracji, a nie w nadziei, że model zachowa się rozsądnie.
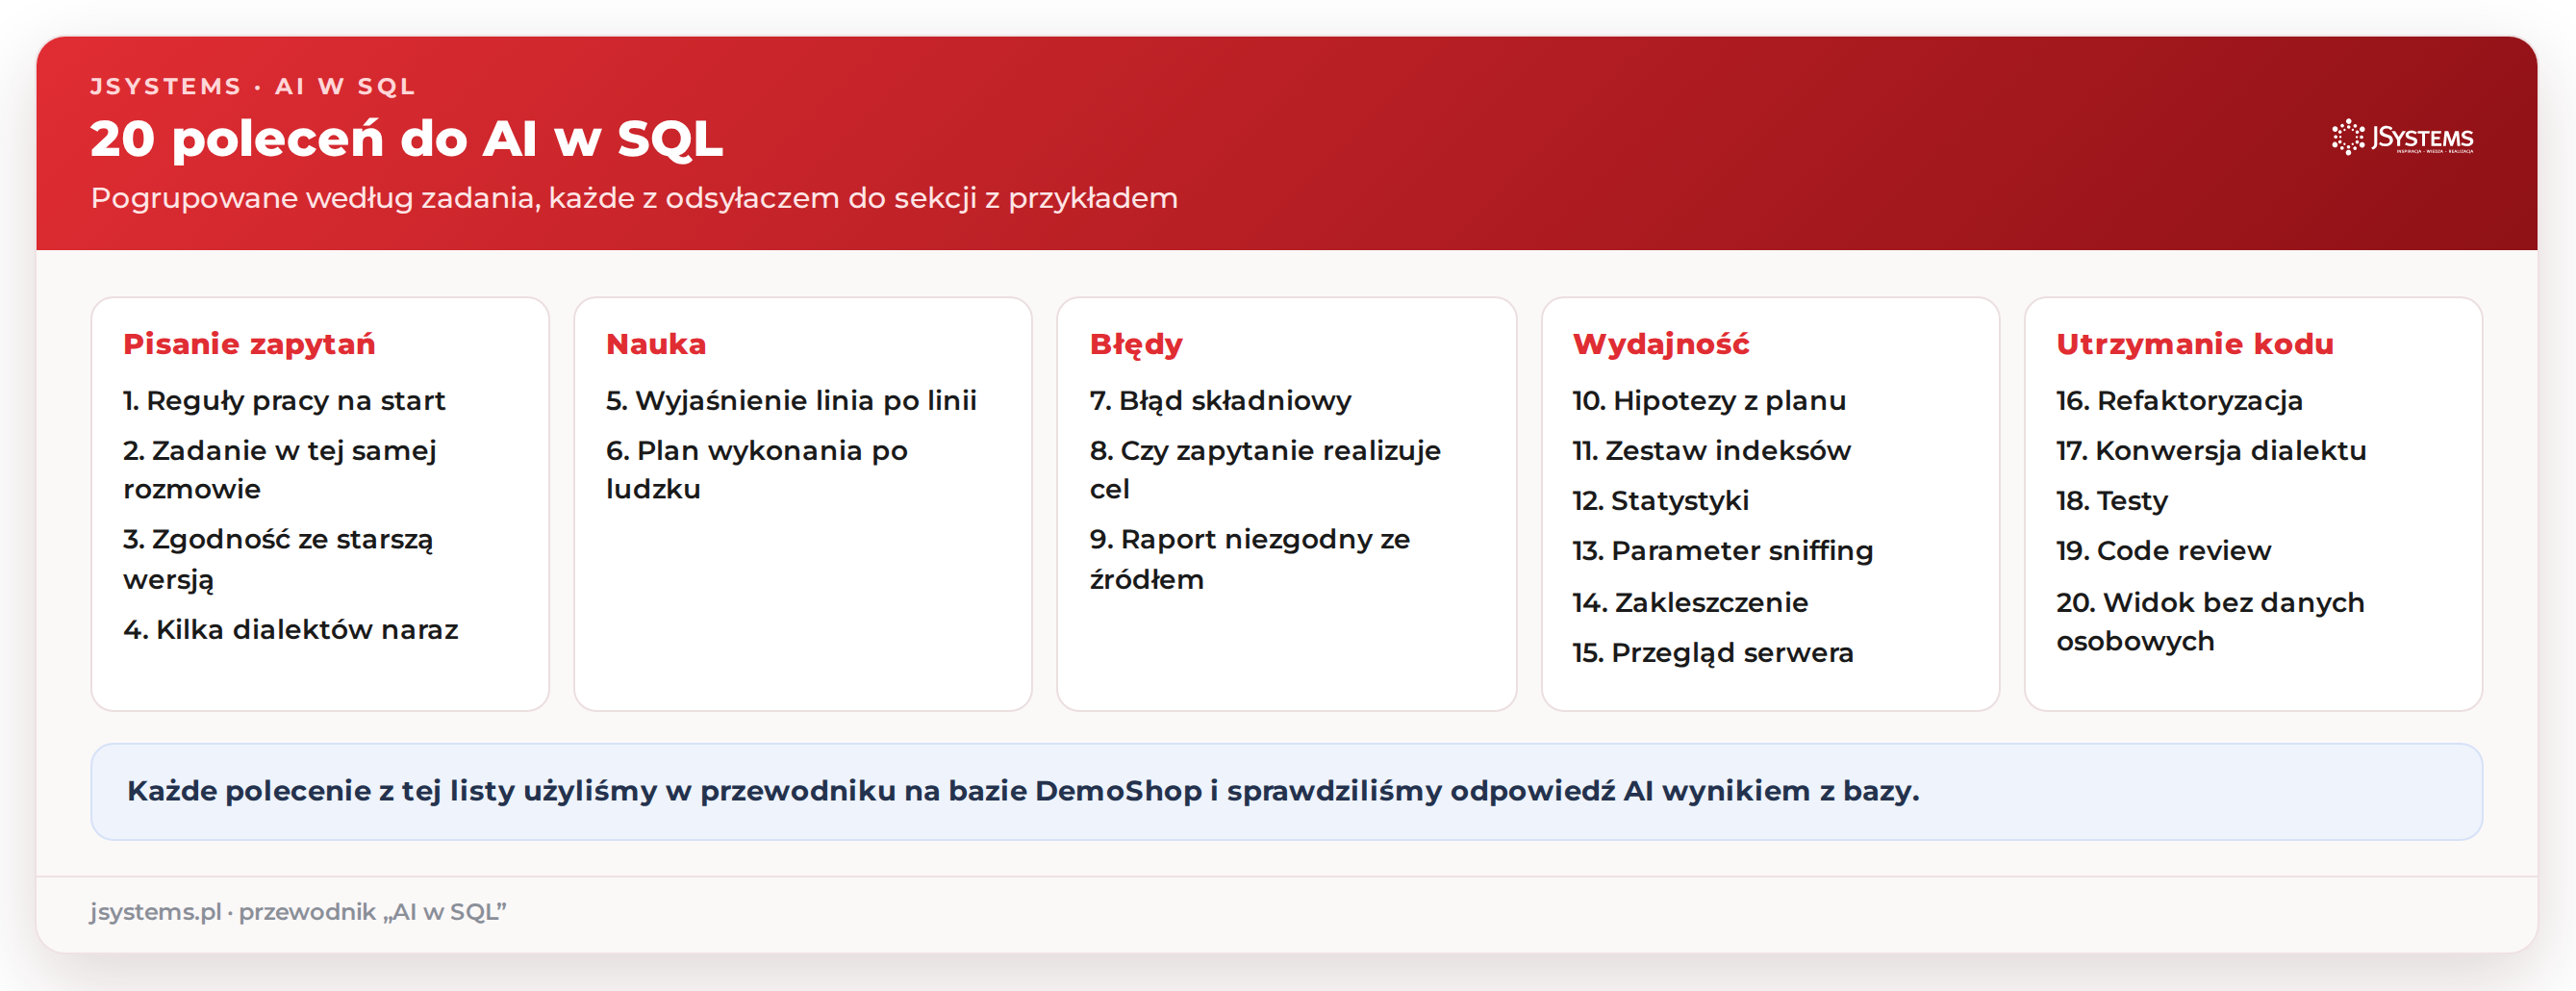
Poniżej polecenia, których użyliśmy w kolejnych sekcjach, w wersji do skopiowania. Nazwy z naszej bazy zamieniliśmy na miejsca do uzupełnienia w nawiasach kwadratowych. Przy każdym poleceniu jest odsyłacz do sekcji, w której widać, co AI odpowiedziało i jak sprawdziliśmy wynik. Wszystkie dotyczą SQL Server 2022, ale po zmianie nazwy silnika działają tak samo dla PostgreSQL, Oracle czy MySQL.
1. Reguły pracy na początek rozmowy (sekcja pisanie zapytań). Wersję serwera i poziom zgodności bazy wpisz swoje: 160 to SQL Server 2022, 150 to 2019, 140 to 2017.
Piszesz zapytania w T-SQL dla Microsoft SQL Server 2022 (poziom zgodności 160). Korzystaj wyłącznie z tabel i kolumn opisanych w załączonym pliku [plik ze schematem]. Jeśli do odpowiedzi brakuje Ci informacji, zapytaj, zamiast zgadywać. Zanim napiszesz zapytanie, wypisz listę tabel i kolumn, których użyjesz. Jeśli czegoś nie ma w schemacie, napisz to wprost.
Zasady liczenia:
- [definicja sprzedaży, np. suma wartości pozycji po rabacie, bez kosztu dostawy],
- [które statusy się nie liczą],
- [według jakiej daty liczymy okres i w jakiej strefie czasowej].
2. Zadanie w tej samej rozmowie (sekcja JOIN, CTE i funkcje okien)
Kolejne zadanie: [co ma pokazać zestawienie, jednym zdaniem]. Kolumny: [lista kolumn]. Posortuj [jak]. Jeśli zadanie da się zrozumieć na dwa sposoby, zapytaj, który wybrać.
3. Zgodność ze starszą wersją serwera (sekcja pisanie zapytań)
Nasz serwer produkcyjny to [wersja, np. SQL Server 2019], a baza ma poziom zgodności [np. 150]. Czy to zapytanie tam zadziała? Jeśli nie, przepisz je tak, żeby działało.
4. To samo zestawienie w kilku dialektach (sekcja pisanie zapytań)
Na podstawie schematu z załączonego pliku napisz to samo zestawienie w dialektach: [lista silników z wersjami]. Zestawienie: [opis]. Każdą wersję podaj w osobnym bloku kodu z nazwą dialektu w nagłówku. Pod blokami wypisz w tabeli, czym różni się składnia: ograniczenie liczby wierszy, łączenie tekstu i literały dat.
5. Wyjaśnienie zapytania (sekcja AI jako nauczyciel SQL)
Wyjaśnij mi to zapytanie linia po linii, prostym językiem. Znam podstawy SELECT, ale nie znam [czego nie znasz, np. funkcji okienkowych]. Baza to SQL Server 2022.
[zapytanie]
6. Plan wykonania po ludzku (sekcja AI jako nauczyciel SQL)
Załączam plik z rzeczywistym planem wykonania tego zapytania ([nazwa].sqlplan, zapisany w SSMS). Wyjaśnij go po ludzku: co serwer robi krok po kroku, który operator kosztuje najwięcej i dlaczego, i czy coś w planie jest niepokojące.
7. Błąd składniowy (sekcja błędy składniowe)
SQL Server 2022 zwraca błąd [numer]: [treść komunikatu skopiowana z zakładki Komunikaty].
Co jest nie tak i jak to poprawić?
[całe zapytanie]
8. Czy zapytanie robi to, co ma robić (sekcja 20 błędów SQL)
Cel zapytania: [cel biznesowy jednym zdaniem]
[zapytanie]
Czy to zapytanie realizuje ten cel? Jeśli nie, wskaż błąd i podaj poprawioną wersję.
9. Raport nie zgadza się z innym źródłem (sekcja błędy logiczne)
Pracuję w SQL Server 2022 na bazie opisanej w załączonym pliku [plik ze schematem]. Poniższy raport ma pokazywać [co]. [Kto] zgłasza, że [jaka różnica, z liczbami z obu źródeł].
Nie poprawiaj jeszcze zapytania. Wypisz hipotezy, co może powodować różnicę, od najbardziej prawdopodobnej, i do każdej podaj krótkie zapytanie diagnostyczne, którym ją sprawdzę.
[treść raportu]
10. Hipotezy z planu wykonania (sekcja optymalizacja)
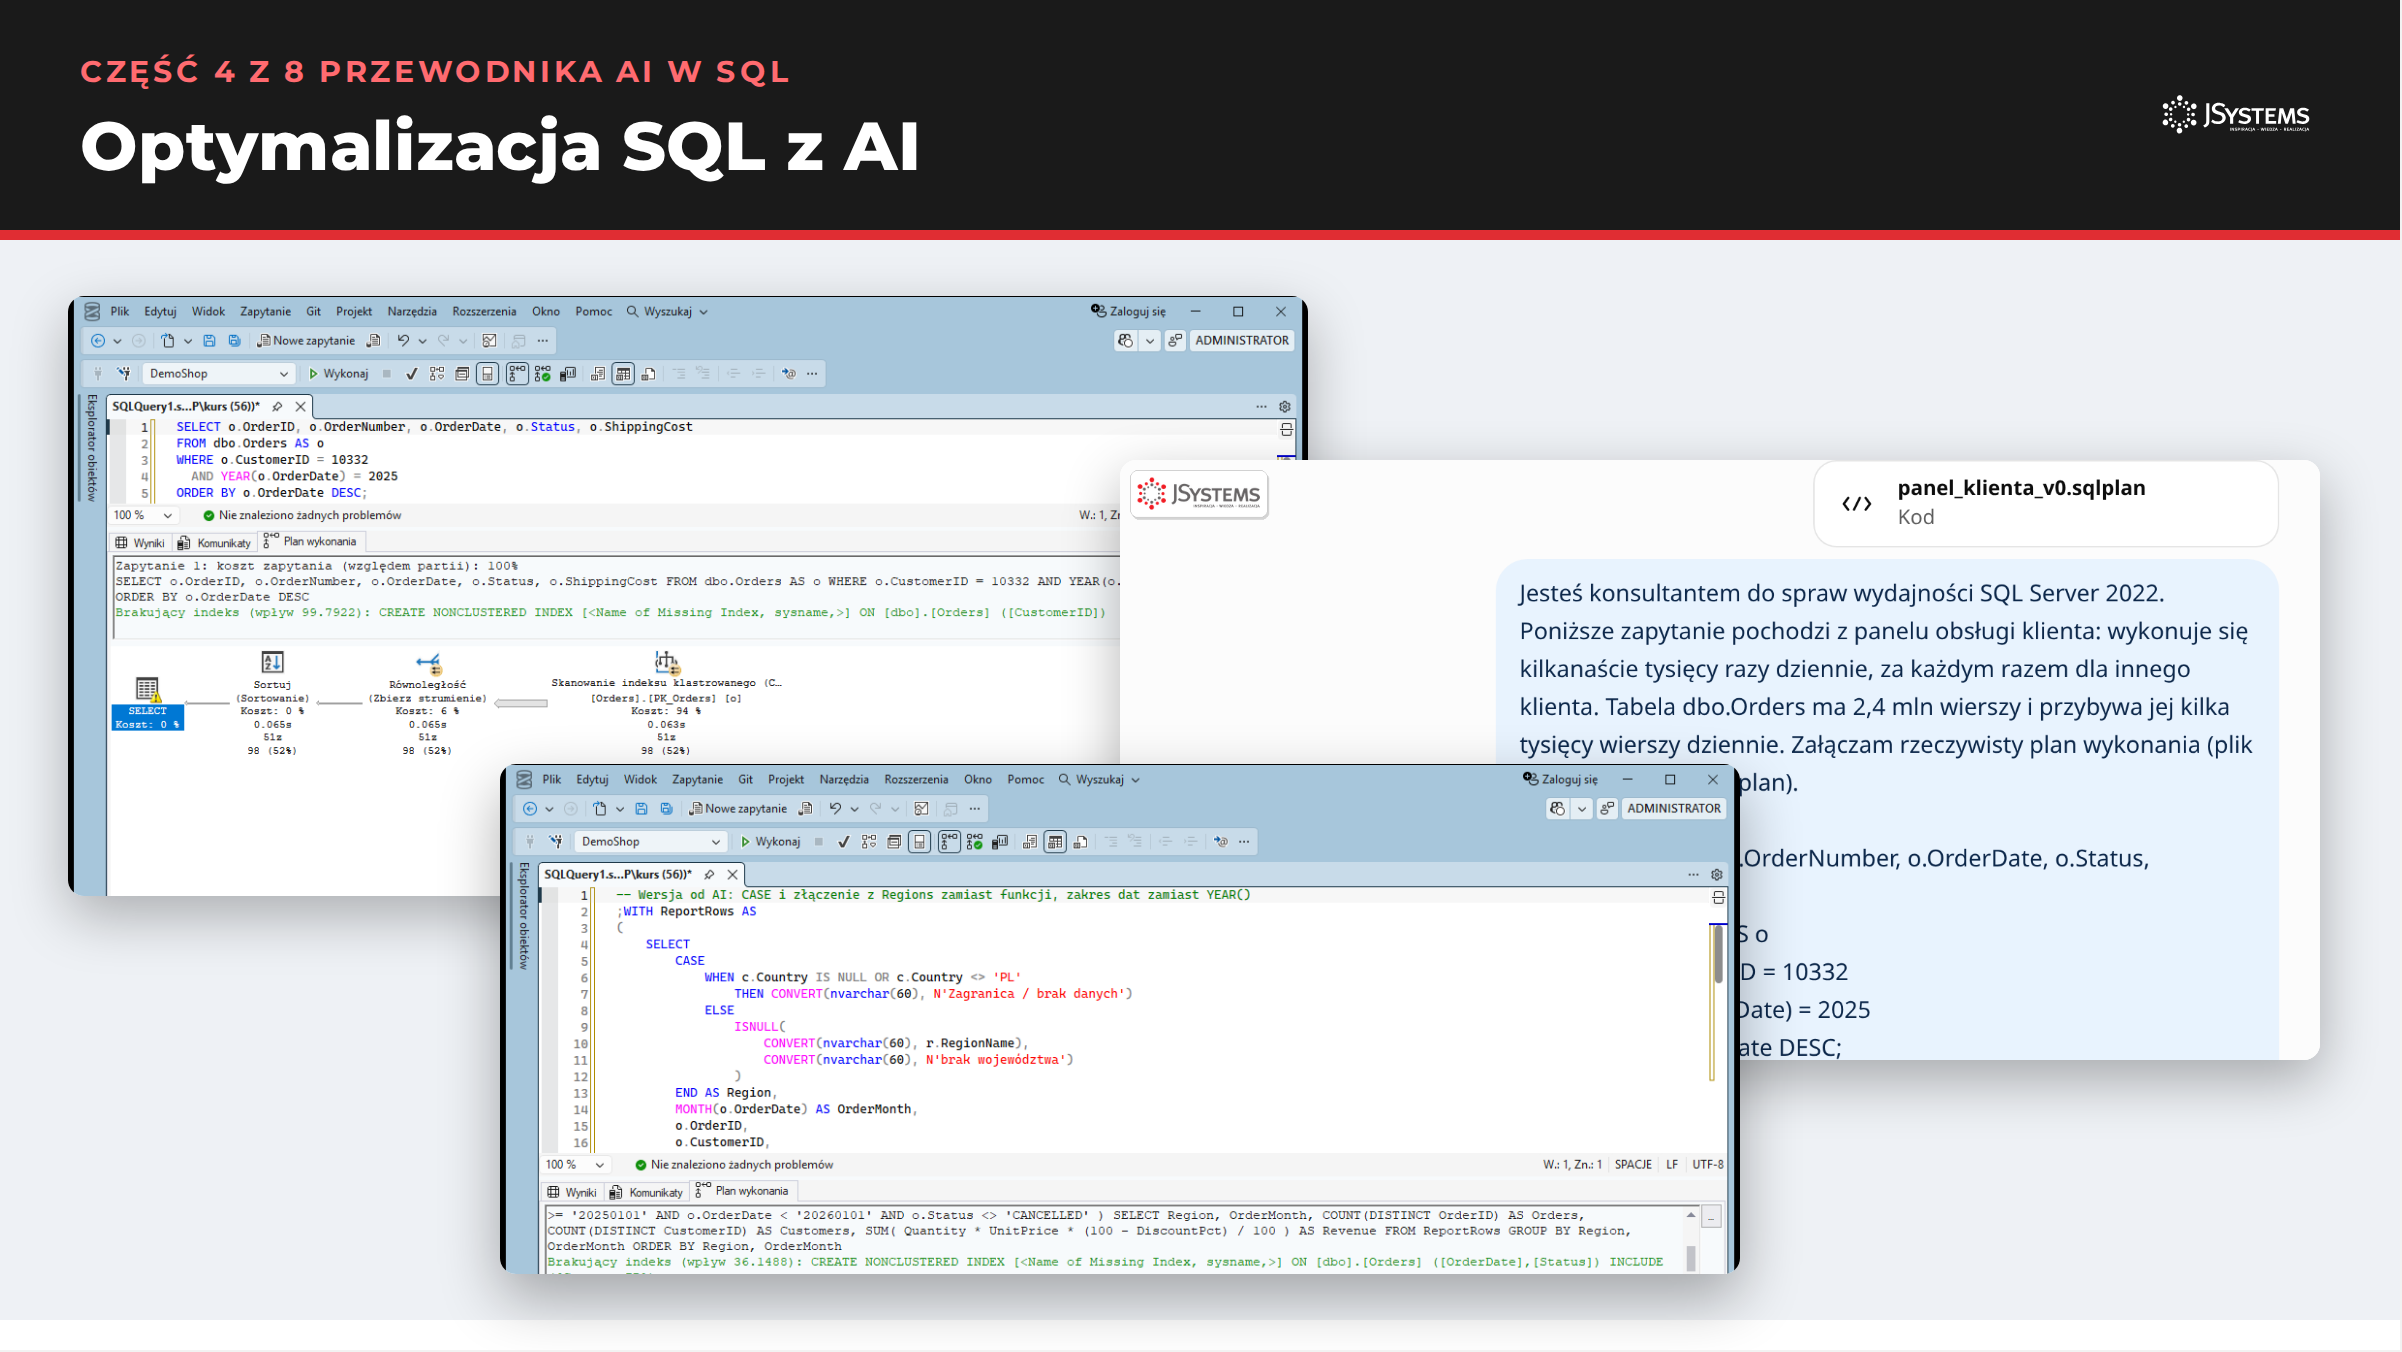
Jesteś konsultantem do spraw wydajności SQL Server 2022. Poniższe zapytanie [jak często i w jakim kontekście się wykonuje]. Tabela [nazwa] ma [liczba] wierszy i [jak rośnie]. Załączam rzeczywisty plan wykonania ([nazwa].sqlplan).
[zapytanie]
Wypisz hipotezy, co sprawia, że zapytanie jest kosztowne, od najważniejszej. Do każdej podaj jedną zmianę do przetestowania i opisz, co powinno się zmienić w planie, jeśli hipoteza jest prawdziwa. Zaproponuj kolejność testowania zmian, po jednej naraz.
11. Zestaw indeksów z widoków systemowych (sekcja indeksy)
Jesteś administratorem SQL Server 2022. W załącznikach: lista brakujących indeksów z widoków sys.dm_db_missing_index_*, statystyki użycia istniejących indeksów (odczyty i zapisy) oraz schemat bazy. Zaproponuj minimalny zestaw indeksów: połącz sugestie, które się pokrywają, odrzuć te, które nie są warte kosztu zapisu, i wskaż istniejące indeksy do usunięcia albo rozszerzenia. Przy każdej propozycji podaj polecenie CREATE INDEX, listę sugestii, które pokrywa, i ryzyko dla zapisów. Zaznacz, czego nie da się ocenić bez dodatkowych danych.
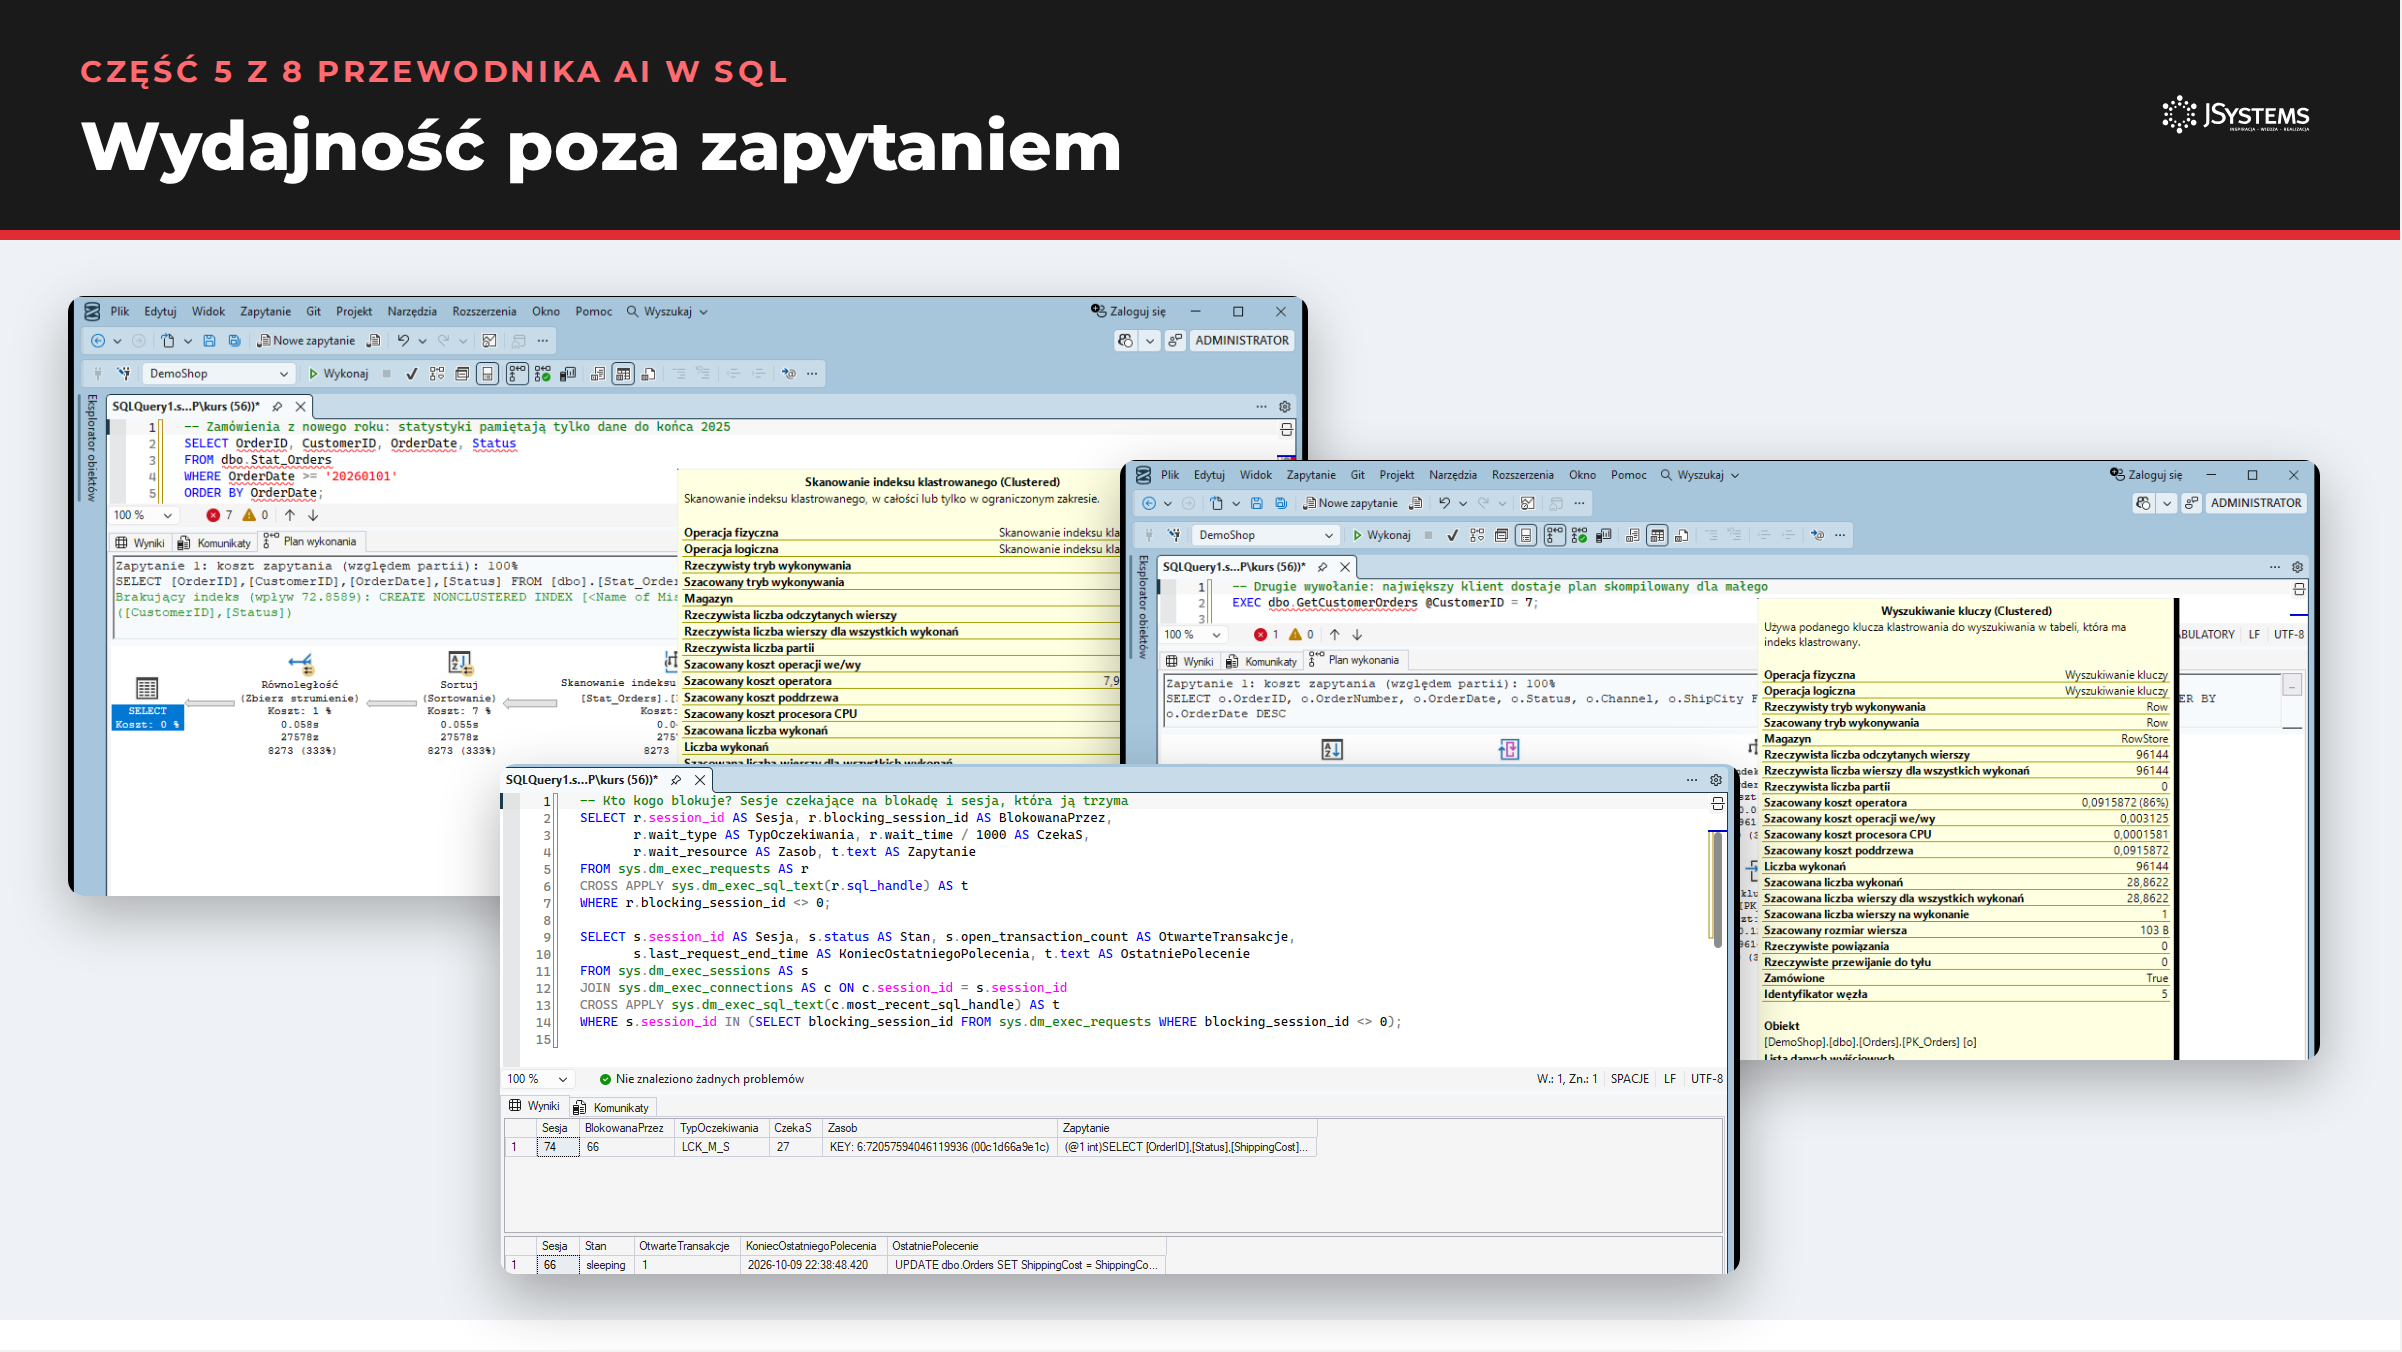
12. Statystyki (sekcja wydajność poza zapytaniem)
Zapytanie [opis] w tabeli [nazwa] (SQL Server 2022) działa wolniej, niż powinno. Załączam rzeczywisty plan wykonania i stan statystyk tabeli (sys.dm_db_stats_properties i ostatnie kroki histogramu). Co jest przyczyną, jak to potwierdzić i jak naprawić teraz oraz na przyszłość, skoro [jak przybywa danych]?
13. Parameter sniffing (sekcja parameter sniffing)
Procedura [nazwa] (kod niżej) raz działa w milisekundy, a raz bardzo wolno. Załączam rzeczywisty plan wolnego wywołania, statystyki procedury z sys.dm_exec_procedure_stats i rozkład danych w kolumnie, po której filtruje. Wyjaśnij, co się dzieje, i porównaj rozwiązania dostępne w SQL Server 2022 razem z ich wadami.
[kod procedury]
14. Zakleszczenie (sekcja wydajność poza zapytaniem)
Aplikacja dostała błąd 1205 (deadlock) na SQL Server 2022. Załączam raport zakleszczenia z sesji zdarzeń system_health. Wyjaśnij krok po kroku, co się stało, która sesja została ofiarą i dlaczego, oraz jak zmienić kod, żeby to się nie powtarzało.
15. Przegląd serwera (sekcja wydajność poza zapytaniem)
Zrób przegląd konfiguracji i stanu serwera [wersja i edycja SQL Server] na [sprzęt: rdzenie, pamięć, rodzaj dysków]. Załączam liczniki pamięci, opóźnienia odczytu i zapisu plików oraz ustawienia serwera i bazy. Wskaż problemy od najważniejszego, z konkretną zmianą i uzasadnieniem. Zaznacz, które zmiany wymagają restartu albo okna serwisowego.
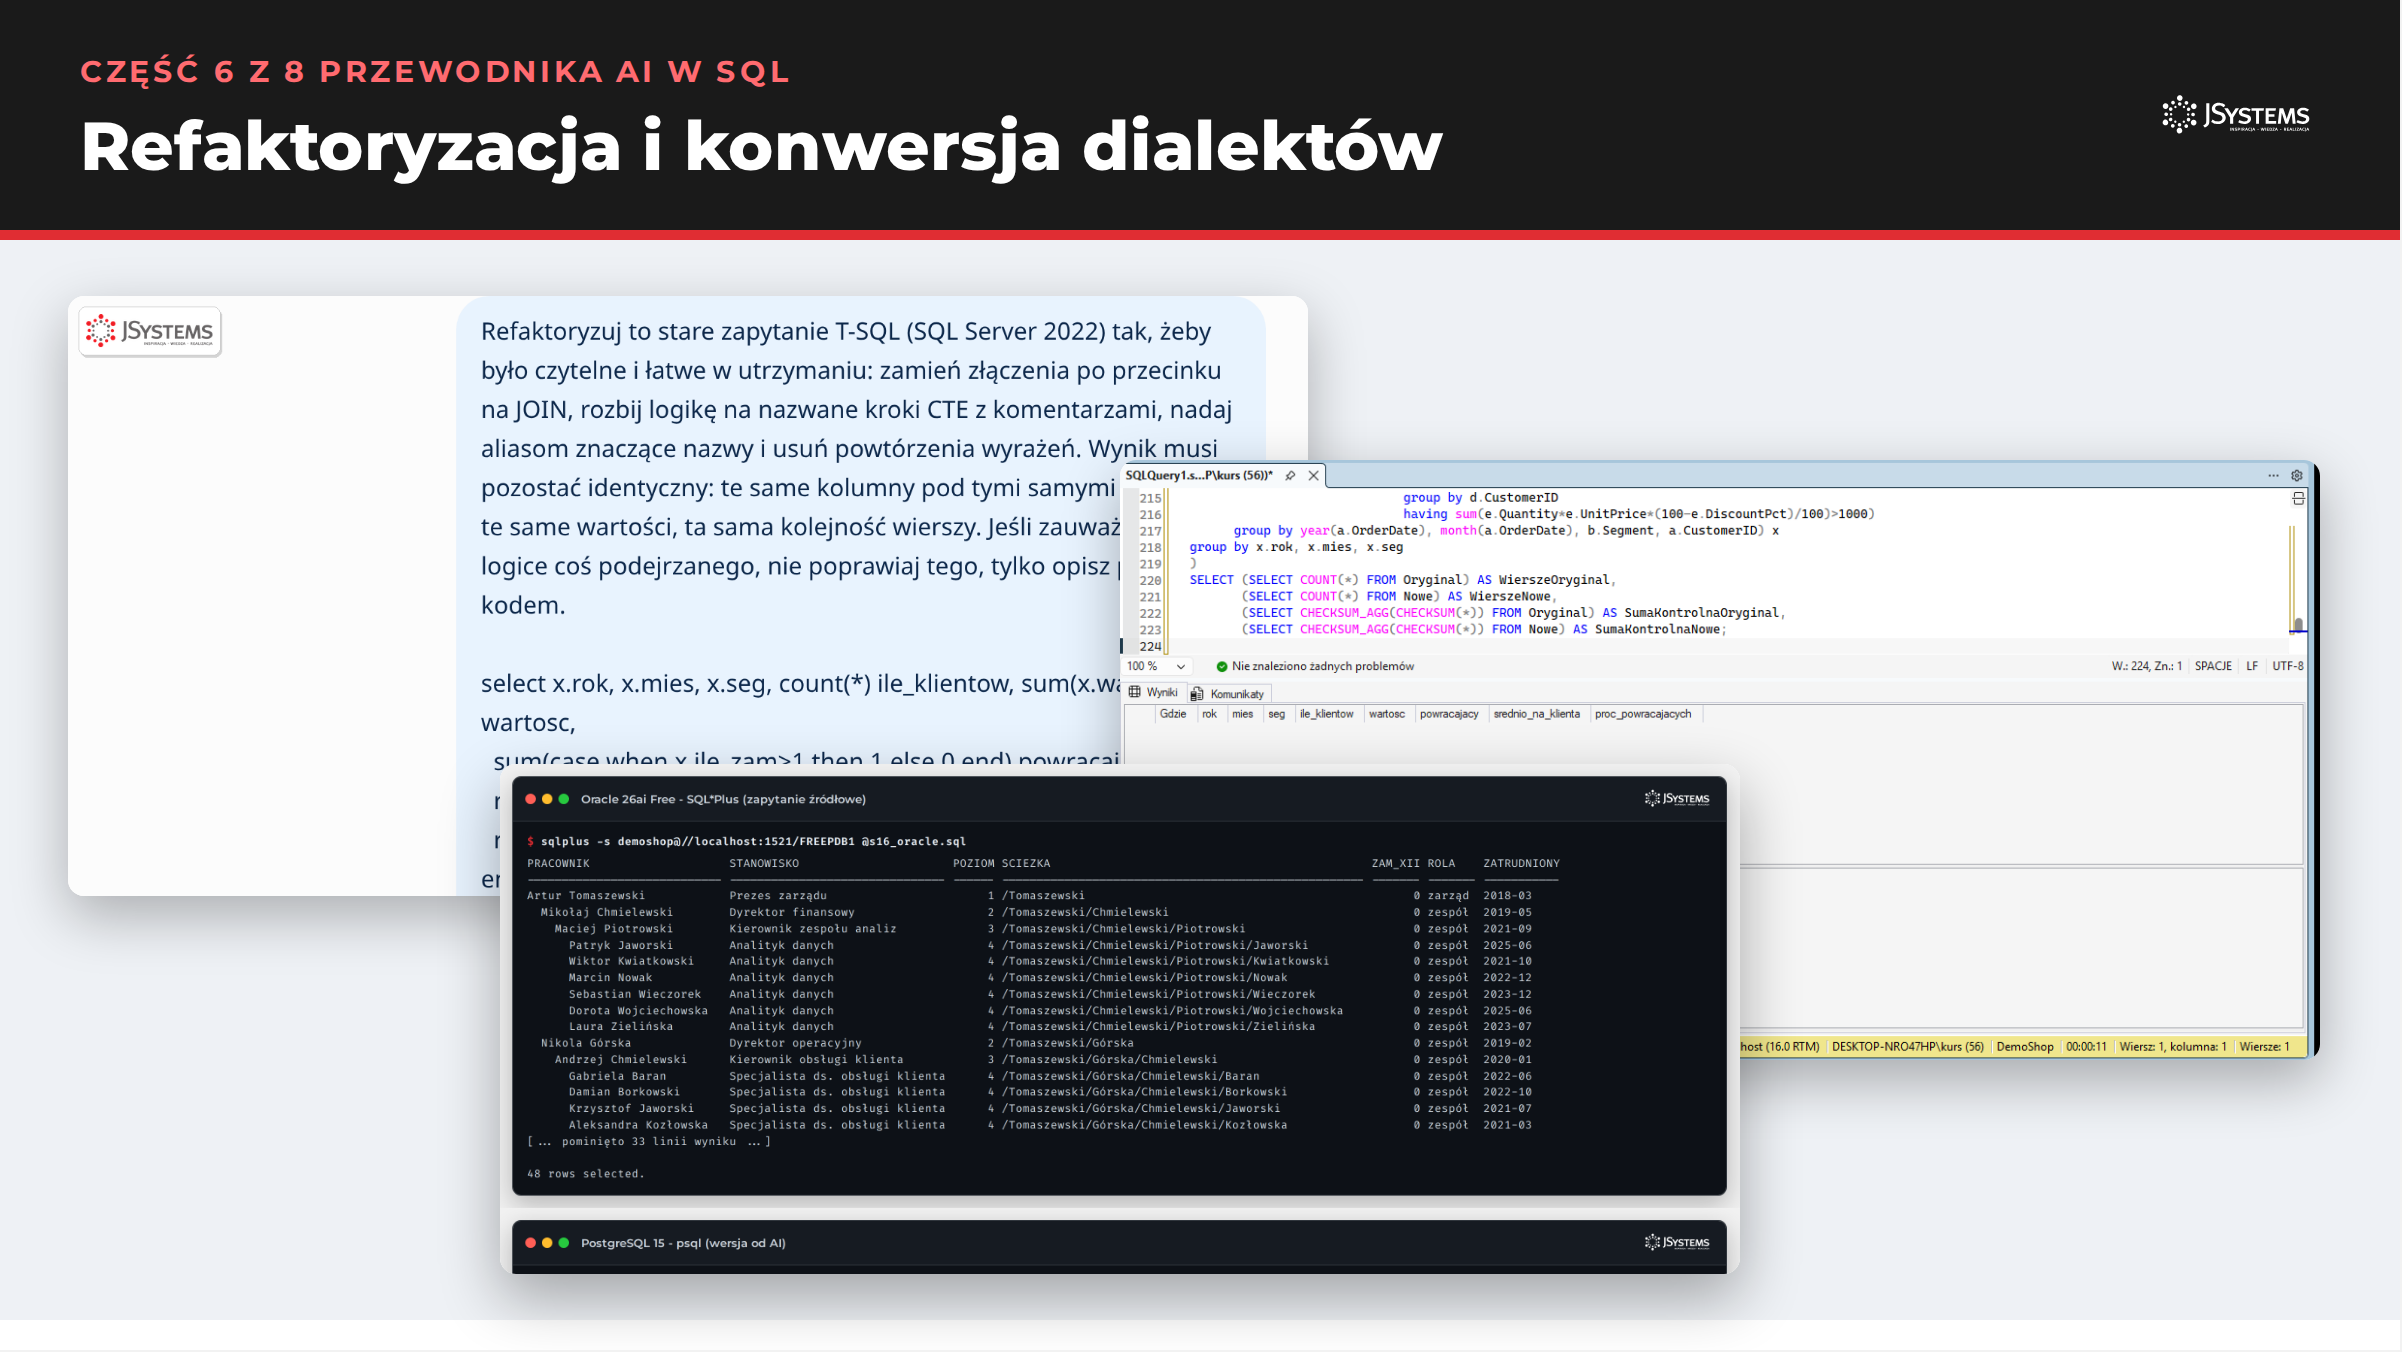
16. Refaktoryzacja bez zmiany wyniku (sekcja refaktoryzacja)
Refaktoryzuj to zapytanie T-SQL (SQL Server 2022) tak, żeby było czytelne i łatwe w utrzymaniu: zamień złączenia po przecinku na JOIN, rozbij logikę na nazwane kroki CTE z komentarzami, nadaj aliasom znaczące nazwy i usuń powtórzenia wyrażeń. Wynik musi pozostać identyczny: te same kolumny pod tymi samymi nazwami, te same wartości, ta sama kolejność wierszy. Jeśli zauważysz w logice coś podejrzanego, nie poprawiaj tego, tylko opisz pod kodem.
[zapytanie]
17. Konwersja dialektu (sekcja konwersja dialektów)
Przekonwertuj to zapytanie z [źródłowa baza] na [docelowa baza z wersją]. Tabele i kolumny w bazie docelowej mają [jak zapisane nazwy, np. małe litery bez cudzysłowów]. Wynik w bazie docelowej ma być identyczny, łącznie z kolejnością wierszy. Pod kodem wypisz każdą konstrukcję, którą zamieniłeś, i na co.
[zapytanie]
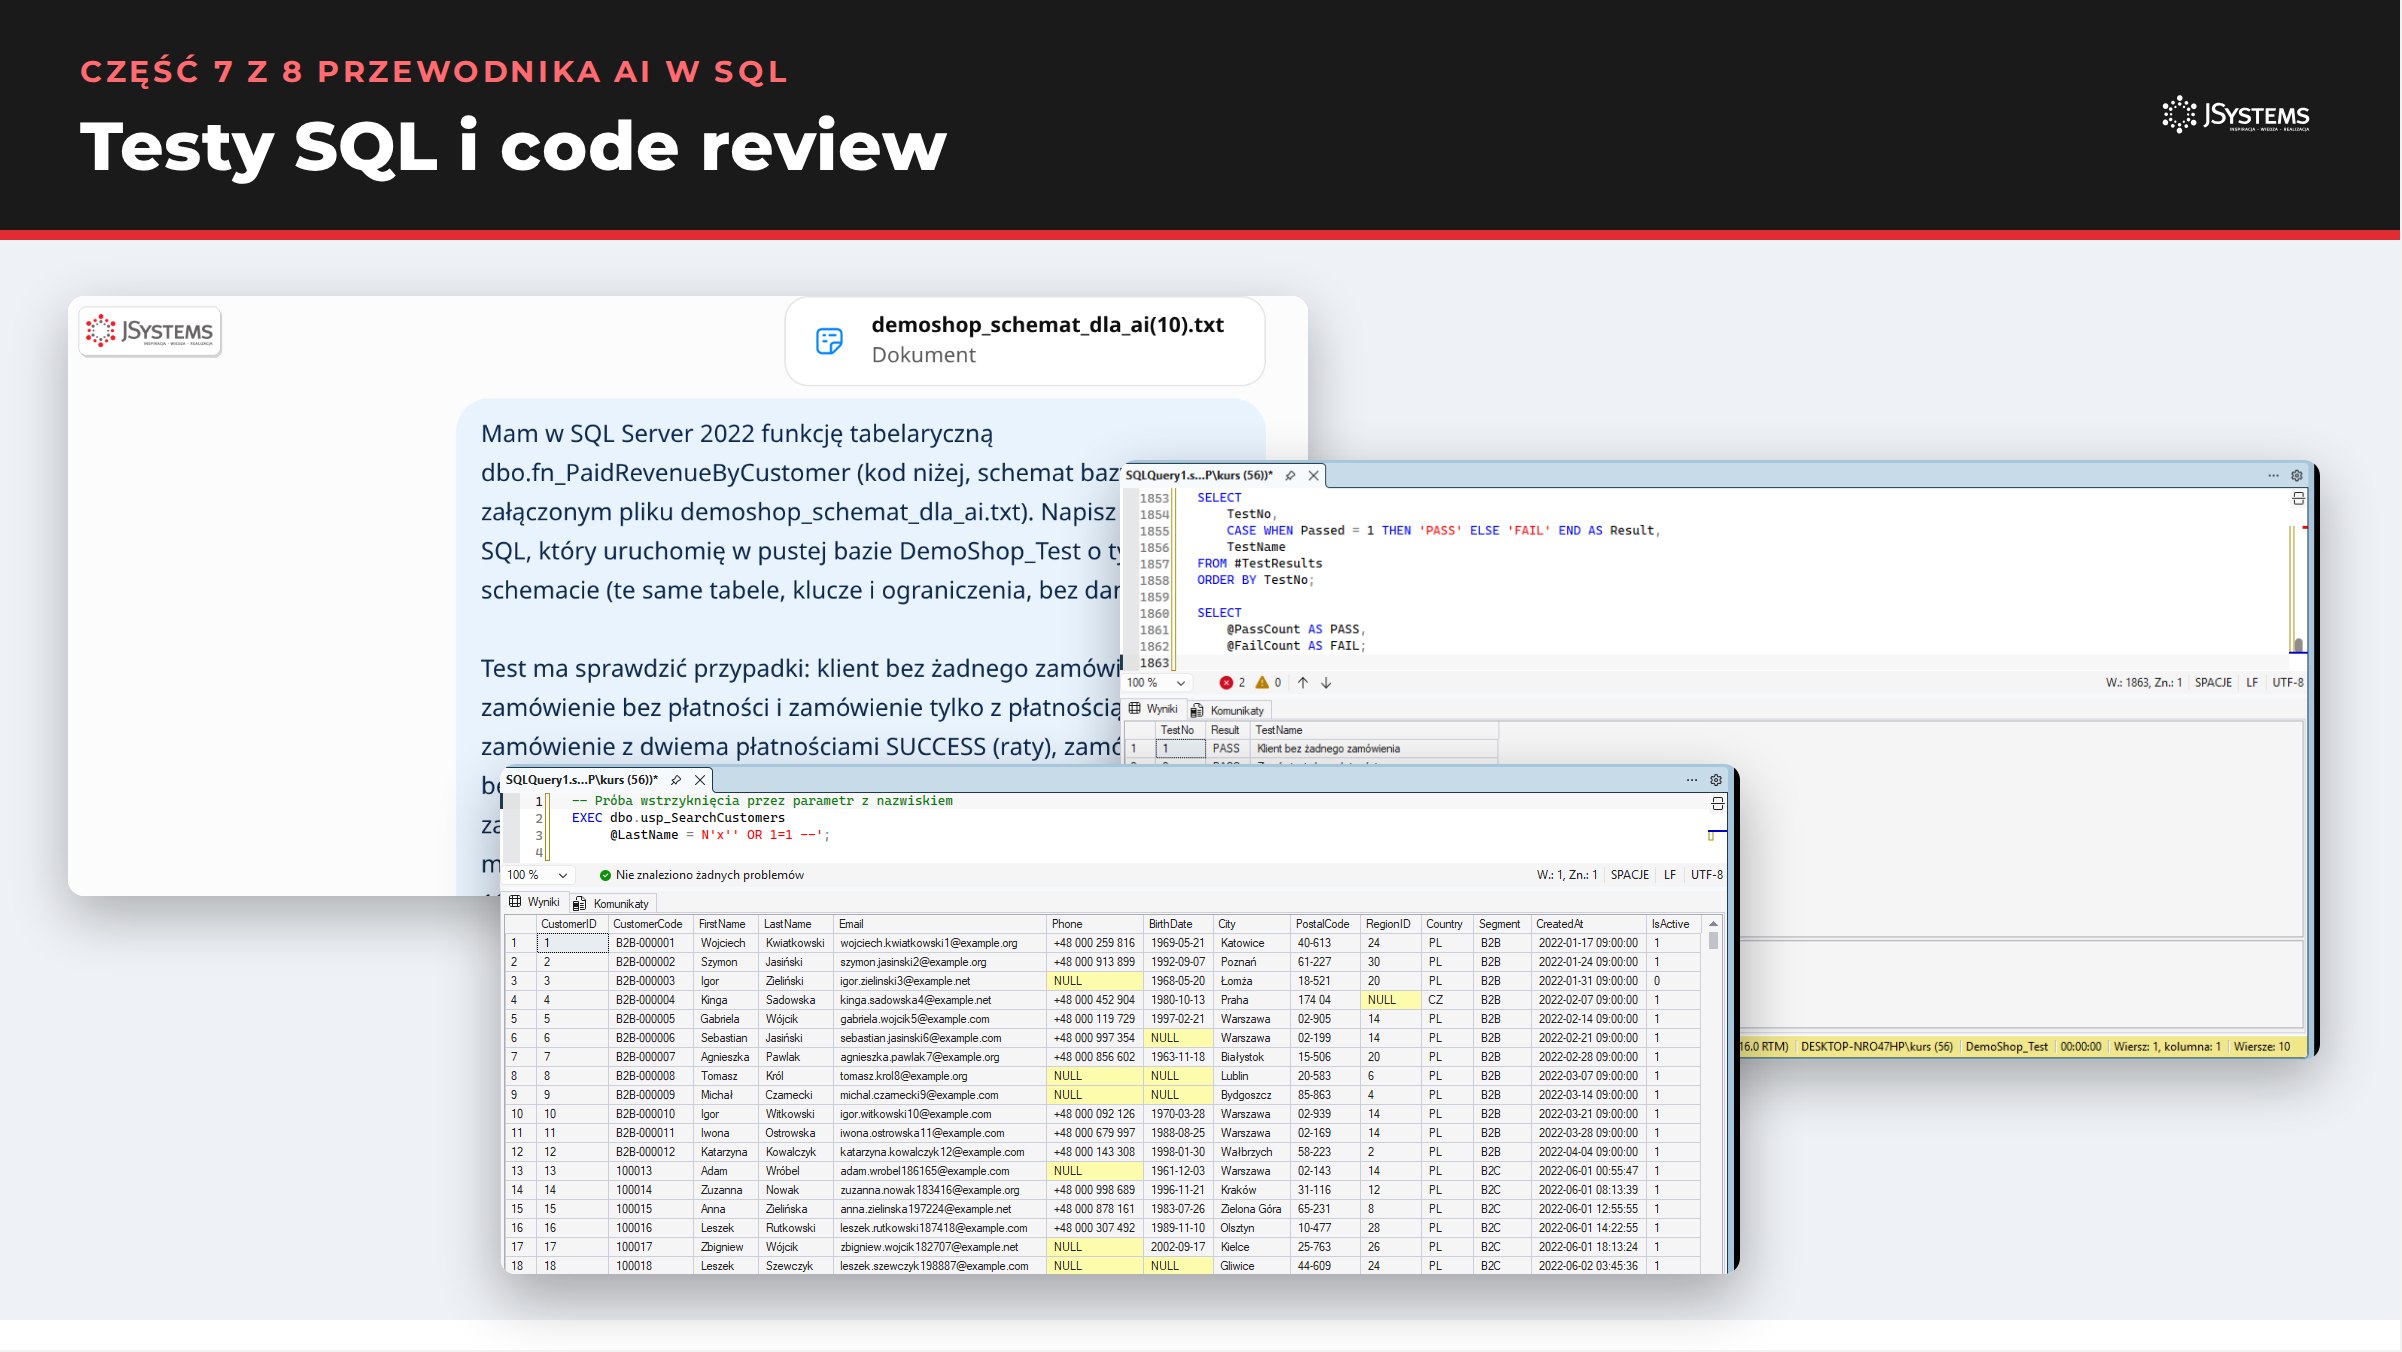
18. Testy z oczekiwanym wynikiem (sekcja testy SQL)
Mam w SQL Server 2022 funkcję [nazwa] (kod niżej, schemat bazy w załączonym pliku). Napisz test w T-SQL, który uruchomię w pustej bazie testowej o tym samym schemacie. Test ma sprawdzić przypadki: [lista przypadków brzegowych]. Dla każdego przypadku przygotuj dane (INSERT z jawnymi identyfikatorami, z zachowaniem kluczy obcych), zapisz oczekiwany wynik w tabeli tymczasowej, porównaj go z wynikiem funkcji przez EXCEPT w obie strony i wypisz jedną linię PASS albo FAIL z nazwą przypadku. Każdy przypadek sprząta po sobie. Na końcu wypisz liczbę PASS i FAIL.
[kod funkcji]
19. Code review według listy kontrolnej (sekcja code review)
Jesteś seniorem DBA. Zrób code review poniższego kodu T-SQL (SQL Server 2022) według listy kontrolnej. Dla każdego punktu napisz: spełnione, niespełnione albo nie dotyczy, a przy niespełnionych podaj konkretną poprawkę. Na końcu wypisz trzy najważniejsze zmiany w kolejności wdrażania.
Lista kontrolna:
[25 punktów z sekcji o code review]
Kod:
[kod]
20. Widok bez danych osobowych (sekcja anonimizacja)
Napisz w T-SQL (SQL Server 2022) widok dla [kogo], który pokaże [jakie dane] bez danych osobowych: pseudonim zamiast identyfikatora i nazwiska, wiek w przedziałach zamiast daty urodzenia, [inne uogólnienia], bez e-maila i telefonu. Schemat bazy w załączniku. Wyjaśnij, czy wynik jest anonimizacją czy pseudonimizacją w rozumieniu RODO i co z tego wynika.
Po kilkudziesięciu zadaniach na prawdziwej bazie obraz jest jasny. AI w SQL oszczędza najwięcej czasu tam, gdzie praca jest żmudna i dobrze opisana: przy pisaniu zapytań na podstawie schematu, czytaniu planów wykonania, konwersji między dialektami, testach i przeglądzie kodu. Najwięcej ryzyka niesie tam, gdzie odpowiedź zależy od danych, których AI nie widzi, i od założeń biznesowych, których nikt mu nie podał. Różnicę między jednym a drugim robi sposób pracy: schemat i wersja serwera w poleceniu, kod uruchamiany zawsze przed oceną, plan rzeczywisty zamiast opisu, zapytanie kontrolne liczone inną drogą, pomiar zamiast wrażenia i uprawnienia zamiast zaufania.
Pobierz pliki z początku przewodnika, odtwórz bazę DemoShop i przejdź jeden przykład z obszaru, który najbardziej Cię dotyczy: optymalizację raportu, wyszukiwanie błędu logicznego albo testy funkcji. Potem powtórz to samo na kopii własnej bazy, bez danych osobowych, i porównaj wynik AI z wynikiem z bazy tak, jak robiliśmy to w każdej sekcji.
Przewodnik AI w SQL: wszystkie części


Komentarze (0)
Brak komentarzy...