
Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
W skrócieOptymalizacja SQL z AI to pętla: plan rzeczywisty, hipotezy od AI, jedna zmiana, ponowny plan i pomiar. Na bazie DemoShop skróciliśmy 500 wywołań panelu klienta z 30,13 s do 0,61 s, a raport zarządu z 74,5 s do 0,82 s. Pokazujemy też 19 sygnałów w planie wykonania i dobór indeksów.
To część 4 z 8 przewodnika AI w SQL. Wszystkie przykłady powstały na bazie DemoShop w SQL Server 2022: fikcyjnym sklepie internetowym z 2,4 mln zamówień. Polecenia wpisujemy do ChatGPT, ale te same możesz podać Microsoft Copilotowi, Claude albo Gemini. Przy skryptach korzystających z mechanizmów serwera w małej szarej ramce znajdziesz ich odpowiedniki dla Oracle i PostgreSQL.
Z tej części dowiesz się:
Pliki do tej części
Skrypt bazy uruchamiasz w SSMS na serwerze SQL Server 2019 lub nowszym. Tworzy bazę DemoShop, na której powstały wszystkie przykłady.
Optymalizacja z AI nie polega na wklejeniu zapytania i prośbie „przyspiesz”. Taki skrót kończy się zwykle listą ogólnych porad, z których połowa nie dotyczy Twojego przypadku. Działa za to pętla, w której AI robi to, w czym jest dobre (czyta plan, stawia hipotezy, proponuje zmiany), a decyzje opierasz na pomiarach z bazy:
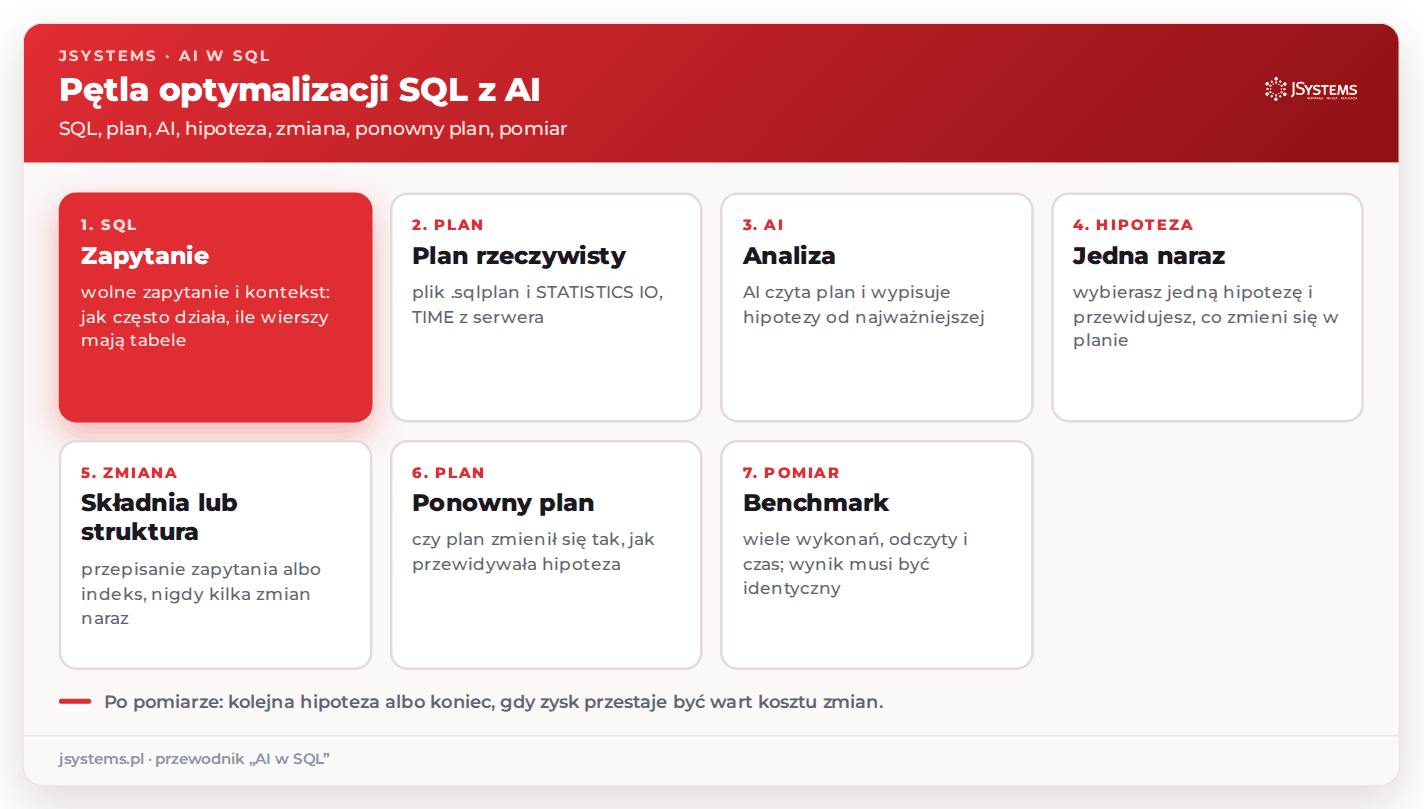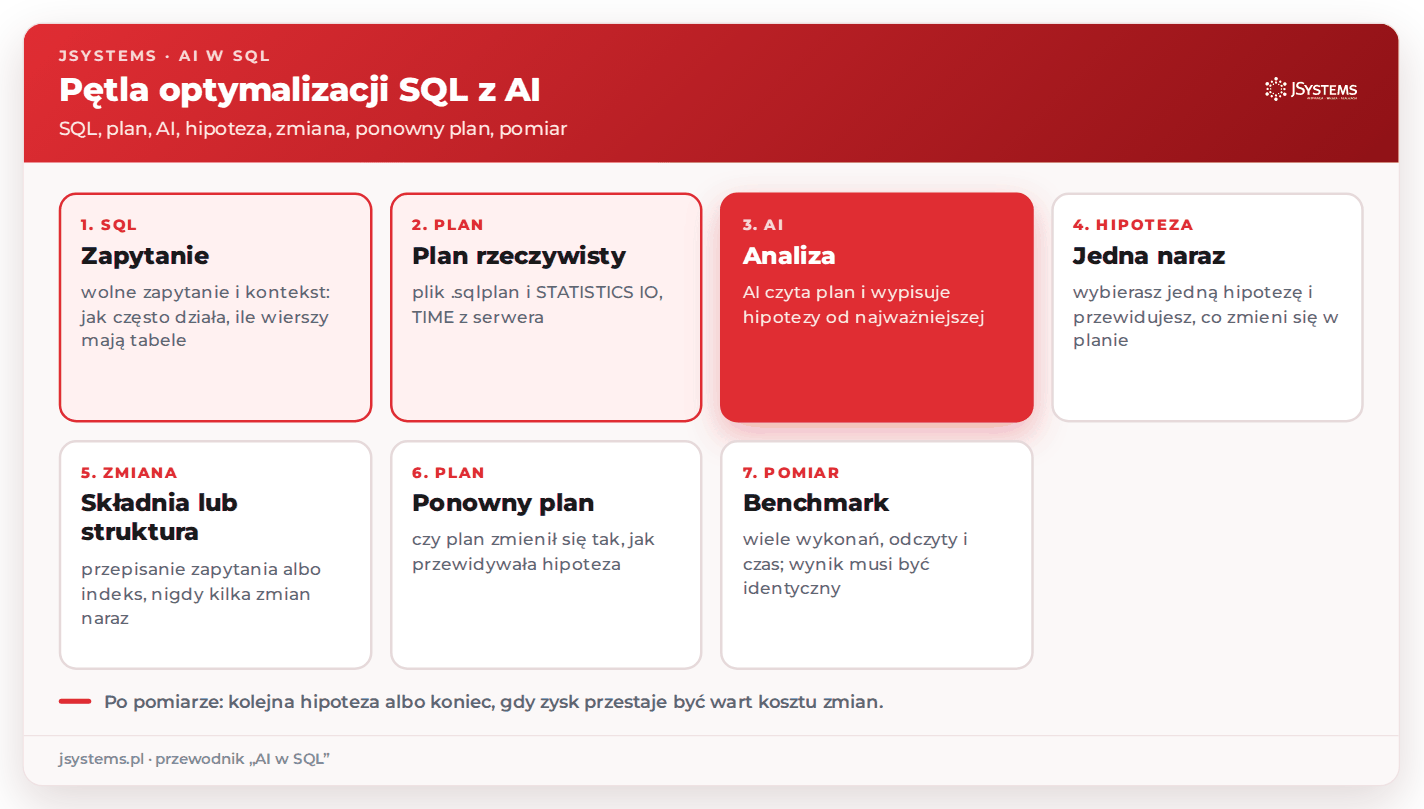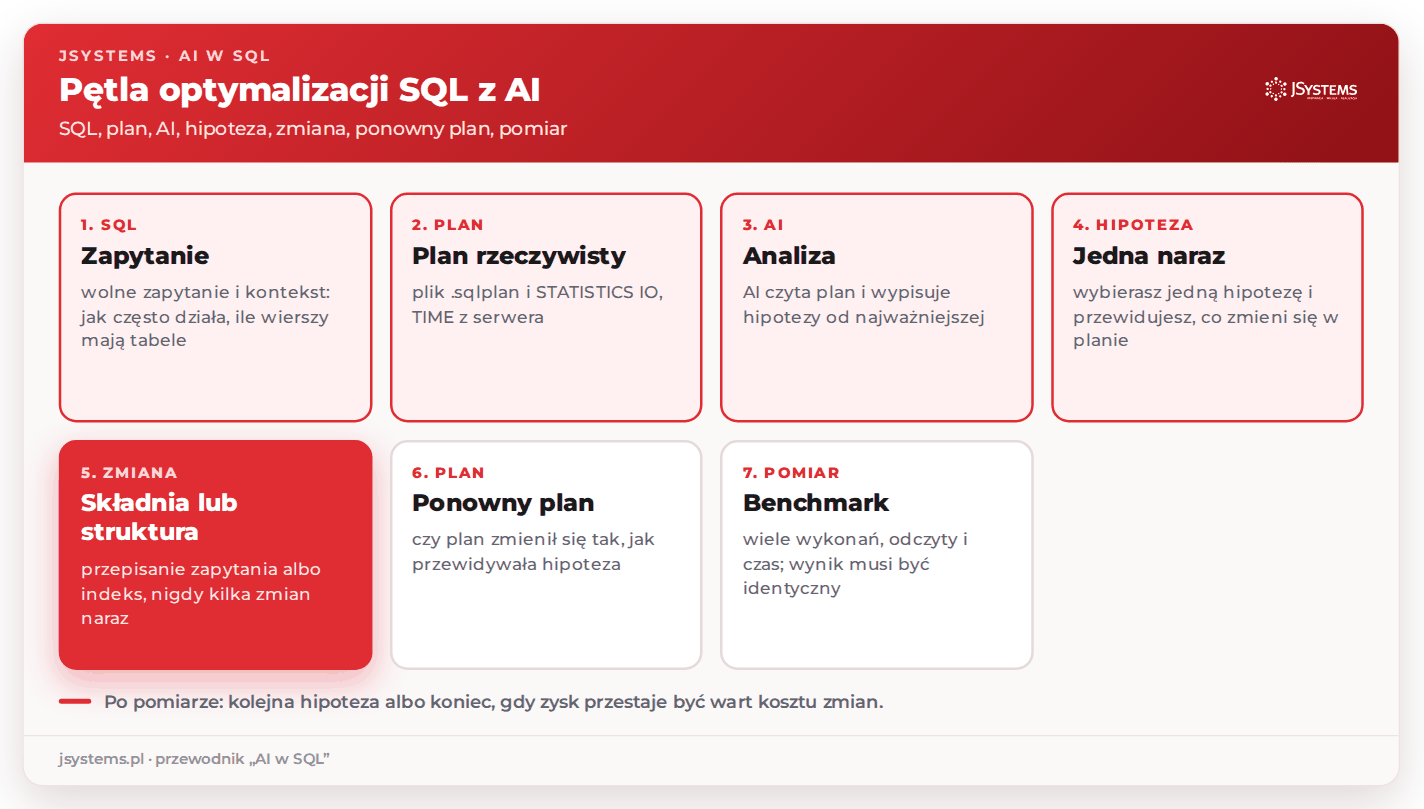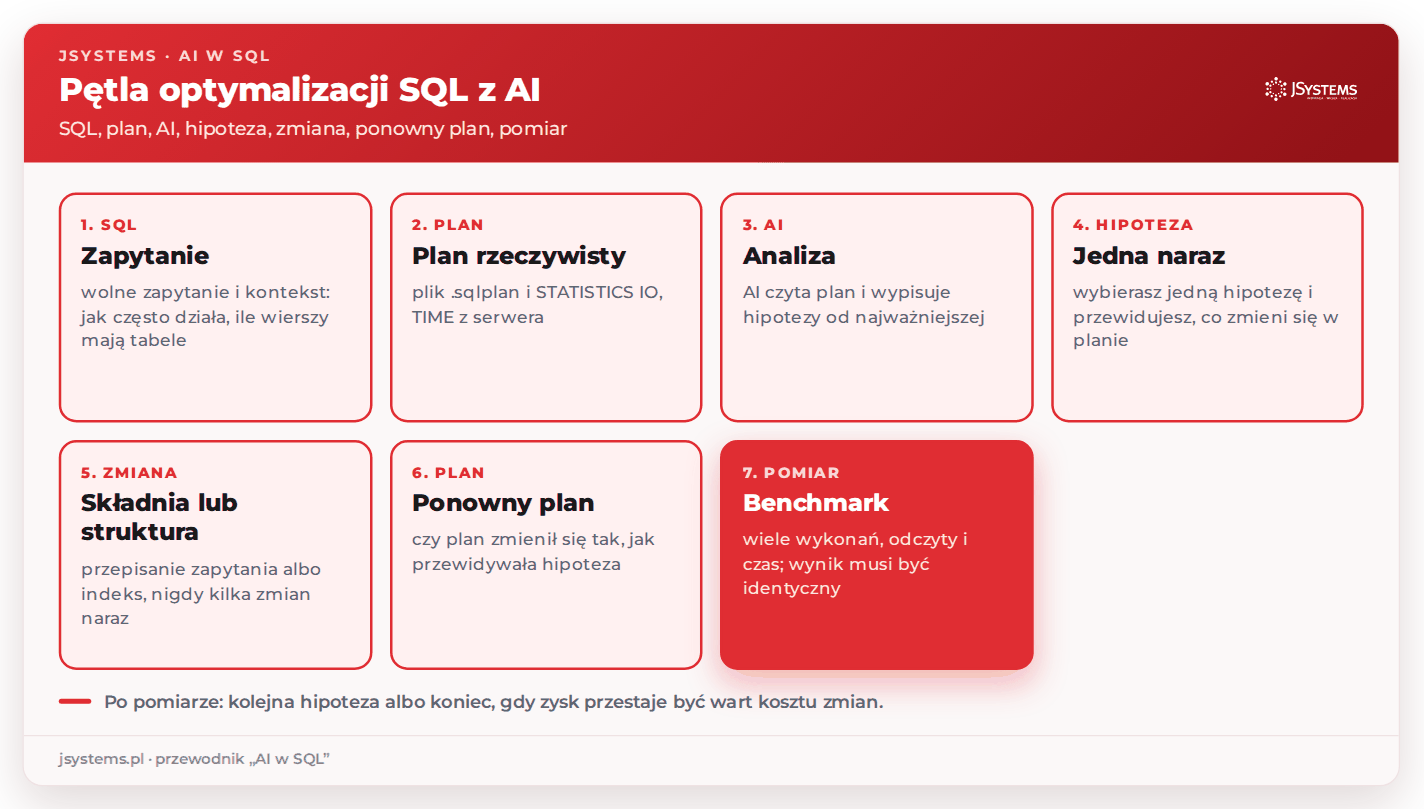
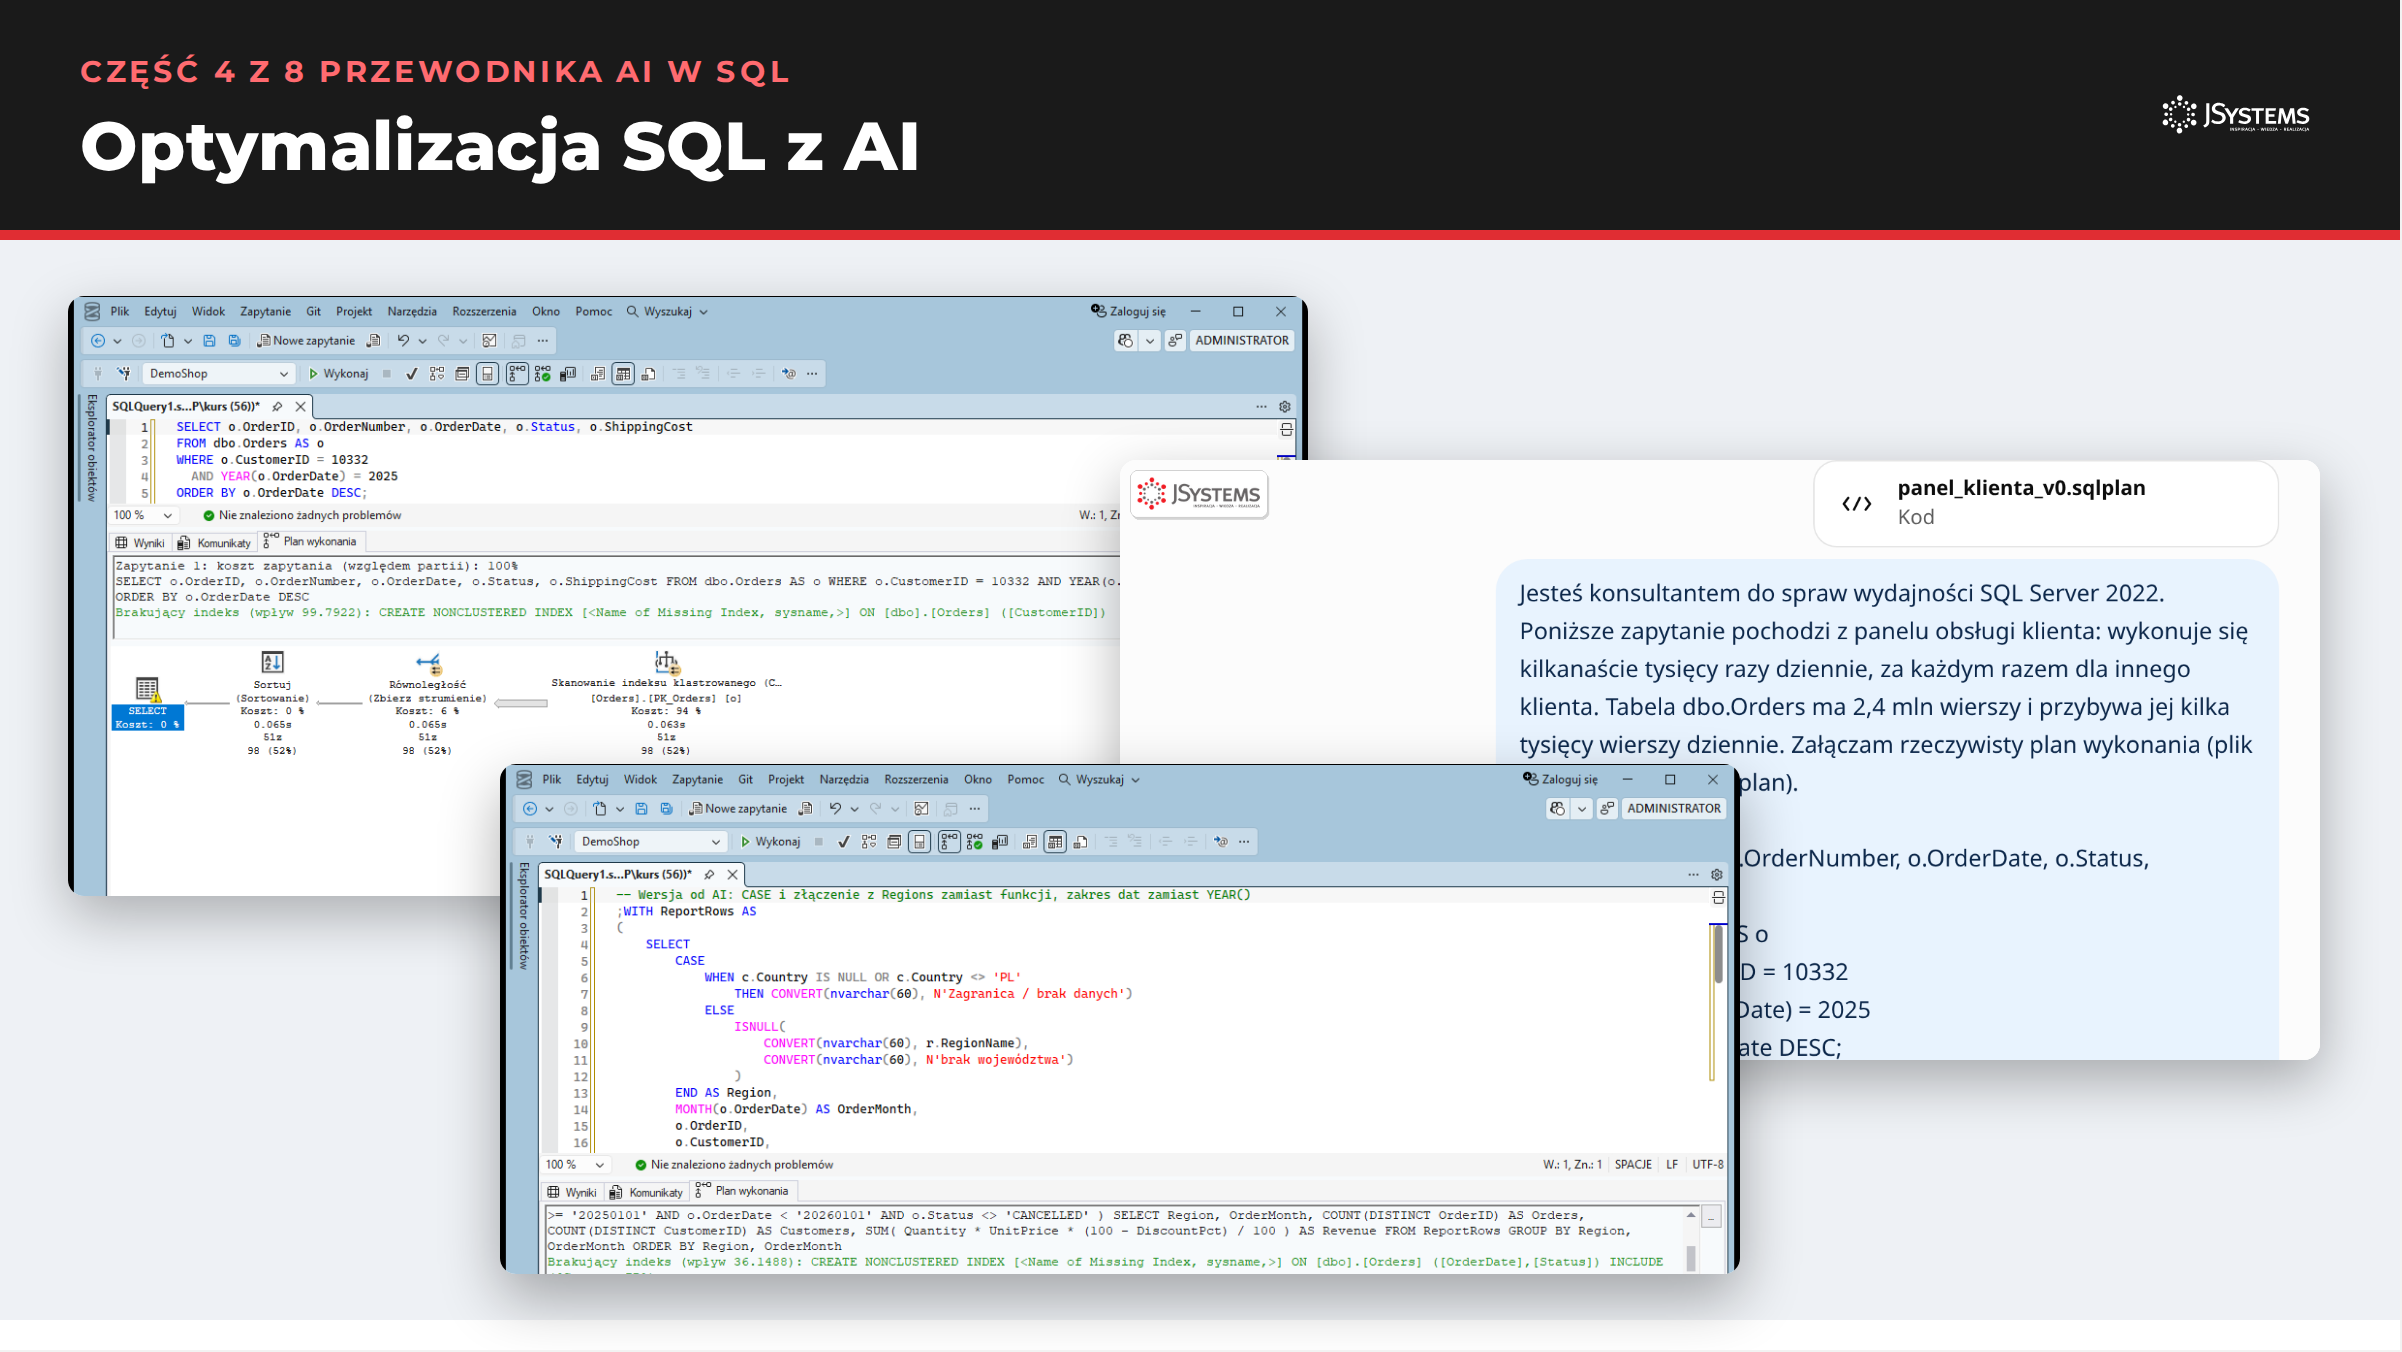
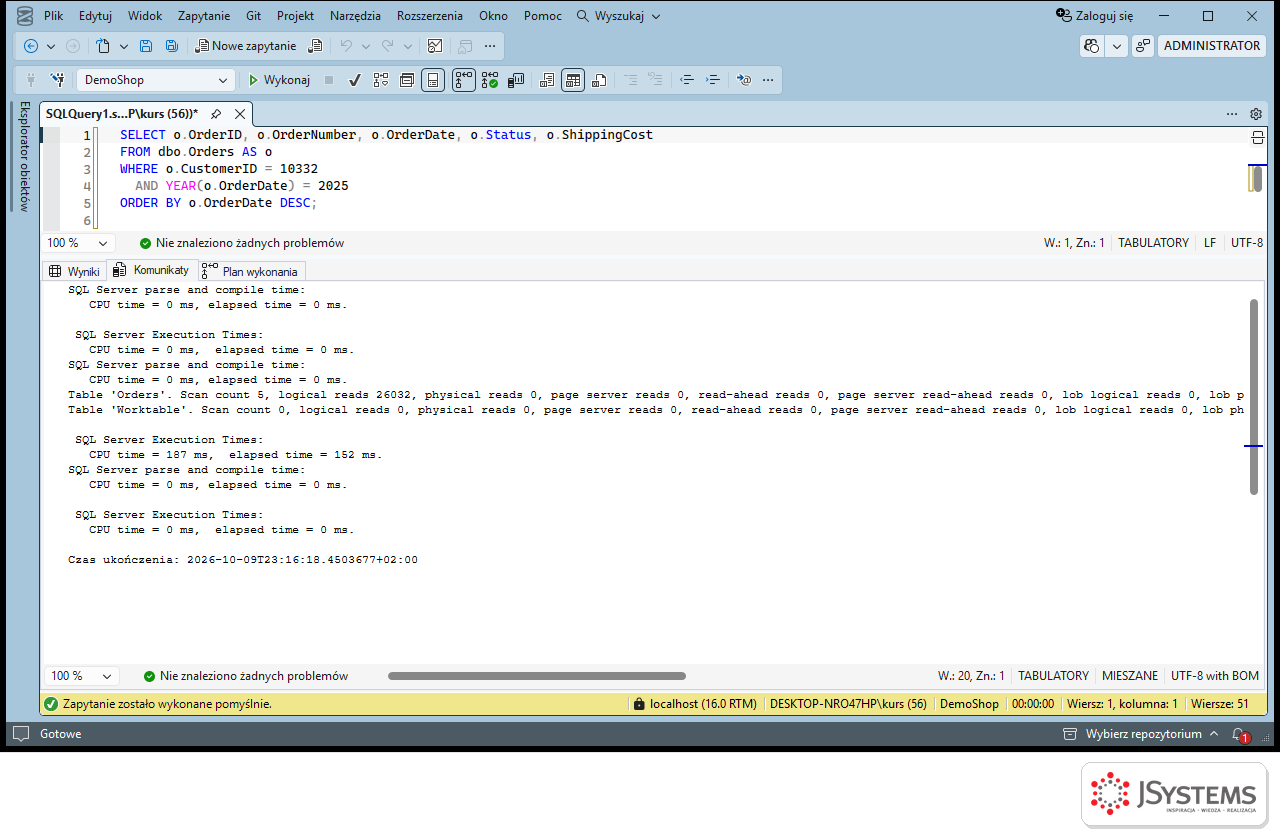
Pokażemy ją na zapytaniu z panelu obsługi klienta. Konsultant otwiera kartę klienta i widzi jego zamówienia z danego roku. Zapytanie jest proste i dla jednego wywołania szybkie, ale wykonuje się tysiące razy dziennie, więc każda milisekunda i każda strona odczytana z dysku mnoży się przez liczbę wywołań.
SELECT o.OrderID, o.OrderNumber, o.OrderDate, o.Status, o.ShippingCost
FROM dbo.Orders AS o
WHERE o.CustomerID = 10332
  AND YEAR(o.OrderDate) = 2025
ORDER BY o.OrderDate DESC;
W SSMS włączamy rzeczywisty plan wykonania (Ctrl+M) i statystyki odczytów (SET STATISTICS IO, TIME ON), a potem uruchamiamy zapytanie. Jak czytać plan krok po kroku, pokazujemy w następnej sekcji; tu wystarczy obraz całości:
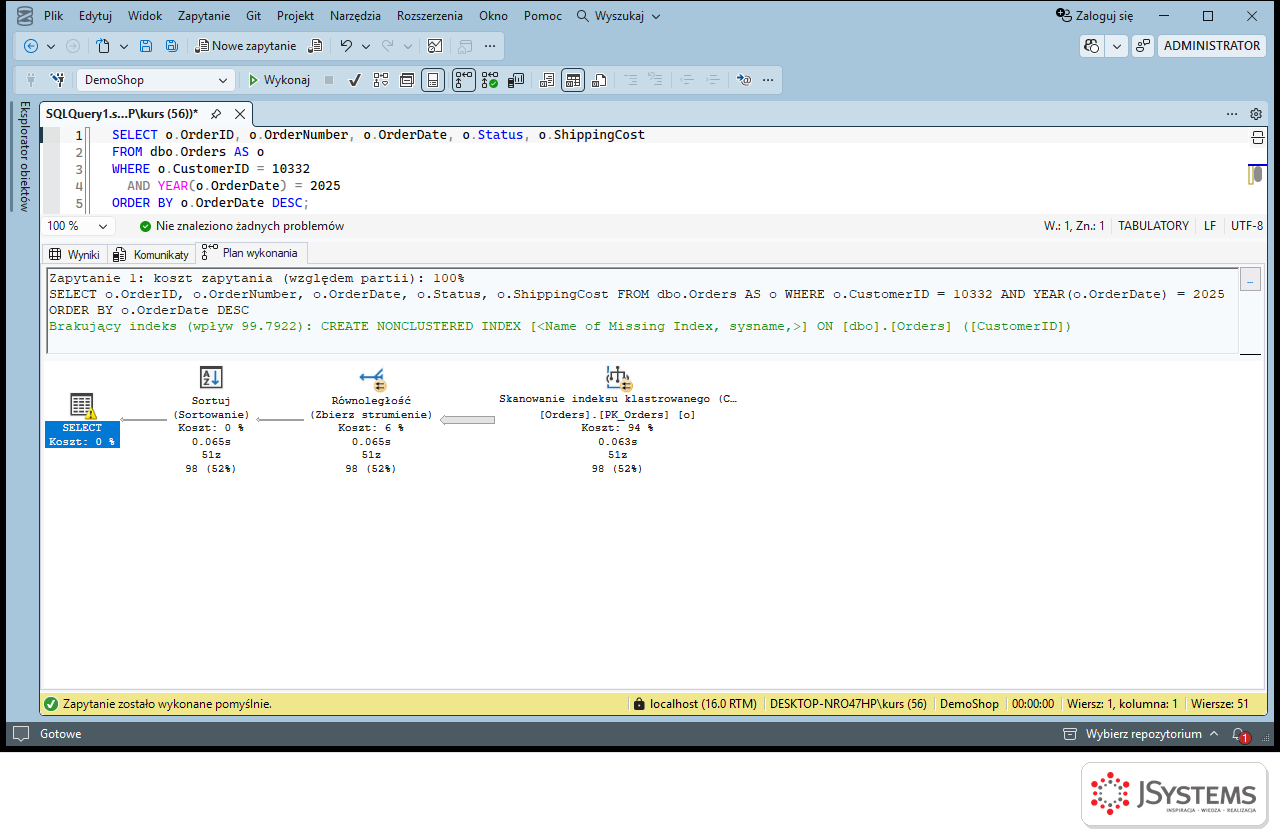
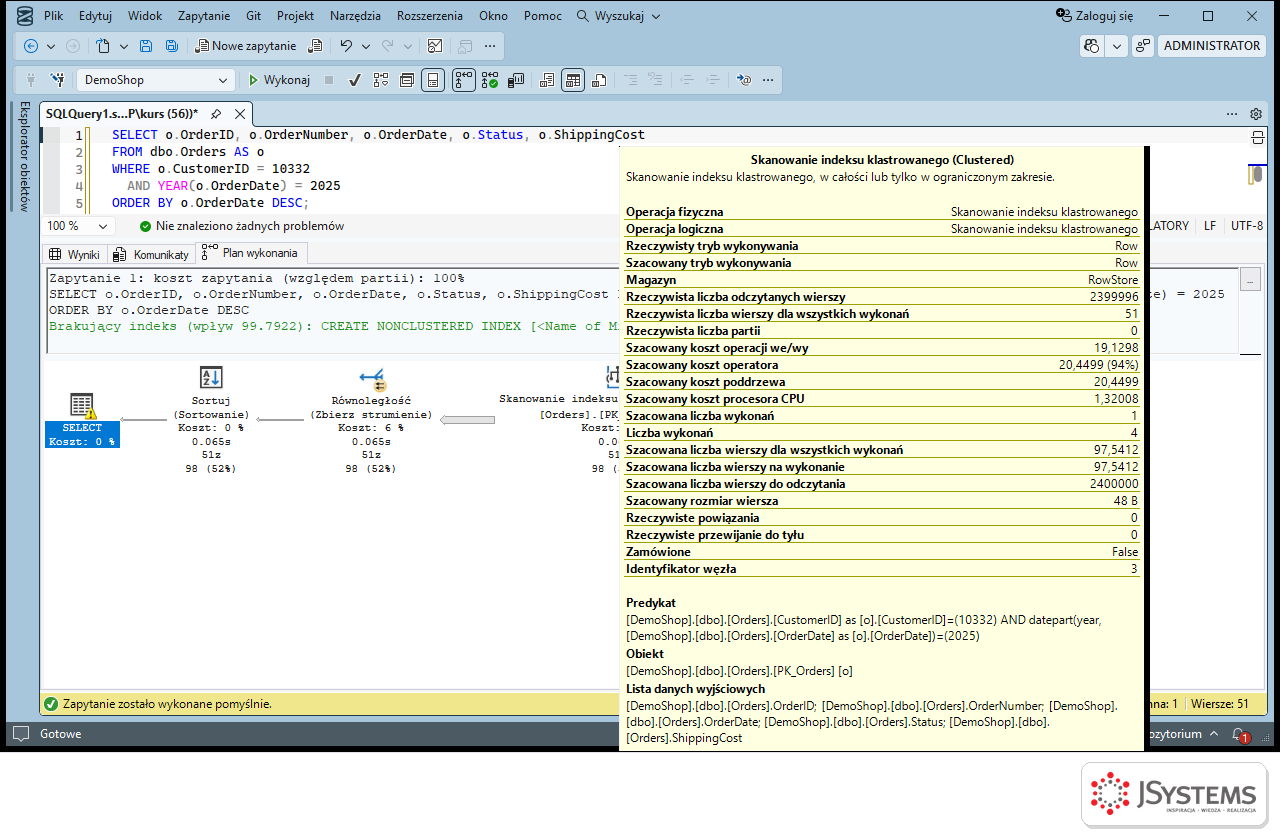
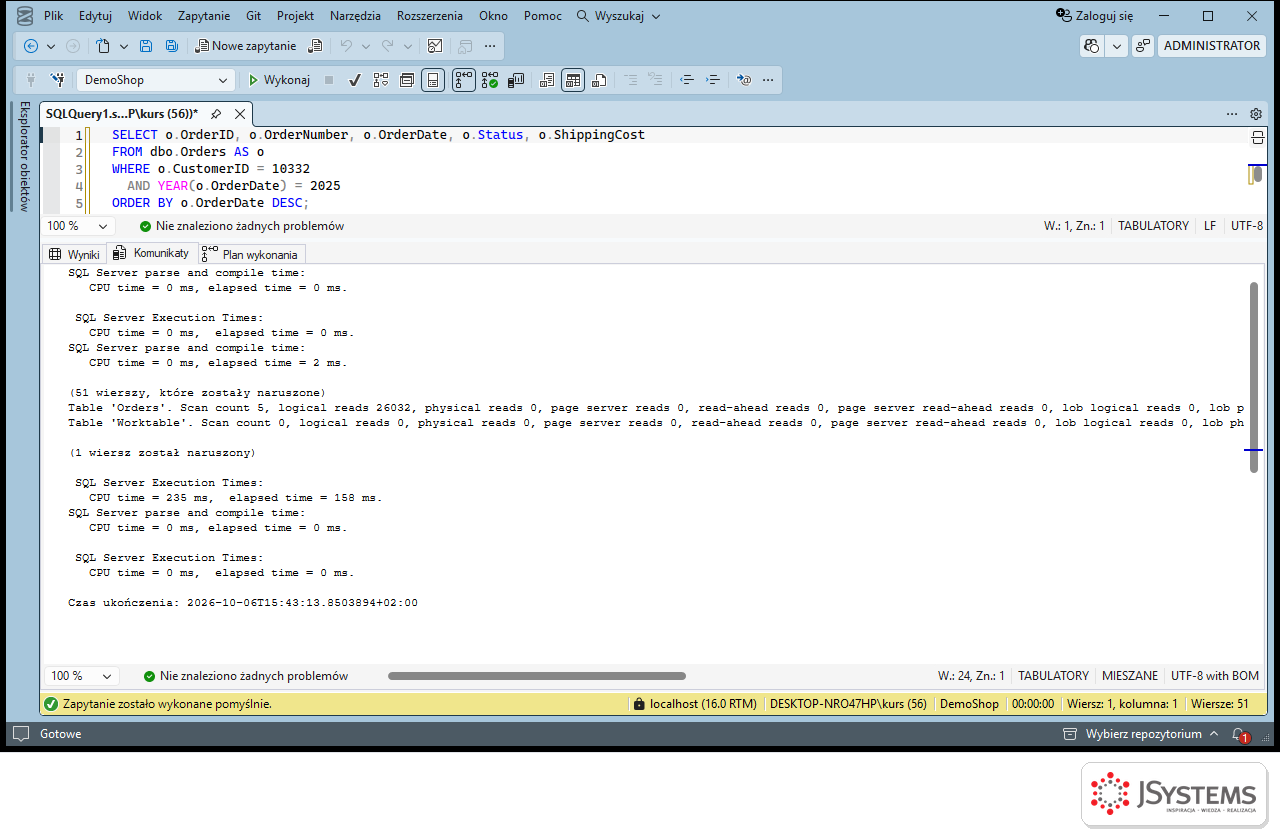
Plan zapisujemy jako plik (prawy przycisk myszy na planie, „Zapisz plan wykonywania jako”). Plik .sqlplan to XML z pełną informacją o wykonaniu: liczbą wierszy w każdym operatorze, odczytami, przydziałem pamięci i ostrzeżeniami. Dla AI jest znacznie cenniejszy niż zrzut ekranu, bo zawiera wszystkie liczby, także te niewidoczne w dymkach. Jak włączyć plan rzeczywisty i zapisać go krok po kroku, pokazujemy w części o planie wykonania.
Polecenie daje AI kontekst biznesowy (jak często zapytanie się wykonuje i jak rośnie tabela) i wymaga konkretnej formy odpowiedzi: hipotezy uszeregowane od najważniejszej, do każdej jedna zmiana do przetestowania i opis, co powinno się zmienić w planie, jeśli hipoteza jest prawdziwa. Ten ostatni element jest kluczowy, bo zamienia poradę w eksperyment, który da się sprawdzić.
Jesteś konsultantem do spraw wydajności SQL Server 2022. Poniższe zapytanie pochodzi z panelu obsługi klienta: wykonuje się kilkanaście tysięcy razy dziennie, za każdym razem dla innego klienta. Tabela dbo.Orders ma 2,4 mln wierszy i przybywa jej kilka tysięcy wierszy dziennie. Załączam rzeczywisty plan wykonania (plik panel_klienta_v0.sqlplan).
[zapytanie]
Wypisz hipotezy, co sprawia, że zapytanie jest kosztowne, od najważniejszej. Do każdej podaj jedną zmianę do przetestowania (w składni zapytania albo w strukturze bazy, np. indeks) i opisz, co powinno się zmienić w planie, jeśli hipoteza jest prawdziwa. Zaproponuj kolejność testowania zmian, po jednej naraz.
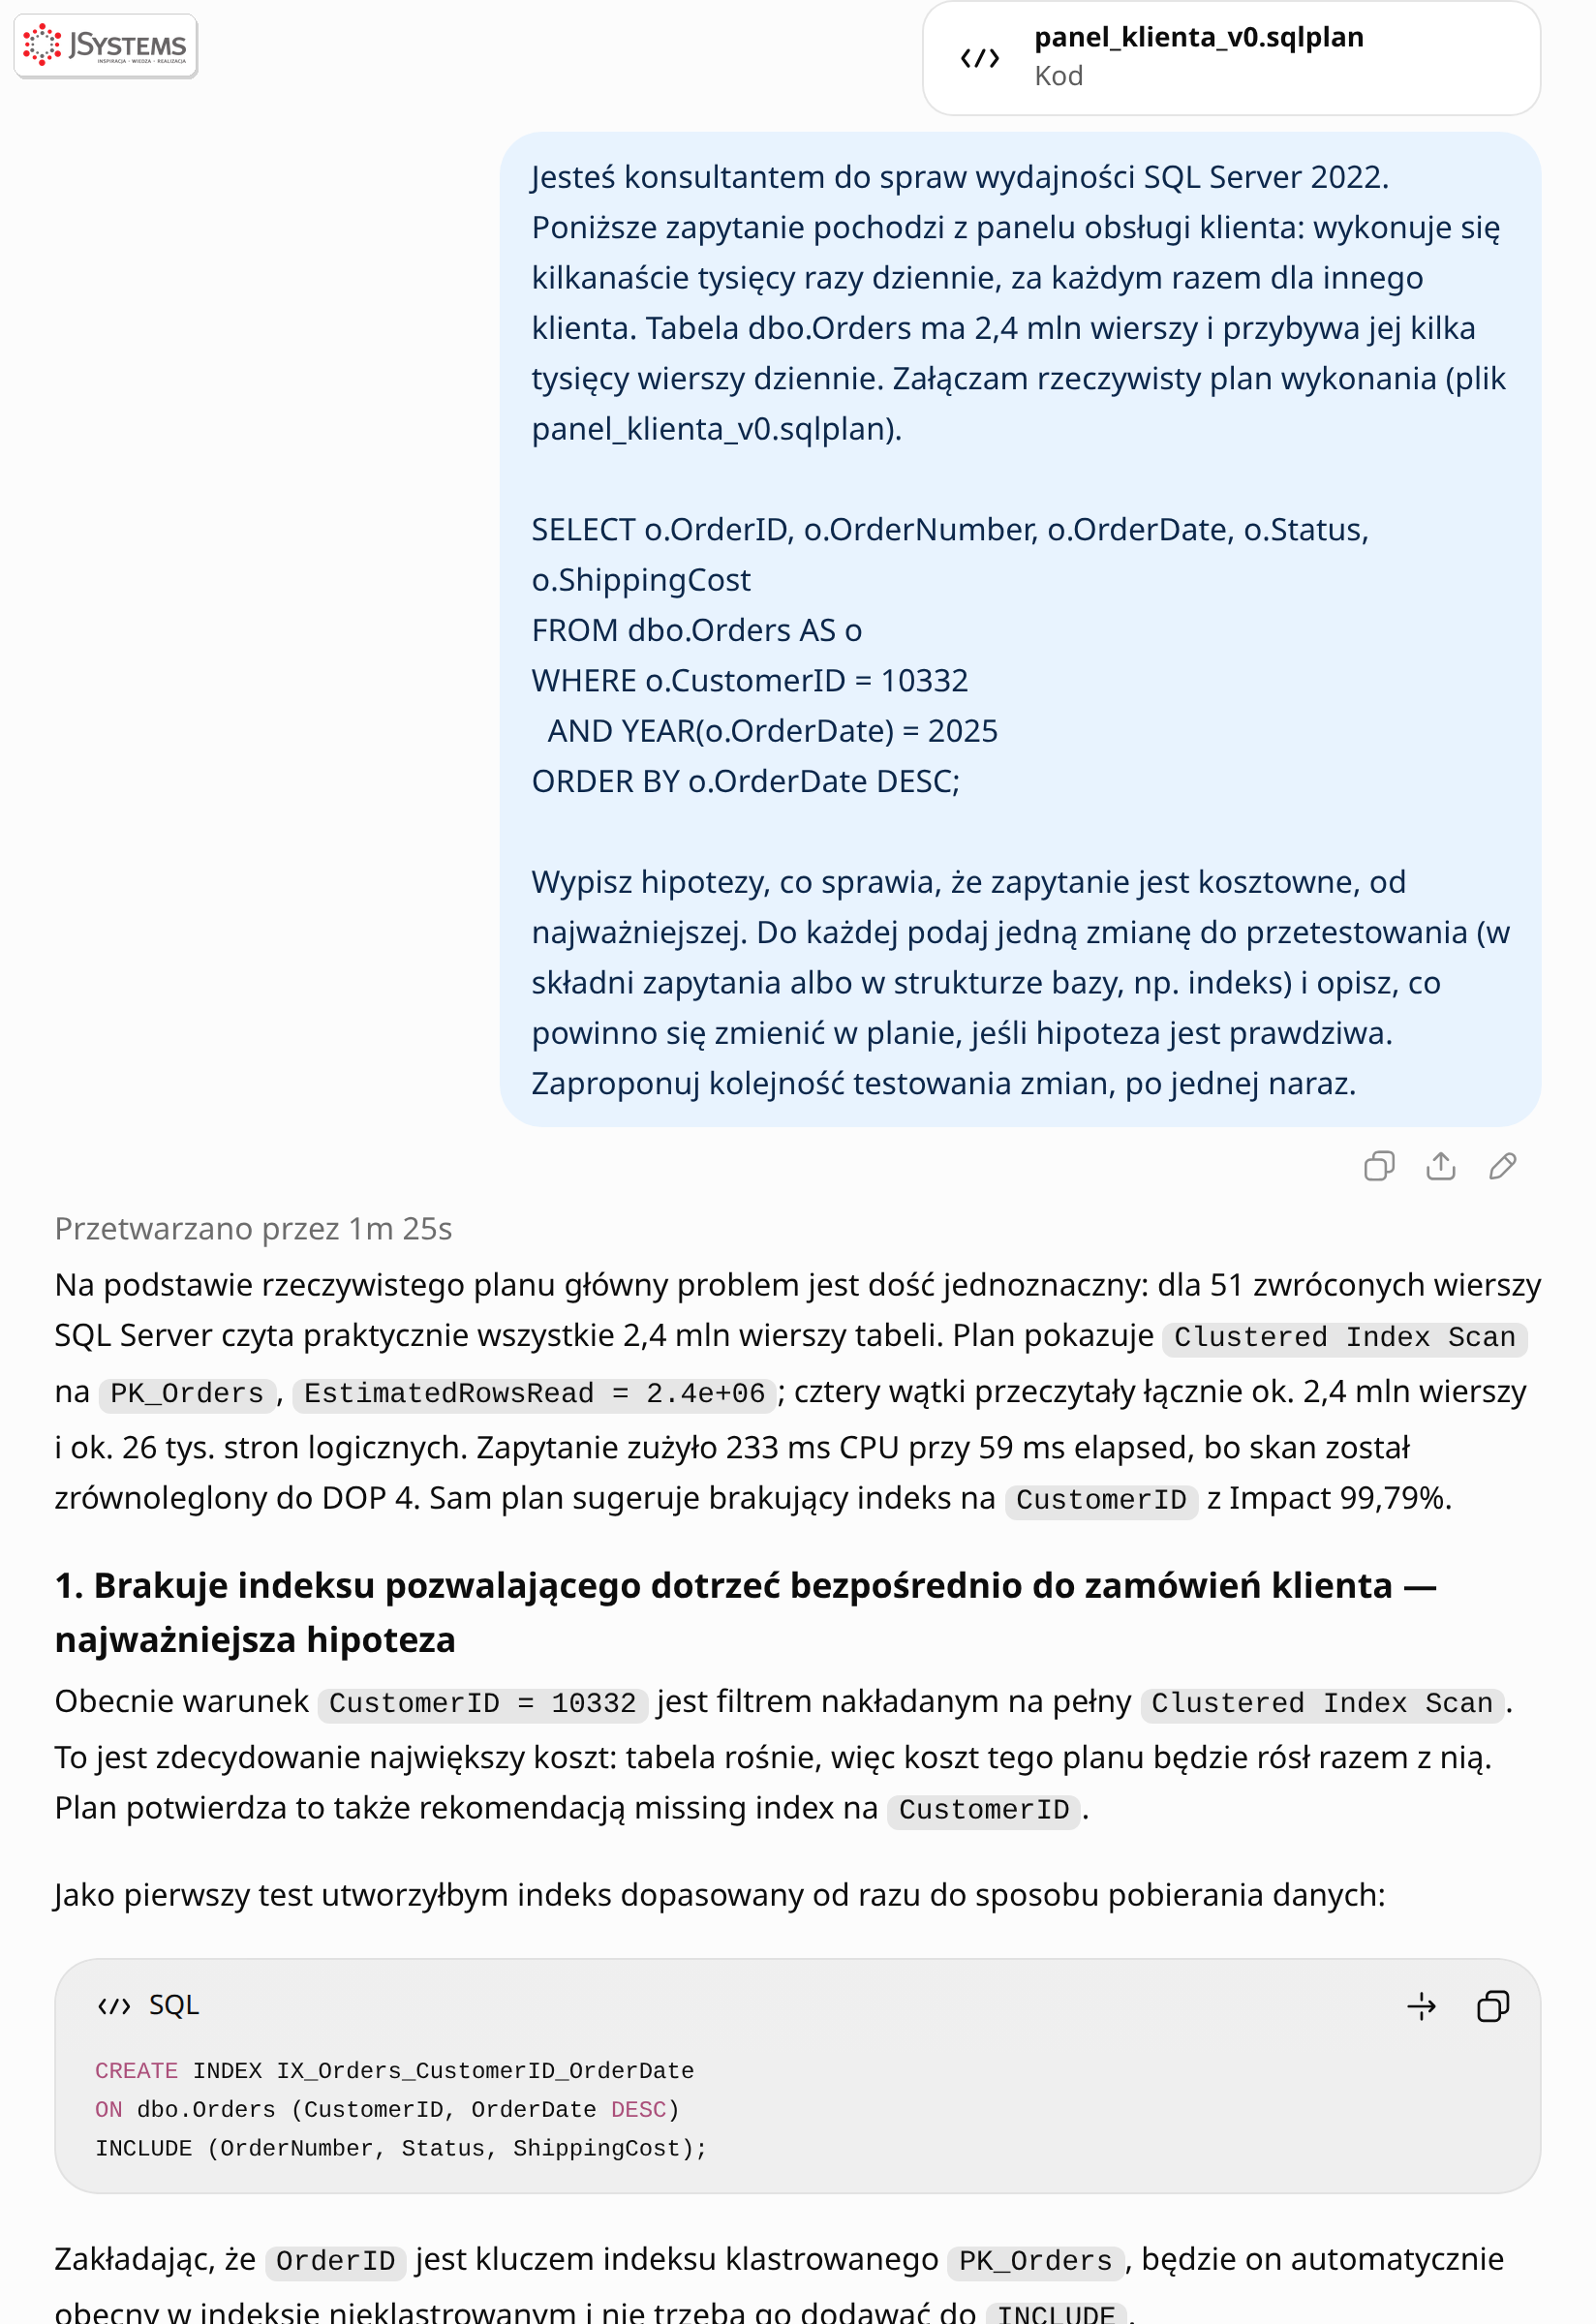
AI postawiło sześć hipotez. W drugiej pada słowo „niesargowalny” (od angielskiego search argument, w skrócie SARG). Sargowalny jest warunek, którego serwer może użyć do wyszukania wartości w indeksie: przy OrderDate >= '20250101' AND OrderDate < '20260101' skacze w indeksie dat od razu na początek roku i kończy na jego końcu. Warunek YEAR(OrderDate) = 2025 jest niesargowalny, bo serwer musi najpierw policzyć YEAR() dla każdego wiersza i dopiero wtedy wie, czy wiersz pasuje, więc czyta wszystkie. Inne przykłady takich warunków opisujemy w sygnale nr 10. Hipotezy AI zestawiamy z tym, co później zmierzyliśmy:
| Nr | Hipoteza AI | Zmiana do testu | Przewidywanie AI | Wynik pomiaru |
|---|---|---|---|---|
| 1 | Brak indeksu prowadzącego do zamówień klienta | Indeks (CustomerID, OrderDate DESC) INCLUDE (OrderNumber, Status, ShippingCost) | Skan zamieni się w wyszukiwanie, odczyty spadną do kilkunastu lub kilkudziesięciu stron | Potwierdzona: 26 032 odczyty spadły do 4 |
| 2 | YEAR(OrderDate) jest niesargowalny | Zakres dat zamiast funkcji | Rok stanie się granicą wyszukiwania, odczytane wiersze zbliżą się do zwróconych | Potwierdzona: 173 odczytane wiersze spadły do 51 |
| 3 | Sortowanie wymusza przydział pamięci | Kolejność DESC w indeksie (bez osobnej zmiany) | Sort i przydział pamięci znikną | Potwierdzona: brak Sort, przydział 0 KB |
| 4 | Równoległość maskuje koszt skanu | Bez wskazówek, sprawdzić plan po zmianach 1-2 | Optymalizator sam wybierze plan szeregowy | Potwierdzona: brak operatora Równoległość |
| 5 | Błąd szacowania liczby wierszy | Brak zmiany, statystyki świeże | Nie jest główną przyczyną | Zgodnie z przewidywaniem: 97,5 szacowanych wobec 51 rzeczywistych |
| 6 | Literał zamiast parametru zaśmieca pamięć planów | Parametryzacja po stronie aplikacji | Wpływ na całe obciążenie, nie na pojedyncze wywołanie | Poza zakresem pomiaru pojedynczego zapytania |
Dwie rzeczy odróżniają tę odpowiedź od porad ogólnych. AI odradziło leczenie objawów: zamiast wskazówki MAXDOP 1 (wymuszenie liczenia zapytania na jednym wątku) czy ograniczania przydziału pamięci zaproponowało usunięcie przyczyny i sprawdzenie, czy objawy znikną same. Do tego zaproponowało jeden indeks, który testuje trzy hipotezy naraz, i wyjaśniło dlaczego.
Zgodnie z kolejnością zaproponowaną przez AI zaczynamy od indeksu. Zapytanie zostaje bez zmian, żeby zmierzyć efekt samego indeksu:
CREATE INDEX IX_Orders_CustomerID_OrderDate
ON dbo.Orders (CustomerID, OrderDate DESC)
INCLUDE (OrderNumber, Status, ShippingCost);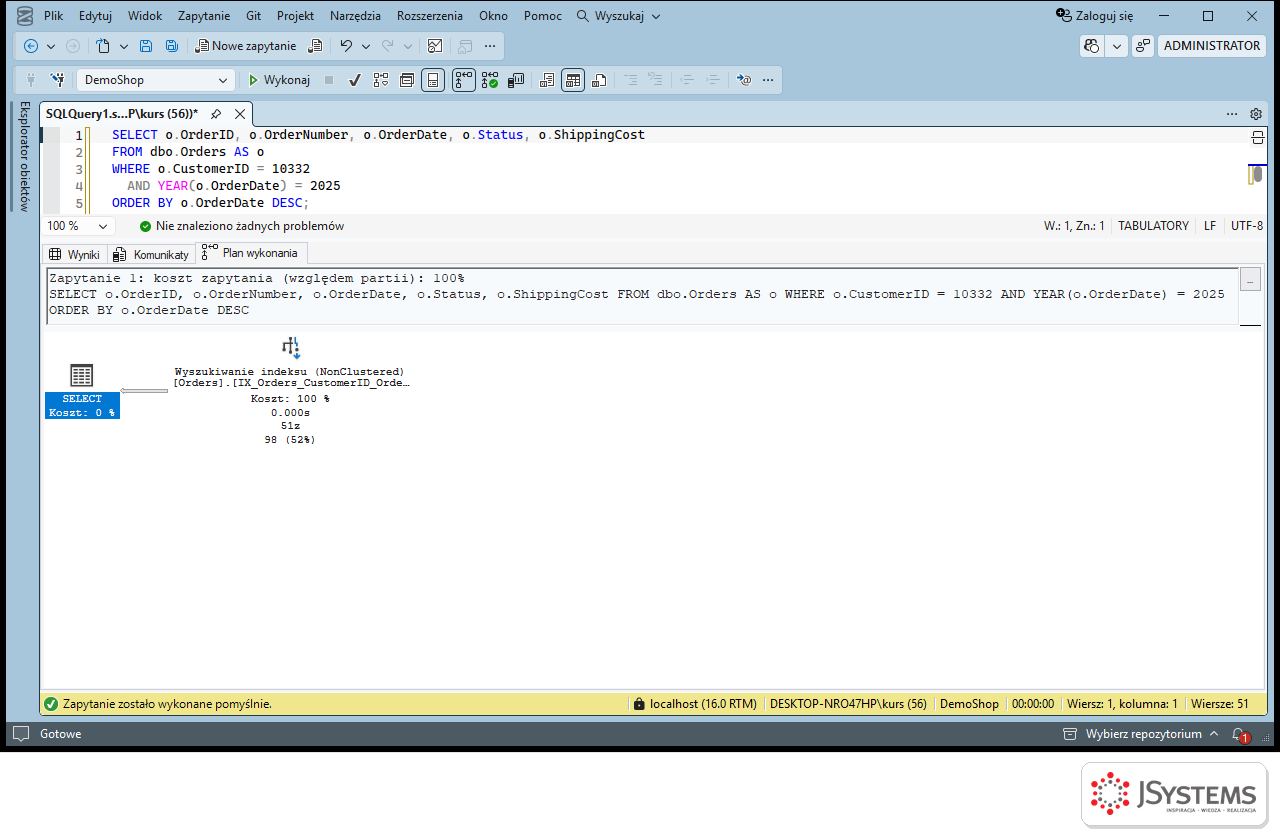
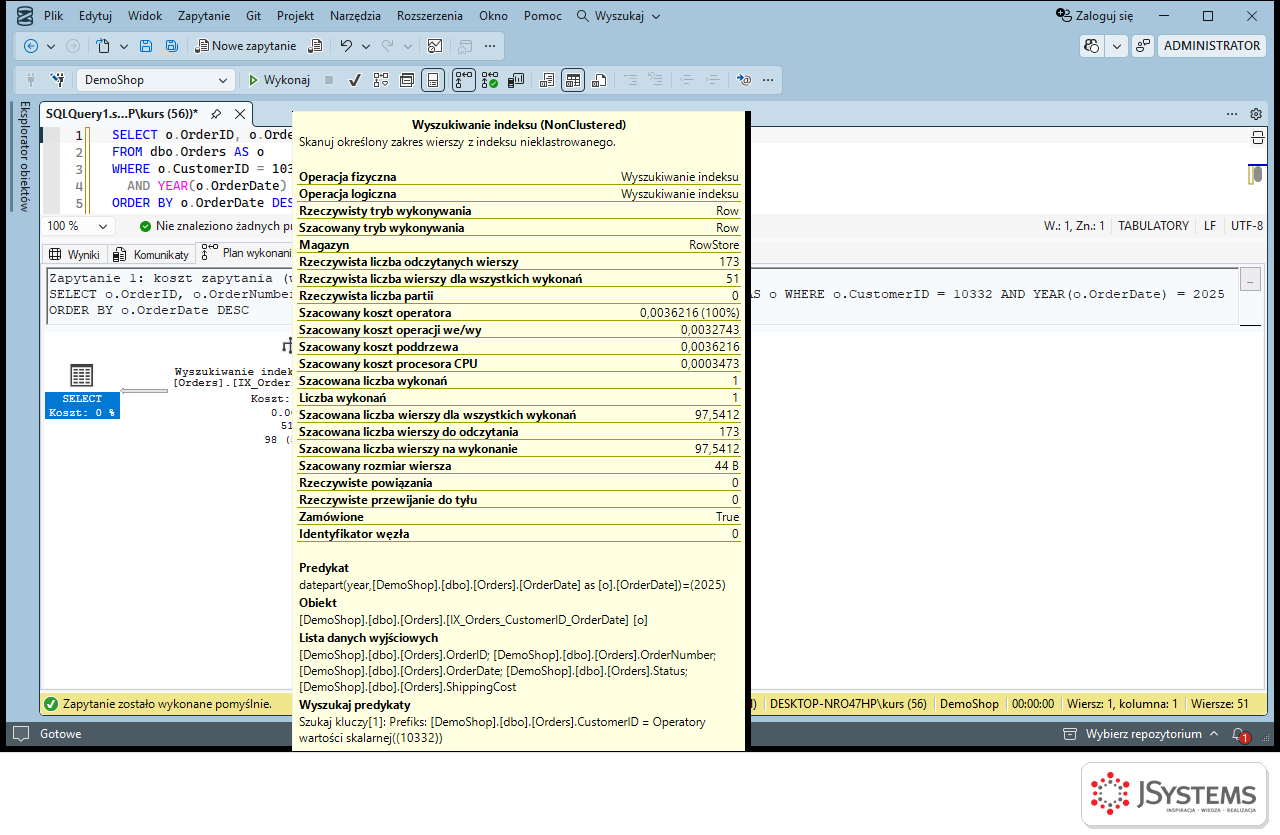
Nowy plan zapisujemy jako plik i wracamy z nim do tej samej rozmowy. AI ma porównać wynik ze swoimi przewidywaniami:
Krok 2 zrobiony: utworzyłem indeks IX_Orders_CustomerID_OrderDate na (CustomerID, OrderDate DESC) z INCLUDE (OrderNumber, Status, ShippingCost). Zapytanie bez zmian. Załączam nowy rzeczywisty plan wykonania (panel_klienta_v1.sqlplan). Które hipotezy się potwierdziły? Czy robimy krok 3?
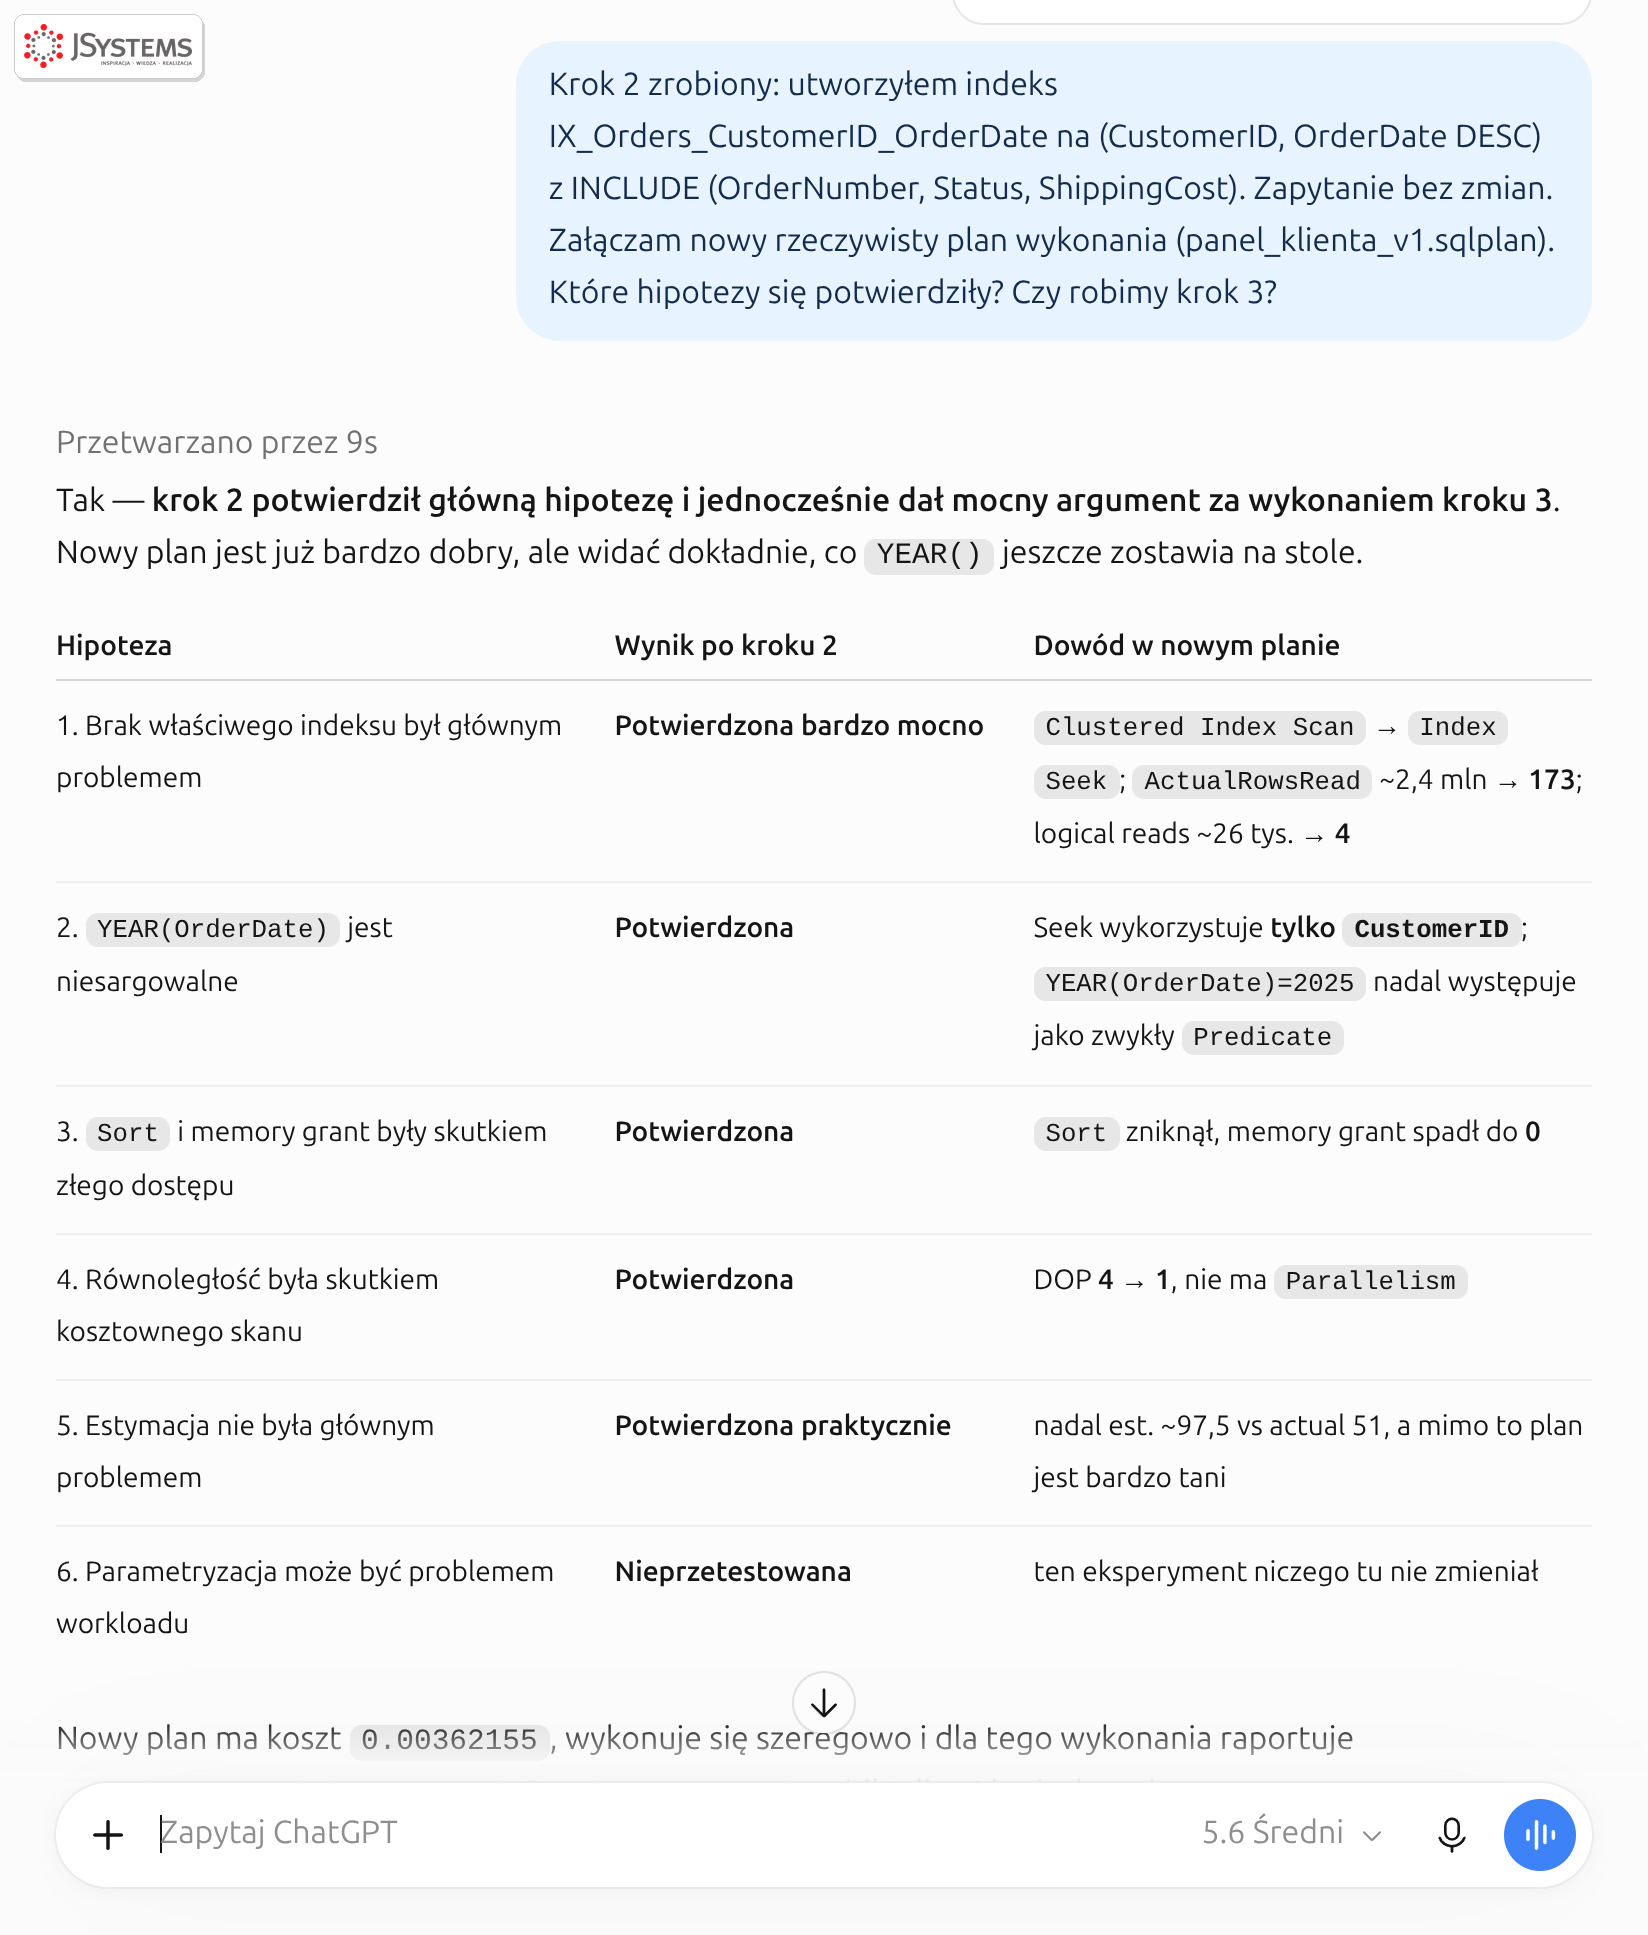
Hipotezy 1, 3 i 4 potwierdzone jednym pomiarem. Zostaje hipoteza 2: dymek pokazuje, że funkcja YEAR nadal działa jak filtr po odczycie. U tego klienta to tylko 122 zbędne wiersze, ale u klienta z kilkudziesięcioma tysiącami zamówień różnica będzie duża.
SELECT o.OrderID, o.OrderNumber, o.OrderDate, o.Status, o.ShippingCost
FROM dbo.Orders AS o
WHERE o.CustomerID = 10332
  AND o.OrderDate >= '20250101'
  AND o.OrderDate <  '20260101'
ORDER BY o.OrderDate DESC;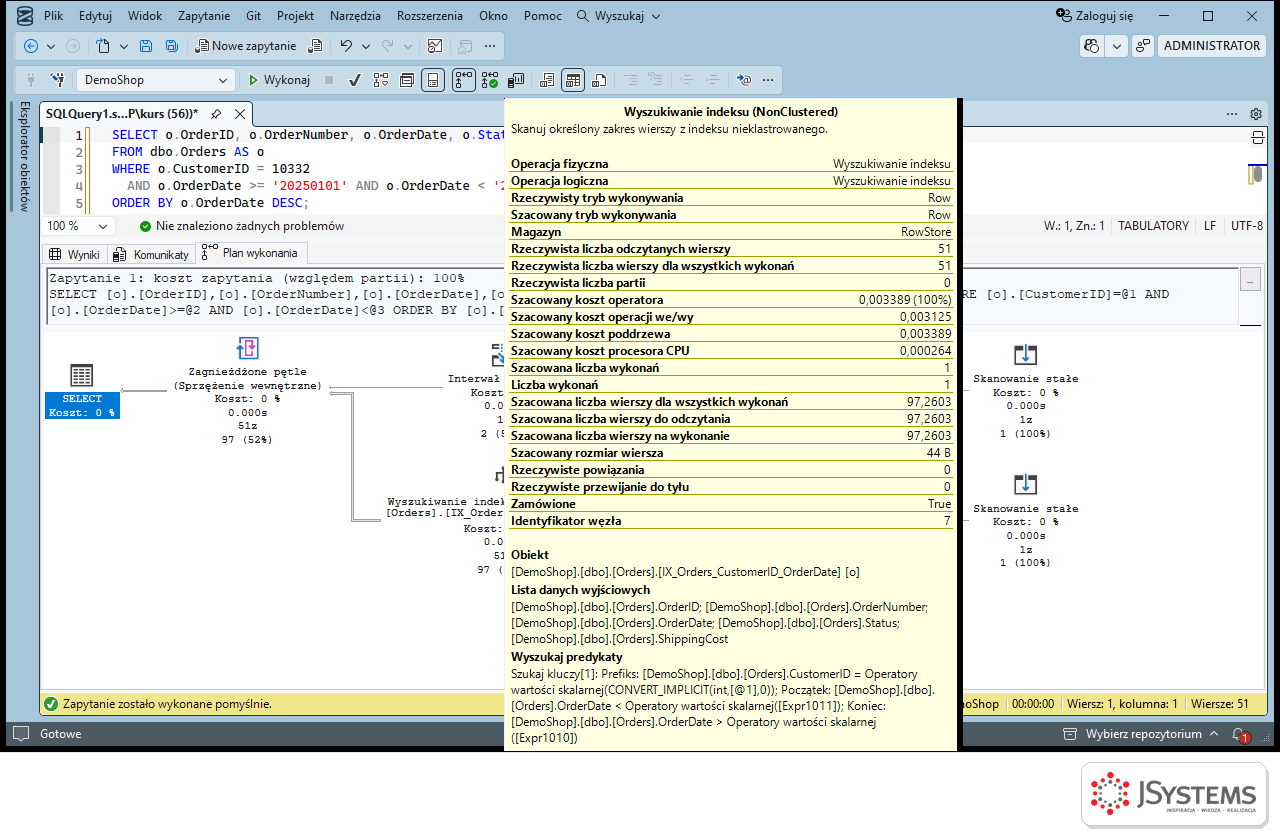
I trzecia tura rozmowy, już z planem po obu zmianach:
Krok 3 zrobiony: zamieniłem YEAR() na zakres dat, indeks bez zmian. Załączam rzeczywisty plan po tej zmianie (panel_klienta_v2.sqlplan). Porównaj go z poprzednimi krokami. Czy coś jeszcze warto zmienić w zapytaniu albo w indeksie, zanim przejdziemy do pomiaru wydajności?
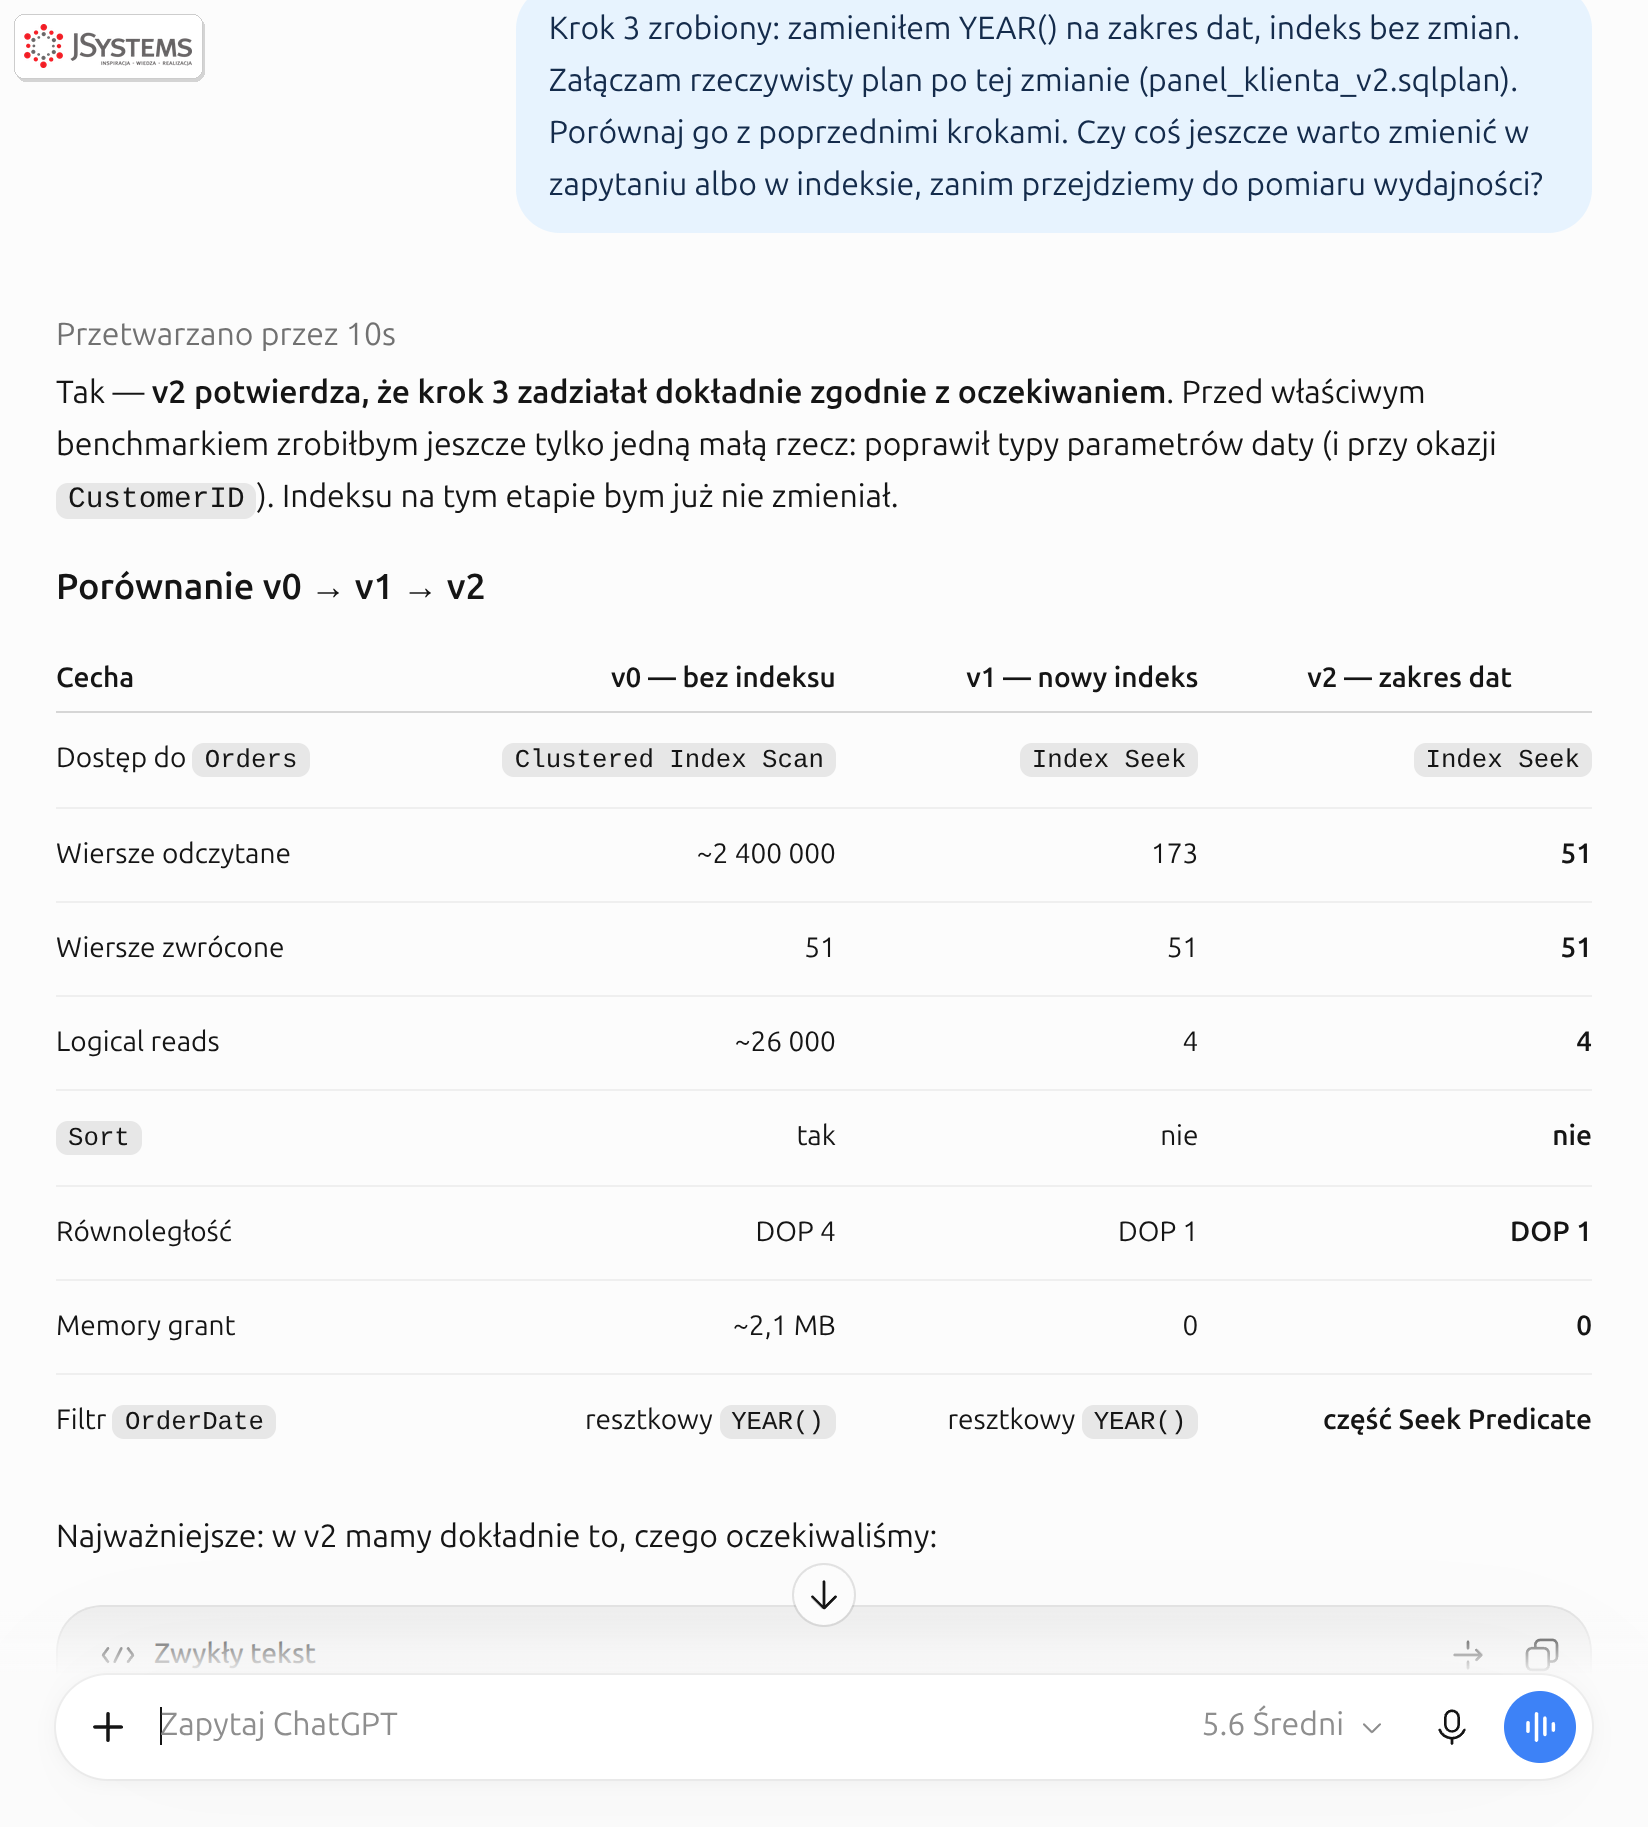
Pod tabelą AI radzi, żeby indeksu już nie zmieniać, a w aplikacji przekazywać daty jako parametry o typie kolumny zamiast tekstu. Ta odpowiedź zawiera jednak jedną drobną pomyłkę, którą warto wyłapać: AI pisze, że kolumna OrderDate ma typ datetime2(7), a w schemacie to datetime2(0). Na wniosek to nie wpływa, bo zalecenie (parametry o typie kolumny zamiast tekstu) jest słuszne przy każdej precyzji.
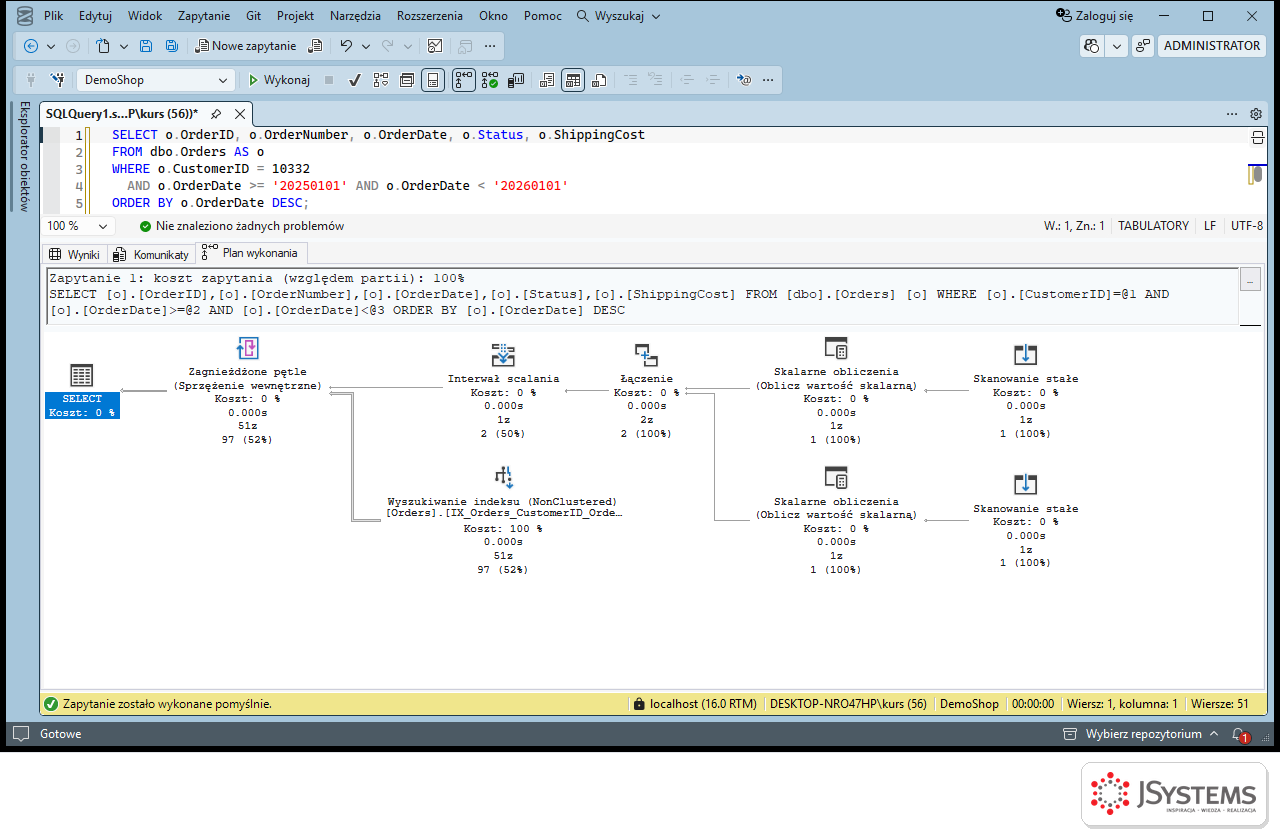
W planie pojawiły się dodatkowe operatory (pętle zagnieżdżone, interwał scalania, skanowanie stałe). To nie regresja: SQL Server sam sparametryzował zapytanie (widać to w tekście planu jako @1, @2, @3) i buduje zakres wyszukiwania z parametrów w czasie wykonania. Koszt tych operatorów jest pomijalny, co widać na planie:
Pojedyncze uruchomienie nie jest pomiarem. Każdy wariant wykonaliśmy 20 razy po jednym rozgrzewkowym przebiegu i wzięliśmy medianę czasu z rzeczywistego planu. Zmierzyliśmy dwóch klientów: typowego (10332, 51 zamówień w 2025 roku) i największego (7, ponad 96 tysięcy zamówień w całej historii), bo optymalizacja, która pomaga jednemu, może zaszkodzić drugiemu. Do tego test obciążenia: 500 losowych klientów wykonanych po kolei, czyli to, co panel robi w ciągu dnia.
| Wariant | Klient 10332: czas (mediana) | CPU | Odczyty | Klient 7: czas (mediana) | CPU | Odczyty | 500 klientów po kolei |
|---|---|---|---|---|---|---|---|
| v0: bez indeksu, YEAR() | 55 ms | 208 ms | 26 032 | 289,5 ms | 269 ms | 26 032 | 30,13 s |
| v1: indeks, YEAR() | poniżej 1 ms | poniżej 1 ms | 4 | 218 ms | 34 ms | 673 | 1,72 s |
| v2: indeks i zakres dat | poniżej 1 ms | poniżej 1 ms | 4 | 208,5 ms | 22,5 ms | 213 | 0,61 s |
Trzy obserwacje, które wychodzą dopiero z pomiaru:
YEAR() kompilował od nowa dla każdego klienta. Sprawdziliśmy to w pamięci planów: zapytanie z zakresem dat ma tam jeden plan typu Prepared z parametrami @1, @2, @3, użyty kilkaset razy, a każde wywołanie z YEAR() ma osobny wpis Adhoc. To potwierdza szóstą hipotezę AI, tę o parametryzacji, której nie dało się ocenić na pojedynczym wywołaniu.Łącznie: 500 wywołań panelu trwa 0,61 s zamiast 30,13 s, prawie 50 razy krócej. Wszystkie liczby, plany przed i po zmianach oraz skrypt pomiaru są w plikach do pobrania.
W PostgreSQL i MySQL plan wykonania pokazuje polecenie EXPLAIN (jak go czytać w PostgreSQL, opisujemy w artykule Jak czytać plan zapytania (EXPLAIN ANALYZE)), a EXPLAIN ANALYZE dodatkowo wykonuje zapytanie i dopisuje rzeczywiste liczby. SQL Server ma te same dwie odmiany, tylko pod innymi nazwami: plan szacowany (estimated), który optymalizator przygotowuje bez wykonywania zapytania, i plan rzeczywisty (actual), który powstaje podczas wykonania i zawiera to, co naprawdę się stało: ile wierszy przeczytał każdy operator, ile razy się wykonał, ile pamięci dostał. Do pracy z AI prawie zawsze potrzebujesz planu rzeczywistego, bo najważniejsze sygnały to rozjazd między szacunkiem a rzeczywistością.
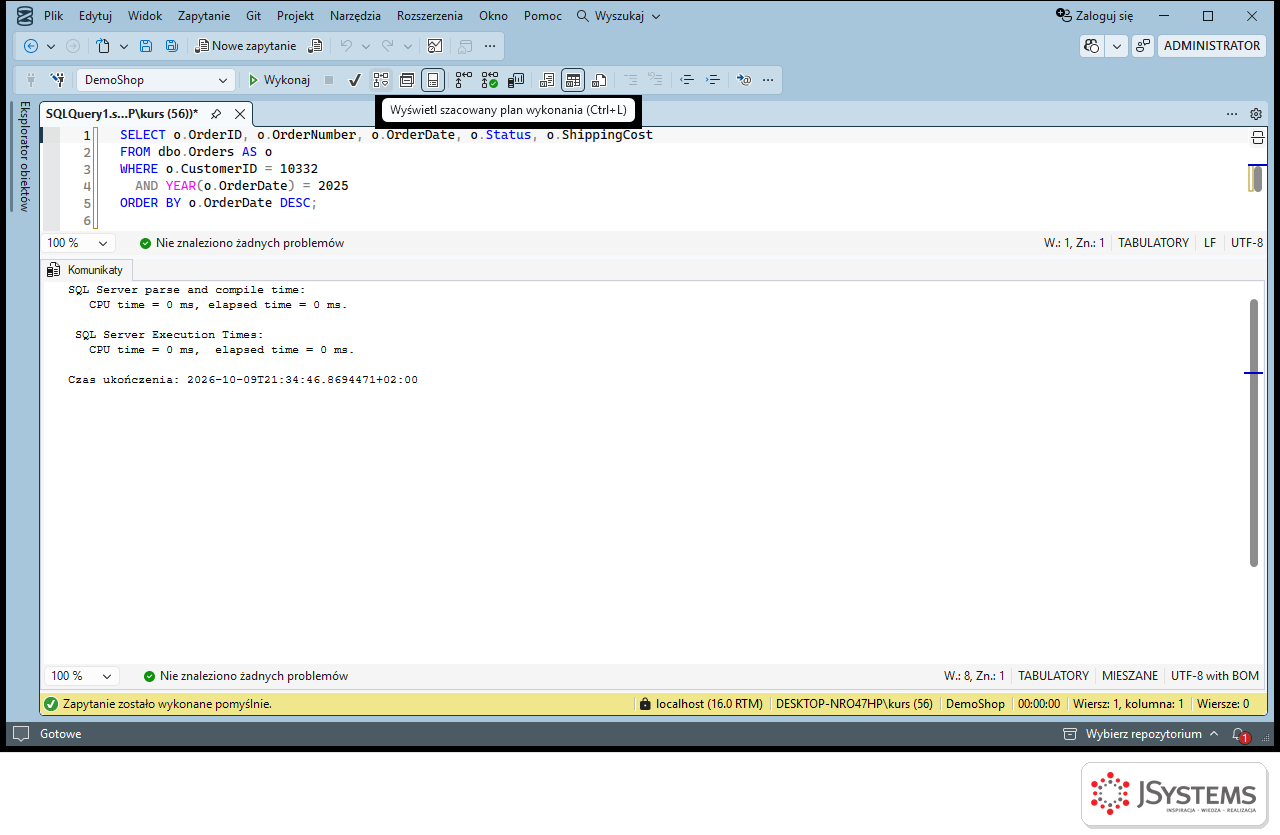
Oba plany włączasz przyciskami na pasku narzędzi SSMS. Wyświetl szacowany plan wykonania (Ctrl+L) pokazuje plan od razu, bez uruchamiania zapytania, więc nadaje się do zapytań, które trwają godzinami albo zmieniają dane. Uwzględnij rzeczywisty plan wykonania (Ctrl+M) to przełącznik: gdy jest włączony, każde wykonanie zapytania (F5) dokłada zakładkę Plan wykonania obok wyników.
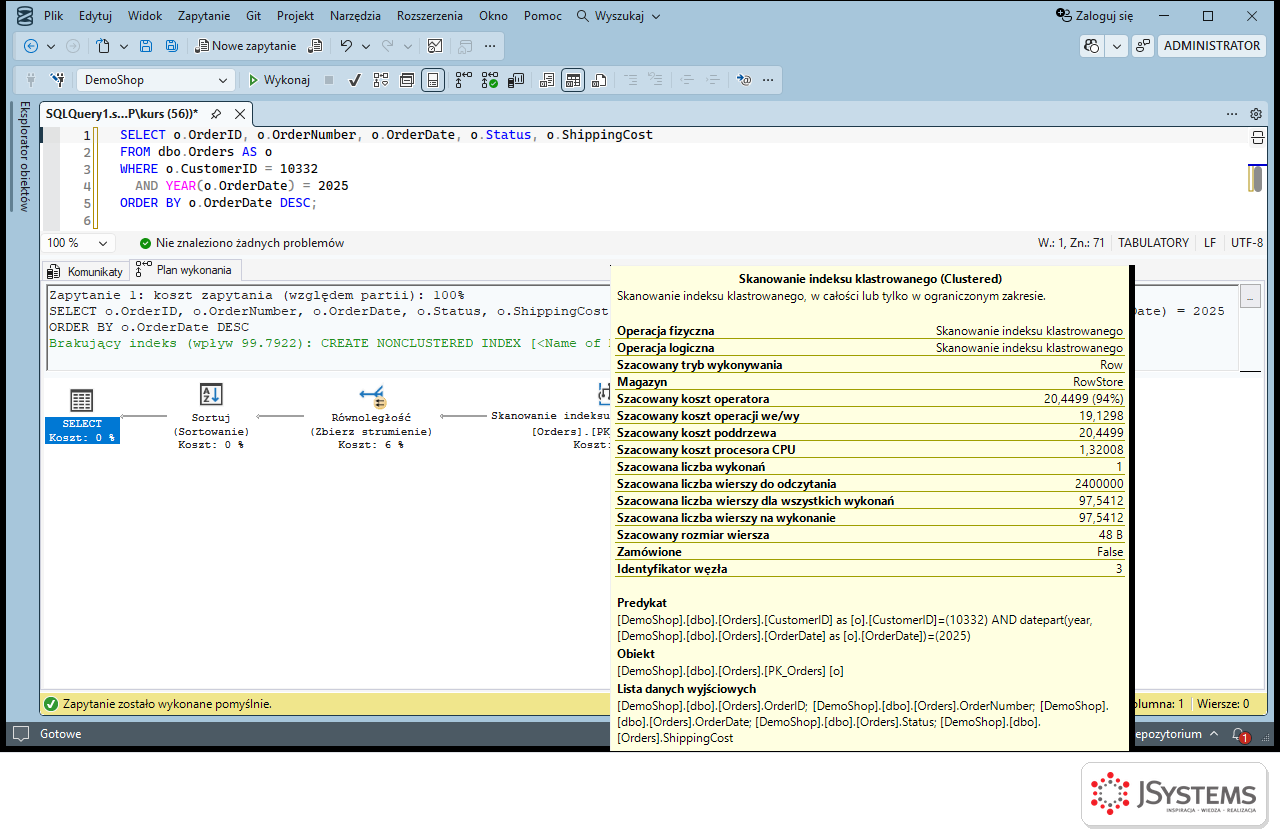
Plan rzeczywisty czyta się od prawej do lewej: dane płyną od operatorów dostępu do tabel (skanowania i wyszukiwania w indeksach) przez złączenia, sortowania i agregacje do operatora SELECT. Pod każdą ikoną SSMS pokazuje koszt operatora jako procent szacowanego kosztu całego planu, czas, liczbę rzeczywistych wierszy i liczbę szacowanych z procentem trafności. Najedź myszą na ikonę, a zobaczysz dymek z pełnym zestawem liczb; kliknij ikonę i wciśnij F4, a w oknie Właściwości zobaczysz jeszcze więcej, łącznie z rozbiciem na wątki.
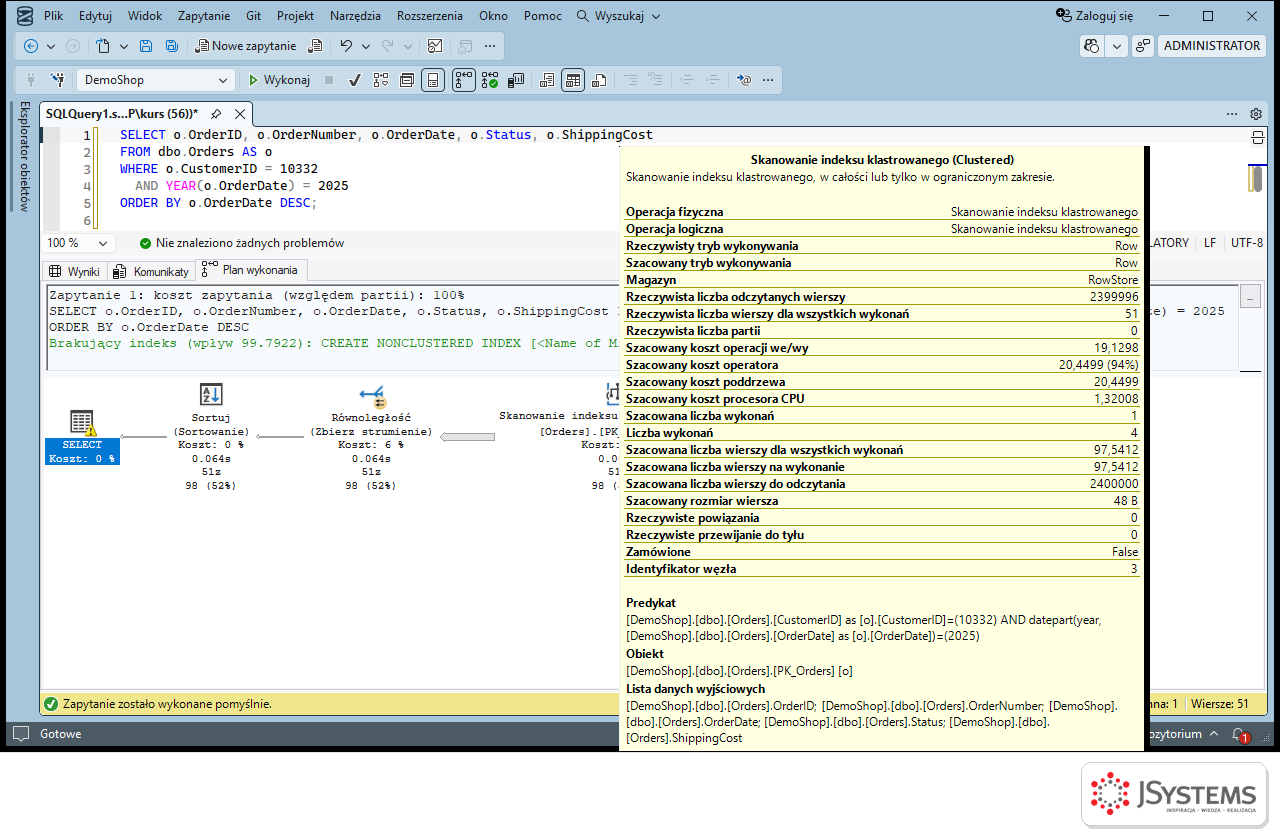
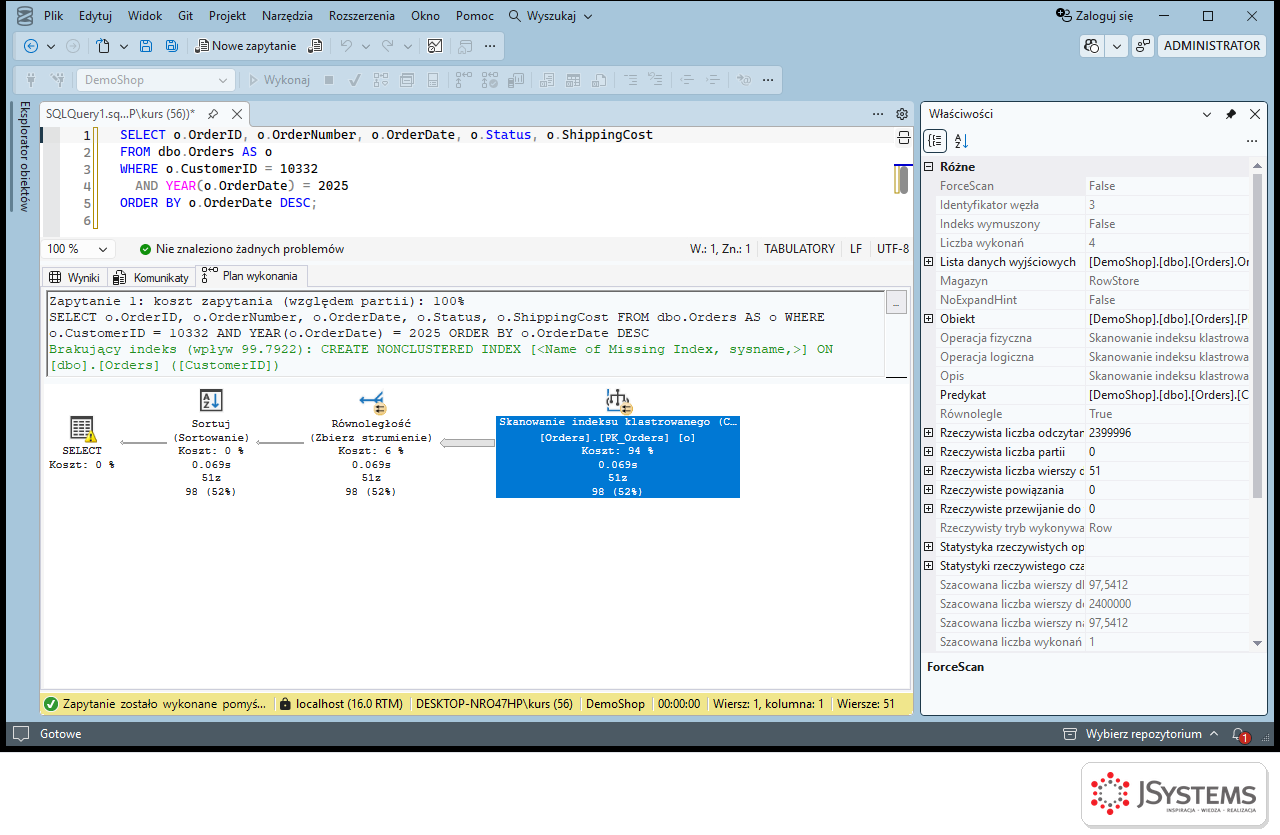
AI nie potrzebuje zrzutu planu. Potrzebuje pliku planu, czyli XML, w którym są wszystkie te liczby naraz, łącznie z ostrzeżeniami, sugestiami brakujących indeksów, statystykami użytymi przez optymalizator i czasami. Kliknij prawym przyciskiem w puste miejsce planu: w menu są polecenia Zapisz plan wykonywania jako (zapis do pliku .sqlplan), Pokaż plik XML planu wykonywania, Porównaj plan wykonania i Brak szczegółów indeksu.
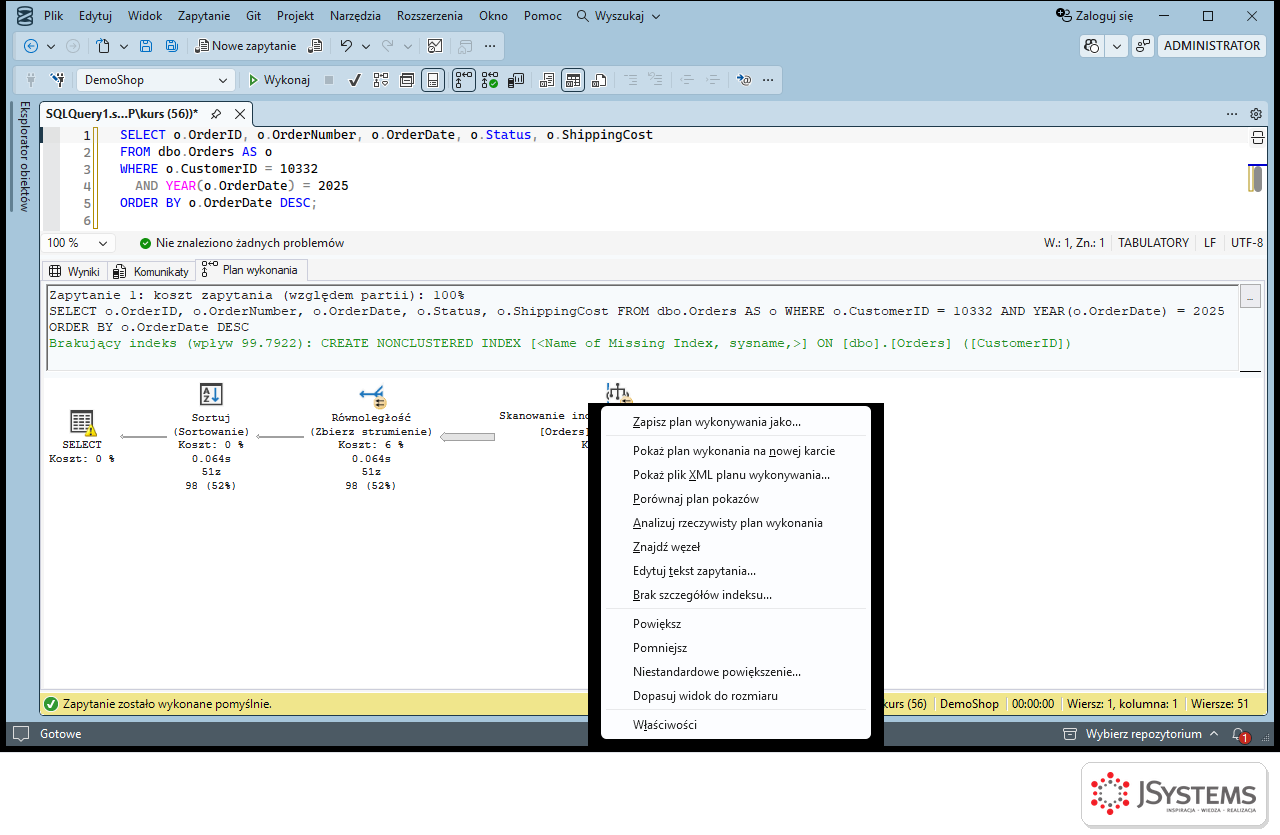
Plik .sqlplan załączasz do rozmowy jak każdy inny dokument. ChatGPT czyta go poprawnie, co sprawdziliśmy, pytając o liczbę operatorów: odpowiedział 16, tyle samo, ile jest elementów RelOp w pliku. Jeśli Twoje narzędzie AI nie przyjmuje załączników, wklej tekst XML wprost do rozmowy. Plany bywają długie, ale dla jednego zapytania to zwykle kilkadziesiąt kilobajtów, co mieści się w rozmowie bez problemu.
Drugie źródło liczb to statystyki czasu i odczytów. Polecenie SET STATISTICS IO, TIME ON; wykonane raz w oknie zapytania sprawia, że po każdym wykonaniu zakładka Komunikaty pokazuje, ile stron każda tabela przeczytała (odczyty logiczne, czyli strony po 8 KB czytane z pamięci lub z dysku) i ile trwało wykonanie. Odczyty logiczne to najlepsza miara do porównań przed i po zmianie, bo w przeciwieństwie do czasu nie zależą od tego, co akurat robi serwer.
Poniżej 19 sygnałów, które w planie wykonania najczęściej wskazują problem. Każdy pokazujemy na zapytaniu uruchomionym na DemoShop: zrzut planu z dymkiem operatora, który zdradza problem, poprawka i zmierzony efekt. Liczby odczytów logicznych i wierszy pochodzą z planów rzeczywistych zapisanych podczas tych wykonań. Wszystkie plany są w paczce plany_wykonania.zip, więc możesz je załączyć do własnej rozmowy z AI i sprawdzić, czy znajdzie to samo.
| Nr | Sygnał | Gdzie go widać w planie | Odczyty przed | Odczyty po |
|---|---|---|---|---|
| 1 | Pełne skanowanie tabeli | Skanowanie indeksu klastrowanego, odczytane wiersze dużo większe niż zwrócone | 26 032 | 69 |
| 2 | Zbędne sortowanie | Operator Sortuj z dużym kosztem i przydziałem pamięci, czasem z ostrzeżeniem o zapisie do tempdb (bazy roboczej serwera na dane tymczasowe) | 26 032 | 26 032, bez sortowania |
| 3 | Dużo odczytanych wierszy | Wyszukiwanie w indeksie, ale odczytanych wierszy dużo więcej niż zwróconych | 456 | 20 |
| 4 | Szacunek daleki od rzeczywistości | Szacowana liczba wierszy 719 999, rzeczywista 2 558 | 26 032 | 7 351 |
| 5 | Zła kolejność złączeń | Duże zbiory pośrednie na początku planu, wskazówka FORCE ORDER | 59 459 | 59 459, połowa CPU |
| 6 | Nested Loops na dużym zbiorze | Wyszukiwanie klucza wykonane 96 144 razy | 276 566 | 923 |
| 7 | Hash, Merge, Nested Loops | Rodzaj operatora złączenia i rozmiary wejść | trzy przykłady | |
| 8 | Funkcja na indeksowanej kolumnie | Skanowanie indeksu z predykatem datepart(...) | 9 914 | 445 |
| 9 | Niejawna konwersja | Ostrzeżenie CONVERT_IMPLICIT przy operatorze SELECT | 507 | 6 |
| 10 | Warunek niesargowalny | Skanowanie indeksu z wyrażeniem na kolumnach | 1 548 | 3 |
| 11 | SELECT * | Wyszukiwanie klucza dla kolumn spoza indeksu | 485 | 4 |
| 12 | Podzapytanie skorelowane | Szpula indeksu budowana w locie, 1 102 wykonania | 7 982 ms CPU | 34 ms CPU |
| 13 | Zbędny DISTINCT | Dopasowanie skrótu (agregacja) i przydział pamięci | 16,9 MB pamięci | 72 KB pamięci |
| 14 | OR, który psuje plan | Skanowanie z predykatem „@parametr IS NULL OR ...” | 26 032 | 484 |
| 15 | Wielokrotne skanowanie tabeli | Kilka operatorów skanowania tej samej tabeli | 84 821 | 26 032 |
| 16 | Niewłaściwy indeks | Indeks istnieje, a plan i tak skanuje tabelę | 26 032 | 53 |
| 17 | Brakujący indeks | Zielona sugestia „Brakujący indeks” nad planem | 26 032 | 4 |
| 18 | Kolejność kolumn w indeksie | Wyszukiwanie po zakresie pierwszej kolumny, druga jako predykat | 511 | 24 |
| 19 | Indeks pokrywający | Wyszukiwanie klucza po wyszukiwaniu w indeksie | 484 | 4 |
Operator Skanowanie indeksu klastrowanego (Clustered Index Scan) czyta całą tabelę, bo indeks klastrowany to sama tabela. Skan nie zawsze jest błędem: gdy zapytanie potrzebuje jednej trzeciej wierszy, skan bywa najszybszą drogą. Sygnałem jest proporcja. Szukamy zamówień wysłanych do Suwałk: serwer czyta 2 399 996 wierszy, żeby zwrócić 11 779, czyli pół procenta.
SELECT OrderID, OrderDate, Status
FROM dbo.Orders
WHERE ShipCity = N'Suwałki';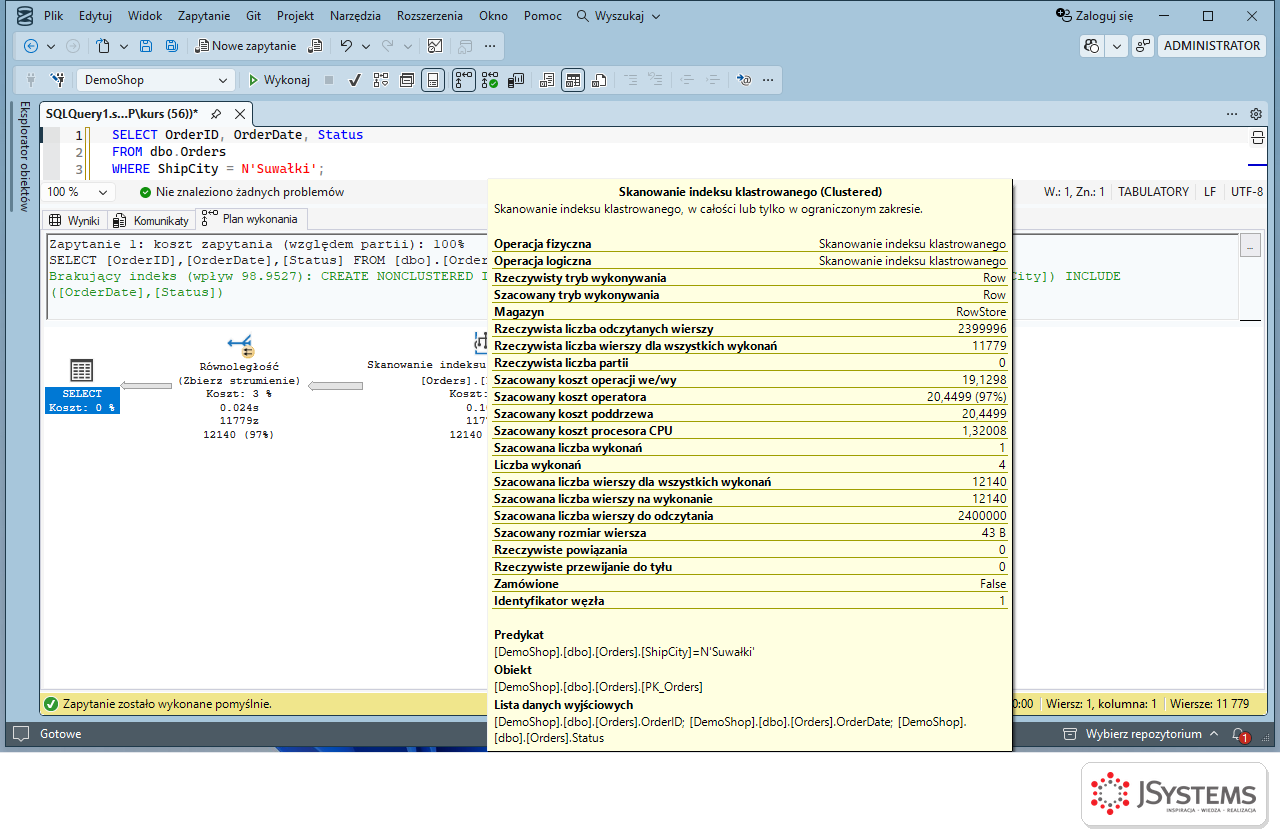
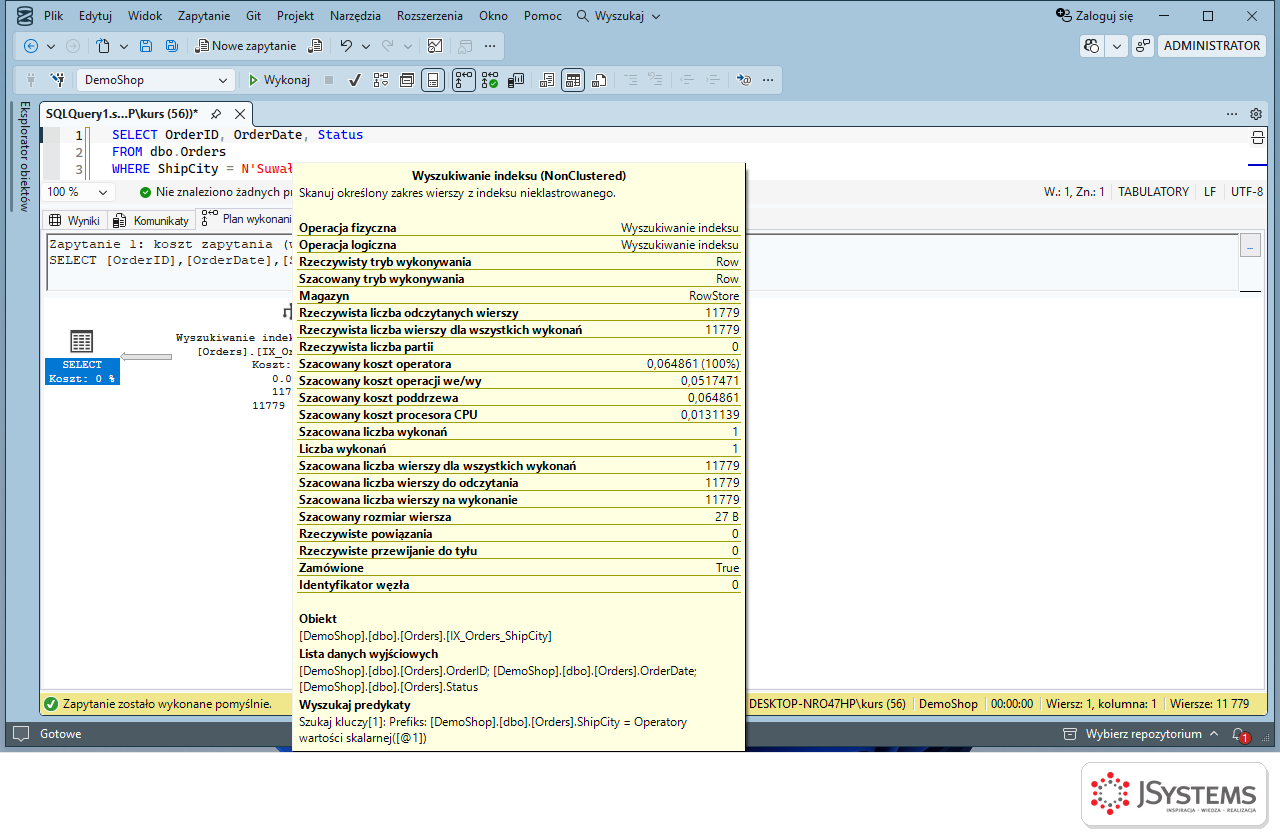
Indeks (ShipCity) INCLUDE (OrderDate, Status) zamienia skan na Wyszukiwanie indeksu (Index Seek), które czyta dokładnie 11 779 wierszy. Odczyty logiczne spadają z 26 032 do 69.
Operator Sortuj potrzebuje pamięci, a gdy jej zabraknie, zapisuje dane w tempdb. Zestawienie zamówień z grudnia na eksport do Excela ma ORDER BY CustomerID, OrderDate, choć odbiorca i tak sortuje dane po swojemu. Sortowanie 107 311 wierszy dostało 21 MB pamięci i zużyło z niej 8 MB. Tym razem dane zmieściły się w pamięci, ale ten sam operator przy złym szacunku liczby wierszy wylewa dane do tempdb, co pokazujemy w części o parameter sniffing.
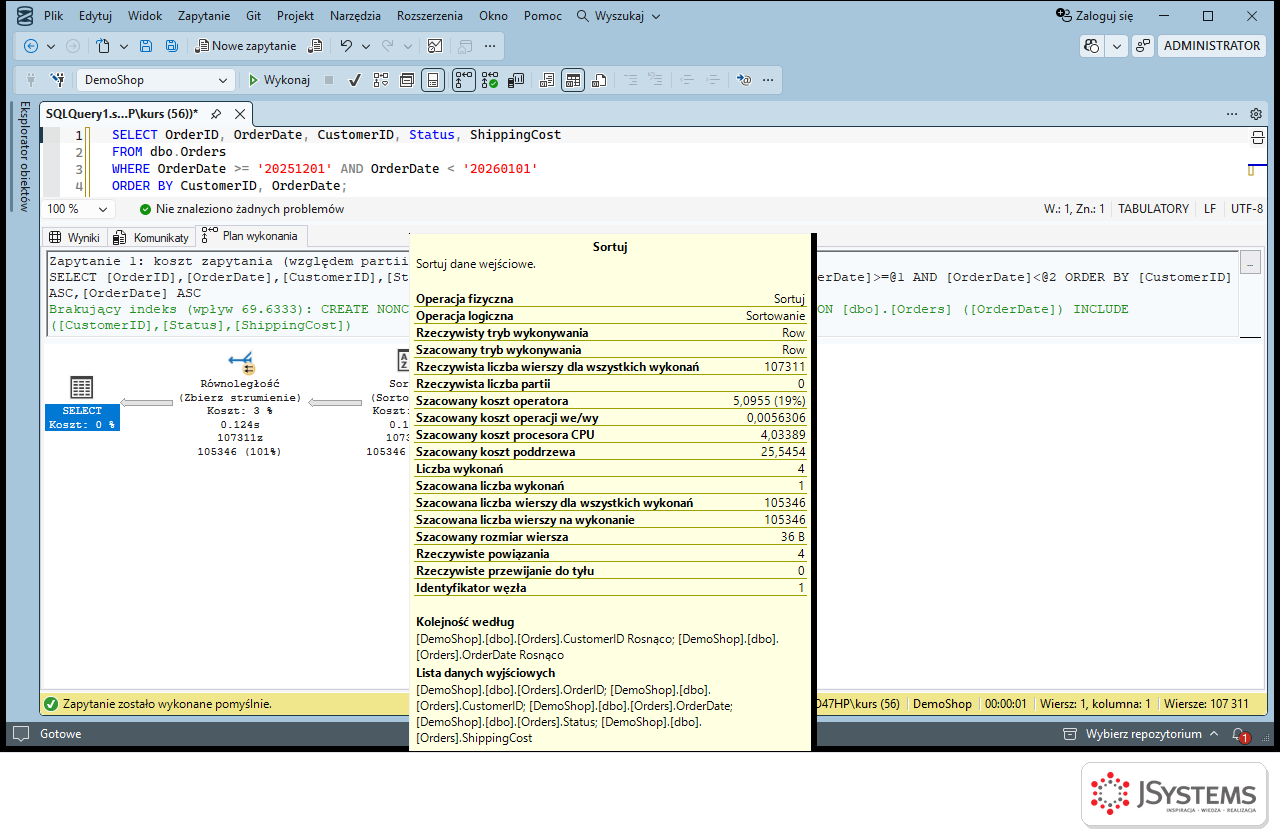
Usunięcie ORDER BY obniżyło czas procesora z 450 do 347 ms. Jeśli kolejność jest potrzebna, lepszym rozwiązaniem od sortowania przy każdym wykonaniu jest indeks o tej samej kolejności kolumn, z którego dane wychodzą już posortowane (sygnały 17 i 18).
„Index Seek” brzmi dobrze, ale nie gwarantuje niczego. Indeks na CustomerID pozwala szybko znaleźć zamówienia klienta nr 7, tylko że ten klient ma ich 96 144, a interesują nas zwrócone (3 386). Warunek na Status działa dopiero po odczytaniu wiersza.
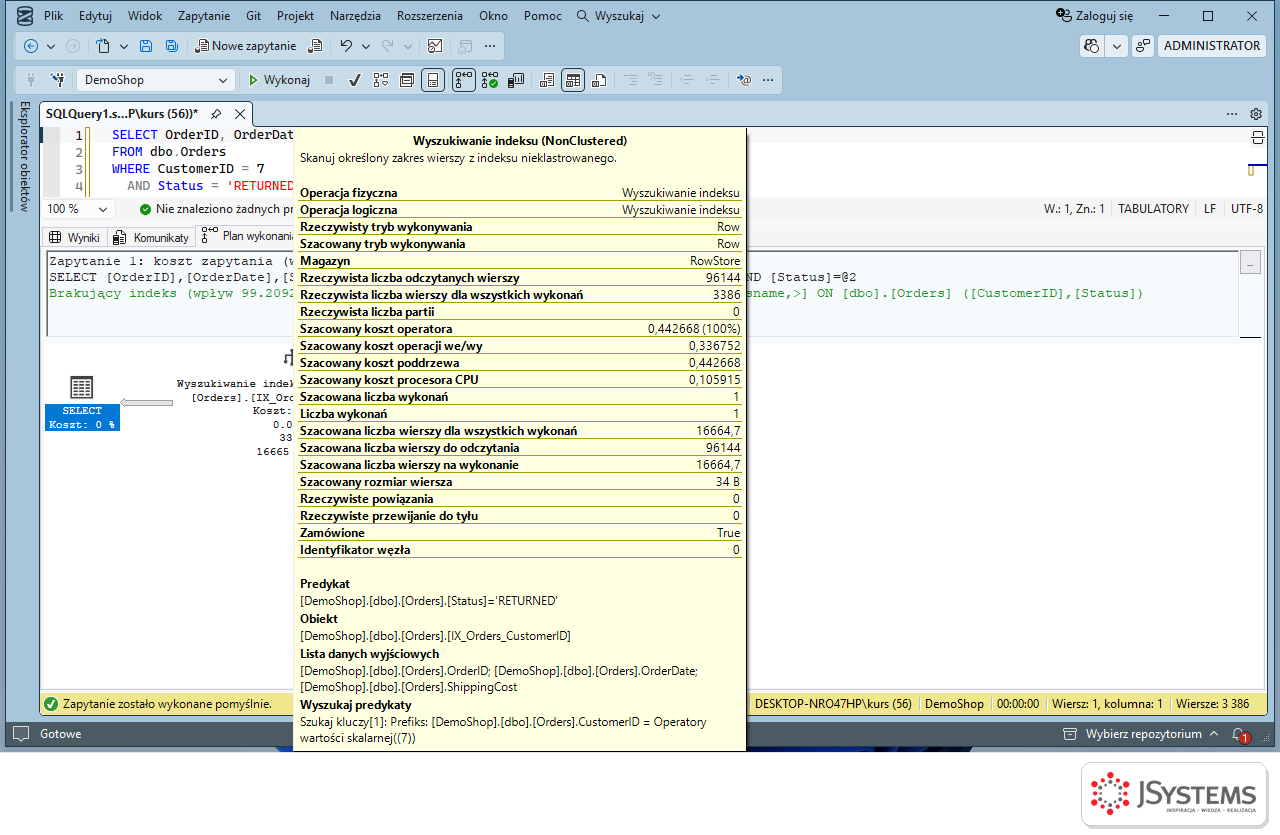
Indeks z kluczem (CustomerID, Status) pozwala wyszukać od razu oba warunki: 3 386 odczytanych wierszy i 20 odczytów logicznych zamiast 456. Porównuj zawsze dwie liczby z dymku: odczytane i zwrócone. Duża różnica przy operatorze Seek oznacza, że indeks jest „prawie dobry”.
Optymalizator wybiera plan na podstawie szacowanej liczby wierszy. Gdy szacunek jest zły, plan też. Zapytanie ze zmienną lokalną (DECLARE @Od ...) nie pozwala optymalizatorowi poznać wartości zmiennej w chwili kompilacji, więc dla warunku >= zakłada 30% tabeli: 719 999 wierszy. Rzeczywiście jest ich 2 558, ale przy szacunku 720 tysięcy skan całej tabeli wygląda rozsądnie.
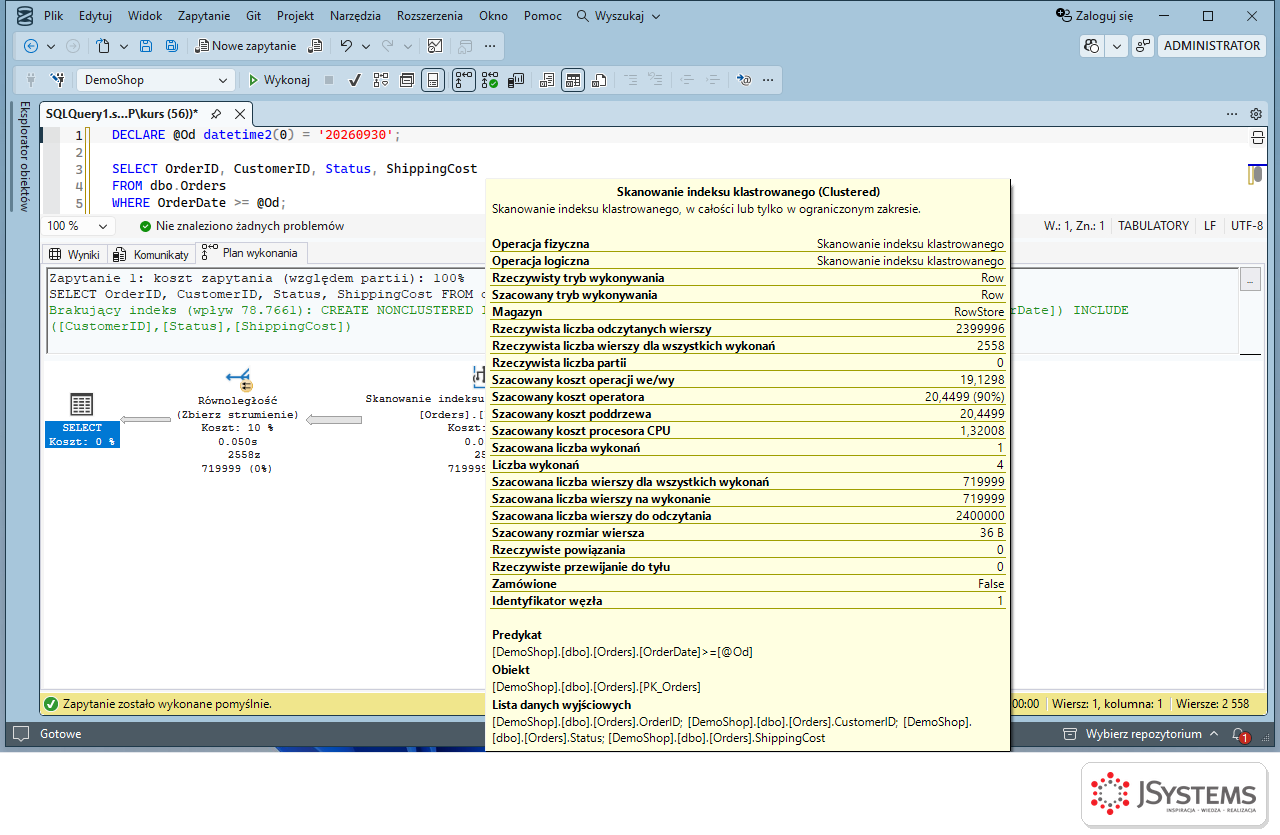
Wskazówka OPTION (RECOMPILE) kompiluje zapytanie z aktualną wartością zmiennej: szacunek 2 658,8 wiersza, wyszukiwanie w indeksie na OrderDate i odczyty logiczne spadają z 26 032 do 7 351. Przyczynom złych szacunków (statystyki, rozkład danych, parameter sniffing) poświęcamy osobną sekcję o problemach spoza zapytania.
SQL Server sam ustala kolejność złączeń, niezależnie od tego, w jakiej kolejności zapiszesz tabele. Zła kolejność pojawia się zwykle wtedy, gdy ktoś to wymusi albo gdy szacunki są błędne. W starym kodzie wymuszenie wygląda tak: OPTION (FORCE ORDER). Zapytanie o sprzedaż produktów jednej kategorii w grudniu łączy wtedy najpierw 6,5 mln pozycji z zamówieniami, a filtr na kategorii produktu działa dopiero na końcu.
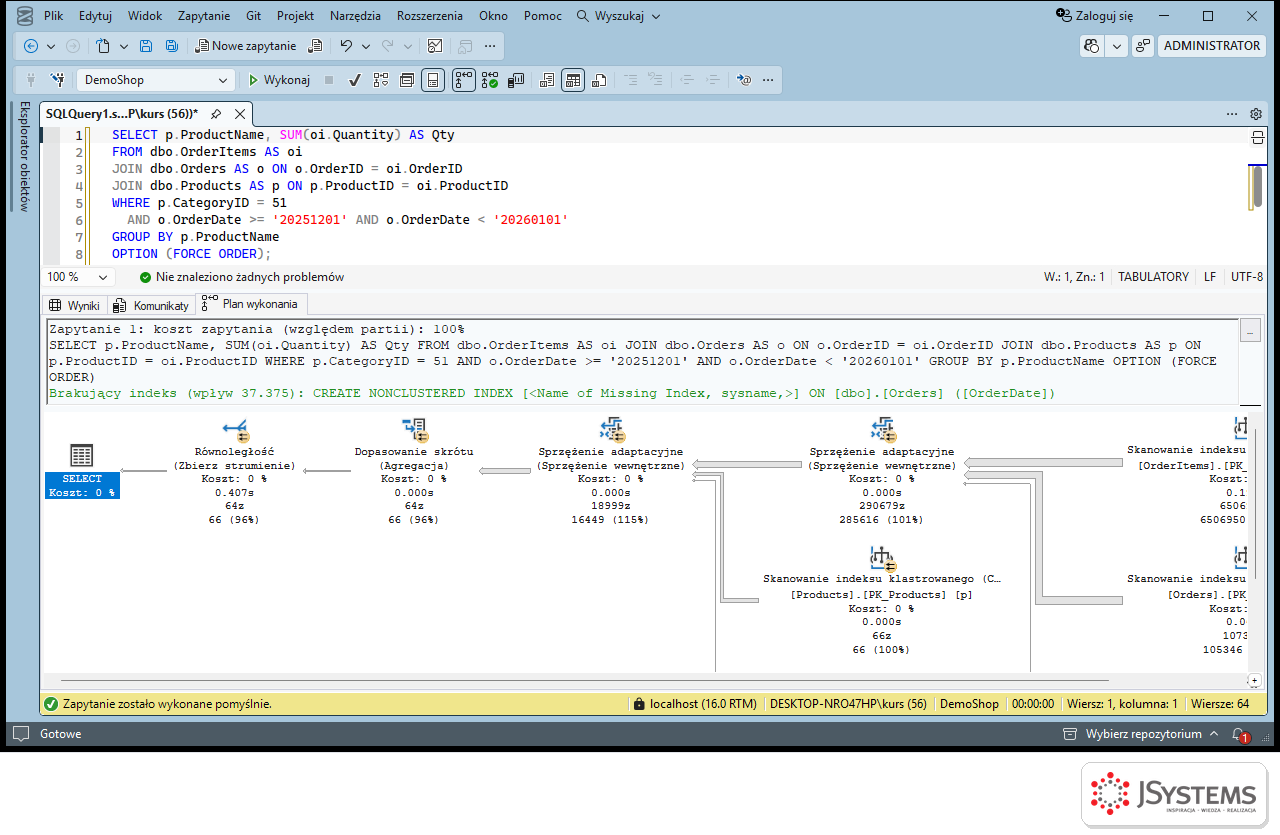
Po usunięciu wskazówki optymalizator zaczyna od 66 produktów kategorii, a złączenia operują na 18 999 wierszach. Czas procesora spada z 1611 do 757 ms, a przydział pamięci z 332 do 33 MB. Odczyty się nie zmieniają, bo obie wersje czytają całe tabele. Gdy AI zobaczy w kodzie wskazówki typu FORCE ORDER, LOOP JOIN czy INDEX(...), zawsze poproś o test bez nich: często zostały po problemach, których dawno nie ma.
Złączenie Zagnieżdżone pętle (Nested Loops) wykonuje wewnętrzną część planu raz dla każdego wiersza zewnętrznego. Dla kilku wierszy to najszybszy sposób, dla stu tysięcy katastrofa. Procedura z historią zamówień klienta skompilowała się dla małego klienta (6 zamówień), a potem wykonała się z tym samym planem dla klienta nr 7:
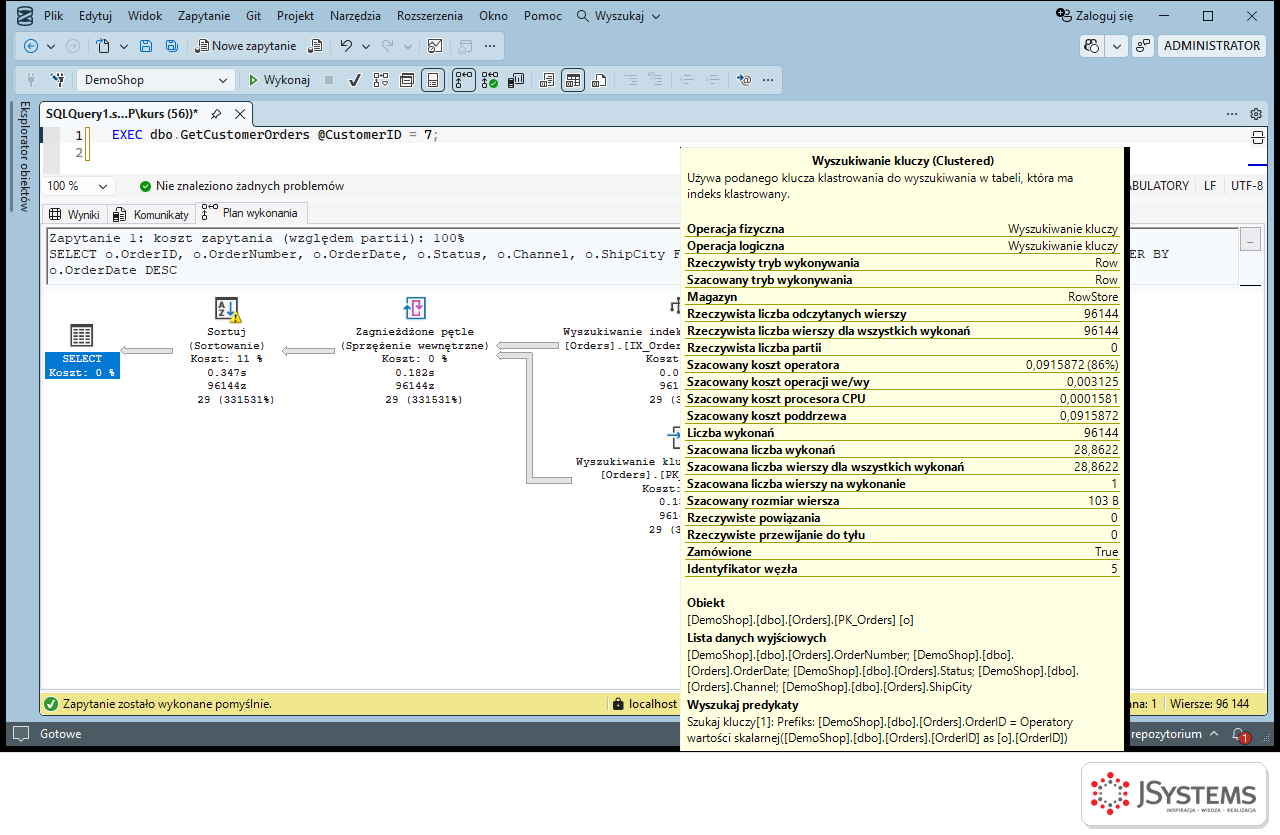
Indeks pokrywający (CustomerID, OrderDate) INCLUDE (...) usuwa wyszukiwania klucza: 923 odczyty. To, dlaczego procedura miała plan dla małego klienta, wyjaśniamy w części o parameter sniffing.
Rodzaj złączenia sam w sobie nie jest dobry ani zły, ale musi pasować do rozmiaru danych. Nested Loops jest najlepsze, gdy zewnętrzne wejście jest małe, a po stronie wewnętrznej jest indeks: jedno zamówienie i jego 5 pozycji to 21 odczytów. Merge Join (w polskim SSMS „Sprzężenie scalające”) łączy dwa wejścia posortowane po kluczu złączenia, jak zamówienia i wysyłki po OrderID, bez dodatkowej pamięci. Hash Match („Dopasowanie skrótu”) buduje w pamięci tablicę z mniejszego wejścia i przepuszcza przez nią większe; to wybór dla dużych, nieposortowanych zbiorów.
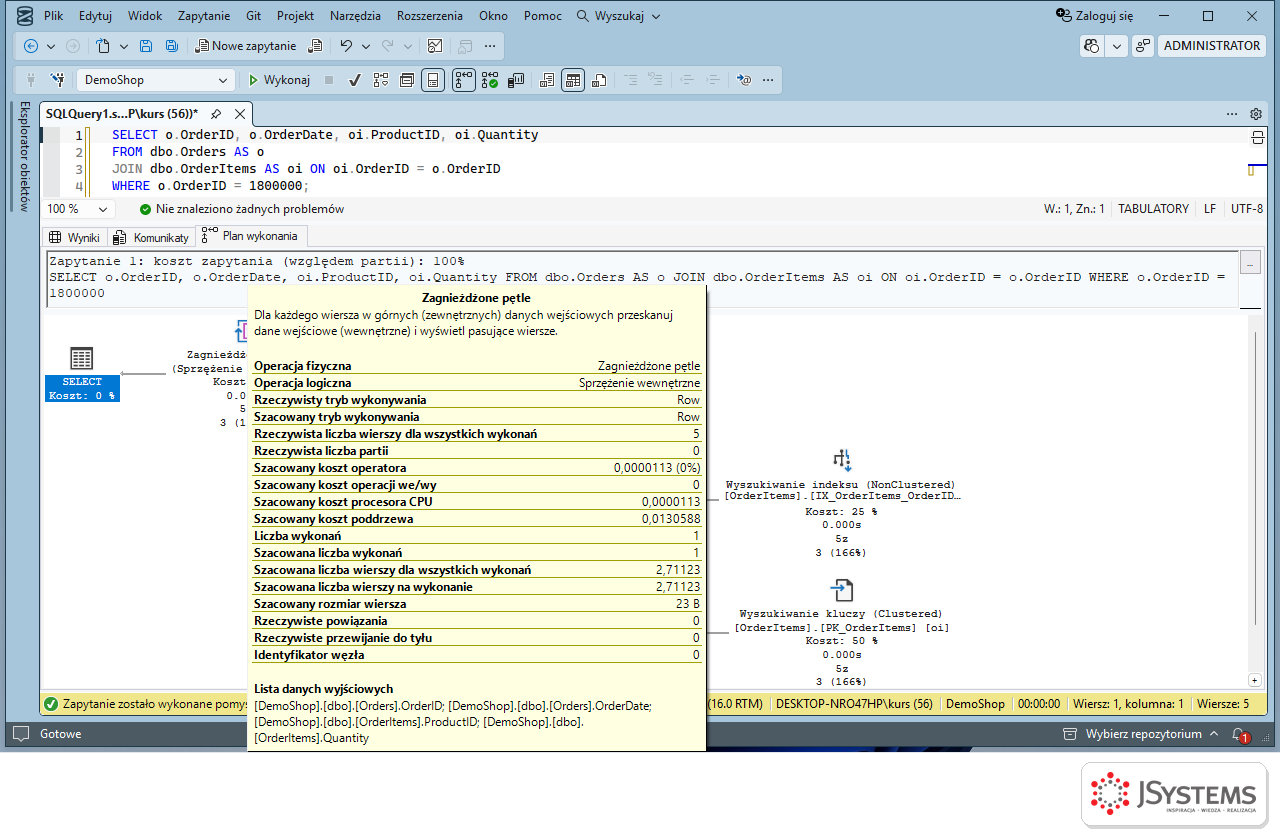
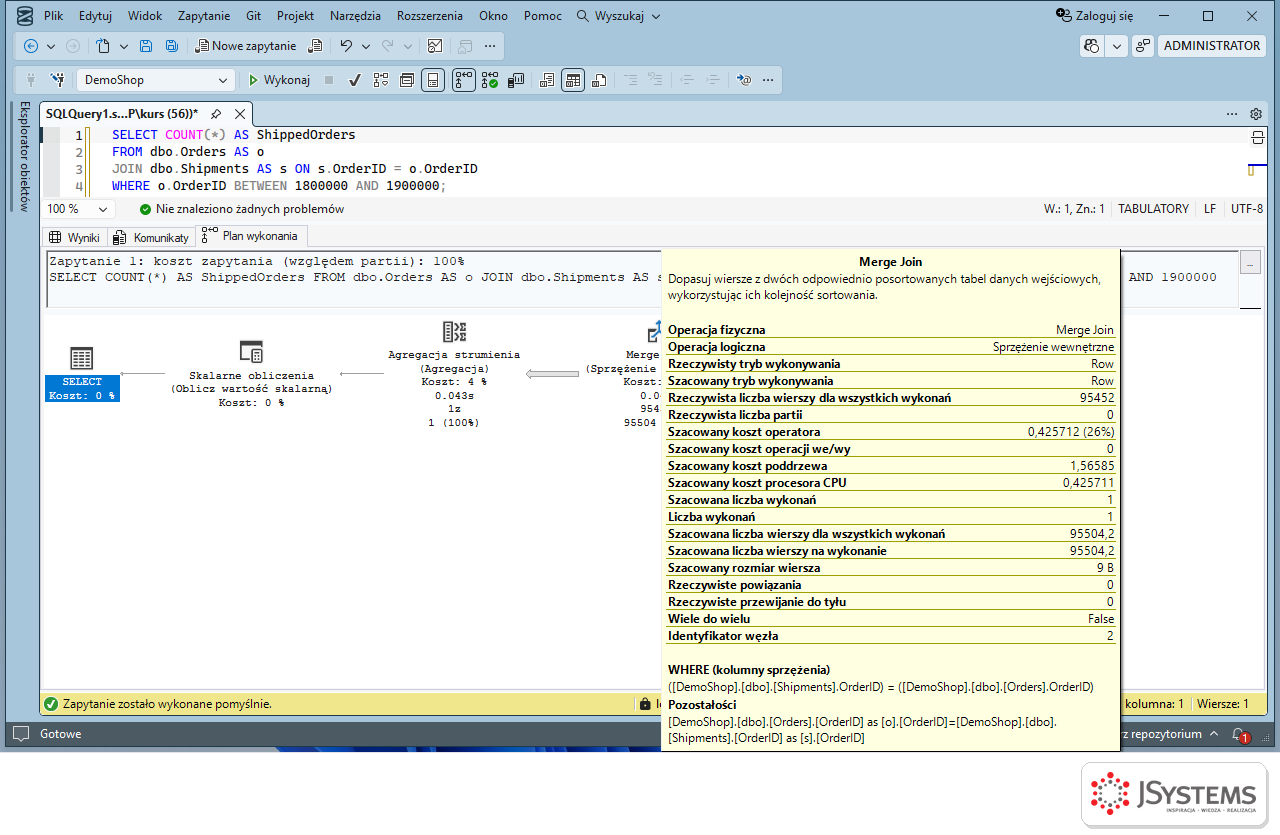
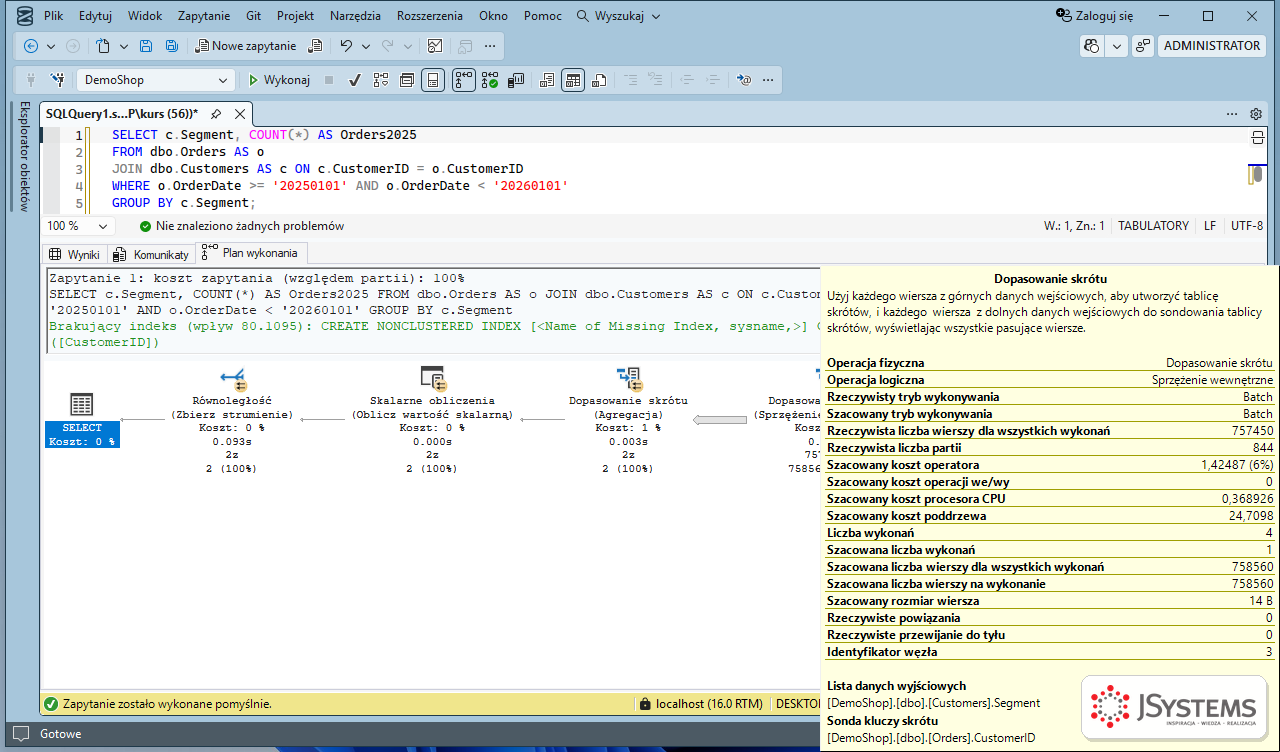
Sygnałem problemu jest niedopasowanie: Nested Loops z tysiącami wykonań po stronie wewnętrznej (sygnał 6) albo Hash Match na kilku wierszach z dużym przydziałem pamięci. W SQL Server 2019 i nowszym zobaczysz też operator Sprzężenie adaptacyjne (Adaptive Join), który wybiera między hash a pętlami dopiero w trakcie wykonania, gdy zna liczbę wierszy.
Warunek YEAR(OrderDate) = 2025 AND MONTH(OrderDate) = 12 wymaga policzenia roku i miesiąca dla każdego wiersza, więc serwer nie może skoczyć w indeksie na OrderDate do grudnia. Skanuje cały indeks: 2 399 996 odczytanych wierszy, 9 914 odczytów logicznych.
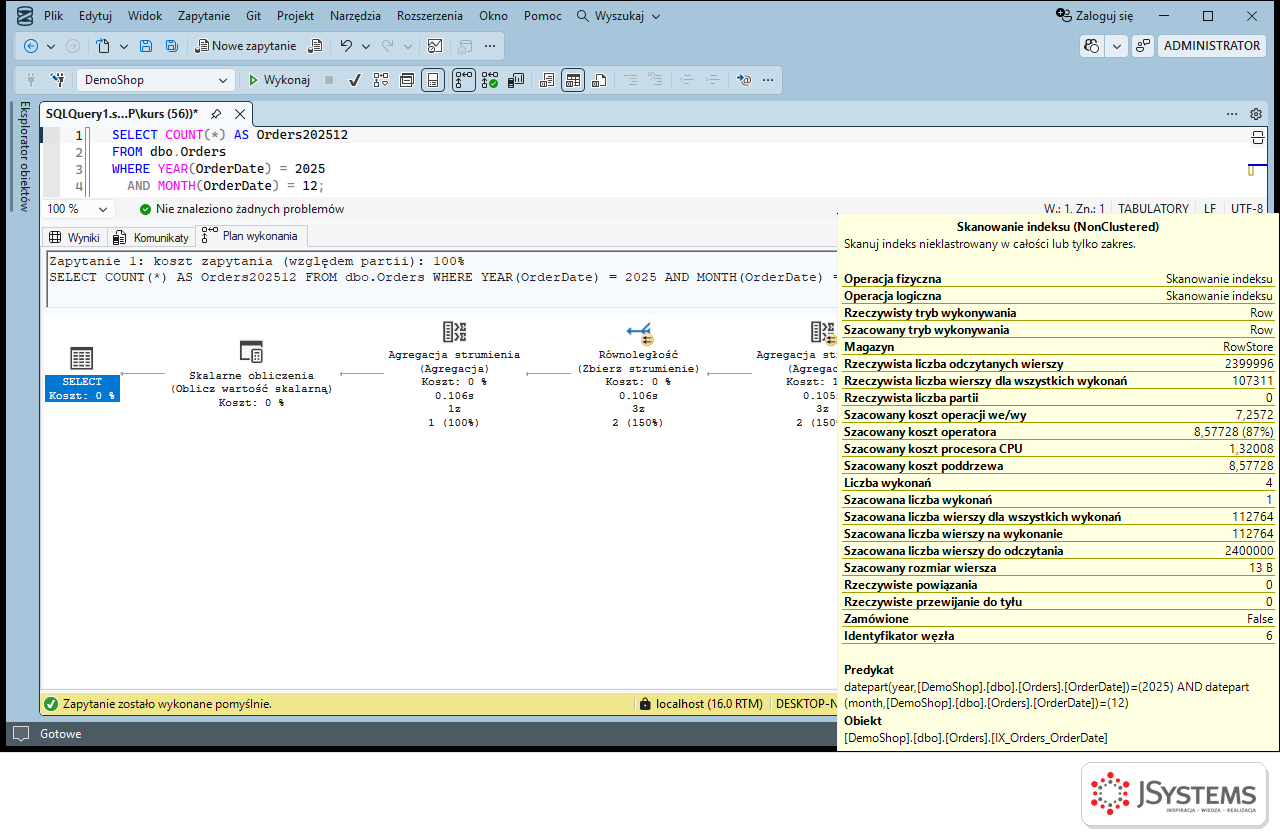
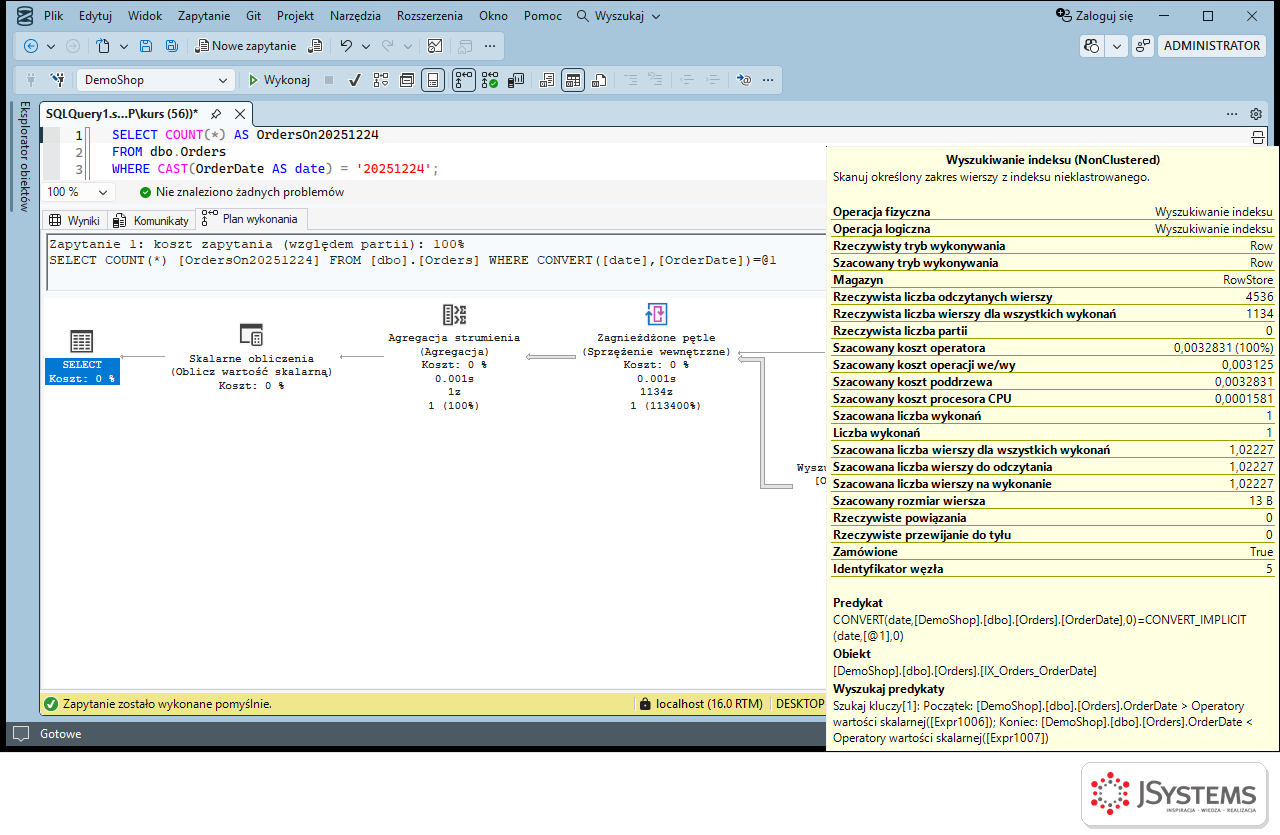
Ten sam warunek zapisany jako zakres (OrderDate >= '20251201' AND OrderDate < '20260101') to wyszukiwanie: 107 311 odczytanych wierszy i 445 odczytów logicznych. Jest jeden ważny wyjątek, który przeczy prostej regule i warto go znać, zanim przyjmiesz poradę AI bez sprawdzenia: CAST(OrderDate AS date) = '20251224' nie blokuje wyszukiwania w indeksie. SQL Server rozpoznaje ten wzorzec i zamienia go na zakres jednego dnia: 23 odczyty.
Gdy porównujesz kolumnę z wartością innego typu, SQL Server konwertuje jedną ze stron według pierwszeństwa typów. Jeśli konwertowana jest kolumna, indeks może przestać działać. To klasyczny problem aplikacji, które wysyłają parametry tekstowe jako nvarchar, gdy kolumna jest varchar. Wynik zależy jednak od sortowania (collation) kolumny. W DemoShop kolumny mają polskie sortowanie Windows i SQL Server radzi sobie z konwersją bez utraty wyszukiwania. Problem pojawia się przy starszym sortowaniu SQL, które wciąż jest domyślne w wielu instalacjach. Pokazujemy go na tabeli archiwalnej przeniesionej ze starego systemu:
CREATE TABLE dbo.CustomersArchive (
    CustomerID   int NOT NULL CONSTRAINT PK_CustomersArchive PRIMARY KEY,
    CustomerCode varchar(12) COLLATE SQL_Latin1_General_CP1_CI_AS NOT NULL,
    FirstName    nvarchar(40) NOT NULL,
    LastName     nvarchar(60) NOT NULL,
    City         nvarchar(60) NOT NULL);
-- dane skopiowane z dbo.Customers, unikalny indeks na CustomerCode

DECLARE @Code nvarchar(12) = N'100250';   -- tak parametr wysyła wiele aplikacji

SELECT CustomerID, FirstName, LastName
FROM dbo.CustomersArchive
WHERE CustomerCode = @Code;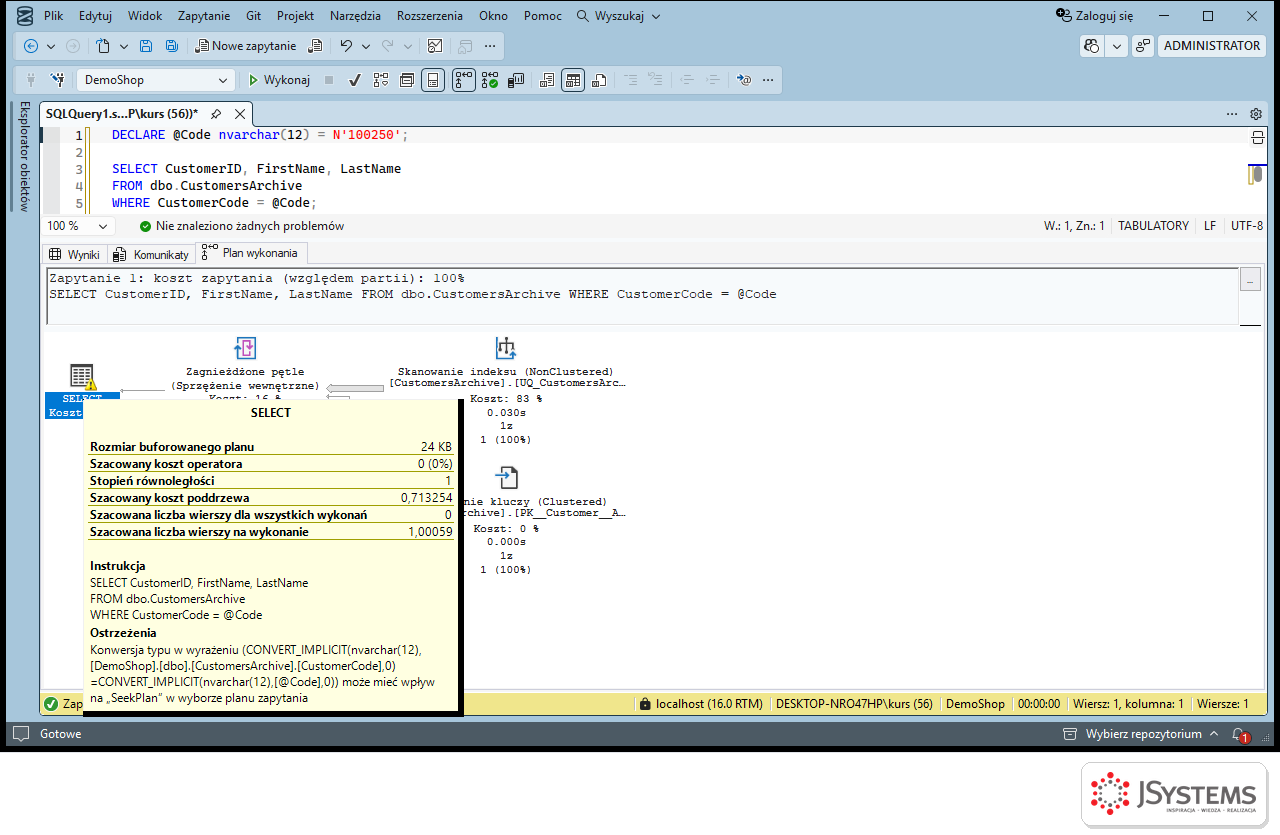
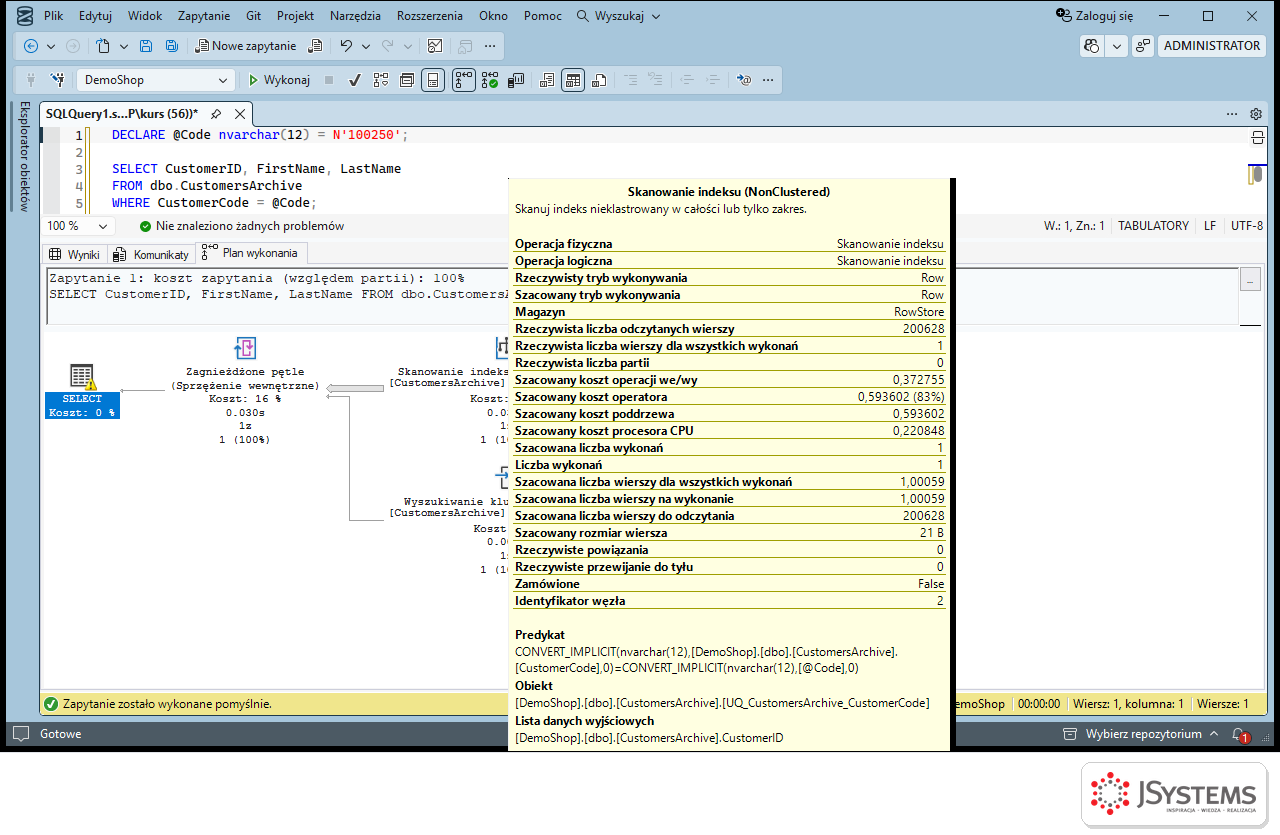
Parametr typu varchar(12), zgodny z kolumną, daje wyszukiwanie: 6 odczytów zamiast 507. W aplikacji poprawka polega zwykle na jawnym podaniu typu parametru (w .NET SqlDbType.VarChar), a nie na zmianie zapytania.
„Sargowalny” (od search argument) to warunek, który pozwala serwerowi wyszukać wartości w indeksie. Funkcja na kolumnie to tylko jeden z przypadków. Niesargowalne są też obliczenia na kolumnach, łączenie tekstu, ISNULL na kolumnie i LIKE z procentem na początku. Szukanie klienta po „nazwisku i imieniu” sklejonym w jeden tekst skanuje cały indeks (LastName, FirstName), choć ten indeks istnieje dokładnie po to, żeby takie zapytanie było szybkie.
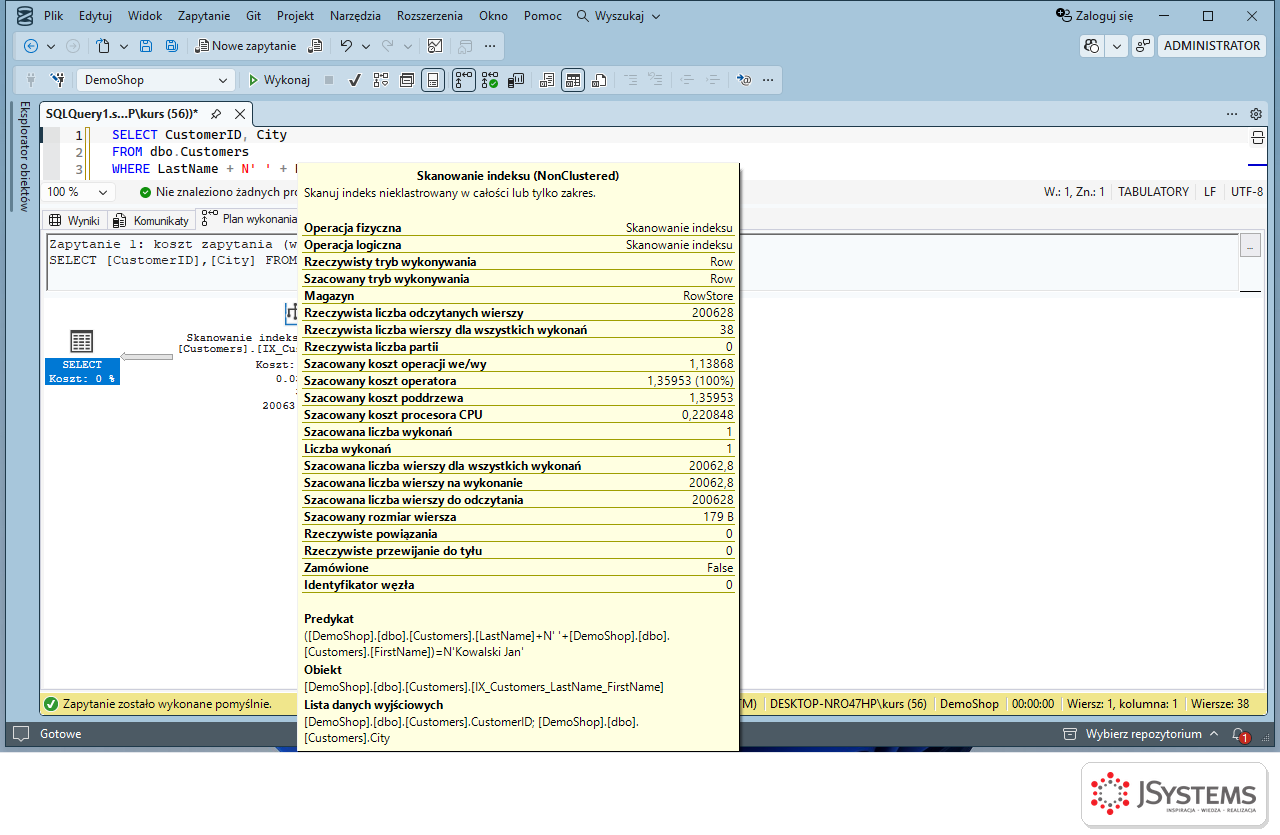
Rozbicie na dwa warunki (LastName = N'Kowalski' AND FirstName = N'Jan') daje wyszukiwanie po obu kolumnach: 38 odczytanych wierszy i 3 odczyty logiczne zamiast 1 548.
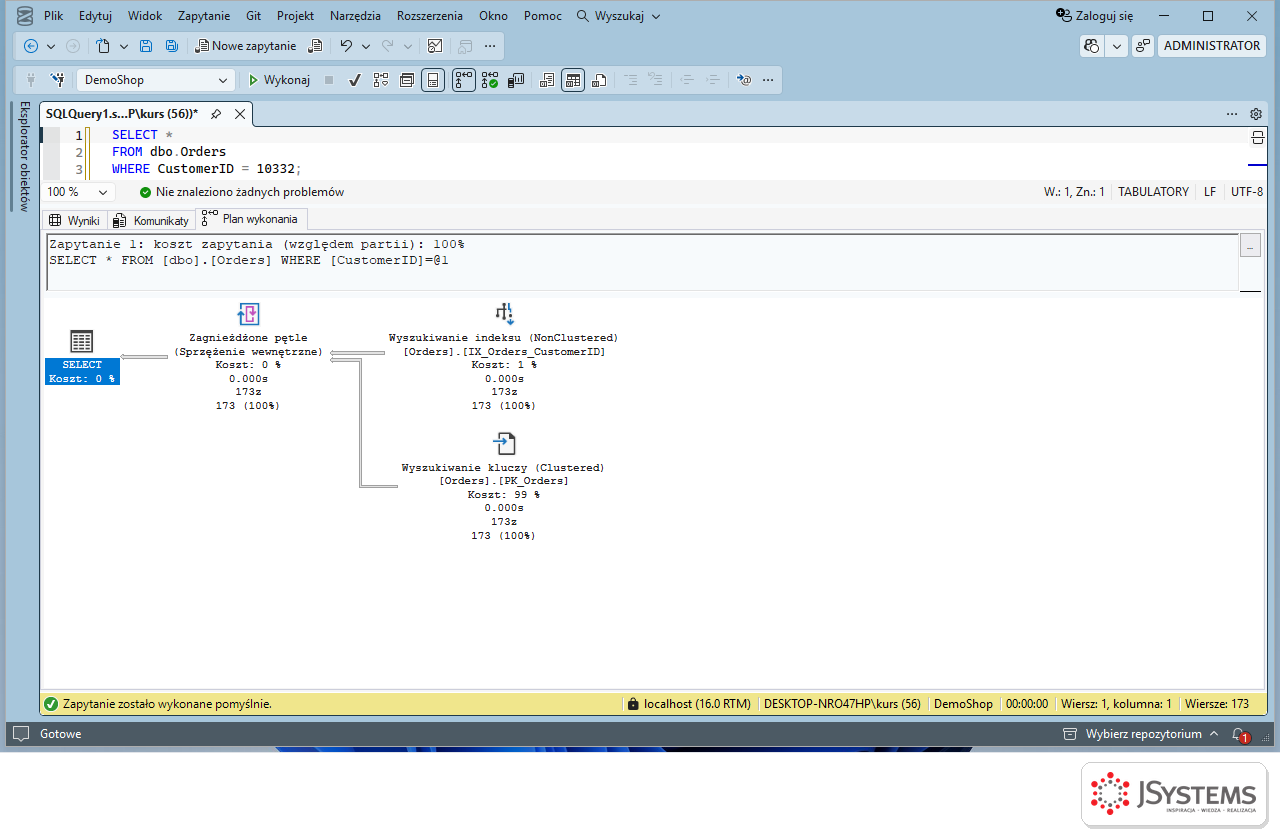
SELECT * to nie tylko więcej danych do przesłania. Gdy na tabeli jest indeks, który obejmuje kolumny potrzebne zapytaniu, gwiazdka sprawia, że i tak trzeba sięgnąć po pozostałe kolumny do tabeli. W planie widać to jako Wyszukiwanie kluczy (Key Lookup) wykonywane dla każdego wiersza.
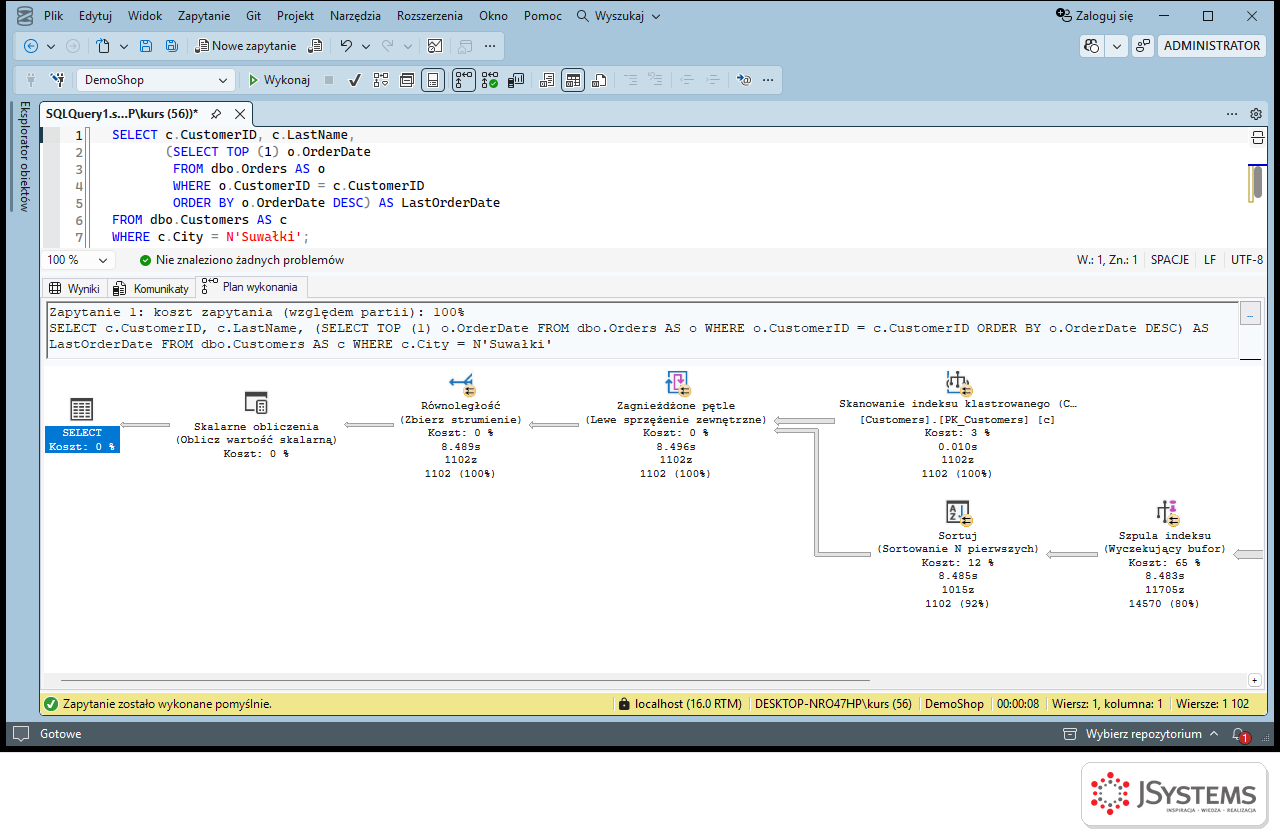
Podzapytanie w liście SELECT, które odwołuje się do tabeli zewnętrznej, logicznie wykonuje się dla każdego wiersza. Optymalizator często przepisuje je na złączenie, ale nie zawsze. Data ostatniego zamówienia dla każdego z 1 102 klientów z Suwałk, liczona przez TOP (1) ... ORDER BY OrderDate DESC, zmusiła serwer do zbudowania w locie tymczasowego indeksu na całej tabeli zamówień. W planie to operator Szpula indeksu (Index Spool, Eager Spool).
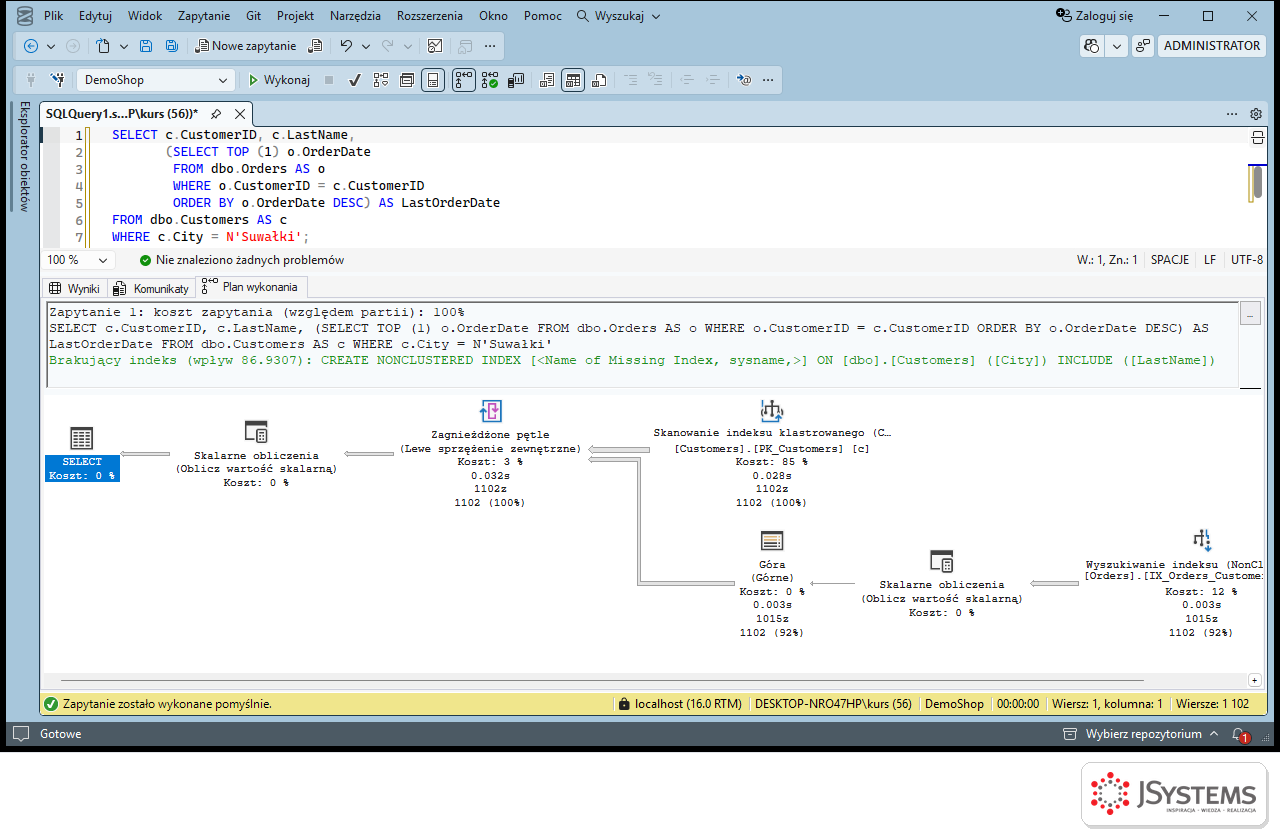
Szpula indeksu w planie to optymalizator mówiący wprost: „brakuje mi indeksu, więc buduję go sobie przy każdym wykonaniu”. Są dwie poprawki. Przepisanie na złączenie z pogrupowaną tabelą zamówień (MAX(OrderDate) ... GROUP BY CustomerID) obniża czas procesora do 239 ms. Indeks (CustomerID, OrderDate) pozwala zostawić oryginalne zapytanie: 34 ms. Podzapytanie skorelowane samo w sobie nie jest więc błędem, błędem był brak indeksu, który je obsłuży.
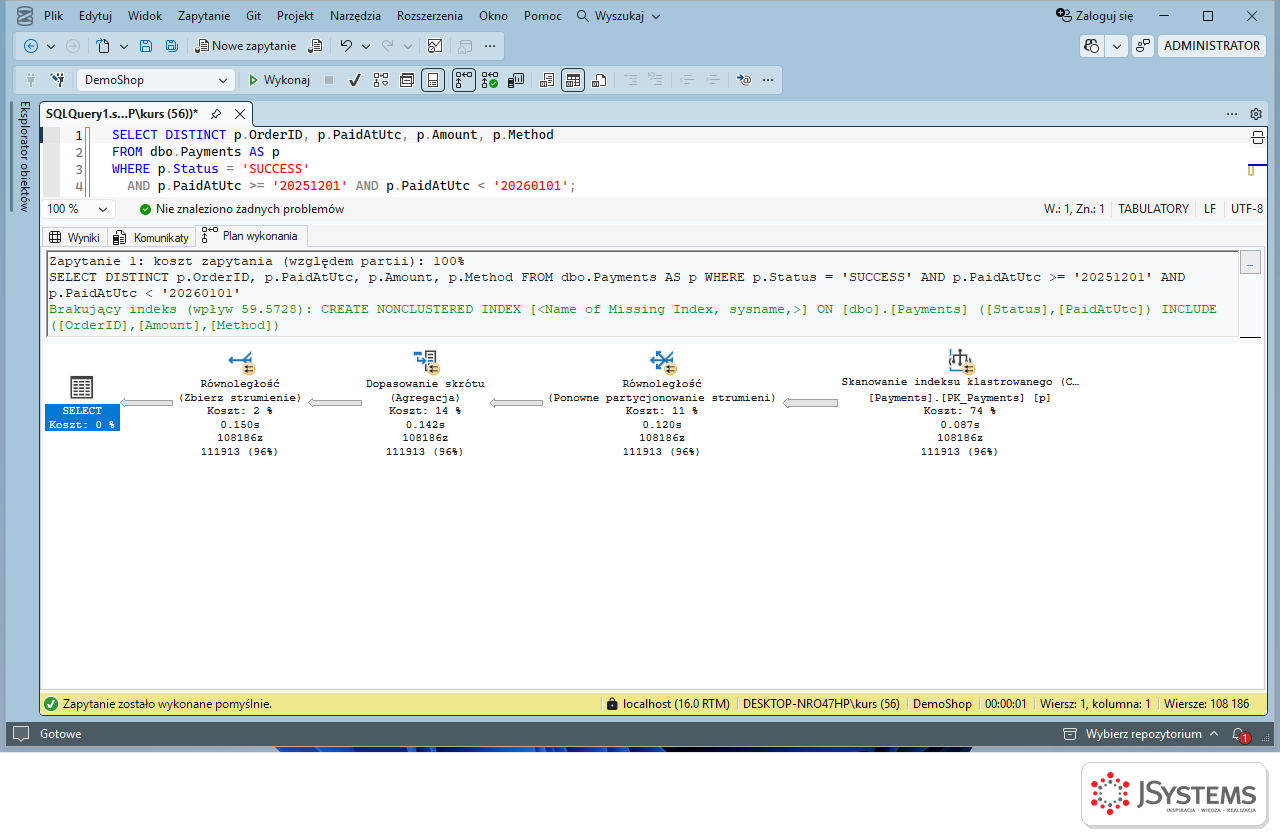
DISTINCT dopisany „na wszelki wypadek” kosztuje: serwer musi porównać wszystkie wiersze, żeby usunąć duplikaty, których może nie być. Lista udanych płatności z grudnia z DISTINCT wymaga operatora Dopasowanie skrótu (agregacja) i 16,9 MB pamięci. Bez DISTINCT wynik ma dokładnie tyle samo wierszy, 108 186, bo każda płatność jest inna, a pamięci wystarcza 72 KB.
Przed usunięciem DISTINCT sprawdź, czy duplikaty naprawdę nie są możliwe: porównaj COUNT(*) z COUNT(DISTINCT ...) na tych samych kolumnach. Jeśli DISTINCT naprawia duplikaty z błędnego złączenia, poprawić trzeba złączenie (pierwszy błąd z listy dwudziestu typowych błędów).
Formularze wyszukiwania często mają jedno zapytanie na wszystkie kombinacje filtrów: (@CustomerID IS NULL OR CustomerID = @CustomerID) AND (@Status IS NULL OR Status = @Status) .... Plan musi działać dla każdej kombinacji, więc nie może wyszukać po CustomerID, bo przy pustym parametrze potrzebne byłyby wszystkie wiersze. Wynik: skan całej tabeli, nawet gdy podano numer klienta.
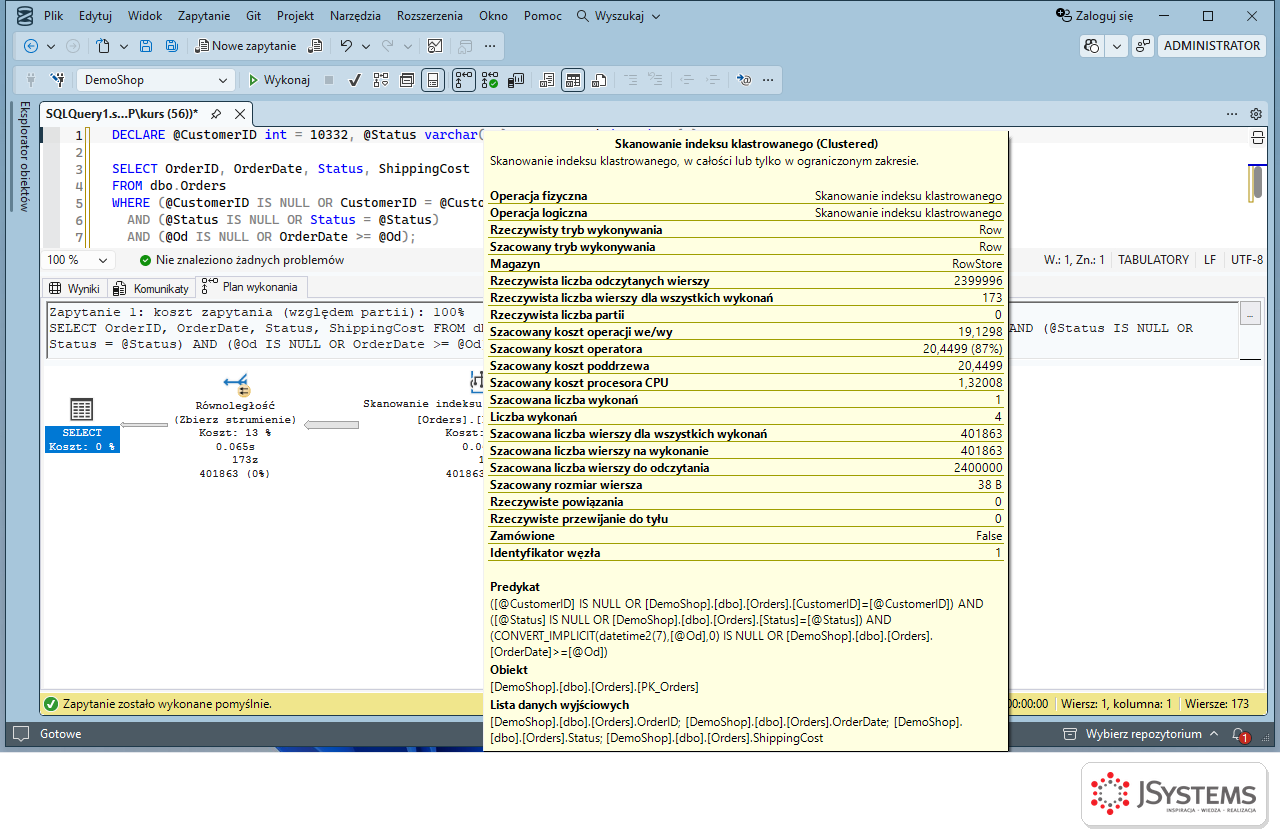
OPTION (RECOMPILE) pozwala optymalizatorowi uprościć warunek dla aktualnych wartości parametrów: zostaje samo CustomerID = 10332 i wyszukiwanie w indeksie (484 odczyty zamiast 26 032). Przy bardzo często wykonywanych zapytaniach koszt kompilacji za każdym razem bywa za wysoki i lepszym rozwiązaniem jest dynamiczny SQL składający tylko podane warunki, z parametrami przez sp_executesql.
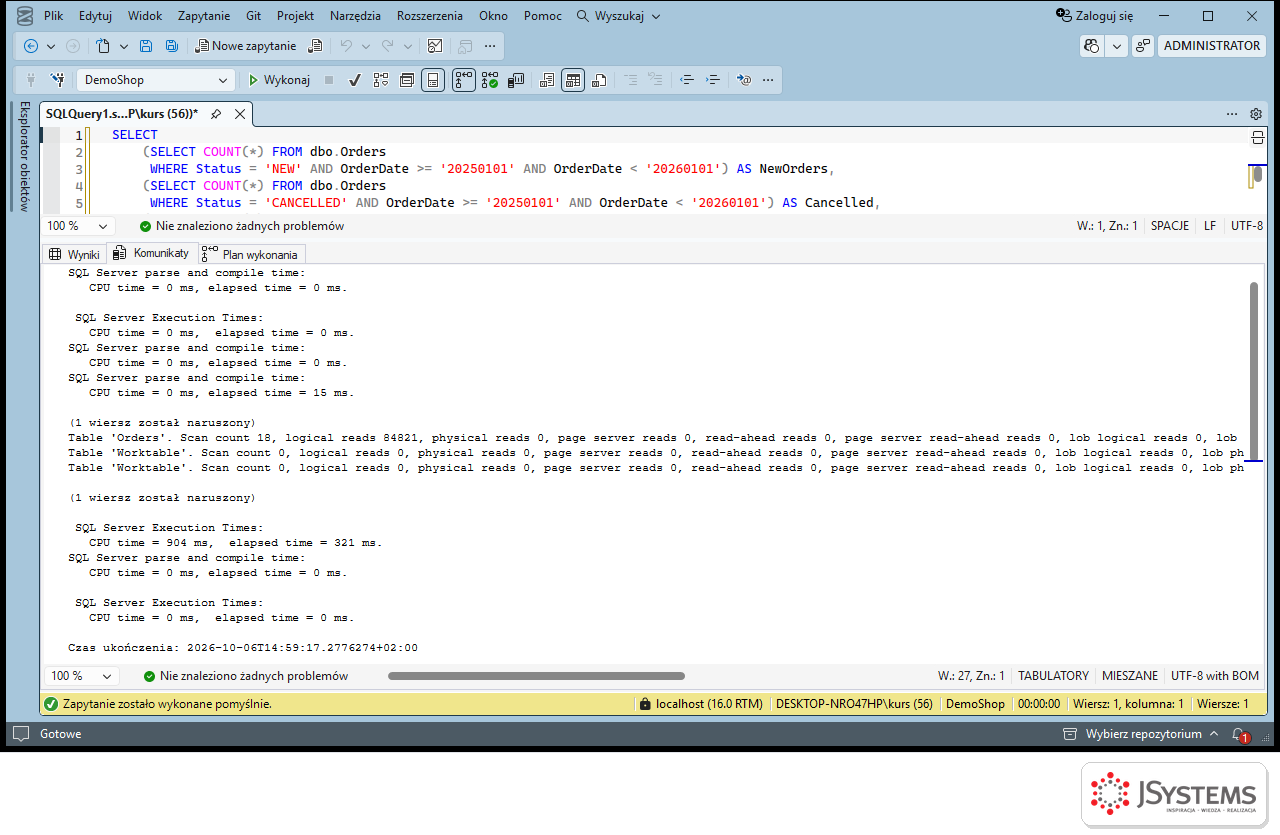
Raport z czterema podzapytaniami w liście SELECT, z których każde liczy coś innego z tabeli zamówień, czyta tę tabelę kilka razy. Zakładka Komunikaty pokazuje to bez czytania planu: liczba skanowań i odczyty logiczne tabeli Orders.
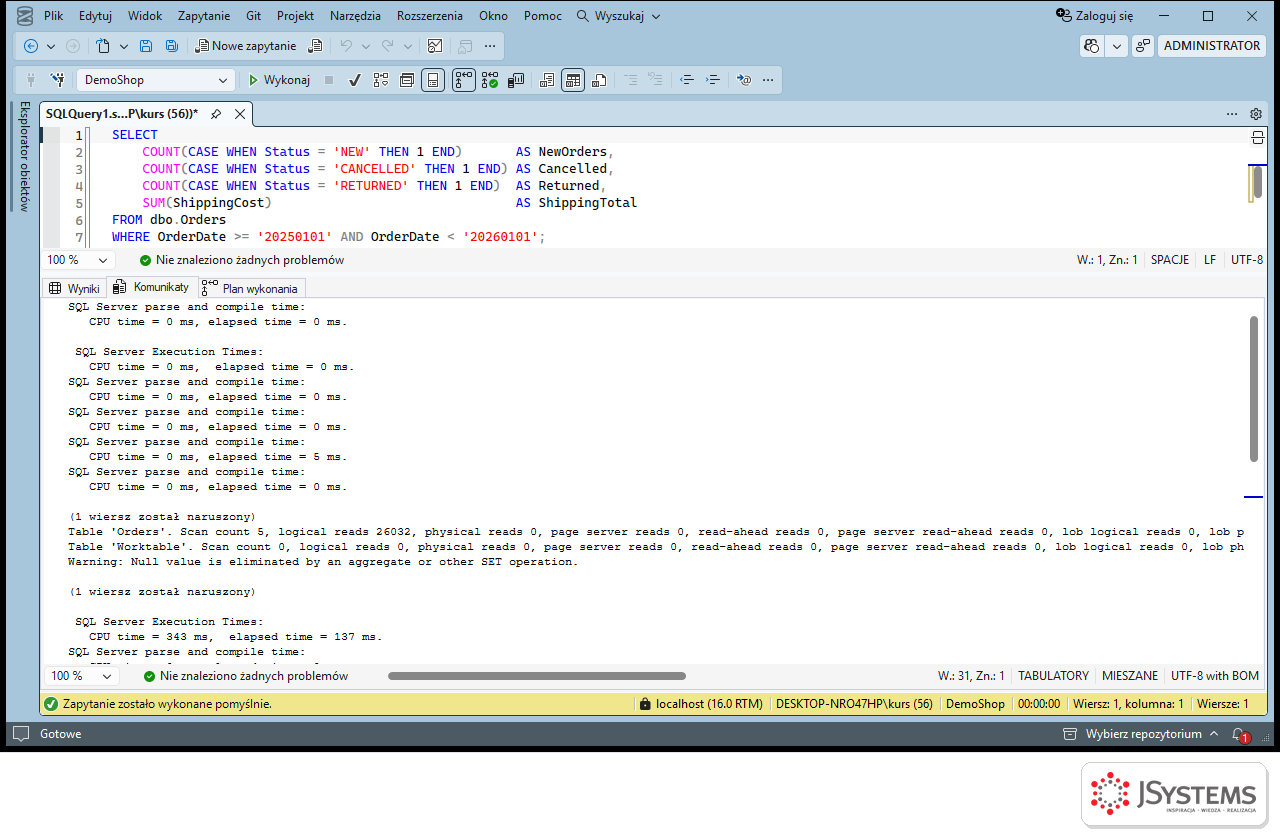
Jedno przejście z agregacją warunkową (COUNT(CASE WHEN Status = 'NEW' THEN 1 END) i tak dalej) czyta tabelę raz: 26 032 odczyty, a czas procesora spada mniej więcej o połowę, z około 900 do około 400 ms.
Indeks istnieje, a plan go nie używa. W DemoShop jest indeks IX_Orders_Status na samej kolumnie statusu. Dla zamówień wysłanych od 20 września 2026 optymalizator i tak wybiera skan całej tabeli, bo indeks wskazałby 11 005 wierszy, a każdy z nich wymagałby osobnego sięgnięcia do tabeli po pozostałe kolumny.
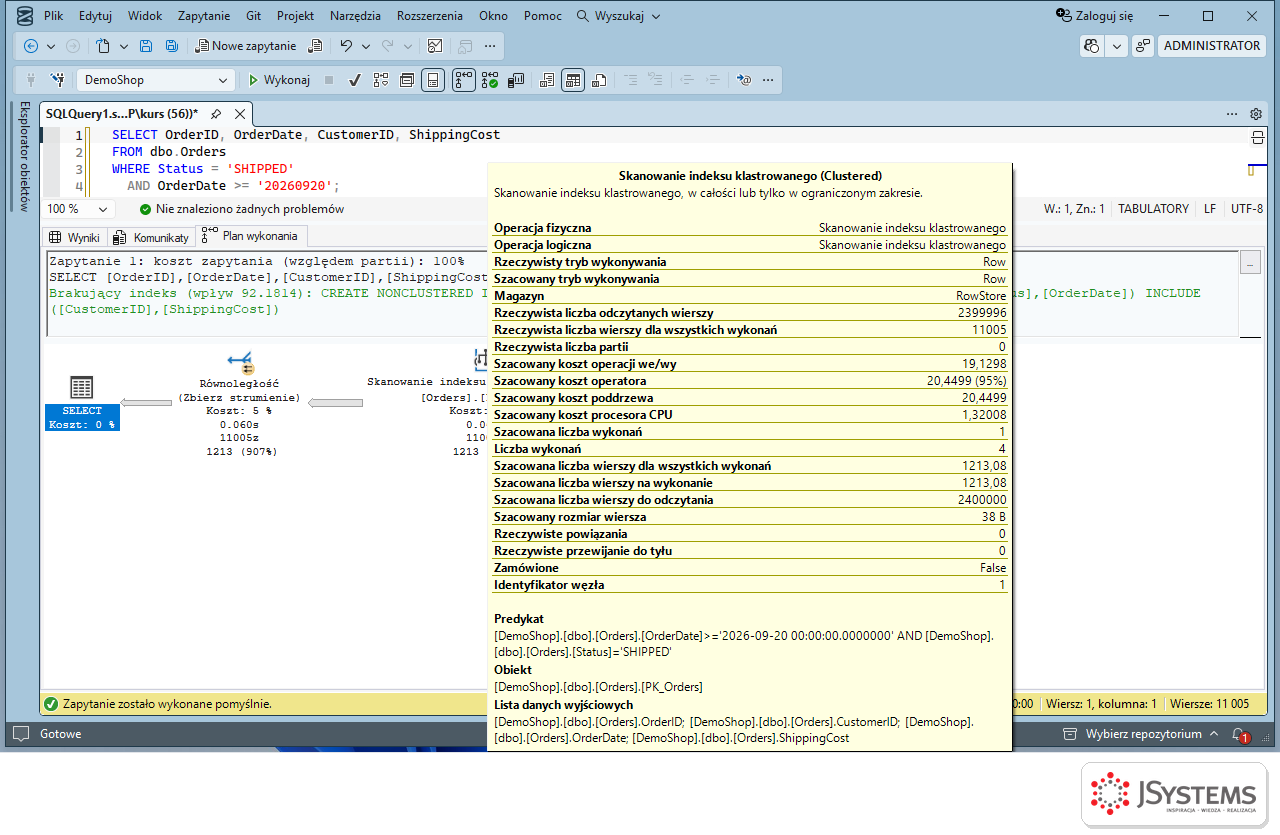
Indeks (Status, OrderDate) INCLUDE (CustomerID, ShippingCost) daje wyszukiwanie z 53 odczytami. Stary indeks na samym Status staje się wtedy zbędny (nowy zaczyna się od tej samej kolumny), a każdy indeks to koszt przy każdym zapisie. Jak sprawdzić, które indeksy są nieużywane, pokazujemy w sekcji o doborze indeksów.
Gdy optymalizator uzna, że indeks znacząco by pomógł, dopisuje nad planem zieloną sugestię „Brakujący indeks” z szacowanym wpływem. Prawy przycisk na planie i Brak szczegółów indeksu (tak polska wersja SSMS tłumaczy polecenie Missing Index Details) otwiera gotowy skrypt CREATE INDEX.
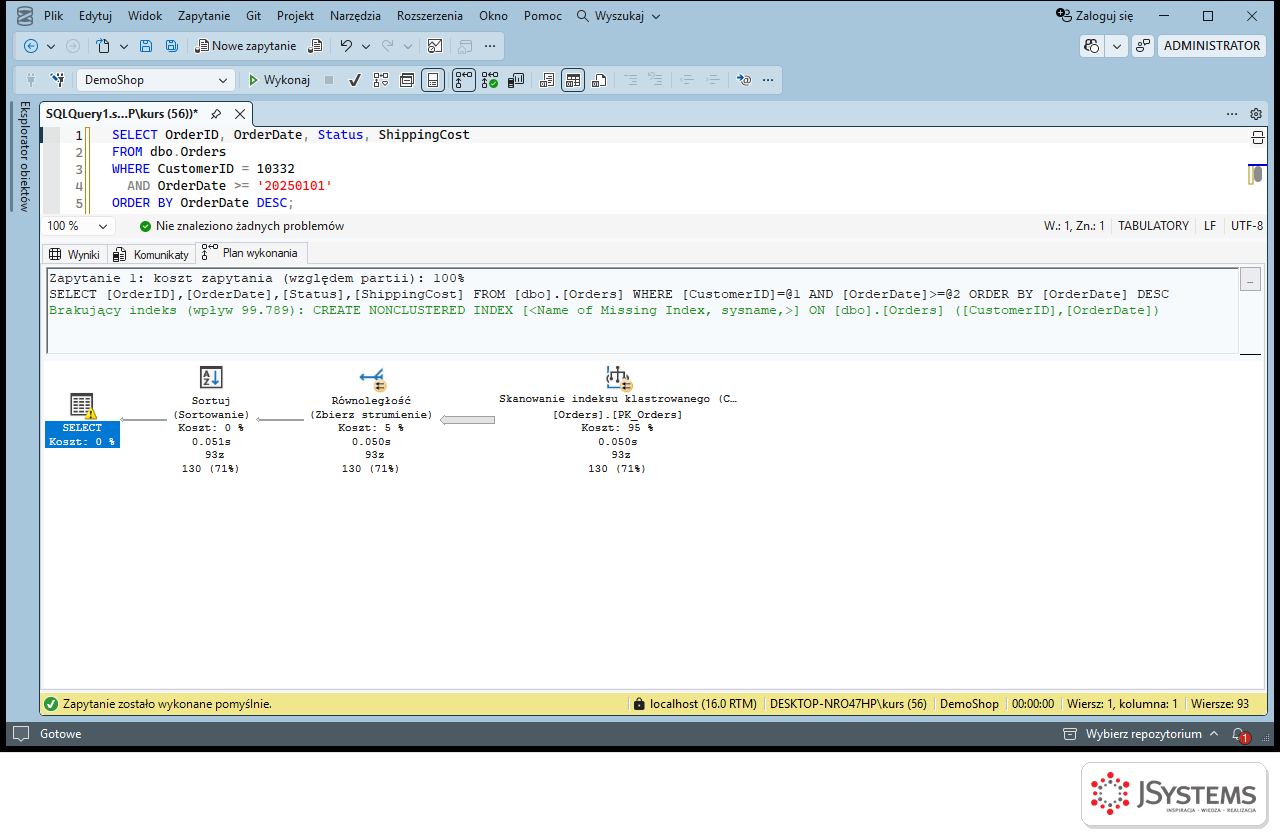
Sugestie są cenne, ale naiwne. Nie biorą pod uwagę kolejności w ORDER BY, istniejących indeksów ani kosztu zapisów, a dla podobnych zapytań potrafią zaproponować kilka prawie identycznych indeksów. To dokładnie miejsce, w którym AI jest przydatne: dostaje sugestie z kilku planów i listę istniejących indeksów, a w odpowiedzi łączy je w jeden przemyślany indeks. Tutaj indeks (CustomerID, OrderDate) INCLUDE (Status, ShippingCost) zmienia 26 032 odczyty w 4 i usuwa z planu sortowanie.
W indeksie wielokolumnowym liczy się kolejność. Dane są posortowane najpierw po pierwszej kolumnie, potem po drugiej. Zapytanie o zamówienia klienta nr 7 z grudnia przy indeksie (OrderDate, CustomerID) wyszukuje zakres dat, czyta wszystkie zamówienia z grudnia (107 311) i dopiero wśród nich szuka klienta.
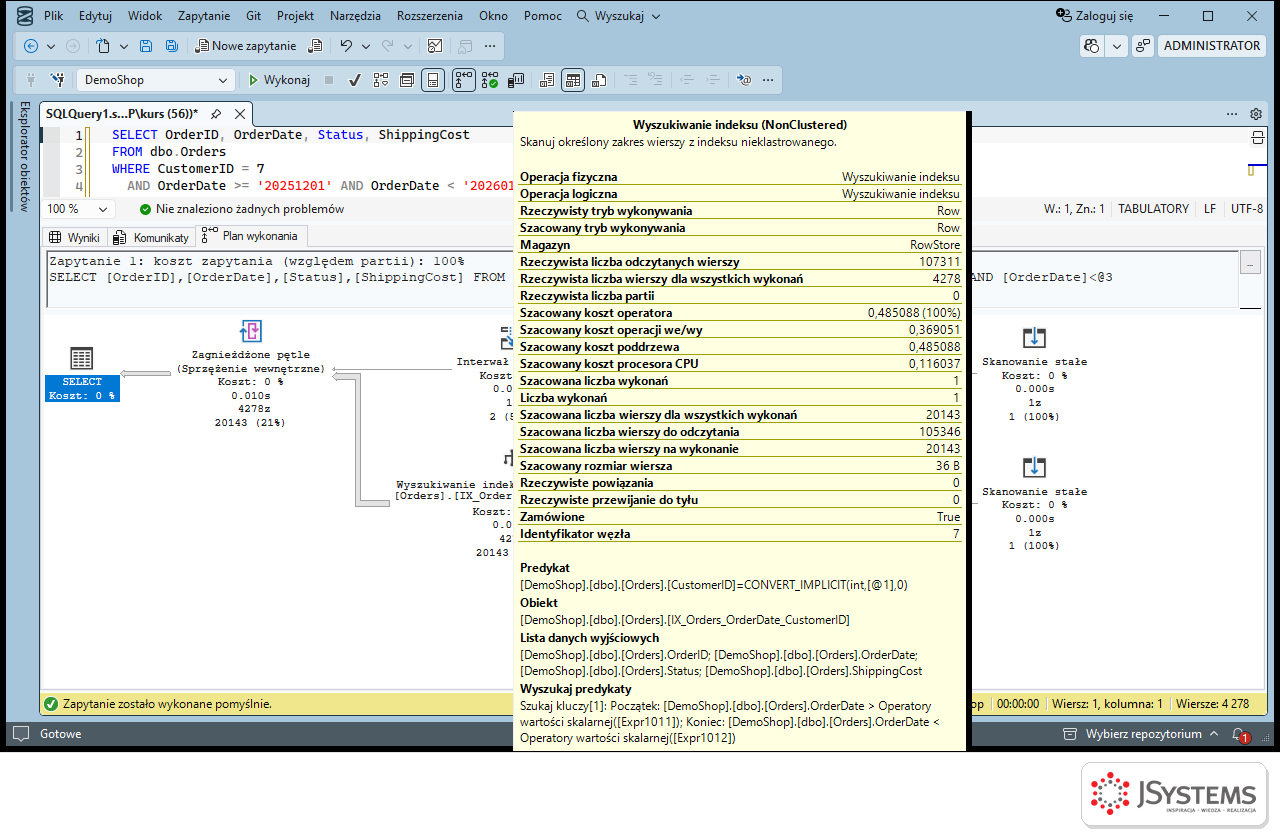
Indeks (CustomerID, OrderDate) stawia warunek równości na początku, a zakres na końcu: 4 278 odczytanych wierszy i 24 odczyty logiczne zamiast 511. Reguła praktyczna, którą AI zna i powinno stosować: najpierw kolumny porównywane przez równość, potem jedna kolumna z zakresem, a kolumny potrzebne tylko w wyniku jako INCLUDE.
Indeks pokrywający (covering index) zawiera wszystkie kolumny potrzebne zapytaniu, więc serwer nie musi sięgać do tabeli. Bez tego każdy znaleziony wiersz kosztuje dodatkowe Wyszukiwanie kluczy: dla 173 zamówień klienta to 173 skoki i 484 odczyty.
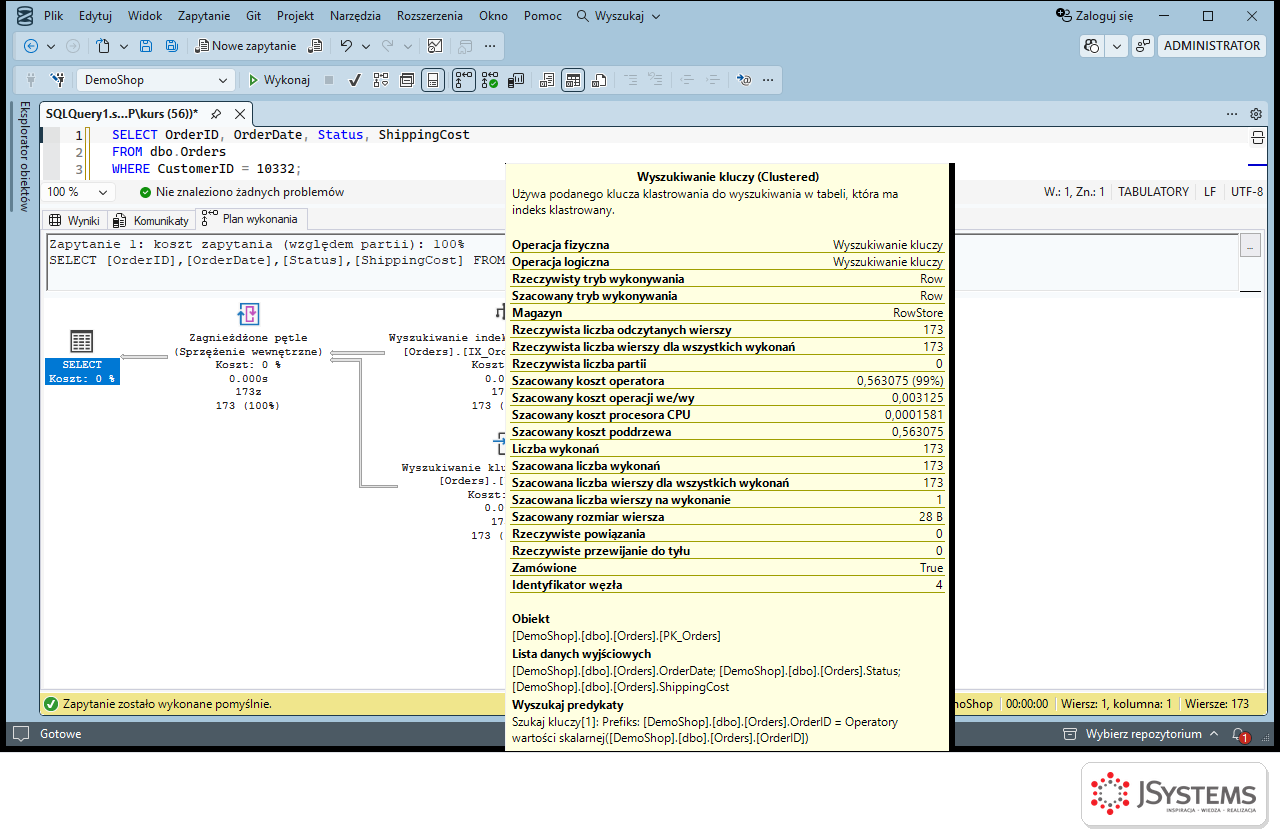
Dopisanie kolumn w INCLUDE ((CustomerID) INCLUDE (OrderDate, Status, ShippingCost)) usuwa wyszukiwania kluczy: 4 odczyty. Kolumny w INCLUDE są przechowywane tylko na najniższym poziomie indeksu, więc nie zmieniają jego porządku i są tańsze niż kolumny w kluczu.
SQL Server zapisuje każdy brakujący indeks, który przyszedł mu do głowy podczas optymalizacji zapytań. Te sugestie widać w zielonej podpowiedzi nad planem (sygnał 17 z listy sygnałów) i zbiorczo w widokach systemowych sys.dm_db_missing_index_*. Są cenne, bo pochodzą z prawdziwego obciążenia, ale każda dotyczy jednego zapytania. Wdrożone wszystkie naraz dają kilka prawie identycznych indeksów i drogie zapisy. Tu AI przydaje się szczególnie: dostaje wszystkie sugestie i statystyki użycia istniejących indeksów naraz i układa z nich jeden spójny zestaw.
-- Brakujące indeksy zebrane przez SQL Server od ostatniego restartu
SELECT TOP (10)
       REPLACE(d.statement, '[DemoShop].[dbo].', '') AS Tabela,
       d.equality_columns AS Rownosc, d.inequality_columns AS Nierownosc,
       d.included_columns AS Dolaczone,
       s.user_seeks AS Wyszukania,
       CAST(s.avg_user_impact AS int) AS WplywProc,
       CAST(s.avg_total_user_cost AS decimal(10, 2)) AS KosztZapytania
FROM sys.dm_db_missing_index_details AS d
JOIN sys.dm_db_missing_index_groups AS g ON g.index_handle = d.index_handle
JOIN sys.dm_db_missing_index_group_stats AS s ON s.group_handle = g.index_group_handle
WHERE d.database_id = DB_ID()
ORDER BY s.user_seeks * s.avg_user_impact * s.avg_total_user_cost DESC;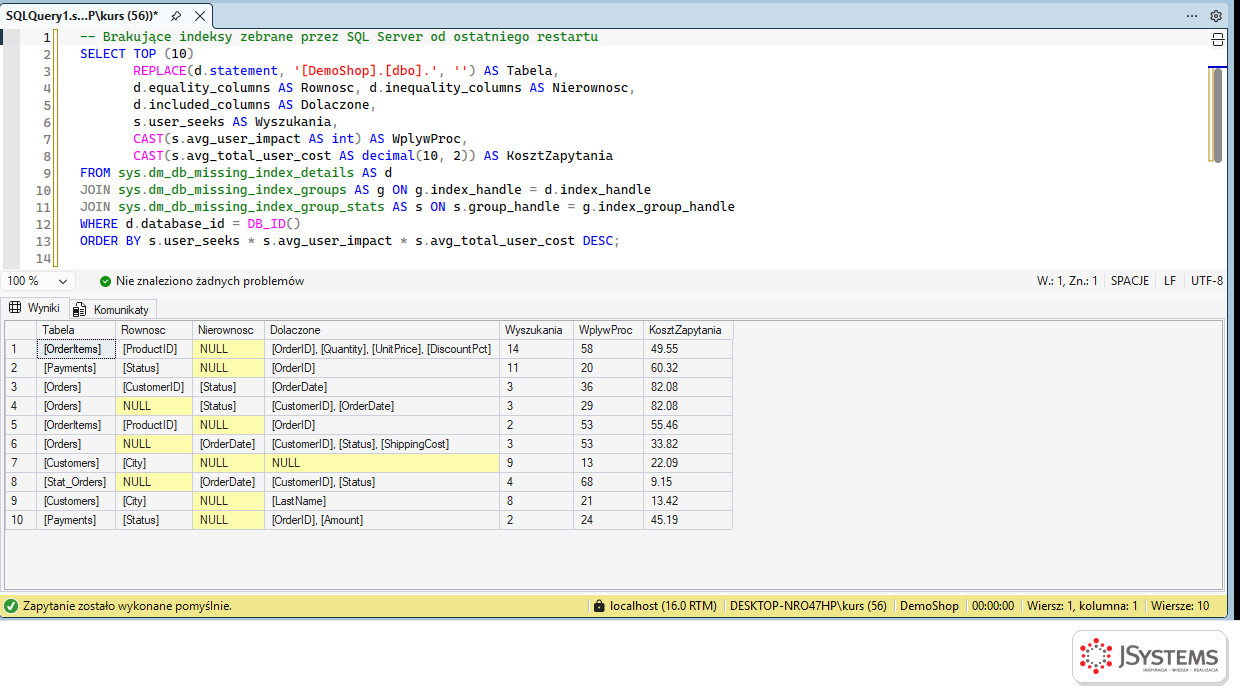
Drugie zapytanie pokazuje, jak używane są istniejące indeksy: ile było wyszukań, skanów i doczytań, a ile zapisów, które każdy indeks musi obsłużyć:
-- Jak używane są istniejące indeksy: odczyty kontra zapisy
SELECT OBJECT_NAME(i.object_id) AS Tabela, i.name AS Indeks, i.type_desc AS Typ,
       ISNULL(u.user_seeks, 0) AS Wyszukania, ISNULL(u.user_scans, 0) AS Skany,
       ISNULL(u.user_lookups, 0) AS Doczytania, ISNULL(u.user_updates, 0) AS Zapisy
FROM sys.indexes AS i
LEFT JOIN sys.dm_db_index_usage_stats AS u
       ON u.object_id = i.object_id AND u.index_id = i.index_id AND u.database_id = DB_ID()
WHERE OBJECTPROPERTY(i.object_id, 'IsUserTable') = 1 AND i.index_id > 0
  AND OBJECT_NAME(i.object_id) IN ('Orders', 'OrderItems', 'Payments', 'Customers')
ORDER BY Tabela, Indeks;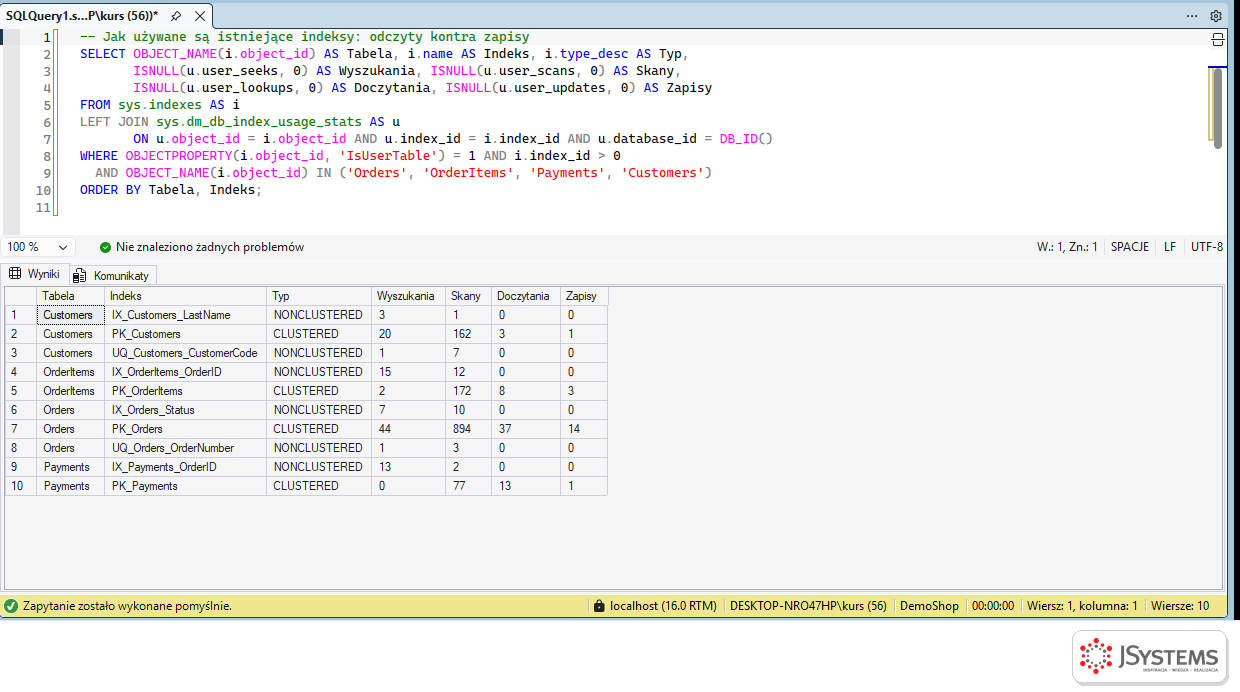
Oba wyniki zapisujemy jako pliki tekstowe i dołączamy razem ze schematem bazy. Polecenie wymaga trzech rzeczy, których same widoki systemowe nie dają: łączenia pokrywających się sugestii, oceny kosztu zapisu i jasnego wskazania, czego nie da się ocenić bez dodatkowych danych.
Jesteś administratorem SQL Server 2022. W załącznikach: lista brakujących indeksów z widoków sys.dm_db_missing_index_* (stan od ostatniego restartu serwera), statystyki użycia istniejących indeksów (odczyty i zapisy) oraz schemat bazy. Zaproponuj minimalny zestaw indeksów: połącz sugestie, które się pokrywają, odrzuć te, które nie są warte kosztu zapisu, i wskaż istniejące indeksy do usunięcia albo rozszerzenia. Przy każdej propozycji podaj polecenie CREATE INDEX, listę sugestii, które pokrywa, i ryzyko dla zapisów. Zaznacz, czego nie da się ocenić bez dodatkowych danych.
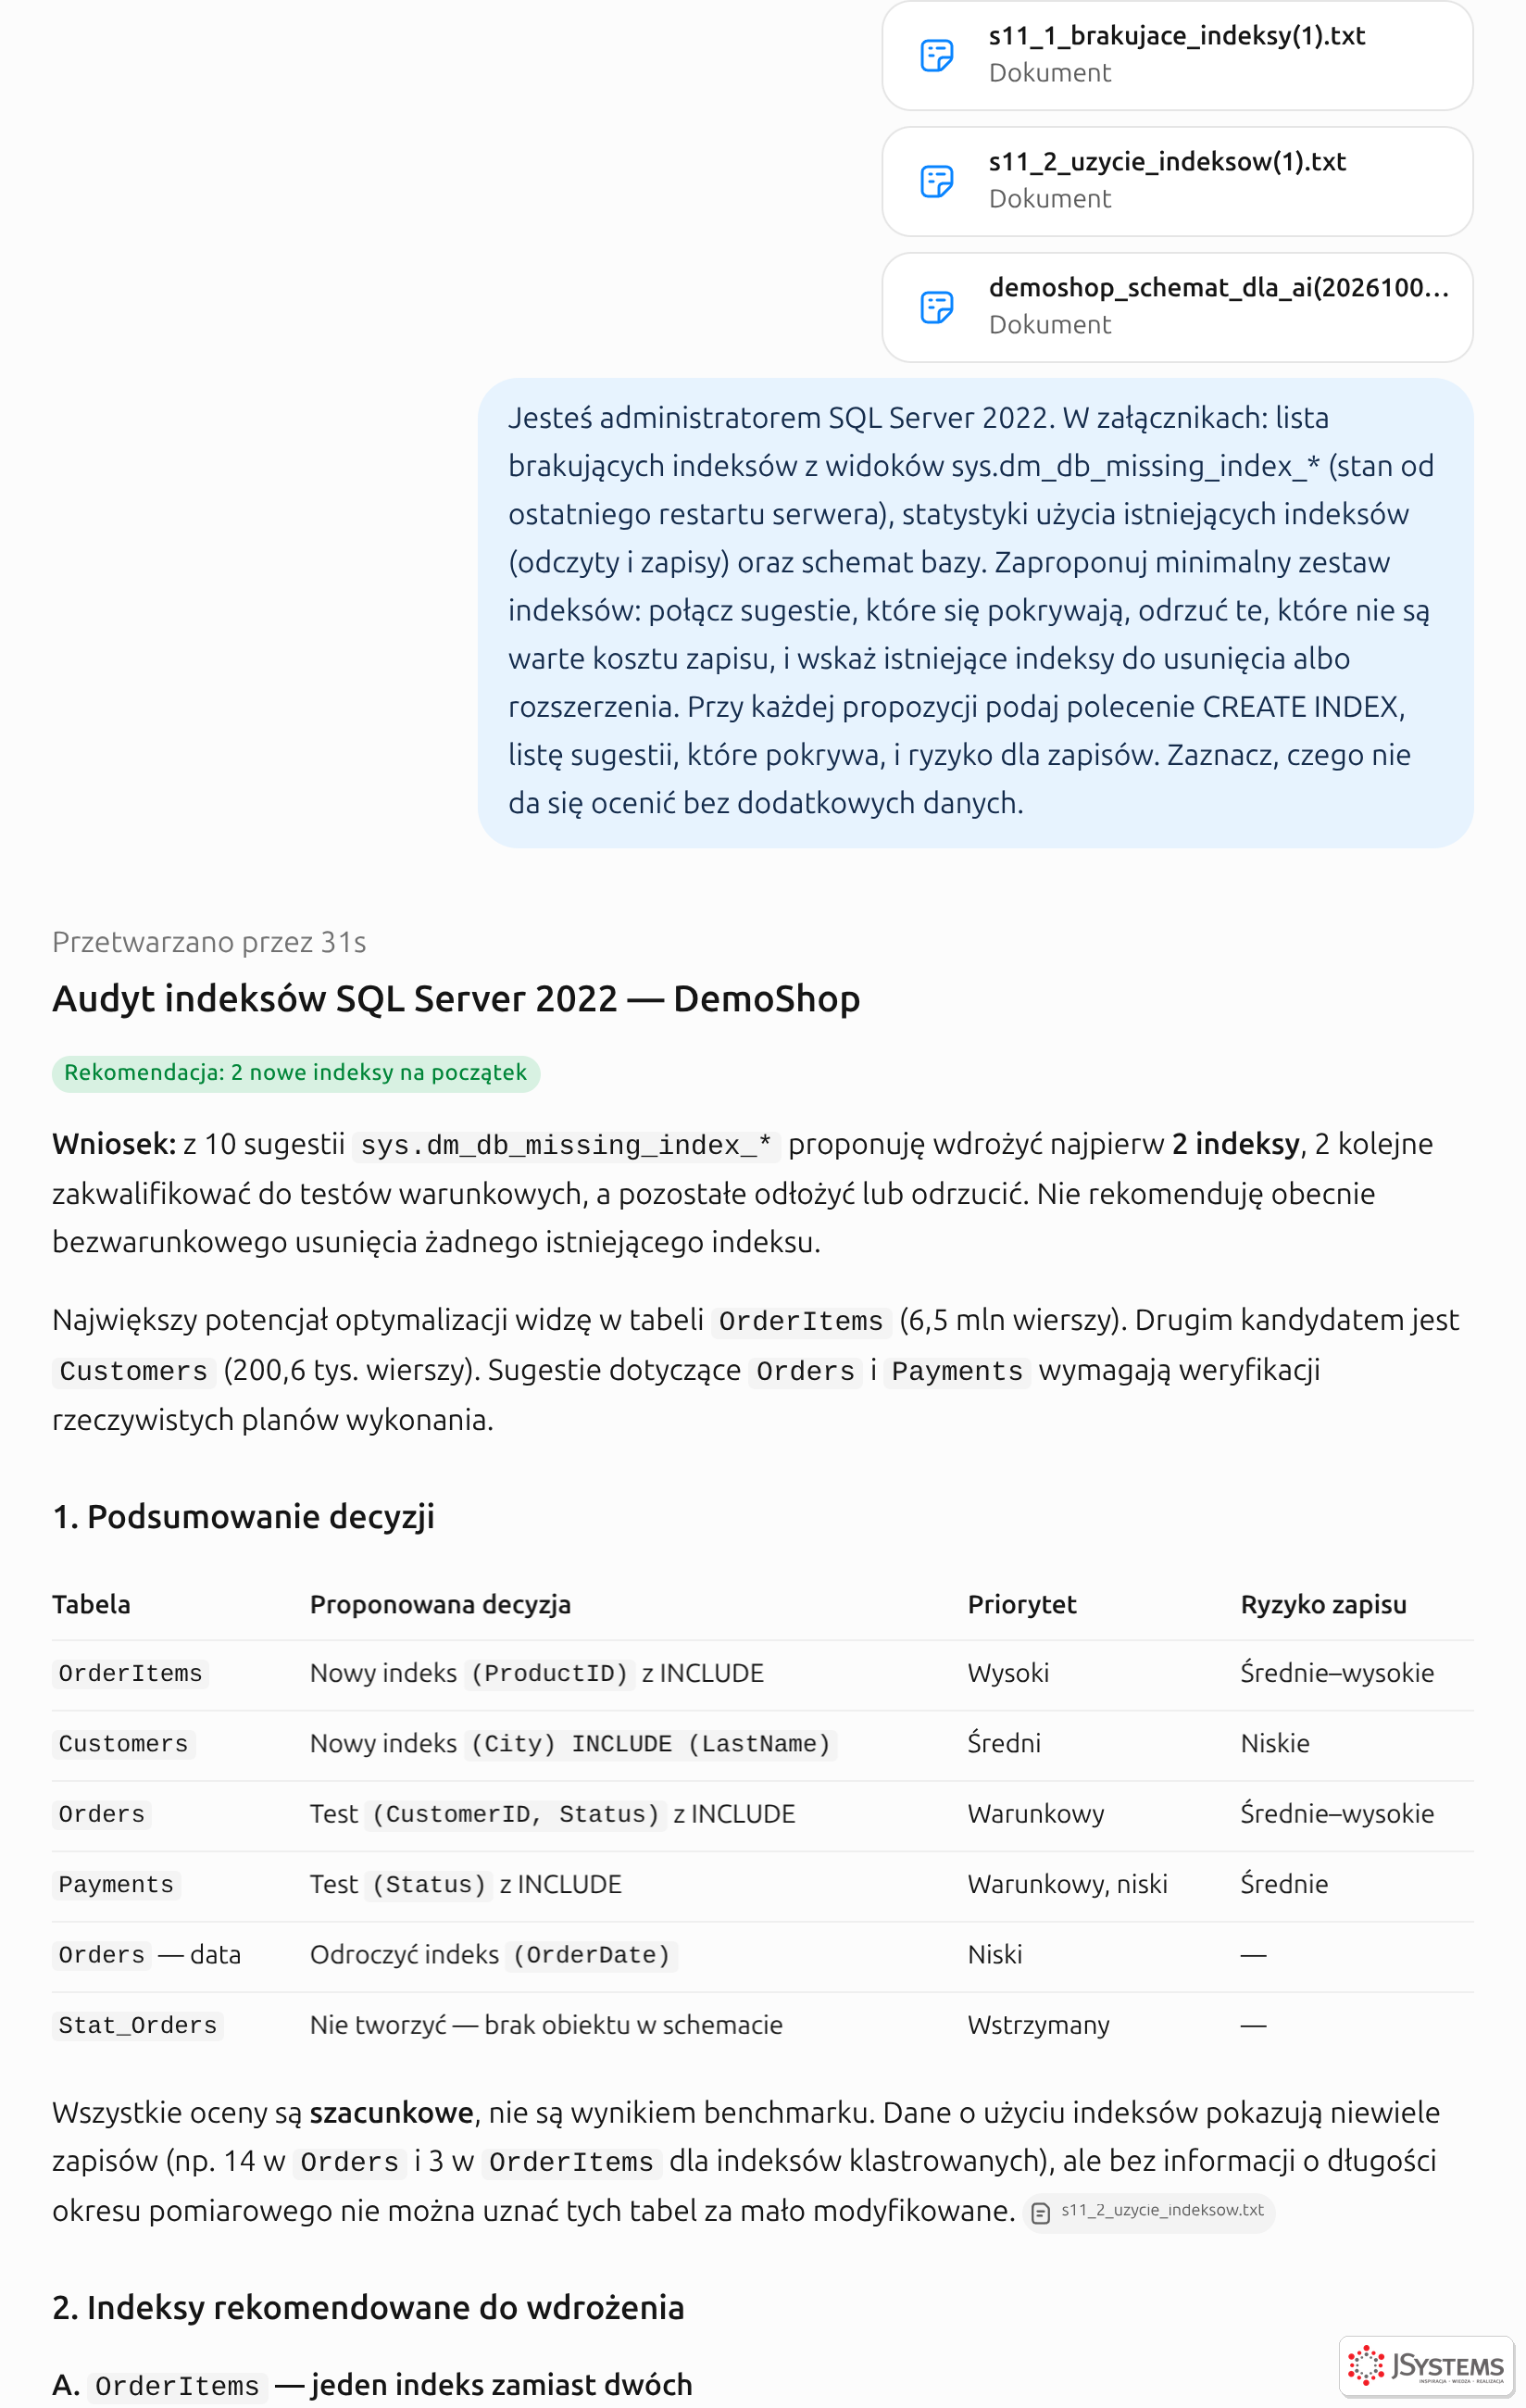
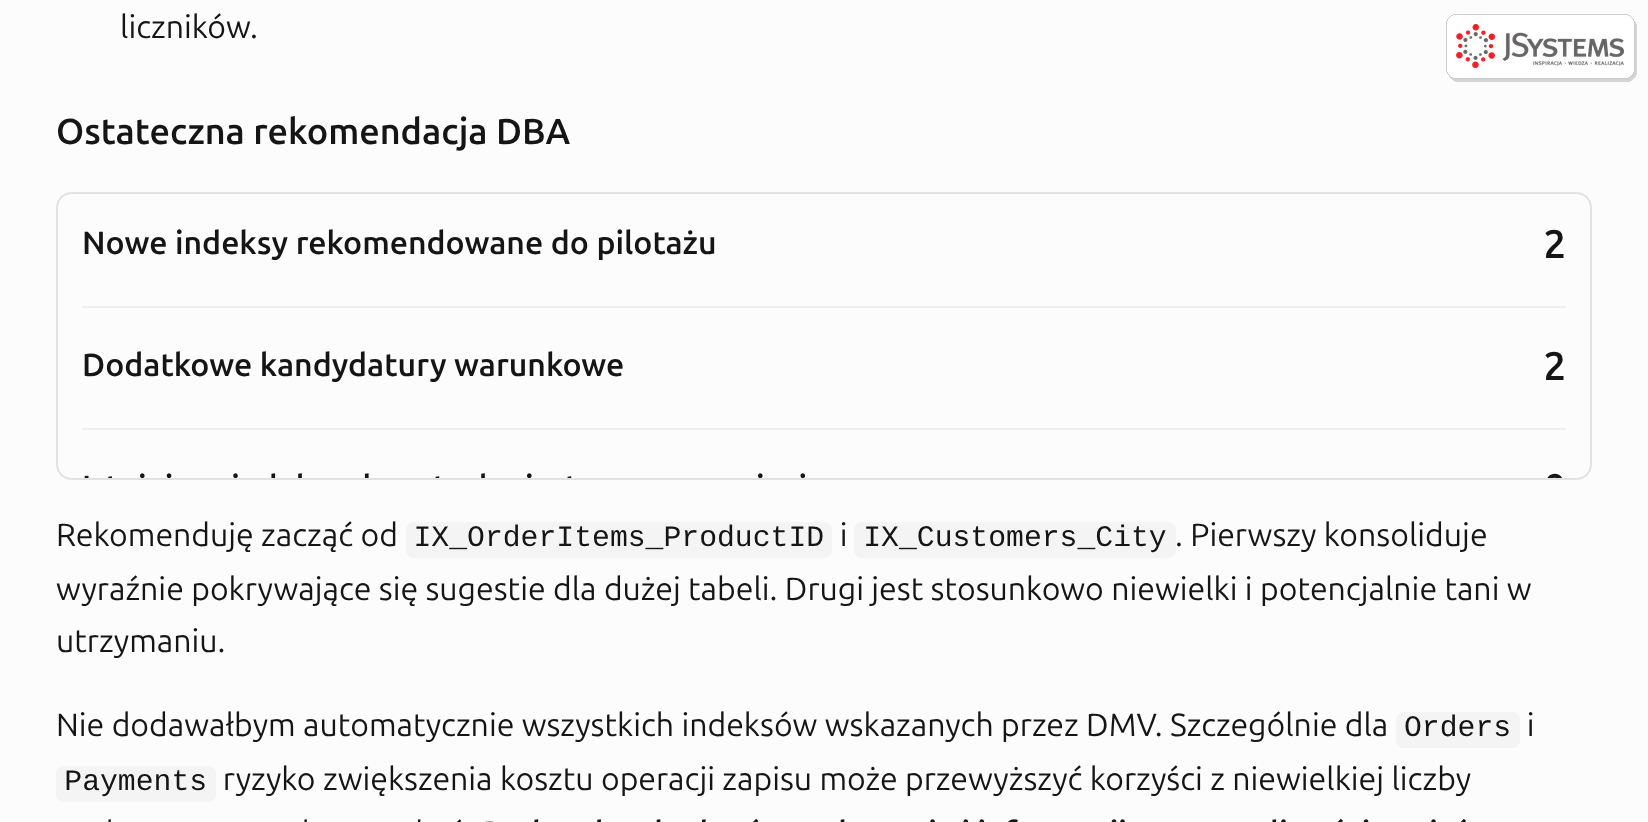
Odpowiedź jest konserwatywna i dobrze uzasadniona. AI połączyło dwie sugestie dla OrderItems w jeden indeks, bo jedna jest podzbiorem drugiej, i tak samo dwie dla Customers. Indeks dla klientów zaproponowało wąski, z jedną kolumną dołączoną, zamiast szerokiego indeksu pokrywającego pełne rekordy klientów. Nie zaproponowało usunięcia żadnego istniejącego indeksu, bo okres obserwacji jest za krótki, a indeksy unikalne pilnują poprawności danych. Wyłapało też coś, czego nie zauważylibyśmy w liście: jedna z sugestii dotyczy tabeli Stat_Orders, której nie ma w schemacie (to tabela testowa z demonstracji statystyk), więc AI wstrzymało decyzję zamiast proponować dla niej indeks.
AI ocenia ryzyko dla zapisów słownie, bo nie ma danych o obciążeniu. Ten koszt łatwo jednak zmierzyć. Na kopii tabeli pozycji zamówień zapisaliśmy 300 tysięcy wierszy dwa razy: raz z samym kluczem głównym, raz z czterema dodatkowymi indeksami:
-- Ile kosztuje zapis przy dodatkowych indeksach? Pomiar na kopii tabeli OrderItems
SET NOCOUNT ON;
DROP TABLE IF EXISTS dbo.KosztIndeksow;
CREATE TABLE dbo.KosztIndeksow (OrderItemID bigint NOT NULL CONSTRAINT PK_KosztIndeksow PRIMARY KEY,
    OrderID int NOT NULL, ProductID int NOT NULL, Quantity smallint NOT NULL,
    UnitPrice decimal(10, 2) NOT NULL, DiscountPct decimal(4, 1) NOT NULL);
DECLARE @t0 datetime2 = SYSDATETIME(), @bez int, @z4 int;
INSERT dbo.KosztIndeksow SELECT TOP (300000) OrderItemID, OrderID, ProductID, Quantity, UnitPrice, DiscountPct
FROM dbo.OrderItems ORDER BY OrderItemID;
SET @bez = DATEDIFF(MILLISECOND, @t0, SYSDATETIME());
TRUNCATE TABLE dbo.KosztIndeksow;
CREATE INDEX IX1 ON dbo.KosztIndeksow (OrderID);
CREATE INDEX IX2 ON dbo.KosztIndeksow (ProductID) INCLUDE (Quantity, UnitPrice);
CREATE INDEX IX3 ON dbo.KosztIndeksow (ProductID, OrderID);
CREATE INDEX IX4 ON dbo.KosztIndeksow (UnitPrice);
SET @t0 = SYSDATETIME();
INSERT dbo.KosztIndeksow SELECT TOP (300000) OrderItemID, OrderID, ProductID, Quantity, UnitPrice, DiscountPct
FROM dbo.OrderItems ORDER BY OrderItemID;
SET @z4 = DATEDIFF(MILLISECOND, @t0, SYSDATETIME());
SELECT 300000 AS Wiersze, @bez AS MsTylkoKlucz, @z4 AS MsZ4Indeksami,
       CAST(1.0 * @z4 / NULLIF(@bez, 0) AS decimal(5, 2)) AS Krotnosc;
DROP TABLE dbo.KosztIndeksow;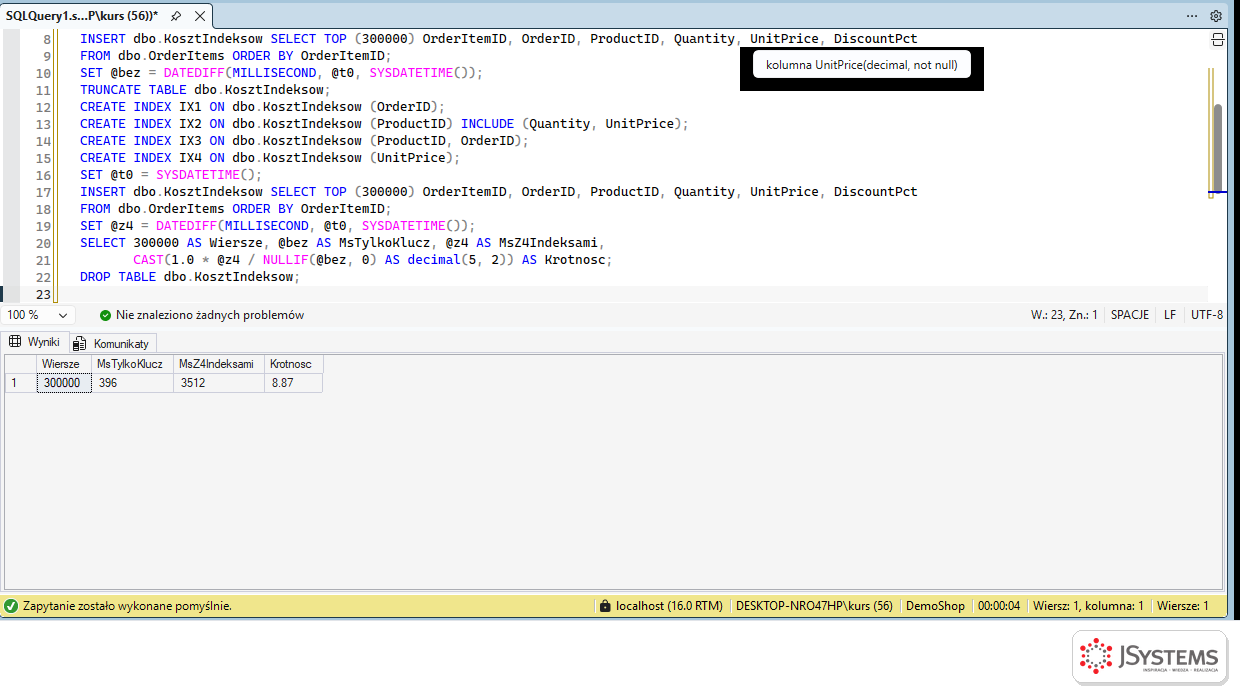
Wynik zależy od sprzętu i od tego, czy wiersze trafiają do indeksów po kolei, ale kierunek jest zawsze ten sam: każdy indeks przyspiesza odczyty, za które płacą wszystkie zapisy do tabeli. Dlatego ostateczna decyzja o indeksie powinna stać na pomiarze odczytów i zapisów na kopii bazy, a nie na samej sugestii, ani tej z widoków systemowych, ani tej od AI.
sys.dm_db_missing_index_* po reprezentatywnym okresie pracy, a nie zaraz po restarcie; dołącz statystyki użycia istniejących indeksów i schemat; poproś AI o łączenie sugestii i ocenę kosztu zapisu; każdy nowy indeks sprawdź na kopii bazy (plan przed i po, odczyty, czas zapisu); po wdrożeniu wróć po tygodniu do sys.dm_db_index_usage_stats i usuń indeksy, z których nikt nie korzysta. Jak to zrobić w PostgreSQL, opisujemy w artykule Które indeksy są nieużywane i jak je znaleźć.Na koniec przechodzimy całą drogę na jednym, realistycznym przypadku: od zgłoszenia „raport się długo liczy”, przez plan wykonania i rozmowę z AI, po zmianę, dowód, że wynik się nie zmienił, i pomiar. Raport zarządu pokazuje sprzedaż 2025 roku według województwa klienta i miesiąca. Napisano go dawno, a etykietę regionu liczy funkcja skalarna, którą ktoś kiedyś dodał „dla porządku”.
/* Funkcja z „dawnych czasów”: etykieta regionu klienta do raportów */
CREATE OR ALTER FUNCTION dbo.fn_RegionLabel (@RegionID tinyint, @Country char(2))
RETURNS nvarchar(60)
AS
BEGIN
    DECLARE @Label nvarchar(60);
    IF @Country IS NULL OR @Country <> 'PL'
        SET @Label = N'Zagranica / brak danych';
    ELSE
        SELECT @Label = r.RegionName FROM dbo.Regions AS r WHERE r.RegionID = @RegionID;
    RETURN ISNULL(@Label, N'brak województwa');
END;
GO
/* Raport zarządu: sprzedaż 2025 według regionu klienta i miesiąca */
SELECT dbo.fn_RegionLabel(c.RegionID, c.Country) AS Region,
       MONTH(o.OrderDate) AS OrderMonth,
       COUNT(DISTINCT o.OrderID) AS Orders,
       COUNT(DISTINCT o.CustomerID) AS Customers,
       SUM(oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100) AS Revenue
FROM dbo.Orders AS o
JOIN dbo.Customers AS c ON c.CustomerID = o.CustomerID
JOIN dbo.OrderItems AS oi ON oi.OrderID = o.OrderID
WHERE YEAR(o.OrderDate) = 2025
  AND o.Status <> 'CANCELLED'
GROUP BY dbo.fn_RegionLabel(c.RegionID, c.Country), MONTH(o.OrderDate)
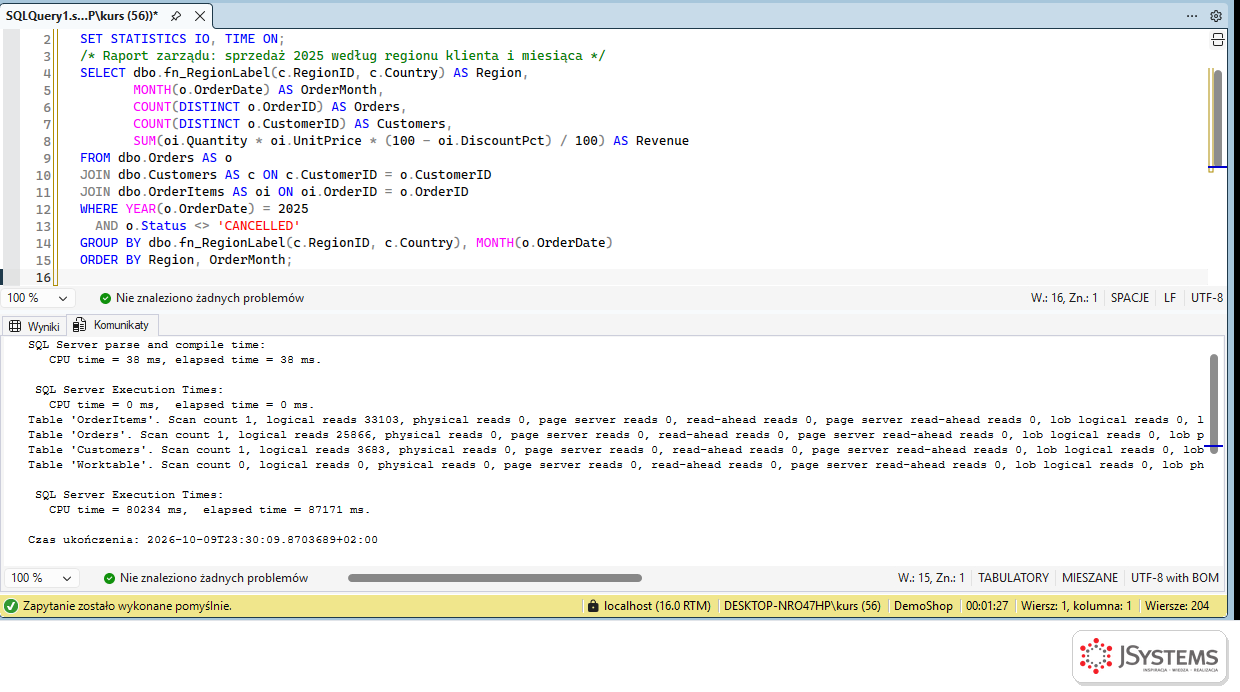
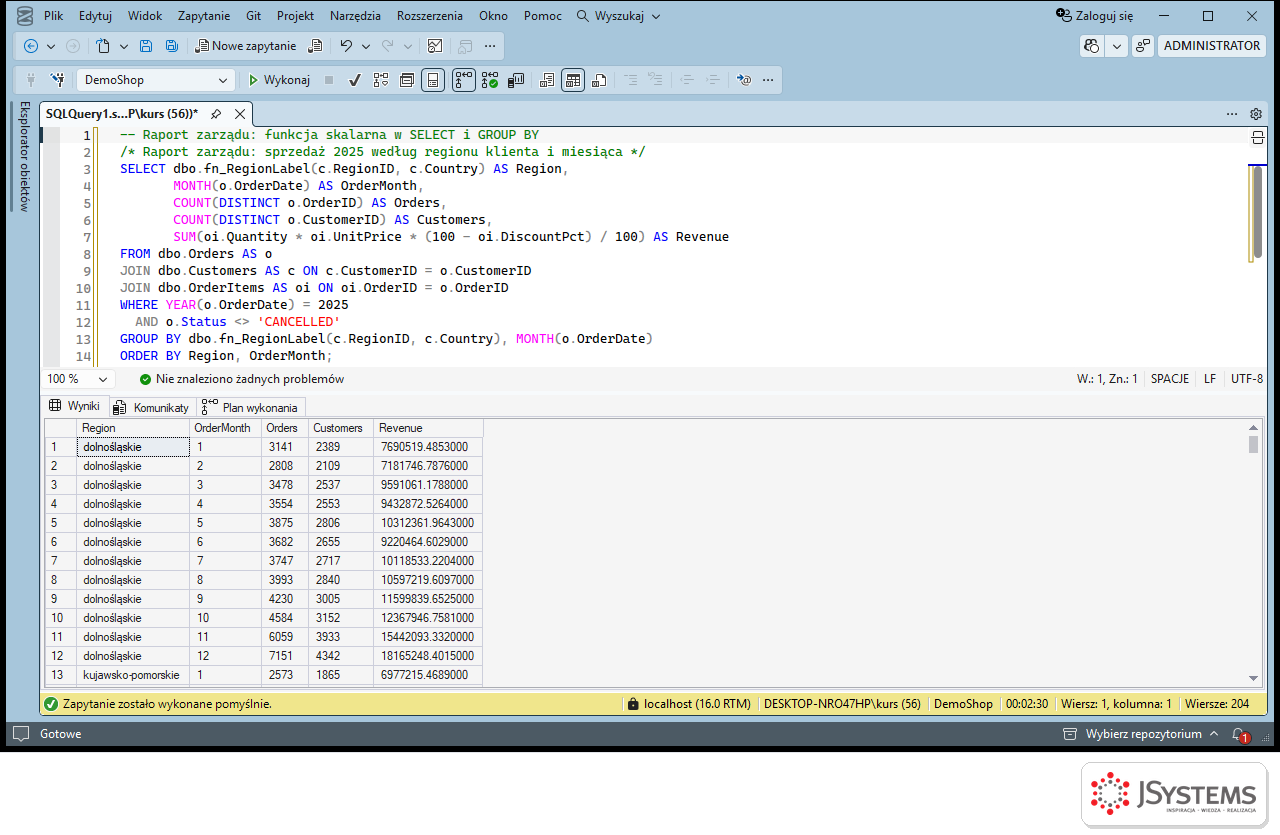
ORDER BY Region, OrderMonth;Raport zwraca 204 wiersze (17 etykiet regionu razy 12 miesięcy). Trzy wykonania trwały 75,2, 74,5 i 74,2 sekundy, prawie w całości na procesorze. W SSMS ze statystykami czasu wyszło 80,2 s procesora i 87,2 s ogółem, a z planem rzeczywistym jeszcze dłużej:
Raport zarządu w SQL Server 2022 (sprzedaż 2025 według regionu klienta i miesiąca) wykonuje się bardzo długo. Załączam rzeczywisty plan wykonania i schemat bazy. Poniżej zapytanie i funkcja, której używa. Wypisz hipotezy, co jest przyczyną, od najważniejszej, do każdej jedną zmianę do przetestowania i przewidywanie, co zmieni się w planie. Potem napisz poprawioną wersję raportu, która zwraca dokładnie ten sam wynik.
[zapytanie i funkcja]
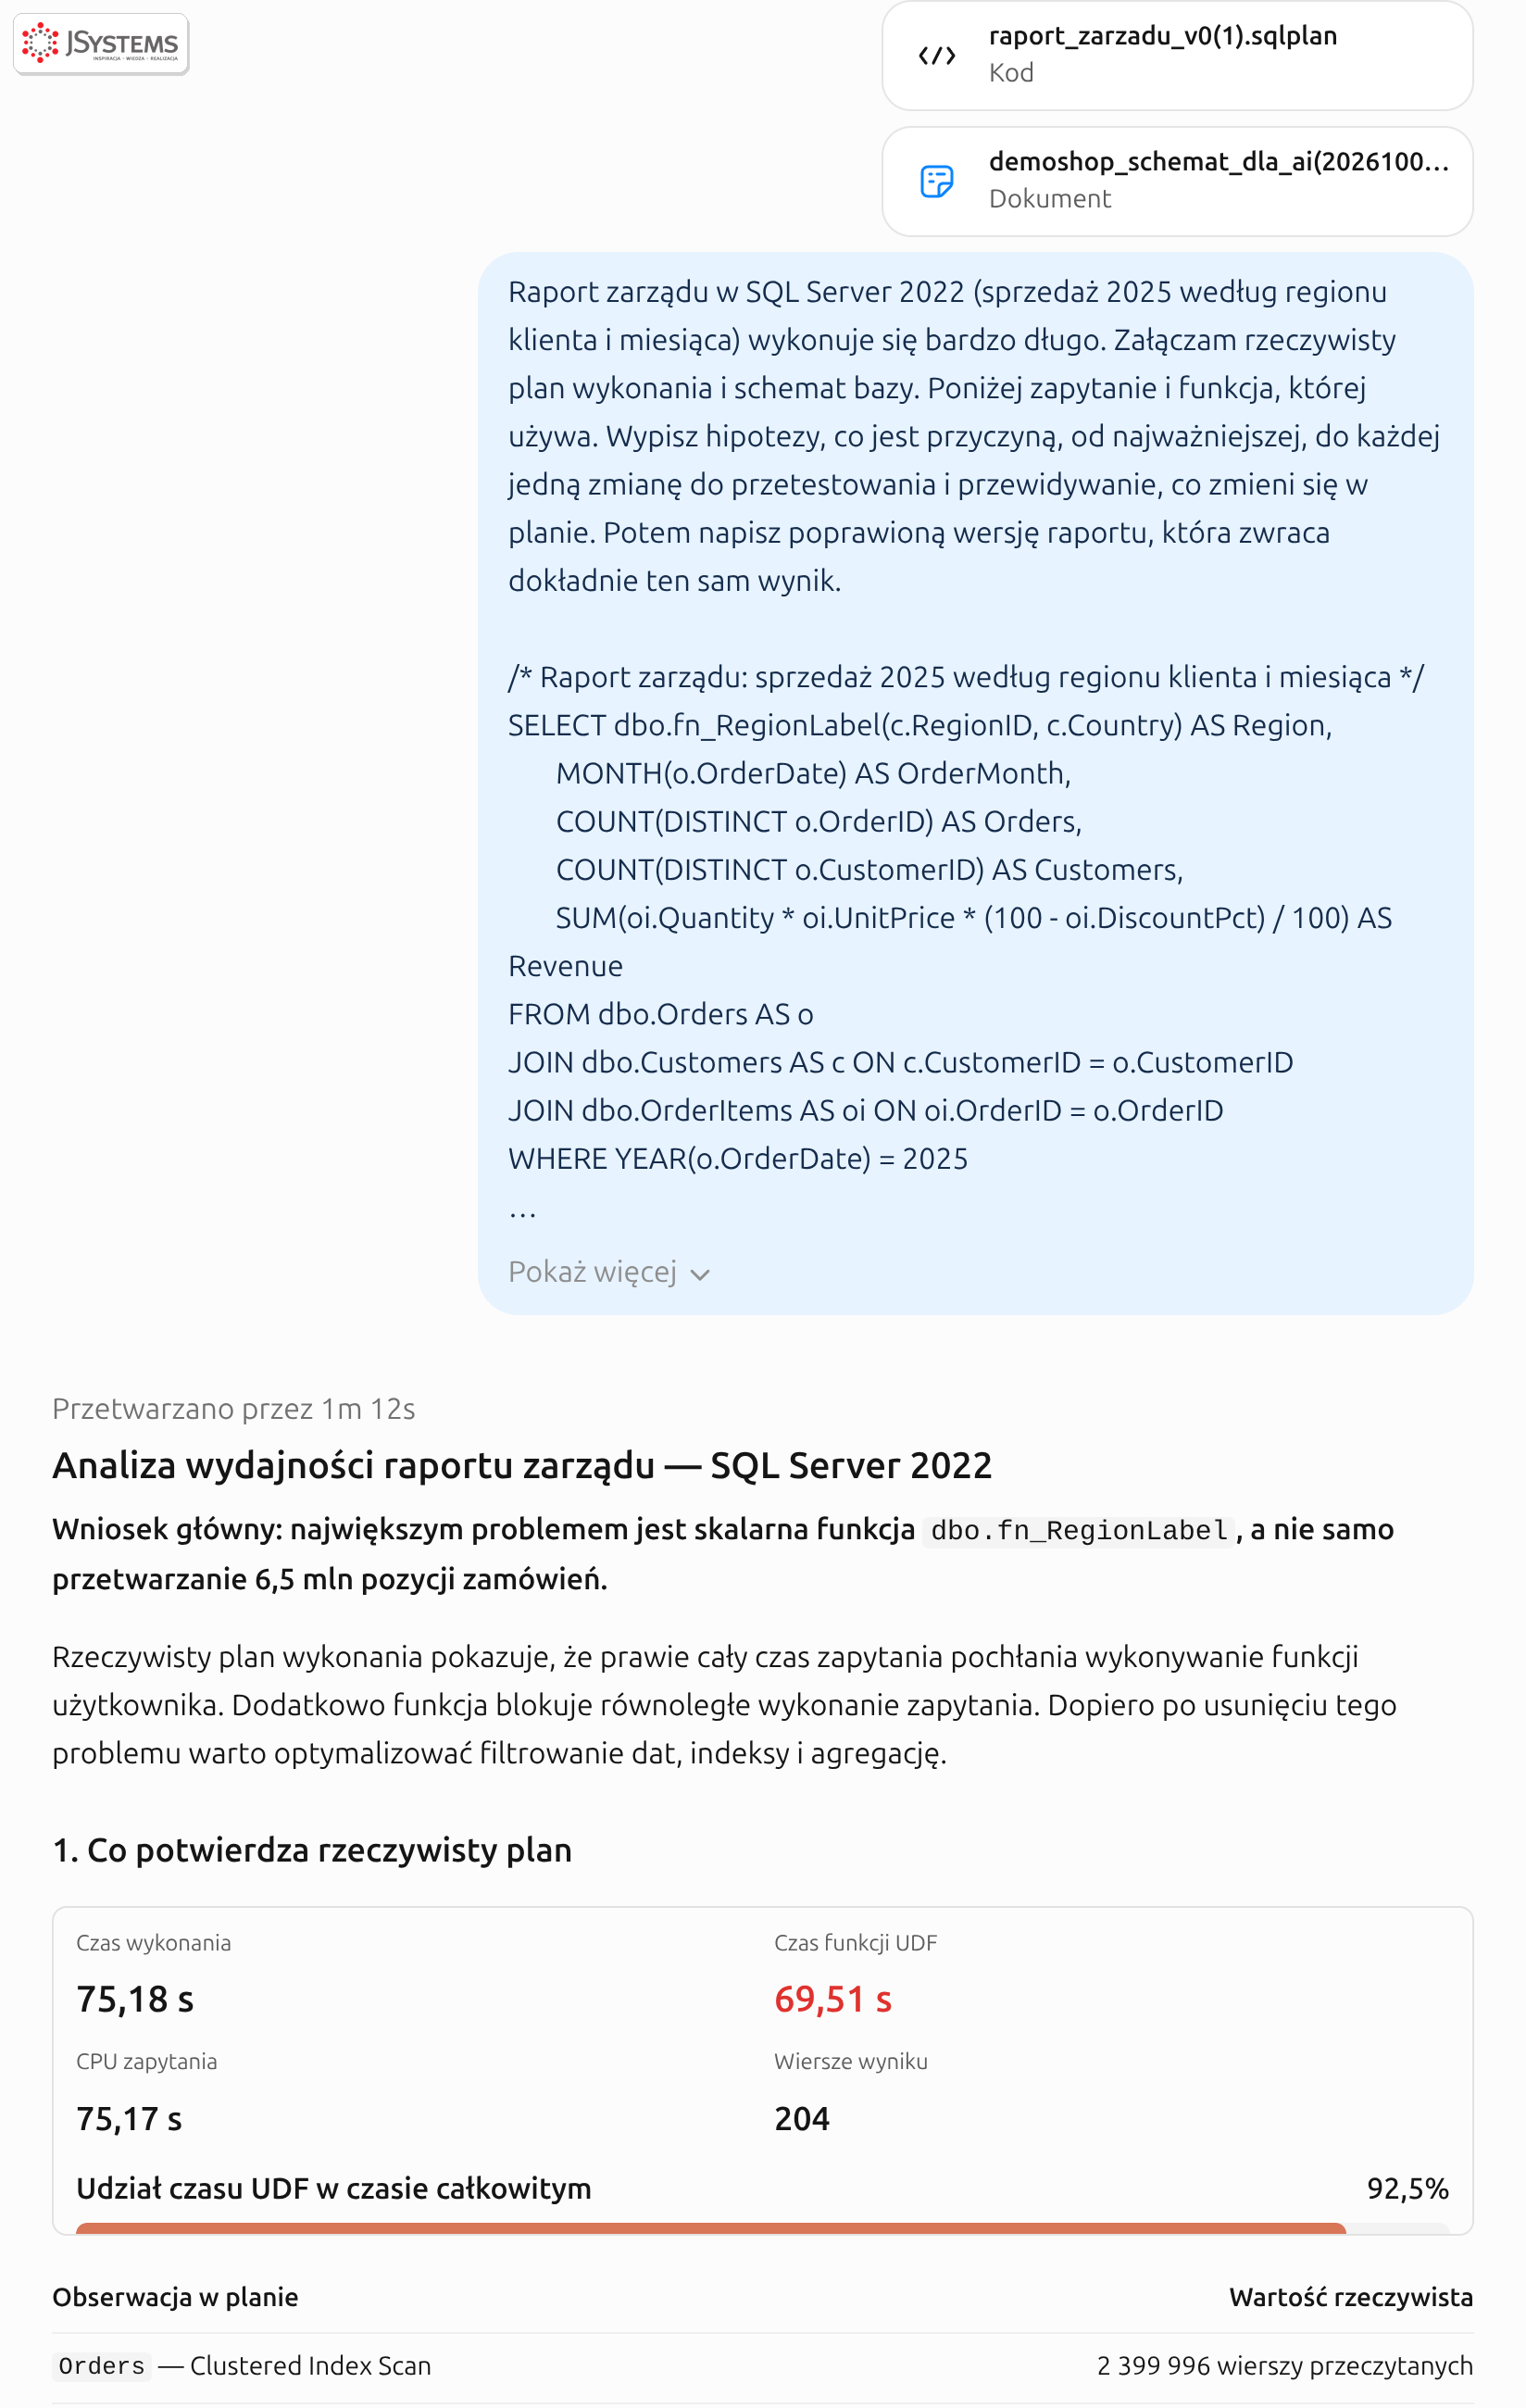
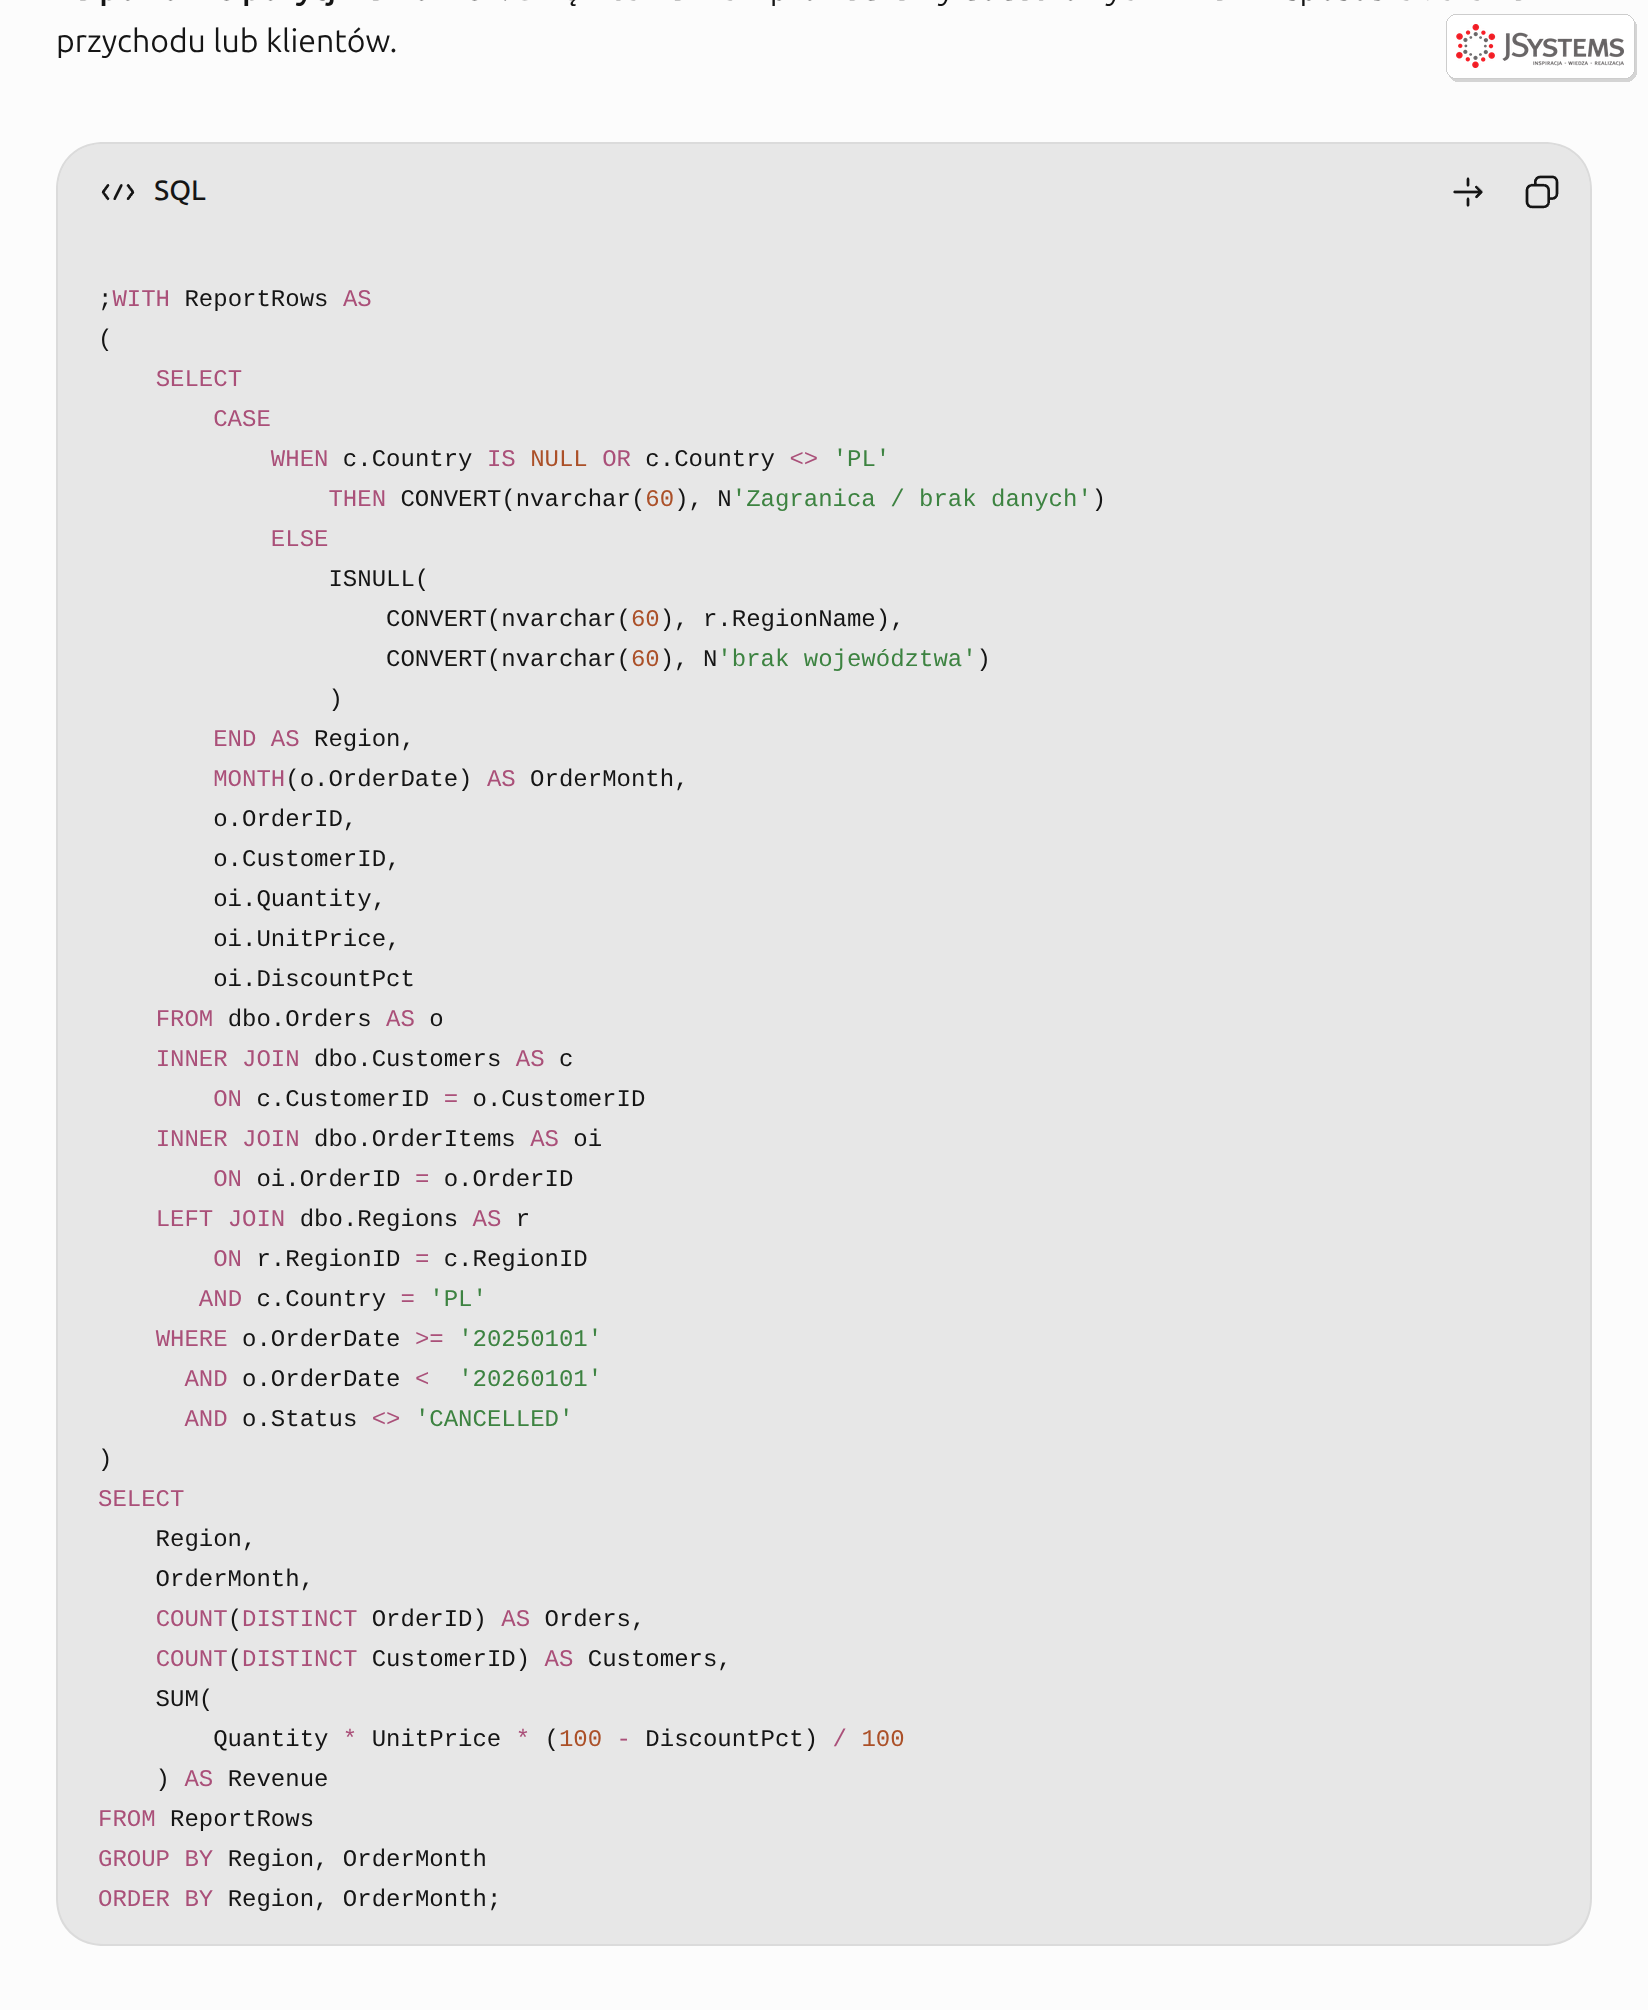
AI znalazło w pliku planu dwie liczby, których nie widać w graficznym planie: czas spędzony w funkcji (UdfElapsedTime) i powód, dla którego plan jest szeregowy (NonParallelPlanReason). Funkcja zabiera 92,5% czasu i blokuje równoległość. Ciekawostka: SQL Server 2019 i nowsze potrafią same wbudować prostą funkcję skalarną w zapytanie (scalar UDF inlining), ale nie zrobiły tego tutaj, bo funkcja jest użyta w GROUP BY. Dalsze hipotezy AI uszeregowało tak, jak w sekcji o optymalizacji: niesargowalny YEAR(), indeks na dacie zamówienia, węższy indeks na pozycjach zamówień, wcześniejsza agregacja i nadmiarowy przydział pamięci, każda z jedną zmianą i przewidywaniem.
WITH ReportRows AS
(
    SELECT
        CASE
            WHEN c.Country IS NULL OR c.Country <> 'PL'
                THEN CONVERT(nvarchar(60), N'Zagranica / brak danych')
            ELSE
                ISNULL(
                    CONVERT(nvarchar(60), r.RegionName),
                    CONVERT(nvarchar(60), N'brak województwa')
                )
        END AS Region,
        MONTH(o.OrderDate) AS OrderMonth,
        o.OrderID,
        o.CustomerID,
        oi.Quantity,
        oi.UnitPrice,
        oi.DiscountPct
    FROM dbo.Orders AS o
    INNER JOIN dbo.Customers AS c
        ON c.CustomerID = o.CustomerID
    INNER JOIN dbo.OrderItems AS oi
        ON oi.OrderID = o.OrderID
    LEFT JOIN dbo.Regions AS r
        ON r.RegionID = c.RegionID
       AND c.Country = 'PL'
    WHERE o.OrderDate >= '20250101'
      AND o.OrderDate <  '20260101'
      AND o.Status <> 'CANCELLED'
)
SELECT
    Region,
    OrderMonth,
    COUNT(DISTINCT OrderID) AS Orders,
    COUNT(DISTINCT CustomerID) AS Customers,
    SUM(
        Quantity * UnitPrice * (100 - DiscountPct) / 100
    ) AS Revenue
FROM ReportRows
GROUP BY Region, OrderMonth
ORDER BY Region, OrderMonth;AI samo zaznaczyło, że nie może potwierdzić identyczności wyniku bez bazy. Robimy to tak jak w sekcji o refaktoryzacji: oba raporty zapisujemy do tabel tymczasowych i porównujemy przez EXCEPT w obie strony oraz przez liczbę wierszy i sumę przychodu:
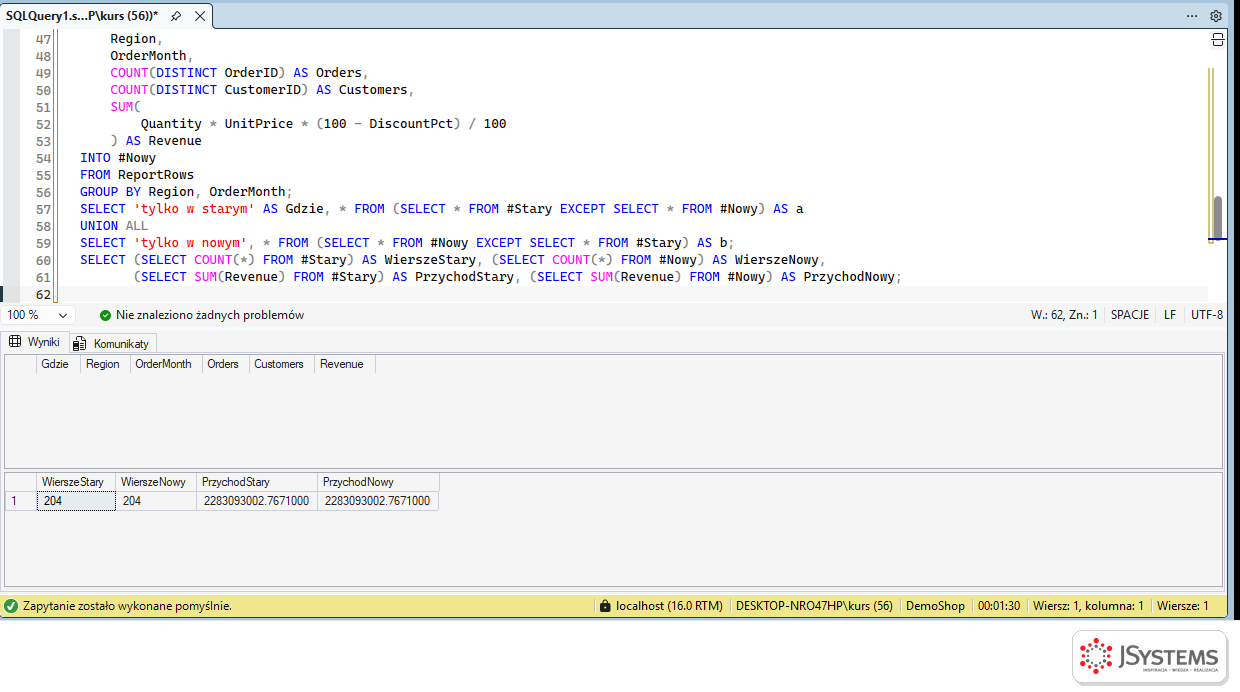
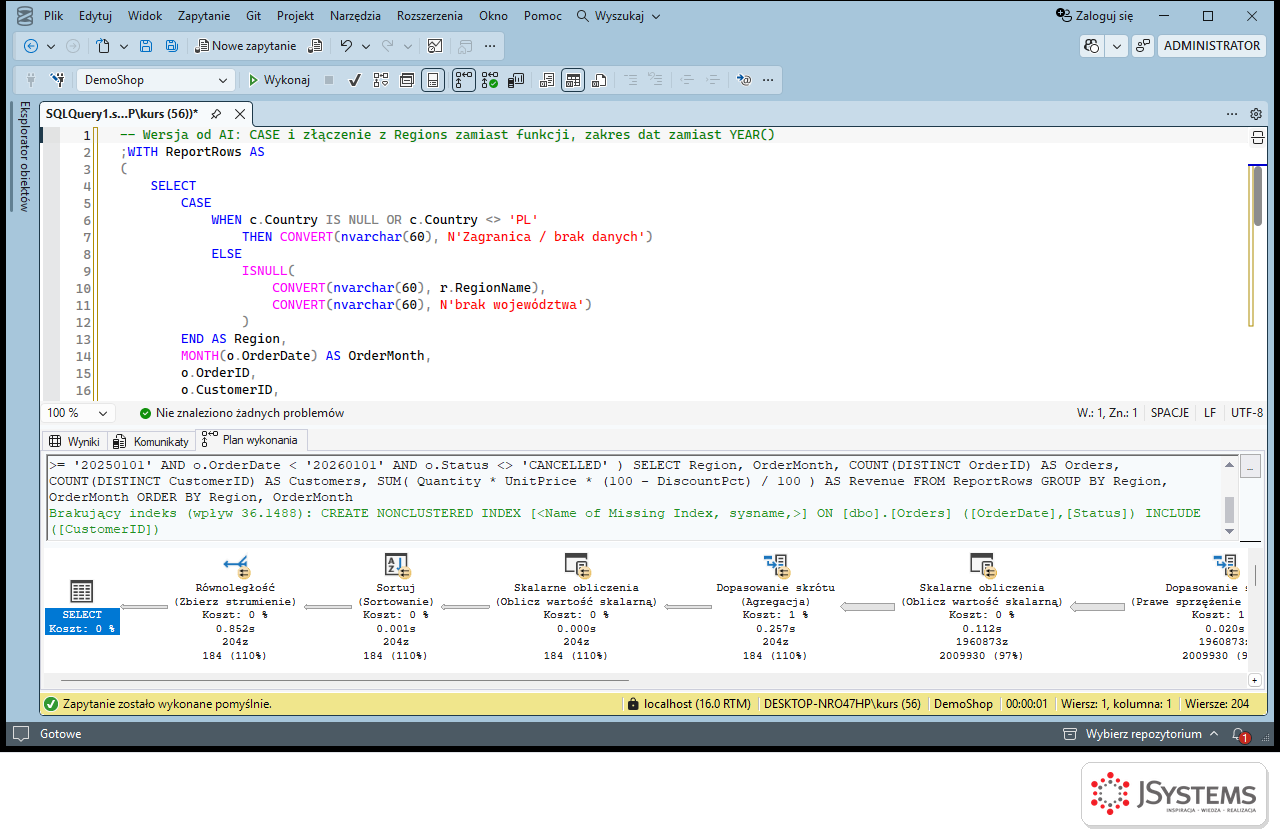
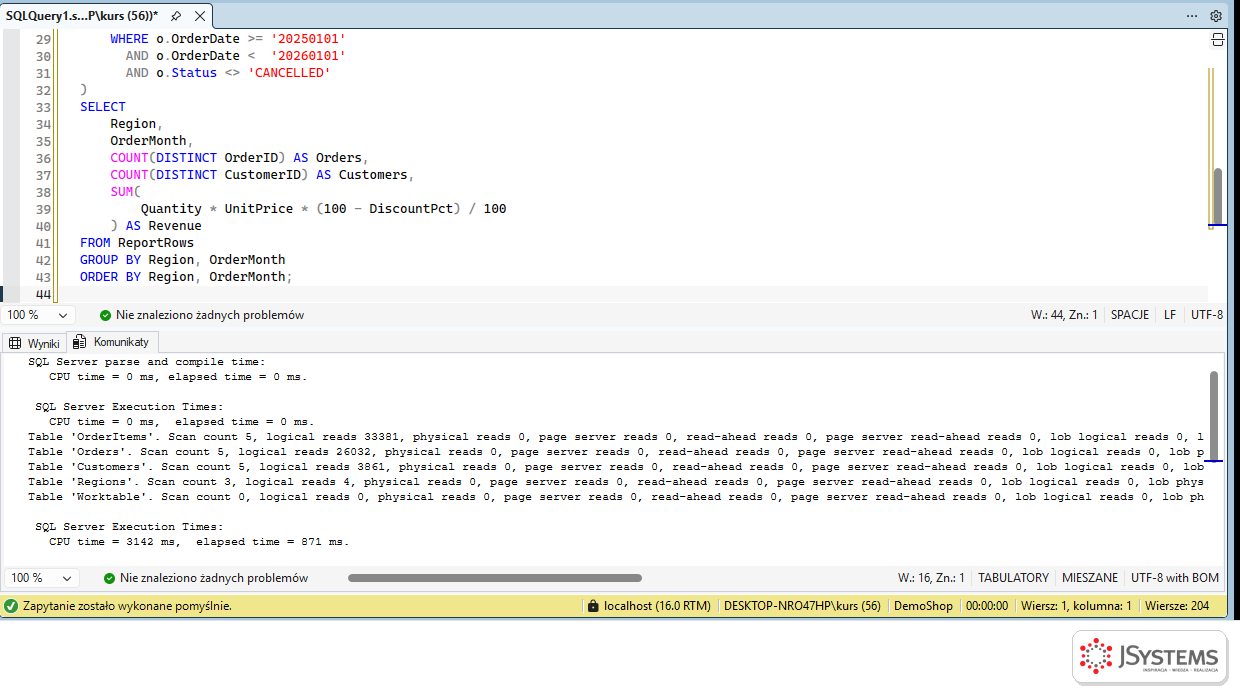
| Wersja | Czas całkowity (mediana z 3) | Czas procesora | Odczyty logiczne | Wątki | Wynik |
|---|---|---|---|---|---|
| Stary raport z funkcją skalarną | 74,5 s | 74,5 s | 62 652 | 1 | 204 wiersze |
| Wersja od AI (CASE, LEFT JOIN, zakres dat) | 0,82 s | 3,08 s | 63 259 | 4 | 204 wiersze, identyczne |
| Wersja od AI i dwa indeksy zaproponowane przez AI | 1,14 s | 3,09 s | 34 603 | 4 | 204 wiersze, identyczne |
Raport liczy się 91 razy szybciej, a czas procesora spadł 24 razy. Ostatni wiersz tabeli pokazuje, po co jest pomiar. AI zaproponowało jako kolejny krok dwa indeksy pokrywające. Zmierzyliśmy je: odczyty spadły prawie o połowę, ale czas całkowity wzrósł z 0,82 do 1,14 s, a indeksy kosztowałyby przy każdym zapisie zamówień i pozycji. Nie wdrażamy ich. Bez pomiaru ta zmiana wyglądałaby na oczywistą poprawę.
EXCEPT w obie strony, liczba wierszy, sumy kontrolne); zmierz ponownie i odrzuć zmiany, które nie poprawiają tego, co miały poprawić. Wszystkie wersje raportu, funkcję i skrypty pomiaru znajdziesz w pliku optymalizacja_raportu.sql.Część 4 z 8 przewodnika AI w SQL


Komentarze (0)
Brak komentarzy...