
Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
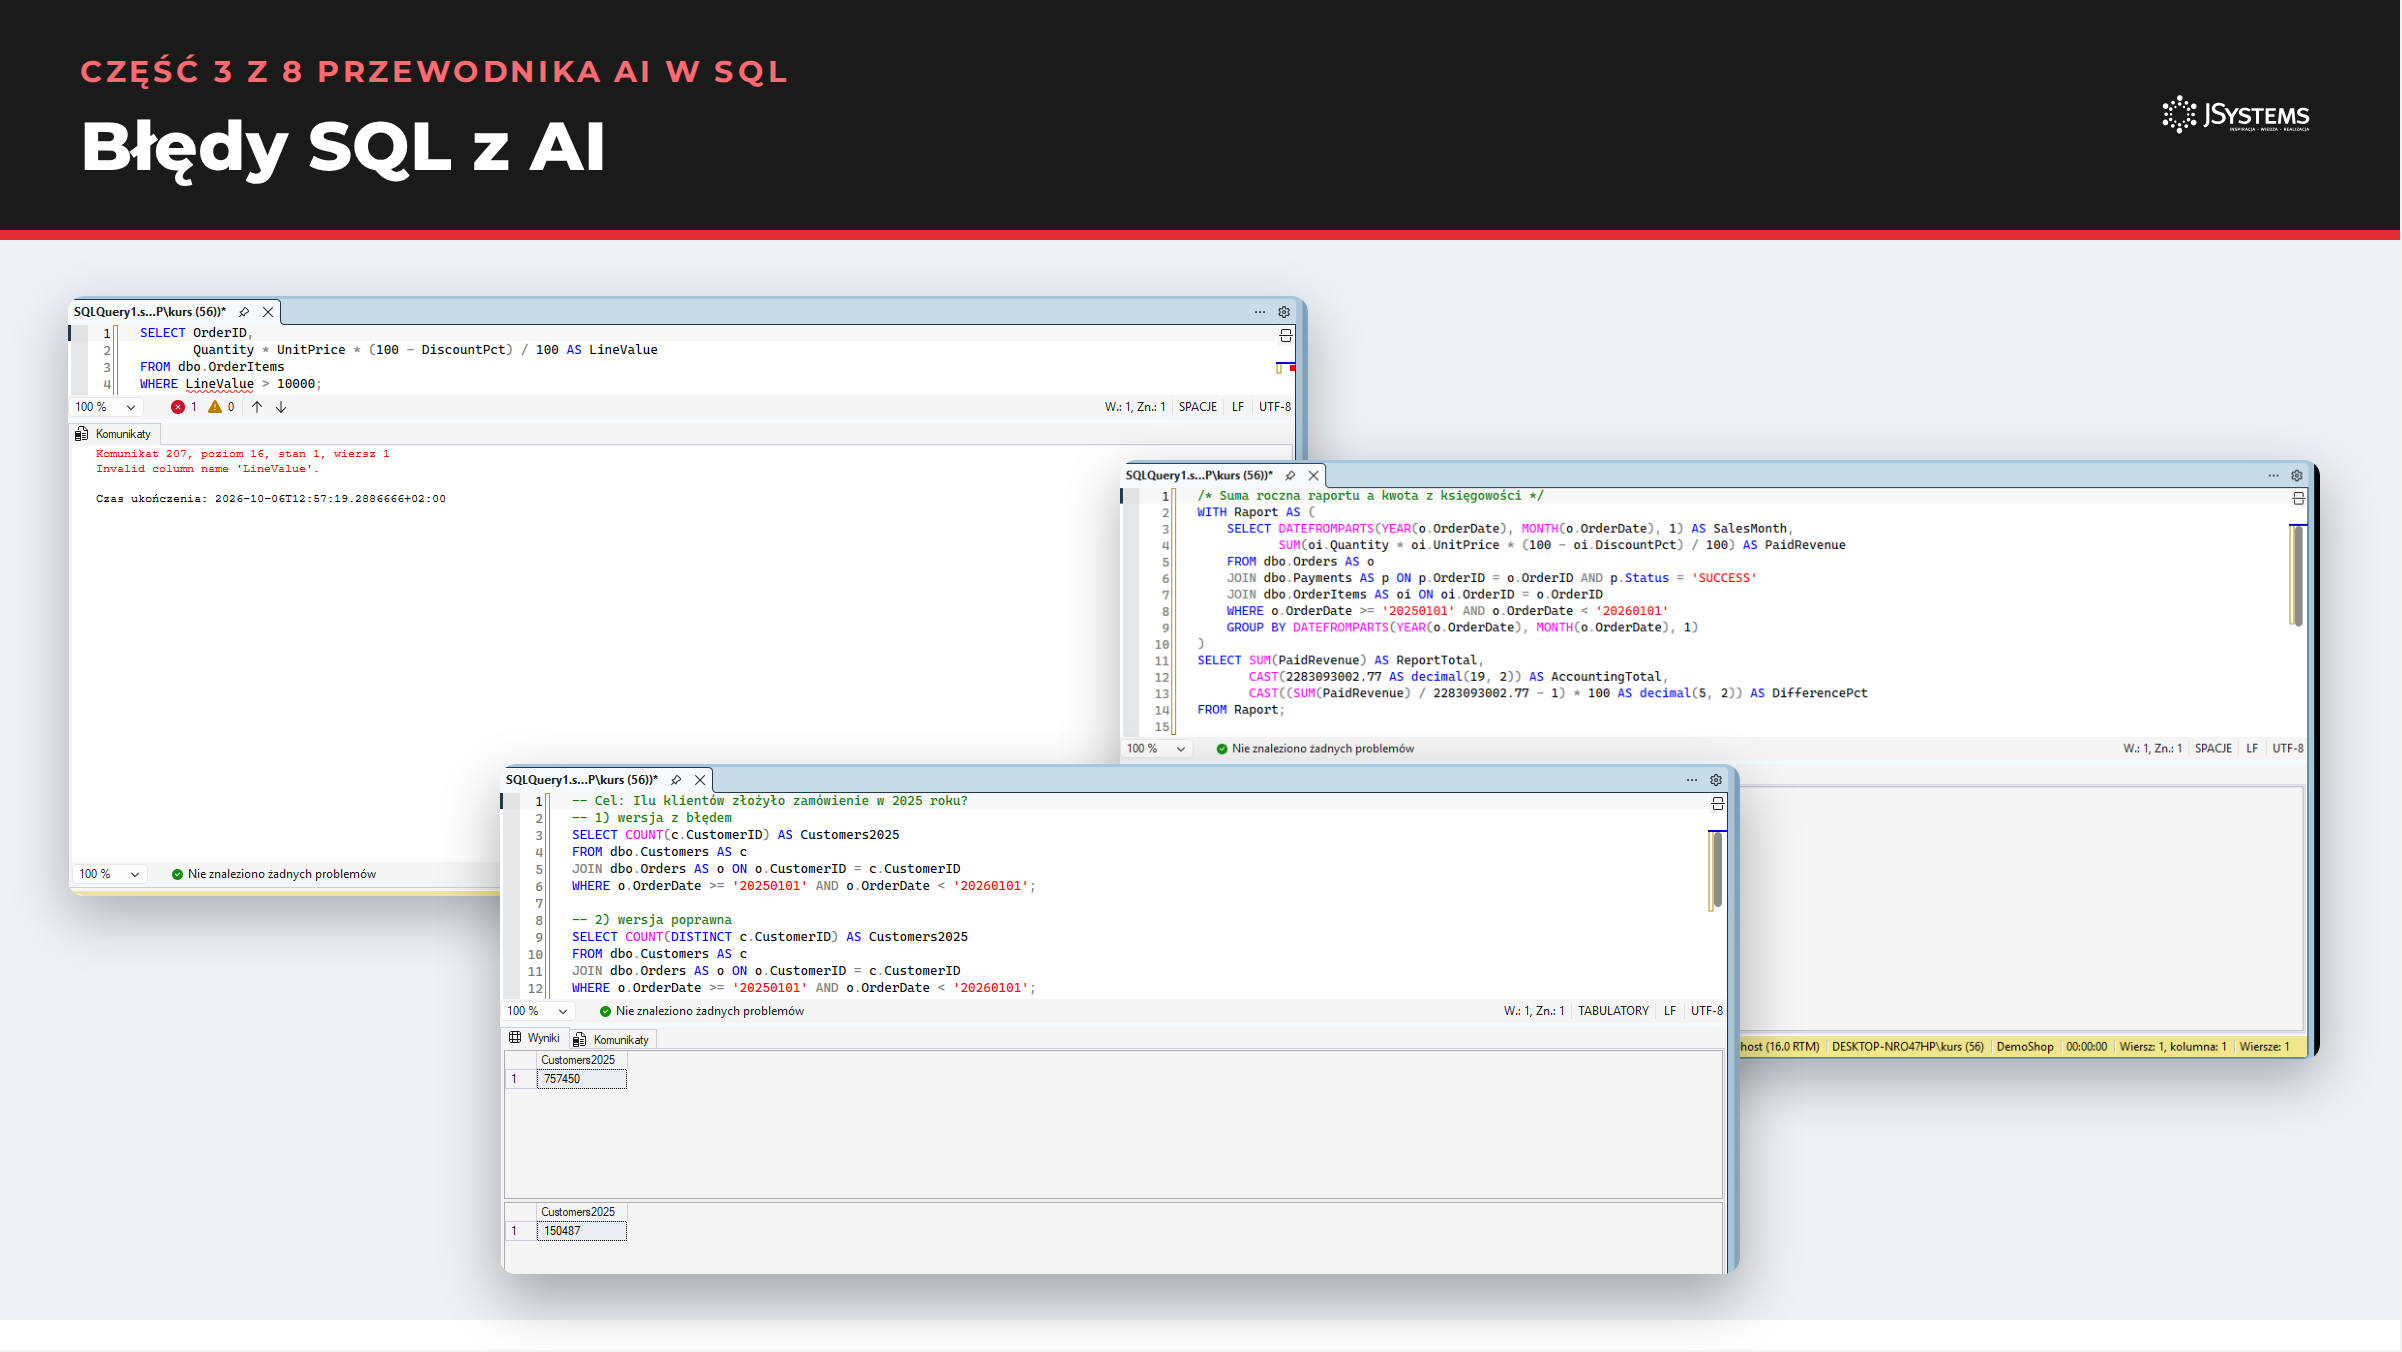
W skrócieBłąd składniowy AI znajduje z komunikatu serwera, a błąd logiczny dopiero wtedy, gdy dostaje cel zapytania i liczbę odniesienia. Pokazujemy osiem błędów składni, studium raportu, który zawyżał przychód o 15,6%, i 20 typowych błędów logicznych z wynikami przed poprawką i po niej.
To część 3 z 8 przewodnika AI w SQL. Wszystkie przykłady powstały na bazie DemoShop w SQL Server 2022: fikcyjnym sklepie internetowym z 2,4 mln zamówień. Polecenia wpisujemy do ChatGPT, ale te same możesz podać Microsoft Copilotowi, Claude albo Gemini. Przy skryptach korzystających z mechanizmów serwera w małej szarej ramce znajdziesz ich odpowiedniki dla Oracle i PostgreSQL.
Z tej części dowiesz się:
Pliki do tej części
Skrypt bazy uruchamiasz w SSMS na serwerze SQL Server 2019 lub nowszym. Tworzy bazę DemoShop, na której powstały wszystkie przykłady.
Błąd składniowy to sytuacja, w której serwer w ogóle nie rozumie zapytania albo nie może go wykonać, więc kończy je komunikatem. To najłatwiejsza kategoria błędów, bo serwer sam wskazuje problem. Kłopot w tym, że komunikat bywa lakoniczny, po angielsku i wskazuje miejsce, w którym parser się poddał, a nie miejsce, w którym naprawdę jest błąd. AI świetnie tłumaczy takie komunikaty, pod warunkiem że dostanie trzy rzeczy: dialekt i wersję, dokładną treść komunikatu z numerem błędu i całe zapytanie.
SQL Server 2022 zwraca błąd [numer]: [treść komunikatu skopiowana z zakładki Komunikaty].
Co jest nie tak i jak to poprawić?
[całe zapytanie]
Przygotowaliśmy osiem zapytań z najczęstszymi błędami, uruchomiliśmy je w SSMS i każdy komunikat w dokładnie takiej postaci przekazaliśmy ChatGPT. Poniżej wszystkie osiem przypadków: najpierw to, co pokazał serwer, potem odpowiedź AI.
| Nr | Błąd | Komunikat SQL Server | Przyczyna |
|---|---|---|---|
| 1 | Brak przecinka | brak, zapytanie działa | druga kolumna stała się aliasem pierwszej |
| 2 | Niedomknięty nawias | 156: Incorrect syntax near the keyword 'GROUP' | parser dotarł do GROUP BY z otwartym nawiasem |
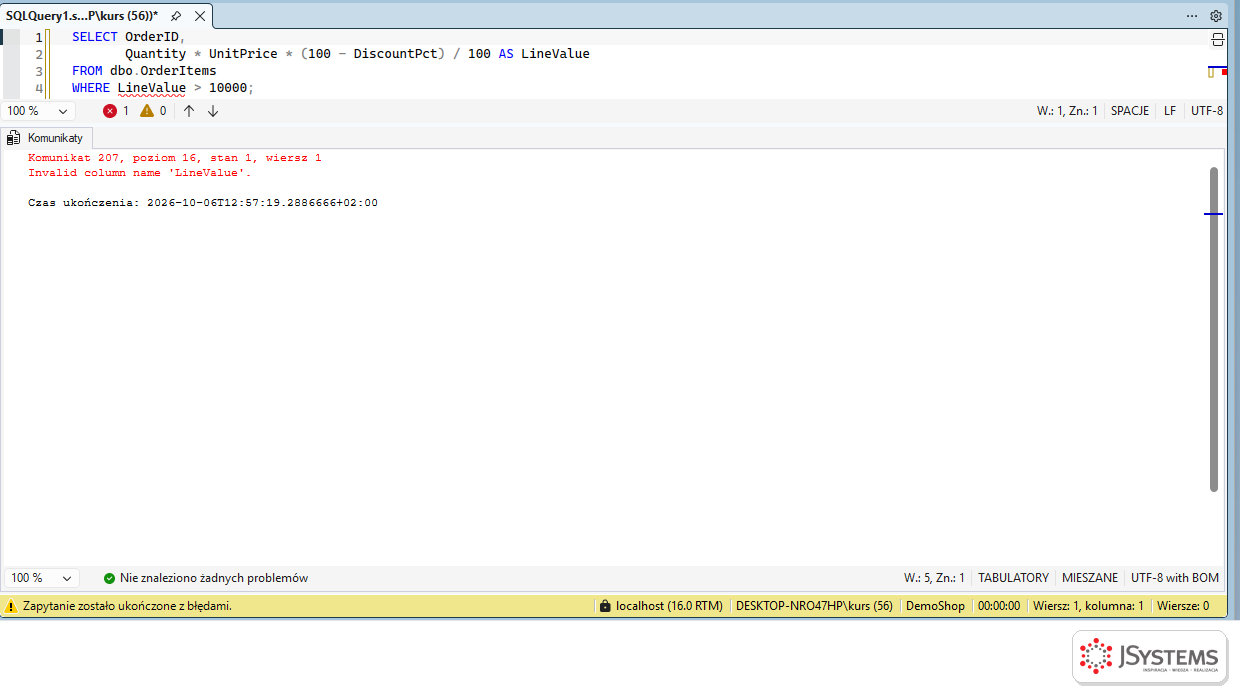
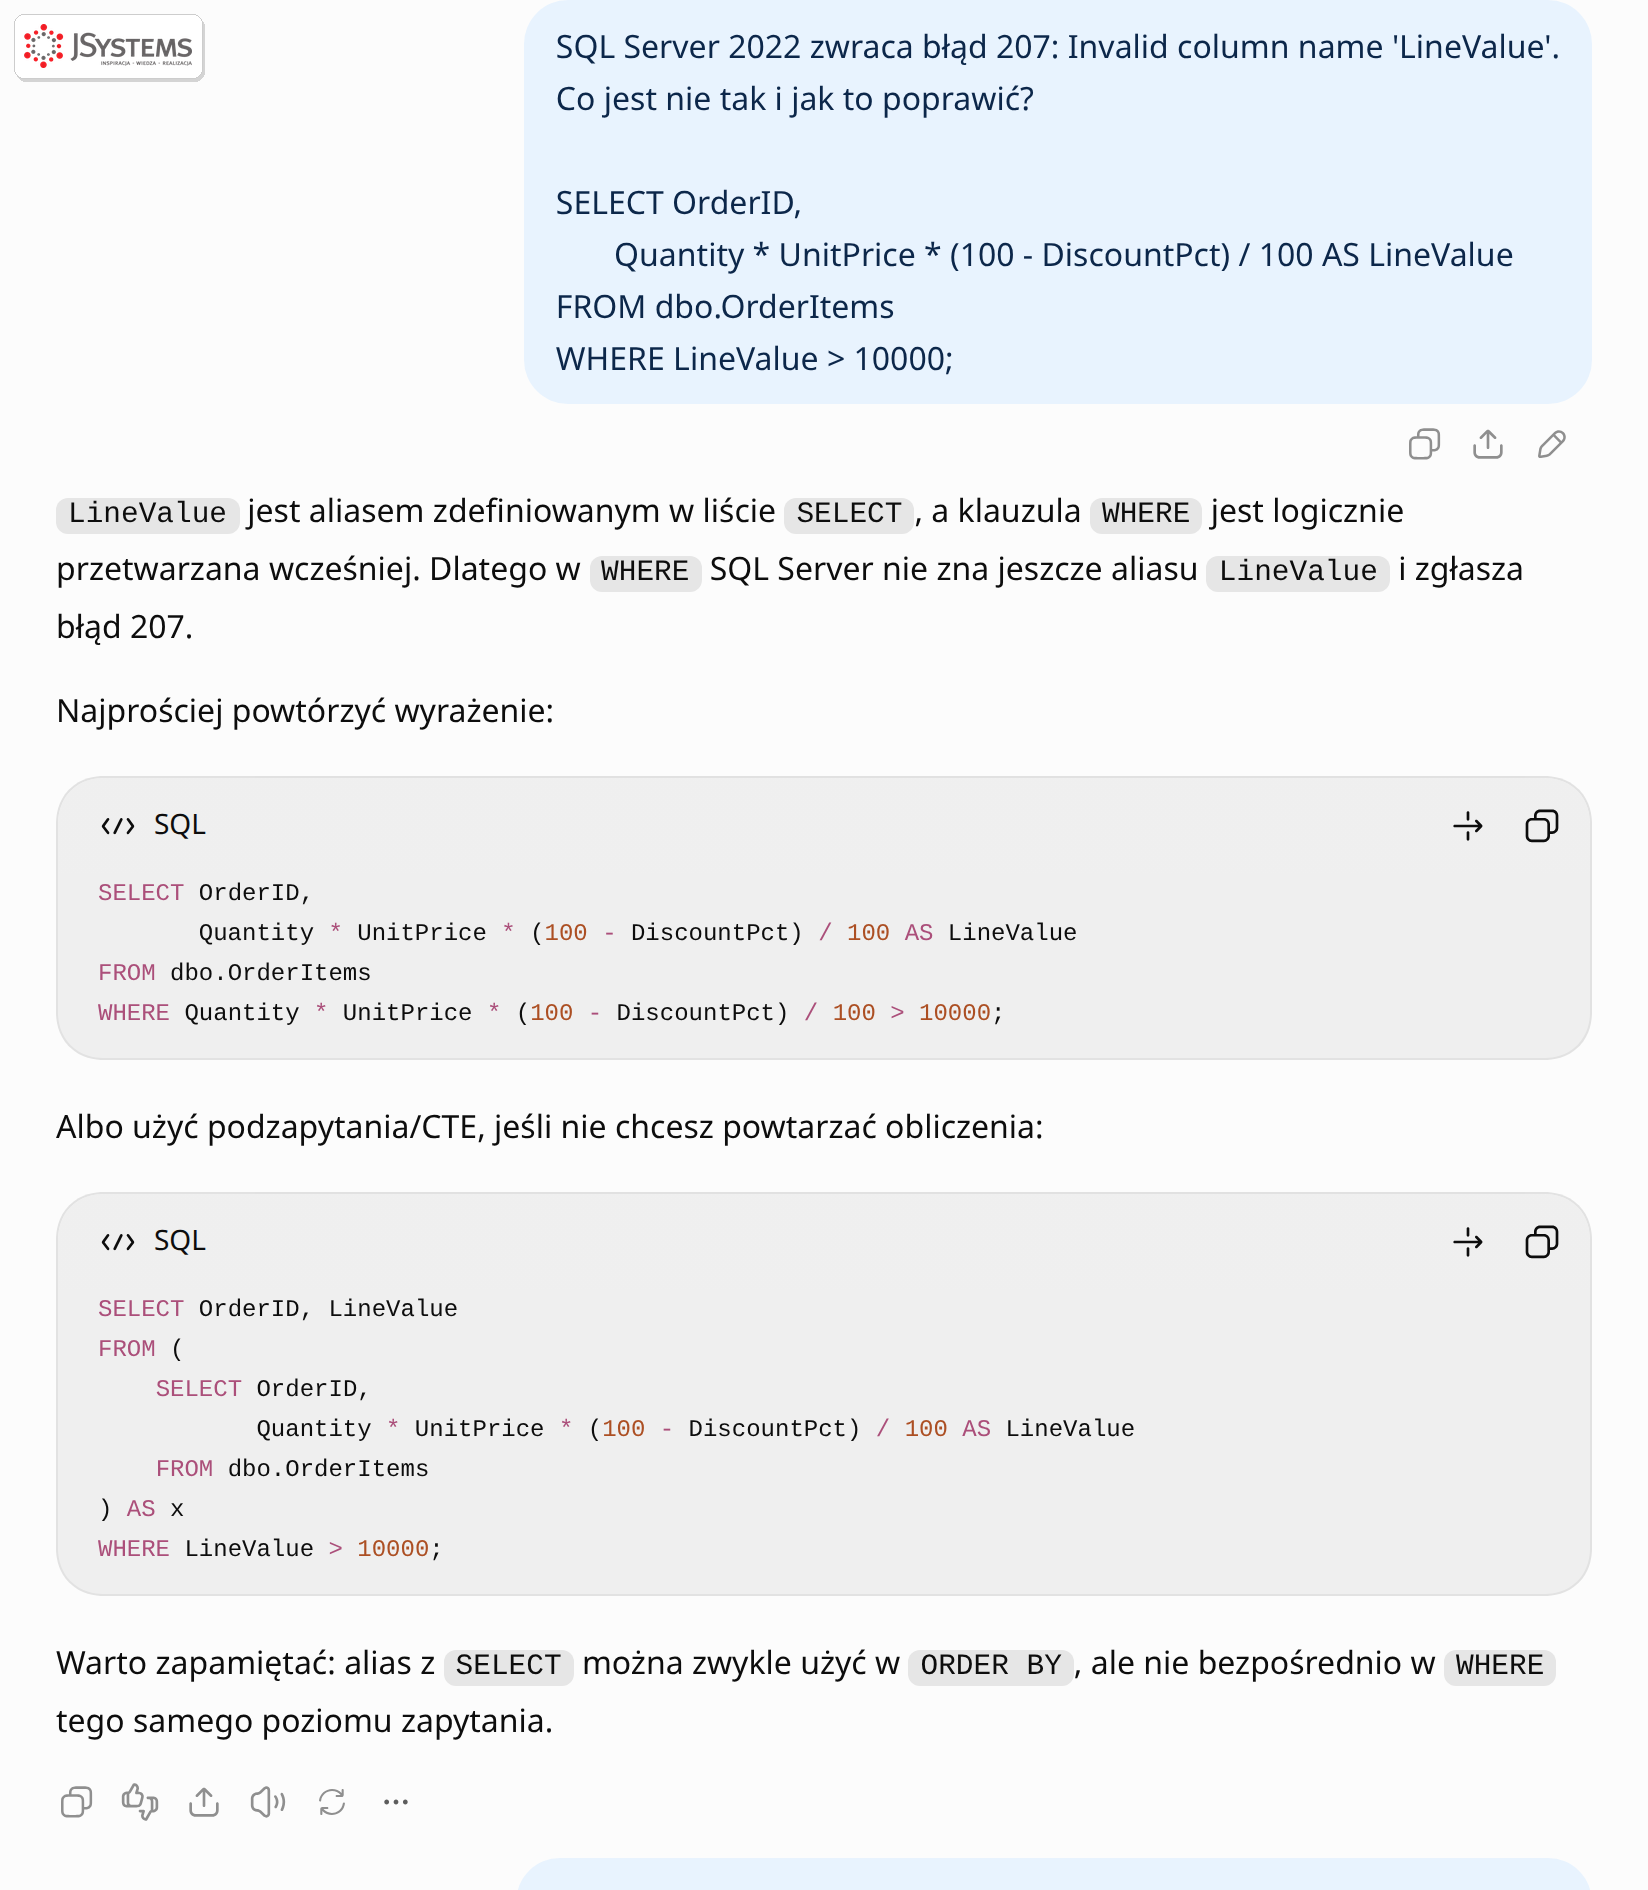
| 3 | Alias w WHERE | 207: Invalid column name 'LineValue' | WHERE działa przed SELECT, alias jeszcze nie istnieje |
| 4 | Nieistniejąca kolumna | 207: Invalid column name 'TotalAmount' | kolumny nie ma w tabeli, wartość trzeba policzyć |
| 5 | Funkcja z innego dialektu | 195: 'DATE_TRUNC' is not a recognized built-in function name | DATE_TRUNC jest w PostgreSQL, w SQL Server 2022 jest DATETRUNC |
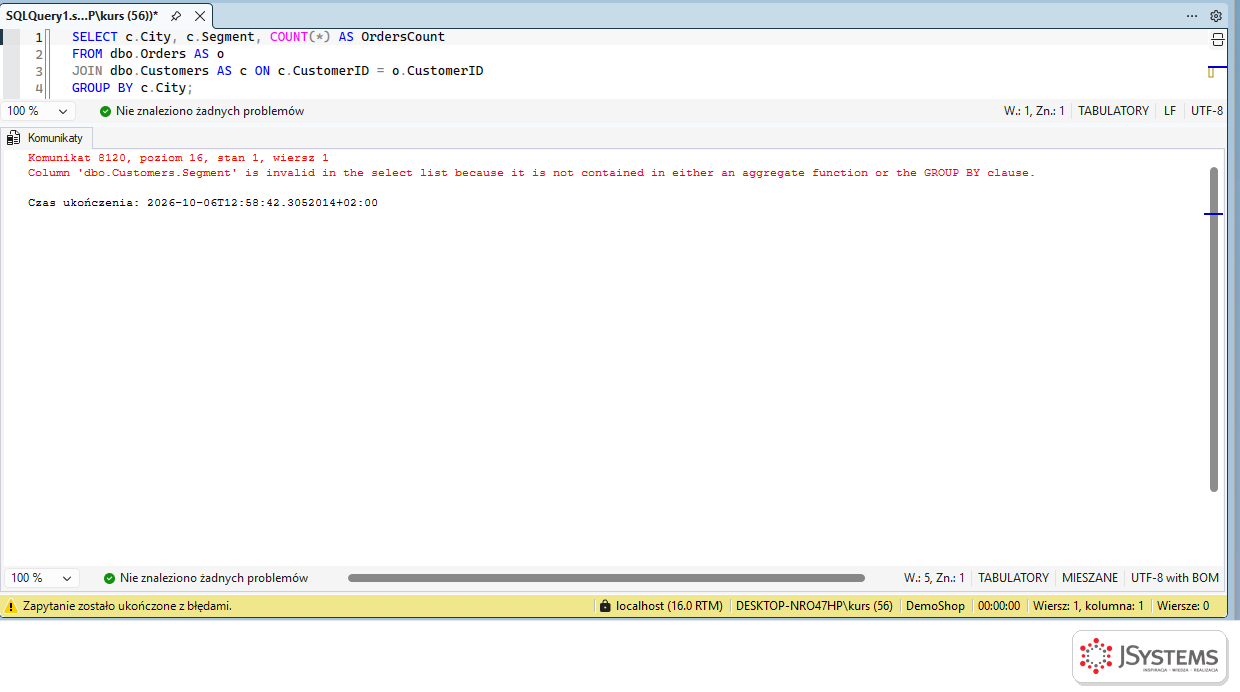
| 6 | GROUP BY | 8120: Column 'dbo.Customers.Segment' is invalid in the select list... | kolumna w SELECT bez agregacji i bez GROUP BY |
| 7 | Konwersja typów | 245: Conversion failed when converting the varchar value 'B2B-000001' to data type int | porównanie tekstu z liczbą |
| 8 | Składnia innego dialektu | 102: Incorrect syntax near 'LIMIT' | LIMIT nie istnieje w T-SQL |
SELECT TOP (5) CustomerID, FirstName LastName, City
FROM dbo.Customers
ORDER BY CustomerID;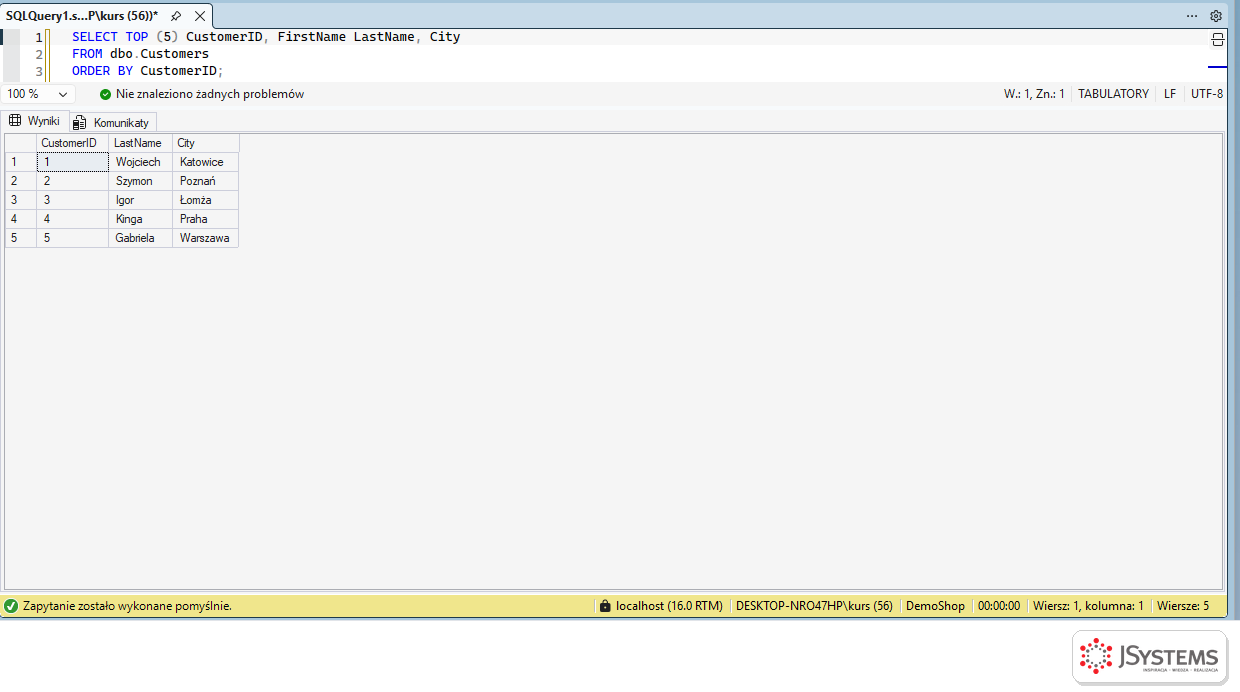
Najgroźniejszy błąd na tej liście, bo nie ma komunikatu. W T-SQL słowo AS przed aliasem jest opcjonalne, więc FirstName LastName znaczy „kolumna FirstName nazwana LastName”. Tu łatwo to zauważyć, ale w zapytaniu z trzydziestoma kolumnami jedna zgubiona kolumna przejdzie niezauważona. Opisujemy objaw, a nie komunikat:
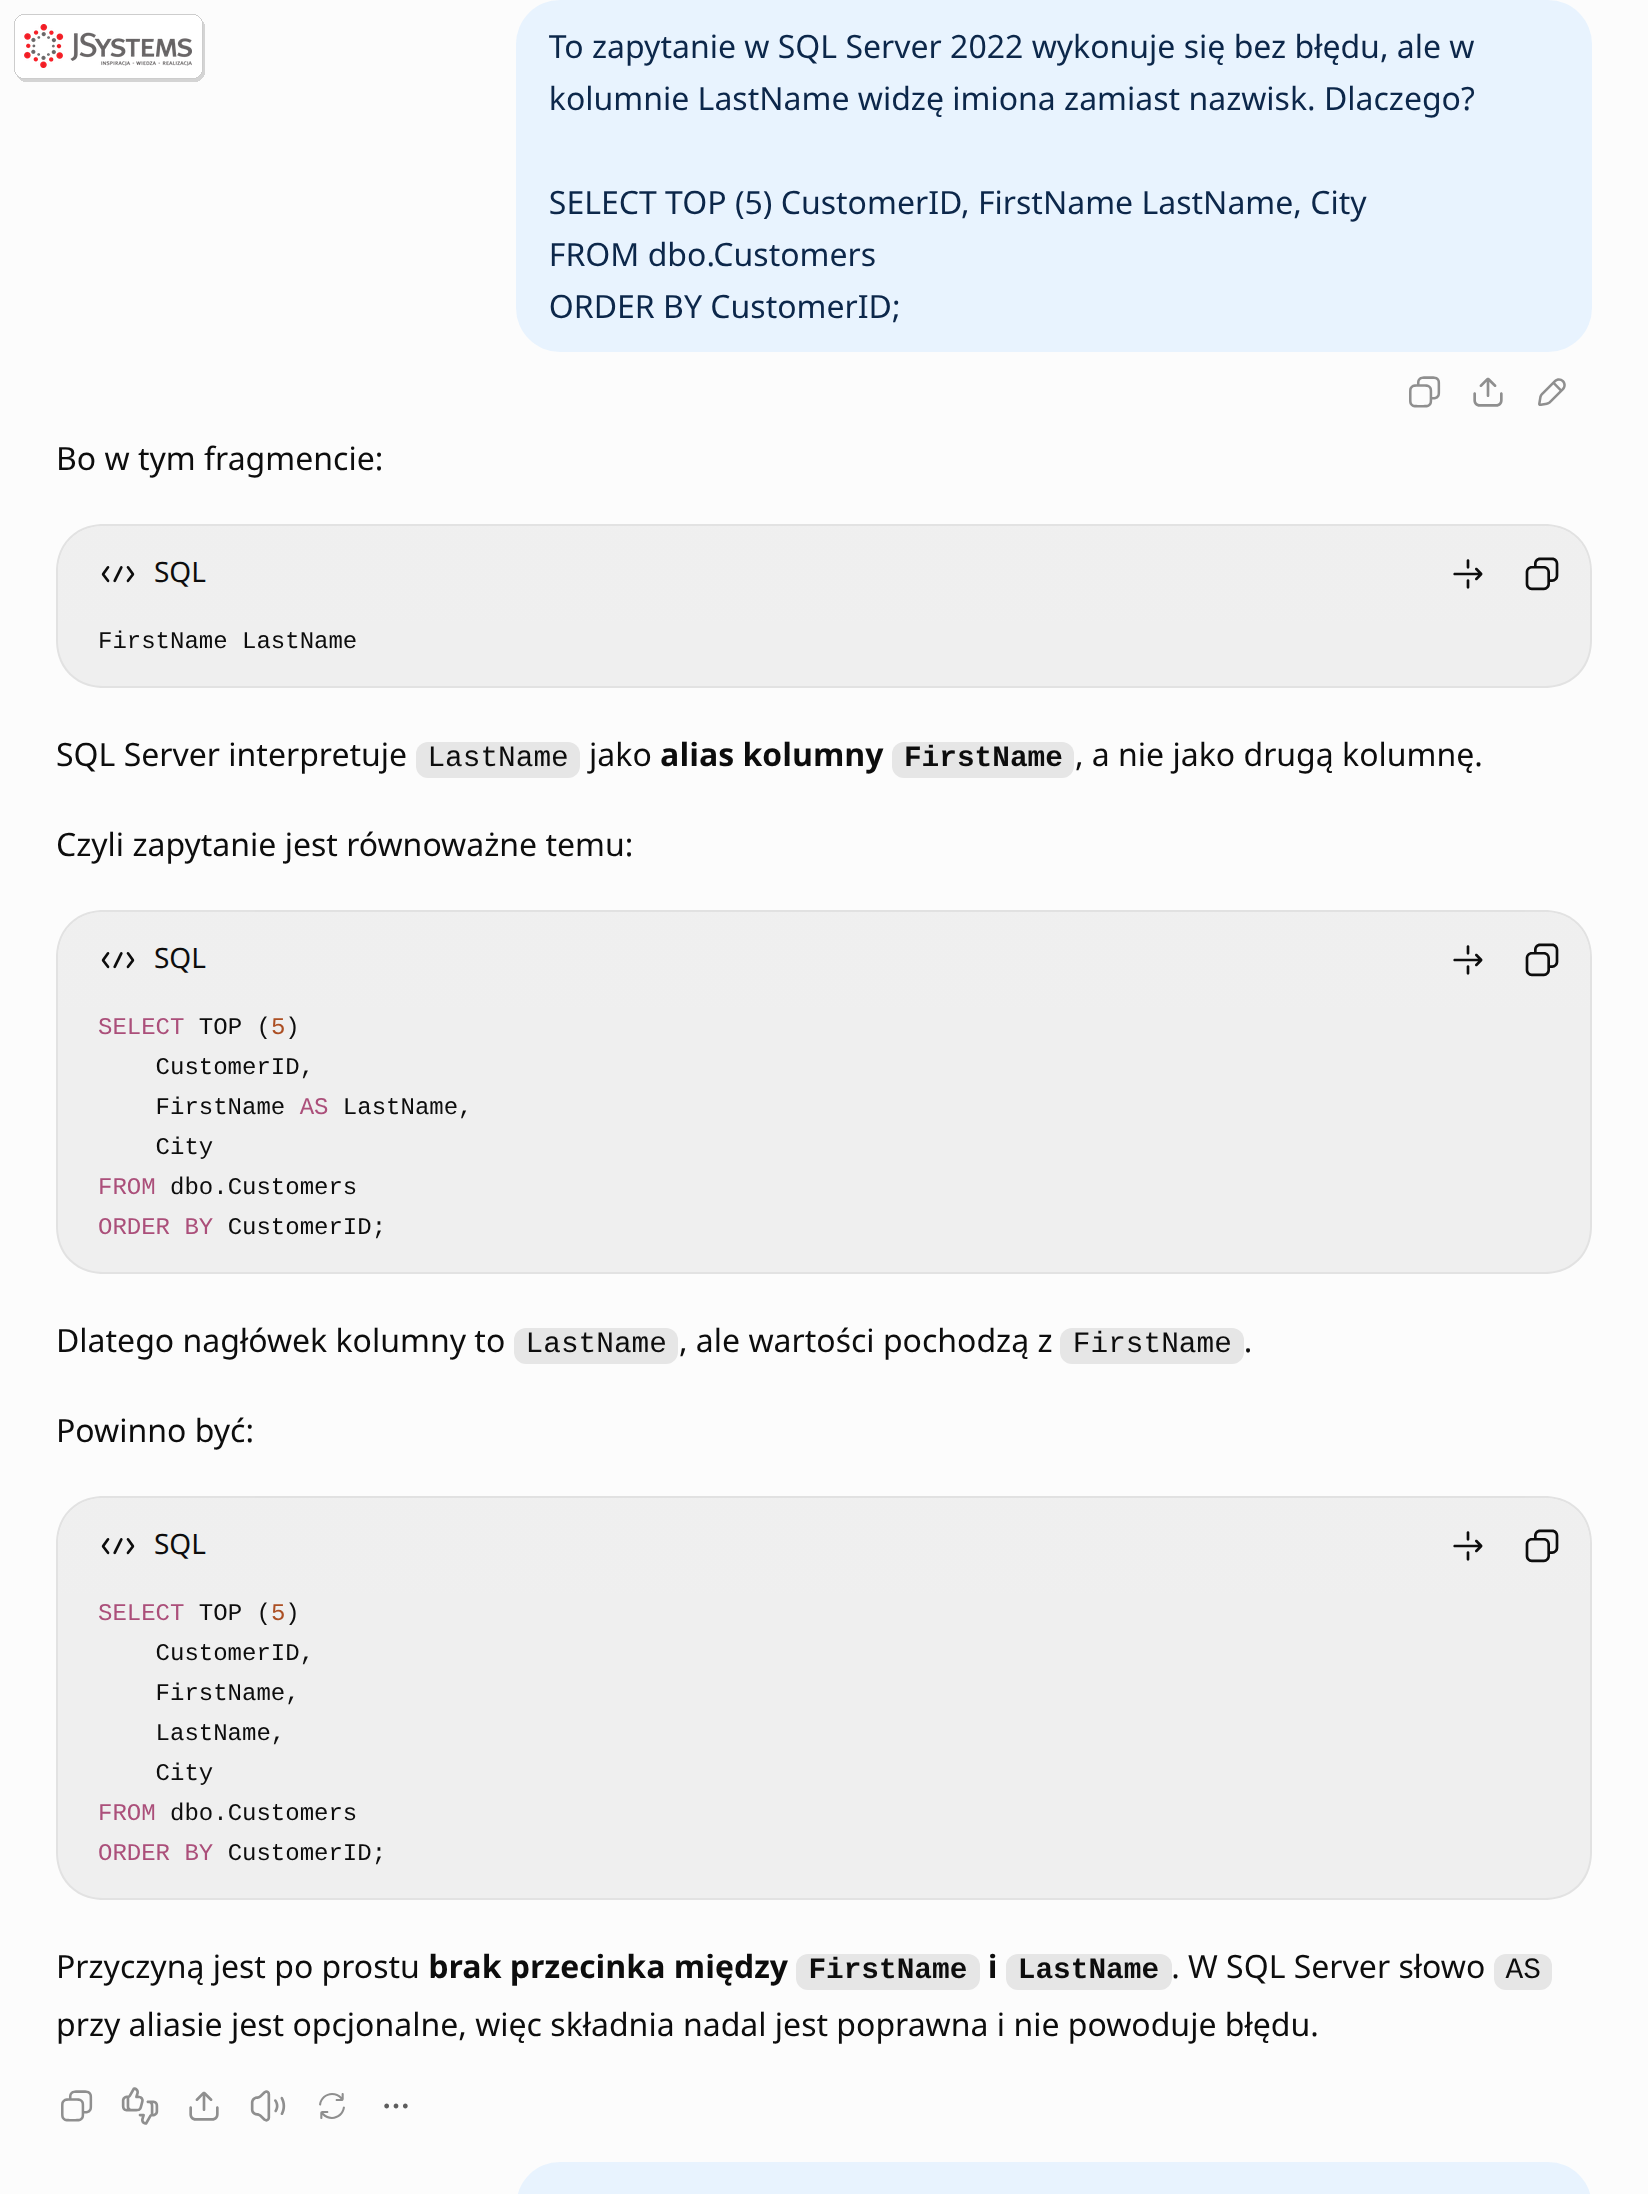
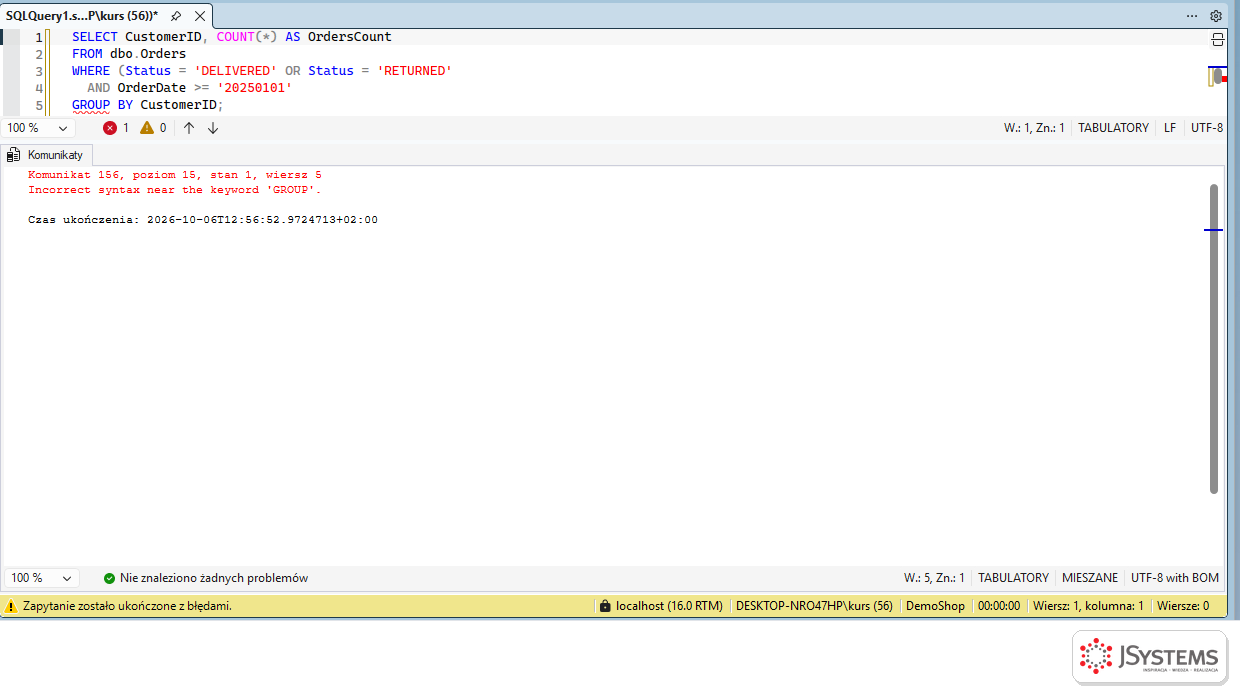
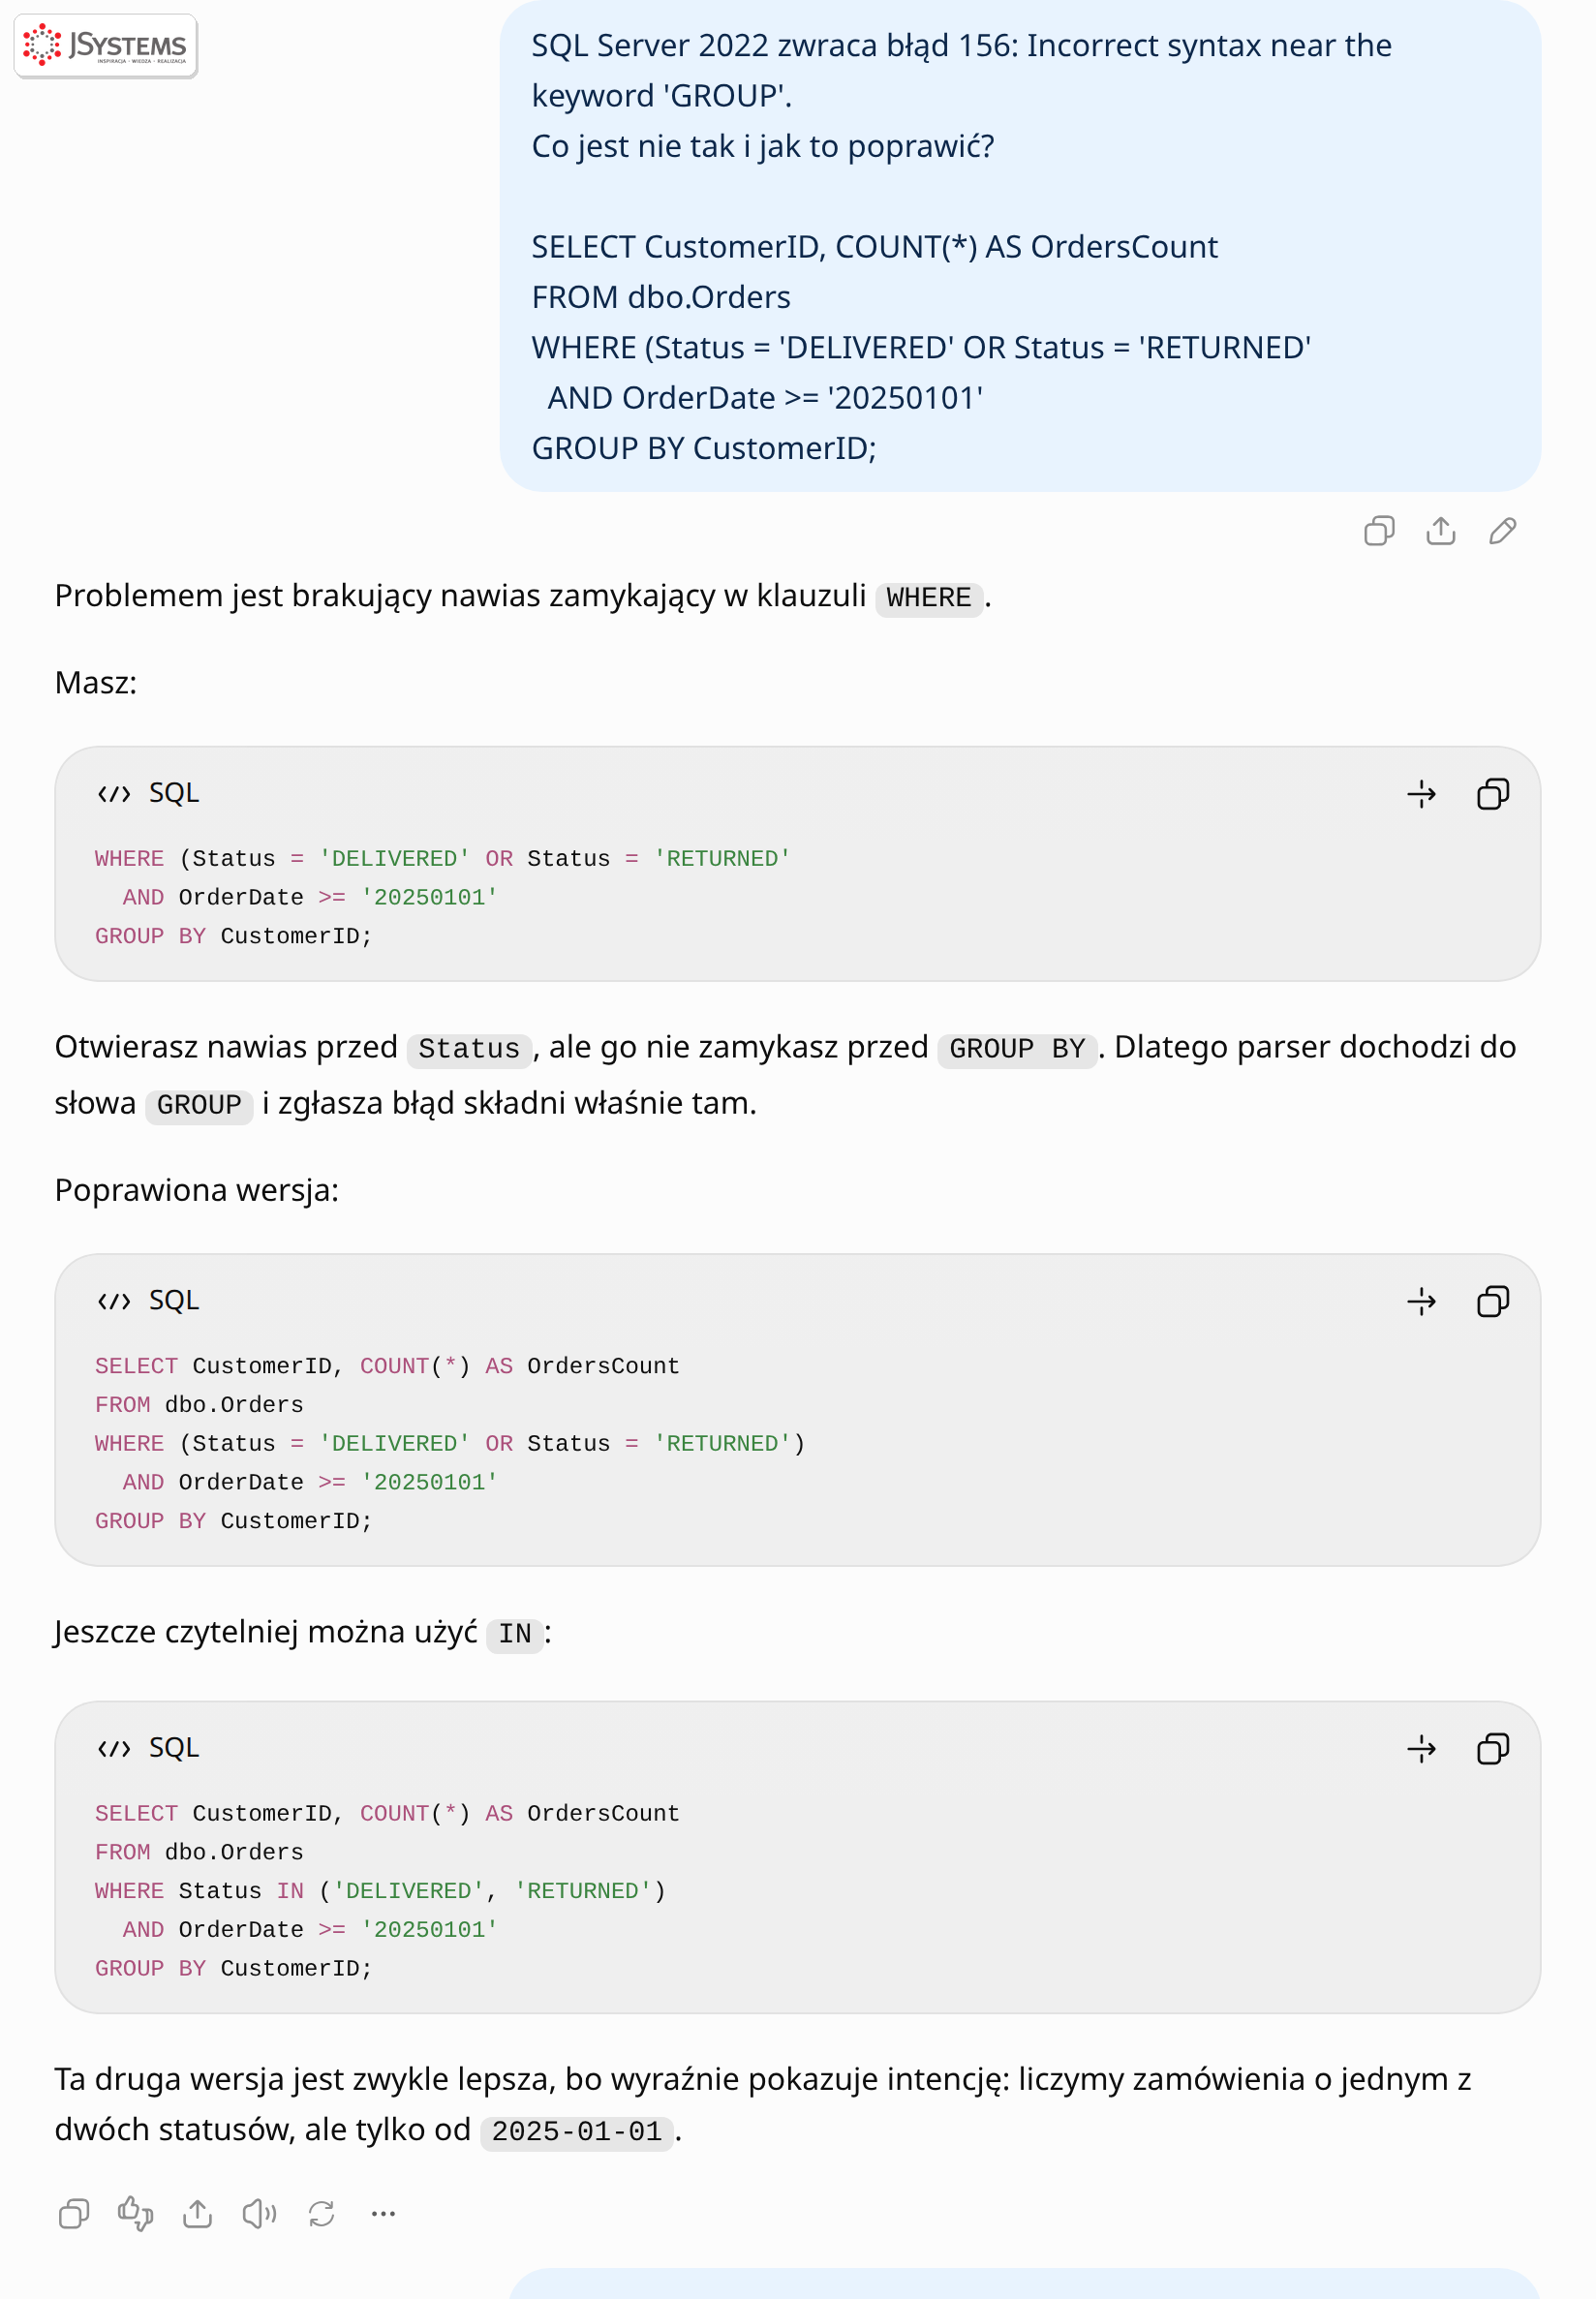
Miejsce zamknięcia nawiasu zmienia znaczenie zapytania. Operator AND wiąże silniej niż OR, więc nawias zamknięty na końcu całego warunku dałby „wszystkie zamówienia doręczone z dowolnego roku plus zwrócone z 2025”. AI wybrało wersję zgodną z sensem („jeden z dwóch statusów, od 2025 roku”) i napisało to wprost. Tę samą pułapkę bez nawiasów, czyli w wersji, która wykonuje się bez błędu i zwraca trzy razy za dużo wierszy, pokazujemy jako błąd 19 na liście dwudziestu typowych błędów.
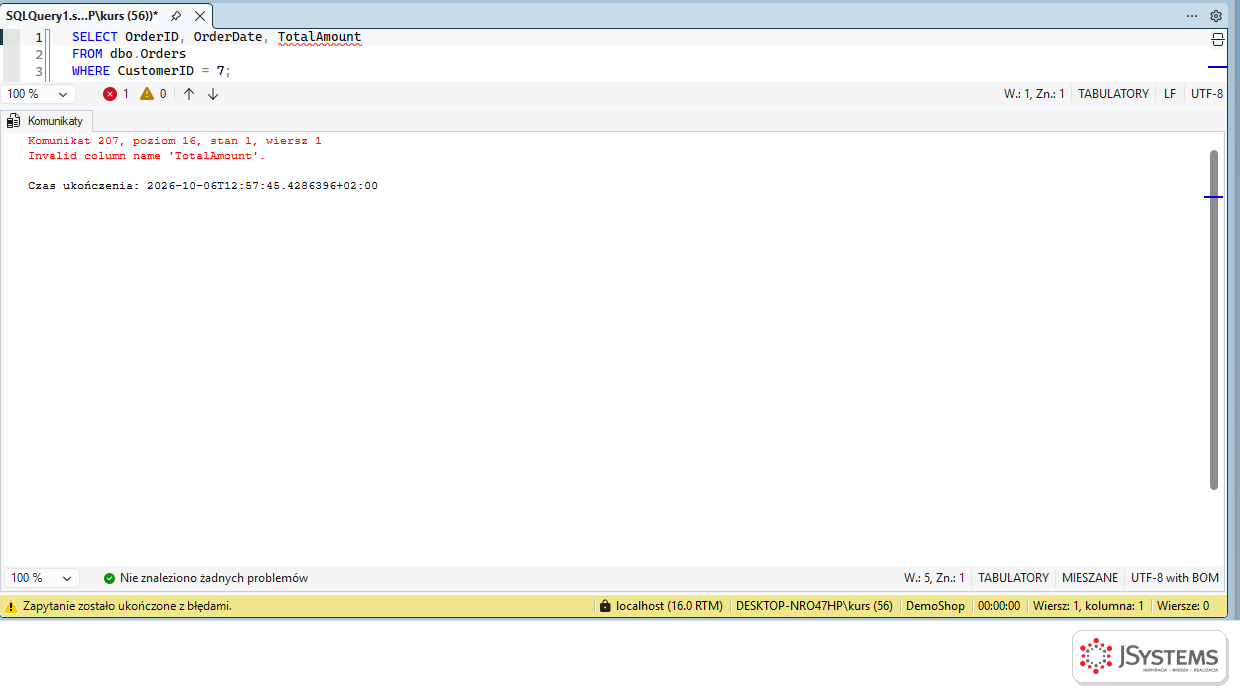
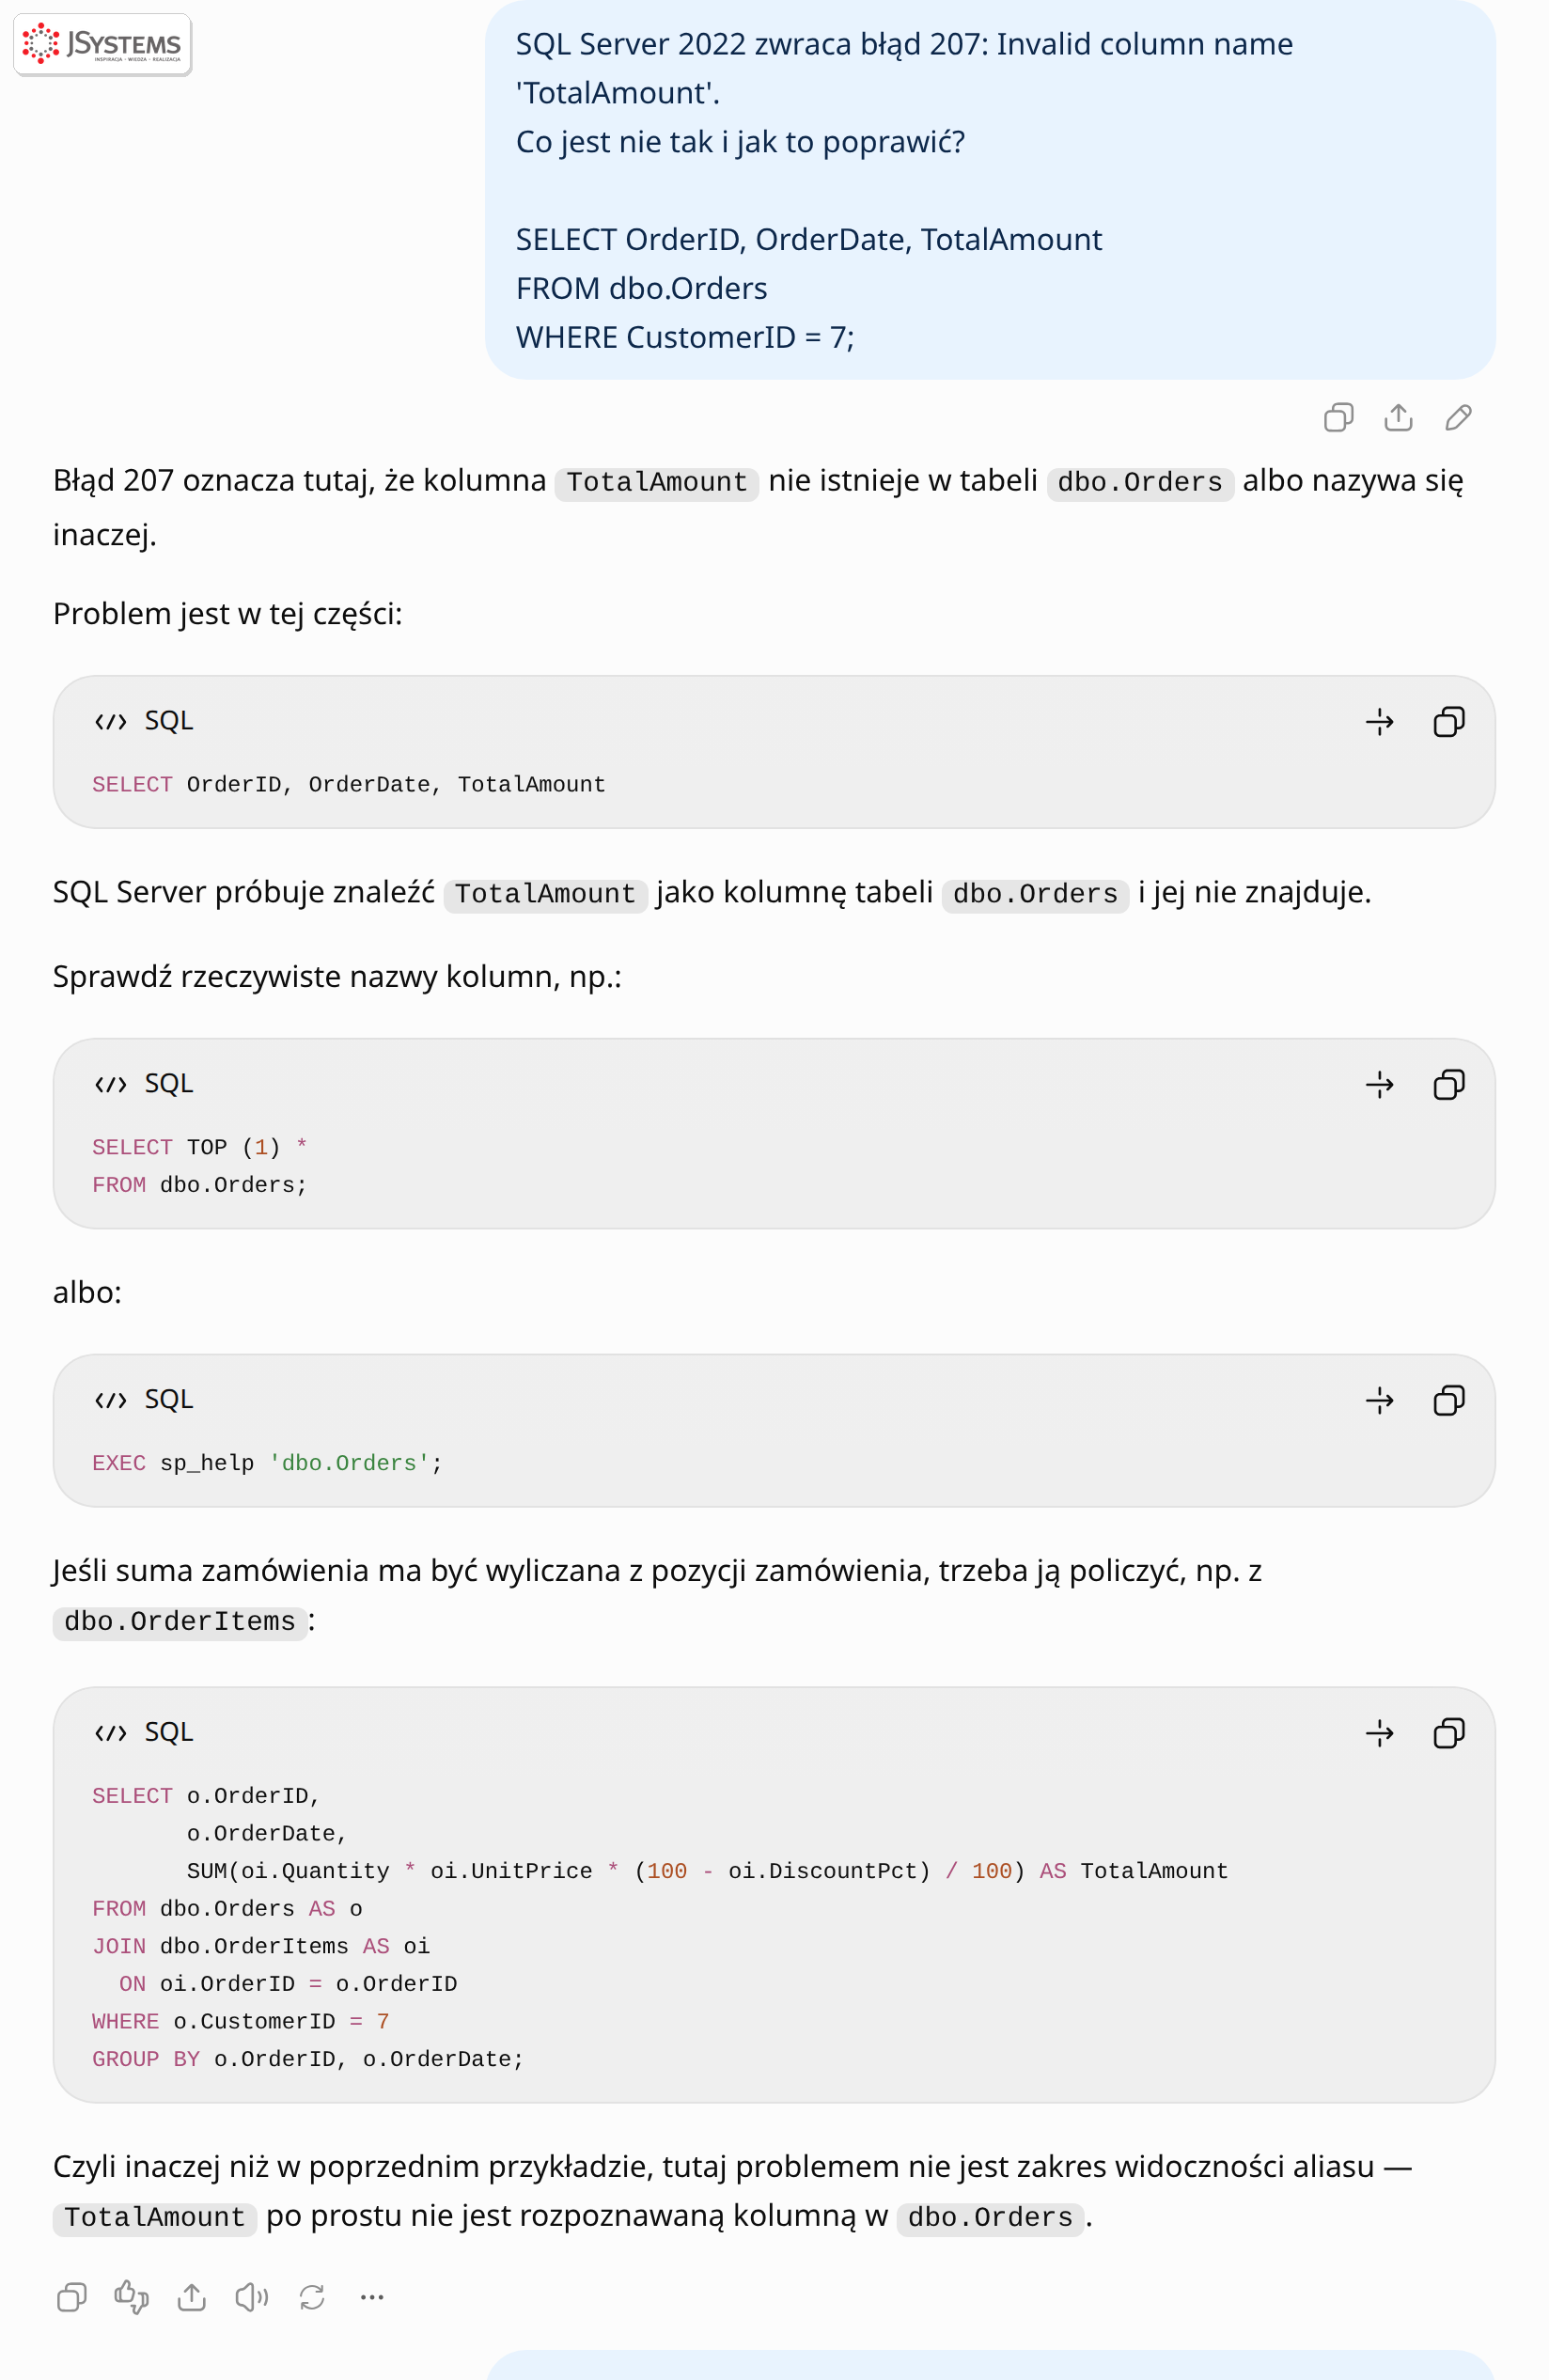
To przykład, w którym AI bez schematu nie może dać ostatecznej odpowiedzi, i dobrze, że tego nie udaje. Jeśli chcesz od razu poprawny kod, dołącz opis schematu z sekcji o schemacie.
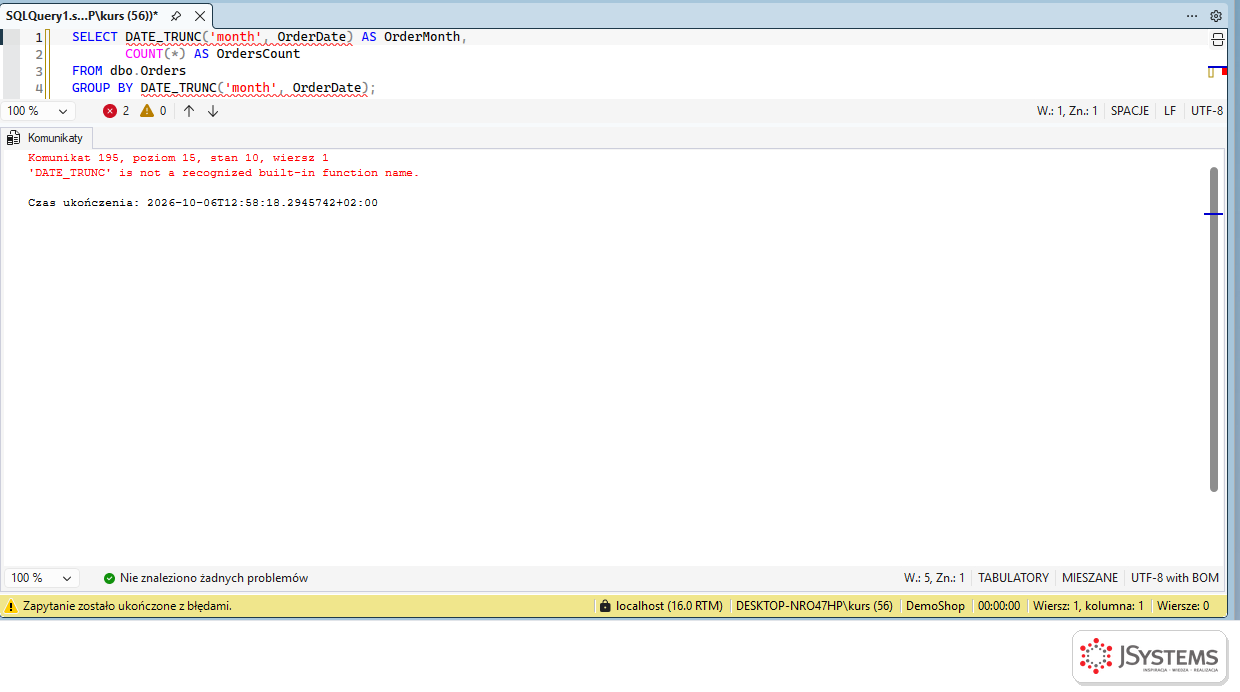
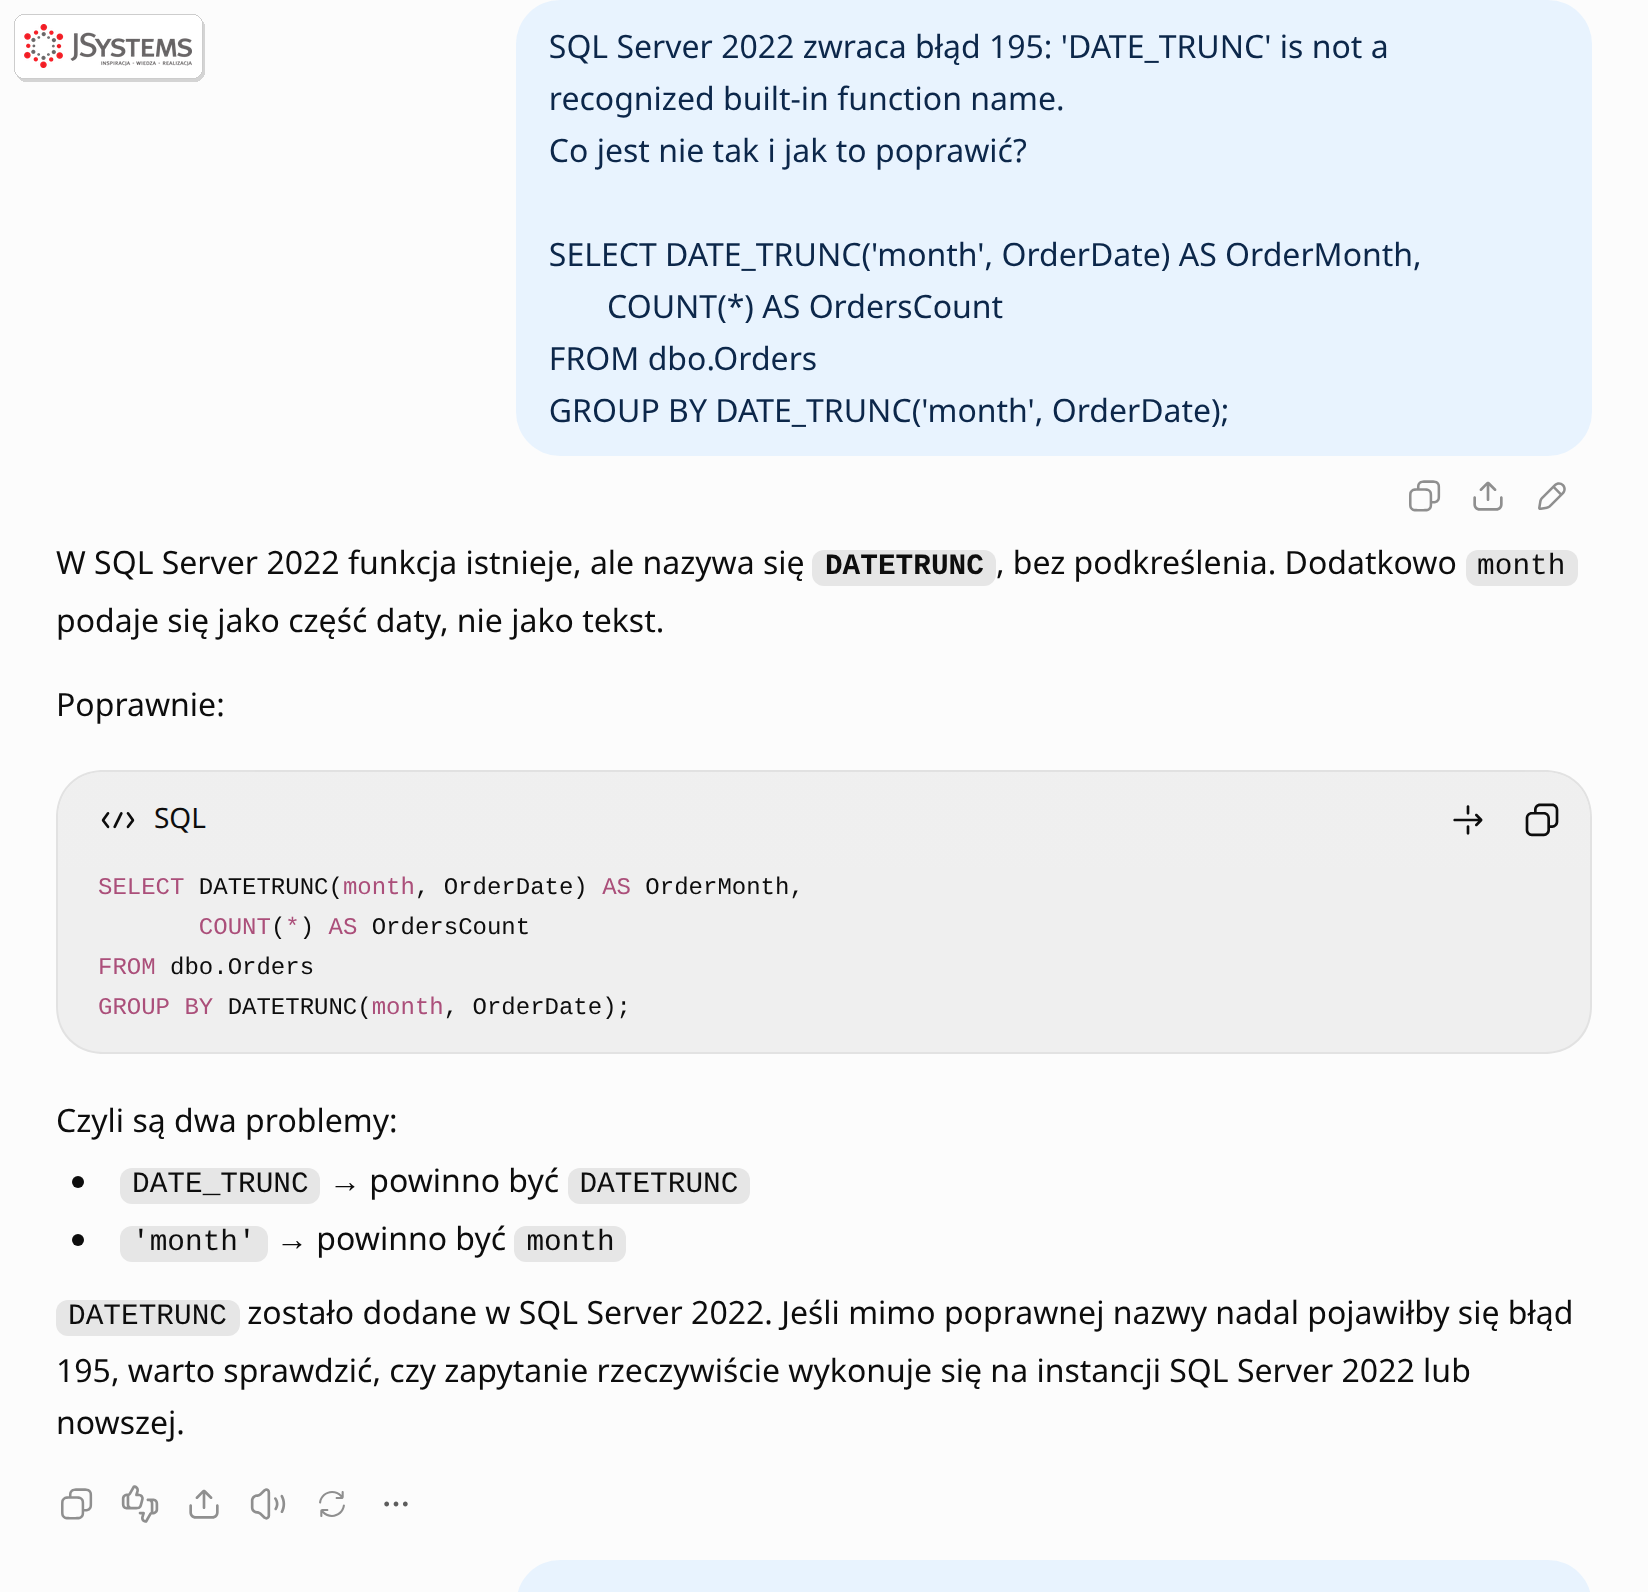
Ostatnia uwaga z odpowiedzi jest praktyczna: na SQL Server 2019 DATETRUNC nie istnieje i poprawka też skończyłaby się błędem 195. Wtedy pierwszy dzień miesiąca liczy się na przykład przez DATEFROMPARTS(YEAR(OrderDate), MONTH(OrderDate), 1).
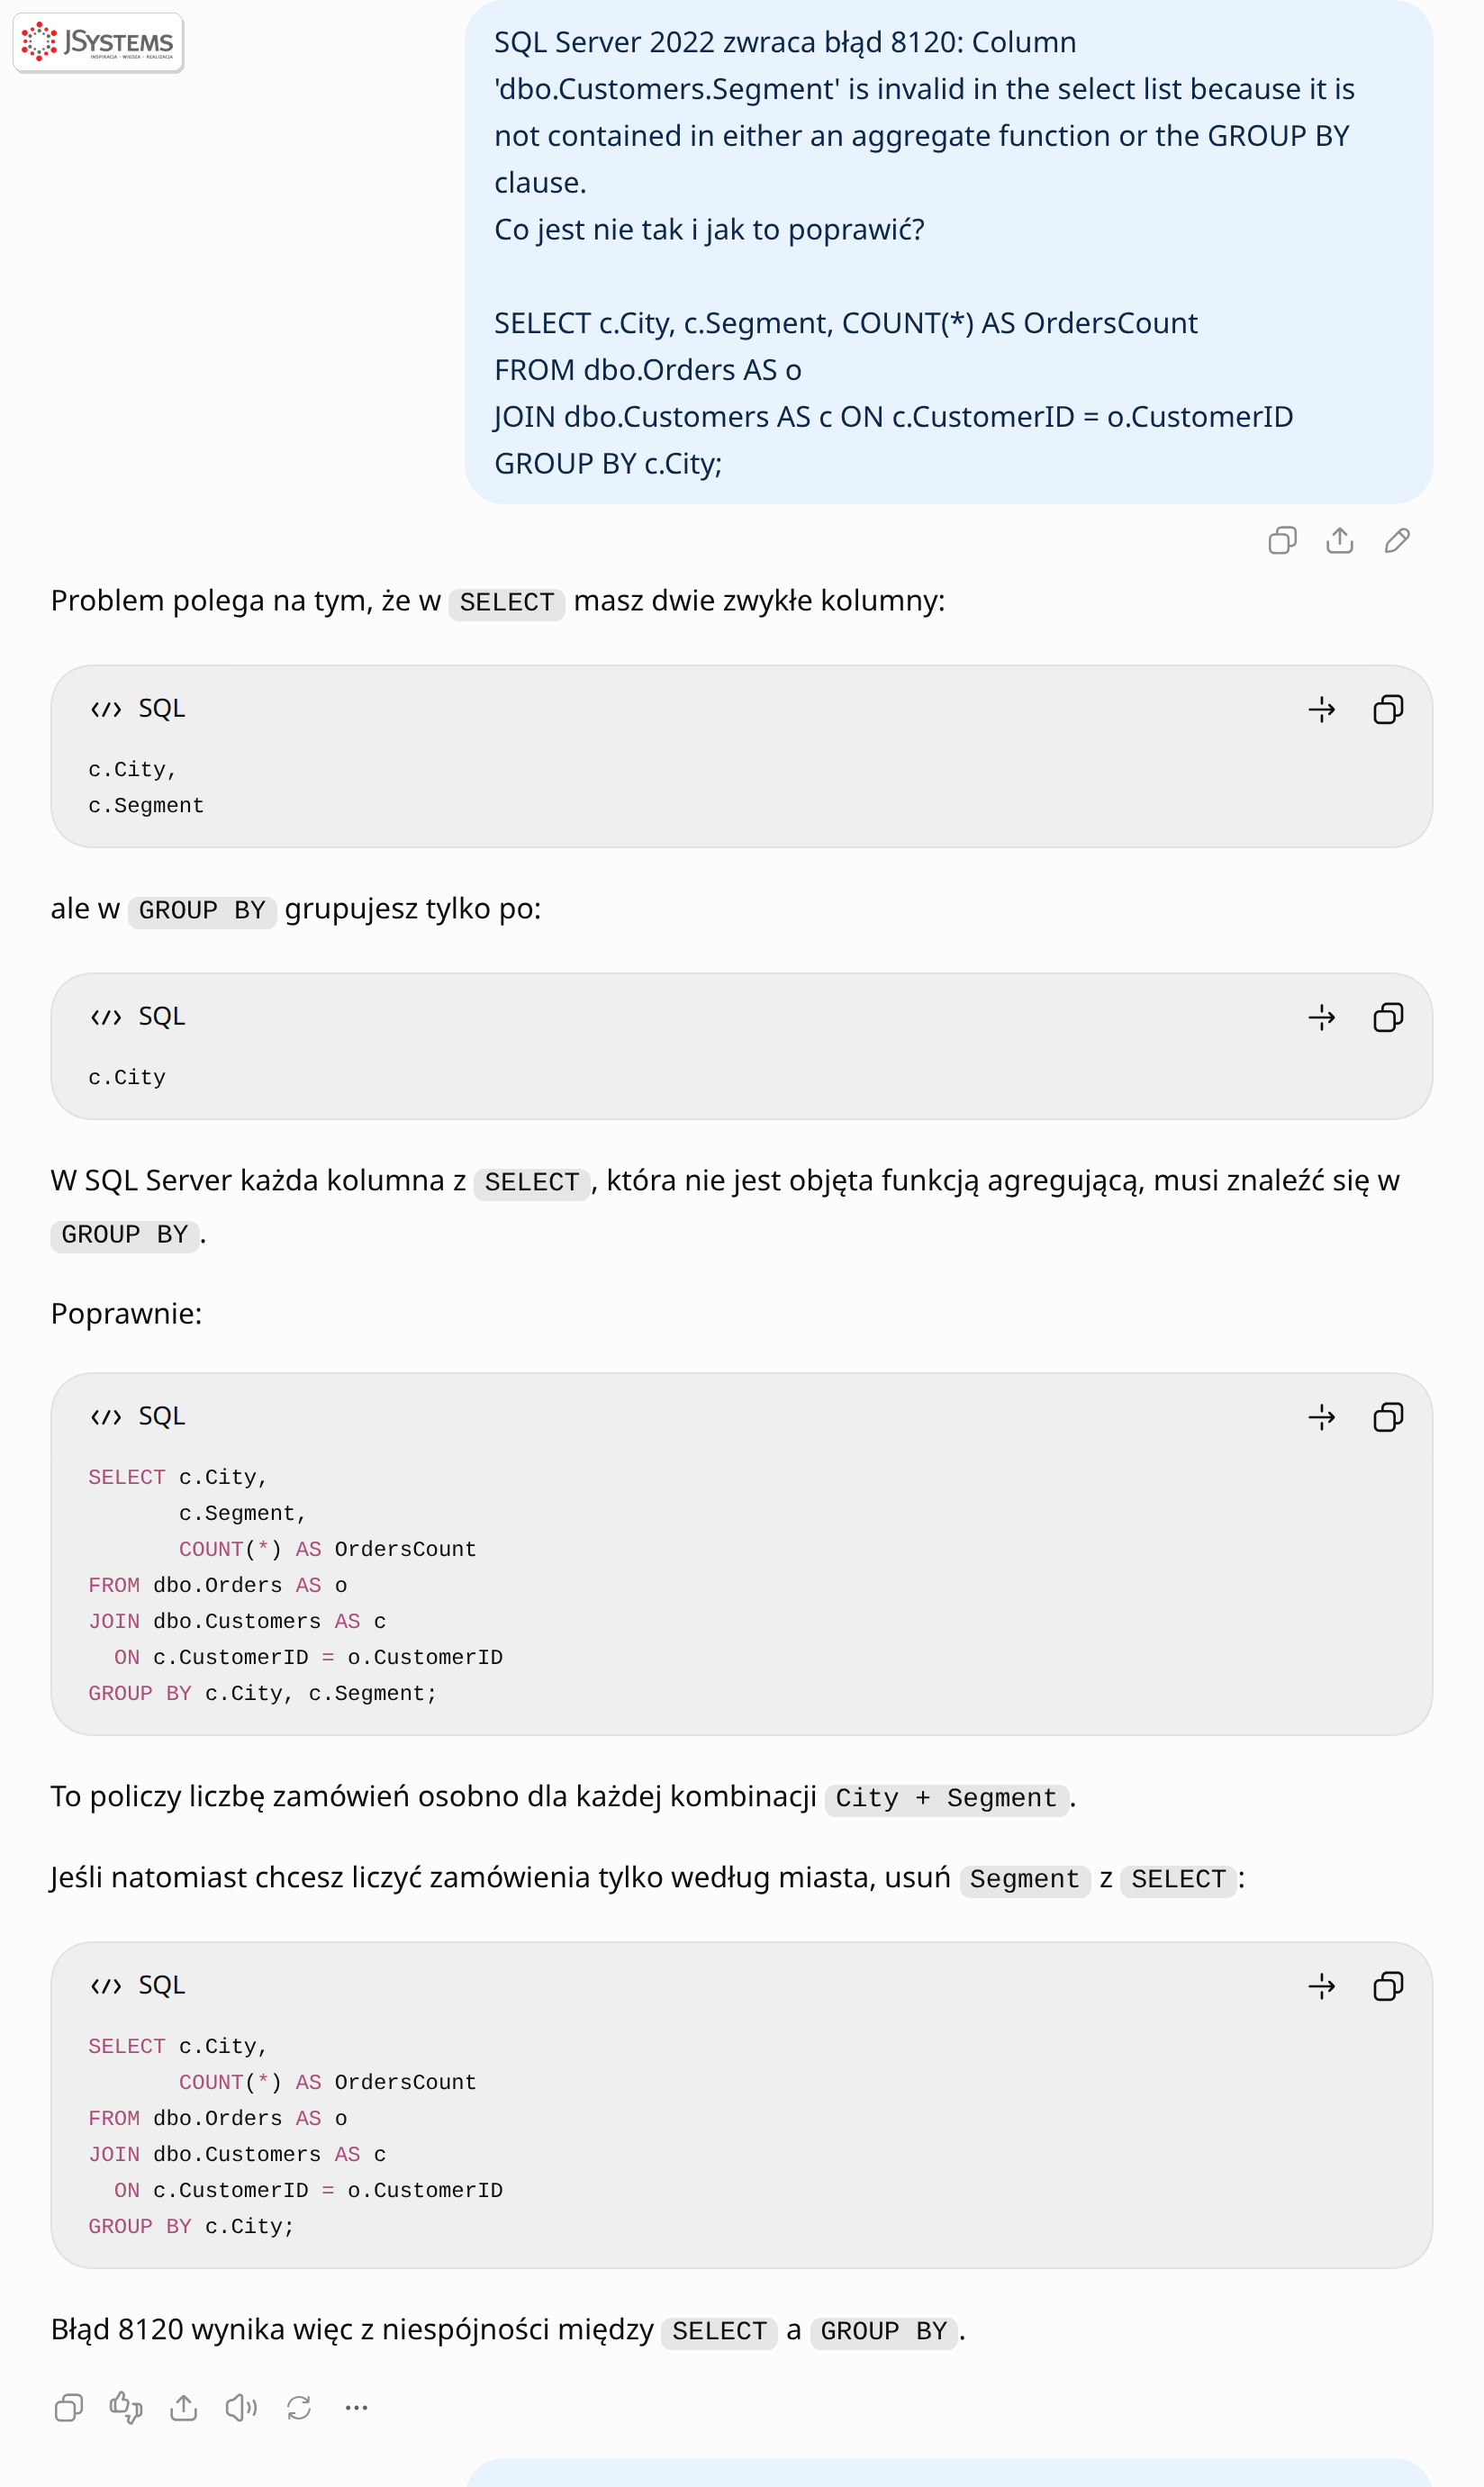
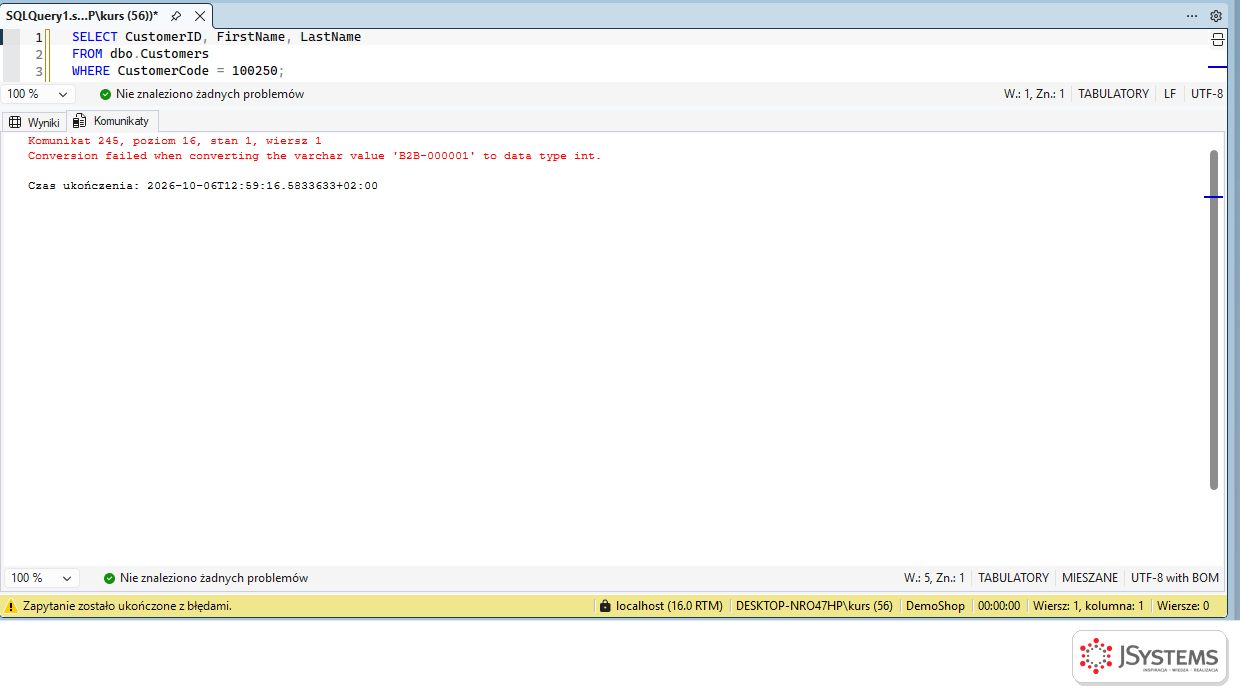
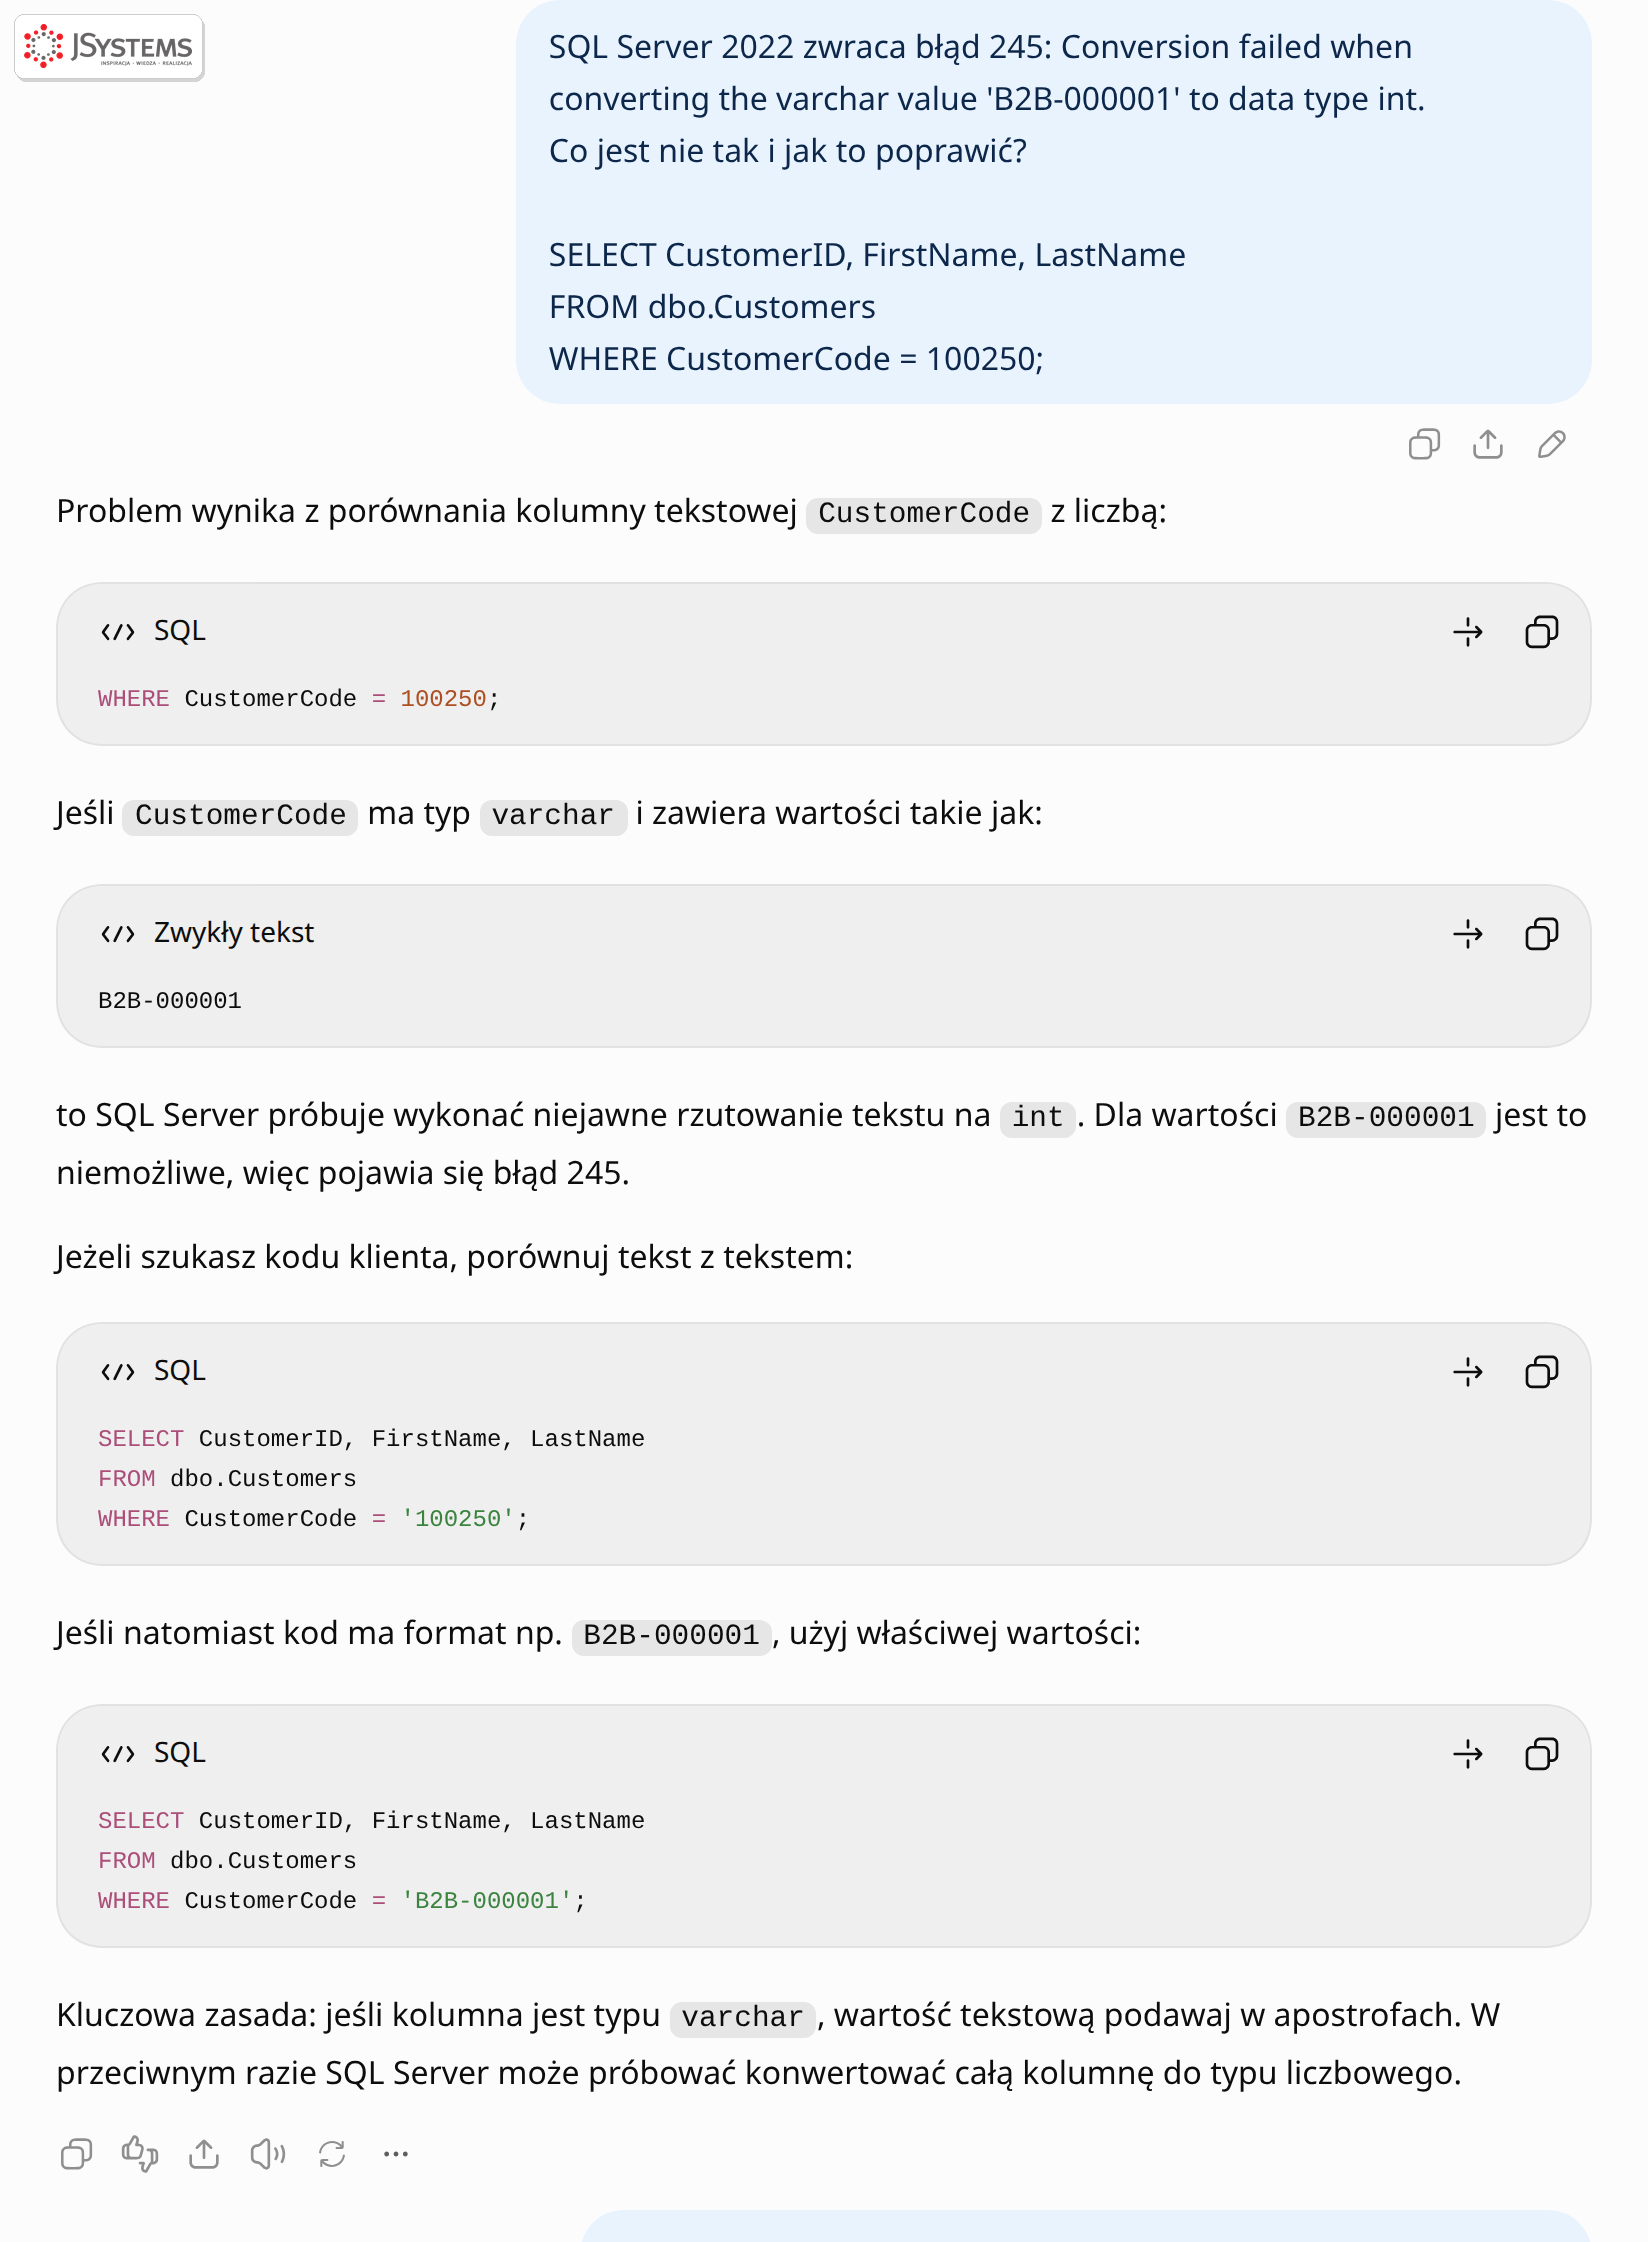
To zdanie ma też drugie dno, o którym AI nie wspomniało. Konwersja całej kolumny oznacza, że serwer nie może skorzystać z indeksu na CustomerCode i musi przeczytać wszystkie kody. Gdyby w tabeli nie było kodów z literami, zapytanie wykonałoby się bez błędu, tylko wolniej. Taką cichą konwersję pokazujemy w sygnale nr 9 w sekcji o planie wykonania.
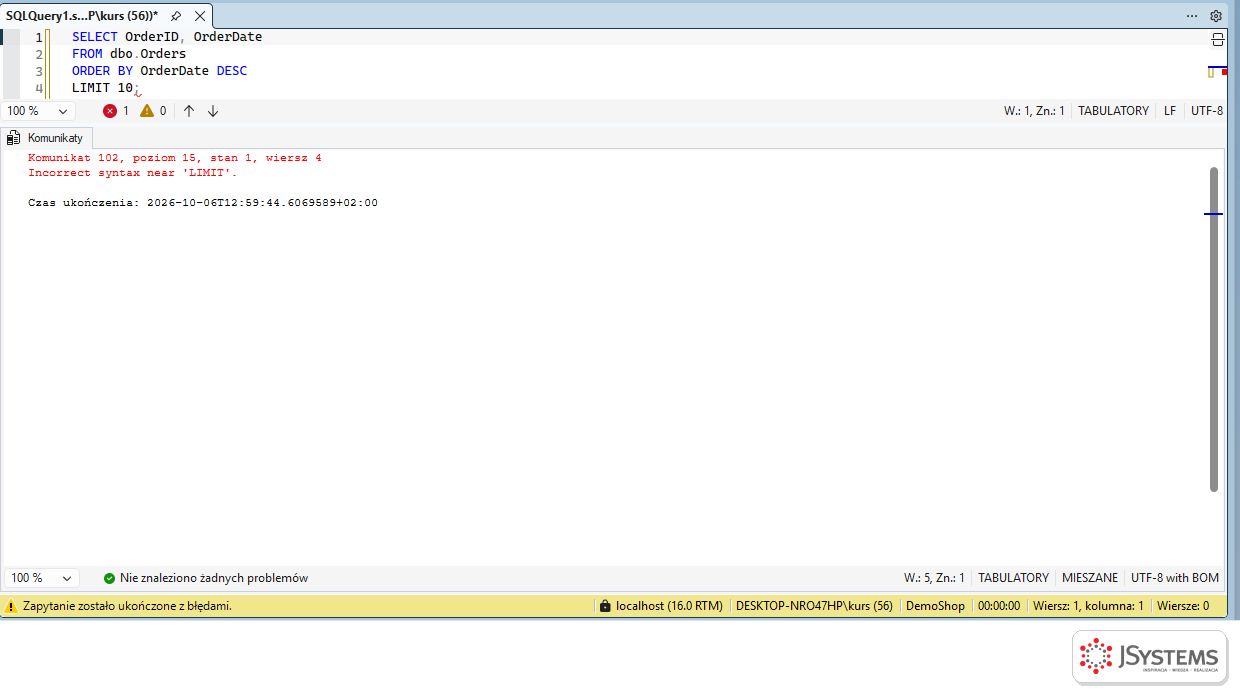
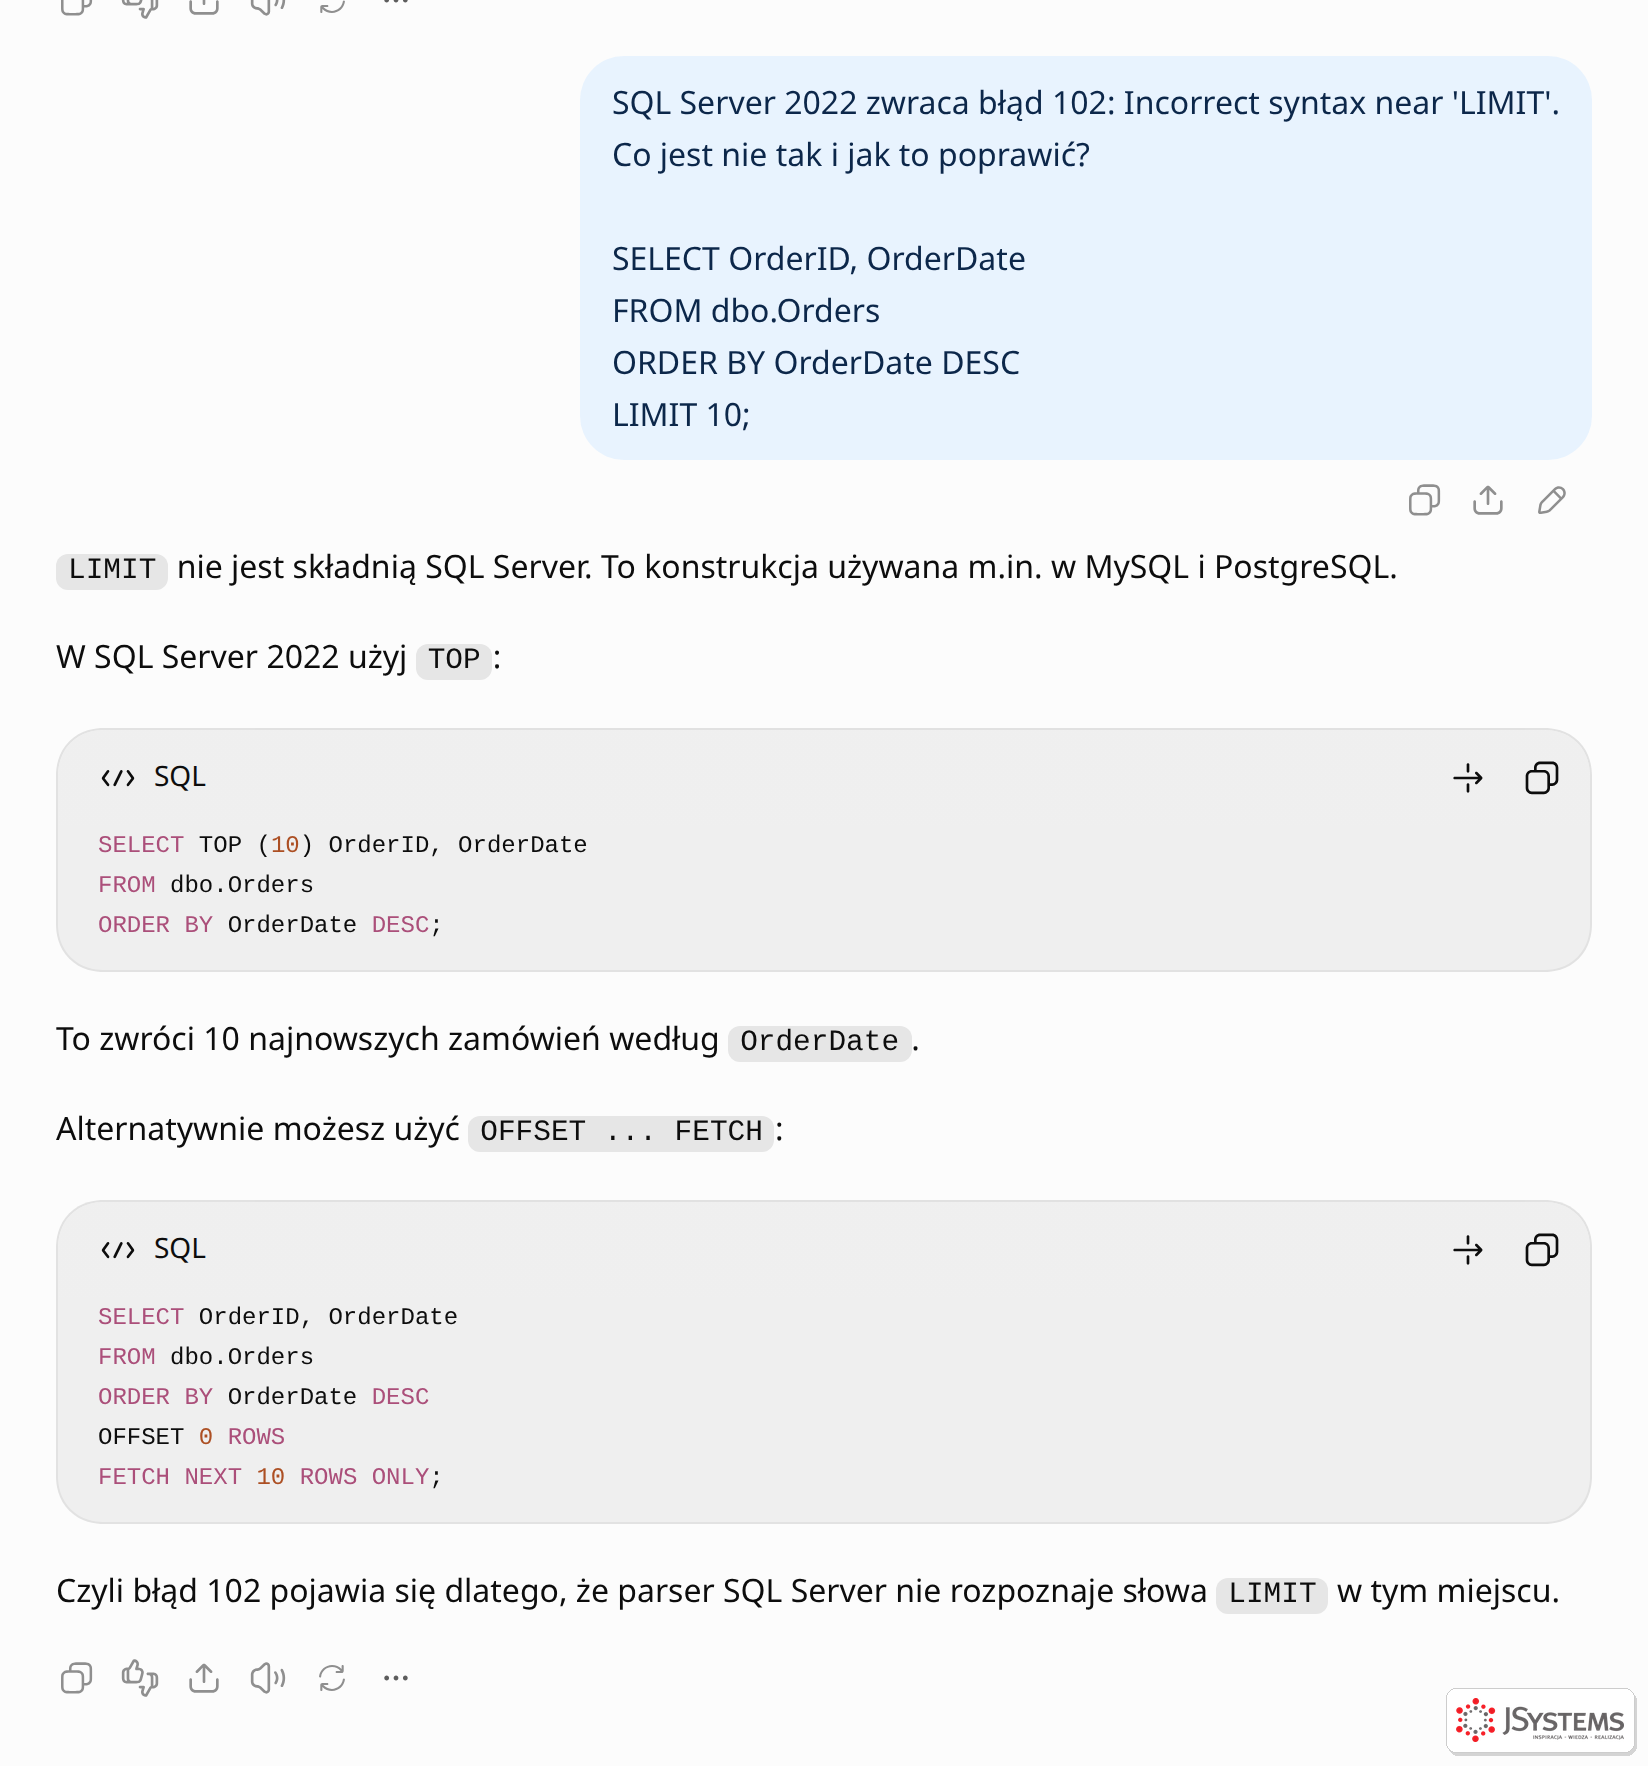
Osiem na osiem trafnych diagnoz, każda w 7-12 sekund. Przy błędach składniowych AI jest po prostu szybsze od szukania w dokumentacji. Dwie praktyczne rady z tych prób: wklejaj komunikat dokładnie tak, jak go podał serwer (z numerem, bo po numerze AI rozpoznaje kategorię błędu), a przy błędzie bez komunikatu, jak w pierwszym przypadku, opisz objaw („w kolumnie LastName widzę imiona”) zamiast pytać ogólnie, co jest nie tak.
Błąd logiczny to sytuacja, w której zapytanie wykonuje się bez komunikatu i zwraca wiarygodnie wyglądające liczby, tylko złe. Serwer nic nie podpowie, więc trzeba wiedzieć, że coś jest nie tak, i znaleźć przyczynę. AI pomaga tu na dwa sposoby. Pierwszy to przegląd kodu pod kątem celu: dajesz cel i zapytanie, AI szuka niezgodności. Tak sprawdziliśmy 20 typowych błędów w następnej sekcji. Drugi sposób jest potrzebny, gdy błąd nie rzuca się w oczy, a jedyny sygnał to liczba, która nie zgadza się z inną liczbą. Wtedy AI jest najlepszym partnerem do stawiania hipotez i projektowania zapytań diagnostycznych.
Dział finansów dostaje co miesiąc raport przychodu z opłaconych zamówień. Zapytanie wygląda niewinnie: zamówienia z 2025 roku, złączone z udanymi płatnościami (żeby wziąć tylko opłacone) i z pozycjami (żeby policzyć wartość).
/* Raport: przychód z opłaconych zamówień w 2025 roku, miesiąc po miesiącu */
SELECT DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1) AS SalesMonth,
       SUM(oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100) AS PaidRevenue
FROM dbo.Orders AS o
JOIN dbo.Payments AS p ON p.OrderID = o.OrderID
                      AND p.Status = 'SUCCESS'
JOIN dbo.OrderItems AS oi ON oi.OrderID = o.OrderID
WHERE o.OrderDate >= '20250101' AND o.OrderDate < '20260101'
GROUP BY DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1)
ORDER BY SalesMonth;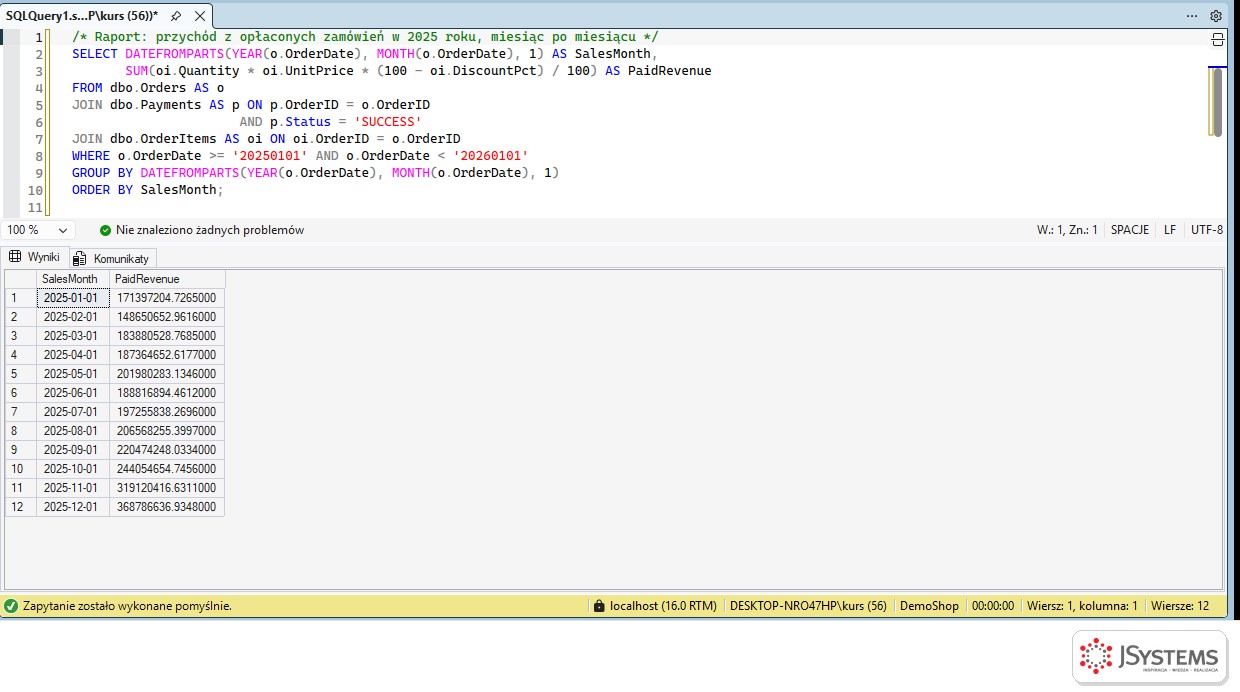
Finanse zgłaszają, że suma roczna nie zgadza się z systemem księgowym. Sprawdzamy to jednym zapytaniem, które sumuje raport i zestawia go z kwotą z księgowości:
/* Suma roczna raportu a kwota z księgowości */
WITH Raport AS (
    SELECT DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1) AS SalesMonth,
           SUM(oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100) AS PaidRevenue
    FROM dbo.Orders AS o
    JOIN dbo.Payments AS p ON p.OrderID = o.OrderID AND p.Status = 'SUCCESS'
    JOIN dbo.OrderItems AS oi ON oi.OrderID = o.OrderID
    WHERE o.OrderDate >= '20250101' AND o.OrderDate < '20260101'
    GROUP BY DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1)
)
SELECT SUM(PaidRevenue) AS ReportTotal,
       CAST(2283093002.77 AS decimal(19, 2)) AS AccountingTotal,
       CAST((SUM(PaidRevenue) / 2283093002.77 - 1) * 100 AS decimal(5, 2)) AS DifferencePct
FROM Raport;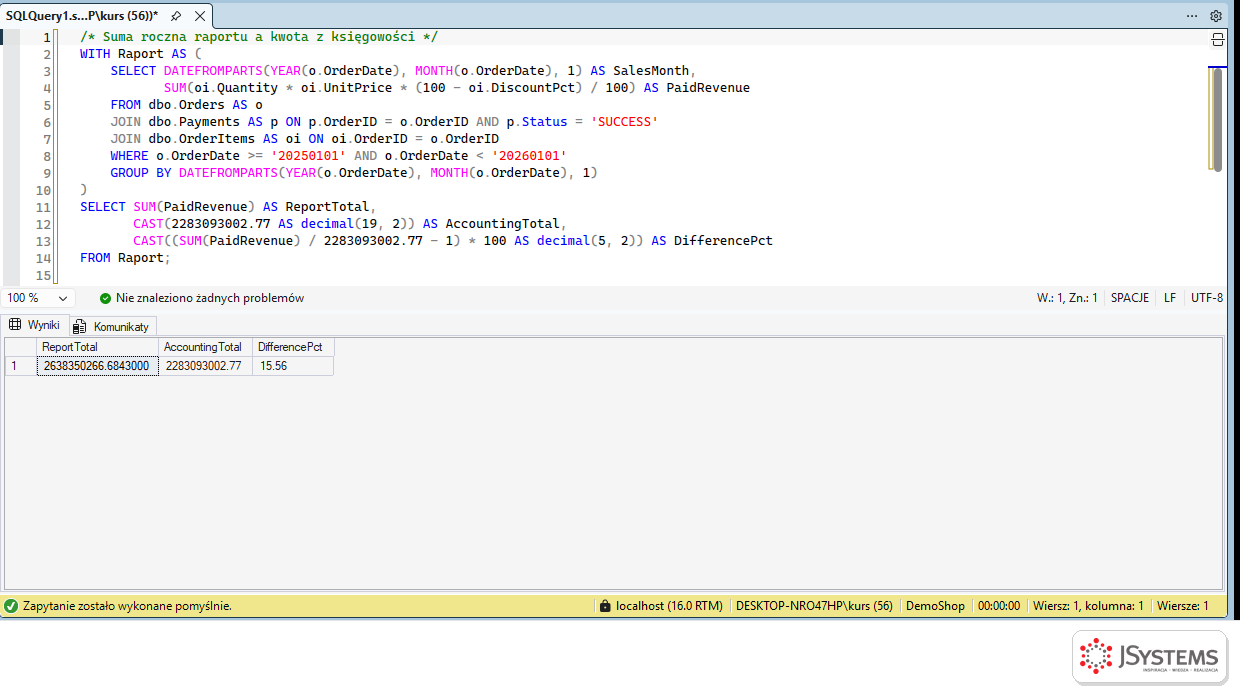
Teraz rozmowa z AI. Załączamy opis schematu, podajemy cel raportu, objaw i obie liczby, a zamiast „popraw to” prosimy o hipotezy z zapytaniami diagnostycznymi:
Pracuję w SQL Server 2022 na bazie opisanej w załączonym pliku demoshop_schemat_dla_ai.txt.
Poniższy raport ma pokazywać przychód z opłaconych zamówień w 2025 roku, miesiąc po miesiącu. Dział finansów zgłasza, że suma za rok jest o około 15,6% wyższa niż w systemie księgowym (raport: 2 638 350 266,68 zł, księgowość: 2 283 093 002,77 zł). Różnica jest podobna w każdym miesiącu.
Nie poprawiaj jeszcze zapytania. Wypisz hipotezy, co może zawyżać wynik, od najbardziej prawdopodobnej, i do każdej podaj krótkie zapytanie diagnostyczne, którym ją sprawdzę.
[treść raportu]
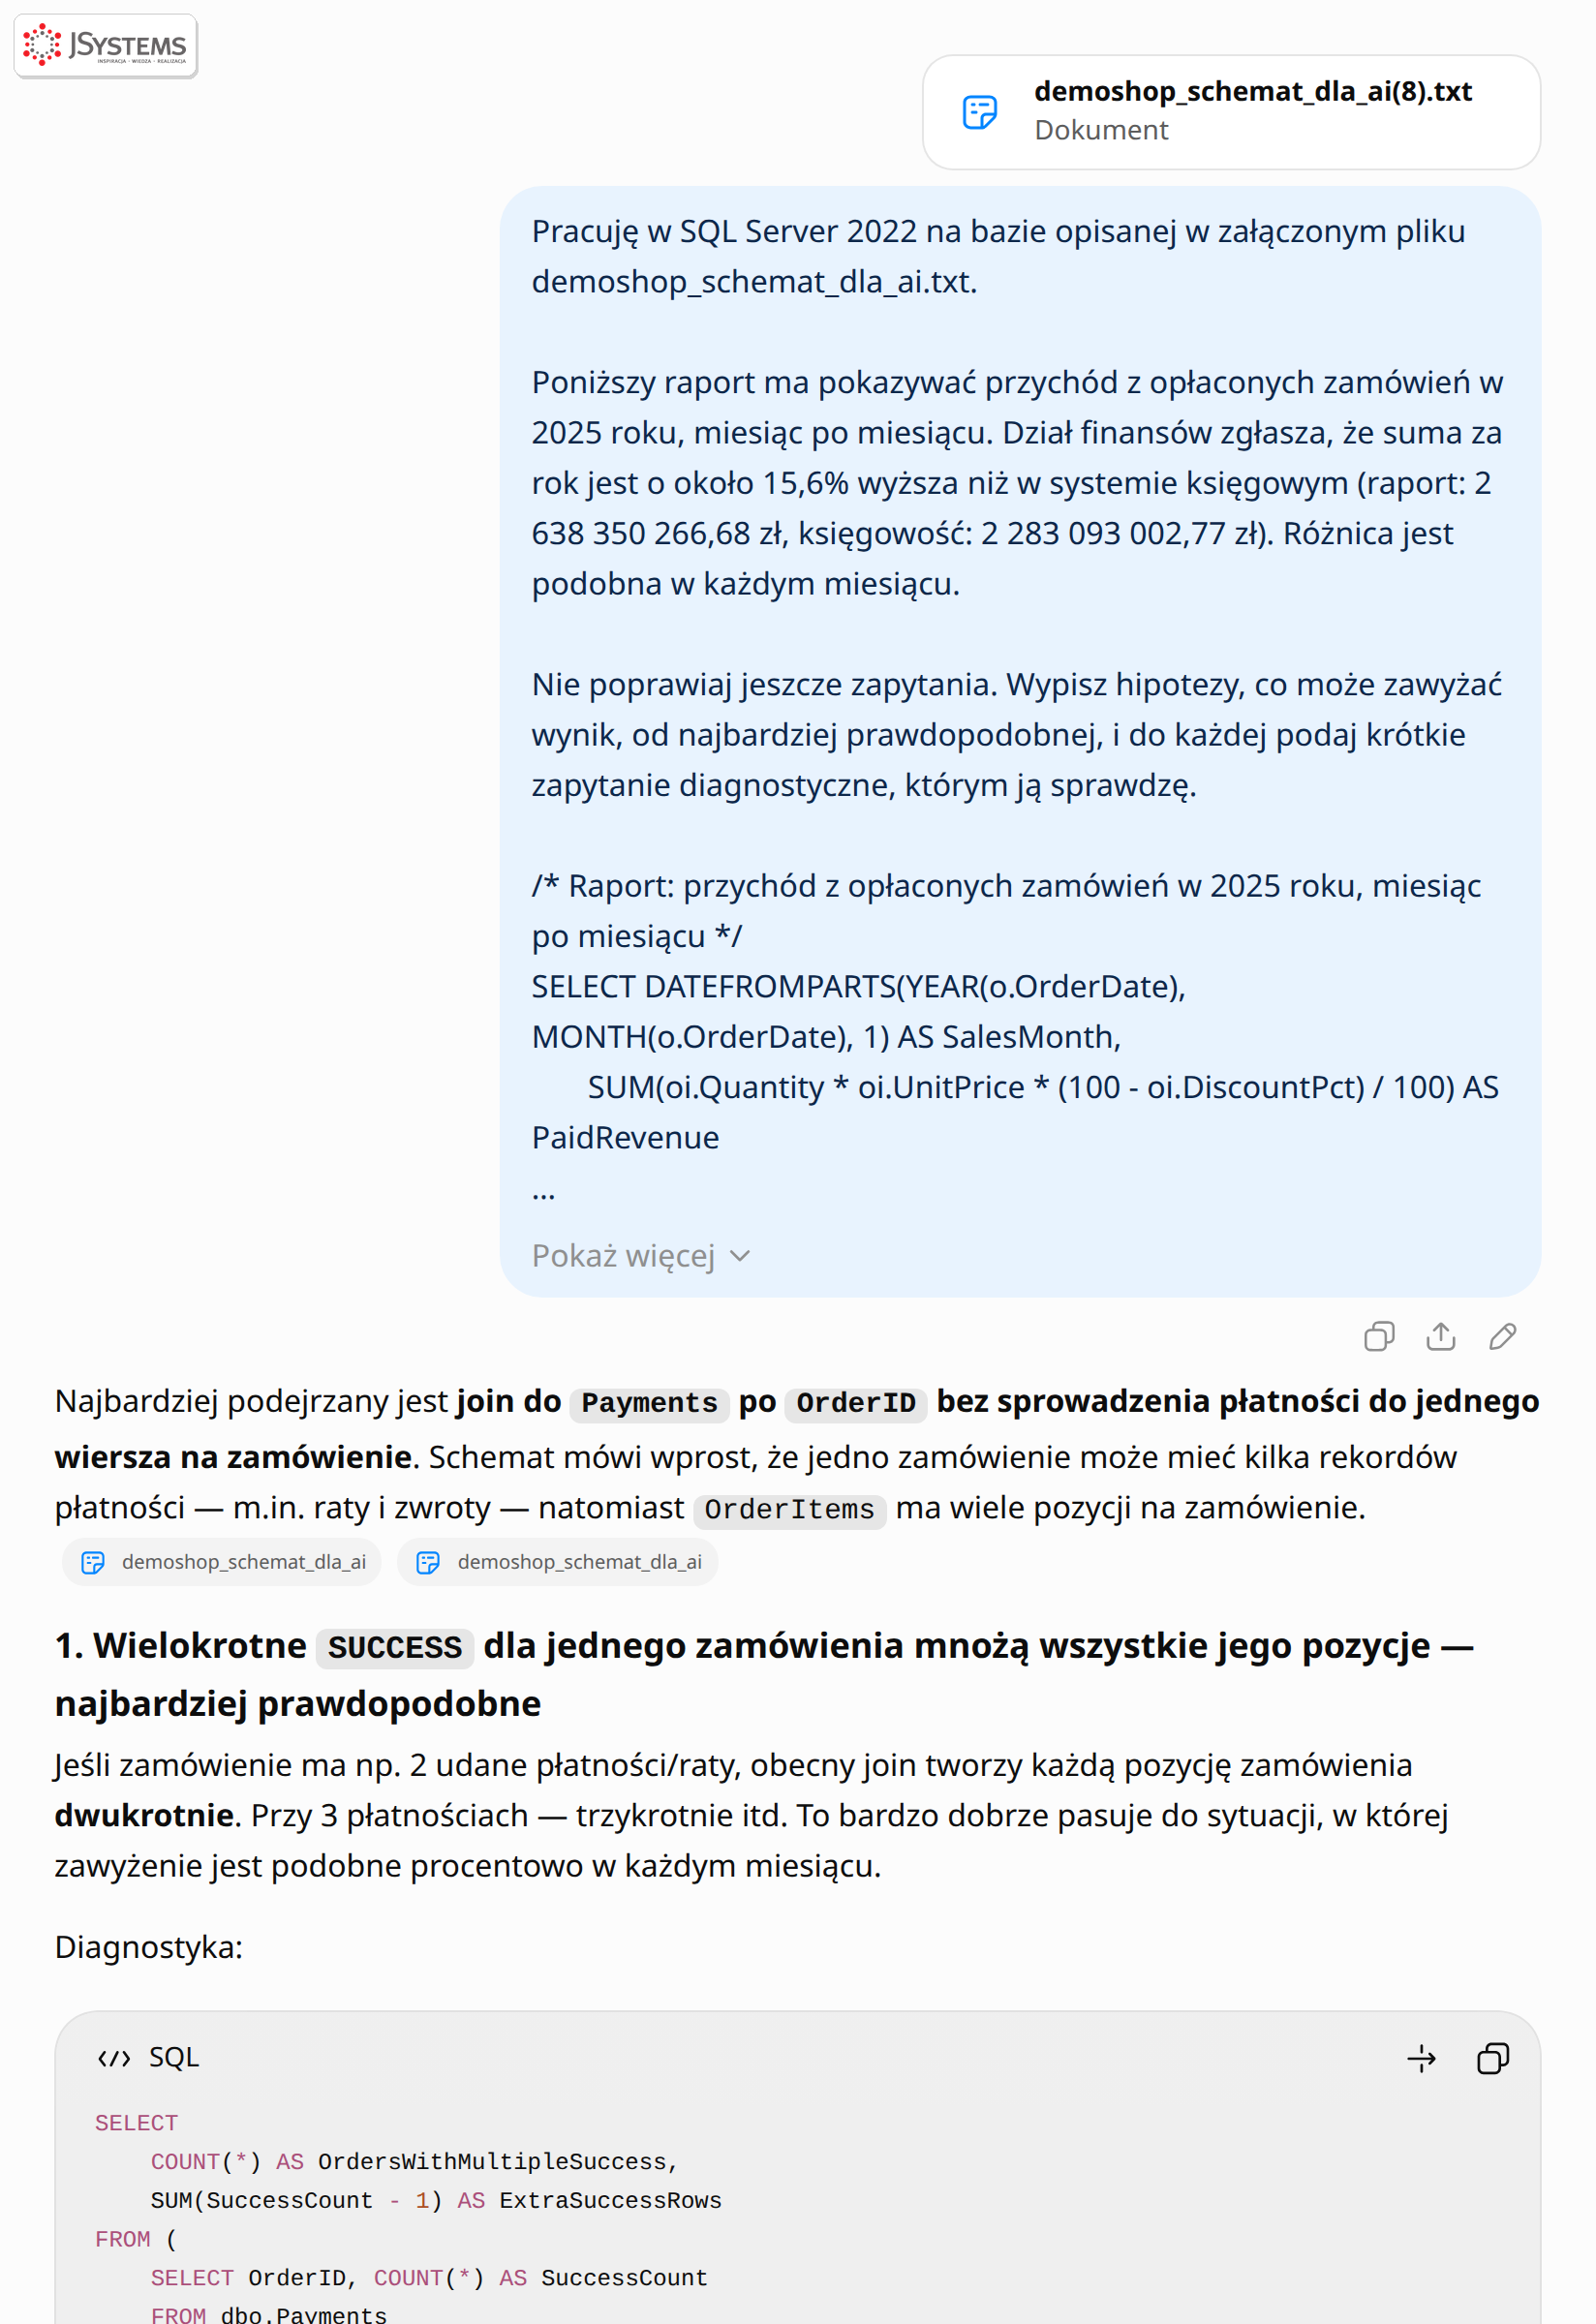
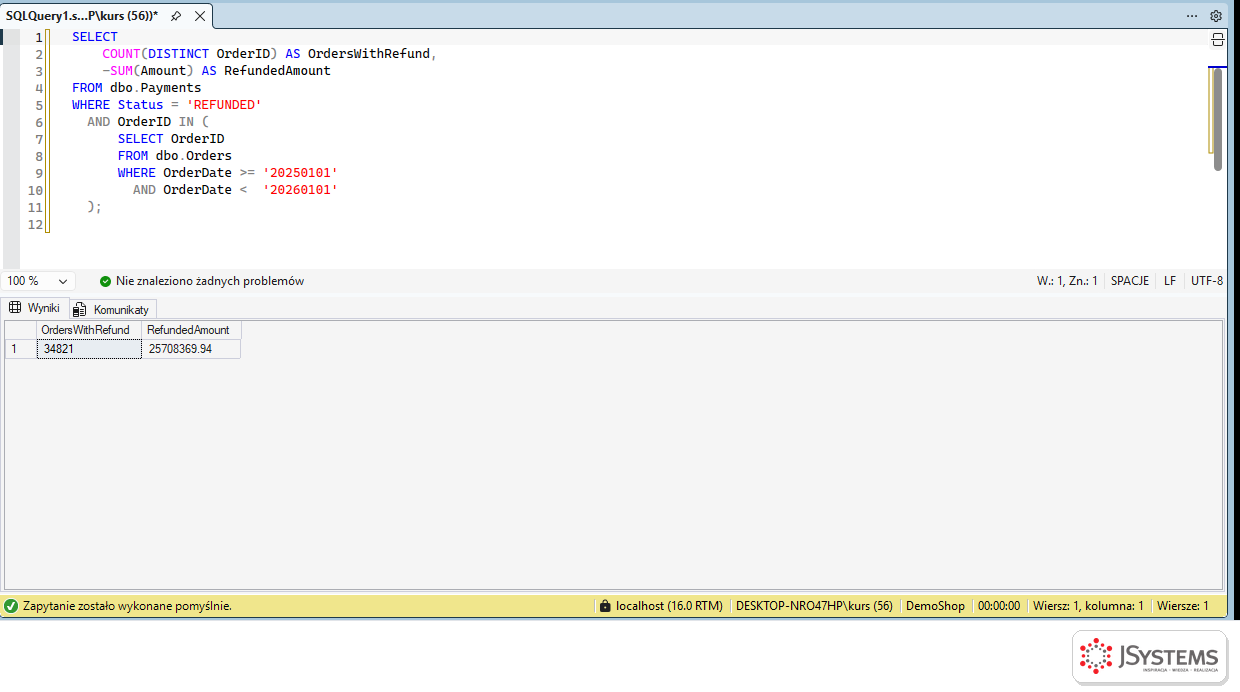
Ranking hipotez jest trafny. Na pierwszym miejscu ChatGPT stawia złączenie z płatnościami bez sprowadzenia ich do jednego wiersza na zamówienie i uzasadnia to opisem tabeli Payments w schemacie („zamówienie może mieć kilka wierszy: nieudane próby, raty i zwroty”) oraz tym, że płatności jest więcej niż zamówień. Przy hipotezie o datach sam zaznacza, że nie tłumaczy ona stałej różnicy w każdym miesiącu. Uruchamiamy jego zapytania diagnostyczne bez żadnych zmian:
SELECT
    COUNT(*) AS OrdersWithMultipleSuccess,
    SUM(SuccessCount - 1) AS ExtraSuccessRows
FROM (
    SELECT OrderID, COUNT(*) AS SuccessCount
    FROM dbo.Payments
    WHERE Status = 'SUCCESS'
    GROUP BY OrderID
    HAVING COUNT(*) > 1
) AS x;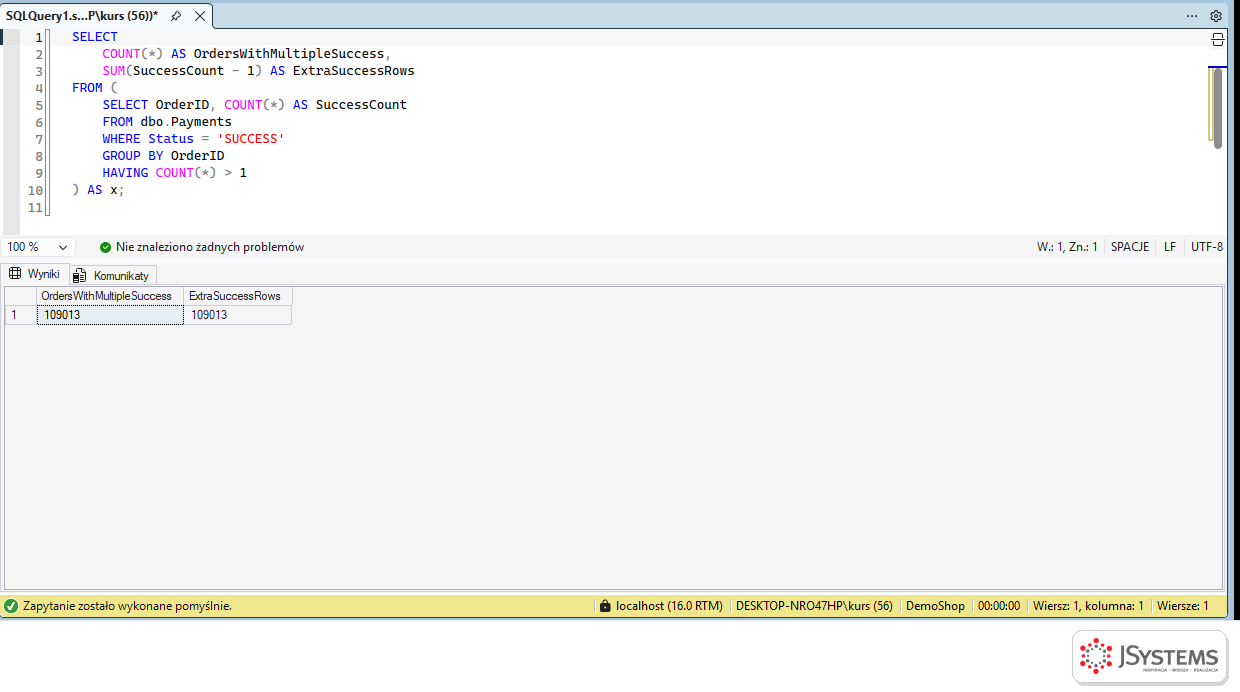
SELECT
    p.SuccessCount,
    COUNT(*) AS OrdersCount
FROM dbo.Orders AS o
JOIN (
    SELECT OrderID, COUNT(*) AS SuccessCount
    FROM dbo.Payments
    WHERE Status = 'SUCCESS'
    GROUP BY OrderID
) AS p ON p.OrderID = o.OrderID
WHERE o.OrderDate >= '20250101'
  AND o.OrderDate <  '20260101'
GROUP BY p.SuccessCount
ORDER BY p.SuccessCount;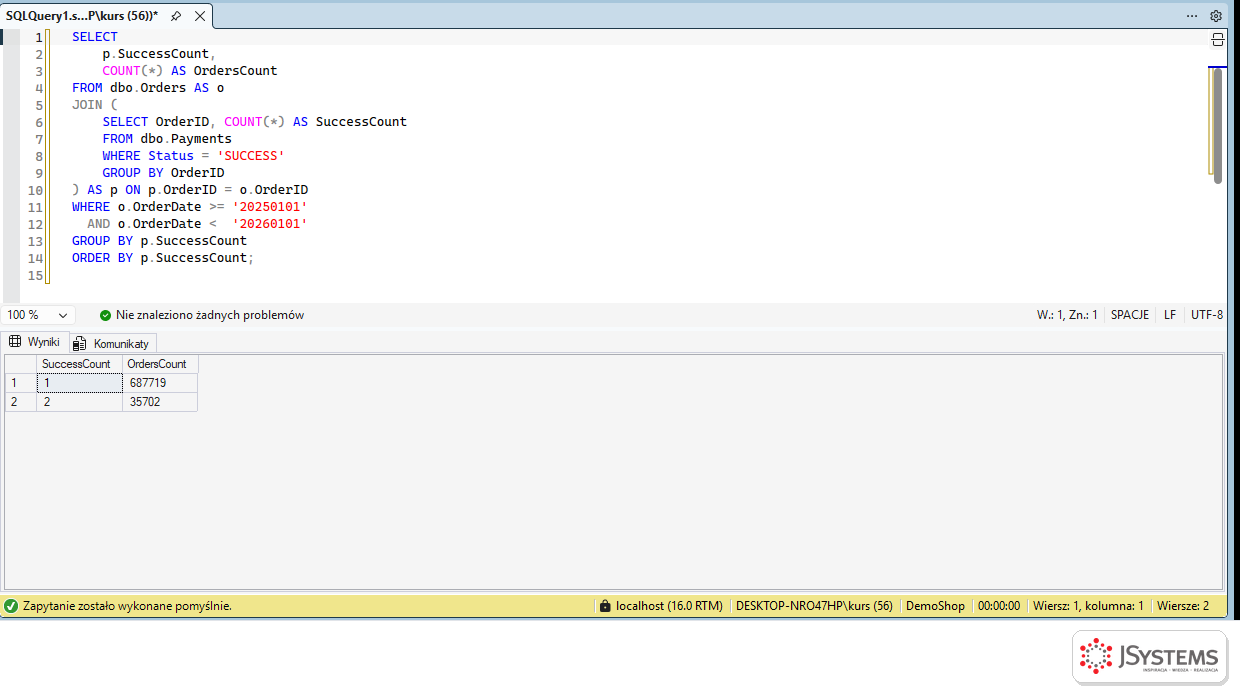
SELECT TOP (100)
    o.OrderID,
    SUM(oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100) AS OrderValue,
    p.SuccessCount,
    p.SuccessAmount
FROM dbo.Orders AS o
JOIN dbo.OrderItems AS oi ON oi.OrderID = o.OrderID
JOIN (
    SELECT
        OrderID,
        COUNT(*) AS SuccessCount,
        SUM(Amount) AS SuccessAmount
    FROM dbo.Payments
    WHERE Status = 'SUCCESS'
    GROUP BY OrderID
) AS p ON p.OrderID = o.OrderID
WHERE o.OrderDate >= '20250101'
  AND o.OrderDate <  '20260101'
GROUP BY o.OrderID, p.SuccessCount, p.SuccessAmount
HAVING p.SuccessCount > 1
ORDER BY p.SuccessCount DESC;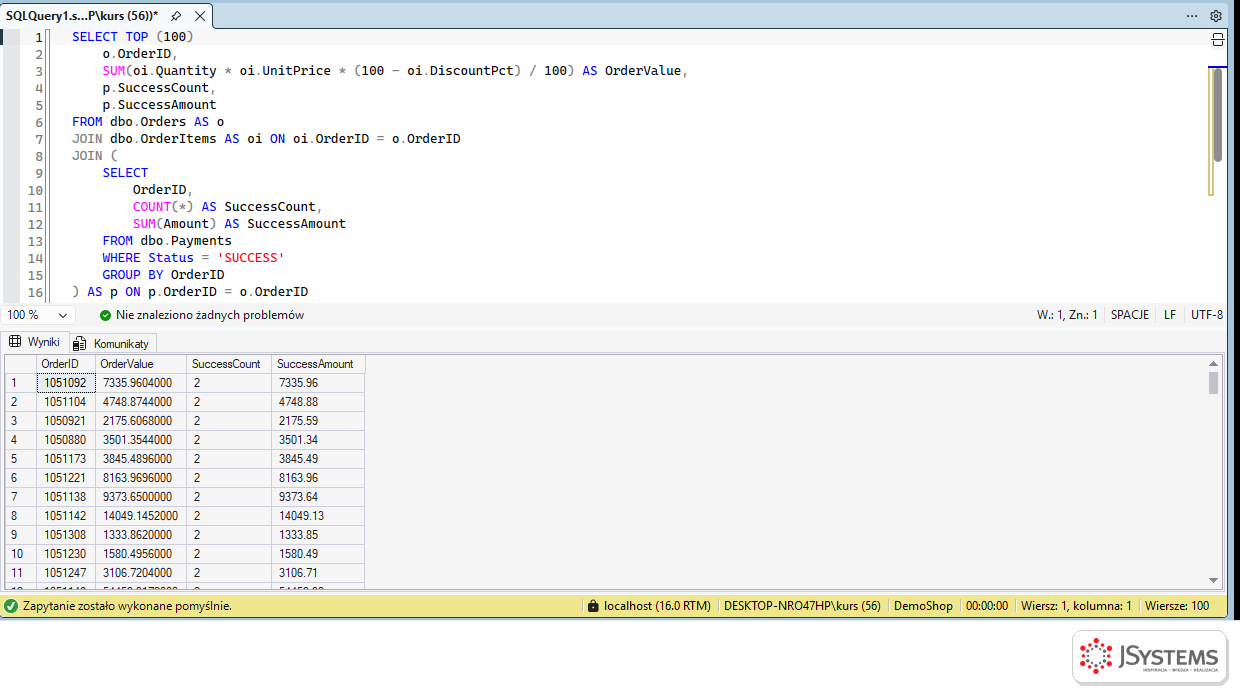
SELECT
    COUNT(DISTINCT OrderID) AS OrdersWithRefund,
    -SUM(Amount) AS RefundedAmount
FROM dbo.Payments
WHERE Status = 'REFUNDED'
  AND OrderID IN (
      SELECT OrderID
      FROM dbo.Orders
      WHERE OrderDate >= '20250101'
        AND OrderDate <  '20260101'
  );
SELECT
    o.Status,
    COUNT(DISTINCT o.OrderID) AS OrdersCount
FROM dbo.Orders AS o
JOIN dbo.Payments AS p
  ON p.OrderID = o.OrderID
 AND p.Status = 'SUCCESS'
WHERE o.OrderDate >= '20250101'
  AND o.OrderDate <  '20260101'
GROUP BY o.Status
ORDER BY OrdersCount DESC;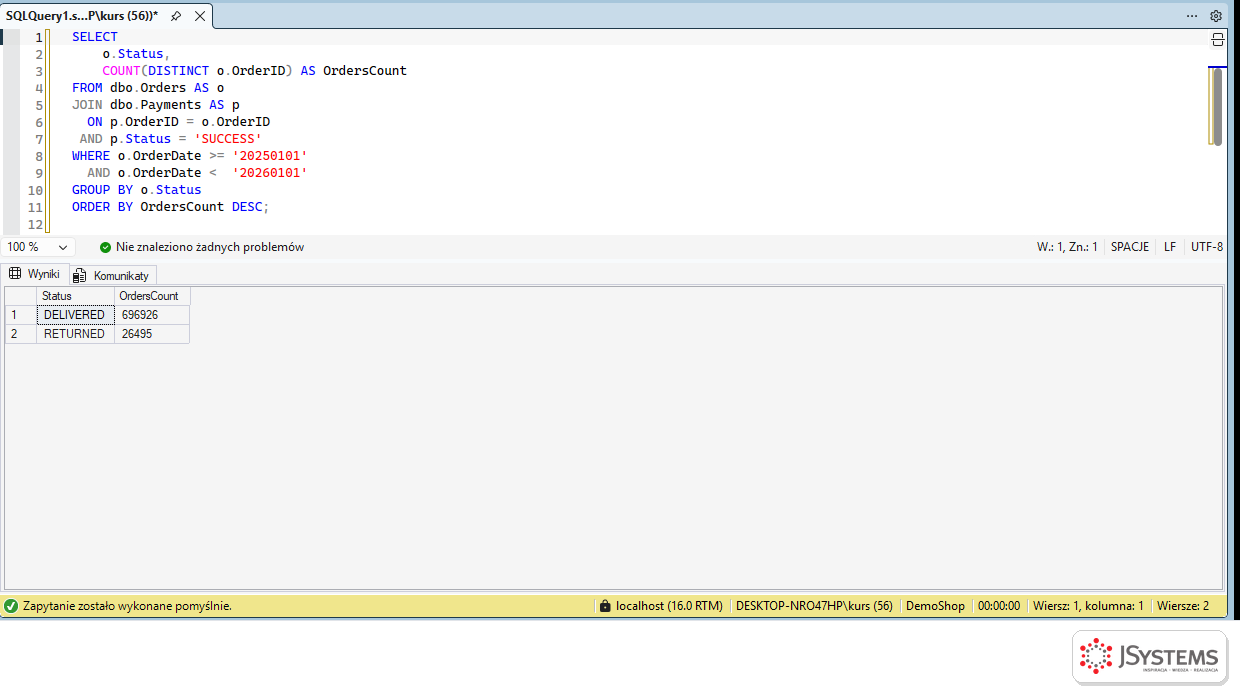
Wyniki wskazują jednoznacznie pierwszą hipotezę. Zanim poprosimy o poprawkę, dokładamy informację, której AI nie mogło znać: jak liczy księgowość. To rozstrzyga hipotezy nr 3 i nr 5, które dotyczą reguł biznesowych, a nie kodu.
Wyniki diagnostyki:
1. W całej bazie 109 013 zamówień ma więcej niż jedną płatność SUCCESS (ExtraSuccessRows: 109 013, czyli każde ma dokładnie dwie).
2. Zamówienia z 2025 roku: 687 719 ma jedną płatność SUCCESS, 35 702 ma dwie.
3. W zamówieniach z dwiema płatnościami suma rat jest równa wartości zamówienia z dokładnością do grosza, np. zamówienie 1051092: wartość 7335,9604, raty łącznie 7335,96.
4. Zwroty REFUNDED w zamówieniach z 2025 roku: 34 821 zamówień, 25 708 369,94 zł.
5. Zamówienia z udaną płatnością mają status DELIVERED (696 926) albo RETURNED (26 495), żadne nie jest CANCELLED.
Księgowość ujmuje przychód brutto w miesiącu złożenia zamówienia, a zwroty księguje osobno.
Napisz poprawioną wersję raportu. Dodaj też zapytanie, które sprawdzi, czy różnica między starym a nowym raportem jest w całości wyjaśniona przez zamówienia z dwiema płatnościami.
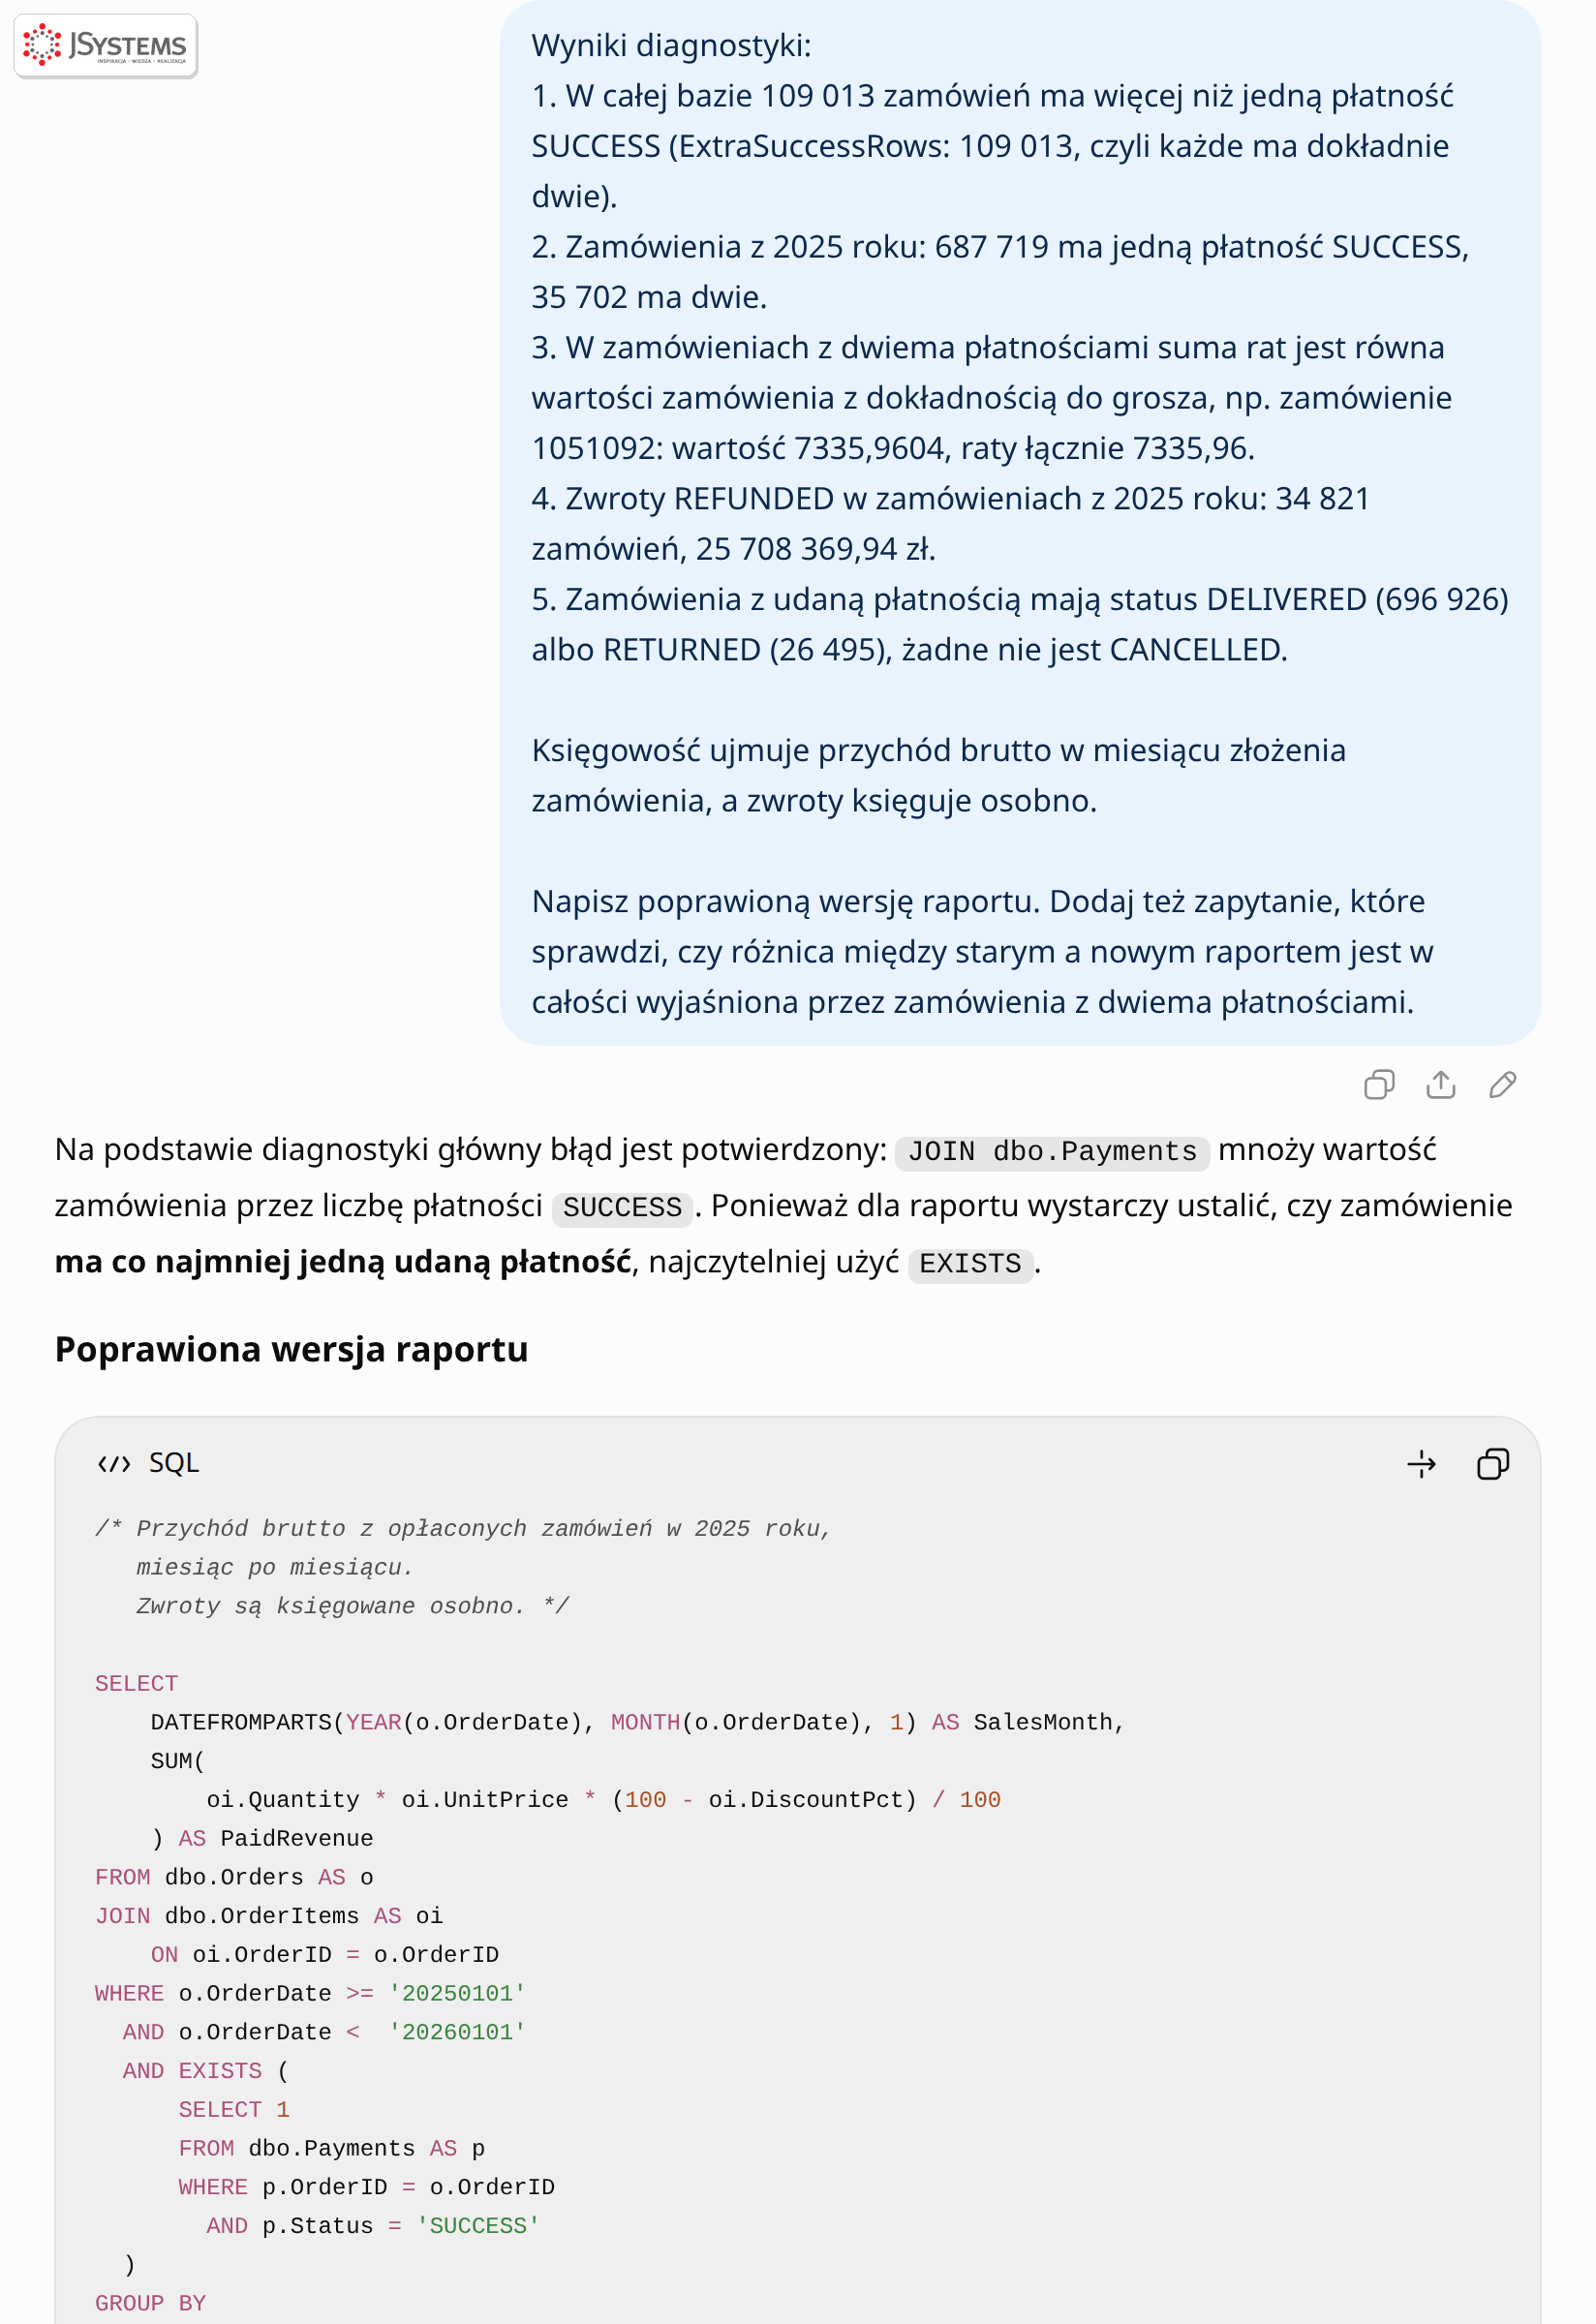
/* Przychód brutto z opłaconych zamówień w 2025 roku,
   miesiąc po miesiącu.
   Zwroty są księgowane osobno. */

SELECT
    DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1) AS SalesMonth,
    SUM(
        oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100
    ) AS PaidRevenue
FROM dbo.Orders AS o
JOIN dbo.OrderItems AS oi
    ON oi.OrderID = o.OrderID
WHERE o.OrderDate >= '20250101'
  AND o.OrderDate <  '20260101'
  AND EXISTS (
      SELECT 1
      FROM dbo.Payments AS p
      WHERE p.OrderID = o.OrderID
        AND p.Status = 'SUCCESS'
  )
GROUP BY
    DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1)
ORDER BY
    SalesMonth;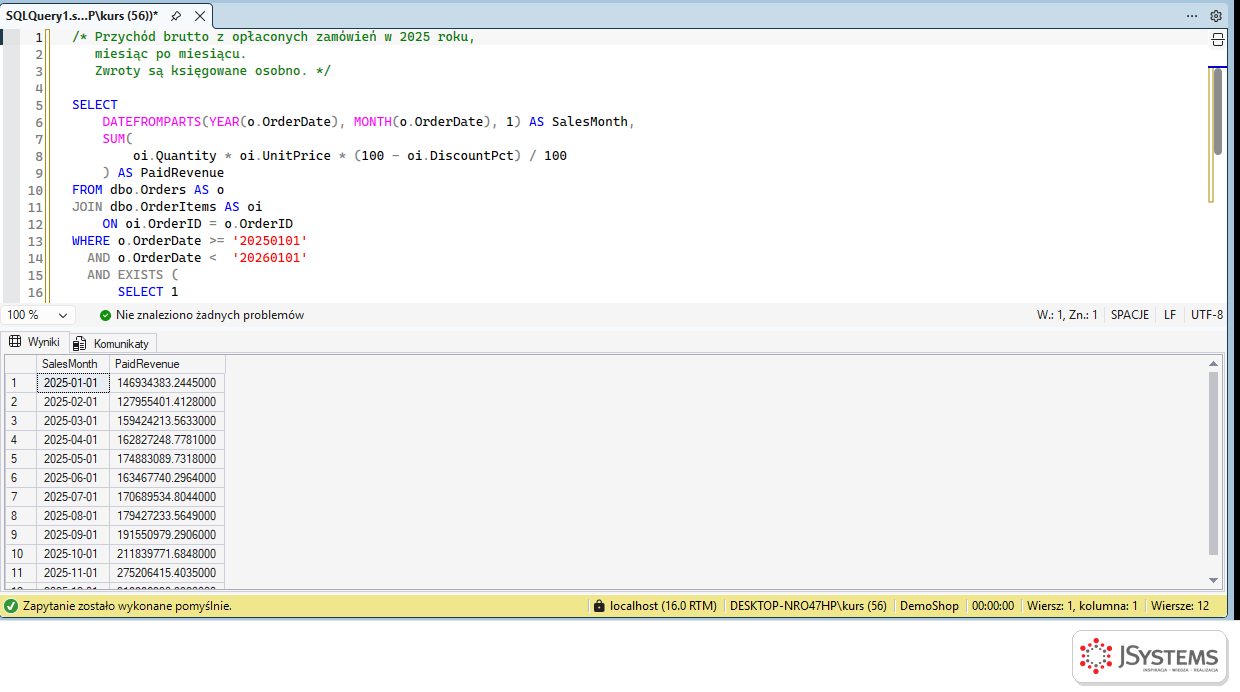
Druga część odpowiedzi to zapytanie, które ma udowodnić, że cała różnica pochodzi z drugich płatności. Uruchomione daje zero niewyjaśnionej różnicy w każdym miesiącu. Wygląda to jak dowód, ale nim nie jest. Zapytanie nie uruchamia starego raportu, tylko odtwarza go wzorem „wartość zamówienia razy liczba płatności”. Różnica między takim „starym raportem” a nowym jest wtedy z definicji równa wartości drugich płatności, więc kolumna UnexplainedDifference wyjdzie zerowa dla każdych danych, nawet gdyby stary raport zawyżało coś jeszcze.
WITH PaymentCounts AS (
    SELECT
        p.OrderID,
        COUNT(*) AS SuccessCount
    FROM dbo.Payments AS p
    WHERE p.Status = 'SUCCESS'
    GROUP BY p.OrderID
),
OrderValues AS (
    SELECT
        o.OrderID,
        DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1) AS SalesMonth,
        SUM(
            oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100
        ) AS OrderValue
    FROM dbo.Orders AS o
    JOIN dbo.OrderItems AS oi
        ON oi.OrderID = o.OrderID
    WHERE o.OrderDate >= '20250101'
      AND o.OrderDate <  '20260101'
    GROUP BY
        o.OrderID,
        DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1)
),
CheckDiff AS (
    SELECT
        ov.SalesMonth,

        /* Tak zachowywał się stary JOIN:
           wartość zamówienia * liczba SUCCESS */
        SUM(ov.OrderValue * pc.SuccessCount) AS OldRevenue,

        /* Poprawny wynik: każde opłacone zamówienie raz */
        SUM(ov.OrderValue) AS NewRevenue,

        /* Nadwyżka przewidywana wyłącznie przez dodatkowy SUCCESS */
        SUM(ov.OrderValue * (pc.SuccessCount - 1)) AS
            ExpectedDuplicatePaymentOverstatement
    FROM OrderValues AS ov
    JOIN PaymentCounts AS pc
        ON pc.OrderID = ov.OrderID
    GROUP BY ov.SalesMonth
)
SELECT
    SalesMonth,
    OldRevenue,
    NewRevenue,
    OldRevenue - NewRevenue AS ActualDifference,
    ExpectedDuplicatePaymentOverstatement,
    (OldRevenue - NewRevenue)
        - ExpectedDuplicatePaymentOverstatement AS UnexplainedDifference
FROM CheckDiff
ORDER BY SalesMonth;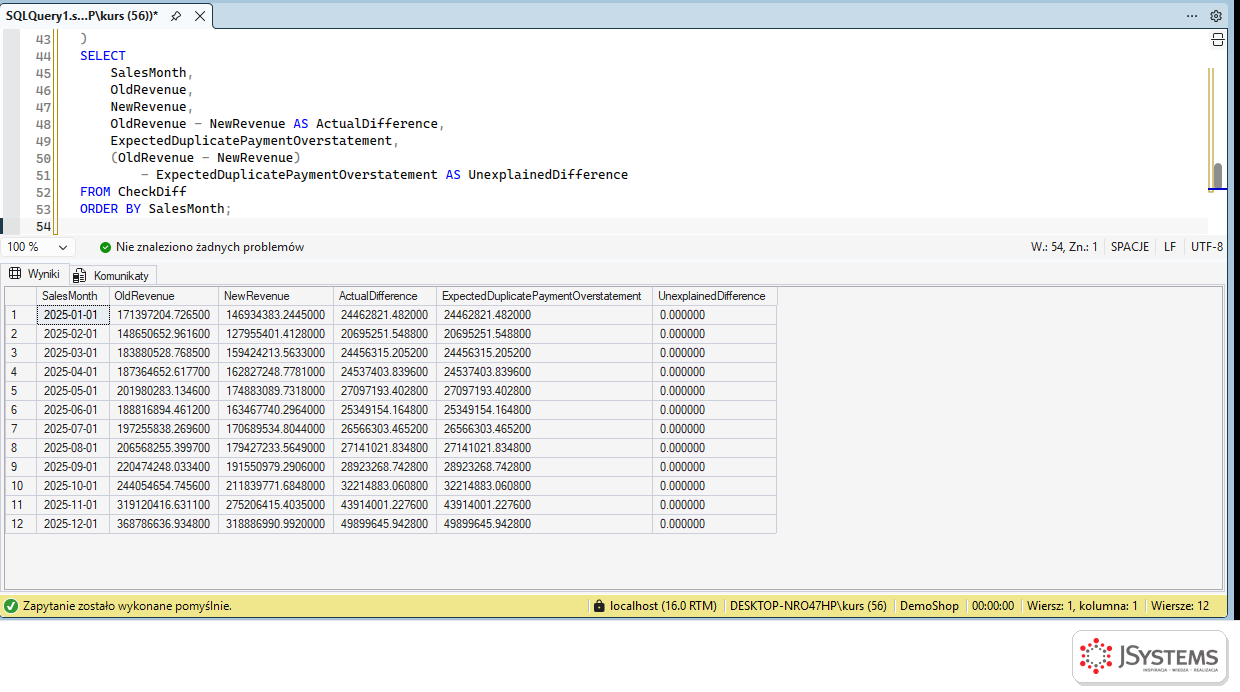
Niezależna kontrola musi porównać rzeczywiste wyniki obu raportów z czymś, co policzono inną drogą. Wstawiamy oba raporty bez zmian do CTE i odejmujemy od ich różnicy wartość zamówień z dokładnie dwiema płatnościami, policzoną osobnym zapytaniem:
/* Niezależna kontrola: rzeczywisty stary raport minus nowy raport,
   porównane z wartością zamówień z dwiema płatnościami SUCCESS */
WITH Stary AS ( /* stary raport bez ORDER BY */ ),
Nowy AS ( /* nowy raport bez ORDER BY */ ),
DwiePlatnosci AS (
    SELECT DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1) AS SalesMonth,
           SUM(oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100) AS DoublePaidValue
    FROM dbo.Orders AS o
    JOIN dbo.OrderItems AS oi ON oi.OrderID = o.OrderID
    WHERE o.OrderDate >= '20250101' AND o.OrderDate < '20260101'
      AND (SELECT COUNT(*) FROM dbo.Payments AS p
           WHERE p.OrderID = o.OrderID AND p.Status = 'SUCCESS') = 2
    GROUP BY DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1)
)
SELECT s.SalesMonth,
       s.PaidRevenue AS OldReport,
       n.PaidRevenue AS NewReport,
       s.PaidRevenue - n.PaidRevenue AS Difference,
       d.DoublePaidValue,
       s.PaidRevenue - n.PaidRevenue - d.DoublePaidValue AS Unexplained
FROM Stary AS s
JOIN Nowy AS n ON n.SalesMonth = s.SalesMonth
JOIN DwiePlatnosci AS d ON d.SalesMonth = s.SalesMonth
ORDER BY s.SalesMonth;
/* Niezależna kontrola: rzeczywisty stary raport minus nowy raport,
porównane z wartością zamówień z dwiema płatnościami SUCCESS */
WITH Stary AS (
SELECT DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1) AS SalesMonth,
SUM(oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100) AS PaidRevenue
FROM dbo.Orders AS o
JOIN dbo.Payments AS p ON p.OrderID = o.OrderID
AND p.Status = 'SUCCESS'
JOIN dbo.OrderItems AS oi ON oi.OrderID = o.OrderID
WHERE o.OrderDate >= '20250101' AND o.OrderDate < '20260101'
GROUP BY DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1)
),
Nowy AS (
SELECT
DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1) AS SalesMonth,
SUM(
oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100
) AS PaidRevenue
FROM dbo.Orders AS o
JOIN dbo.OrderItems AS oi
ON oi.OrderID = o.OrderID
WHERE o.OrderDate >= '20250101'
AND o.OrderDate < '20260101'
AND EXISTS (
SELECT 1
FROM dbo.Payments AS p
WHERE p.OrderID = o.OrderID
AND p.Status = 'SUCCESS'
)
GROUP BY
DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1)
),
DwiePlatnosci AS (
SELECT DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1) AS SalesMonth,
SUM(oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100) AS DoublePaidValue
FROM dbo.Orders AS o
JOIN dbo.OrderItems AS oi ON oi.OrderID = o.OrderID
WHERE o.OrderDate >= '20250101' AND o.OrderDate < '20260101'
AND (SELECT COUNT(*) FROM dbo.Payments AS p
WHERE p.OrderID = o.OrderID AND p.Status = 'SUCCESS') = 2
GROUP BY DATEFROMPARTS(YEAR(o.OrderDate), MONTH(o.OrderDate), 1)
)
SELECT s.SalesMonth,
s.PaidRevenue AS OldReport,
n.PaidRevenue AS NewReport,
s.PaidRevenue - n.PaidRevenue AS Difference,
d.DoublePaidValue,
s.PaidRevenue - n.PaidRevenue - d.DoublePaidValue AS Unexplained
FROM Stary AS s
JOIN Nowy AS n ON n.SalesMonth = s.SalesMonth
JOIN DwiePlatnosci AS d ON d.SalesMonth = s.SalesMonth
ORDER BY s.SalesMonth;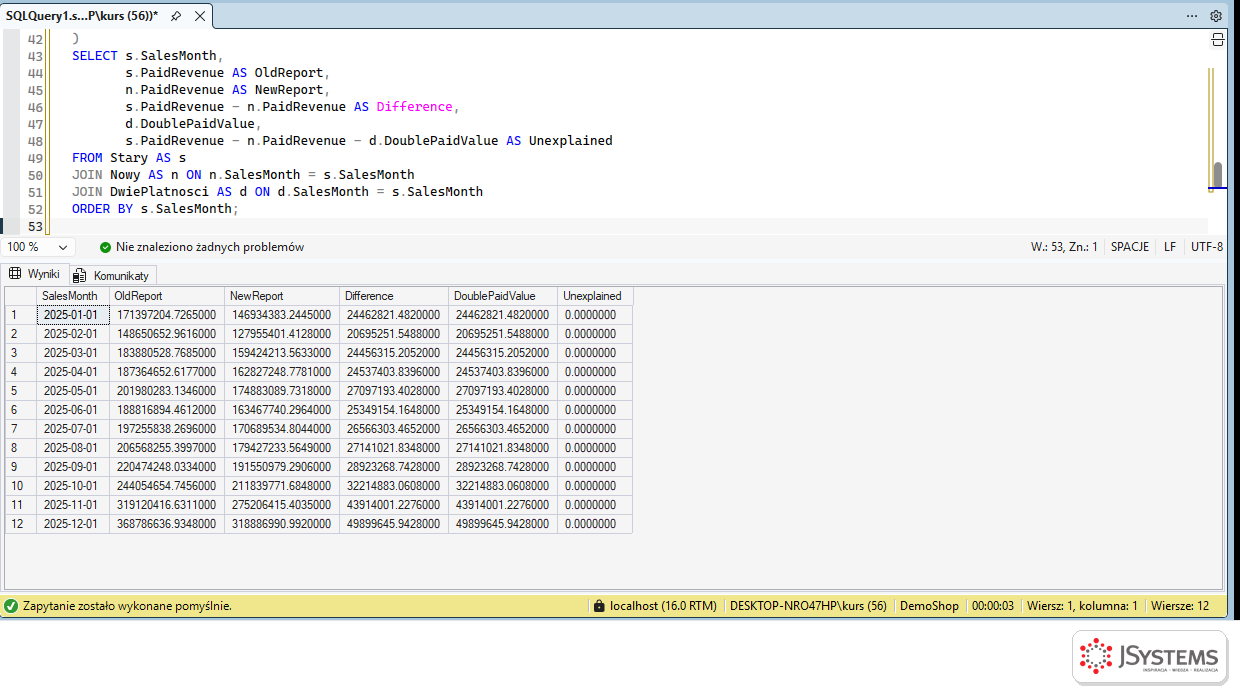
Co AI zrobiło w tym studium dobrze: trafnie uszeregowało hipotezy, do każdej dało działające zapytanie diagnostyczne, a poprawka (EXISTS zamiast złączenia) jest prosta i poprawna. Na naszą prośbę nie skorygowało zapytania od razu, więc nie „naprawiło” zwrotów ani statusów, które okazały się fałszywym tropem. Czego AI nie zrobiło: nie znało reguły księgowej (musieliśmy ją podać) i zaproponowało kontrolę, która niczego nie sprawdza. Ten drugi punkt warto zapamiętać na zawsze: zapytanie weryfikujące musi liczyć stronę porównawczą inną drogą niż sprawdzane zapytanie. Jeśli obie strony wynikają z tego samego wzoru, zgodność jest gwarantowana i nic nie dowodzi.
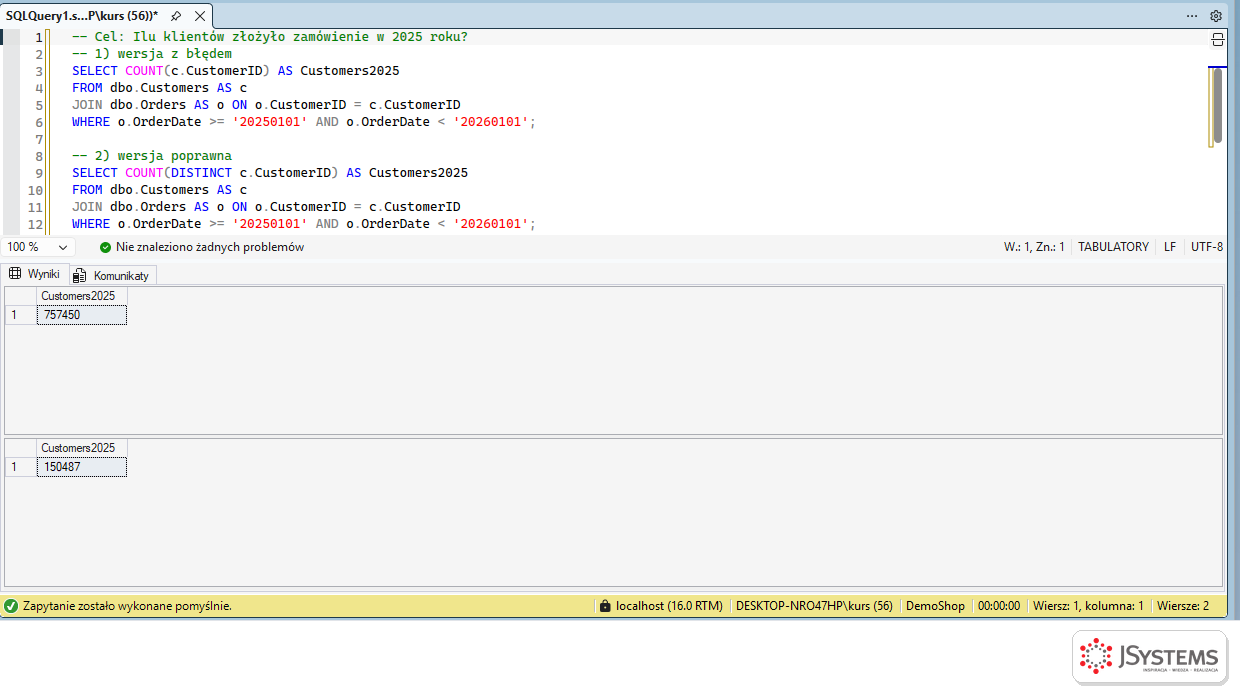
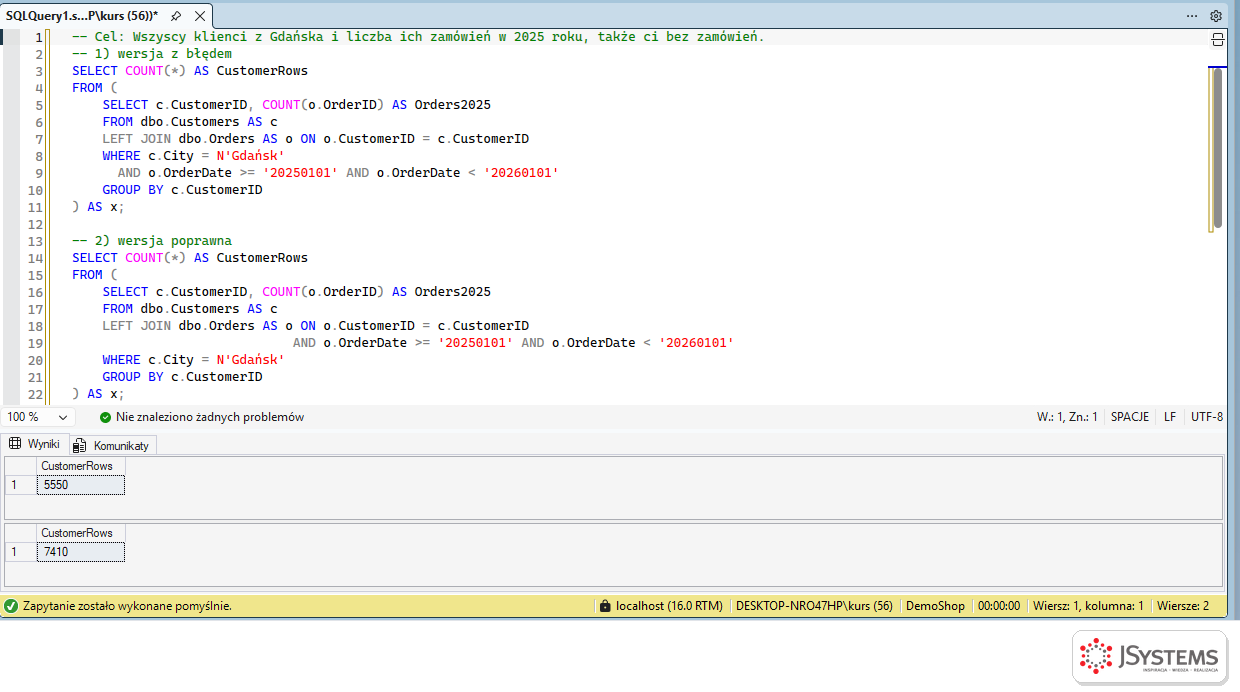
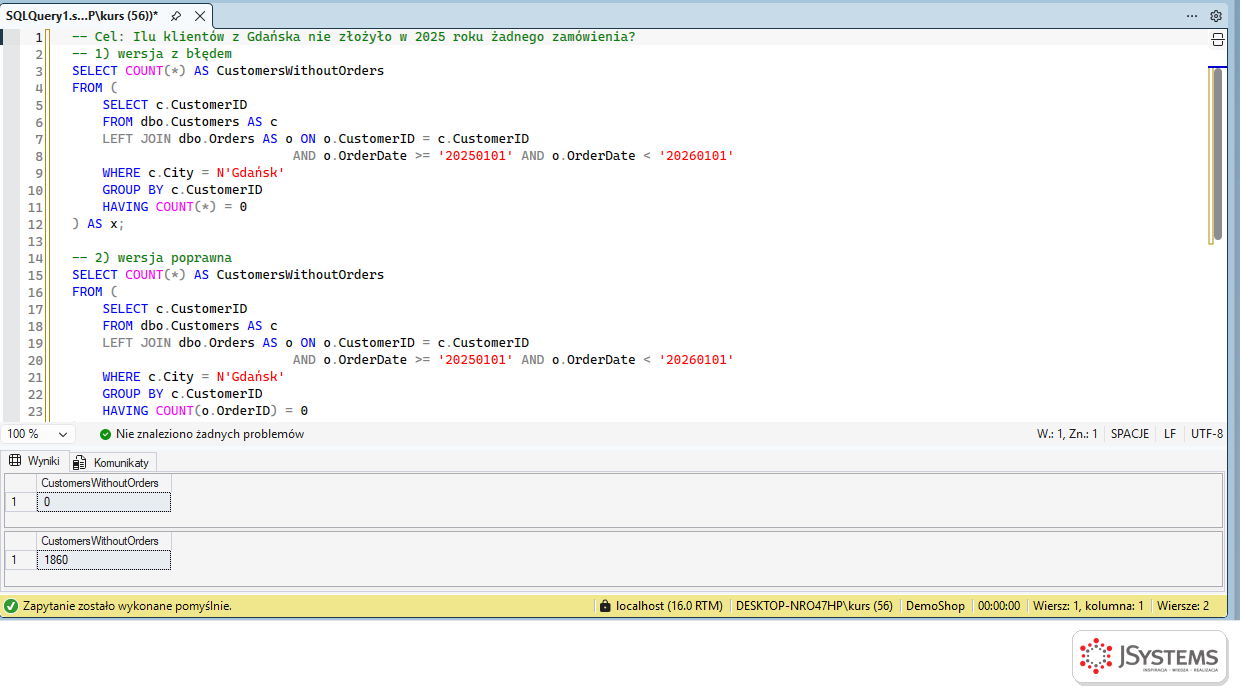
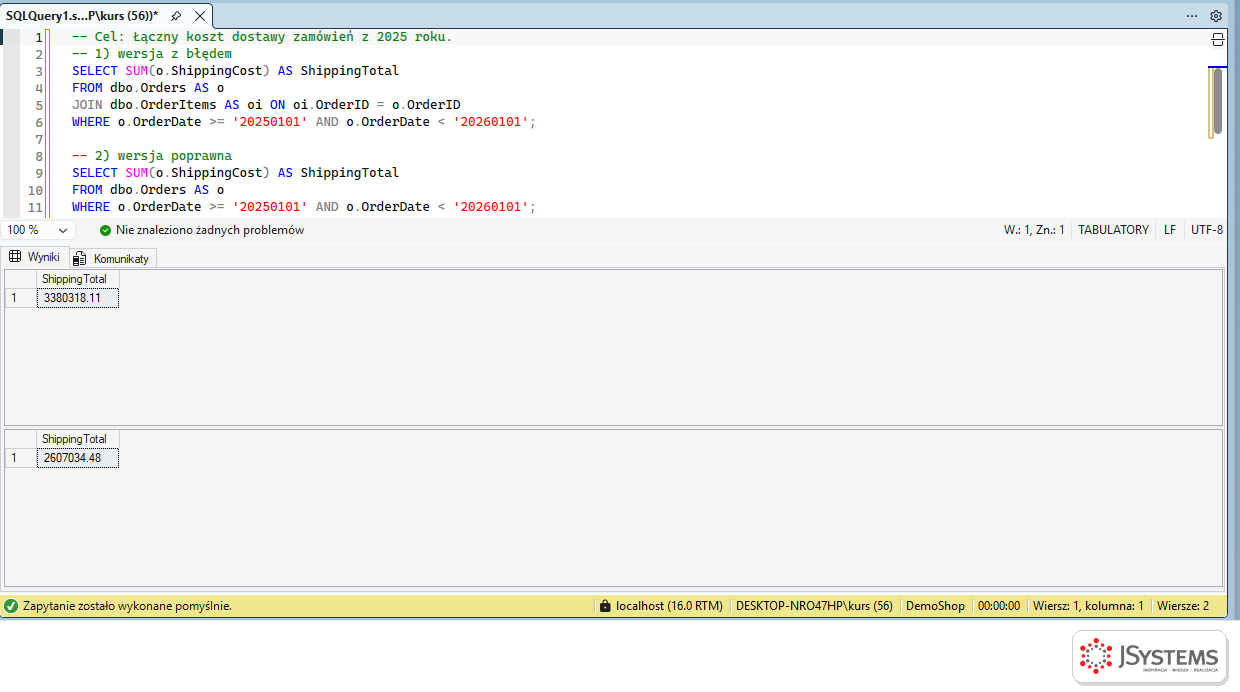
Każdy z dwudziestu błędów poniżej ma tę samą anatomię: zapytanie wykonuje się bez żadnego komunikatu i zwraca liczbę, która wygląda wiarygodnie, ale jest zła. Do każdego przygotowaliśmy parę zapytań, wersję z błędem i wersję poprawną, uruchomiliśmy obie w SSMS w jednym oknie (zrzut pokazuje oba wyniki jeden pod drugim) i zapisaliśmy prawdziwe liczby z DemoShop. Wszystkie 20 par są do pobrania w pliku bledy_logiczne_20.sql.
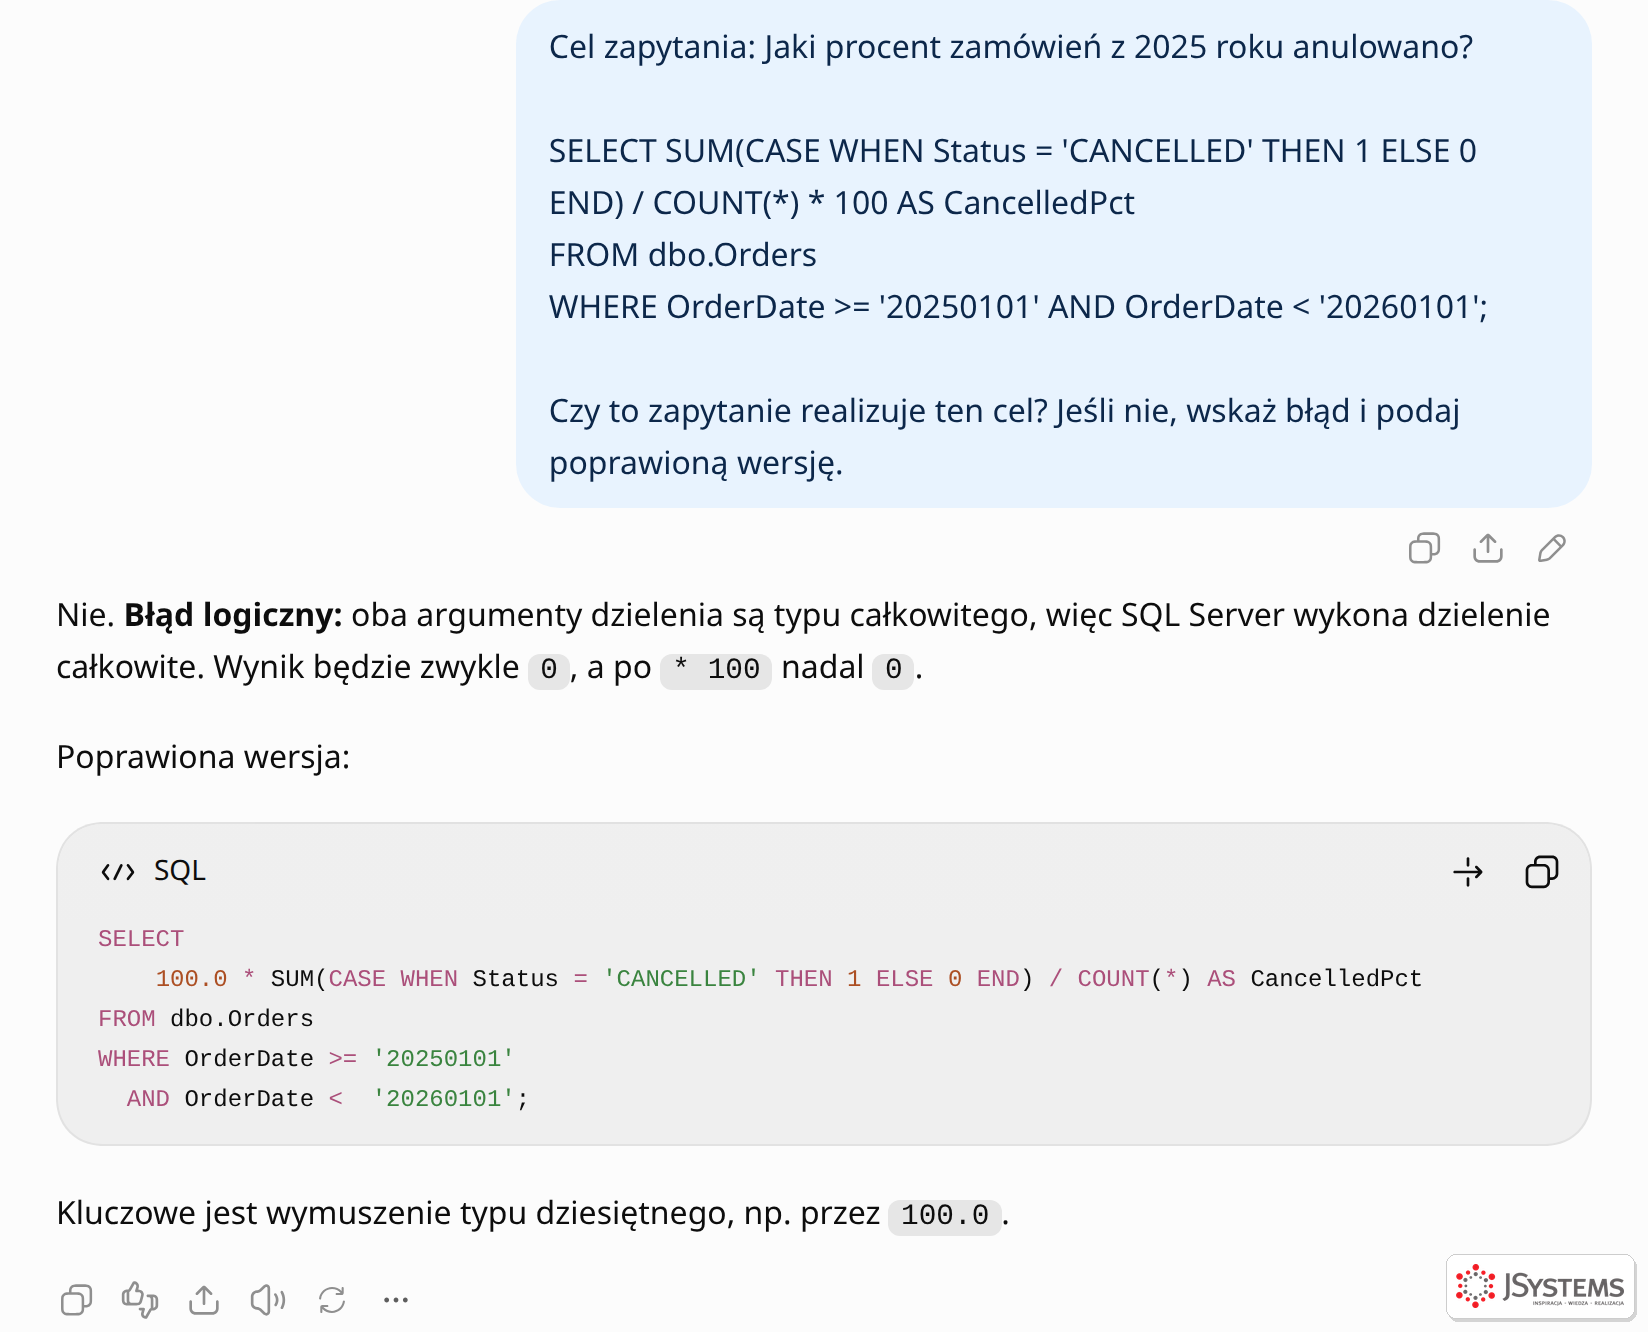
Potem w jednej rozmowie daliśmy ChatGPT po kolei cel biznesowy i wersję z błędem, bez podpowiedzi, czego szukać. Pierwsza wiadomość zawierała opis schematu i zasadę odpowiadania, kolejne miały stały układ:
Cel zapytania: [cel biznesowy jednym zdaniem]
[zapytanie]
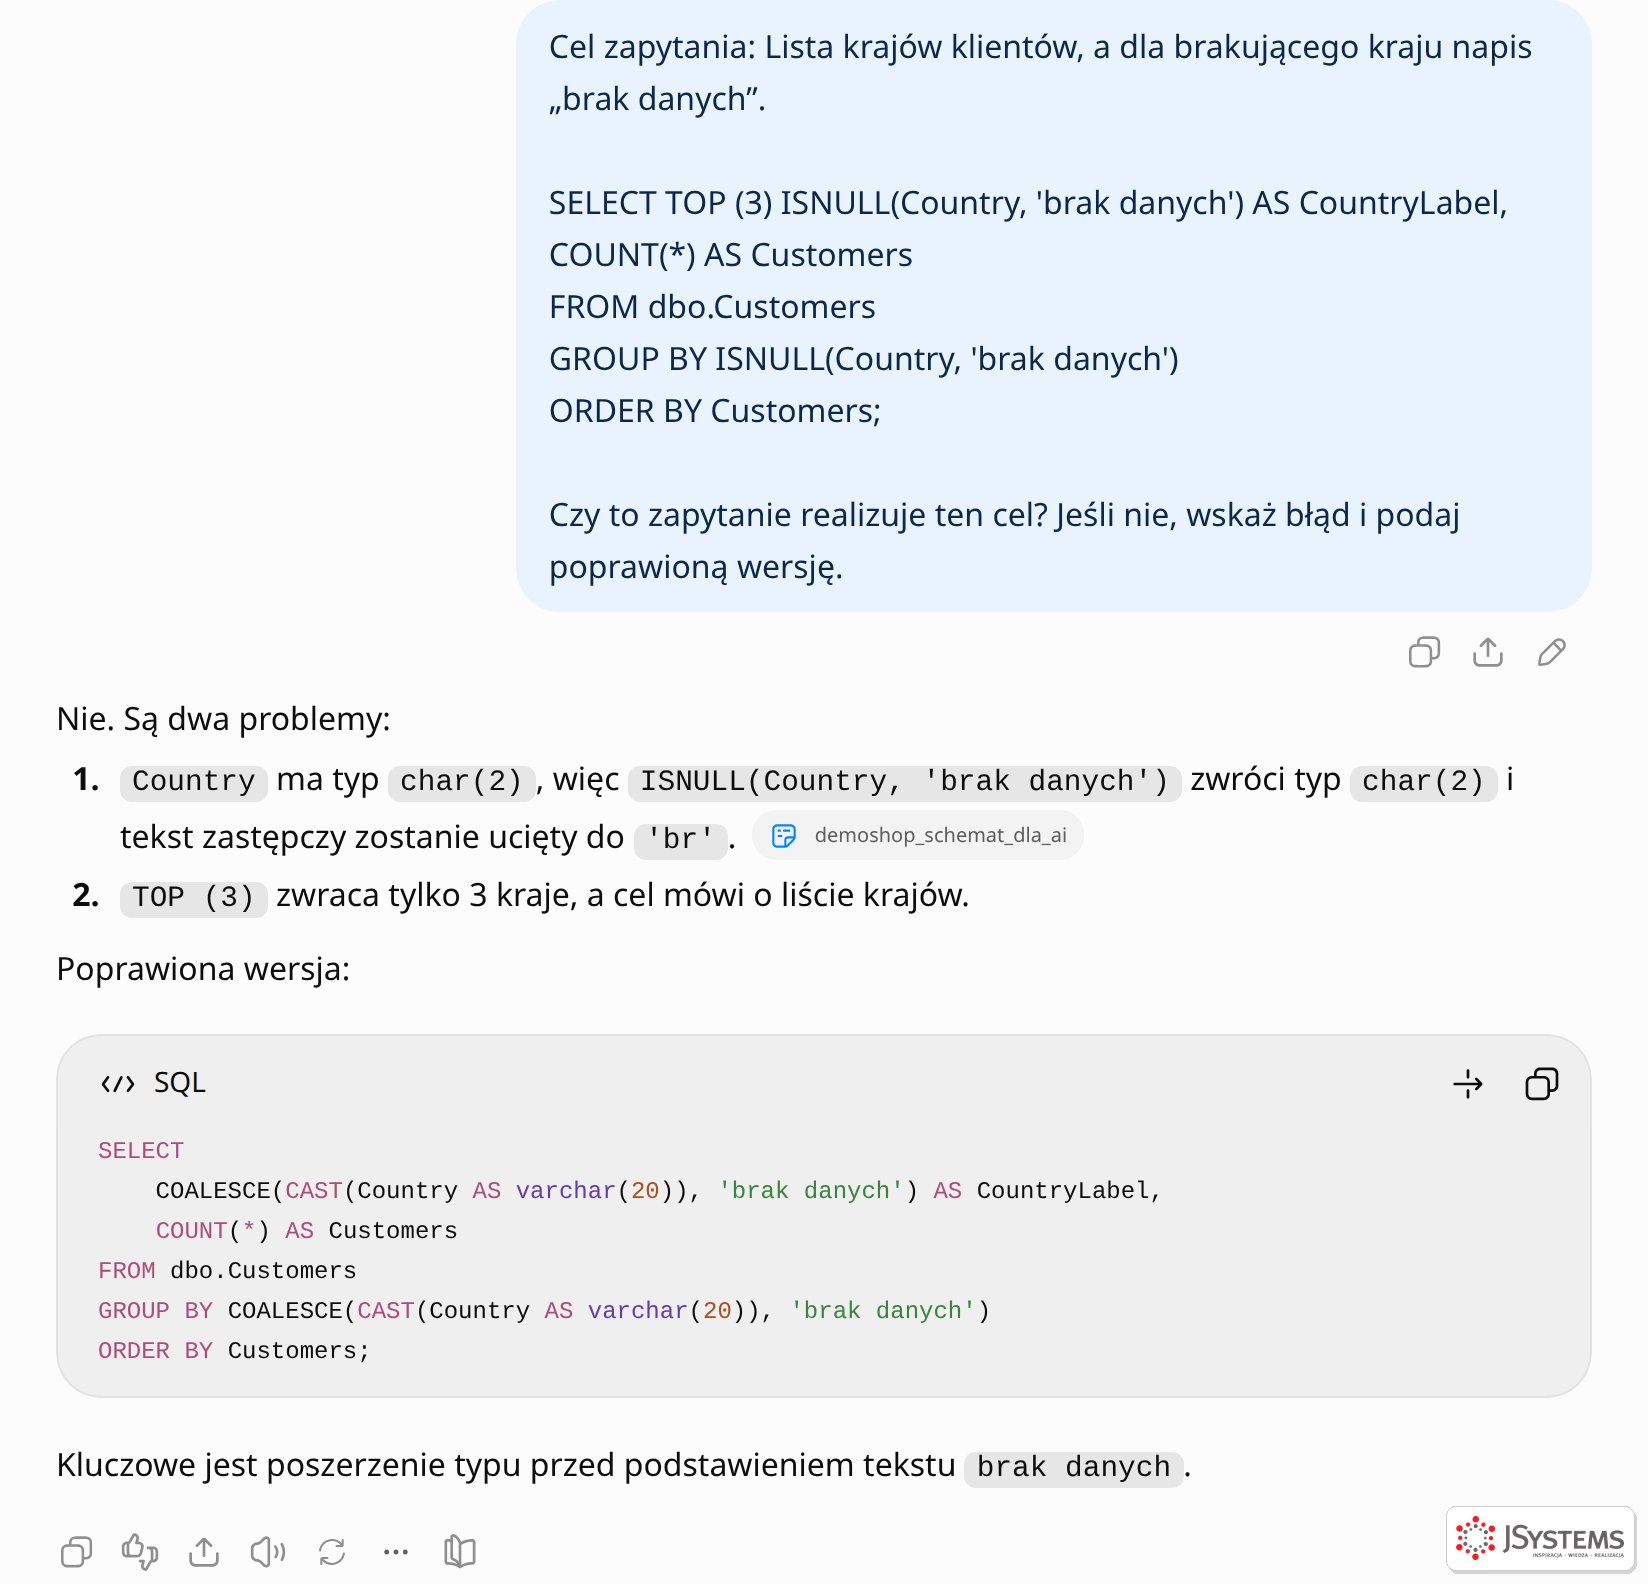
Czy to zapytanie realizuje ten cel? Jeśli nie, wskaż błąd i podaj poprawioną wersję.
Wynik: w 19 przypadkach na 20 ChatGPT wskazał dokładnie ten błąd, który zaszyliśmy. Każdą z tych 19 poprawek uruchomiliśmy i każda dała ten sam wynik co nasza wersja poprawna (w przypadku nr 2 zamiast liczby listę 7 410 klientów, czyli dokładnie to, o co prosił cel). W jednym przypadku (błąd 11) zrozumiał cel inaczej, niż zakładaliśmy, i odpowiedział na inne pytanie. Ten przypadek jest najciekawszy z całej listy.
| Nr | Błąd | Wynik z błędem | Wynik poprawny | AI |
|---|---|---|---|---|
| 1 | JOIN zwielokrotnia wiersze | 757 450 | 150 487 | wykrył |
| 2 | Warunek z LEFT JOIN w WHERE | 5 550 | 7 410 | wykrył |
| 3 | COUNT(*) po LEFT JOIN | 0 | 1 860 | wykrył |
| 4 | NULL w porównaniu | 39 871 | 749 654 | wykrył |
| 5 | NOT IN z NULL w podzapytaniu | 0 | 24 | wykrył |
| 6 | SUM(DISTINCT) | 196 064,36 | 5 108 720,66 | wykrył |
| 7 | UNION zamiast UNION ALL | 102 645 885,53 | 105 772 529,64 | wykrył |
| 8 | Granica zakresu dat | 754 197 | 757 450 | wykrył |
| 9 | BETWEEN na przedziałach | 2 062 030 wierszy | 2 052 953 wiersze | wykrył |
| 10 | Strefa czasowa | 6 596 770,28 | 6 752 338,49 | wykrył |
| 11 | Zduplikowane konta klientów | 150 487 | 150 171 | inna interpretacja |
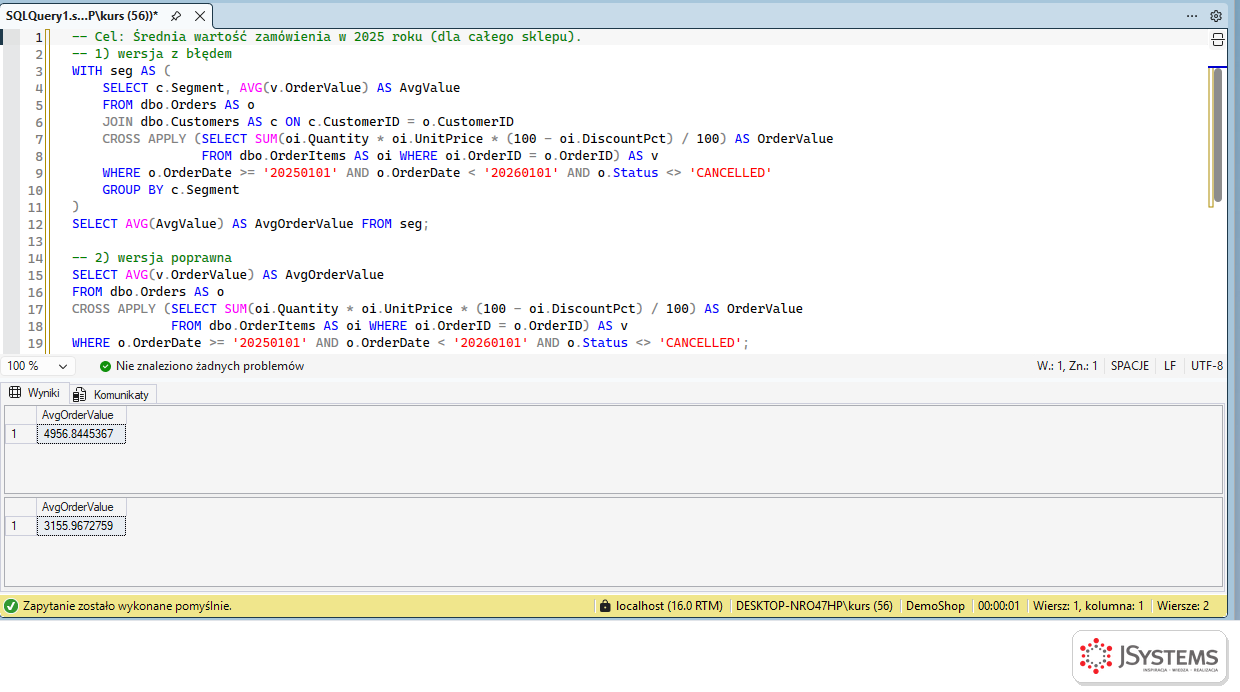
| 12 | Średnia ze średnich | 4 956,84 | 3 155,97 | wykrył |
| 13 | Zły poziom szczegółowości | 3 380 318,11 | 2 607 034,48 | wykrył |
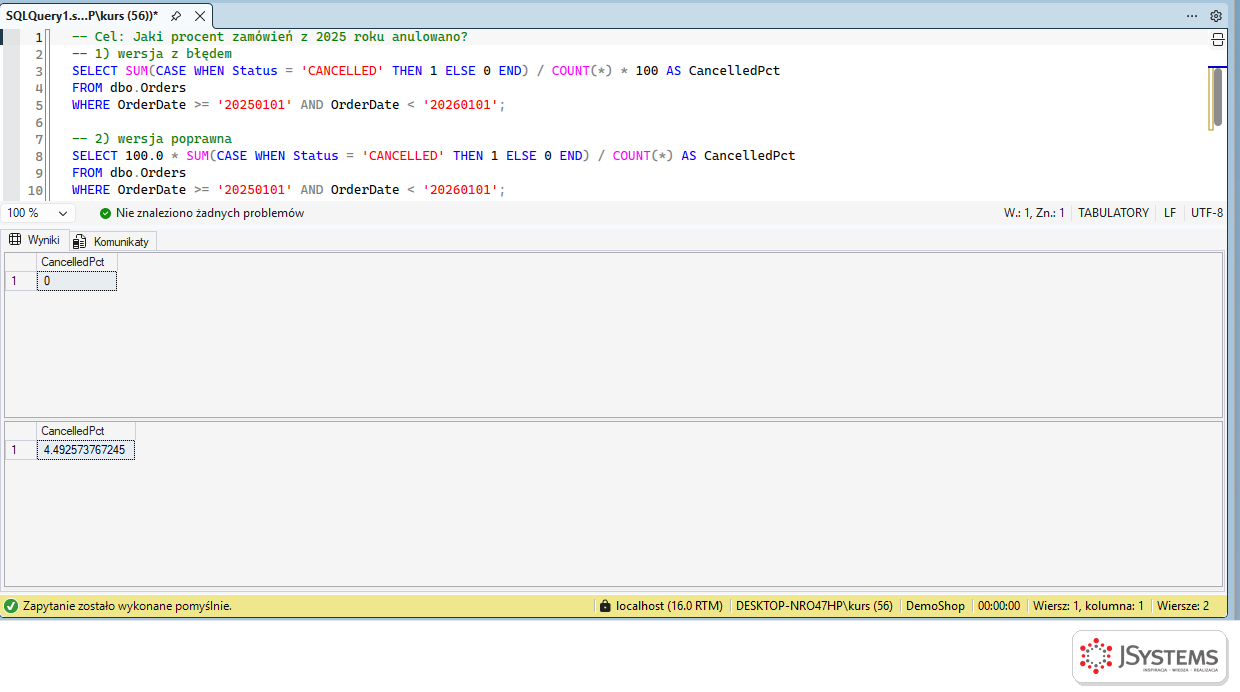
| 14 | Dzielenie całkowite | 0 | 4,49% | wykrył |
| 15 | LAST_VALUE bez ramki | data bieżącego zamówienia | data ostatniego zamówienia | wykrył |
| 16 | Zły PARTITION BY | 100% dla każdego | 9,61%, 5,35%... | wykrył |
| 17 | Domyślna ramka RANGE | 13 861 015,91 od pierwszej wpłaty | 714,76, 5 021,60... | wykrył |
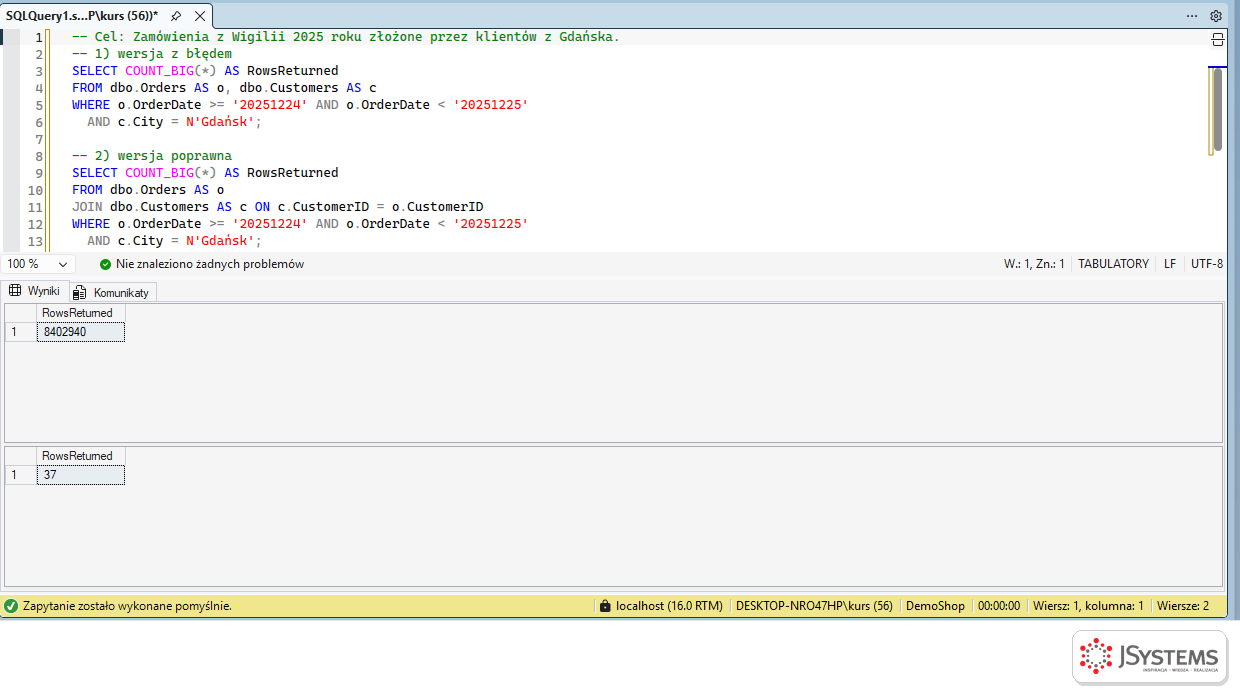
| 18 | Iloczyn kartezjański | 8 402 940 | 37 | wykrył |
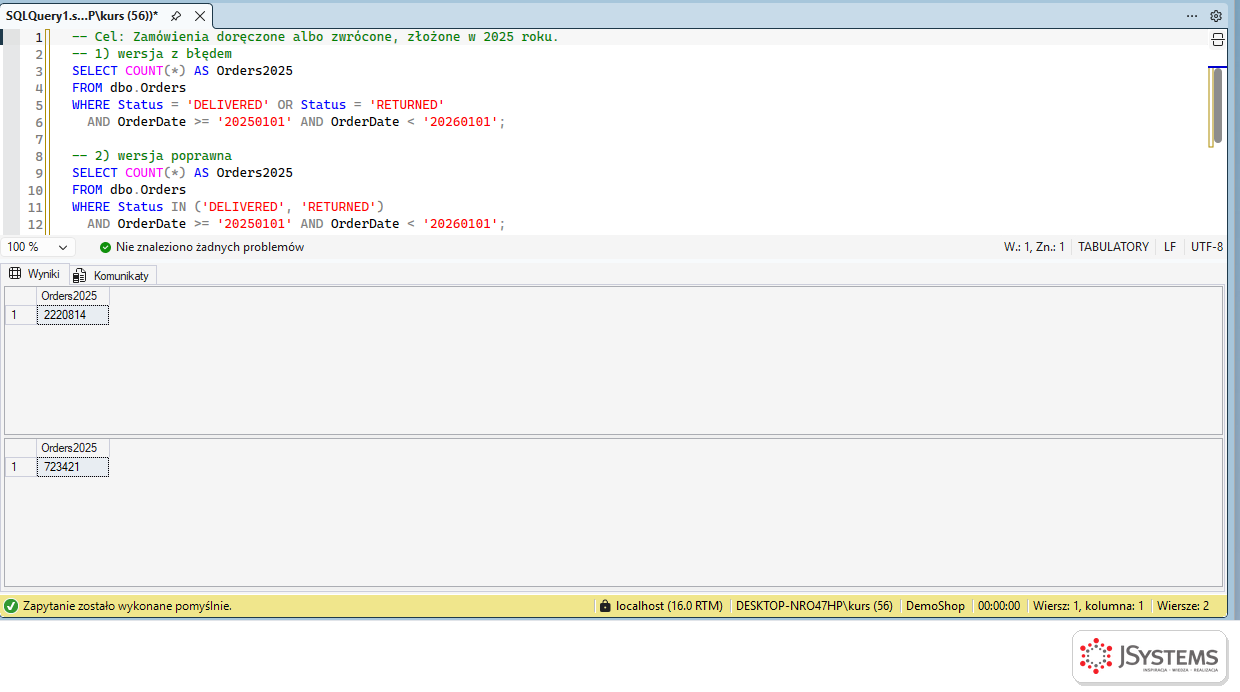
| 19 | AND i OR bez nawiasów | 2 220 814 | 723 421 | wykrył |
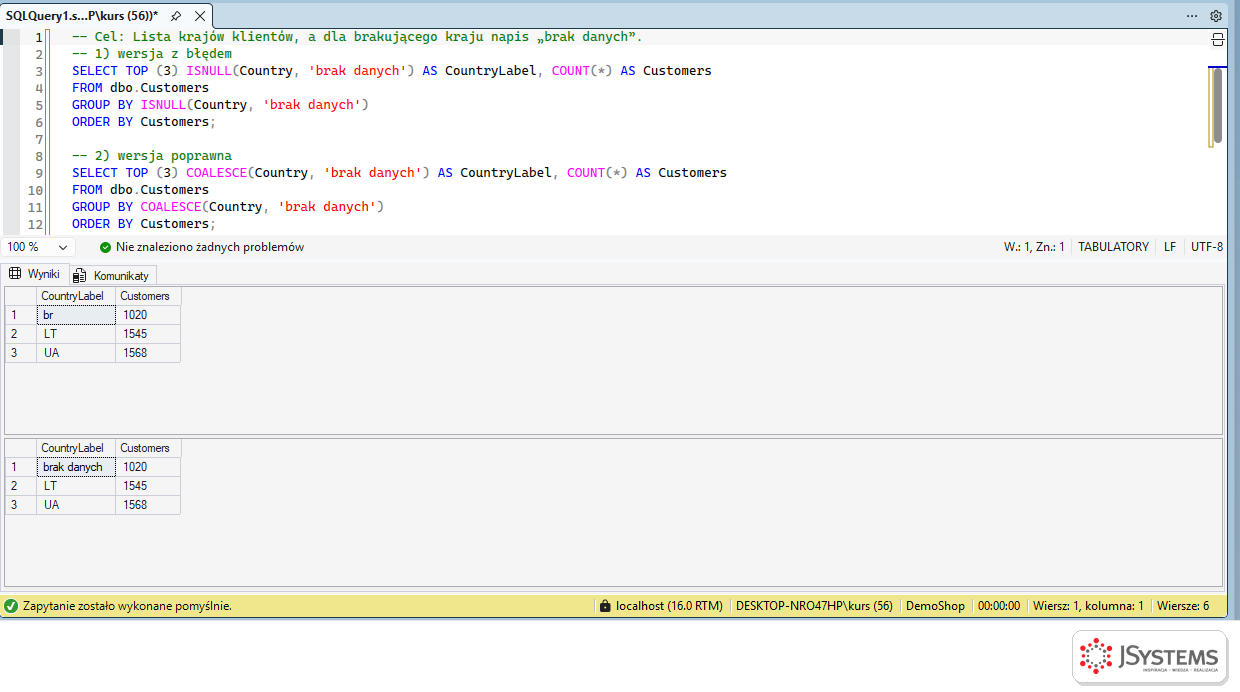
| 20 | ISNULL obcina tekst | „br” | „brak danych” | wykrył |
Cel: ilu klientów złożyło zamówienie w 2025 roku. Wersja z błędem łączy klientów z zamówieniami i liczy COUNT(c.CustomerID), więc klient z dziesięcioma zamówieniami liczy się dziesięć razy. Wynik 757 450 to w rzeczywistości liczba zamówień. Poprawnie: COUNT(DISTINCT c.CustomerID), czyli 150 487. ChatGPT dodał jeszcze uproszczenie: złączenie z Customers nie jest tu w ogóle potrzebne, bo CustomerID jest w tabeli zamówień.
Cel: wszyscy klienci z Gdańska z liczbą zamówień w 2025 roku, także ci bez zamówień. Warunek na dacie zamówienia w WHERE odrzuca wiersze, w których po złączeniu zewnętrznym kolumny zamówienia są puste, więc LEFT JOIN zachowuje się jak INNER JOIN. Znika 1 860 klientów: 5 550 zamiast 7 410. Warunek na tabeli dołączanej przez LEFT JOIN należy do ON.
Cel: ilu klientów z Gdańska nie złożyło w 2025 roku żadnego zamówienia. Wersja z błędem grupuje po kliencie i szuka grup z COUNT(*) = 0. Takich grup nie ma nigdy, bo LEFT JOIN zostawia dla klienta bez zamówień jeden wiersz z pustymi kolumnami zamówienia, a COUNT(*) liczy wiersze, nie zamówienia. Wynik 0 zamiast 1 860. Poprawnie: COUNT(o.OrderID), które pomija NULL.
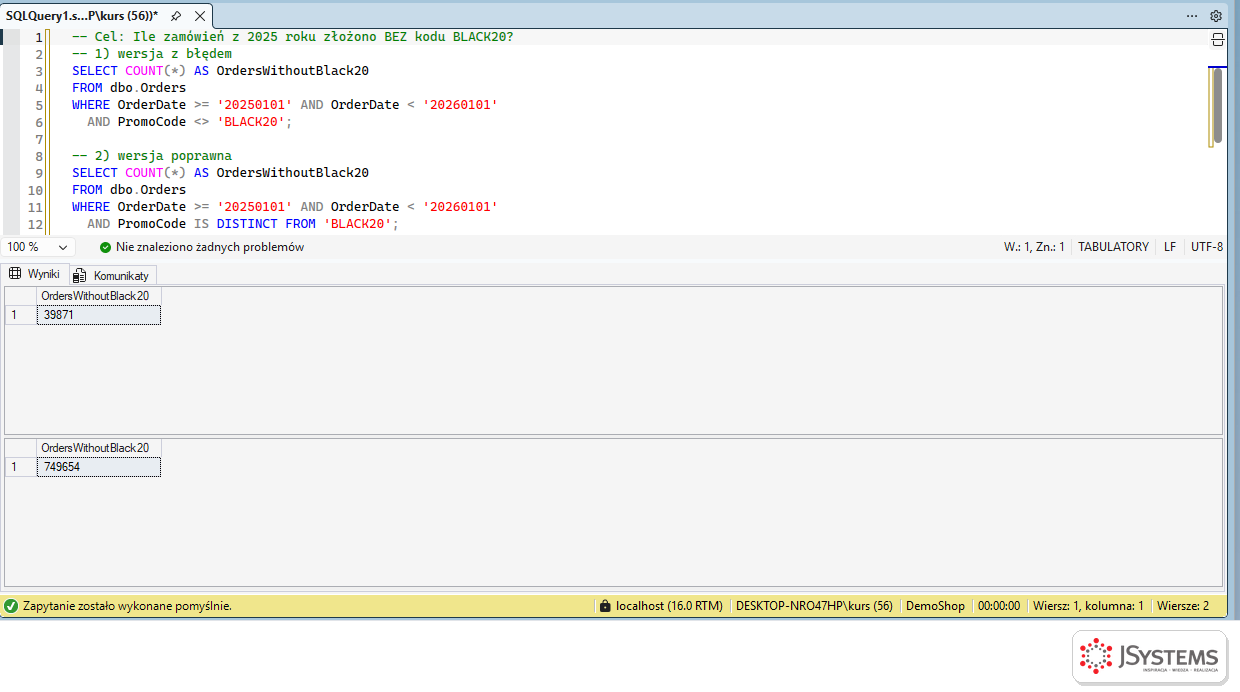
Cel: ile zamówień z 2025 roku złożono bez kodu BLACK20. Warunek PromoCode <> 'BLACK20' dla zamówień bez żadnego kodu (NULL) nie jest ani prawdziwy, ani fałszywy, tylko nieznany, więc wiersz odpada. Zostaje 39 871 zamówień z innymi kodami, a powinno być 749 654. W SQL Server 2022 najkrócej poprawić to przez PromoCode IS DISTINCT FROM 'BLACK20', we wcześniejszych wersjach przez (PromoCode <> 'BLACK20' OR PromoCode IS NULL).
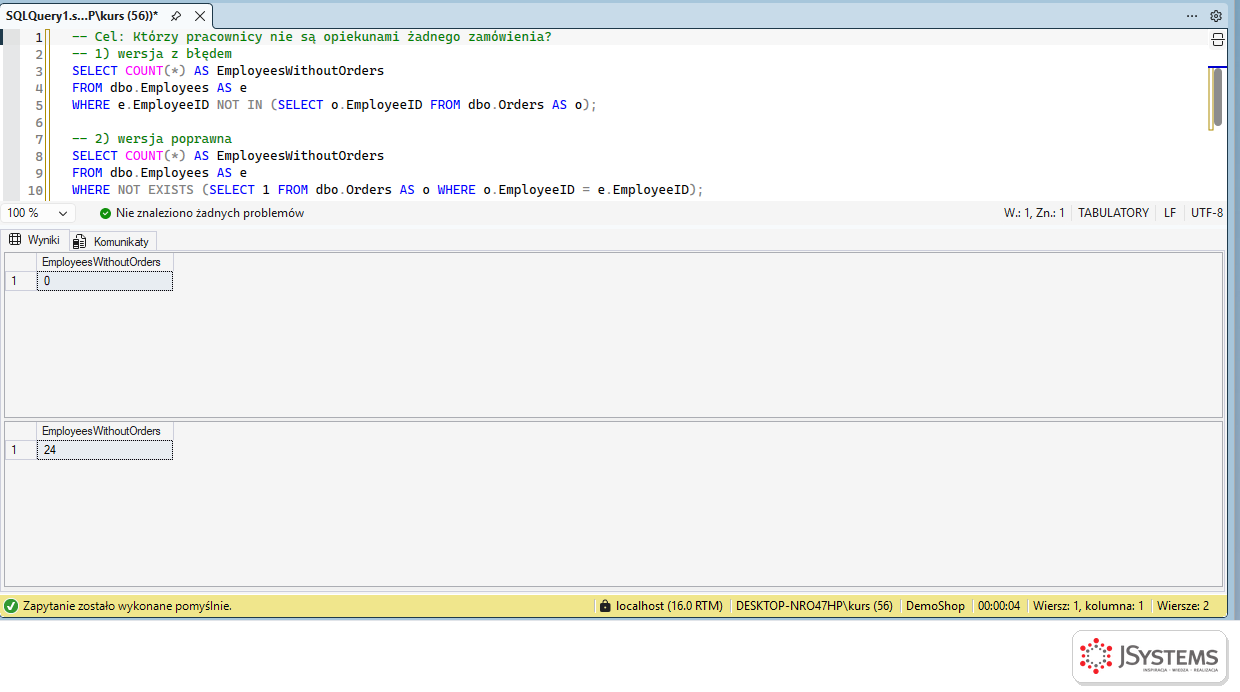
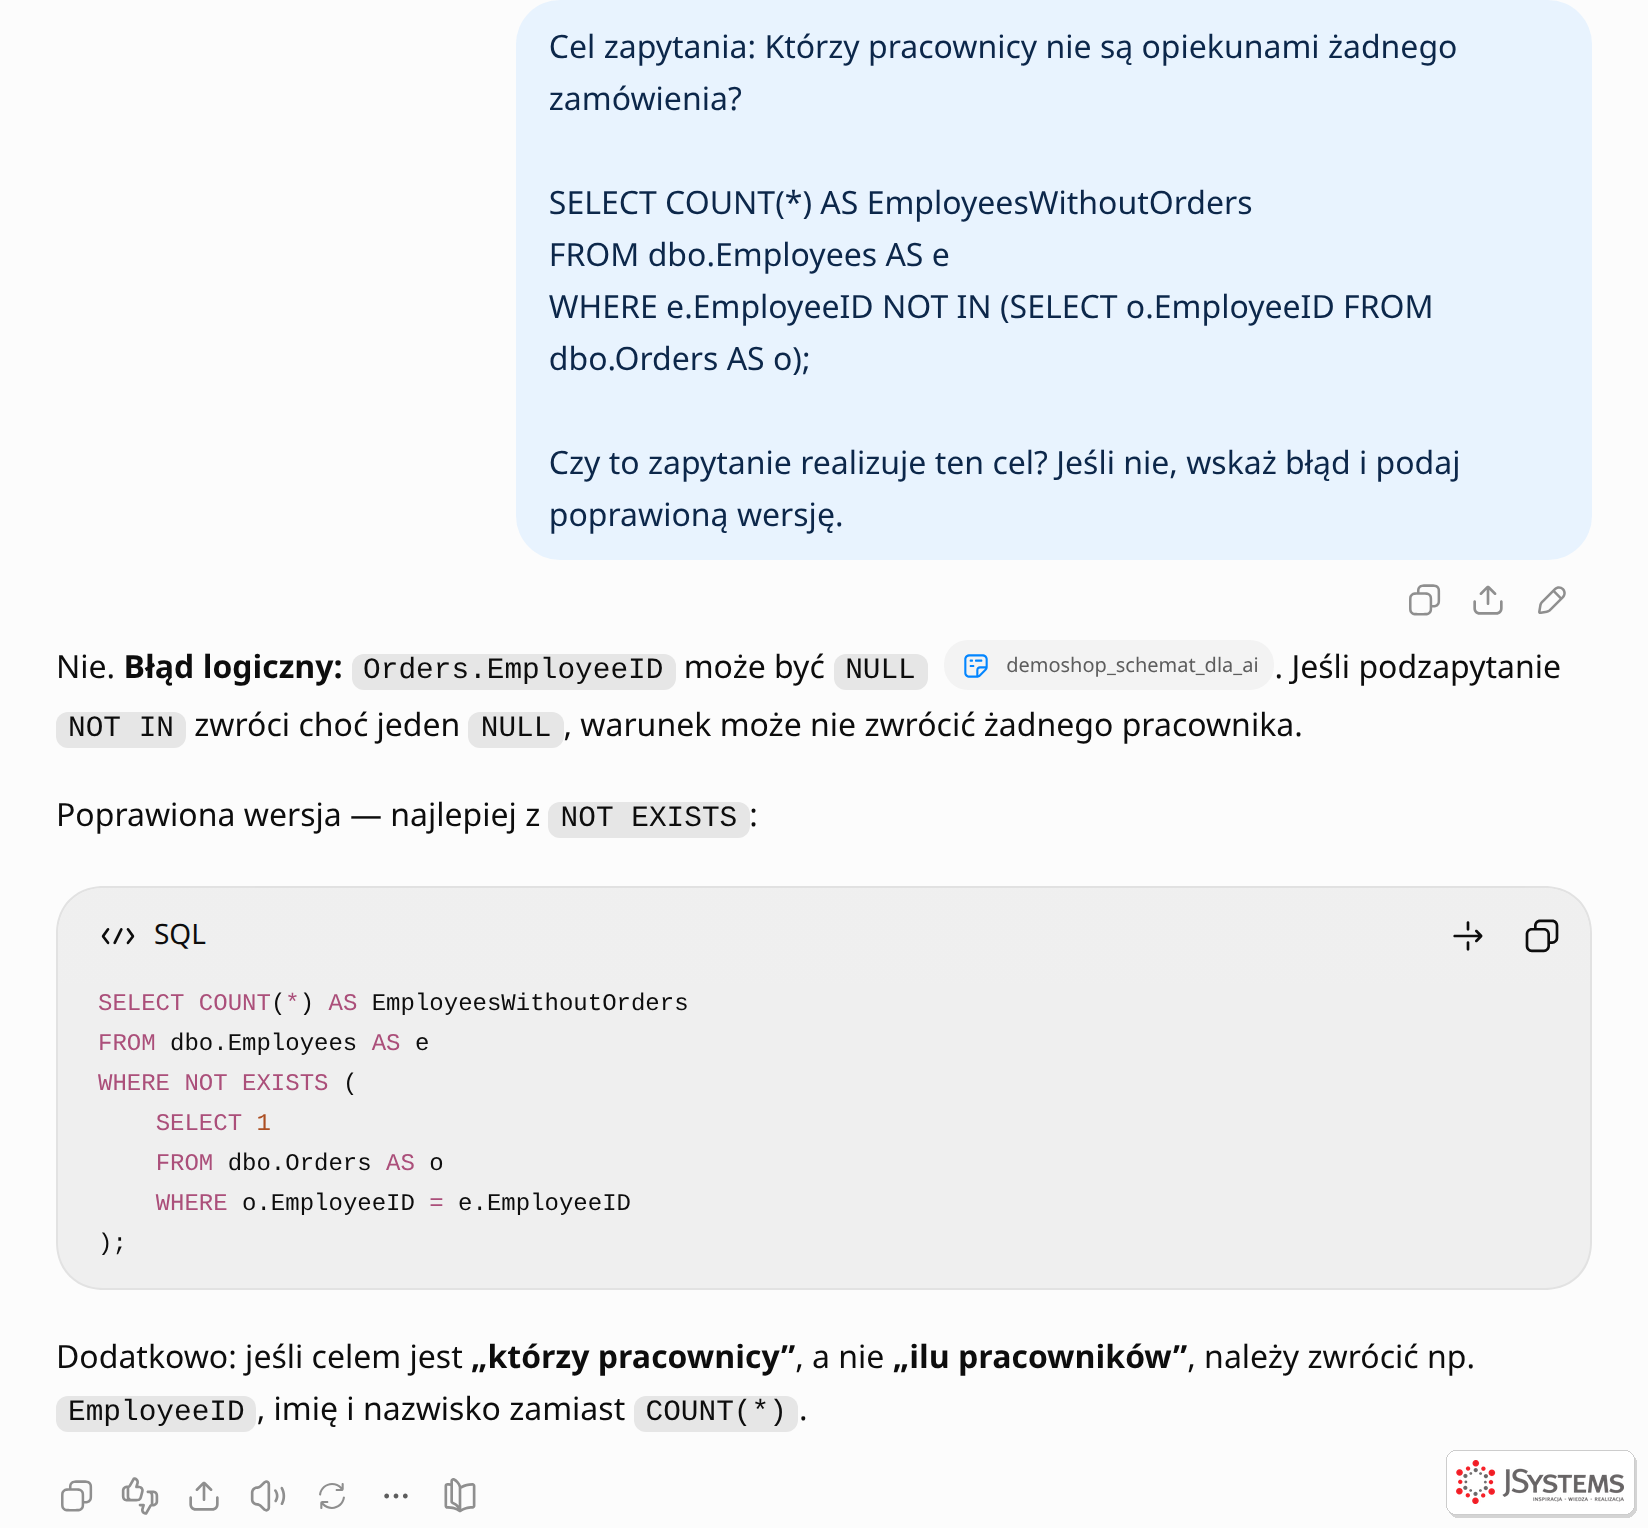
Cel: którzy pracownicy nie są opiekunami żadnego zamówienia. Orders.EmployeeID jest pusty dla zamówień klientów indywidualnych. Wystarczy jeden NULL w wyniku podzapytania, żeby NOT IN nie zwróciło niczego: 0 zamiast 24. NOT EXISTS nie ma tego problemu.
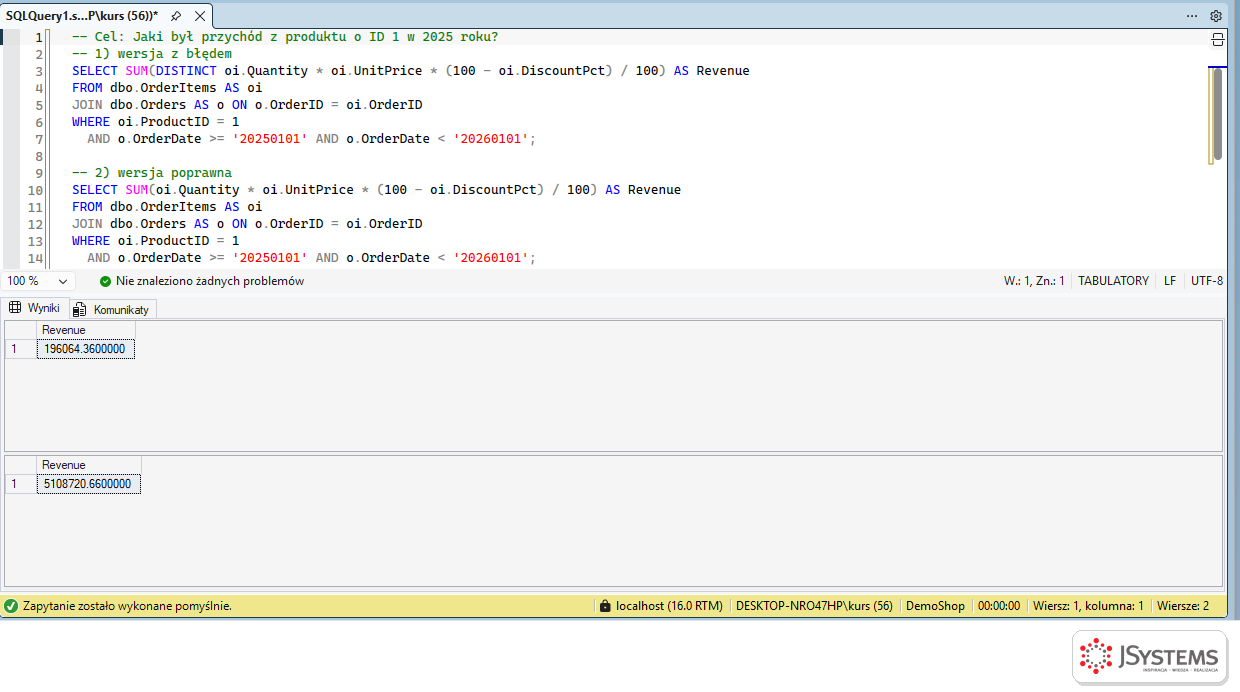
Cel: przychód z produktu o identyfikatorze 1 w 2025 roku. SUM(DISTINCT ...) sumuje tylko różne wartości pozycji, więc wszystkie pozycje o tej samej wartości (ta sama cena, ilość i rabat) liczą się raz. Wynik 196 064,36 zł zamiast 5 108 720,66 zł. DISTINCT w funkcji agregującej prawie zawsze jest błędem, chyba że naprawdę chcesz policzyć różne wartości.
Cel: suma udanych wpłat BLIK i kartą w grudniu 2025 roku. UNION usuwa powtarzające się wiersze, a wiersz to tu tylko dzień i kwota. Dwie różne wpłaty na tę samą kwotę tego samego dnia zlewają się w jedną. Brakuje 3 126 644,11 zł. UNION ALL zachowuje wszystkie wiersze i jest przy okazji szybszy, bo nie musi sortować ani porównywać.
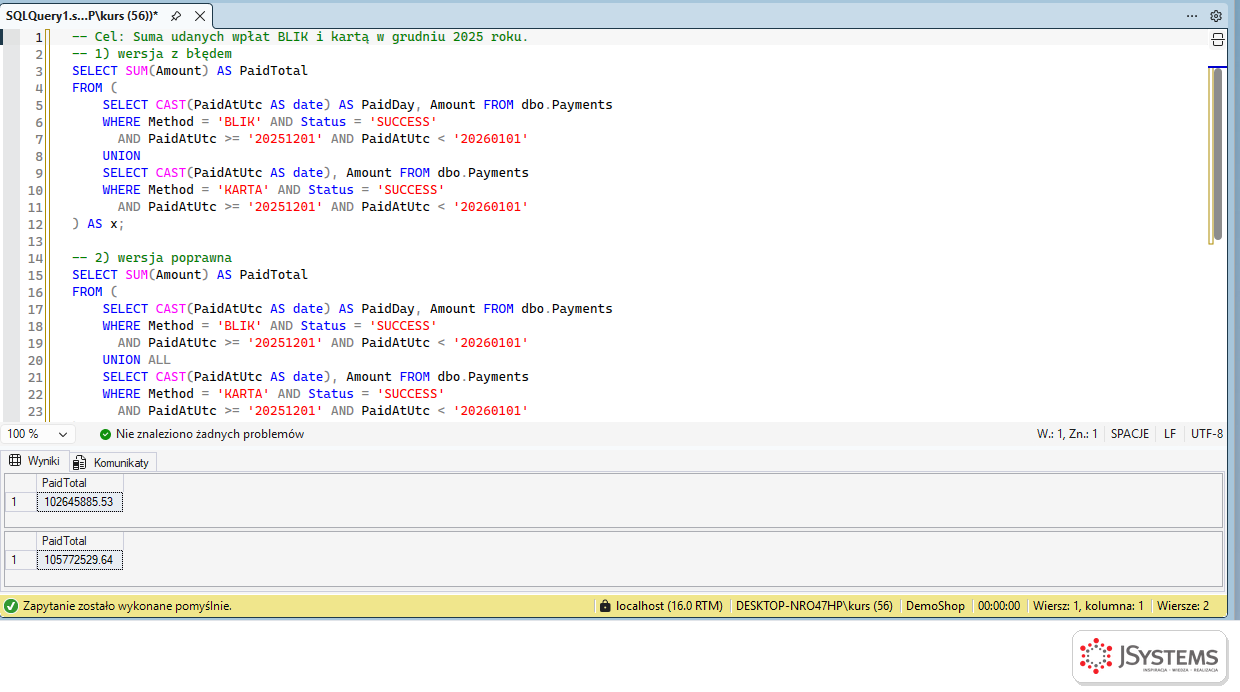
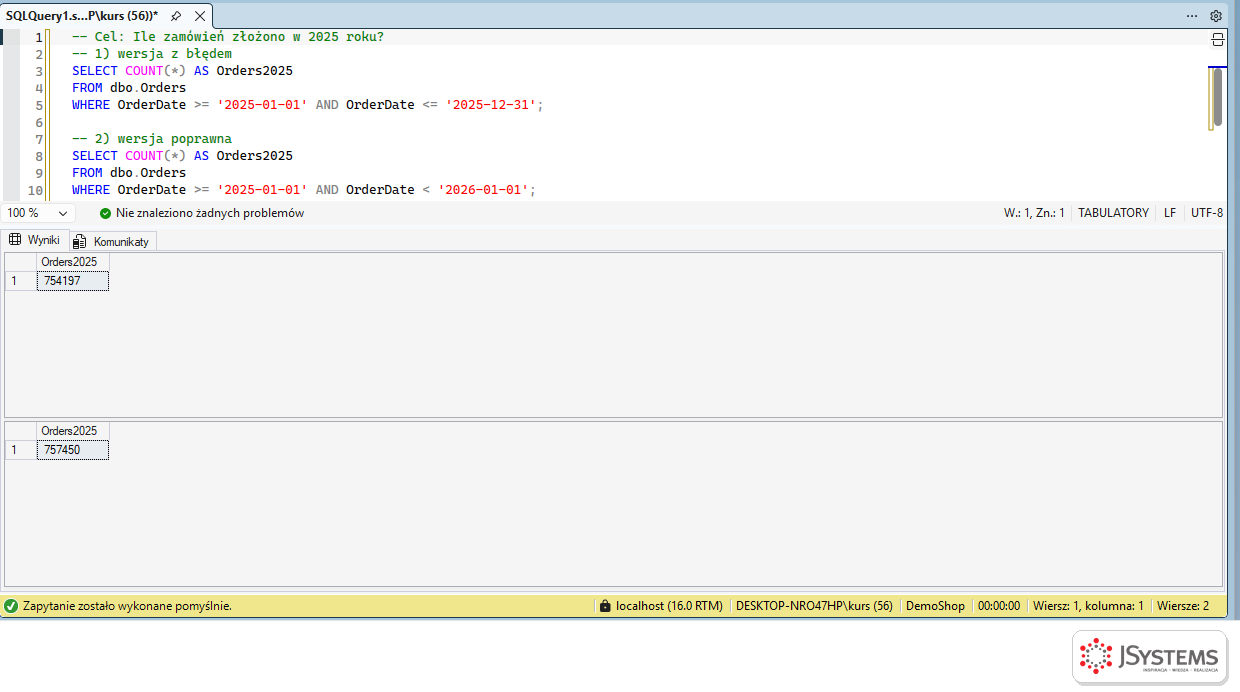
Cel: ile zamówień złożono w 2025 roku. OrderDate przechowuje datę z godziną, więc <= '2025-12-31' oznacza „do północy 31 grudnia” i gubi cały ostatni dzień roku: 754 197 zamiast 757 450. Bezpieczny wzorzec dla każdego typu daty to przedział półotwarty: >= '2025-01-01' AND < '2026-01-01'.
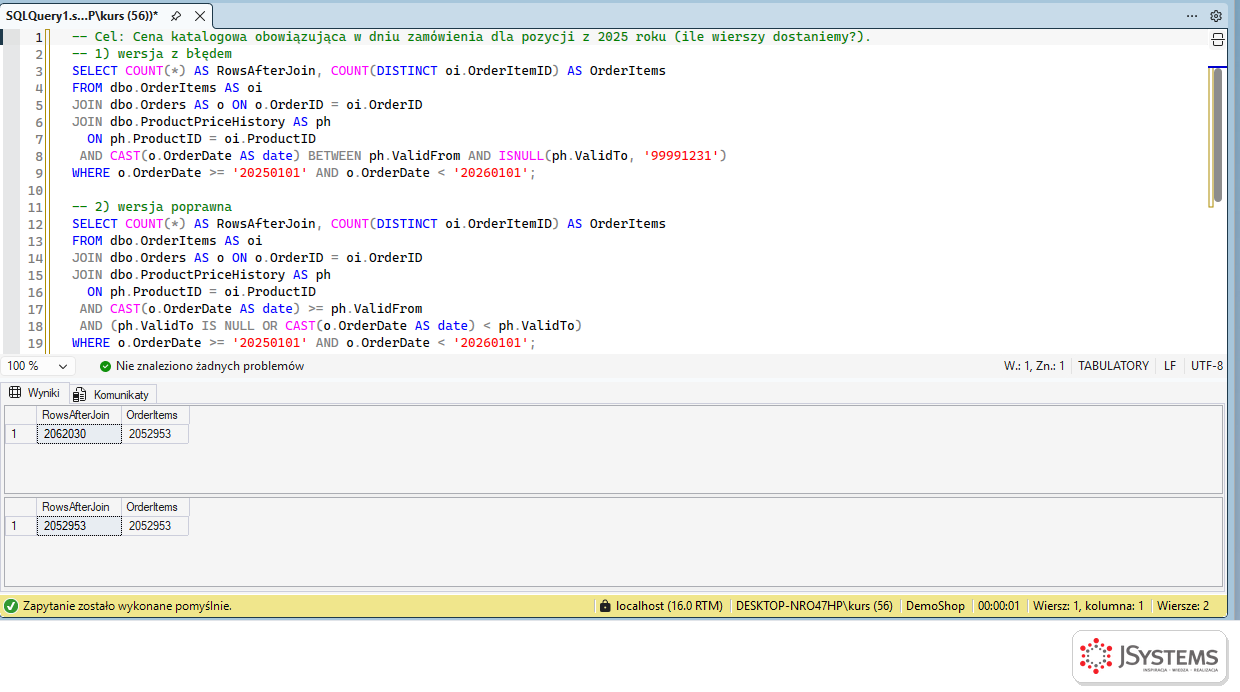
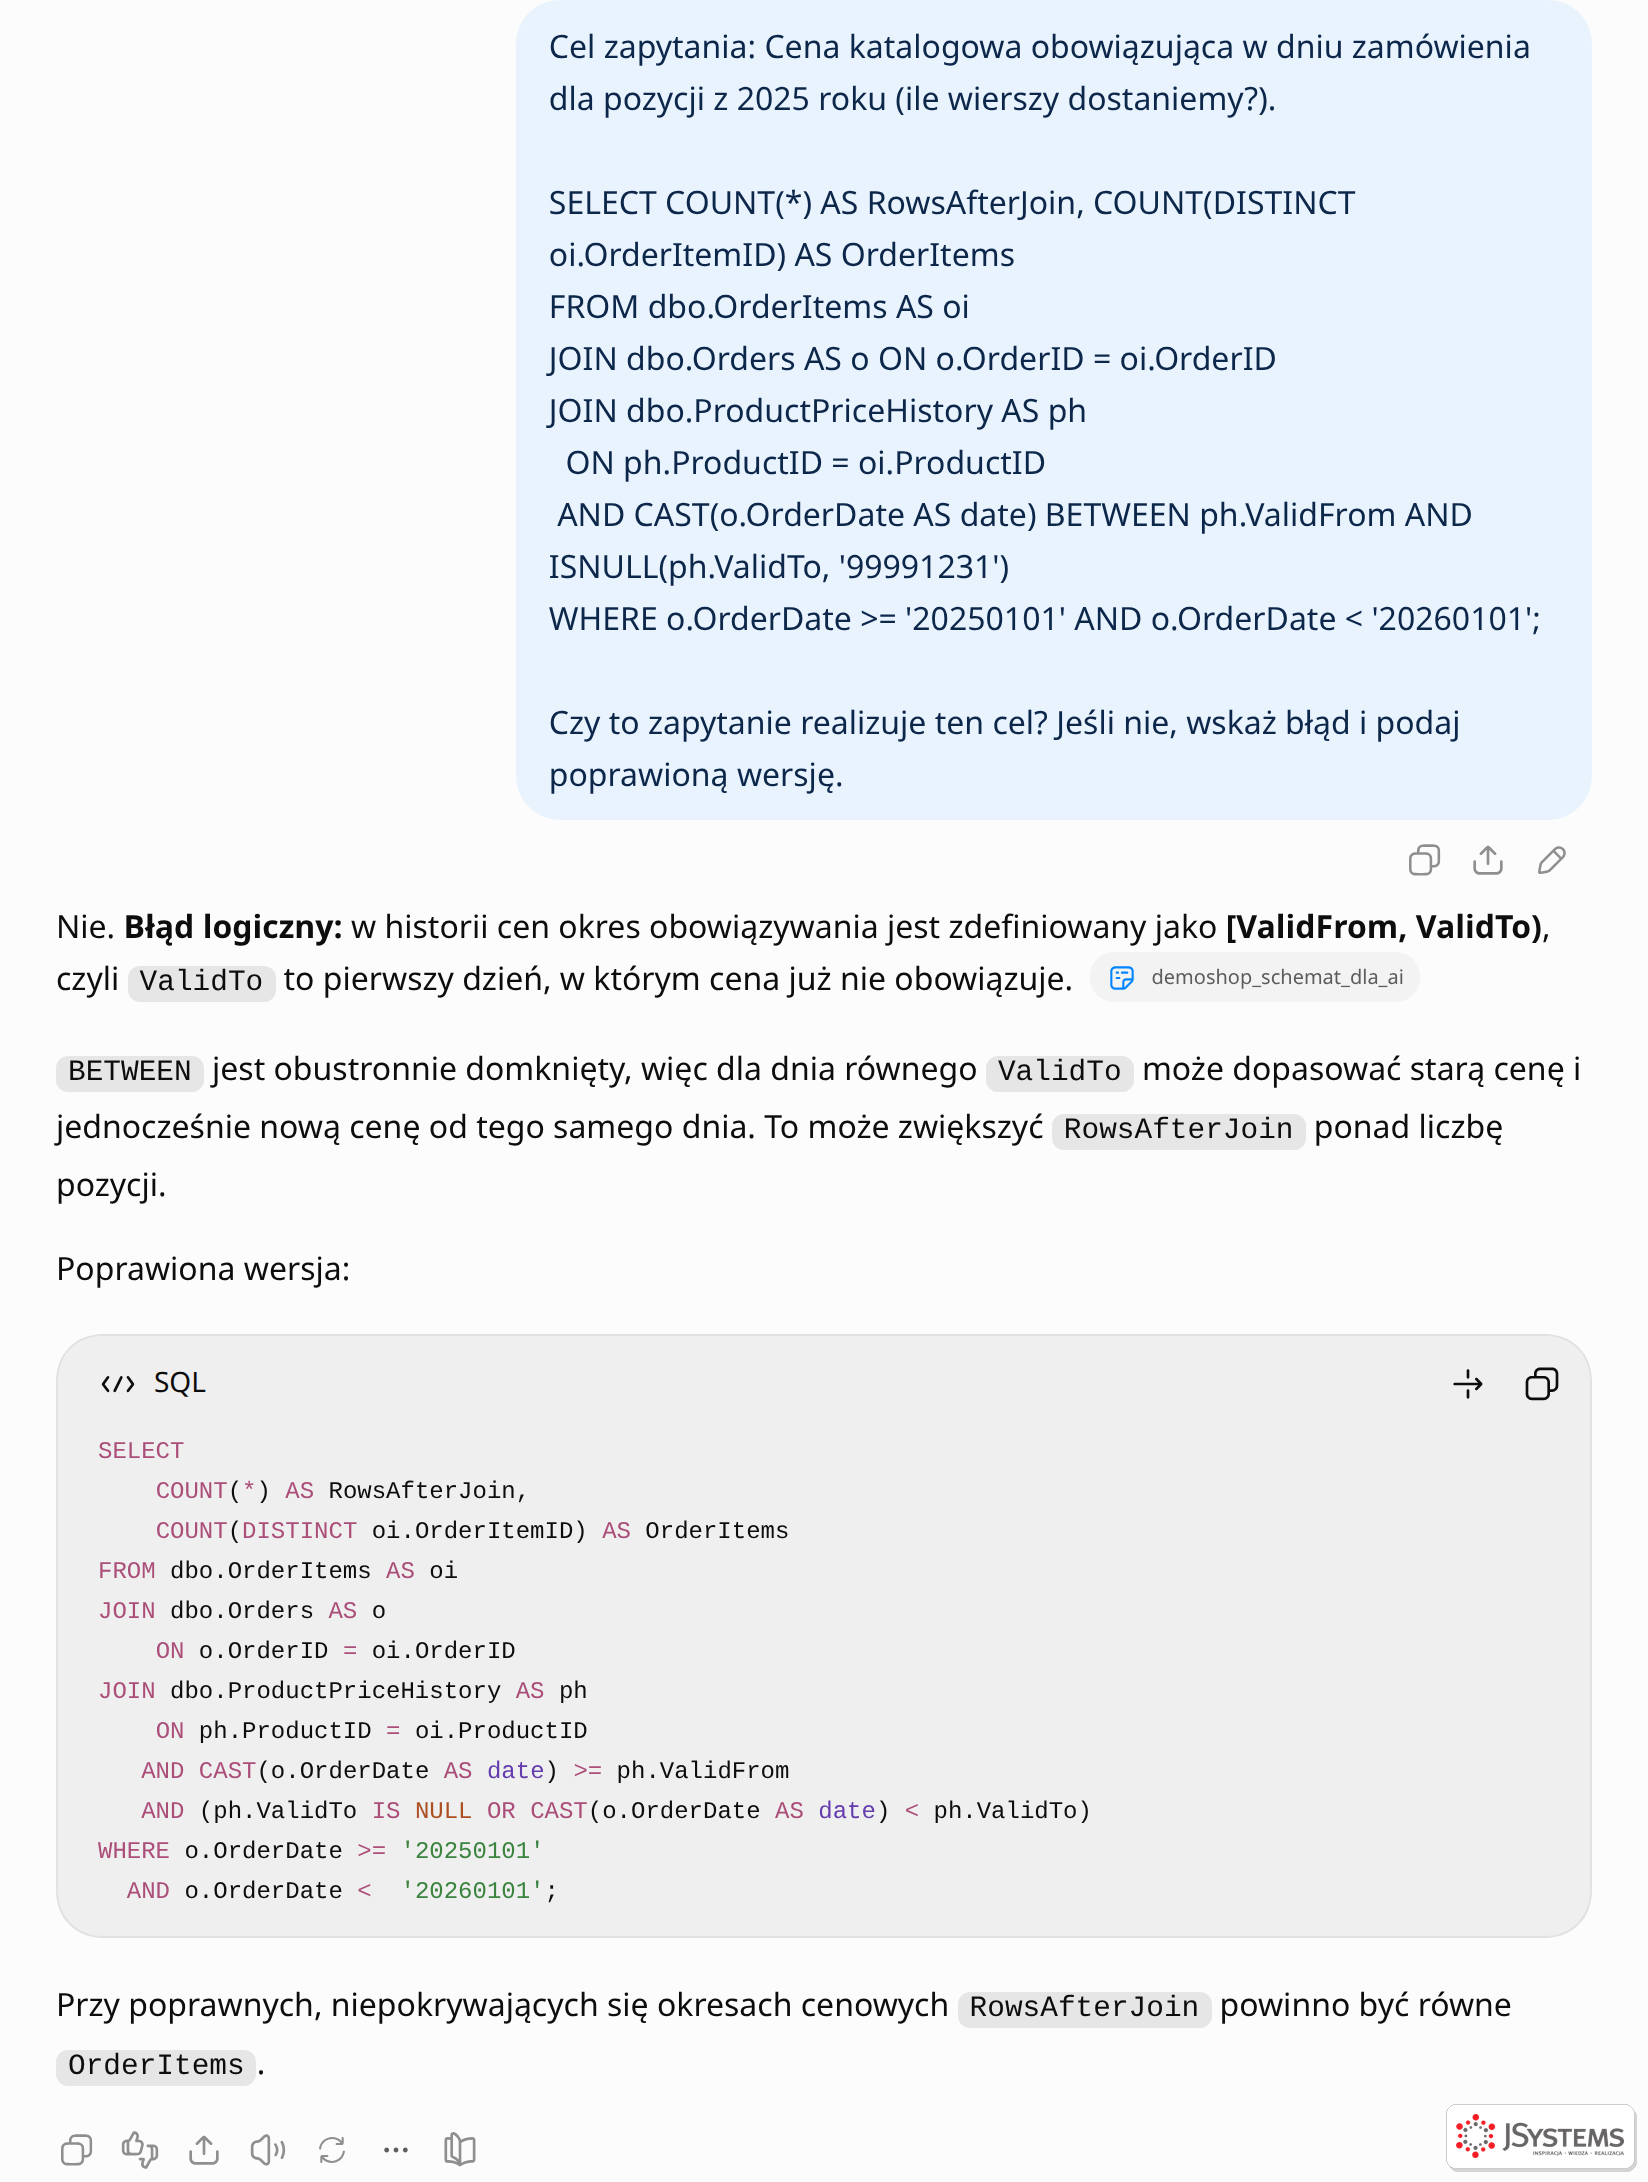
Cel: cena obowiązująca w dniu zamówienia. Historia cen zapisuje okresy jako [ValidFrom, ValidTo), czyli ValidTo to pierwszy dzień nowej ceny. BETWEEN obejmuje oba końce, więc pozycja z dnia zmiany ceny pasuje do starej i nowej ceny naraz. Złączenie zwraca 2 062 030 wierszy przy 2 052 953 pozycjach: 9 077 pozycji się podwoiło i każda suma oparta na tym złączeniu jest zawyżona.
Cel: suma udanych wpłat z 1 stycznia 2026 roku według czasu polskiego. PaidAtUtc jest w UTC, a 1 stycznia w Polsce trwa od 23:00 UTC 31 grudnia do 23:00 UTC 1 stycznia. Obcięcie do daty w UTC przesuwa granicę o godzinę: 6 596 770,28 zł zamiast 6 752 338,49 zł.
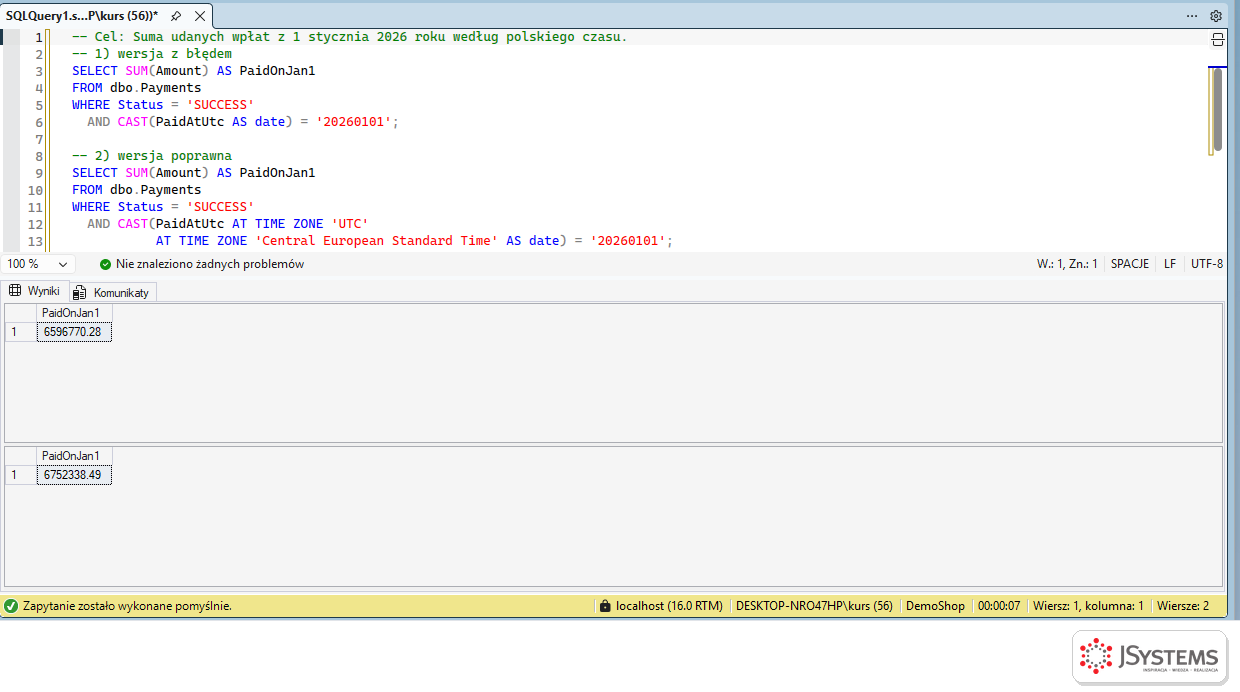
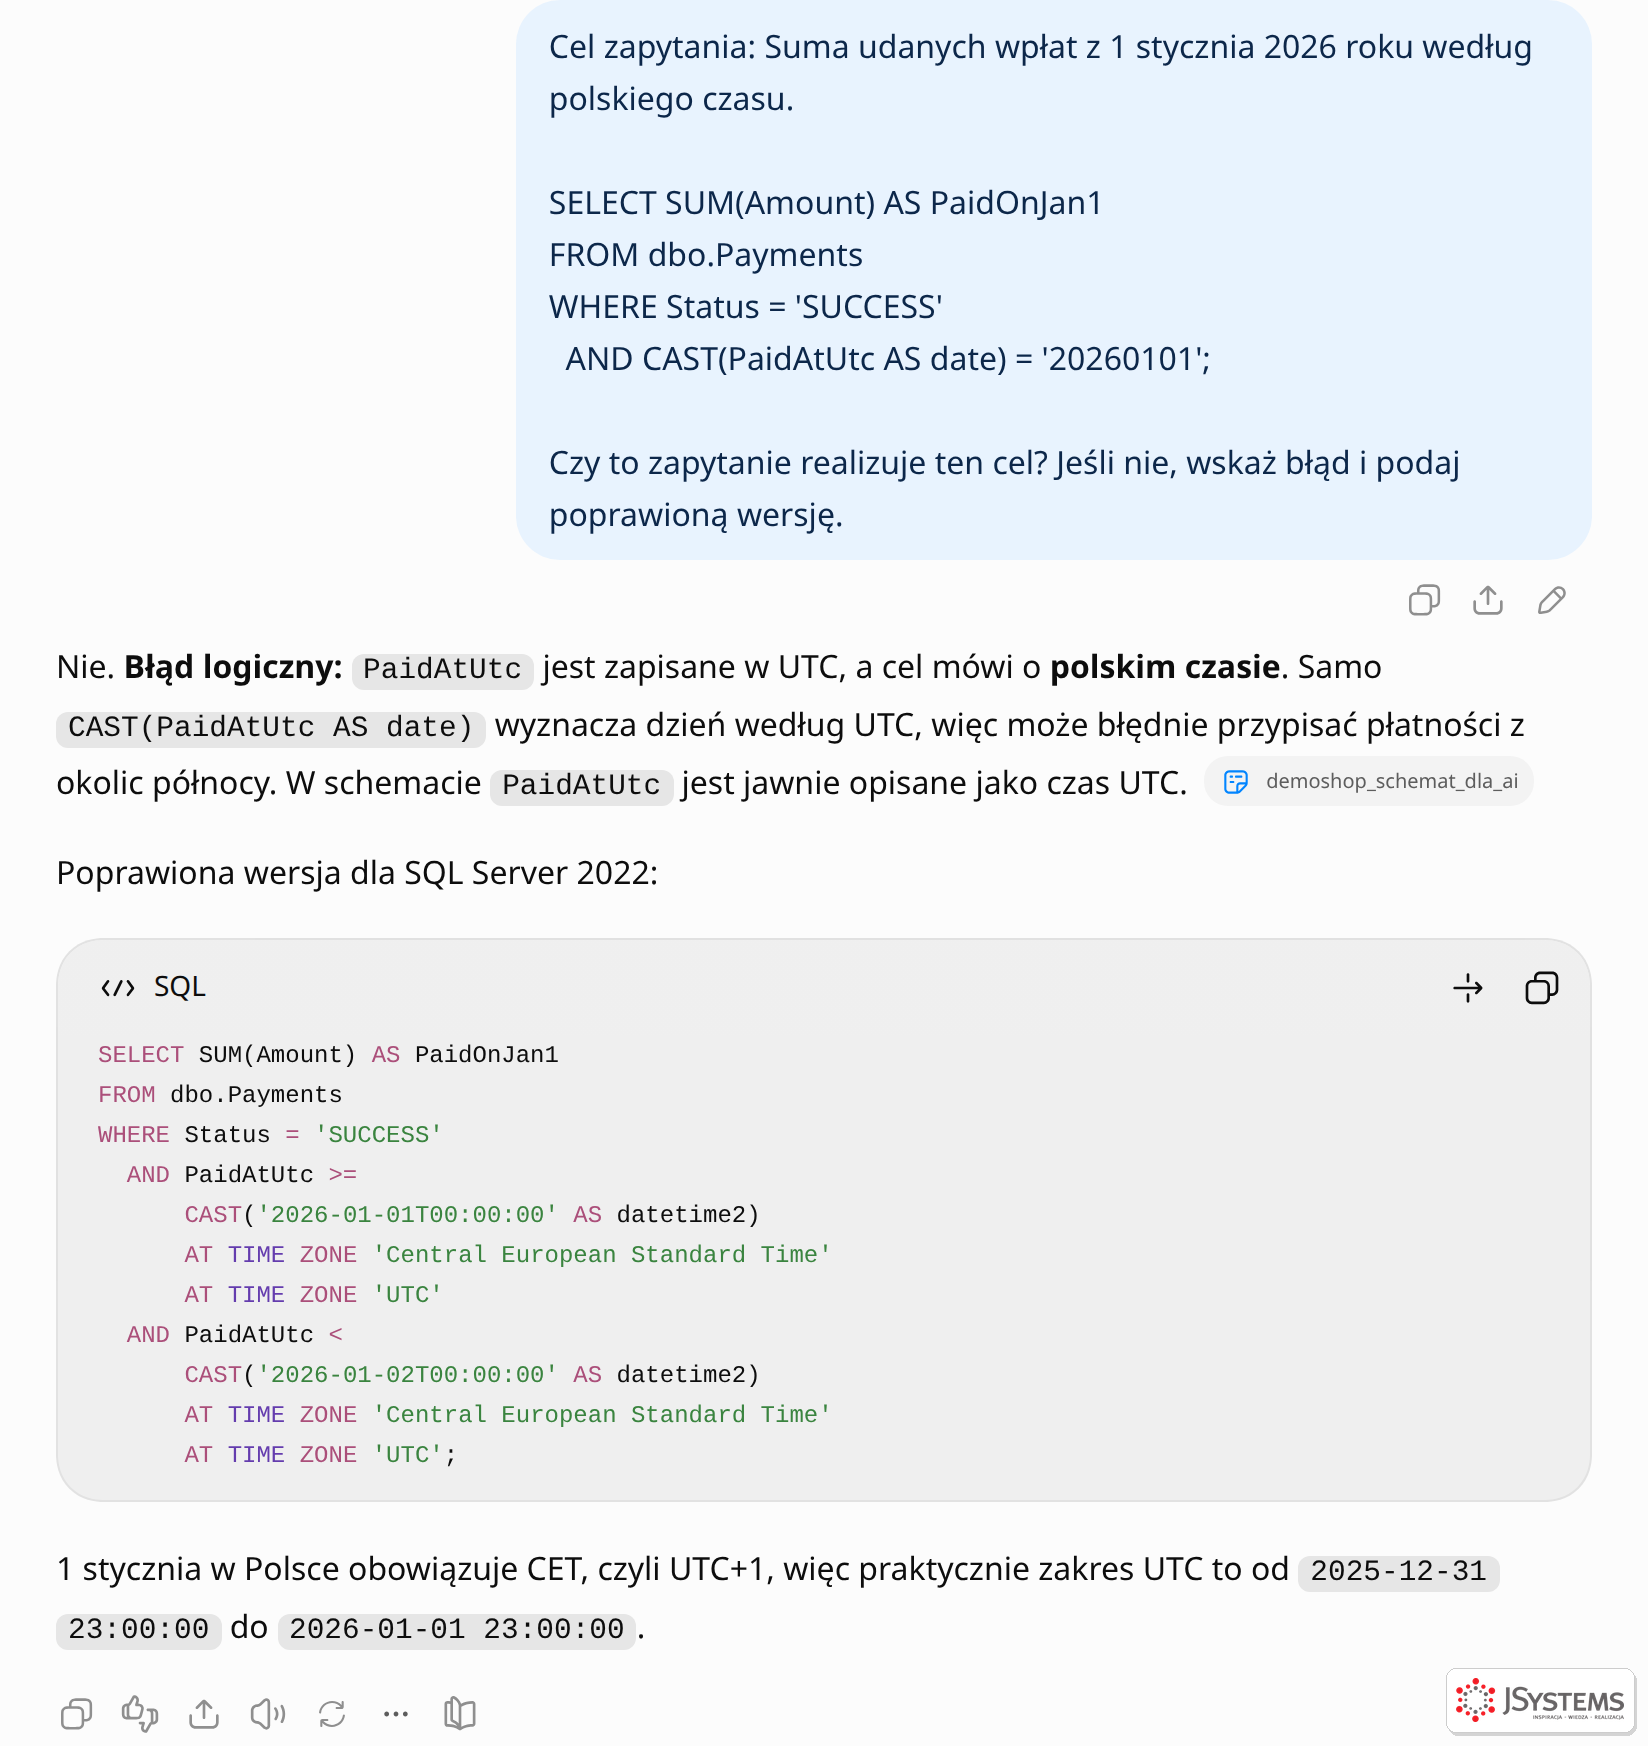
Różnicę między obiema poprawkami zmierzyliśmy na tymczasowym indeksie na PaidAtUtc. Wersja od AI zostawia kolumnę bez funkcji, więc serwer wyszukuje w indeksie tylko zakres jednej doby: 12 odczytów stron i 1 ms. Nasza przelicza strefę czasową dla każdej z 2,6 mln płatności: 11 686 odczytów, 6,7 s czasu i 25,7 s czasu procesora. Operator AT TIME ZONE jest wygodny, ale kosztowny, i lepiej używać go na stałych niż na kolumnie.
Cel: ile różnych osób kupiło coś w 2025 roku. Wśród kupujących w DemoShop 316 osób ma po dwa konta klienta z tym samym adresem e-mail, w 142 parach różniącym się tylko wielkością liter. COUNT(DISTINCT CustomerID) liczy konta: 150 487. Osób, liczonych po adresie e-mail, jest 150 171.
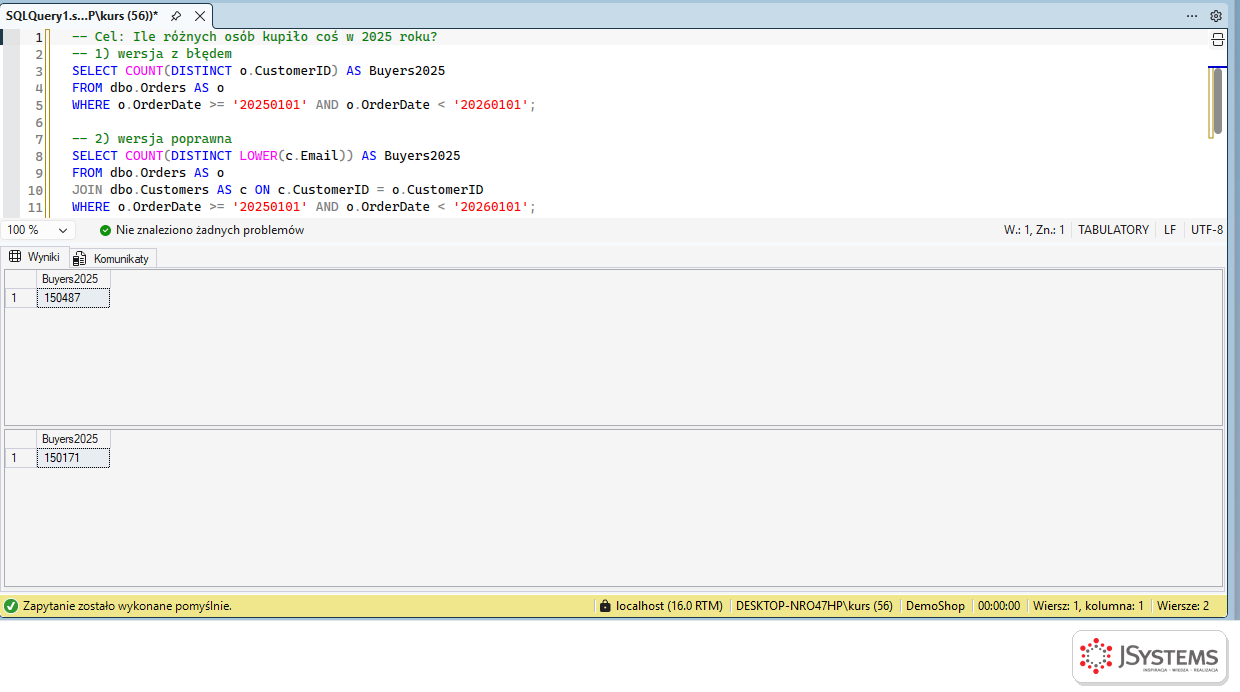
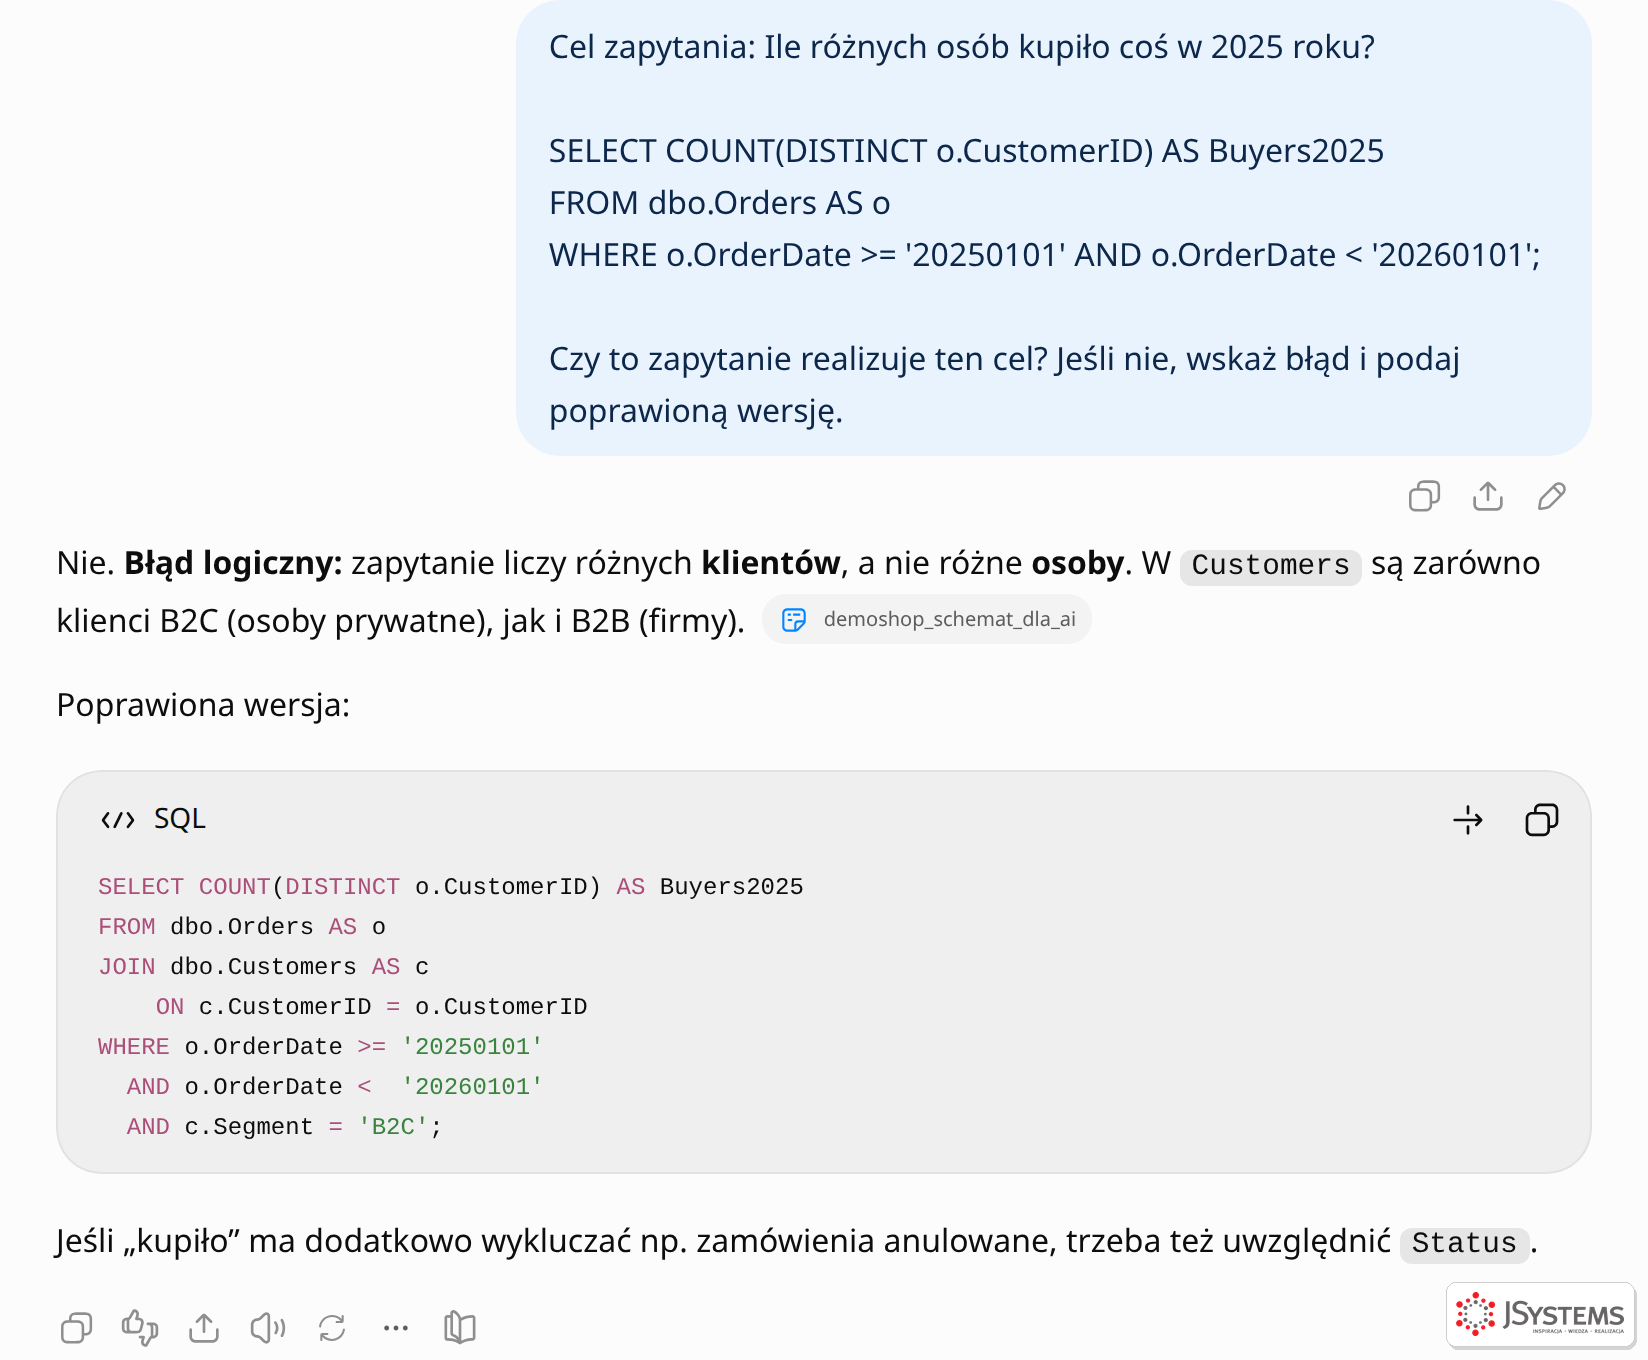
Wszystkie pozostałe błędy wynikały z kodu i dało się je znaleźć, czytając zapytanie i schemat. Ten wynika z danych: z tego, że ktoś założył drugie konto. AI, które widzi tylko kod i opis tabel, takiego problemu nie znajdzie. Znajdzie go zapytanie kontrolne, na przykład porównanie COUNT(DISTINCT CustomerID) z COUNT(DISTINCT LOWER(Email)), i warto o takie zapytania prosić AI wprost: „jakimi zapytaniami sprawdzę, czy w danych nie ma duplikatów, które zawyżą ten wynik?”.
Cel: średnia wartość zamówienia w 2025 roku dla całego sklepu. Wersja z błędem liczy średnią osobno w segmentach B2B i B2C, a potem uśrednia te dwie liczby. Obie grupy dostają tę samą wagę, choć zamówień B2C jest 3,5 raza więcej (564 530 wobec 158 891). Wynik 4 956,84 zł zamiast 3 155,97 zł.
Cel: łączny koszt dostawy zamówień z 2025 roku. Koszt dostawy jest zapisany raz na zamówienie, a złączenie z pozycjami powtarza go tyle razy, ile zamówienie ma pozycji. Wynik 3 380 318,11 zł zamiast 2 607 034,48 zł. Przed każdą sumą zadaj sobie pytanie, na jakim poziomie (zamówienie czy pozycja) zapisana jest sumowana kolumna.
Cel: jaki procent zamówień z 2025 roku anulowano. W SQL Server dzielenie liczby całkowitej przez liczbę całkowitą daje liczbę całkowitą, więc 34 029 / 757 450 to 0, a 0 razy 100 to nadal 0. Wystarczy jedna liczba dziesiętna na początku wyrażenia: 100.0 * SUM(...) / COUNT(*) daje 4,49%.
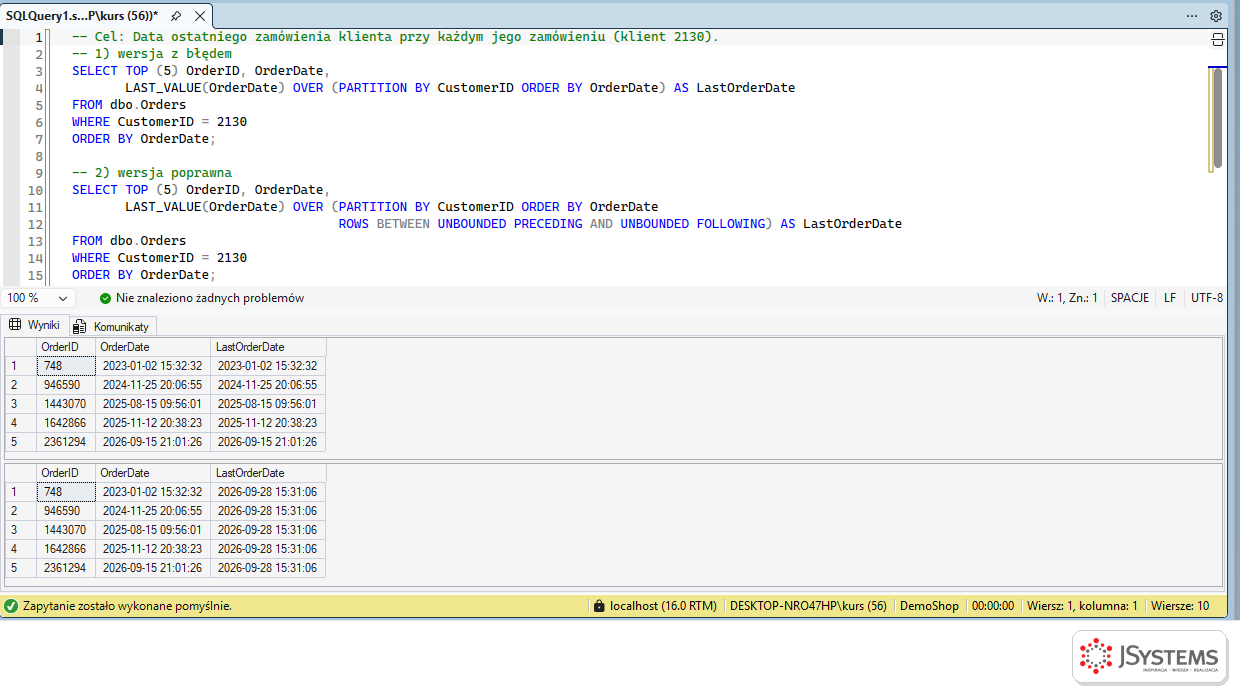
Cel: data ostatniego zamówienia klienta przy każdym jego zamówieniu. Z ORDER BY w klauzuli OVER domyślna ramka kończy się na bieżącym wierszu, więc „ostatnia” wartość to po prostu data bieżącego zamówienia. Trzeba jawnie rozszerzyć ramkę do końca partycji, czyli grupy wierszy wyznaczonej przez PARTITION BY (tu: wszystkich zamówień jednego klienta): ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING.
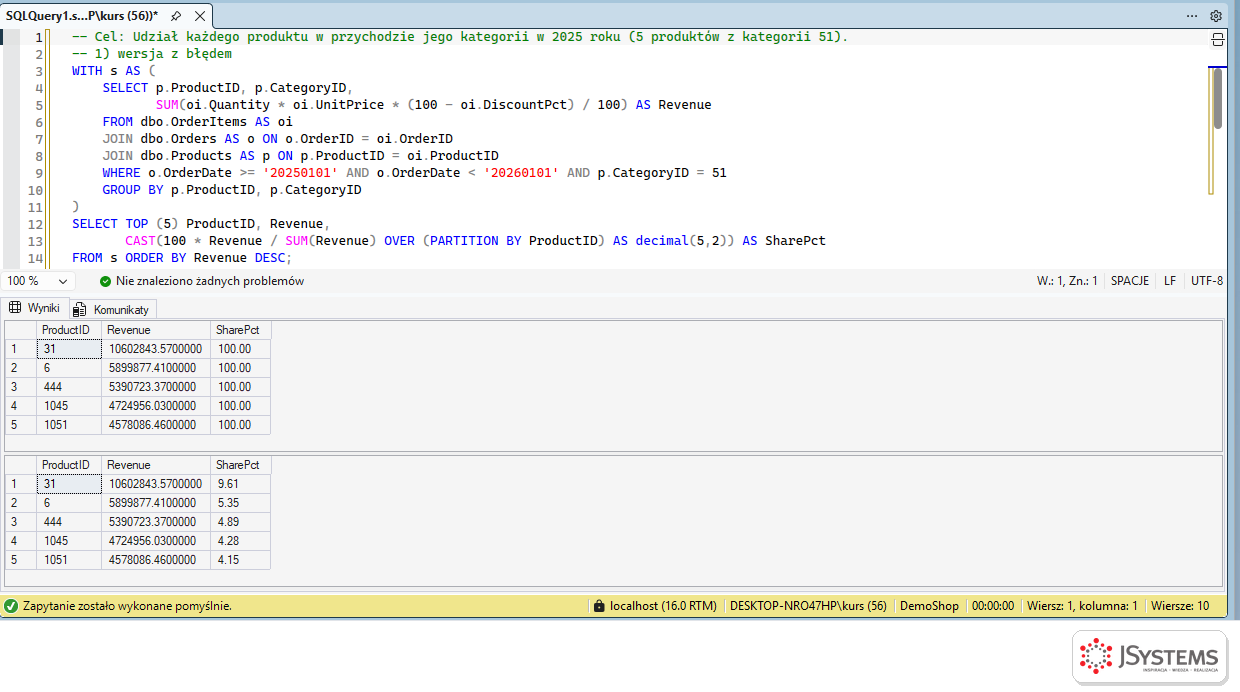
Cel: udział każdego produktu w przychodzie jego kategorii. Suma w mianowniku jest liczona w partycji produktu, więc każdy produkt dzieli się sam przez siebie i ma 100%. Partycja musi odpowiadać całości, do której porównujemy, czyli kategorii.
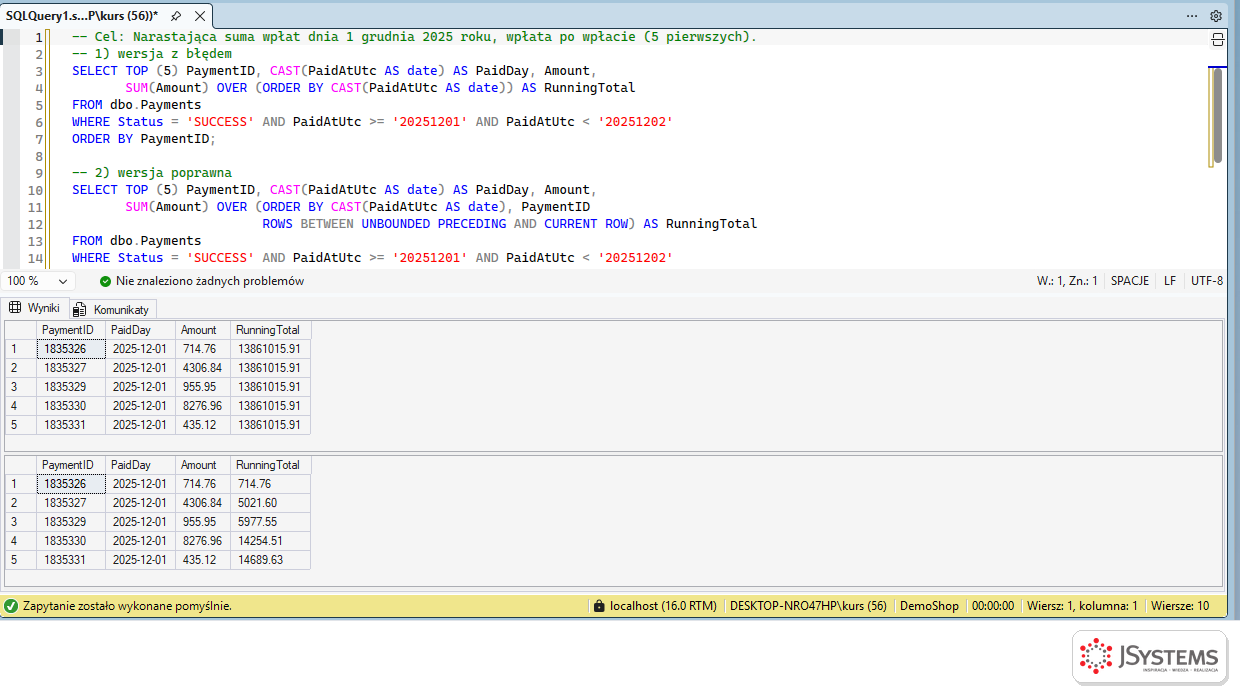
Cel: narastająca suma wpłat z 1 grudnia, wpłata po wpłacie. Okno jest posortowane po dacie (bez godziny), a wszystkie wpłaty mają tę samą datę. Domyślna ramka RANGE traktuje równe wartości jako jedną grupę, więc każdy wiersz dostaje sumę całego dnia: 13 861 015,91 zł już przy pierwszej wpłacie. Pomaga jednoznaczny porządek i ramka ROWS.
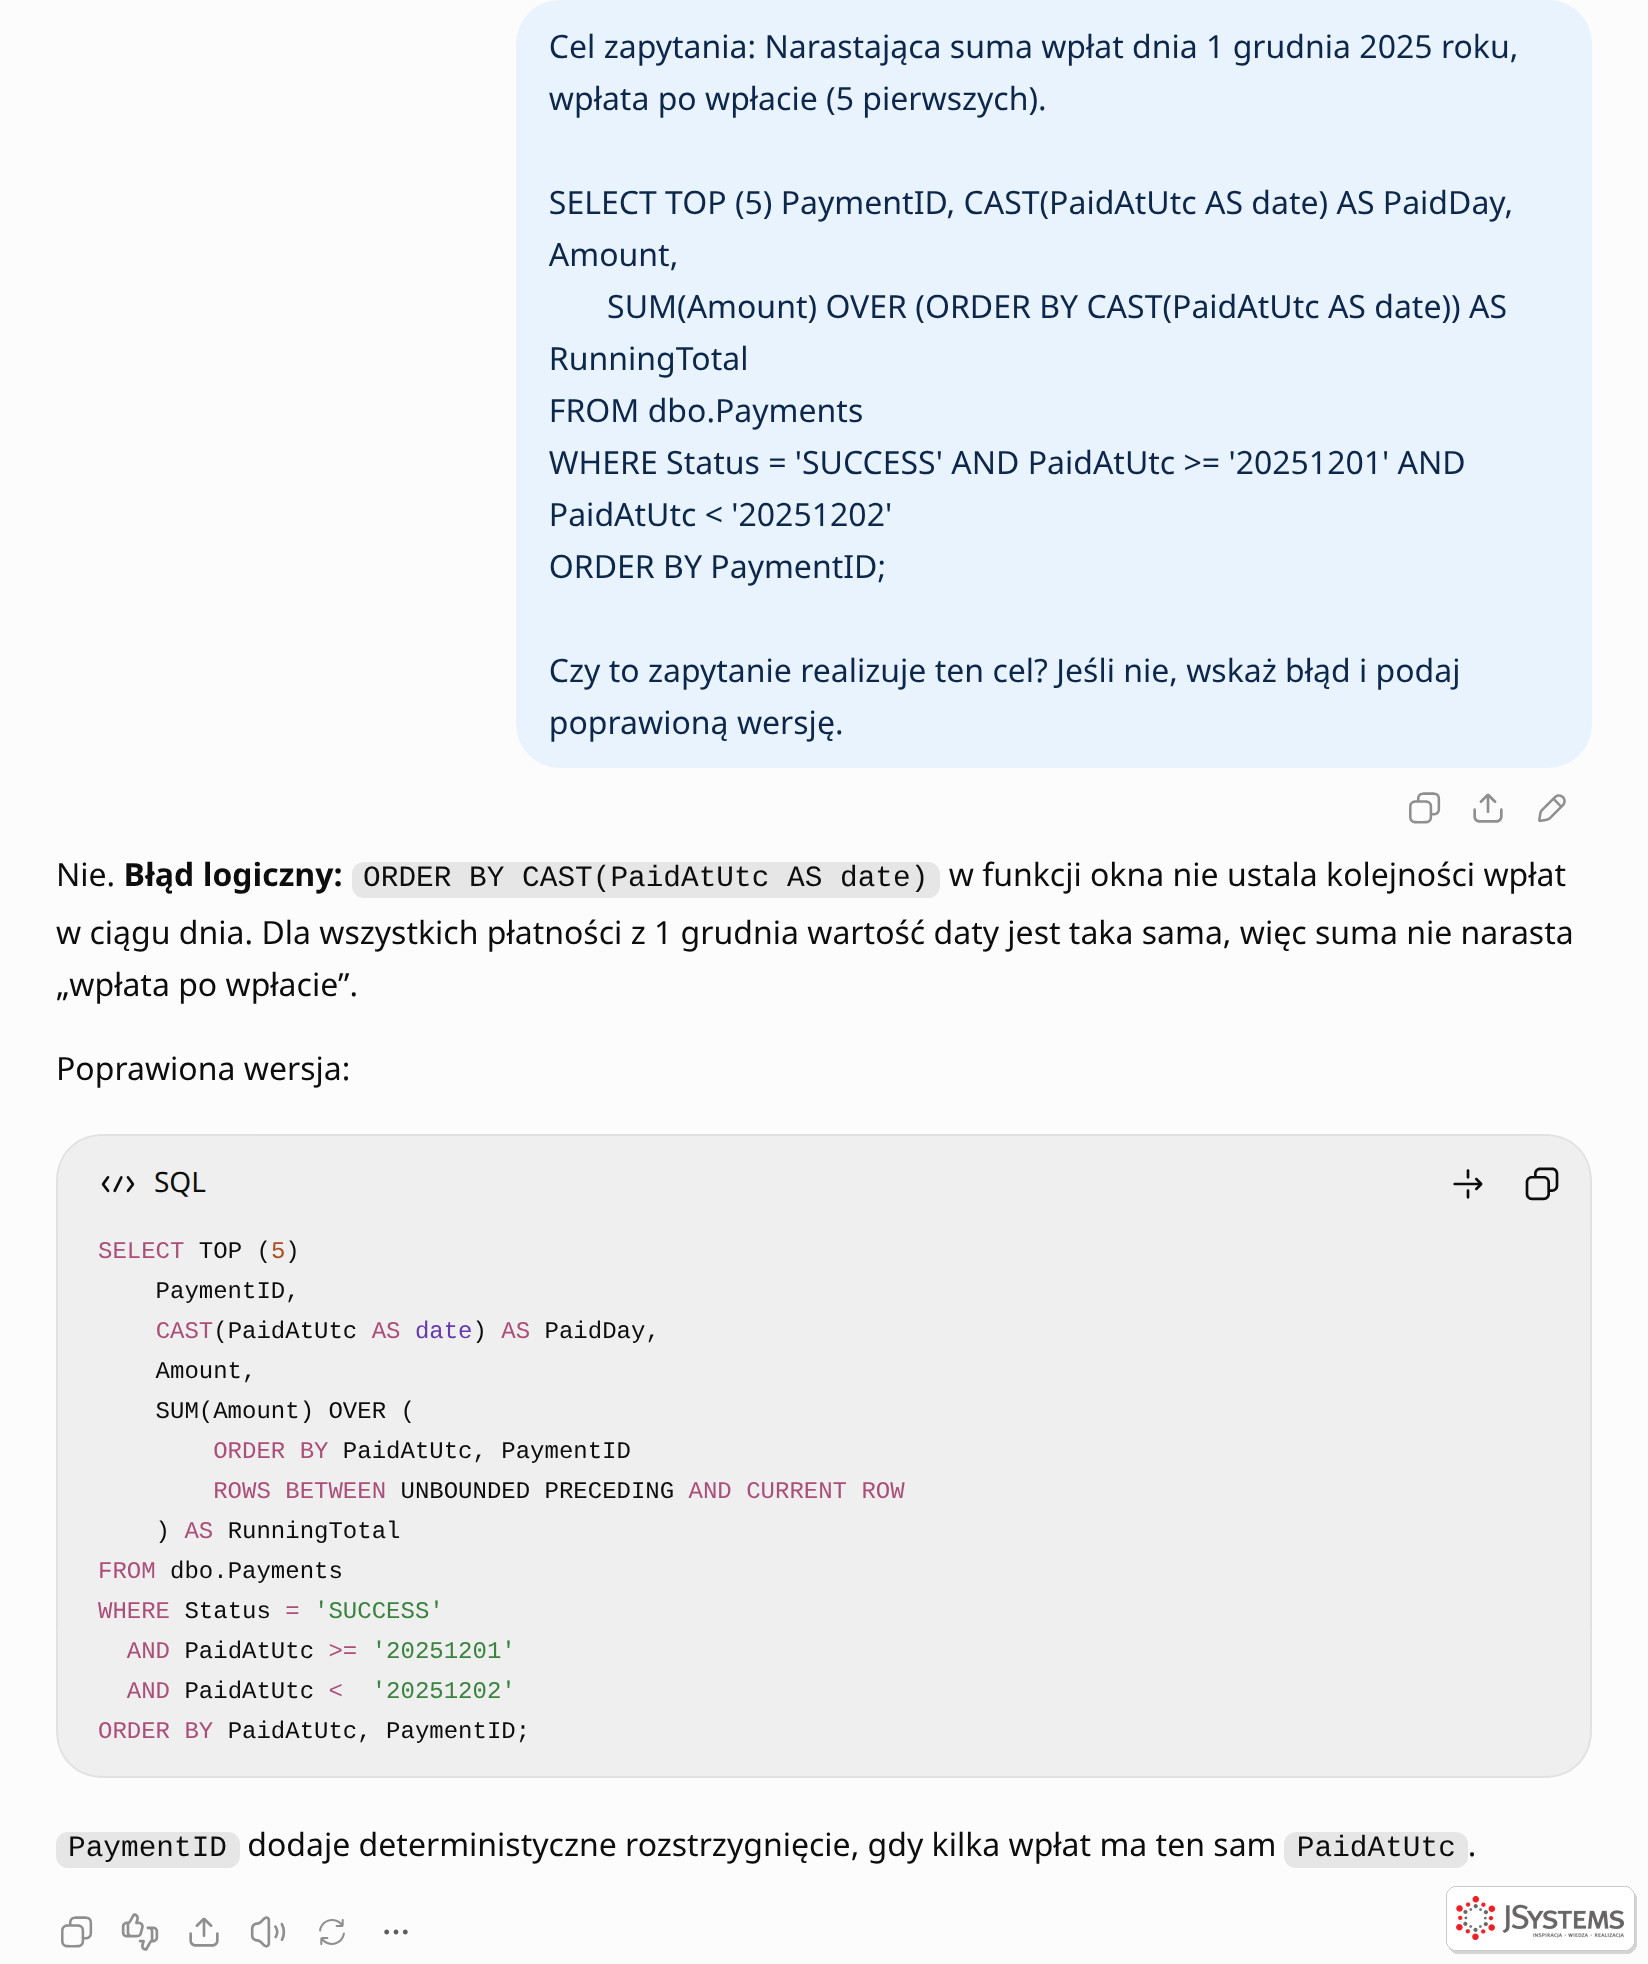
Cel: zamówienia z Wigilii 2025 roku od klientów z Gdańska. Tabele są wymienione po przecinku w FROM, ale brakuje warunku, który je łączy. Każde z zamówień z Wigilii zostaje połączone z każdym klientem z Gdańska: 8 402 940 wierszy zamiast 37. Pisz złączenia jawnie przez JOIN ... ON, wtedy brak warunku jest błędem składni, a nie cichym mnożeniem.
Cel: zamówienia doręczone albo zwrócone, złożone w 2025 roku. AND wiąże silniej niż OR, więc warunek oznacza „wszystkie doręczone z dowolnego roku albo zwrócone z 2025”. Wynik jest ponad trzy razy za duży: 2 220 814 zamiast 723 421. To ta sama pułapka co przy błędzie składniowym nr 2, tylko bez komunikatu.
Cel: lista krajów klientów, a dla brakującego kraju napis „brak danych”. ISNULL zwraca typ pierwszego argumentu, a Country to char(2). Napis zastępczy zostaje obcięty do „br”. COALESCE wybiera typ według pierwszeństwa typów i zwraca pełny tekst.
Wniosek z tej listy jest dwojaki. Po pierwsze, AI z opisem schematu wyłapuje błędy logiczne w kodzie bardzo skutecznie, często szybciej niż człowiek, i potrafi dorzucić uwagę, o którą nie prosiliśmy (błędy 5 i 20). Po drugie, nie zastąpi zapytań kontrolnych na danych: błąd 11 wymagał spojrzenia w dane, a nie w kod. Najlepsze efekty daje połączenie obu podejść, takie jak w studium przypadku z poprzedniej sekcji.
Część 3 z 8 przewodnika AI w SQL


Komentarze (0)
Brak komentarzy...