
Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
W skrócieAI dobrze przepisuje stary SQL na czytelny i tłumaczy zapytania między dialektami, ale wynik trzeba udowodnić na bazie. Pokazujemy refaktoryzację zapytania z dowodem przez EXCEPT i sumę kontrolną oraz trzy konwersje do PostgreSQL: z Oracle, SQL Server i MySQL, każdą z tym samym wynikiem w obu bazach.
To część 6 z 8 przewodnika AI w SQL. Wszystkie przykłady powstały na bazie DemoShop w SQL Server 2022: fikcyjnym sklepie internetowym z 2,4 mln zamówień. Polecenia wpisujemy do ChatGPT, ale te same możesz podać Microsoft Copilotowi, Claude albo Gemini. Przy skryptach korzystających z mechanizmów serwera w małej szarej ramce znajdziesz ich odpowiedniki dla Oracle i PostgreSQL.
Z tej części dowiesz się:
Pliki do tej części
Skrypt bazy uruchamiasz w SSMS na serwerze SQL Server 2019 lub nowszym. Tworzy bazę DemoShop, na której powstały wszystkie przykłady.
Refaktoryzacja to przebudowa kodu bez zmiany tego, co kod robi. W SQL oznacza to zwykle: złączenia zapisane jawnie przez JOIN zamiast przecinków w FROM, logikę rozbitą na nazwane kroki CTE, czytelne aliasy, komentarze tam, gdzie reguła nie jest oczywista, i usunięte powtórzenia. AI robi to szybko i zwykle dobrze. Trudność jest gdzie indziej: trzeba udowodnić, że wynik się nie zmienił, bo „przepisane ładniej” nie może oznaczać „liczy trochę inaczej”.
Wzięliśmy zapytanie w stylu, który zna każdy, kto przejmował raporty po poprzednikach: aliasy jednoliterowe, złączenia po przecinku, warunek z podzapytaniem w IN, to samo wyrażenie na wartość pozycji w dwóch miejscach i polskie nazwy kolumn bez wielkich liter.
select x.rok, x.mies, x.seg, count(*) ile_klientow, sum(x.wart) wartosc,
  sum(case when x.ile_zam>1 then 1 else 0 end) powracajacy,
  round(sum(x.wart)/count(*),2) srednio_na_klienta,
  round(100.0*sum(case when x.ile_zam>1 then 1 else 0 end)/count(*),1) proc_powracajacych
from (select year(a.OrderDate) rok, month(a.OrderDate) mies, b.Segment seg, a.CustomerID kl,
        count(distinct a.OrderID) ile_zam,
        sum(c.Quantity*c.UnitPrice*(100-c.DiscountPct)/100) wart
      from dbo.Orders a, dbo.Customers b, dbo.OrderItems c
      where a.CustomerID=b.CustomerID and c.OrderID=a.OrderID and a.Status<>'CANCELLED'
        and a.OrderDate>='20250101' and a.OrderDate<'20260101'
        and a.CustomerID in (select d.CustomerID from dbo.Orders d, dbo.OrderItems e
                             where e.OrderID=d.OrderID and d.Status<>'CANCELLED'
                               and d.OrderDate>='20250101' and d.OrderDate<'20260101'
                             group by d.CustomerID
                             having sum(e.Quantity*e.UnitPrice*(100-e.DiscountPct)/100)>1000)
      group by year(a.OrderDate), month(a.OrderDate), b.Segment, a.CustomerID) x
group by x.rok, x.mies, x.seg
order by 1,2,3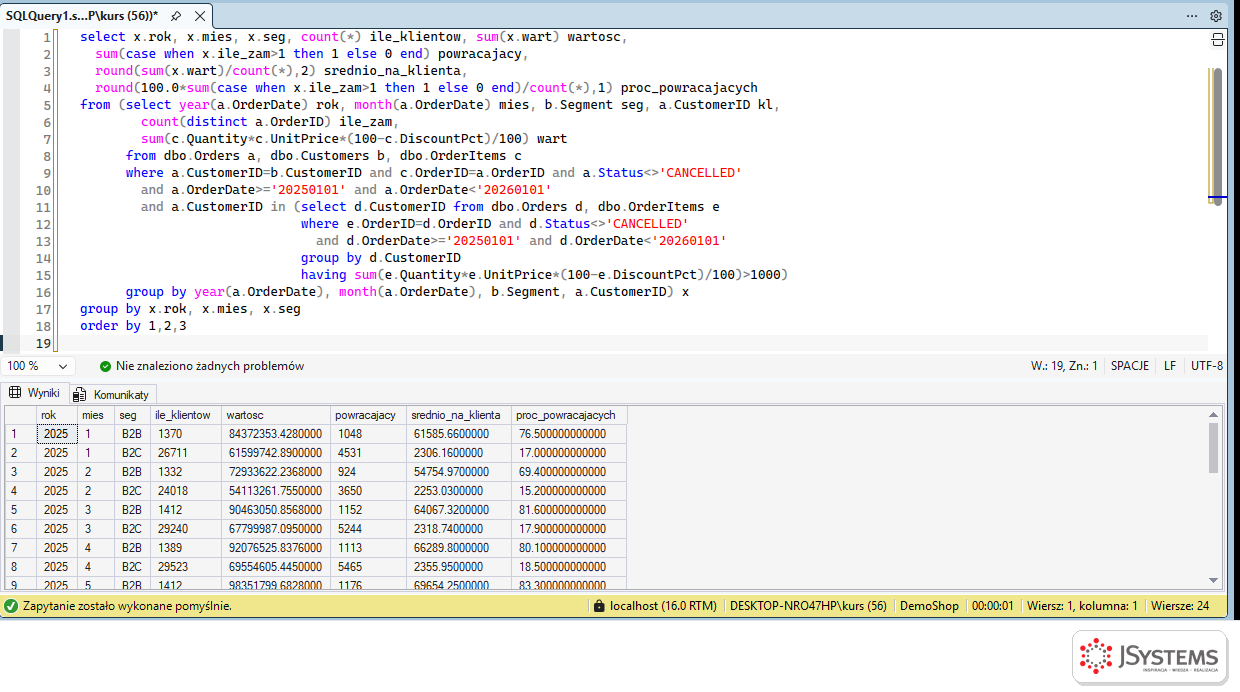
Polecenie do AI ma trzy części: co poprawić w formie, twardy warunek „wynik identyczny co do kolumny i wiersza” i prośbę, żeby podejrzane miejsca w logice opisać, a nie poprawiać. Ostatnia część jest ważna. Refaktoryzacja i naprawa błędów to dwie różne zmiany i mieszanie ich w jednym kroku sprawia, że nie da się już udowodnić, że wynik jest ten sam.
Refaktoryzuj to stare zapytanie T-SQL (SQL Server 2022) tak, żeby było czytelne i łatwe w utrzymaniu: zamień złączenia po przecinku na JOIN, rozbij logikę na nazwane kroki CTE z komentarzami, nadaj aliasom znaczące nazwy i usuń powtórzenia wyrażeń. Wynik musi pozostać identyczny: te same kolumny pod tymi samymi nazwami, te same wartości, ta sama kolejność wierszy. Jeśli zauważysz w logice coś podejrzanego, nie poprawiaj tego, tylko opisz pod kodem.
[stare zapytanie]
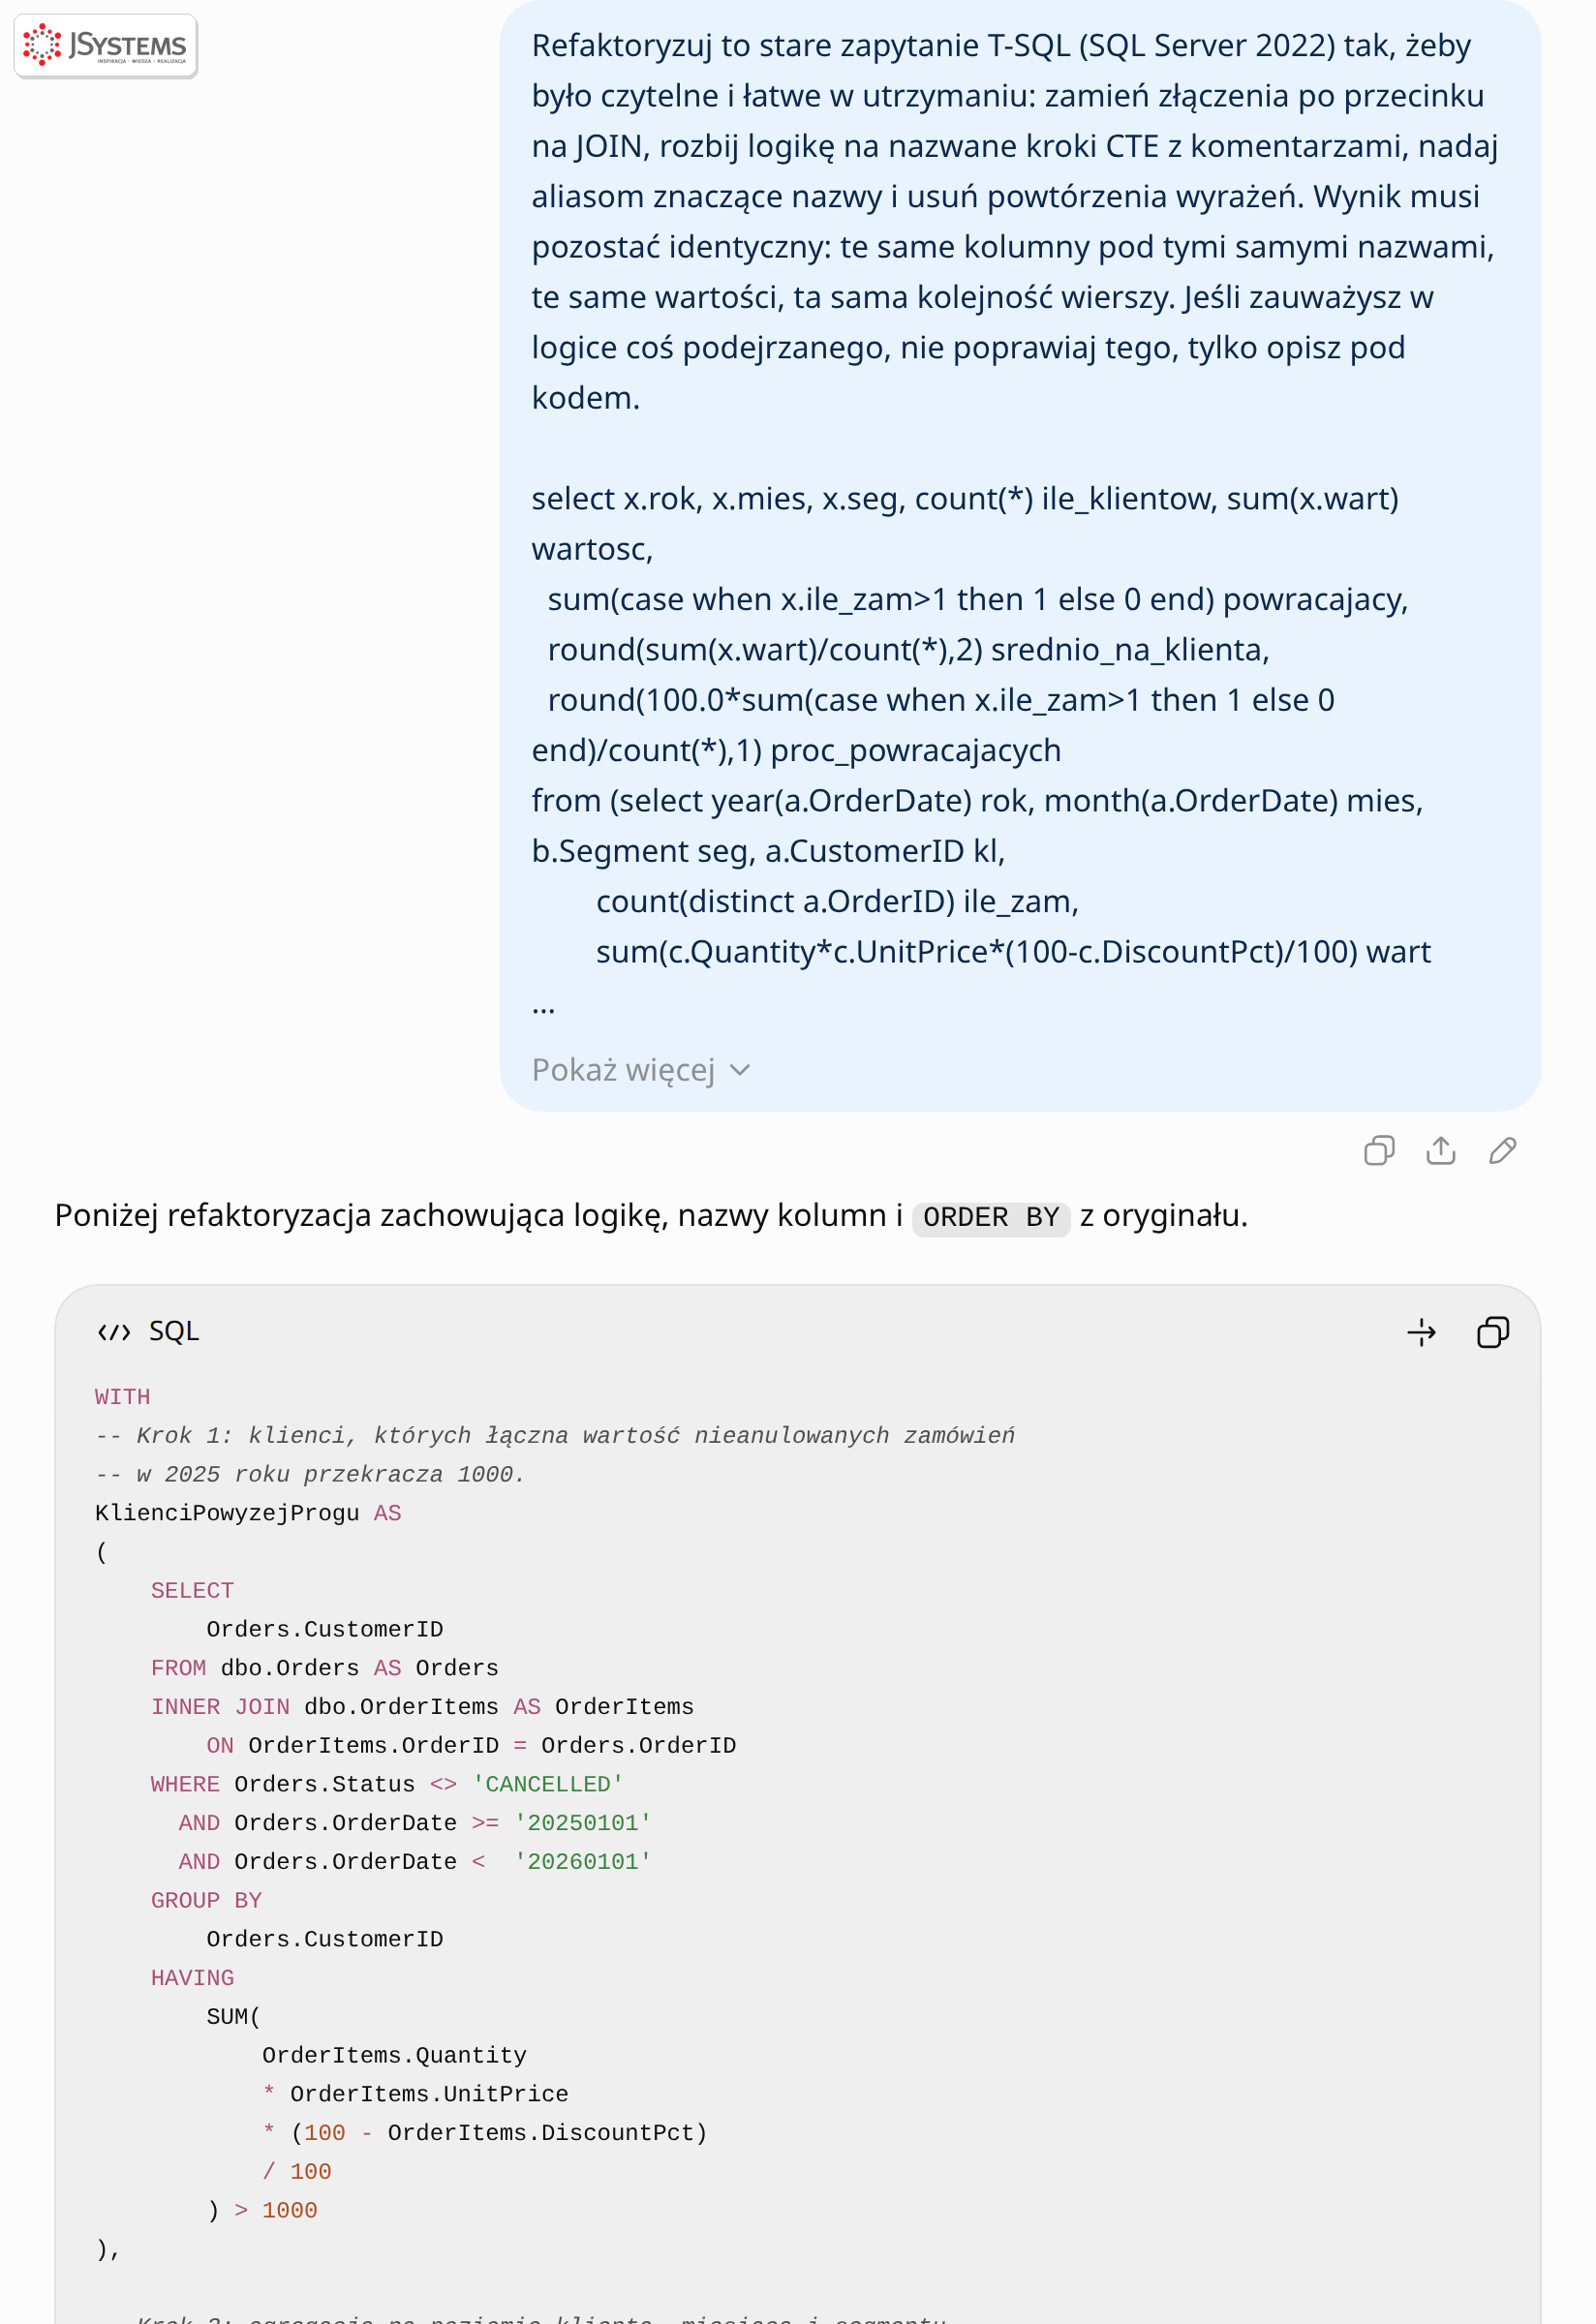
Najcenniejsza część odpowiedzi jest pod kodem. ChatGPT zauważył dwie rzeczy, które w starym zapytaniu łatwo przeoczyć. Kolumna powracajacy nie liczy klientów, którzy wrócili po wcześniejszych zakupach, tylko tych, którzy złożyli więcej niż jedno zamówienie w danym miesiącu, więc nazwa wprowadza w błąd. Próg 1000 zł liczony jest za cały rok, więc klient, który przekroczył go dopiero zakupami z grudnia, trafia także do statystyk styczniowych. Obie uwagi są trafne i obie dotyczą znaczenia raportu, a nie składni. Zgodnie z poleceniem AI ich nie poprawiło, tylko opisało, co zostawia decyzję właścicielowi raportu.
Jedno zalecenie z polecenia AI spełniło tylko częściowo: wyrażenie na wartość pozycji nadal występuje w dwóch krokach. Nie zmienia to wyniku, ale pokazuje, że listę oczekiwań warto po odpowiedzi przejść punkt po punkcie.
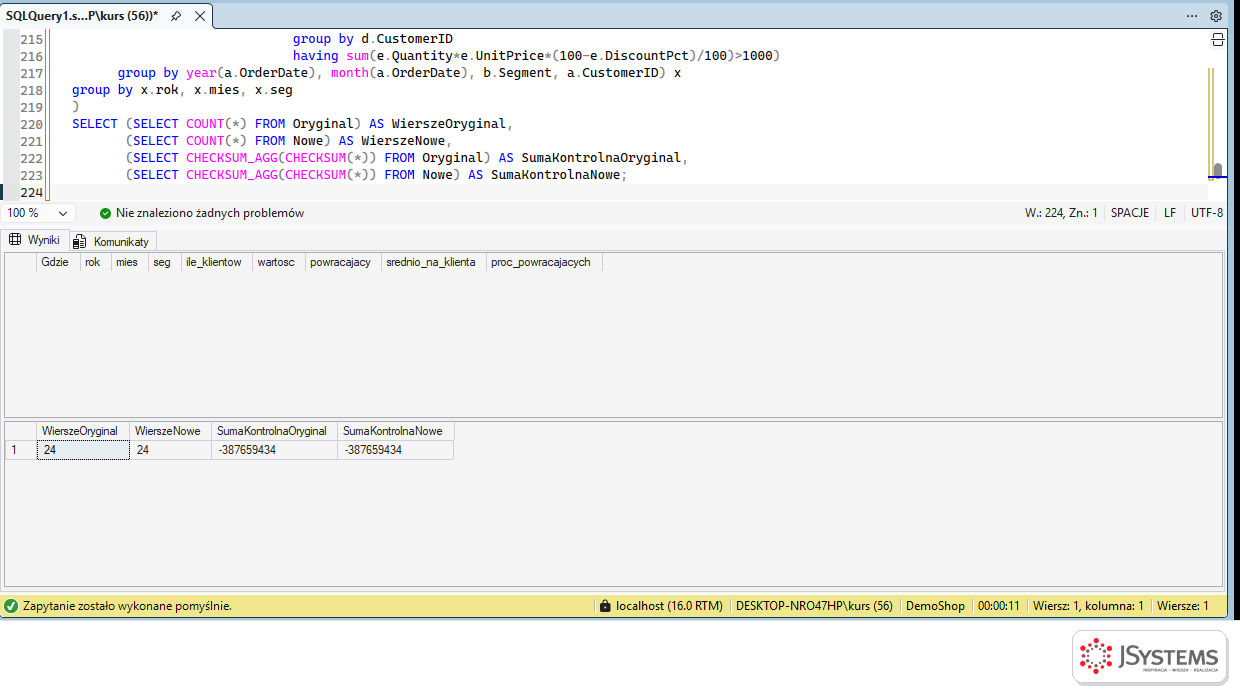
Do sprawdzenia równoważności używamy tego samego szablonu co w sekcji o AI jako nauczycielu, rozszerzonego o drugą kontrolę. Pierwsze zapytanie zwraca wiersze, które są tylko w jednej z wersji (EXCEPT w obie strony). Drugie porównuje liczbę wierszy i sumę kontrolną CHECKSUM_AGG(CHECKSUM(*)), która wyłapie także różnicę w liczbie powtórzeń tego samego wiersza, czego EXCEPT nie widzi.
Cały skrypt dowodu ma 223 linie, bo zawiera obie wersje raportu, więc nie wklejamy go tutaj. Do skopiowania jest w pliku refaktoryzacja_dowod_rownowaznosci.sql.
WITH
-- Krok 1: klienci, których łączna wartość nieanulowanych zamówień
-- w 2025 roku przekracza 1000.
KlienciPowyzejProgu AS
(
    SELECT
        Orders.CustomerID
    FROM dbo.Orders AS Orders
    INNER JOIN dbo.OrderItems AS OrderItems
        ON OrderItems.OrderID = Orders.OrderID
    WHERE Orders.Status <> 'CANCELLED'
      AND Orders.OrderDate >= '20250101'
      AND Orders.OrderDate <  '20260101'
    GROUP BY
        Orders.CustomerID
    HAVING
        SUM(
            OrderItems.Quantity
            * OrderItems.UnitPrice
            * (100 - OrderItems.DiscountPct)
            / 100
        ) > 1000
),

-- Krok 2: agregacja na poziomie klienta, miesiąca i segmentu.
WynikiKlientow AS
(
    SELECT
        YEAR(Orders.OrderDate)  AS rok,
        MONTH(Orders.OrderDate) AS mies,
        Customers.Segment      AS seg,
        Orders.CustomerID      AS kl,
        COUNT(DISTINCT Orders.OrderID) AS ile_zam,
        SUM(
            OrderItems.Quantity
            * OrderItems.UnitPrice
            * (100 - OrderItems.DiscountPct)
            / 100
        ) AS wart
    FROM dbo.Orders AS Orders
    INNER JOIN dbo.Customers AS Customers
        ON Customers.CustomerID = Orders.CustomerID
    INNER JOIN dbo.OrderItems AS OrderItems
        ON OrderItems.OrderID = Orders.OrderID
    INNER JOIN KlienciPowyzejProgu AS KwalifikowaniKlienci
        ON KwalifikowaniKlienci.CustomerID = Orders.CustomerID
    WHERE Orders.Status <> 'CANCELLED'
      AND Orders.OrderDate >= '20250101'
      AND Orders.OrderDate <  '20260101'
    GROUP BY
        YEAR(Orders.OrderDate),
        MONTH(Orders.OrderDate),
        Customers.Segment,
        Orders.CustomerID
),

-- Krok 3: obliczenia pomocnicze używane w agregacji końcowej.
WynikiKlientowZWskaznikami AS
(
    SELECT
        rok,
        mies,
        seg,
        wart,
        CASE
            WHEN ile_zam > 1 THEN 1
            ELSE 0
        END AS czy_powracajacy
    FROM WynikiKlientow
)

SELECT
    rok,
    mies,
    seg,
    COUNT(*) AS ile_klientow,
    SUM(wart) AS wartosc,
    SUM(czy_powracajacy) AS powracajacy,
    ROUND(SUM(wart) / COUNT(*), 2) AS srednio_na_klienta,
    ROUND(
        100.0 * SUM(czy_powracajacy) / COUNT(*),
        1
    ) AS proc_powracajacych
FROM WynikiKlientowZWskaznikami
GROUP BY
    rok,
    mies,
    seg
ORDER BY
    1,
    2,
    3;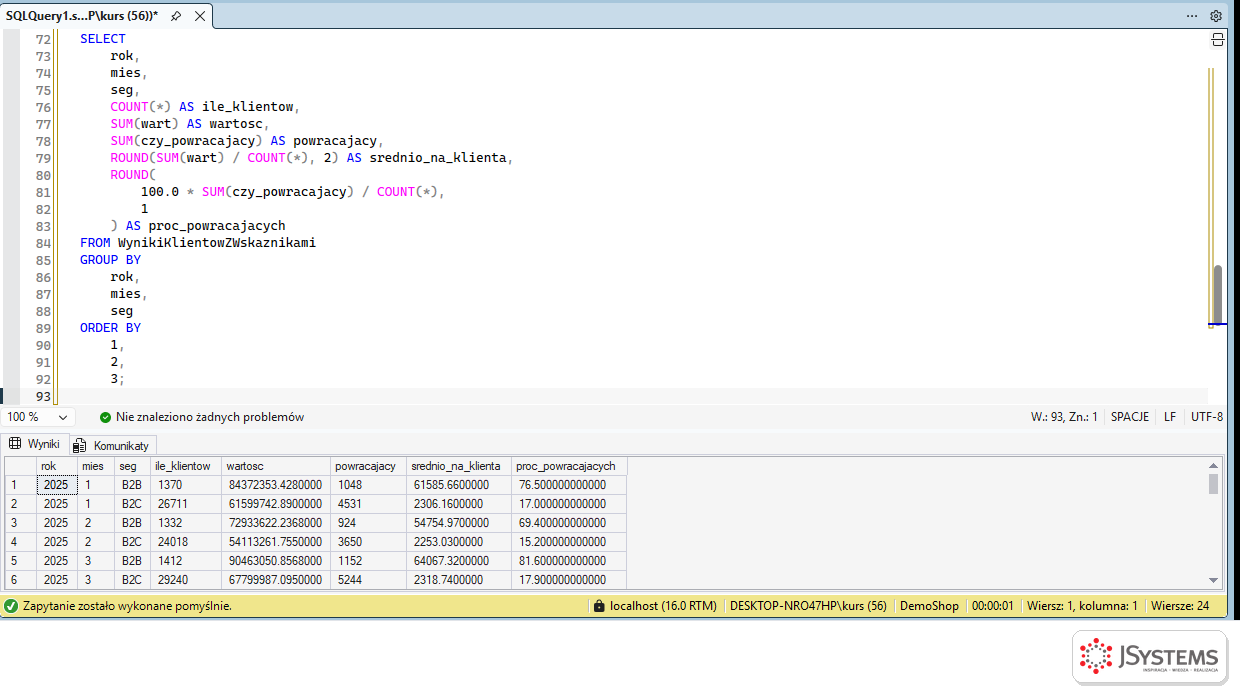
Przenoszenie zapytań między bazami to zadanie, w którym AI oszczędza najwięcej czasu, bo zna mapowania funkcji i składni wszystkich popularnych silników. Ryzyko leży w szczegółach, które nie powodują błędu, tylko zmieniają wynik: kolejność wierszy przy remisach, zaokrąglenia, sposób liczenia różnicy dat, traktowanie NULL i pustego tekstu, wielkość liter w nazwach. Dlatego każdą konwersję sprawdziliśmy tak samo: zapytanie źródłowe uruchomione w jego własnej bazie, wersja od AI uruchomiona w PostgreSQL, obie na tych samych danych z 2025 roku, wyniki porównane wiersz po wierszu, łącznie z kolejnością.
Polecenie do AI w każdym przypadku zawierało trzy informacje, które decydują o jakości konwersji: wersję docelowej bazy, sposób zapisu nazw tabel w PostgreSQL (małe litery, bez cudzysłowów) i wymóg identycznego wyniku. Do tego prośba o listę zamienionych konstrukcji, która później ułatwia przegląd kodu.
Zapytanie hierarchiczne to najtrudniejszy przypadek przy przenoszeniu kodu z Oracle, bo CONNECT BY nie ma w PostgreSQL odpowiednika jeden do jednego. Nasze zapytanie buduje drzewo pracowników z wcięciami, ścieżką przełożonych, liczbą zamówień z grudnia i sortowaniem rodzeństwa po nazwisku:
SELECT LPAD(' ', 2 * (LEVEL - 1)) || e.FirstName || ' ' || e.LastName AS Pracownik,
       e.JobTitle AS Stanowisko,
       LEVEL AS Poziom,
       SYS_CONNECT_BY_PATH(e.LastName, '/') AS Sciezka,
       NVL((SELECT COUNT(*) FROM Orders o
             WHERE o.EmployeeID = e.EmployeeID
               AND o.OrderDate >= DATE '2025-12-01'
               AND o.OrderDate < DATE '2026-01-01'), 0) AS ZamowieniaGrudzien,
       DECODE(e.ManagerID, NULL, 'zarząd', 'zespół') AS Rola,
       TO_CHAR(e.HireDate, 'YYYY-MM') AS Zatrudniony
FROM Employees e
START WITH e.ManagerID IS NULL
CONNECT BY PRIOR e.EmployeeID = e.ManagerID
ORDER SIBLINGS BY e.LastName;
Przekonwertuj to zapytanie z Oracle Database na PostgreSQL 15. Tabele i kolumny w PostgreSQL mają te same nazwy, zapisane małymi literami i bez cudzysłowów (employees, orders). Wynik w PostgreSQL ma być identyczny, łącznie z kolejnością wierszy. Pod kodem wypisz każdą konstrukcję Oracle, którą zamieniłeś, i na co.
[zapytanie]
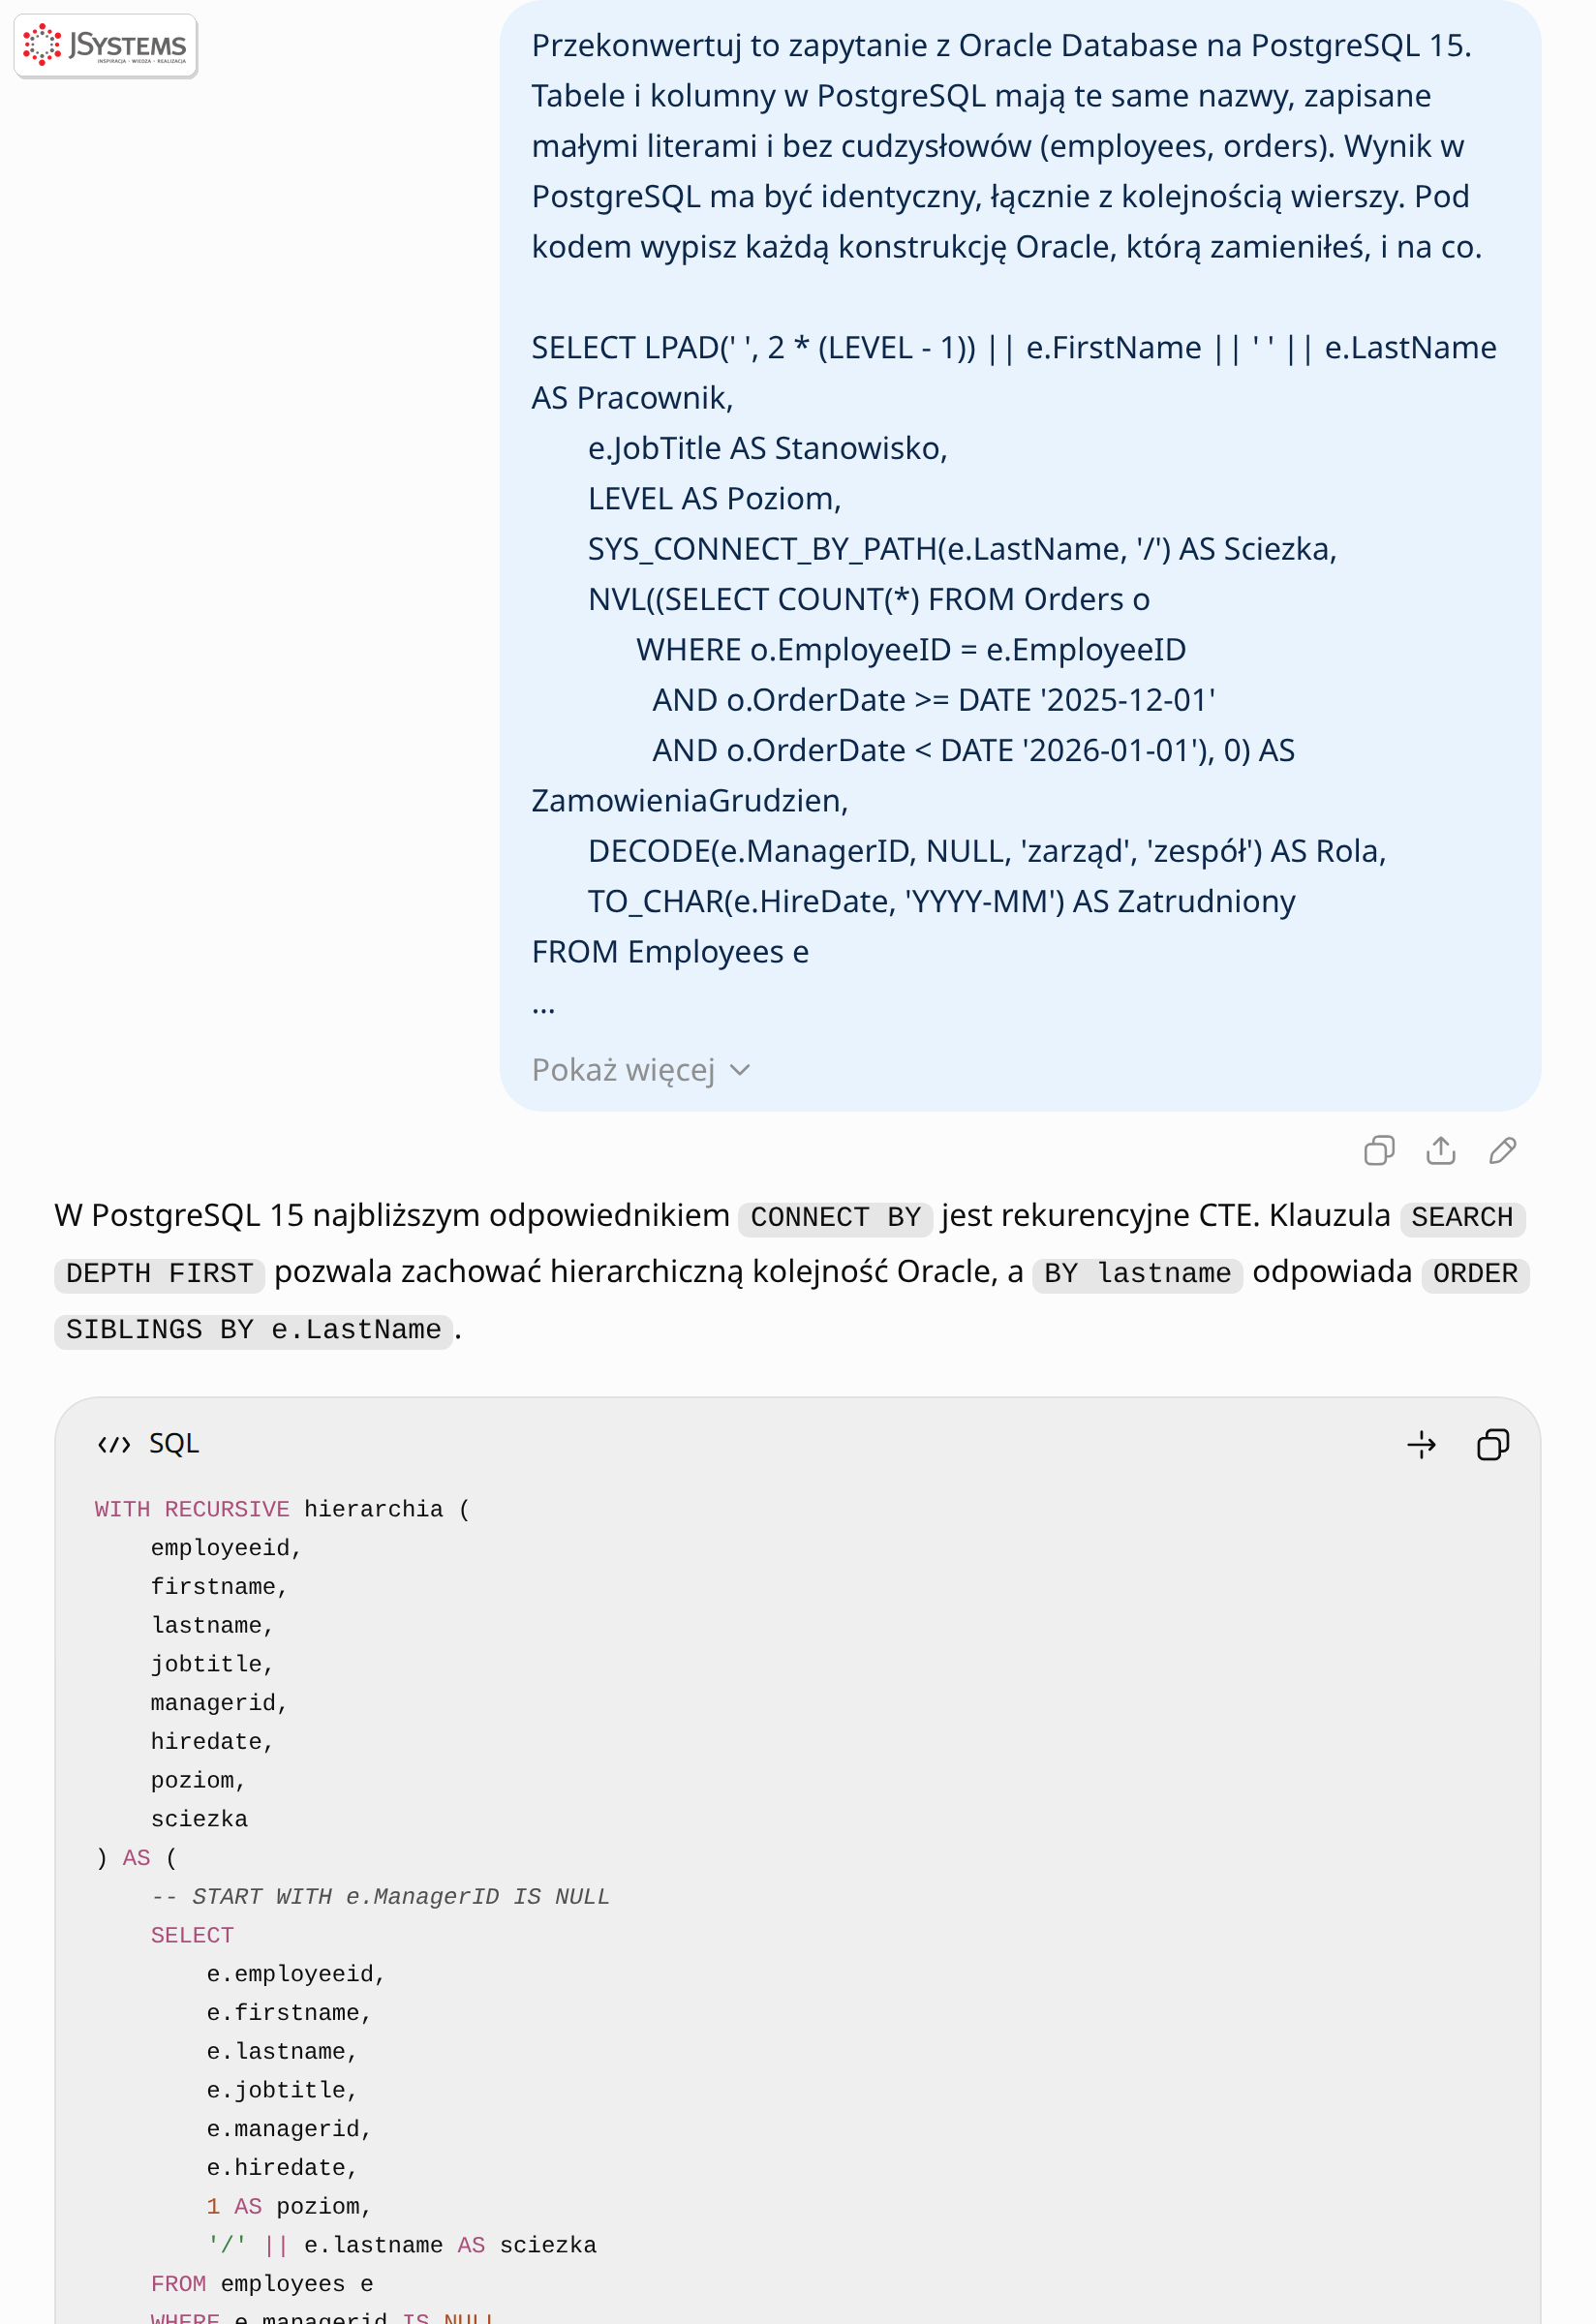
To rozwiązanie jest lepsze od tego, co zwykle widać w starszych przewodnikach, gdzie kolejność drzewa odtwarza się sortowaniem po sklejonej ścieżce tekstowej. Klauzula SEARCH DEPTH FIRST BY robi dokładnie to, co ORDER SIBLINGS BY w Oracle. AI dodało też uczciwe zastrzeżenie: gdy dwie osoby z tym samym przełożonym mają identyczne nazwisko, kolejność między nimi nie jest określona w żadnej z baz i dla pewności warto dodać drugi klucz sortowania.
Wersja dla PostgreSQL od ChatGPT do skopiowania, bez zmian, dokładnie ta, którą uruchomiliśmy:
WITH RECURSIVE hierarchia (
    employeeid,
    firstname,
    lastname,
    jobtitle,
    managerid,
    hiredate,
    poziom,
    sciezka
) AS (
    -- START WITH e.ManagerID IS NULL
    SELECT
        e.employeeid,
        e.firstname,
        e.lastname,
        e.jobtitle,
        e.managerid,
        e.hiredate,
        1 AS poziom,
        '/' || e.lastname AS sciezka
    FROM employees e
    WHERE e.managerid IS NULL

    UNION ALL

    -- CONNECT BY PRIOR e.EmployeeID = e.ManagerID
    SELECT
        e.employeeid,
        e.firstname,
        e.lastname,
        e.jobtitle,
        e.managerid,
        e.hiredate,
        h.poziom + 1,
        h.sciezka || '/' || e.lastname
    FROM employees e
    JOIN hierarchia h
      ON h.employeeid = e.managerid
)
SEARCH DEPTH FIRST BY lastname SET kolejnosc
SELECT
    LPAD(' ', 2 * (poziom - 1)) || firstname || ' ' || lastname AS pracownik,
    jobtitle AS stanowisko,
    poziom,
    sciezka,
    COALESCE(
        (
            SELECT COUNT(*)
            FROM orders o
            WHERE o.employeeid = hierarchia.employeeid
              AND o.orderdate >= DATE '2025-12-01'
              AND o.orderdate <  DATE '2026-01-01'
        ),
        0
    ) AS zamowieniagrudzien,
    CASE
        WHEN managerid IS NULL THEN 'zarząd'
        ELSE 'zespół'
    END AS rola,
    TO_CHAR(hiredate, 'YYYY-MM') AS zatrudniony
FROM hierarchia
ORDER BY kolejnosc;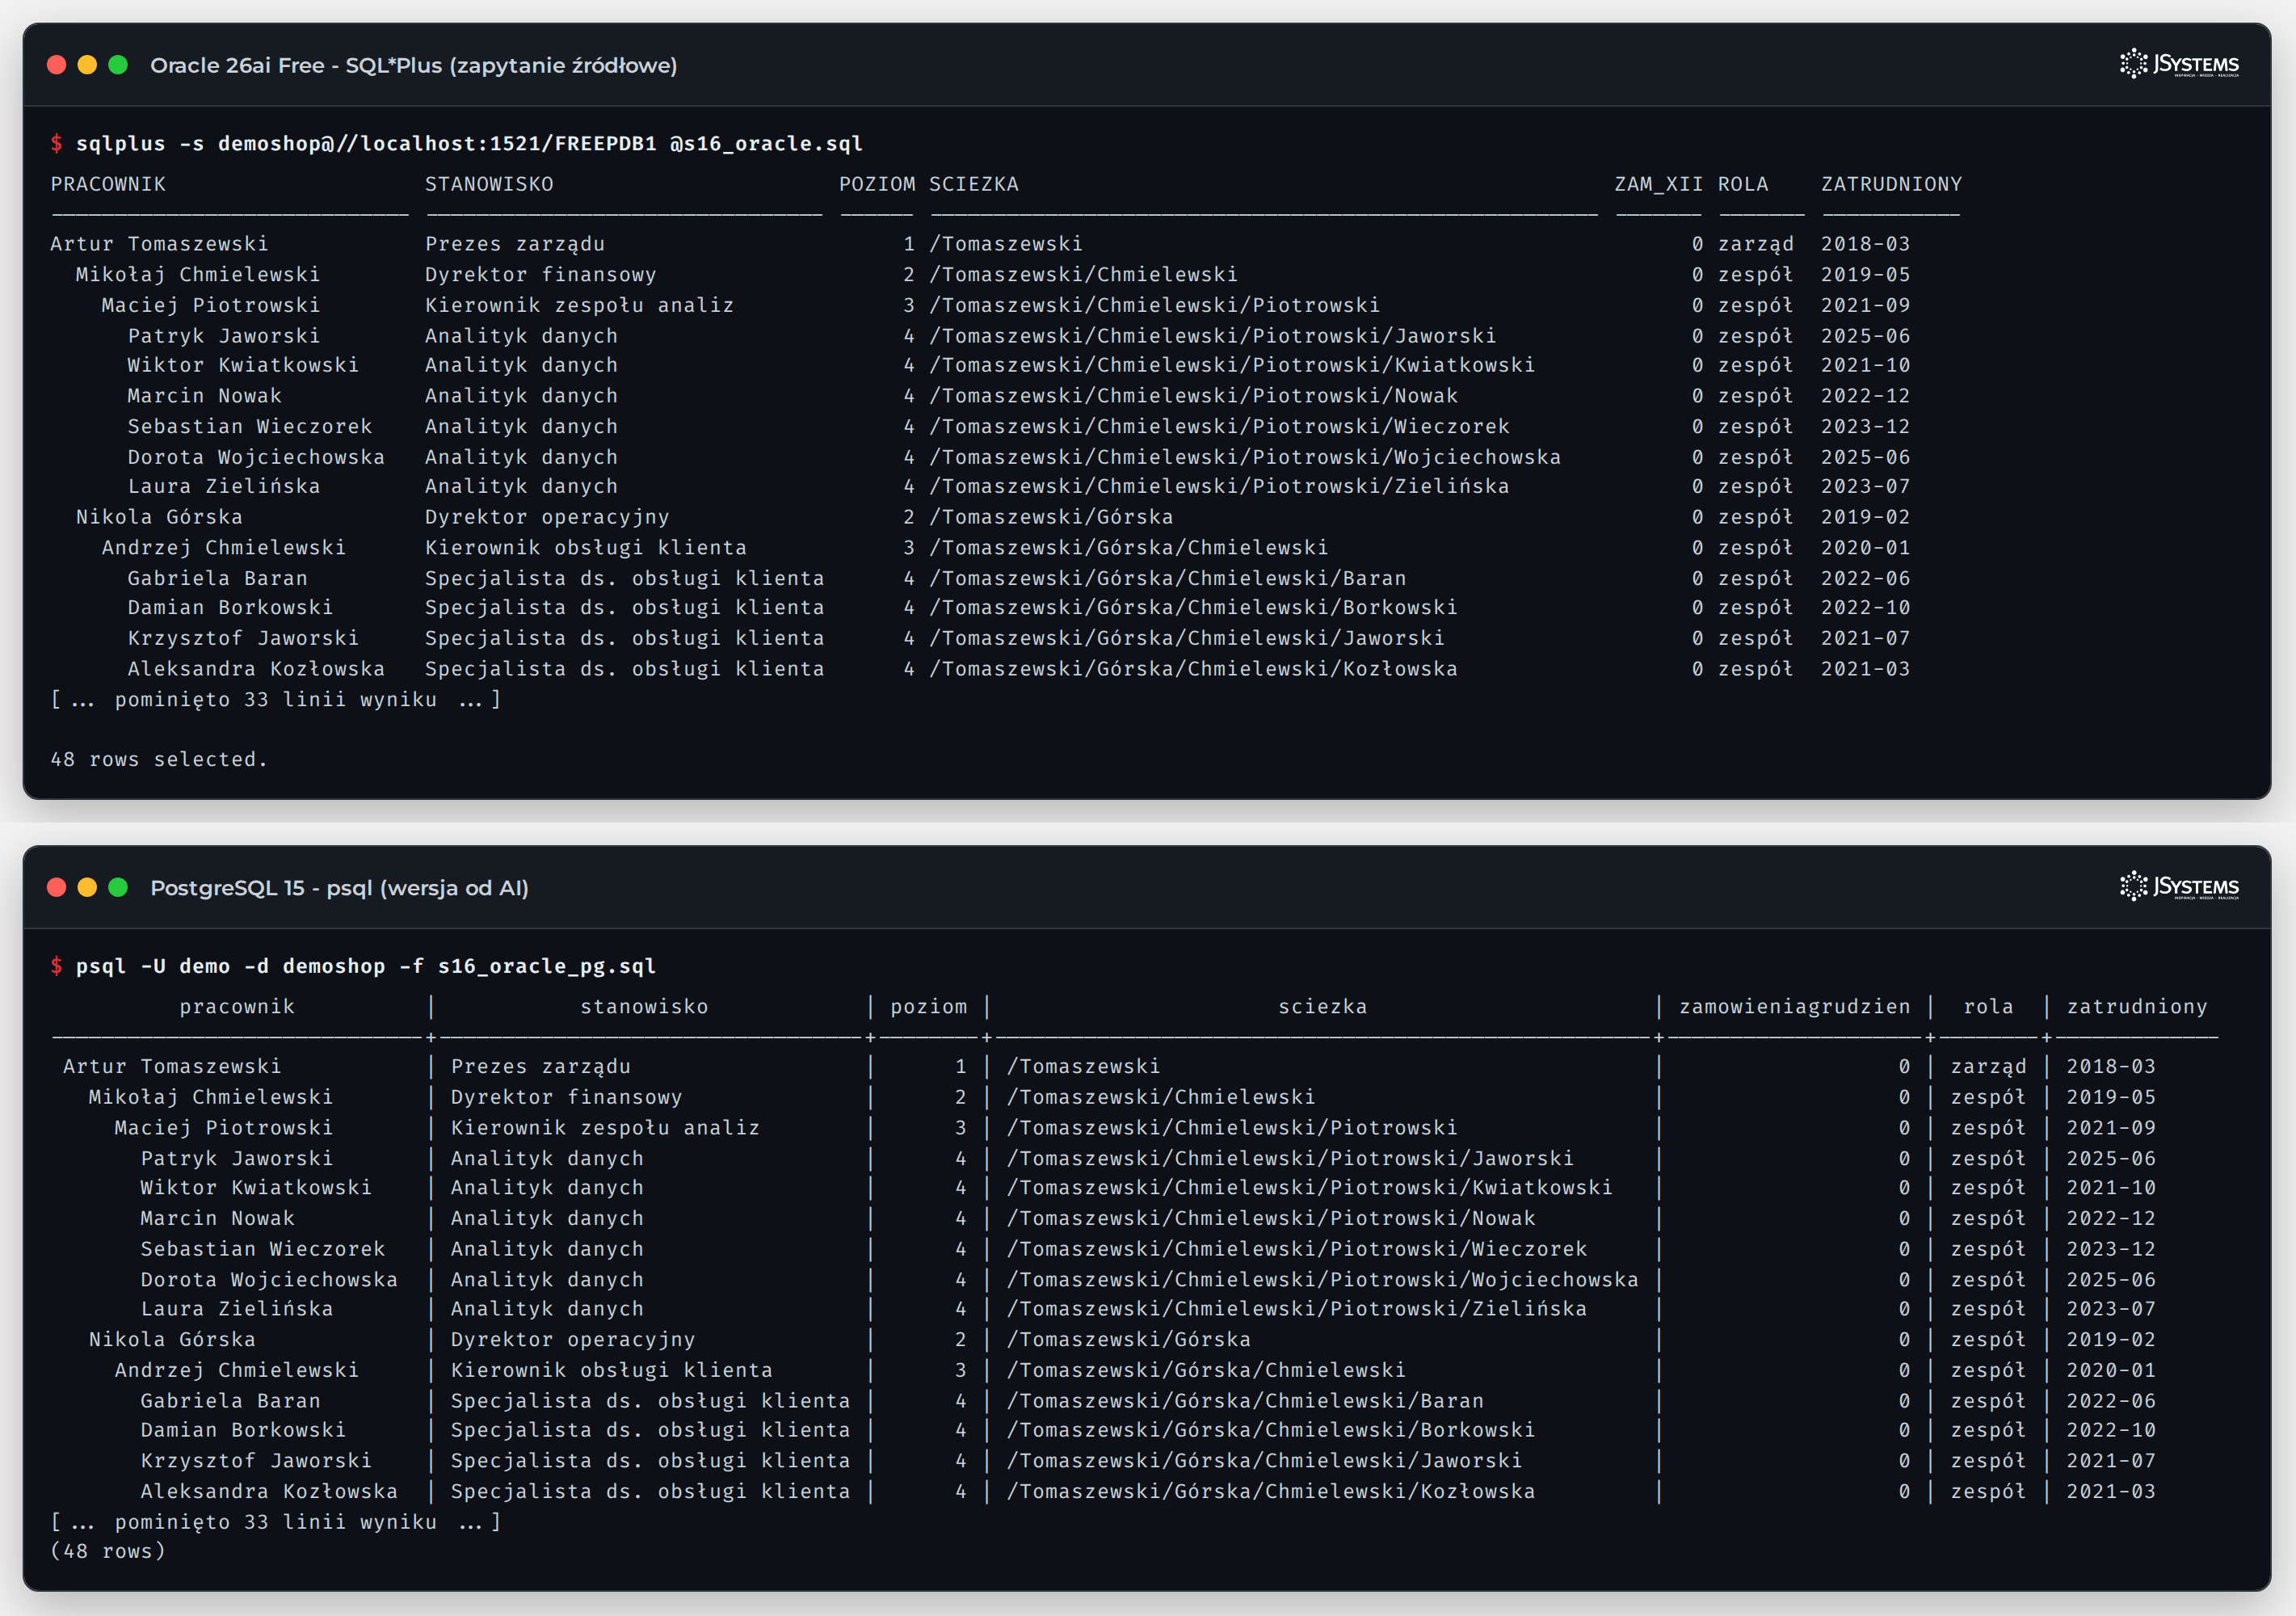
Zapytanie w T-SQL wybiera dziesięciu najaktywniejszych klientów indywidualnych 2025 roku z datą ostatniego zamówienia, liczbą dni aktywności i statusem ostatniego zamówienia pobranym przez CROSS APPLY:
SELECT TOP (10)
       c.CustomerID,
       c.FirstName + N' ' + c.LastName AS Klient,
       ISNULL(c.Country, 'PL') AS Kraj,
       COUNT(*) AS Zamowienia,
       FORMAT(MAX(o.OrderDate), 'yyyy-MM-dd') AS OstatnieZamowienie,
       DATEDIFF(DAY, MIN(o.OrderDate), MAX(o.OrderDate)) AS DniAktywnosci,
       IIF(COUNT(*) >= 20, N'stały', N'okazjonalny') AS Typ,
       ls.LastStatus
FROM dbo.Customers AS c
JOIN dbo.Orders AS o ON o.CustomerID = c.CustomerID
CROSS APPLY (SELECT TOP (1) o2.Status AS LastStatus
             FROM dbo.Orders AS o2
             WHERE o2.CustomerID = c.CustomerID
               AND o2.OrderDate >= '20250101' AND o2.OrderDate < '20260101'
             ORDER BY o2.OrderDate DESC) AS ls
WHERE o.OrderDate >= '20250101' AND o.OrderDate < '20260101'
  AND c.Segment = 'B2C'
GROUP BY c.CustomerID, c.FirstName, c.LastName, c.Country, ls.LastStatus
ORDER BY Zamowienia DESC, c.CustomerID;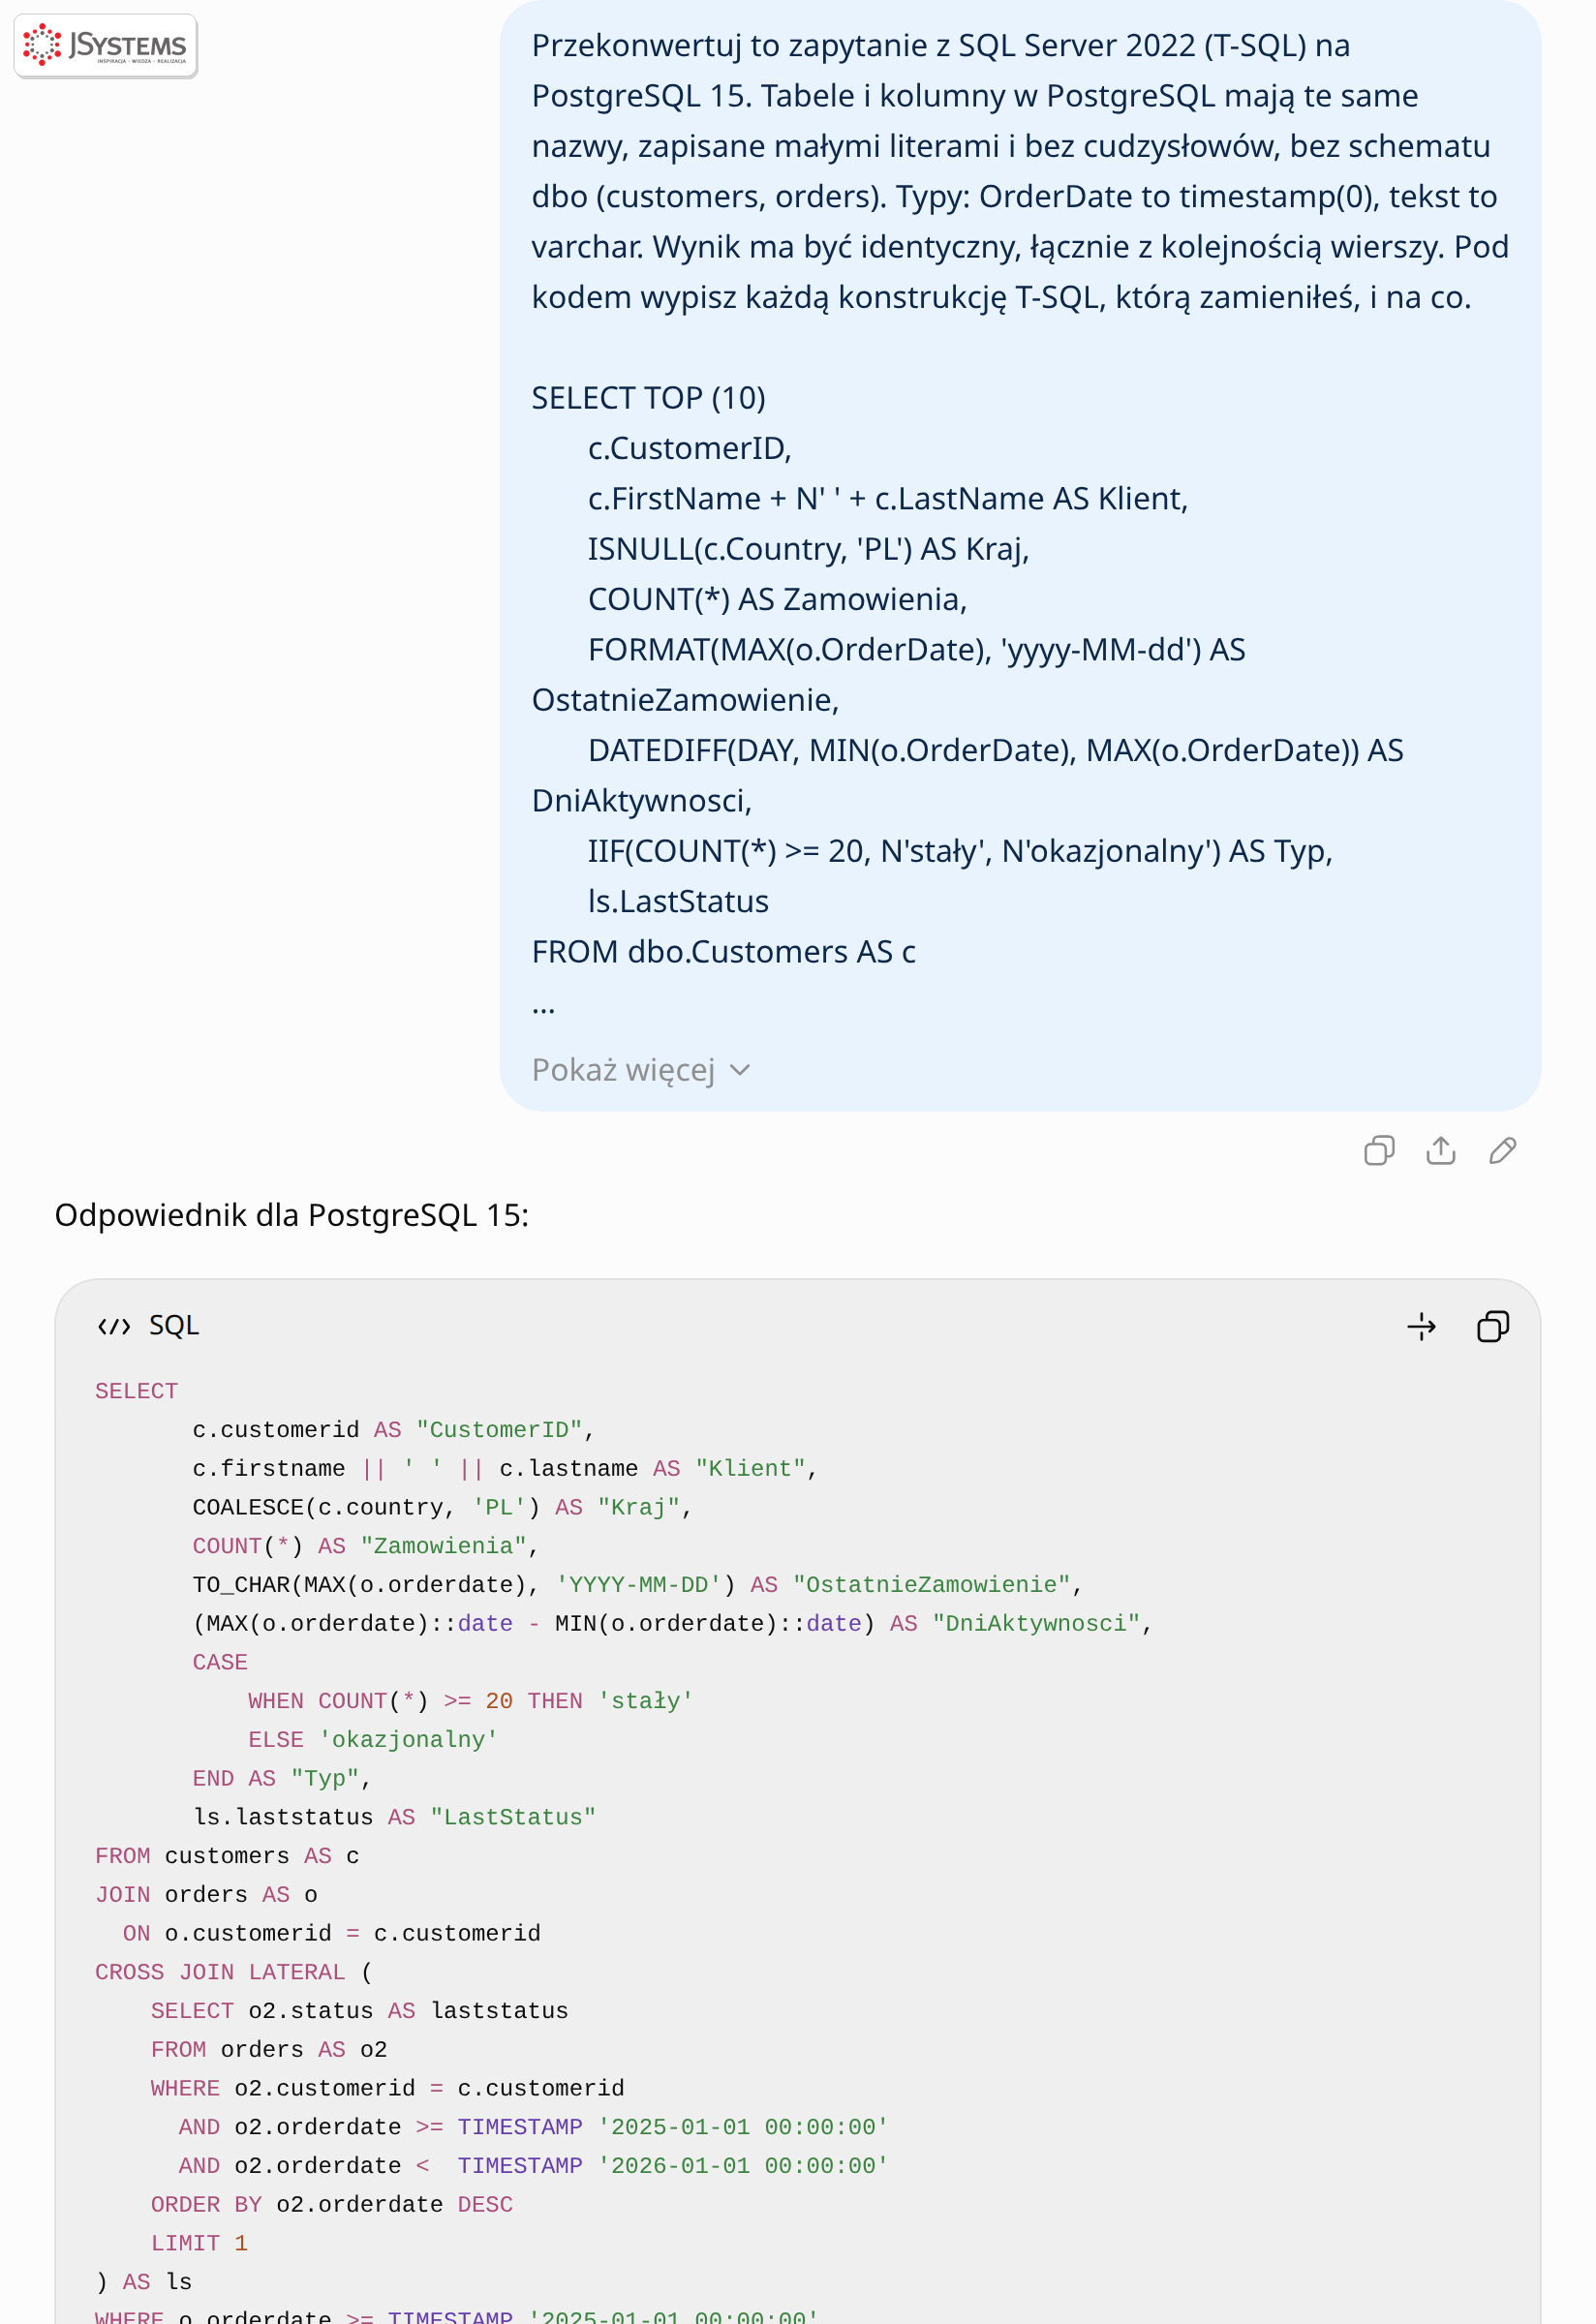
Dwa szczegóły z tej odpowiedzi warto zapamiętać. Pierwszy to DATEDIFF(DAY, ...): SQL Server liczy w nim przekroczone granice dni, a nie pełne doby, więc odpowiednikiem nie jest różnica znaczników czasu, tylko różnica dat po rzutowaniu na date, i dokładnie tak AI to zapisało. Drugi to aliasy kolumn w cudzysłowach (AS "Klient"): bez nich PostgreSQL zwróciłby nagłówki małymi literami, co przy aplikacji czytającej kolumny po nazwie może mieć znaczenie.
Wersja dla PostgreSQL od ChatGPT do skopiowania, bez zmian, dokładnie ta, którą uruchomiliśmy:
SELECT
       c.customerid AS "CustomerID",
       c.firstname || ' ' || c.lastname AS "Klient",
       COALESCE(c.country, 'PL') AS "Kraj",
       COUNT(*) AS "Zamowienia",
       TO_CHAR(MAX(o.orderdate), 'YYYY-MM-DD') AS "OstatnieZamowienie",
       (MAX(o.orderdate)::date - MIN(o.orderdate)::date) AS "DniAktywnosci",
       CASE
           WHEN COUNT(*) >= 20 THEN 'stały'
           ELSE 'okazjonalny'
       END AS "Typ",
       ls.laststatus AS "LastStatus"
FROM customers AS c
JOIN orders AS o
  ON o.customerid = c.customerid
CROSS JOIN LATERAL (
    SELECT o2.status AS laststatus
    FROM orders AS o2
    WHERE o2.customerid = c.customerid
      AND o2.orderdate >= TIMESTAMP '2025-01-01 00:00:00'
      AND o2.orderdate <  TIMESTAMP '2026-01-01 00:00:00'
    ORDER BY o2.orderdate DESC
    LIMIT 1
) AS ls
WHERE o.orderdate >= TIMESTAMP '2025-01-01 00:00:00'
  AND o.orderdate <  TIMESTAMP '2026-01-01 00:00:00'
  AND c.segment = 'B2C'
GROUP BY
       c.customerid,
       c.firstname,
       c.lastname,
       c.country,
       ls.laststatus
ORDER BY "Zamowienia" DESC, c.customerid
LIMIT 10;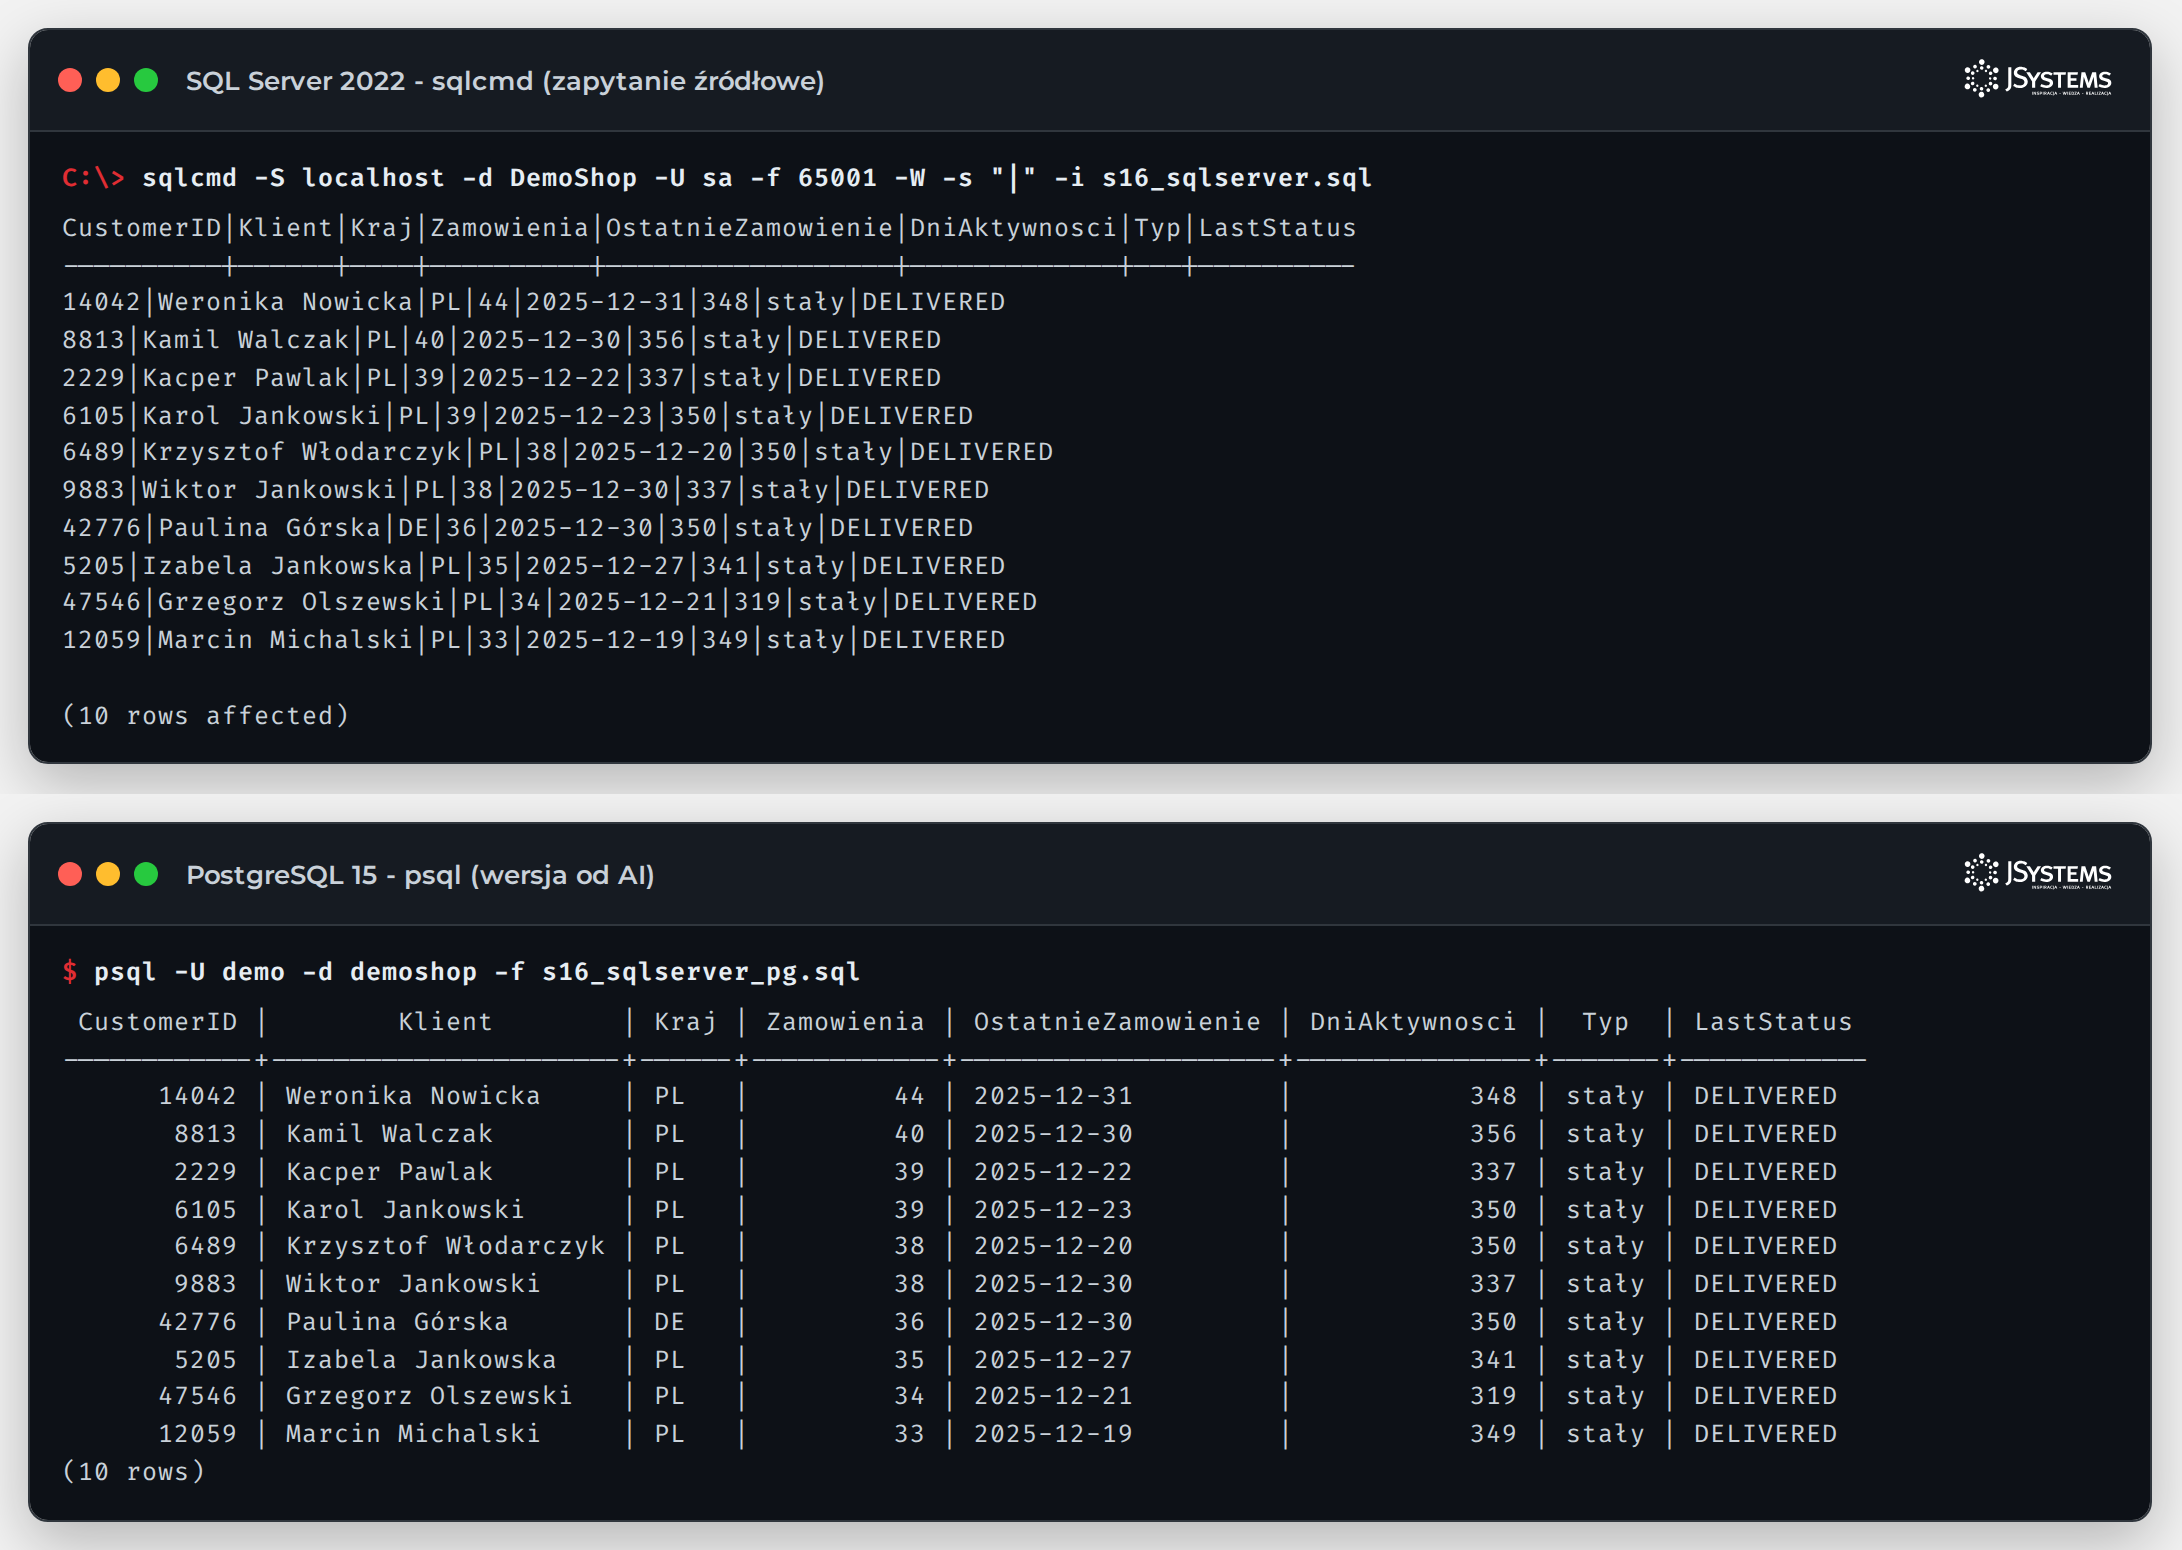
SELECT p.CategoryID,
       COUNT(DISTINCT p.ProductID) AS Produkty,
       GROUP_CONCAT(DISTINCT o.Channel ORDER BY o.Channel SEPARATOR ', ') AS Kanaly,
       IFNULL(ROUND(SUM(oi.Quantity * oi.UnitPrice * (100 - oi.DiscountPct) / 100), 2), 0) AS Sprzedaz,
       DATE_FORMAT(MAX(o.OrderDate), '%Y-%m-%d') AS OstatnieZamowienie
FROM `Products` p
JOIN `OrderItems` oi ON oi.ProductID = p.ProductID
JOIN `Orders` o ON o.OrderID = oi.OrderID
WHERE p.CategoryID IN (53, 54)
  AND o.Status <> 'CANCELLED'
GROUP BY p.CategoryID
ORDER BY Sprzedaz DESC
LIMIT 0, 5;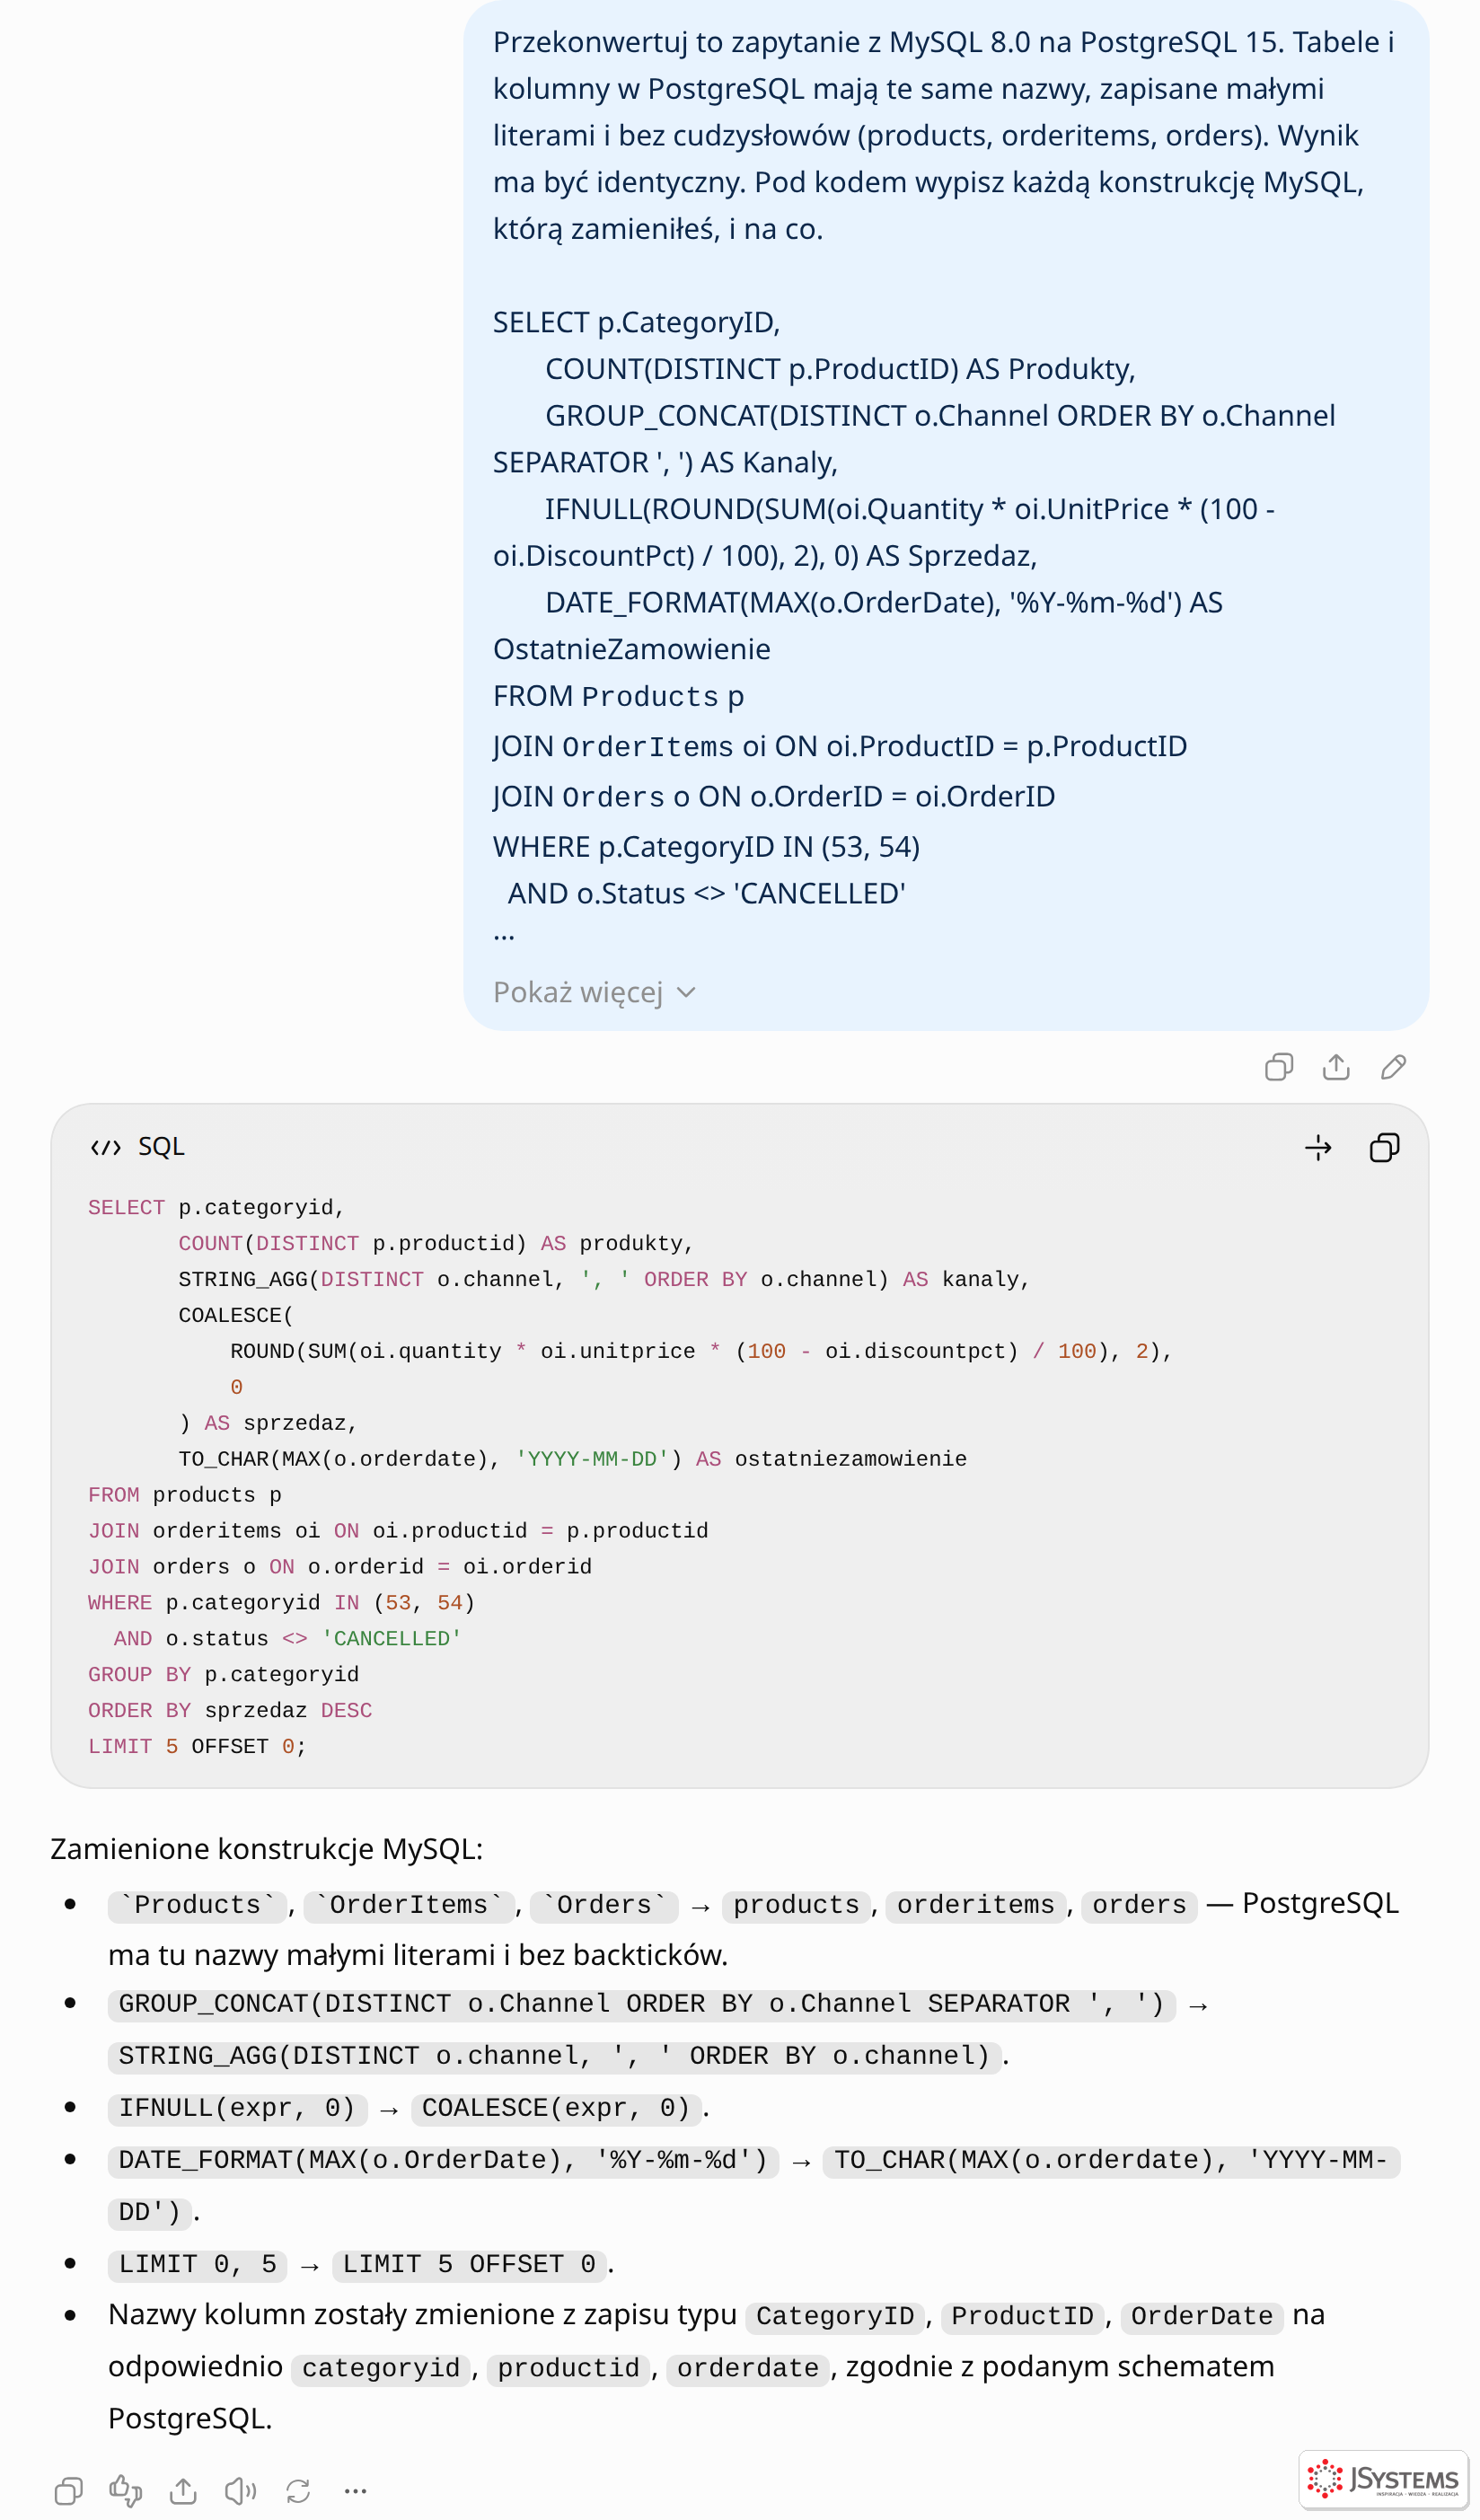
Wersja dla PostgreSQL od ChatGPT do skopiowania, bez zmian, dokładnie ta, którą uruchomiliśmy:
SELECT p.categoryid,
       COUNT(DISTINCT p.productid) AS produkty,
       STRING_AGG(DISTINCT o.channel, ', ' ORDER BY o.channel) AS kanaly,
       COALESCE(
           ROUND(SUM(oi.quantity * oi.unitprice * (100 - oi.discountpct) / 100), 2),
           0
       ) AS sprzedaz,
       TO_CHAR(MAX(o.orderdate), 'YYYY-MM-DD') AS ostatniezamowienie
FROM products p
JOIN orderitems oi ON oi.productid = p.productid
JOIN orders o ON o.orderid = oi.orderid
WHERE p.categoryid IN (53, 54)
  AND o.status <> 'CANCELLED'
GROUP BY p.categoryid
ORDER BY sprzedaz DESC
LIMIT 5 OFFSET 0;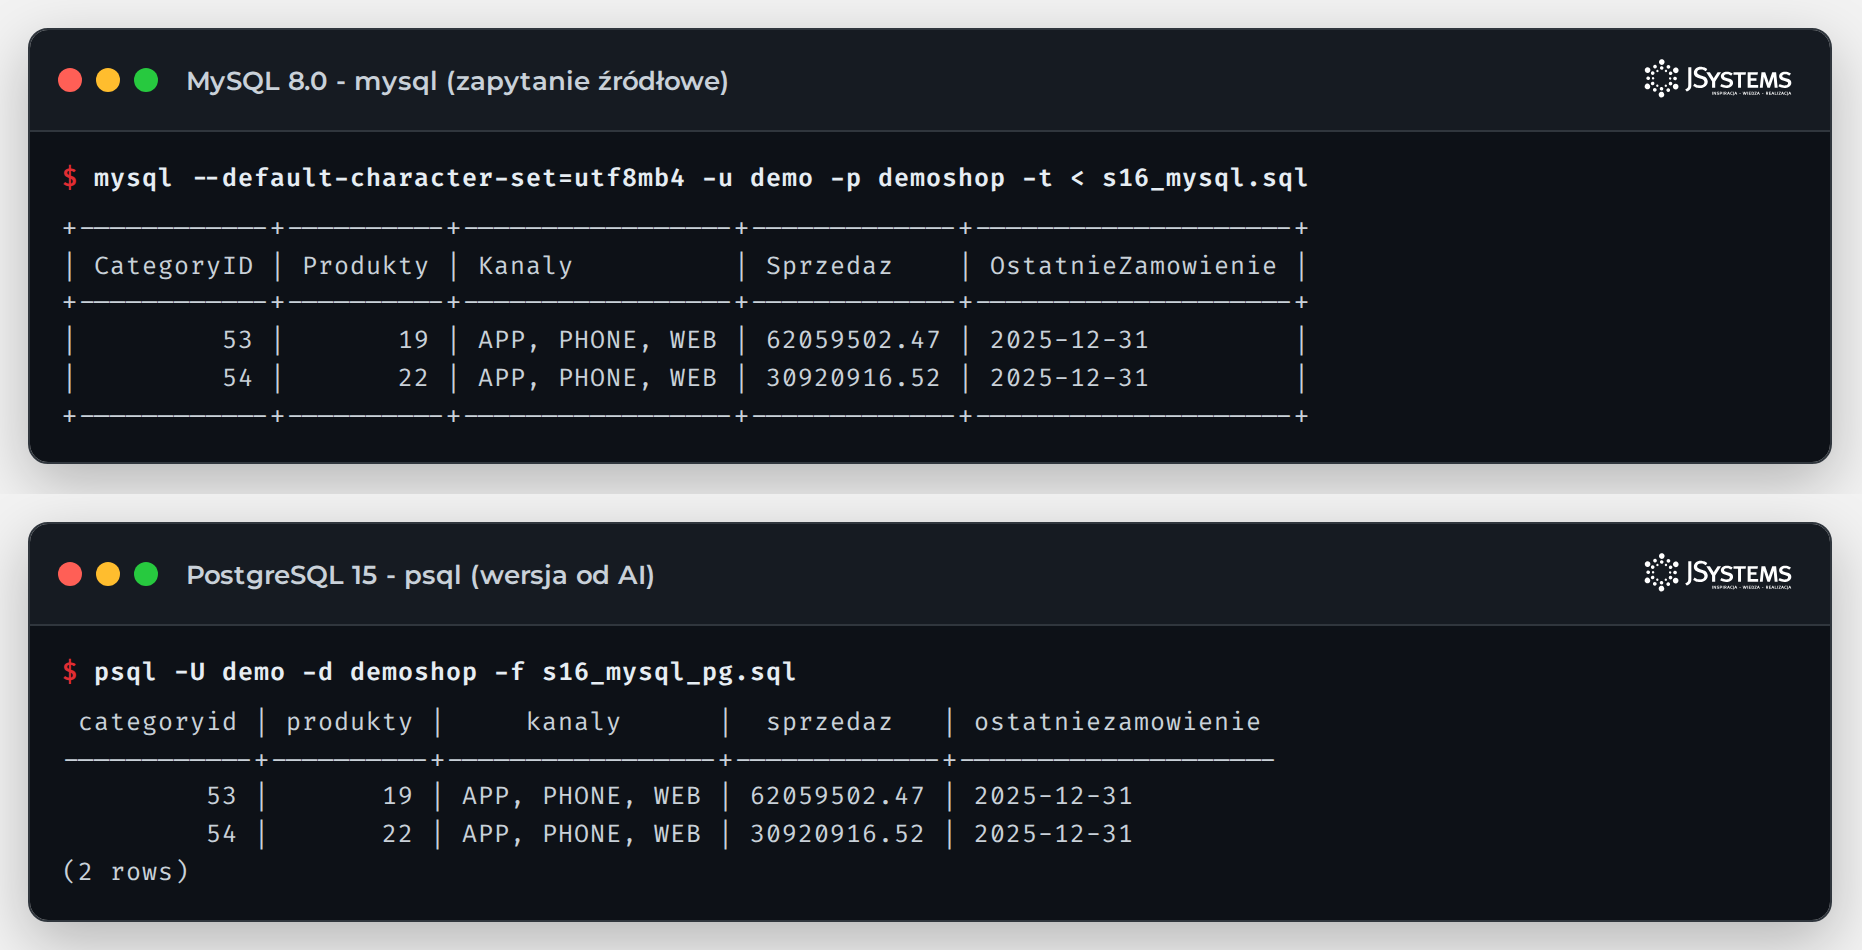
| Obszar | Pułapka | Jak sprawdzić |
|---|---|---|
| Wielkość liter w nazwach | PostgreSQL zamienia nazwy bez cudzysłowów na małe litery; tabele utworzone jako "Orders" wymagają cudzysłowów zawsze | Podaj AI, jak nazwano tabele w bazie docelowej |
| Kolejność wierszy | Remisy w ORDER BY rozstrzygane różnie w różnych silnikach | Porównanie wyników z kolejnością, dodatkowy klucz sortowania |
| Daty i czas | DATEDIFF liczy granice, odejmowanie znaczników czasu liczy doby; różne domyślne formaty i strefy | Przypadki na granicach dni i miesięcy |
| NULL i pusty tekst | Oracle traktuje '' jak NULL, PostgreSQL i SQL Server nie | Dane testowe z pustymi tekstami |
| Typy liczbowe | Dzielenie całkowite i różna precyzja wyników dzielenia | Sumy kontrolne na wynikach liczbowych |
| Sortowanie tekstu | Różne collation dają różną kolejność polskich znaków | Porównanie kolejności dla nazw z ogonkami |
Wszystkie trzy konwersje dały wynik identyczny ze źródłem. To dobry wynik, ale nie powód, żeby rezygnować z porównania. Te zapytania liczyły się na danych bez remisów i bez pustych tekstów, a pułapki z tabeli wychodzą właśnie na takich przypadkach. Do ich wyszukania przydają się testy z części o testach SQL z AI.
Część 6 z 8 przewodnika AI w SQL


Komentarze (0)
Brak komentarzy...