Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
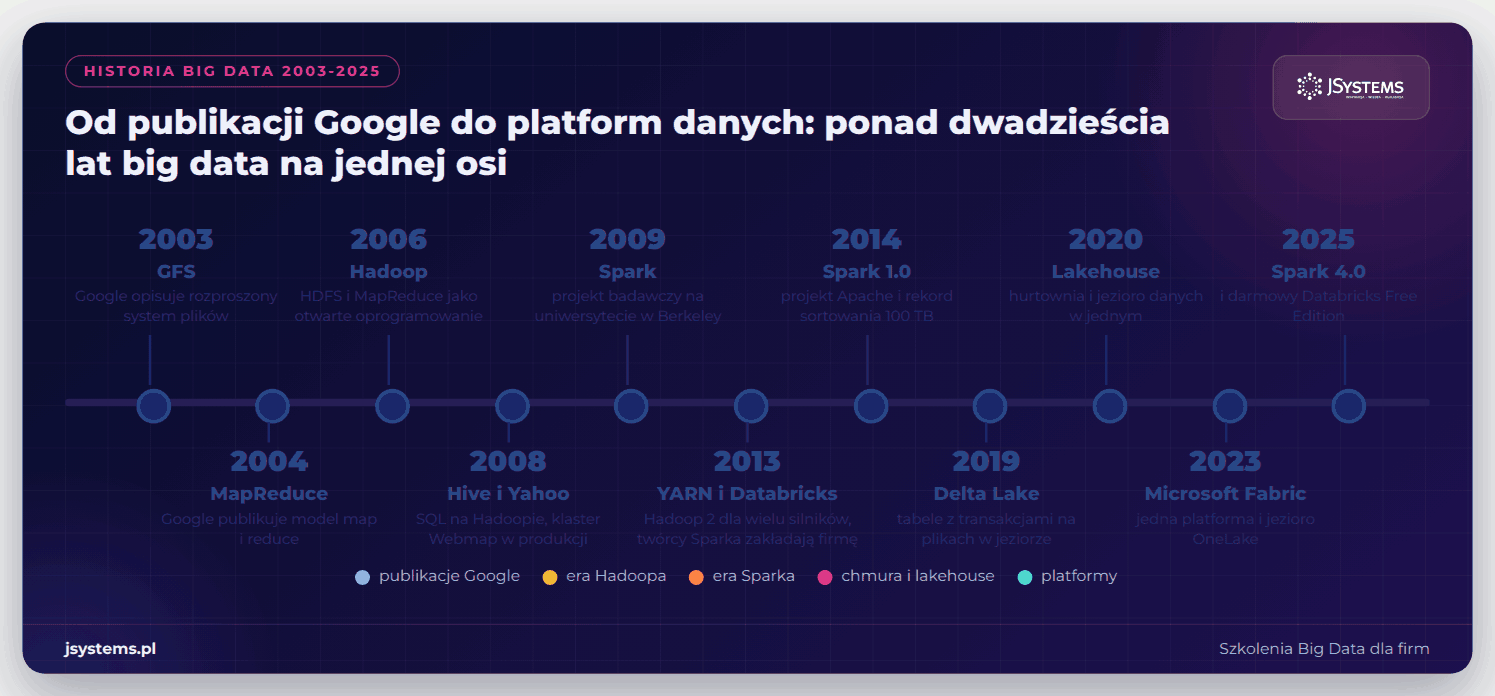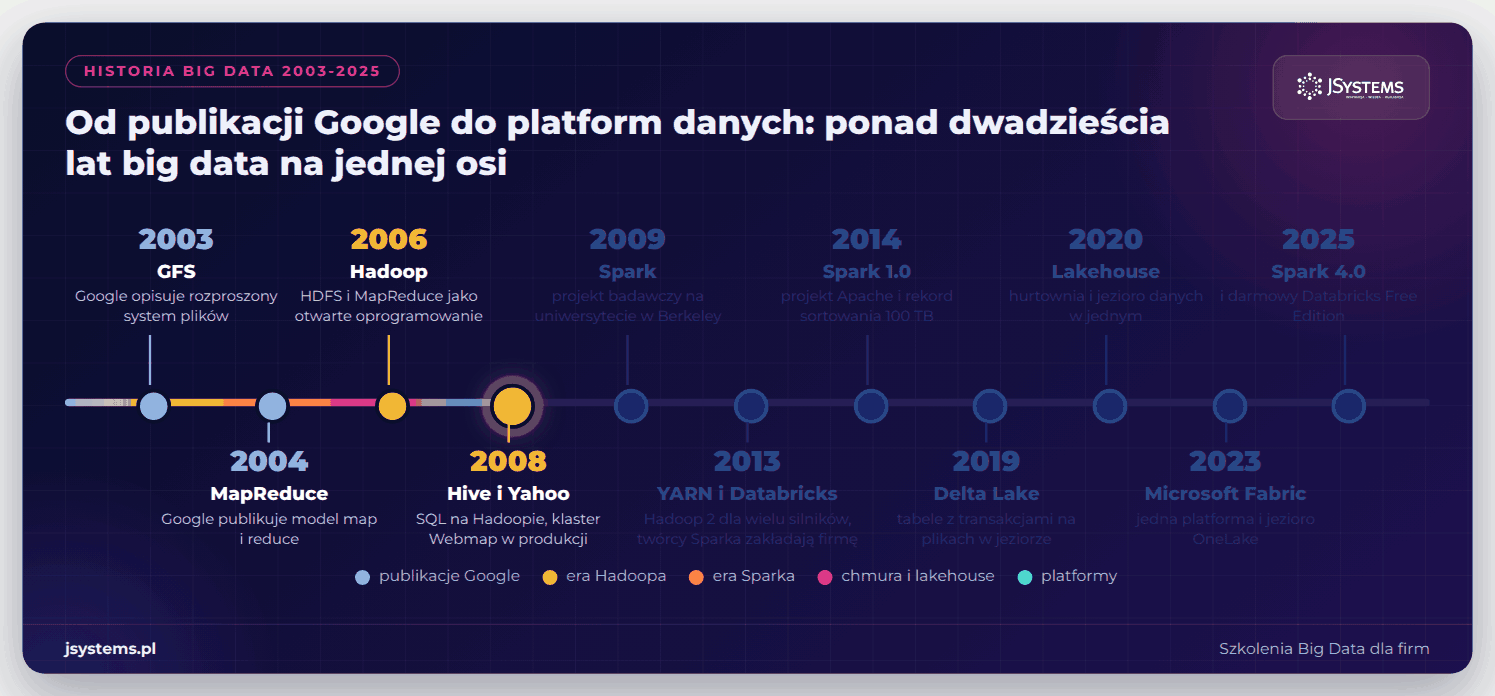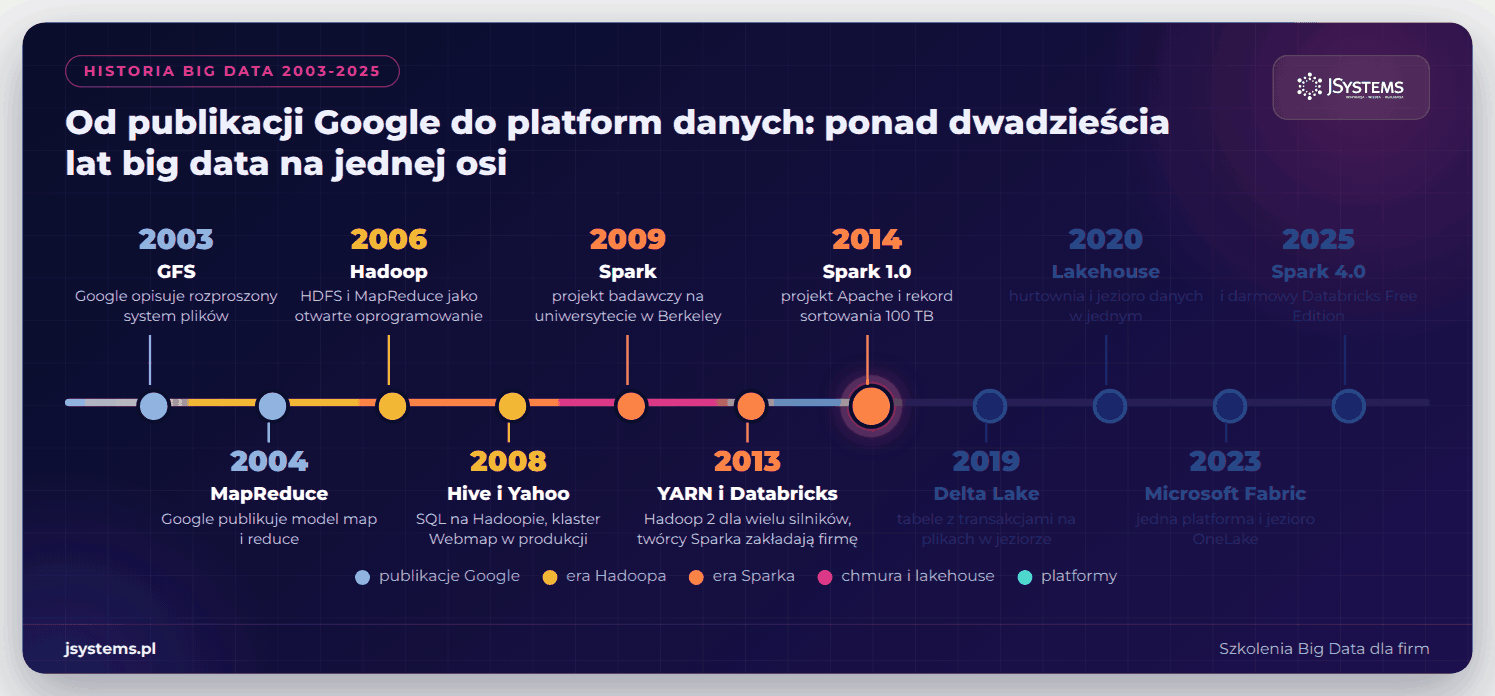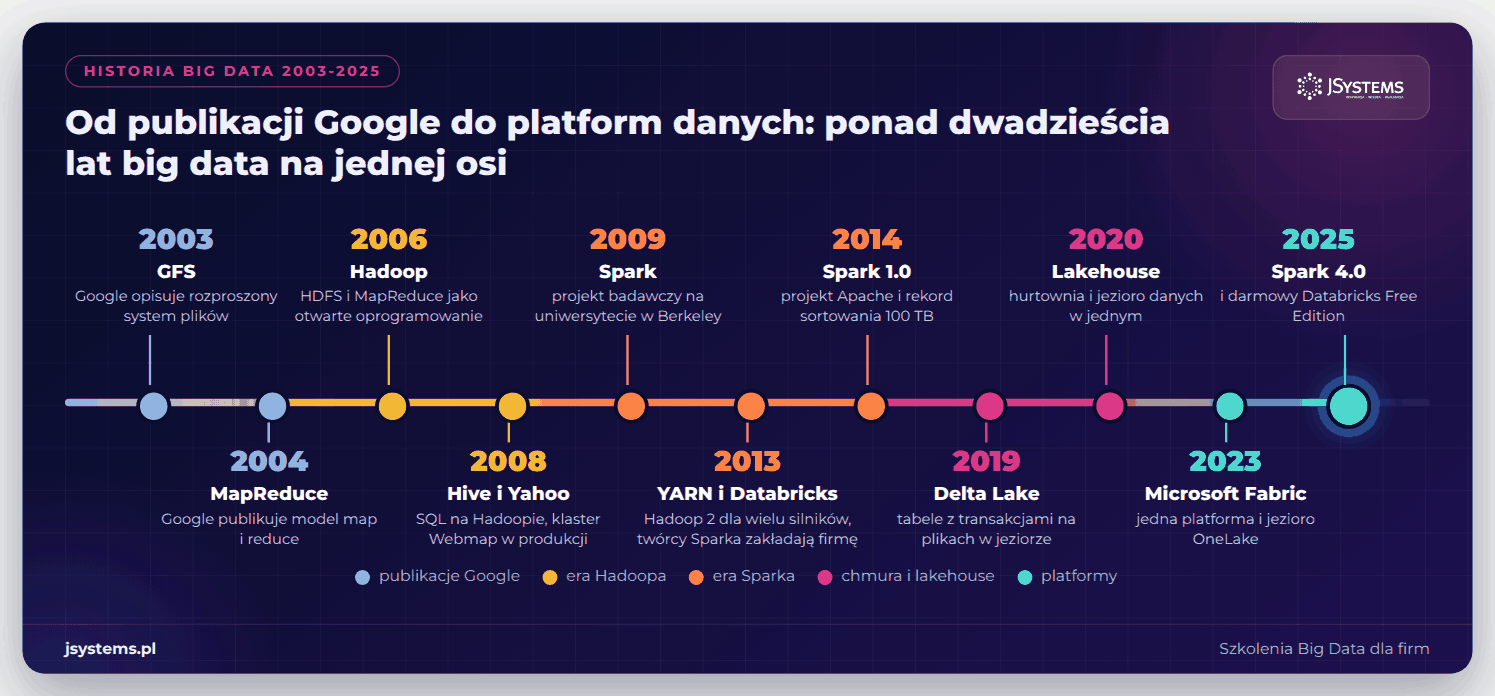
W skrócieHistoria big data to dwadzieścia lat drogi od danych, które przestały mieścić się w jednym serwerze, do platform, w których klastra w ogóle nie widać. Google opisał GFS i MapReduce, Hadoop zamienił te pomysły w otwarte oprogramowanie, Spark przeniósł obliczenia do pamięci, a Databricks i Microsoft Fabric połączyły jezioro danych z hurtownią.
Dwadzieścia lat temu policzenie słów w kilku terabajtach tekstu było zadaniem dla zespołu inżynierów z własnym klastrem serwerów. Dziś ten sam rachunek robią trzy linie PySparka w notatniku w przeglądarce, a wynik ląduje w tabeli, do której zajrzysz zwykłym SQL-em. Między tymi punktami mieści się cała historia big data: publikacje Google, Hadoop, firmy, które wokół niego wyrosły, Spark, chmura, lakehouse i platformy w rodzaju Databricks i Microsoft Fabric. Czym jest samo big data, z jakich warstw składa się dziś krajobraz narzędzi i czym różnią się główne platformy, opisujemy w artykule Co to jest big data? Pojęcia, krajobraz technologiczny i platformy.
Żeby nie skończyło się na samych datach, przeprowadzimy przez tę historię jeden problem. Policzymy, ile razy każde słowo występuje w „Panu Tadeuszu”, kolejno pięcioma narzędziami z kolejnych epok: MapReduce w Javie, Hadoop Streaming w Pythonie, Hive, Spark i tabelą Delta. Po drodze to samo policzymy też w notatnikach Databricks i Microsoft Fabric. Wszystkie wersje liczą ten sam tekst i zwracają te same wyniki (w pliku powielonym tysiąc razy, na którym mierzymy czasy, liczby są po prostu tysiąc razy większe), więc dobrze widać, co zmieniało się z epoki na epokę: ilość kodu, czas oczekiwania na wynik i wiedza potrzebna do uruchomienia zadania.
Z tego artykułu dowiesz się
Pliki do pobrania
Ten sam tekst i kod, na którym liczymy słowa w każdej epoce. Uruchomisz je na własnym komputerze z Linuksem.
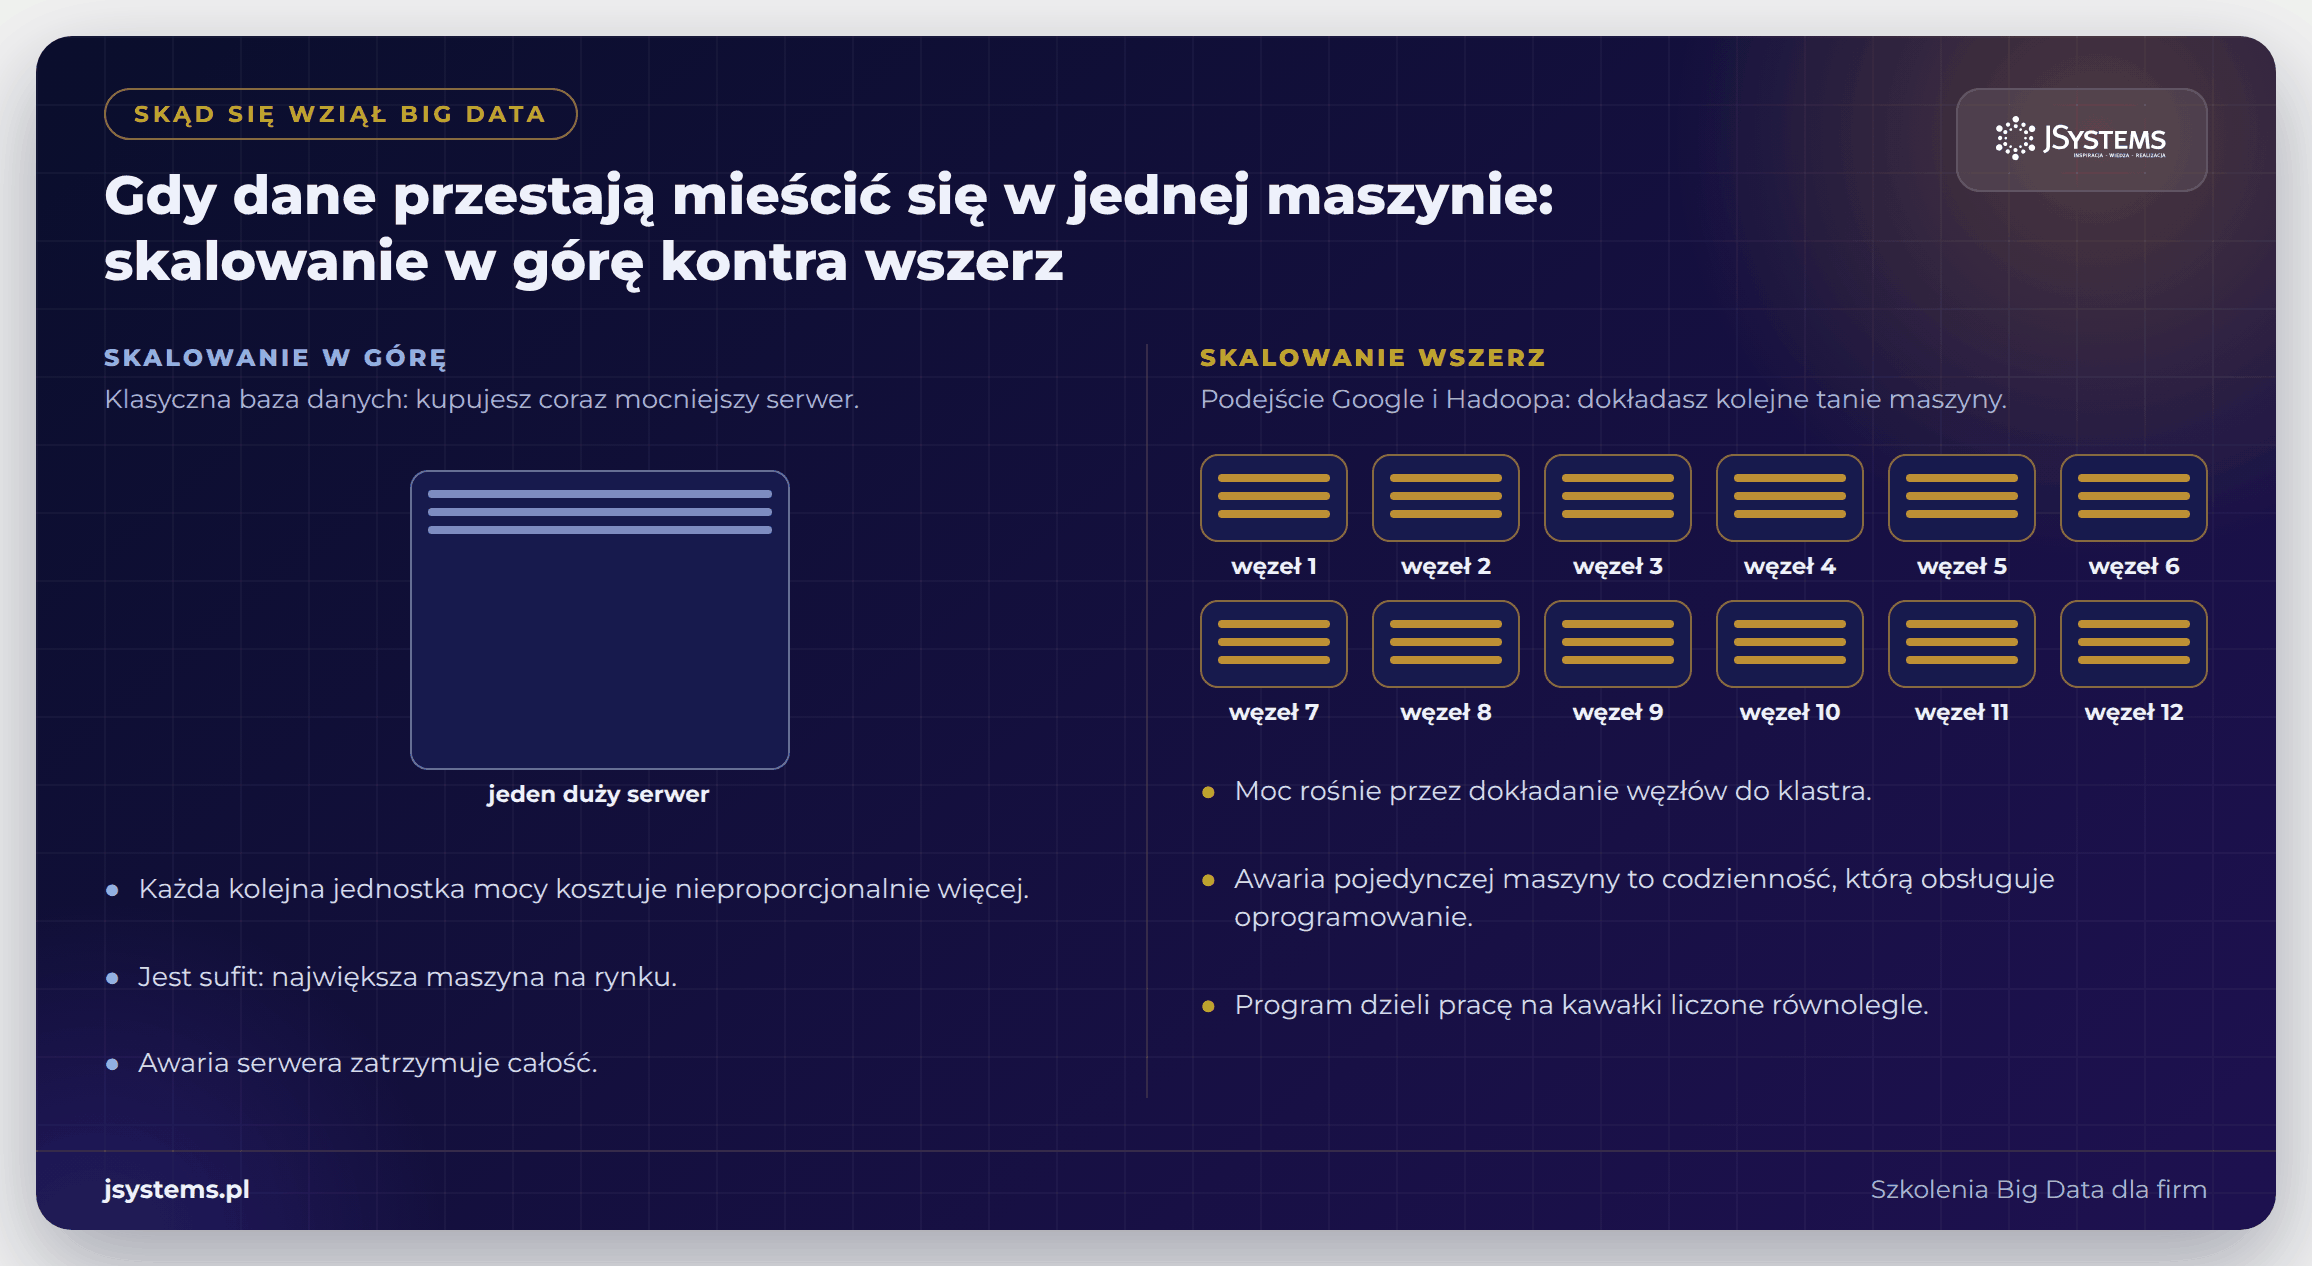
Na początku XXI wieku wyszukiwarki internetowe musiały co kilka dni przeczytać i zaindeksować miliardy stron. Baza danych na jednym serwerze, nawet najmocniejszym, nie miała na to ani dysków, ani czasu. Do wyboru były dwie drogi: kupować coraz większe maszyny albo połączyć setki zwykłych, tanich komputerów w klaster, czyli grupę maszyn, które razem pracują nad jednym zadaniem. Każdą maszynę w klastrze nazywamy węzłem.
Google wybrał drugą drogę i od razu przyjął założenie, które ukształtowało całą późniejszą historię: przy tysiącach tanich dysków i serwerów awaria jest codziennością, więc obsługiwać ją musi oprogramowanie, a nie administrator. Program dzieli pracę na małe kawałki, rozsyła je na węzły i powtarza te, które przepadły razem z uszkodzoną maszyną.
Sam termin „big data” pojawiał się w tekstach inżynierów już pod koniec lat 90. W 1997 roku Michael Cox i David Ellsworth z ośrodka NASA Ames nazwali w raporcie „problemem big data” sytuację, w której dane do wizualizacji nie mieszczą się ani w pamięci, ani na lokalnym dysku komputera. W latach 1998-1999 John Mashey z firmy Silicon Graphics wygłaszał wykład „Big Data and the Next Wave of InfraStress” o rosnących wymaganiach wobec infrastruktury, między innymi na konferencji USENIX w 1999 roku. W 2001 roku analityk Doug Laney z firmy META Group opisał trzy wymiary wyzwań w zarządzaniu danymi: objętość (volume), szybkość napływu (velocity) i różnorodność (variety). Sama notatka Laneya nie używa jeszcze słów „big data”. Z pojęciem big data te trzy wymiary, nazywane dziś 3V, powiązano dopiero później. Od tamtej pory otwierają wiele wprowadzeń do tematu, często uzupełnione o wiarygodność (veracity) i wartość (value).
W październiku 2003 roku na konferencji SOSP inżynierowie Google Sanjay Ghemawat, Howard Gobioff i Shun-Tak Leung opisali Google File System (GFS), rozproszony system plików dla tysięcy tanich serwerów. Duże pliki są w nim dzielone na kawałki po 64 MB, a każdy kawałek leży w trzech kopiach na różnych maszynach. Jeden serwer główny pamięta tylko, gdzie są kawałki, a same dane płyną bezpośrednio między programem a serwerami, które je przechowują.
Rok później, w grudniu 2004 roku na konferencji OSDI, Jeffrey Dean i Sanjay Ghemawat pokazali MapReduce, czyli model programowania, w którym programista pisze tylko dwie funkcje. Funkcja map dostaje fragment danych i wypisuje pary klucz i wartość. Funkcja reduce dostaje wszystkie wartości z tym samym kluczem i składa z nich wynik. Resztą zajmuje się biblioteka: dzieli dane, rozsyła zadania na setki maszyn, ponawia je po awariach i zbiera wyniki. Pierwszym przykładem w tej publikacji jest liczenie wystąpień słów w dużym zbiorze dokumentów.
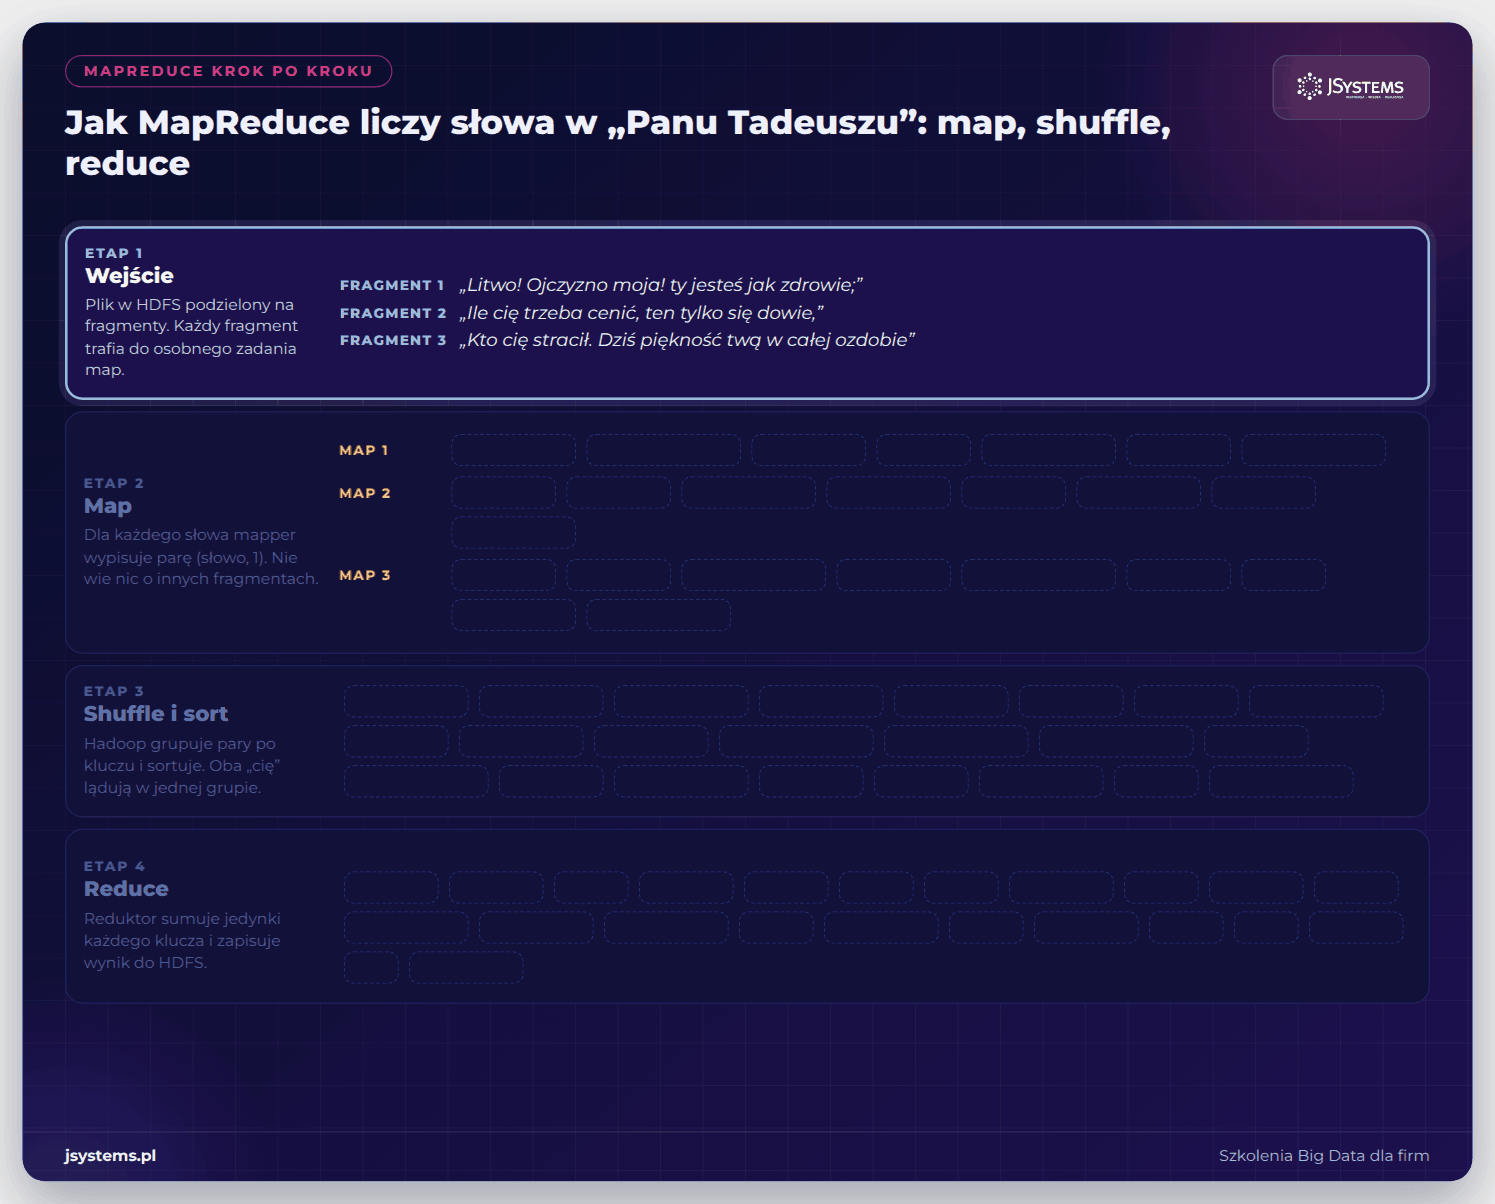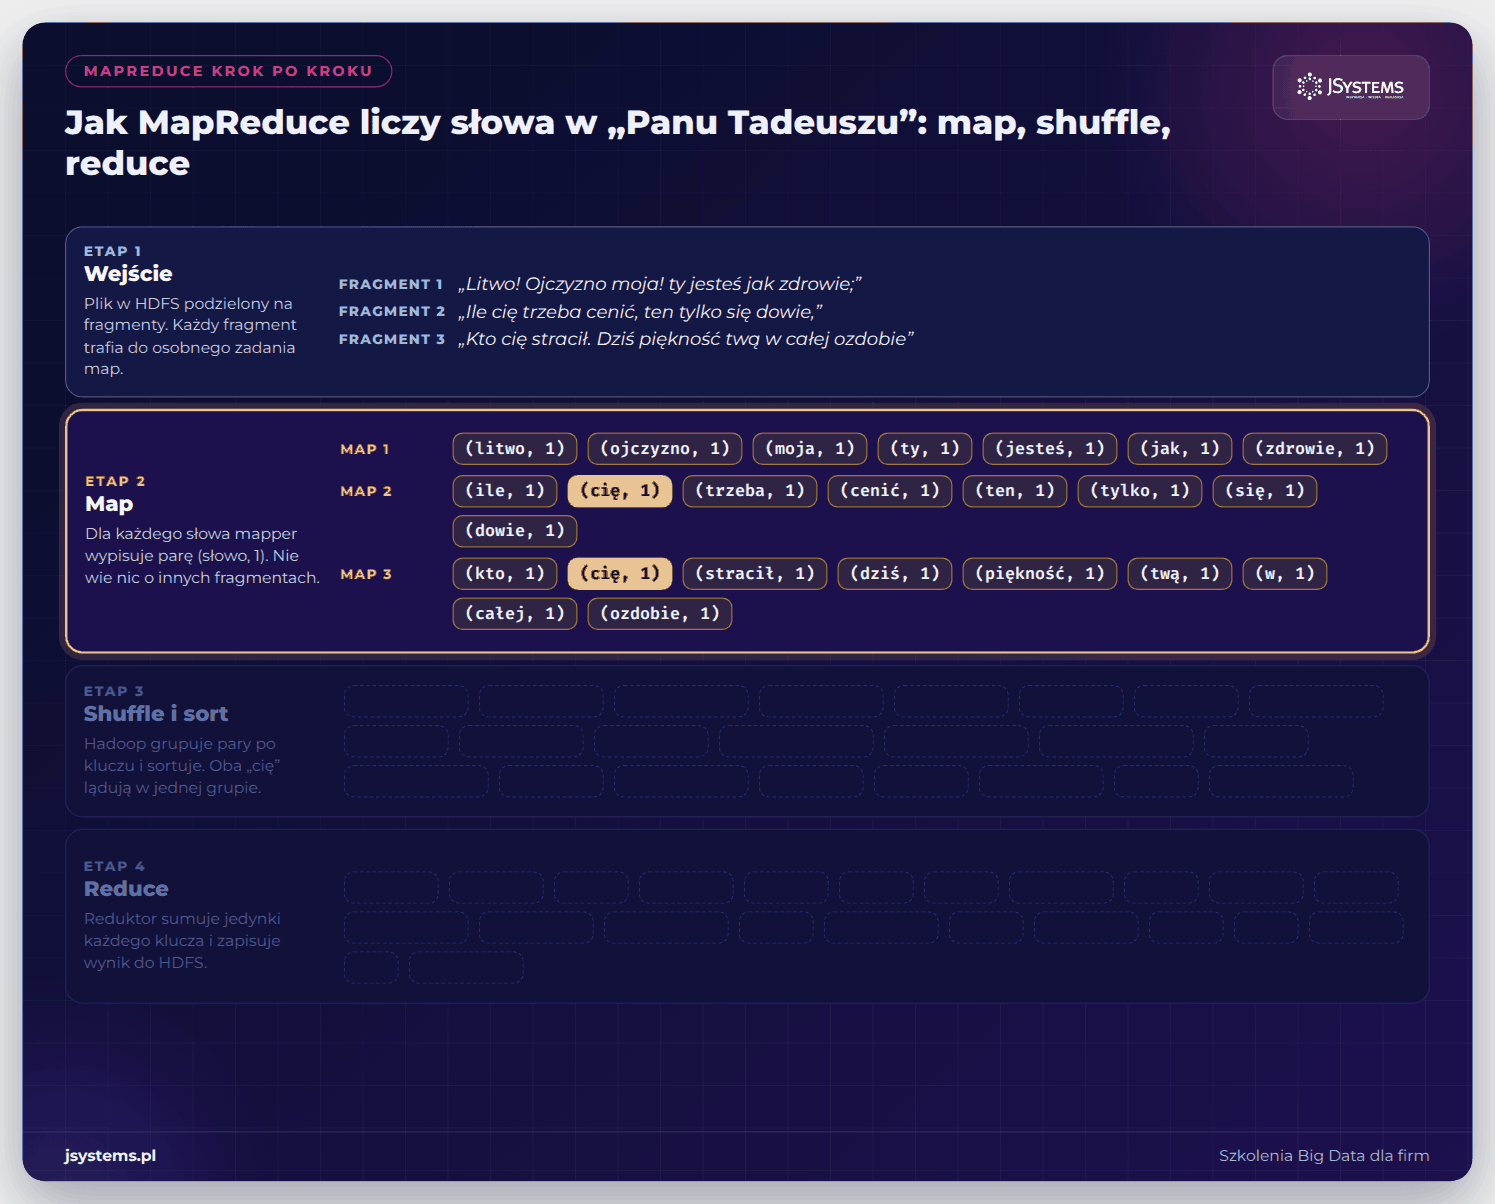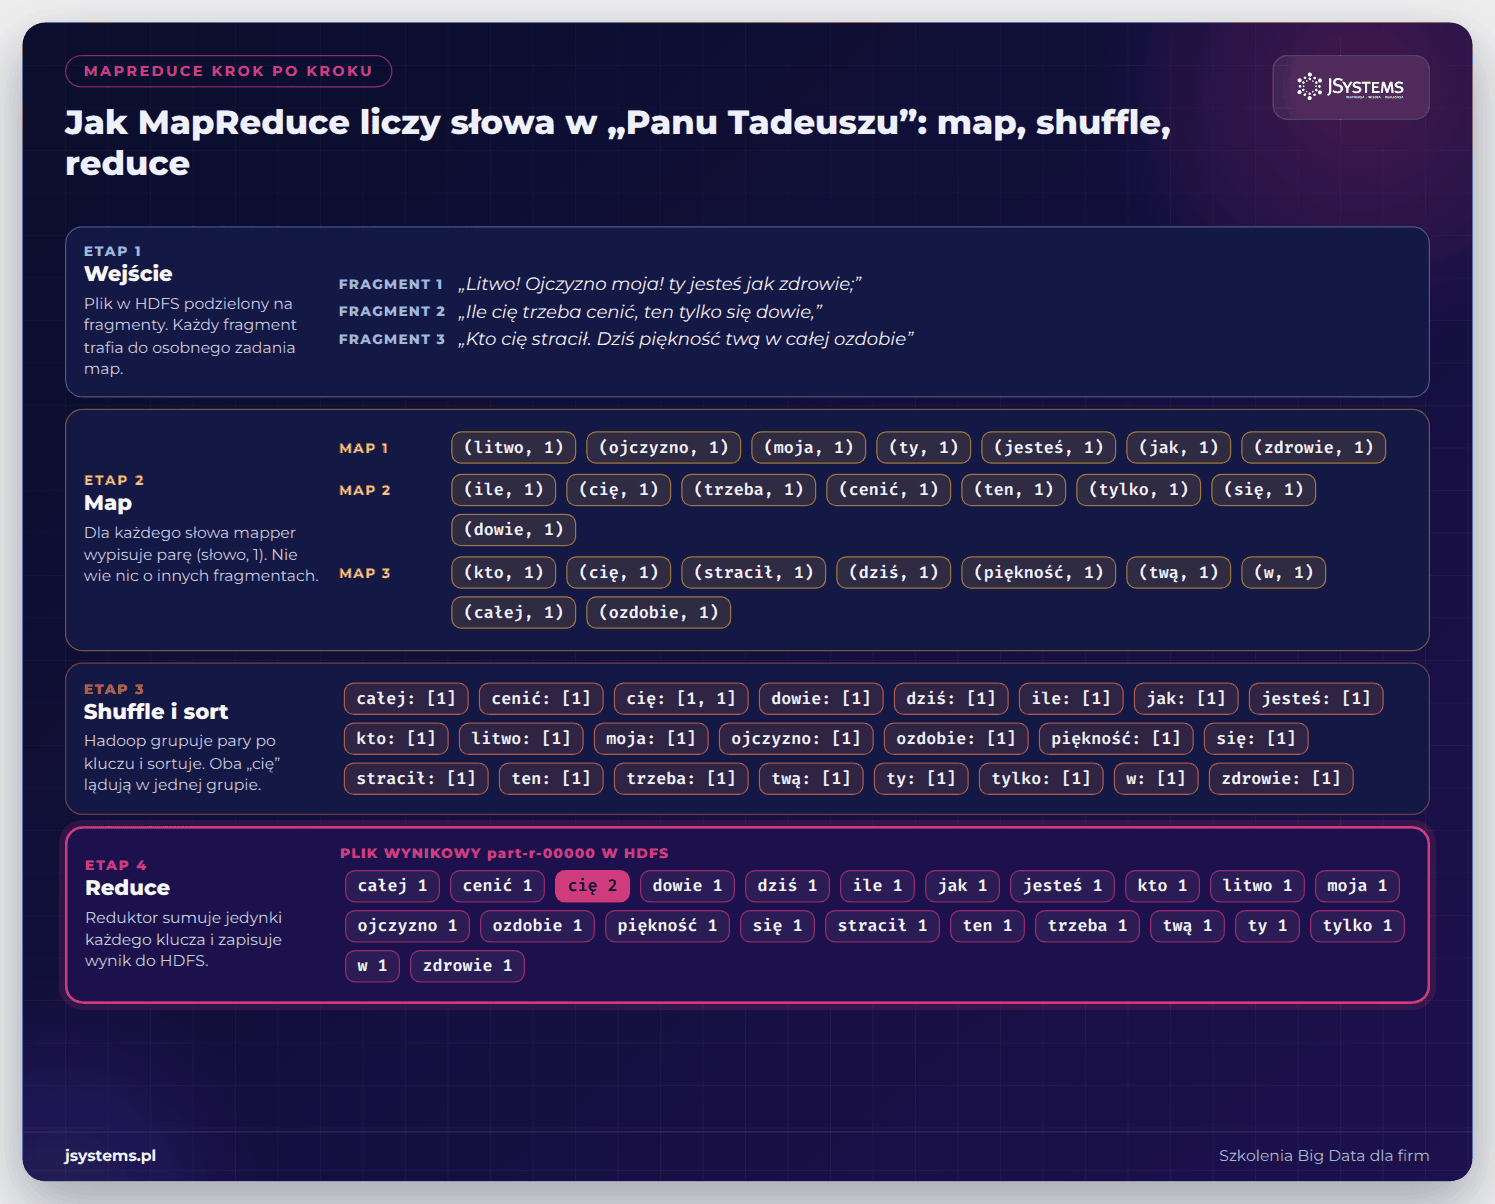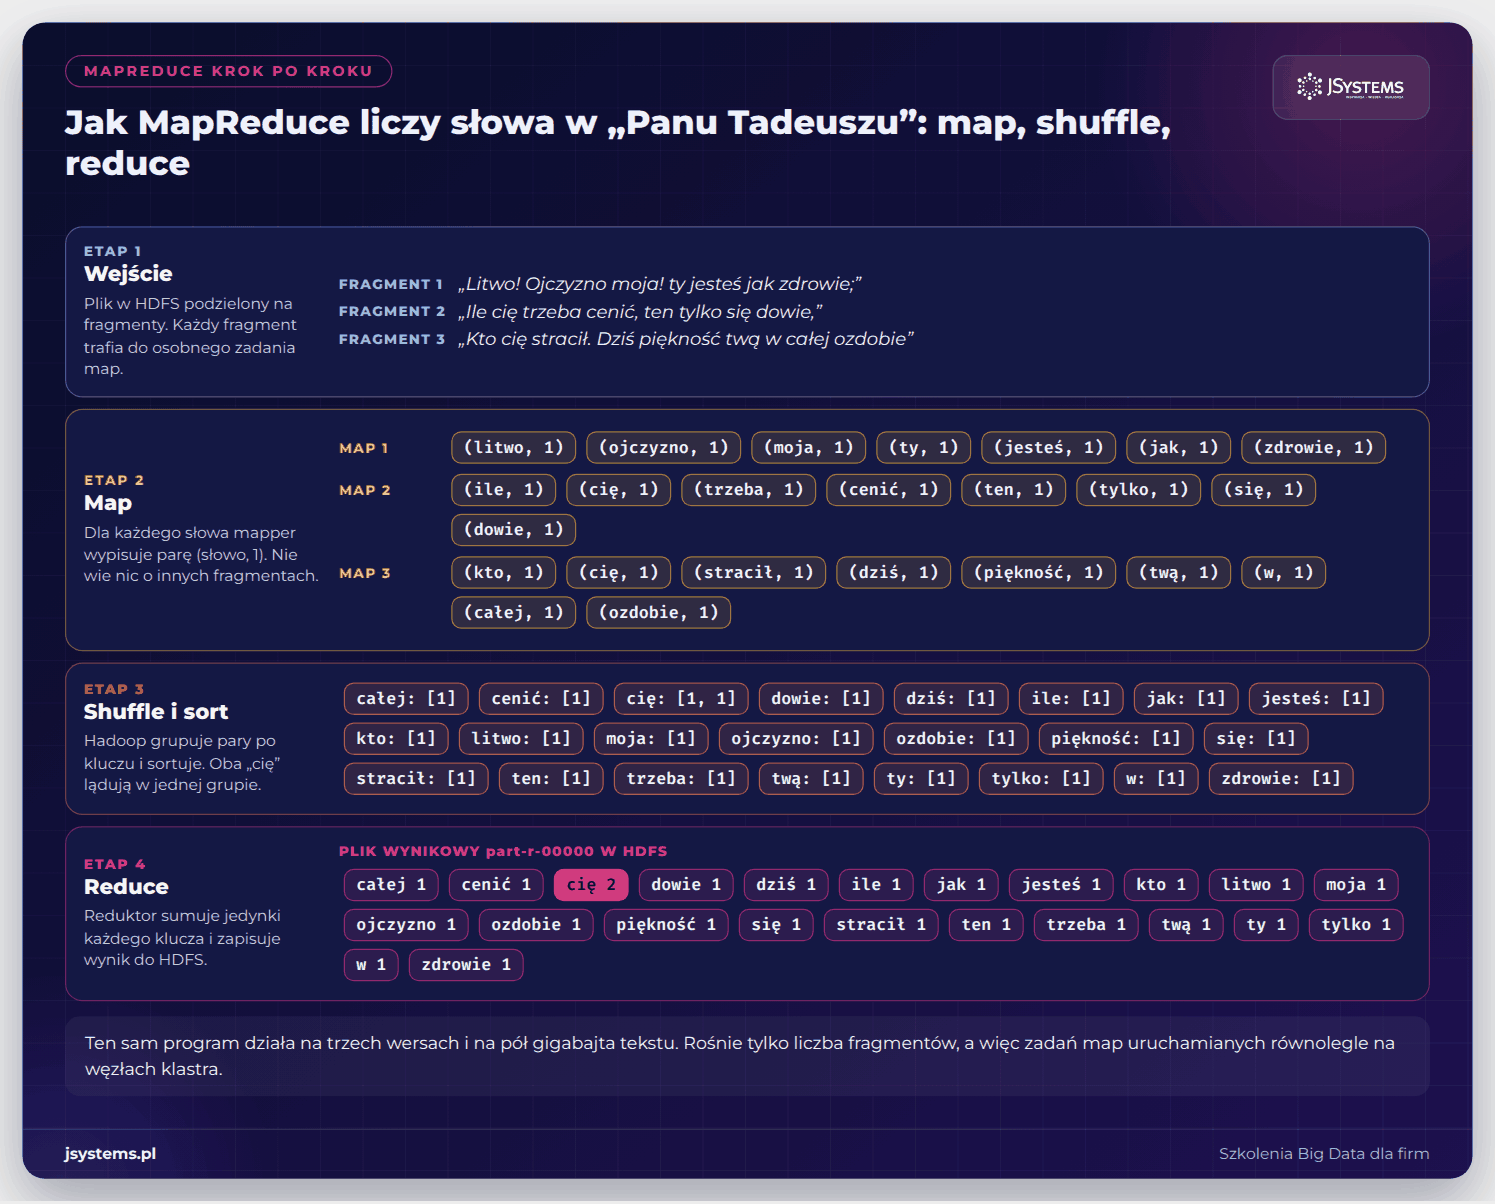
Jak to wygląda w praktyce, najłatwiej zobaczyć na trzech pierwszych wersach „Pana Tadeusza”. Każdy wers trafia do osobnego zadania map, które wypisuje pary (słowo, 1). Potem następuje etap shuffle, czyli przetasowanie: system grupuje pary po kluczu i sortuje je, więc oba wystąpienia słowa „cię” lądują w jednej grupie. Na końcu reduktor, czyli zadanie reduce, sumuje jedynki i zapisuje wynik.
Google nie udostępnił kodu GFS ani MapReduce, ale opisał je na tyle dokładnie, że dało się je odtworzyć. W 2006 roku dołączyła trzecia publikacja z tej serii, o bazie Bigtable, z której później wyrósł HBase. Pierwszy po te opisy sięgnął zespół, który akurat budował wyszukiwarkę z otwartym kodem.
Doug Cutting, autor biblioteki wyszukiwania pełnotekstowego Lucene, od 2002 roku razem z Mikiem Cafarellą budował Nutcha, otwartą wyszukiwarkę internetową. Żeby przeszukać i zaindeksować całą sieć, Nutch musiał działać na wielu maszynach naraz, a do tego potrzebował wspólnego miejsca na dane i sposobu na podział pracy. Publikacje Google przyszły w samą porę. W 2004 roku w Nutchu działał już rozproszony system plików NDFS, wzorowany na GFS: Cafarella przeszukał z jego pomocą 35 milionów stron na tuzinie maszyn. W marcu 2005 roku Cutting ogłosił, że własna implementacja MapReduce jest prawie gotowa.
W styczniu 2006 roku Cutting zaproponował, żeby tę część wydzielić z Nutcha do osobnego podprojektu Apache Lucene o nazwie Hadoop, a na początku lutego przeniósł do niego kod. Nazwa pochodzi od żółtego pluszowego słonia, którego tak nazwał syn Cuttinga. W tym samym roku Cutting pracował już w Yahoo, które postanowiło oprzeć na Hadoopie własne przetwarzanie danych i dało projektowi inżynierów oraz tysiące maszyn do testów. Pierwsze wydanie, Hadoop 0.1.0, ukazało się 1 kwietnia 2006 roku.
Hadoop od początku składał się z dwóch części: HDFS (Hadoop Distributed File System), czyli odpowiednika GFS, i silnika MapReduce. HDFS dzieli plik na duże bloki (dziś domyślnie po 128 MB, w pierwszych wersjach po 64 MB) i zapisuje każdy blok w trzech kopiach na różnych węzłach. Serwer główny, nazywany NameNode, przechowuje tylko metadane: listę plików, ich bloków i miejsc, w których leżą kopie. Same bloki trzymają węzły z danymi, czyli DataNode'y. Gdy jeden z nich padnie, NameNode zleca odtworzenie brakujących kopii na pozostałych węzłach.
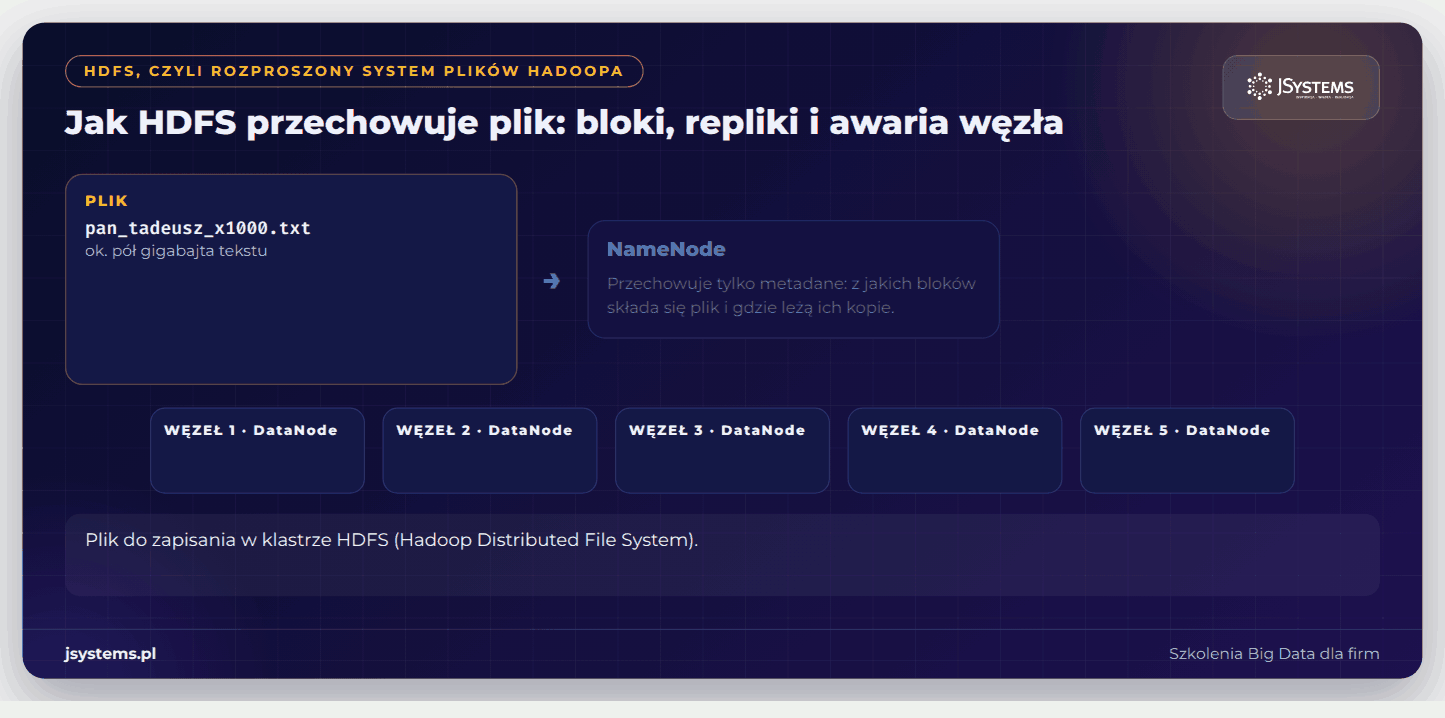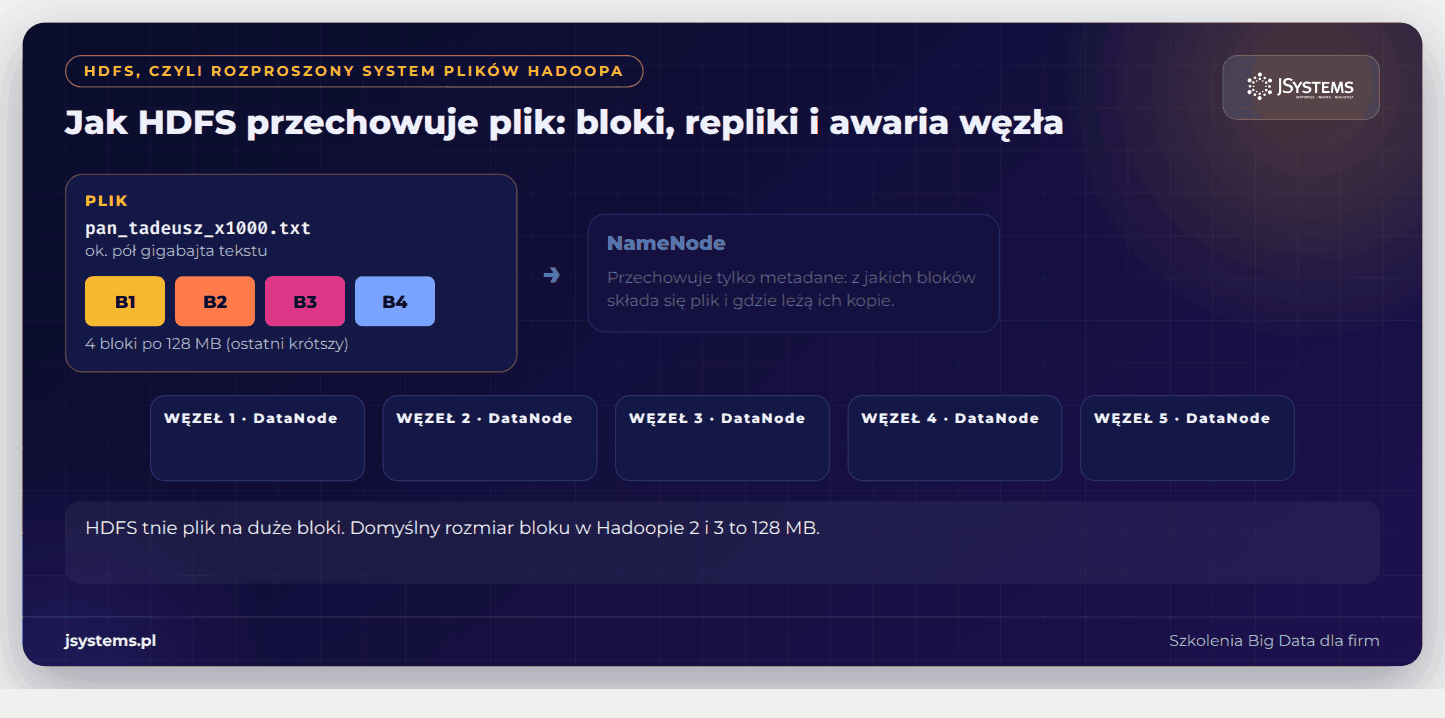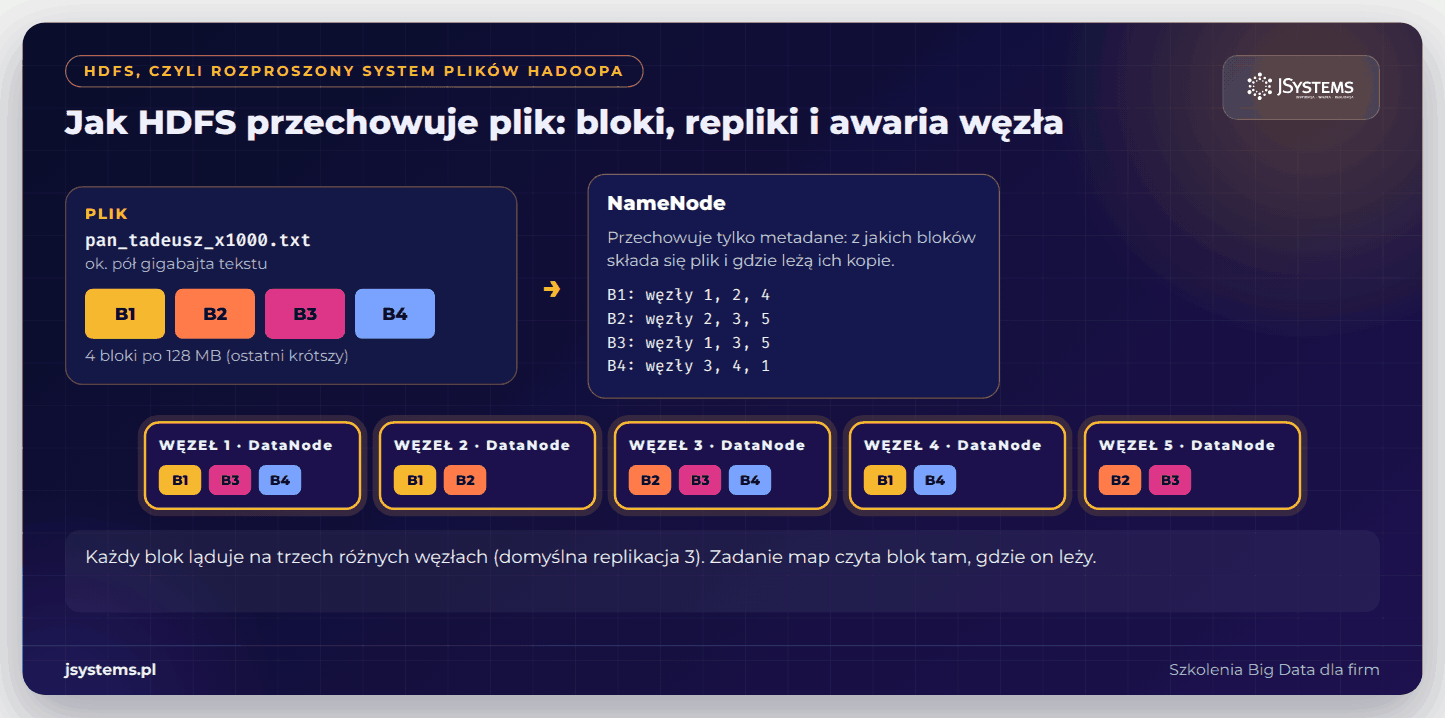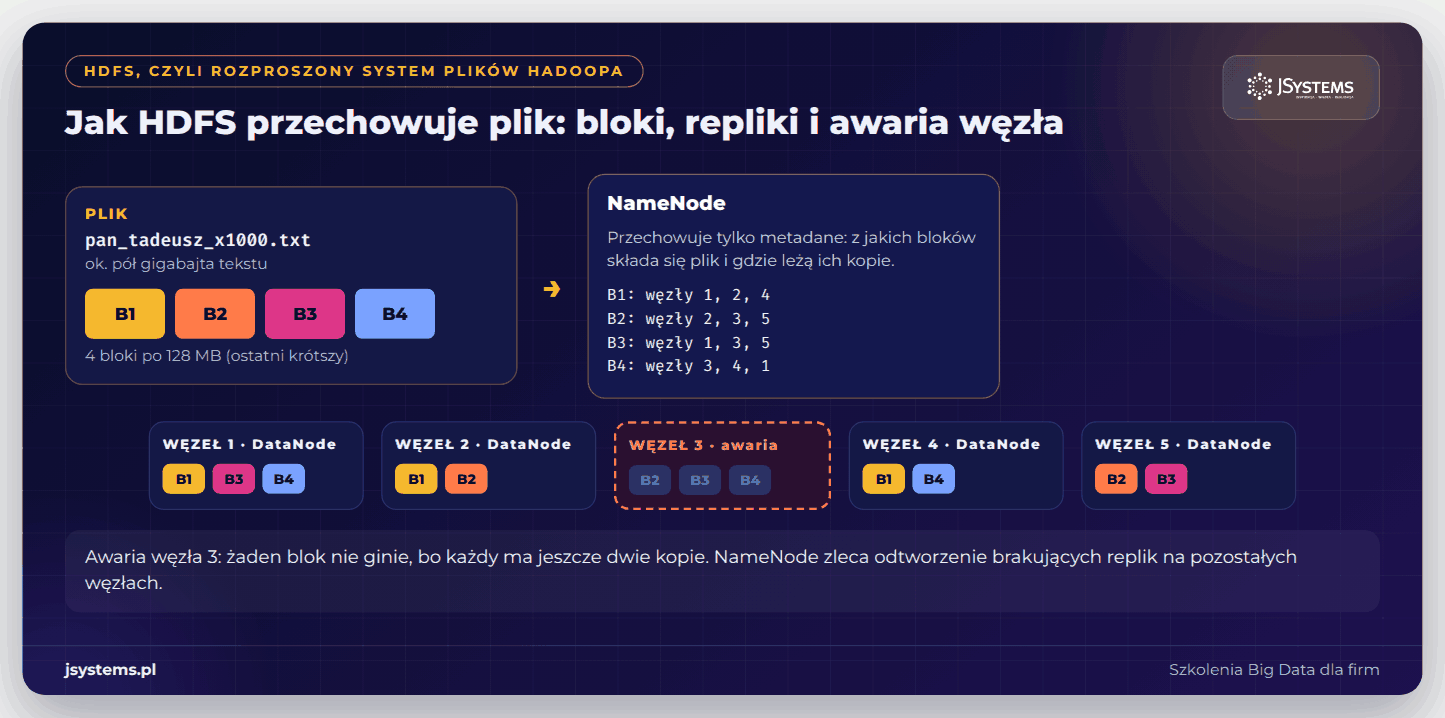
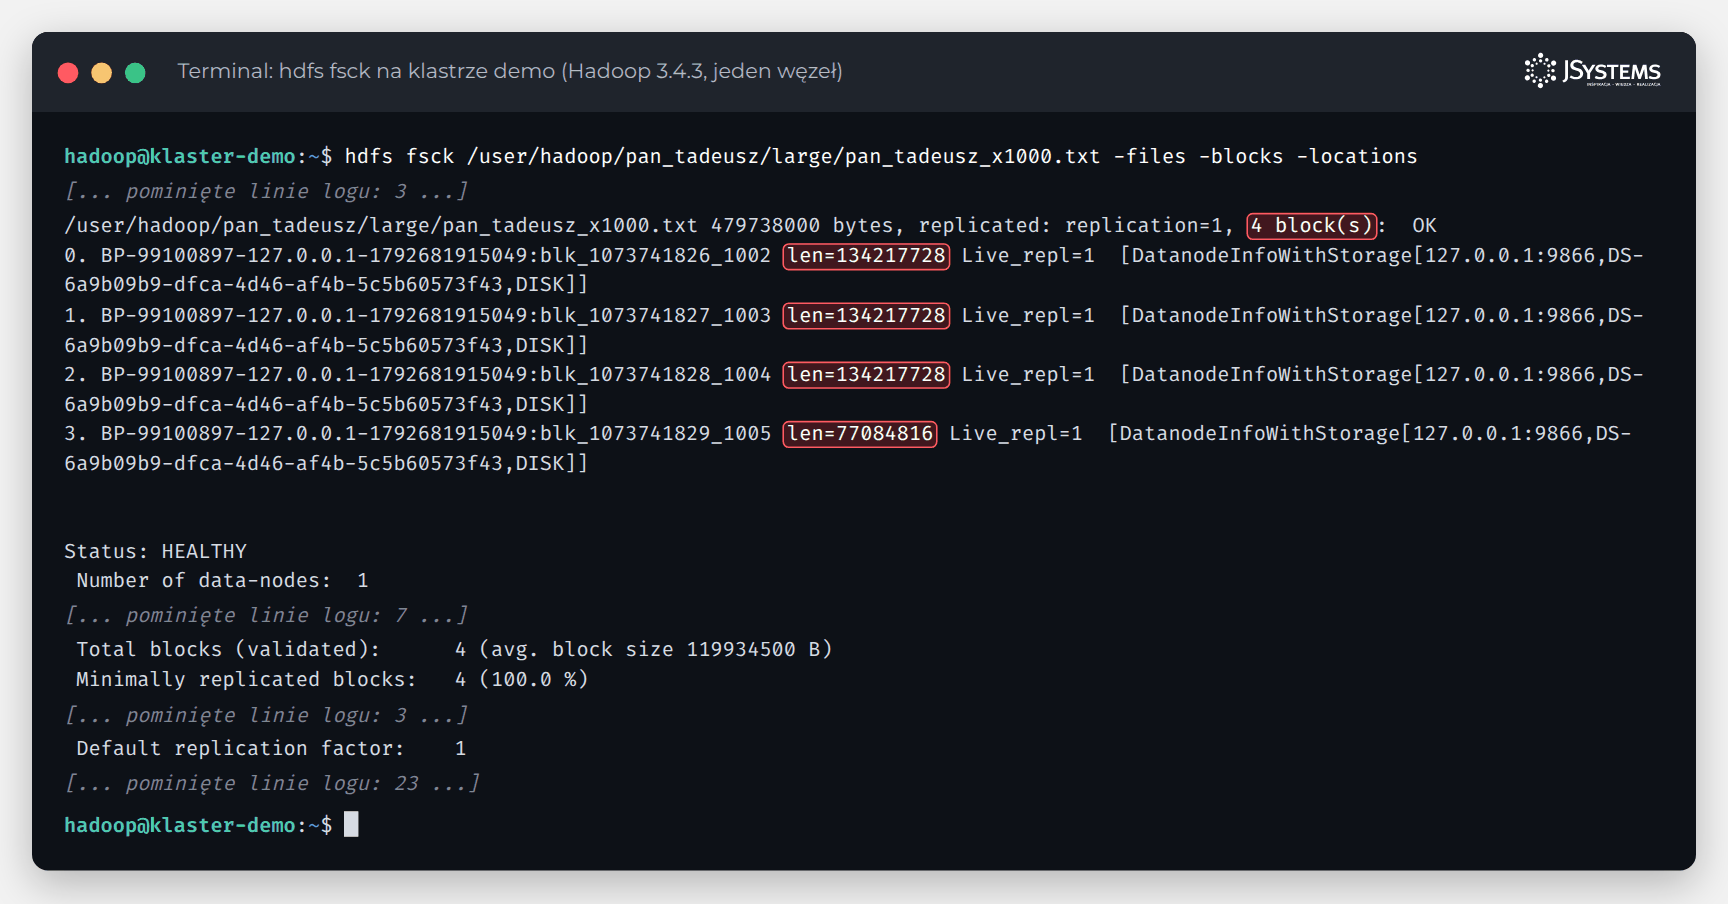
To samo widać na klastrze, na którym liczymy słowa w tym artykule. Hadoopa uruchomiliśmy w trybie pseudorozproszonym, czyli ze wszystkimi usługami na jednym komputerze, i wgraliśmy do HDFS dwa pliki: „Pana Tadeusza” i ten sam tekst powielony tysiąc razy, który zajmuje 479 738 000 bajtów, czyli niecałe pół gigabajta. Polecenie hdfs fsck pokazuje, że HDFS pociął duży plik na cztery bloki: trzy pełne po 128 MB i czwarty, krótszy, na resztę danych. Przy jednym węźle każdy blok ma tylko jedną kopię, bo nie ma gdzie położyć drugiej, dlatego w naszej konfiguracji ustawiliśmy replikację 1.
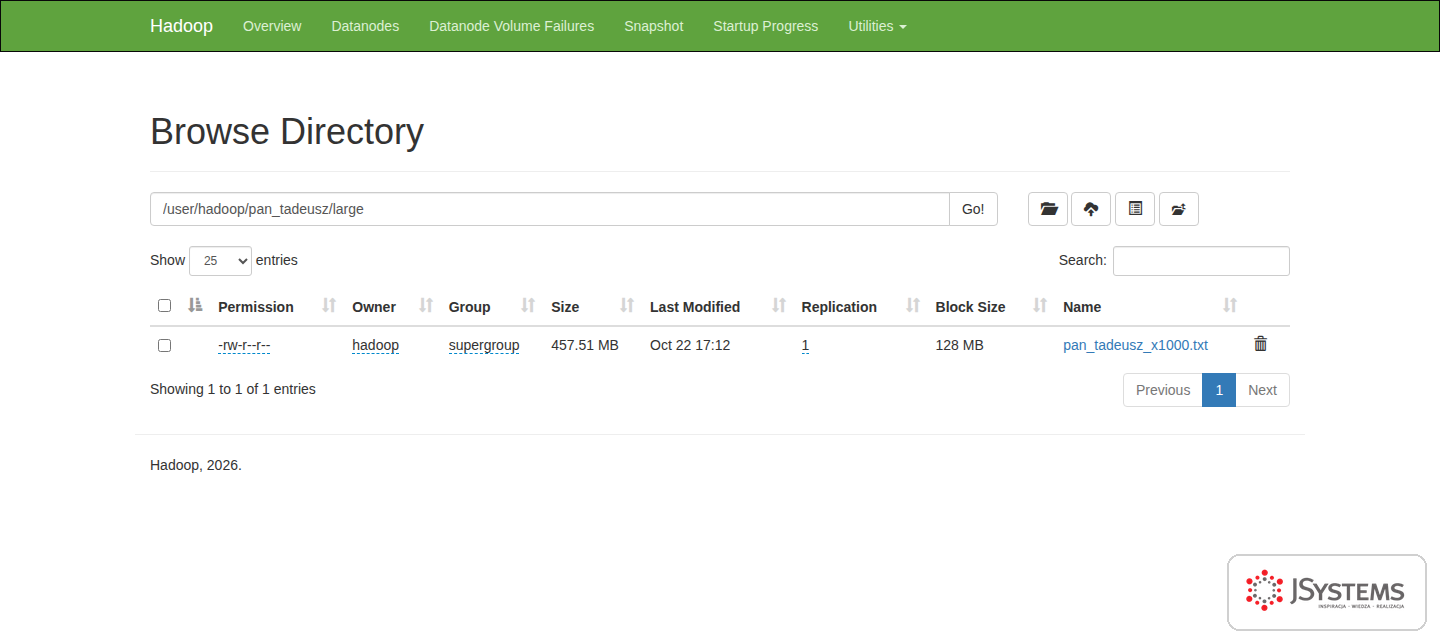
Co chcemy osiągnąć. Policzymy wystąpienia każdego słowa w pół gigabajta tekstu tak, jak robiło się to w pierwszych latach Hadoopa: programem w Javie uruchomionym na klastrze. Na końcu w HDFS powstanie plik z listą słów i liczbą ich wystąpień, a w interfejsie WWW klastra zobaczymy przebieg i liczniki zadania. Żeby powtórzyć to u siebie, pobierz pan_tadeusz.txt, WordCount.java i paczkę hadoop_demo.zip z konfiguracją Hadoopa na jednym komputerze. W systemie Linux rozpakuj paczkę i uruchom ./uruchom_hadoop.sh all: skrypt pobierze JDK, Hadoopa, Hive i PySparka do katalogu ~/bigdata_demo, zapisze konfigurację, uruchomi usługi Hadoopa i wgra oba pliki z tekstem do HDFS. Polecenie ./uruchom_hadoop.sh stop zatrzymuje usługi.
Program składa się z trzech klas. WordMapper dostaje kolejne wiersze pliku, zamienia litery na małe, tnie wiersz na słowa w miejscach, gdzie kończą się litery, i dla każdego słowa wypisuje parę (słowo, 1). SumReducer dostaje słowo z listą liczb i wypisuje ich sumę. SumCombiner, czyli combiner, robi to samo, ale jeszcze po stronie zadań map, na wynikach z jednego bloku. Dzięki temu przez sieć do reduktora płyną sumy częściowe zamiast milionów jedynek. Resztę pliku zajmuje konfiguracja zadania: klasy, typy kluczy i wartości oraz katalogi wejścia i wyjścia w HDFS. Razem z importami i komentarzami program ma 107 linii, a bez komentarzy i pustych linii 81 linii.
WordCount.java: liczenie słów w Hadoop MapReduce
import java.io.IOException;
import java.util.Locale;
import java.util.regex.Pattern;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.conf.Configured;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.Reducer;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;
import org.apache.hadoop.util.Tool;
import org.apache.hadoop.util.ToolRunner;

/**
 * Zliczanie słów w „Panu Tadeuszu” - klasyczny MapReduce w Javie.
 *
 * Tokenizacja jest taka sama we wszystkich wersjach demo (Java, Streaming, Hive, Spark):
 * małe litery, podział na ciągi znaków niebędących literami Unicode, puste elementy odrzucone.
 *
 * Uruchomienie:  hadoop jar wordcount.jar WordCount WEJŚCIE_HDFS WYJŚCIE_HDFS
 */
public class WordCount extends Configured implements Tool {

    /** Mapper: dla każdej linii tekstu emituje pary (słowo, 1). */
    public static class WordMapper extends Mapper<LongWritable, Text, Text, IntWritable> {
        private static final Pattern NOT_LETTERS = Pattern.compile("[^\\p{L}]+");
        private static final IntWritable ONE = new IntWritable(1);
        private final Text word = new Text();

        @Override
        protected void map(LongWritable offset, Text line, Context context)
                throws IOException, InterruptedException {
            // małe litery, potem podział na wszystko, co nie jest literą
            String lower = line.toString().toLowerCase(Locale.ROOT);
            for (String token : NOT_LETTERS.split(lower)) {
                if (!token.isEmpty()) {
                    word.set(token);
                    context.write(word, ONE);
                }
            }
        }
    }

    /**
     * Combiner: „mały reducer” działający po stronie mappera. Sumuje częściowe wyniki
     * jeszcze przed wysłaniem ich siecią, więc przez shuffle płynie dużo mniej danych.
     */
    public static class SumCombiner extends Reducer<Text, IntWritable, Text, IntWritable> {
        private final IntWritable partial = new IntWritable();

        @Override
        protected void reduce(Text word, Iterable<IntWritable> counts, Context context)
                throws IOException, InterruptedException {
            int sum = 0;
            for (IntWritable count : counts) {
                sum += count.get();
            }
            partial.set(sum);
            context.write(word, partial);
        }
    }

    /** Reducer: dla każdego słowa sumuje wszystkie liczby od mapperów i combinerów. */
    public static class SumReducer extends Reducer<Text, IntWritable, Text, IntWritable> {
        private final IntWritable total = new IntWritable();

        @Override
        protected void reduce(Text word, Iterable<IntWritable> counts, Context context)
                throws IOException, InterruptedException {
            int sum = 0;
            for (IntWritable count : counts) {
                sum += count.get();
            }
            total.set(sum);
            context.write(word, total);
        }
    }

    @Override
    public int run(String[] args) throws Exception {
        if (args.length != 2) {
            System.err.println("Użycie: WordCount <katalog wejściowy HDFS> <katalog wyjściowy HDFS>");
            return 2;
        }
        Configuration conf = getConf();
        Job job = Job.getInstance(conf, "word count Pan Tadeusz (Java)");
        job.setJarByClass(WordCount.class);
        job.setMapperClass(WordMapper.class);
        job.setCombinerClass(SumCombiner.class);
        job.setReducerClass(SumReducer.class);
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(IntWritable.class);
        FileInputFormat.addInputPath(job, new Path(args[0]));
        FileOutputFormat.setOutputPath(job, new Path(args[1]));
        // true = wypisuj postęp na konsoli (linie „map 0% reduce 0%”)
        return job.waitForCompletion(true) ? 0 : 1;
    }

    public static void main(String[] args) throws Exception {
        System.exit(ToolRunner.run(new Configuration(), new WordCount(), args));
    }
}
Program kompilujemy kompilatorem Javy z bibliotekami Hadoopa w ścieżce klas, pakujemy do pliku JAR i wysyłamy na klaster poleceniem hadoop jar:
mkdir -p classes
javac -cp "$(hadoop classpath)" -d classes WordCount.java
jar -cvf wordcount.jar -C classes .
hadoop jar wordcount.jar WordCount /user/hadoop/pan_tadeusz/large /user/hadoop/output/java_large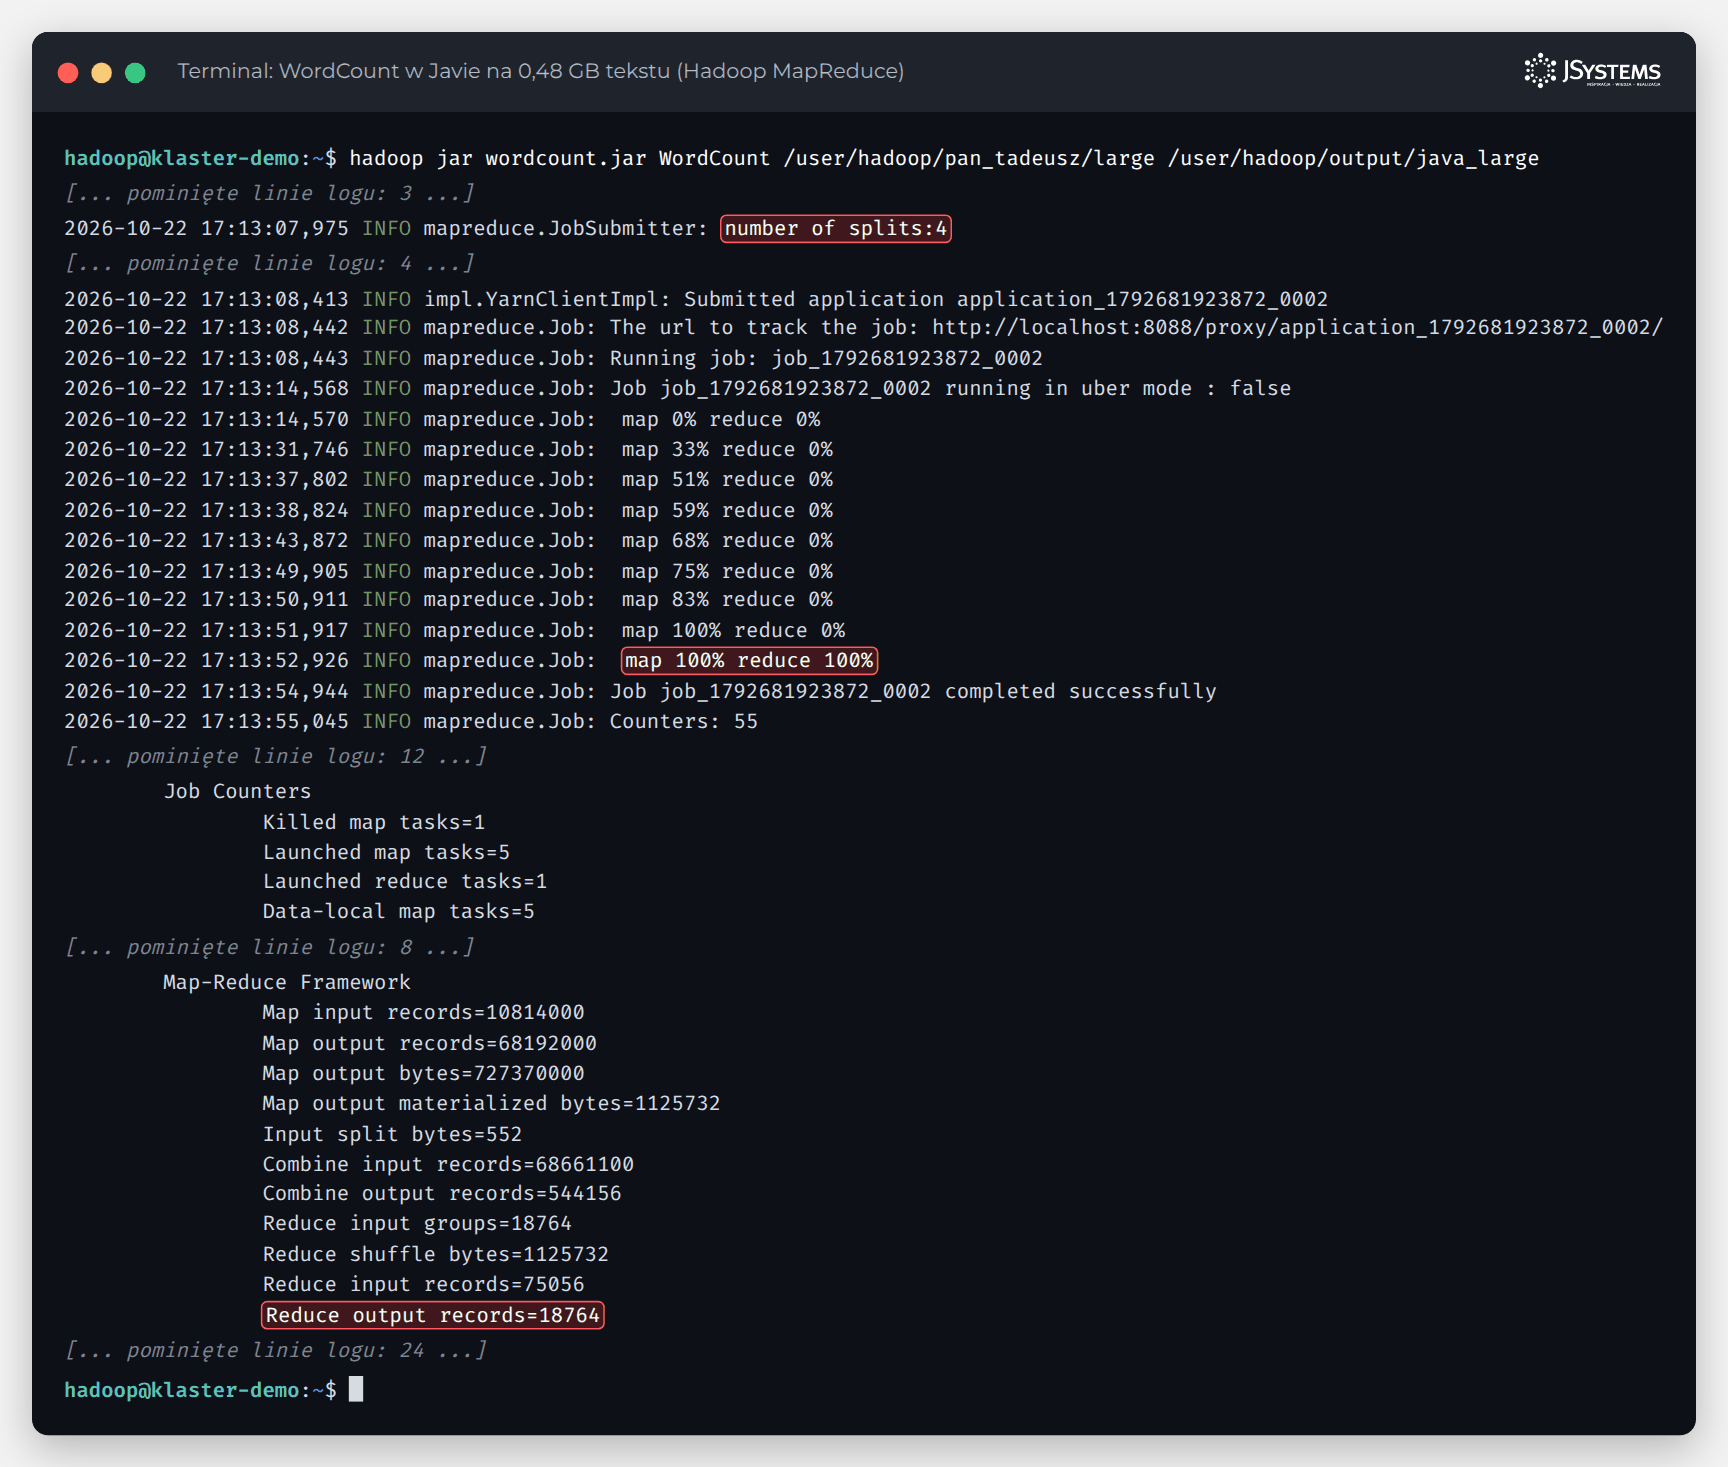
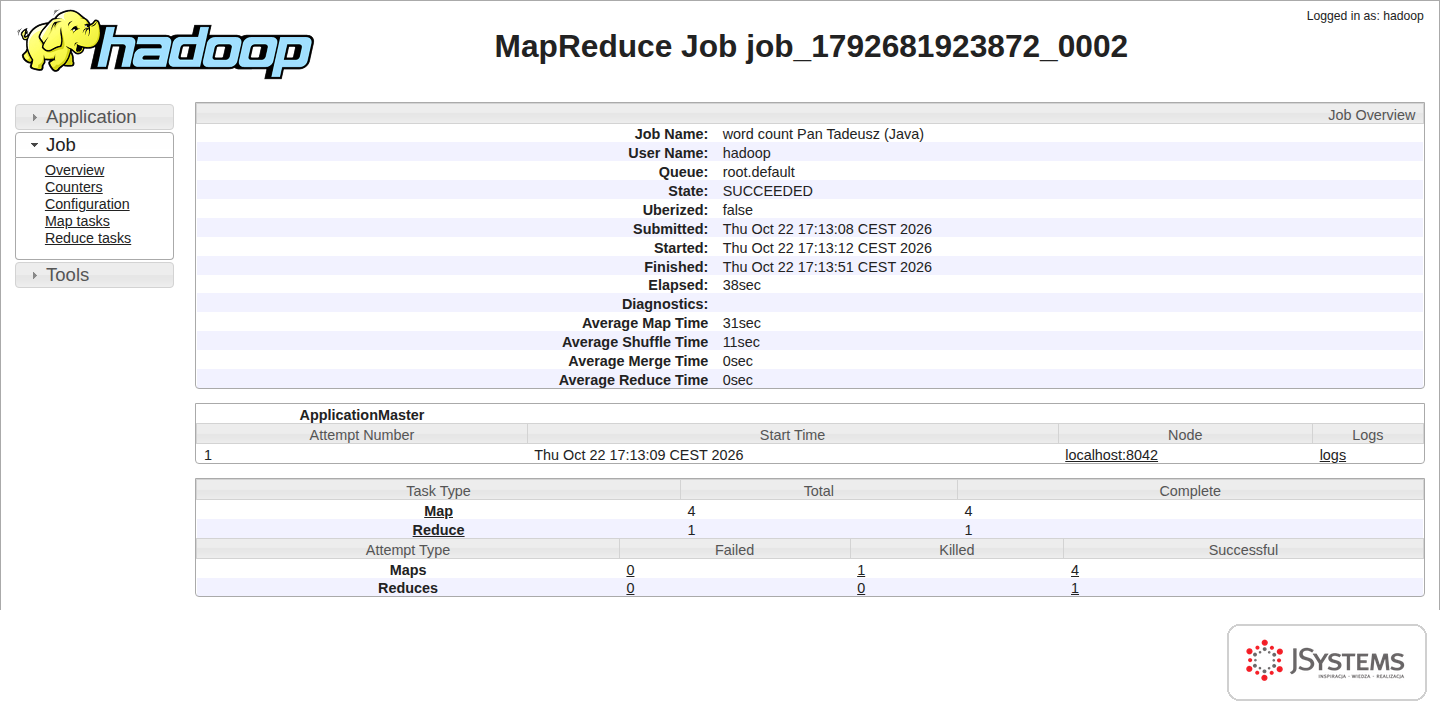
Hadoop podzielił wejście na cztery części (number of splits:4), czyli dokładnie tyle, ile plik ma bloków, i uruchomił zadania map na węźle, który przechowuje dany blok. Licznik Launched map tasks pokazuje jednak pięć zadań, a Killed map tasks jedno. To wykonanie spekulacyjne: gdy jedno z zadań idzie wolniej od pozostałych, Hadoop uruchamia jego zapasową kopię i zabija tę, która skończy później. Pomysł pochodzi wprost z publikacji Google o MapReduce, gdzie nazywa się zadaniami zapasowymi (backup tasks).
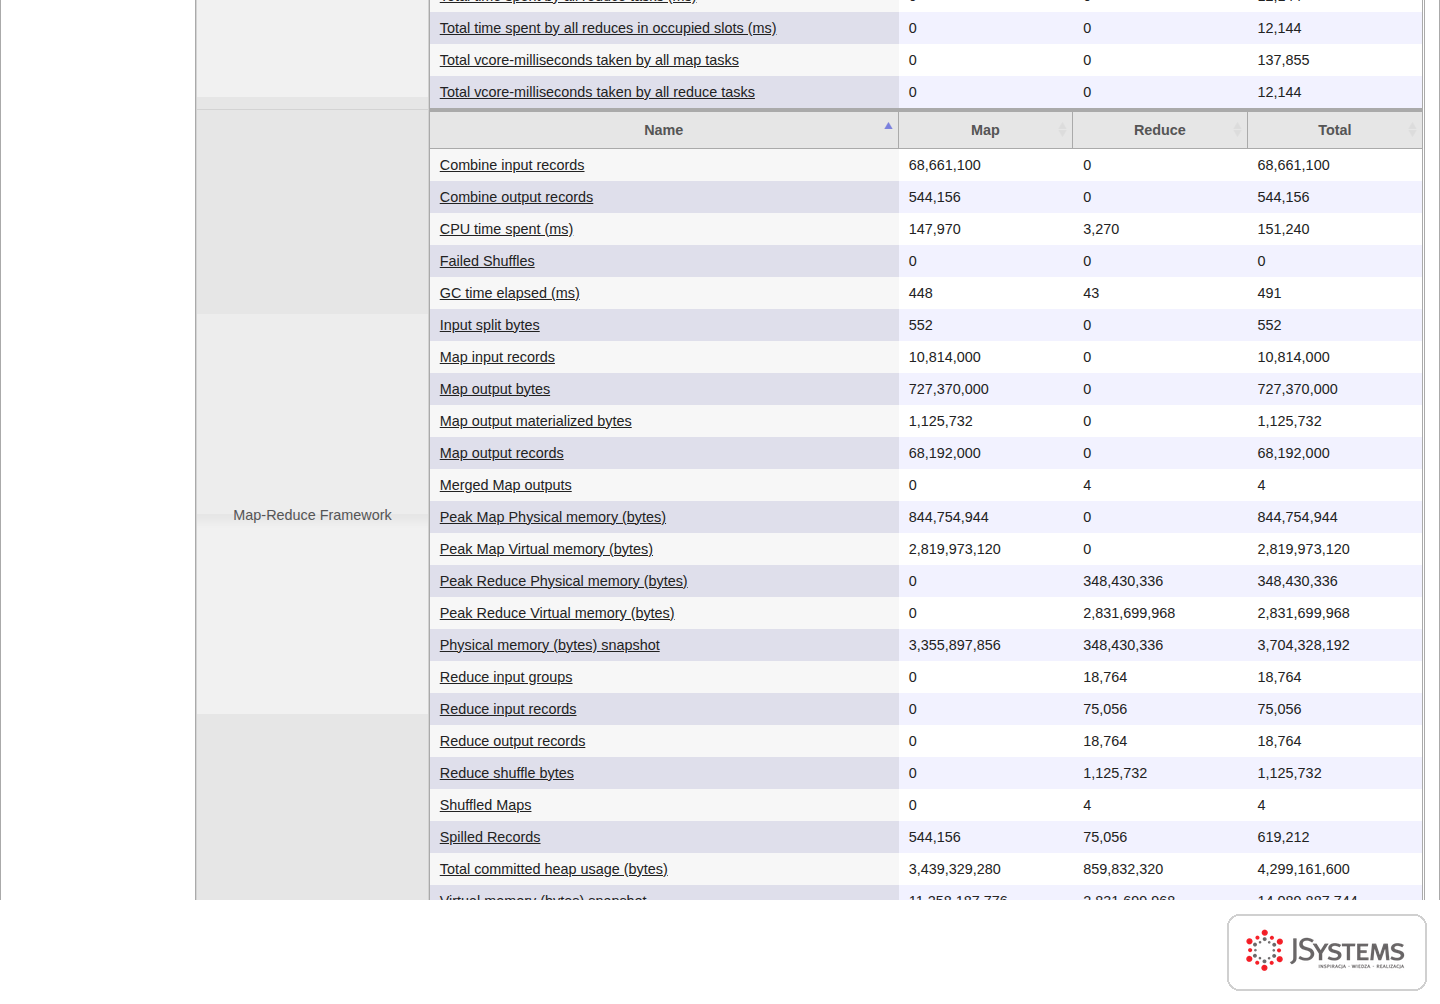
Liczniki pokazują też, ile pracy oszczędził combiner. Mappery przeczytały 10 814 000 wierszy i wypisały 68 192 000 par (słowo, 1), czyli ponad 700 MB danych pośrednich. Po wstępnym sumowaniu przez etap shuffle do reduktora trafiło zaledwie 1 125 732 bajty. Wynik to 18 764 różne słowa. Polecenie trwało 50 sekund, z czego samo zadanie na klastrze 38 sekund (pole Elapsed w serwerze historii zadań niżej), a resztę zajęło uruchomienie klienta i przydział zasobów. Najczęstsze słowa „Pana Tadeusza” to spójniki i przyimki: „i”, „w”, „się”, „z” i „na”.
Tak wyglądała codzienność zespołów danych około 2008 roku. Każda zmiana w analizie oznaczała zmianę kodu, kompilację, nowy plik JAR i kolejne uruchomienie na klastrze. Do tego dochodził czas startu: zanim pierwsza linia danych trafi do mappera, Hadoop musi przydzielić zasoby i uruchomić osobną maszynę wirtualną Javy dla każdego zadania. Nic dziwnego, że szybko pojawiły się sposoby, żeby pisać mniej Javy.
Co chcemy osiągnąć. Ten sam wynik, ale bez Javy: mapper i reducer jako dwa krótkie skrypty w Pythonie. Hadoop Streaming uruchamia dowolny program, który czyta dane ze standardowego wejścia i pisze wyniki na standardowe wyjście, więc liczenie słów sprowadza się do dwóch plików: mapper.py i reducer.py.
Mapper wypisuje każde słowo z liczbą 1, oddzielone tabulatorem. Reducer korzysta z gwarancji, którą daje Hadoop: przed etapem reduce wiersze są posortowane po kluczu, więc wszystkie wystąpienia danego słowa przychodzą do reduktora jedno po drugim. Wystarczy sumować, dopóki słowo się nie zmieni.
mapper.py
#!/usr/bin/env python3
"""Hadoop Streaming - mapper zliczania słów.

Czyta linie ze standardowego wejścia i dla każdego słowa wypisuje „słowo<TAB>1”.
Tokenizacja jak w pozostałych wersjach demo: małe litery, podział na ciągi znaków
niebędących literami Unicode, puste elementy odrzucone.
"""
import re
import sys

sys.stdin.reconfigure(encoding='utf-8')
sys.stdout.reconfigure(encoding='utf-8')

# [^\W\d_] to znak „słowa” bez cyfr i podkreślenia, czyli litera Unicode
LETTERS = re.compile(r'[^\W\d_]+')

for line in sys.stdin:
    for word in LETTERS.findall(line.lower()):
        sys.stdout.write(word + '\t1\n')
reducer.py
#!/usr/bin/env python3
"""Hadoop Streaming - reducer zliczania słów (służy też jako combiner).

Wejście przychodzi posortowane po kluczu, więc wystarczy sumować kolejne wiersze
z tym samym słowem i wypisać wynik, gdy słowo się zmieni.
"""
import sys

sys.stdin.reconfigure(encoding='utf-8')
sys.stdout.reconfigure(encoding='utf-8')

current_word = None
current_sum = 0

for line in sys.stdin:
    word, count = line.rstrip('\n').split('\t')
    if word == current_word:
        current_sum += int(count)
    else:
        if current_word is not None:
            sys.stdout.write('%s\t%d\n' % (current_word, current_sum))
        current_word, current_sum = word, int(count)

if current_word is not None:
    sys.stdout.write('%s\t%d\n' % (current_word, current_sum))
hadoop jar $HADOOP_HOME/share/hadoop/tools/lib/hadoop-streaming-3.4.3.jar \
-D mapreduce.job.name="word count Pan Tadeusz (Streaming)" \
-files mapper.py,reducer.py \
-mapper "python3 mapper.py" -combiner "python3 reducer.py" -reducer "python3 reducer.py" \
-input /user/hadoop/pan_tadeusz/large -output /user/hadoop/output/streaming_large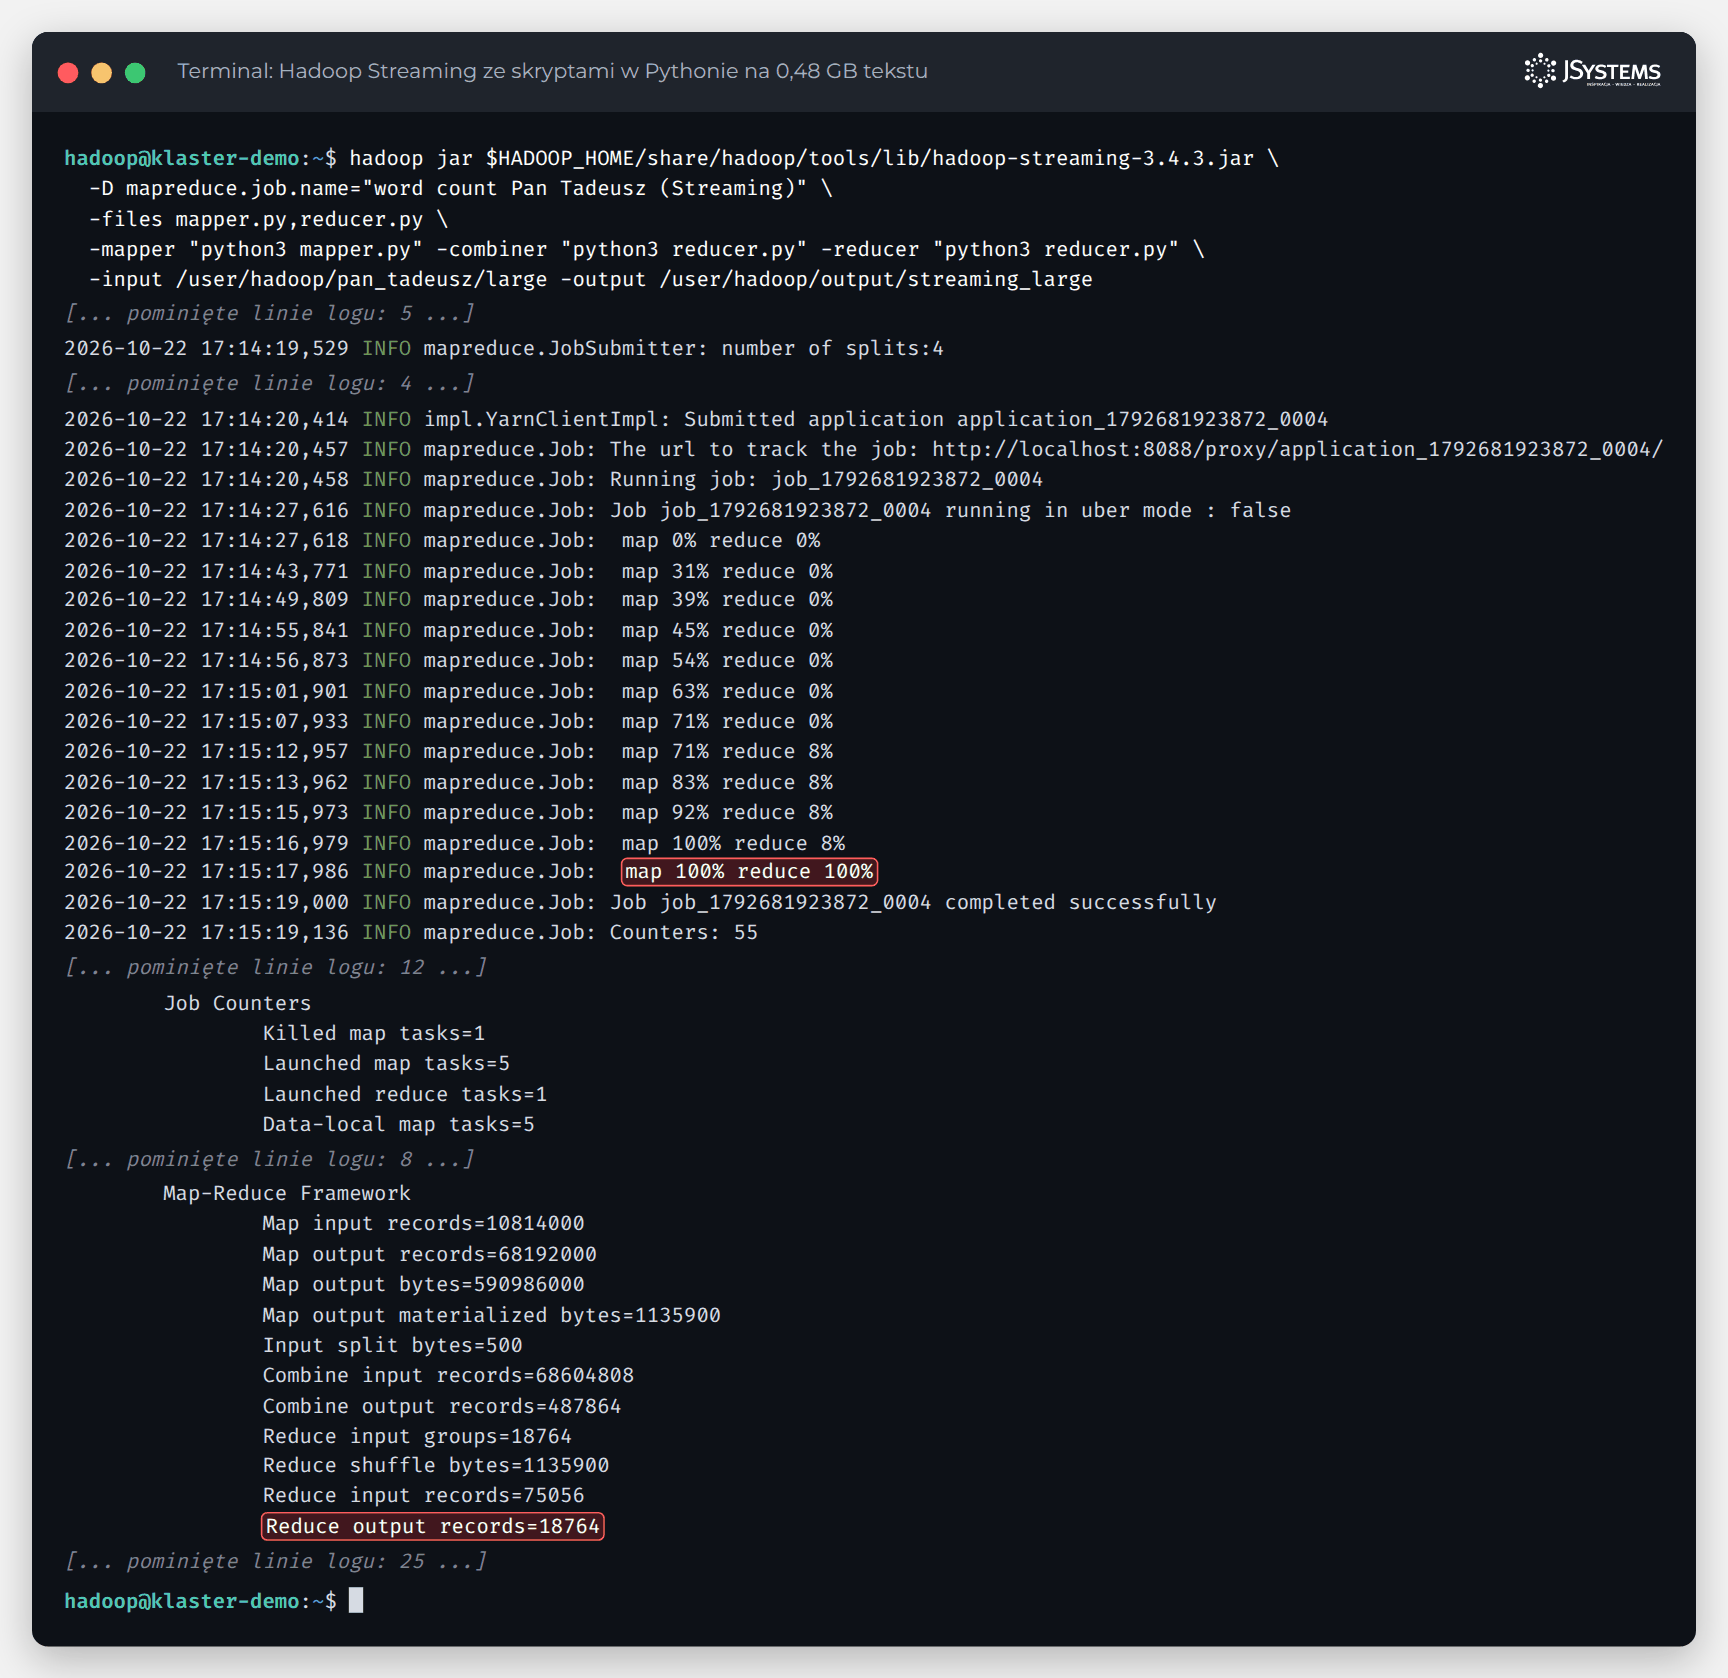
Wynik jest identyczny: te same 68 192 000 słów i te same 18 764 różne słowa. Przebieg trwał jednak dłużej, około minuty, bo każdy wiersz wędruje między procesem Javy a interpreterem Pythona jako tekst przez standardowe wejście i wyjście. Hadoop Streaming otworzył Hadoopa dla programistów Pythona, Perla czy Ruby, ale nie zmienił samego modelu: dalej trzeba było myśleć parami klucz i wartość, a każde zadanie startowało od odczytu z dysku.
W styczniu 2008 roku Hadoop został projektem najwyższego poziomu Apache Software Foundation, czyli samodzielnym projektem, a nie podprojektem Lucene. Miesiąc później Yahoo ogłosiło, że indeks stron dla wyszukiwarki, tak zwany Webmap, liczy produkcyjnie klaster Hadoopa z ponad 10 tysiącami rdzeni. W lipcu tego samego roku klaster Hadoopa w Yahoo wygrał konkurs w sortowaniu terabajta danych: 209 sekund na 910 węzłach, wobec poprzedniego rekordu 297 sekund. Pierwszy raz wygrał program napisany w Javie i dostępny jako otwarte oprogramowanie.
Wraz z dojrzewaniem Hadoopa wyszedł na jaw jego największy problem: programów MapReduce w Javie umiało pisać niewielu ludzi, a z danych chcieli korzystać analitycy, którzy znali SQL. Facebook zbudował więc Hive, który zamienia zapytania w języku podobnym do SQL (HiveQL) na zadania MapReduce i trzyma opis tabel w katalogu metadanych. Yahoo odpowiedziało językiem przepływów danych Pig. Obok powstała cała menażeria narzędzi, której nazwy do dziś brzmią jak spis mieszkańców zoo:
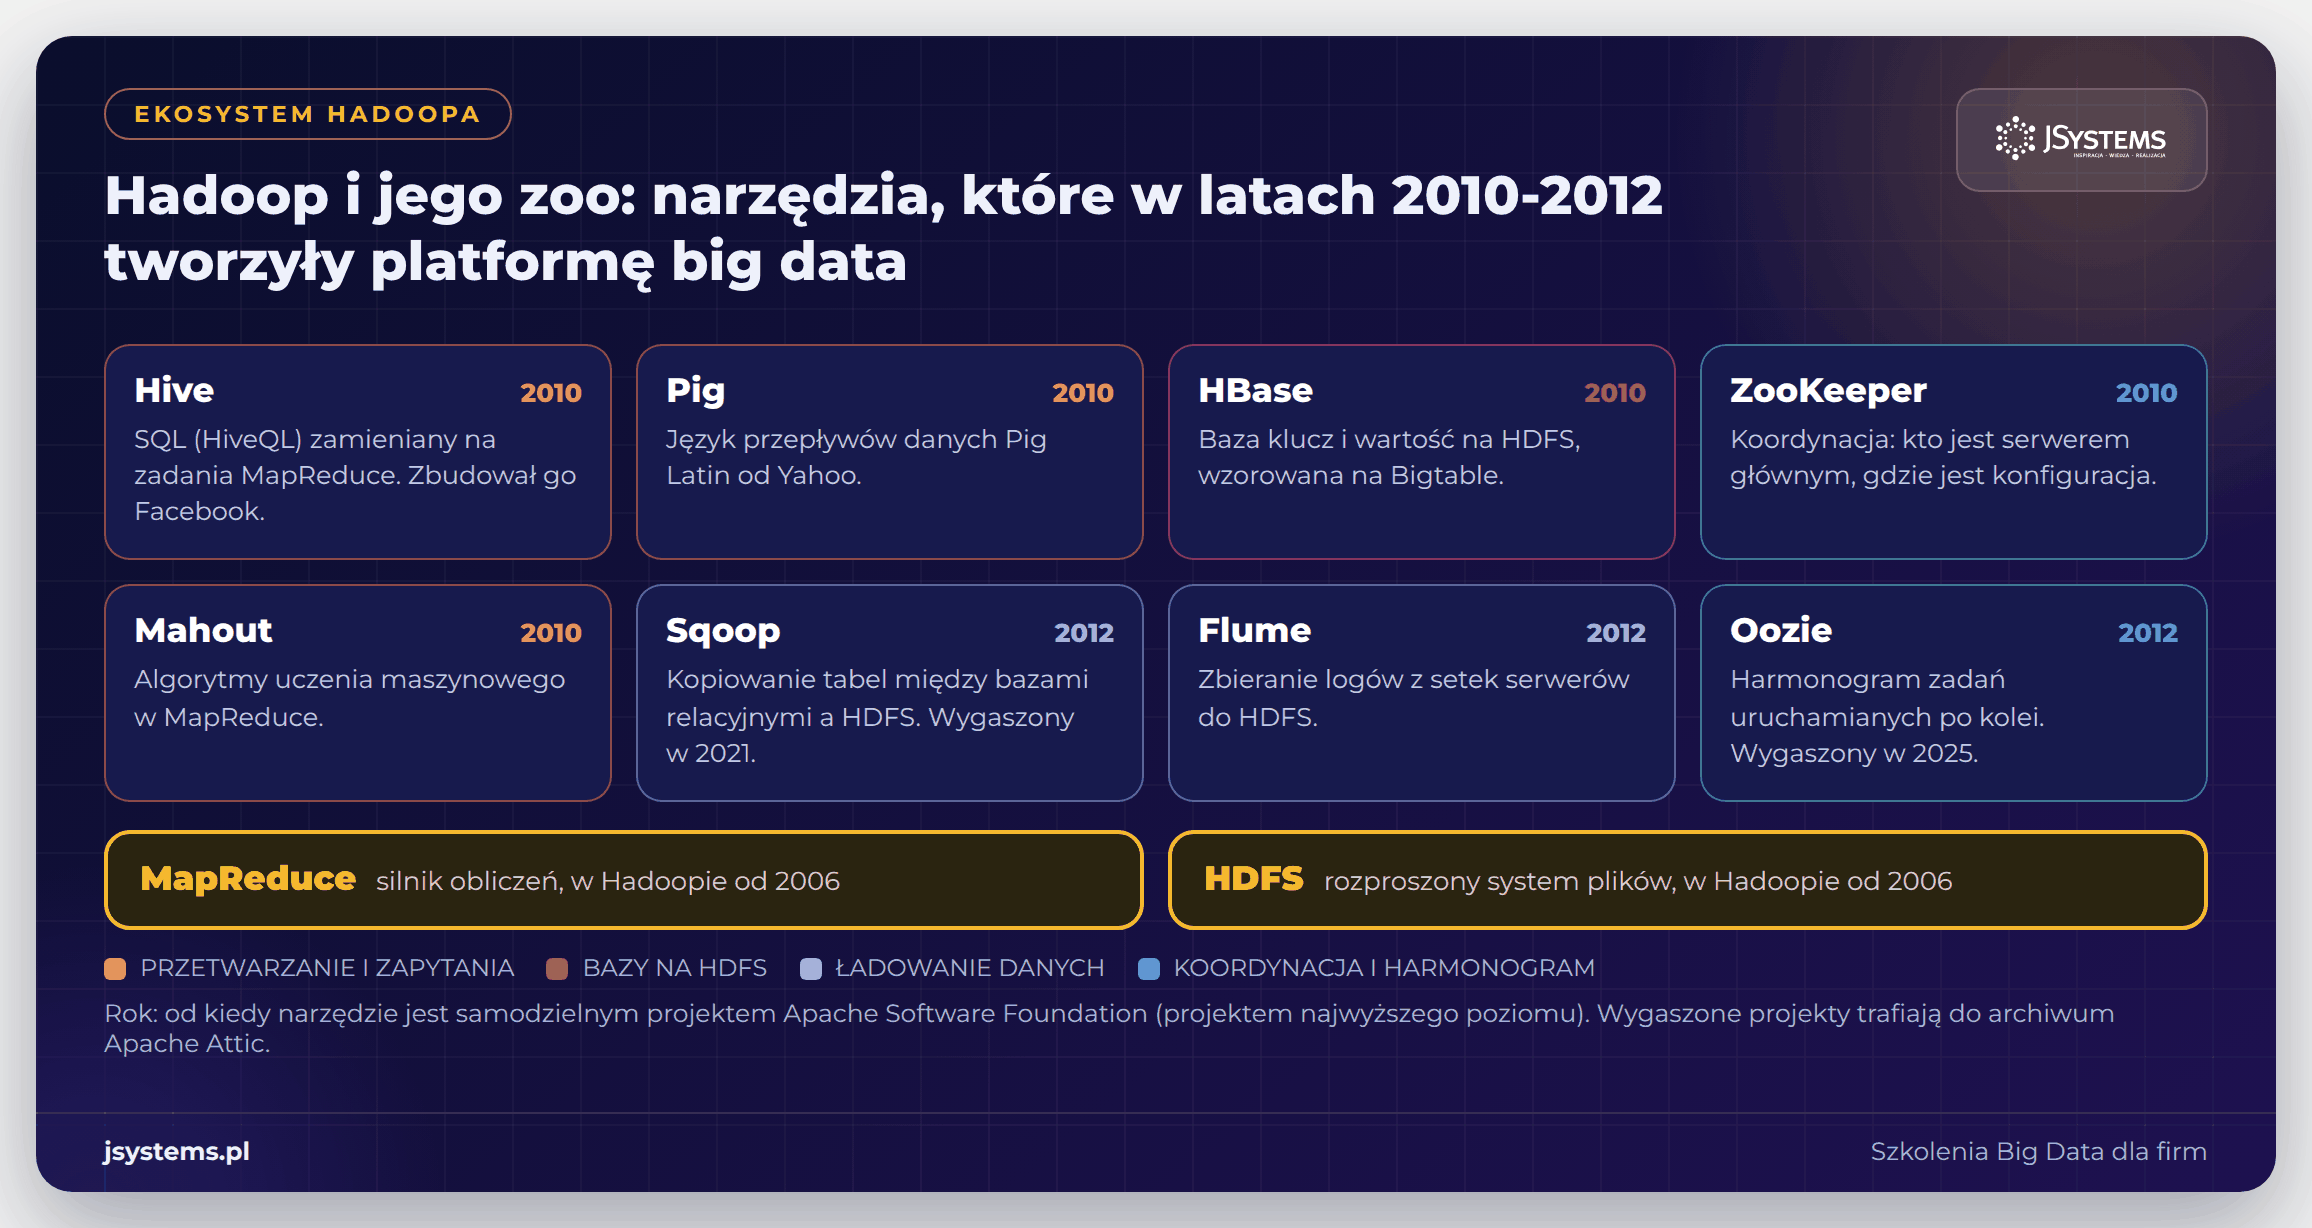
Więcej o samym Hive, jego architekturze i języku HiveQL znajdziesz w artykule Czym jest Apache Hive - kompleksowy przewodnik dla początkujących. Tutaj sprawdzimy tylko, jak wyglądało nasze liczenie słów, gdy zamiast Javy wystarczył SQL.
Zobacz też: Szkolenie Przetwarzanie danych Big Data z Apache Spark
Co chcemy osiągnąć. Policzymy słowa w tym samym pliku w HDFS, pisząc tylko zapytanie SQL. Hive założy na katalogu z plikiem tabelę zewnętrzną, a samo zapytanie zamieni na zadanie MapReduce, które uruchomi na klastrze. Zapytanie jest w pliku wordcount.hql.
wordcount.hql
-- Zliczanie słów w „Panu Tadeuszu” w Hive (silnik MapReduce).
-- Tokenizacja jak w pozostałych wersjach demo: małe litery, podział na ciągi znaków
-- niebędących literami Unicode (\p{L}), puste elementy odrzucone.

-- Tabela zewnętrzna: Hive nie kopiuje danych, tylko czyta pliki z katalogu HDFS.
-- Jedna kolumna = jedna linia tekstu.
DROP TABLE IF EXISTS pan_tadeusz;
CREATE EXTERNAL TABLE pan_tadeusz (line STRING)
STORED AS TEXTFILE
LOCATION '/user/hadoop/pan_tadeusz/large';

-- 20 najczęstszych słów. Remisy rozstrzyga kolejność alfabetyczna.
SELECT word, COUNT(*) AS cnt
FROM (
  SELECT explode(split(lower(line), '[^\\p{L}]+')) AS word
  FROM pan_tadeusz
) words
WHERE word <> ''
GROUP BY word
ORDER BY cnt DESC, word ASC
LIMIT 20;
Plik przekazujemy klientowi beeline, który w tym trybie uruchamia serwer Hive w tym samym procesie:
beeline -u jdbc:hive2:// -n hadoop < wordcount.hql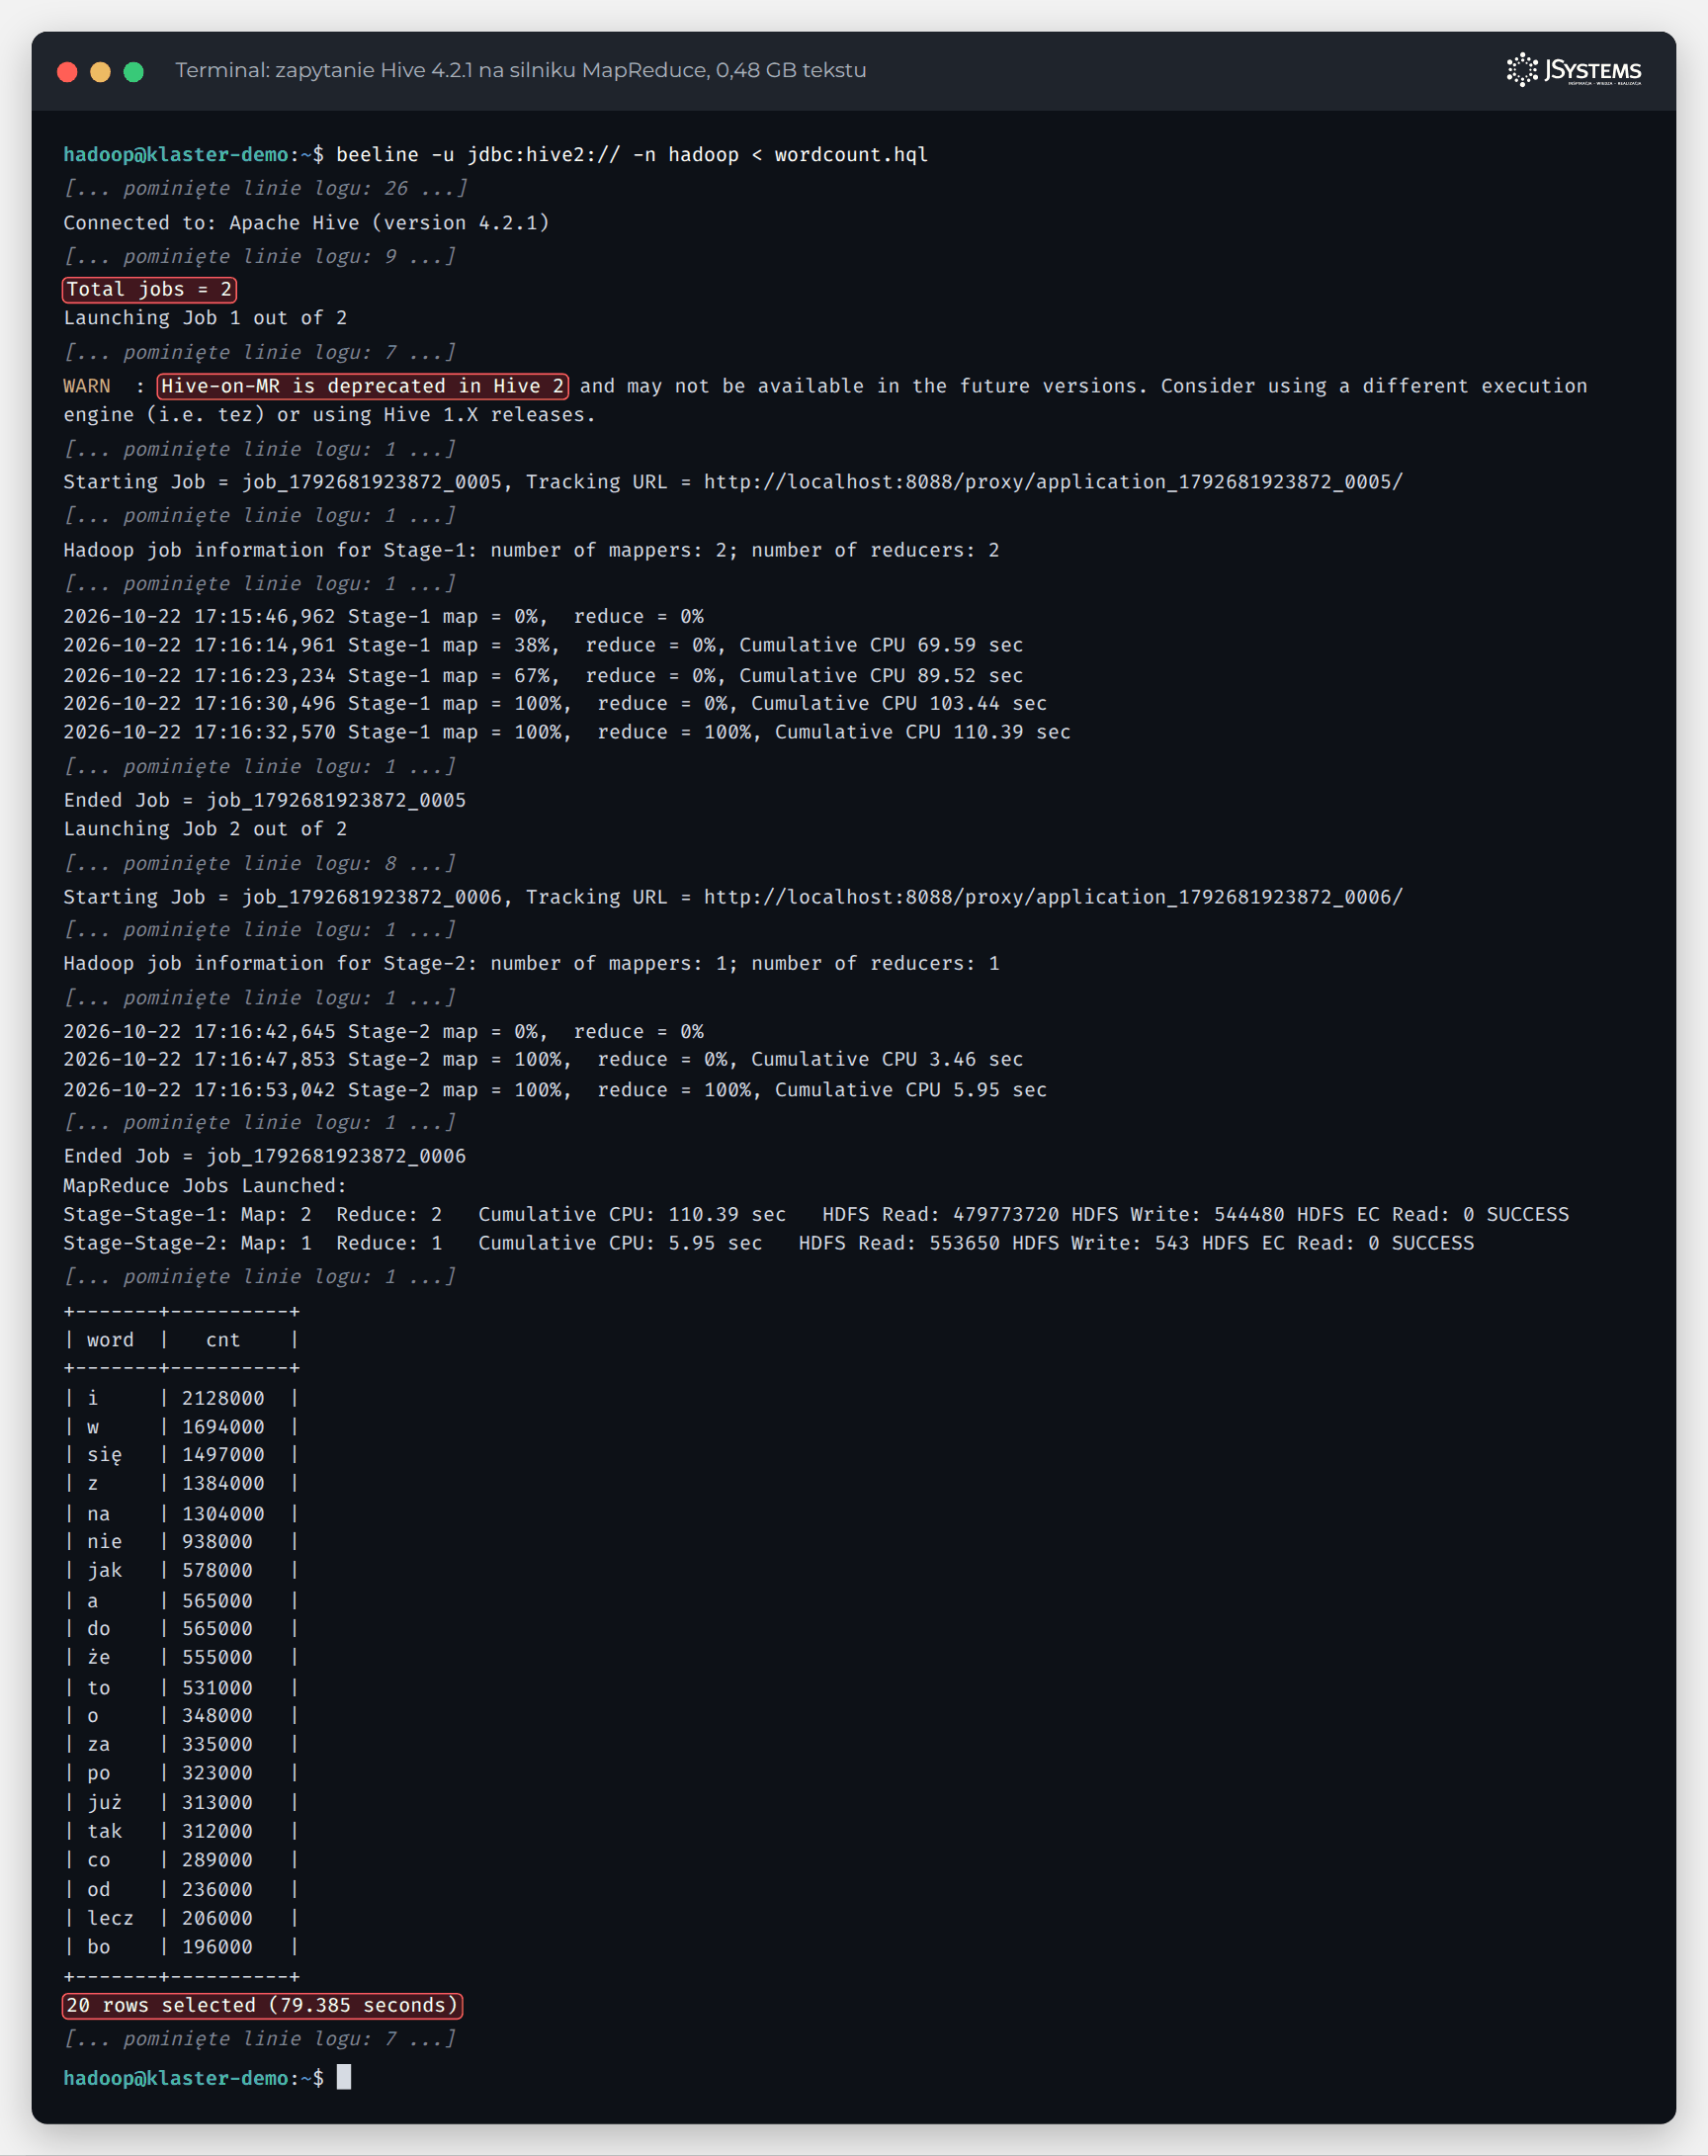
Hive założył tabelę zewnętrzną na katalogu z plikiem i zamienił zapytanie na dwa zadania MapReduce: pierwsze (Stage-1) liczy słowa, drugie (Stage-2) sortuje wynik i obcina go do 20 wierszy. W logu widać ostrzeżenie, że MapReduce jako silnik Hive jest przestarzały od wersji 2 i lepiej użyć silnika Tez. Takie ostrzeżenie w aktualnym Hive 4.2.1 dobrze podsumowuje epokę, którą opisujemy. Samo zapytanie trwało 79 sekund, a całe polecenie razem z uruchomieniem Hive 90 sekund. To dłużej niż program w Javie, bo dwa zadania wykonały się jedno po drugim i każde zaczynało od odczytu danych z HDFS. Za to zamiast 81 linii Javy wystarczyło 13 linii SQL, czytelnych dla każdego analityka, który pisze zapytania do baz danych.
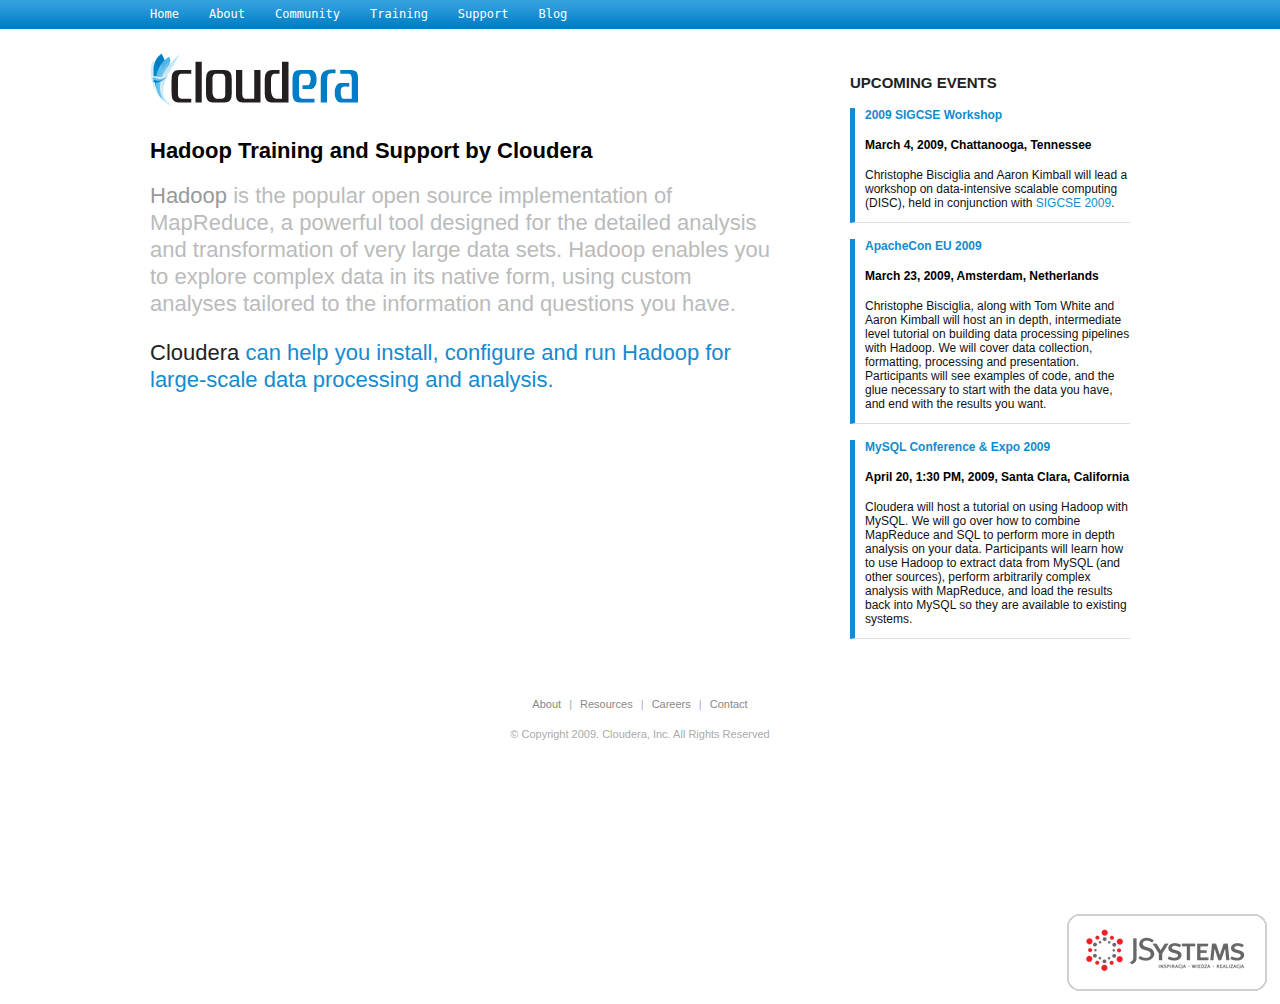
Postawienie i utrzymanie klastra Hadoop z kilkunastoma narzędziami w zgodnych ze sobą wersjach było trudne. Na tym wyrósł model biznesowy dystrybucji: firma testuje zestaw projektów Apache, dodaje narzędzia do instalacji i monitorowania, sprzedaje wsparcie. W 2008 roku powstała Cloudera, która w marcu 2009 roku udostępniła darmową dystrybucję Hadoopa i zarabiała na wsparciu oraz szkoleniach. We wrześniu tego samego roku dołączył do niej z Yahoo Doug Cutting. W 2009 roku powstał też MapR, który zamiast HDFS oferował własny system plików. W 2011 roku z Yahoo wydzielił się zespół Hortonworks, który rozwijał Hadoopa od pierwszych dni.
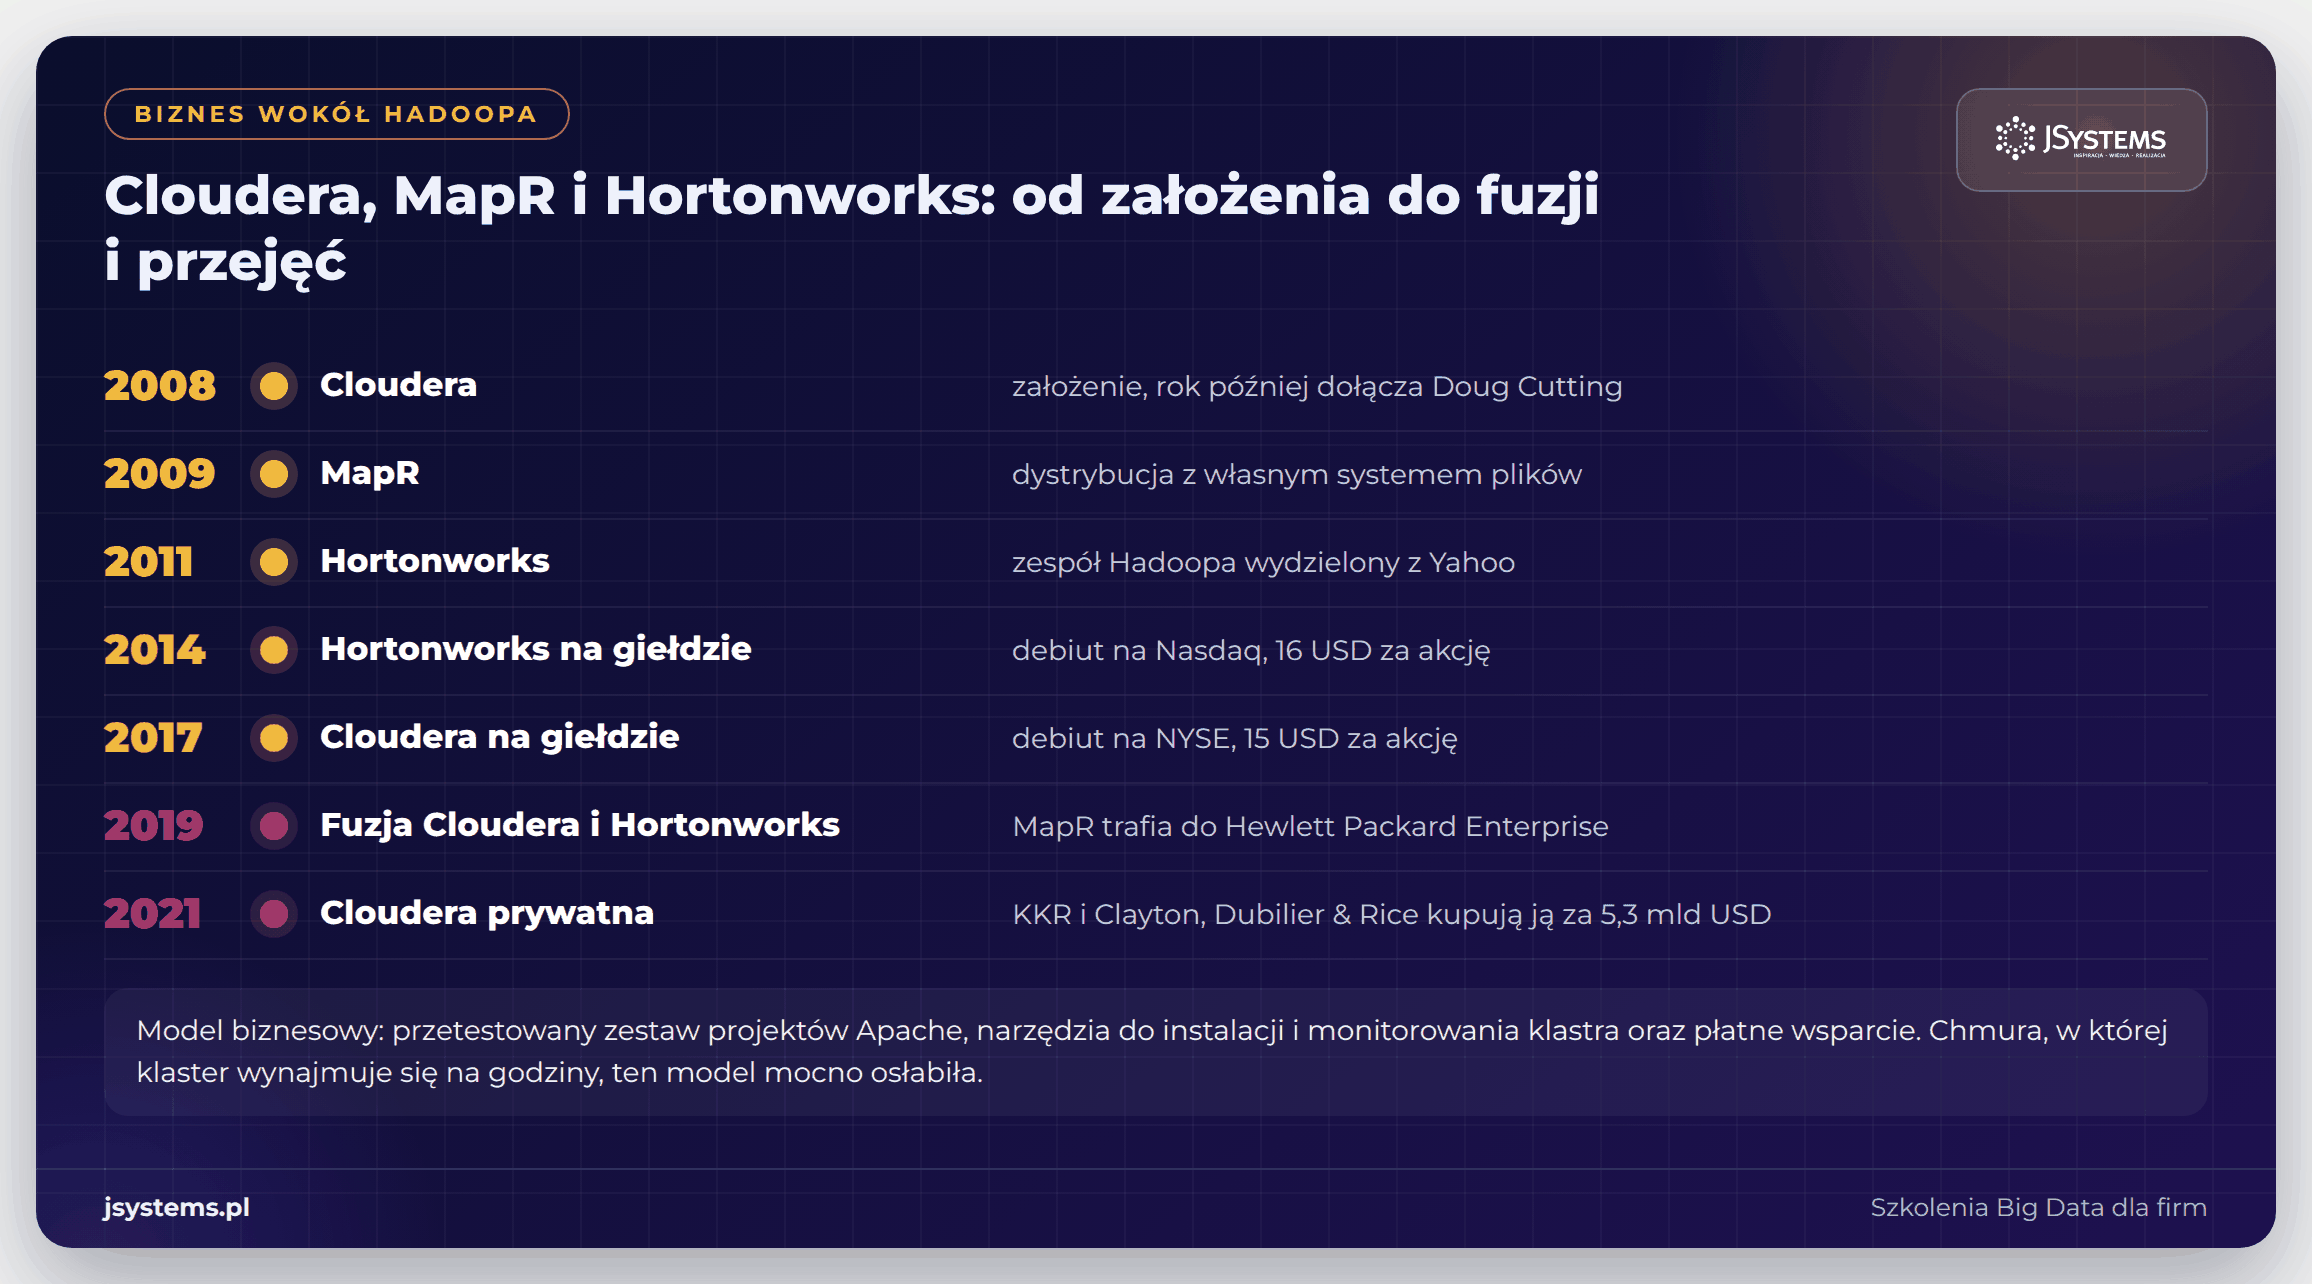
Szczyt popularności Hadoopa przypadł na połowę dekady. Firmy budowały własne klastry, a na Stack Overflow najwięcej pytań oznaczonych tagiem hadoop zadano w 2015 roku. Potem przyszła chmura, w której klaster można wynająć na godziny, i Spark, który w wielu zastosowaniach zastąpił MapReduce. W październiku 2018 roku Cloudera i Hortonworks ogłosiły fuzję, zamkniętą w styczniu 2019 roku. W tym samym roku Hewlett Packard Enterprise przejął aktywa MapR, a w 2021 roku Clouderę za około 5,3 mld USD kupiły fundusze Clayton, Dubilier & Rice i KKR, więc spółka zniknęła z giełdy.
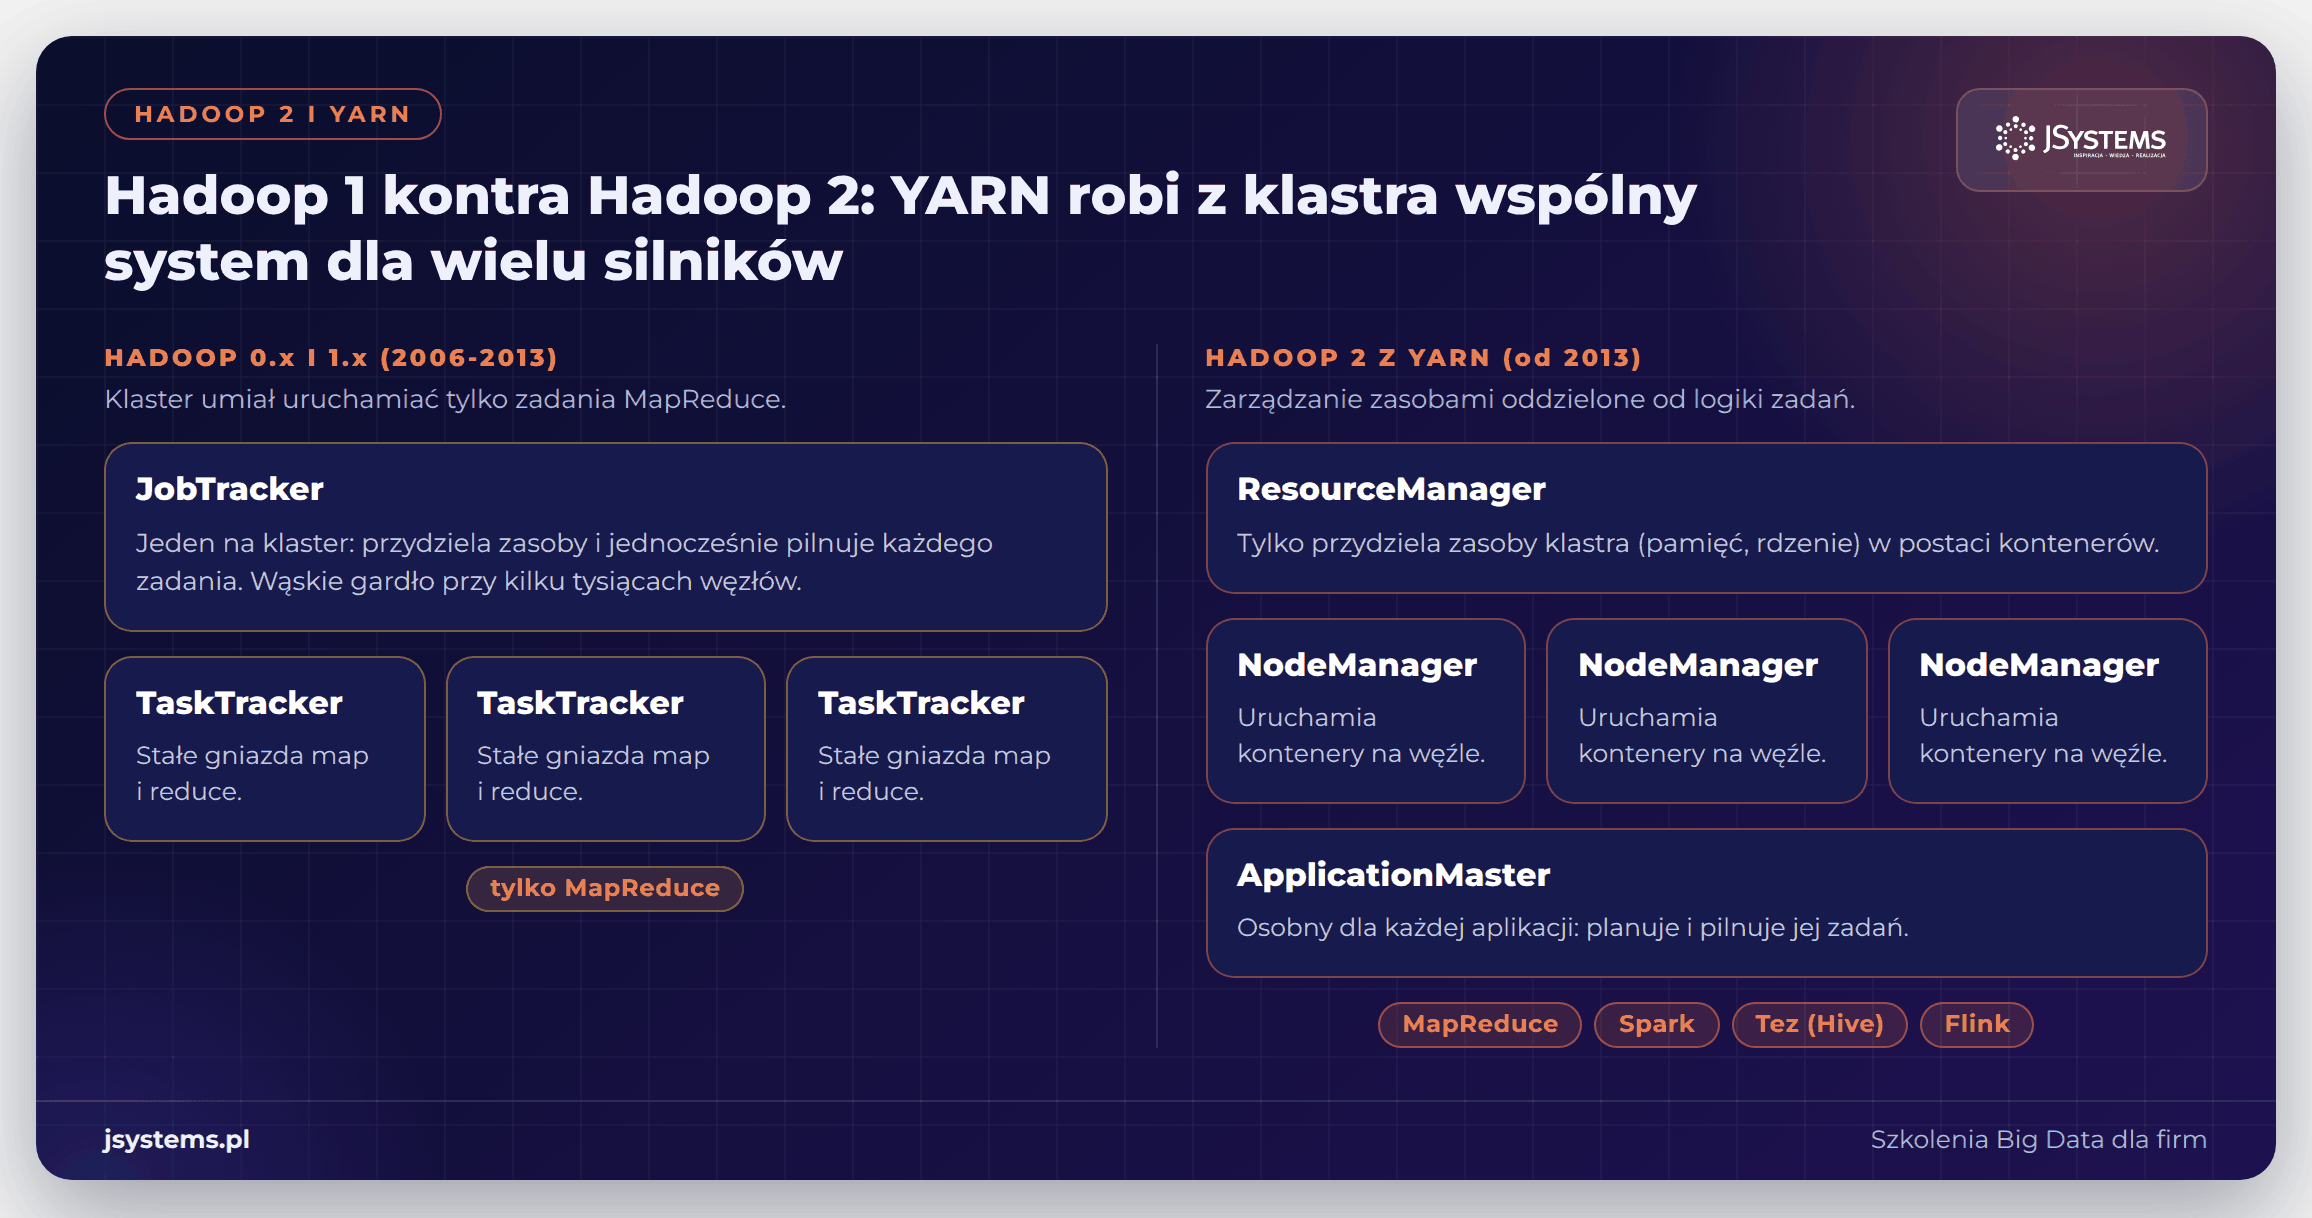
Wersja 1.0 ukazała się dopiero w grudniu 2011 roku, prawie sześć lat po pierwszym wydaniu. Architektura miała wtedy wyraźny sufit. Jeden proces JobTracker przydzielał zasoby i jednocześnie pilnował każdego zadania na klastrze, więc przy kilku tysiącach węzłów stawał się wąskim gardłem. Klaster umiał też uruchamiać wyłącznie zadania MapReduce.
Odpowiedzią był YARN (Yet Another Resource Negotiator), który w Hadoopie 2 oddzielił zarządzanie zasobami od logiki zadań. ResourceManager tylko przydziela pamięć i rdzenie w postaci kontenerów, a każda aplikacja dostaje własnego zarządcę, ApplicationMastera. Od wersji 2.2.0 z października 2013 roku na tym samym klastrze mogły pracować obok siebie MapReduce, Spark, Tez czy Flink.
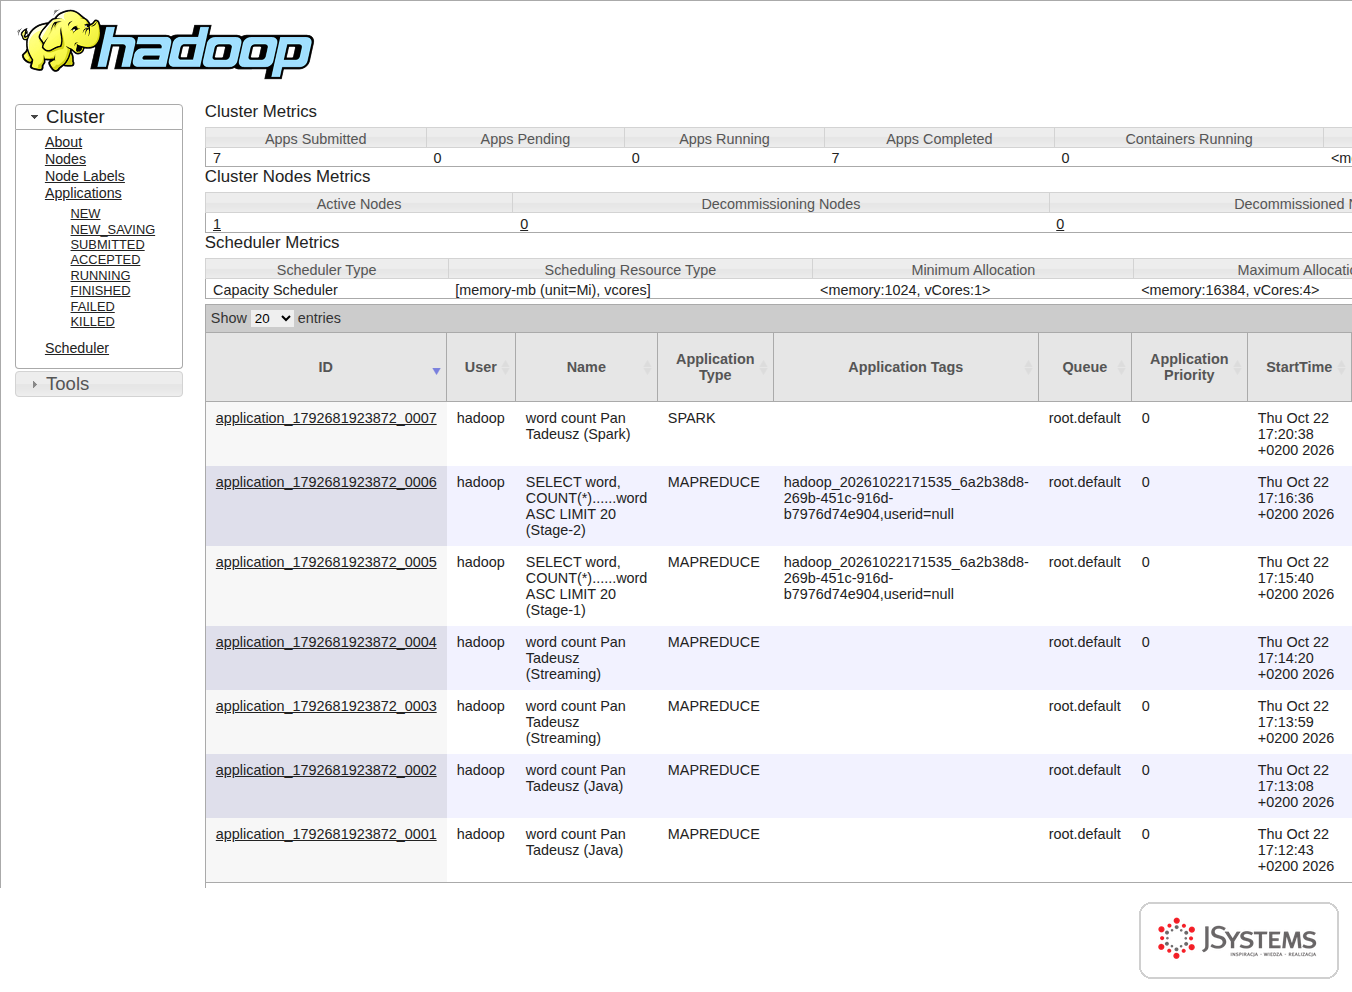
Na naszym klastrze widać to w interfejsie ResourceManagera. Obok siebie widać tam zadania MapReduce z programu w Javie i ze skryptów Pythona, dwa zadania wygenerowane przez zapytanie Hive i aplikacja Sparka, którą wysłaliśmy na ten sam klaster poleceniem spark-submit --master yarn. Każda z nich dostała od YARN kontenery z pamięcią i rdzeniami procesora, a ResourceManager nie musiał wiedzieć, jakim silnikiem liczą.
W 2009 roku na Uniwersytecie Kalifornijskim w Berkeley doktorant Matei Zaharia zaczął pracę nad silnikiem, który miał rozwiązać jeden konkretny problem MapReduce. Algorytmy uczenia maszynowego i analizy interaktywne przechodzą po tych samych danych wiele razy. W MapReduce każdy taki przebieg to osobne zadanie, które czyta dane z dysku i zapisuje wynik z powrotem na dysk. Spark wczytuje dane raz i trzyma je w pamięci operacyjnej klastra.
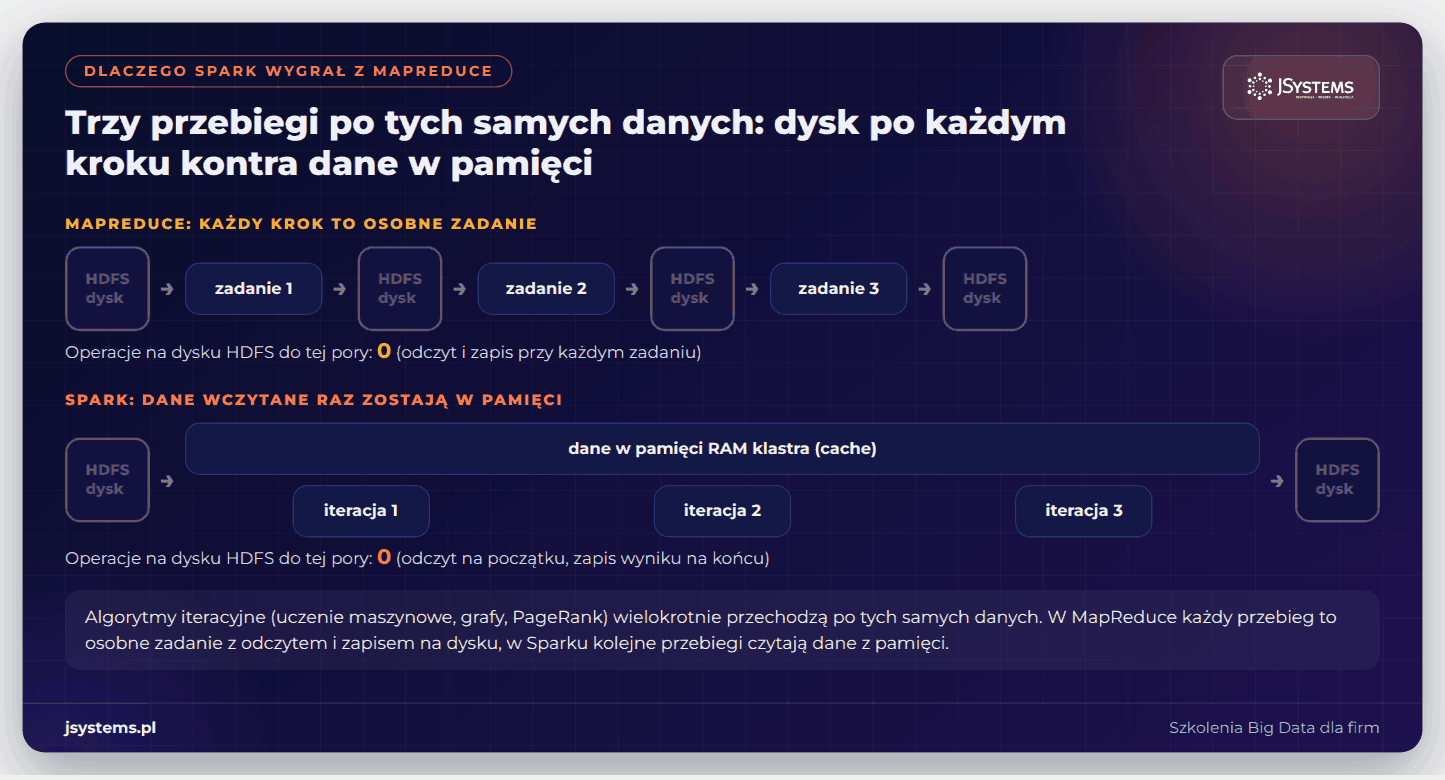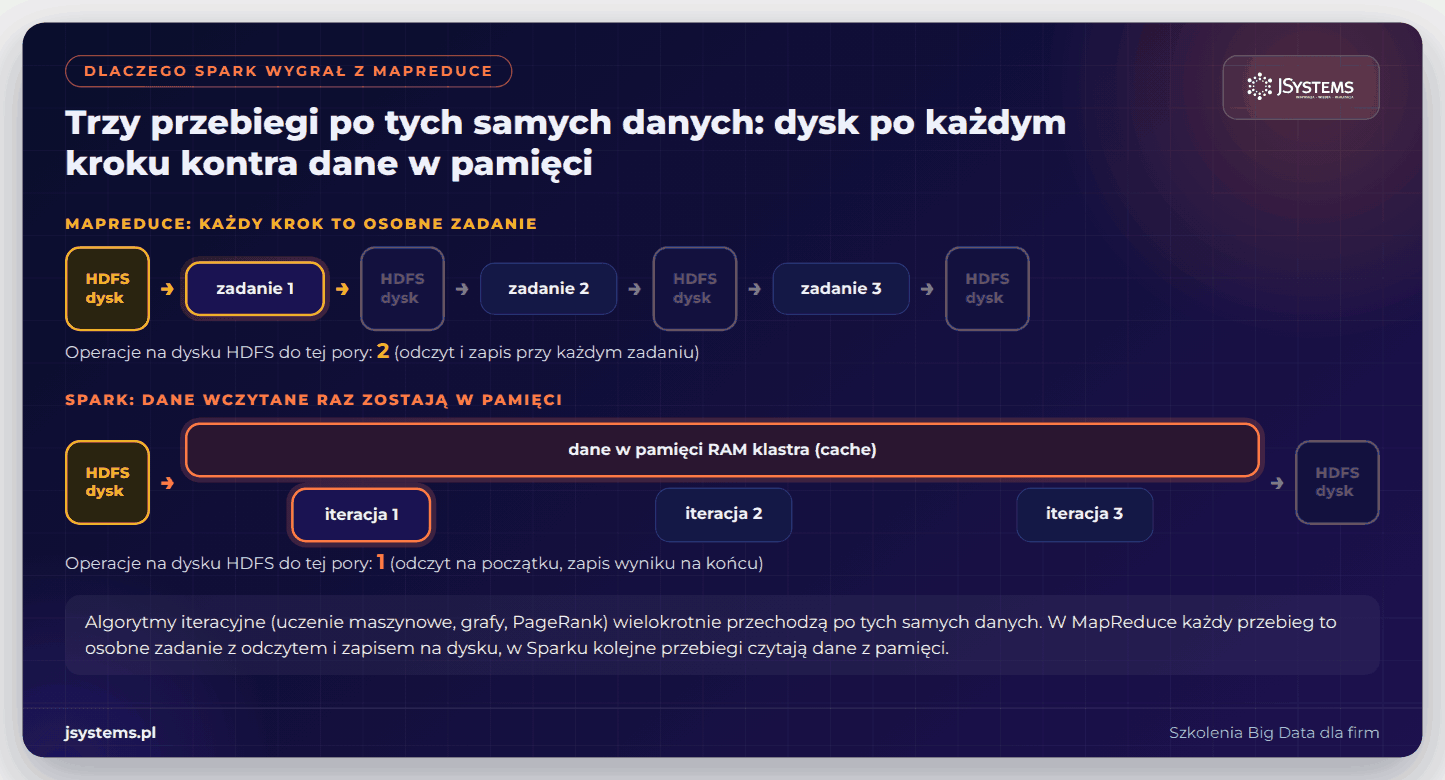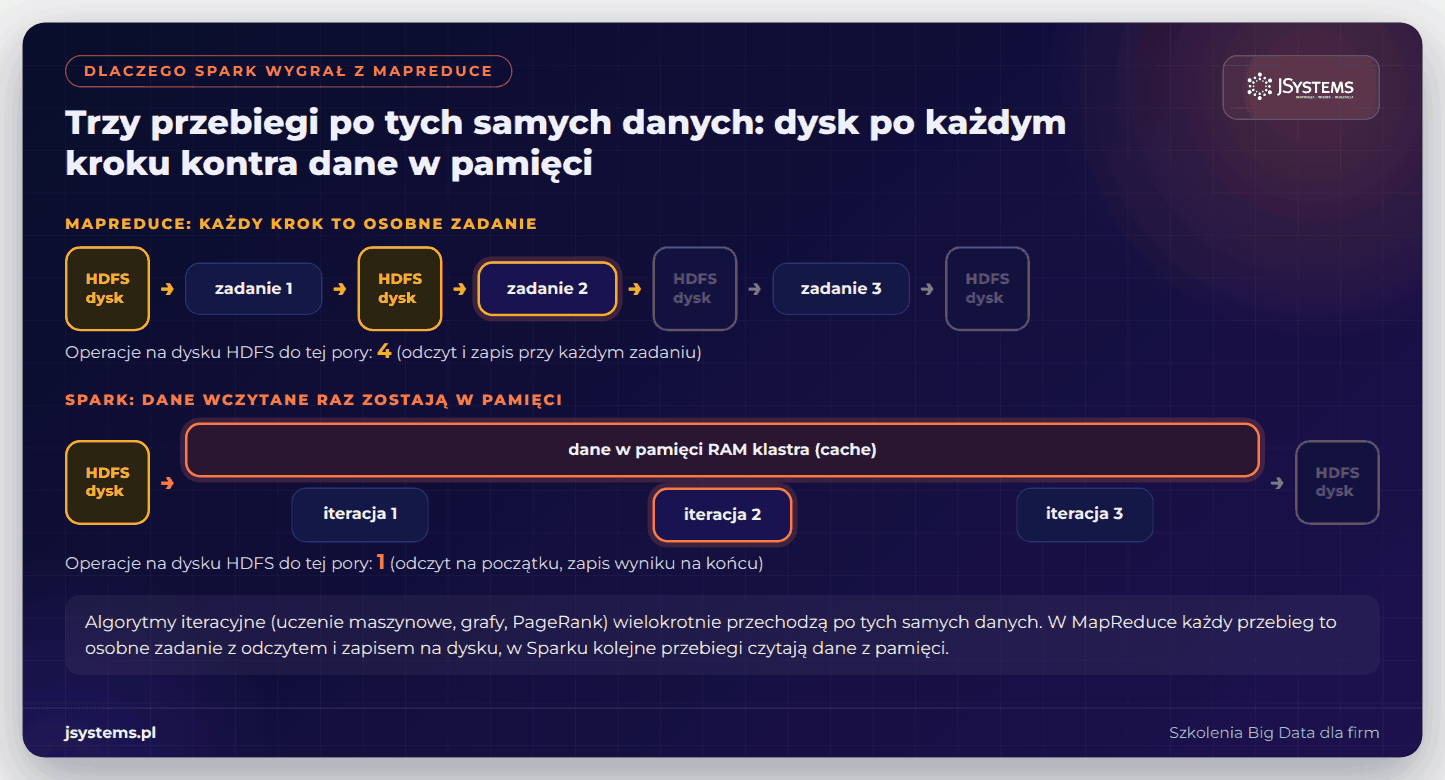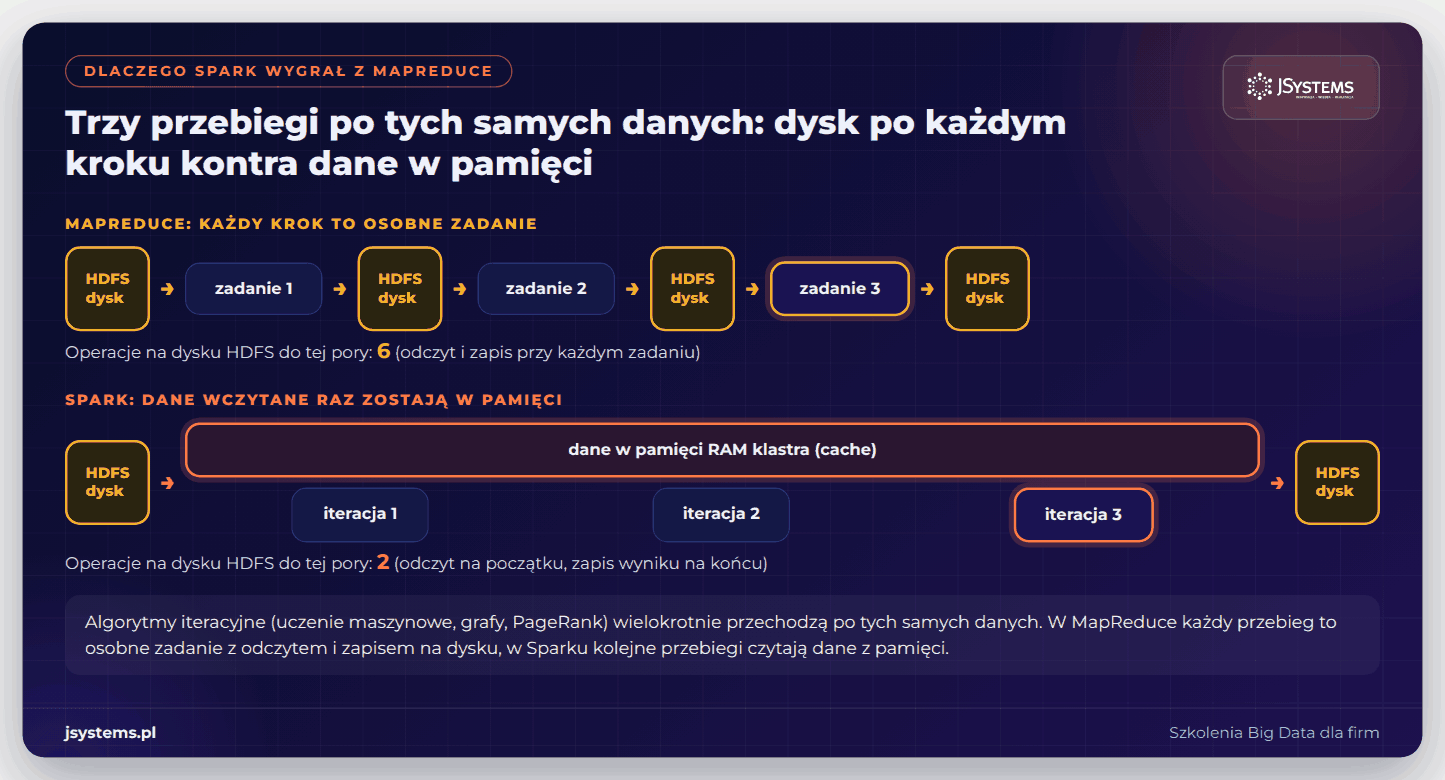
Sercem Sparka był RDD (Resilient Distributed Dataset), czyli niezmienny zbiór danych podzielony na części leżące na różnych węzłach. Odporność na awarie Spark zapewnia inaczej niż HDFS: nie kopiuje danych trzy razy, tylko zapamiętuje, z jakich operacji powstał każdy fragment. Gdy węzeł padnie, brakującą część po prostu liczy od nowa. Kod Sparka udostępniono jako otwarte oprogramowanie w 2010 roku. Projekt rozwijał się dalej w laboratorium AMPLab, które Berkeley uruchomiło w 2011 roku, a publikacja o RDD dostała nagrodę za najlepszą pracę na konferencji NSDI w 2012 roku.
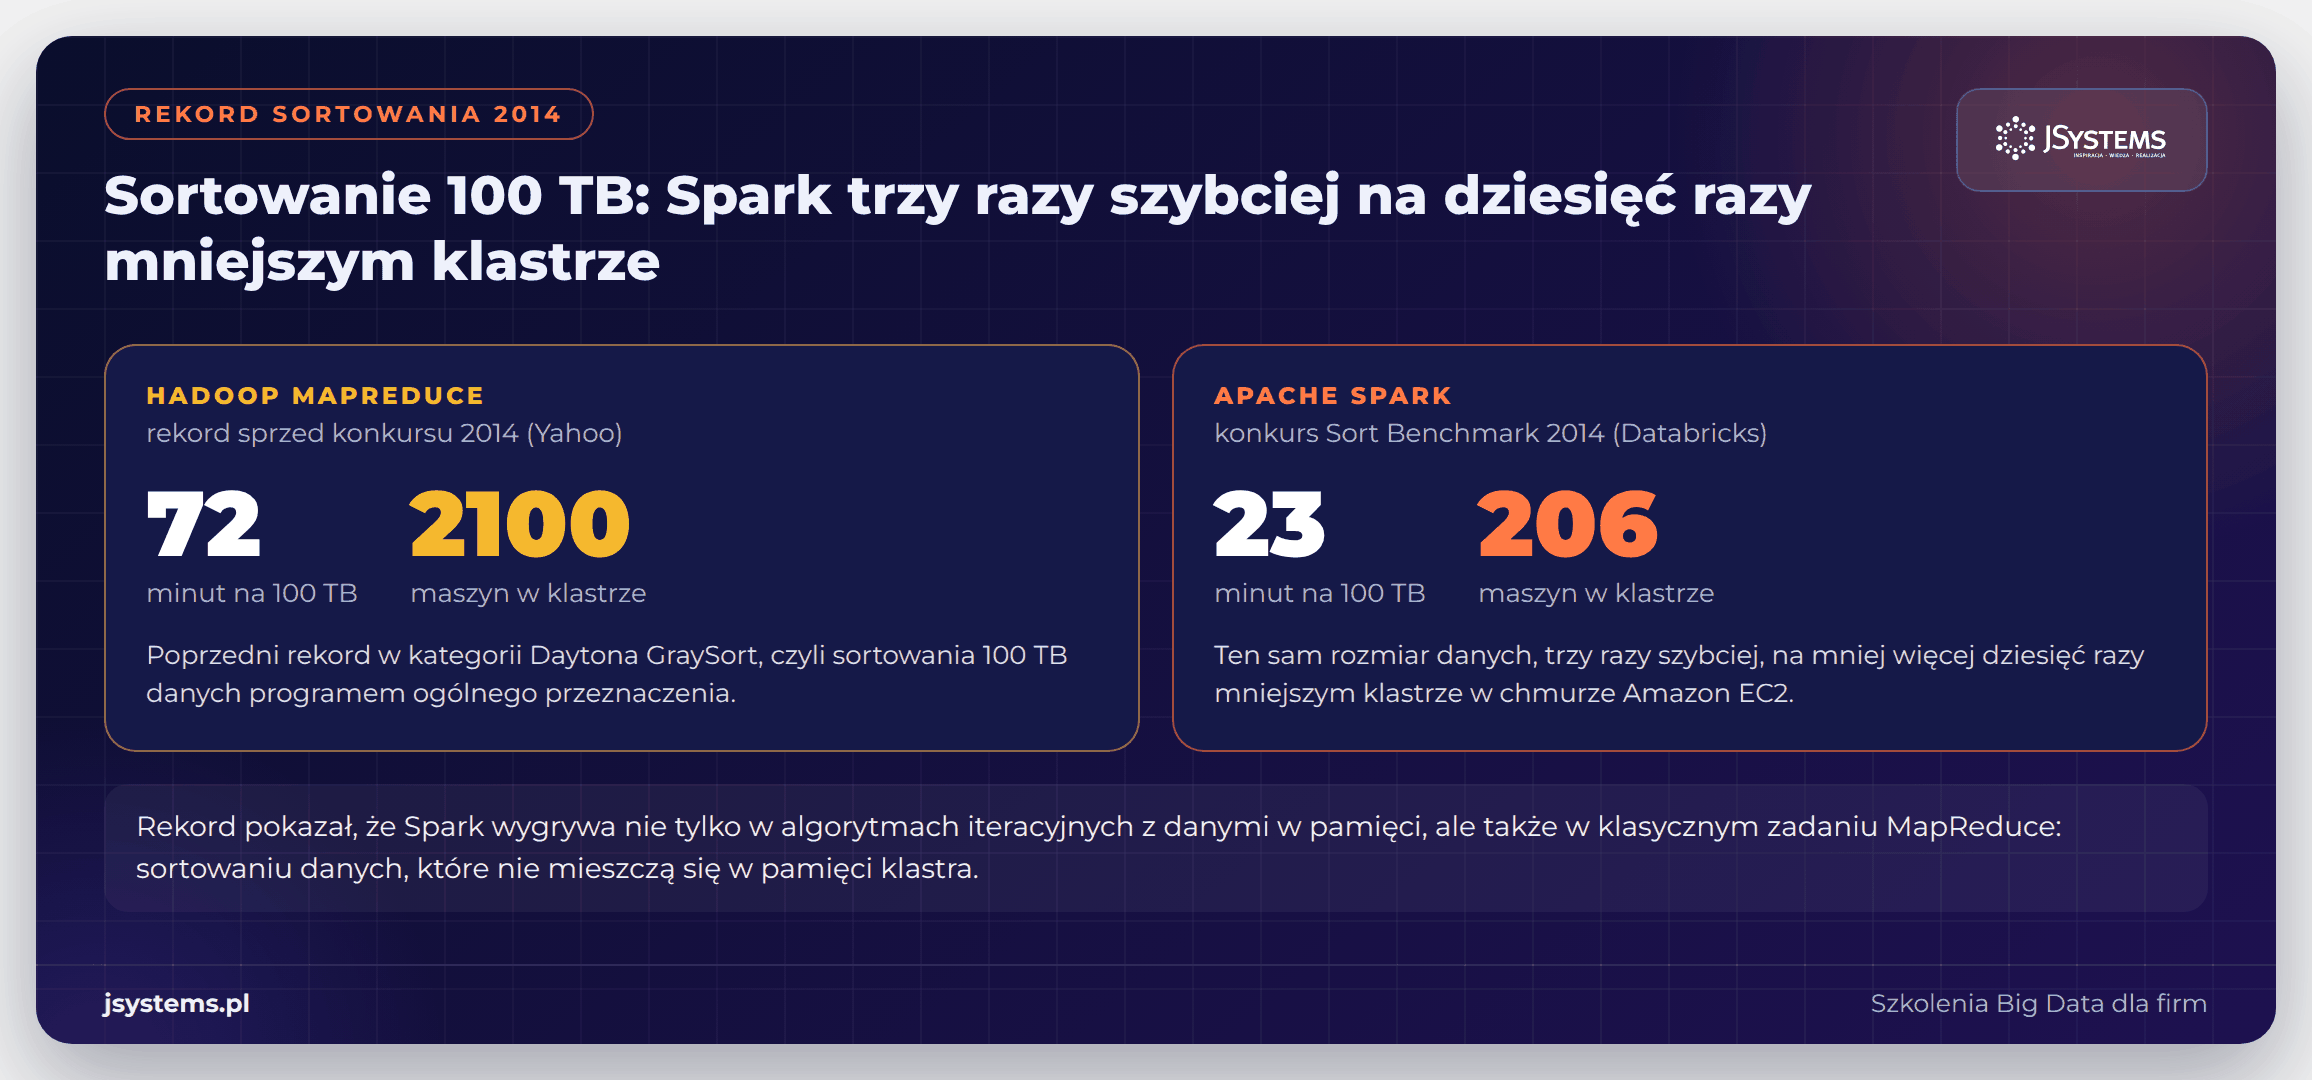
W czerwcu 2013 roku Spark trafił do inkubatora Apache Software Foundation, w lutym 2014 roku został projektem najwyższego poziomu, a w maju 2014 roku ukazała się wersja 1.0. Jesienią tego samego roku Spark ustanowił rekord w konkursie Daytona GraySort, czyli w sortowaniu 100 TB danych: zajęło mu to 23 minuty na 206 maszynach (rekord ex aequo z zespołem Themis z Uniwersytetu Kalifornijskiego w San Diego). Poprzedni rekord, ustanowiony przez Hadoop MapReduce, wynosił 72 minuty na 2100 maszynach. Spark sortował przy tym dane na dyskach, bez trzymania ich w pamięci, więc o wyniku nie zdecydowała pamięć operacyjna, tylko wydajniejszy silnik.
Spark nie wymagał porzucenia Hadoopa. Czytał pliki z HDFS i działał jako jedna z aplikacji YARN, więc firmy mogły go dołożyć do istniejących klastrów. Szczegółowe omówienie architektury, leniwego wykonania i optymalizatora Catalyst znajdziesz w przewodniku Czym jest Apache Spark - kompletny przewodnik dla początkujących, a pomiar tej samej analizy w Sparku i w Hive w artykule Apache Spark vs Apache Hive - które narzędzie Big Data wybrać.
Co chcemy osiągnąć. Policzymy słowa w tym samym pliku z HDFS najpierw w interaktywnej powłoce PySparka, a potem w krótkim skrypcie z API DataFrame. Zobaczymy, ile kodu zostało z programu w Javie, ile trwa przebieg i jak Spark rozpisuje zadanie na etapy w swoim interfejsie WWW. Skrypt jest w pliku wordcount_spark.py.
W powłoce PySparka całe liczenie słów to trzy linie: wczytanie pliku z HDFS (sc.textFile), podział wierszy na słowa (flatMap) i zliczenie par (map oraz reduceByKey). Te linie jeszcze niczego nie liczą. Spark zapisuje tylko plan i wykonuje go dopiero wtedy, gdy poprosimy o wynik, na przykład wywołując count() albo takeOrdered(). To tak zwane leniwe wykonanie: Spark widzi cały plan naraz, więc może go zoptymalizować przed startem.
import re
lines = sc.textFile("hdfs://127.0.0.1:9000/user/hadoop/pan_tadeusz/small/pan_tadeusz.txt")
lines.count()
words = lines.flatMap(lambda line: re.findall(r'[^\W\d_]+', line.lower()))
words.count()
counts = words.map(lambda w: (w, 1)).reduceByKey(lambda a, b: a + b)
counts.count()
counts.takeOrdered(5, key=lambda kv: (-kv[1], kv[0]))
spark.version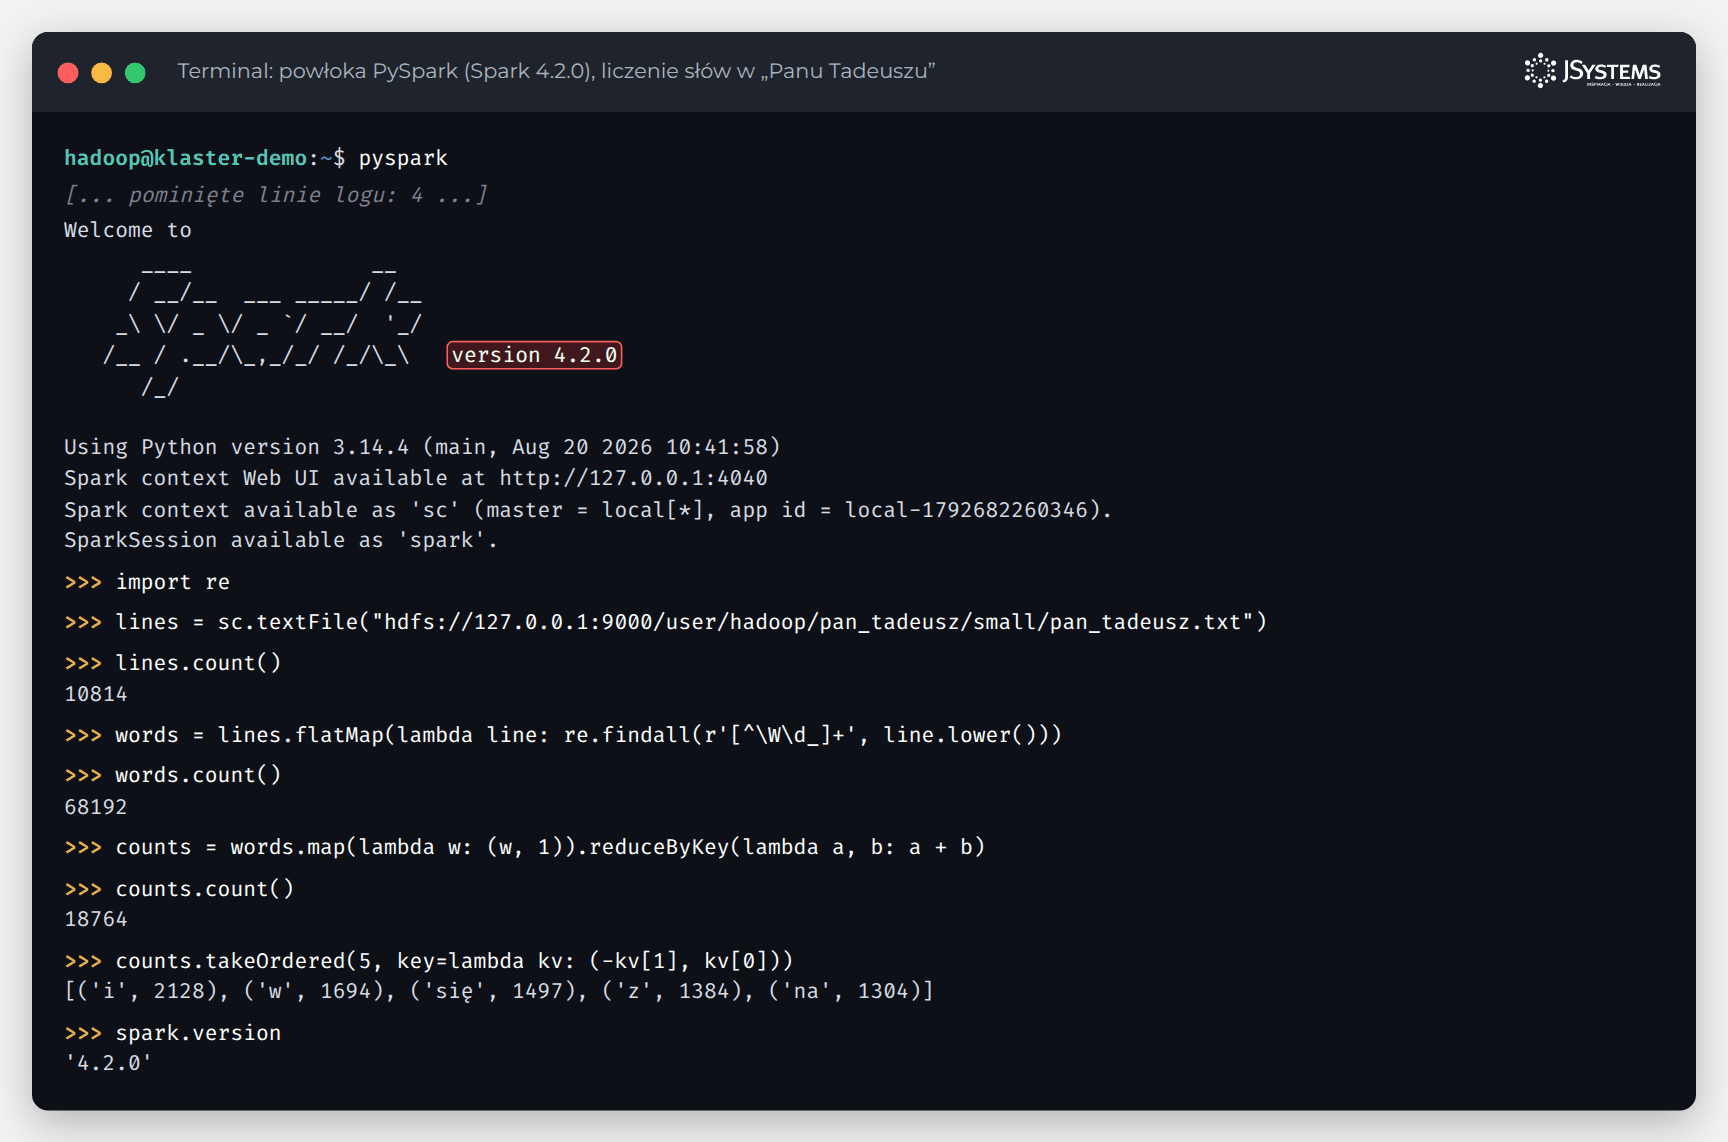
wordcount_spark.py: wersja RDD i DataFrame
#!/usr/bin/env python3
"""Zliczanie słów w „Panu Tadeuszu” w Sparku: wersja RDD i wersja DataFrame/SQL.

Tokenizacja jak w pozostałych wersjach demo (Java, Streaming, Hive): małe litery,
podział na ciągi znaków niebędących literami Unicode, puste elementy odrzucone.

Użycie:
    spark-submit wordcount_spark.py {rdd|df|both} {small|large} [--pause SECONDS] [--label yarn]

--pause zostawia aplikację przy życiu po policzeniu, żeby można było obejrzeć Spark UI (port 4040).
--label dopisuje przedrostek do katalogu wynikowego (np. dla uruchomienia na YARN).
Wersja RDD zapisuje wynik przez saveAsTextFile, które nie nadpisuje istniejącego katalogu:
przed ponownym uruchomieniem usuń go (hdfs dfs -rm -r /user/hadoop/output/spark_rdd_large).
"""
import argparse
import re
import sys
import time

from pyspark.sql import SparkSession
from pyspark.sql import functions as F

BASE_PATH = 'hdfs://127.0.0.1:9000/user/hadoop'
INPUT_PATHS = {'small': BASE_PATH + '/pan_tadeusz/small', 'large': BASE_PATH + '/pan_tadeusz/large'}

# [^\W\d_] to litera Unicode (znak „słowa” bez cyfr i podkreślenia)
LETTERS = re.compile(r'[^\W\d_]+')


def count_rdd(spark, input_path, output_path):
    """Klasyczne API RDD: flatMap -> map -> reduceByKey."""
    lines = spark.sparkContext.textFile(input_path)
    counts = (lines
              .flatMap(lambda line: LETTERS.findall(line.lower()))   # każde słowo osobno
              .map(lambda word: (word, 1))                           # para (słowo, 1)
              .reduceByKey(lambda a, b: a + b)                       # suma po słowie
              .cache())                                              # wynik jest mały, więc trzymamy go w pamięci
    counts.map(lambda pair: '%s\t%d' % pair).saveAsTextFile(output_path)
    top = counts.takeOrdered(20, key=lambda pair: (-pair[1], pair[0]))
    return top, counts.count(), counts.values().sum()


def count_dataframe(spark, input_path, output_path):
    """DataFrame i SQL: ten sam wynik, ale optymalizuje go Catalyst, a nie programista."""
    lines = spark.read.text(input_path)                               # jedna kolumna: value
    lines.createOrReplaceTempView('pan_tadeusz')
    counts = spark.sql(r"""
        SELECT word, COUNT(*) AS cnt
        FROM (SELECT explode(split(lower(value), '[^\\p{L}]+')) AS word FROM pan_tadeusz)
        WHERE word <> ''
        GROUP BY word
    """).cache()
    counts.write.mode('overwrite').option('sep', '\t').csv(output_path)
    top = [tuple(row) for row in counts.orderBy(F.desc('cnt'), F.asc('word')).limit(20).collect()]
    return top, counts.count(), counts.agg(F.sum('cnt')).first()[0]


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('mode', choices=['rdd', 'df', 'both'])
    parser.add_argument('dataset', choices=['small', 'large'])
    parser.add_argument('--pause', type=int, default=0, help='ile sekund utrzymać aplikację po policzeniu')
    parser.add_argument('--label', default='', help='przedrostek katalogu wynikowego, np. yarn')
    args = parser.parse_args()

    spark = SparkSession.builder.appName('word count Pan Tadeusz (Spark)').getOrCreate()
    spark.sparkContext.setLogLevel('WARN')
    print('Spark %s, Python %s, master=%s' % (spark.version, sys.version.split()[0], spark.sparkContext.master))

    for mode, count_fn in (('rdd', count_rdd), ('df', count_dataframe)):
        if args.mode not in (mode, 'both'):
            continue
        prefix = args.label + '_' if args.label else ''
        output_path = '%s/output/spark_%s%s_%s' % (BASE_PATH, prefix, mode, args.dataset)
        spark.sparkContext.setJobDescription('word count (%s, %s)' % (mode.upper(), args.dataset))
        started = time.time()
        top, distinct_words, total_words = count_fn(spark, INPUT_PATHS[args.dataset], output_path)
        print('\n== wersja %s, zbiór %s: %d różnych słów, %d wszystkich, czas %.1f s' %
              (mode.upper(), args.dataset, distinct_words, total_words, time.time() - started))
        print('== wynik zapisany w %s' % output_path)
        print('== 20 najczęstszych słów:')
        for word, count in top:
            print('%s\t%d' % (word, count))

    if args.pause:
        print('\n== Spark UI: %s (pauza %d s)' % (spark.sparkContext.uiWebUrl, args.pause))
        sys.stdout.flush()
        time.sleep(args.pause)
    spark.stop()


if __name__ == '__main__':
    main()
Skrypt uruchamiamy poleceniem spark-submit, podając wersję (rdd, df albo obie, both) i plik (small albo large). Bez dodatkowych opcji Spark działa lokalnie, w jednym procesie. Żeby wysłać ten sam skrypt na klaster YARN, najpierw kopiujemy biblioteki Sparka do HDFS, żeby YARN nie musiał ich przesyłać przy każdym uruchomieniu, a potem dodajemy --master yarn i rozmiar wykonawców:
spark-submit wordcount_spark.py df large

hdfs dfs -mkdir -p /spark/jars && hdfs dfs -put -f $SPARK_HOME/jars/*.jar /spark/jars/
spark-submit --master yarn --deploy-mode client \
  --num-executors 2 --executor-cores 2 --executor-memory 2g \
  --conf spark.yarn.jars='hdfs://127.0.0.1:9000/spark/jars/*.jar' \
  wordcount_spark.py df large --label yarn
Na dużym pliku, czyli 0,48 GB tekstu, wersja DataFrame uruchomiona lokalnie policzyła słowa w 24 sekundy, a wersja RDD w 30 sekund. Program MapReduce w Javie potrzebował na to samo 50 sekund. Spark uruchomiony lokalnie działa w jednym procesie, w którym zadania są wątkami, więc nie traci czasu na uruchamianie osobnego kontenera dla każdego zadania, jak MapReduce na YARN. Wersja DataFrame wyprzedza RDD, bo zapytanie przed uruchomieniem optymalizuje Catalyst, a dzielenie wierszy na słowa i liczenie odbywa się w całości w maszynie wirtualnej Javy. W wersji RDD funkcje lambda wykonuje Python, więc każdy wiersz wędruje do procesu Pythona i z powrotem. Ten sam skrypt wysłany na klaster poleceniem spark-submit --master yarn trwał 59 sekund, bo doszło uruchomienie aplikacji na YARN i kontenerów dla wykonawców (executors). Na jednym komputerze nic na tym nie zyskaliśmy, ale ten sam skrypt bez zmian działa na klastrze z setkami węzłów.
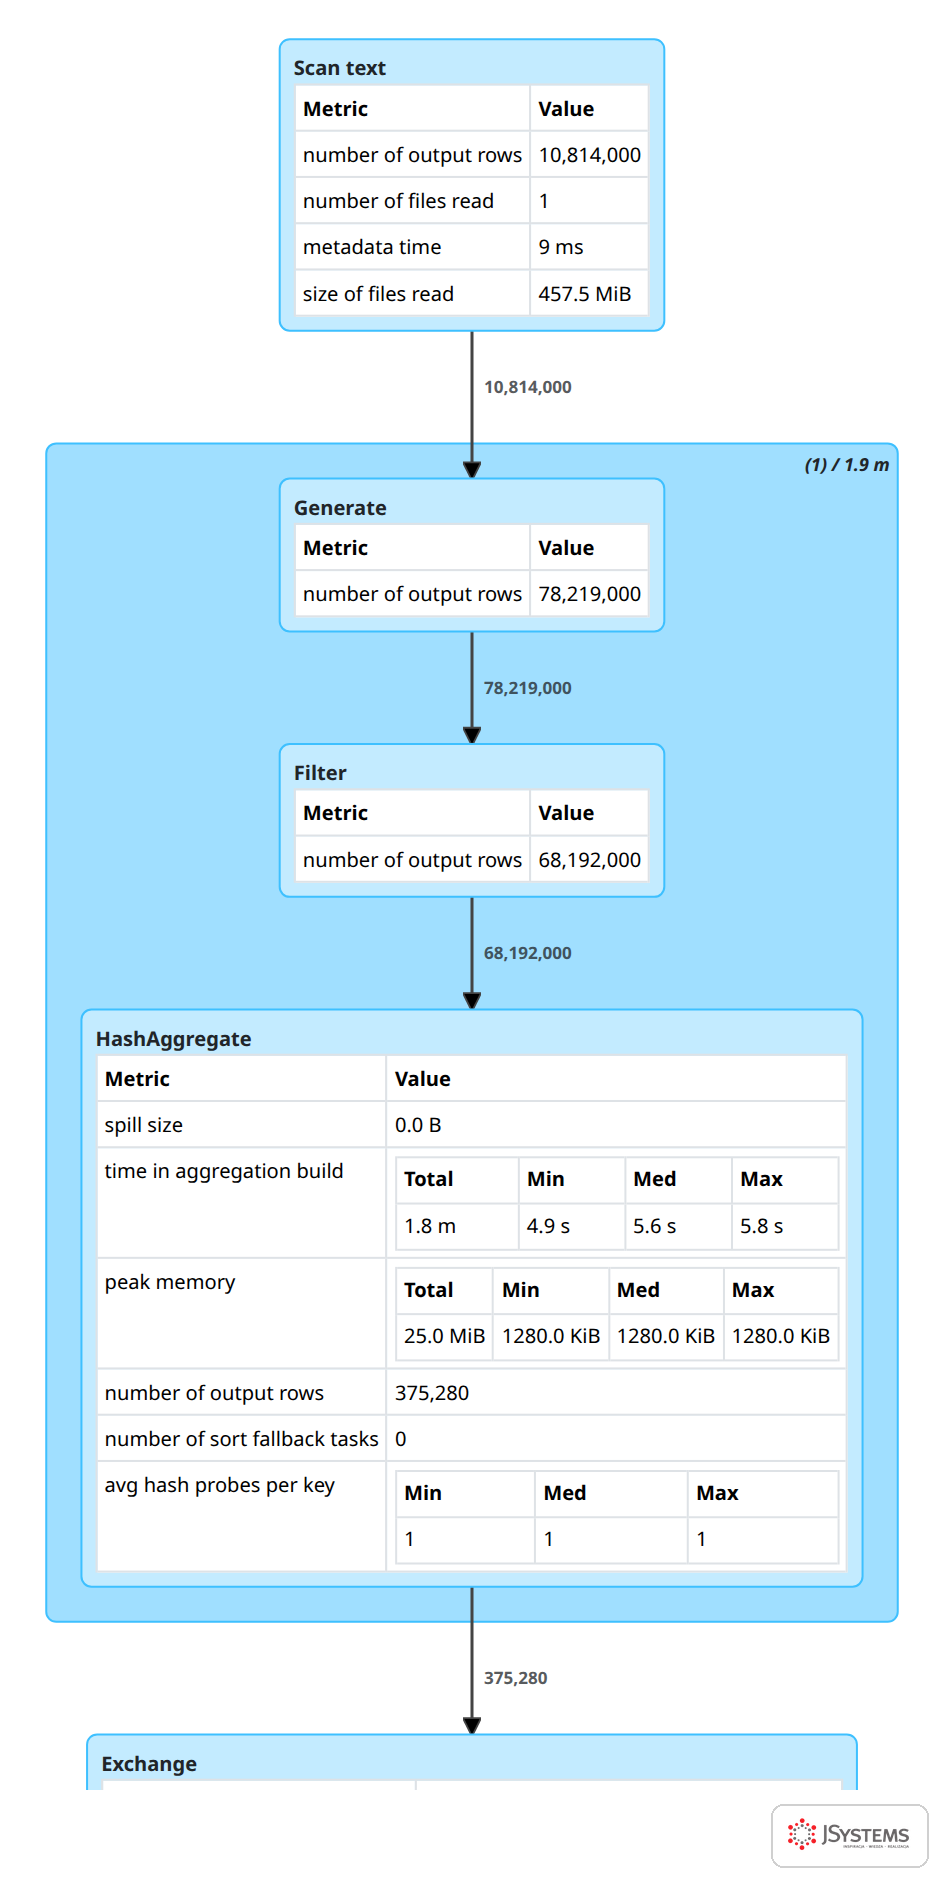
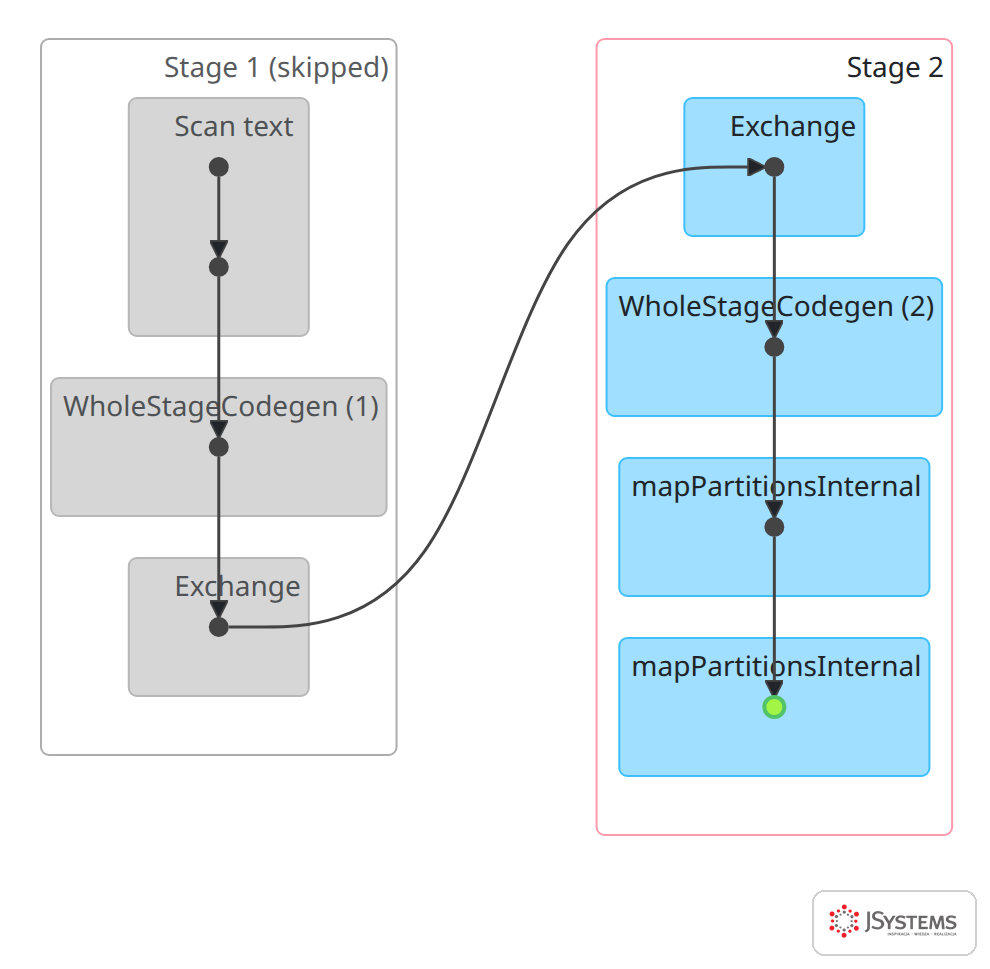
Zakładka SQL / DataFrame w Spark UI pokazuje, co Catalyst zrobił z naszym zapytaniem. Plan czyta się od góry. Scan text wczytuje 10 814 000 wierszy, Generate rozbija je na 78 219 000 elementów, a Filter odrzuca puste ciągi i zostawia 68 192 000 słów. Pierwszy HashAggregate liczy słowa w każdej partycji osobno, tak jak combiner w MapReduce, i do etapu Exchange, czyli shuffle, przekazuje już tylko 375 280 wierszy. Drugi HashAggregate sumuje je w 18 764 słowa wyniku. To ten sam schemat, który w Javie zaprogramowaliśmy ręcznie w klasach WordMapper, SumCombiner i SumReducer, tylko że tutaj Spark ułożył go sam z jednego zapytania SQL. W zakładce Jobs widać z kolei, że w miejscu operacji Exchange Spark dzieli zadanie na dwa etapy (stage): dane muszą zostać przesłane między węzłami, zanim zacznie się drugi etap.
Chcesz przećwiczyć PySparka i Spark SQL na danych projektowych, pod okiem praktyka? Szkolenie Przetwarzanie danych Big Data z Apache Spark --> prowadzi przez PySpark DataFrame, Spark SQL, pracę w Databricks i Unity Catalog. To szkolenie ma terminy gwarantowane.
W 2013 roku twórcy Sparka z Berkeley, wśród nich Ali Ghodsi, Ion Stoica, Matei Zaharia i Reynold Xin, założyli firmę Databricks. Pomysł był prosty: zamiast instalować Sparka na własnym klastrze, klient otwiera w przeglądarce notatnik, czyli dokument, w którym kod przeplata się z wynikami, a klaster w chmurze uruchamia się i wyłącza sam. Pierwszą wersję platformy, Databricks Cloud, firma pokazała w czerwcu 2014 roku, a rok później udostępniła ją wszystkim klientom. W 2018 roku ruszyła usługa Azure Databricks, prowadzona razem z Microsoftem.
Dziś Databricks działa w trzech chmurach: AWS, Microsoft Azure i Google Cloud. Z czasem firma dołożyła do Sparka kolejne warstwy: MLflow do śledzenia eksperymentów uczenia maszynowego, Delta Lake do tabel z transakcjami na plikach w jeziorze danych i Unity Catalog do uprawnień i opisu danych. Od 2025 roku platformę można poznać bezpłatnie w wersji Databricks Free Edition, w której klaster obliczeniowy uruchamia się bez żadnej konfiguracji.
Co chcemy osiągnąć. Uruchomimy nasze liczenie słów w Databricks Free Edition i zapiszemy wynik jako tabelę w katalogu Unity Catalog. Zobaczymy, co z pracy z klastrem przejęła platforma: tu nie instalujemy Sparka i nie zakładamy klastra, tylko wgrywamy plik i uruchamiamy komórki notatnika wordcount_databricks.ipynb.
Pierwsza komórka zakłada schemat workspace.historia_big_data i wolumen pliki, czyli miejsce na zwykłe pliki zarządzane przez katalog. Plik pan_tadeusz.txt wgrywamy do wolumenu w eksploratorze katalogu przyciskiem Upload to this volume. Druga komórka to znany już kod PySparka, który czyta plik ze ścieżki /Volumes/workspace/historia_big_data/pliki/ i zapisuje wynik jako tabelę word_counts.
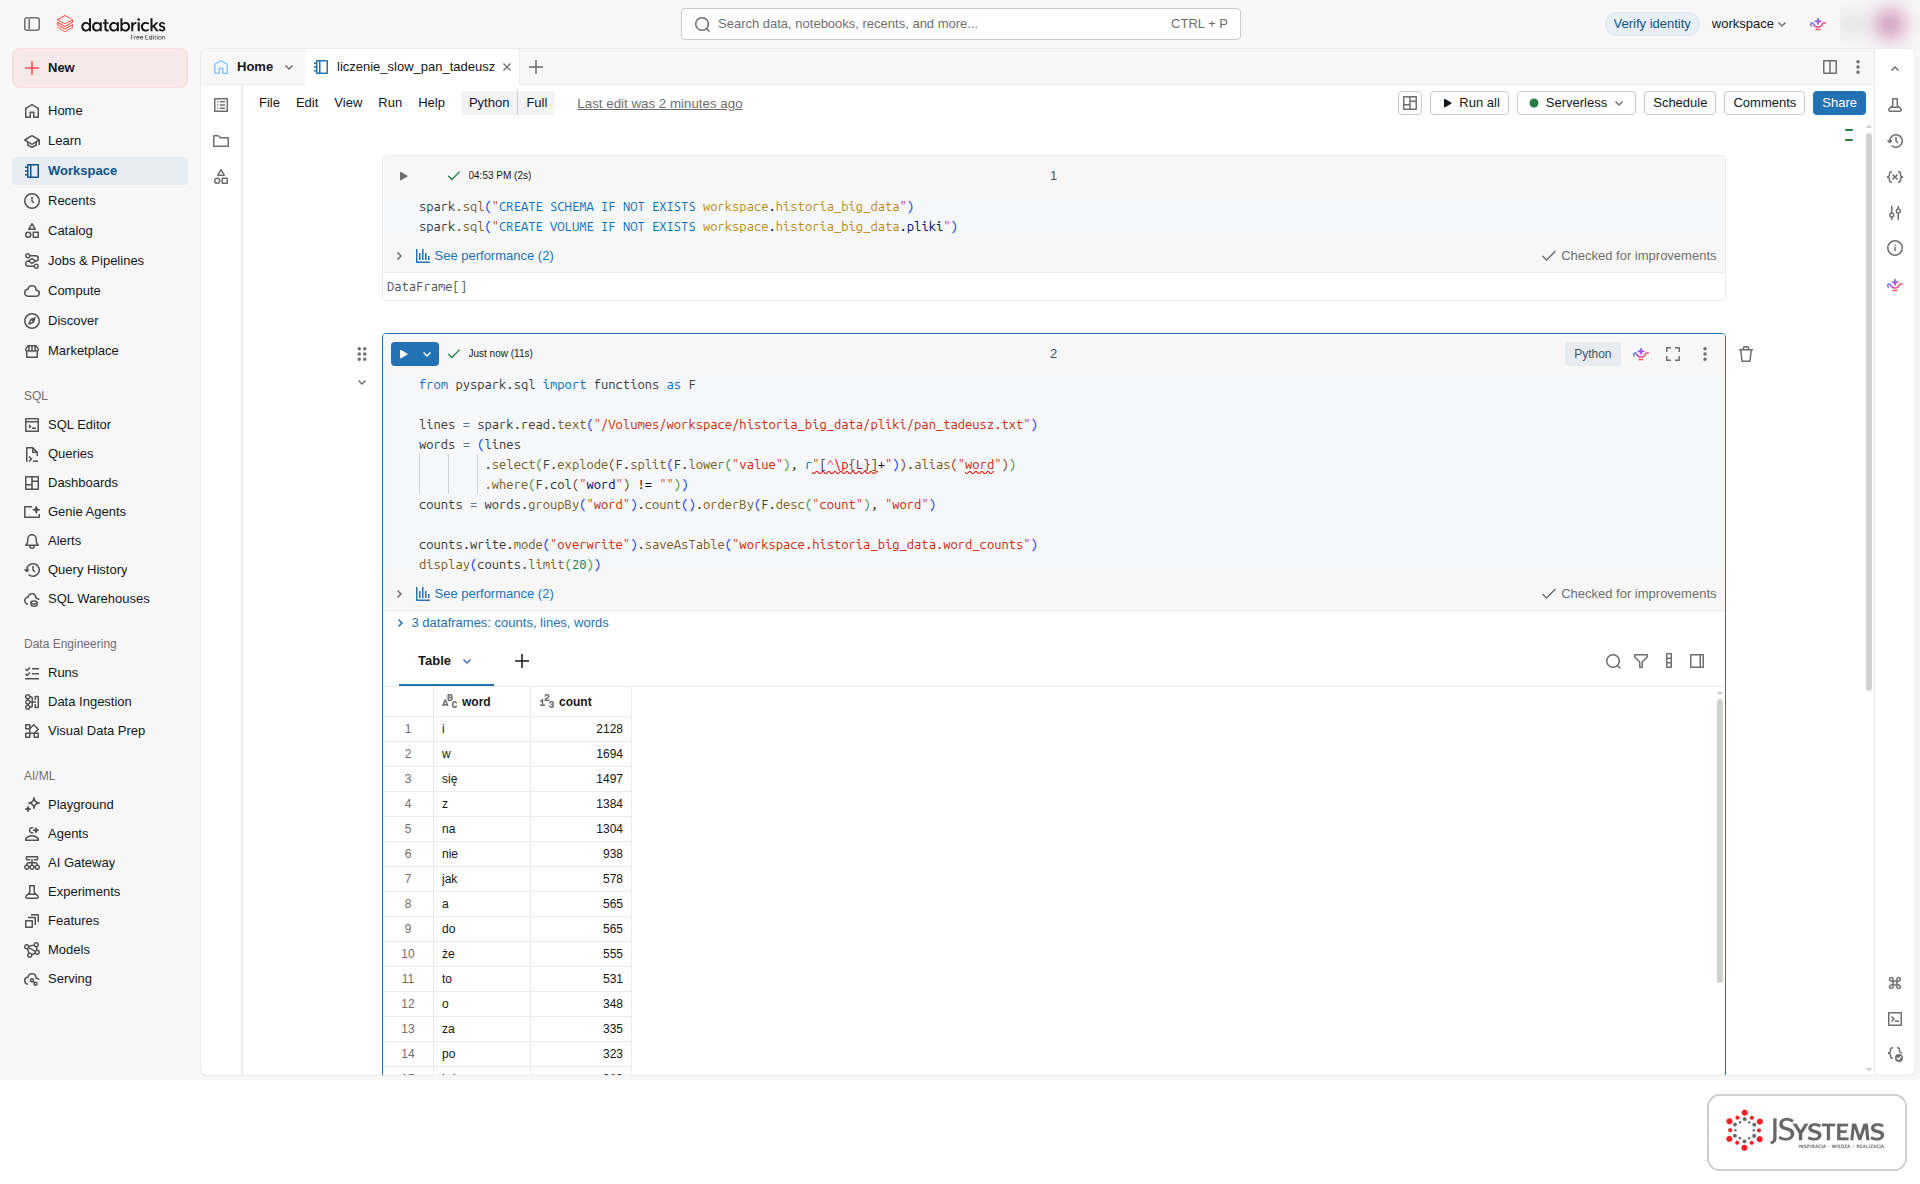
Obliczenia uruchamiają się w trybie serverless, czyli bez wybierania i konfigurowania klastra, a druga komórka liczyła się 11 sekund. Wynik jest taki sam jak w Hadoopie i w Sparku: na pierwszym miejscu „i” z 2128 wystąpieniami. To dobrze pokazuje, ile pracy przez dwadzieścia lat przeszło z ludzi na platformy: zostało to, co dotyczy samych danych.
Czym jest Databricks dziś, z czego się składa i jak zacząć z nim pracę, opisujemy w przewodniku Czym jest Databricks? Kompletny przewodnik po platformie lakehouse. Porównanie z platformą Microsoftu znajdziesz w artykule Microsoft Fabric vs Databricks: porównanie na tych samych danych.
Równolegle z rozwojem Sparka zmieniało się miejsce, w którym liczono dane. W kwietniu 2009 roku Amazon uruchomił, na początek w wersji beta, usługę Elastic MapReduce, czyli klaster Hadoopa wynajmowany na godziny. Google poszedł inną drogą: od 2012 roku każdy mógł korzystać z BigQuery, usługi opartej na wewnętrznym silniku Dremel, opisanym w publikacji z 2010 roku. W BigQuery nie ma klastra do zarządzania, jest tylko zapytanie SQL i opłata za przeczytane dane. Amazon pod koniec 2012 roku zapowiedział hurtownię Redshift, a od 2015 roku dostępny był Snowflake, hurtownia, w której przechowywanie danych i obliczenia skalują się niezależnie.
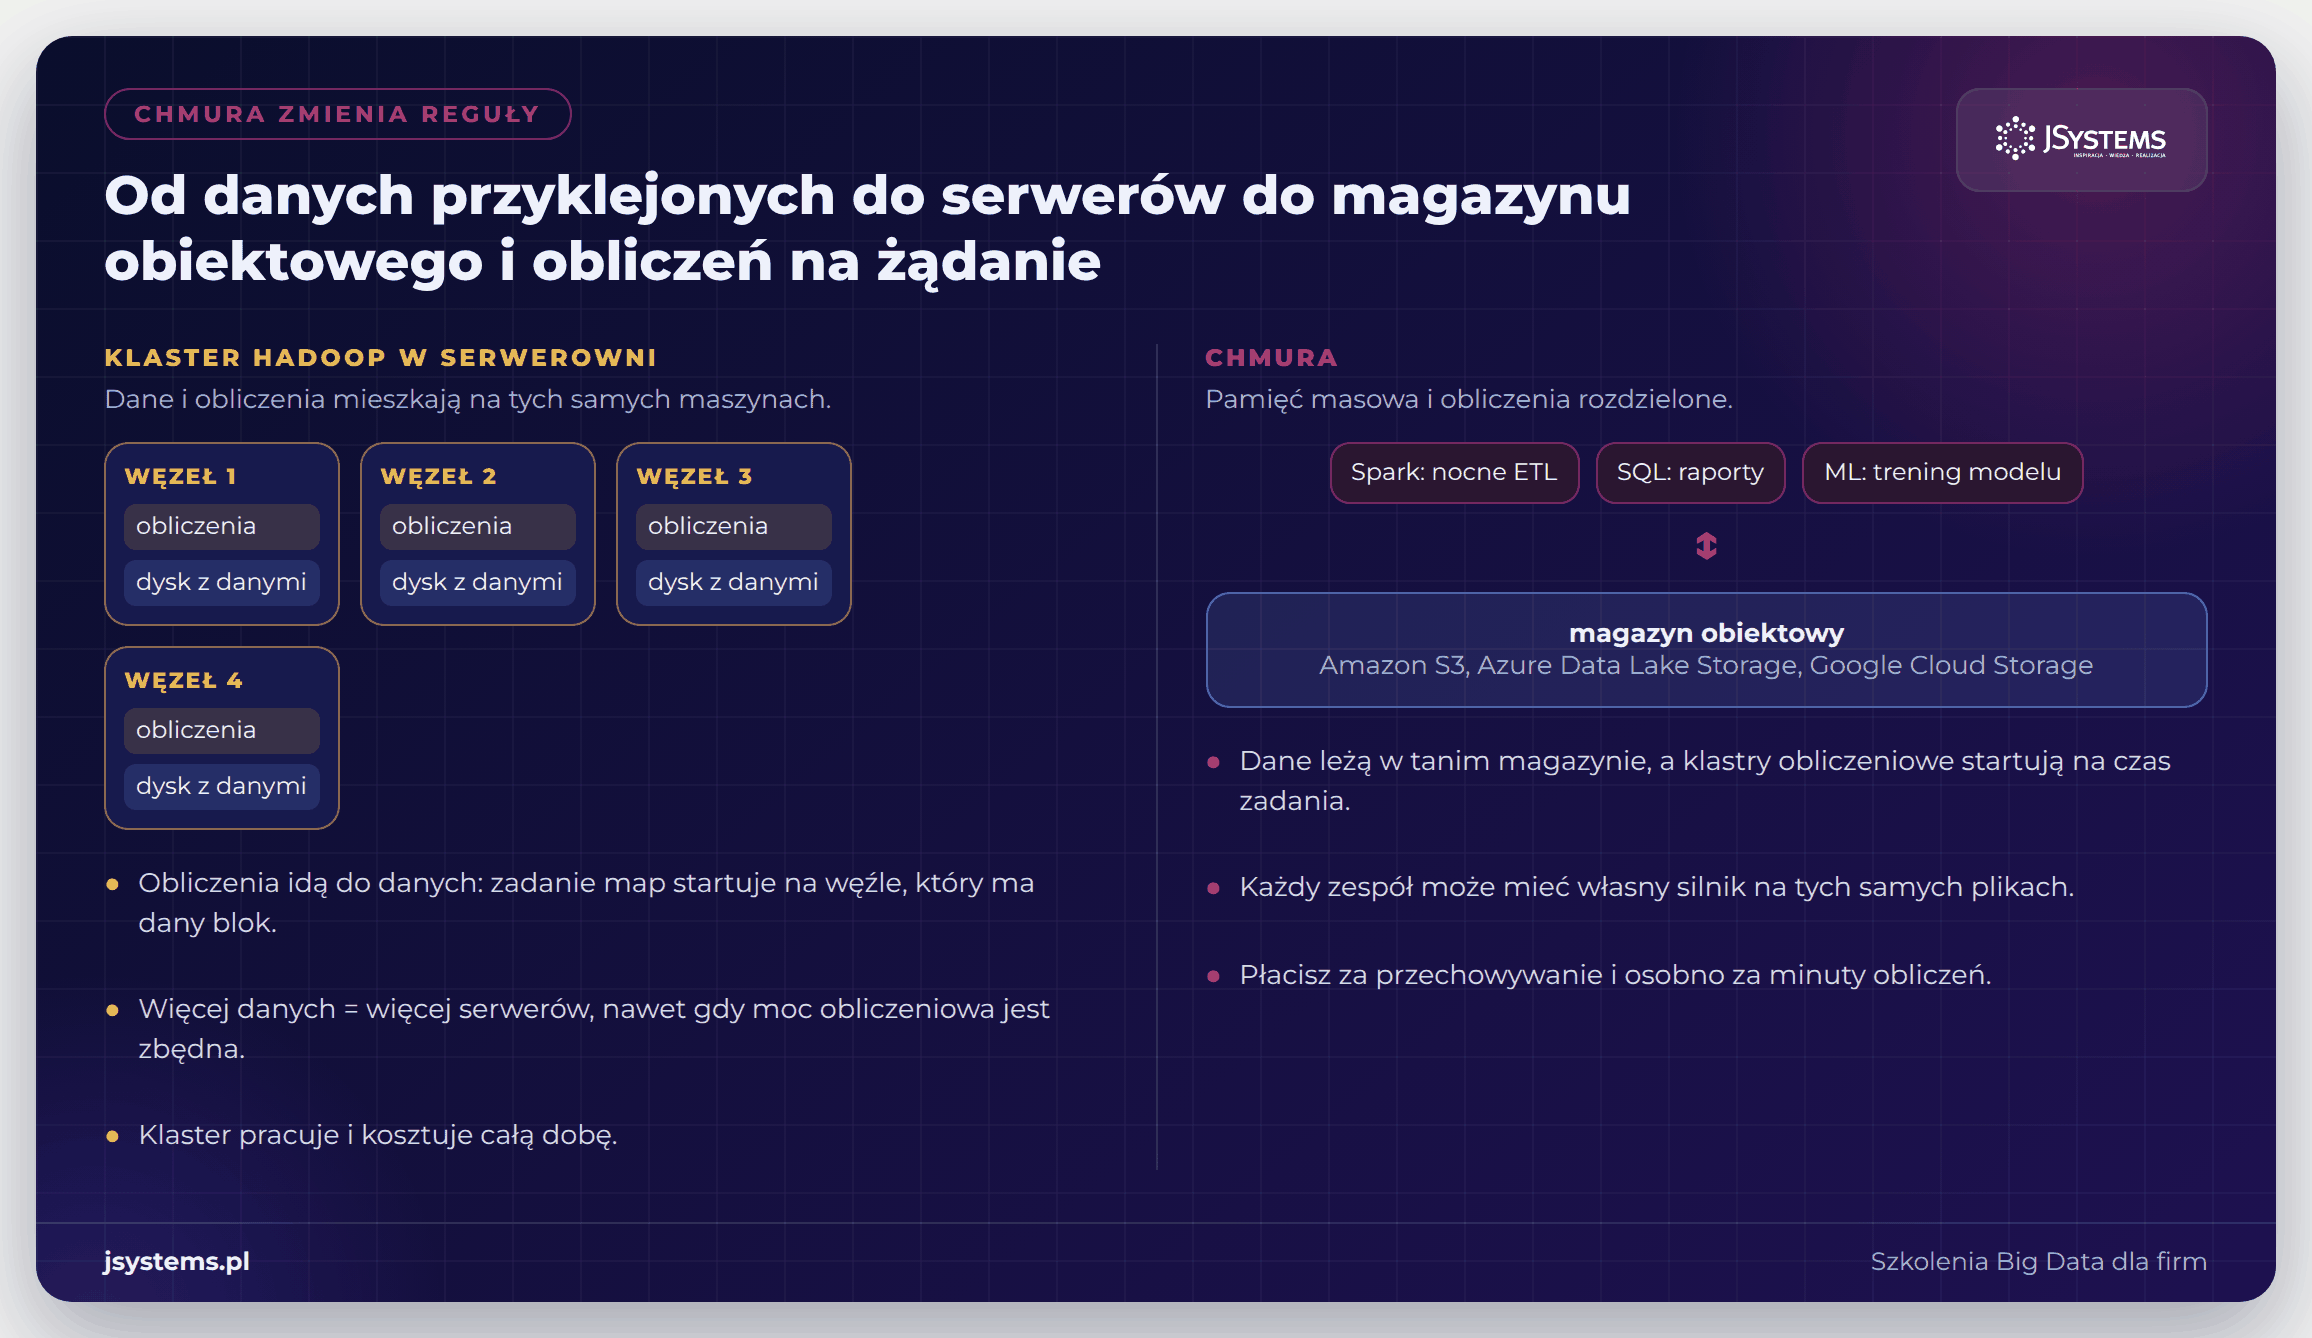
Ten podział okazał się trwalszy niż sam Hadoop. Dane lądują w tanim magazynie obiektowym (Amazon S3, Azure Data Lake Storage, Google Cloud Storage), a silników, które je czytają, może być kilka naraz. Dlatego współczesne platformy mają zwykle Sparka, SQL i narzędzia do uczenia maszynowego nad tymi samymi plikami. Hurtowniom w chmurze poświęciliśmy osobne artykuły: Co to jest BigQuery? Kompletny przewodnik dla początkujących, Co to jest Snowflake? Prosty przewodnik po chmurowej hurtowni danych i ich porównanie BigQuery vs Snowflake - czym się różnią i co wybrać?
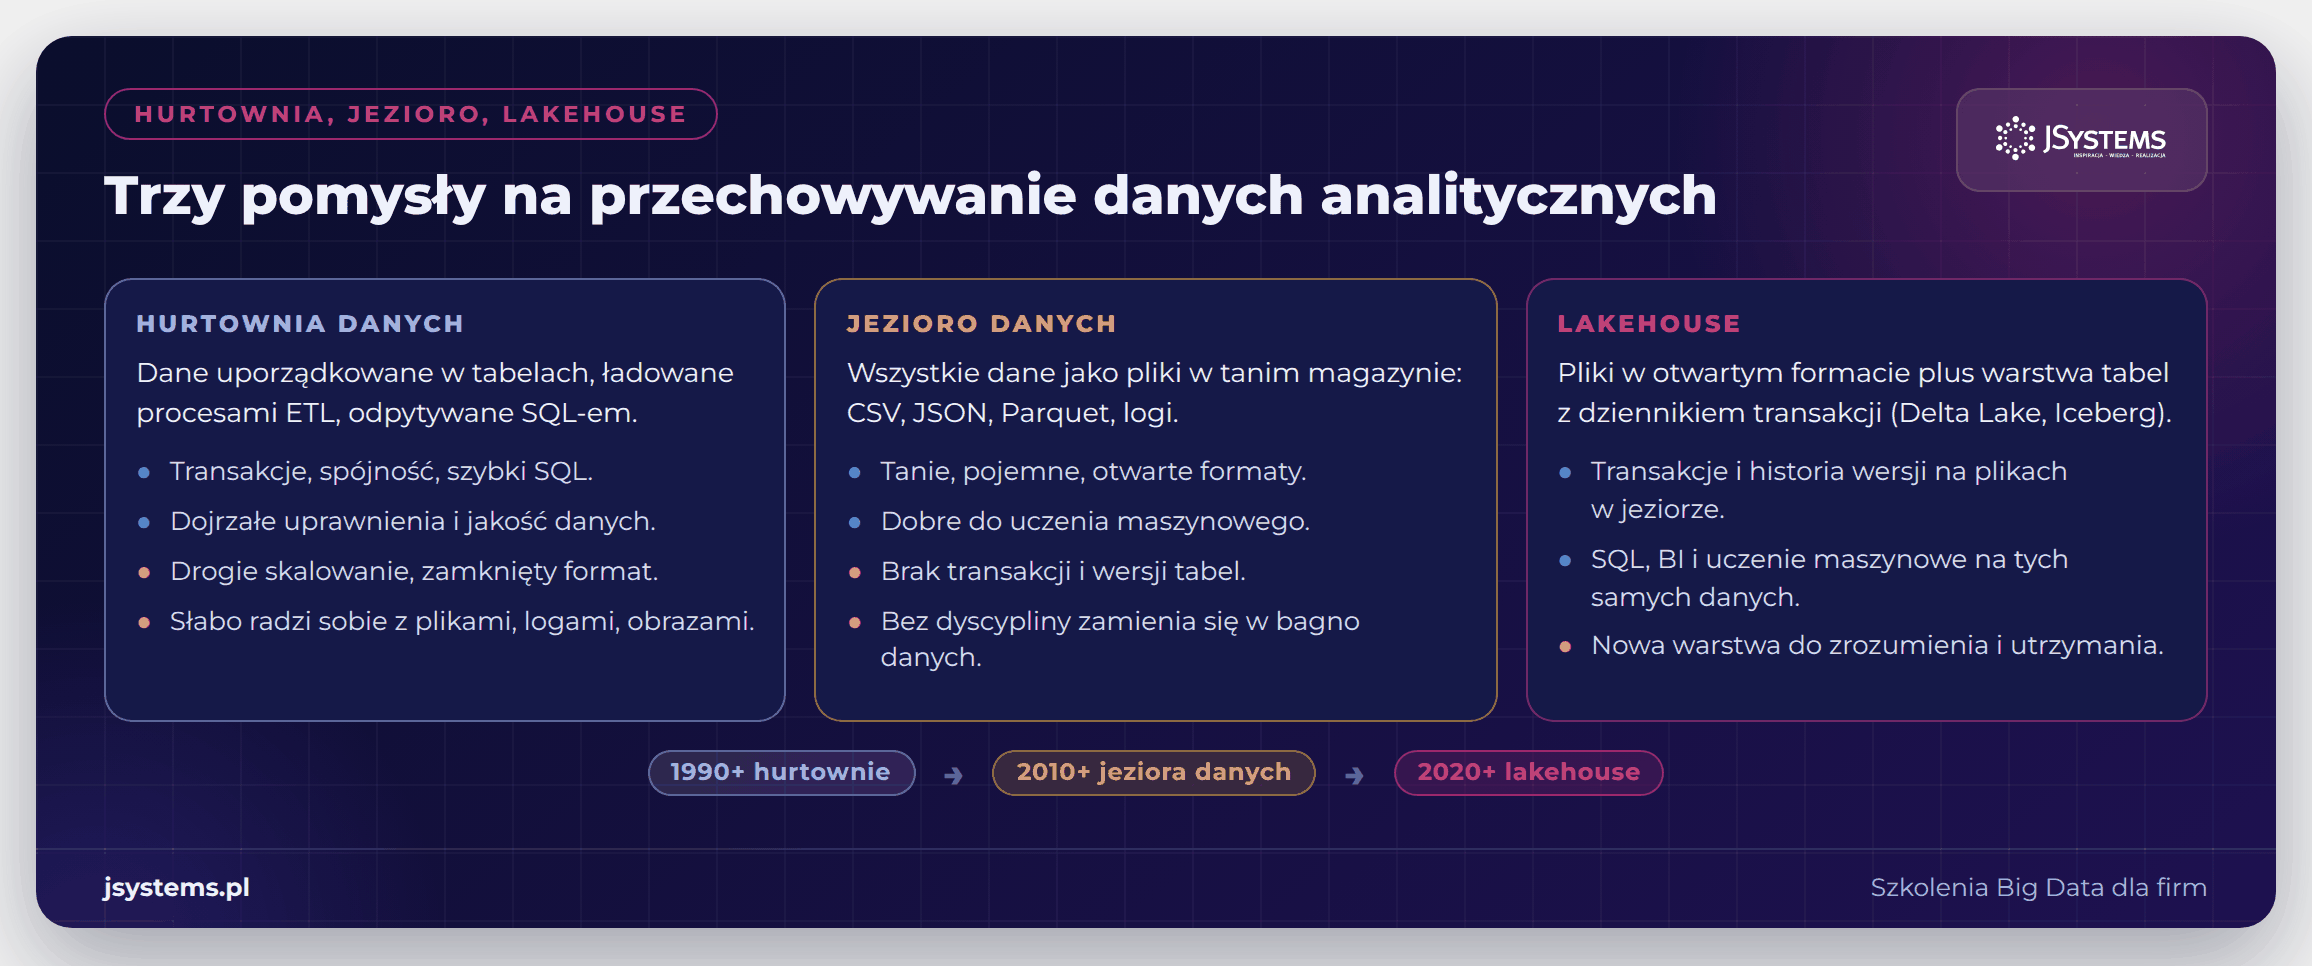
Gdy przechowywanie stało się tanie, firmy zaczęły zrzucać do HDFS, a potem do magazynów obiektowych w chmurze, wszystko jak leci: eksporty z baz, logi, pliki CSV i JSON. Taki zbiór nazwano jeziorem danych (data lake), a pojęcie wprowadził w 2010 roku James Dixon z firmy Pentaho. Bez dyscypliny jezioro szybko zamieniało się w bagno danych: nikt nie wiedział, które pliki są aktualne, zadanie przerwane w połowie zostawiało niepełne dane, a dwie osoby zapisujące tę samą tabelę potrafiły nawzajem zniszczyć sobie wyniki.
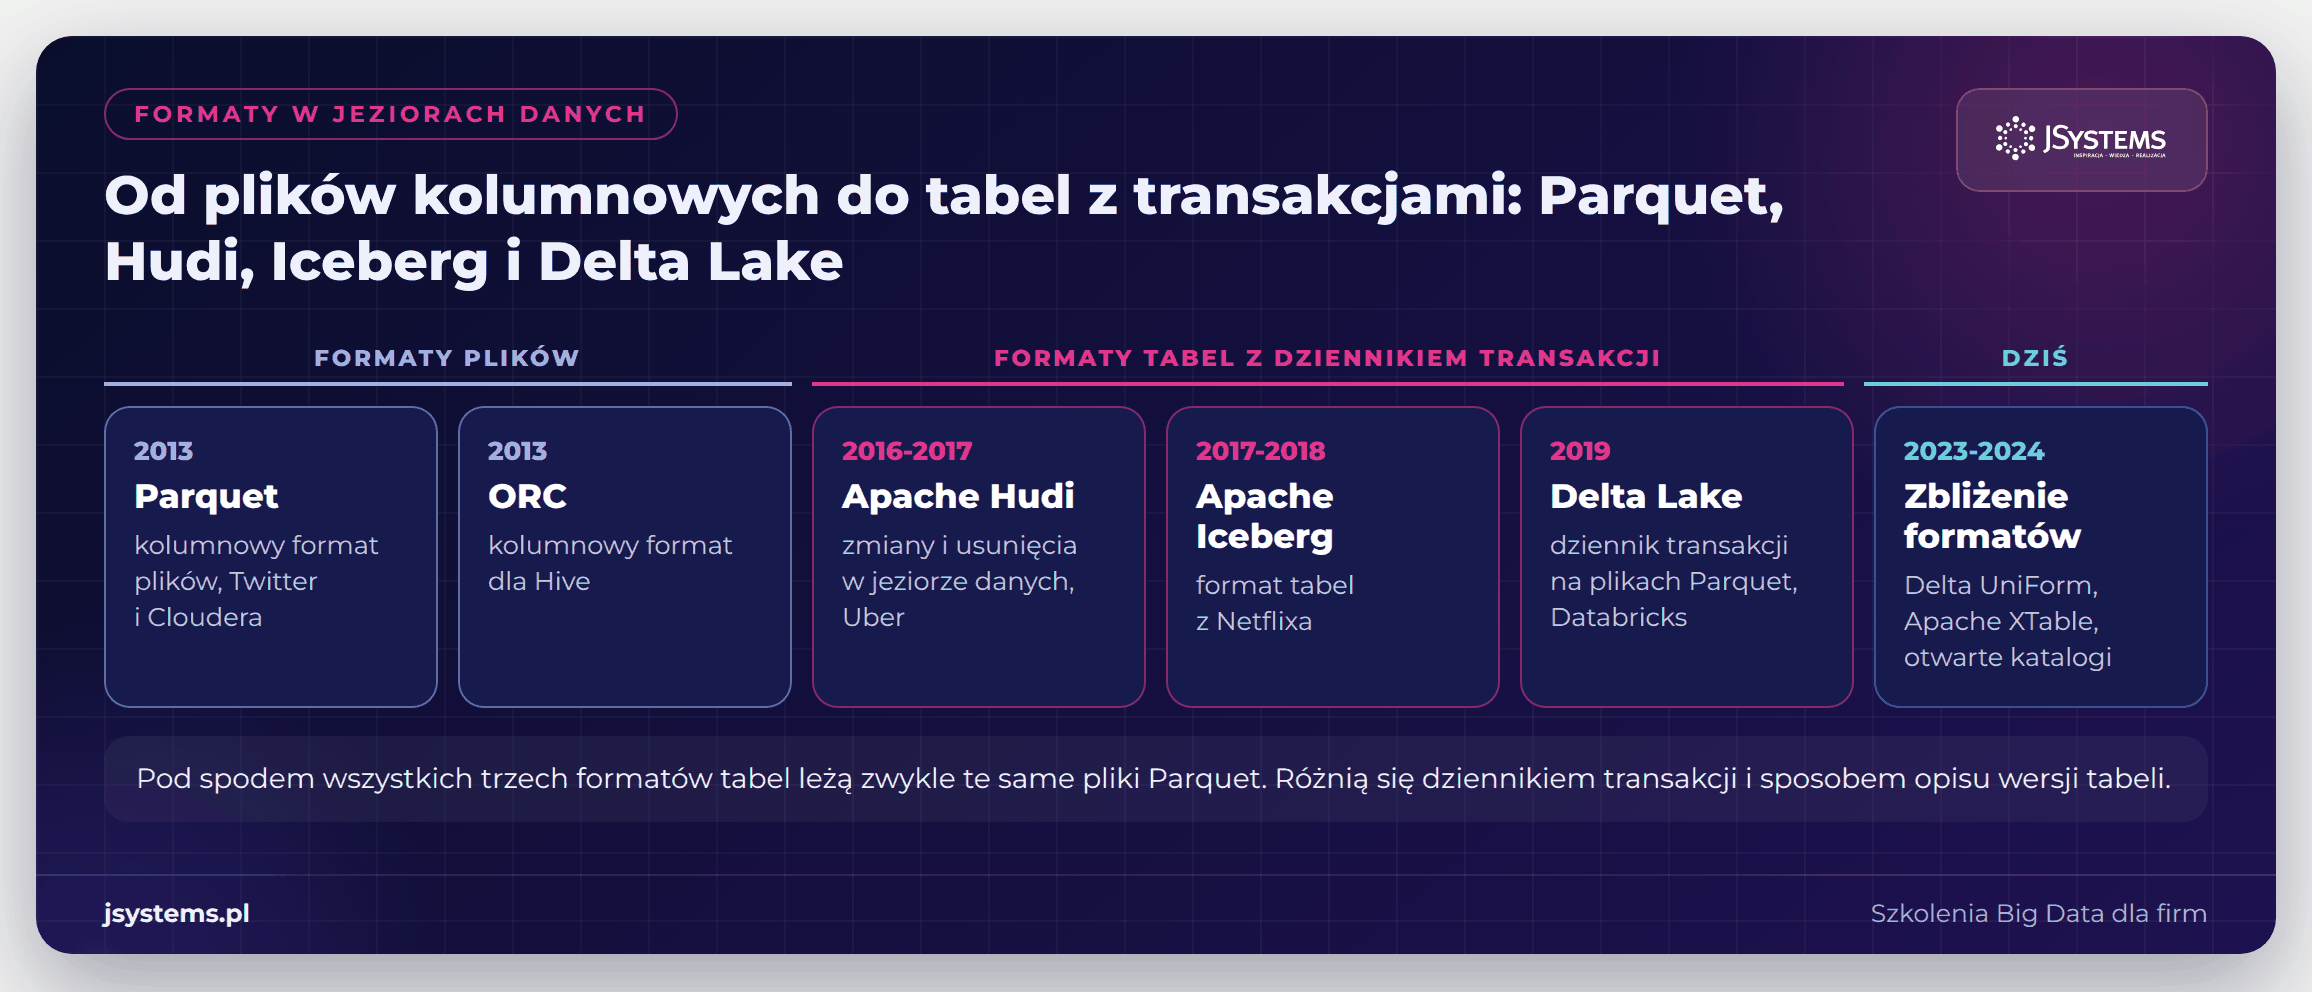
Pierwszym krokiem do porządku były formaty kolumnowe. Parquet (2013, Twitter i Cloudera) i ORC (2013, powstał w projekcie Hive) zapisują dane kolumna po kolumnie, z kompresją i statystykami, więc zapytanie o dwie kolumny z pięćdziesięciu czyta tylko ułamek pliku. Drugim krokiem były formaty tabel, które dokładają do zwykłych plików Parquet dziennik transakcji, czyli zapis kolejnych zmian tabeli. Dzięki niemu zapis jest atomowy, czyli udaje się w całości albo wcale, czytelnik widzi spójny stan tabeli, a starsze wersje zostają dostępne. Uber zbudował Hudi, Netflix Iceberga, a Databricks w 2019 roku udostępnił Delta Lake.
Co chcemy osiągnąć. Zapiszemy wynik liczenia słów jako tabelę Delta, a potem zmienimy ją tak, jak w praktyce zmienia się tabele: usuniemy część wierszy i poprawimy inne. Na końcu zobaczymy historię wersji tabeli, przeczytamy jej pierwotny stan i zajrzymy do dziennika transakcji, który Delta trzyma obok plików Parquet. Kod jest w pliku delta_demo.py.
delta_demo.py: tabela Delta, zmiany i historia wersji
#!/usr/bin/env python3
"""Delta Lake na HDFS: wynik zliczania słów jako tabela z historią wersji.

Kroki: zapis tabeli (wersja 0), DELETE (wersja 1), UPDATE (wersja 2), DESCRIBE HISTORY,
podróż w czasie (VERSION AS OF 0) i porównanie z bieżącą wersją.

Użycie:  python delta_demo.py
Wymaga pakietu delta-spark (pip install delta-spark). Skrypt uruchamiamy zwykłym `python`, a nie
`spark-submit`, bo `configure_spark_with_delta_pip` dopisuje do konfiguracji pakiet Delta, który
Spark pobiera z Maven Central przy pierwszym uruchomieniu (JVM startuje już z tym pakietem).
"""
from delta import configure_spark_with_delta_pip
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

BASE_PATH = 'hdfs://127.0.0.1:9000/user/hadoop'
INPUT_PATH = BASE_PATH + '/pan_tadeusz/small'
TABLE_PATH = BASE_PATH + '/delta/pan_tadeusz_words'
T = 'delta.`%s`' % TABLE_PATH      # tabela Delta wskazana ścieżką, bez rejestrowania w katalogu


def section(title):
    print('\n' + '=' * 78 + '\n' + title + '\n' + '=' * 78)


builder = (SparkSession.builder.appName('Delta Lake Pan Tadeusz')
           .config('spark.sql.extensions', 'io.delta.sql.DeltaSparkSessionExtension')
           .config('spark.sql.catalog.spark_catalog', 'org.apache.spark.sql.delta.catalog.DeltaCatalog'))
spark = configure_spark_with_delta_pip(builder).getOrCreate()
spark.sparkContext.setLogLevel('WARN')

# --- wersja 0: wynik liczenia zapisany jako tabela Delta
section('1. Zapis wyniku liczenia jako tabeli Delta (wersja 0)')
counts = (spark.read.text(INPUT_PATH)
          .select(F.explode(F.split(F.lower('value'), r'[^\p{L}]+')).alias('word'))
          .where("word <> ''")
          .groupBy('word').count().withColumnRenamed('count', 'cnt'))
counts.write.format('delta').mode('overwrite').save(TABLE_PATH)
spark.sql('SELECT COUNT(*) AS words, SUM(cnt) AS occurrences FROM %s' % T).show()
spark.sql('SELECT * FROM %s ORDER BY cnt DESC, word LIMIT 5' % T).show()

# --- wersja 1: DELETE
section('2. DELETE: usuwamy słowa jednoliterowe (wersja 1)')
spark.sql('SELECT word, cnt FROM %s WHERE length(word) = 1 ORDER BY cnt DESC' % T).show(5)
spark.sql('DELETE FROM %s WHERE length(word) = 1' % T).show()
spark.sql('SELECT COUNT(*) AS words, SUM(cnt) AS occurrences FROM %s' % T).show()

# --- wersja 2: UPDATE
section('3. UPDATE: dopisujemy wystąpienia z tytułu utworu, który wycięliśmy z pliku (wersja 2)')
spark.sql("SELECT word, cnt FROM %s WHERE word IN ('pan', 'tadeusz') ORDER BY word" % T).show()
spark.sql("UPDATE %s SET cnt = cnt + 1 WHERE word IN ('pan', 'tadeusz')" % T).show()
spark.sql("SELECT word, cnt FROM %s WHERE word IN ('pan', 'tadeusz') ORDER BY word" % T).show()

# --- historia
section('4. DESCRIBE HISTORY: kto, kiedy i co zmienił')
history = spark.sql('DESCRIBE HISTORY %s' % T)
history.select('version', 'timestamp', 'userName', 'operation', 'operationParameters').show(truncate=70)
history.select('version', 'operation',
               F.col('operationMetrics')['numAddedFiles'].alias('added_files'),
               F.col('operationMetrics')['numRemovedFiles'].alias('removed_files'),
               F.col('operationMetrics')['numDeletedRows'].alias('deleted_rows'),
               F.col('operationMetrics')['numUpdatedRows'].alias('updated_rows')).show()

# --- podróż w czasie
section('5. Podróż w czasie: VERSION AS OF 0 kontra bieżąca wersja')
spark.sql('SELECT COUNT(*) AS words_v0 FROM %s VERSION AS OF 0' % T).show()
spark.sql('SELECT COUNT(*) AS words_current FROM %s' % T).show()
print('Słowa, które były w wersji 0, a w bieżącej ich nie ma (10 najczęstszych):')
spark.sql('''SELECT word, cnt FROM %s VERSION AS OF 0
             WHERE word NOT IN (SELECT word FROM %s)
             ORDER BY cnt DESC, word LIMIT 10''' % (T, T)).show()
print("Słowa 'pan' i 'tadeusz' w obu wersjach:")
spark.sql('''SELECT v0.word, v0.cnt AS version_0, now.cnt AS current
             FROM %s VERSION AS OF 0 v0 JOIN %s now ON v0.word = now.word
             WHERE v0.word IN ('pan', 'tadeusz') ORDER BY v0.word''' % (T, T)).show()

spark.stop()
Skrypt uruchamiamy zwykłym poleceniem python delta_demo.py, a nie spark-submit: pakiet delta-spark sam dopisuje do konfiguracji Sparka bibliotekę Delta Lake, którą Spark pobiera z repozytorium Maven Central przy pierwszym uruchomieniu.
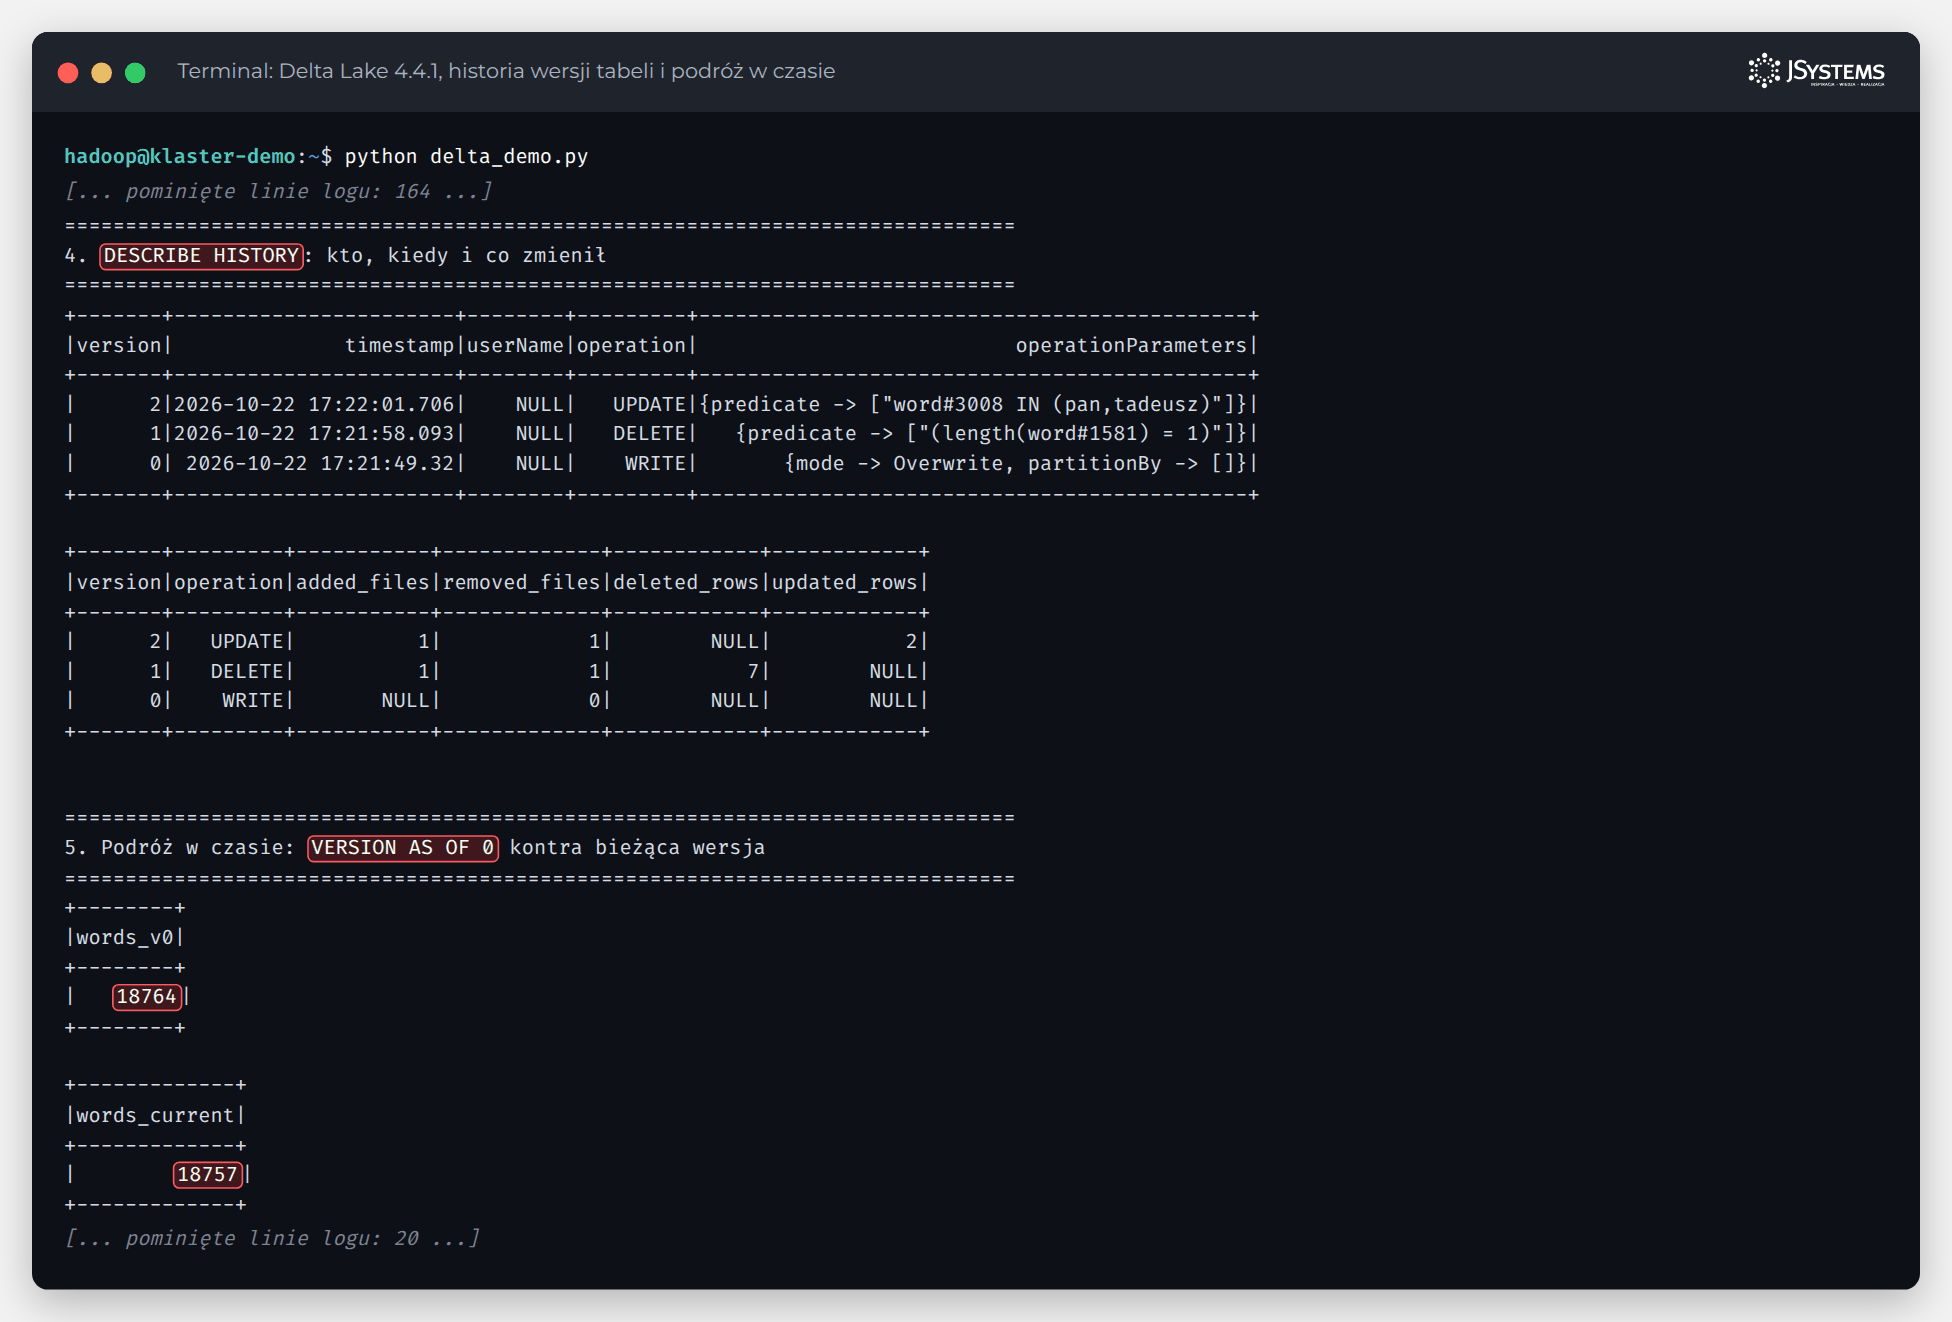
Każda operacja na tabeli dała nową wersję. Wersja 0 to zapisany wynik liczenia: 18 764 różne słowa i 68 192 wystąpienia. W wersji 1 polecenie DELETE usunęło 7 słów jednoliterowych, takich jak „i”, „w” i „z”, więc w tabeli zostało 18 757 słów. W wersji 2 polecenie UPDATE dodało po jednym wystąpieniu słowom „pan” i „tadeusz”, bo tytuł utworu wycięliśmy z pliku razem z nagłówkiem Wolnych Lektur. DESCRIBE HISTORY pokazuje wszystkie trzy wersje z czasem i rodzajem operacji, a druga tabela pod nim podaje, ile wierszy każda operacja usunęła albo zmieniła.
Zapytanie z dopiskiem VERSION AS OF 0 czyta tabelę tak, jak wyglądała przed zmianami, i zwraca 18 764 słowa, choć bieżąca wersja ma ich 18 757. To tak zwana podróż w czasie (time travel). Pozwala odtworzyć wczorajszy raport na danych z wczoraj, sprawdzić, co zmieniło ostatnie zadanie, albo przywrócić tabelę do wersji sprzed błędnej zmiany poleceniem RESTORE. Na samym HDFS i w klasycznym Hive tabela nie miała historii wersji, więc do takich porównań trzeba było robić kopie albo migawki katalogów.
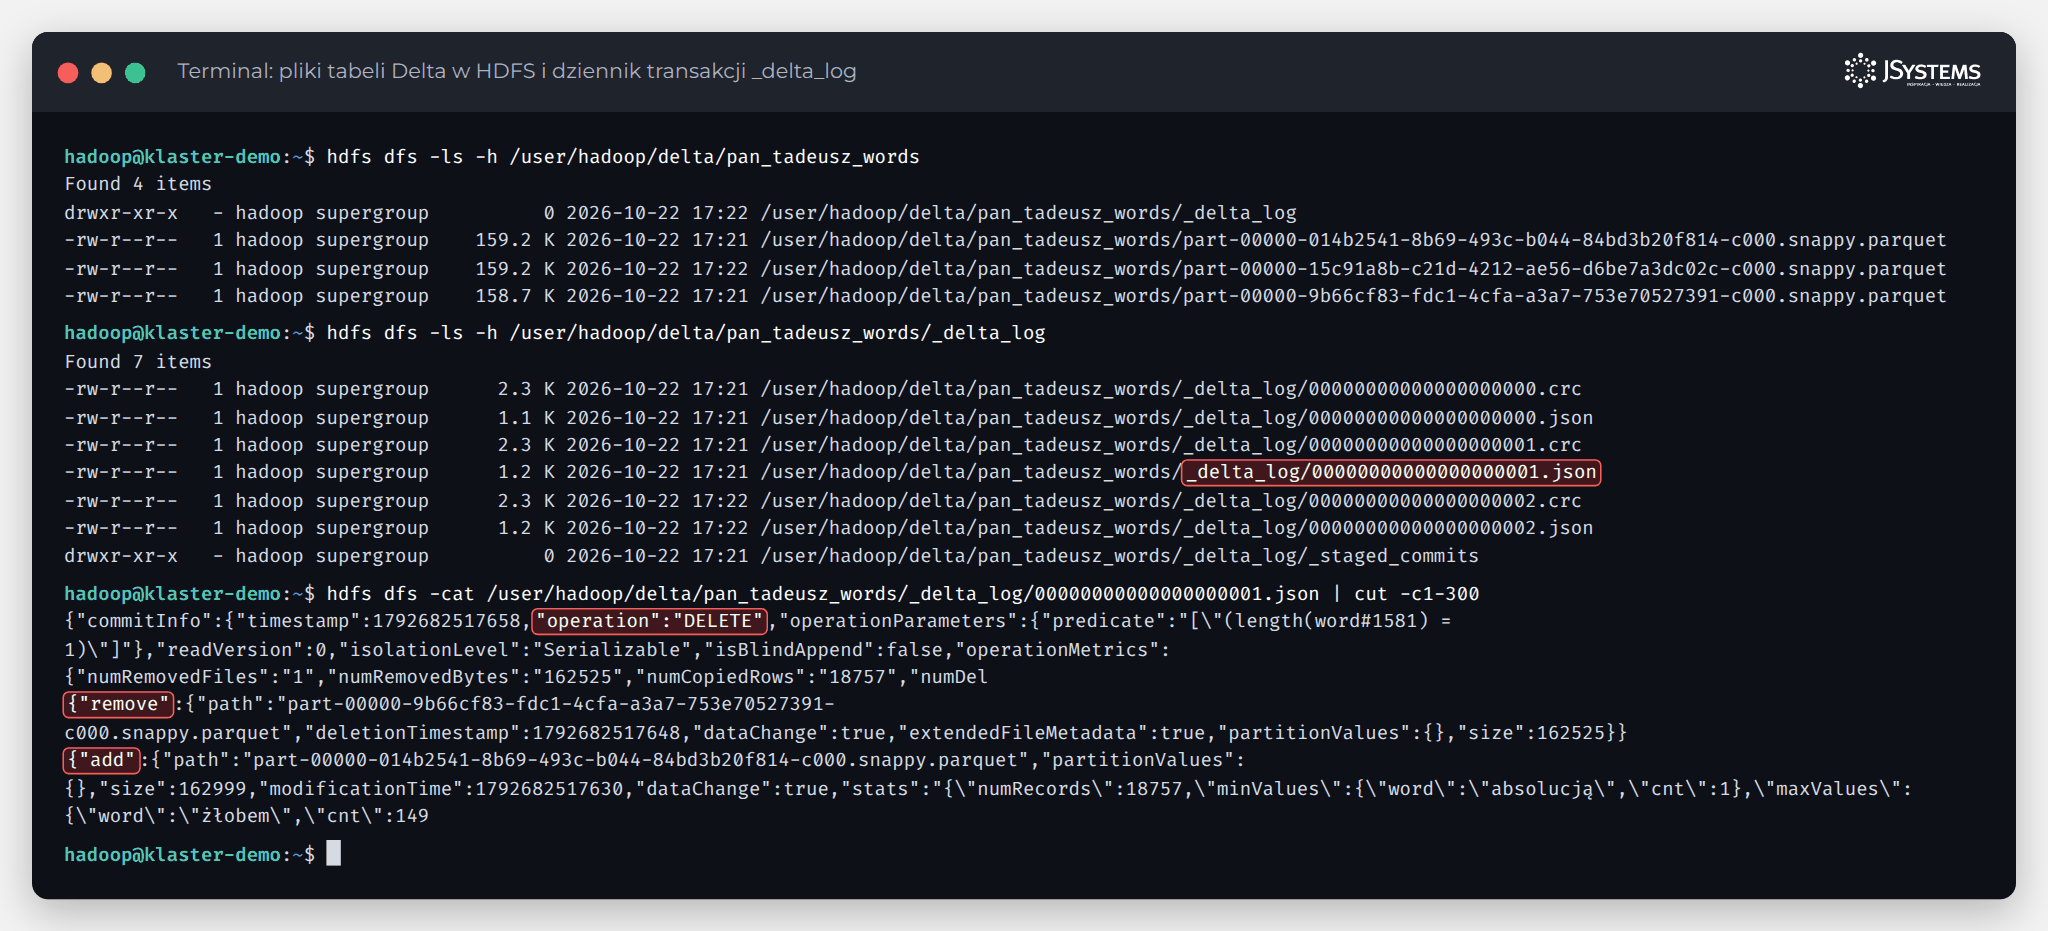
Na dysku tabela Delta to zwykły katalog. Leżą w nim pliki Parquet z danymi i podkatalog _delta_log z dziennikiem transakcji: dla każdej wersji jeden plik JSON z numerem wersji w nazwie, a obok niego plik .crc z sumą kontrolną i podsumowaniem stanu tabeli. Plik 00000000000000000001.json opisuje wersję 1, czyli nasze usunięcie. Pierwsza linia (commitInfo) zapisuje, kiedy i jaką operację wykonano oraz z jakim warunkiem. Dwie następne mówią, co się zmieniło w plikach: remove wycofuje z tabeli plik Parquet z wersji 0, a add dodaje nowy plik z 18 757 wierszami, razem ze statystykami najmniejszych i największych wartości w kolumnach.
Delta nigdy nie nadpisuje plików Parquet. W naszym przebiegu przy usunięciu i przy zmianie zapisała nowy plik ze wszystkimi pozostałymi wierszami, a stary tylko oznaczyła w dzienniku jako usunięty. Dlatego w katalogu tabeli leżą trzy pliki Parquet, po jednym na wersję, i dlatego podróż w czasie w ogóle jest możliwa. Stare pliki zostają na dysku, dopóki nie usunie ich polecenie VACUUM. Czytelnik tabeli najpierw czyta dziennik, a dopiero potem te pliki Parquet, które według dziennika należą do wybranej wersji. Na tym samym pomyśle, czyli dzienniku transakcji nad zwykłymi plikami w jeziorze danych, opierają się też Iceberg i Hudi.
Przez lata firmy utrzymywały dwa osobne światy. Jezioro danych służyło do uczenia maszynowego i surowych plików, a hurtownia, do której dane kopiowano procesami ETL, do raportów i SQL-a. Każda kopia to opóźnienie, koszt i ryzyko, że dwa raporty pokażą różne liczby. W styczniu 2020 roku Databricks opisał na swoim blogu architekturę nazwaną lakehouse, a rok później jej twórcy przedstawili ją w publikacji na konferencji CIDR. Pomysł: zostawić dane w otwartym formacie w jeziorze i dołożyć do nich to, co dotąd dawała tylko hurtownia, czyli transakcje, schematy, uprawnienia i szybki SQL.
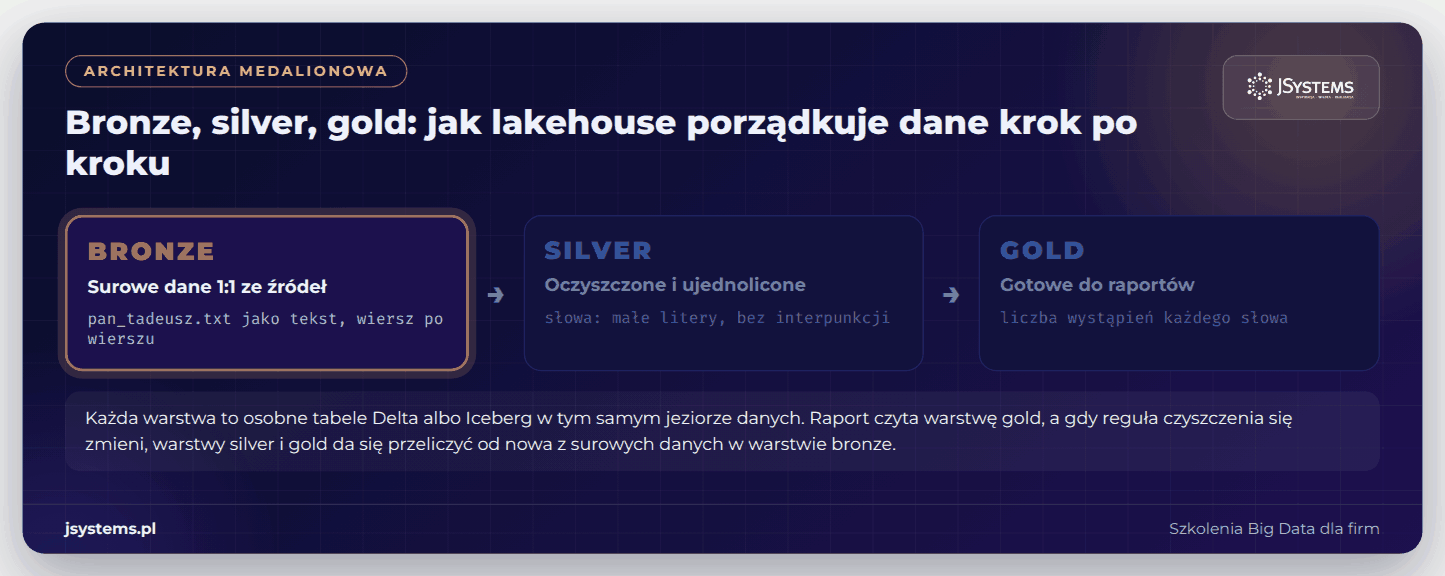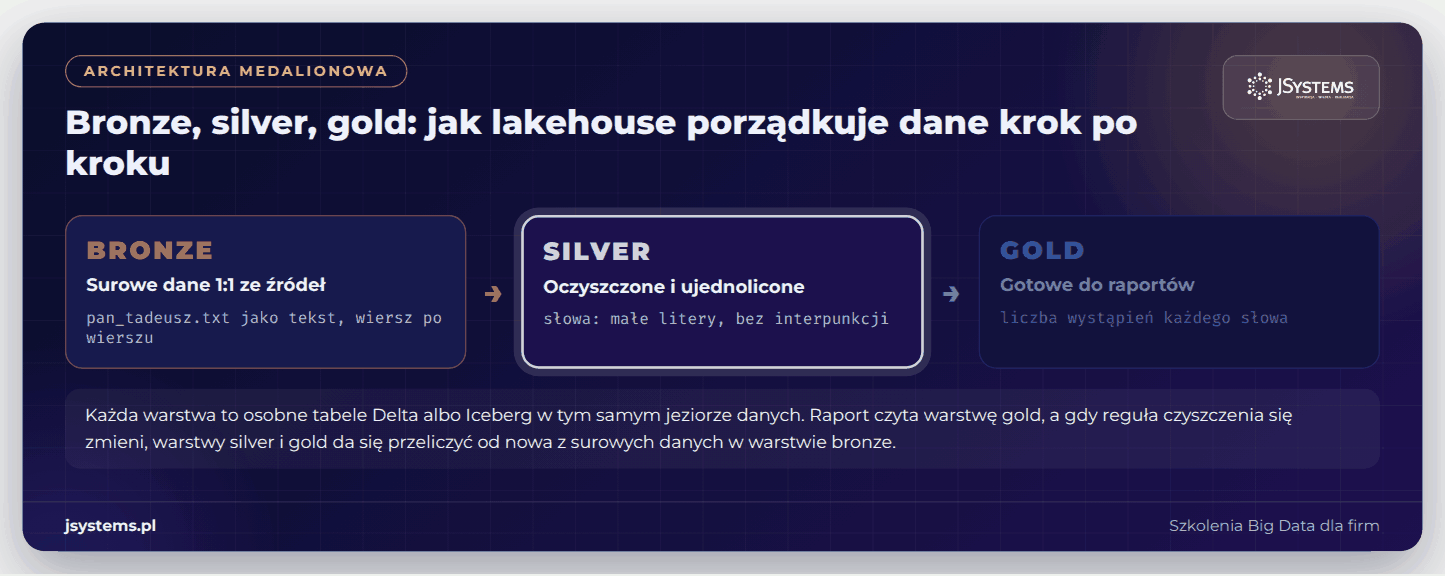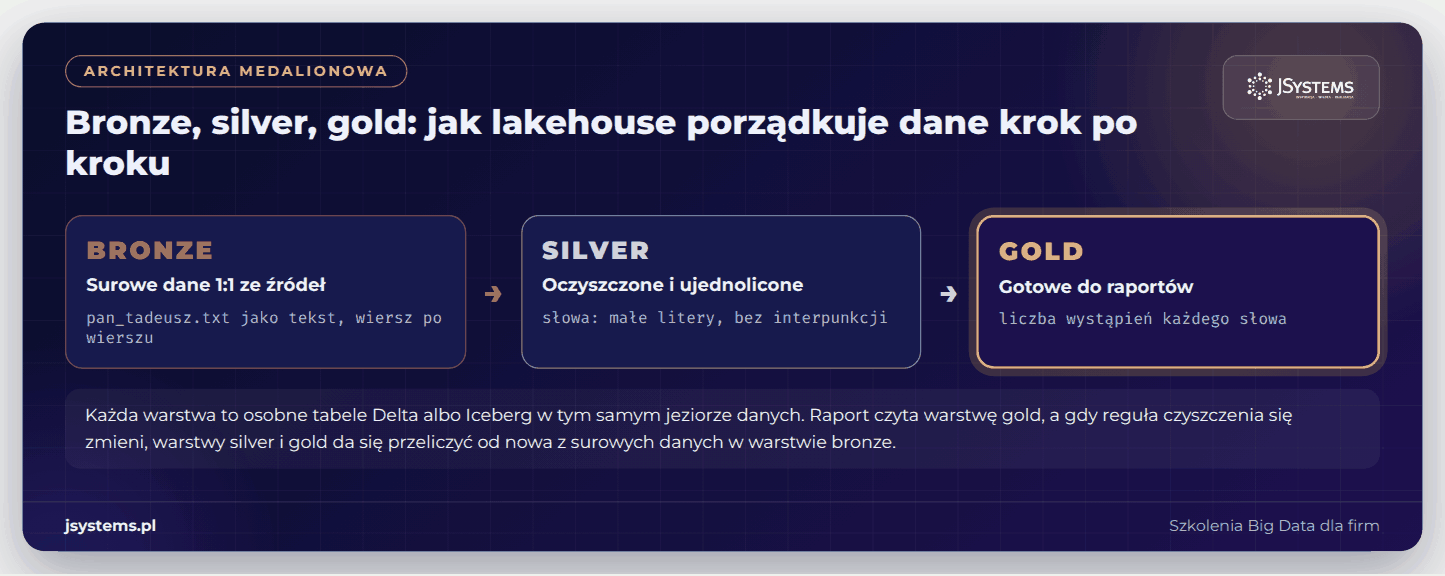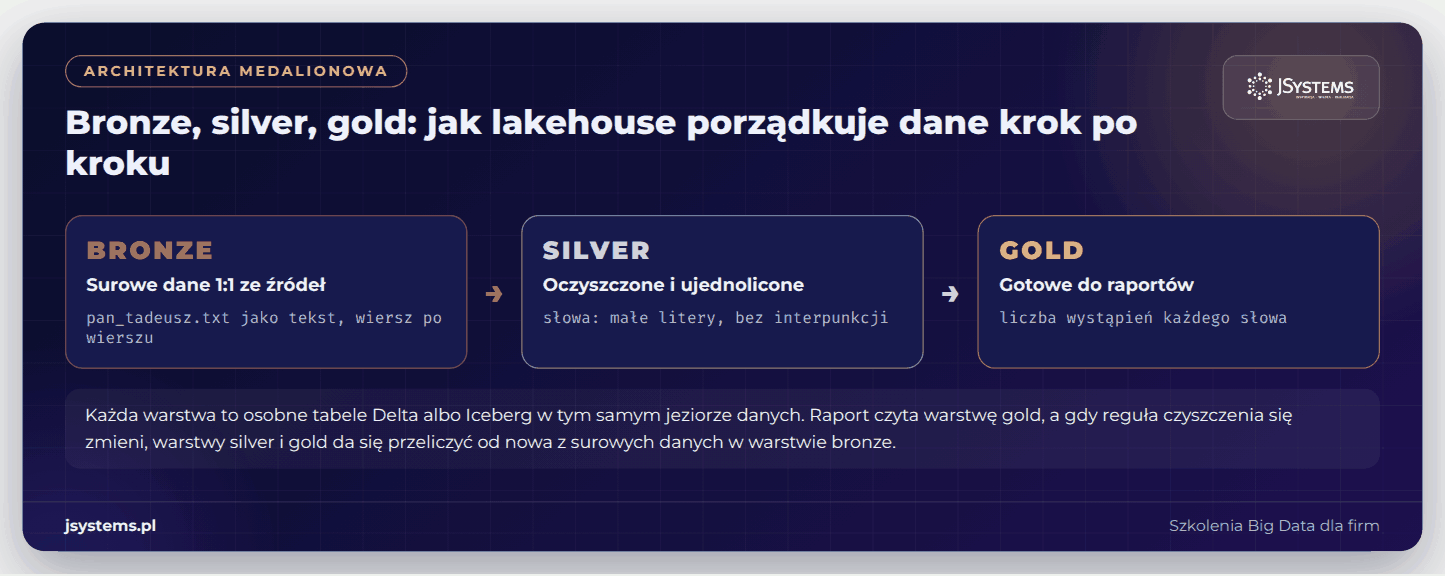
W praktyce lakehouse porządkuje się zwykle według architektury medalionowej. Surowe dane trafiają do warstwy bronze, oczyszczone i ujednolicone do warstwy silver, a tabele gotowe do raportów do warstwy gold. Nasze liczenie słów pasuje do tego schematu: tekst „Pana Tadeusza” to bronze, lista słów pisanych małymi literami bez interpunkcji to silver, a liczba wystąpień każdego słowa to gold. Szerszy obraz współczesnego stosu danych, ze strumieniami Kafki i silnikiem Trino, opisujemy w artykule Współczesne rozwiązania Big Data - Spark, lakehouse, streaming i federacyjne SQL w praktyce.
Historia Microsoftu w big data dobrze pokazuje, jak zmieniała się cała branża. W 2013 roku firma uruchomiła HDInsight, czyli Hadoopa w chmurze Azure zbudowanego na dystrybucji Hortonworks. Potem przyszedł magazyn Azure Data Lake Storage dla analityki, w 2018 roku Azure Databricks, a w 2019 roku Microsoft zapowiedział Azure Synapse Analytics (dostępne dla wszystkich od końca 2020 roku), które połączyło hurtownię SQL ze Sparkiem i potokami danych w jednym obszarze roboczym.
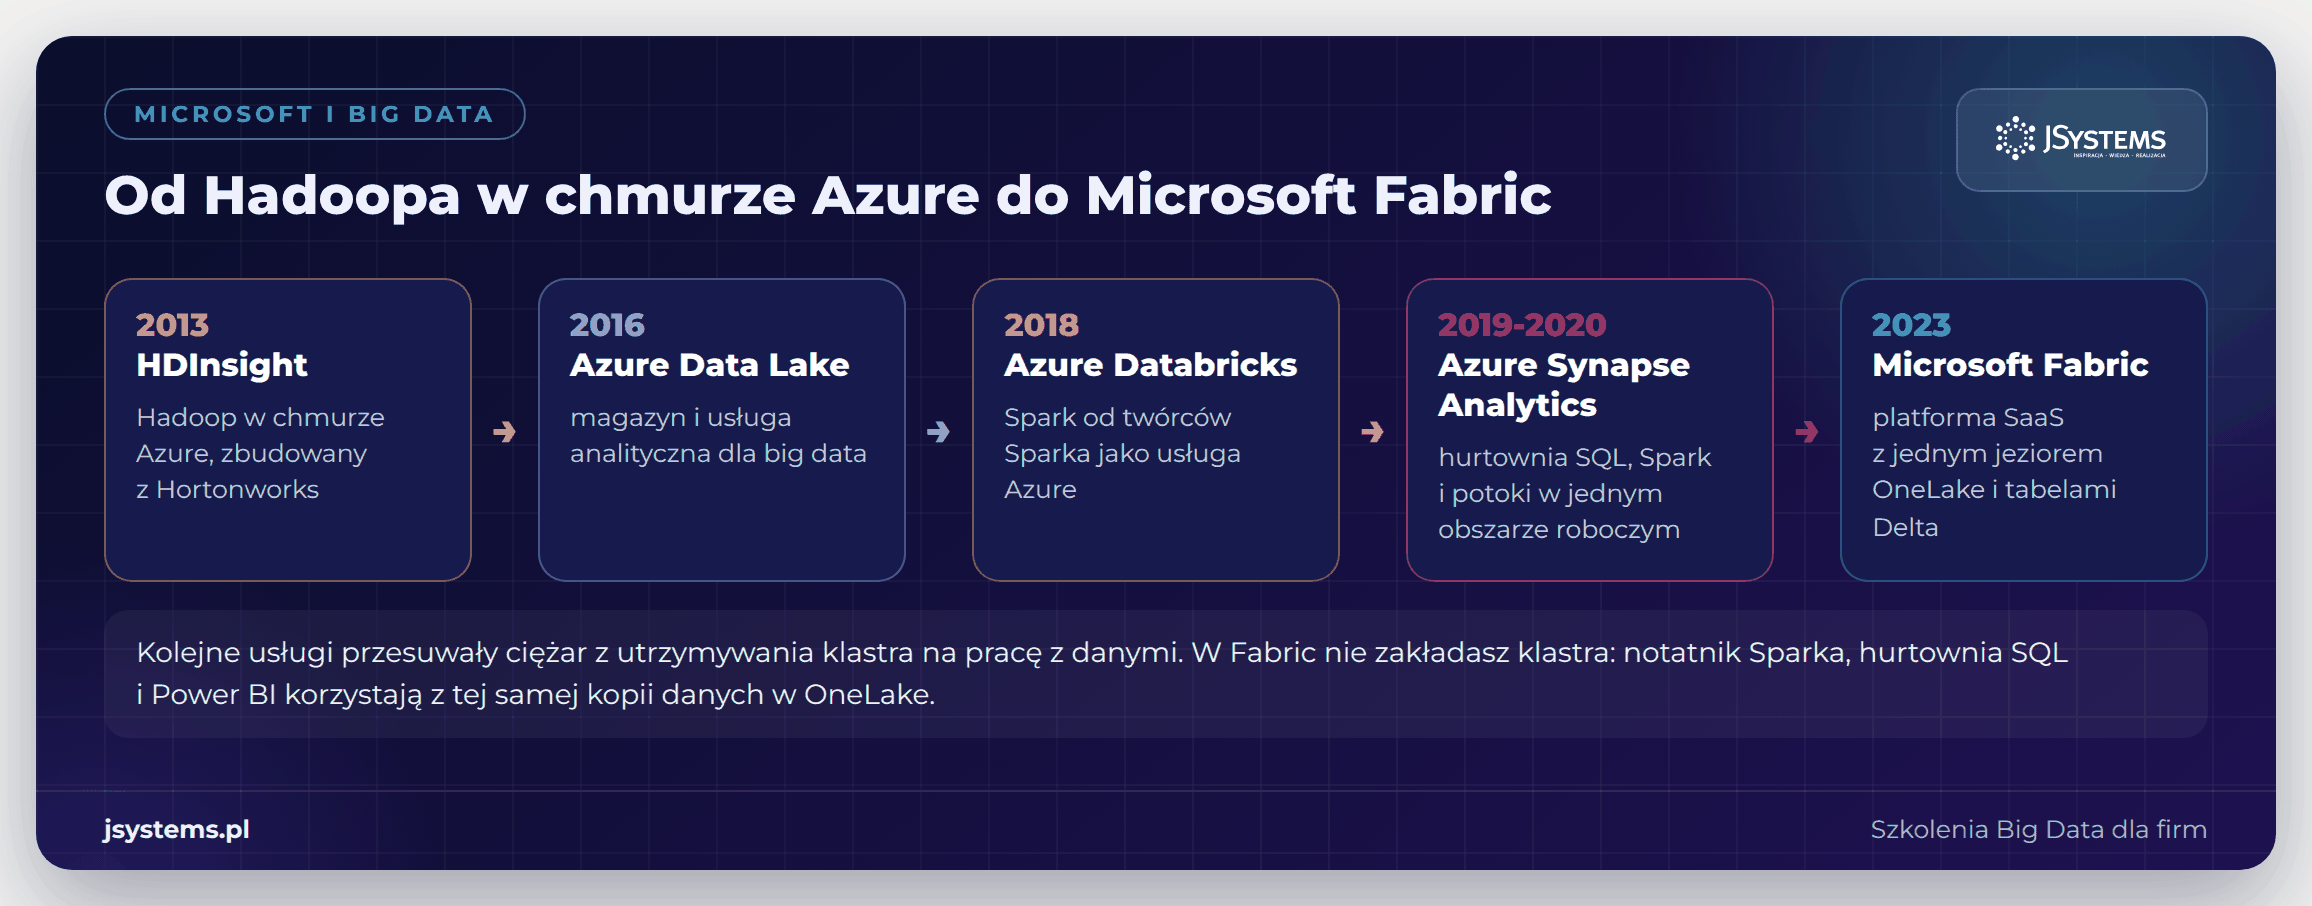
W maju 2023 roku Microsoft zapowiedział Microsoft Fabric, a w listopadzie tego samego roku udostępnił go wszystkim. Fabric to platforma w modelu usługi, w której integracja danych, inżynieria danych na Sparku, hurtownia SQL, analiza danych w czasie rzeczywistym i Power BI korzystają z jednego jeziora danych OneLake. Wszystkie te silniki zapisują tabele w tym samym formacie, Delta Lake na plikach Parquet, więc raport Power BI może czytać tabelę zapisaną przez notatnik Sparka bez kopiowania danych. Płaci się za pojemność, czyli moc obliczeniową wykupioną dla całej organizacji, a nie za osobne klastry.
Co chcemy osiągnąć. Policzymy słowa w „Panu Tadeuszu” w notatniku Fabric i zapiszemy wynik jako tabelę Delta w lakehouse, czyli w tym, co w Fabric pełni rolę jeziora danych z tabelami. Zobaczymy, ile z dawnej pracy z klastrem zostało w platformie w modelu usługi. Potrzebny jest obszar roboczy z pojemnością Fabric (u nas próbną), lakehouse z plikiem pan_tadeusz.txt wgranym do sekcji Files i notatnik wordcount_fabric.ipynb.
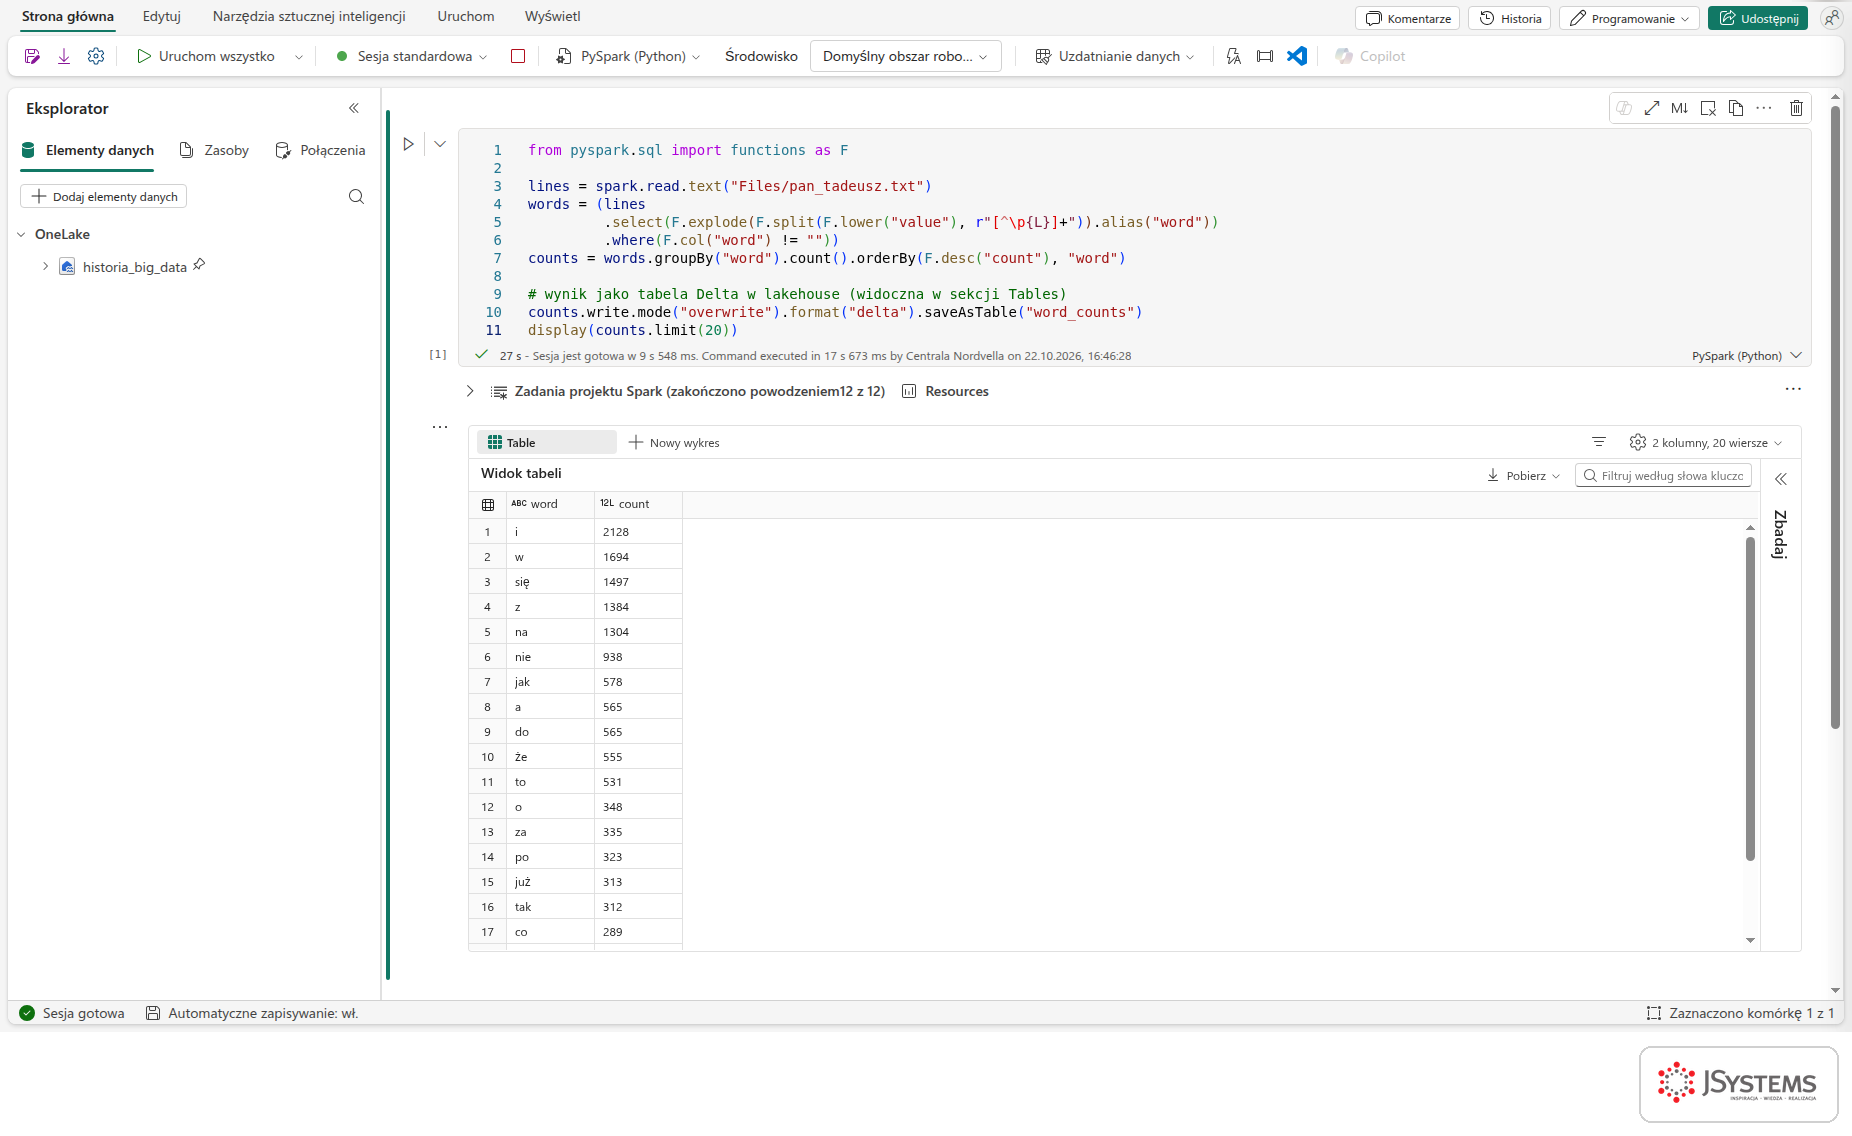
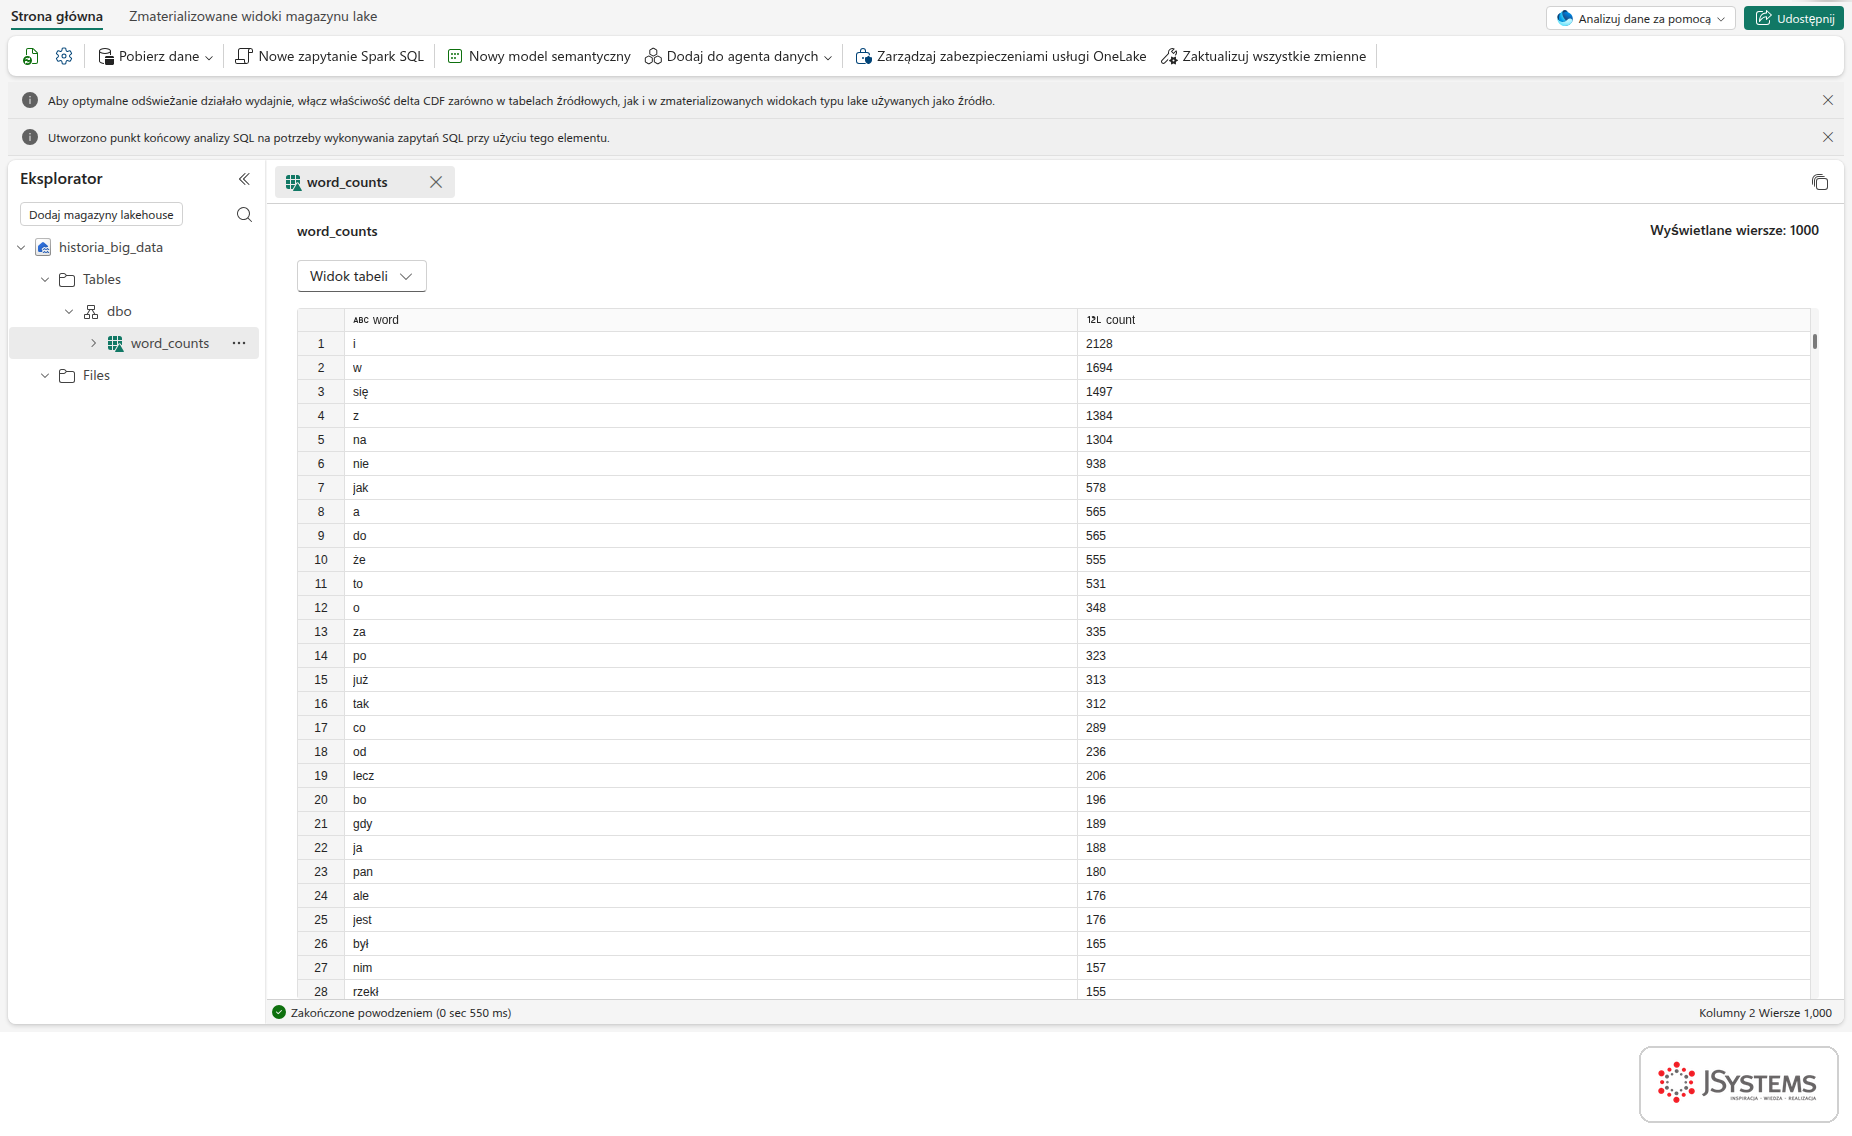
Notatnik podpięty do lakehouse'a czyta plik ścieżką względną Files/pan_tadeusz.txt. Kod to ten sam PySpark co w epoce czwartej, w wersji z API DataFrame: małe litery, podział na słowa, grupowanie i zapis wyniku jako tabeli Delta poleceniem saveAsTable. Sesja Spark była gotowa po niecałych 10 sekundach, a samo polecenie trwało około 18 sekund. Nie trzeba było instalować Javy, konfigurować klastra ani pilnować portów.
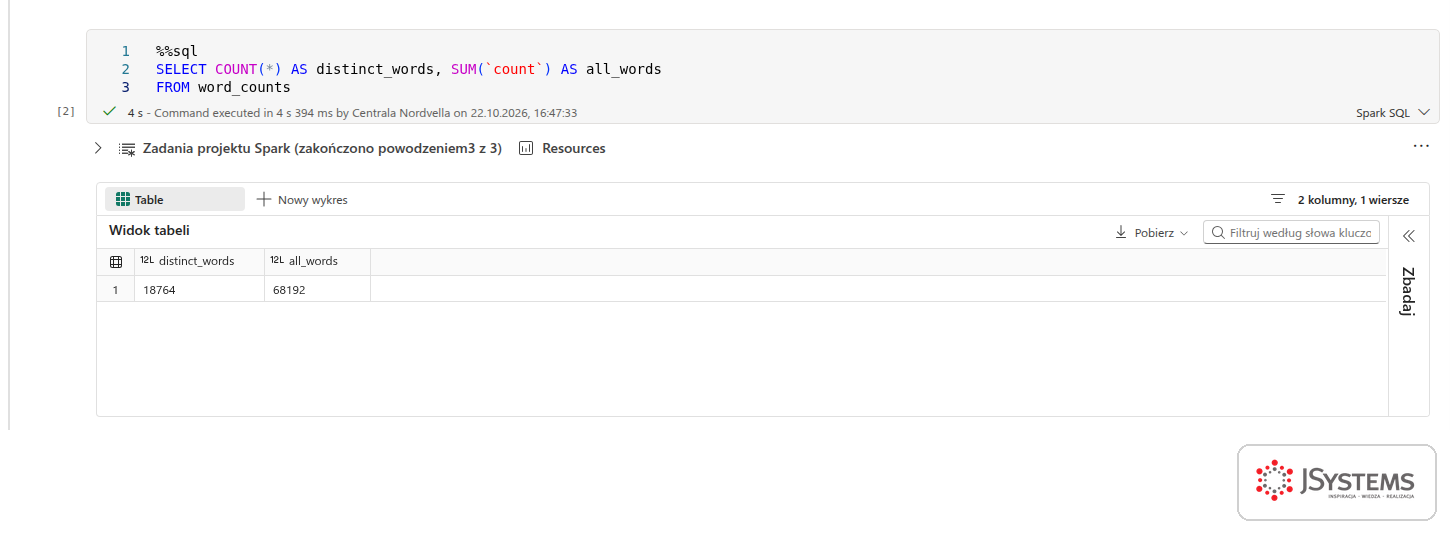
Kontrolne zapytanie SQL w drugiej komórce zwraca 18 764 różne słowa i 68 192 wszystkie, dokładnie tyle samo co MapReduce w Javie i Hadoop Streaming na naszym klastrze. Tabela word_counts pojawia się od razu w sekcji Tables lakehouse'a. Fabric przechowuje ją w OneLake jako pliki Parquet z dziennikiem Delta, więc ten sam wynik przeczyta raport Power BI w trybie Direct Lake albo punkt końcowy SQL lakehouse'a, bez kopiowania danych.
Krok po kroku przez obszary robocze, lakehouse, notatniki i licencjonowanie przeprowadzamy w przewodniku Co to jest Microsoft Fabric. Jeśli pracujesz w Power BI, zobacz też lekcję kursu o trybie Direct Lake: Kurs Power BI: Układ mobilny, Fabric (Direct Lake) i Copilot.
Ostatnie lata to spór o to, który format tabel zostanie standardem, i jednocześnie zbliżanie się Delta Lake i Iceberga. Już w 2023 roku Delta Lake 3.0 dostał funkcję UniForm, dzięki której tę samą tabelę mogą czytać narzędzia obsługujące Iceberga i Hudi. W czerwcu 2024 roku Databricks ogłosił przejęcie firmy Tabular, założonej przez twórców Iceberga, i udostępnił jako otwarte oprogramowanie swój katalog Unity Catalog. W tym samym miesiącu Snowflake przedstawił własny otwarty katalog dla Iceberga, Polaris, który w lutym 2026 roku został projektem najwyższego poziomu Apache. Katalogi stały się nowym polem rywalizacji: to w nich zapisane jest, które tabele istnieją, gdzie leżą ich pliki i kto ma do nich dostęp.
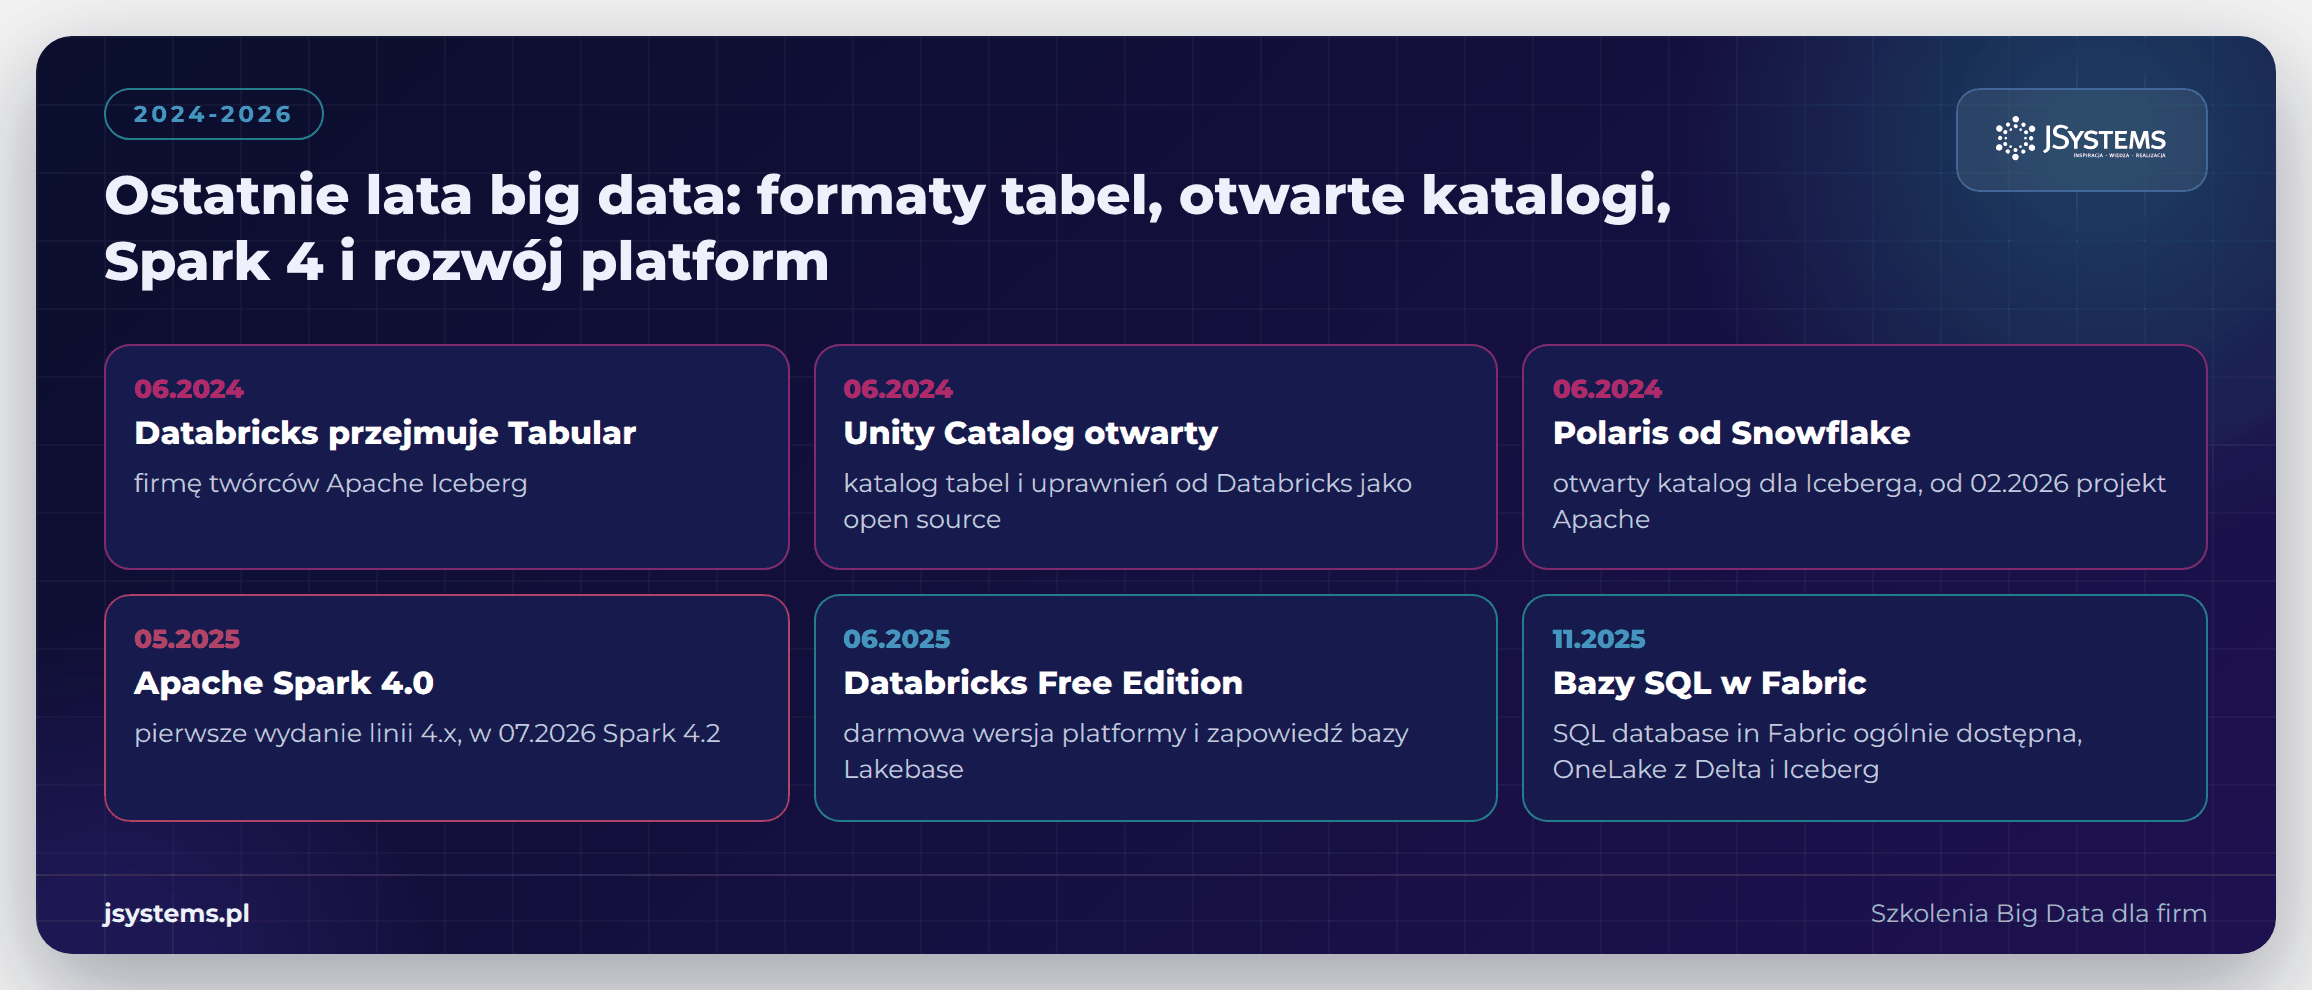
W maju 2025 roku ukazał się Spark 4.0, pierwsze wydanie linii 4.x, a w lipcu 2026 roku Spark 4.2, na którym liczyliśmy słowa w tym artykule. W czerwcu 2025 roku Databricks udostępnił bezpłatną wersję Free Edition i zapowiedział Lakebase, bazę Postgres w lakehouse zbudowaną na technologii przejętej firmy Neon. Skalę tego rynku dobrze pokazuje sam Databricks: w sierpniu 2026 roku firma podała, że jej przychody w ujęciu rocznym (run-rate) przekroczyły 7 mld USD, a ostatnia runda finansowania wyceniła ją na 190 mld USD. Microsoft w tym czasie dokładał do Fabric kolejne elementy. Od listopada 2025 roku są w nim ogólnie dostępne bazy SQL, a OneLake obsługuje tabele zarówno w formacie Delta, jak i Iceberg. Starsze usługi Azure odchodzą: Azure Data Lake Storage Gen1 wycofano w lutym 2024 roku, a HDInsight on AKS w styczniu 2025 roku. Azure Synapse Analytics jest nadal wspierany, ale Microsoft udostępnia już narzędzia do migracji z niego do Fabric.
Projekt Apache Hadoop nadal się rozwija: w kwietniu 2026 roku ukazała się wersja 3.5.0, która wymaga już Javy 17, a nasze demo działa na wersji 3.4.3 z lutego. Według kwietniowego raportu dla zarządu Apache Software Foundation projekt ma 248 committerów, czyli osób z prawem zatwierdzania zmian. Tempo prac jest jednak dużo mniejsze niż dekadę temu: w 2025 roku do głównej gałęzi repozytorium trafiło 559 zmian (commitów), a w 2016 roku 2569. Klastry HDFS i YARN wciąż pracują w firmach, które trzymają dane we własnych serwerowniach i nie przeniosły ich do chmury. W nowych projektach jego części zastąpiły jednak inne technologie: MapReduce ustąpił Sparkowi, HDFS magazynom obiektowym w chmurze, a YARN coraz częściej Kubernetesowi. Dobrze to widać w pytaniach zadawanych przez programistów na Stack Overflow.
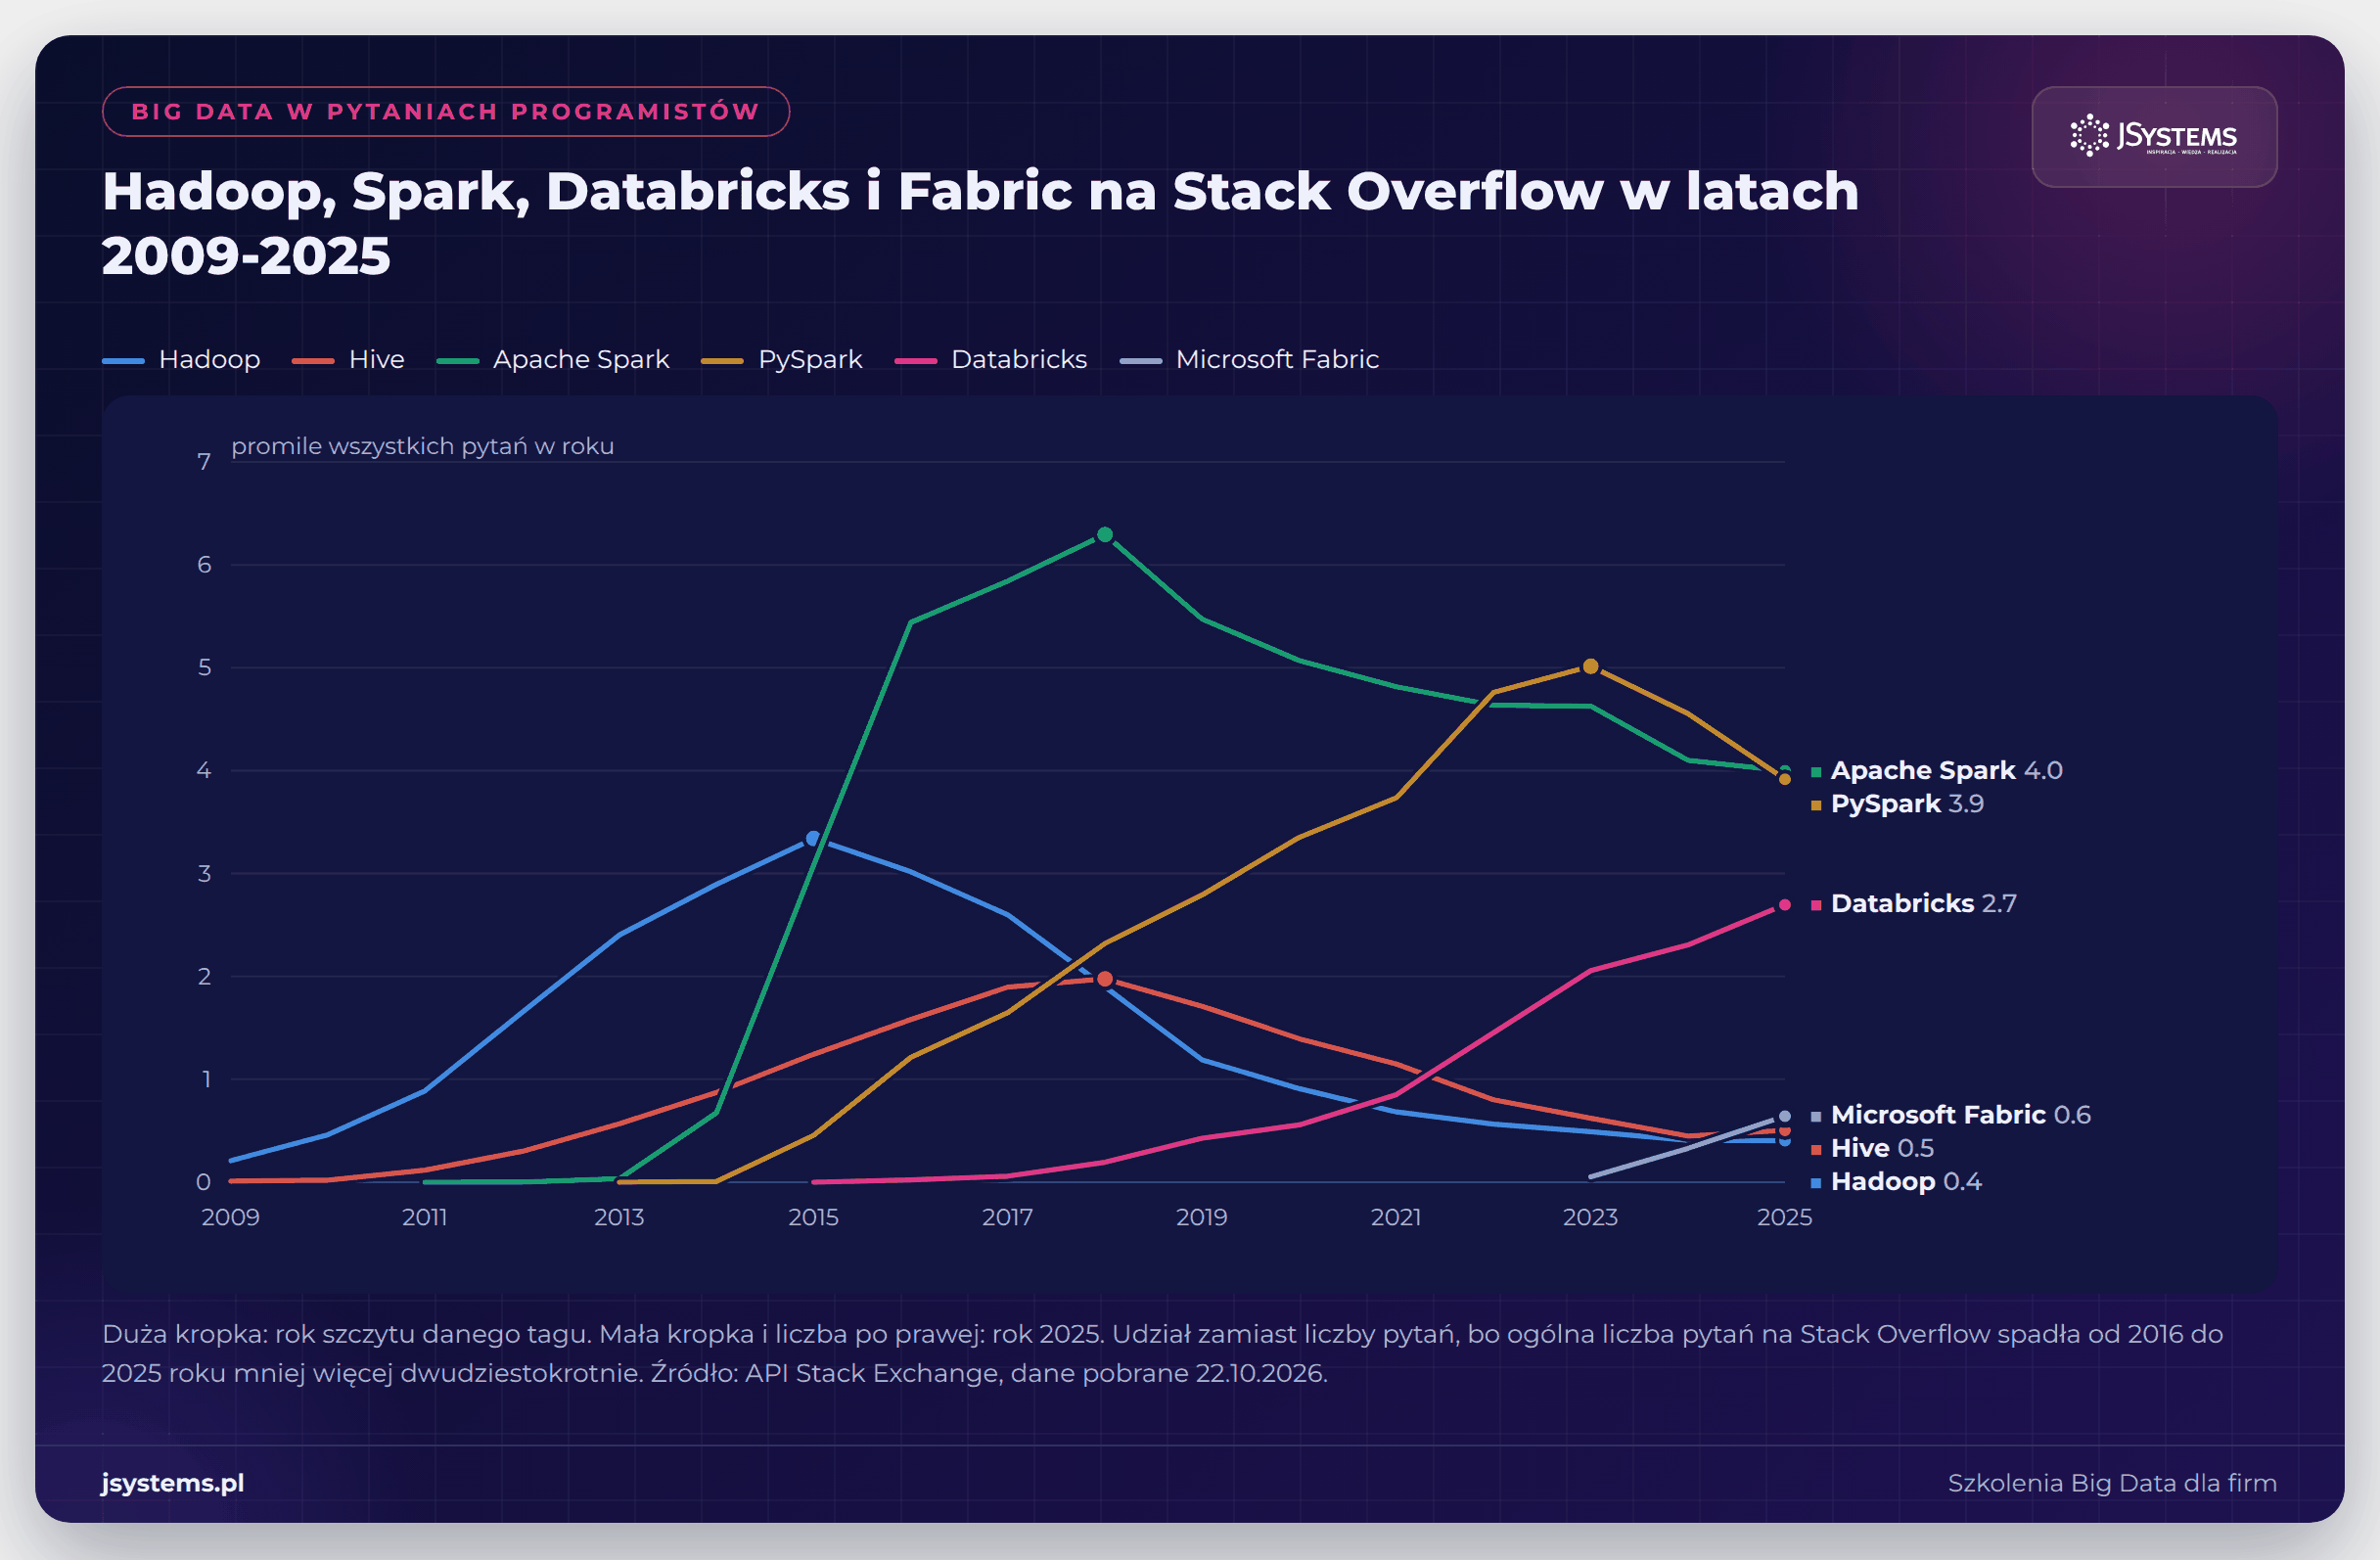
Najwięcej pytań o Hadoopa programiści zadali w 2015 roku: 7269, czyli 3,3 promila wszystkich pytań w serwisie. Rok później pytań z tagiem apache-spark było już prawie dwa razy więcej niż z tagiem hadoop, a w 2025 roku o Hadoopa zapytano 44 razy. W latach 2022-2024 pytań z tagiem pyspark było więcej niż z tagiem apache-spark, co dobrze pokazuje, że Python stał się głównym językiem pracy ze Sparkiem. Udział Databricks rósł z roku na rok w latach 2019-2025, a Microsoft Fabric jest na tej liście najmłodszy, z tagiem od 2023 roku. Wykres pokazuje udział, a nie liczbę pytań, bo cały Stack Overflow między 2016 a 2025 rokiem stracił około 95 procent pytań.
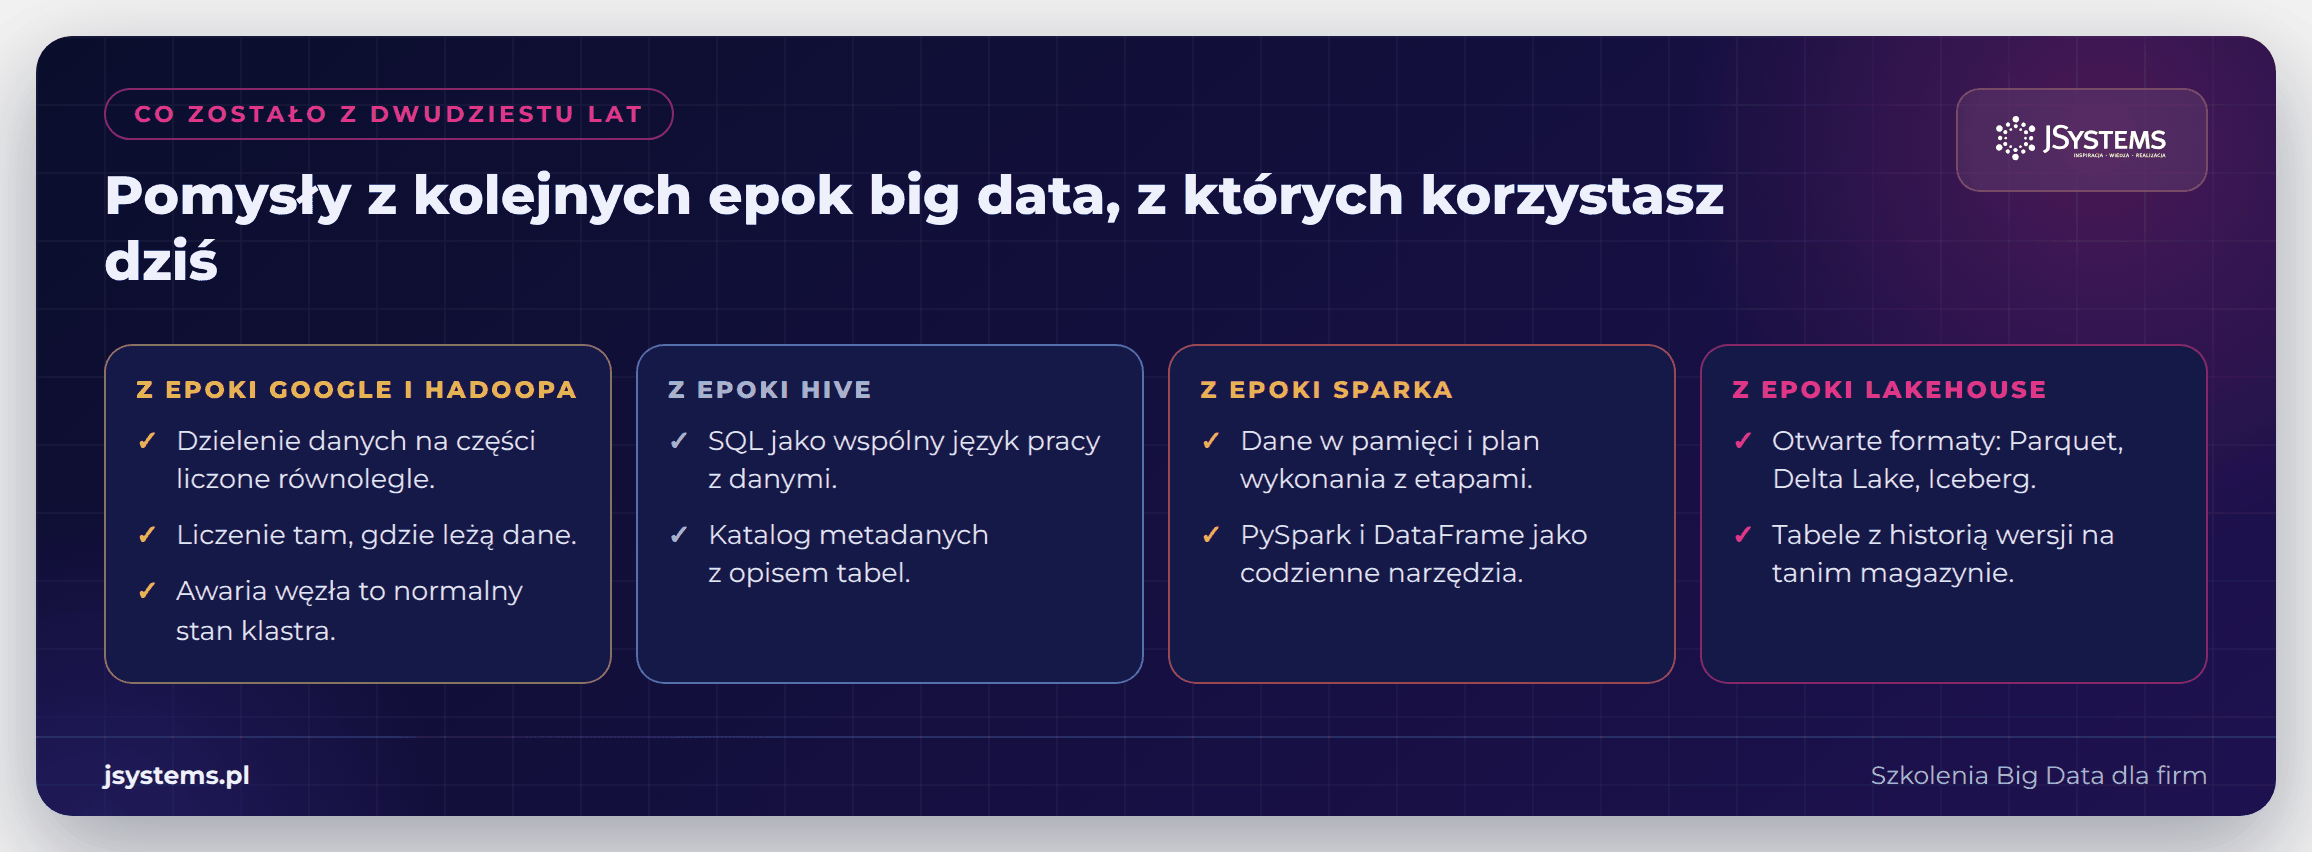
Część dawnego zoo trafiła już do archiwum Apache Attic, w którym lądują wygaszone projekty: Sqoop w 2021 roku, Oozie w lutym 2025 roku, a Mesos, menedżer klastra konkurujący kiedyś z YARN, w sierpniu 2025 roku. Cloudera, od 2021 roku spółka prywatna, przedstawia się dziś jako dostawca platformy lakehouse. Najwięcej z epoki Hadoopa przetrwało w pomysłach, nie w programach. Podział danych na bloki i liczenie tam, gdzie leżą dane, to dalej podstawa działania Sparka. Niezmienne pliki z dziennikiem zmian to zasada działania Delta Lake i Iceberga. A od Hive, który dał analitykom SQL zamiast Javy, zaczyna się droga do dzisiejszych hurtowni w lakehouse.
Zestawmy wszystkie wersje w jednym miejscu. Czas to czas ścienny całego polecenia na jednym komputerze z 10 rdzeniami (20 wątków), na pliku 0,48 GB, razem z uruchomieniem programu i zadań. Kod liczymy w liniach bez pustych linii i komentarzy. Każdą wersję zmierzyliśmy raz, a na komputerze działały w tym czasie także inne procesy, więc czasy pokazują rząd wielkości, a nie wynik benchmarku. Epoka piąta, czyli tabela Delta, nie zmienia samego liczenia, tylko sposób przechowywania wyniku, dlatego w zestawieniu czasów jej nie ma.
| Epoka | Narzędzie | Kod | Czas | Co trzeba umieć |
|---|---|---|---|---|
| 1 | MapReduce w Javie | 81 linii Javy, kompilacja i plik JAR | 50 s | Java, API MapReduce, HDFS |
| 2 | Hadoop Streaming | 23 linie Pythona w dwóch skryptach | 62 s | Python, pary klucz i wartość, sortowanie przed reduce |
| 3 | Hive | 13 linii SQL | 90 s | SQL i tabele zewnętrzne |
| 4 | Spark lokalnie (DataFrame) | skrypt PySpark albo trzy linie w powłoce | 24 s | Python albo SQL, leniwe wykonanie |
| 4 | Spark na YARN (DataFrame) | ten sam skrypt | 59 s | to samo plus konfiguracja klastra |
| dla porównania | Python w jednym procesie | jeden skrypt, bez klastra | 41 s | Python |
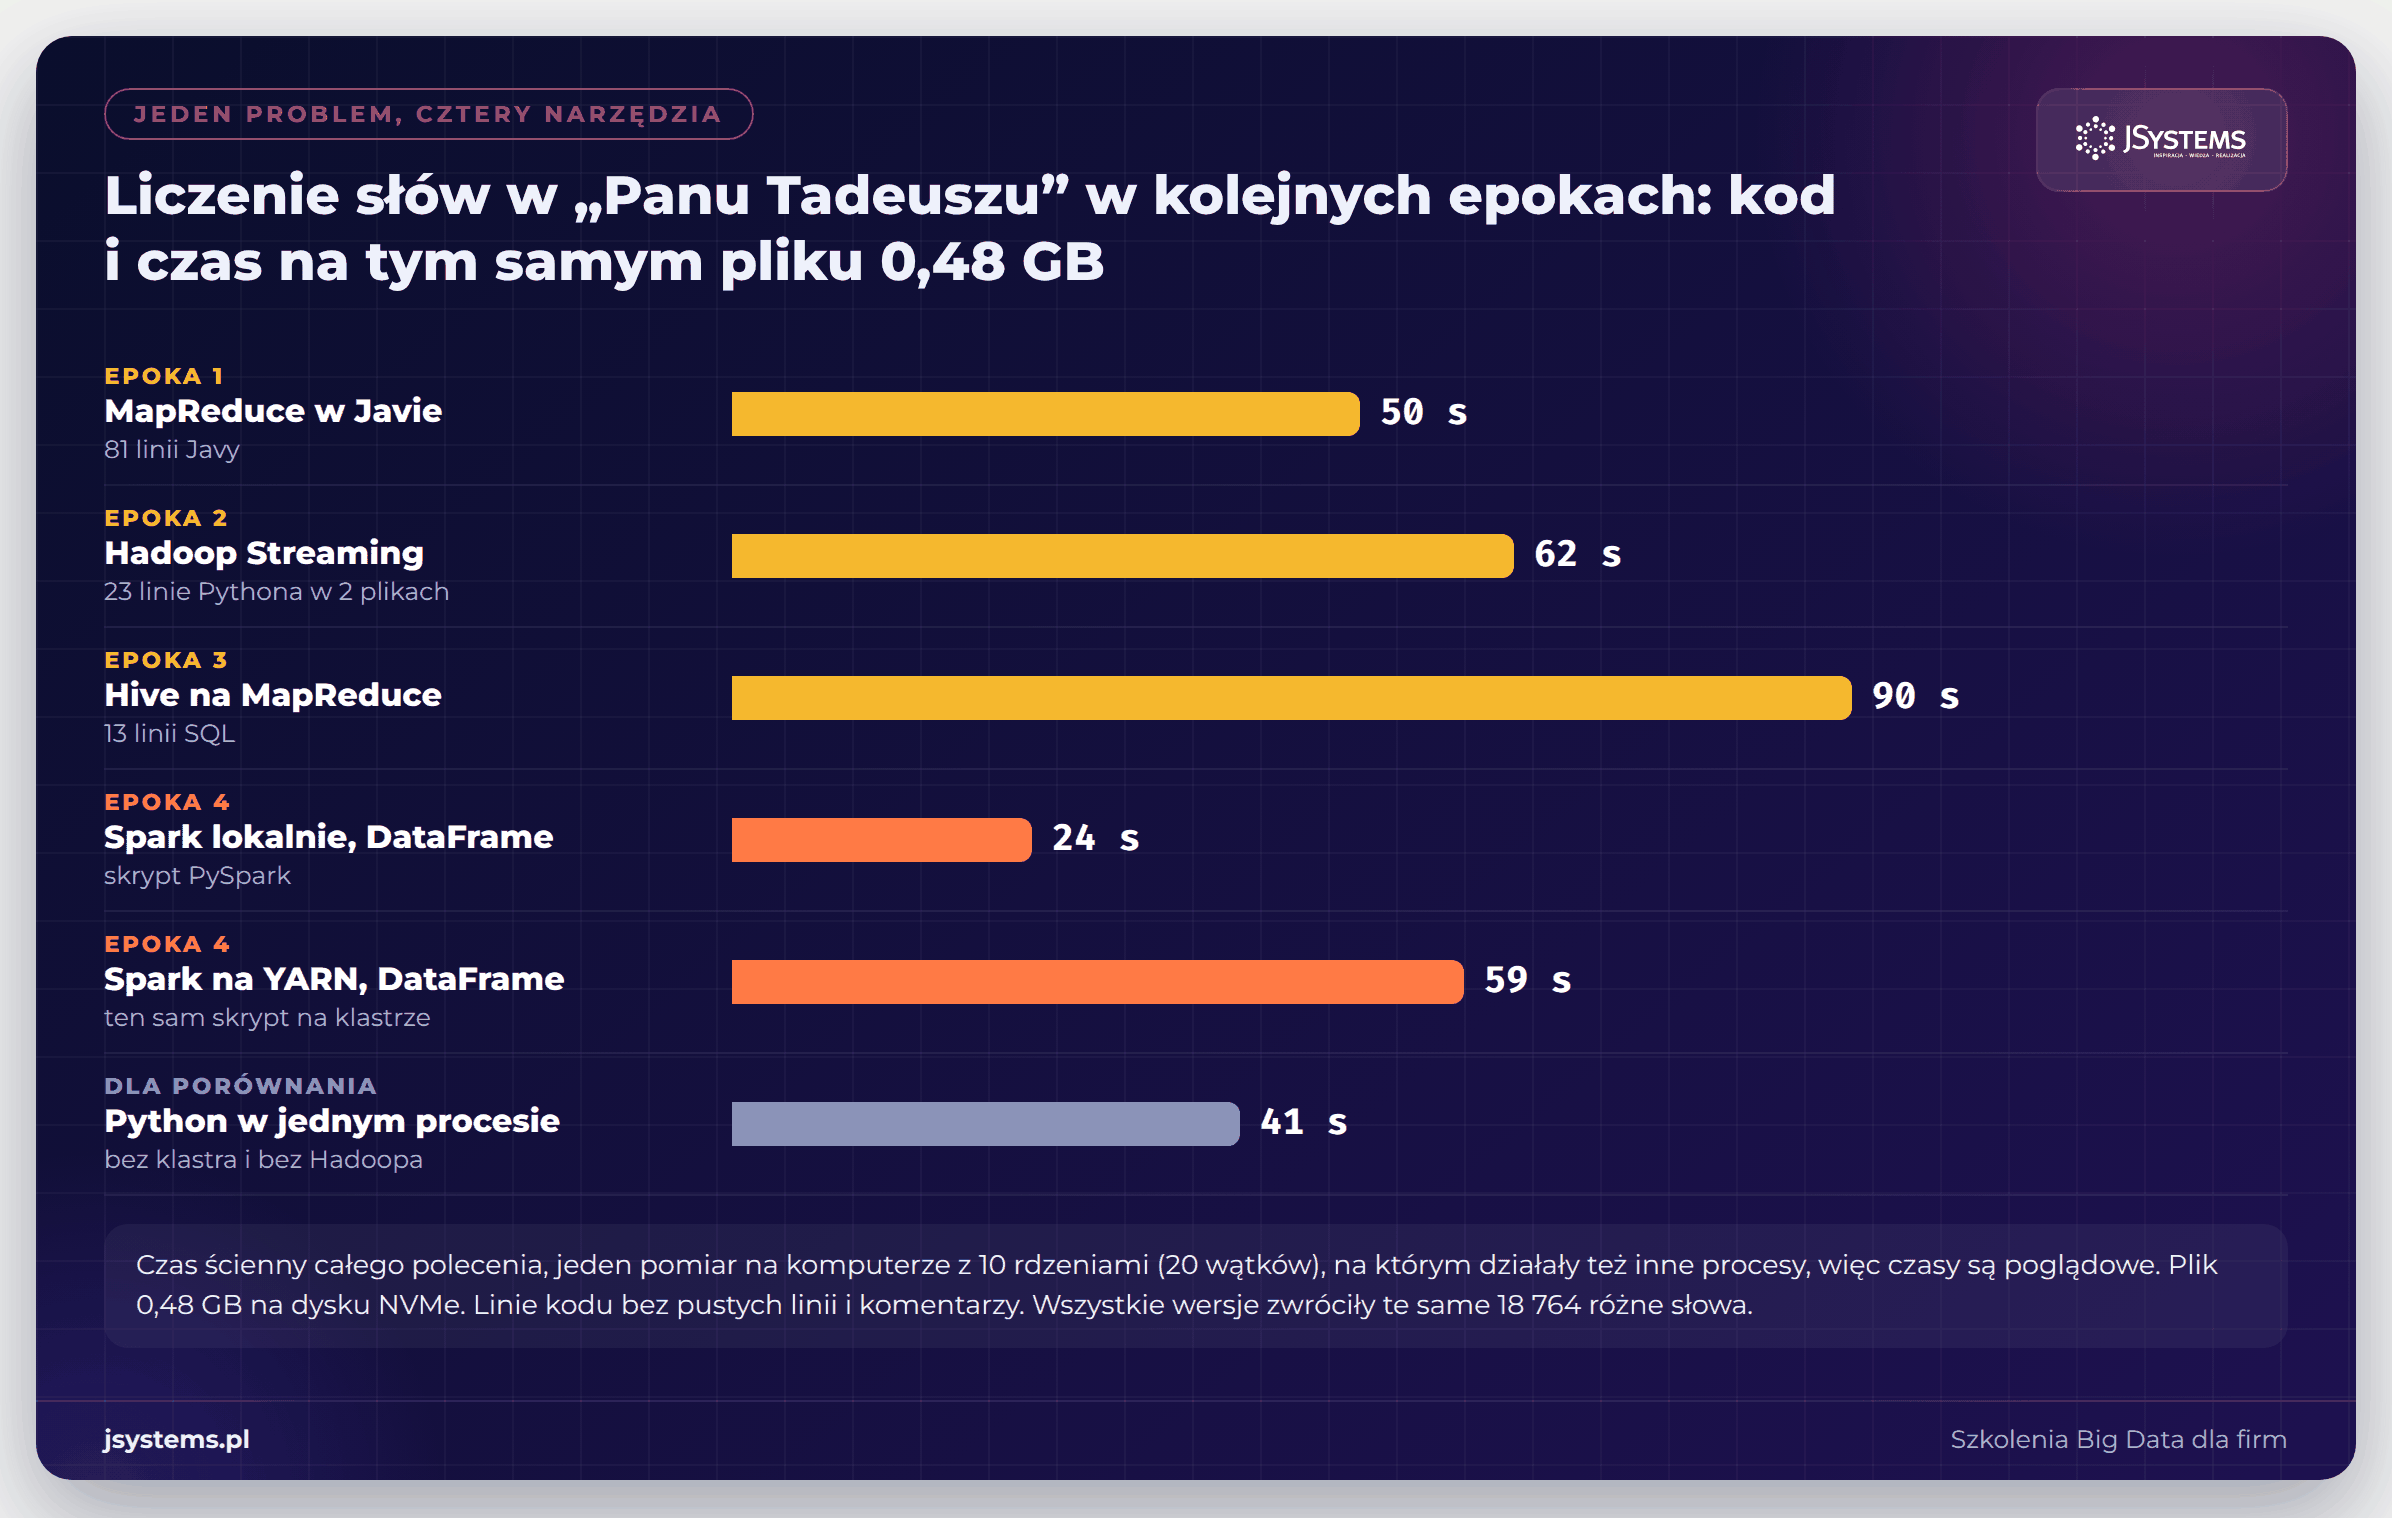
Najwięcej mówi ostatni wiersz. Zwykły skrypt Pythona w jednym procesie (wordcount_single_process.py) policzył pół gigabajta w 41 sekund, szybciej niż MapReduce. Na jednym komputerze i przy takim rozmiarze danych narzut rozproszonego systemu przeważa nad zyskiem z równoległości. Hadoop i Spark nie powstały po to, żeby szybciej policzyć pół gigabajta, tylko po to, żeby dało się w ogóle przetworzyć setki terabajtów, których nie zmieści żaden pojedynczy serwer. Spark lokalnie był najszybszy, bo działał w jednym procesie, bez uruchamiania kontenerów. Ten sam skrypt na YARN trwał dłużej, bo doszło do tego uruchamianie kontenerów dla wykonawców na klastrze.
Dwadzieścia lat historii big data da się streścić krótko: narzędzia zmieniały się co kilka lat, a pomysły zostawały. Kto rozumiał MapReduce, szybko zrozumiał etapy w Sparku. Kto znał Hive, odnalazł się w Spark SQL, a potem w hurtowniach na lakehouse. Z tej historii wynikają trzy praktyczne wnioski dla każdego, kto dziś zaczyna pracę z dużymi danymi.
Hadoop przydaje się dziś głównie w dwóch sytuacjach: gdy firma utrzymuje własny klaster we własnej serwerowni i gdy dane trzeba z takiego klastra przenieść do chmury. W obu przypadkach znajomość HDFS, YARN i Hive pozwala ocenić, co da się przenieść bez zmian, a co trzeba przepisać.
Komentarze (0)
Brak komentarzy...