Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
Apache Spark i Apache Hive to dwa najczęściej mylone ze sobą narzędzia świata Big Data. Oba potrafią przeliczyć ogromne zbiory danych zwykłym SQL, oba pochodzą z ekosystemu Hadoop - a mimo to są zupełnie inne. W tym przewodniku pokażemy różnice nie na sucho, lecz na żywym Sparku i żywym Hive uruchomionych w kontenerach, na tym samym zbiorze 53 031 transakcji sprzedaży. Zobaczysz identyczne wyniki, realne plany wykonania, prawdziwy panel Spark UI i uczciwy pomiar czasów - a na końcu jasną odpowiedź, kiedy wybrać które (i dlaczego często warto mieć oba).
Najkrótsza możliwa odpowiedź brzmi: Apache Hive to hurtownia danych z dostępem przez SQL, a Apache Spark to uniwersalny silnik obliczeniowy, który SQL ma tylko jako jedną z wielu możliwości. To rozróżnienie tłumaczy niemal wszystkie dalsze różnice, więc warto je dobrze osadzić.
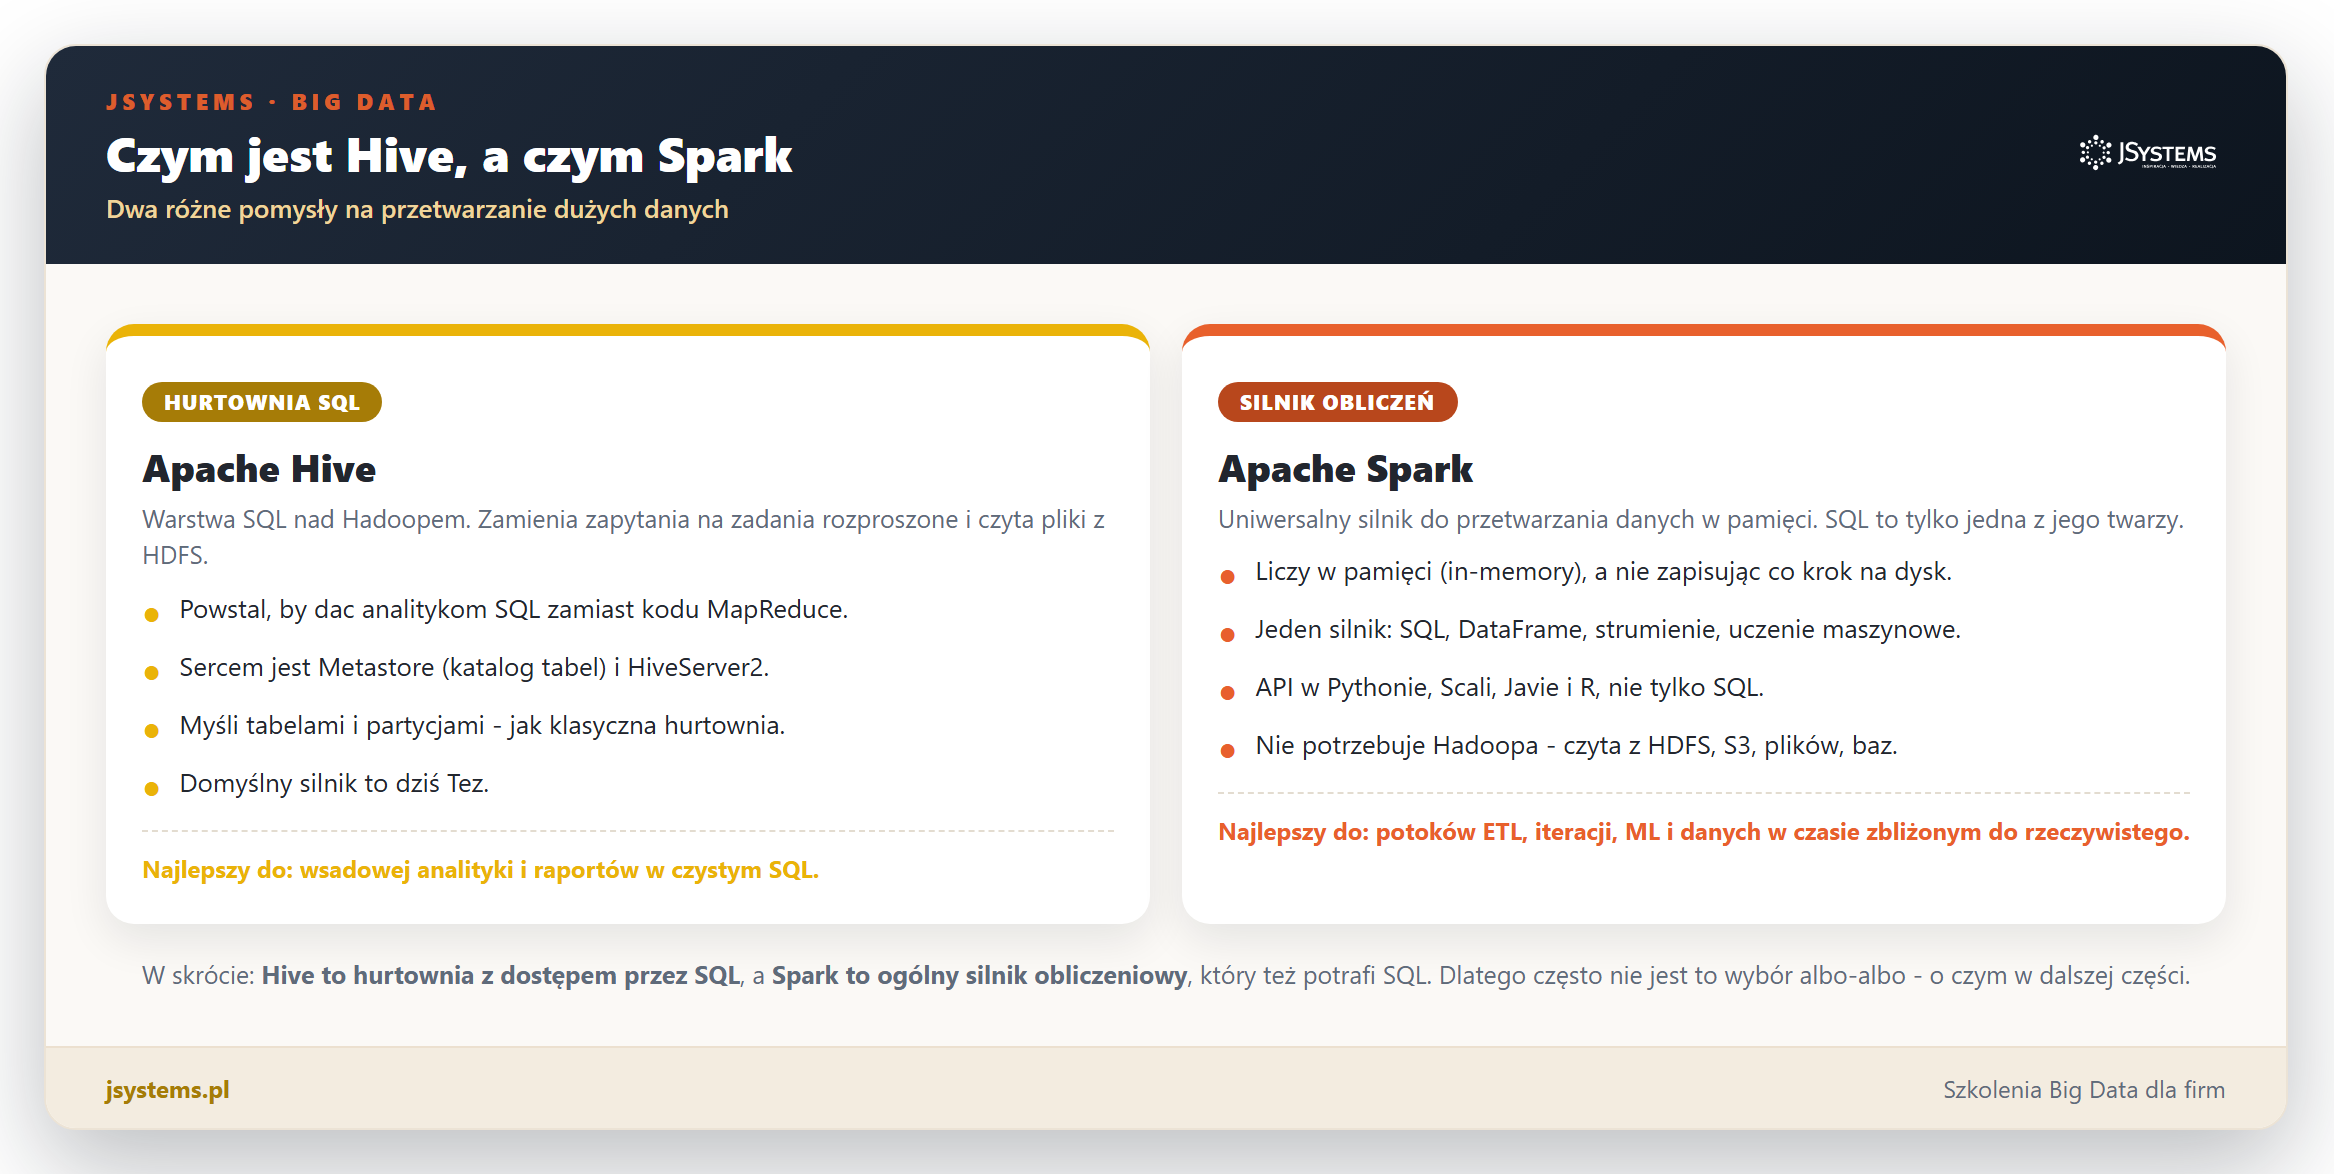
Hive powstał w Facebooku, by analitycy mogli odpytywać dane w Hadoopie zwykłym SQL, zamiast pisać ręcznie kod MapReduce. Jego sercem jest Metastore (katalog tabel i partycji) oraz serwer HiveServer2. Hive myśli tabelami - dokładnie jak klasyczna hurtownia. Jeśli chcesz poznać go od podszewki, opisaliśmy to w osobnym artykule o tym, czym jest Apache Hive i jak działa od środka.
Spark narodził się na uniwersytecie Berkeley jako odpowiedź na wolność MapReduce. Jego kluczowy pomysł to przetwarzanie w pamięci (in-memory) zamiast zapisywania każdego kroku na dysk. Spark nie jest przywiązany do Hadoopa - czyta dane z HDFS, chmury (S3), plików czy baz - i udostępnia jeden silnik do SQL, potoków ETL, strumieni danych i uczenia maszynowego. To dlatego stał się domyślnym wyborem inżynierów danych. Szerszy kontekst obu narzędzi znajdziesz w przeglądzie współczesnych rozwiązań Big Data.
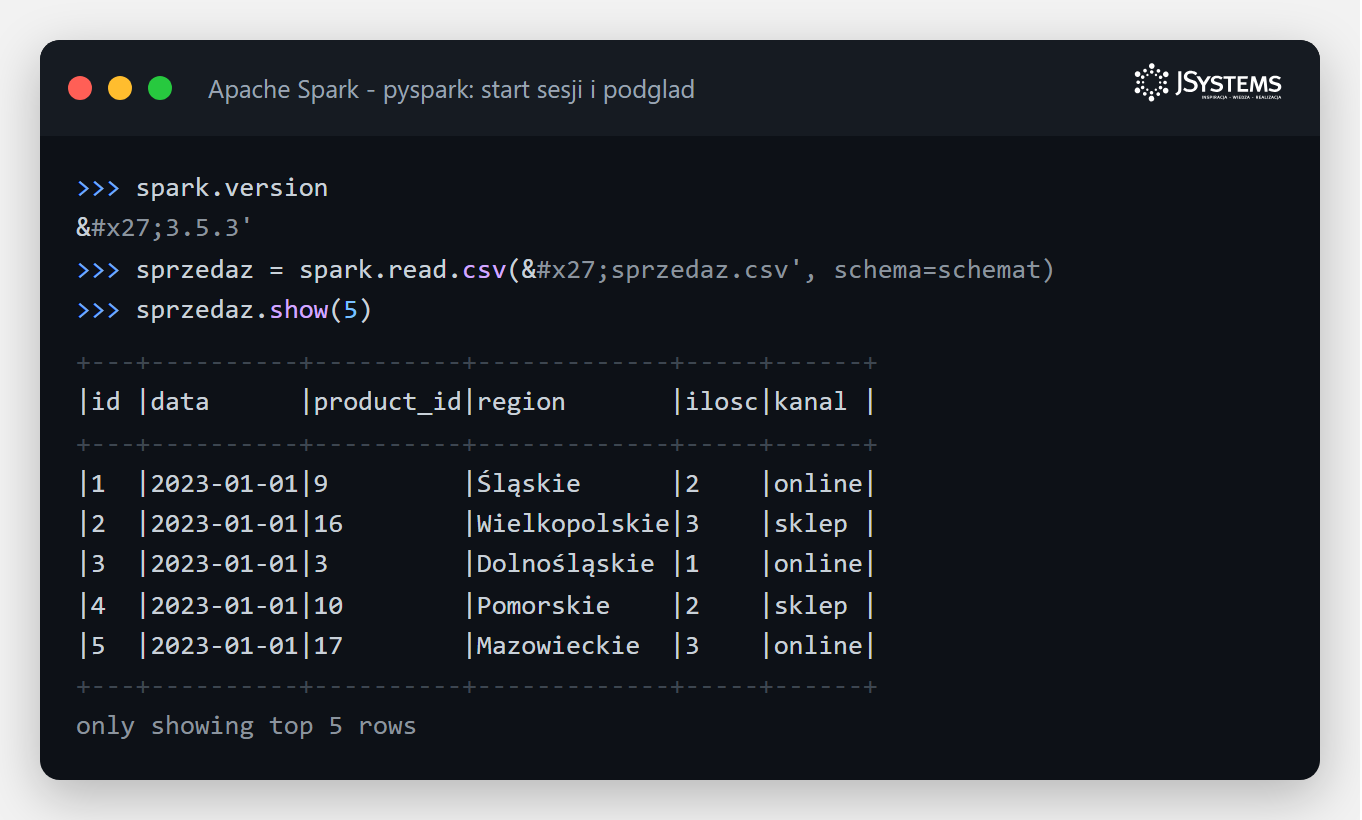
Zamiast opowiadać, pokażmy. Przygotowaliśmy jeden zbiór - 53 031 transakcji sprzedaży i mały wymiar 20 produktów - i załadowaliśmy dokładnie te same pliki CSV do Hive i do Sparka. Zacznijmy od strony Sparka: wczytujemy plik i nakładamy na niego schemat (to znany z Hive model schema-on-read, czyli schemat przy odczycie).
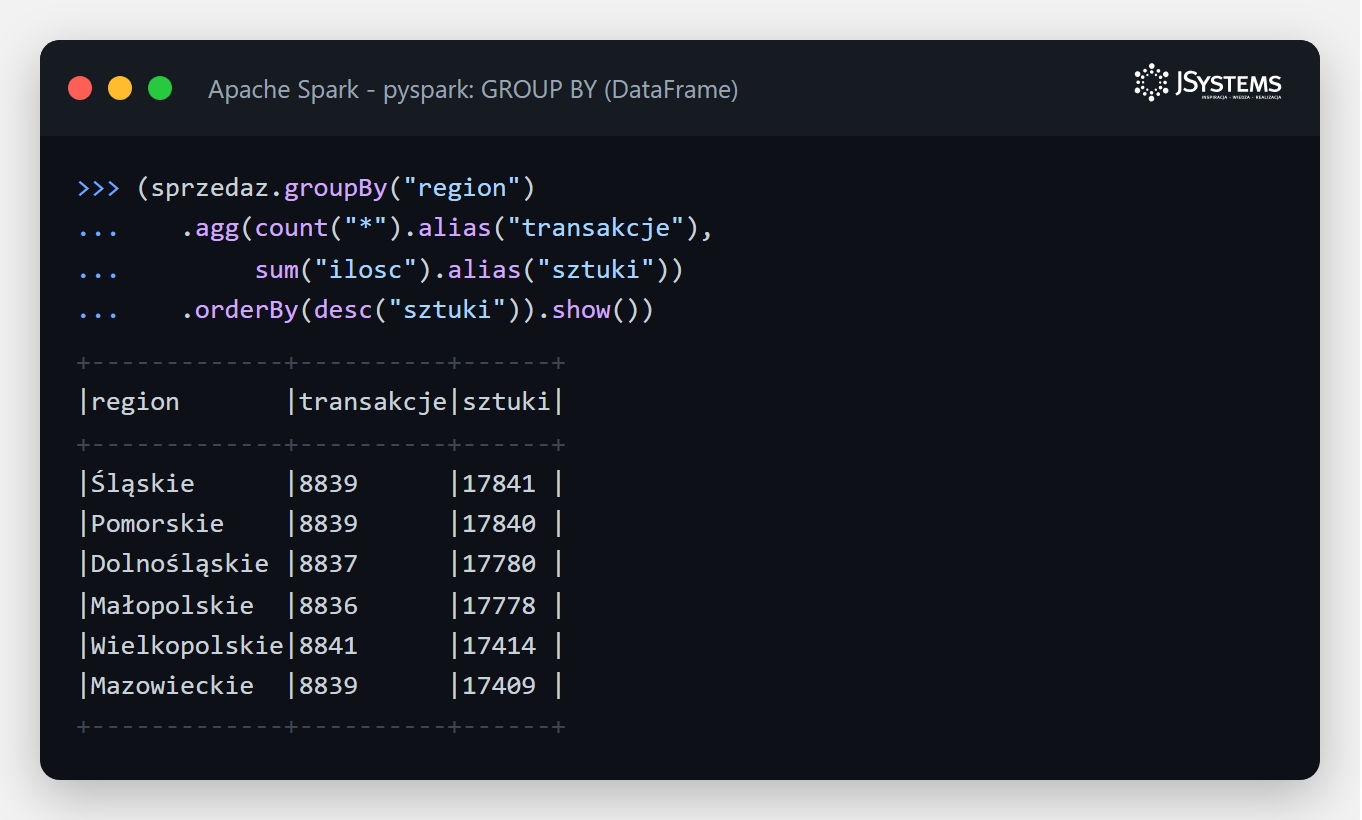
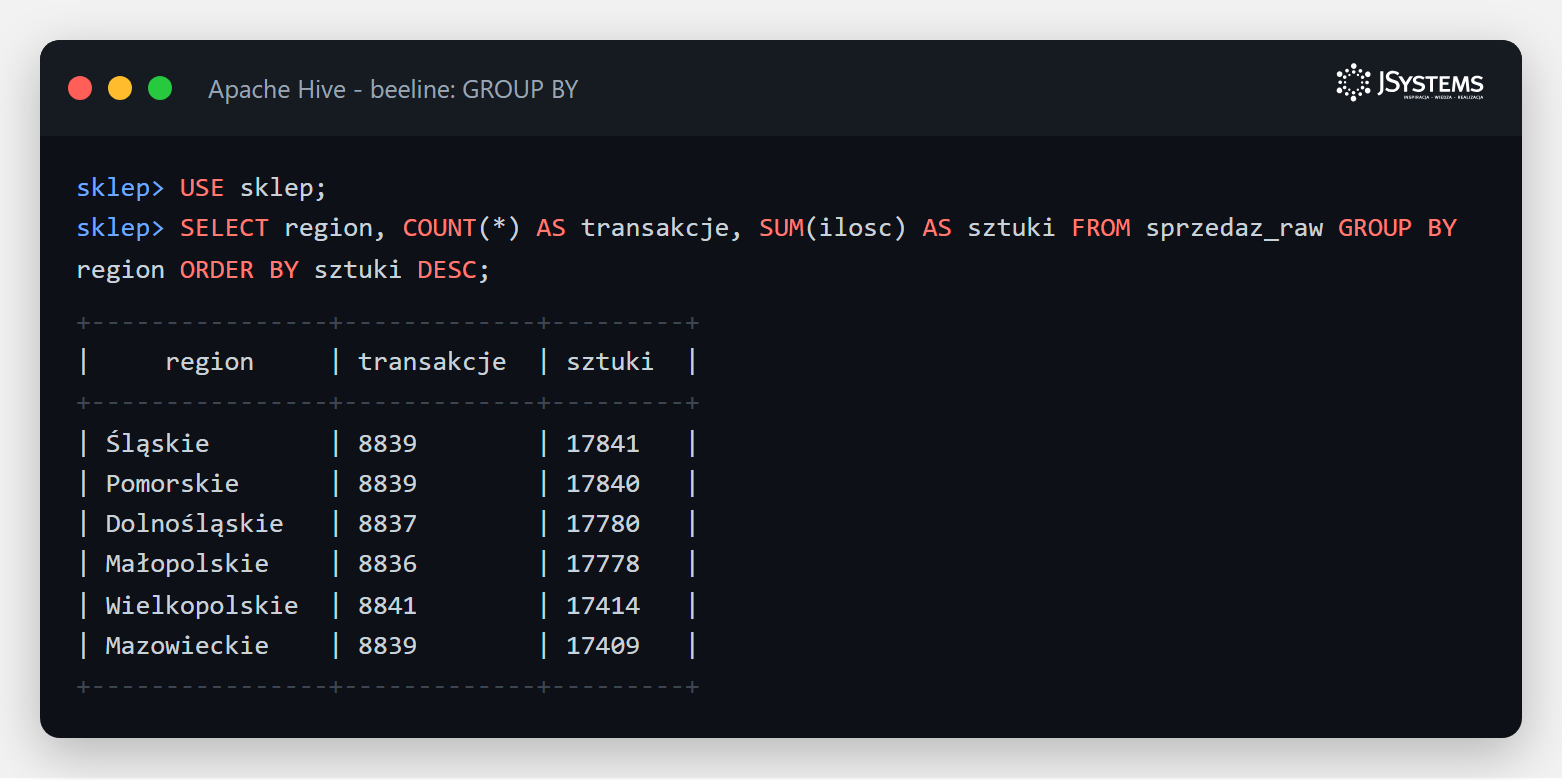
Teraz najważniejszy dowód. Zadajmy oba pytania analityczne - agregację sprzedaży według regionu - najpierw w Sparku, potem w Hive. Zwróć uwagę na liczby: są co do jednego identyczne.
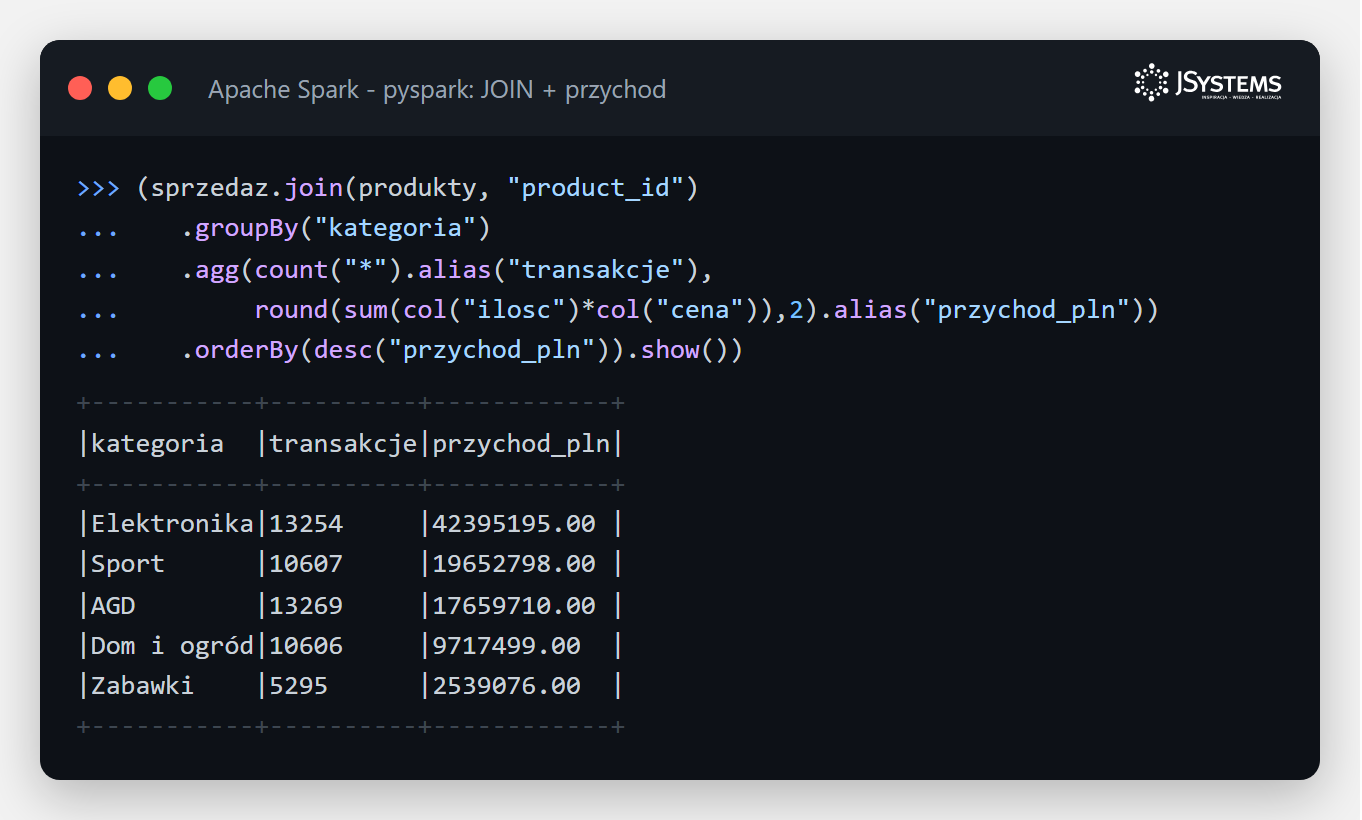
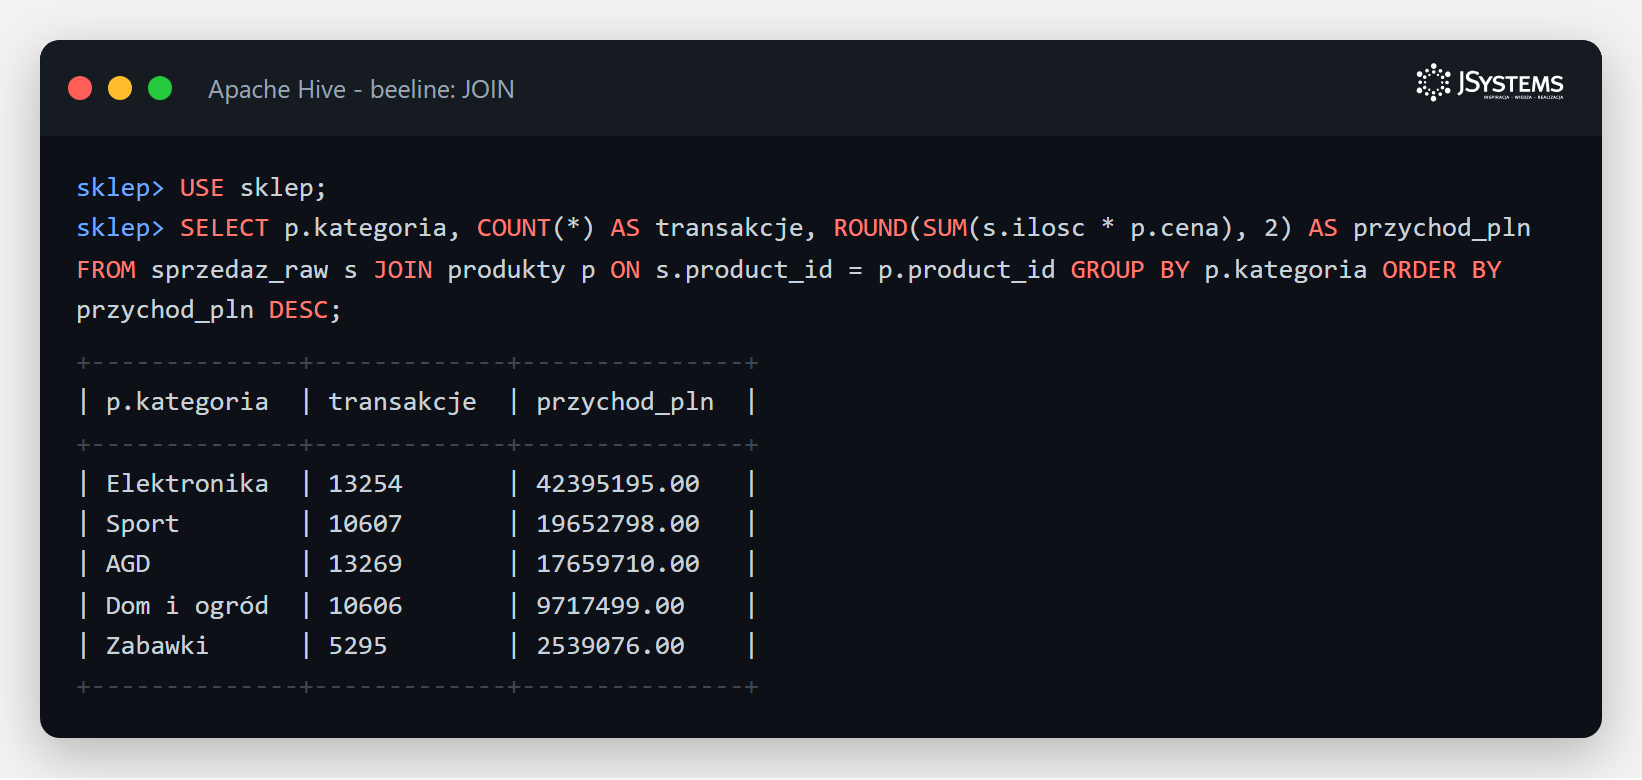
To samo dzieje się przy bardziej złożonym zapytaniu ze złączeniem (JOIN) tabel sprzedaży i produktów, liczącym przychód według kategorii. Elektronika daje ponad 42 miliony złotych - i tę samą kwotę co do grosza policzą oba silniki.
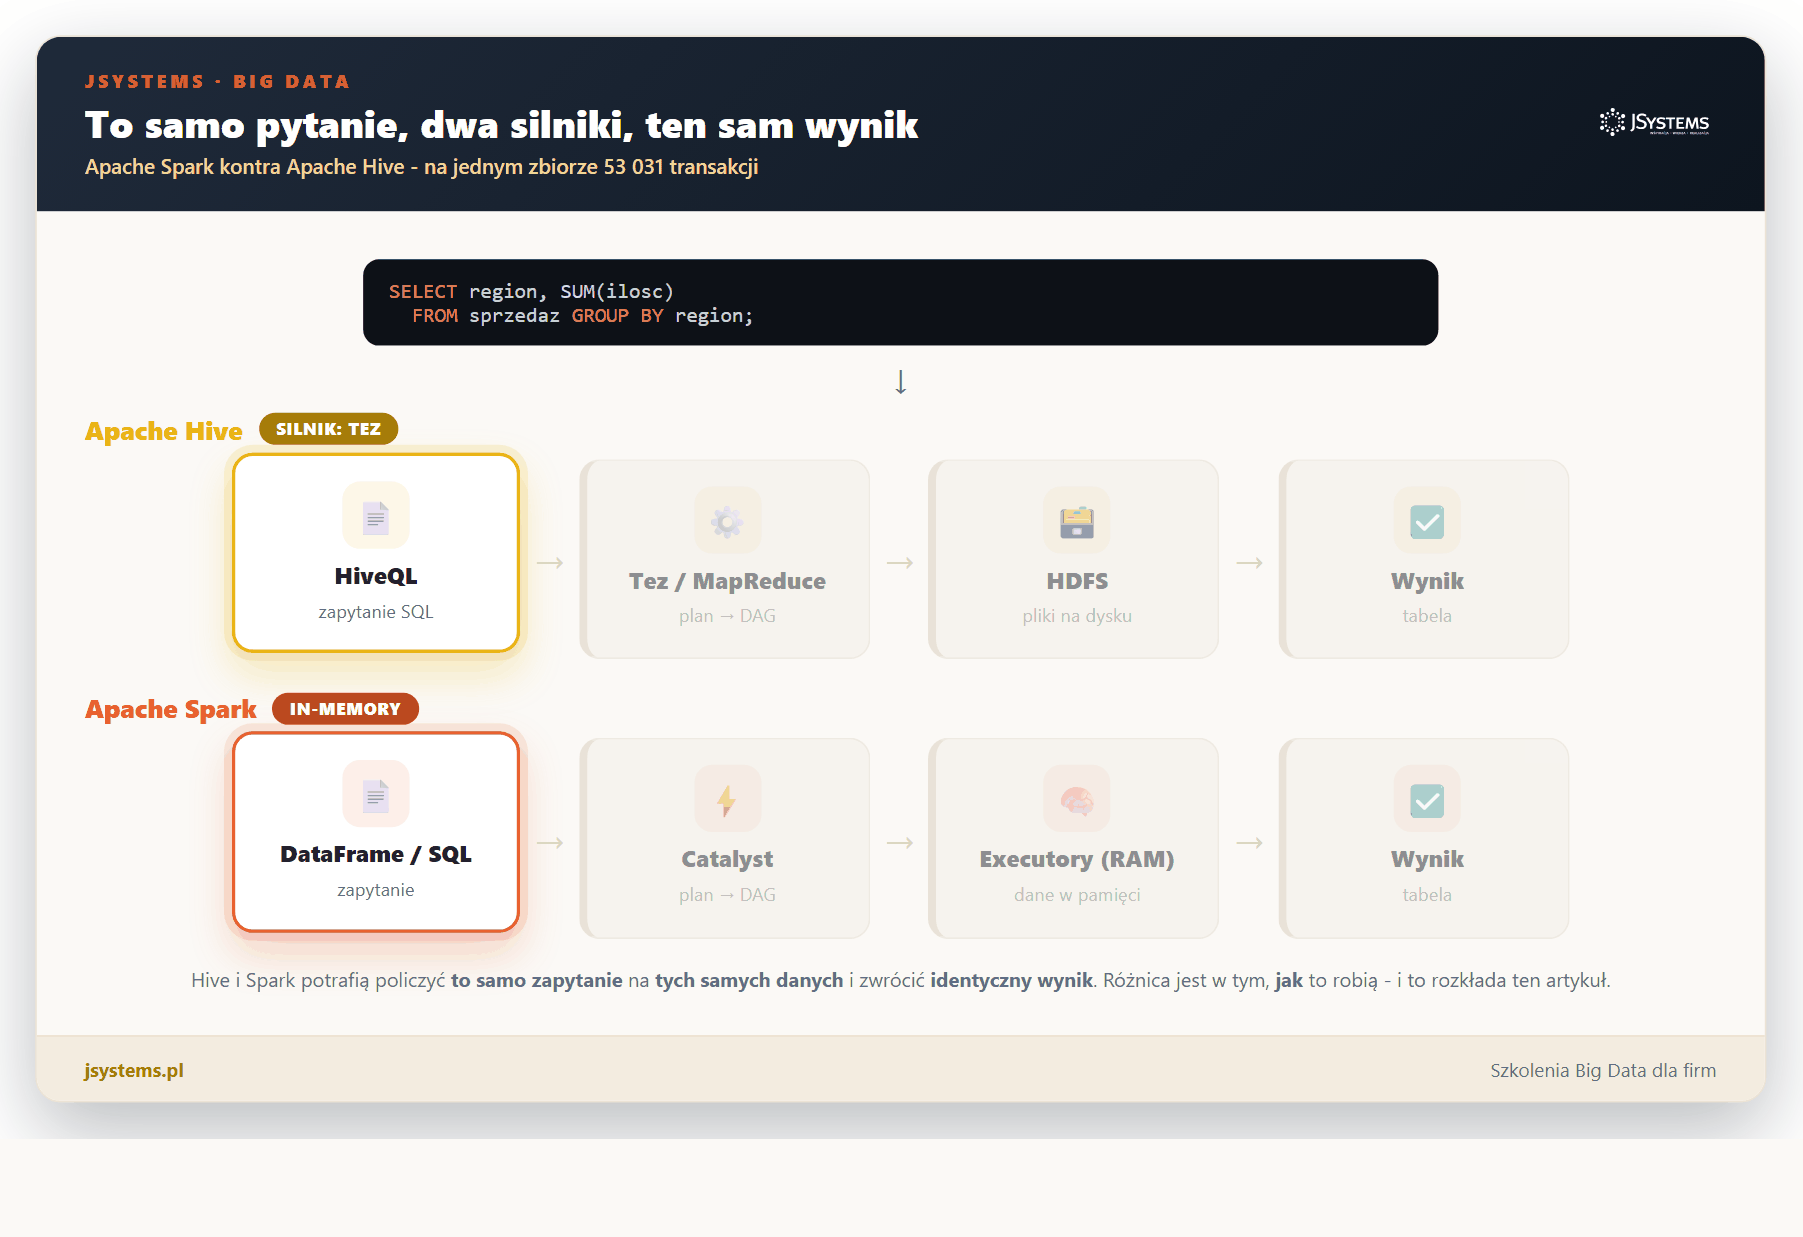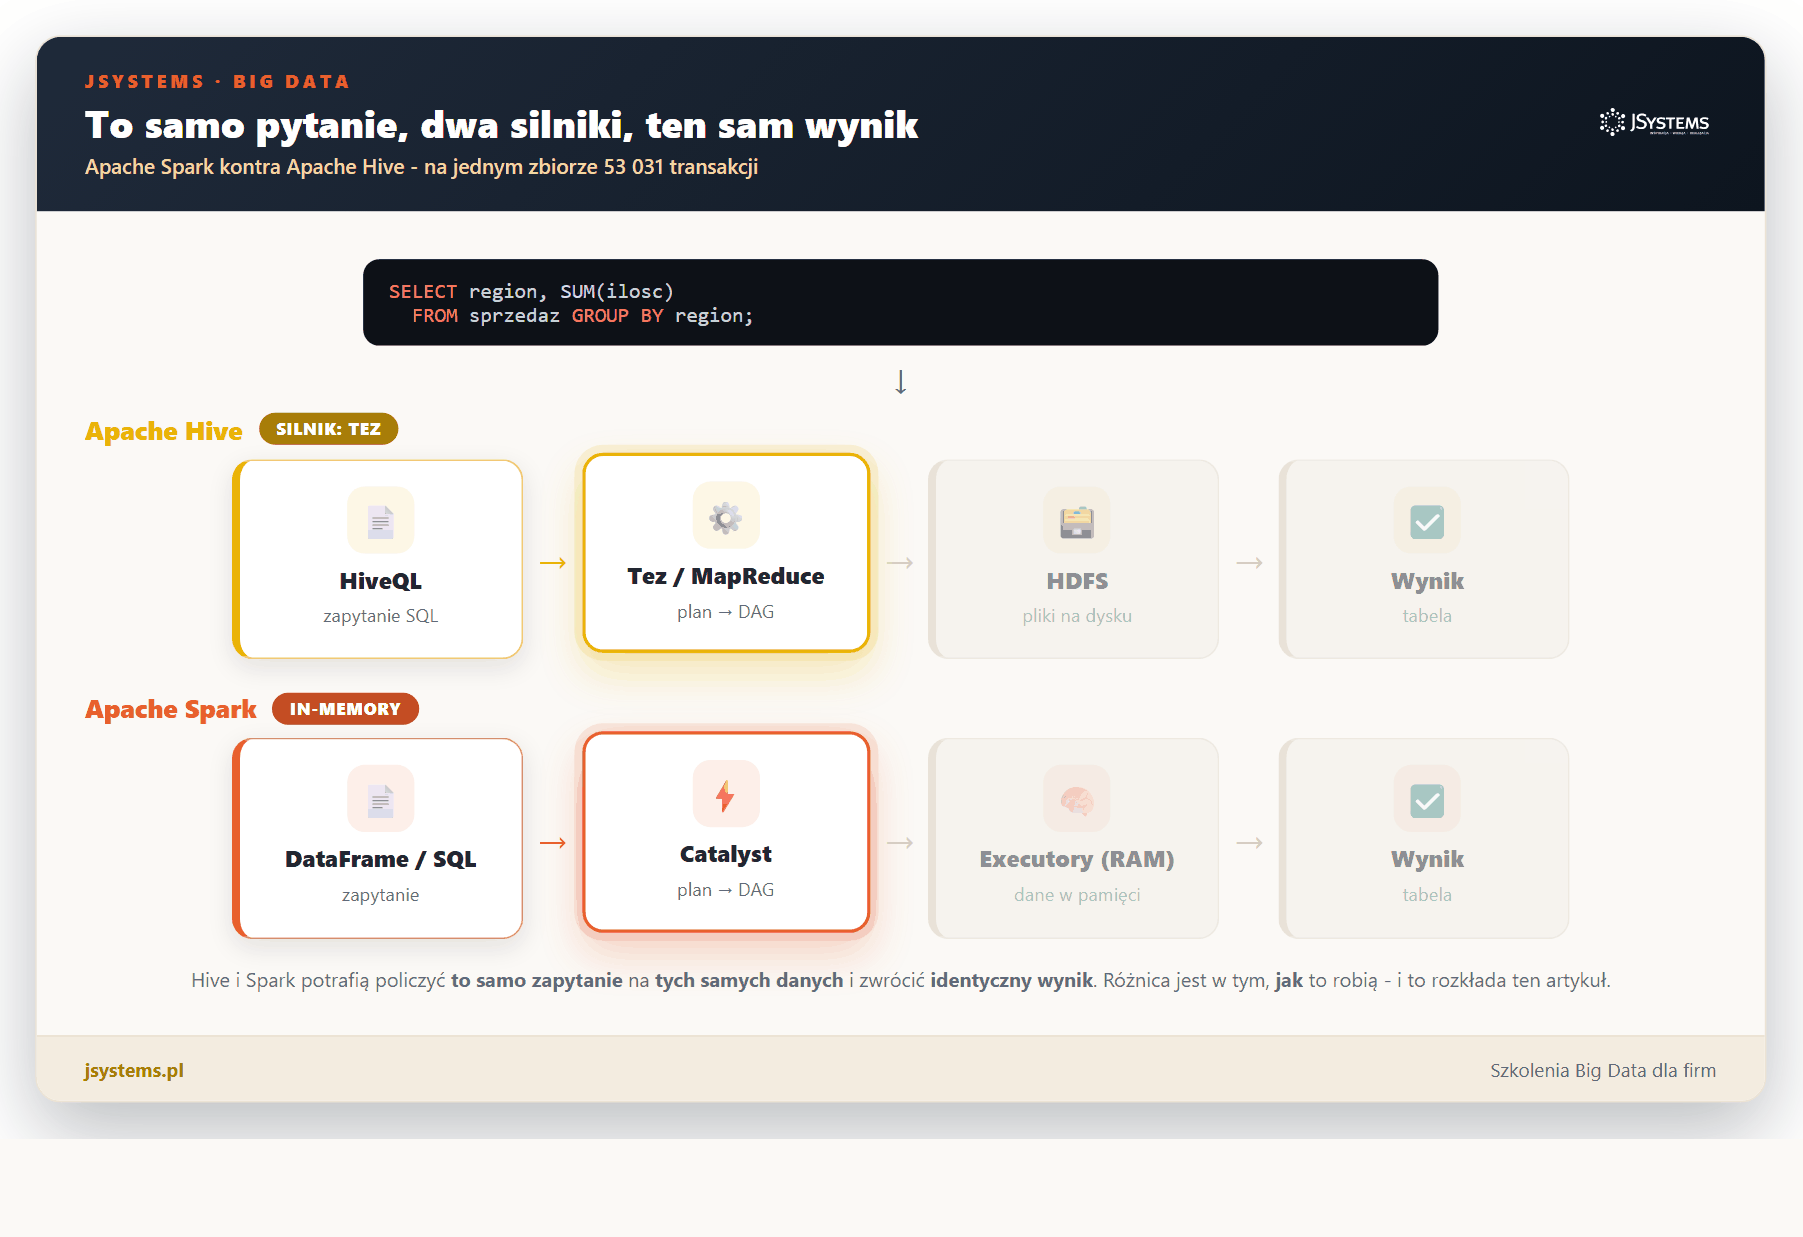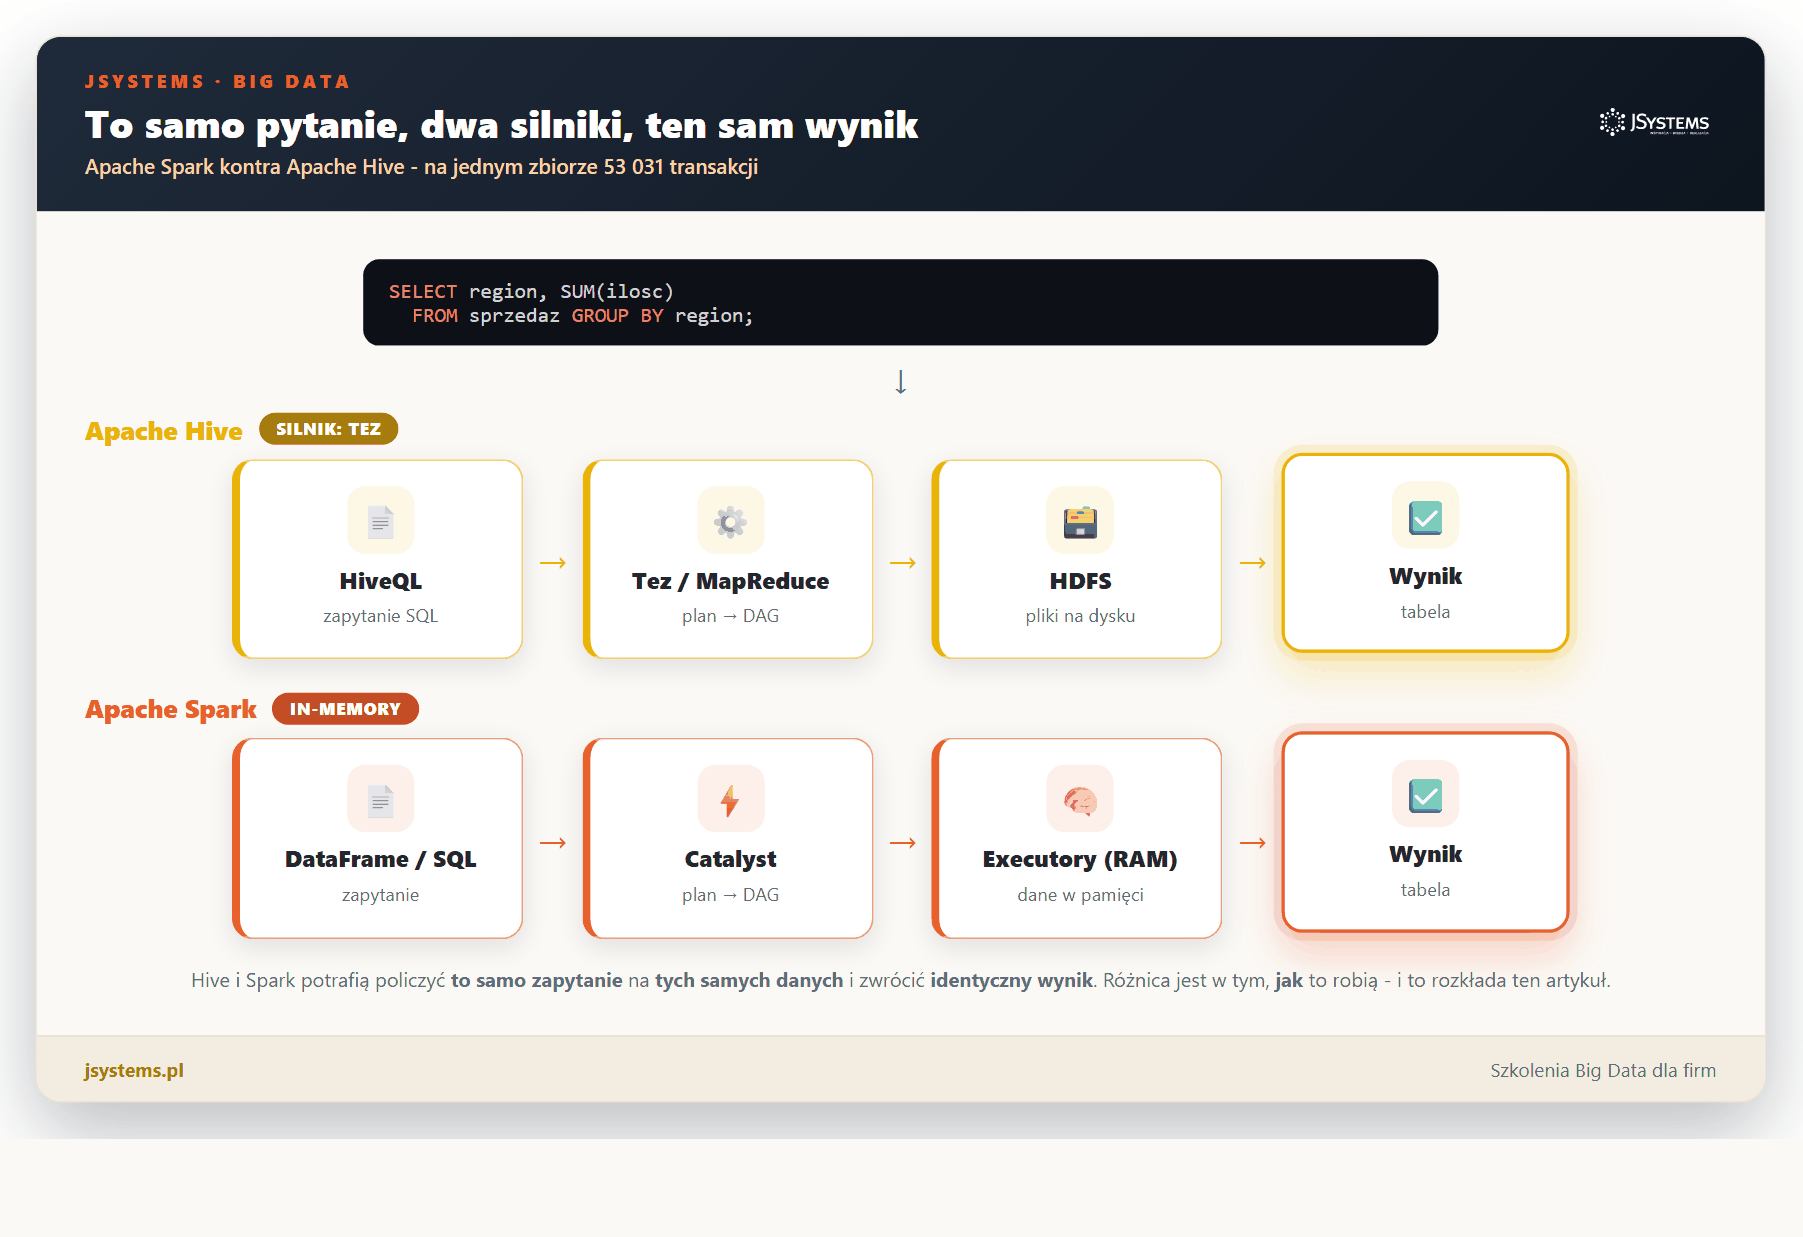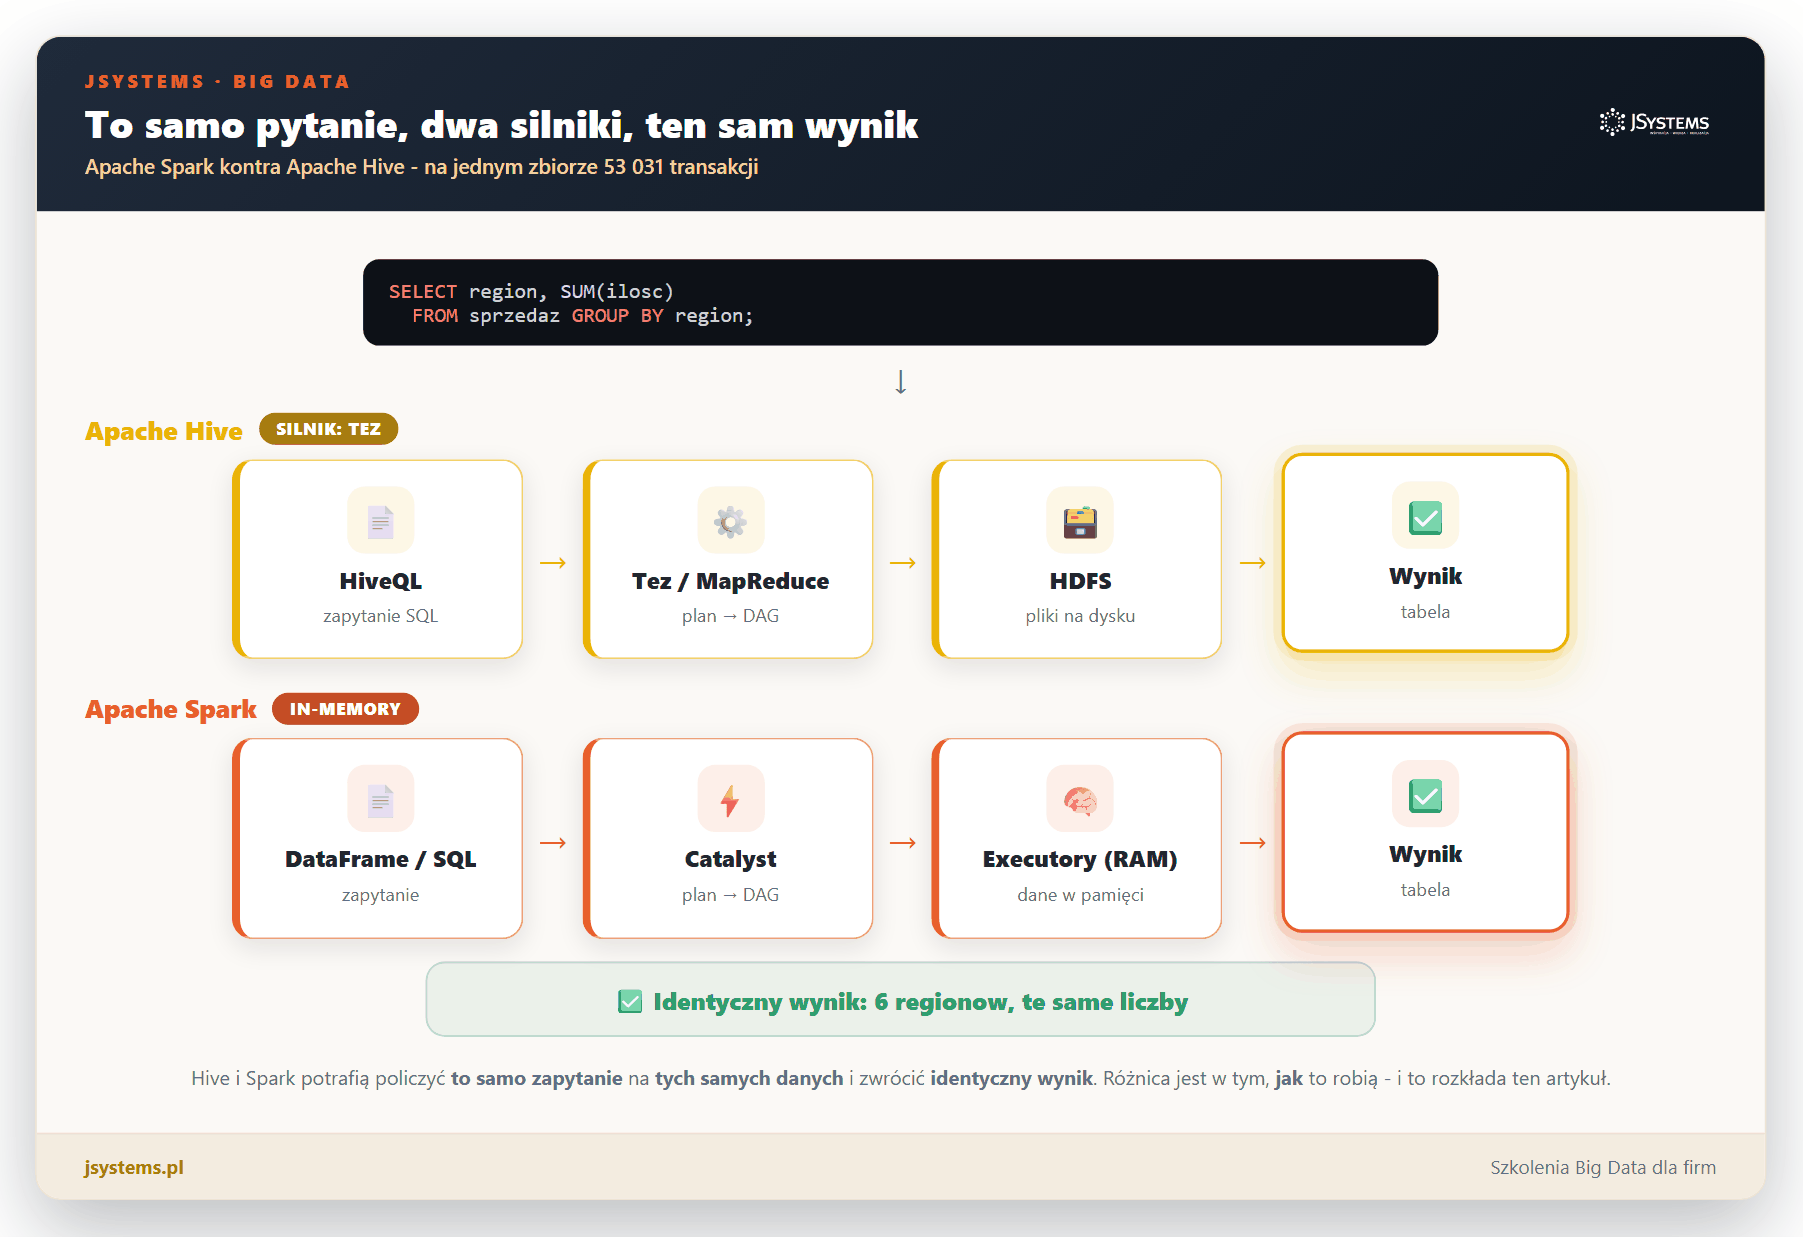
Oba narzędzia mają warstwę klienta, optymalizator zapytań, warstwę wykonania i warstwę zasobów - ale rozkładają akcenty inaczej. Poniższa infografika stawia obie architektury obok siebie.
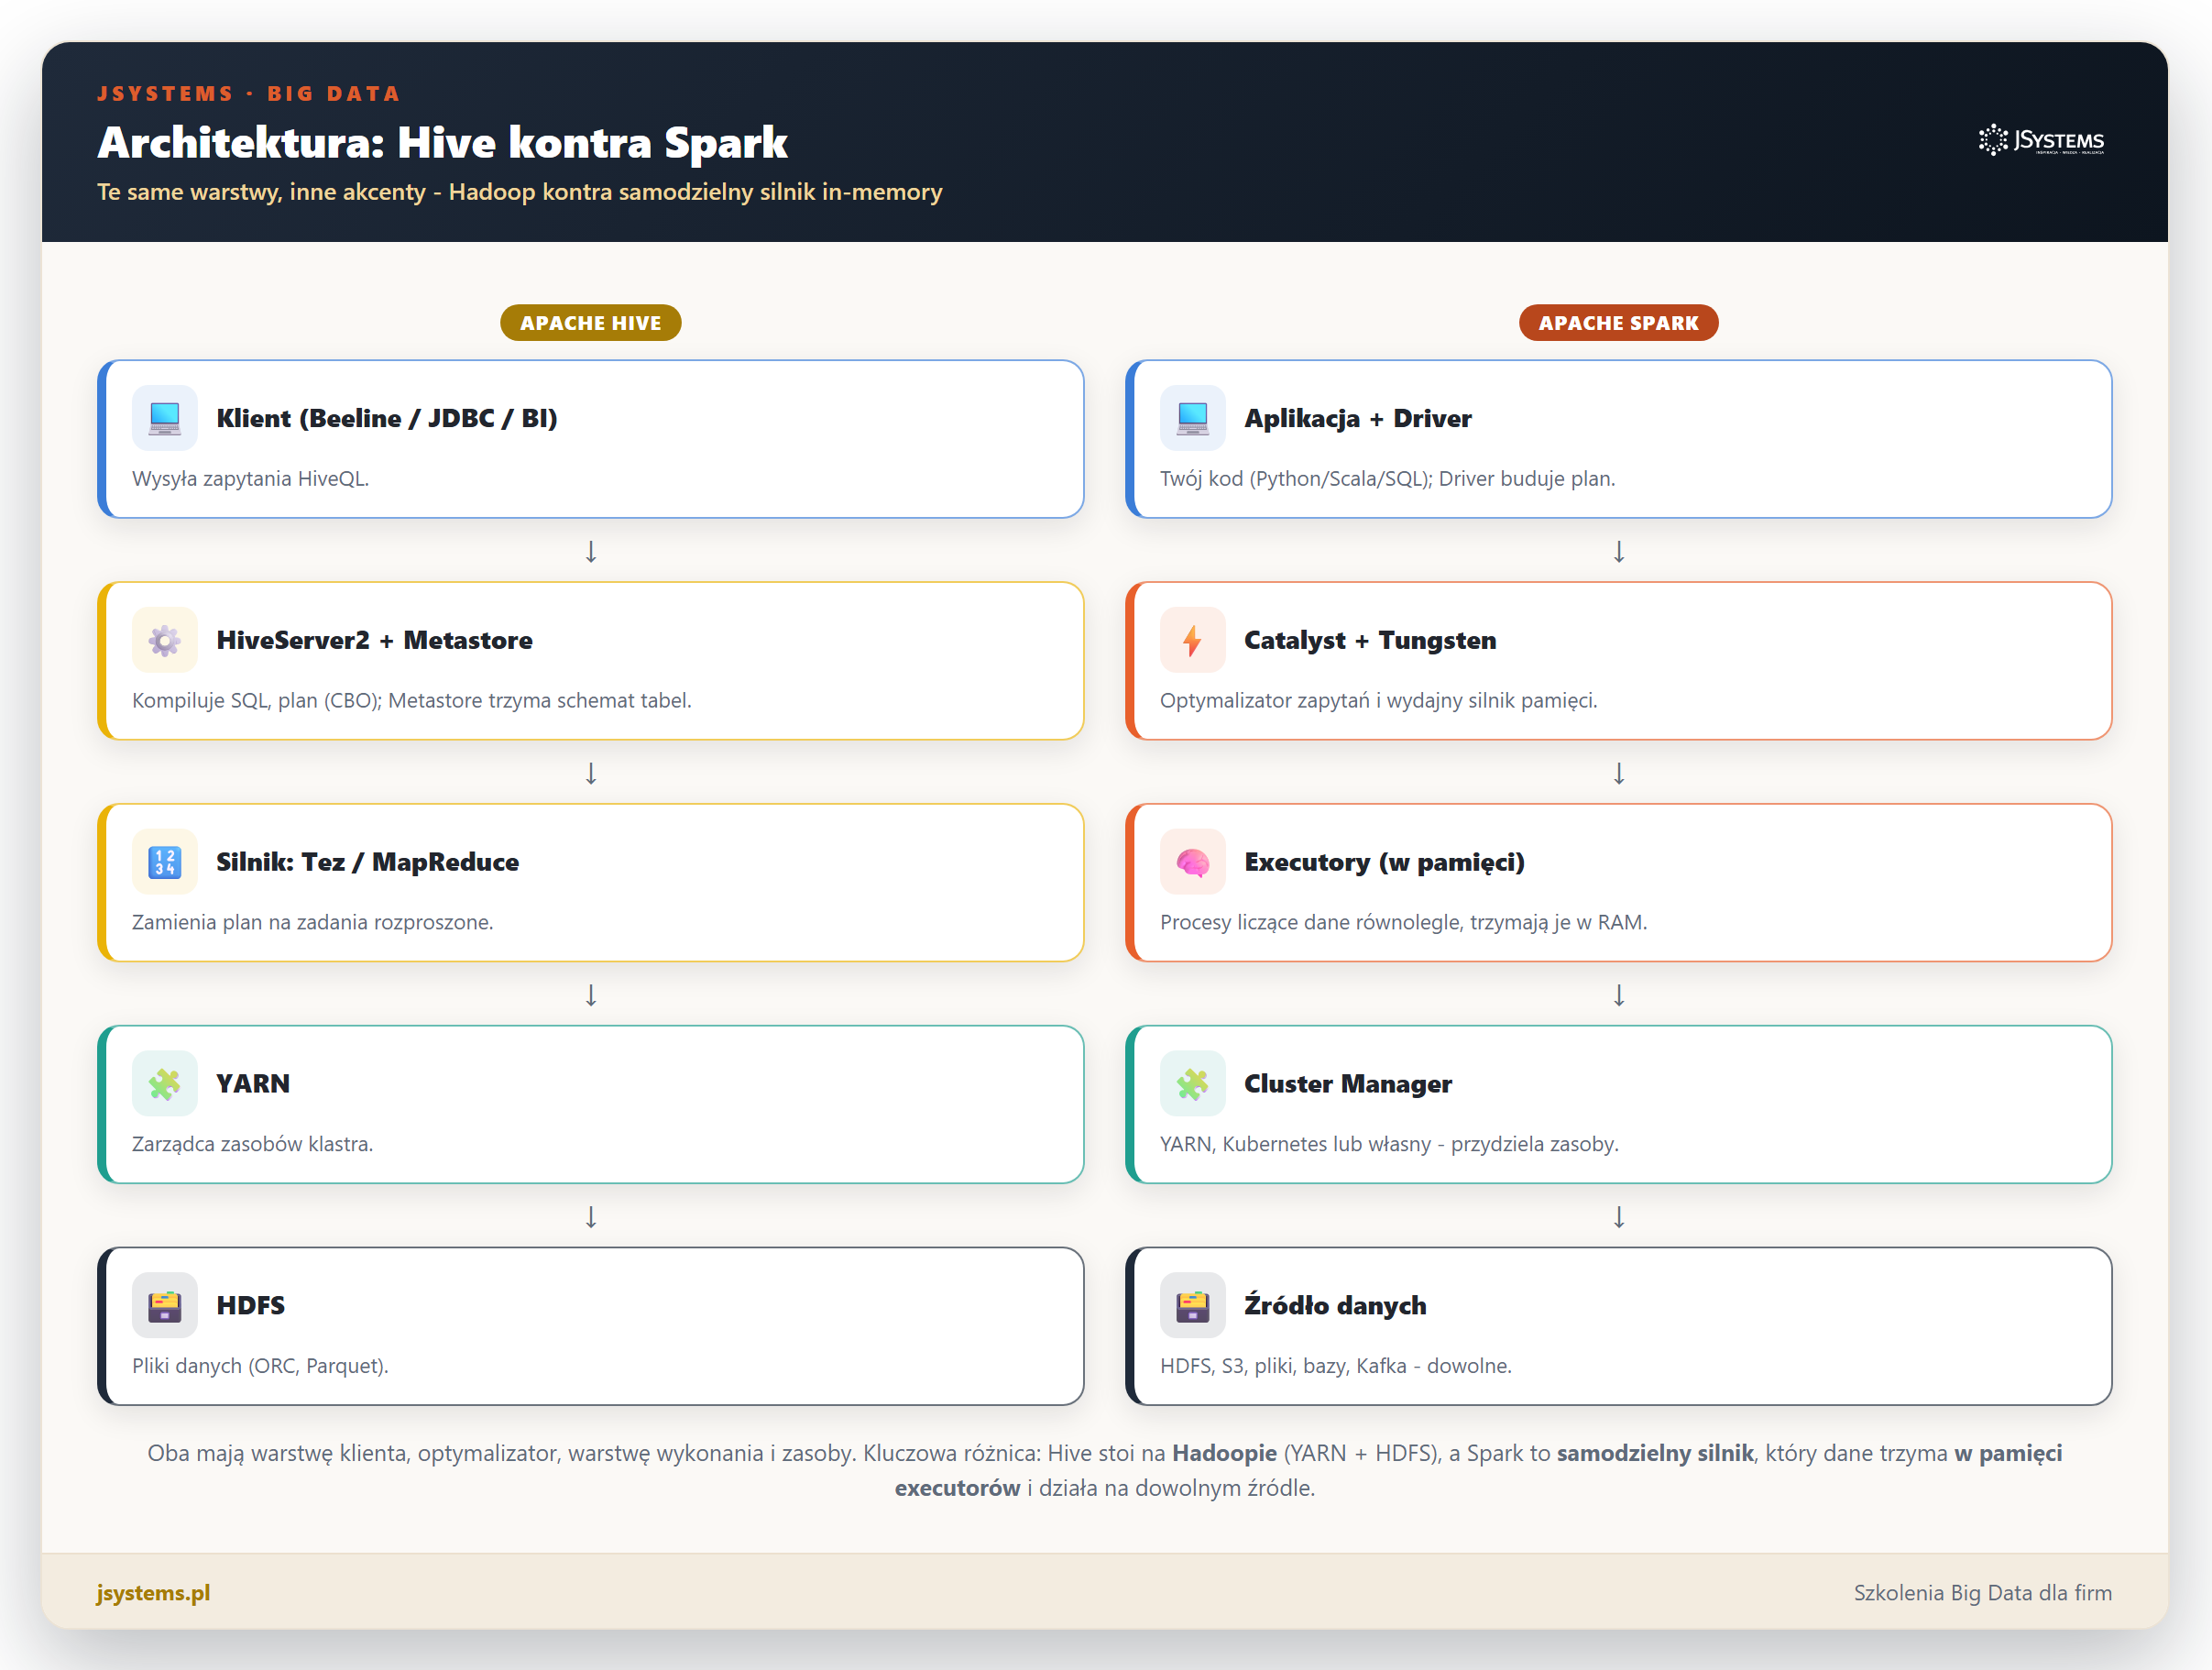
Kluczowa różnica jest taka: Hive to warstwa SQL nad Hadoopem - potrzebuje YARN do zasobów i HDFS do danych, a swój plan oddaje silnikowi (dziś zwykle Tez). Spark jest samodzielny: sam zarządza wykonaniem przez Driver i Executory, dane trzyma w pamięci procesów wykonawczych, a zasobami może dzielić YARN, Kubernetes albo jego własny menedżer. Spark nie potrzebuje Hive ani nawet Hadoopa, żeby działać.
Tu leży serce różnicy w wydajności. Klasyczny MapReduce, na którym wyrósł Hive, po każdym kroku zapisywał wynik pośredni na dysk i czytał go z powrotem w kroku następnym. Przy wielokrokowych obliczeniach to mnóstwo operacji wejścia-wyjścia. Spark zaprojektowano tak, by dane pomiędzy krokami zostawały w pamięci (RAM), co przy złożonych i iteracyjnych potokach potrafi dać ogromną oszczędność.
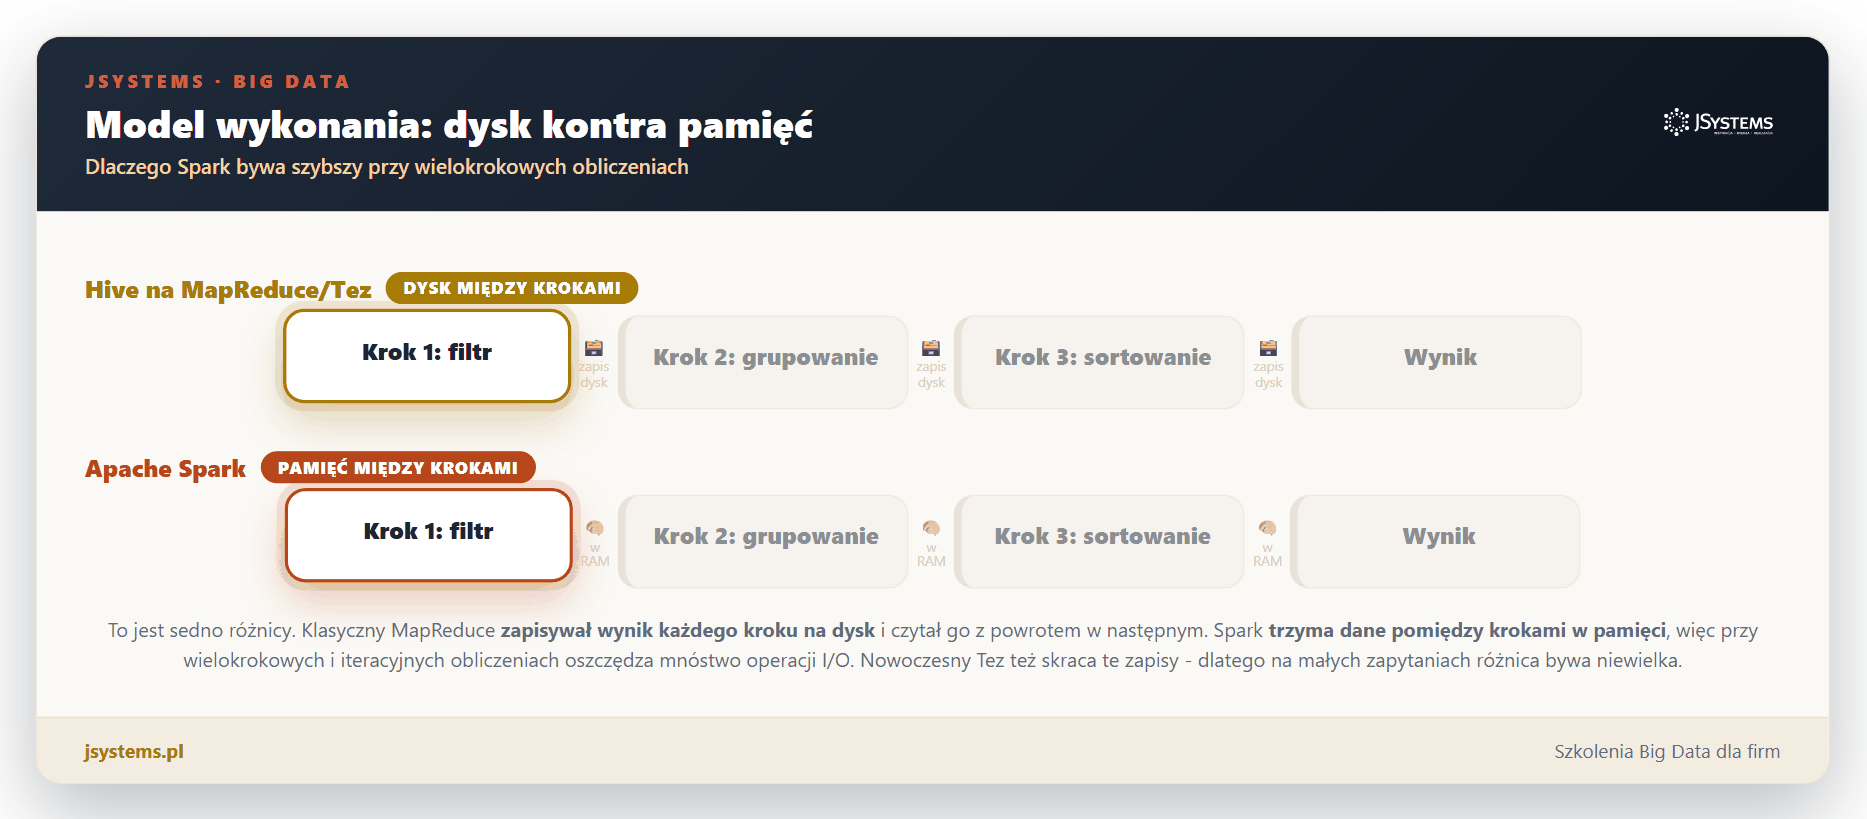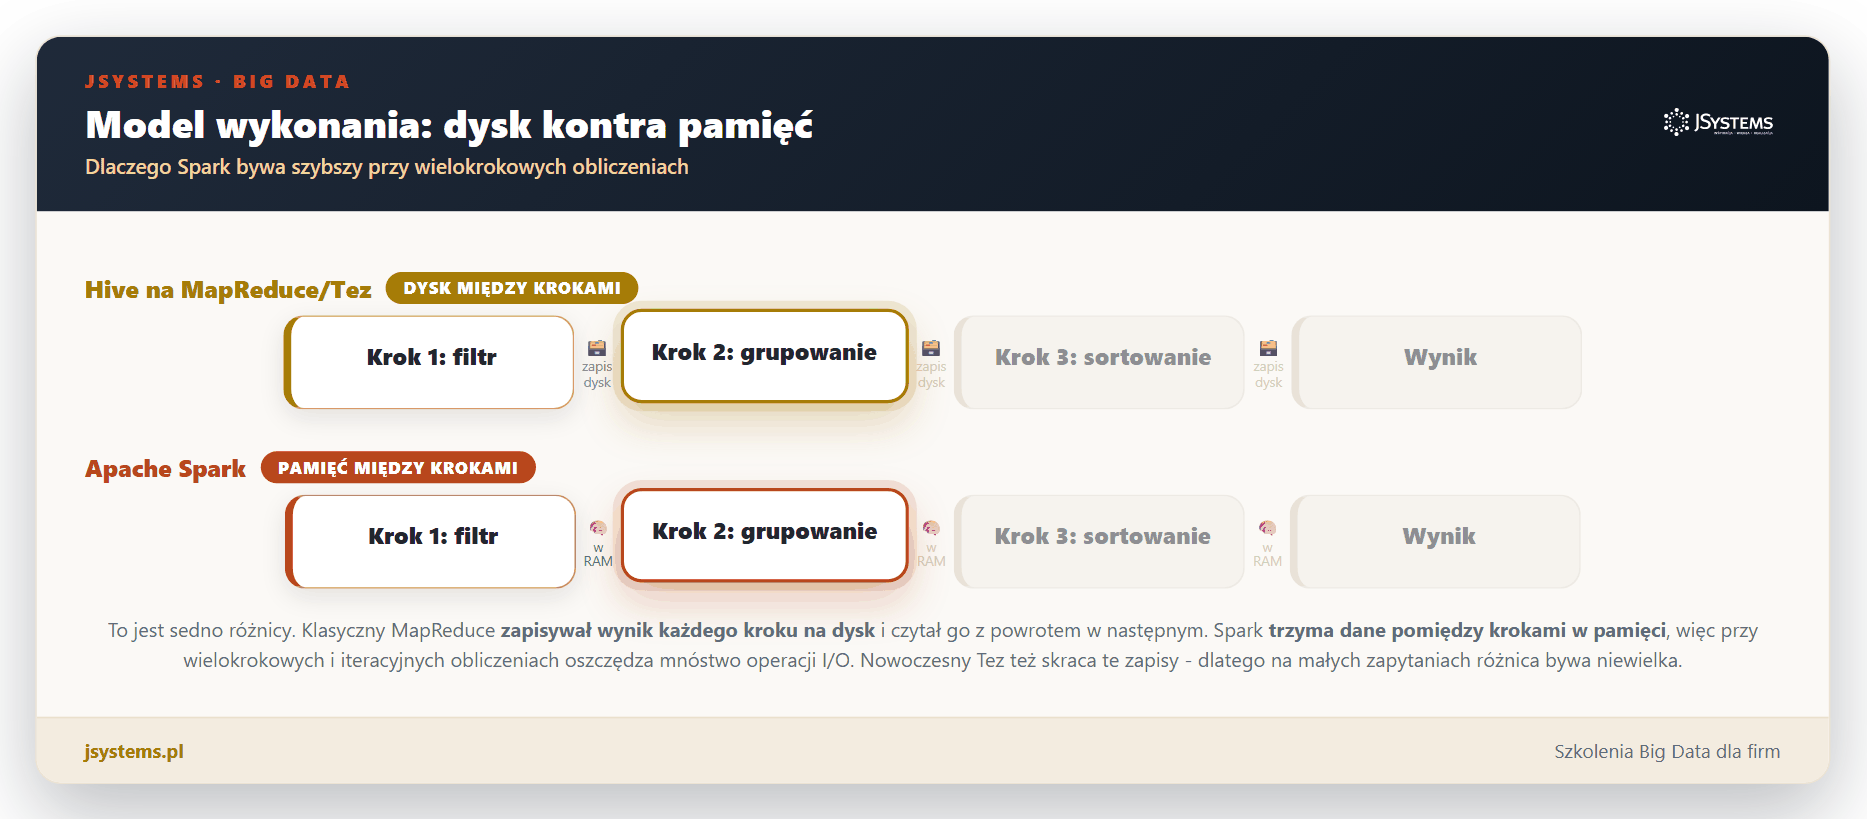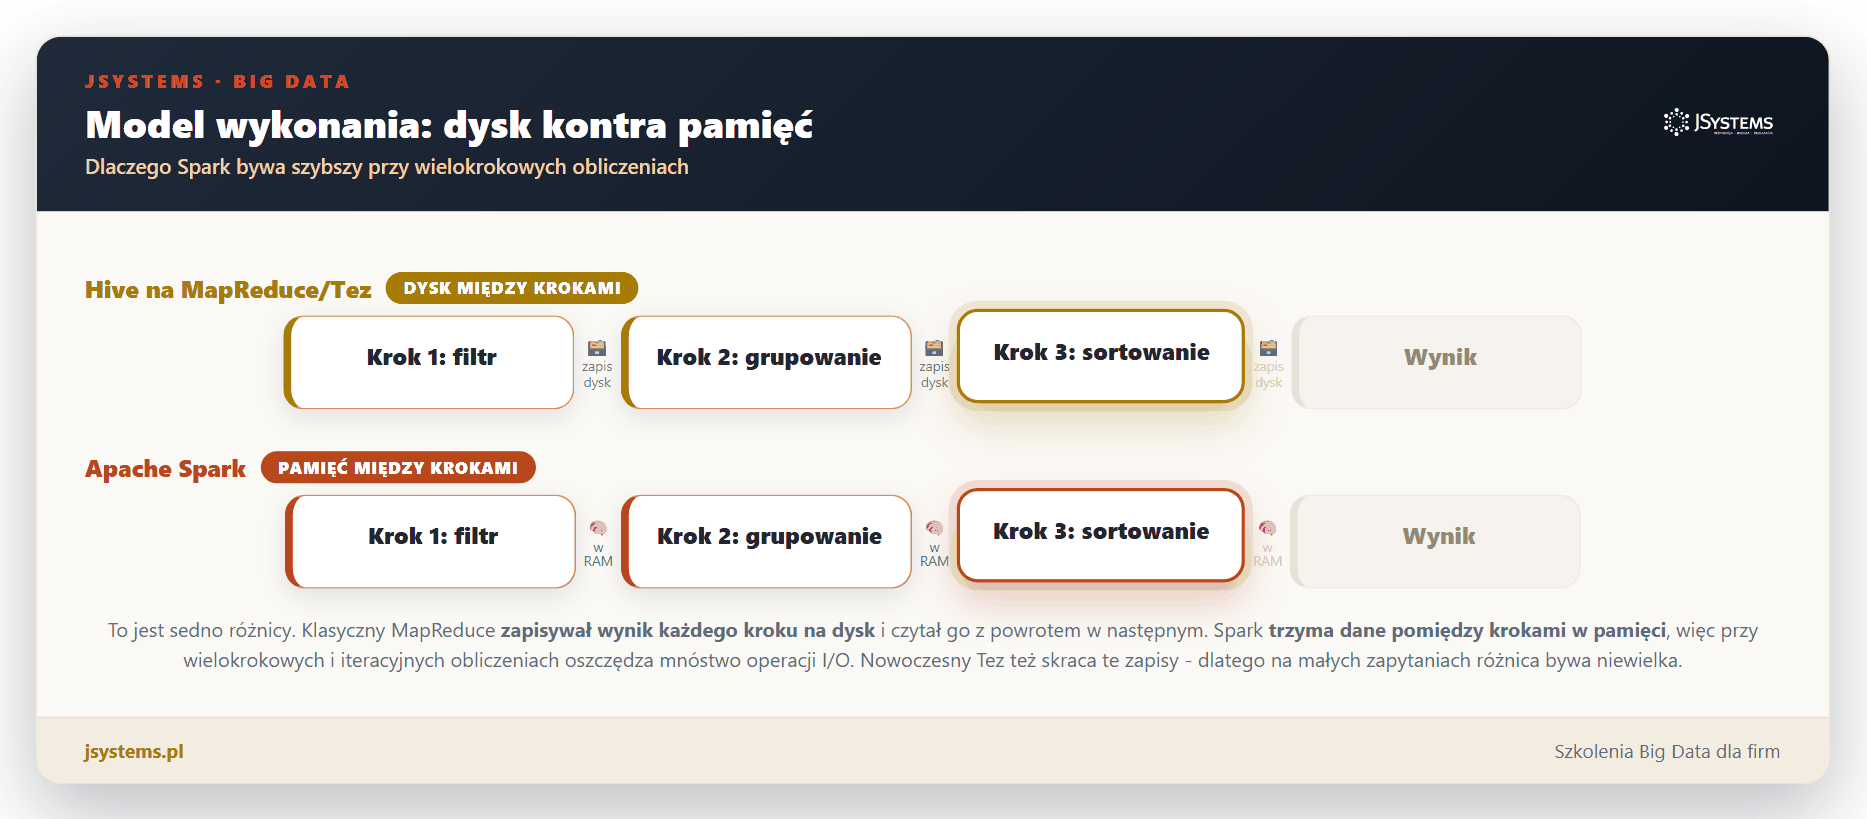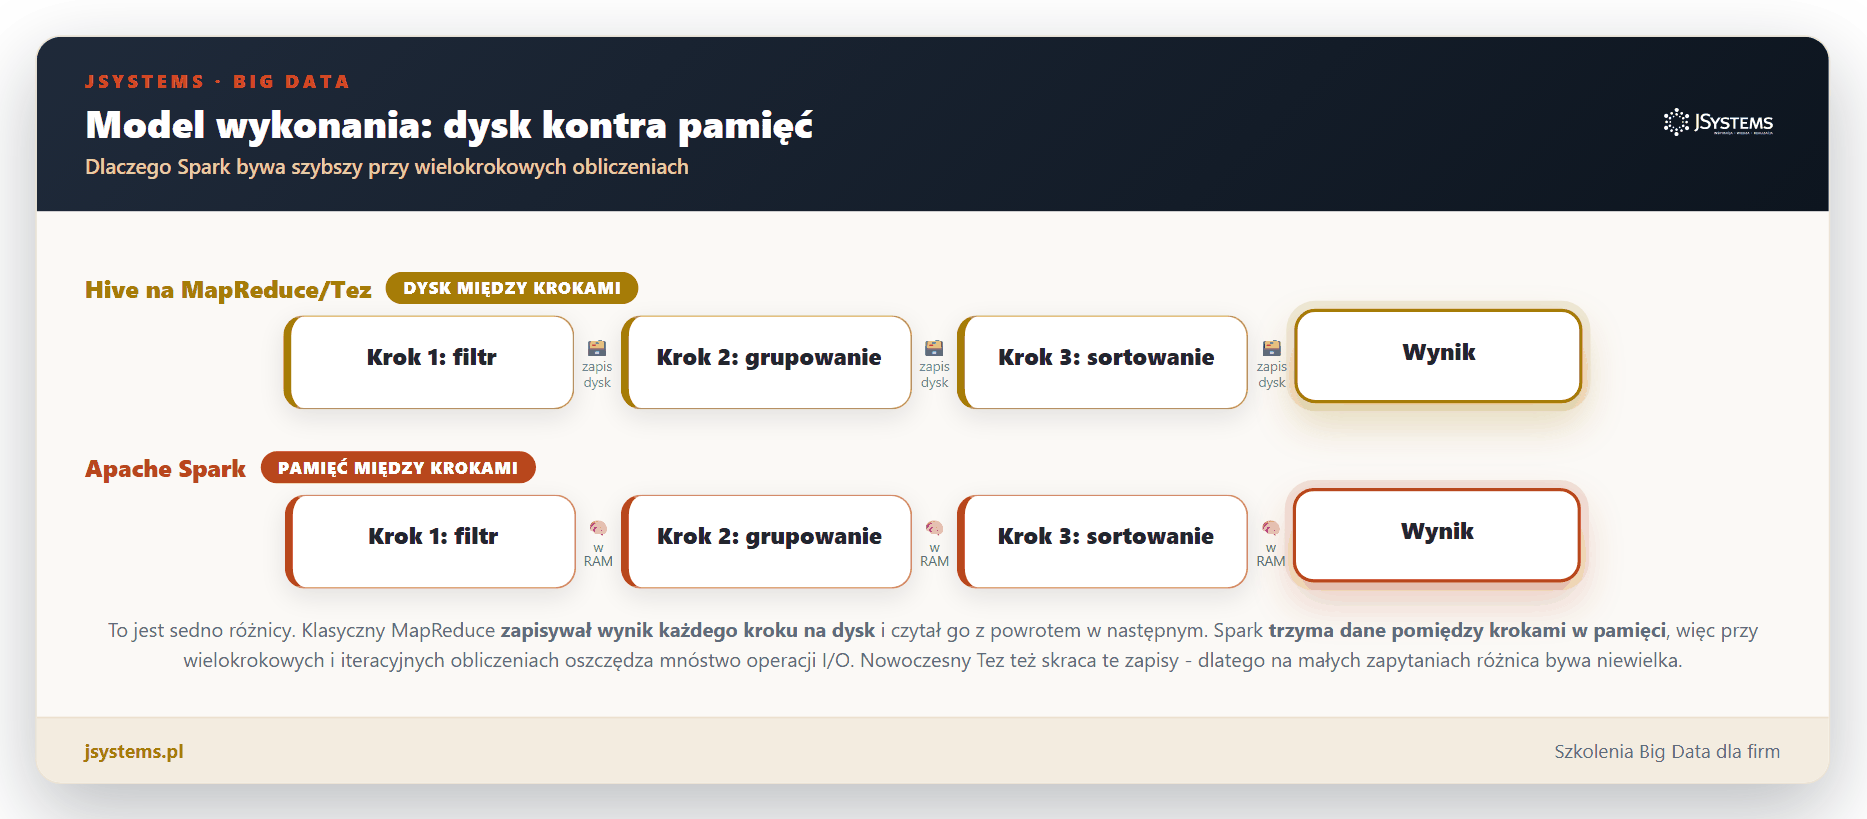
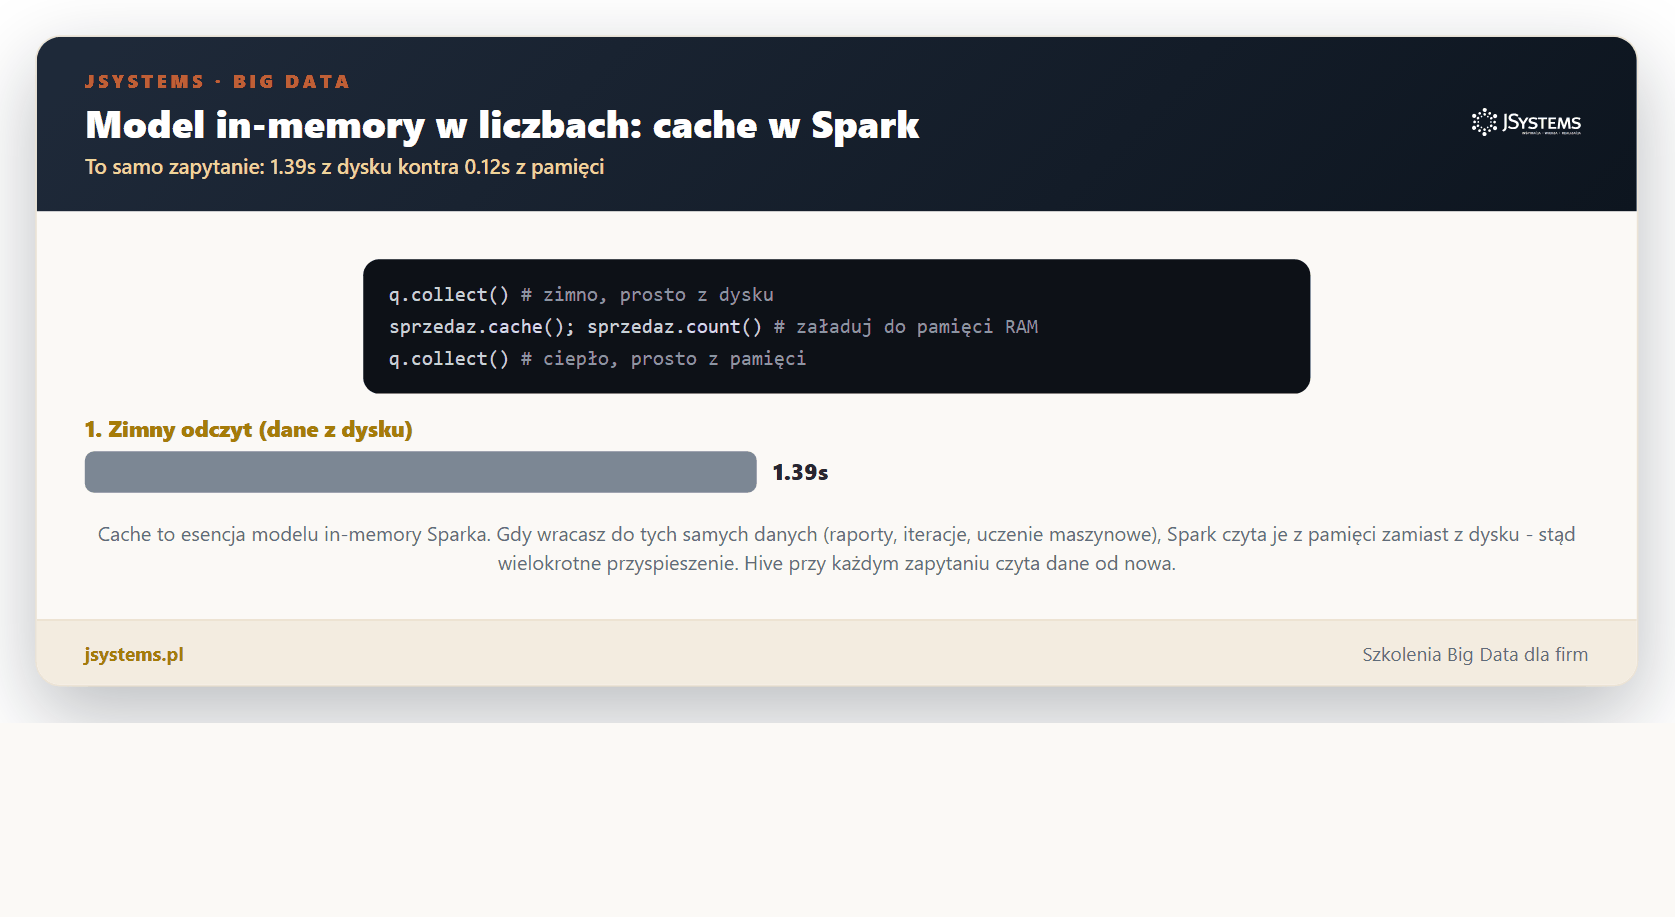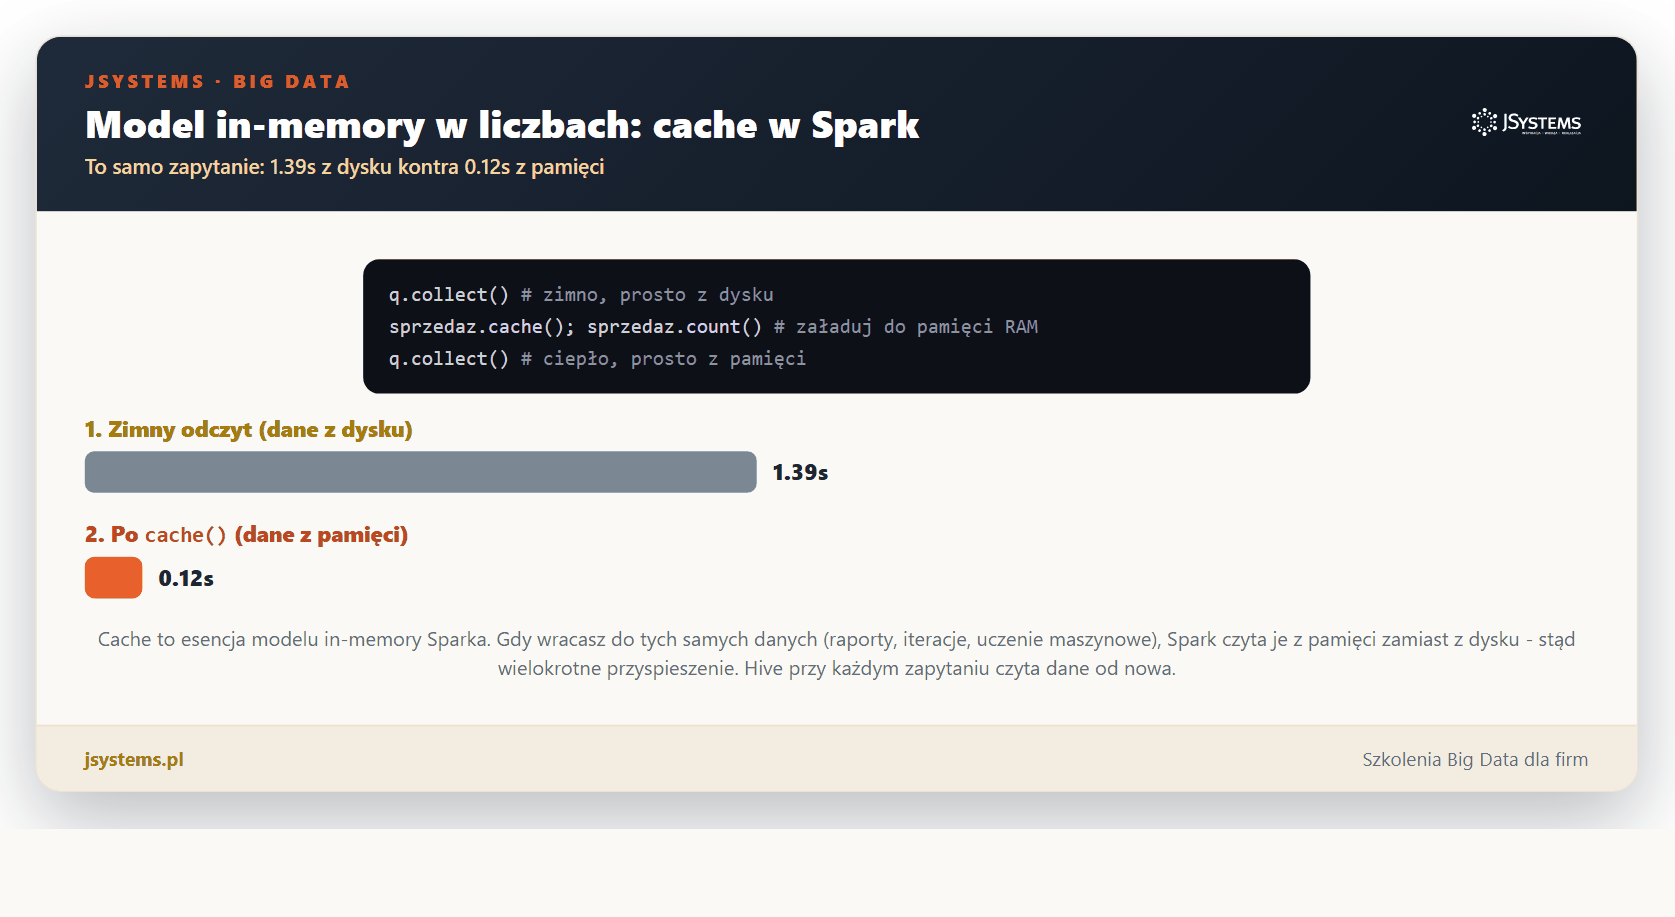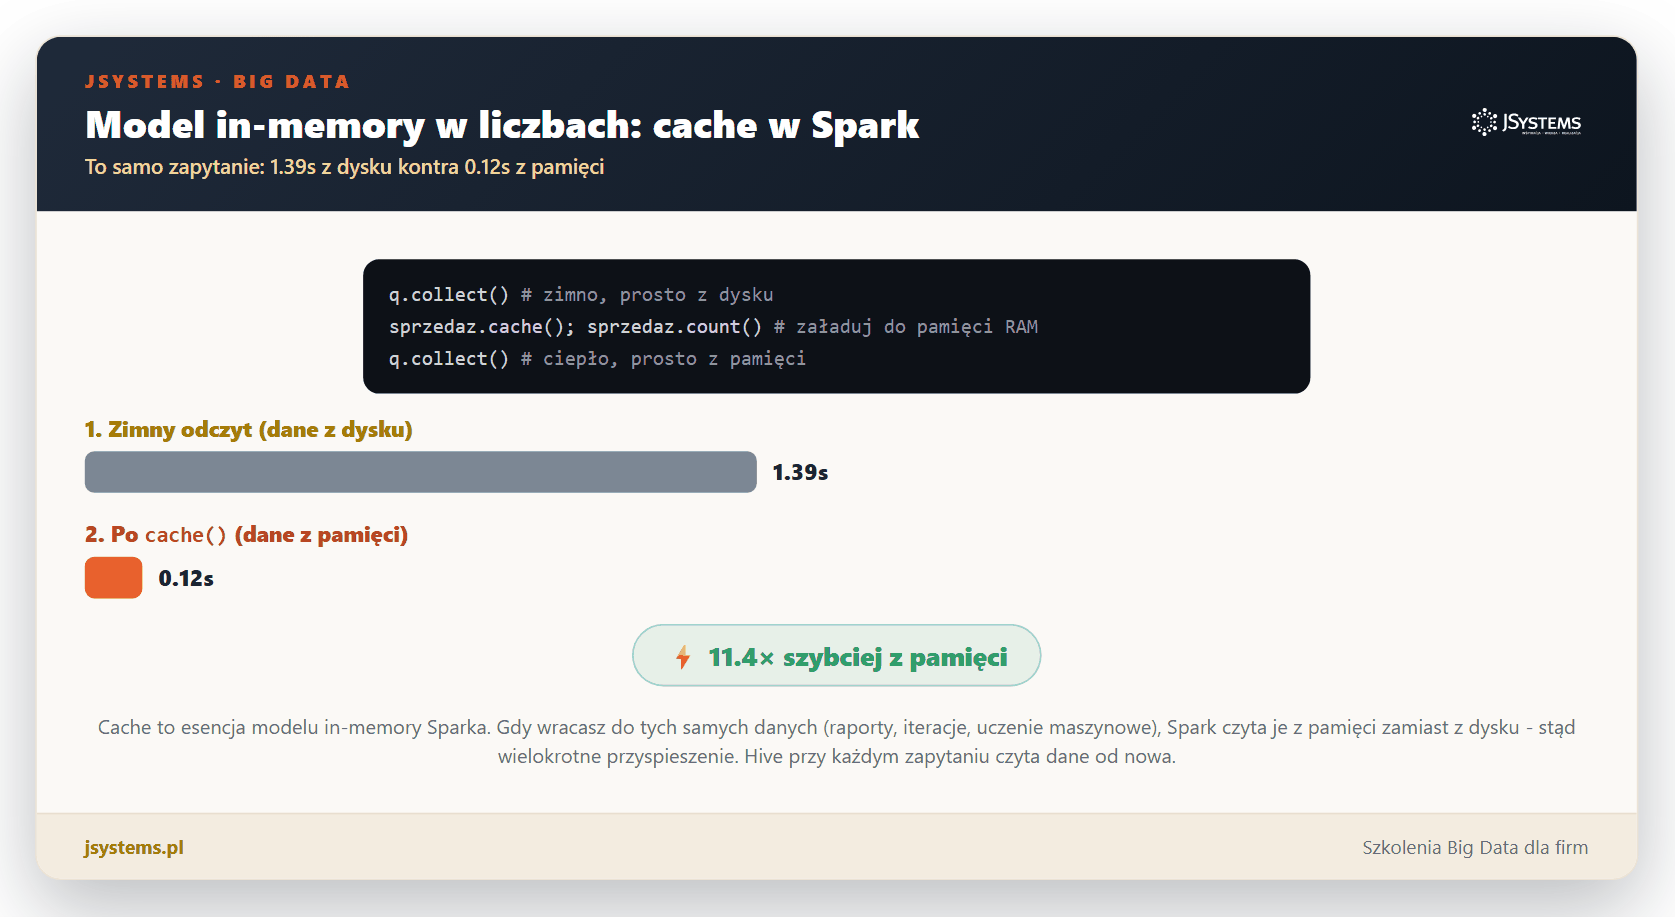
Najlepiej widać to na mechanizmie cache. Gdy wracasz do tych samych danych - co jest normą przy raportach, iteracjach i uczeniu maszynowym - Spark potrafi trzymać je w pamięci i nie czytać ponownie z dysku. W naszym demo to samo zapytanie z pamięci policzyło się ponad jedenaście razy szybciej niż z dysku.
To właśnie ta cecha zbudowała pozycję Sparka. Jeśli chcesz nauczyć się budować takie potoki w praktyce - z realnymi zadaniami na dużych zbiorach, a nie tylko w teorii - to najkrótsza droga do tego, by z Big Data zacząć realnie korzystać.
Chcesz przetwarzać duże zbiory danych w praktyce? Szkolenie Big Data: Przetwarzanie danych Big Data z Apache Spark ma terminy gwarantowane.
W Hive masz jeden język: HiveQL, czyli dialekt SQL. To jego wielka zaleta - każdy, kto zna SQL, jest w domu. Spark daje wybór. Możesz pisać identyczny SQL, a możesz sięgnąć po DataFrame API w Pythonie, Scali czy Javie, które pozwala budować transformacje jak w kodzie. Poniżej to samo pytanie zadane w Sparku czystym SQL - składnia praktycznie nie różni się od HiveQL.
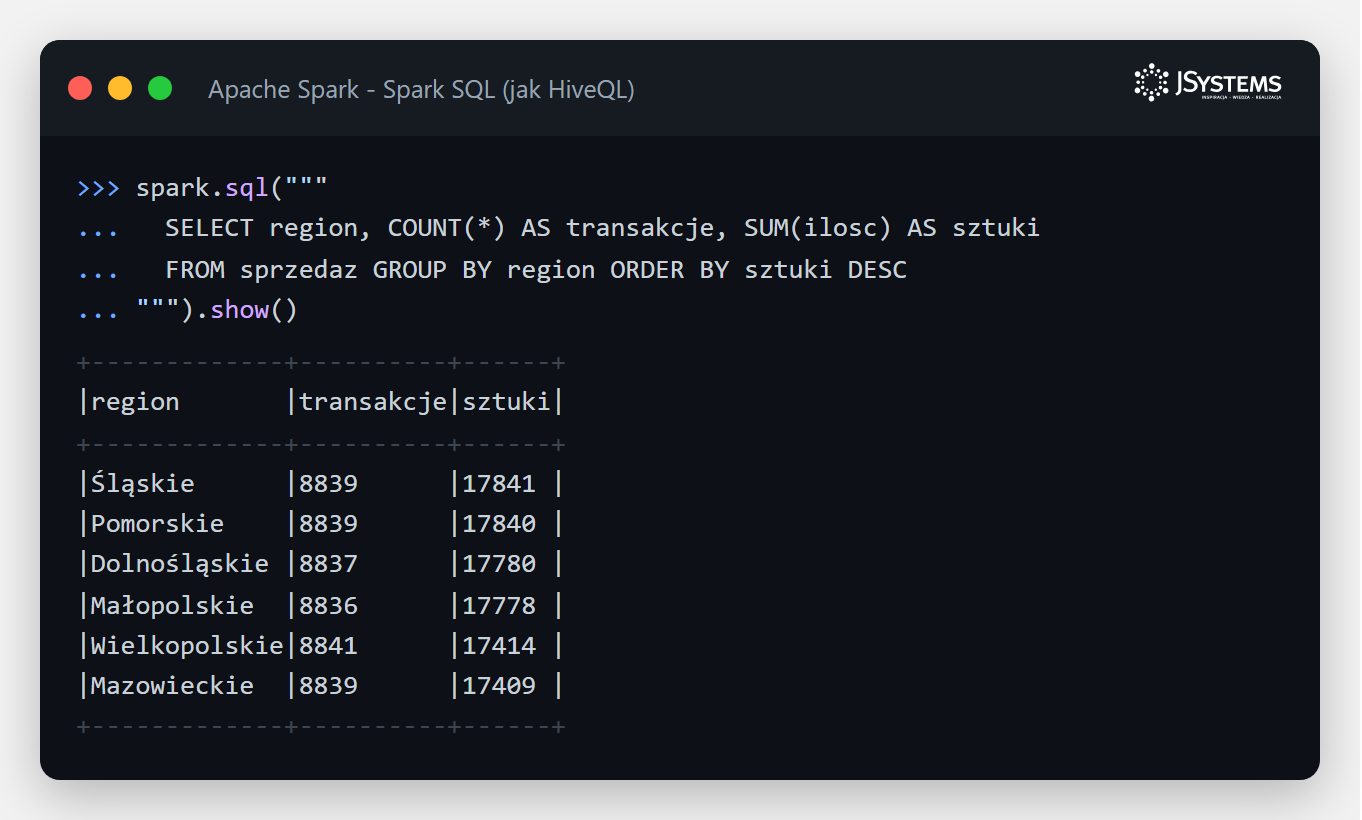
W praktyce oba style łączy się swobodnie. Poniższy fragment pokazuje, że w Sparku ten sam wynik osiągniesz i przez API, i przez SQL - to kwestia wygody, nie ograniczeń.
# Spark: nakładamy schemat na surowy plik CSV (schema-on-read)
sprzedaz = spark.read.csv("sprzedaz.csv", schema=schemat)
sprzedaz.createOrReplaceTempView("sprzedaz")

# to samo pytanie można zadać dwoma stylami:
# 1) DataFrame API
sprzedaz.groupBy("region").agg(sum("ilosc")).show()
# 2) czysty SQL - składnia jak w HiveQL
spark.sql("SELECT region, SUM(ilosc) FROM sprzedaz GROUP BY region").show()
Ta wszechstronność bywa też pułapką dla początkujących: więcej możliwości to większa krzywa wejścia. Dlatego solidne podstawy SQL opłacają się niezależnie od silnika - to wspólny mianownik Hive, Spark SQL i każdej hurtowni danych. Wyniki takich zapytań często trafiają potem do dalszej analizy danych w Pythonie z biblioteką pandas albo do narzędzi raportowych.
Chcesz opanować Apache Hive i język HiveQL w praktyce - od podstaw po techniki zaawansowane? Zajrzyj na Szkolenie Big Data: Apache Hive - HiveQL od podstaw do technik zaawansowanych.
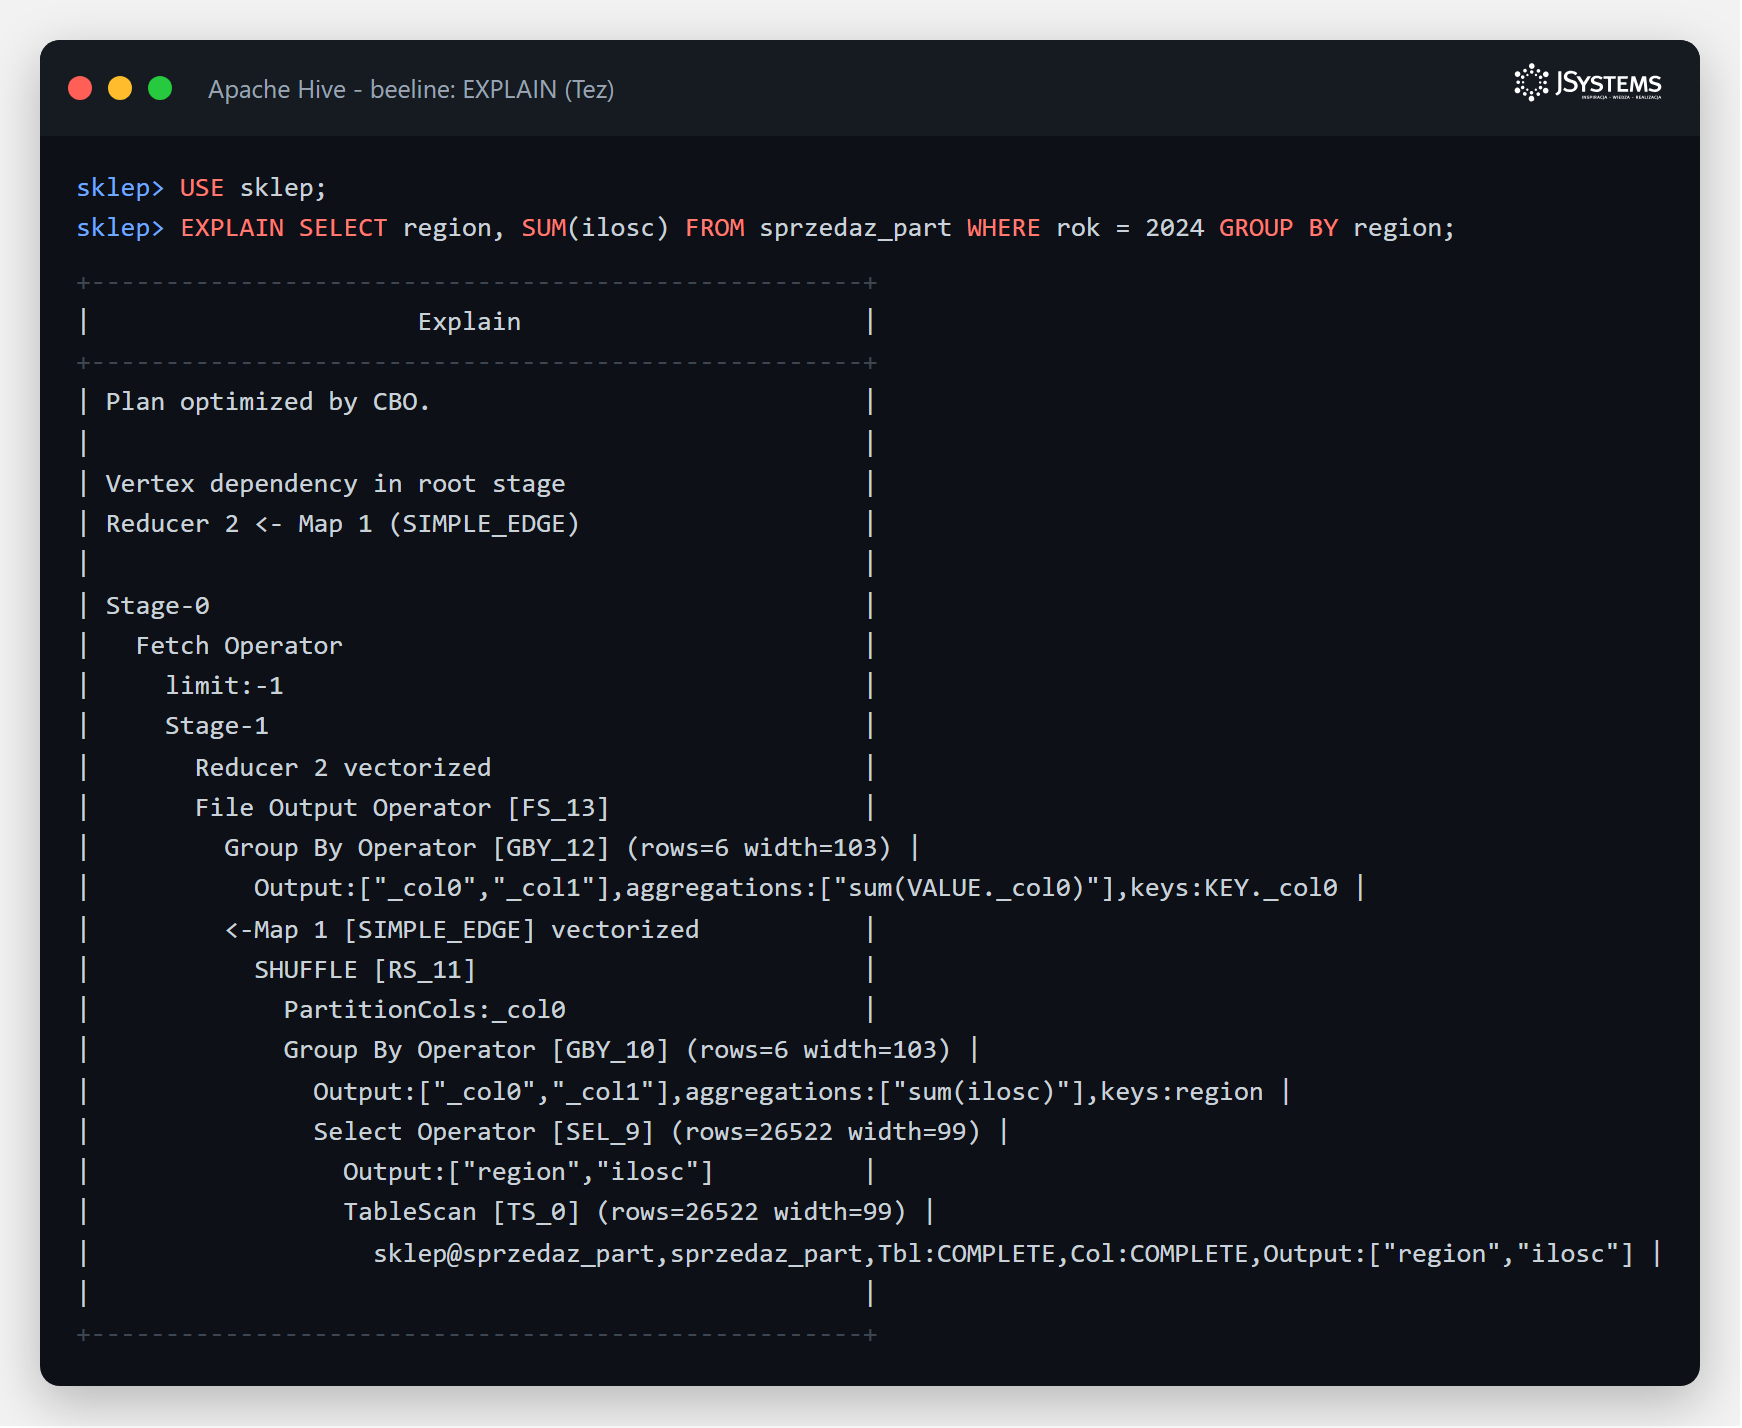
Oba narzędzia pokazują, jak zamierzają policzyć zapytanie, zanim je uruchomią. W Hive robi to polecenie EXPLAIN - poniżej plan na silniku Tez, z optymalizatorem kosztowym (CBO) i wektoryzacją.
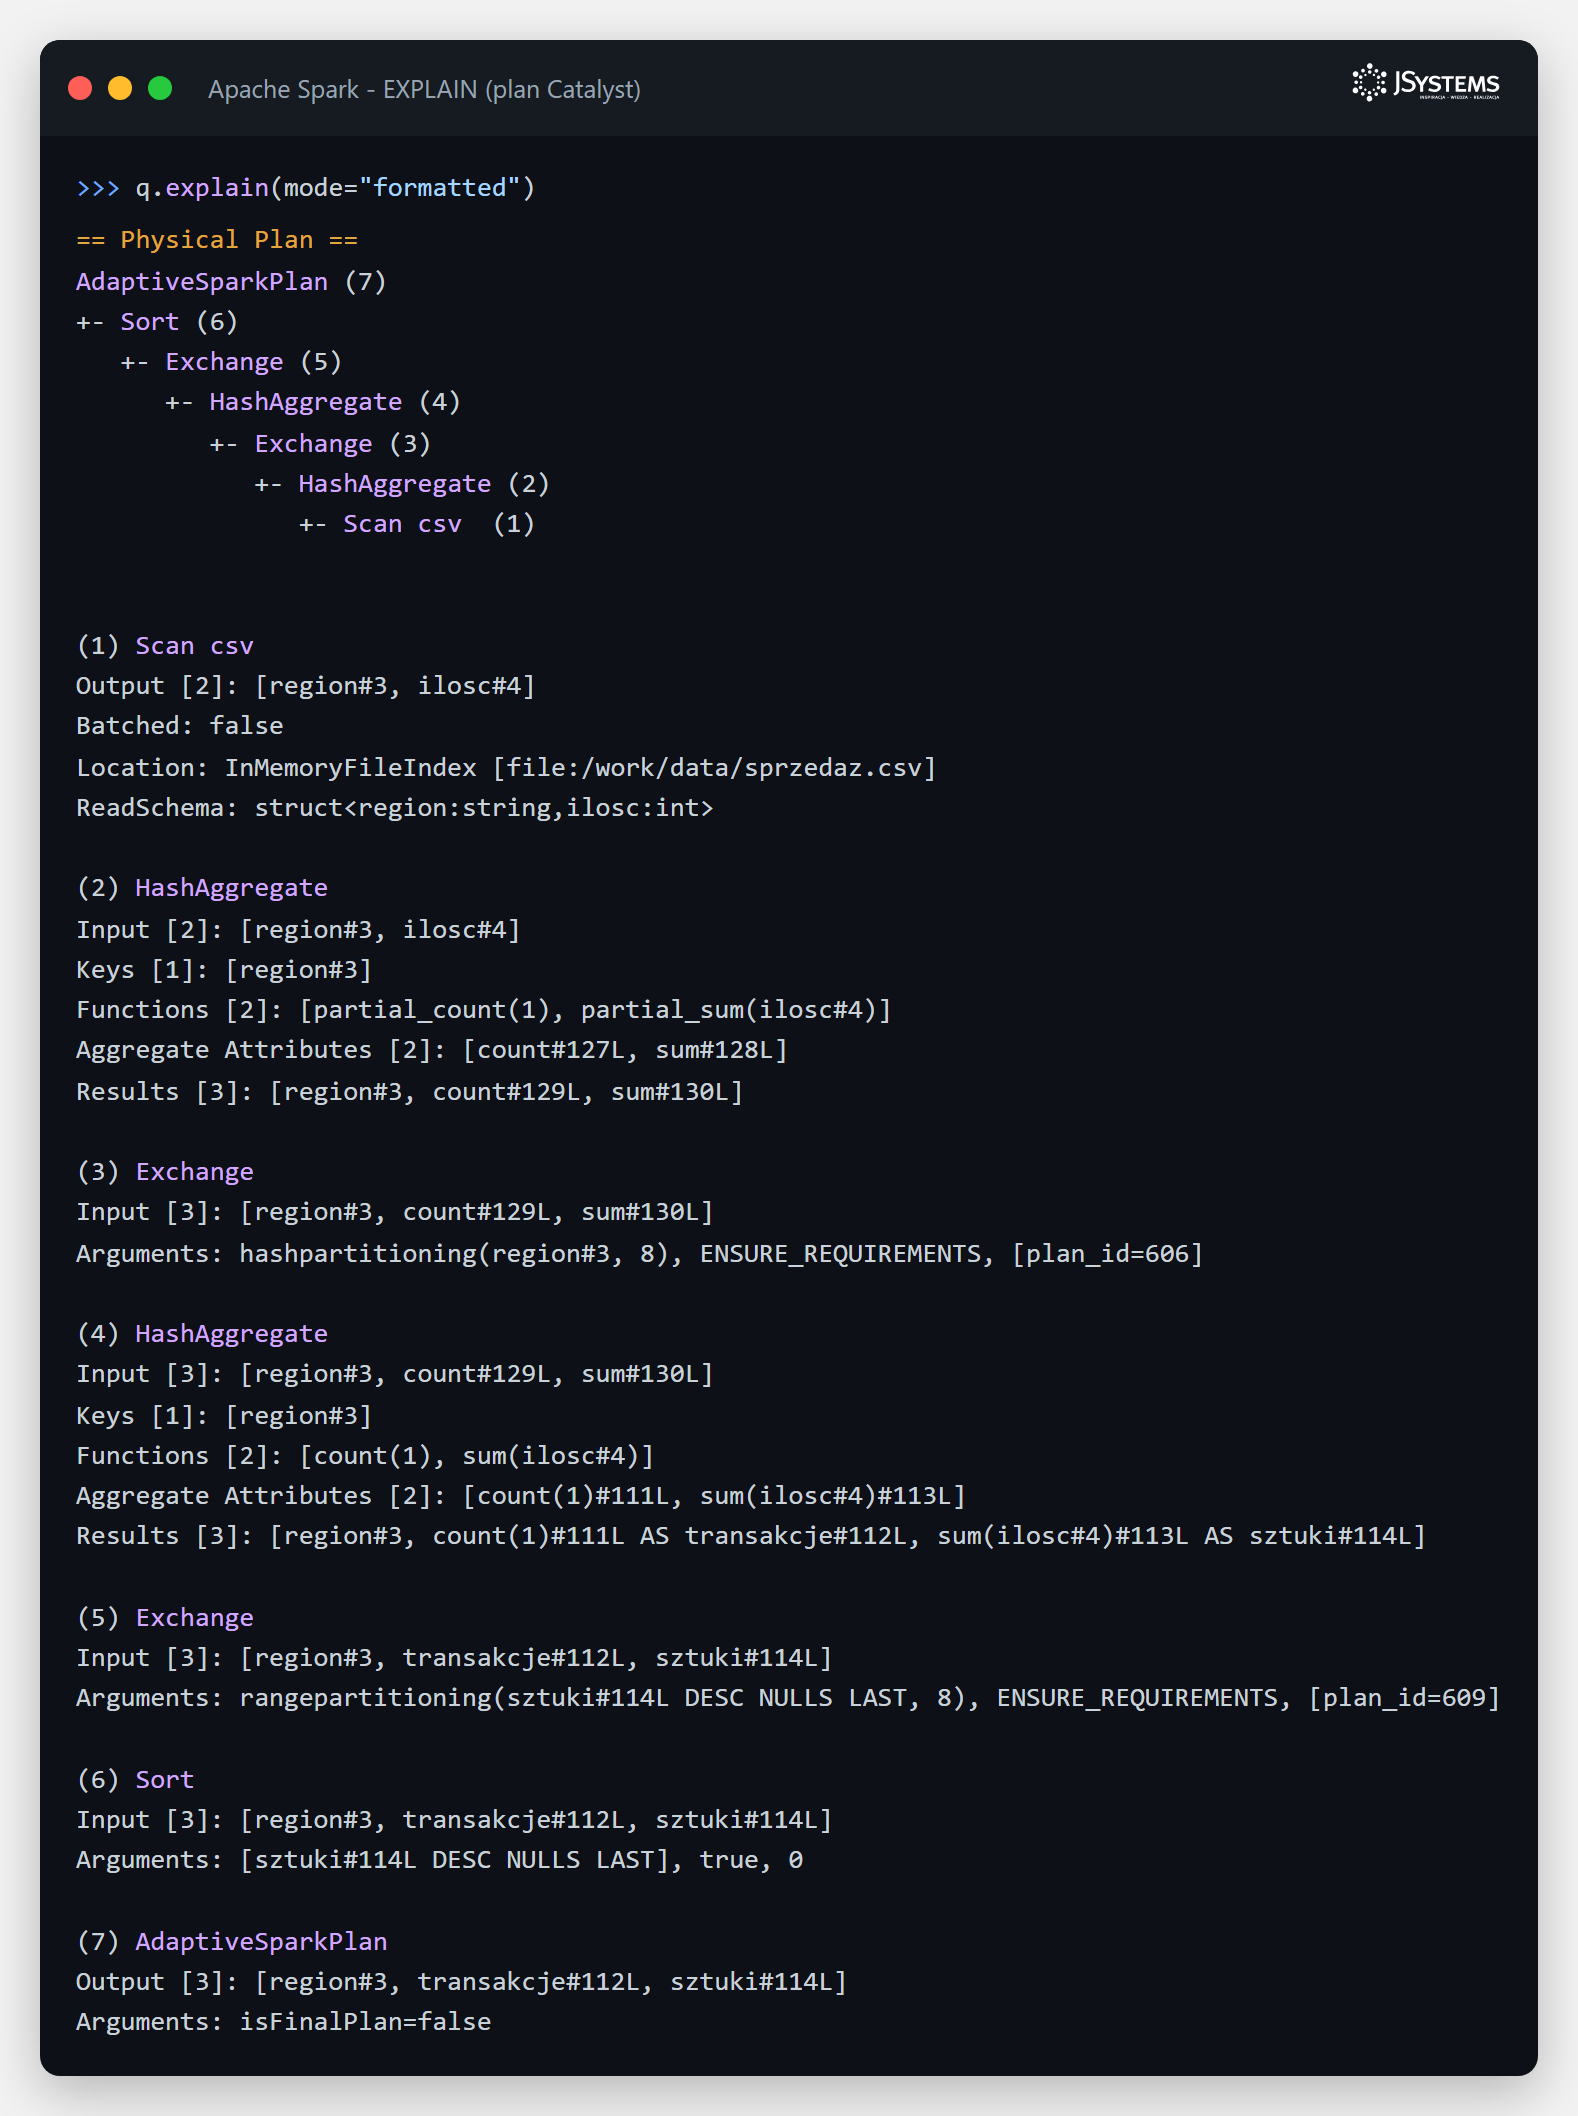
Spark ma swój optymalizator - Catalyst - i pokazuje plan fizyczny poleceniem explain. Zwróć uwagę na AdaptiveSparkPlan: to mechanizm AQE (Adaptive Query Execution), który potrafi zmieniać plan w trakcie, gdy pozna faktyczne rozmiary danych.
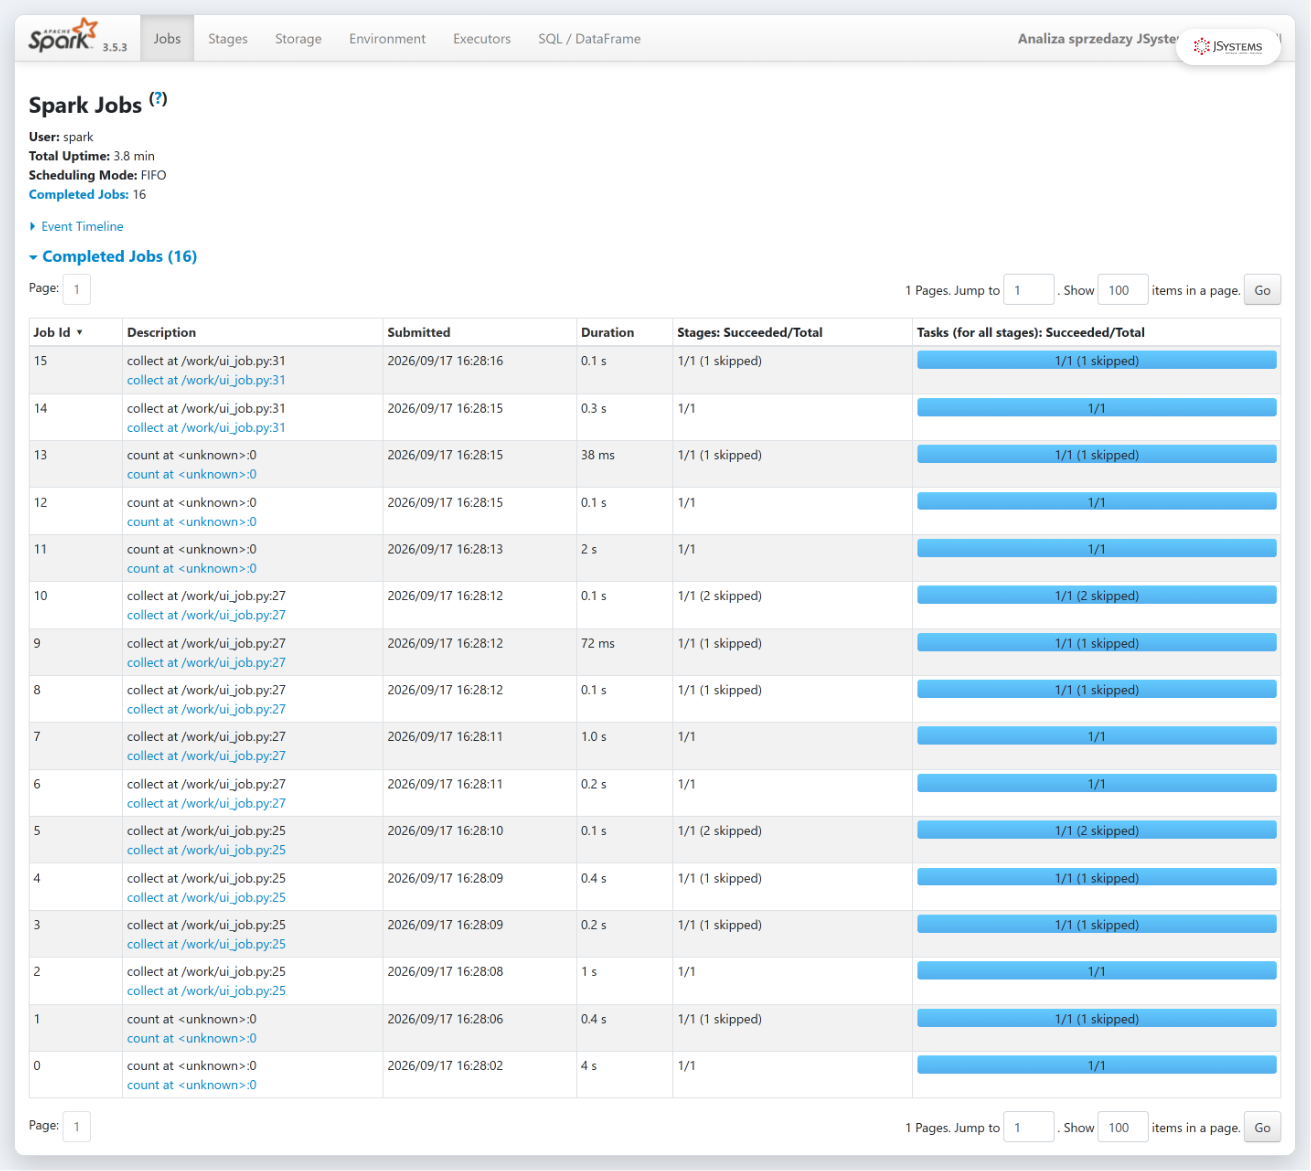
Największą przewagą Sparka w codziennej pracy jest jednak jego panel WWW (Spark UI). Uruchamia się automatycznie i pokazuje każde zadanie na żywo. Poniżej realny zrzut z naszego demo - lista szesnastu zakończonych zadań z czasami wykonania.
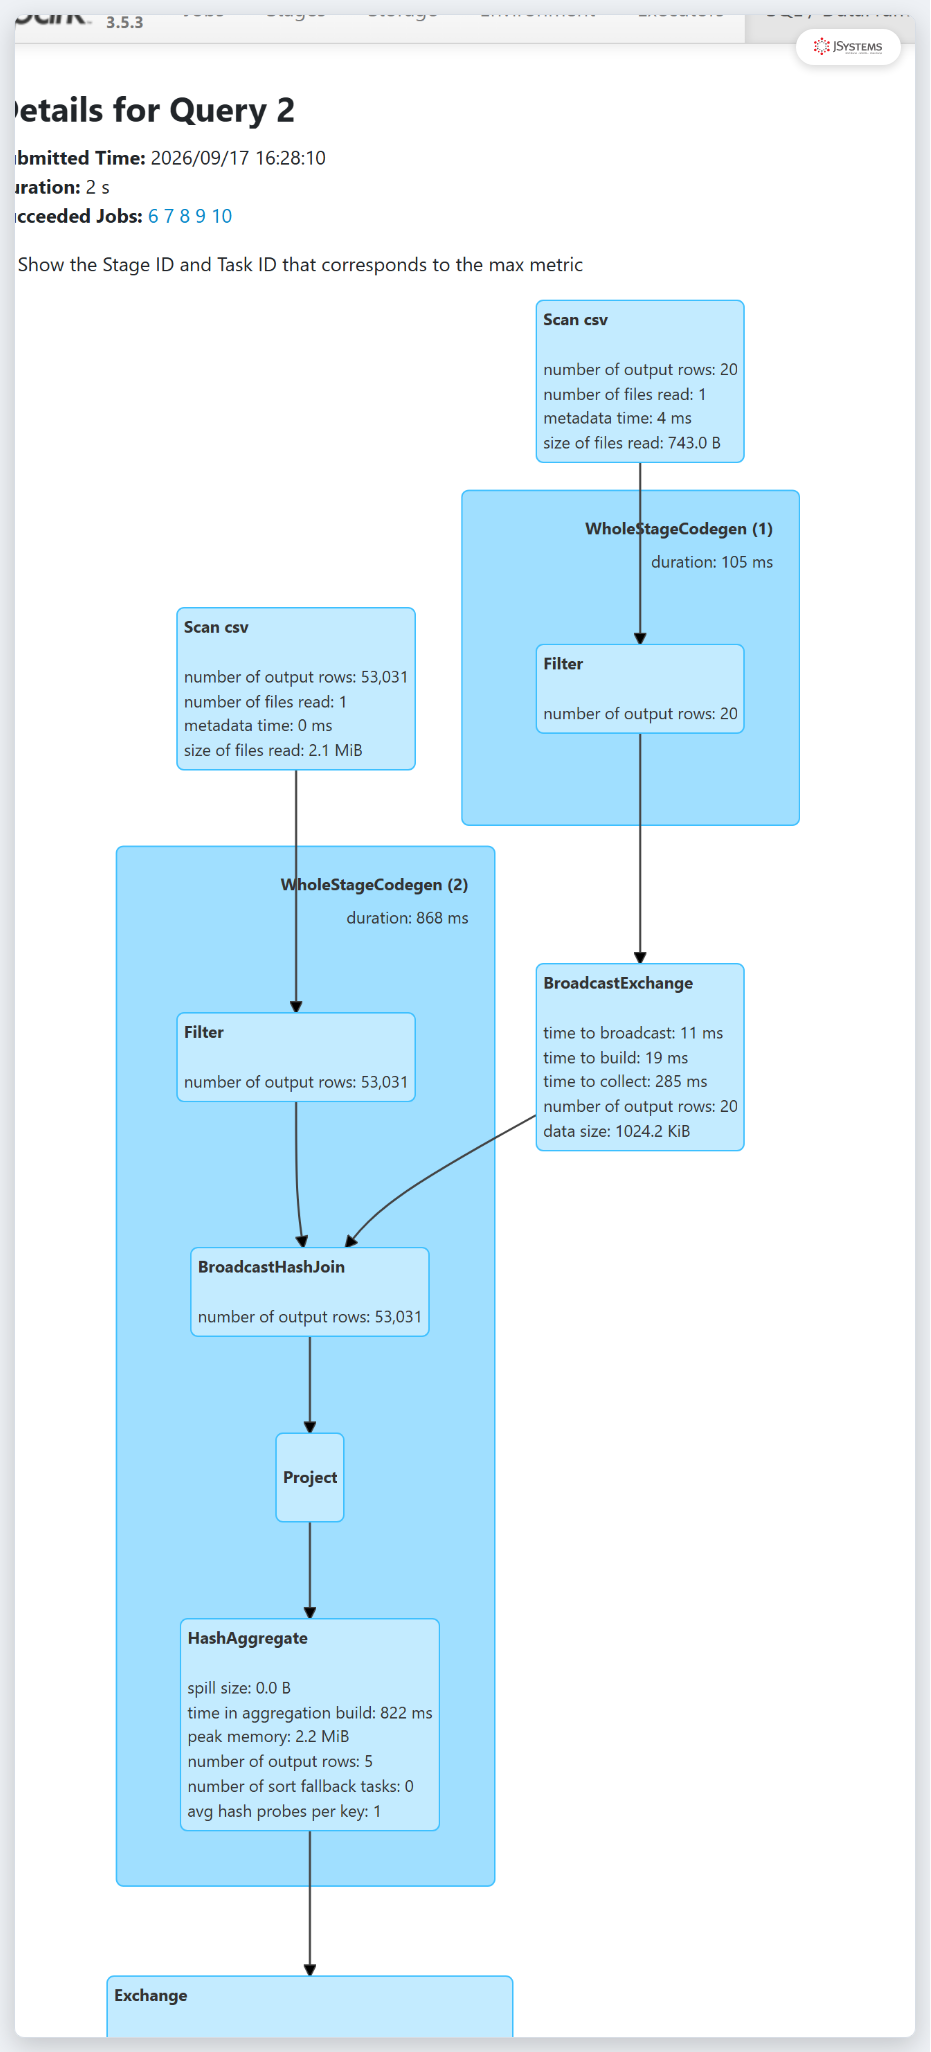
Jeszcze ciekawszy jest podgląd pojedynczego zapytania jako grafu (DAG). Poniżej realny plan naszego zapytania ze złączeniem. Spark rozpoznał, że tabela produktów jest mała, i zastosował BroadcastHashJoin - rozesłał ją do wszystkich zadań zamiast kosztownie przetasowywać dużą tabelę sprzedaży.
Podstawą wydajności w obu narzędziach jest partycjonowanie - fizyczny podział danych, dzięki któremu zapytanie czyta tylko potrzebny fragment. Hive robi to na tabelach ORC, Spark - na przykład na plikach Parquet. W Sparku zapisaliśmy sprzedaż podzieloną według roku i miesiąca, a potem zapytaliśmy o jeden miesiąc.
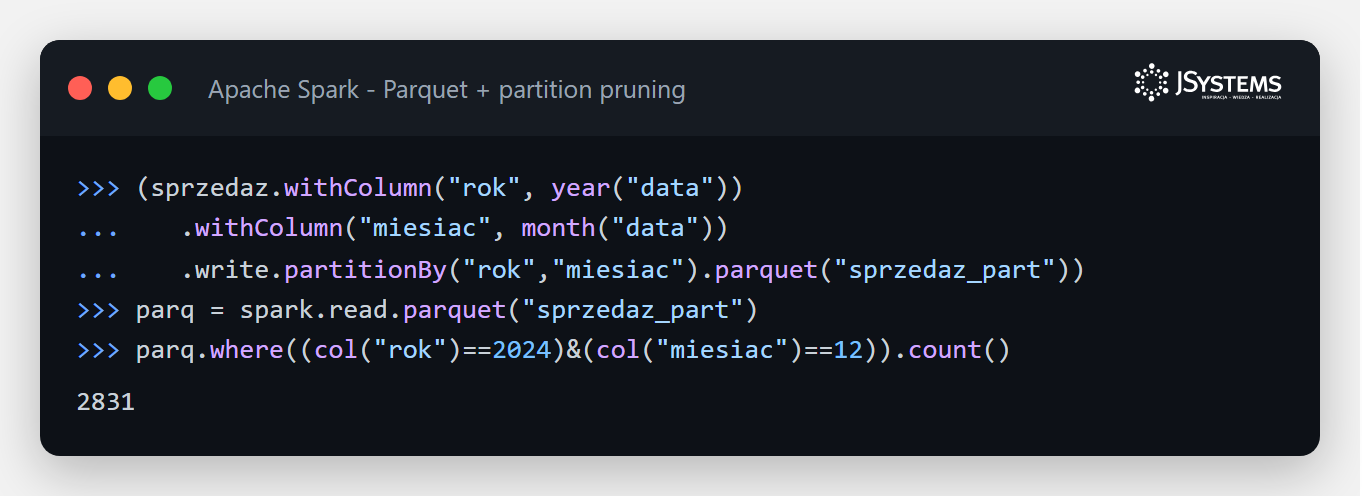
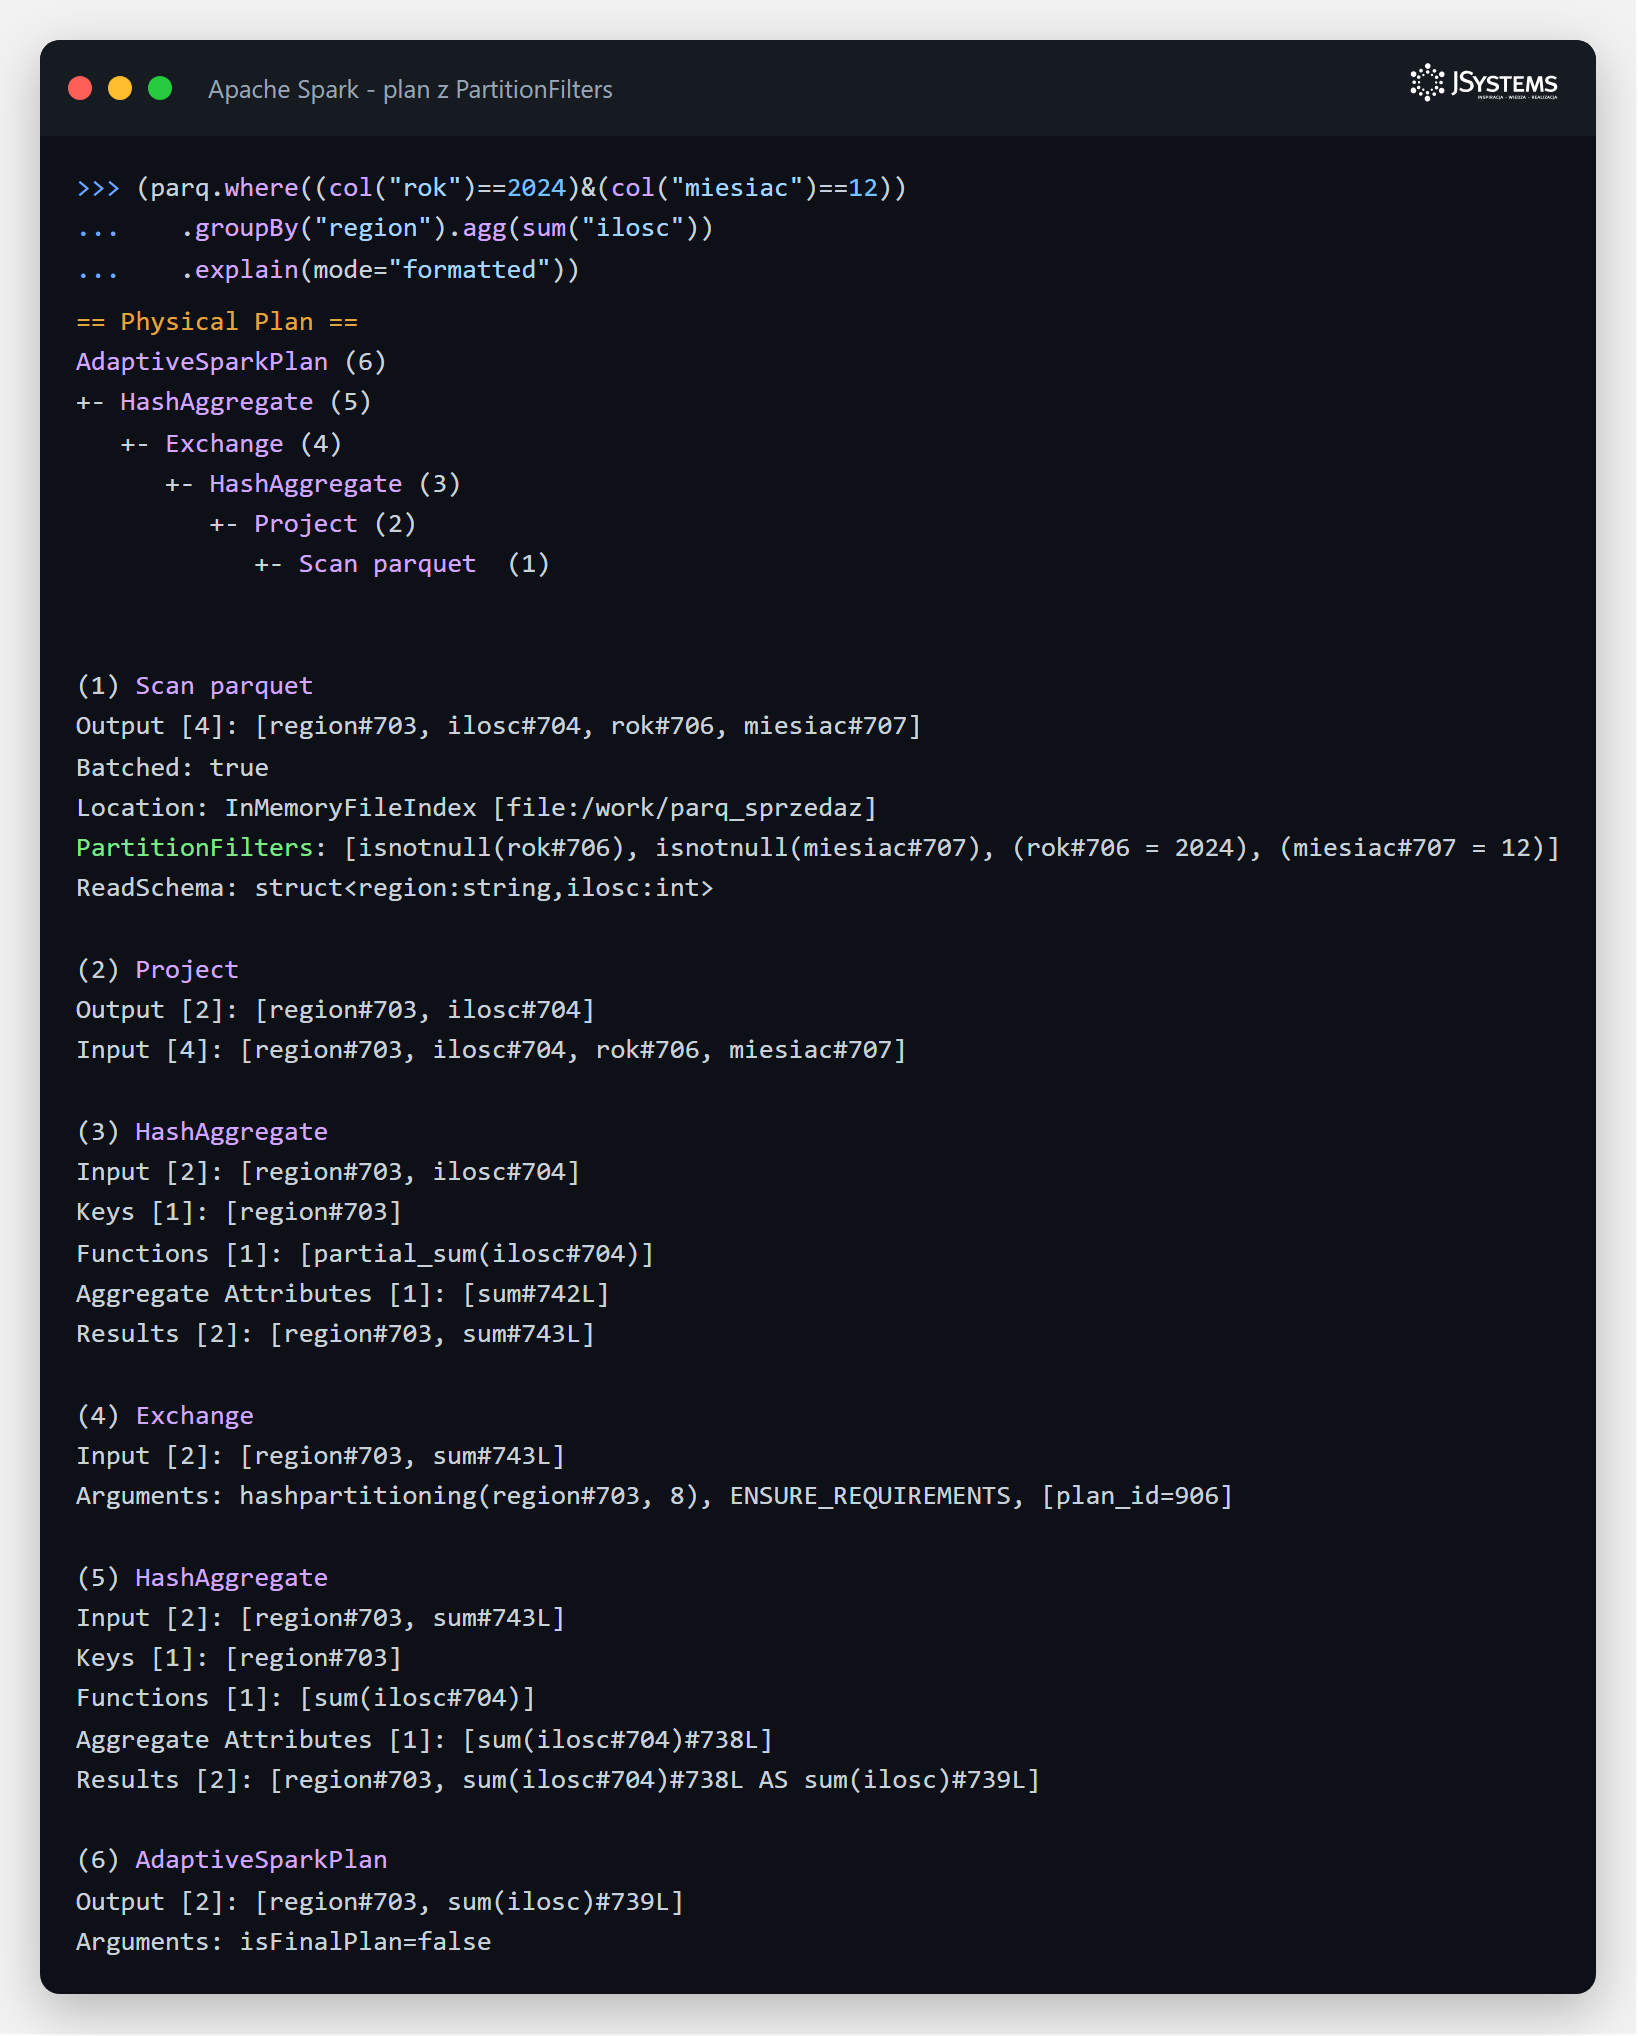
Że faktycznie pomija resztę, potwierdza plan wykonania. W sekcji skanu Parquet widać PartitionFilters z warunkiem na roku i miesiącu - Spark z góry wie, których katalogów nie musi otwierać. To jest partition pruning, dokładnie ten sam mechanizm, który w Hive skraca skanowanie ogromnych tabel.
Przejdźmy do liczb - ale uczciwie. Uruchomiliśmy te same cztery zapytania na obu silnikach, na tym samym zbiorze, w jednowęzłowym demo w Dockerze. To nie jest benchmark klastrowy i nie służy do ogłaszania zwycięzcy - służy pokazaniu, jak każdy silnik się zachowuje.
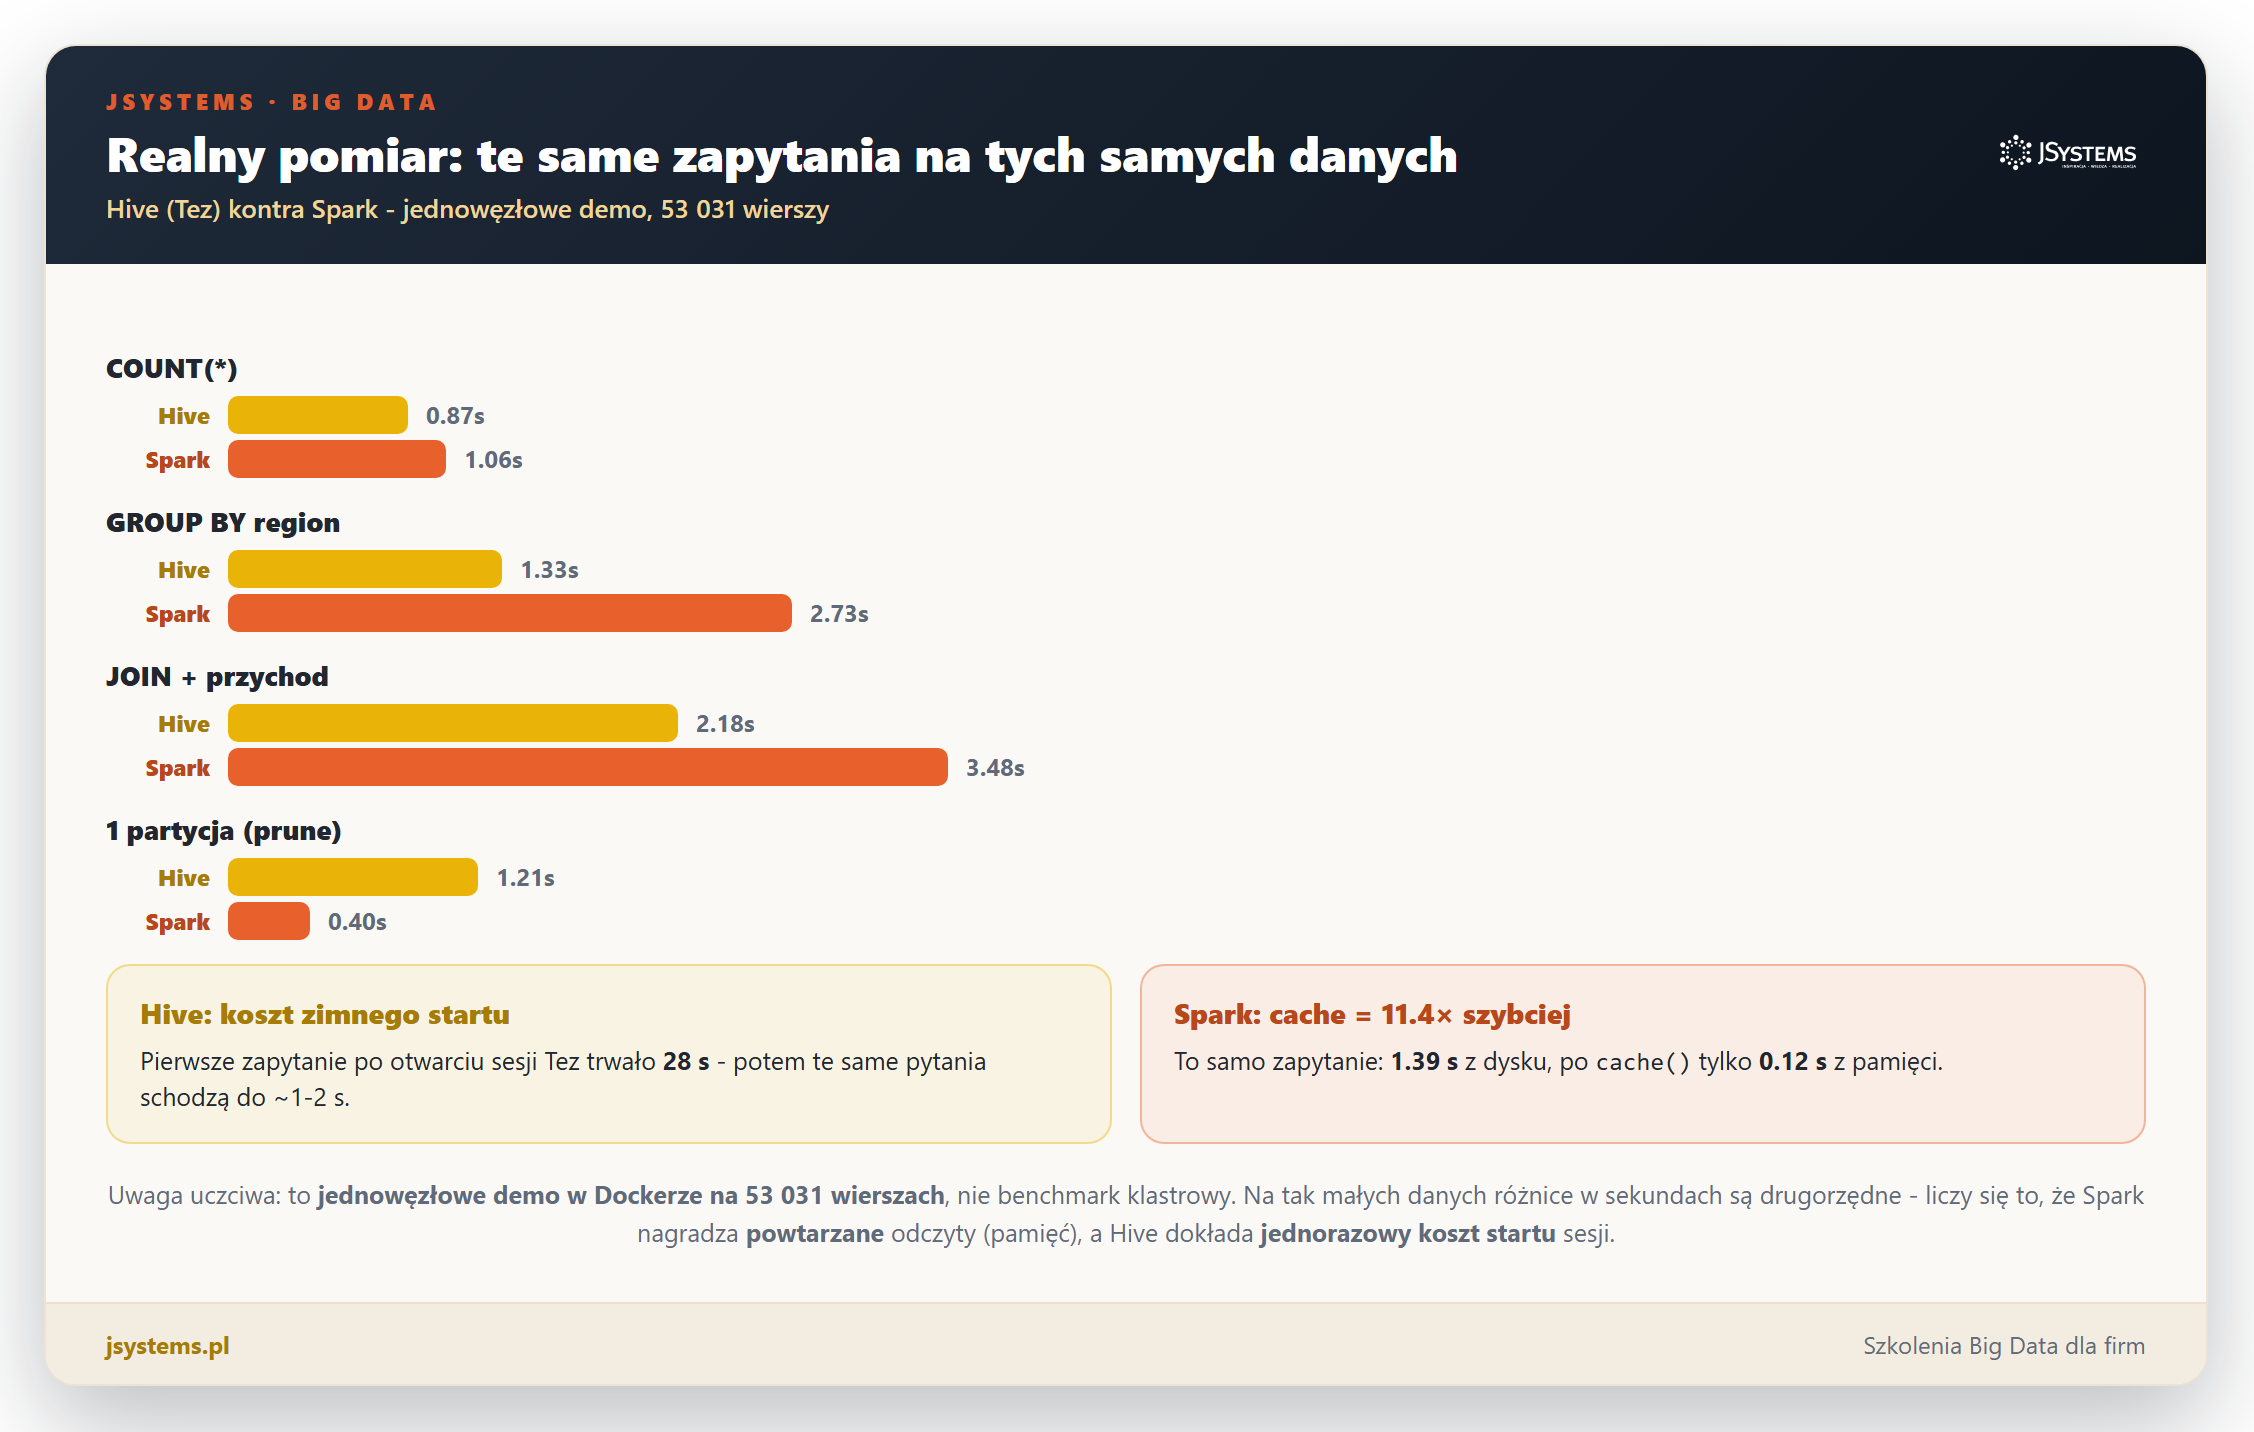
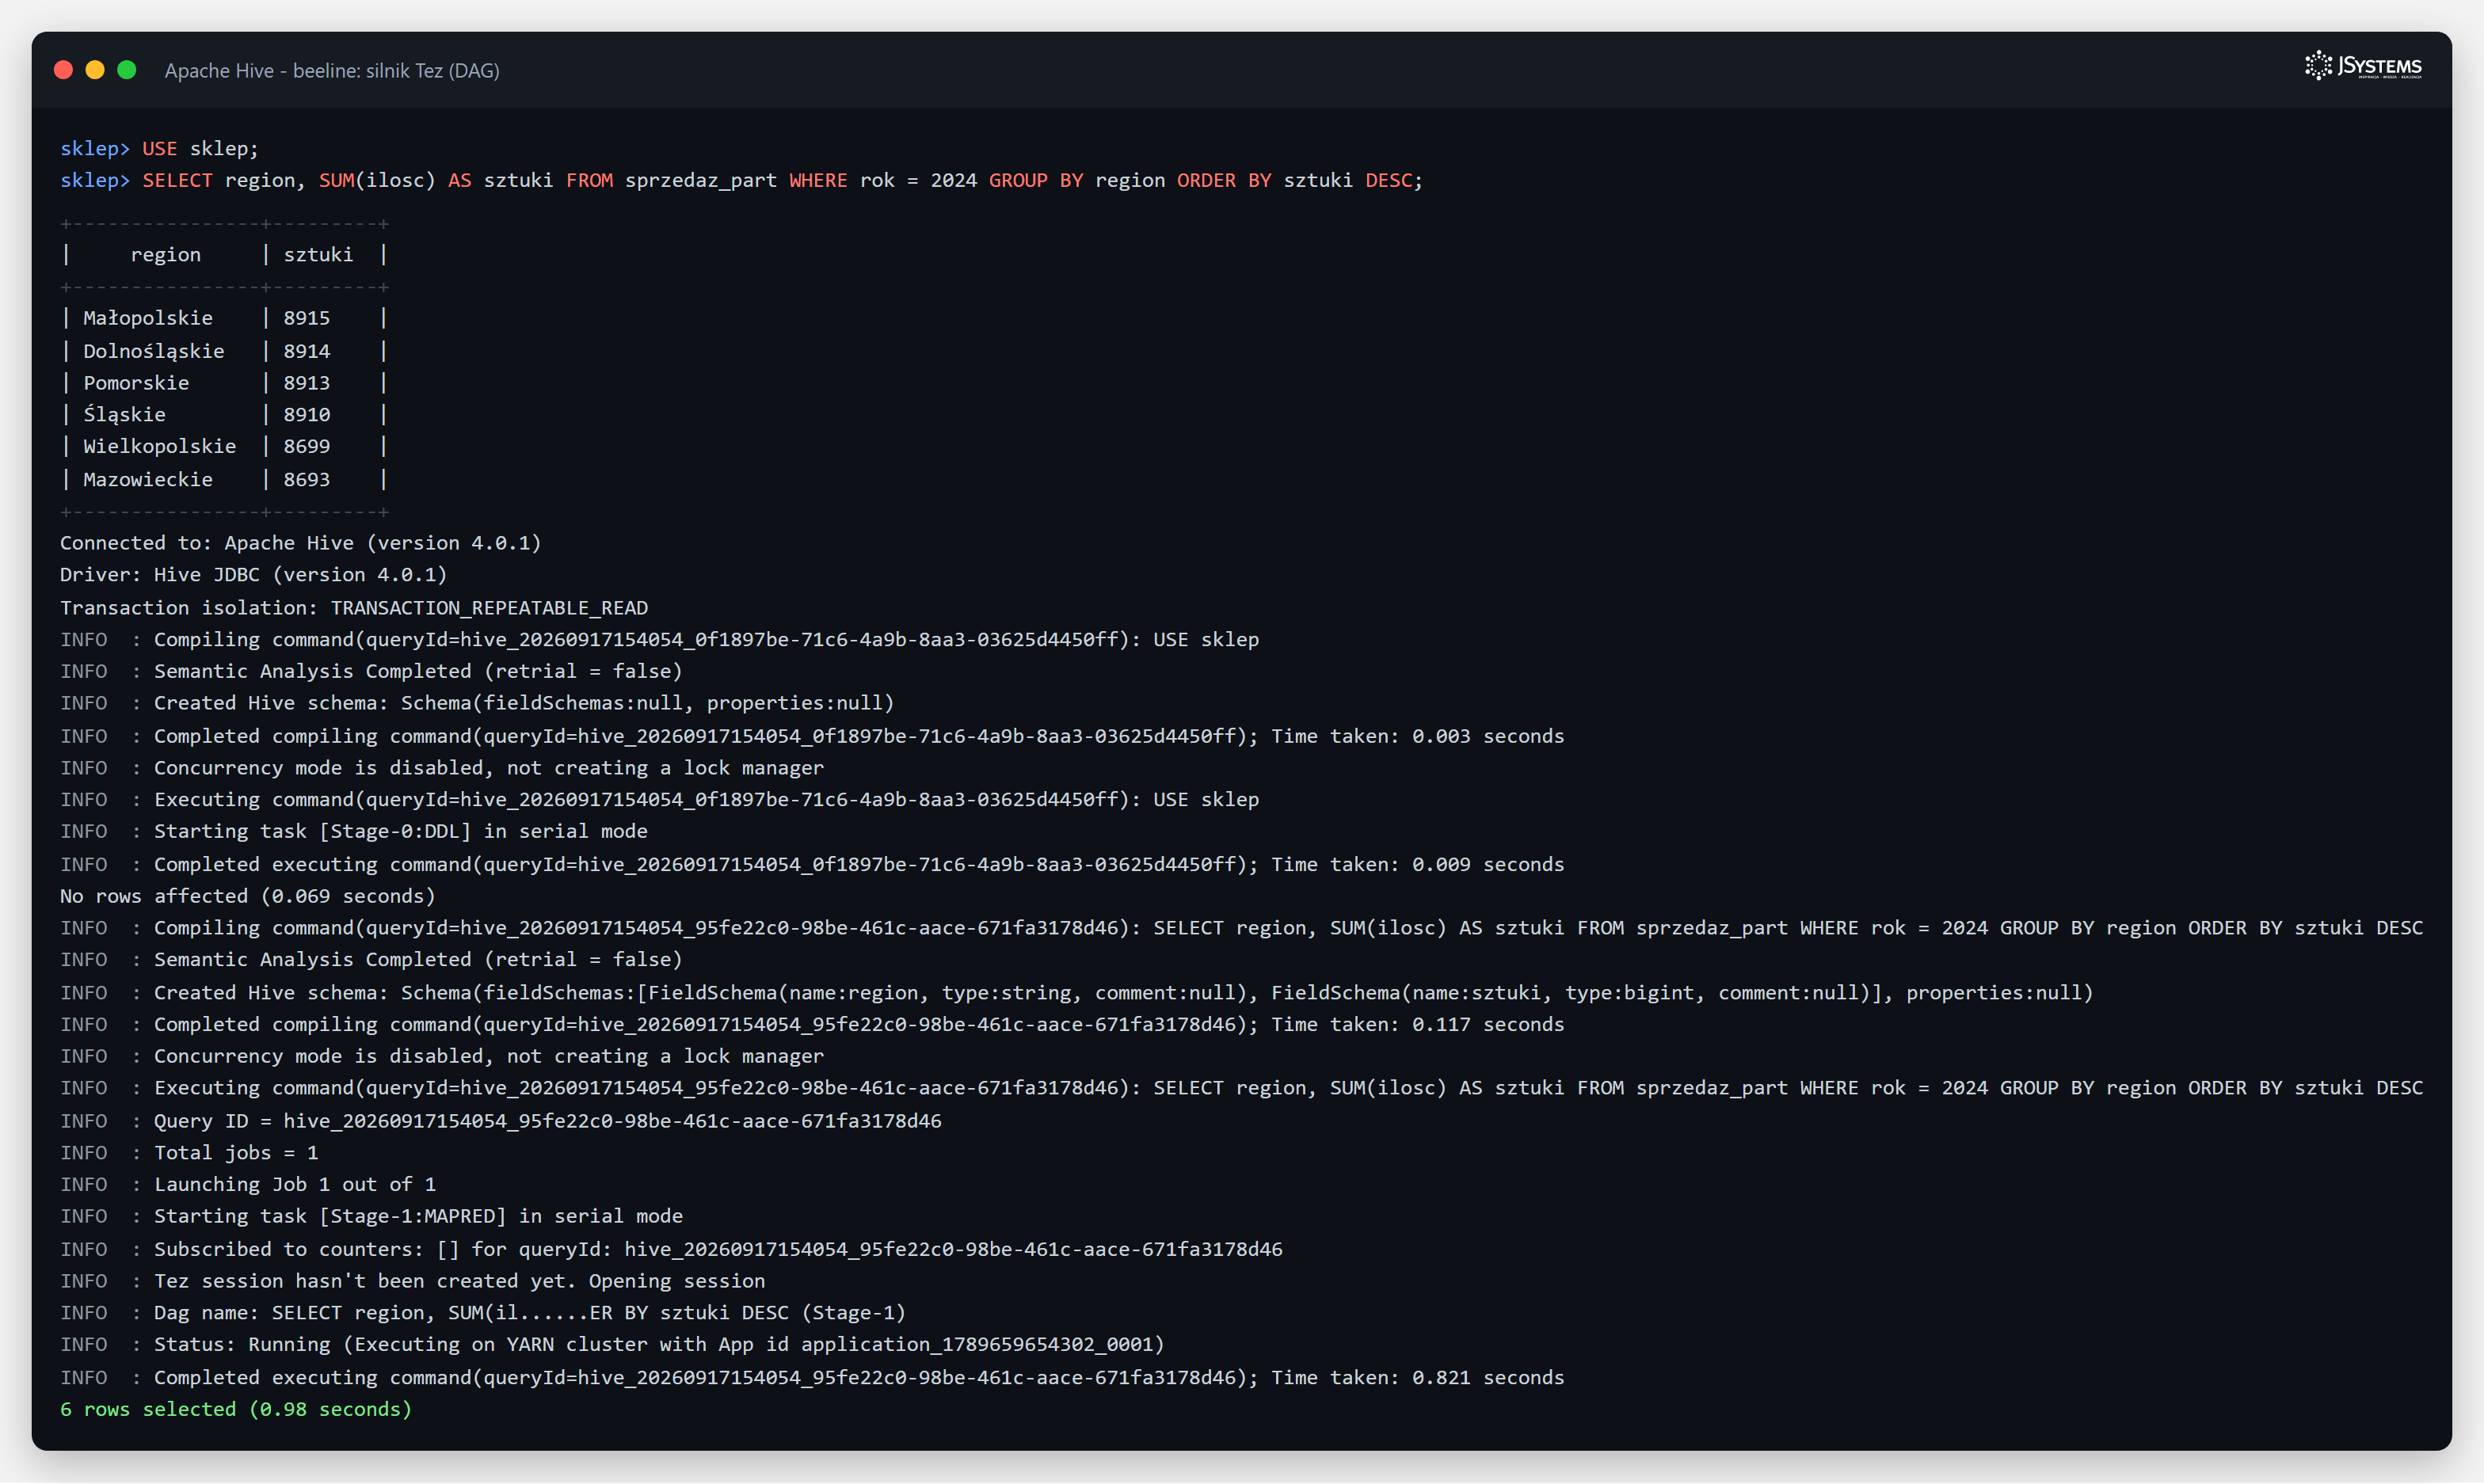
Wnioski są dwa i oba są ważniejsze niż same słupki. Po pierwsze, Hive płaci koszt zimnego startu: pierwsze zapytanie po otwarciu sesji Tez trwało u nas prawie 28 sekund, bo silnik musiał wystartować na klastrze - kolejne schodziły do 1-2 sekund. Widać to na realnym zrzucie z Hive poniżej.
Po drugie, Spark nagradza powtarzalność: przy pierwszym odczycie z dysku jest porównywalny z Hive, ale gdy dane wpadną do pamięci (cache), kolejne zapytania są wielokrotnie szybsze. Dlatego na małych, pojedynczych zapytaniach wsadowych różnice są niewielkie, a przewaga Sparka rośnie tam, gdzie liczysz iteracyjnie i wielokrotnie na tych samych danych.
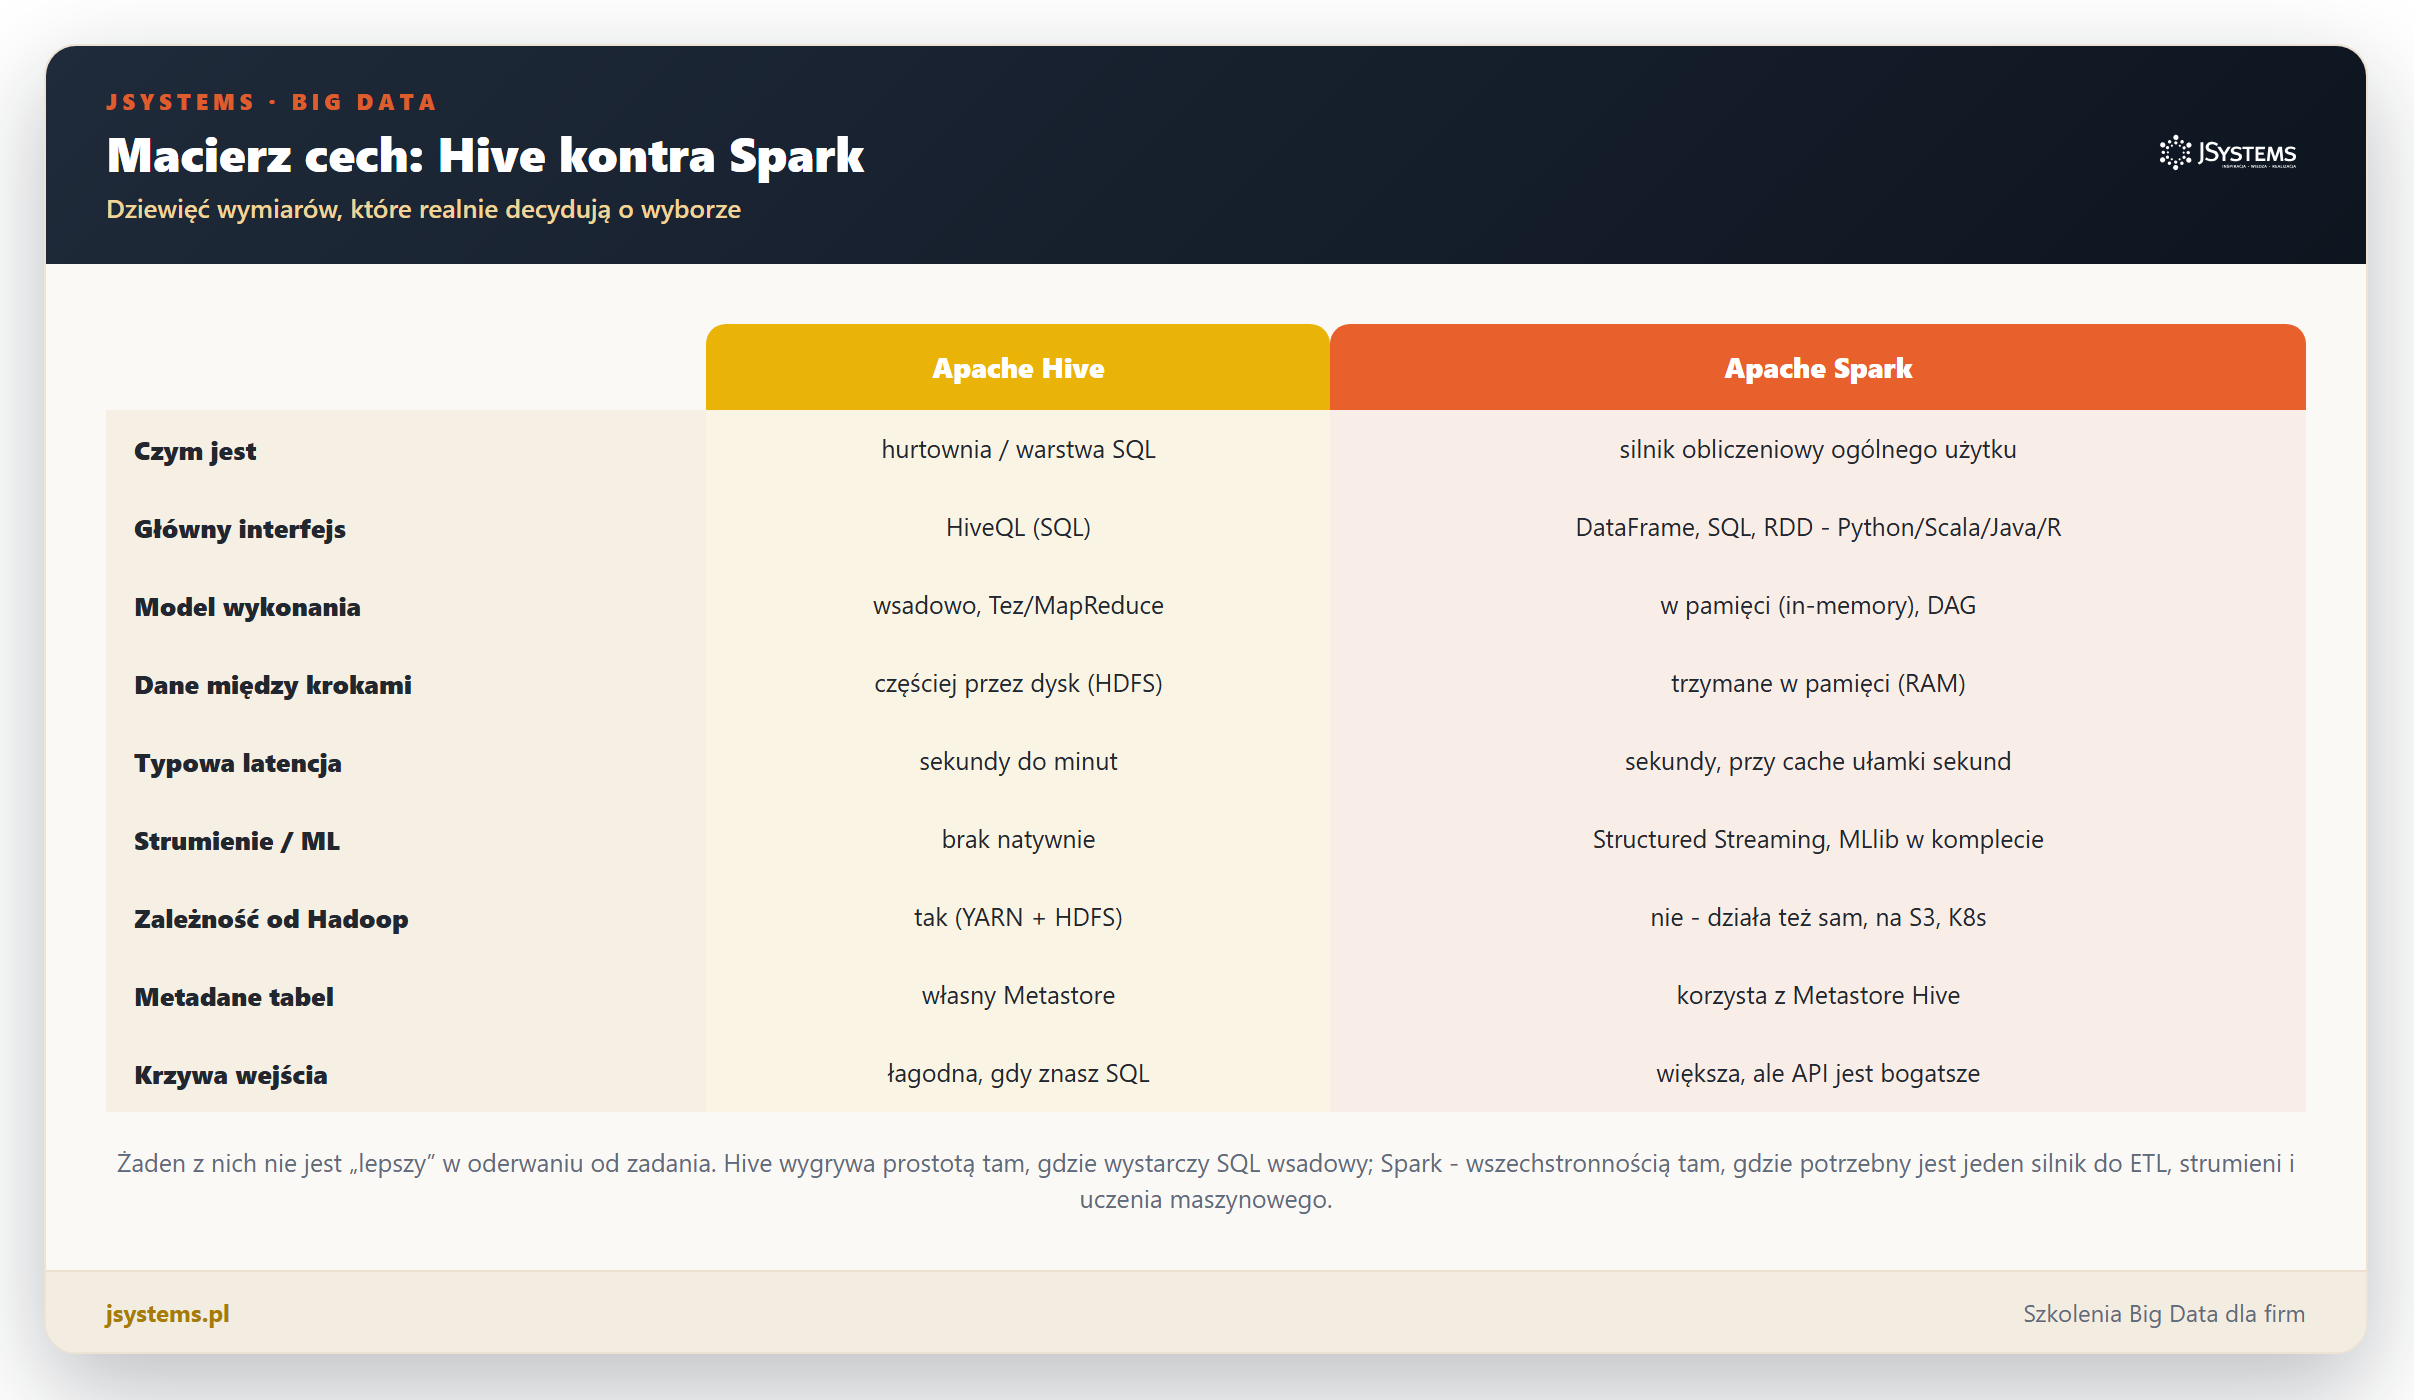
Zbierzmy wszystko w jednym miejscu. Poniższa tabela zestawia oba narzędzia w dziewięciu wymiarach, które realnie decydują o wyborze.
Skoro znamy już różnice, decyzja robi się prosta. Co ważne, w praktyce najczęściej nie jest to wybór albo-albo.
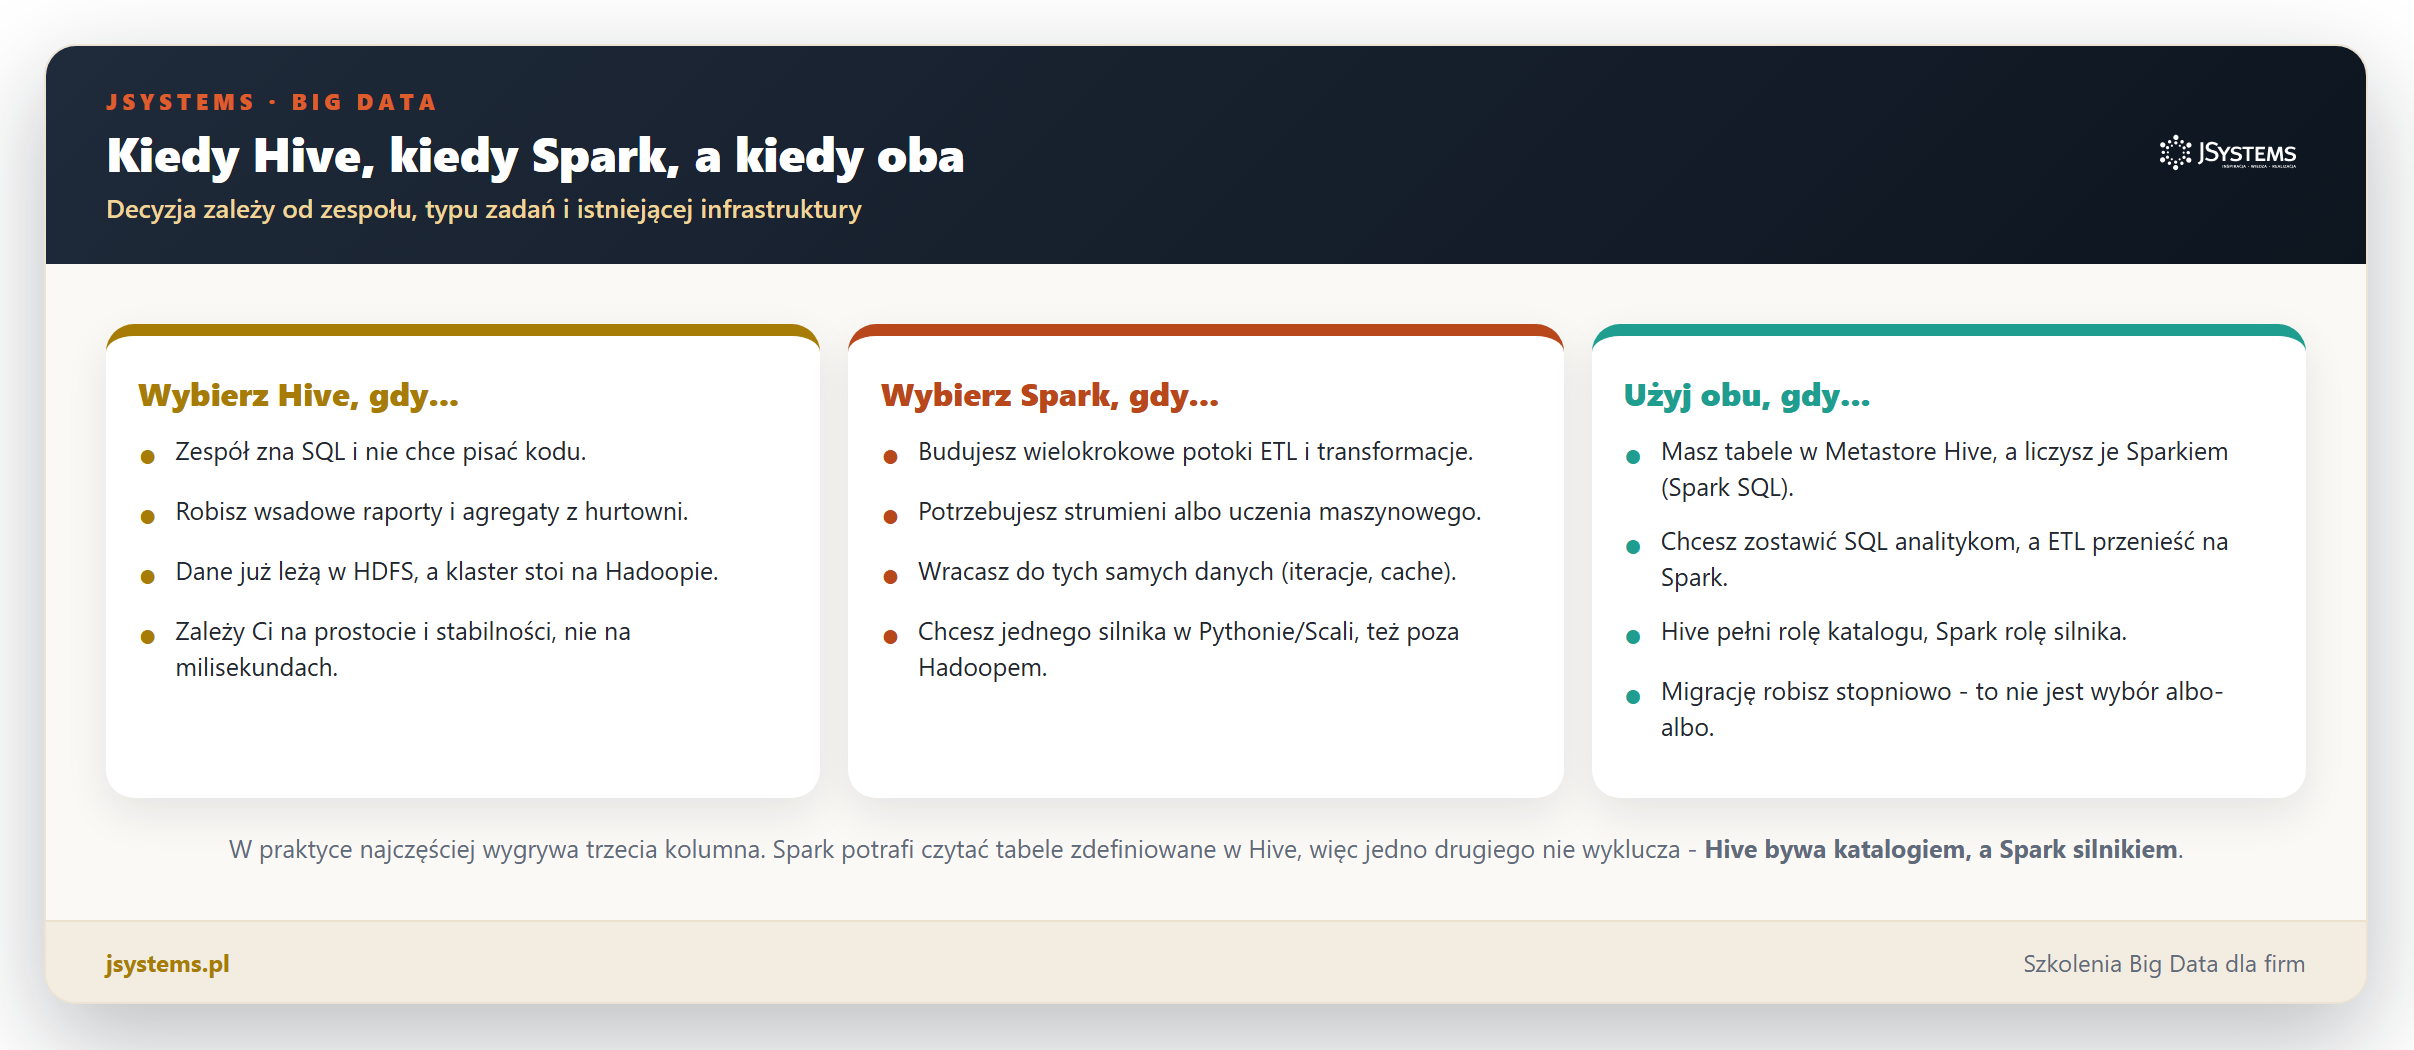
Wybierz Hive, gdy zespół zna SQL, robicie wsadowe raporty z hurtowni, a dane leżą już w HDFS. Wybierz Spark, gdy budujesz wielokrokowe potoki, potrzebujesz strumieni lub uczenia maszynowego albo wracasz do tych samych danych. A jeśli rozważasz rozwiązanie w chmurze zamiast własnego klastra, warto poznać też w pełni zarządzaną hurtownię, jaką jest Google BigQuery - to trzecia droga obok Hive i Sparka.
Najczęstszym nieporozumieniem jest traktowanie tego jak pojedynku. W dojrzałej architekturze danych Hive i Spark współpracują: Hive (a właściwie jego Metastore) pełni rolę wspólnego katalogu tabel, a Spark jest silnikiem, który te tabele liczy.
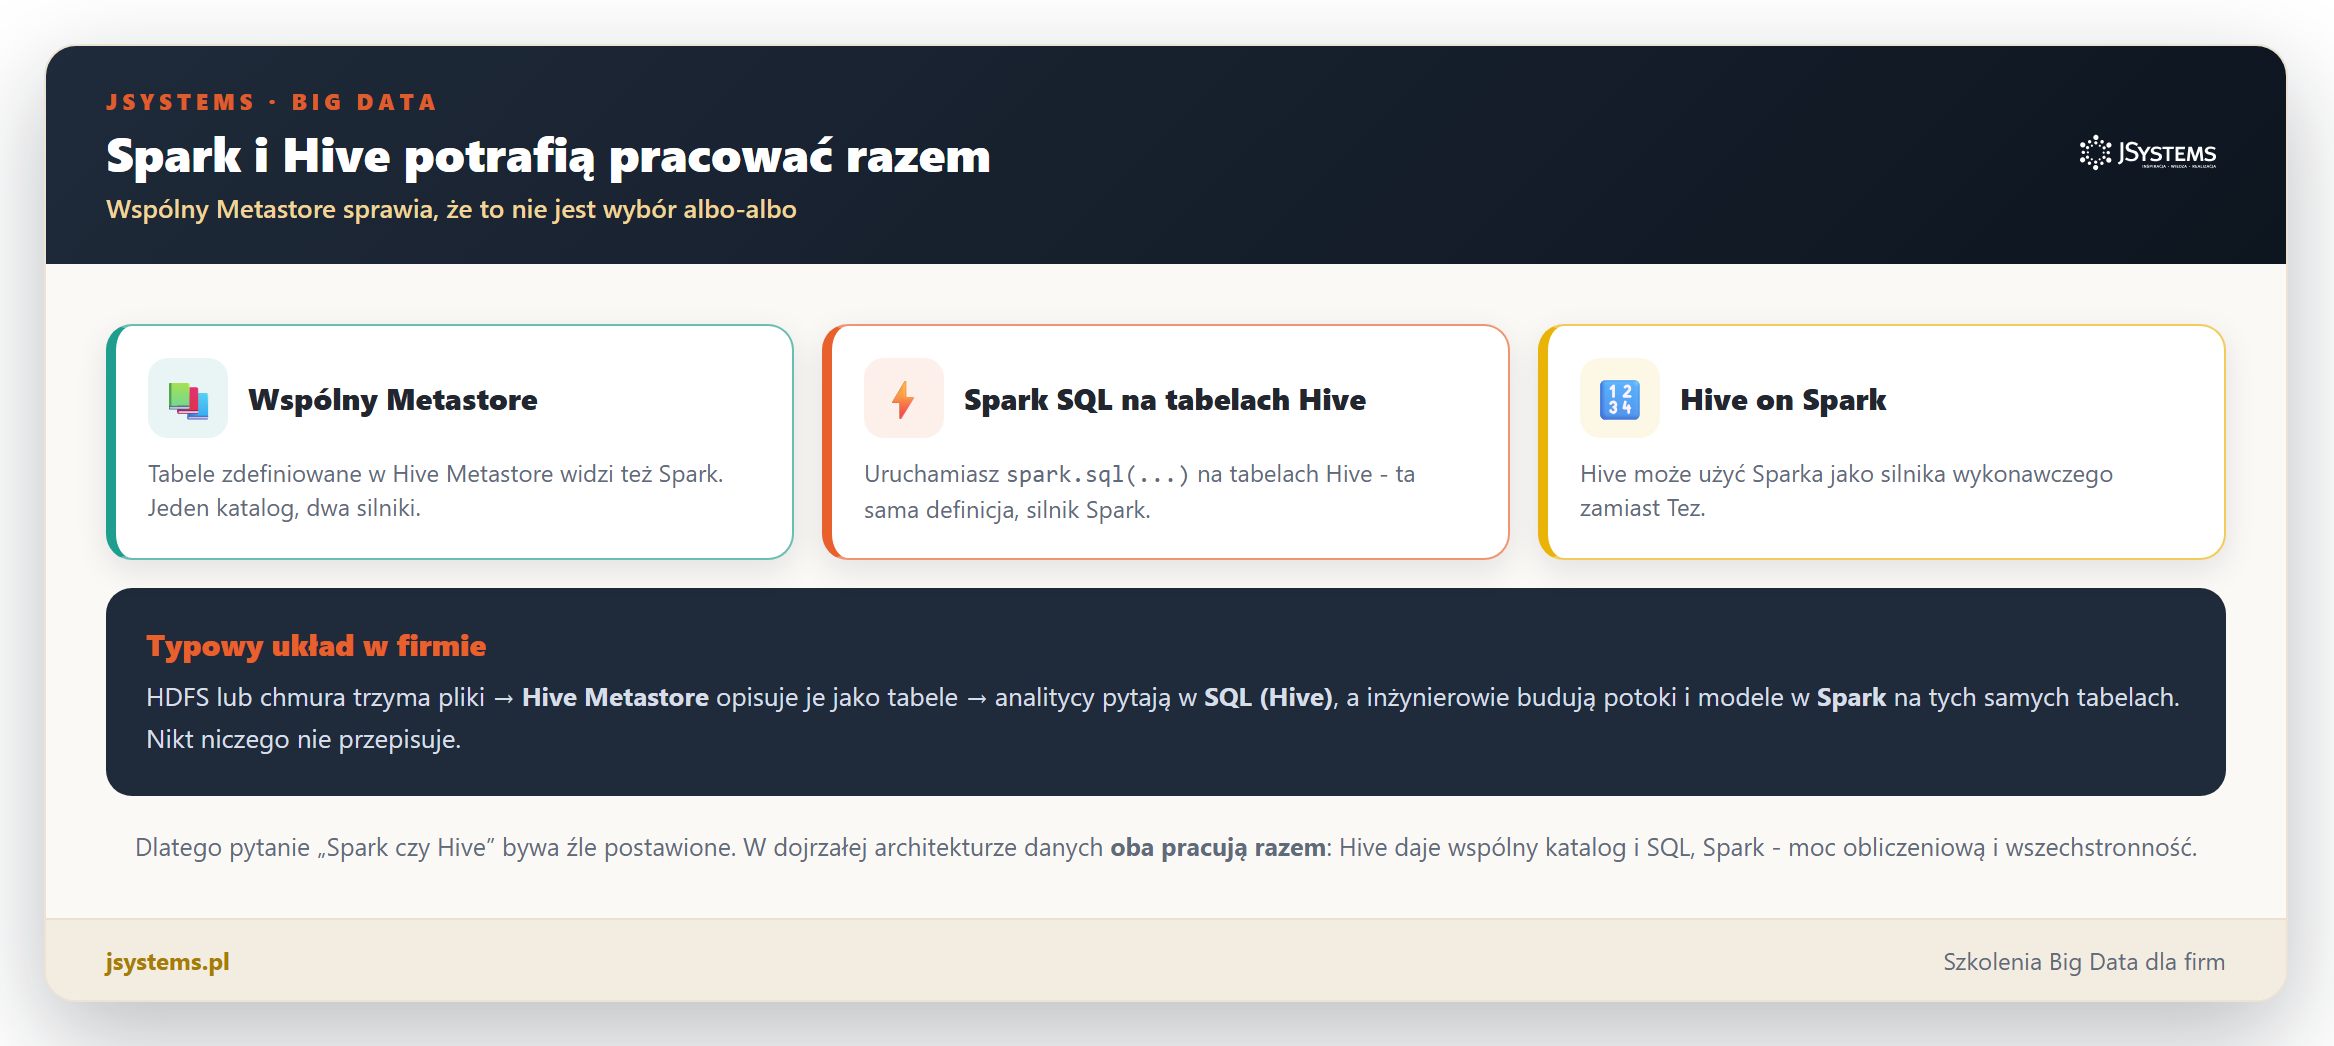
W typowej firmie wygląda to tak: pliki leżą w HDFS lub w chmurze, Hive Metastore opisuje je jako tabele, analitycy odpytują je w SQL, a inżynierowie budują potoki i modele w Spark - na tych samych tabelach. Spark potrafi uruchomić spark.sql(...) wprost na tabelach zdefiniowanych w Hive, więc migrację można robić stopniowo, bez rewolucji.
Najlepszy sposób, żeby to wszystko poczuć, to odpalić oba na własnym komputerze. Dokładnie tak przygotowaliśmy to demo - dwoma poleceniami Dockera. Najpierw Hive z serwerem zapytań i konsolą Beeline:
# Apache Hive: serwer zapytań w jednym kontenerze
docker run -d -p 10000:10000 -p 10002:10002 \
  --env SERVICE_NAME=hiveserver2 \
  --name hive apache/hive:4.0.1

# konsola Beeline (klient SQL)
docker exec -it hive beeline -u 'jdbc:hive2://localhost:10000/'
A obok Spark, który tę samą analizę policzy zadaniem spark-submit albo interaktywnie w powłoce PySpark:
# Apache Spark: uruchomienie zadania na tych samych danych
docker run --rm -v "$PWD:/work" \
  apache/spark:3.5.3 \
  /opt/spark/bin/spark-submit /work/analiza.py

# albo interaktywnie w powłoce PySpark
docker run --rm -it apache/spark:3.5.3 /opt/spark/bin/pyspark
Od tego momentu możesz ładować dane i pisać zapytania w obu - i na własne oczy porównać, jak każdy z nich dochodzi do tego samego wyniku.
Apache Hive i Apache Spark nie są konkurentami w prostym sensie. Hive to hurtownia danych z dostępem przez SQL - prosta, dojrzała, idealna do wsadowej analityki dla zespołów, które znają SQL. Spark to uniwersalny silnik obliczeniowy - liczy w pamięci, obsługuje SQL, DataFrame, strumienie i uczenie maszynowe, i nie potrzebuje Hadoopa. Na tych samych danych oba policzą identyczny wynik; różni je to, jak i jak szybko do niego dochodzą. Spark błyszczy przy iteracjach i złożonych potokach dzięki modelowi in-memory, Hive - prostotą i stabilnością w czystym SQL. A ponieważ Spark potrafi czytać tabele Hive przez wspólny Metastore, w praktyce najlepszą odpowiedzią bywa: użyj obu. Najlepsze jest to, że całość przećwiczysz dziś na własnym laptopie w dwóch kontenerach - a stąd już blisko do pracy z prawdziwym Big Data.
To szkolenie może być dofinansowane dla Ciebie z KFS lub BUR. Ma terminy gwarantowane.
To szkolenie może być dofinansowane dla Ciebie z KFS lub BUR.


Komentarze (0)
Brak komentarzy...