Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
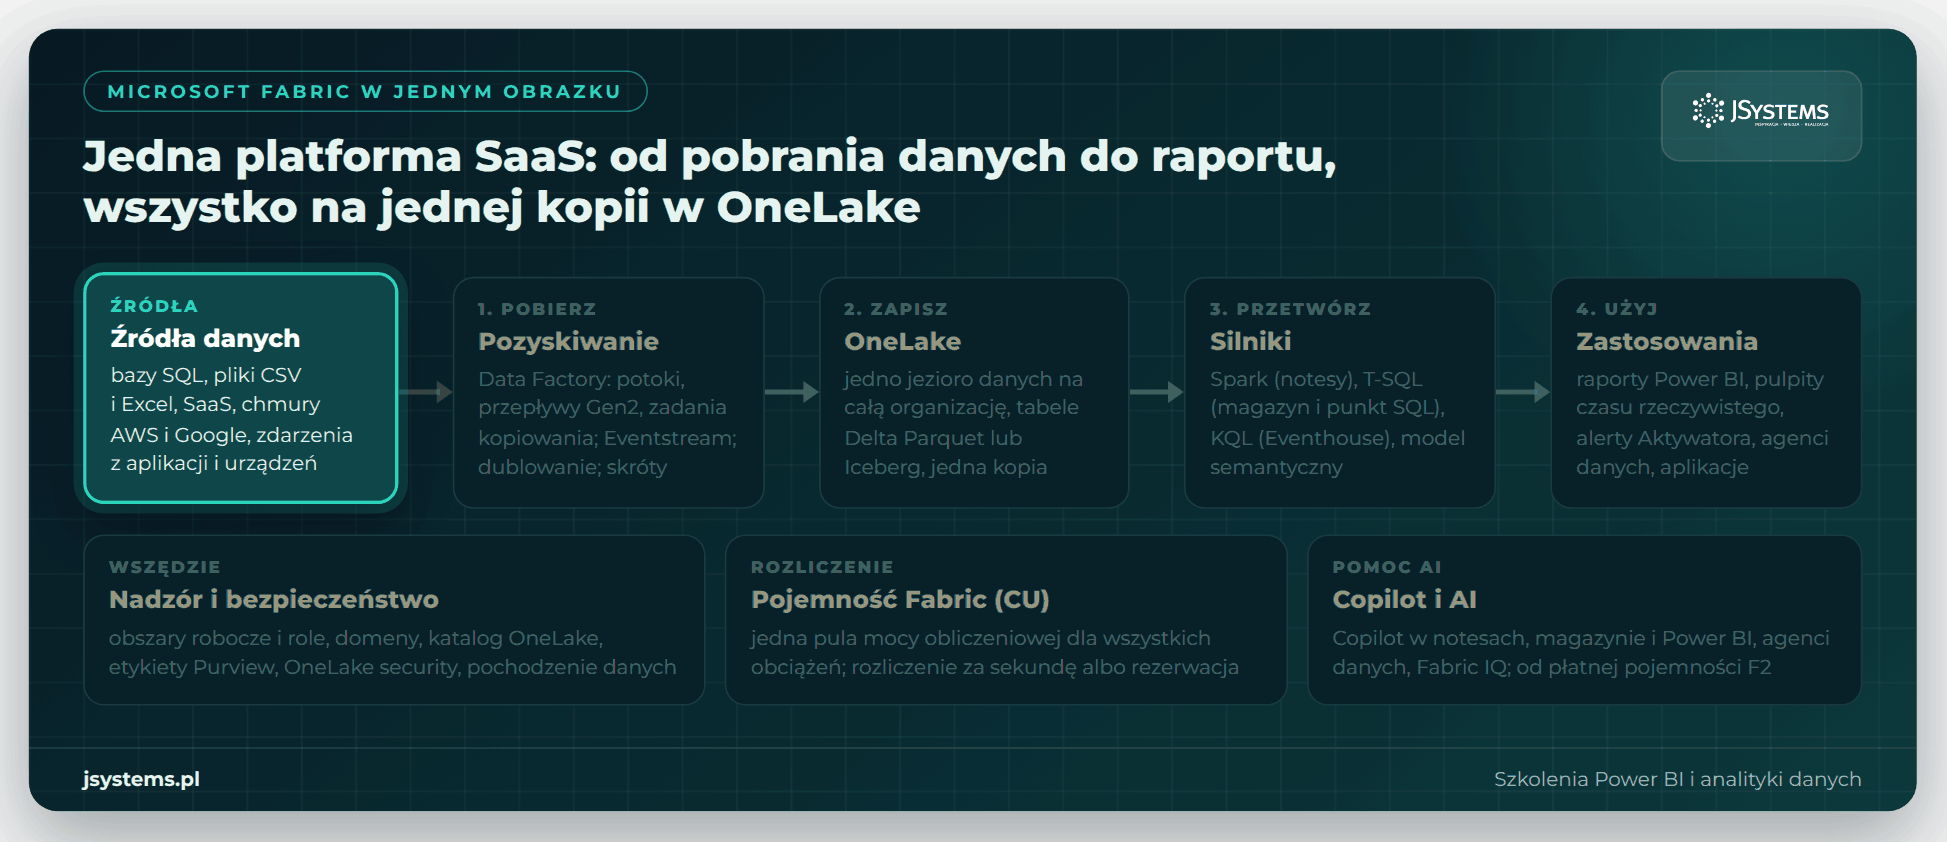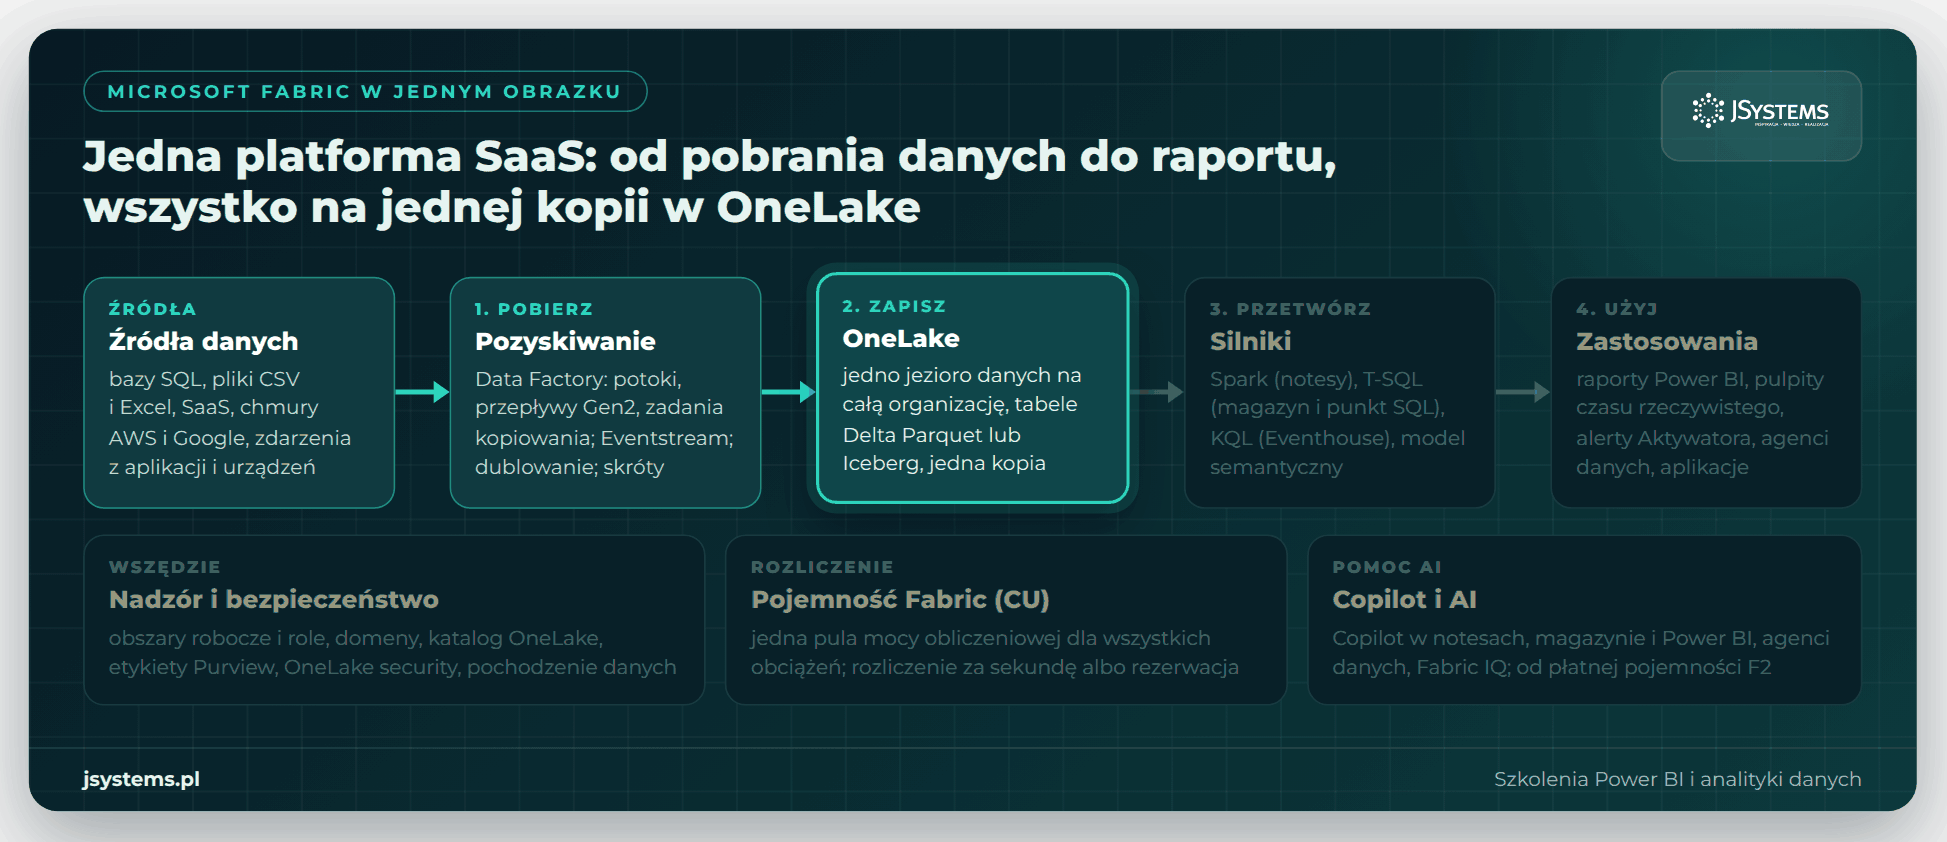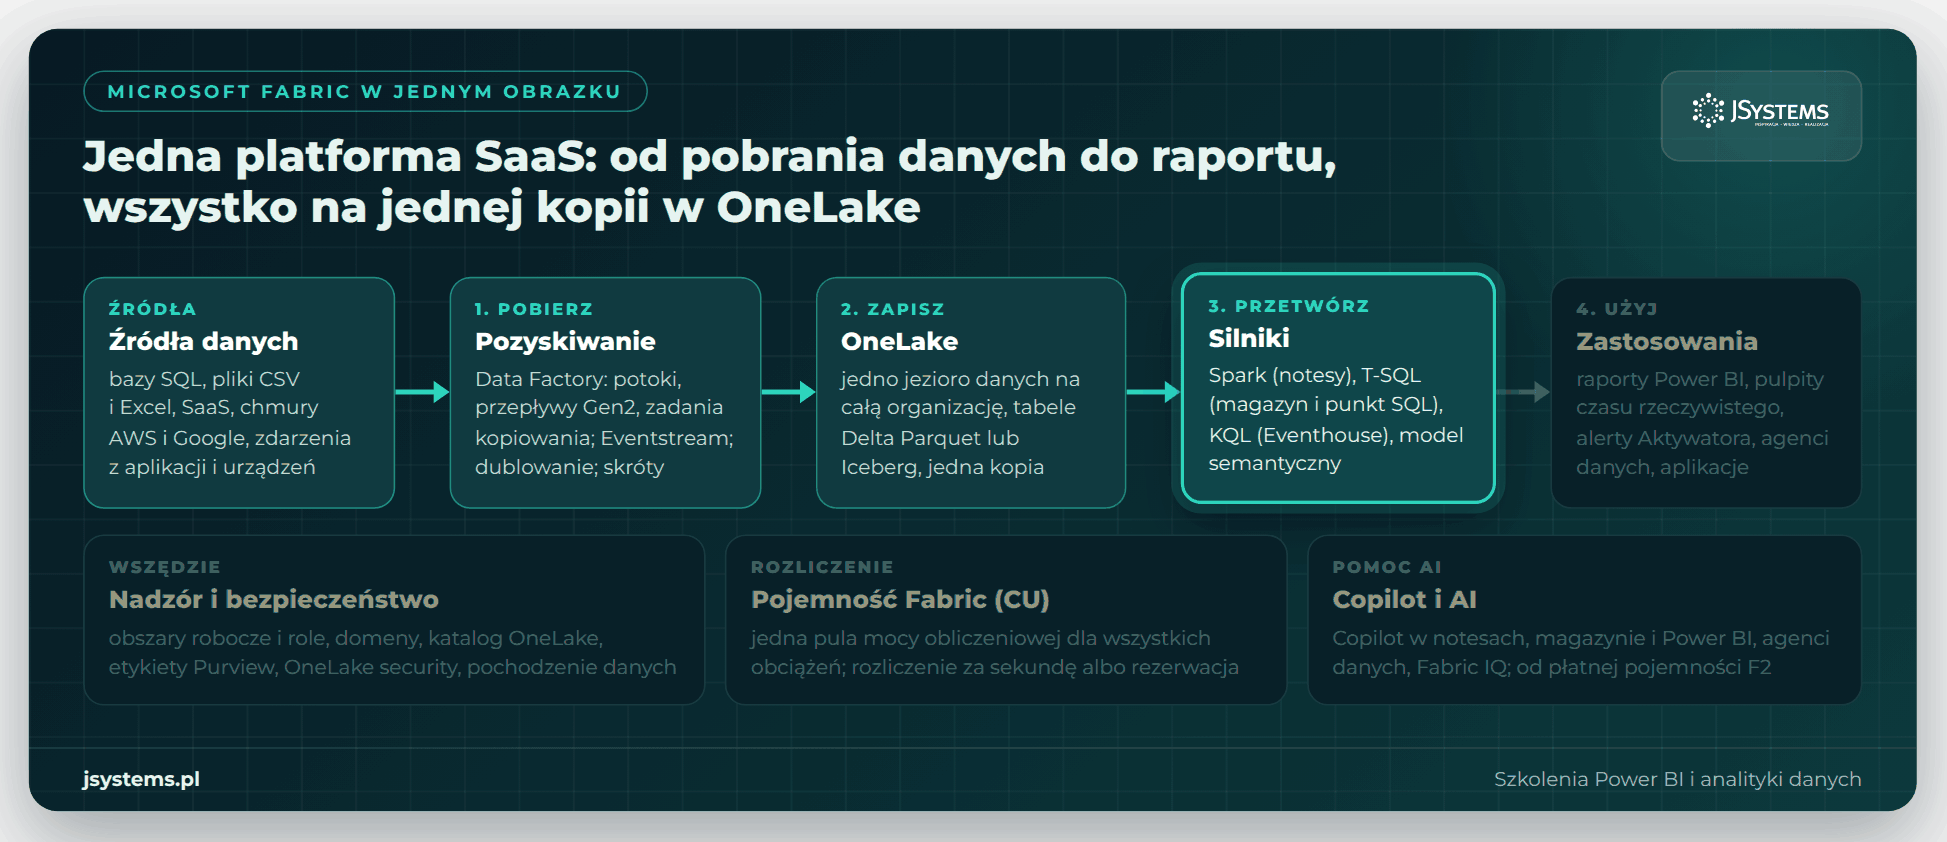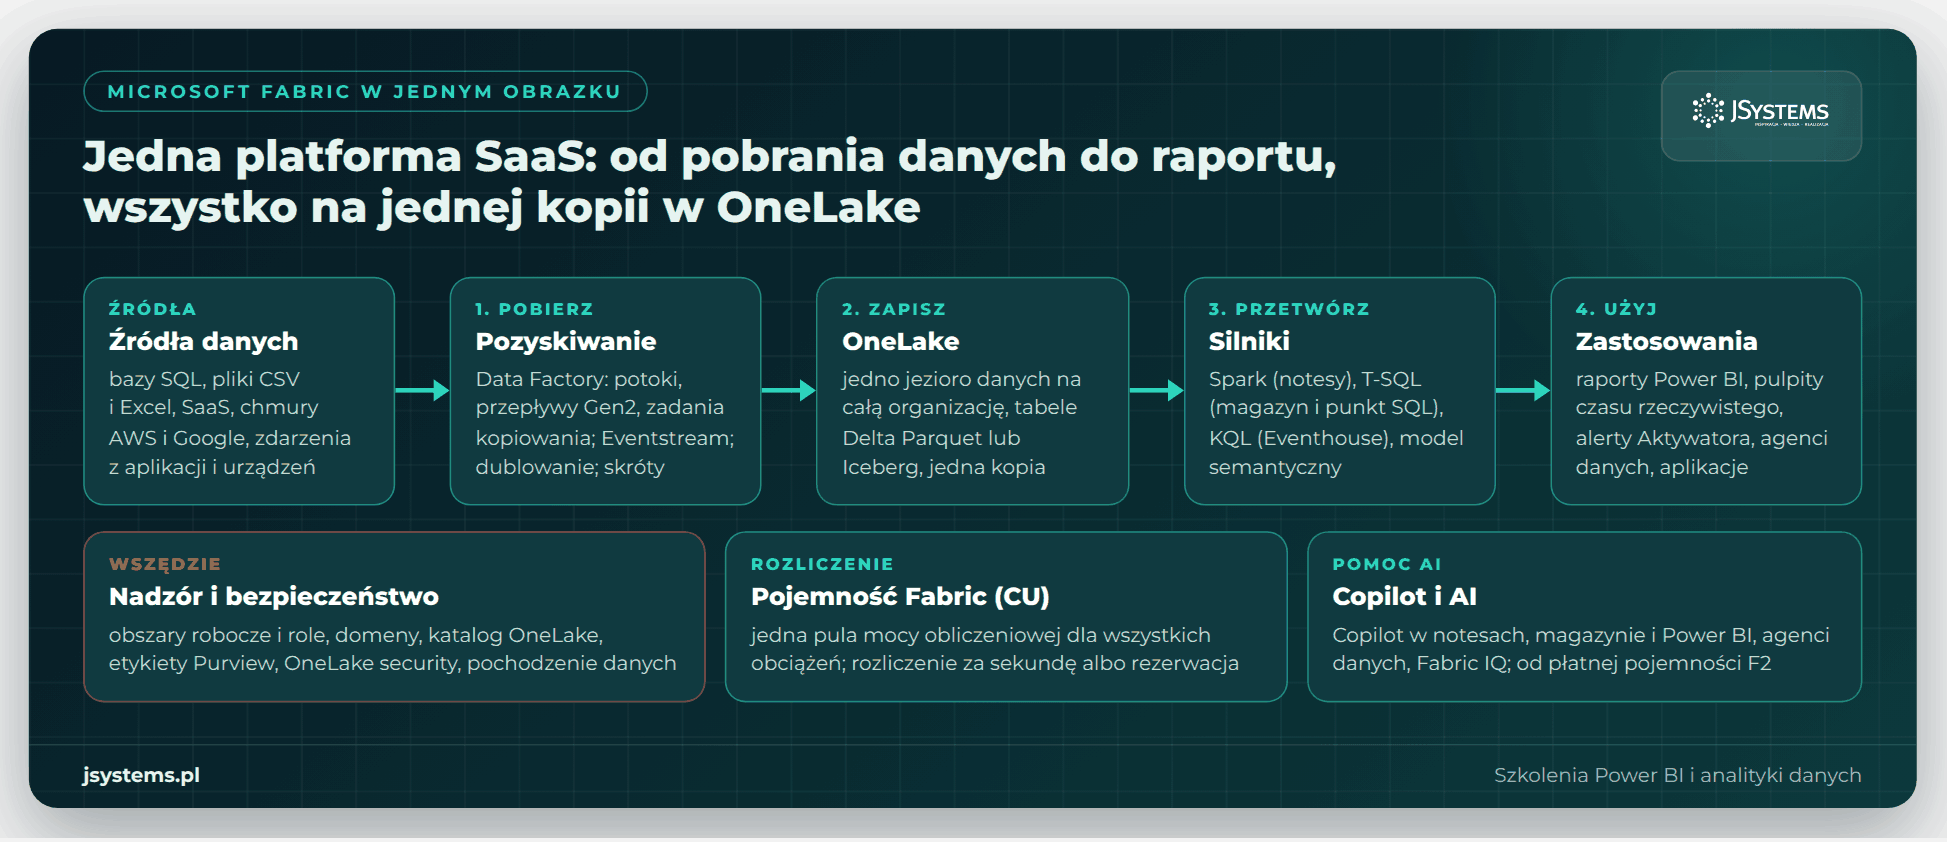
W skrócieMicrosoft Fabric to platforma analityczna Microsoftu w modelu SaaS, która w jednym miejscu łączy pobieranie danych, ich przetwarzanie, hurtownię, analizę w czasie rzeczywistym, naukę o danych i raporty Power BI. Wszystkie te narzędzia zapisują dane w jednym magazynie OneLake w otwartym formacie Delta Parquet i korzystają z jednej puli mocy obliczeniowej, czyli pojemności Fabric.
Ten przewodnik prowadzi od definicji do działającego rozwiązania. Najpierw wyjaśniamy pojęcia, bez których trudno się w Fabric odnaleźć: OneLake, obciążenia, obszar roboczy, pojemność, lakehouse i magazyn. Potem budujemy kompletny przykład dla fikcyjnej sieci sklepów z elektroniką Nordvella, która ma 15 sklepów stacjonarnych i sklep internetowy. Ładujemy eksport sprzedaży do lakehouse, przeliczamy go w notesie PySpark, odpytujemy w T-SQL, budujemy model Power BI w trybie Direct Lake z raportem, automatyzujemy odświeżanie potokiem Data Factory i podłączamy strumień transakcji z kas, który trafia na pulpit czasu rzeczywistego.
Cały przykład mieści się w bezpłatnej wersji próbnej Fabric (pojemność 4 CU, region Poland Central), więc każdy krok powtórzysz na tych samych plikach do pobrania. Na końcu omawiamy licencje i ceny, dławienie przy przeciążeniu pojemności, porównanie z Databricks, Snowflake i Synapse oraz plan nauki.
Z tego artykułu dowiesz się:
Pliki do pobrania: na nich pracujemy w całym przewodniku
Nordvella, jej sklepy, pracownicy i marki produktów są fikcyjne. Sprzedaż obejmuje 108 675 transakcji od stycznia 2022 do maja 2026 roku, z sezonowymi szczytami i zwrotami.
Microsoft opisuje Fabric jako platformę analityczną, która obsługuje kompletny przepływ pracy z danymi: pobieranie, przekształcanie, przetwarzanie strumieni w czasie rzeczywistym, analizę i raportowanie. W praktyce oznacza to, że narzędzia, które dotąd były osobnymi usługami Azure (Data Factory do przenoszenia danych, Synapse do Sparka i hurtowni) oraz usługa Power BI, działają w jednym portalu, na wspólnym magazynie danych i na wspólnej puli mocy obliczeniowej.
Fabric jest usługą typu SaaS (Software as a Service, oprogramowanie jako usługa). Nie instalujesz serwerów, nie konfigurujesz klastrów Sparka i nie aktualizujesz silników baz danych. Logujesz się kontem służbowym Microsoft 365 na stronie app.fabric.microsoft.com, a Microsoft dba o infrastrukturę, kopie zapasowe i nowe wersje. Firma decyduje tylko, ile mocy obliczeniowej kupuje i w którym regionie chmury mają leżeć dane.
| Rola | Co robi w Fabric | Główne elementy |
|---|---|---|
| Analityk biznesowy | buduje raporty, przygotowuje dane bez kodu | raport i model semantyczny Power BI, przepływ danych Gen2 |
| Inżynier danych | ładuje i przelicza dane, buduje warstwy jeziora | lakehouse, notes, potok, definicja zadania Spark |
| Deweloper SQL | projektuje hurtownię, pisze procedury i widoki | magazyn (Warehouse), punkt końcowy analizy SQL |
| Analityk danych zdarzeniowych | śledzi logi, czujniki i transakcje na bieżąco | Eventstream, Eventhouse, zestaw zapytań KQL, pulpit czasu rzeczywistego |
| Data scientist | trenuje i ocenia modele uczenia maszynowego | notes, eksperyment i model ML (MLflow) |
| Administrator | zarządza pojemnością, obszarami i zasadami | portal administracyjny, aplikacja metryk pojemności, domeny |
Według Microsoftu (listopad 2025) Fabric ma ponad 28 000 klientów, w tym 80% firm z listy Fortune 500. Dla działu, który dziś ma raporty Power BI, kilka baz danych i pliki eksportowane do Excela, najważniejsze jest jednak coś innego: Fabric pozwala zbudować porządne źródło danych do raportów bez osobnej hurtowni, osobnego narzędzia ETL i osobnych faktur za każde z nich.
Microsoft ogłosił Fabric 23 maja 2023 roku na konferencji Build jako platformę, która łączy Azure Data Factory, Azure Synapse Analytics i Power BI w jeden produkt. Na starcie było siedem obciążeń, z czego większość w wersji zapoznawczej (preview), a Data Activator miał dopiero dojść. Ogólna dostępność (GA, general availability, czyli wersja produkcyjna objęta pełnym wsparciem) przyszła 15 listopada 2023 roku na konferencji Ignite.
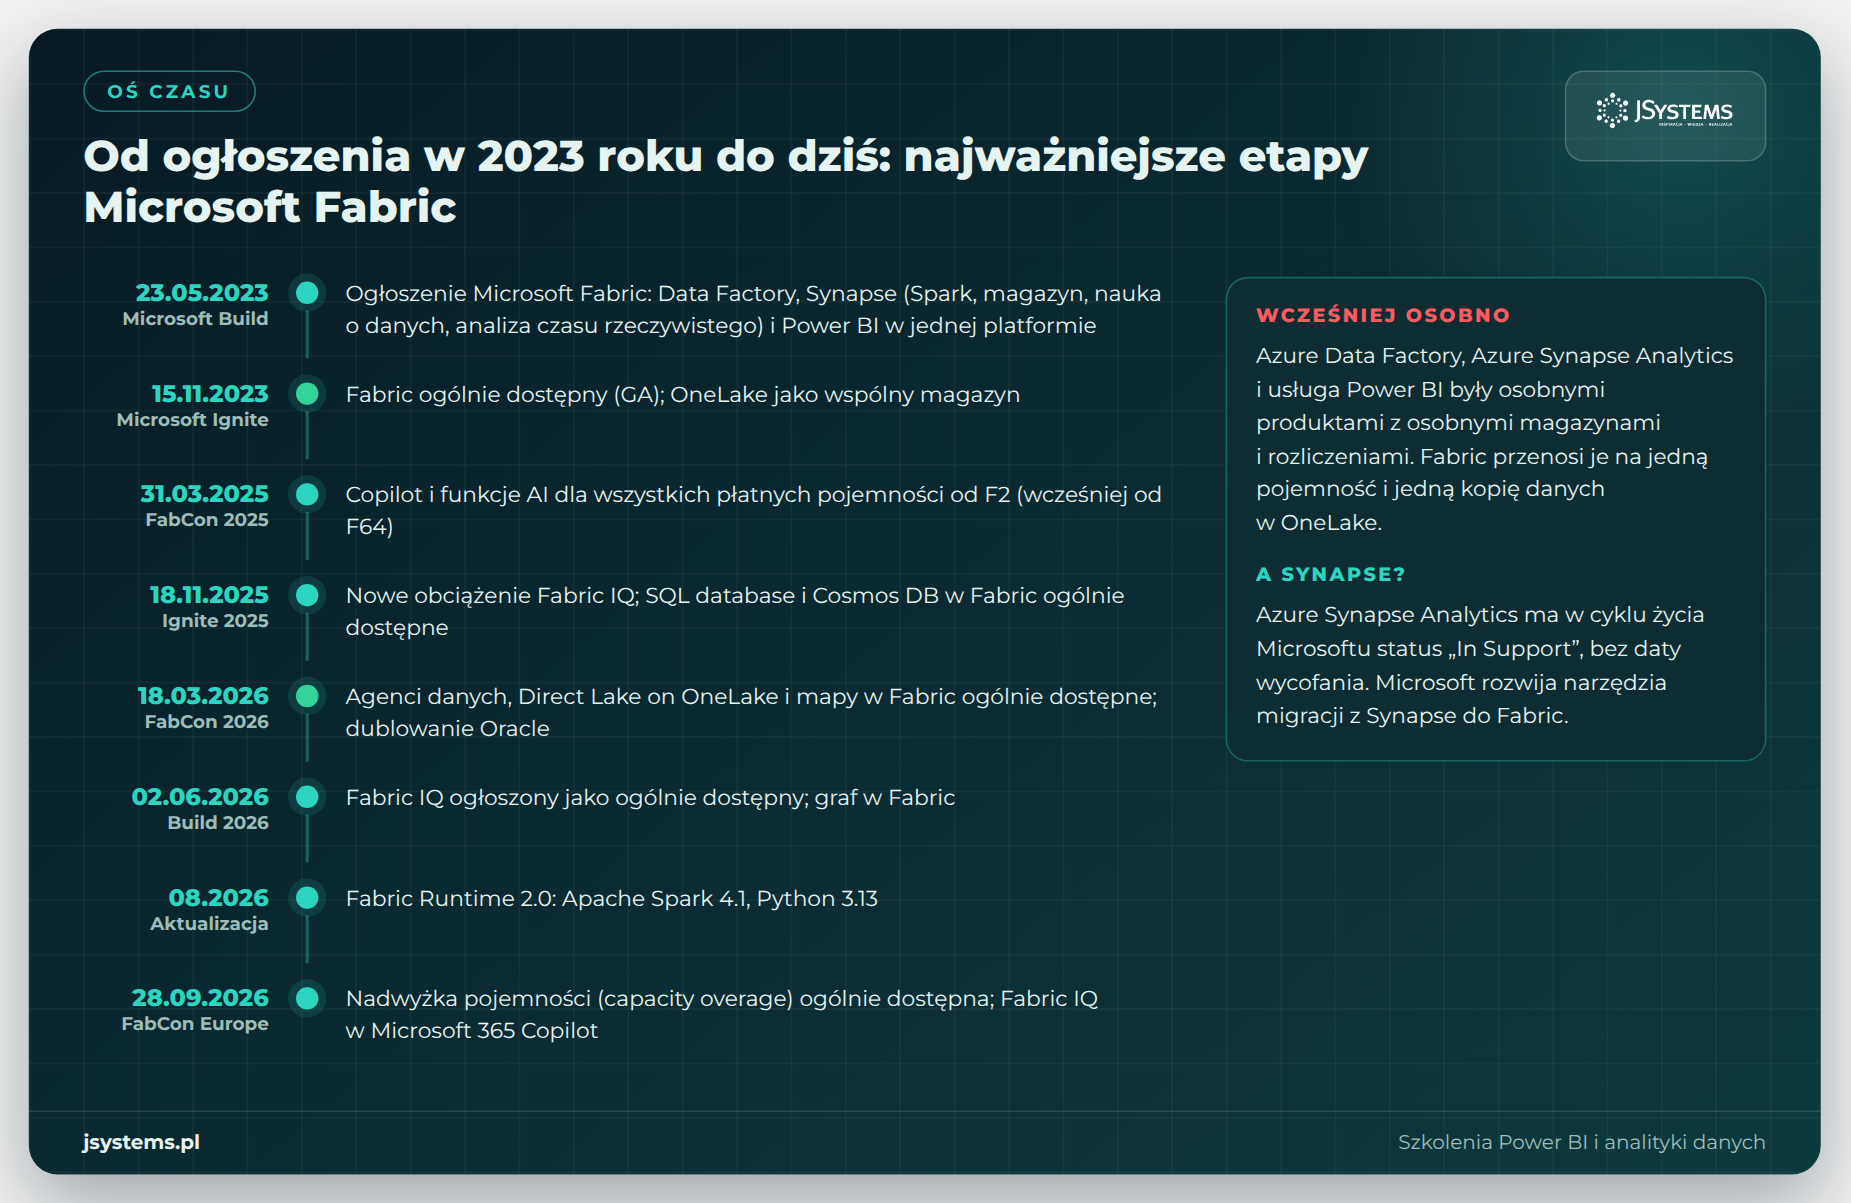
Od tamtej pory platforma wyraźnie urosła. Doszły bazy transakcyjne (SQL database i Cosmos DB w Fabric są ogólnie dostępne od listopada 2025), agenci danych do rozmowy z danymi w języku naturalnym, tryb Direct Lake on OneLake, dublowanie kolejnych baz, w tym Oracle i Google BigQuery, oraz obciążenie Fabric IQ, które opisuje dane w kategoriach biznesowych dla ludzi i agentów AI. W sierpniu 2026 roku ukazał się Fabric Runtime 2.0 z Apache Spark 4.1 i Pythonem 3.13.
Dawne pojemności Power BI Premium (jednostki P1-P5) Microsoft wycofuje, a nowe wdrożenia mają korzystać z pojemności Fabric (jednostki F). W kreatorze nowego obszaru roboczego typ „Power BI Premium” ma już dopisek, że został wycofany. Jeśli Twoja firma ma dziś pojemność Premium, przejście na F to dobry moment, żeby przy okazji przemyśleć, które dane warto przenieść do OneLake.
Nie ma na to dowodu. W zasadach cyklu życia produktów Microsoftu Azure Synapse Analytics ma status „In Support” bez daty wycofania. Jednocześnie Microsoft rozwija narzędzia migracji: przewodnik przenoszenia zadań Spark z Synapse do Fabric, wbudowane w Fabric przenoszenie hurtowni Synapse oraz asystentów migracji z Azure Data Factory, Synapse i Azure SQL. Nowe funkcje, takie jak agenci danych czy Direct Lake, powstają w Fabric. Rozsądne podejście: istniejące rozwiązania na Synapse mogą działać dalej, a nowe projekty analityczne warto planować w Fabric.
OneLake to logiczne jezioro danych (data lake, czyli magazyn plików, w którym trzyma się dane w surowej i przetworzonej postaci), wbudowane w Fabric. Każda dzierżawa, czyli organizacja zarejestrowana w Microsoft Entra ID, ma dokładnie jeden OneLake i dostaje go automatycznie, tak jak każdy pracownik dostaje OneDrive. Nie zakładasz kont magazynu i nie konfigurujesz kontenerów: dane każdego nowego elementu od razu trafiają do OneLake.
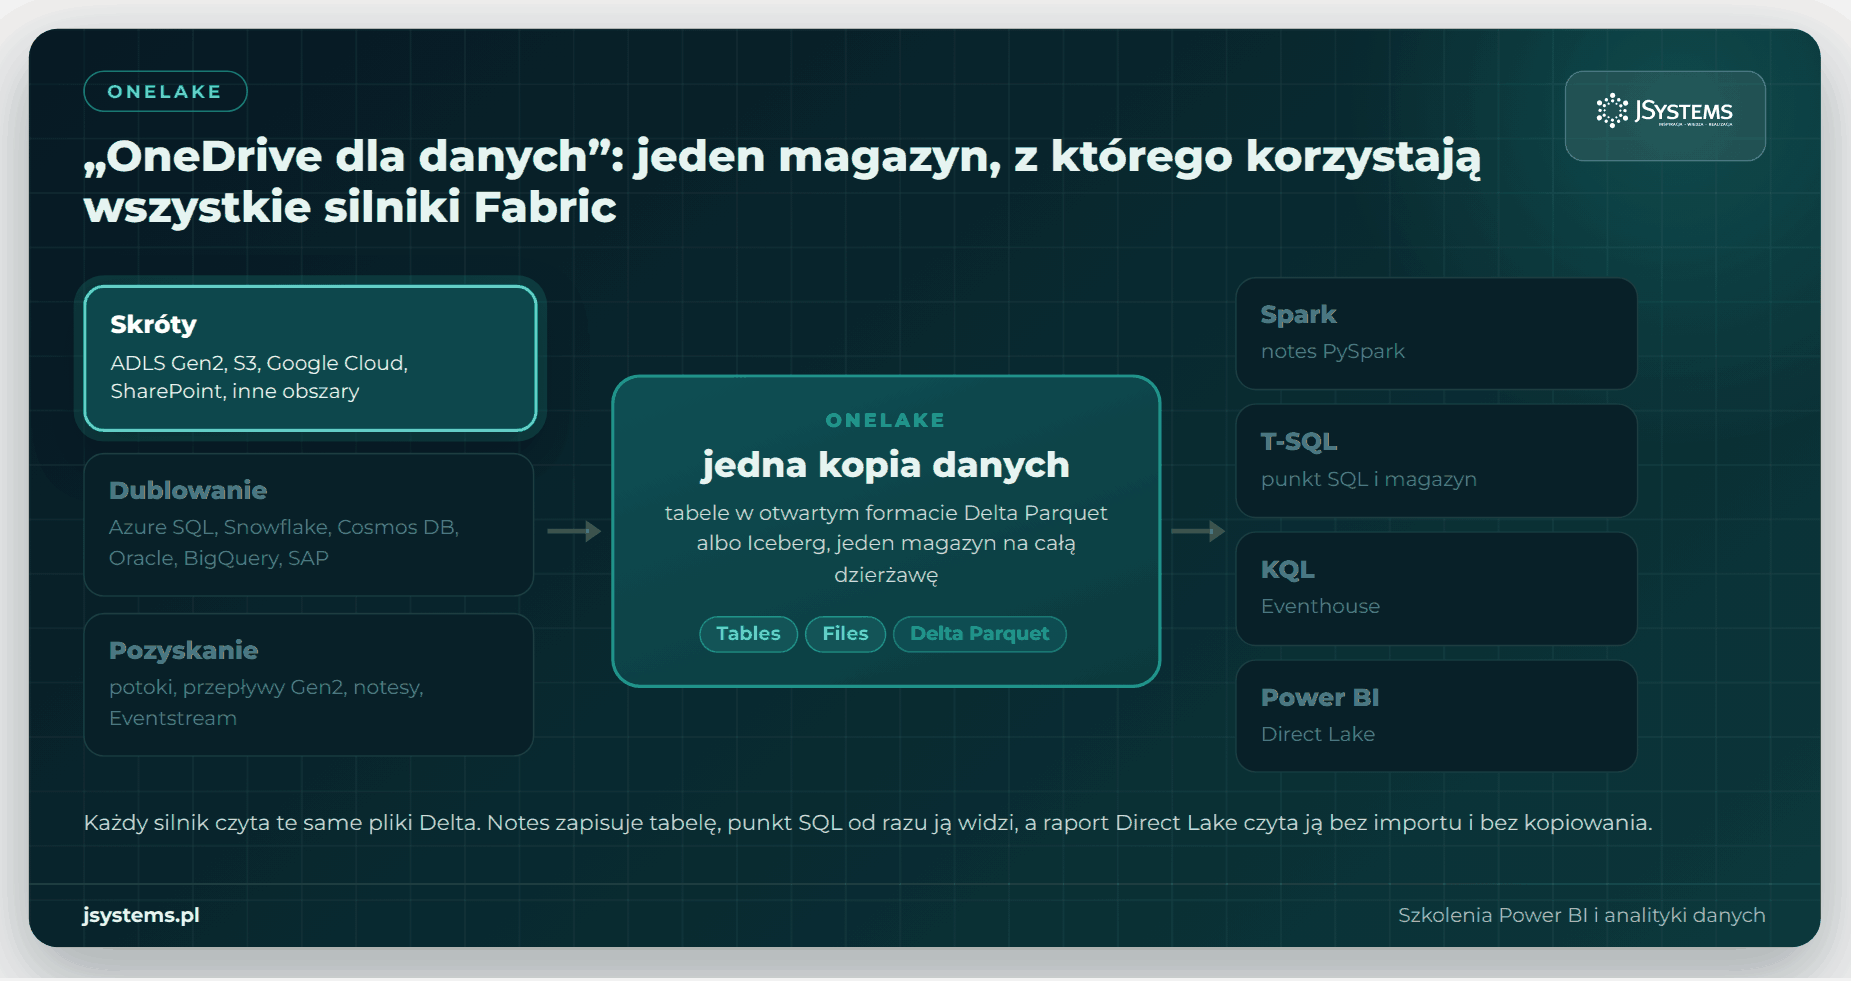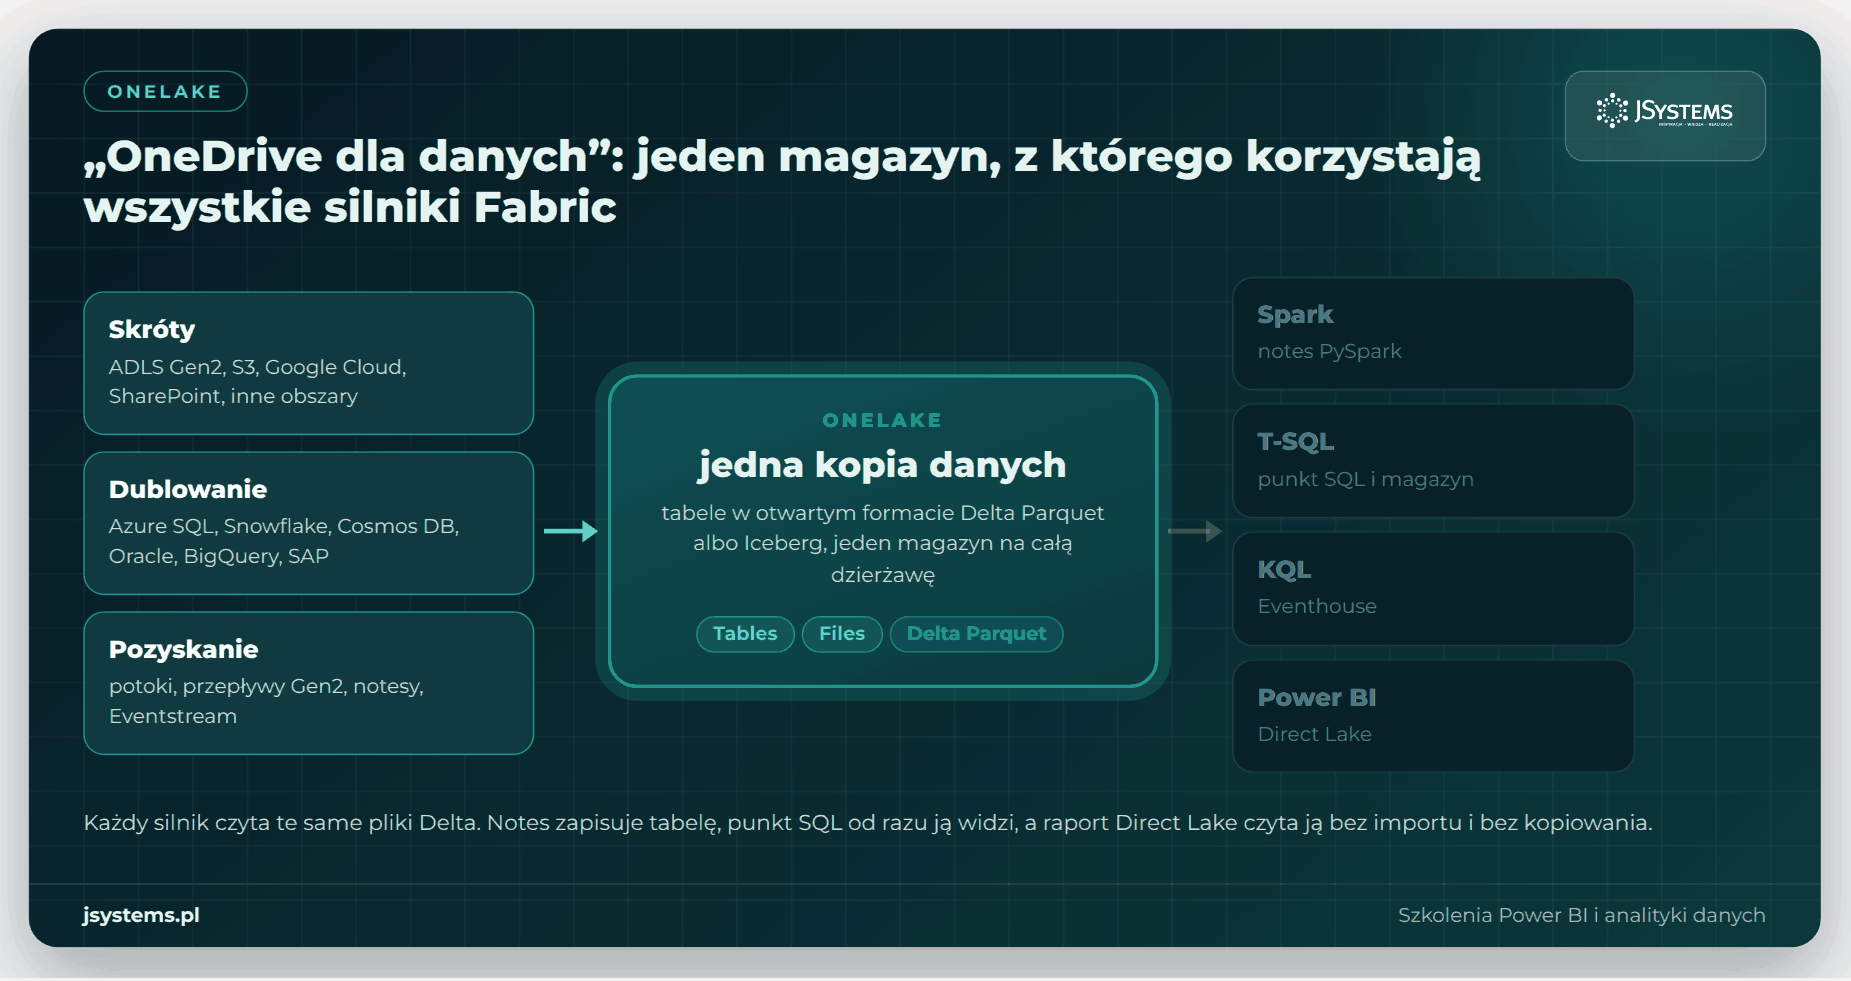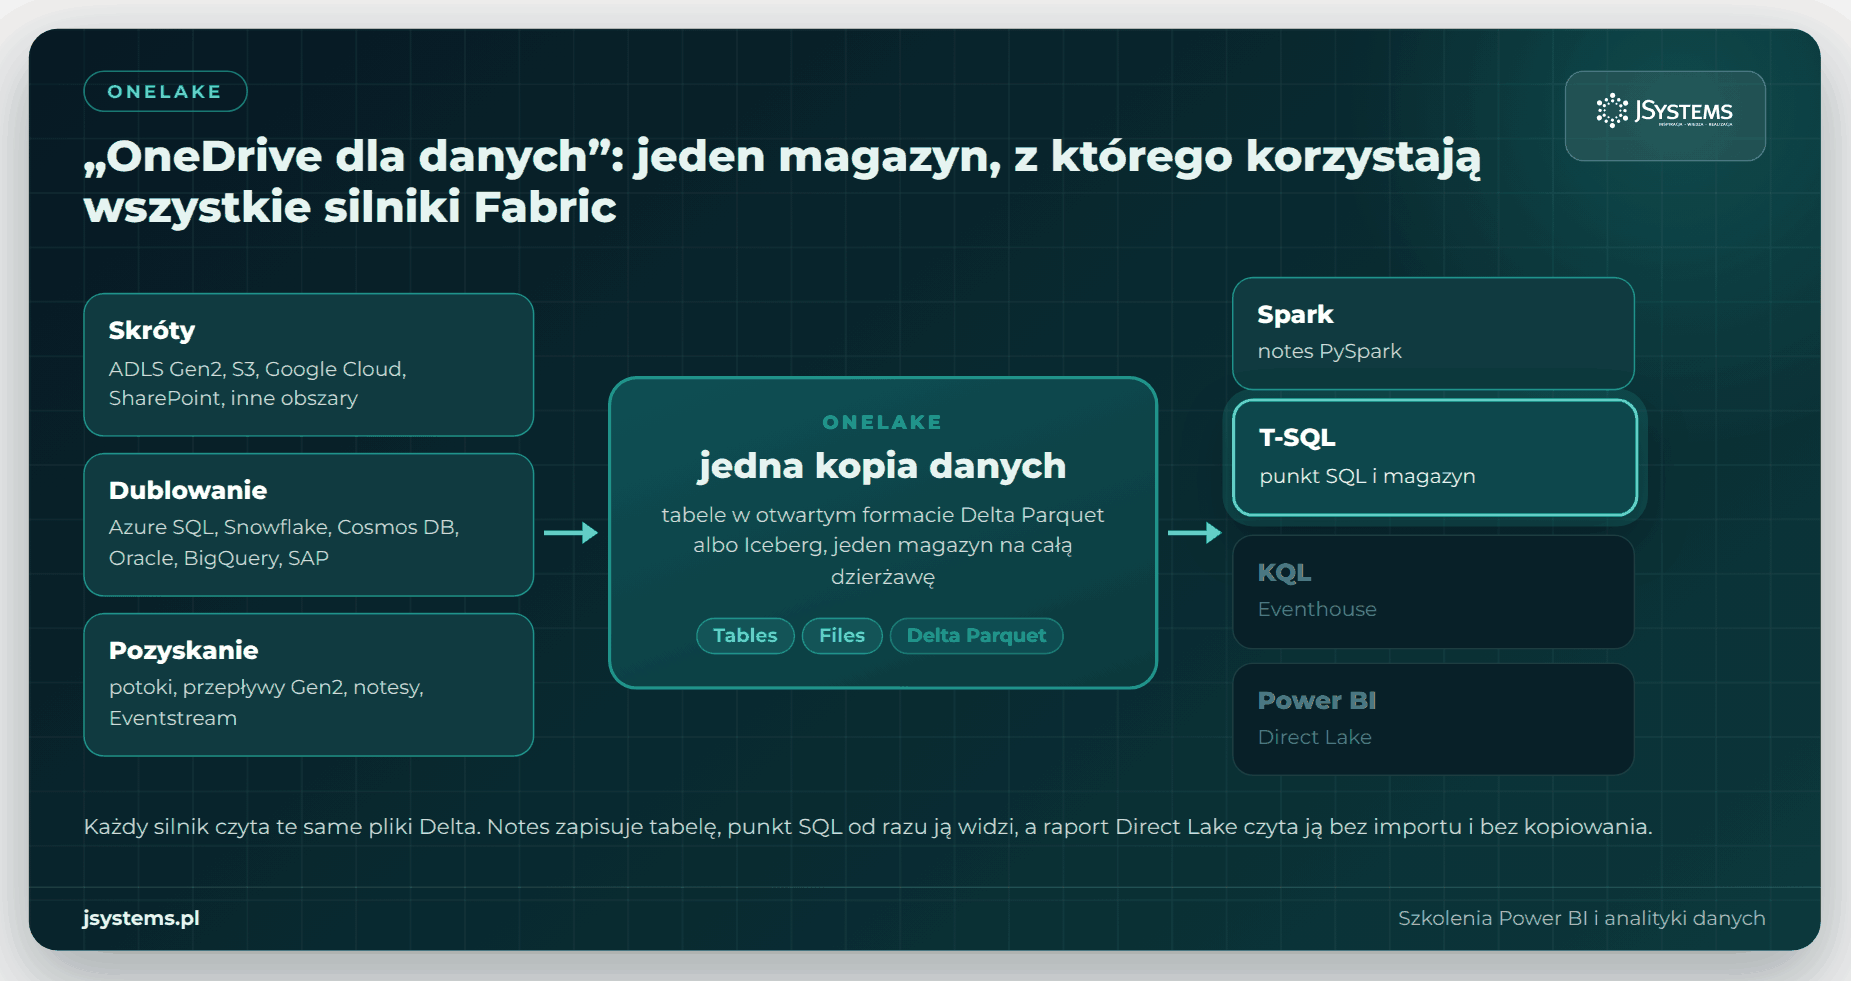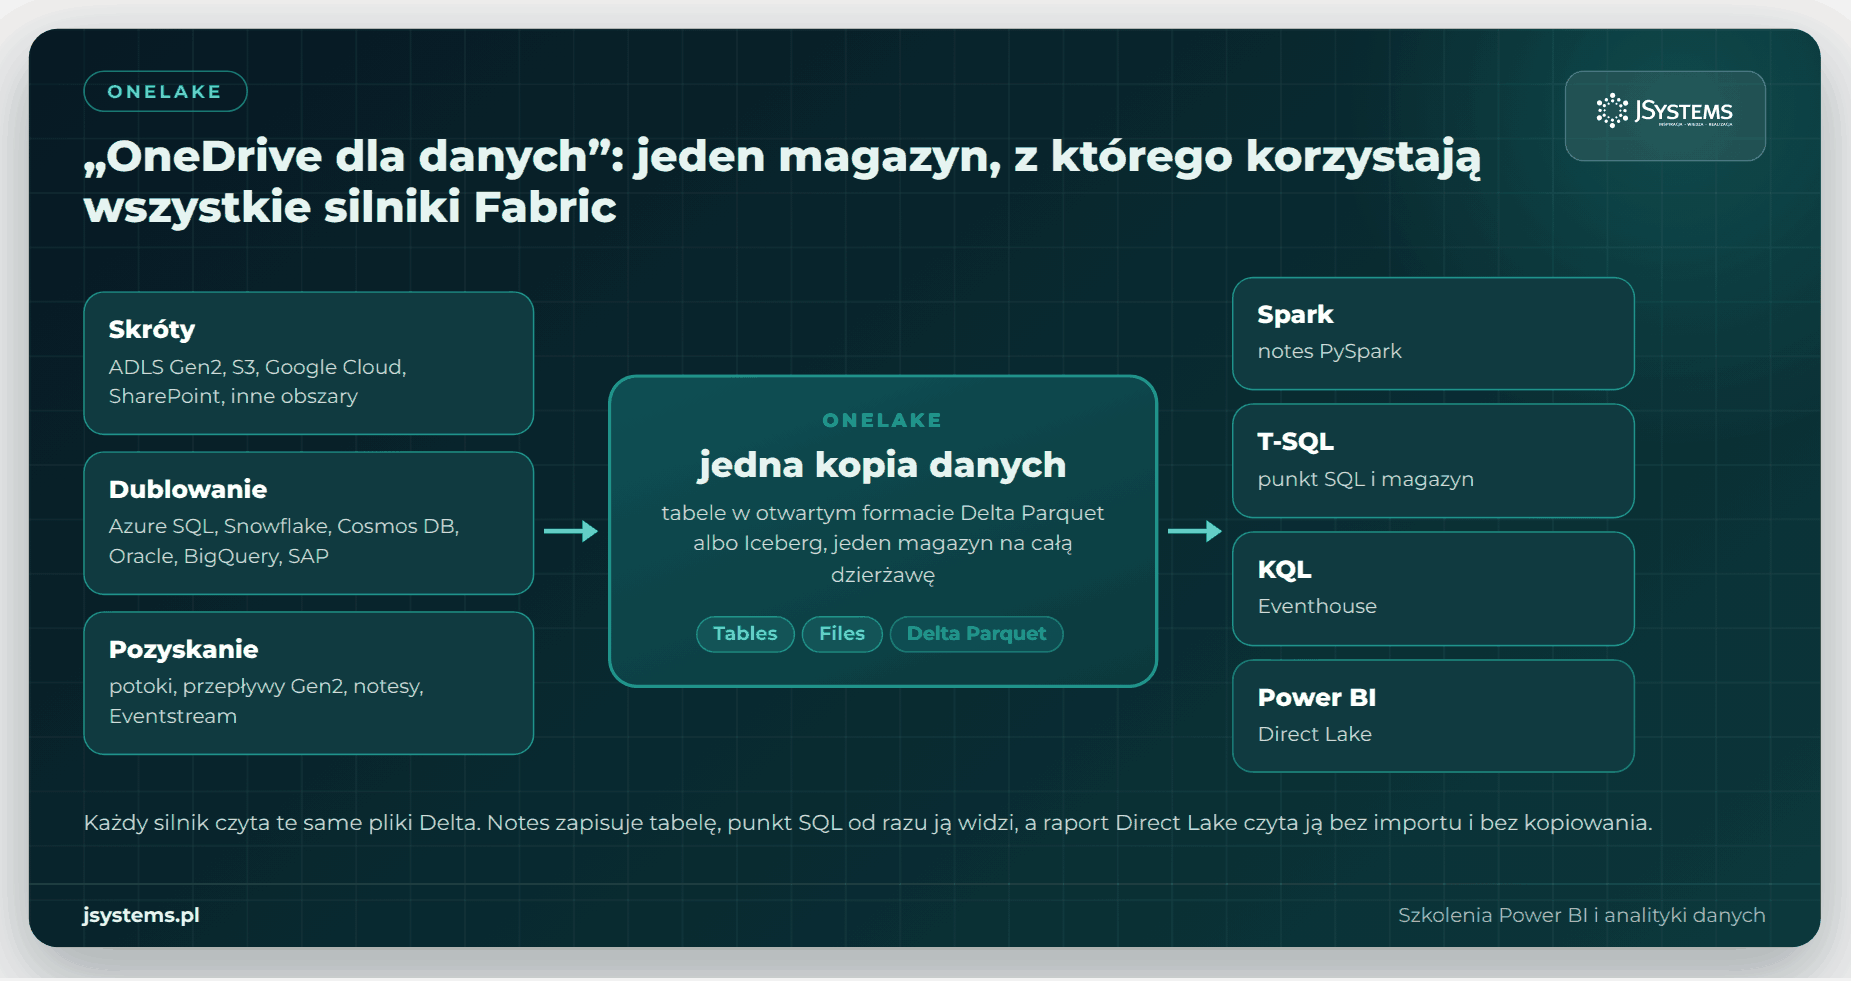
Struktura OneLake odpowiada strukturze Fabric: dzierżawa dzieli się na obszary robocze, w obszarach są elementy (lakehouse, magazyn, baza KQL), a w elementach tabele i pliki. Tabele są zapisywane w otwartym formacie Delta Parquet albo Iceberg, czyli w plikach Parquet z dziennikiem transakcji. Dzięki temu ten sam plik może przeczytać Spark, silnik SQL, Power BI i narzędzia spoza Microsoftu, które obsługują Delta Lake. OneLake ma też interfejs zgodny z Azure Data Lake Storage Gen2, więc istniejące narzędzia i biblioteki łączą się z nim jak ze zwykłym kontem magazynu.
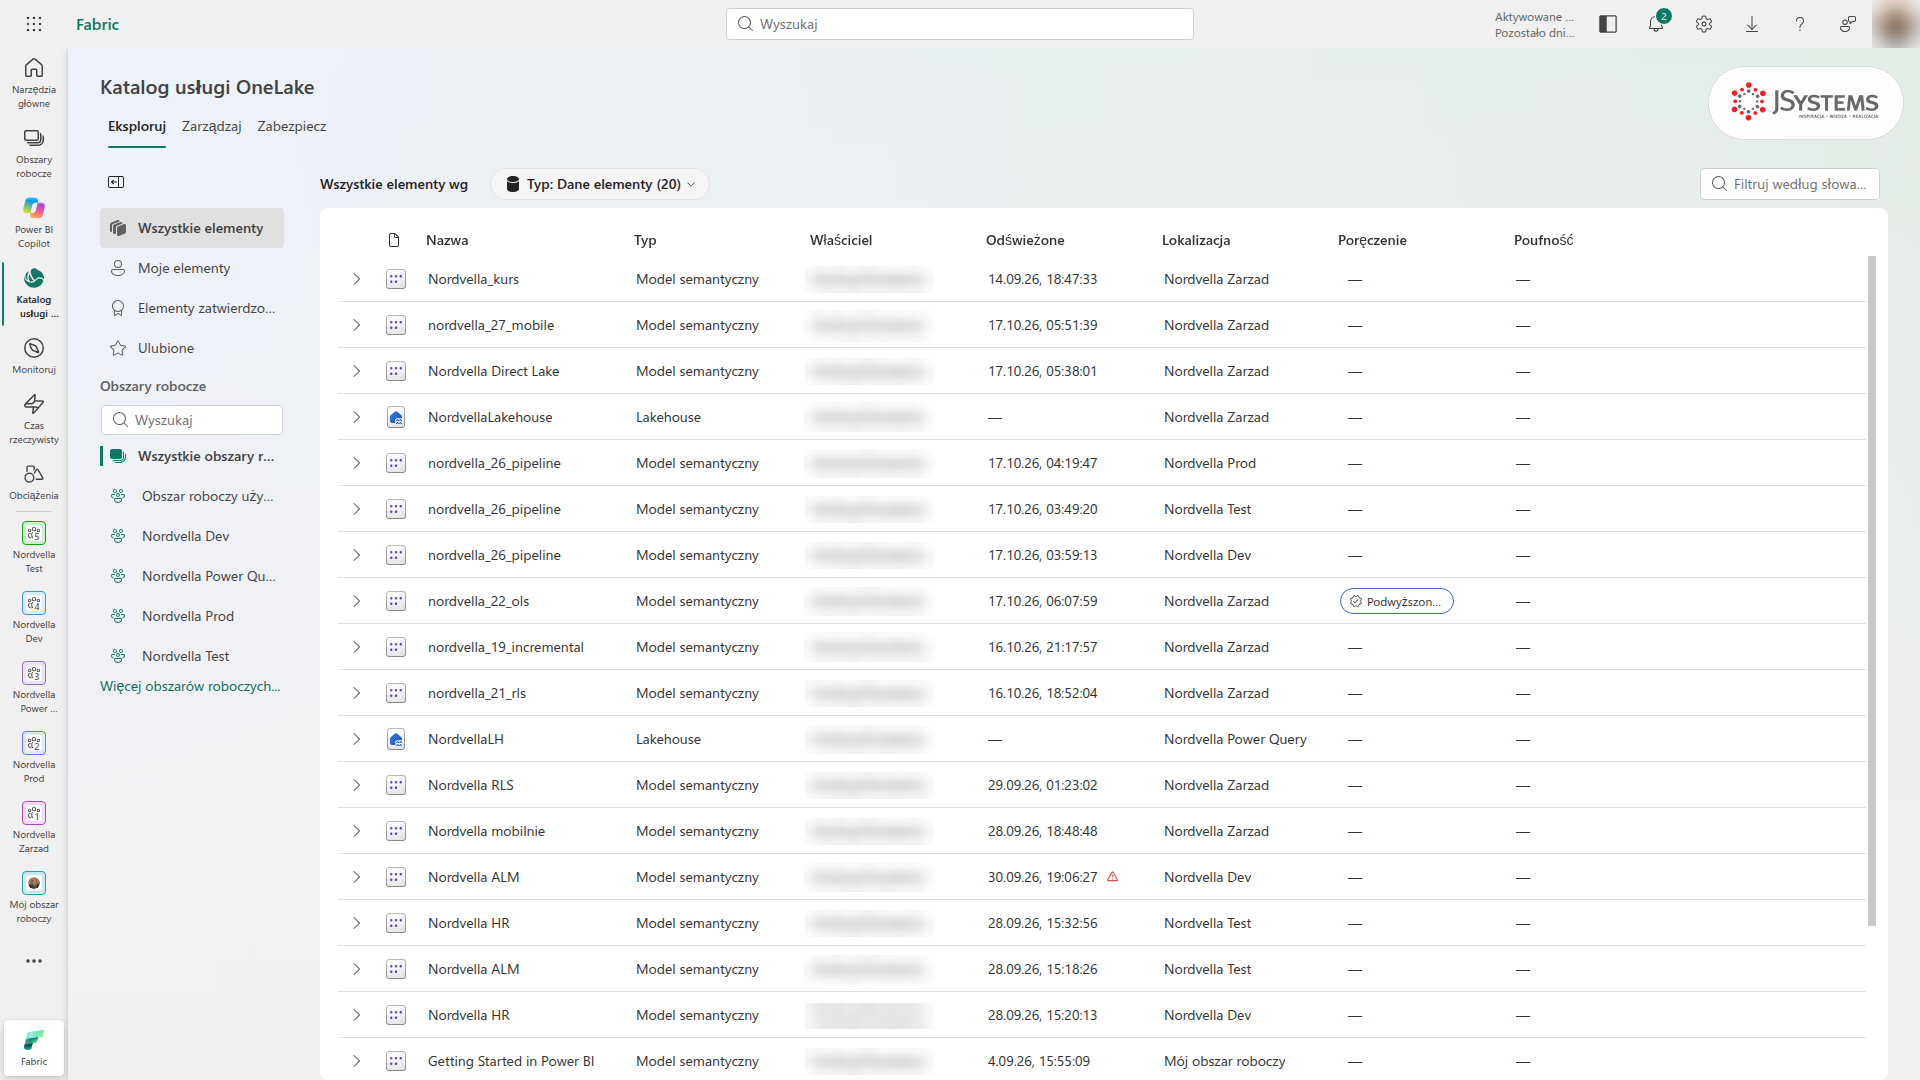
Katalog OneLake to wyszukiwarka wszystkich elementów z danymi, do których masz dostęp, we wszystkich obszarach roboczych. Widać w nim typ elementu, właściciela, datę odświeżenia, obszar roboczy i oznaczenie poręczenia (promowany albo certyfikowany). Z tego miejsca zaczyna się zwykle szukanie danych przed budową nowego raportu.
Skrót (shortcut) to odnośnik w lakehouse albo magazynie, który pokazuje dane leżące gdzie indziej tak, jakby były na miejscu. Działa podobnie do skrótu na pulpicie: dane zostają w źródle, a usunięcie skrótu nie usuwa danych. Źródłem może być inny element OneLake, także w innej dzierżawie, albo zewnętrzny magazyn w chmurze.
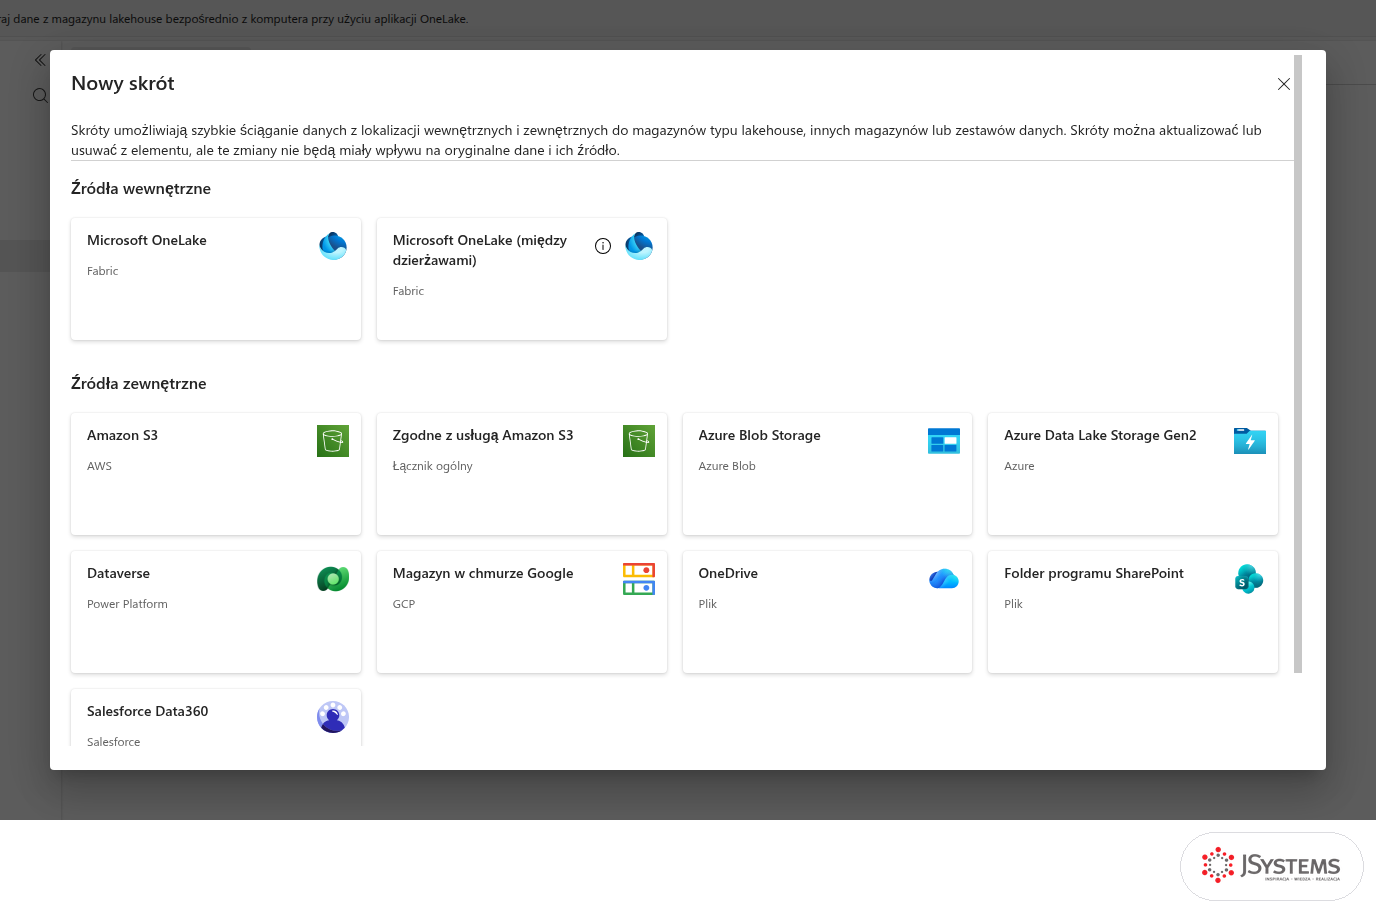
Skróty przydają się, gdy dane już leżą w porządnym jeziorze, np. w Amazon S3 albo ADLS Gen2 używanym przez Databricks, a chcesz je tylko odczytać w Fabric. Odczyt przez skrót z innej chmury może kosztować transfer danych po stronie tamtego dostawcy (np. opłaty za ruch wychodzący w AWS), więc przy dużych i często czytanych tabelach policz, czy taniej nie wyjdzie kopia.
Dublowanie (mirroring) utrzymuje w OneLake aktualną replikę bazy operacyjnej, np. Azure SQL Database, Azure Cosmos DB, Snowflake, Oracle, Google BigQuery, SAP Datasphere albo katalogu Azure Databricks. Fabric sam przenosi zmiany, a replika od razu jest dostępna jako tabele Delta dla Sparka, SQL i Power BI. Moc obliczeniowa zużywana na replikację w tle jest bezpłatna i nie obciąża pojemności, a każda kupiona jednostka CU daje 1 TB bezpłatnego miejsca na repliki (F64 to 64 TB). Ten darmowy limit nie obejmuje wersji próbnej, a wstrzymana pojemność oznacza, że replikacja staje.
Najlepiej widać ideę OneLake w menu „Analizuj dane za pomocą” w lakehouse. Tę samą tabelę możesz otworzyć w notesie (Spark), w punkcie końcowym analizy SQL (T-SQL) albo w punkcie końcowym domu wydarzeń (KQL), bez eksportu i bez czekania na kopię.
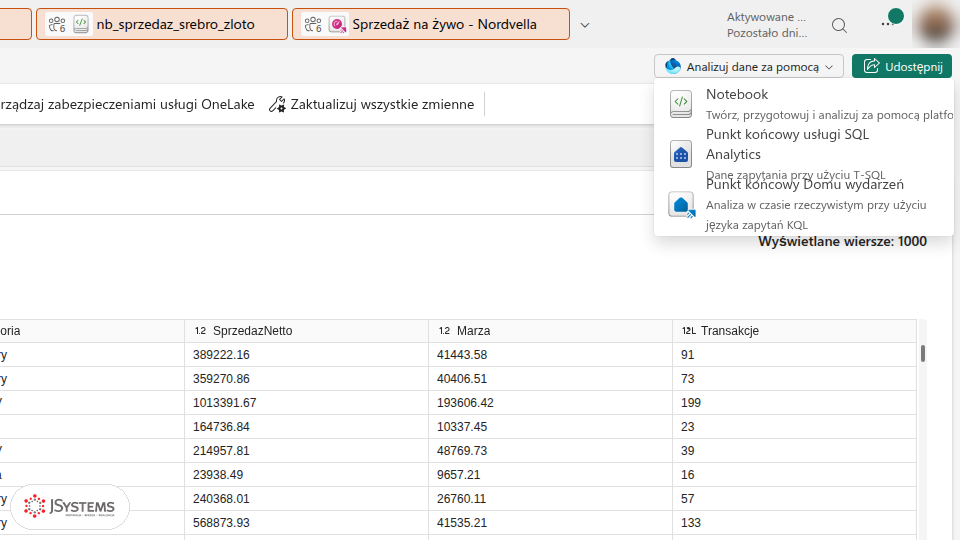
Dwa szczegóły, które warto znać od początku. Usunięte pliki OneLake przez 7 dni można odzyskać (miękkie usuwanie). Dla Windows jest eksplorator plików OneLake, który pokazuje jezioro jak dysk sieciowy, co ułatwia wgrywanie i podgląd plików bez przeglądarki.
Fabric dzieli funkcje na obciążenia (workloads), czyli zestawy narzędzi do jednego rodzaju pracy. Obciążenie nie jest osobną usługą do kupienia: wszystkie są dostępne w każdym obszarze roboczym na pojemności Fabric i zużywają moc z tej samej puli. Pracujesz na elementach (items), takich jak lakehouse, notes czy raport, które tworzysz w obszarze roboczym.
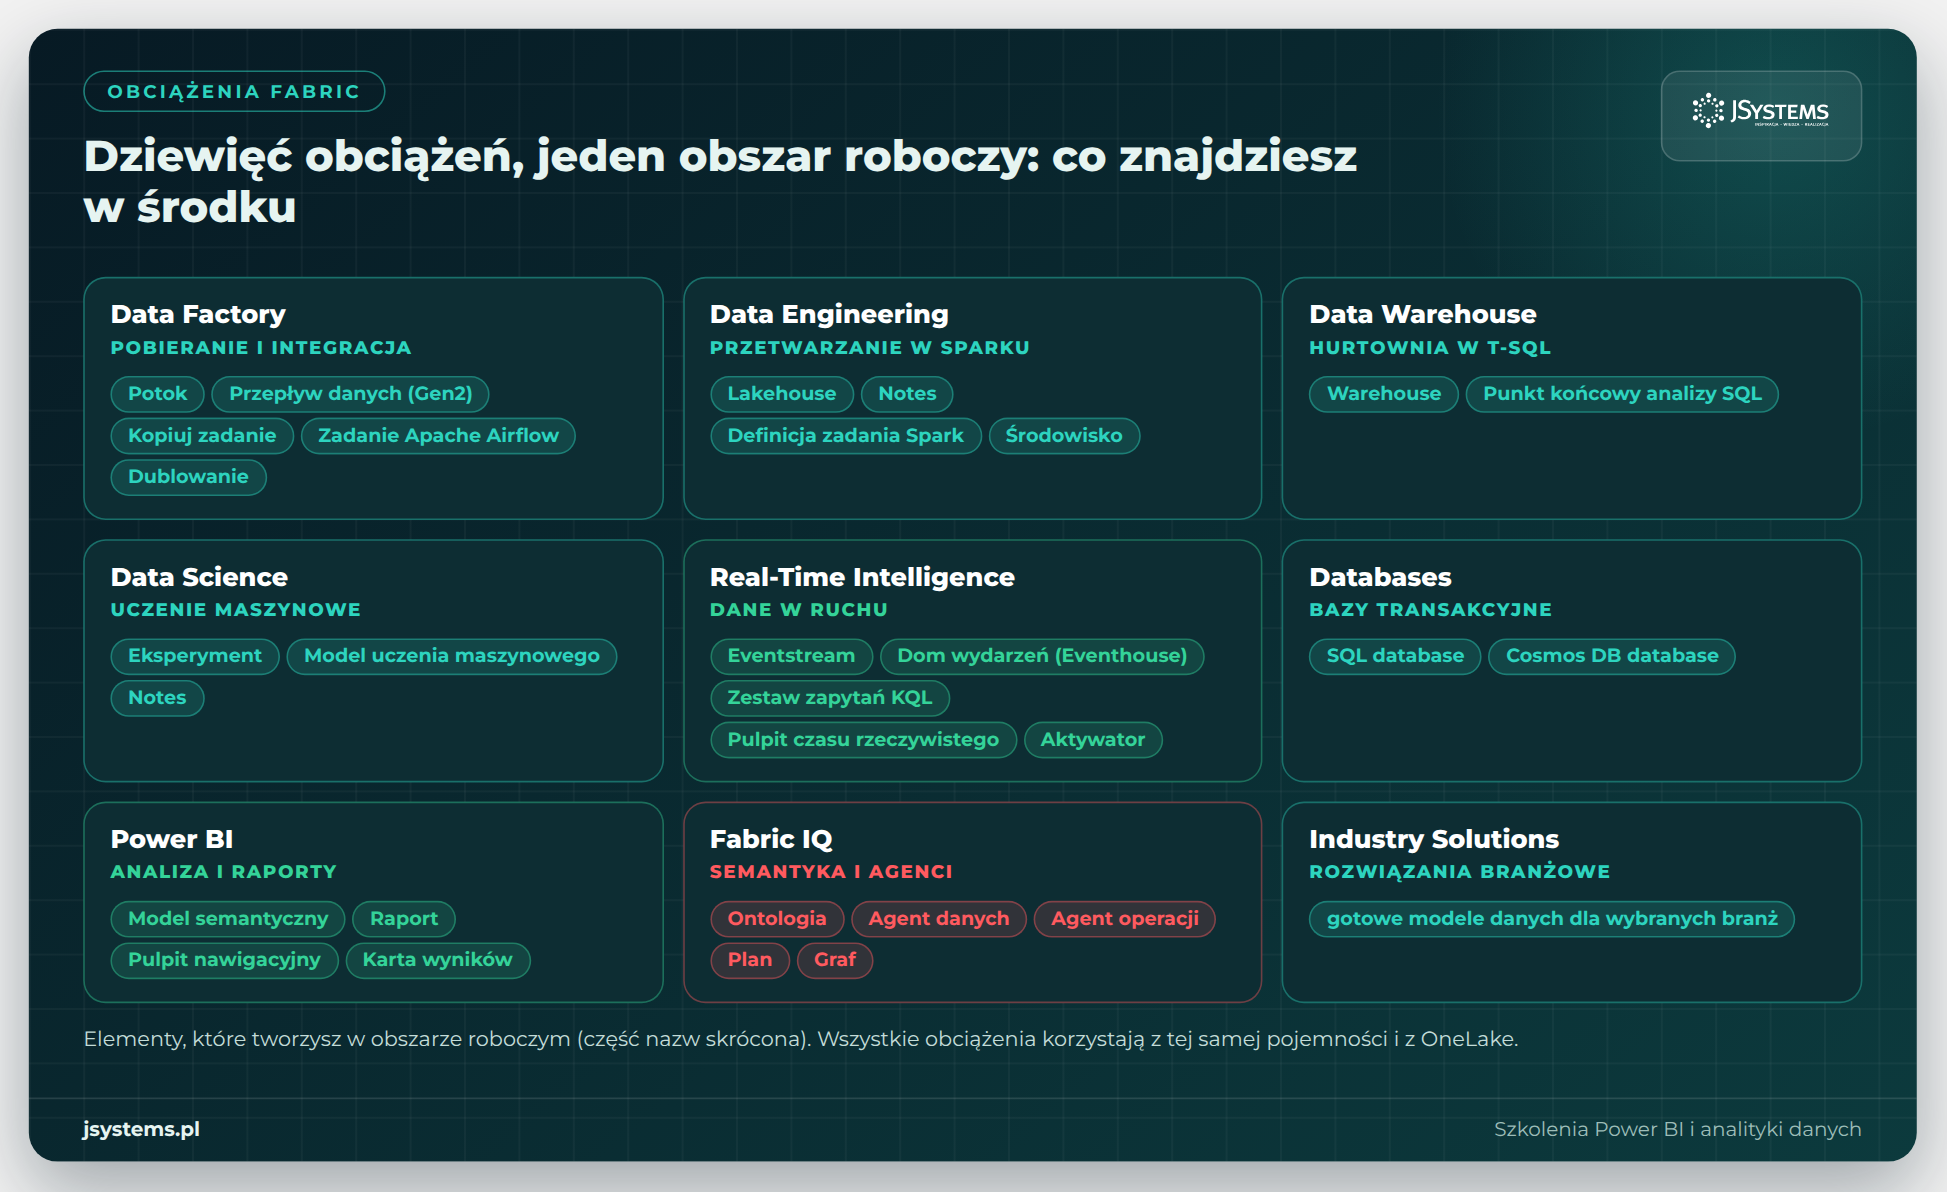
| Obciążenie | Do czego służy | Przykład z Nordvelli |
|---|---|---|
| Data Factory | pobieranie i integracja danych: potoki, przepływy danych Gen2 (Power Query w przeglądarce), zadania kopiowania, dublowanie, zadania Apache Airflow i dbt | codzienne pobranie eksportu z kas |
| Data Engineering | przetwarzanie w Apache Spark: lakehouse, notesy, definicje zadań Spark, środowiska z bibliotekami | oczyszczenie i agregacja sprzedaży |
| Data Warehouse | hurtownia w T-SQL z pełnym zapisem i transakcjami | tabela dla kontrolingu |
| Data Science | uczenie maszynowe: notesy, eksperymenty i modele w MLflow, ocena modeli funkcją PREDICT | prognoza sprzedaży sklepów |
| Real-Time Intelligence | dane w ruchu: Eventstream, Eventhouse z bazą KQL, pulpity czasu rzeczywistego, Aktywator do alertów | transakcje z kas na bieżąco |
| Databases | bazy transakcyjne w Fabric: SQL database i Cosmos DB, z automatyczną kopią w OneLake | baza aplikacji lojalnościowej |
| Power BI | modele semantyczne, raporty, pulpity, karty wyników i aplikacje | raport sprzedaży dla zarządu |
| Fabric IQ | ontologia, graf, plan i agenci: opis danych w kategoriach biznesowych | wspólna definicja „sklepu” i „klienta” |
| Industry Solutions | gotowe rozwiązania danych dla wybranych branż | nie używamy w przykładzie |
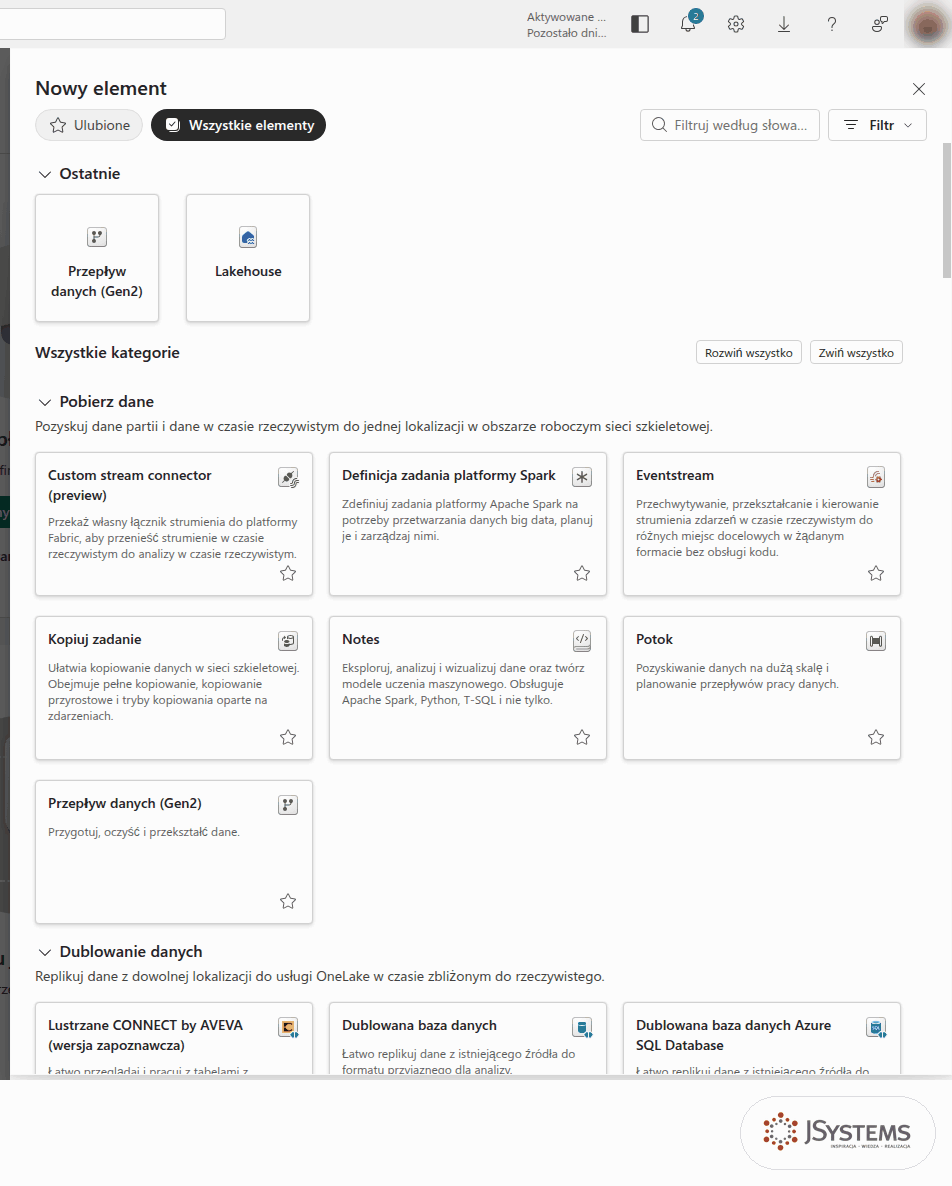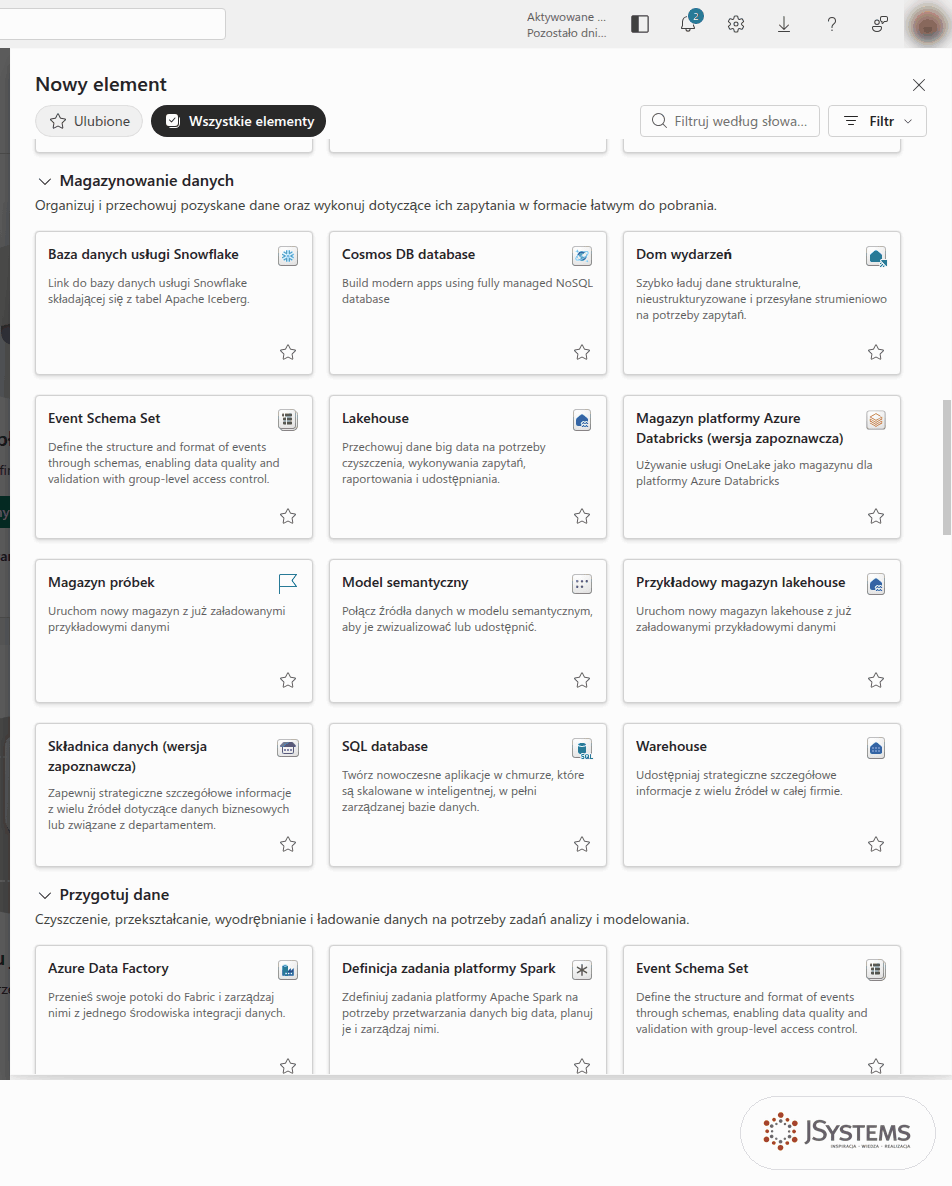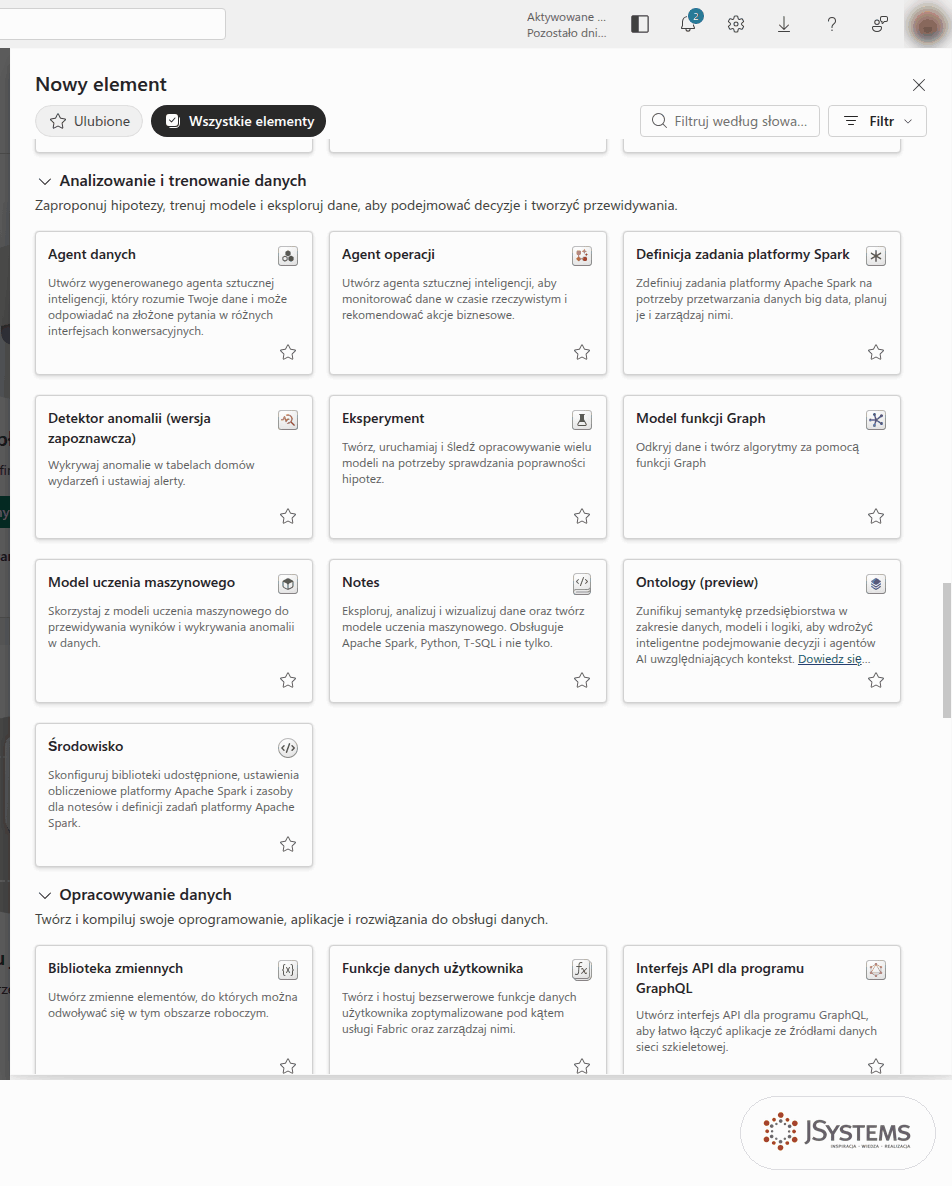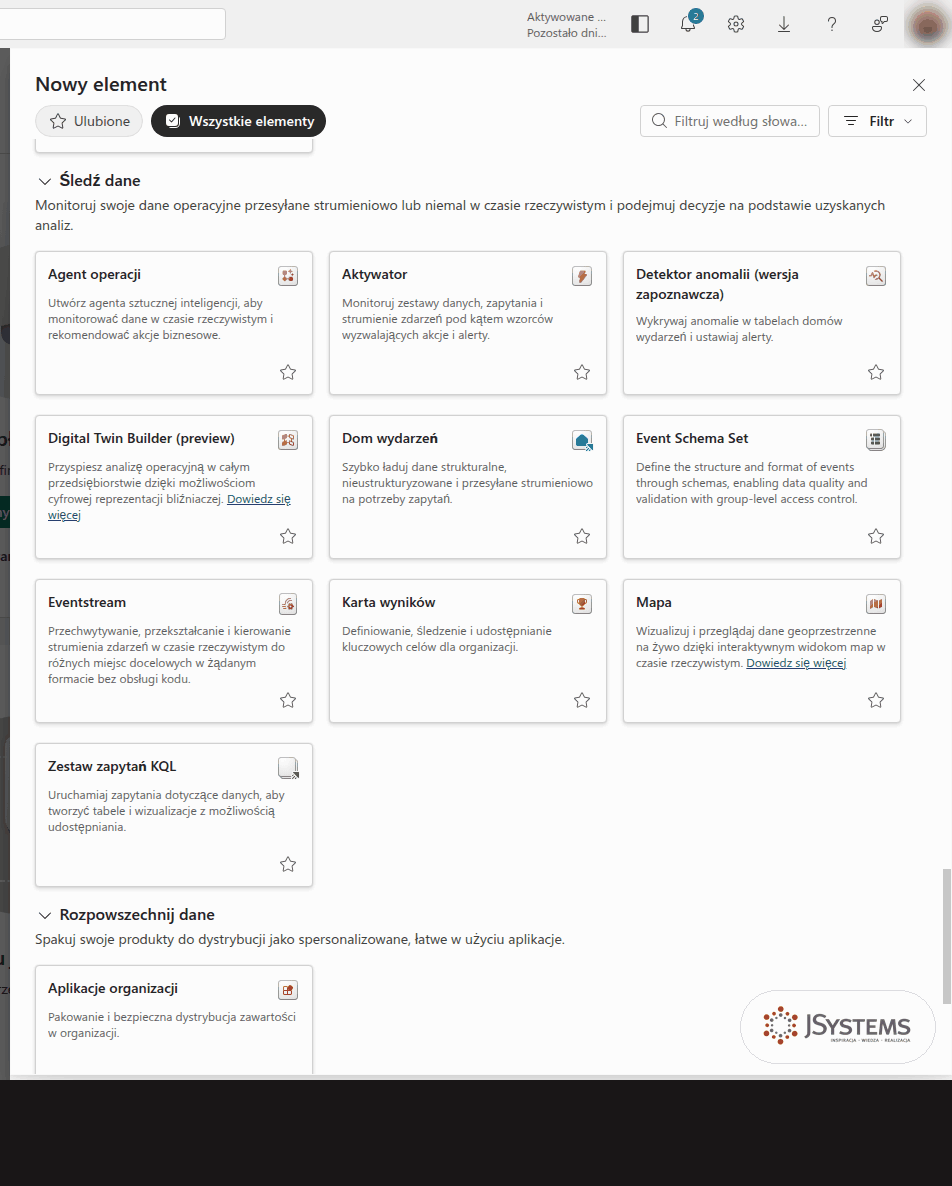
Wszystkie elementy tworzysz z panelu „Nowy element” w obszarze roboczym. Panel grupuje je według zadań, a nie według obciążeń: Pobierz dane, Dublowanie danych, Magazynowanie danych, Przygotuj dane, Analizowanie i trenowanie danych, Opracowywanie danych, Wizualizowanie danych, Śledź dane, Rozpowszechnij dane i Zarządzaj danymi. Ten sam element, np. notes albo Eventstream, występuje w kilku grupach.
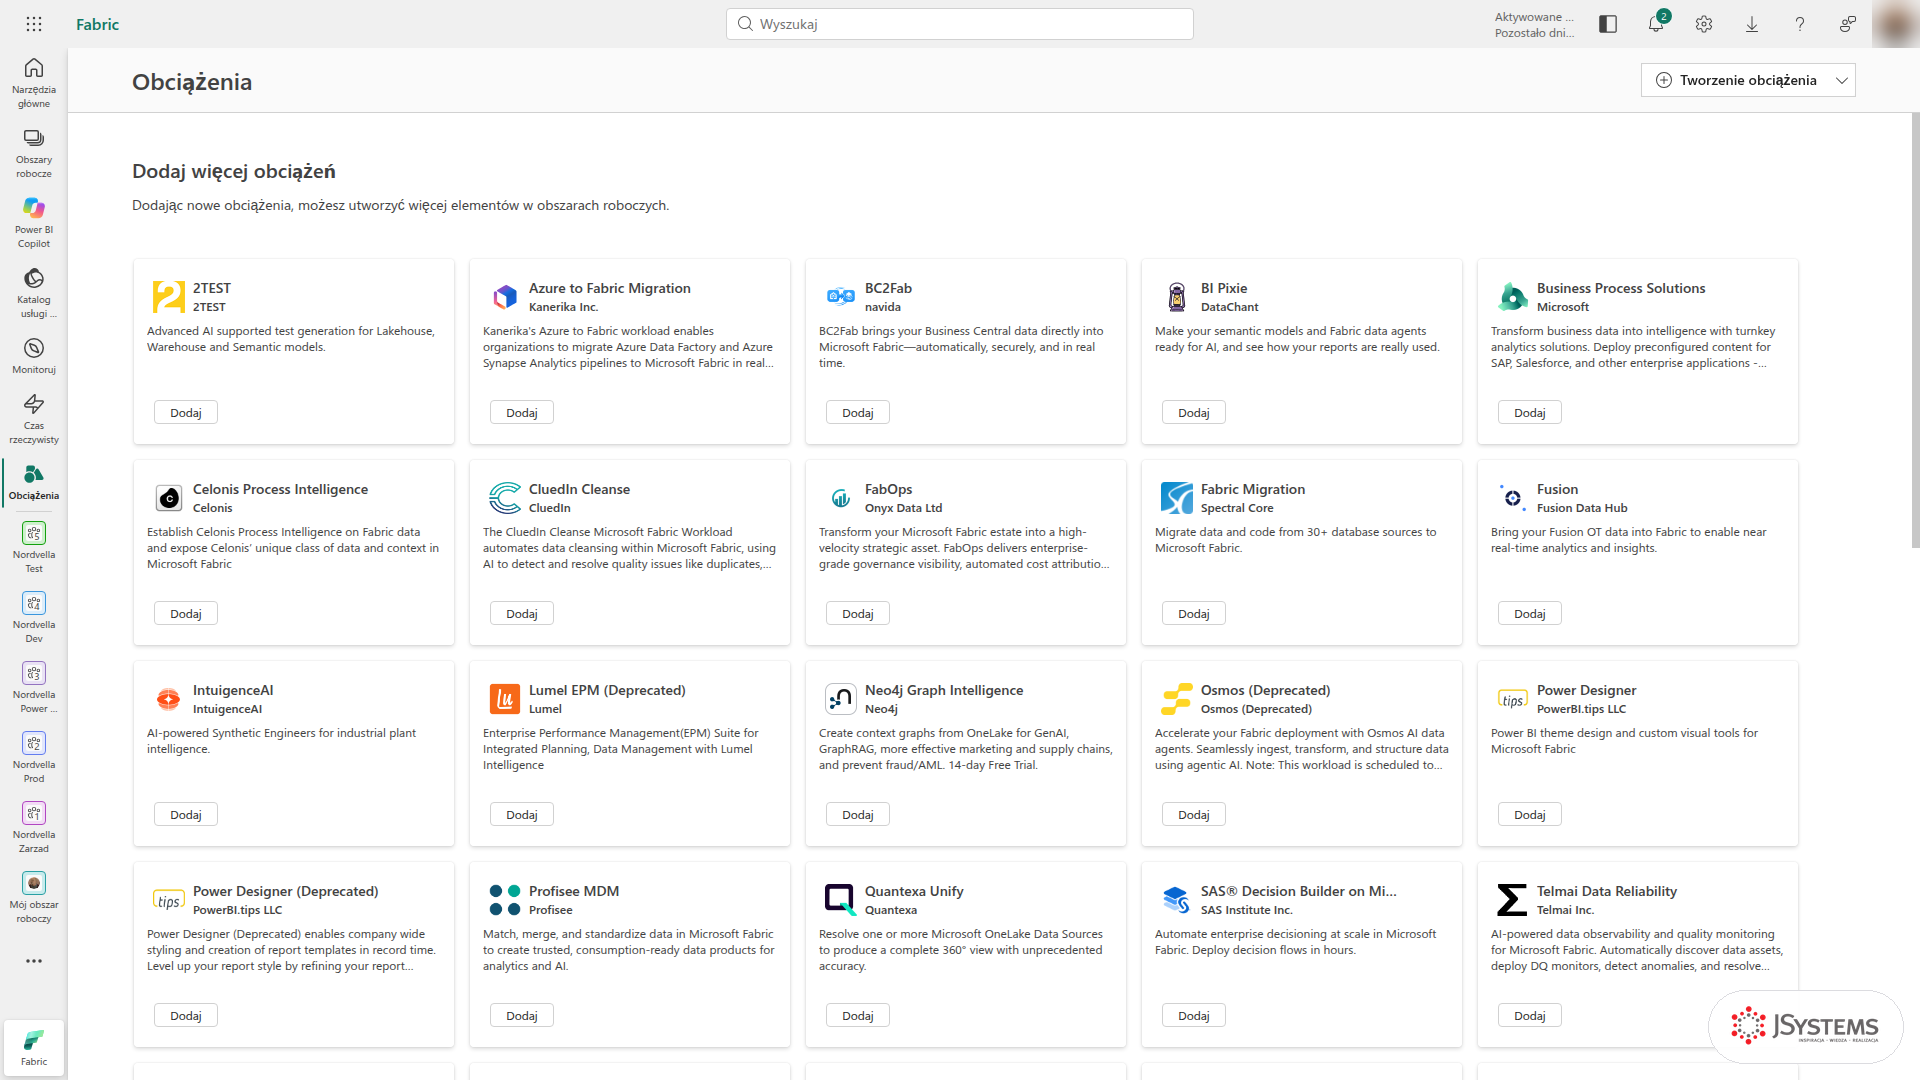
Poza obciążeniami Microsoftu możesz dodać obciążenia partnerów. Na stronie „Obciążenia” znajdziesz rozszerzenia firm trzecich, które dokładają do Fabric własne elementy, np. do jakości danych, planowania albo migracji. Elementy dodanego obciążenia działają na tej samej pojemności co reszta Fabric.
Obszar roboczy (workspace) to kontener na elementy jednego zespołu albo projektu, z własnymi uprawnieniami. Osoby dodane do obszaru dostają jedną z czterech ról: Administrator, Członek, Współautor albo Osoba przeglądająca, a od roli zależy, czy mogą tworzyć, edytować i udostępniać elementy. Każdy obszar jest przypisany do pojemności, która dostarcza moc obliczeniową. Elementy Fabric (lakehouse, notes, magazyn, Eventstream) da się tworzyć tylko w obszarze na pojemności Fabric albo na pojemności próbnej.
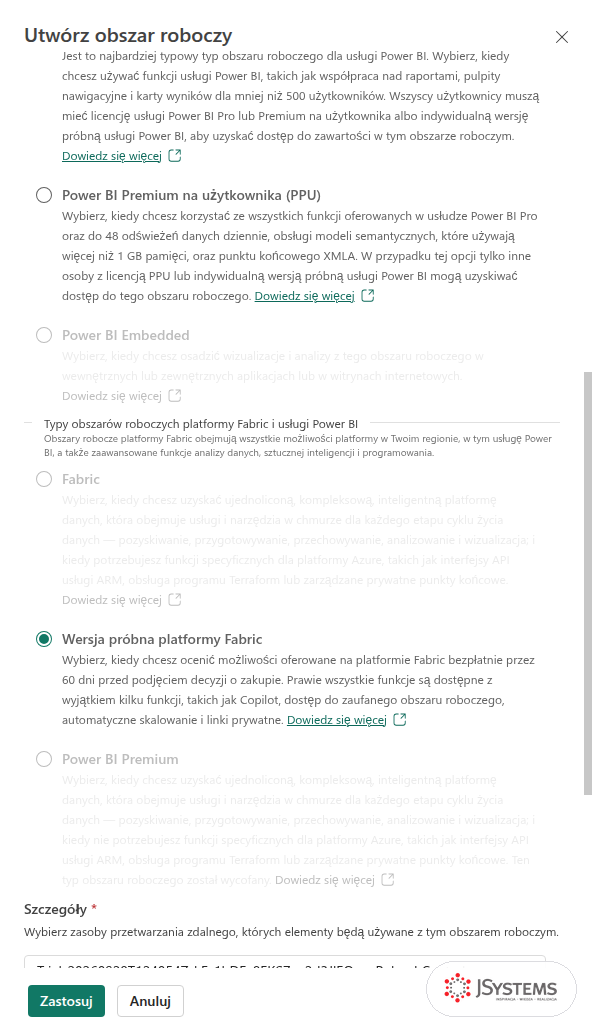
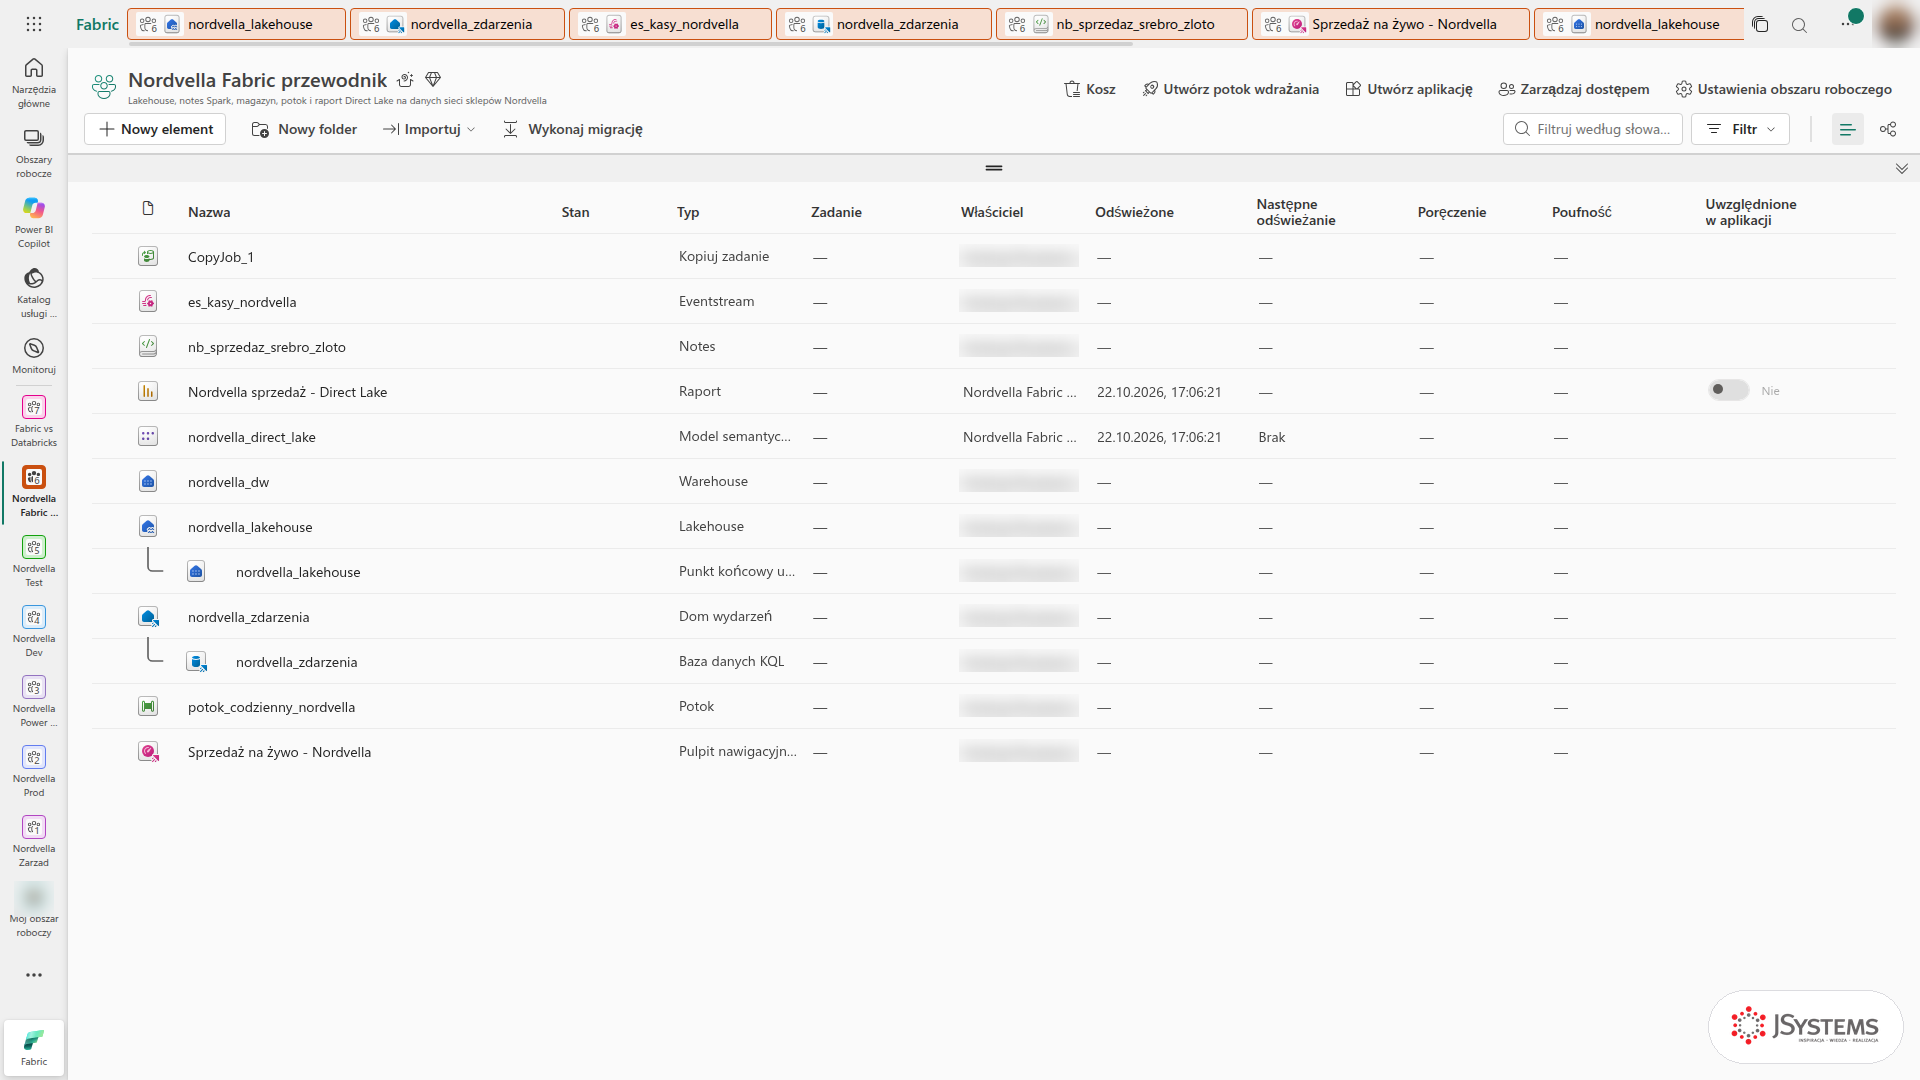
Co chcemy osiągnąć. Na potrzeby przewodnika zakładamy obszar „Nordvella Fabric przewodnik” na bezpłatnej wersji próbnej. W nim powstaną wszystkie elementy przykładu, więc po zakończeniu nauki wystarczy usunąć jeden obszar, żeby posprzątać. To krok 1 części praktycznej.
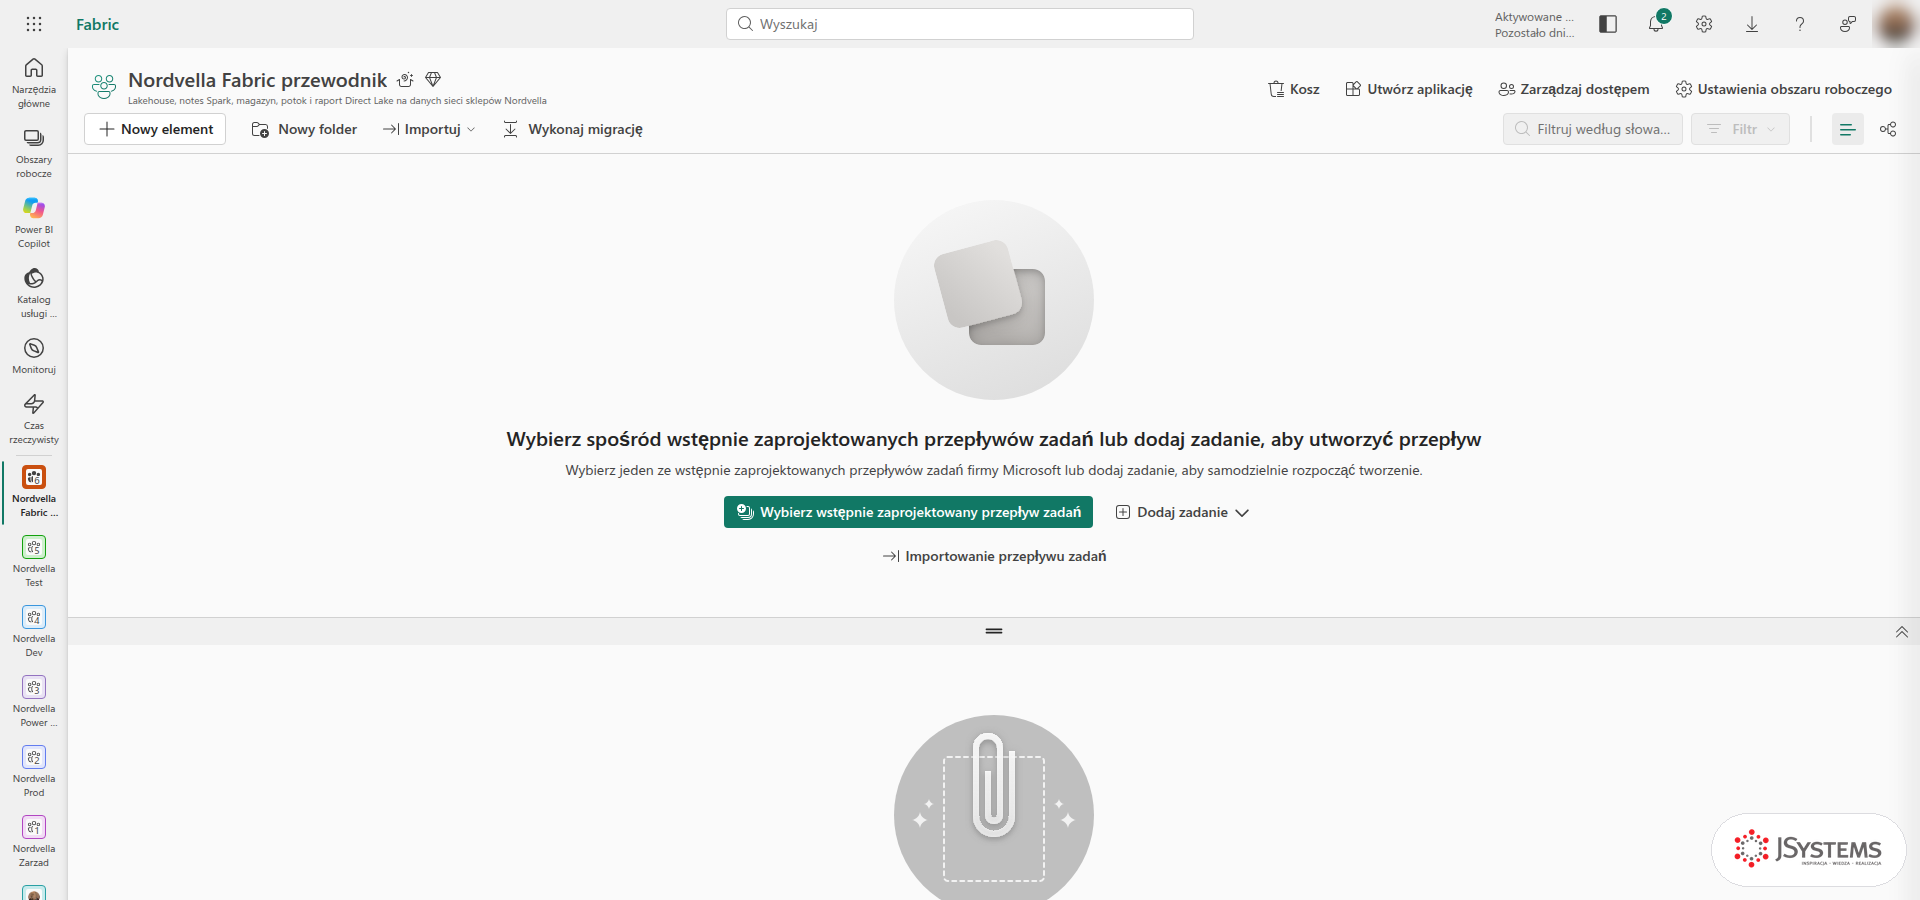
Pusty obszar ma na górze cztery przyciski: „Nowy element” (panel z poprzedniej sekcji), „Nowy folder”, „Importuj” (np. notes z pliku .ipynb albo raport .pbix) i „Wykonaj migrację” do przenoszenia rozwiązań z Azure Synapse i Data Factory.
Jaką pojemność dostał obszar, sprawdzisz w ustawieniach obszaru roboczego, w zakładce „Typ obszaru roboczego”. U nas to wersja próbna z jednostką SKU FTL4 (4 CU) w regionie Poland Central. Region ma znaczenie, bo dane obszaru fizycznie leżą w centrum danych tego regionu. Poland Central obsługuje wszystkie obciążenia Fabric, a jedyną niedostępną tam funkcją są aplikacje Fabric w wersji zapoznawczej.
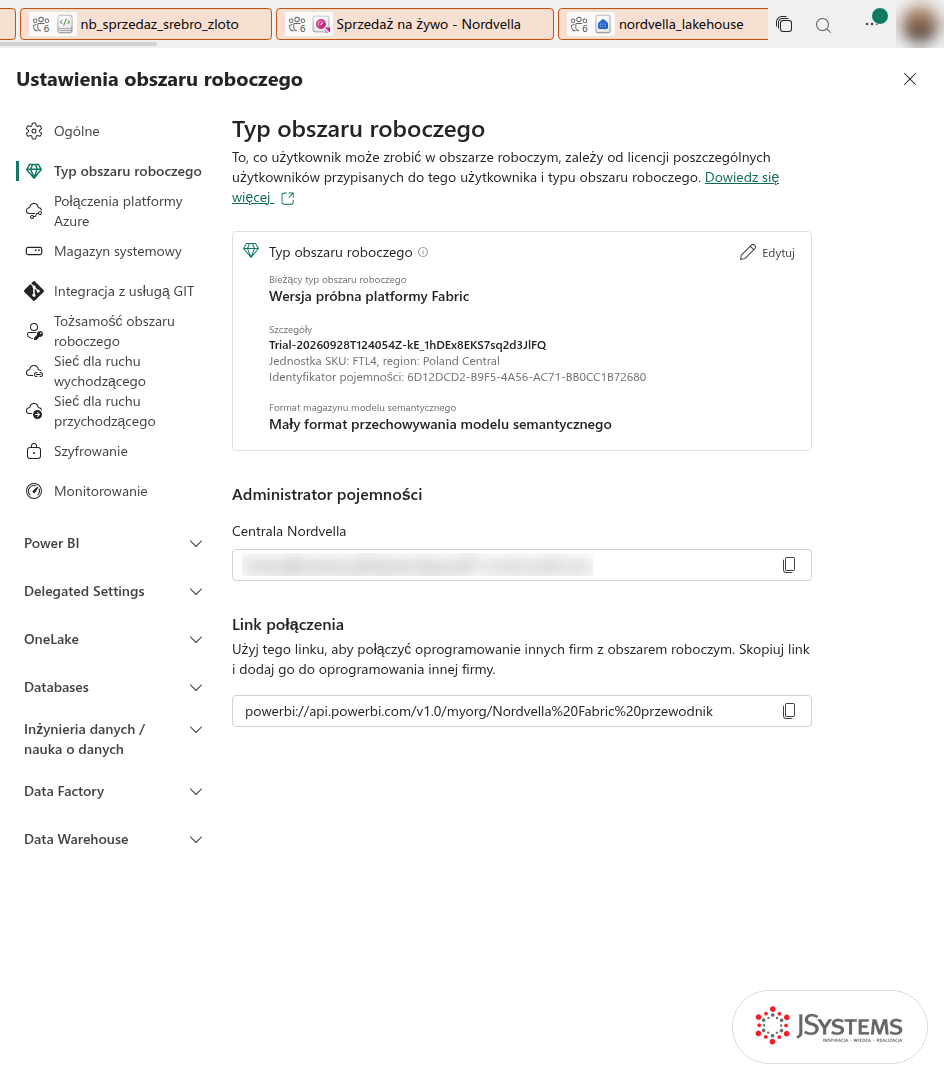
Link połączenia w tym samym oknie (adres zaczynający się od powerbi://) pozwala podłączyć do obszaru narzędzia zewnętrzne, np. Power BI Desktop, Tabular Editor albo Excel, przez punkt końcowy XMLA.
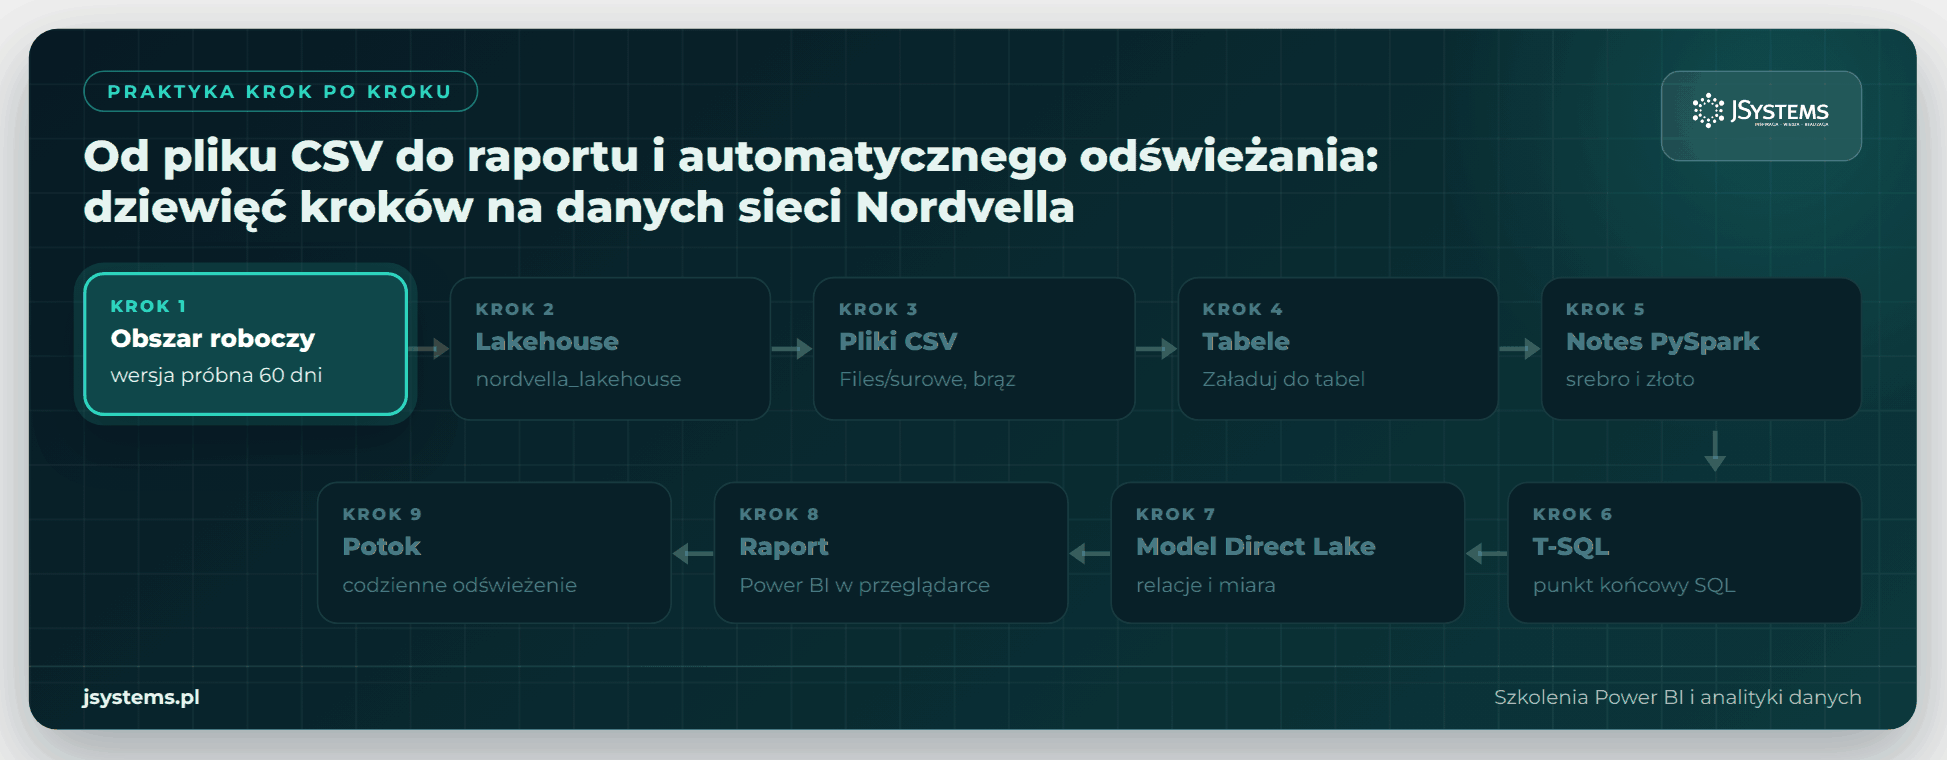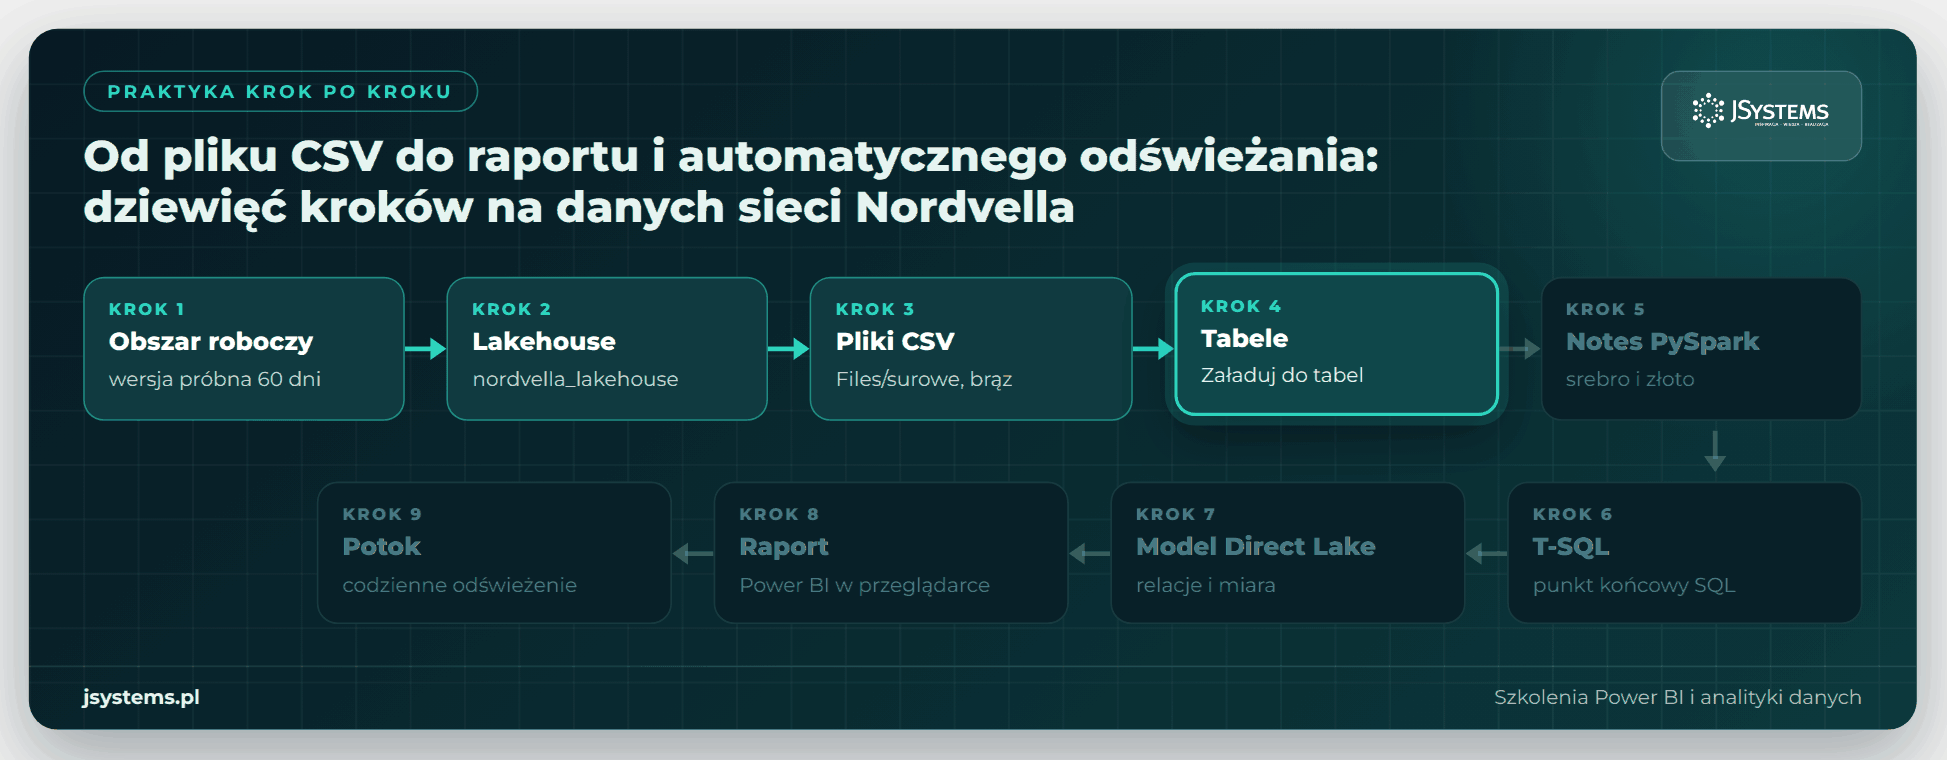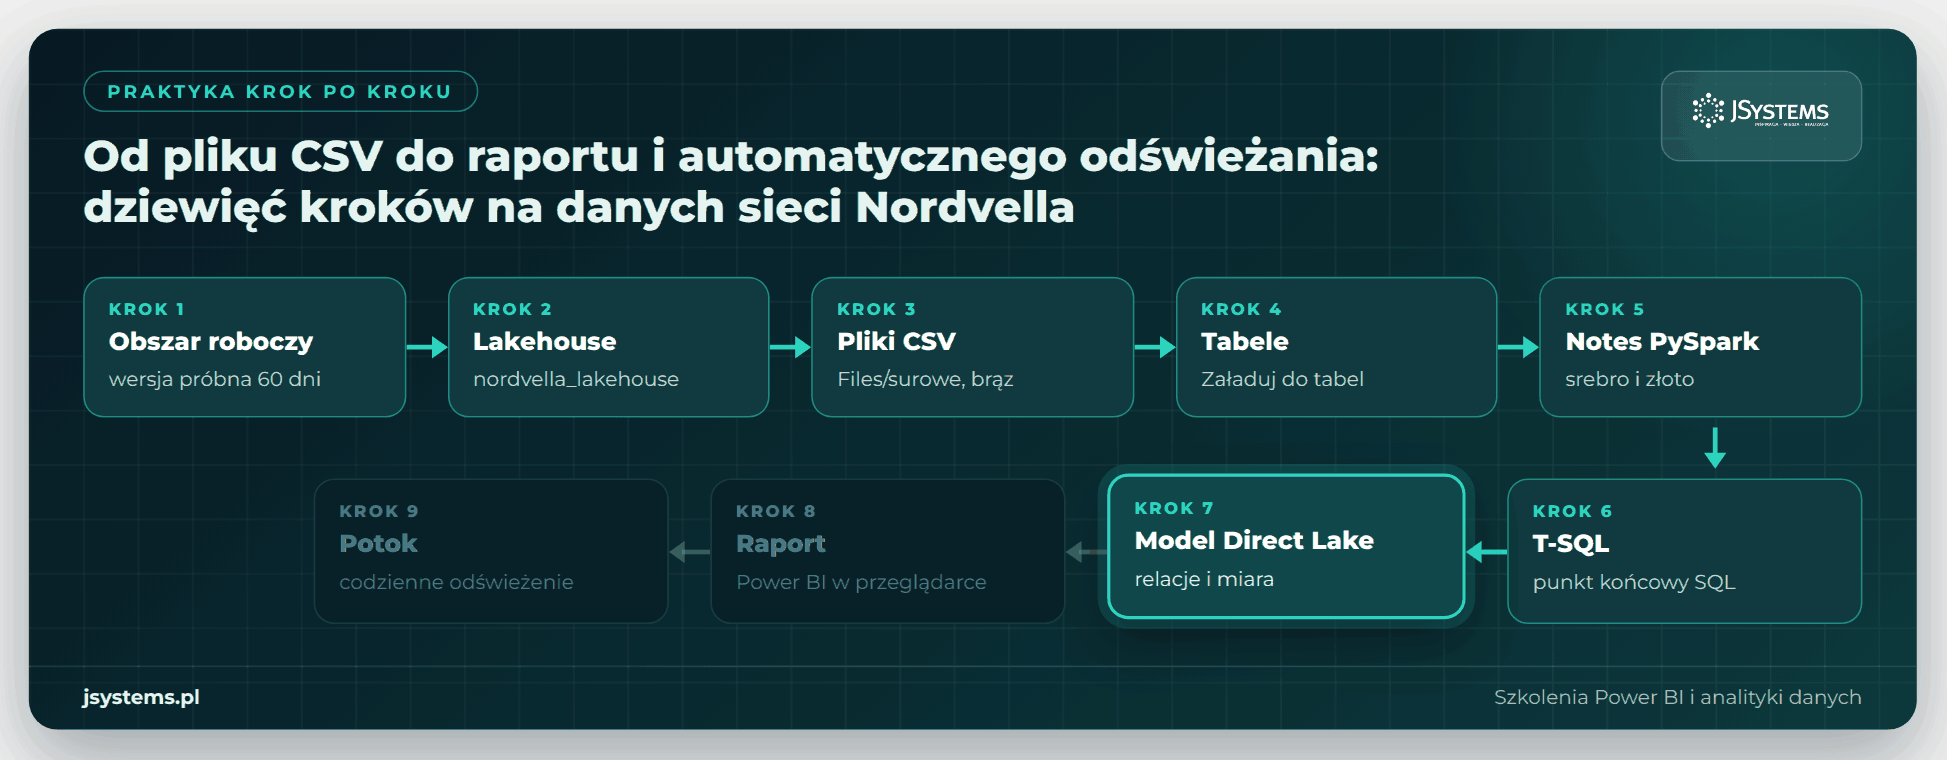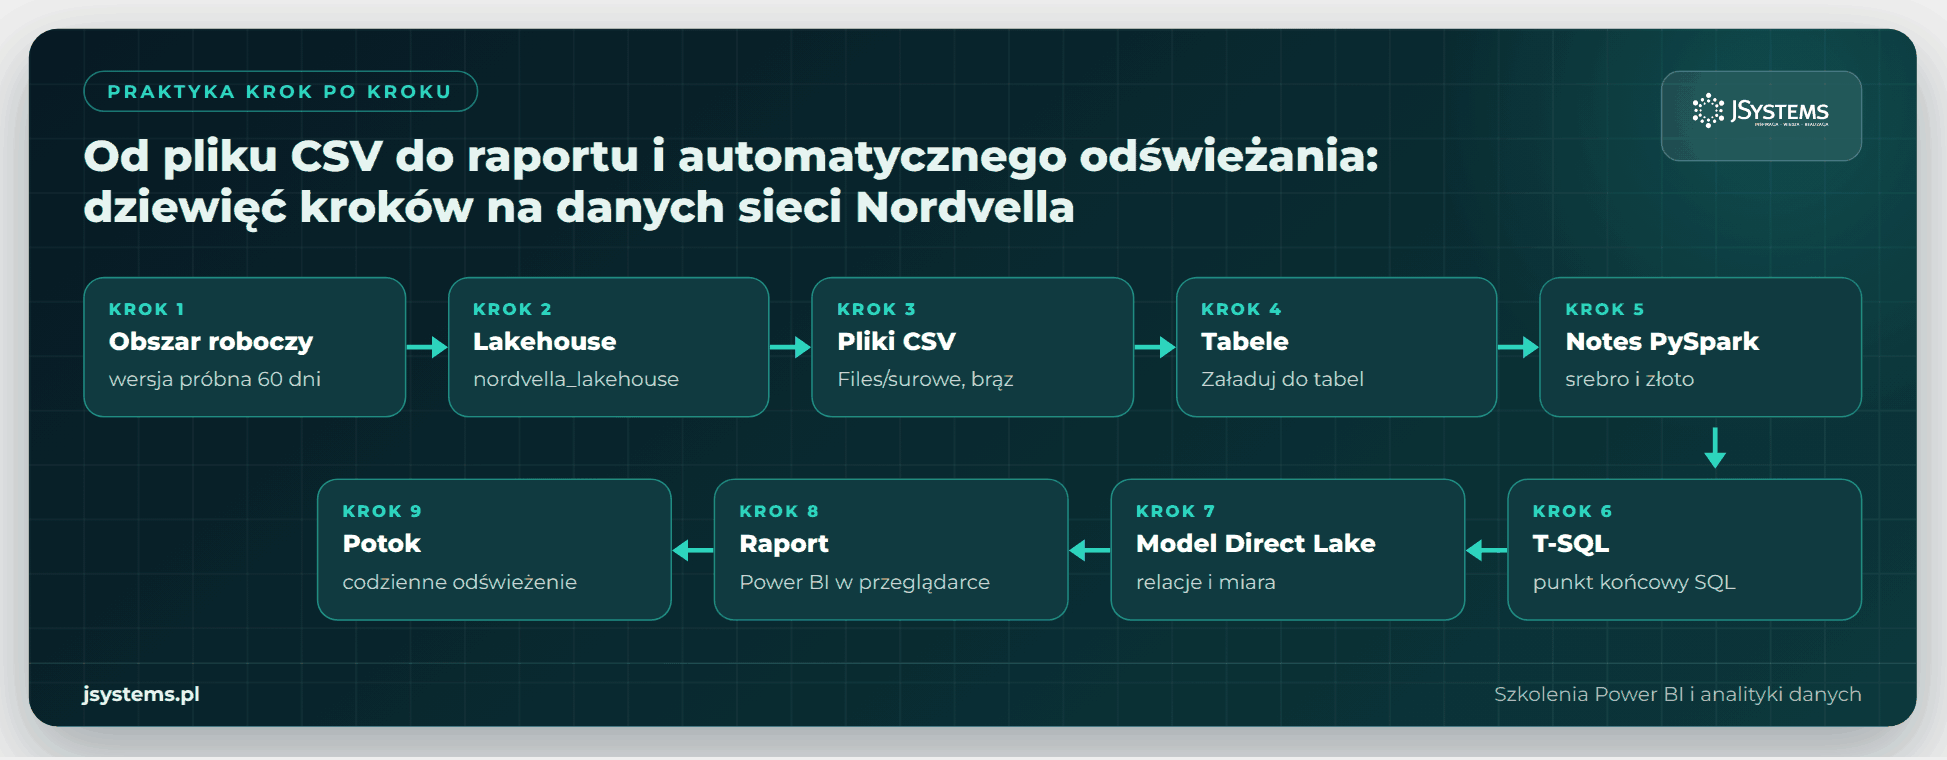
Co chcemy osiągnąć. Zarząd Nordvelli chce co rano widzieć sprzedaż według miesięcy, regionów i kategorii, a kierownik operacyjny dodatkowo transakcje z kas na bieżąco. Dziś system kasowy co noc eksportuje plik sprzedaz.csv, a analityk ręcznie skleja go w Excelu. Na końcu części praktycznej będziemy mieć lakehouse z warstwami danych, zapytania SQL, raport Power BI w trybie Direct Lake, potok, który odświeża wszystko codziennie o 6:00, oraz pulpit z transakcjami na żywo. W tej części zakładamy lakehouse i wgrywamy do niego surowe pliki z paczki nordvella_.
Lakehouse (połączenie data lake i data warehouse) to element, który przechowuje jednocześnie pliki w dowolnym formacie i tabele Delta. Ma dwa główne katalogi: Files na pliki, takie jak CSV, JSON czy obrazy, oraz Tables na tabele, które od razu widzą SQL i Power BI.
nordvella_lakehouse. Zostaw zaznaczone pole „Schematy usługi Lakehouse”, dzięki któremu tabele trafiają do schematów (domyślnie dbo), tak jak w bazie SQL.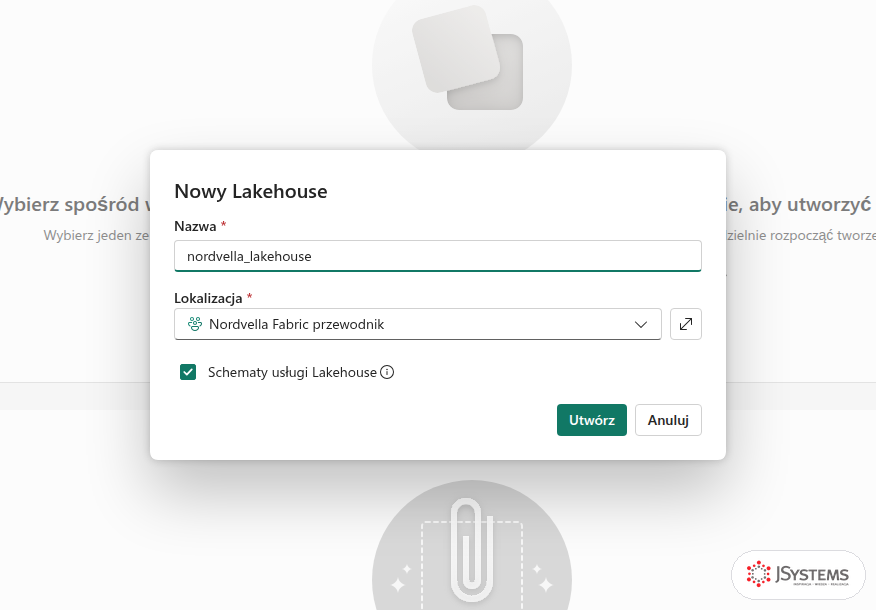
Nowy lakehouse jest pusty i od razu podpowiada, jak dodać dane: przekazanie plików z komputera, tabele z przykładowymi danymi, nowy skrót, przepływ danych Gen2 albo potok. Razem z lakehouse Fabric tworzy automatycznie punkt końcowy analizy SQL, do którego wrócimy w części 3.
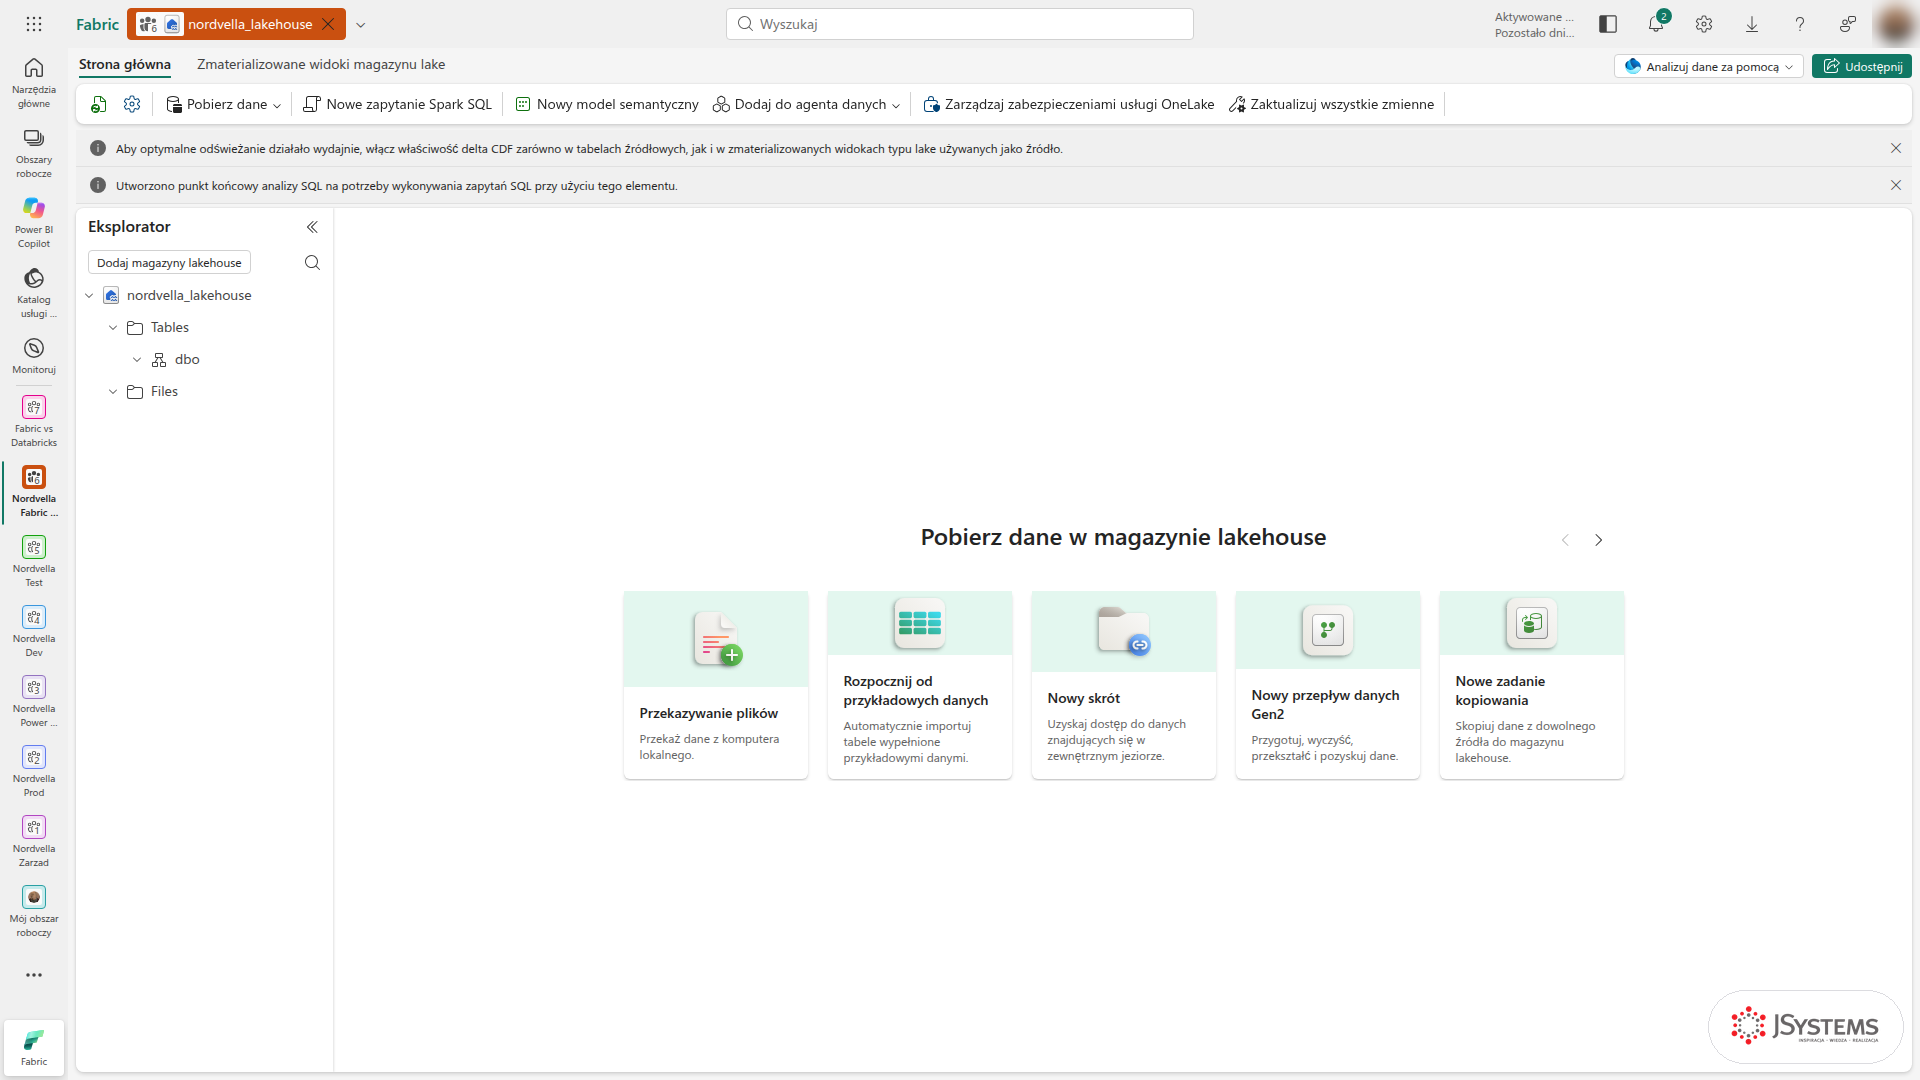
Zasada, której warto się trzymać od pierwszego dnia: surowe pliki trafiają do osobnego folderu i nikt ich nie poprawia ręcznie. To warstwa brązowa architektury medalionowej, którą omawiamy w części 2. Gdy po miesiącu ktoś zapyta, skąd wzięła się liczba w raporcie, zawsze możesz wrócić do oryginału.
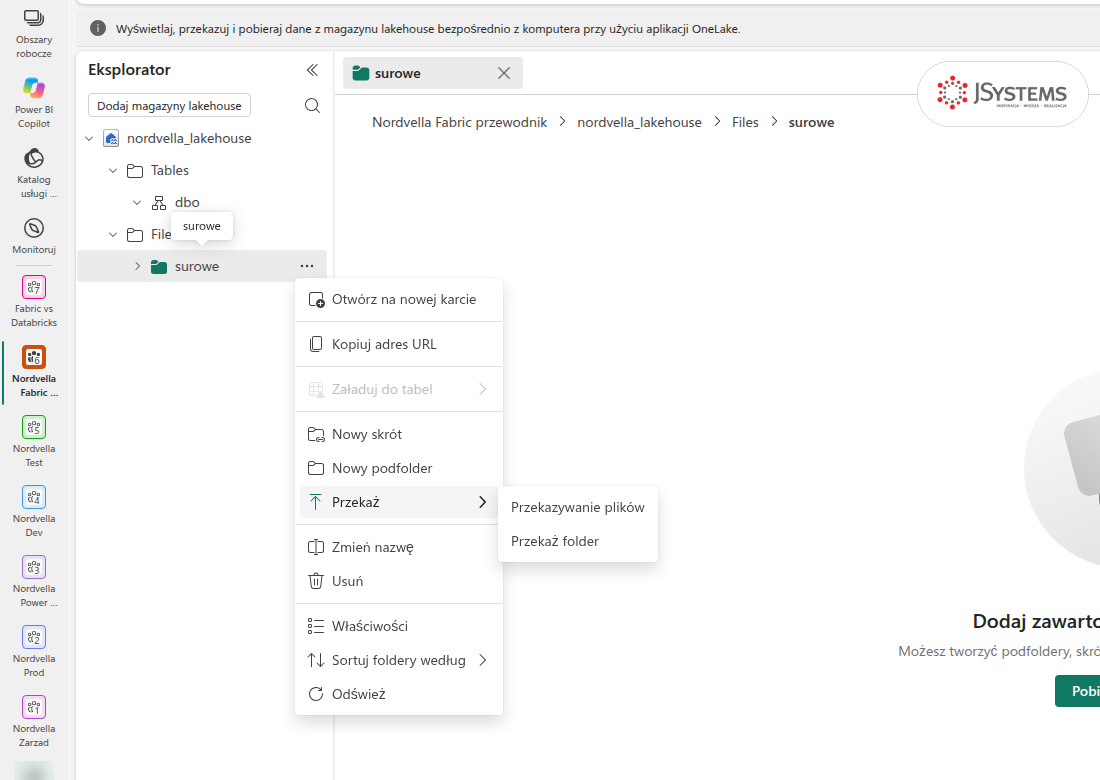
surowe i kliknij „Utwórz”.surowe kliknij trzy kropki, wybierz „Przekaż”, a potem „Przekazywanie plików”.nordvella_fabric_dane.zip (sprzedaz.csv, sklepy.csv, produkty.csv i kalendarz.csv) i kliknij „Przekaż”.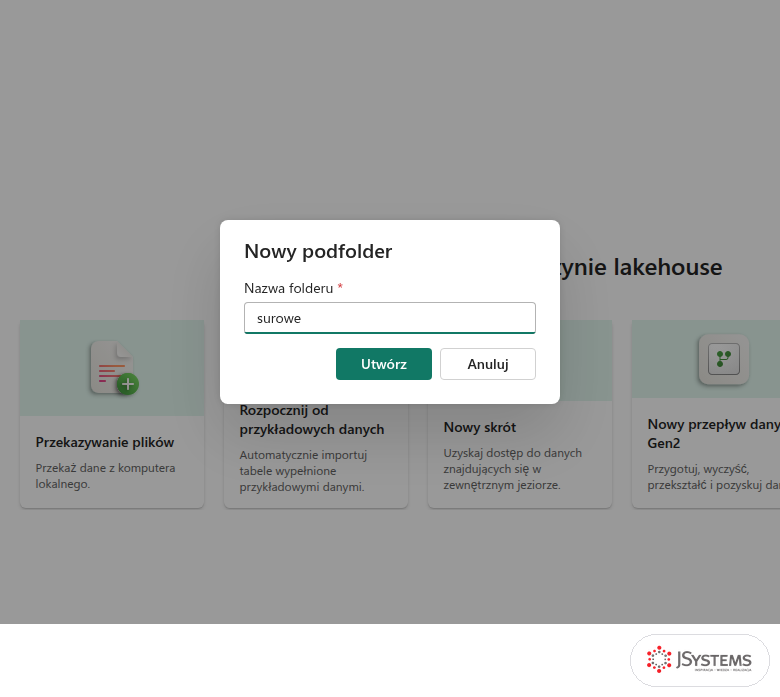
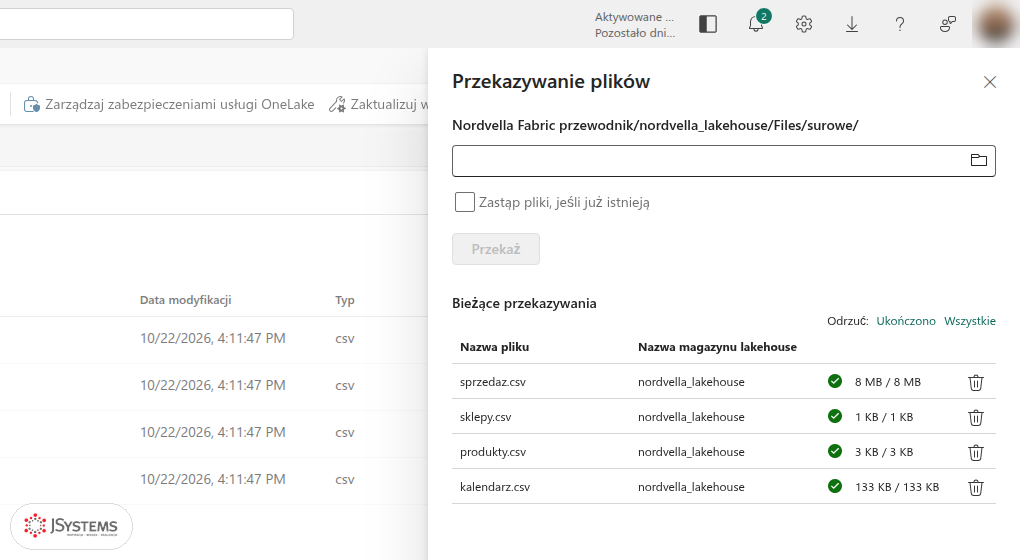
sprzedaz.csv, sklepy.csv, produkty.csv i kalendarz.csv trafiły do Files/surowe w nordvella_lakehouse.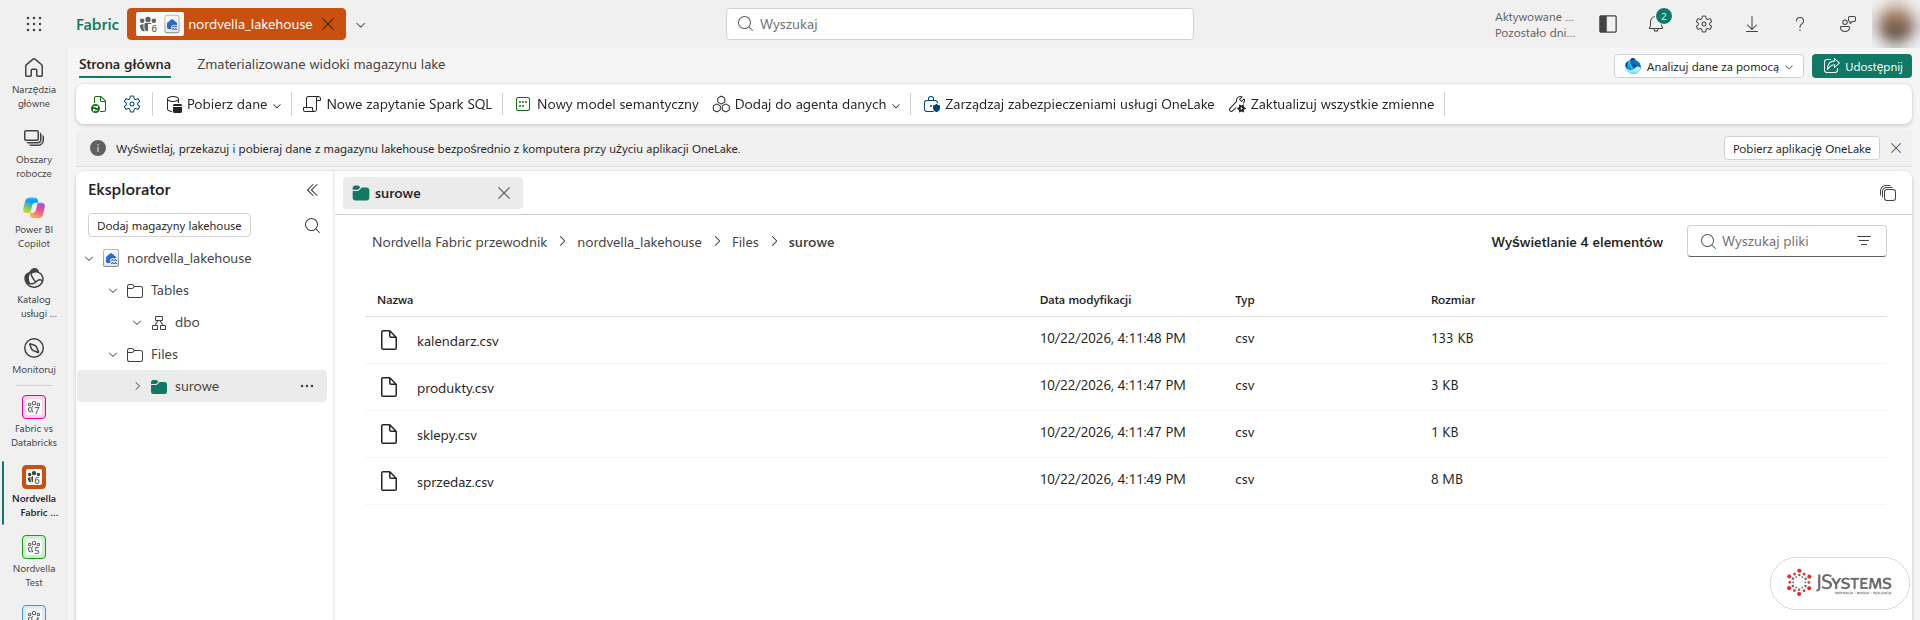
Sklepy, produkty i kalendarz to małe tabele słownikowe, które nie wymagają czyszczenia, więc zamieniamy je na tabele Delta jednym poleceniem. Sprzedaż zostawiamy jako plik, bo przeliczy ją notes w następnej części.
sklepy.csv kliknij trzy kropki, wybierz „Załaduj do tabel”, a potem „Nowa tabela”.dbo, nazwę tabeli sklepy, zaznaczone „Użyj nagłówka dla nazw kolumn” i separator przecinek. Kliknij „Załaduj”.produkty.csv i kalendarz.csv.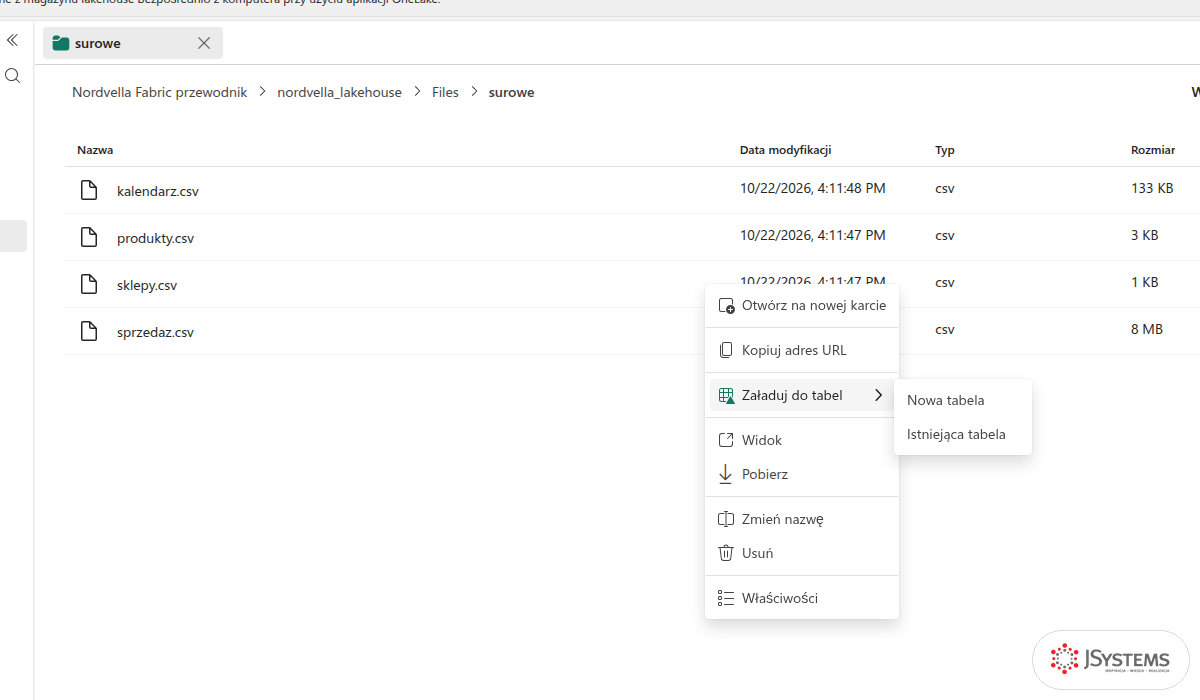
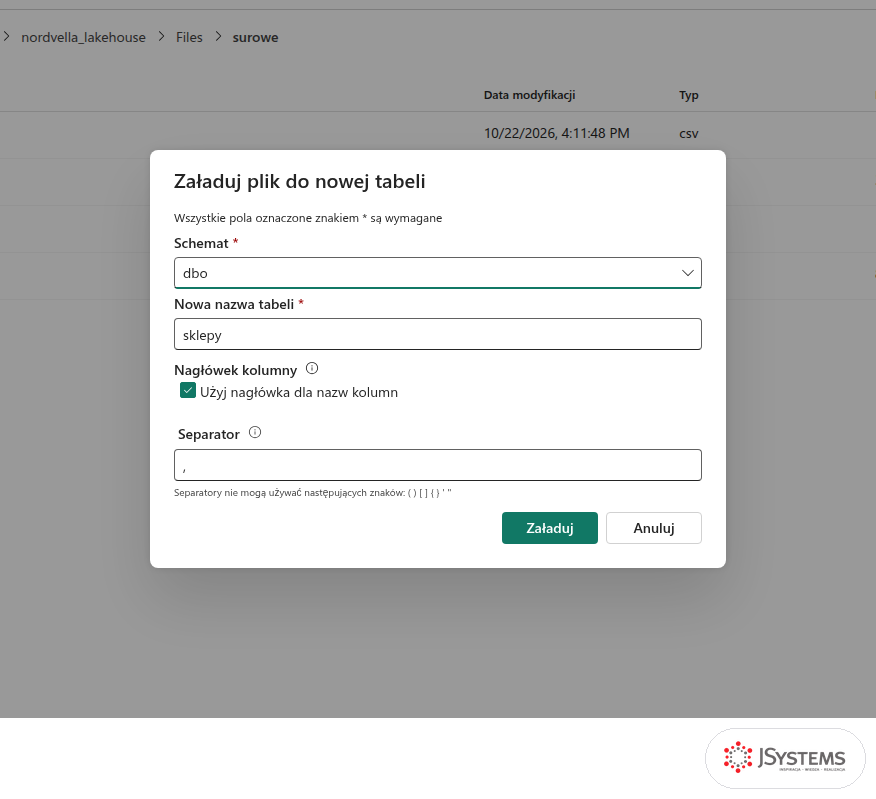
sklepy.csv: schemat dbo, nazwa tabeli sklepy, nagłówek pliku jako nazwy kolumn i przecinek jako separator.„Załaduj do tabel” uruchamia w tle krótkie zadanie Spark. W monitorze zobaczysz je jako operację lakehouse, a na małej pojemności próbnej warto poczekać, aż skończy się poprzednie ładowanie, zanim uruchomisz następne (więcej w sekcji o pułapkach na starcie). Po trzech ładowaniach w katalogu Tables są tabele sklepy, produkty i kalendarz.
Co chcemy osiągnąć. Surowy eksport z kas zawiera zwroty, datę zapisaną jako liczba (np. 20250314) i 108 675 pojedynczych transakcji. Zarząd potrzebuje czystej tabeli sprzedaży do analiz oraz zestawienia miesięcznego według regionów i kategorii. Oba przygotujemy w jednym notesie PySpark, który da się potem uruchamiać z potoku codziennie, bez ręcznej pracy.
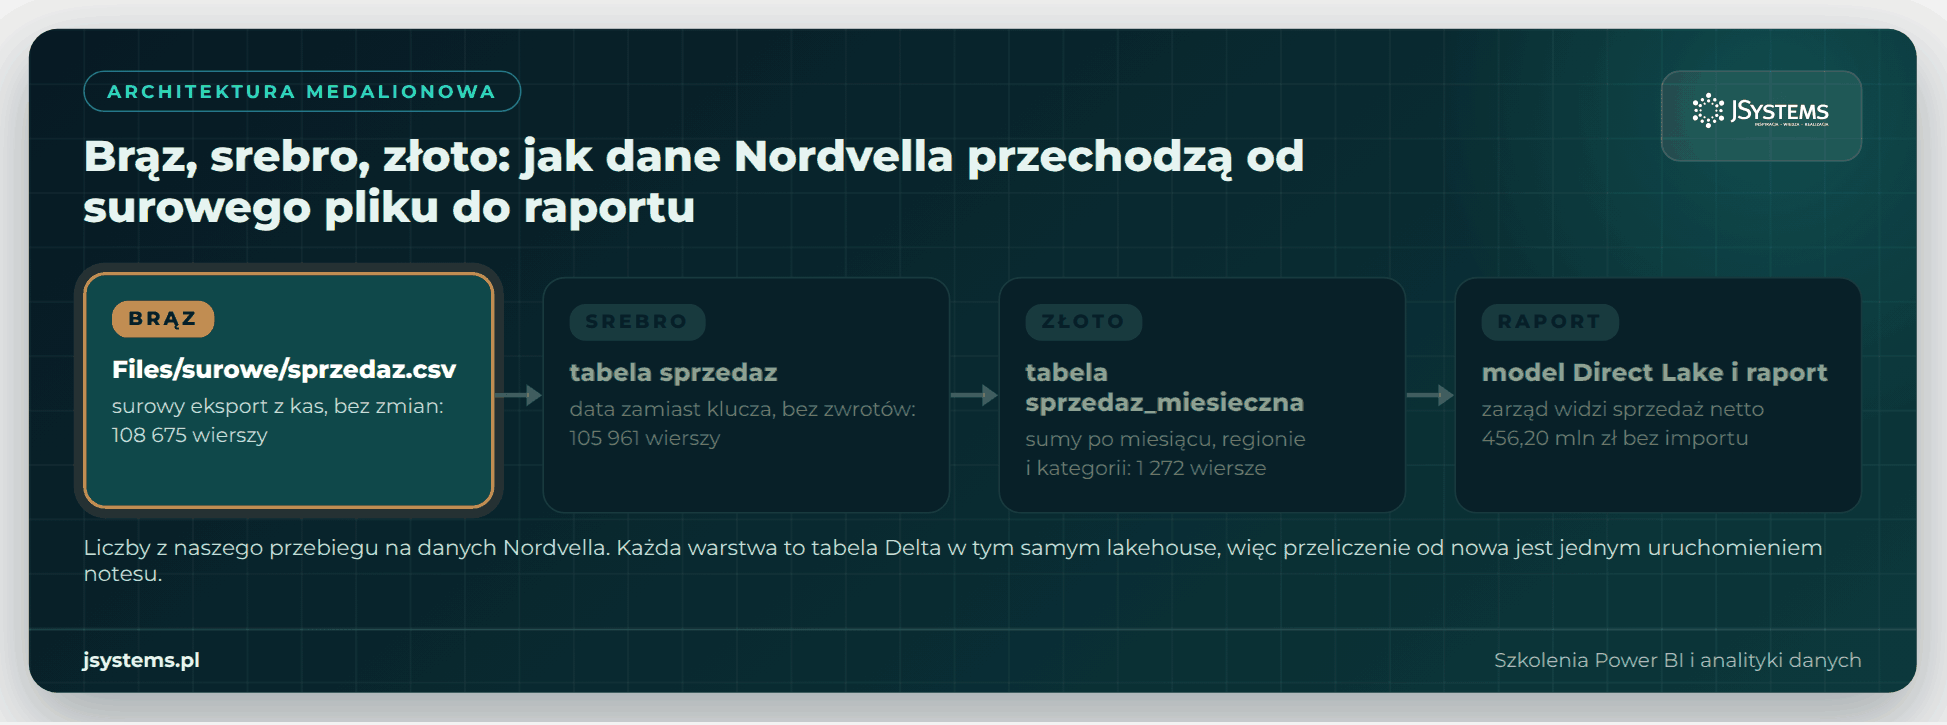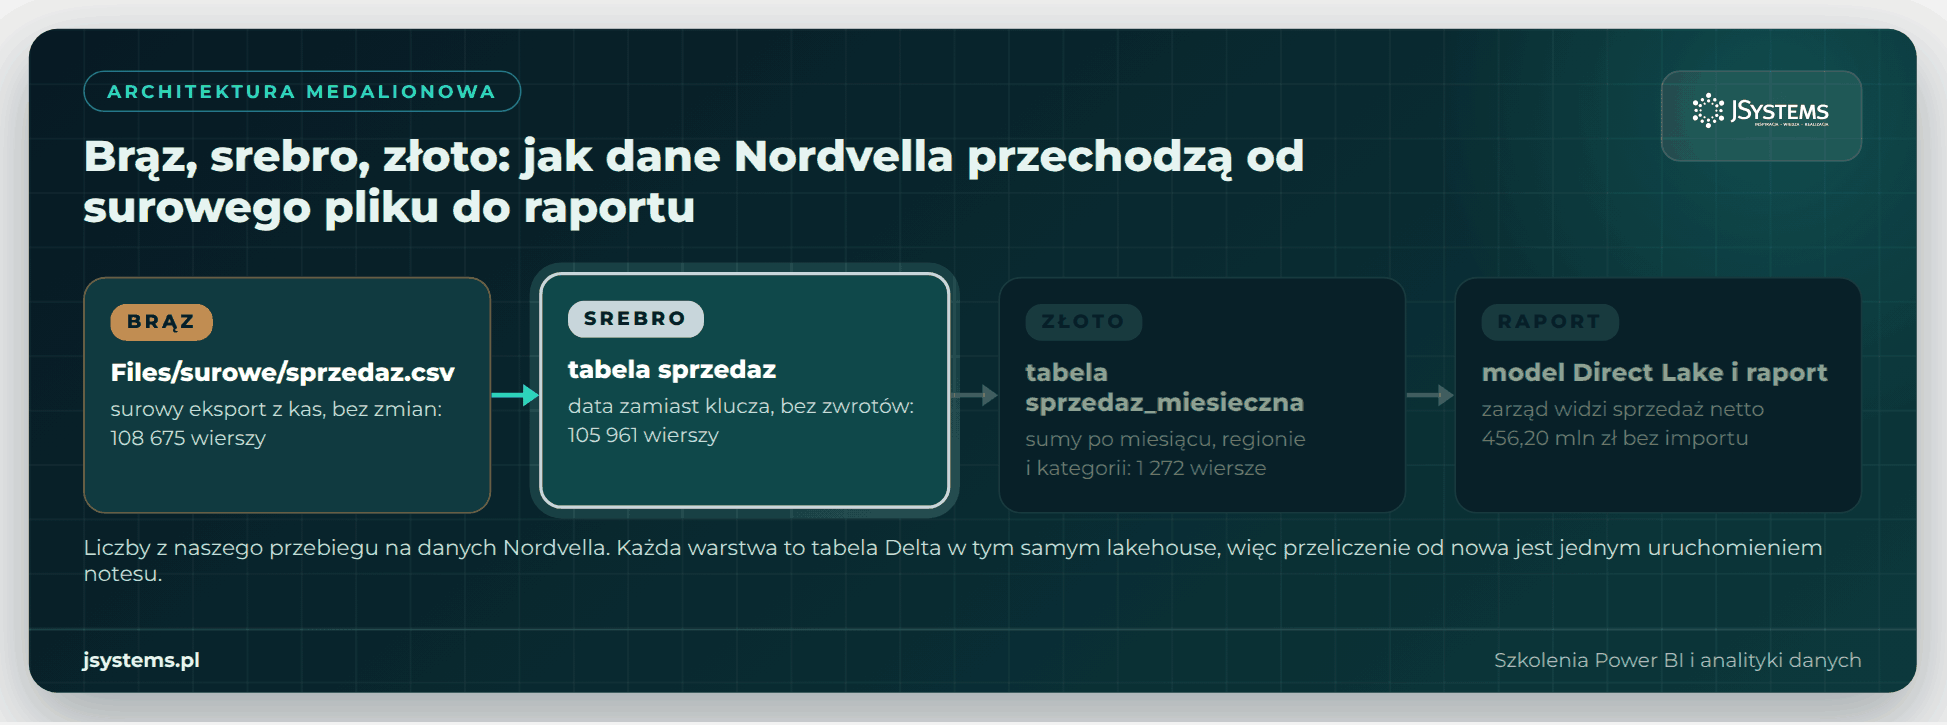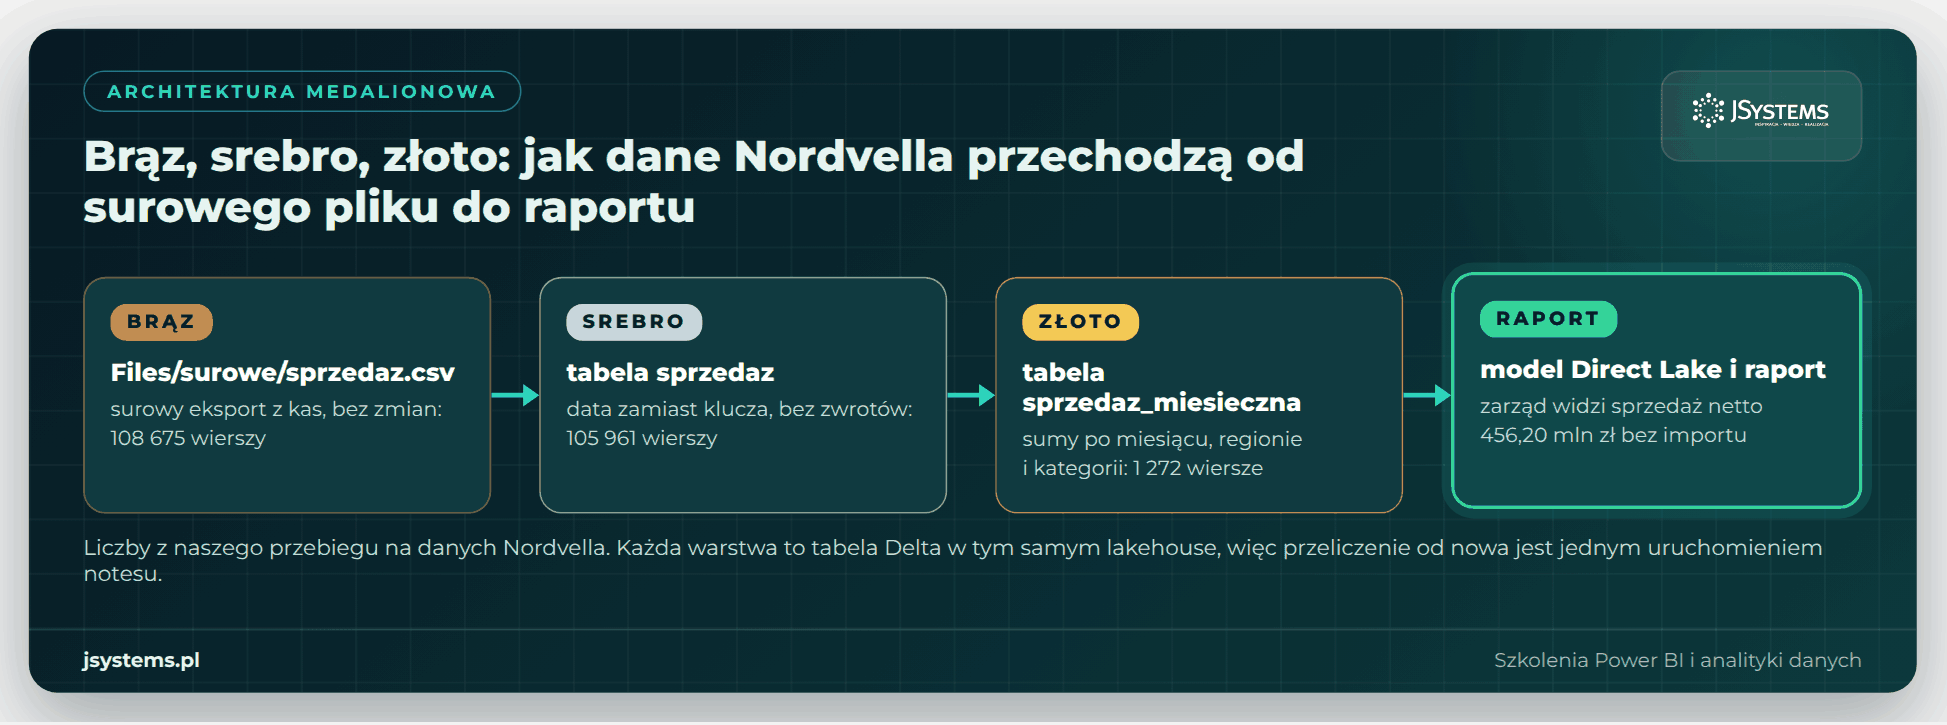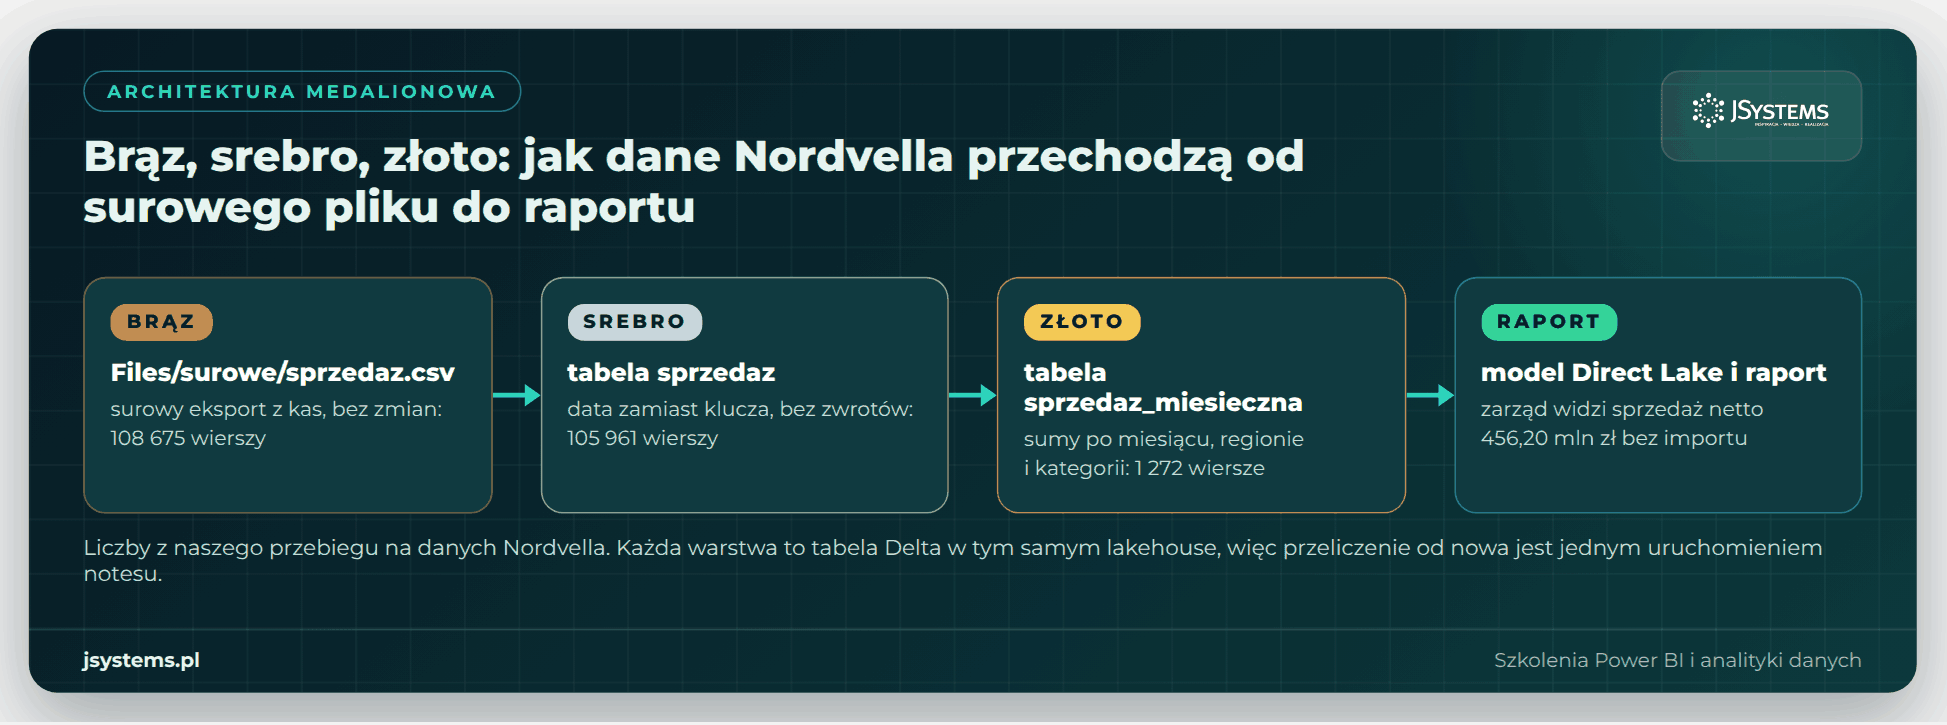
Architektura medalionowa to umowny podział jeziora danych na trzy warstwy. Brązowa przechowuje dane dokładnie tak, jak przyszły ze źródła. Srebrna zawiera dane oczyszczone i ujednolicone: poprawne typy, bez duplikatów i rekordów technicznych. Złota to tabele pod konkretne potrzeby biznesu, zwykle zagregowane. Każda warstwa jest osobną tabelą Delta, więc gdy zmienisz regułę czyszczenia, przeliczasz srebro i złoto od nowa z brązu, bez ponownego pobierania danych.
Zobacz też: Szkolenie Power BI - Desktop, DAX i Online + Copilot
nb_sprzedaz_srebro_zloto.ipynb . Możesz też utworzyć pusty notes („Nowy element”, potem „Notes”), nazwać go nb_sprzedaz_srebro_zloto i wkleić kod z ramek poniżej, komórka po komórce.nordvella_lakehouse. Stanie się domyślnym lakehouse notesu, więc ścieżki typu Files/surowe/sprzedaz.csv i nazwy tabel będą wskazywać właśnie na niego.Pierwsza komórka czyta plik sprzedaz.csv z nagłówkiem i pozwala Sparkowi samemu rozpoznać typy kolumn (inferSchema). Wynik to ramka danych sales_raw, z której wypisujemy liczbę wierszy i schemat.
# Warstwa brązowa: surowy plik CSV wgrany do folderu Files/surowe
sales_raw = (spark.read
    .option("header", True)
    .option("inferSchema", True)
    .csv("Files/surowe/sprzedaz.csv"))

print(f"{sales_raw.count():,} wierszy".replace(",", " "))
sales_raw.printSchema()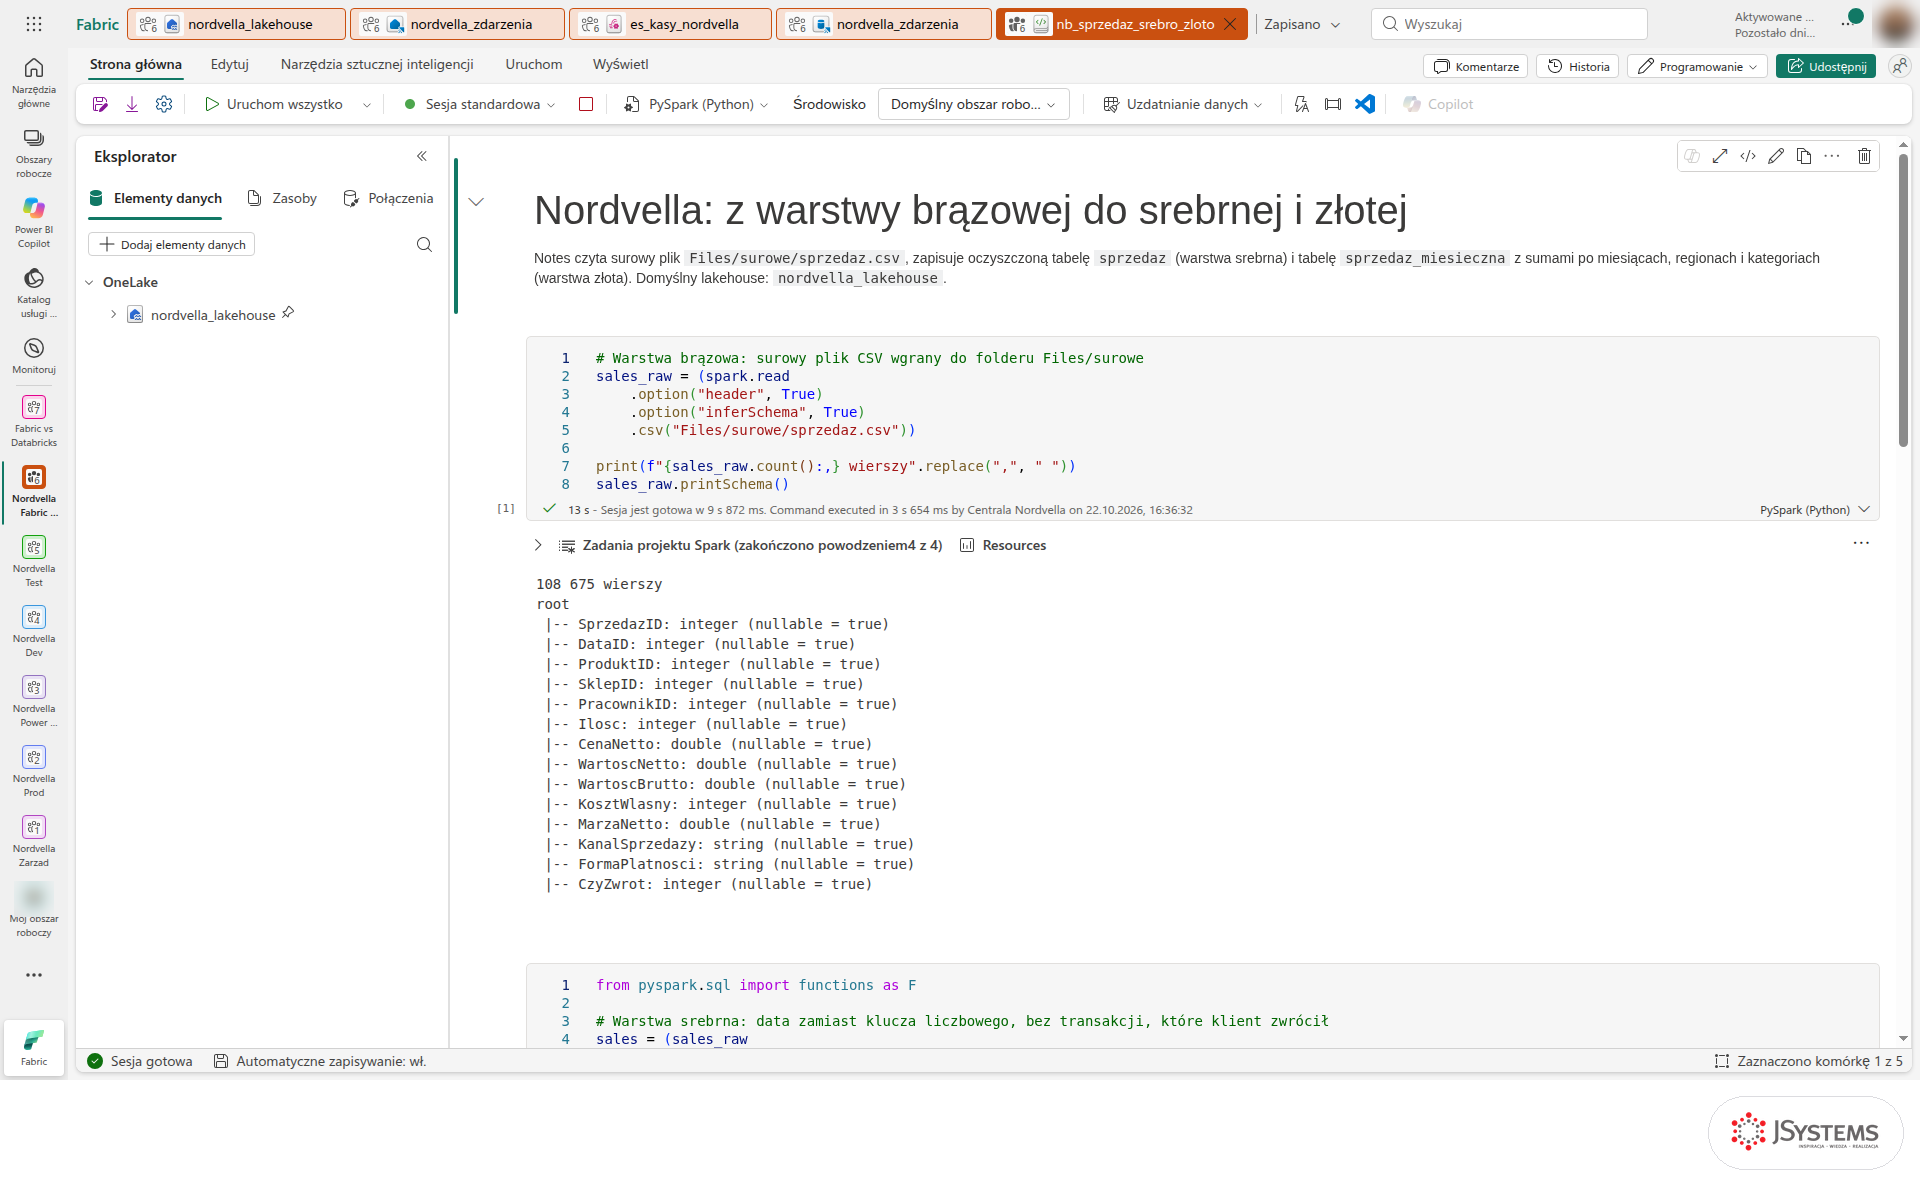
Druga komórka zamienia klucz DataID na prawdziwą datę, odrzuca transakcje zwrócone przez klientów i zapisuje wynik jako tabelę Delta sprzedaz. Tryb overwrite sprawia, że każde uruchomienie buduje tabelę od nowa, co przy codziennym odświeżaniu z potoku jest najprostsze i odporne na powtórzenia.
from pyspark.sql import functions as F

# Warstwa srebrna: data zamiast klucza liczbowego, bez transakcji, które klient zwrócił
sales = (sales_raw
    .withColumn("Data", F.to_date(F.col("DataID").cast("string"), "yyyyMMdd"))
    .filter(F.col("CzyZwrot") == 0)
    .drop("CzyZwrot"))

sales.write.mode("overwrite").format("delta").saveAsTable("sprzedaz")
print(f"Tabela sprzedaz: {sales.count():,} wierszy".replace(",", " "))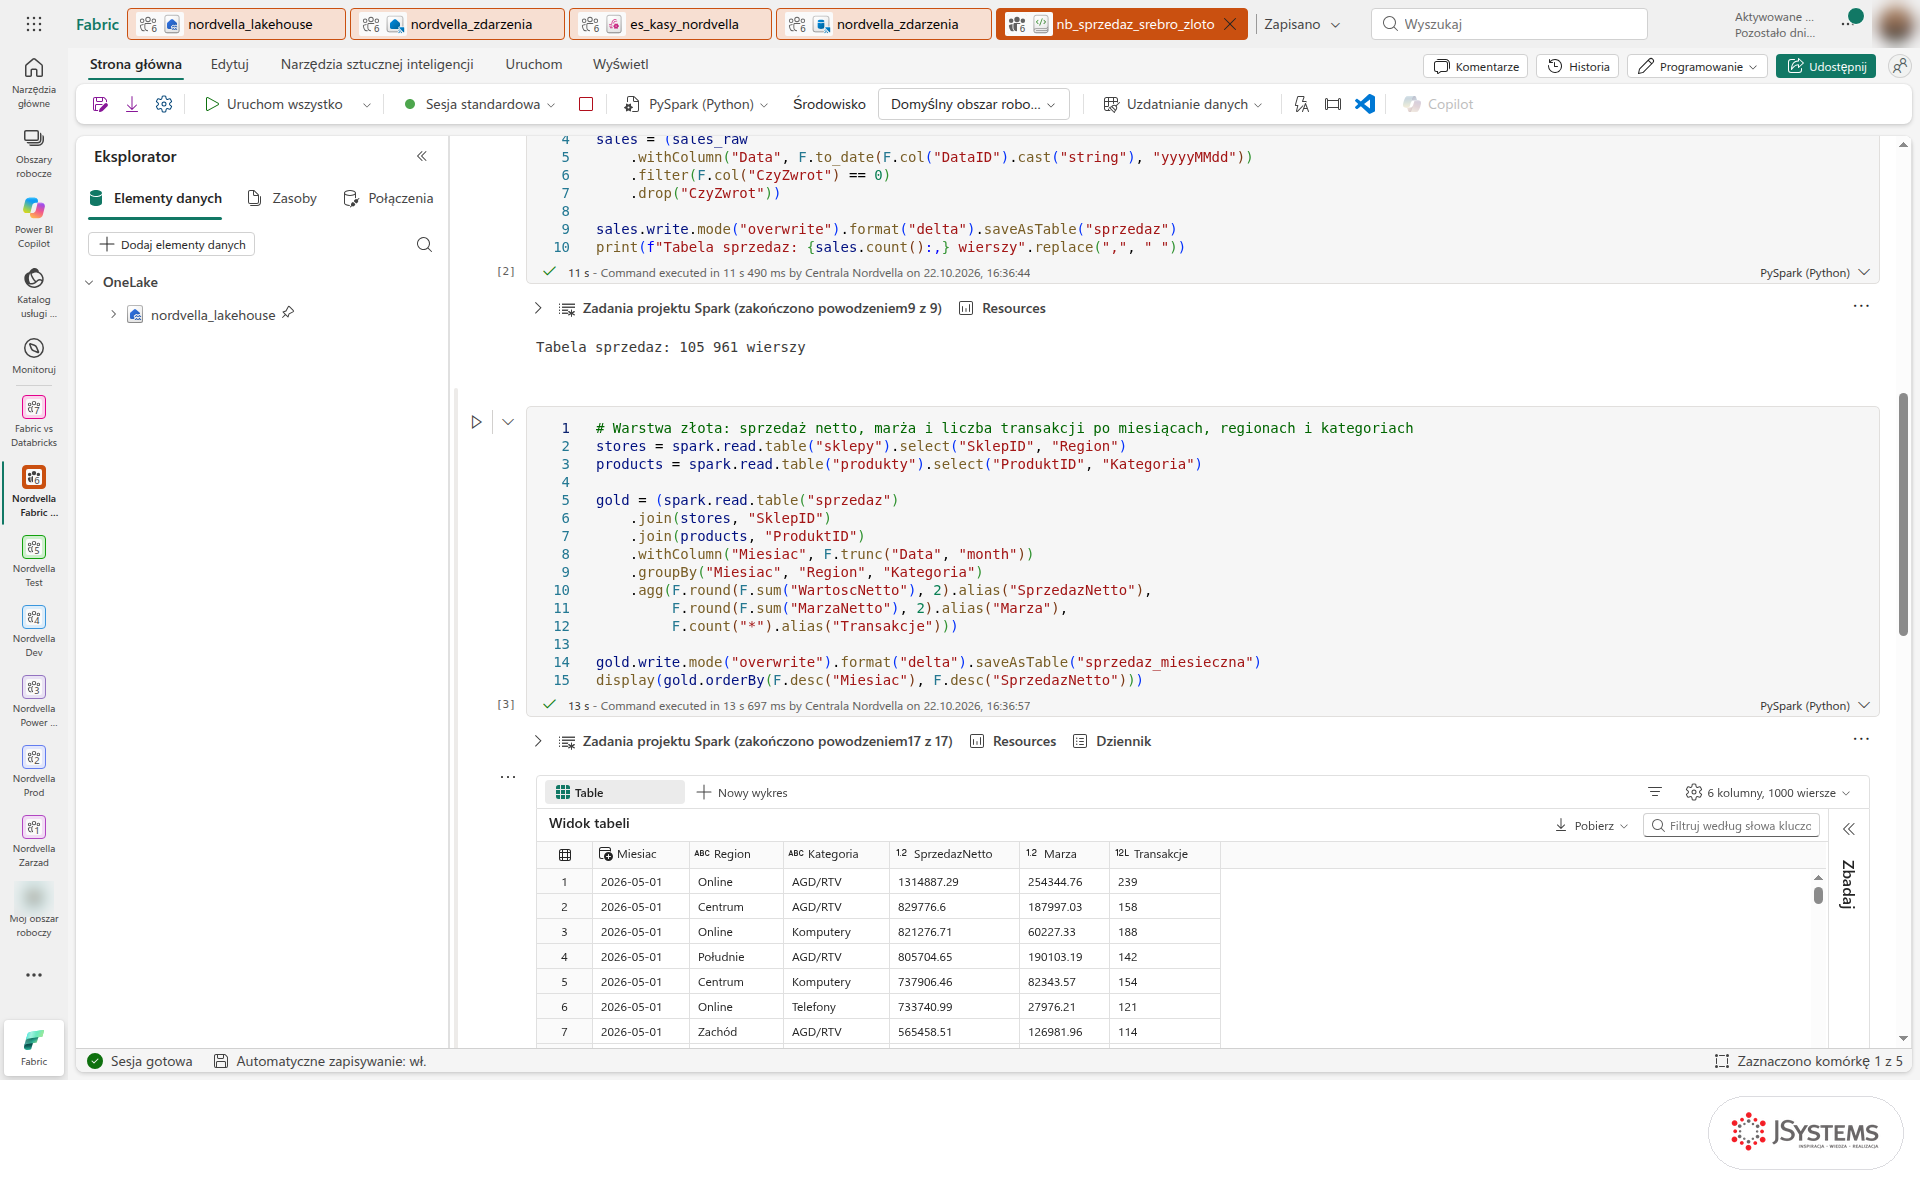
Trzecia komórka dołącza do sprzedaży region sklepu i kategorię produktu, obcina datę do pierwszego dnia miesiąca (F.trunc) i liczy sprzedaż netto, marżę oraz liczbę transakcji. Wynik trafia do tabeli sprzedaz_miesieczna, a funkcja display pokazuje go jako interaktywną tabelę. Tabela ma 1 272 wiersze: 53 miesiące razy 6 regionów razy 4 kategorie.
# Warstwa złota: sprzedaż netto, marża i liczba transakcji po miesiącach, regionach i kategoriach
stores = spark.read.table("sklepy").select("SklepID", "Region")
products = spark.read.table("produkty").select("ProduktID", "Kategoria")

gold = (spark.read.table("sprzedaz")
    .join(stores, "SklepID")
    .join(products, "ProduktID")
    .withColumn("Miesiac", F.trunc("Data", "month"))
    .groupBy("Miesiac", "Region", "Kategoria")
    .agg(F.round(F.sum("WartoscNetto"), 2).alias("SprzedazNetto"),
         F.round(F.sum("MarzaNetto"), 2).alias("Marza"),
         F.count("*").alias("Transakcje")))

gold.write.mode("overwrite").format("delta").saveAsTable("sprzedaz_miesieczna")
display(gold.orderBy(F.desc("Miesiac"), F.desc("SprzedazNetto")))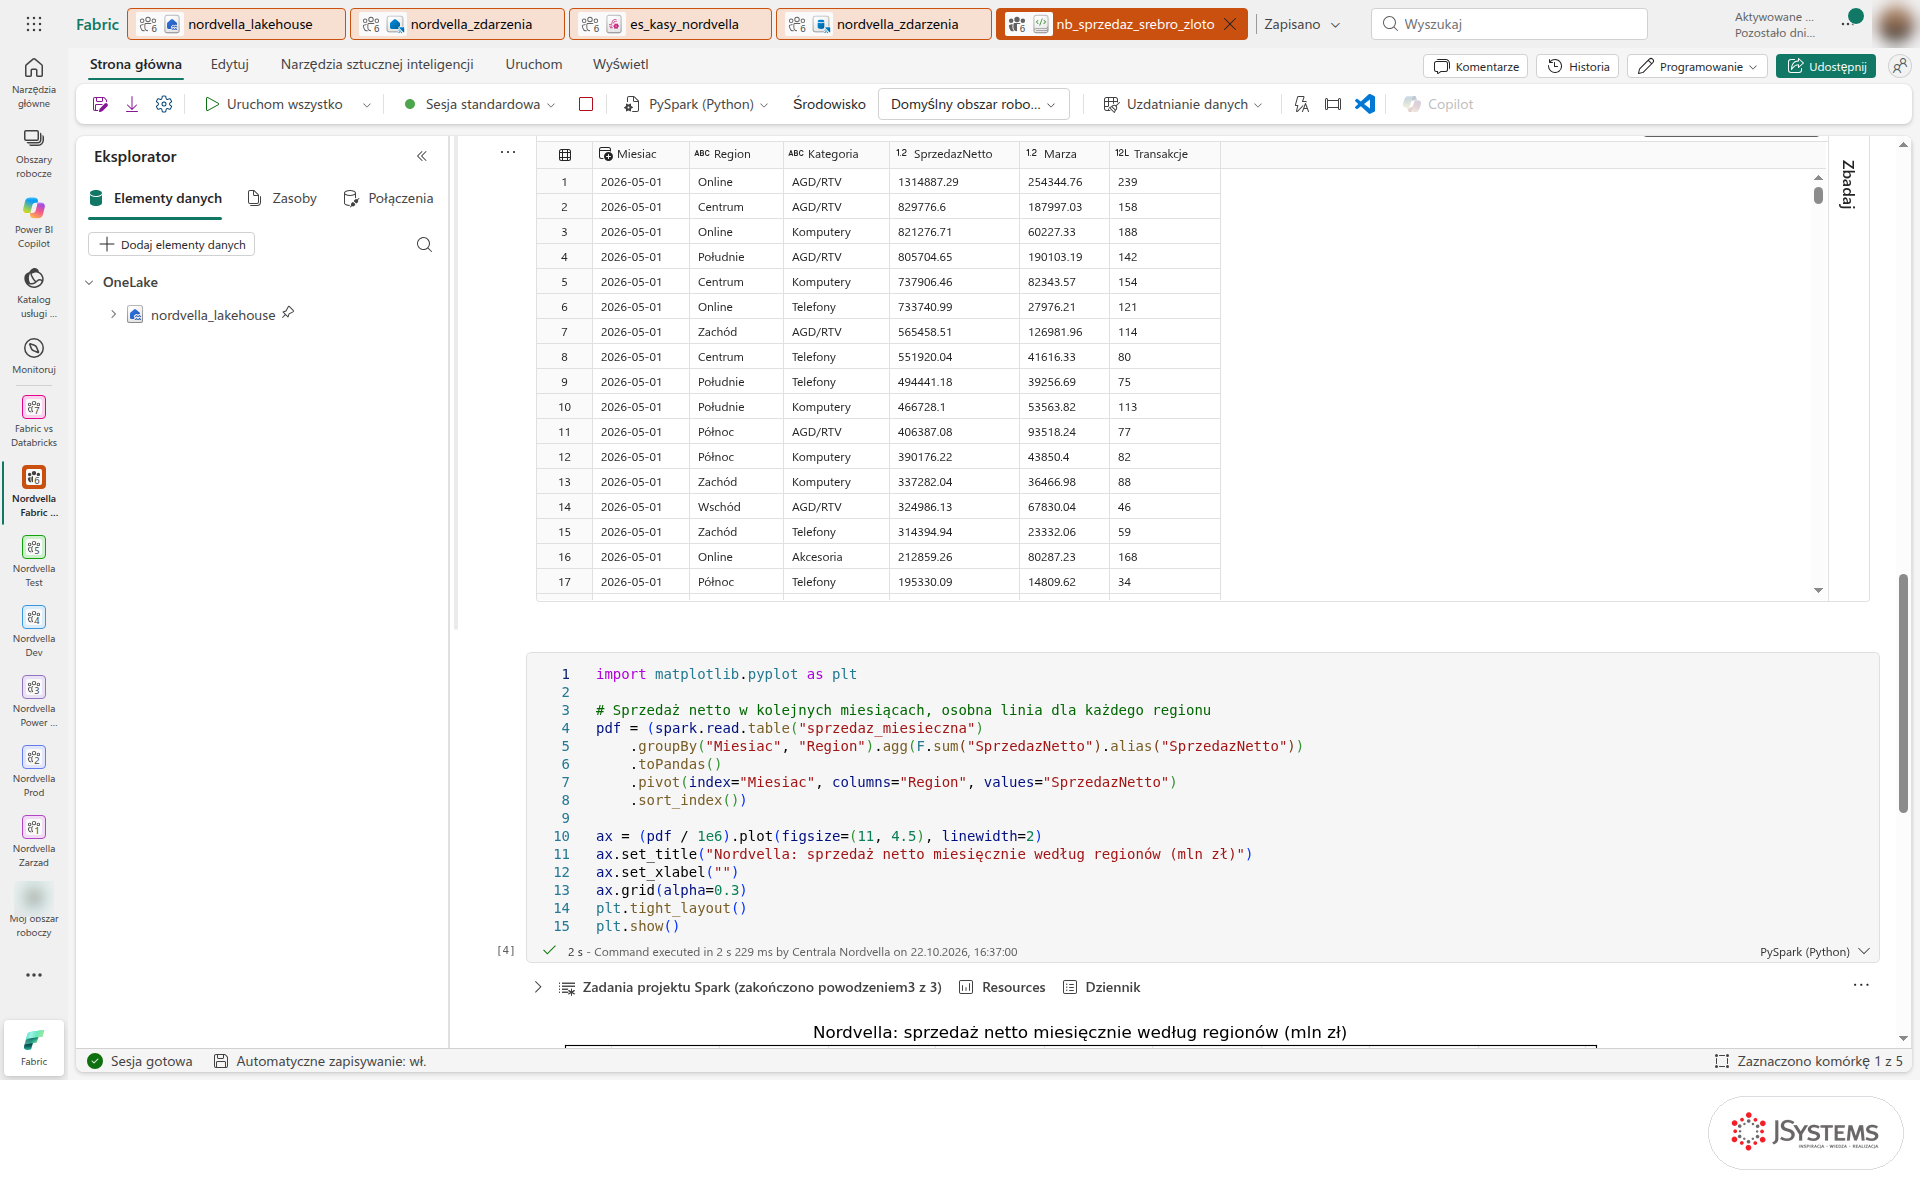
Ostatnia komórka rysuje sprzedaż w czasie osobno dla każdego regionu. Do małej tabeli złotej wystarczy przejść z ramki Sparka do pandas (toPandas) i użyć matplotlib, który jest w środowisku Fabric od razu.
import matplotlib.pyplot as plt

# Sprzedaż netto w kolejnych miesiącach, osobna linia dla każdego regionu
pdf = (spark.read.table("sprzedaz_miesieczna")
    .groupBy("Miesiac", "Region").agg(F.sum("SprzedazNetto").alias("SprzedazNetto"))
    .toPandas()
    .pivot(index="Miesiac", columns="Region", values="SprzedazNetto")
    .sort_index())

ax = (pdf / 1e6).plot(figsize=(11, 4.5), linewidth=2)
ax.set_title("Nordvella: sprzedaż netto miesięcznie według regionów (mln zł)")
ax.set_xlabel("")
ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()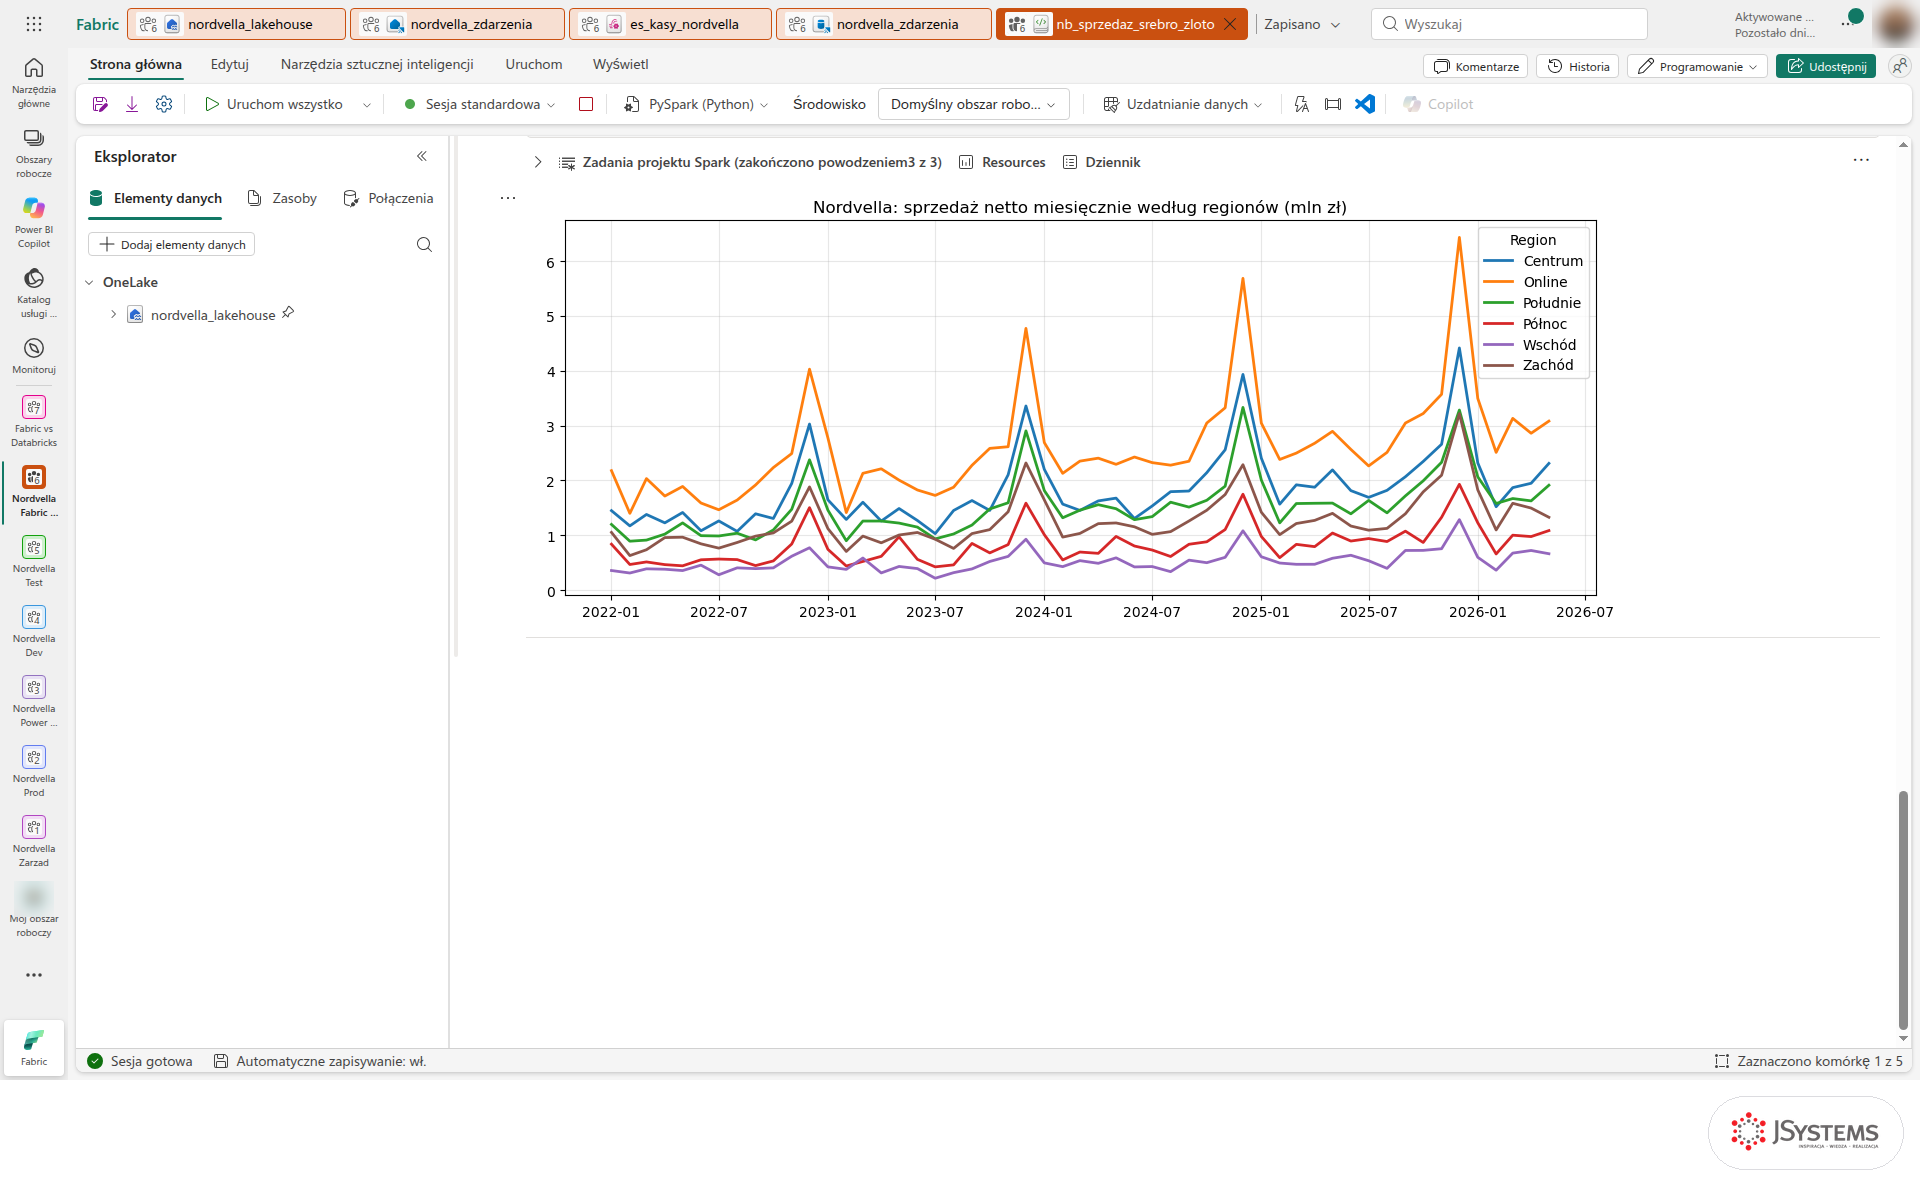
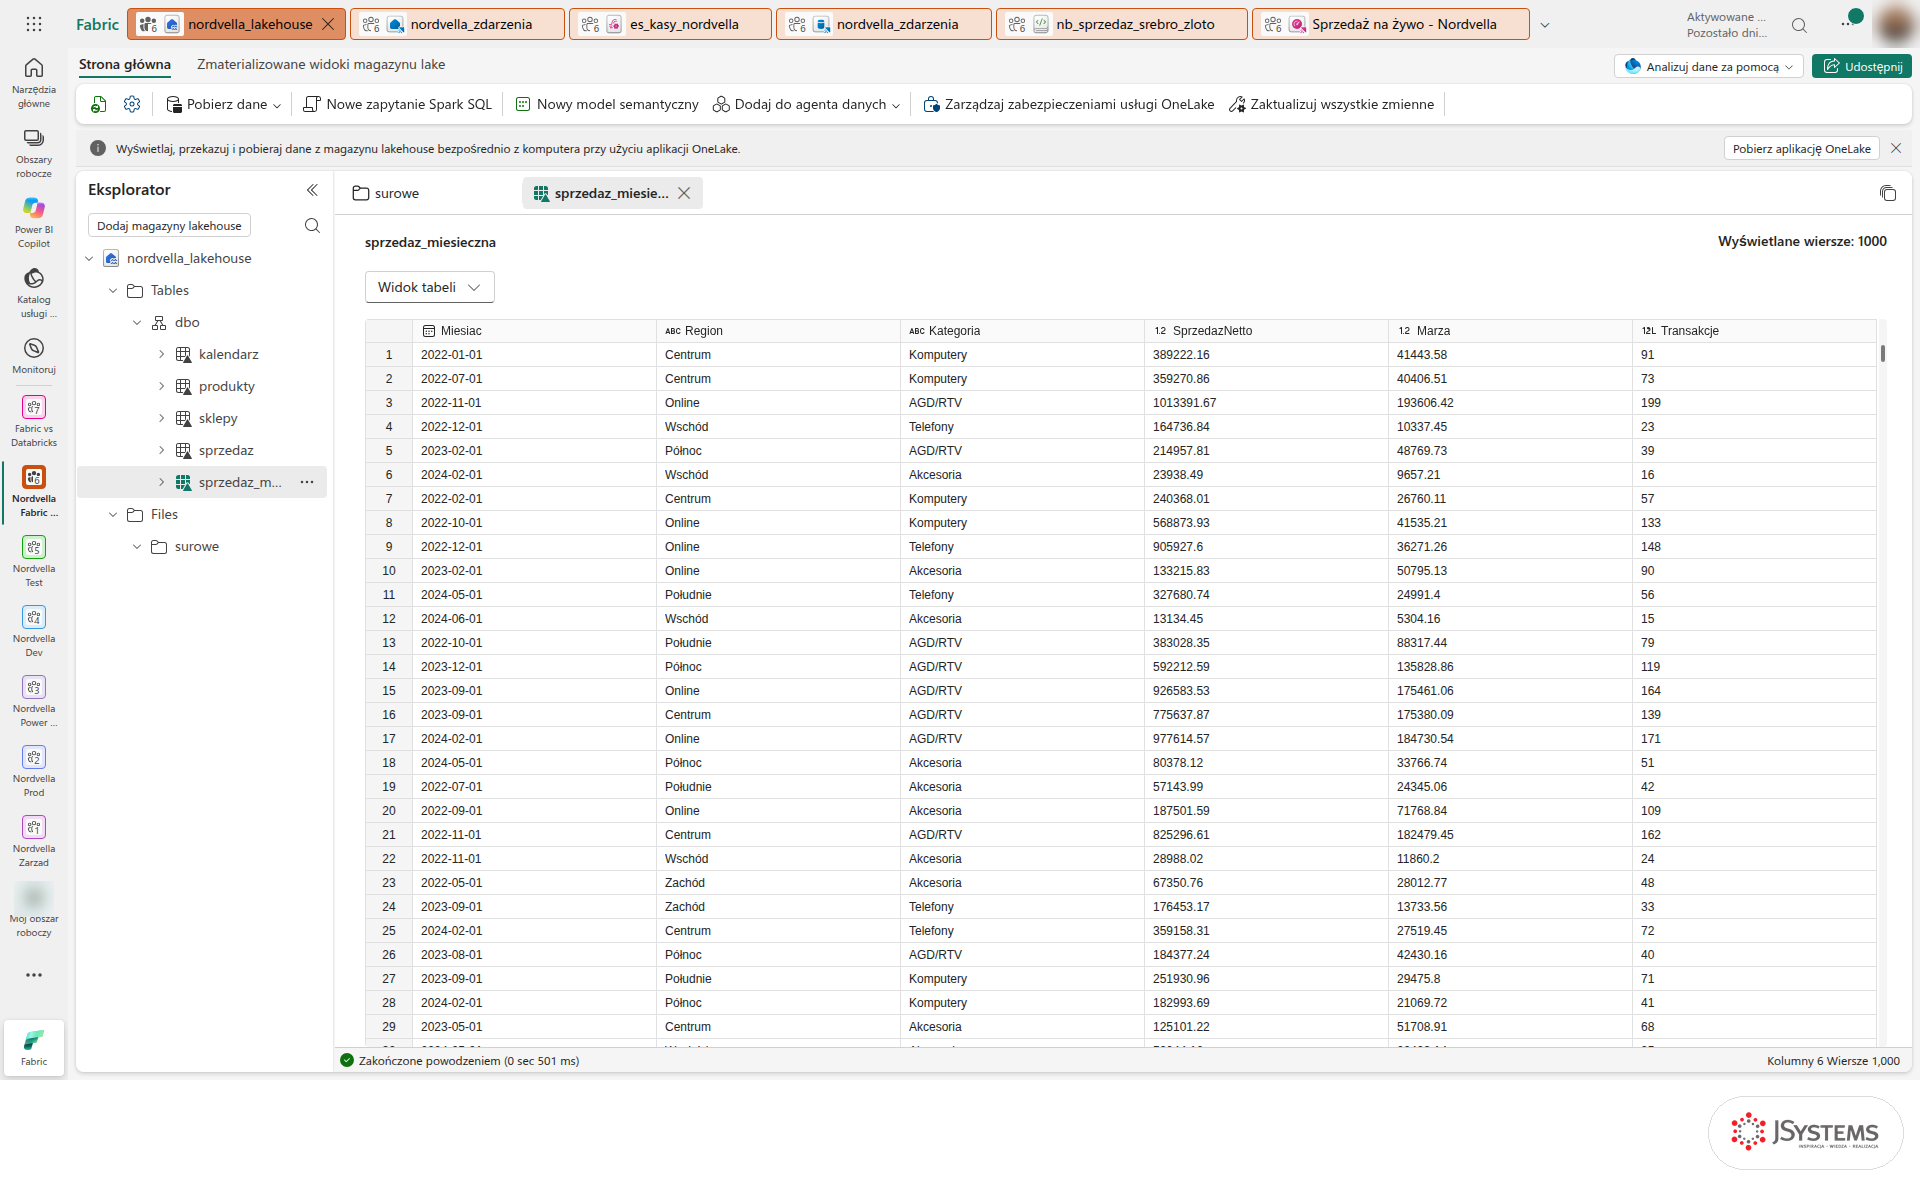
Po przeliczeniu w lakehouse są dwie nowe tabele. Podgląd tabeli sprzedaz_miesieczna otworzysz jednym kliknięciem w eksploratorze, bez pisania zapytania.
Co chcemy osiągnąć. Kontroler finansowy Nordvelli zna SQL, ale nie PySpark, i chce sprawdzić, który region w 2025 roku dał najwięcej sprzedaży i jaką marżę. Dział controllingu prosi dodatkowo o osobną tabelę z rocznymi wynikami regionów w hurtowni, na której zbuduje własne zestawienia. Pokażemy oba narzędzia SQL w Fabric: punkt końcowy analizy SQL i magazyn.
Każdy lakehouse ma automatycznie tworzony punkt końcowy analizy SQL (SQL analytics endpoint). To widok tabel Delta przez silnik T-SQL, tylko do odczytu: możesz pisać zapytania, tworzyć widoki i funkcje, ale nie zmienisz danych poleceniami INSERT czy UPDATE. Dane zmieniasz po stronie lakehouse, np. notesem, a punkt końcowy widzi je po synchronizacji metadanych.
zapytanie_regiony_2025.sql ) i kliknij „Uruchom”.-- Sprzedaż netto i marża według regionów w 2025 roku (punkt końcowy analizy SQL magazynu lakehouse)
SELECT Region,
SUM(SprzedazNetto) AS SprzedazNetto,
CAST(100.0 * SUM(Marza) / SUM(SprzedazNetto) AS DECIMAL(5, 2)) AS MarzaProcent,
SUM(Transakcje) AS Transakcje
FROM dbo.sprzedaz_miesieczna
WHERE Miesiac >= '2025-01-01' AND Miesiac < '2026-01-01'
GROUP BY Region
ORDER BY SprzedazNetto DESC;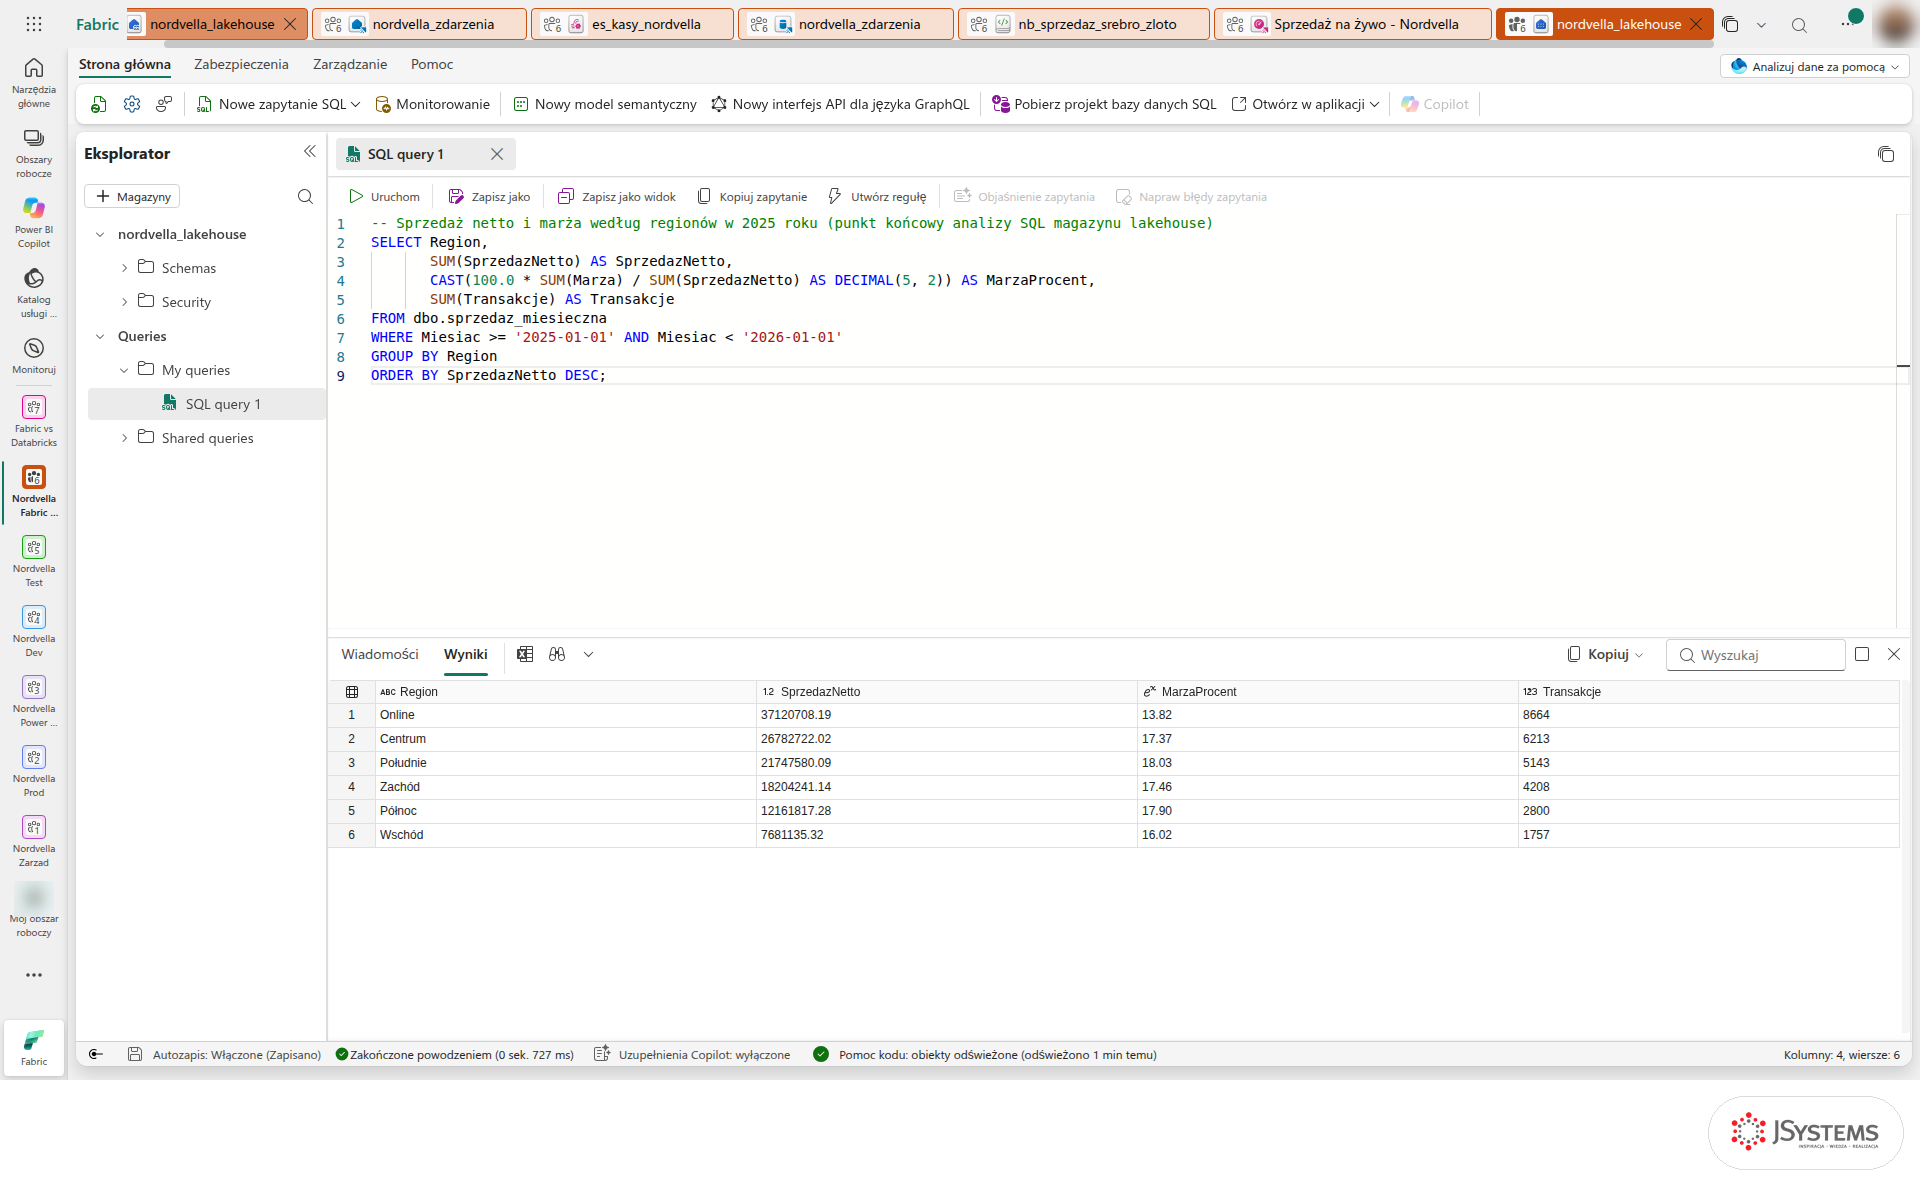
| Region | Sprzedaż netto 2025 (zł) | Marża (%) | Transakcje |
|---|---|---|---|
| Online | 37 120 708,19 | 13,82 | 8 664 |
| Centrum | 26 782 722,02 | 17,37 | 6 213 |
| Południe | 21 747 580,09 | 18,03 | 5 143 |
| Zachód | 18 204 241,14 | 17,46 | 4 208 |
| Północ | 12 161 817,28 | 17,90 | 2 800 |
| Wschód | 7 681 135,32 | 16,02 | 1 757 |
Wynik dobrze pokazuje, po co analizować marżę obok sprzedaży: sklep internetowy sprzedaje najwięcej, ale ma najniższą marżę procentową ze wszystkich regionów. Razem sieć sprzedała w 2025 roku towar za 123 698 204,04 zł netto w 28 785 transakcjach.
Magazyn to hurtownia danych w Fabric, w której T-SQL działa w pełnym zakresie: INSERT, UPDATE, DELETE, procedury składowane i transakcje obejmujące wiele tabel. Tabele magazynu też są zapisywane w OneLake w formacie Delta Parquet, więc Spark i Power BI czytają je tak samo jak tabele lakehouse.
nordvella_dw.magazyn_ctas.sql ) i uruchom go.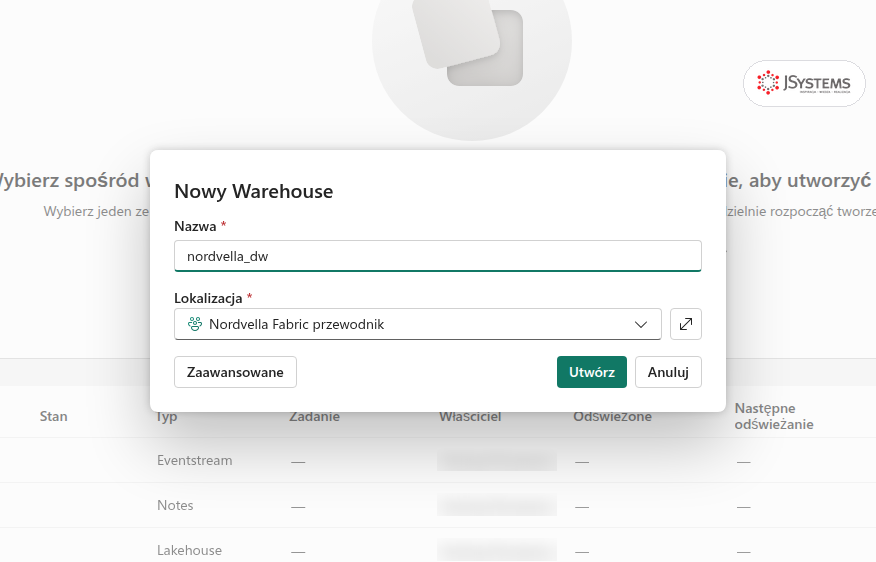
-- Magazyn nordvella_dw: tabela z danych lakehouse'a utworzona jednym zapytaniem (bez kopiowania plików)
DROP TABLE IF EXISTS dbo.sprzedaz_region_rok;

CREATE TABLE dbo.sprzedaz_region_rok AS
SELECT s.Region,
       YEAR(z.Data) AS Rok,
       CAST(SUM(z.WartoscNetto) AS DECIMAL(18, 2)) AS SprzedazNetto,
       COUNT(*) AS Transakcje
FROM nordvella_lakehouse.dbo.sprzedaz AS z
JOIN nordvella_lakehouse.dbo.sklepy AS s ON s.SklepID = z.SklepID
GROUP BY s.Region, YEAR(z.Data);

SELECT Region, Rok, SprzedazNetto, Transakcje
FROM dbo.sprzedaz_region_rok
WHERE Rok = 2025
ORDER BY SprzedazNetto DESC;
Najważniejsza jest tu klauzula FROM nordvella_lakehouse.dbo.sprzedaz. Magazyn czyta tabele lakehouse z tego samego obszaru roboczego po nazwie trzyczłonowej (element, schemat, tabela), tak jakby były w jednej bazie. CREATE TABLE AS SELECT (CTAS) tworzy z wyniku nową tabelę magazynu jednym poleceniem, bez eksportu i importu plików.
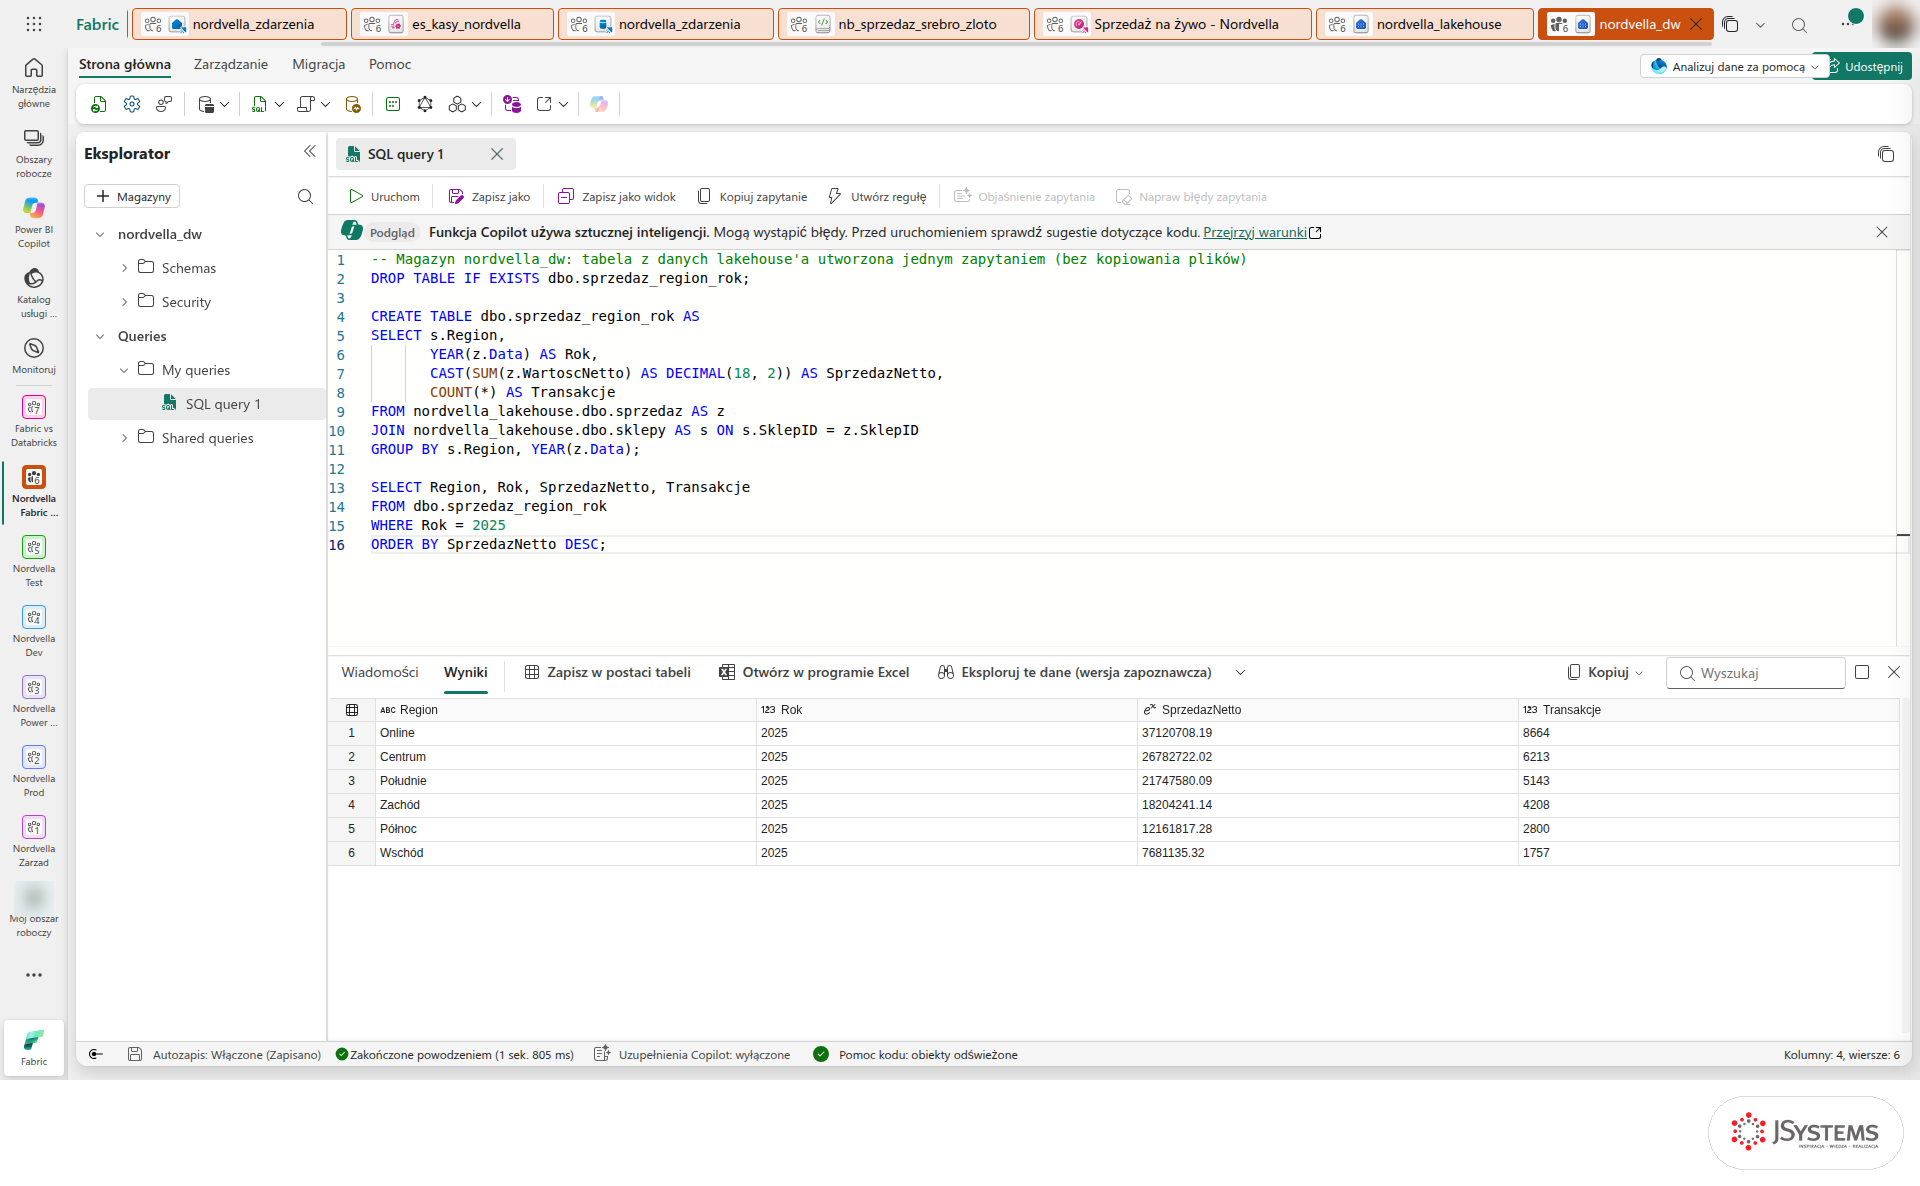
Wyniki w magazynie zgadzają się co do grosza z zapytaniem na punkcie końcowym, choć liczyliśmy je inną drogą: tam z tabeli złotej, tu z tabeli srebrnej. Taka zgodność dwóch niezależnych ścieżek to prosty test, że warstwy medalionowe zostały policzone poprawnie.
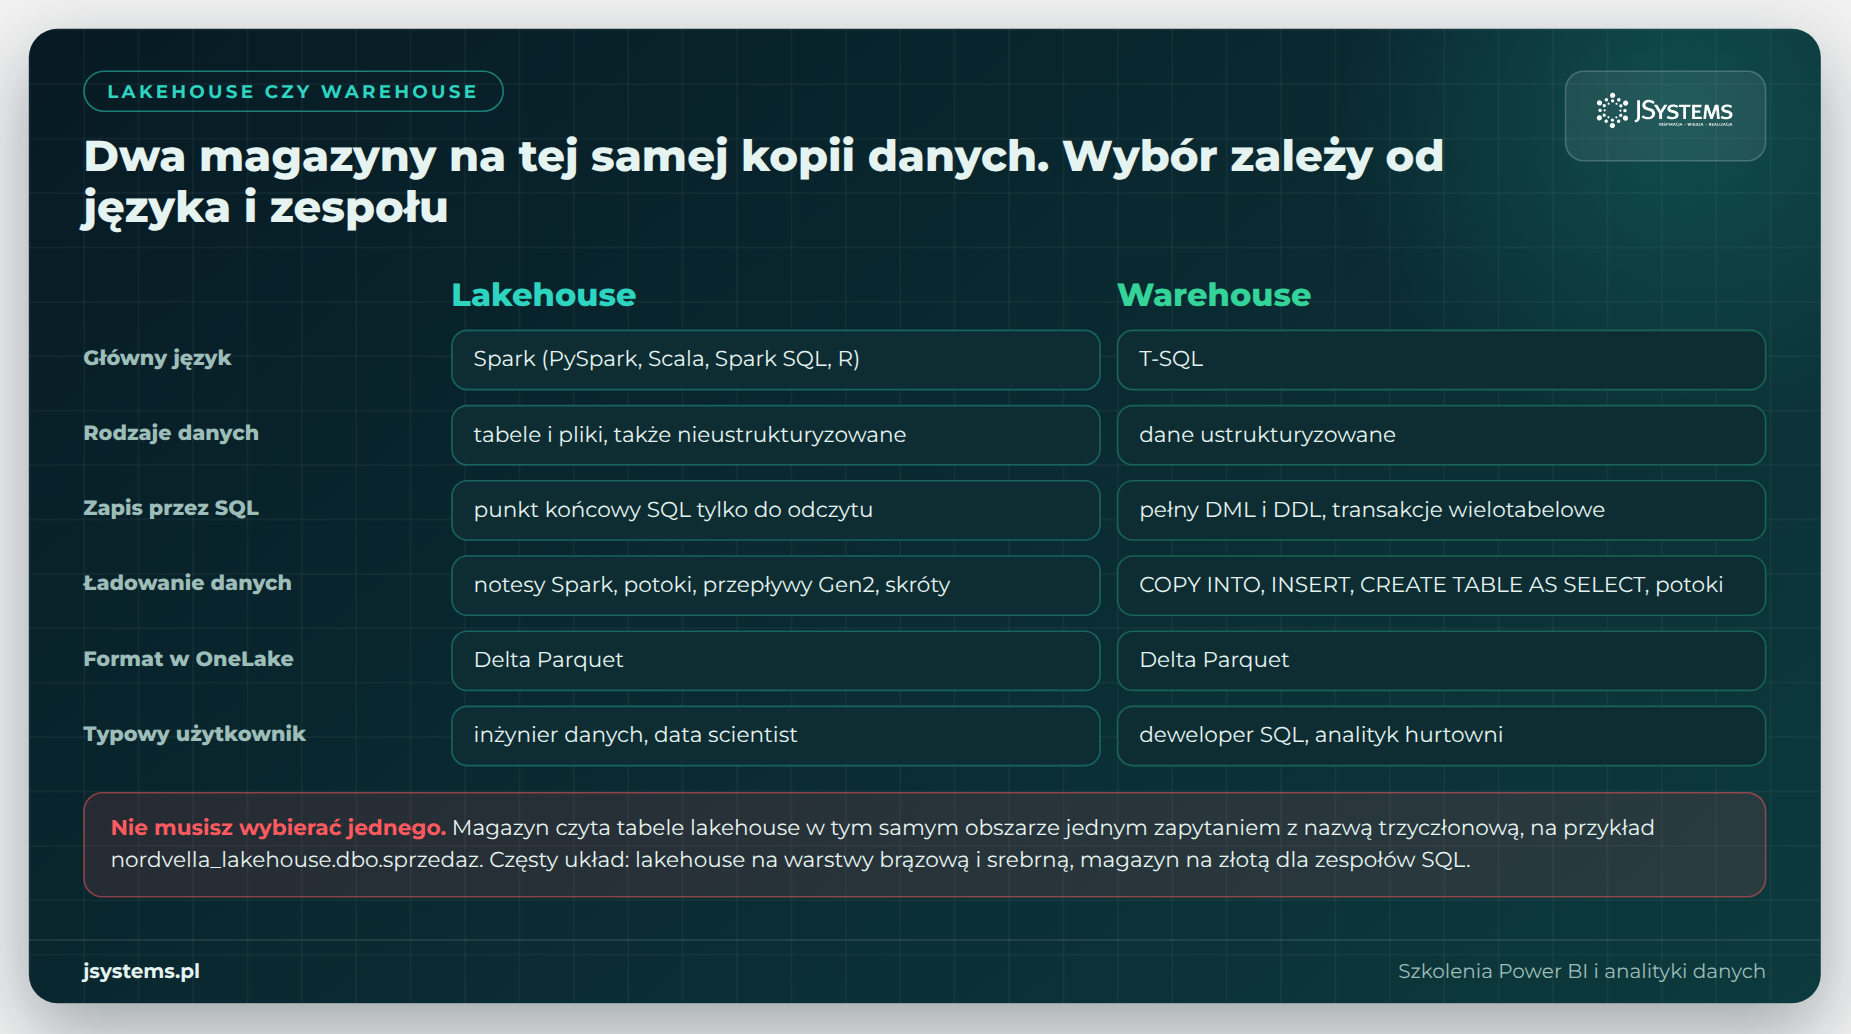
Wybór zwykle wynika z zespołu, a nie z danych. Jeśli dane przygotowują inżynierowie w Sparku, a analitycy tylko je czytają, wystarczy lakehouse z punktem końcowym SQL. Jeśli zespół hurtowni pisze w T-SQL procedury, które zmieniają dane, potrzebny jest magazyn. Częsty układ łączy oba: lakehouse na warstwy brązową i srebrną, magazyn na warstwę złotą, z której korzystają raporty i controlling.
Co chcemy osiągnąć. Zarząd ma dostać raport ze sprzedażą według regionów, kategorii i miesięcy, z filtrem kanału sprzedaży. Raport ma czytać tabele prosto z lakehouse, bez kopiowania danych do modelu i bez osobnego harmonogramu importu, tak żeby po nocnym przeliczeniu notesu rano pokazywał nowe liczby. Do tego służy tryb Direct Lake.
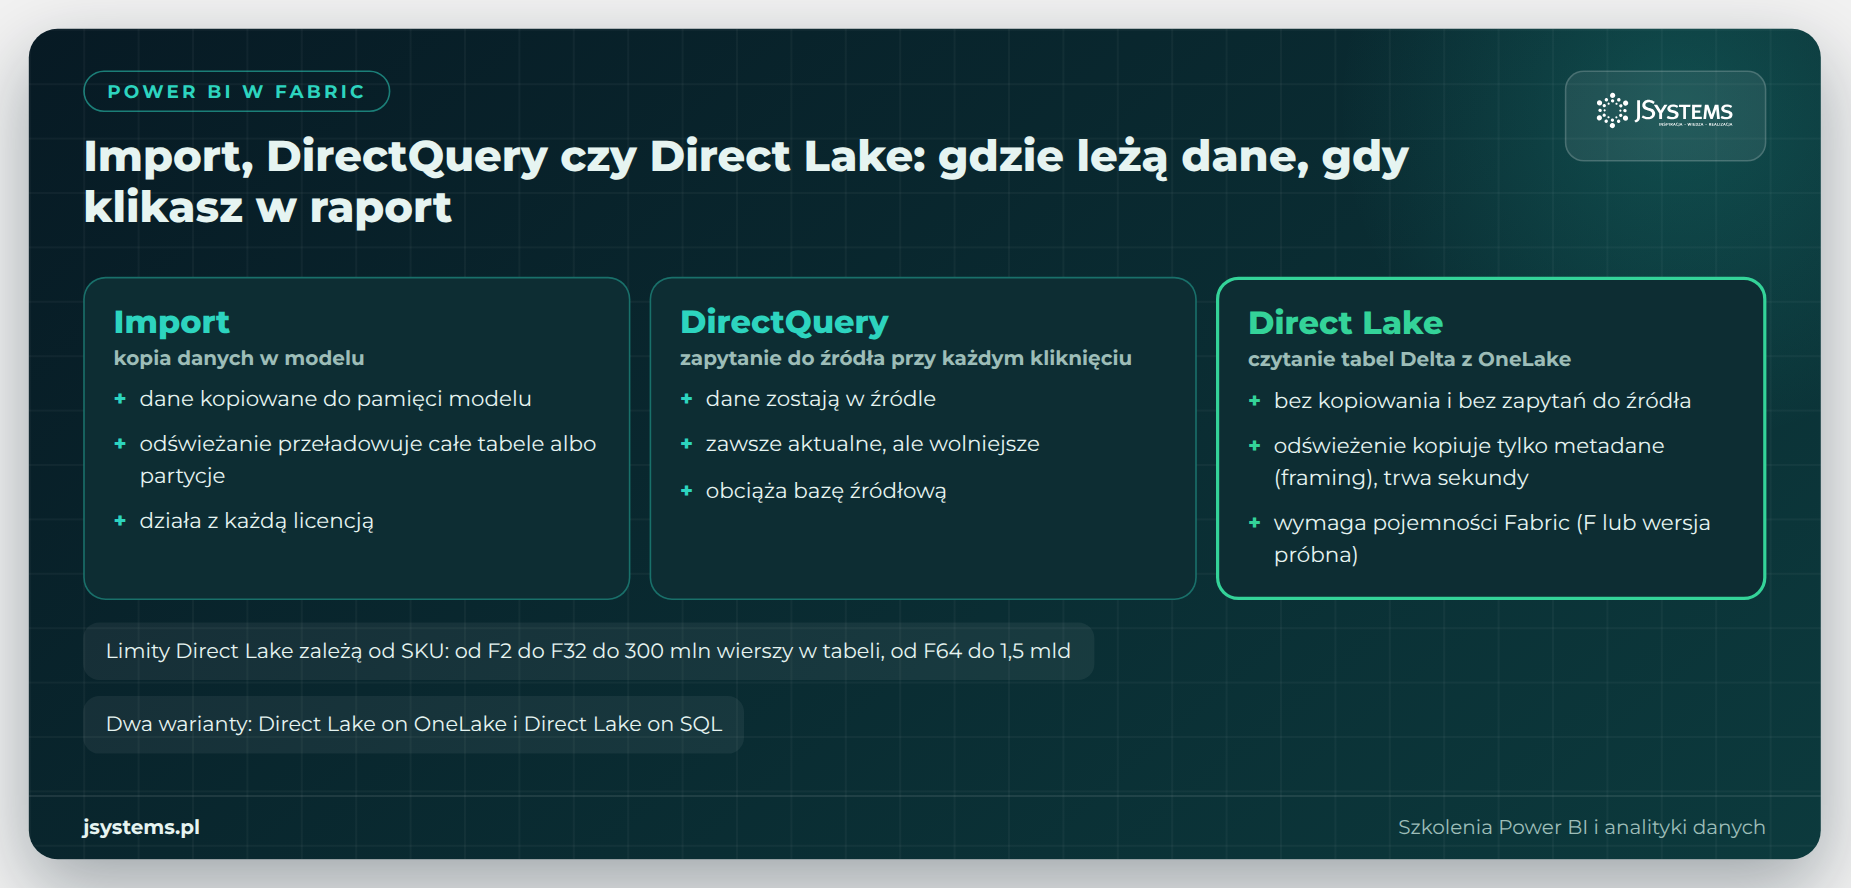
W trybie Import Power BI kopiuje dane do pamięci modelu, więc raport jest szybki, ale pokazuje stan z ostatniego odświeżenia, a przy dużych tabelach odświeżanie trwa długo. W DirectQuery każde kliknięcie wysyła zapytanie do źródła, więc dane są aktualne, ale raport zależy od wydajności bazy. Direct Lake łączy zalety obu: silnik Power BI wczytuje do pamięci kolumny prosto z plików Parquet w OneLake, dopiero gdy są potrzebne. Odświeżenie modelu Direct Lake kopiuje tylko metadane, czyli wskazanie, która wersja tabel Delta obowiązuje (ramkowanie, framing), więc trwa sekundy, a nie minuty.
nordvella_direct_lake i jako tryb przechowywania zostaw „Usługa Direct Lake w usłudze OneLake”.kalendarz, produkty, sklepy i sprzedaz. Tabeli złotej sprzedaz_miesieczna nie dodajemy, bo model sam policzy agregaty z tabeli srebrnej, a przy okazji zachowamy szczegóły do analizy w dół. Kliknij „Potwierdź”.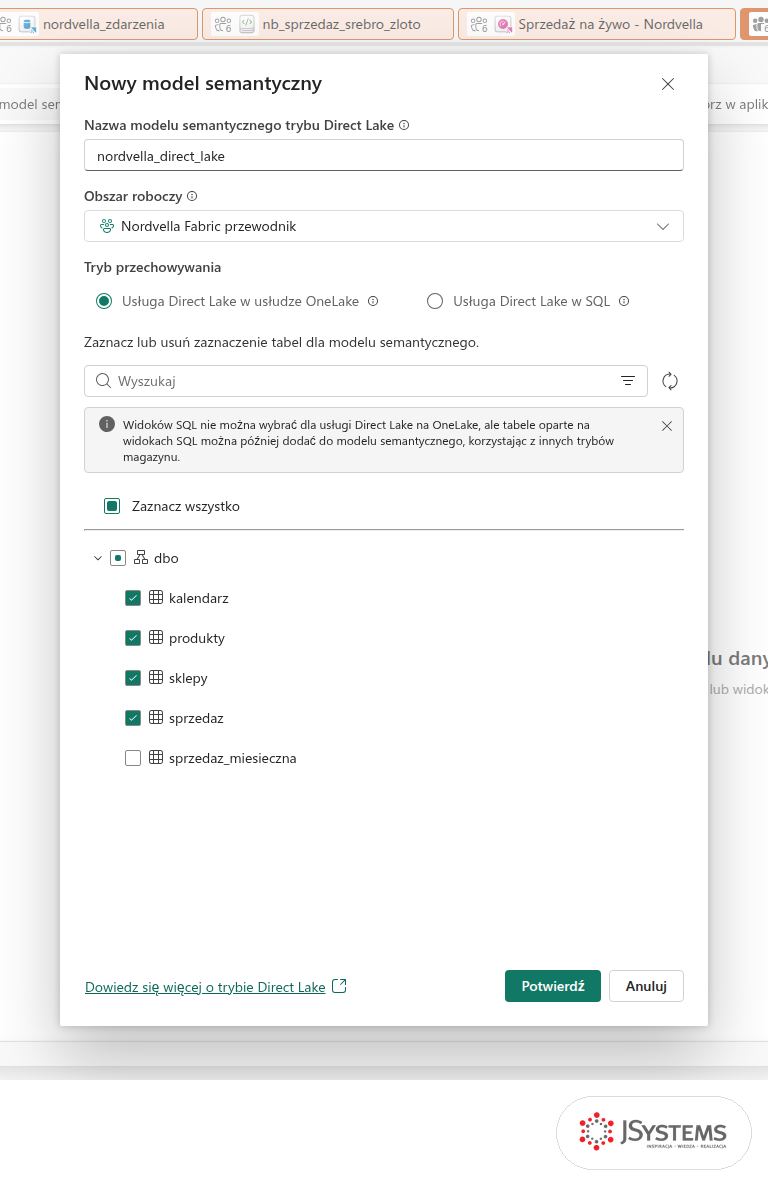
Model otwiera się w edytorze w przeglądarce. Relacje między tabelami można przeciągać myszą w diagramie, ale szybciej i powtarzalnie zrobisz to skryptem w widoku TMDL (Tabular Model Definition Language, tekstowy język definicji modelu). Otwórz „Widok TMDL”, wklej skrypt z ramki albo z pliku relacje.tmdl i kliknij „Zastosuj”.
createOrReplace

    relationship sprzedaz_sklepy
        fromColumn: sprzedaz.SklepID
        toColumn: sklepy.SklepID

    relationship sprzedaz_produkty
        fromColumn: sprzedaz.ProduktID
        toColumn: produkty.ProduktID

    relationship sprzedaz_kalendarz
        fromColumn: sprzedaz.DataID
        toColumn: kalendarz.DataID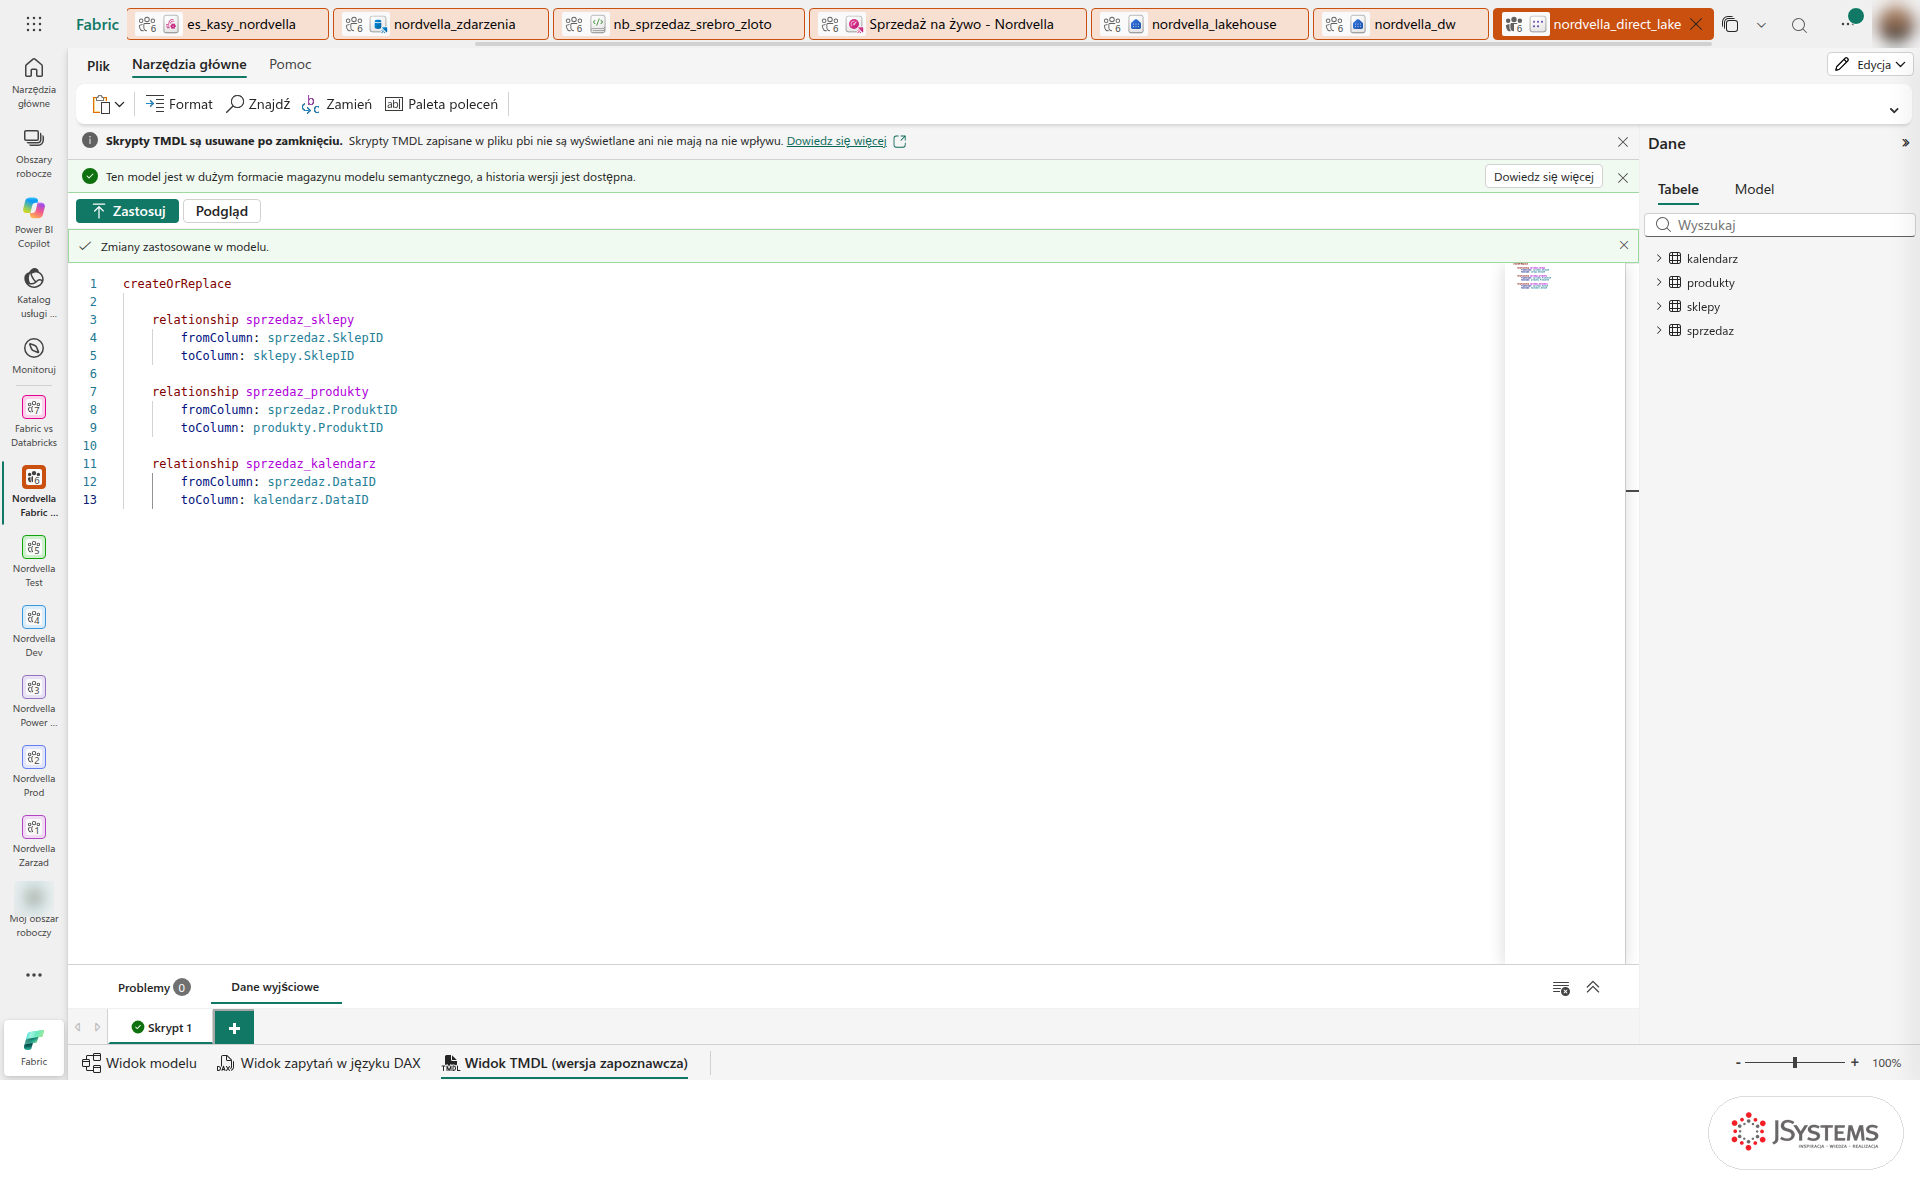
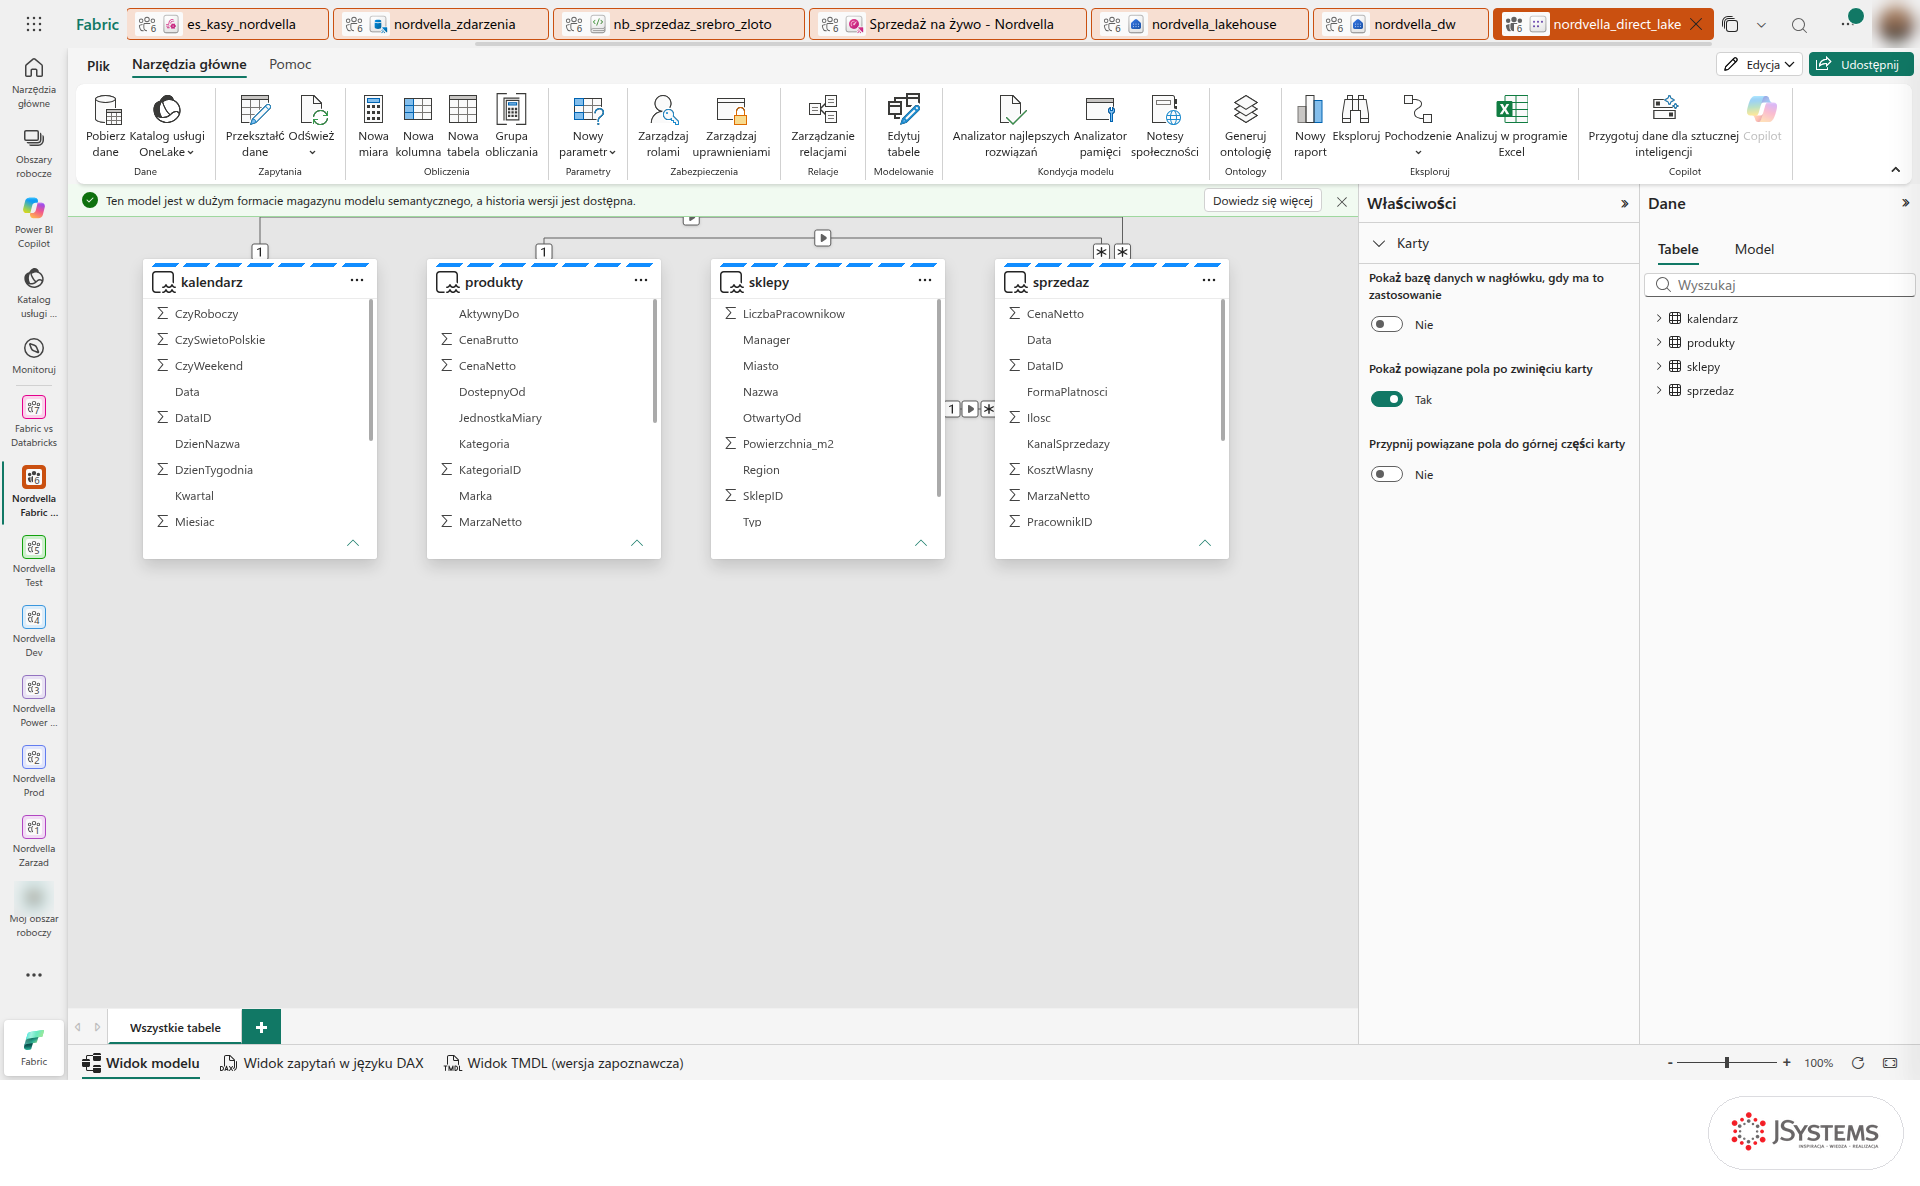
Na koniec miara. Na wstążce kliknij „Nowa miara” i wpisz formułę DAX z ramki. Miara w modelu to jedna definicja liczby, z której korzystają wszystkie raporty, zamiast sumowania kolumny osobno w każdej wizualizacji.
Sprzedaż netto = SUM(sprzedaz[WartoscNetto])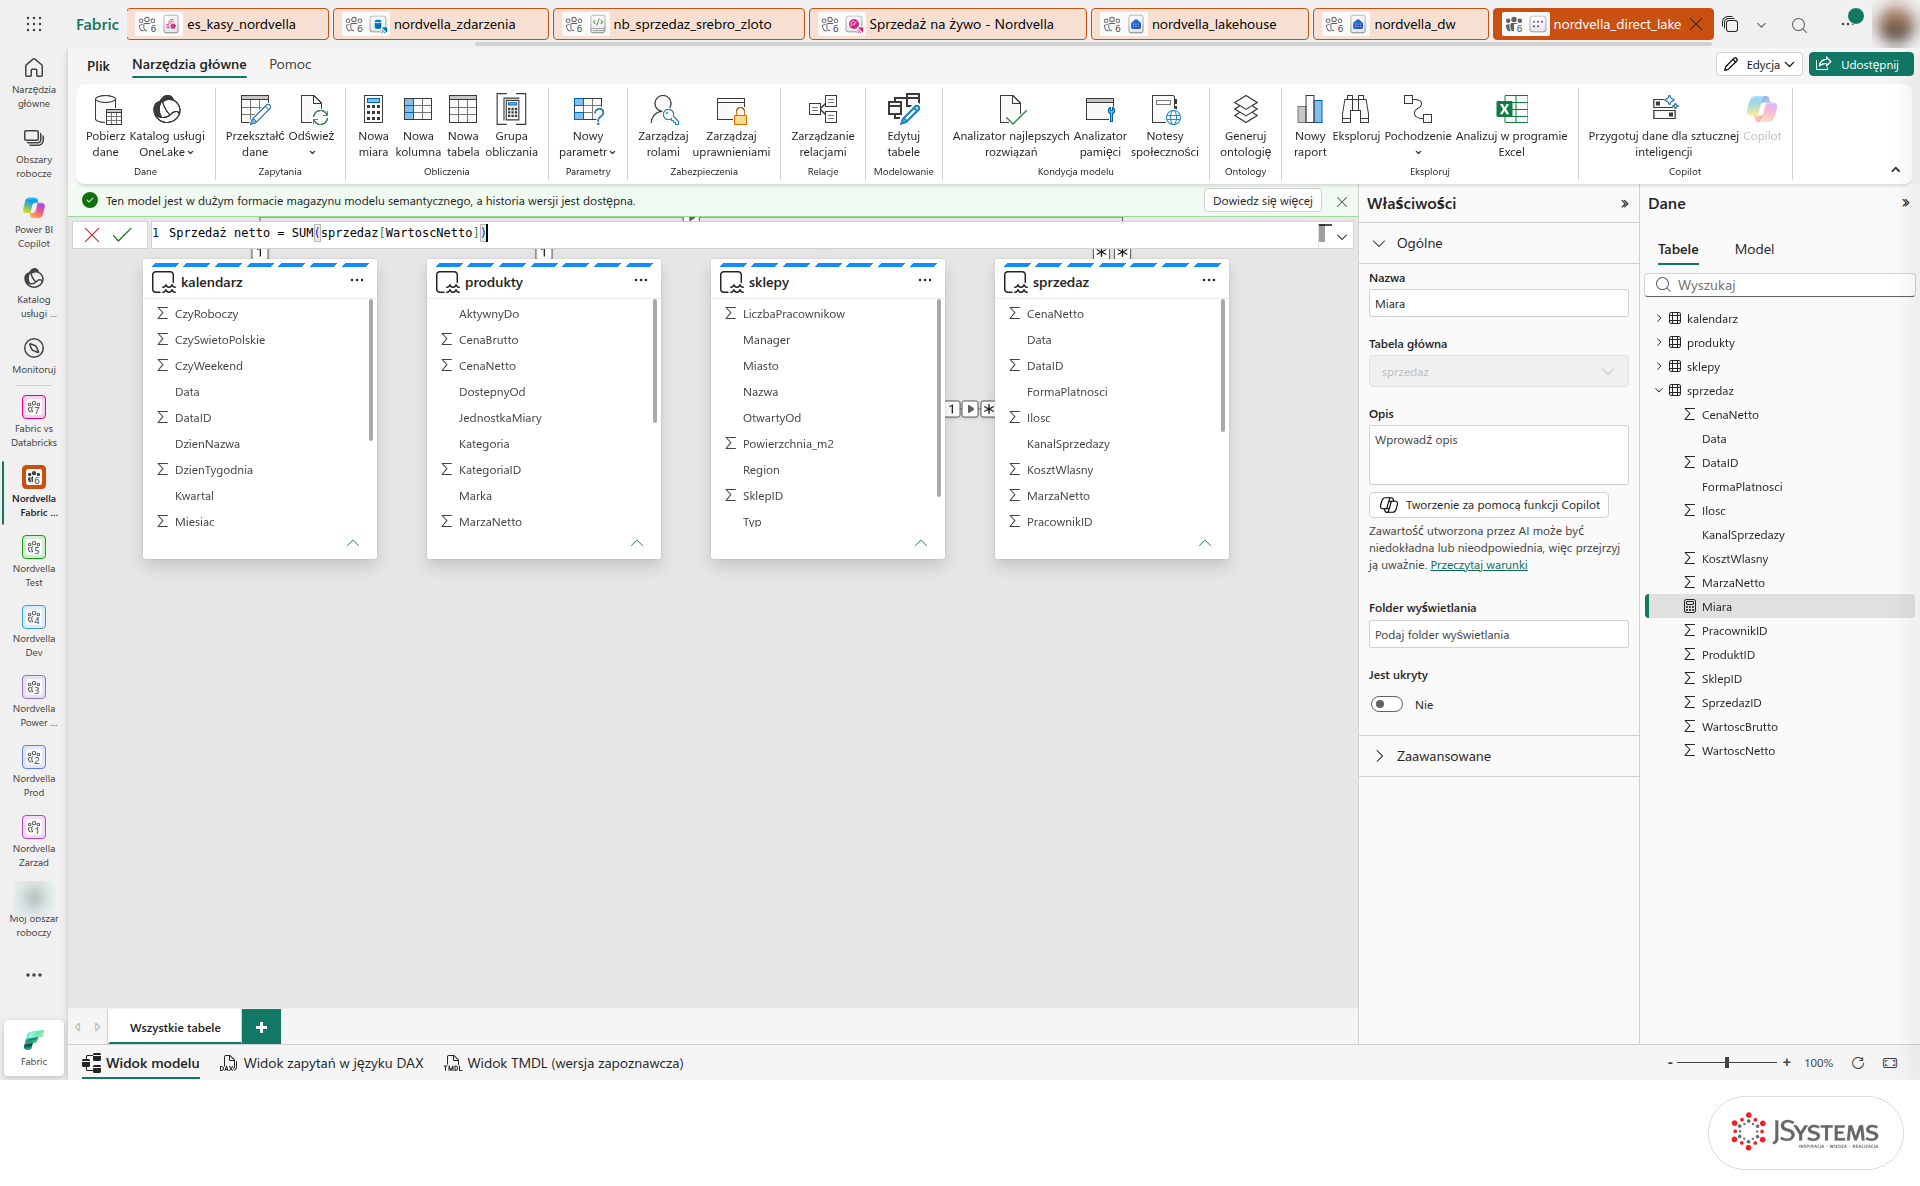
W edytorze modelu kliknij „Nowy raport” i ułóż pięć wizualizacji: kartę z miarą „Sprzedaż netto”, wykres kolumnowy według sklepy[Region], wykres pierścieniowy według produkty[Kategoria], fragmentator sprzedaz[KanalSprzedazy] i wykres liniowy według kalendarz[RokMiesiac]. Zapisz raport jako „Nordvella sprzedaż - Direct Lake”.
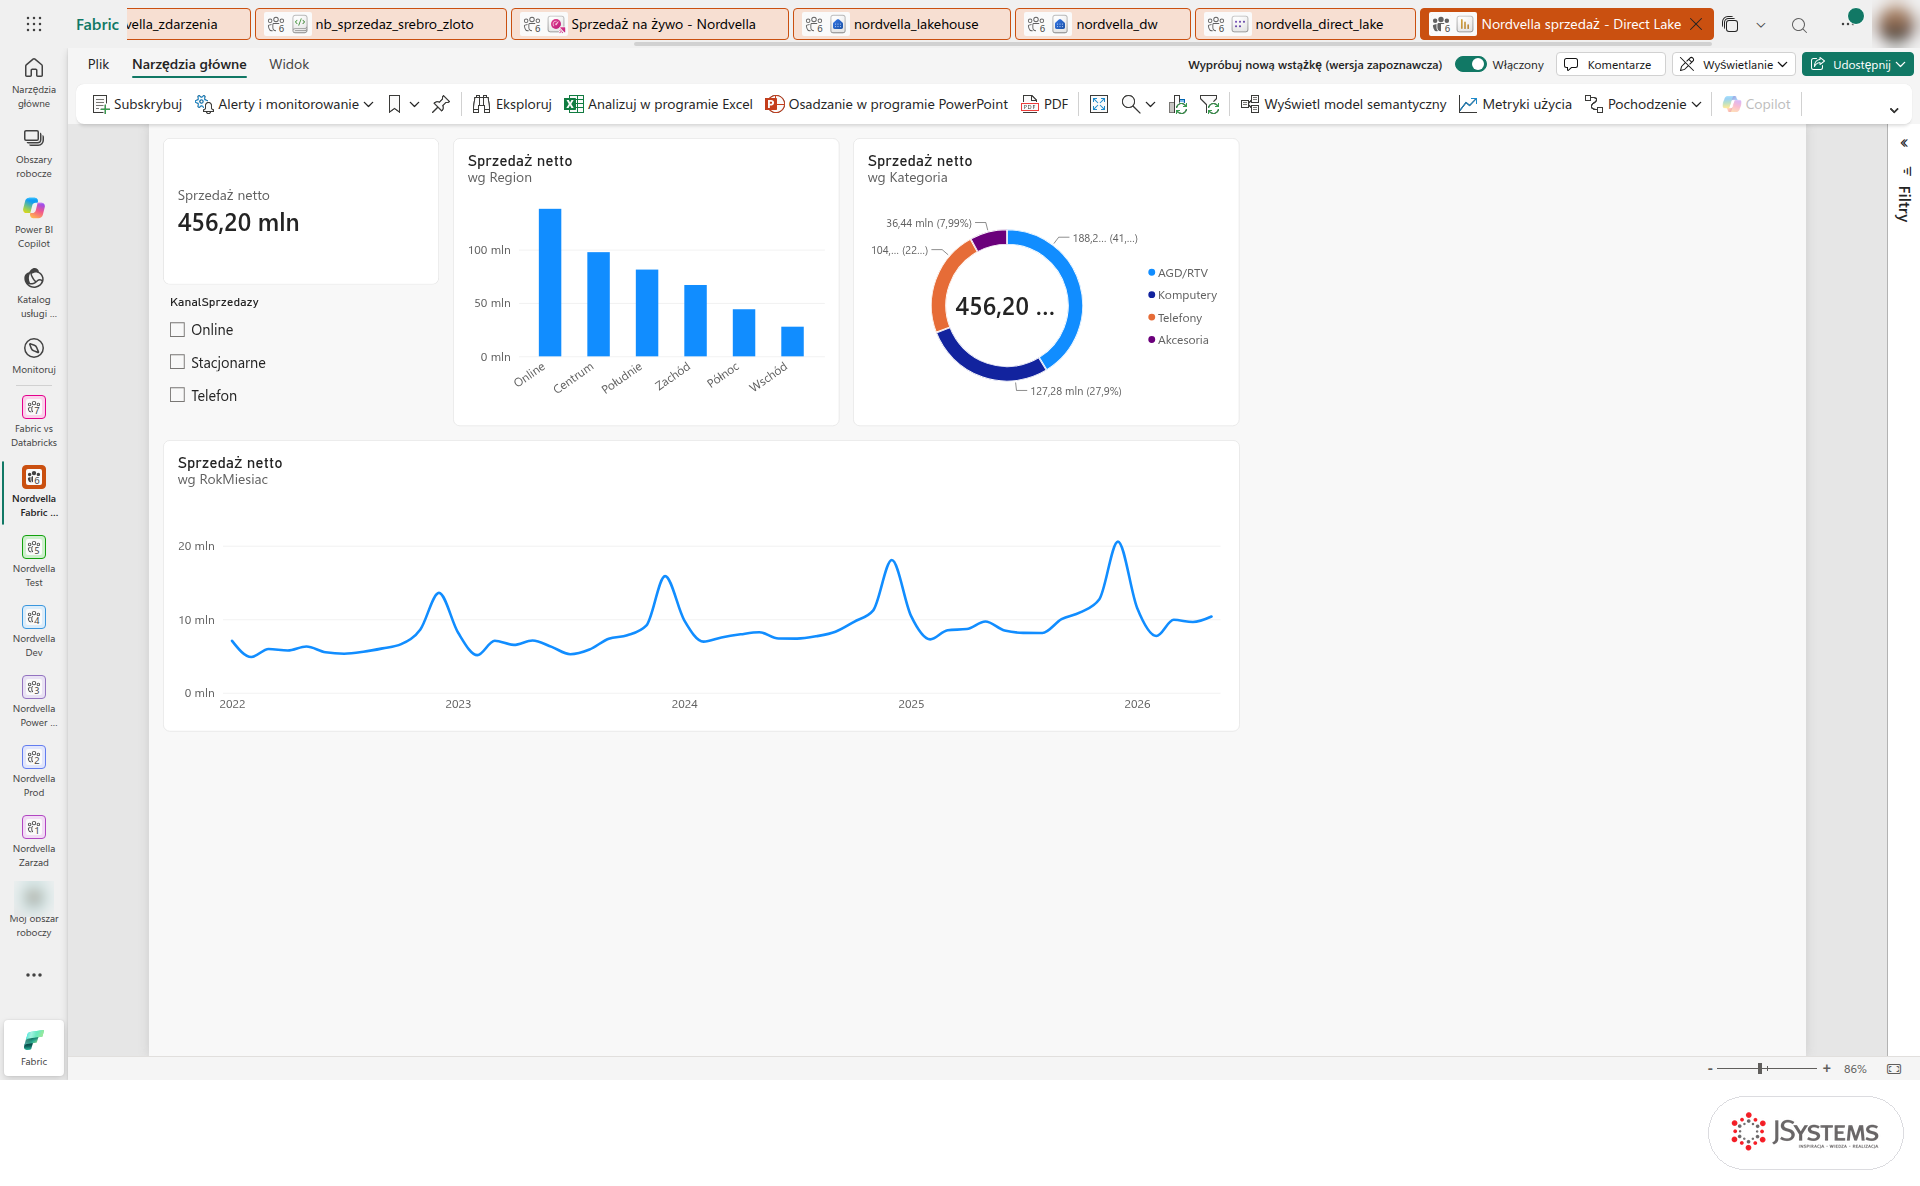
Karta pokazuje 456,20 mln zł, czyli dokładnie sumę 105 961 transakcji z tabeli srebrnej (456 203 988,98 zł). Gdy jutro rano potok przeliczy tabele, model po odświeżeniu metadanych pokaże nowe wartości bez ponownego importu. Model Direct Lake może też sam śledzić zmiany w tabelach Delta, co ustawia się w jego ustawieniach.
Direct Lake ma limity zależne od rozmiaru pojemności. Na F2-F32 tabela może mieć do 300 mln wierszy i do 1000 plików Parquet, a model na dysku od 10 do 40 GB. Od F64 limit rośnie do 1,5 mld wierszy w tabeli, a rozmiar modelu na dysku nie jest ograniczony. Co się dzieje po przekroczeniu limitu, zależy od wariantu. W Direct Lake on OneLake odświeżenie się nie udaje i modelu nie da się odpytać, dopóki tabele Delta nie zostaną zoptymalizowane (np. scalone w mniej plików). W Direct Lake on SQL model może przełączyć się w tryb DirectQuery, jeśli ta możliwość jest włączona. Przyczyny takiego przełączenia opisaliśmy w artykule Direct Lake przełącza się na DirectQuery - przyczyny trybu zapasowego.
Chcesz budować modele i raporty Power BI od podstaw, z DAX i publikacją w usłudze? Szkolenie Power BI - Desktop, DAX i Online + Copilot --> W programie jest Power Query, model danych z relacjami, miary DAX z Time Intelligence, wizualizacje i KPI oraz publikacja i udostępnianie raportów w usłudze Power BI. To szkolenie ma terminy gwarantowane.
Co chcemy osiągnąć. System kasowy Nordvelli co noc publikuje świeży eksport sprzedaz.csv pod stałym adresem internetowym. Chcemy, żeby Fabric codziennie o 6:00 sam pobrał plik do Files/surowe, a zaraz potem uruchomił notes, który przelicza warstwę srebrną i złotą. Zarząd otworzy raport o 8:00 i zobaczy dane z poprzedniego dnia, a nikt nie musi niczego klikać.
Data Factory w Fabric daje kilka narzędzi do przenoszenia danych. Warto wiedzieć, które do czego służy:
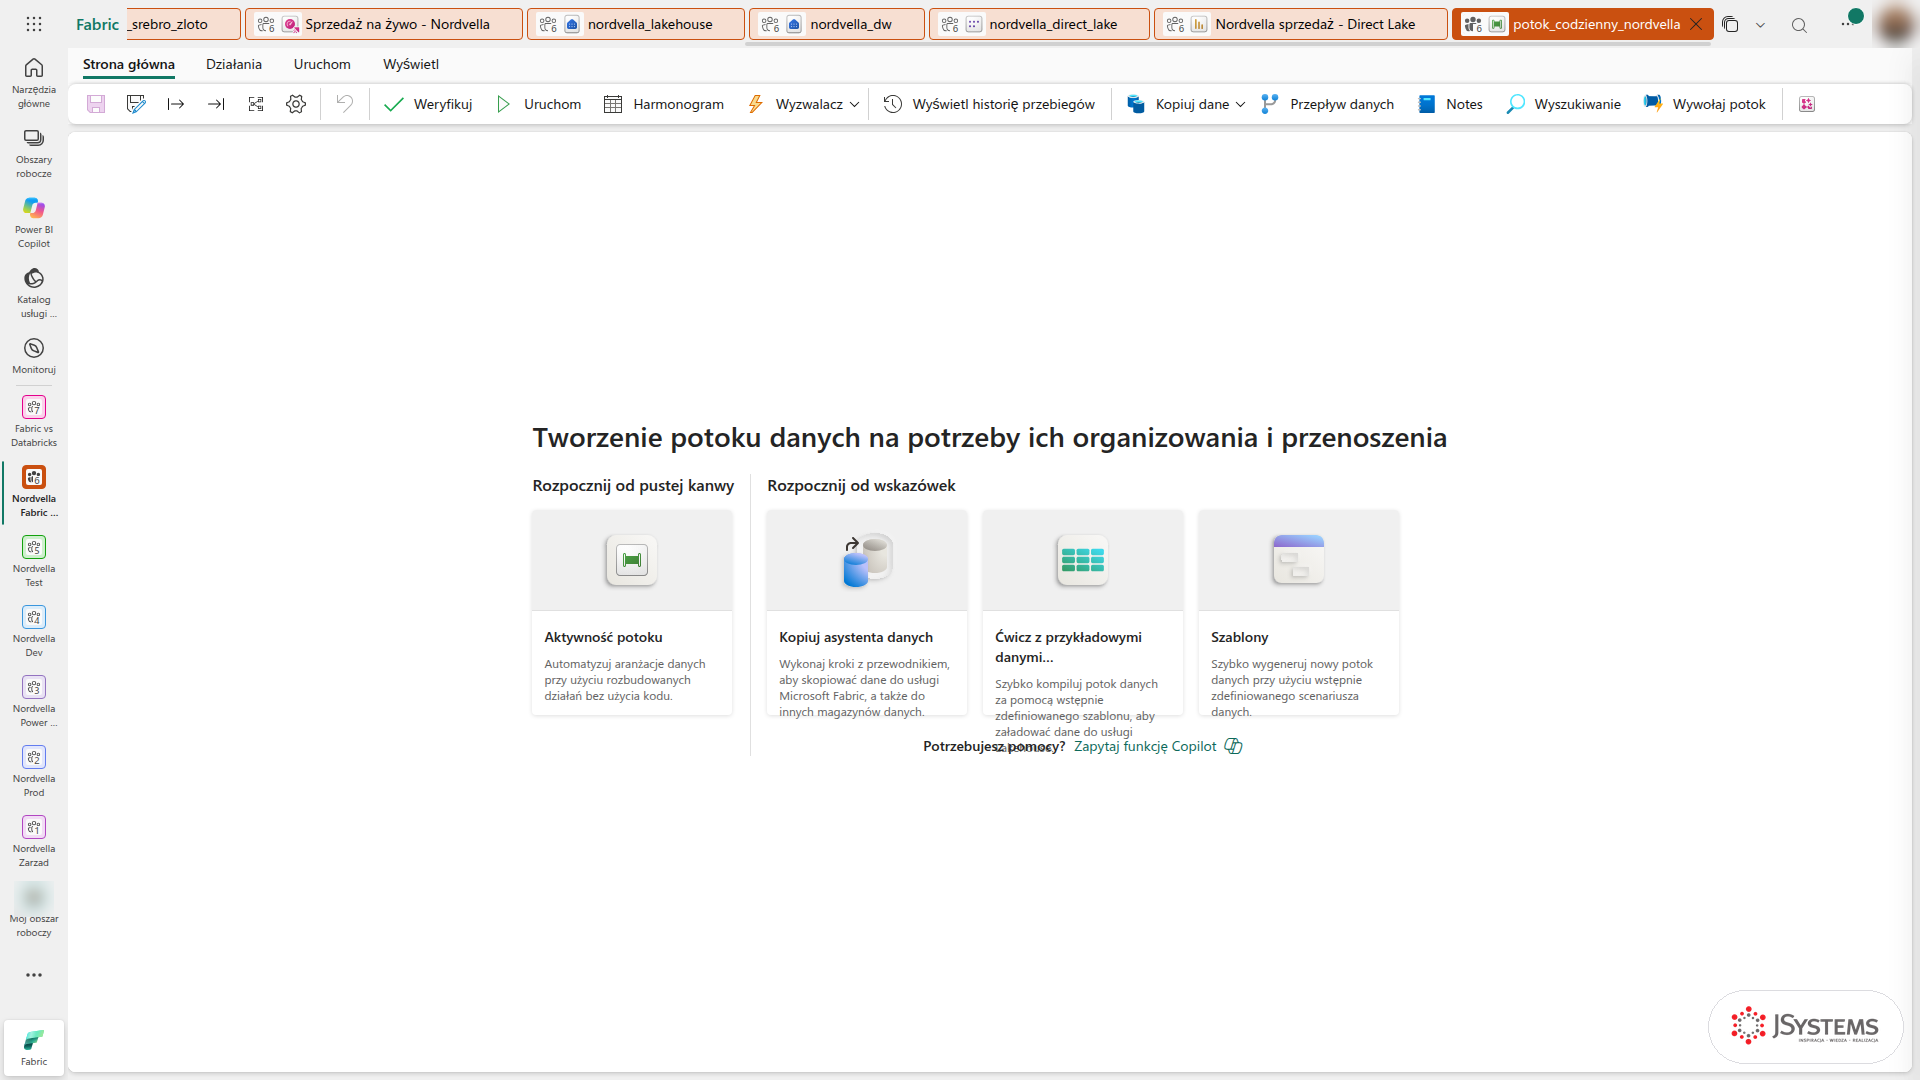
Nowy potok tworzysz w obszarze roboczym („Nowy element”, potem „Potok”). Ekran startowy proponuje pustą kanwę z działaniami albo asystenta kopiowania danych, przykładowe dane i szablony.
Asystent kopiowania prowadzi przez wybór źródła, połączenie, podgląd danych, metodę kopiowania, mapowanie i podsumowanie. Przy źródle HTTP tworzysz połączenie z adresem pliku i uwierzytelnianiem anonimowym, a podgląd od razu pokazuje kolumny pliku CSV.
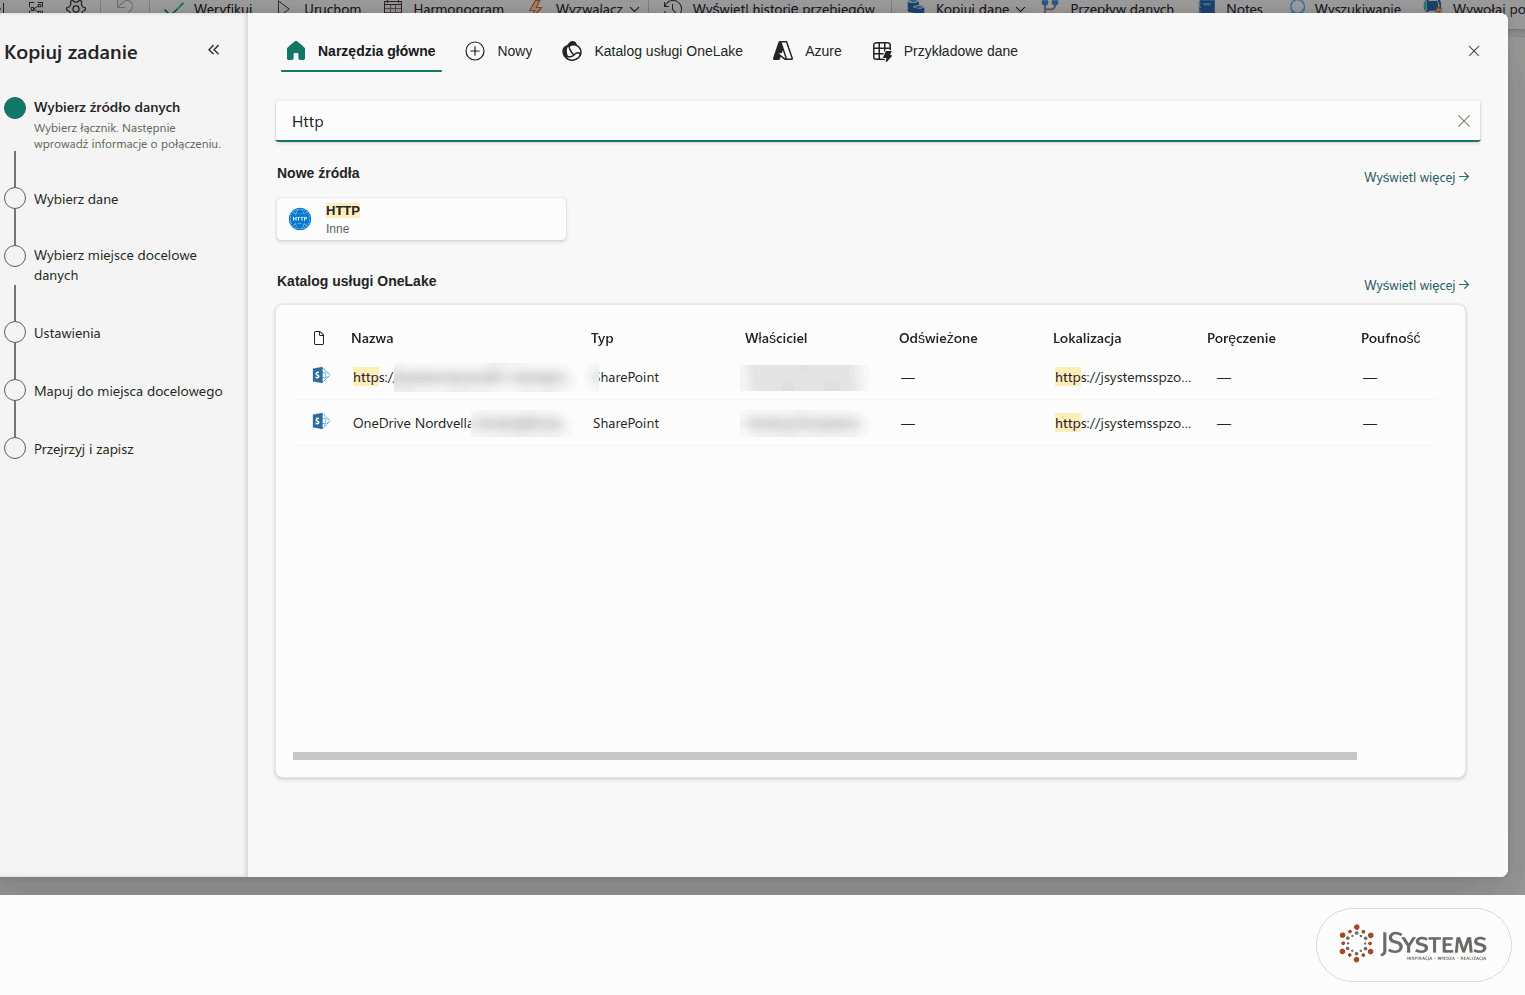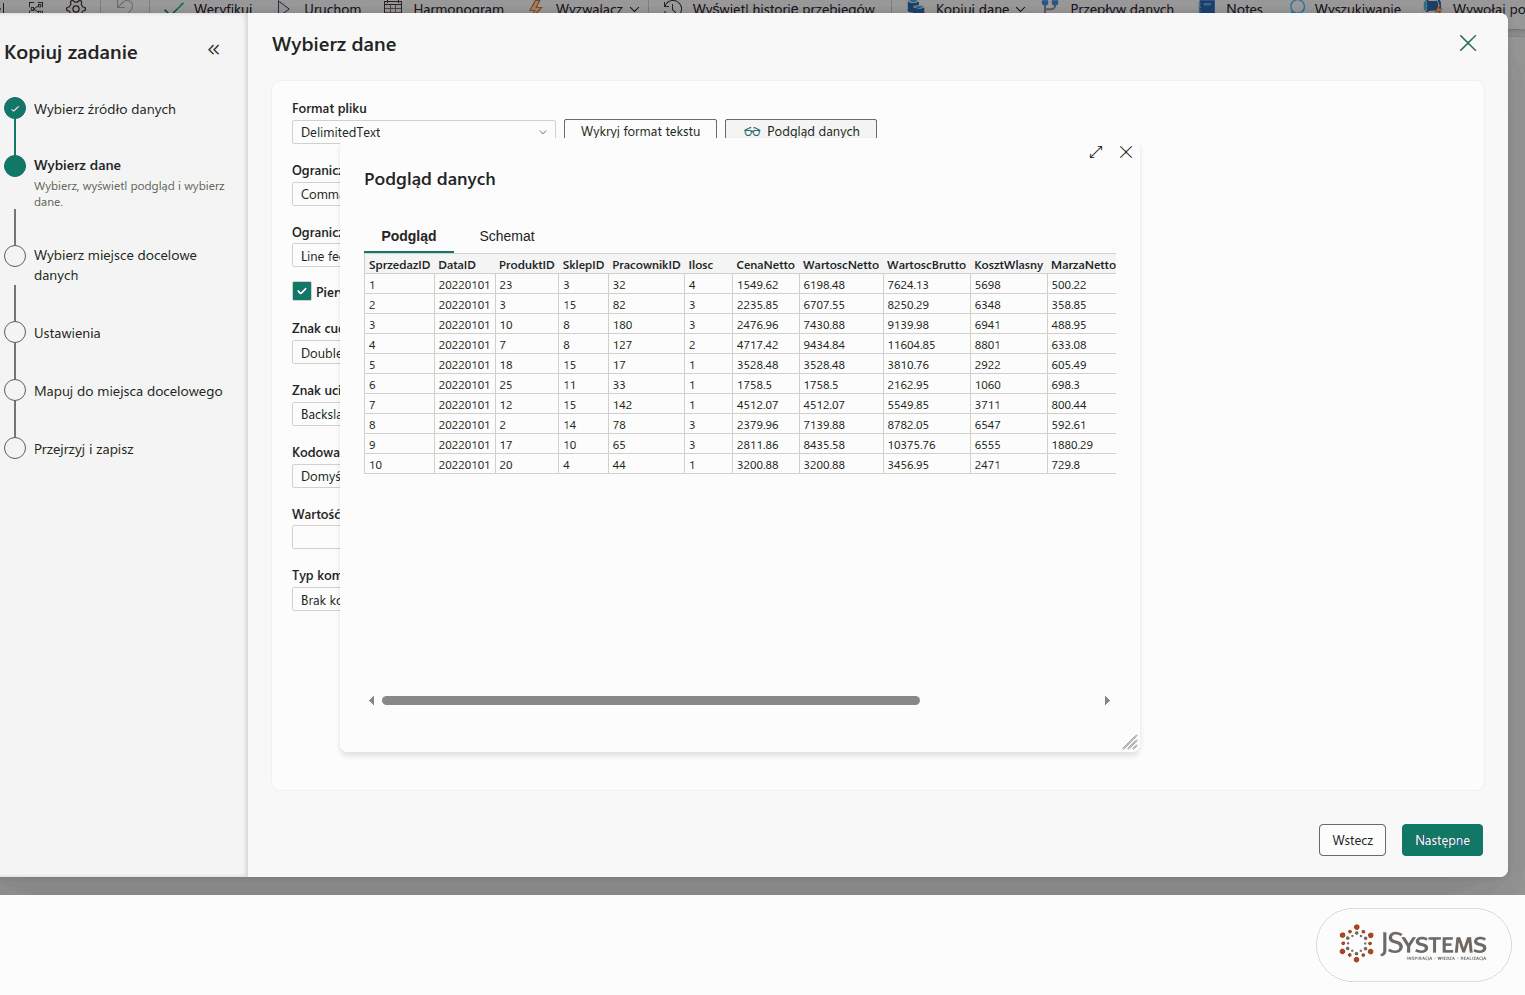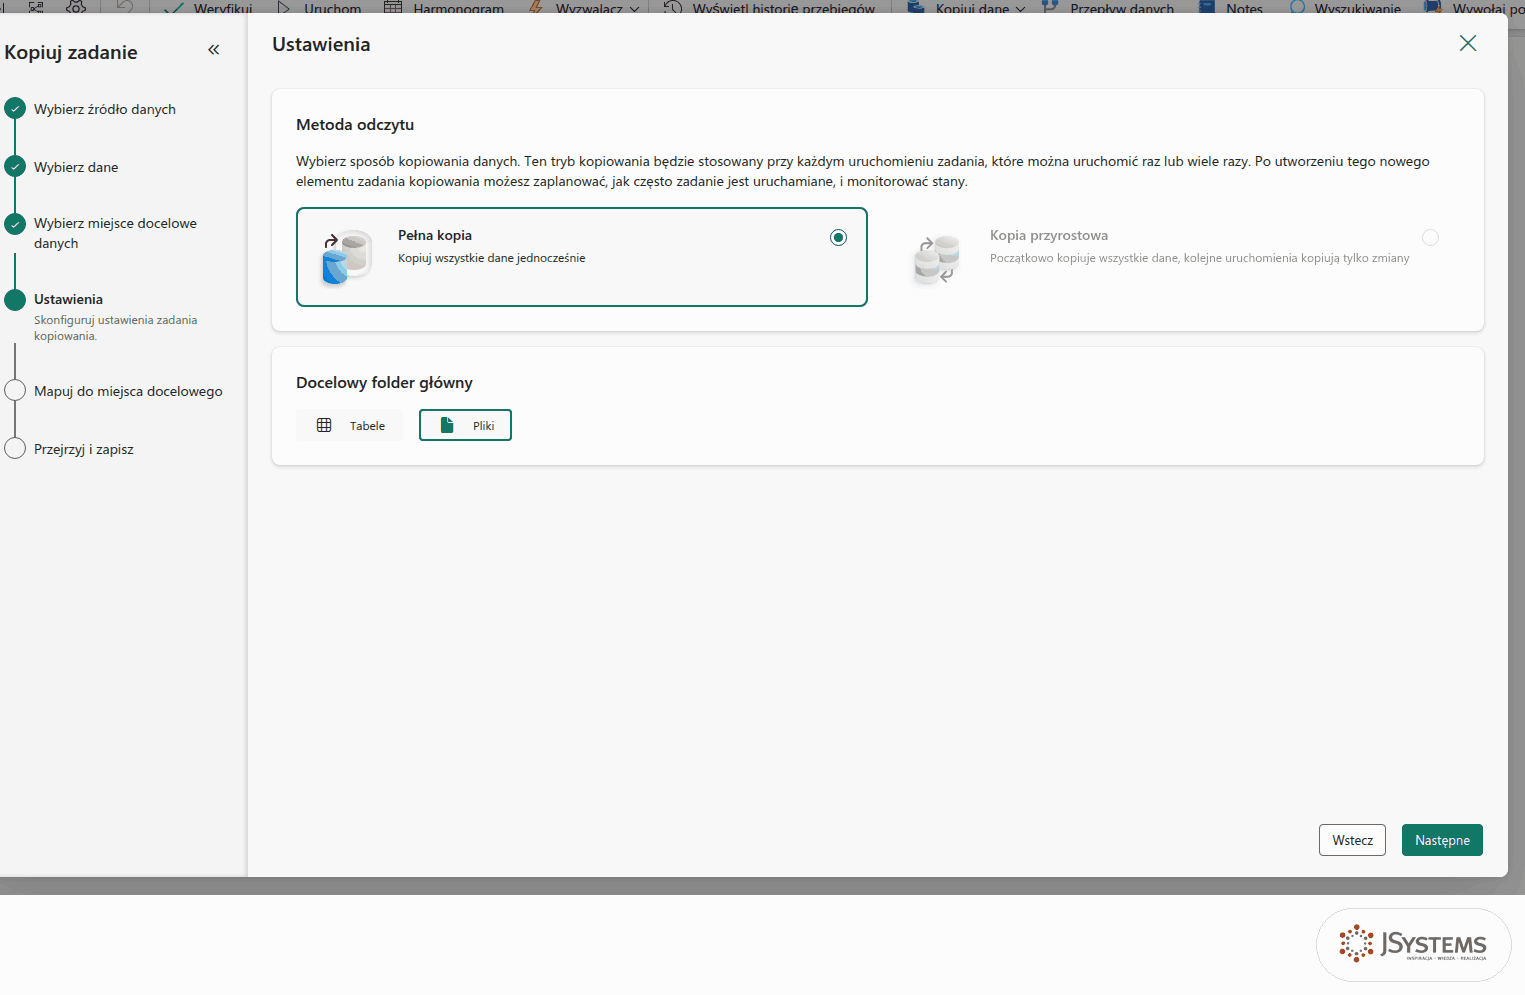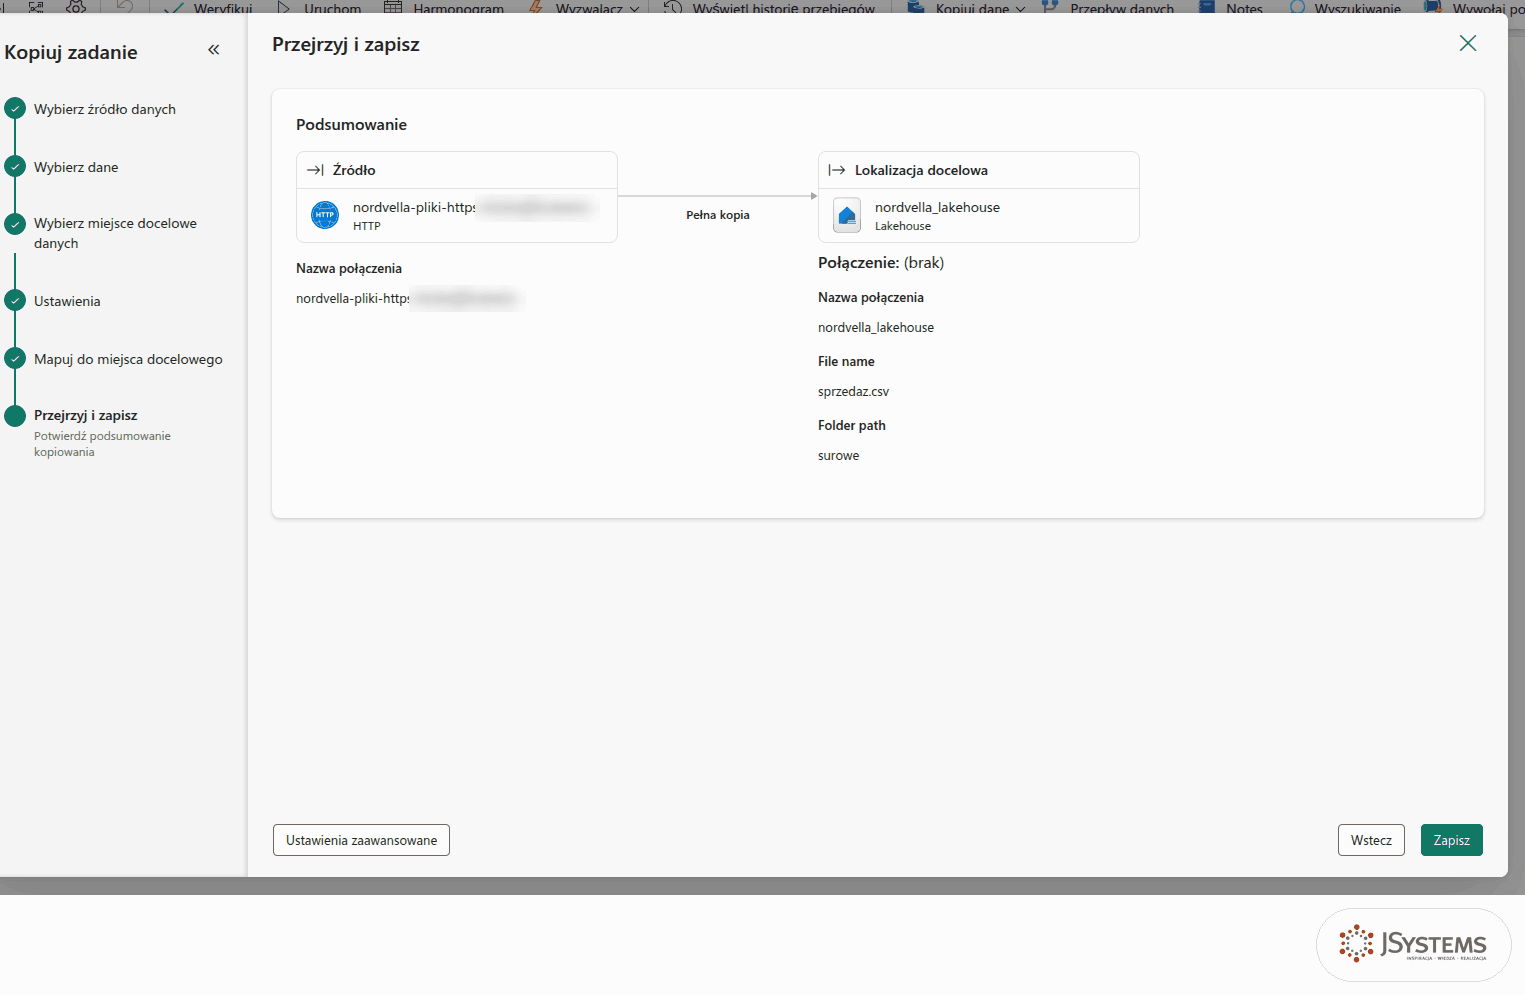
sprzedaz.csv, metoda kopiowania (pełna albo przyrostowa), mapowanie do lakehouse i ekran przeglądu.Działanie „Kopiuj dane” ustawiasz w dolnym panelu kanwy. Na zakładce „Źródło” wybierasz połączenie HTTP nordvella-pliki-https. Jego adres wskazuje wprost na plik (https://jsystems.pl/), więc pole „Względny adres URL” zostaje puste. Gdy połączenie wskazuje na folder z wieloma plikami, w tym polu wpisujesz nazwę pliku. Format pliku ustawiasz na Binary. Format binarny kopiuje plik bajt w bajt, bez parsowania kolumn, co przy surowej warstwie jest dokładnie tym, czego chcemy.
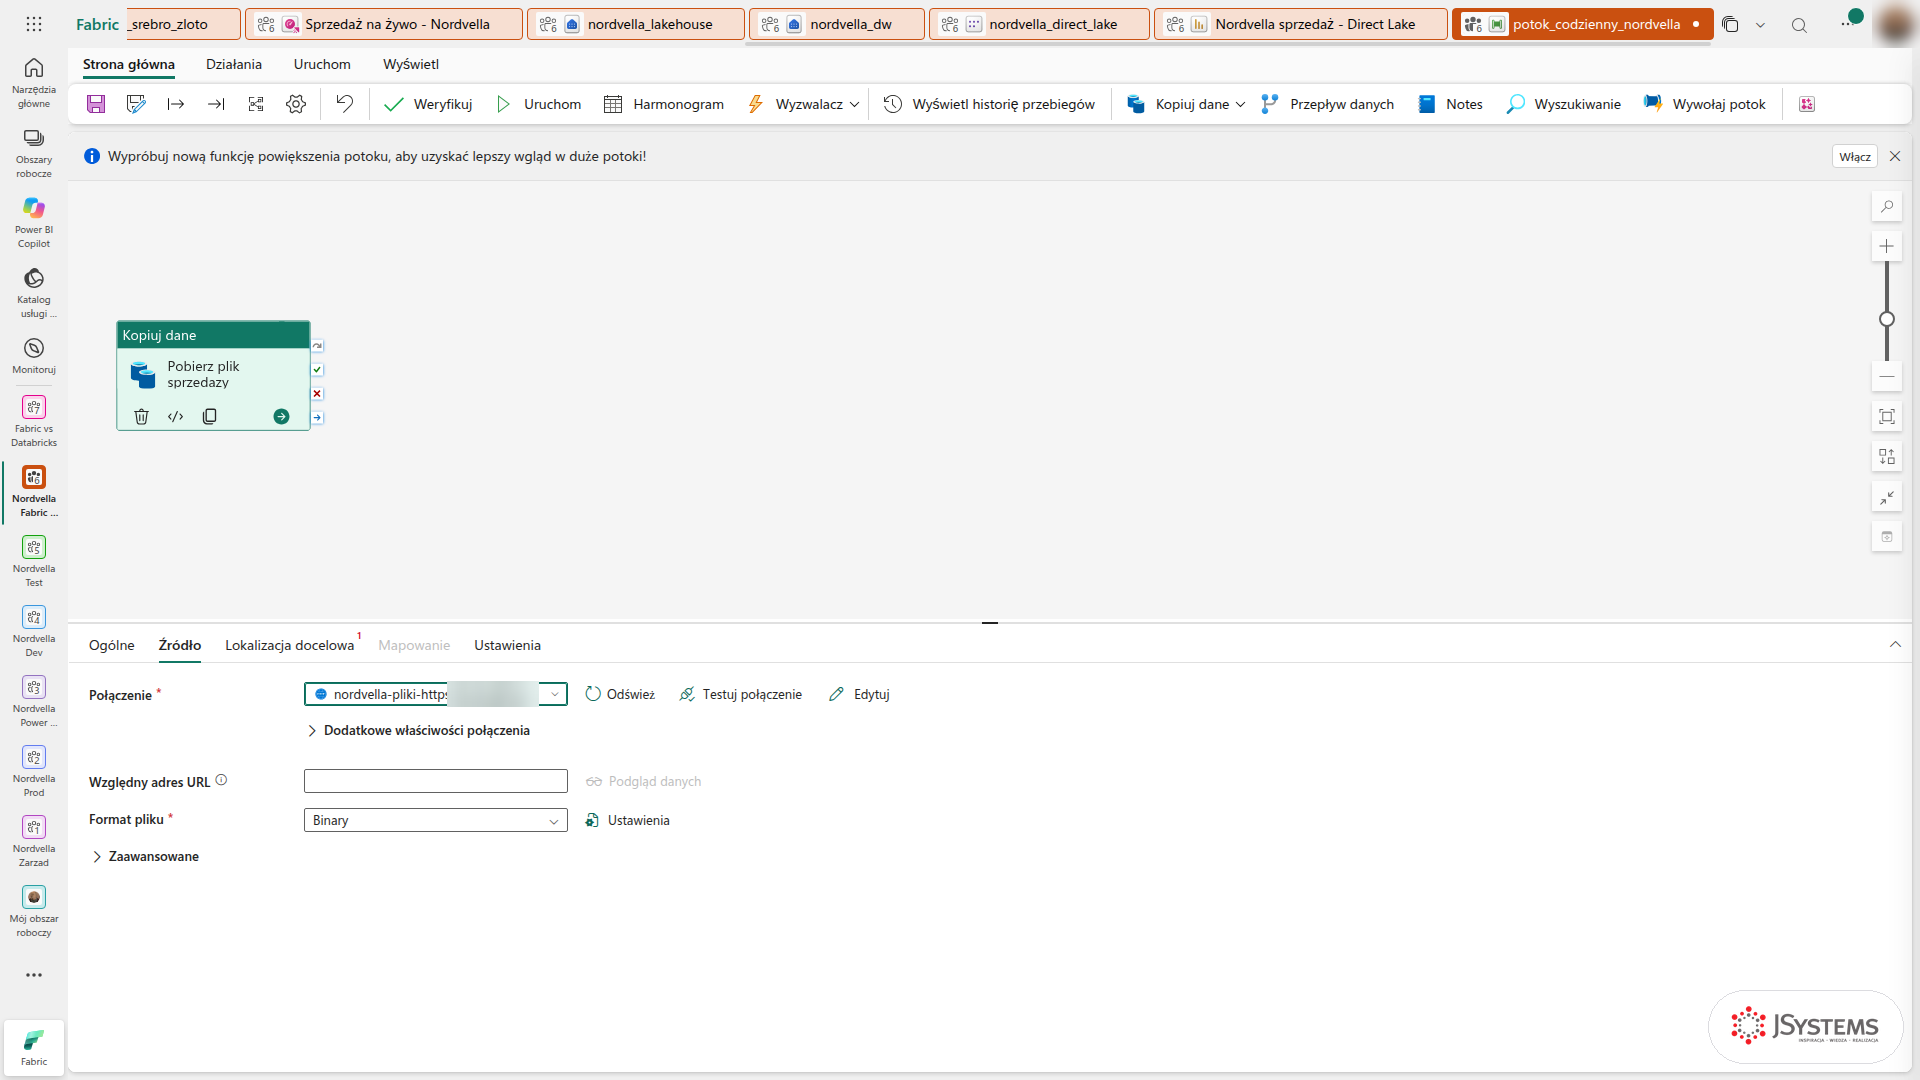
Na zakładce „Lokalizacja docelowa” wskazujesz lakehouse nordvella_lakehouse, folder główny „Pliki”, ścieżkę surowe i nazwę pliku sprzedaz.csv, również w formacie Binary. Każde uruchomienie nadpisze plik nowym eksportem.
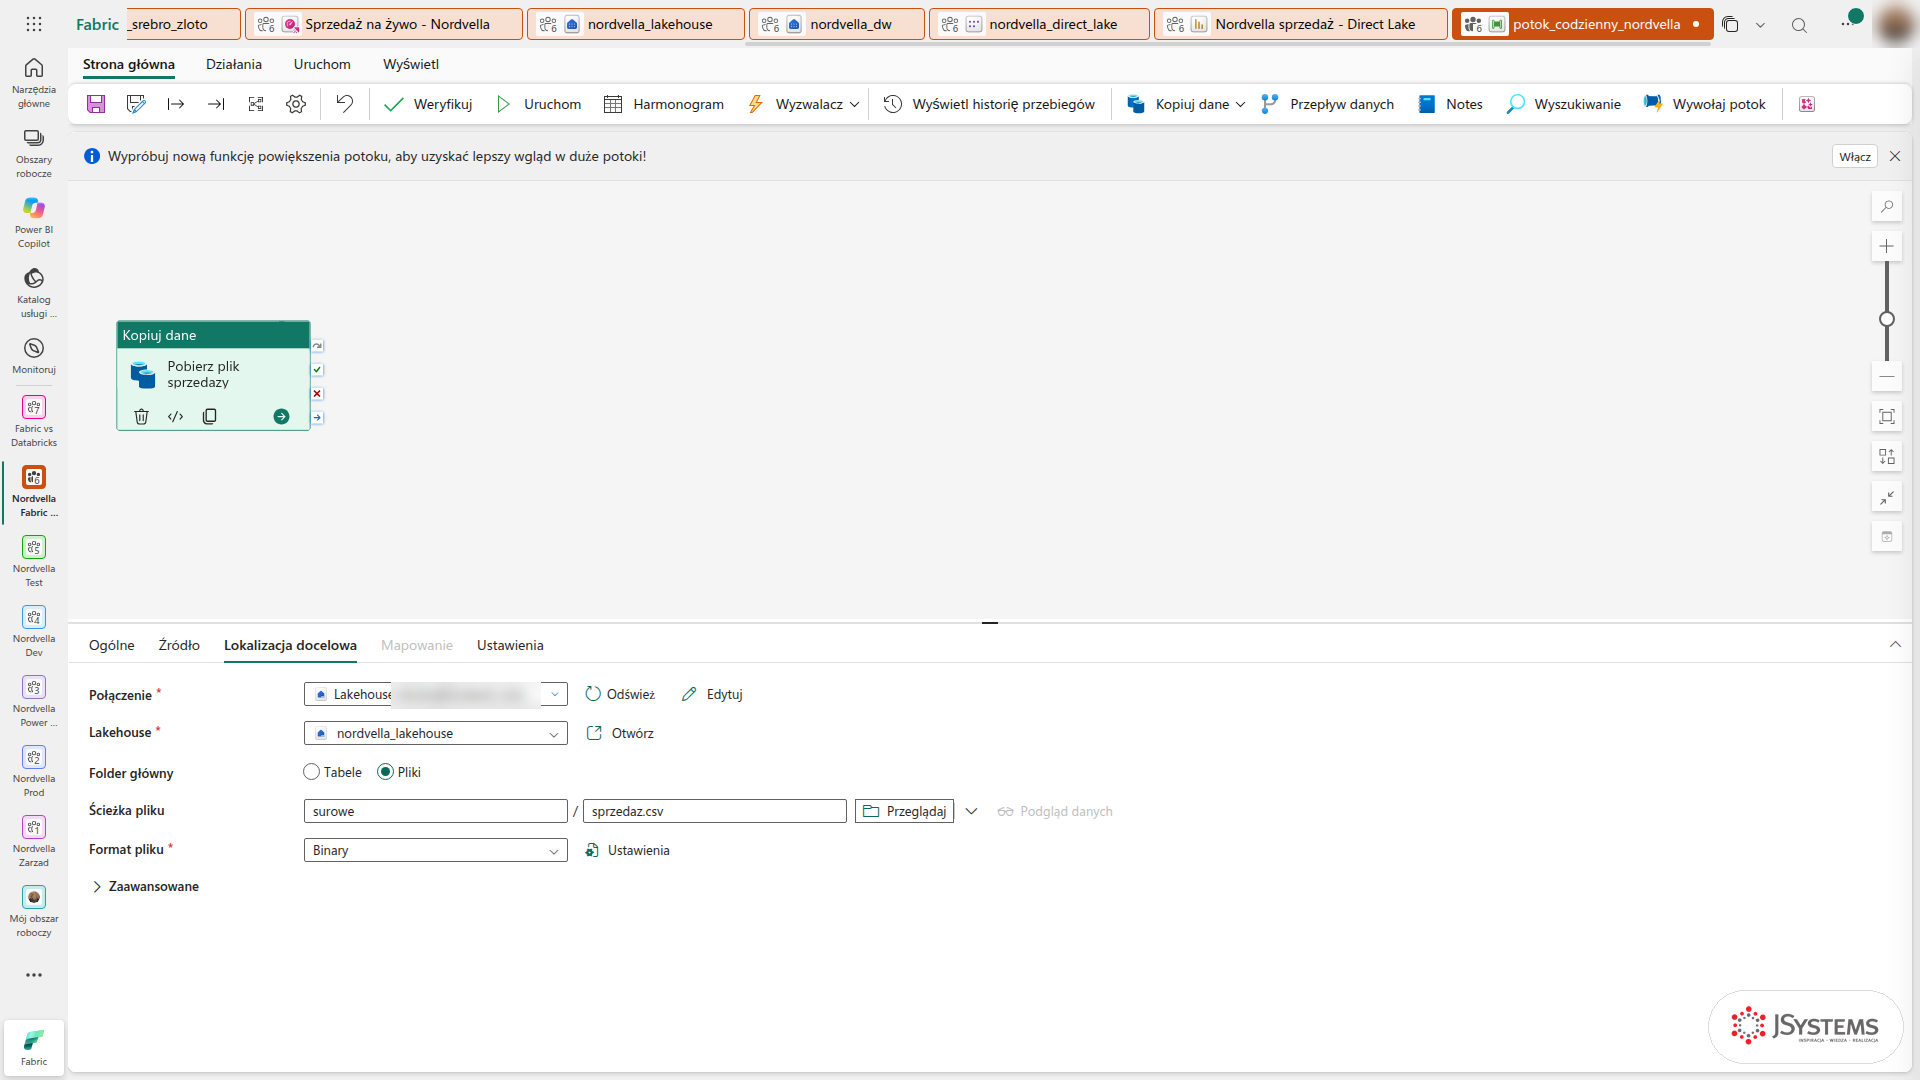
Teraz przeciągnij z paska działanie „Notes”, w jego ustawieniach wybierz notes nb_sprzedaz_srebro_zloto i nazwij je „Przelicz srebro i zloto” (nazwy działań wpisaliśmy bez polskich znaków, tak jak na zrzutach). Połącz zielony uchwyt „Po powodzeniu” działania kopiowania z notesem. Dzięki temu notes ruszy tylko wtedy, gdy plik dotarł, a przy błędzie pobierania tabele zostaną w stanie z poprzedniego dnia.
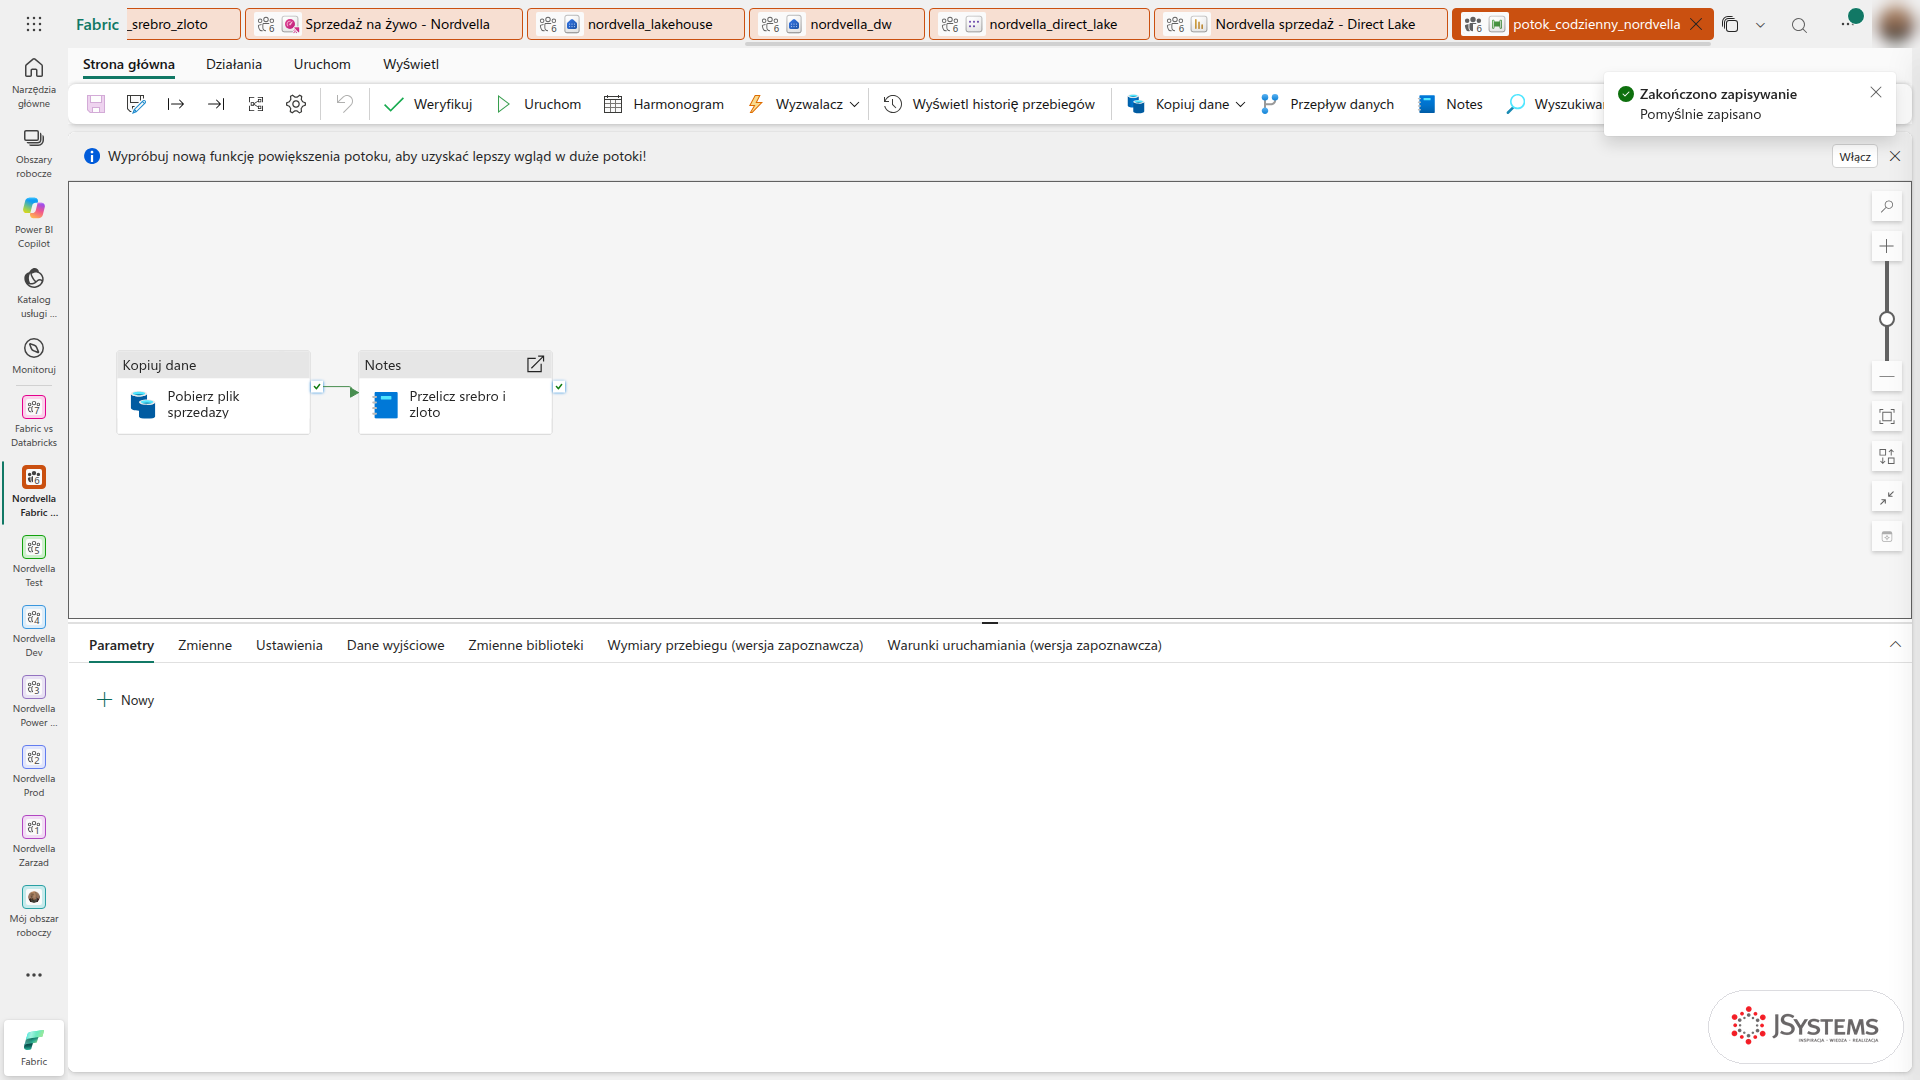
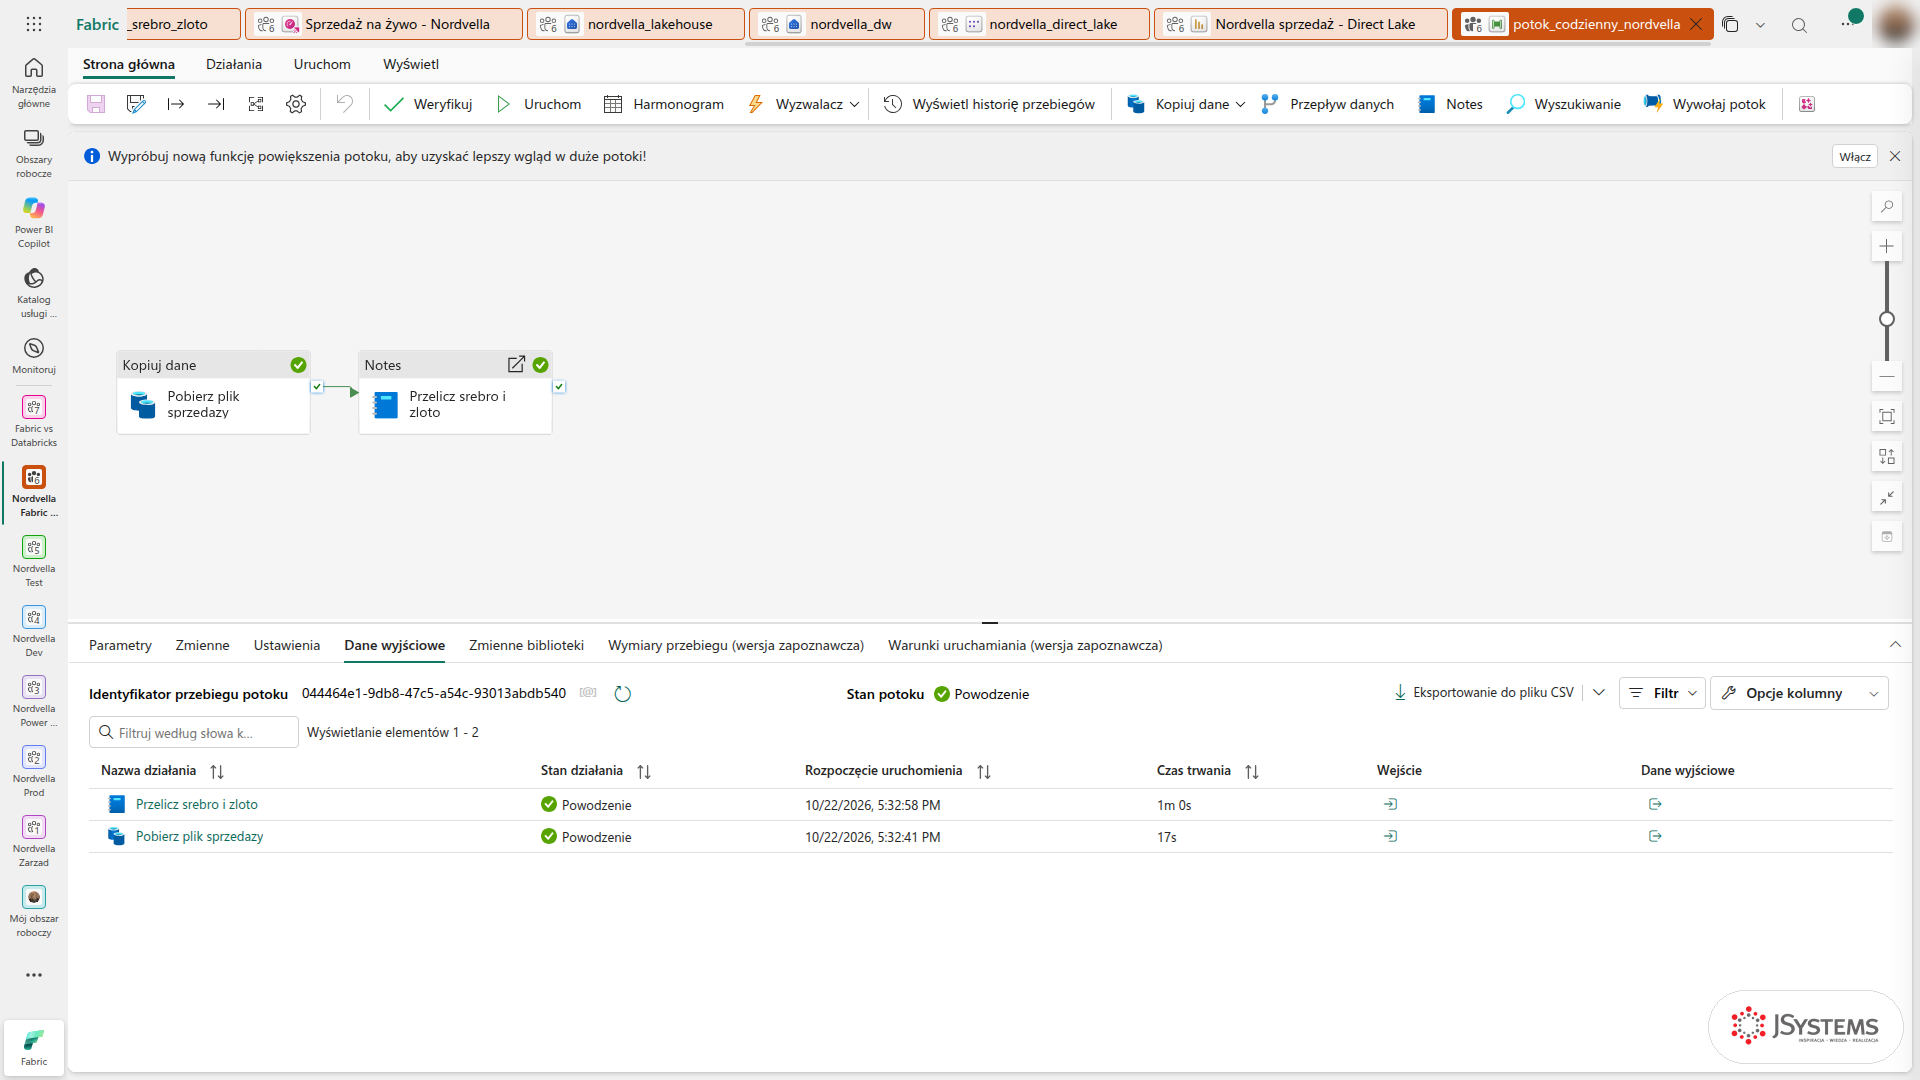
Kliknij „Zapisz”, a potem „Uruchom”. Przebieg widać w zakładce „Dane wyjściowe” pod kanwą: u nas kopiowanie pliku trwało 17 sekund, a przeliczenie w notesie minutę.
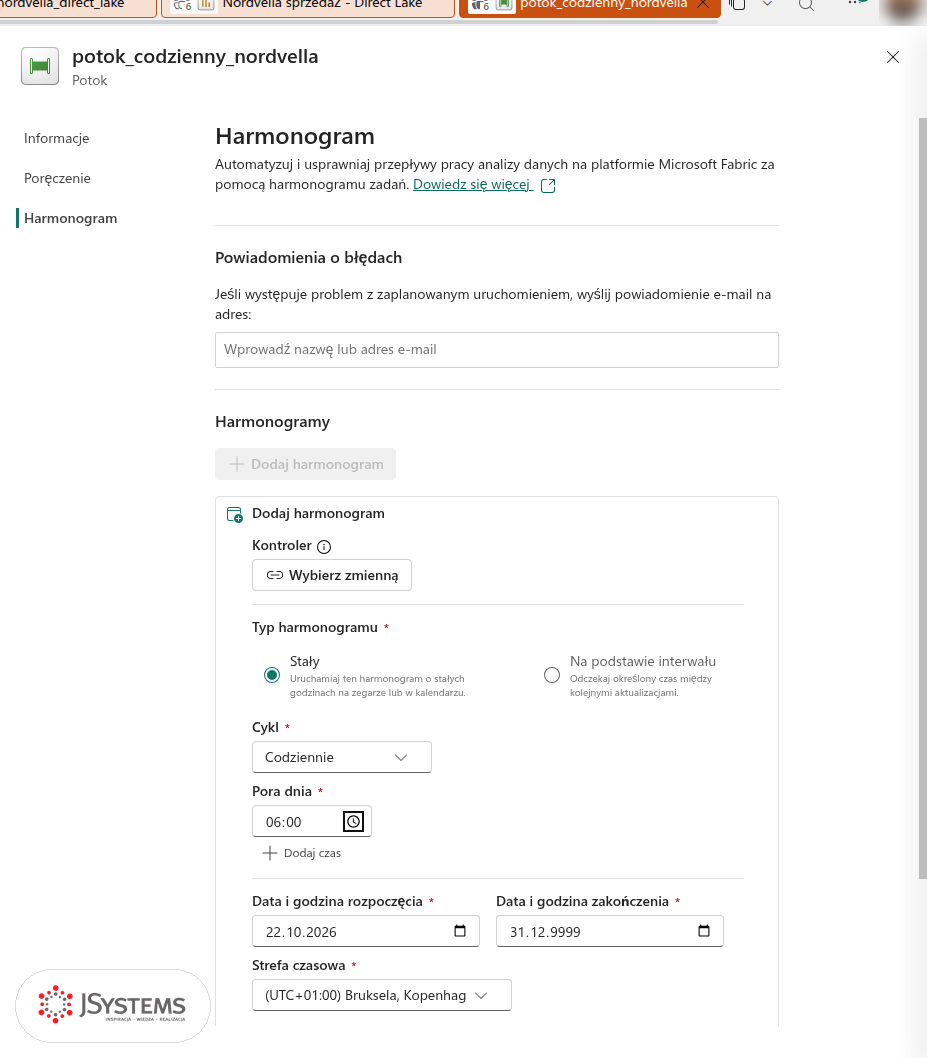
Na pasku potoku kliknij „Harmonogram”, dodaj harmonogram o typie stałym, ustaw cykl „Codziennie”, porę dnia 06:00, datę rozpoczęcia i strefę czasową. Dla polskich godzin wybierz strefę UTC+01:00, w której leży Warszawa (na naszym zrzucie wybrana jest strefa z Brukselą i Paryżem, która ma te same godziny co Polska). W polu powiadomień o błędach możesz wpisać adres osoby, która ma dostać maila, gdy zaplanowany przebieg się nie uda. Na koniec zapisz harmonogram.
Potok w Fabric może też odświeżać model semantyczny (działanie odświeżania modelu), wysyłać wiadomość w Teams albo mailem i reagować na zdarzenia, np. pojawienie się pliku w OneLake. Dla źródeł w sieci firmowej, takich jak SQL Server w serwerowni, potrzebna jest brama danych lokalnych, którą opisaliśmy w lekcji Brama danych i harmonogram odświeżania kursu Power BI.
Co chcemy osiągnąć. Raport z poprzednich części pokazuje dane z wczoraj. Kierownik operacyjny Nordvelli chce widzieć sprzedaż z kas na bieżąco, z podziałem na miasta, i dostawać powiadomienie o każdej transakcji powyżej 25 000 zł, bo takie zakupy warto od razu zweryfikować. Kasy wyślą transakcje do Eventstream, ten zapisze je w Eventhouse, a na danych zbudujemy zapytania KQL, pulpit odświeżany na żywo i regułę alertu w Aktywatorze.
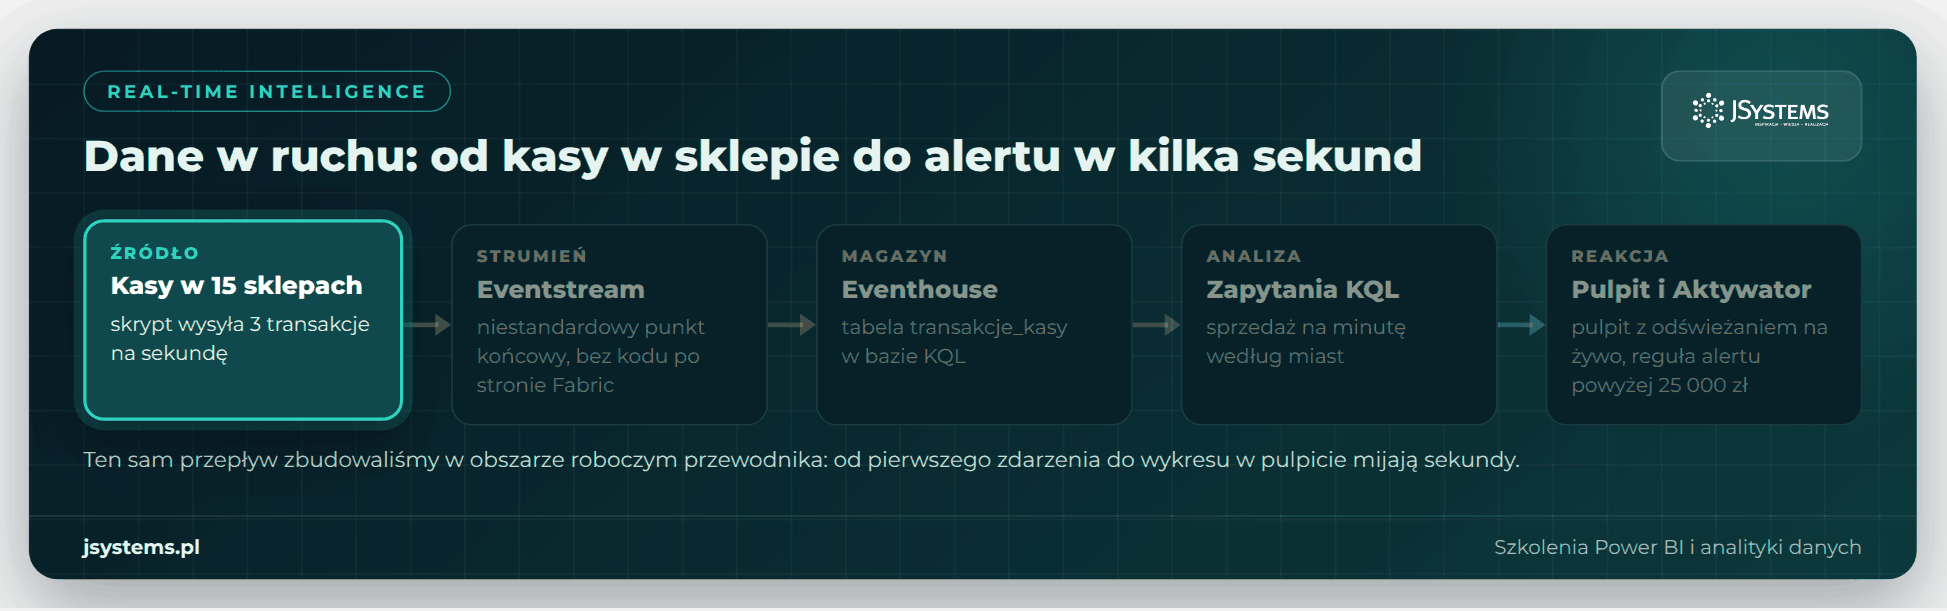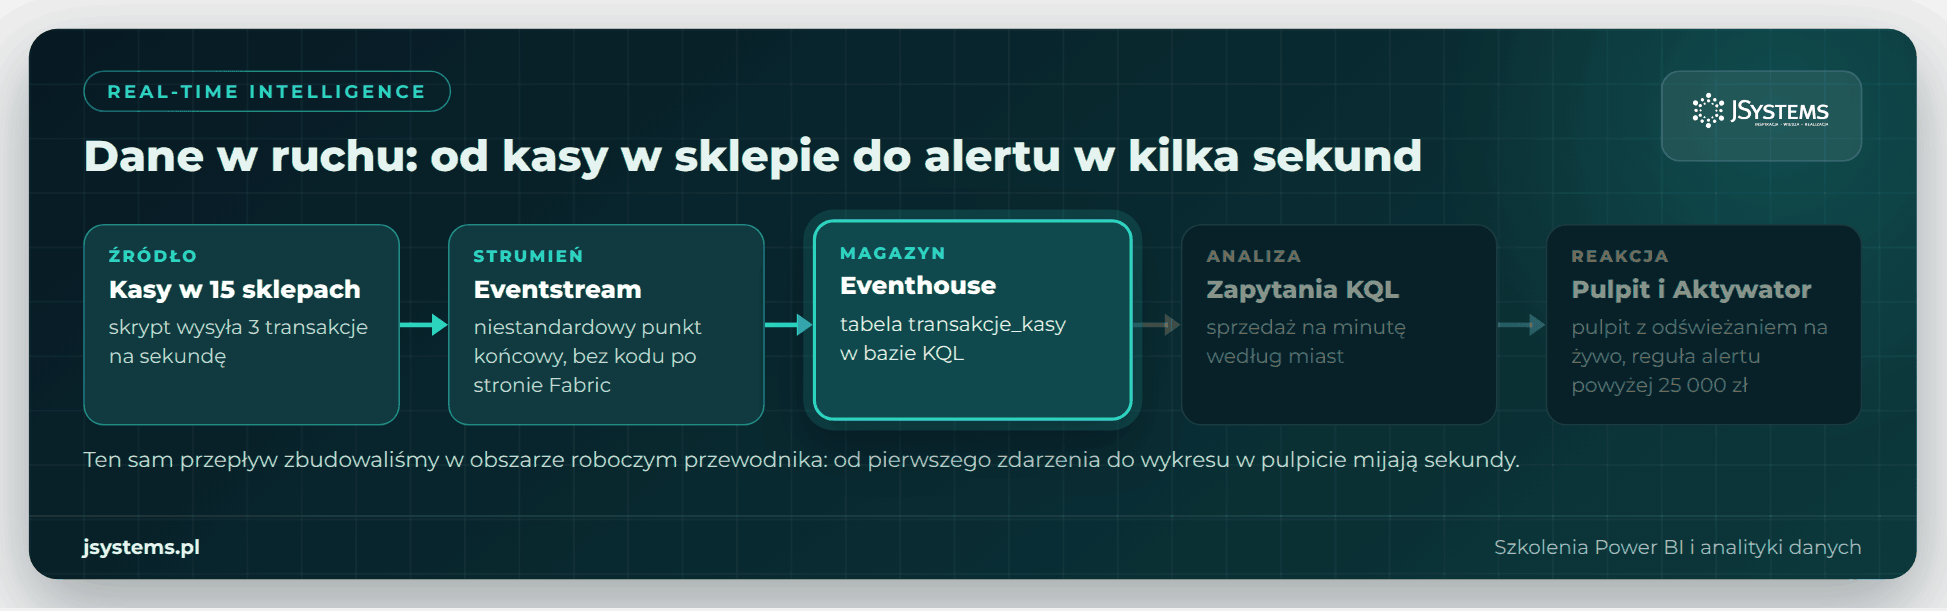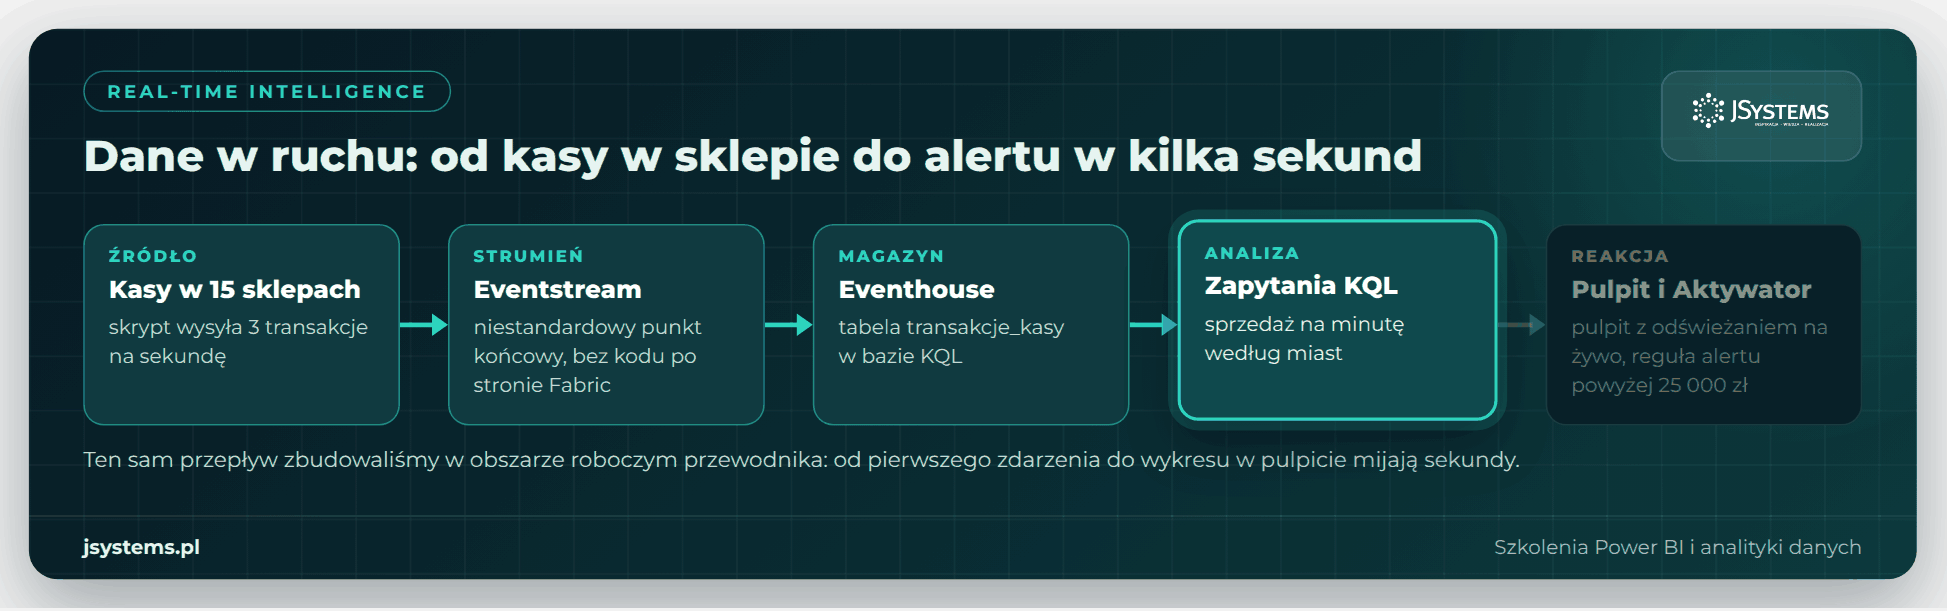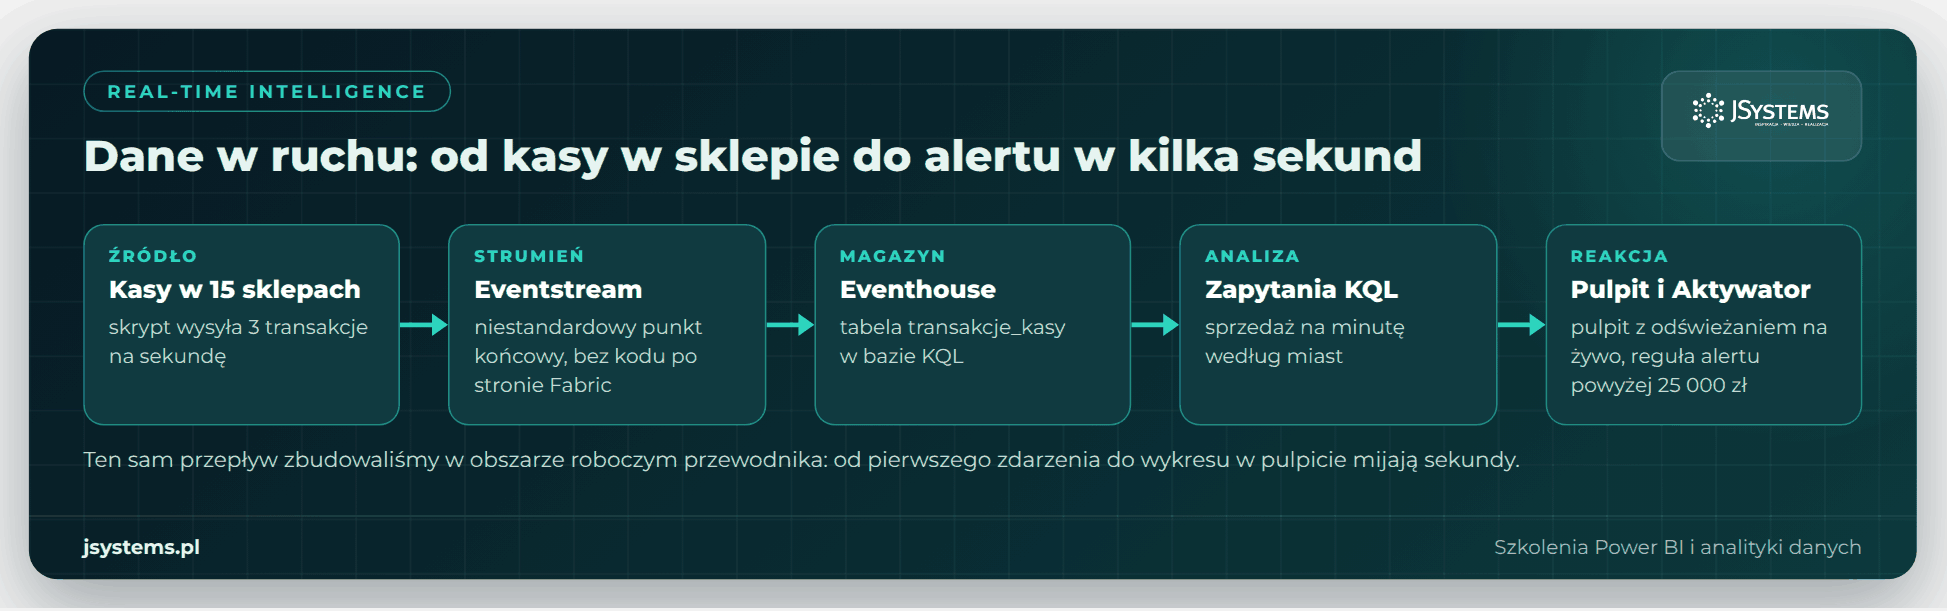
Real-Time Intelligence to obciążenie Fabric do danych, które napływają bez przerwy: transakcji, logów aplikacji, odczytów z czujników, kliknięć na stronie. Składa się z kilku elementów. Eventstream przyjmuje zdarzenia i kieruje je dalej, Eventhouse (w polskim interfejsie „Dom wydarzeń”) przechowuje je w bazach KQL zoptymalizowanych pod szeregi czasowe, KQL (Kusto Query Language) służy do zapytań, pulpit czasu rzeczywistego pokazuje wyniki na żywo, a Aktywator (Activator) reaguje na warunki w danych.
nordvella_zdarzenia. Fabric utworzy eventhouse i w nim bazę KQL o tej samej nazwie.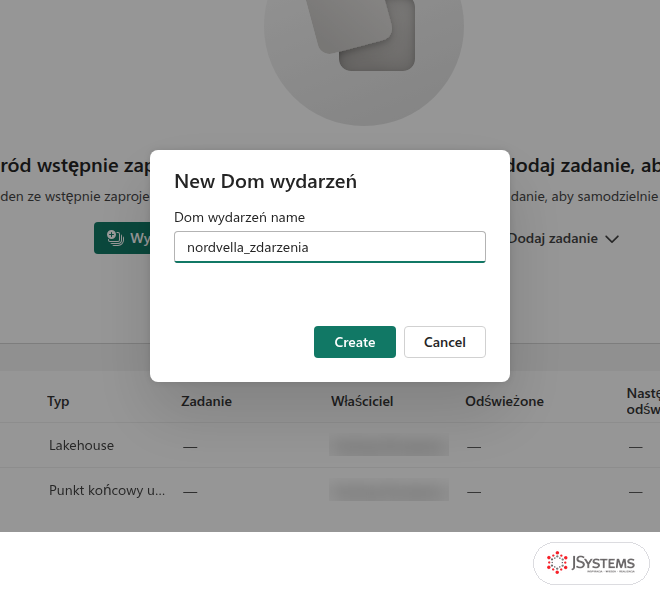
.create table transakcje_kasy (
    Czas: datetime,
    SklepID: int,
    Miasto: string,
    Region: string,
    Kanal: string,
    Produkt: string,
    Kategoria: string,
    Ilosc: int,
    WartoscBrutto: real,
    FormaPlatnosci: string
)
Tabelę tworzymy sami, zanim podłączymy strumień, bo wtedy dokładnie kontrolujemy typy kolumn. Kreator miejsca docelowego w Eventstream potrafi też utworzyć tabelę, ale przy naszej konfiguracji ta opcja nie zadziałała, a wybranie gotowej tabeli z listy zadziałało od razu.
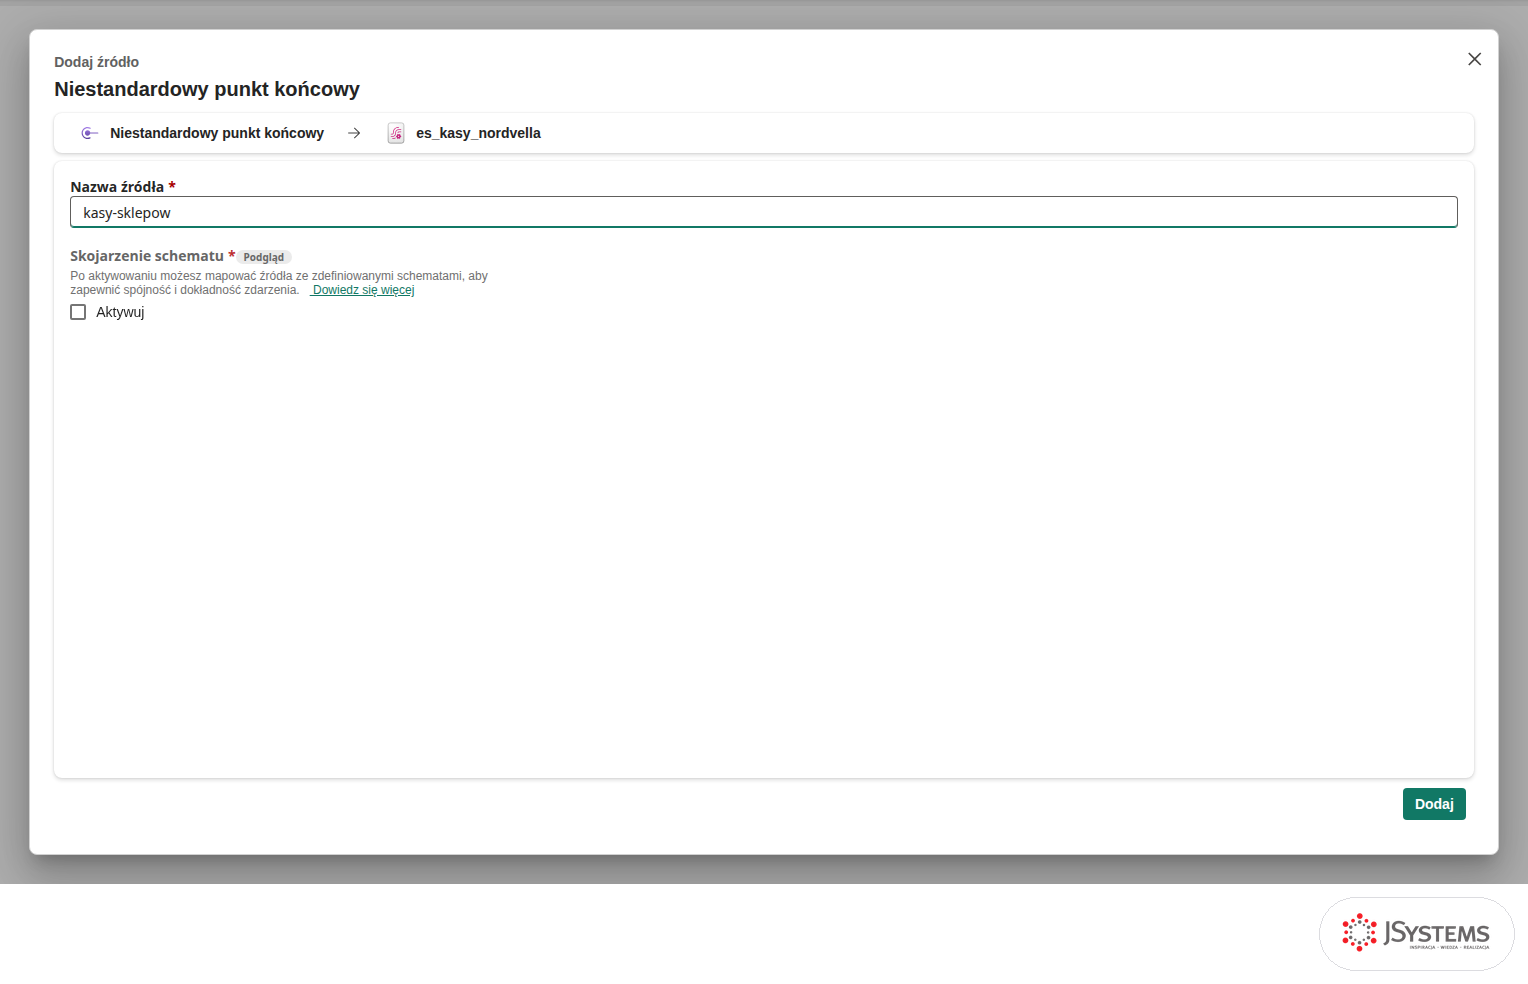
es_kasy_nordvella. Pole schematów w wersji zapoznawczej zostaw niezaznaczone.kasy-sklepow i kliknij „Dodaj”.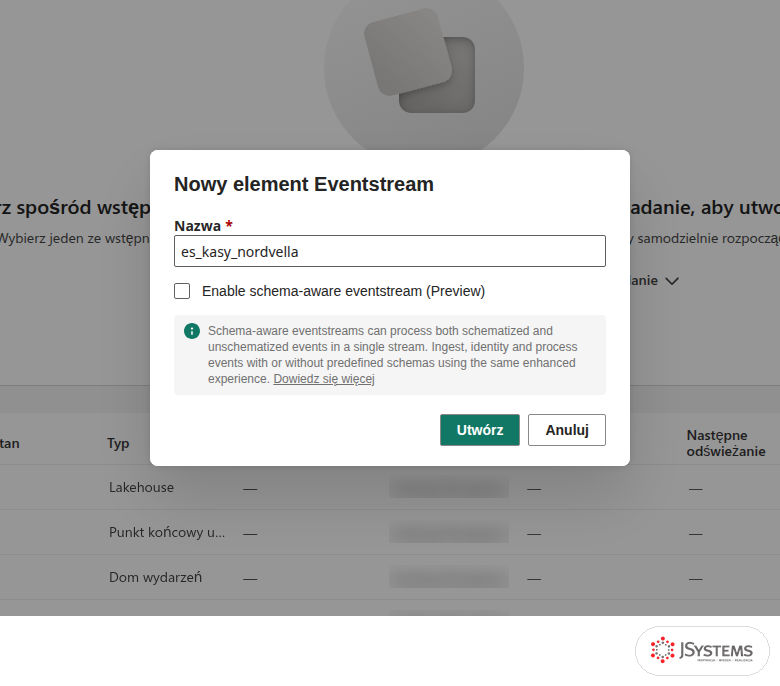
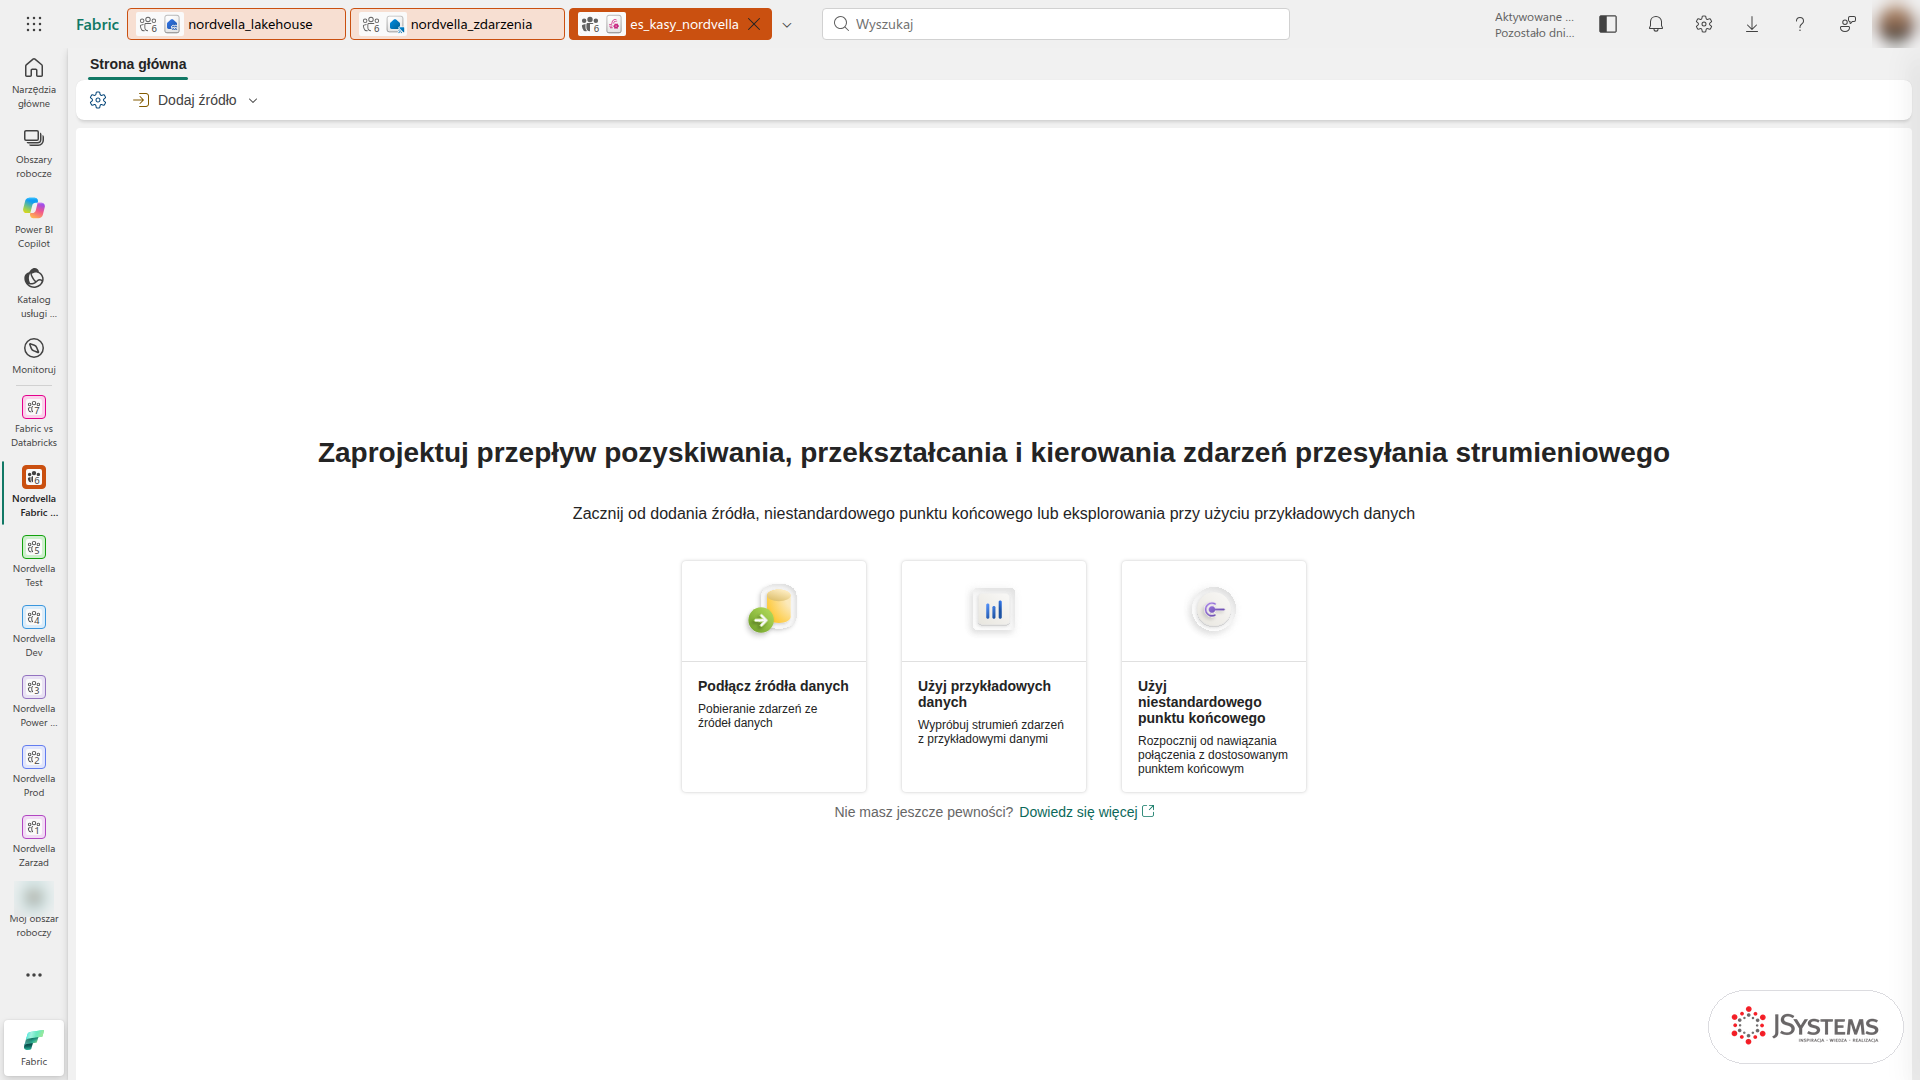
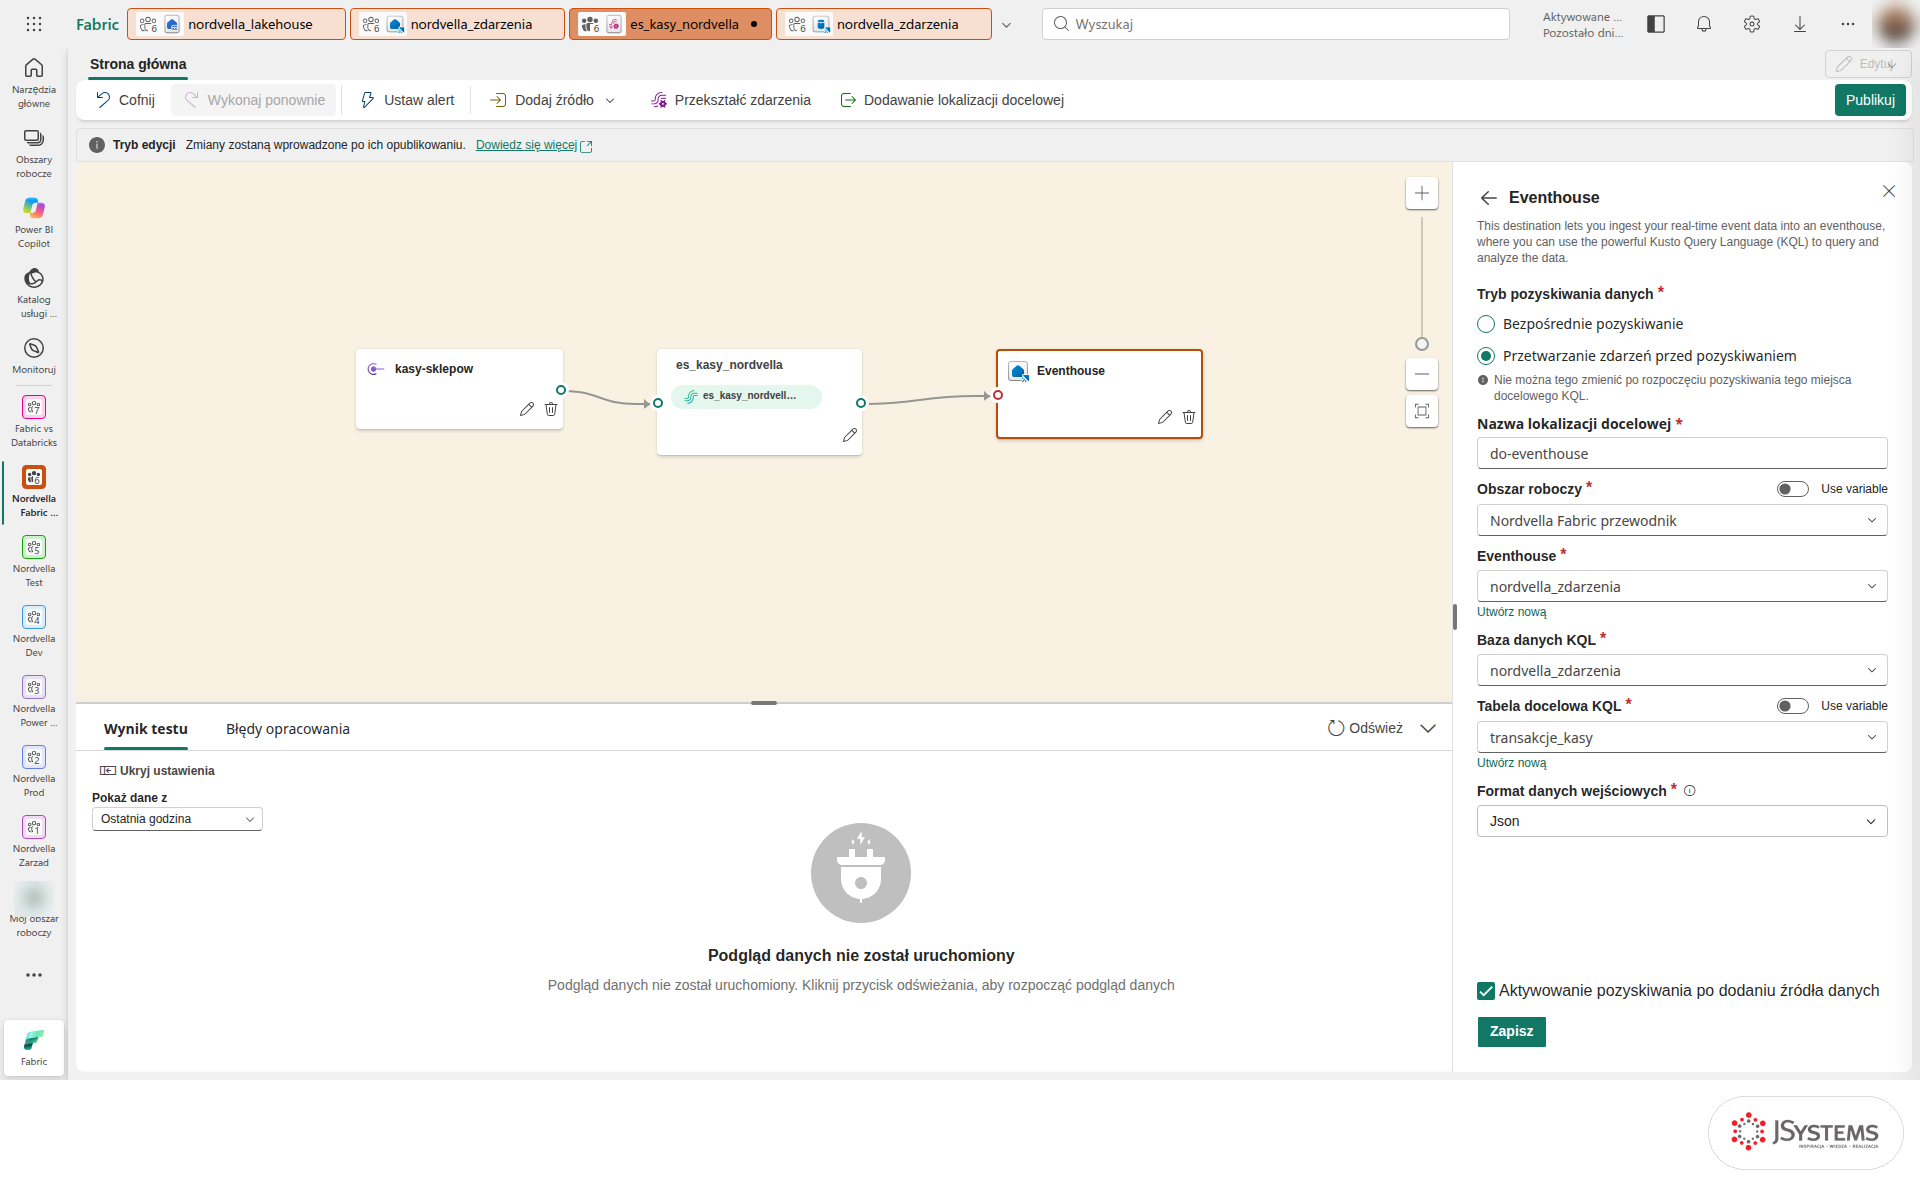
Na kanwie Eventstream kliknij „Dodaj miejsce docelowe”. Do wyboru są m.in. Aktywator, Eventhouse, Lakehouse, niestandardowy punkt końcowy i notes Sparka ze strumieniowaniem strukturalnym. Wybierz Eventhouse i ustaw:
do-eventhouse, obszar roboczy, eventhouse i bazę KQL nordvella_zdarzenia,transakcje_kasy i format danych wejściowych Json,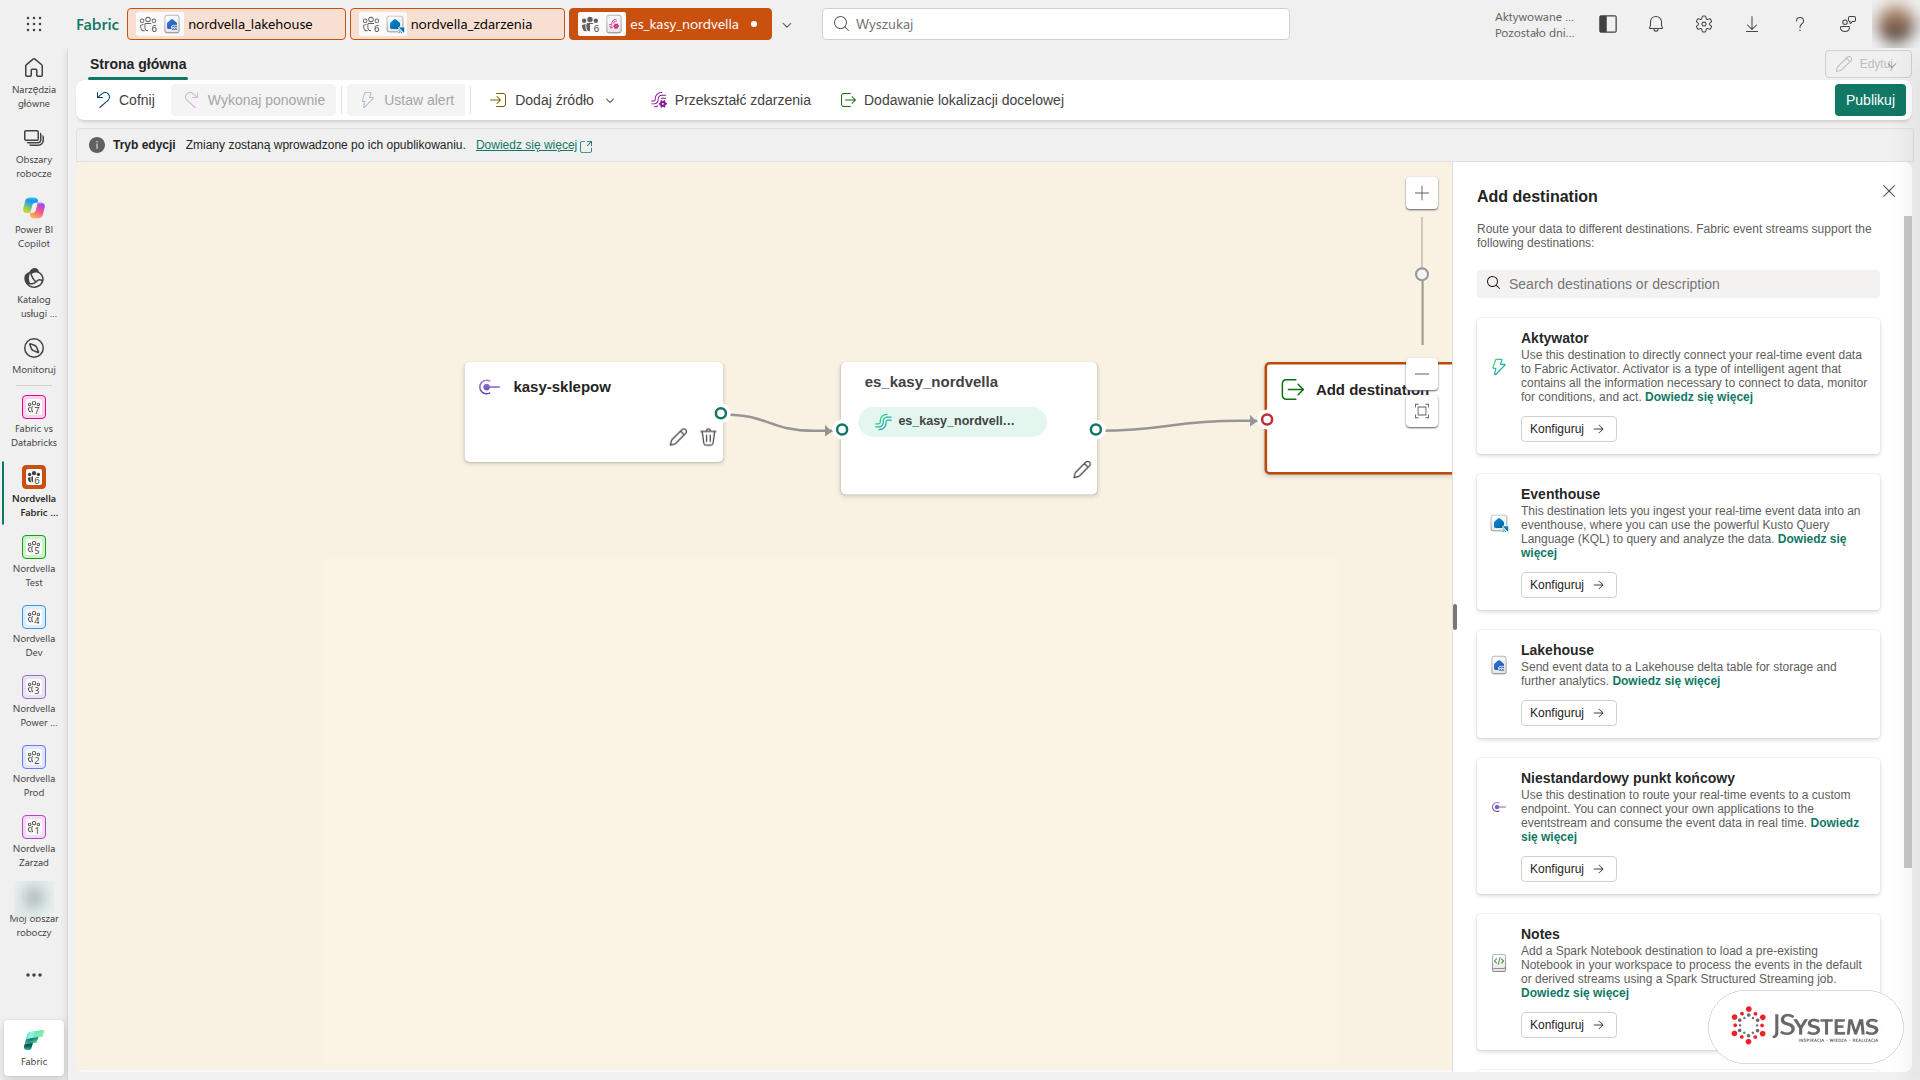
Zamiast prawdziwych kas użyjemy skryptu wyslij_. Co sekundę wysyła kilka transakcji z losowych sklepów Nordvelli (sklepy typu Flagship sprzedają mniej więcej trzy razy więcej), a mniej więcej w połowie przebiegu przez kilka minut kieruje większość ruchu do sklepu Warszawa Centrum, żeby było na czym przetestować alert. Skrypt potrzebuje plików sklepy.csv i produkty.csv w tym samym katalogu.
pip install azure-eventhub
export FABRIC_ES_CONN="Endpoint=sb://...;SharedAccessKeyName=...;SharedAccessKey=...;EntityPath=..."
python wyslij_transakcje.py --minutes 15 --per-second 3
Pobierz wyslij_transakcje.py W systemie Windows zamiast export użyj w PowerShellu $env:FABRIC_ES_CONN = "...". Parametry połączenia wklejasz w całości, razem z EntityPath na końcu.
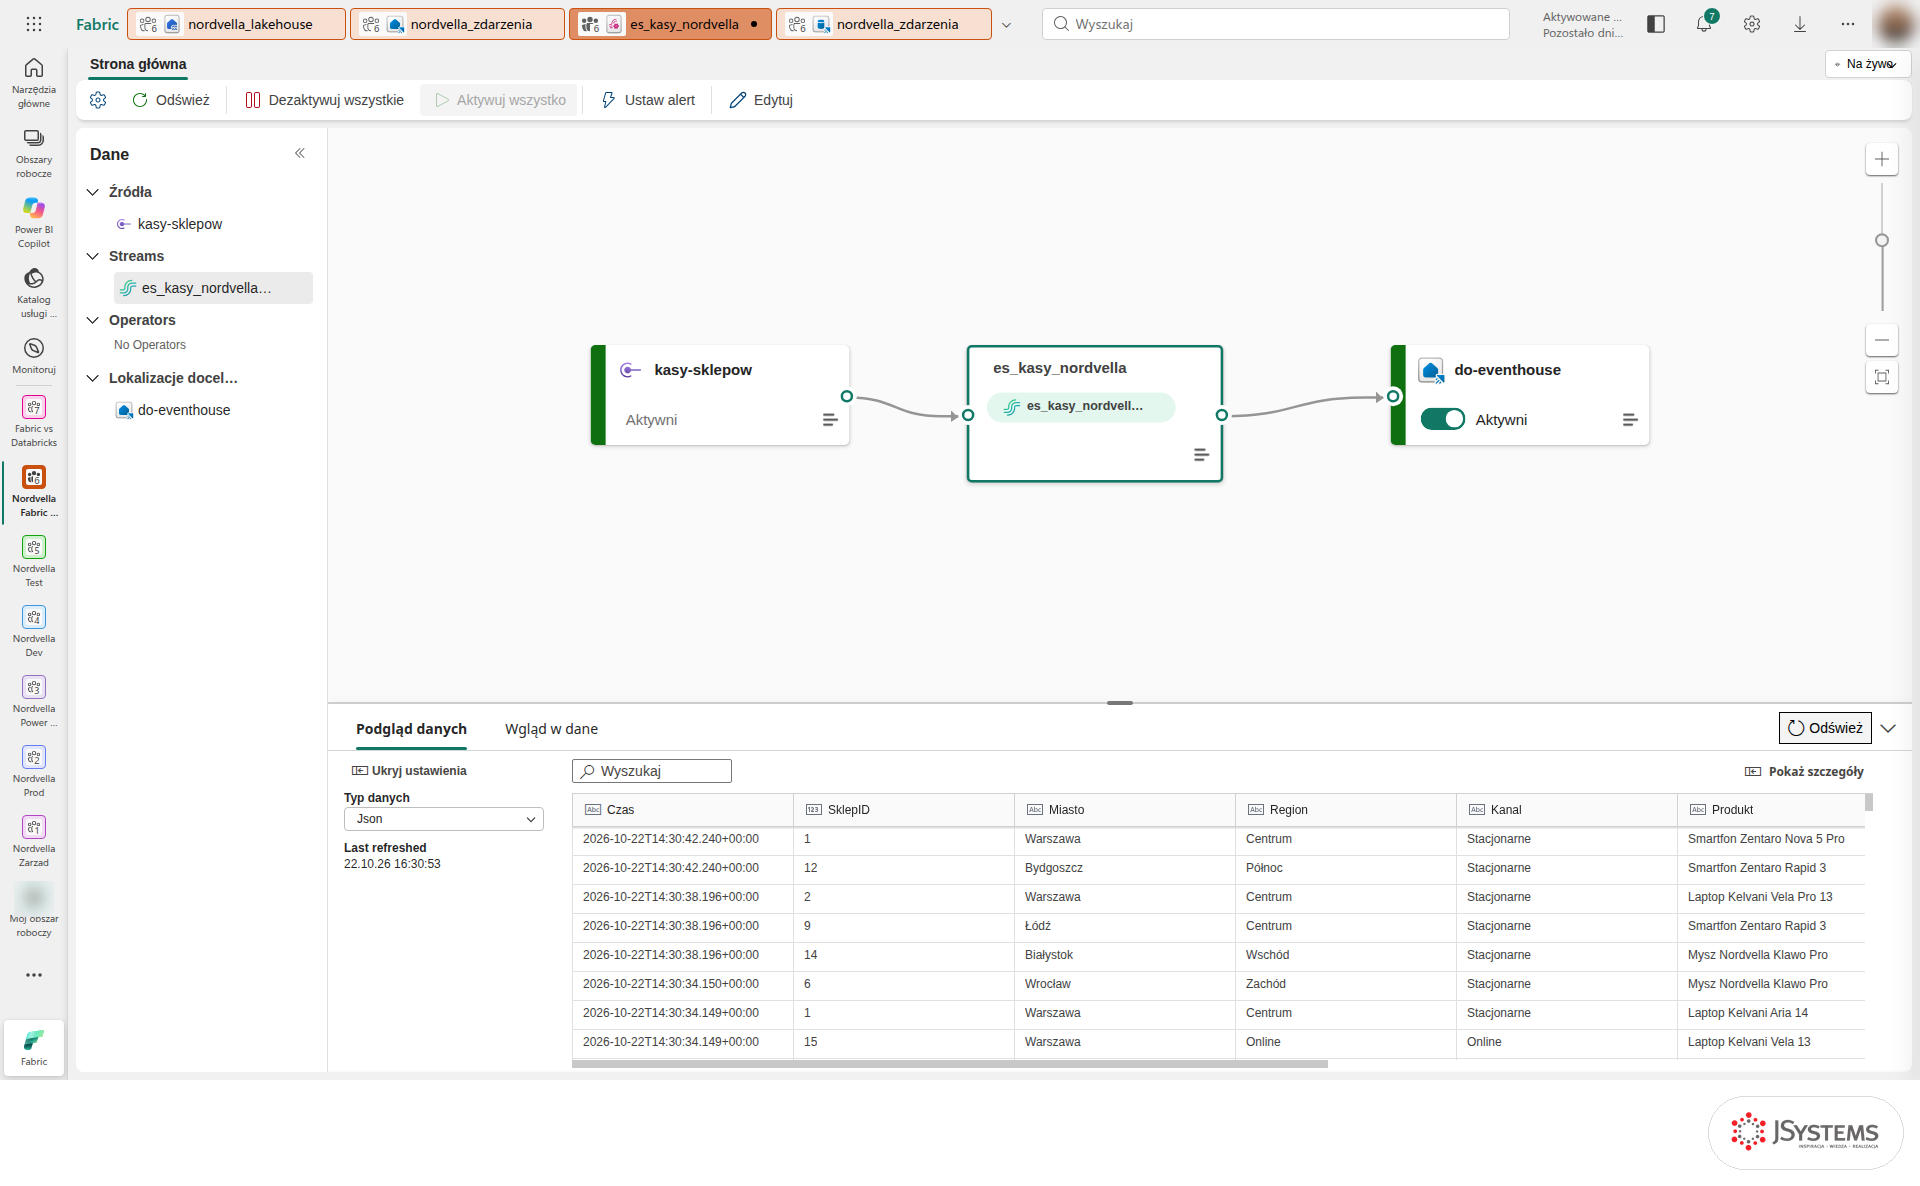
Kilka sekund po starcie skryptu w podglądzie danych Eventstream pojawiają się pierwsze transakcje, a węzeł Eventhouse ma status aktywny.
KQL czyta się od góry do dołu jak potok: bierzesz tabelę, filtrujesz, grupujesz, sortujesz. Pierwsze zapytanie sumuje sprzedaż i liczy transakcje według miast z ostatnich 15 minut.
transakcje_kasy
| where Czas > ago(15m)
| summarize Sprzedaz = round(sum(WartoscBrutto), 2), Transakcje = count() by Miasto
| order by Sprzedaz desc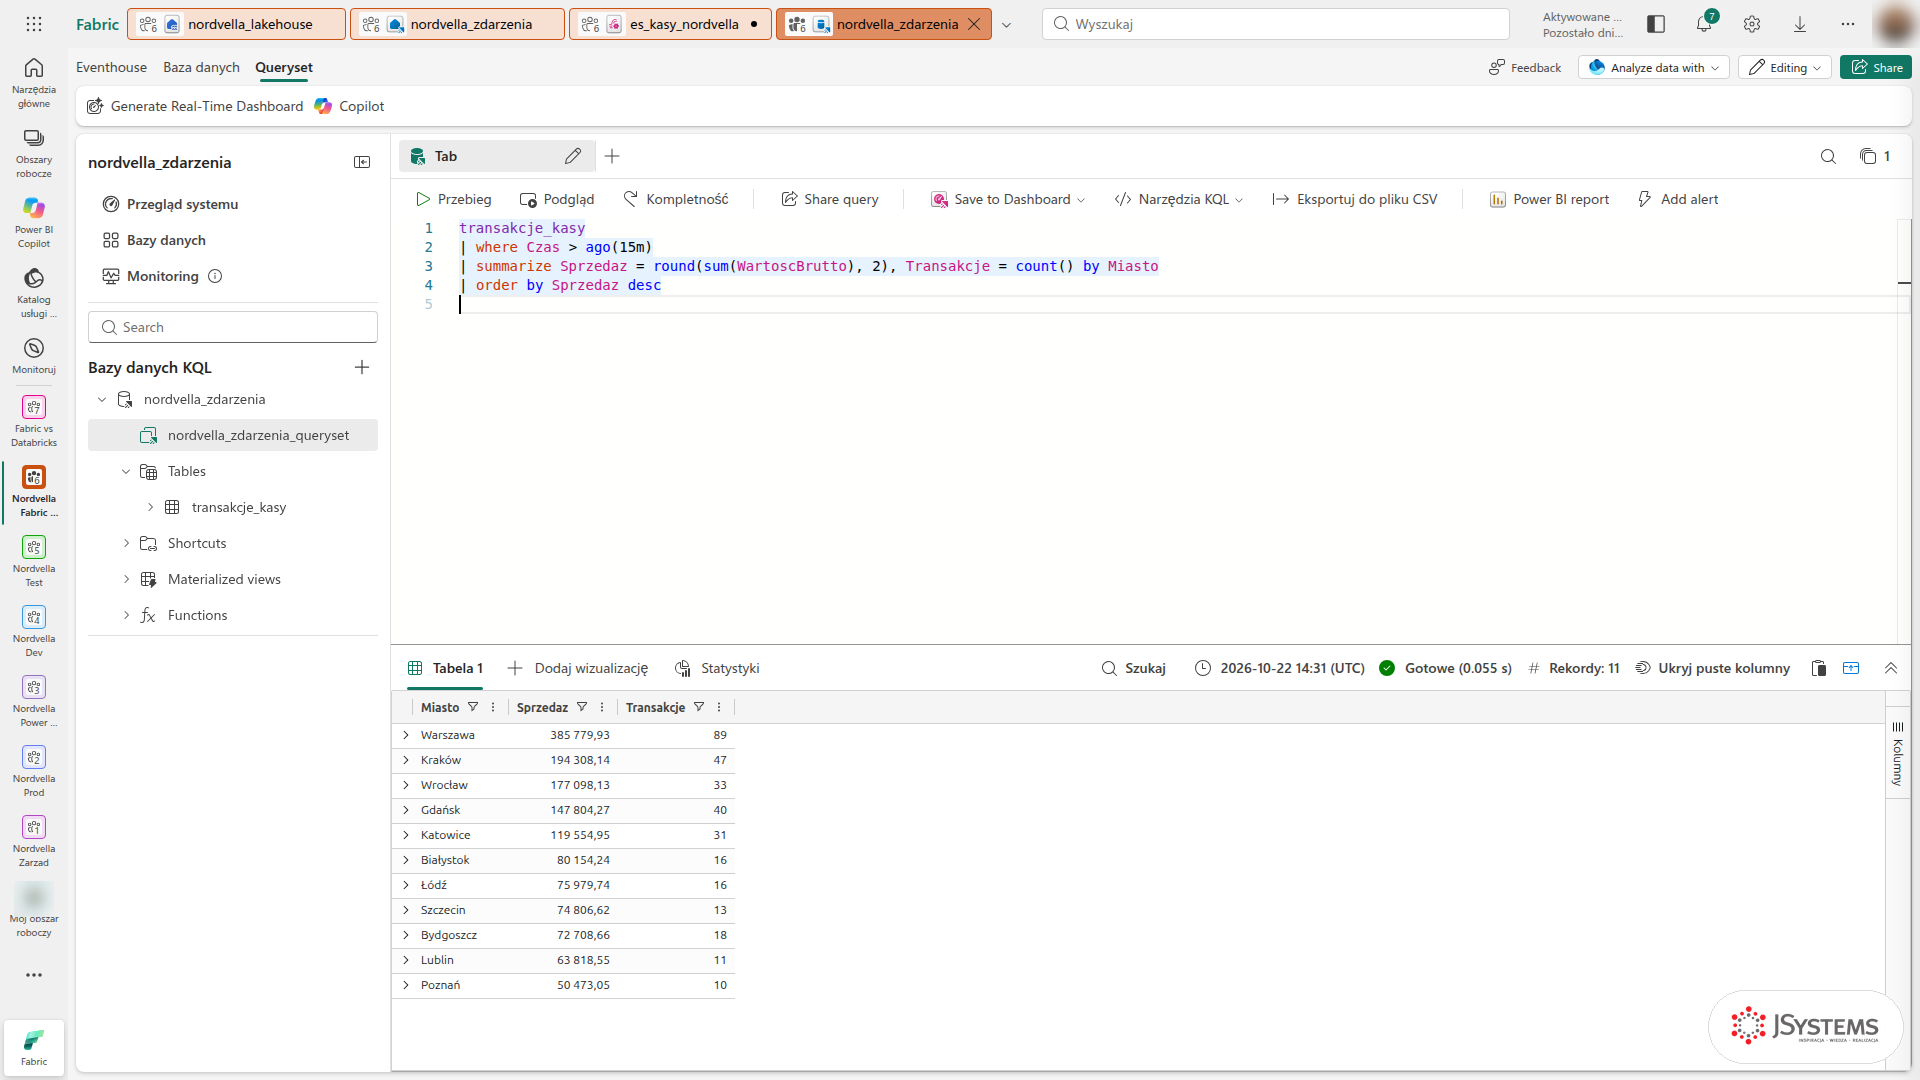
Drugie zapytanie dzieli dane na minutowe przedziały i rysuje wykres czasowy z osobną linią dla każdego miasta. Operator render timechart od razu zamienia wynik w wykres.
transakcje_kasy
| where Czas > ago(30m)
| summarize Sprzedaz = sum(WartoscBrutto) by bin(Czas, 1m), Miasto
| render timechart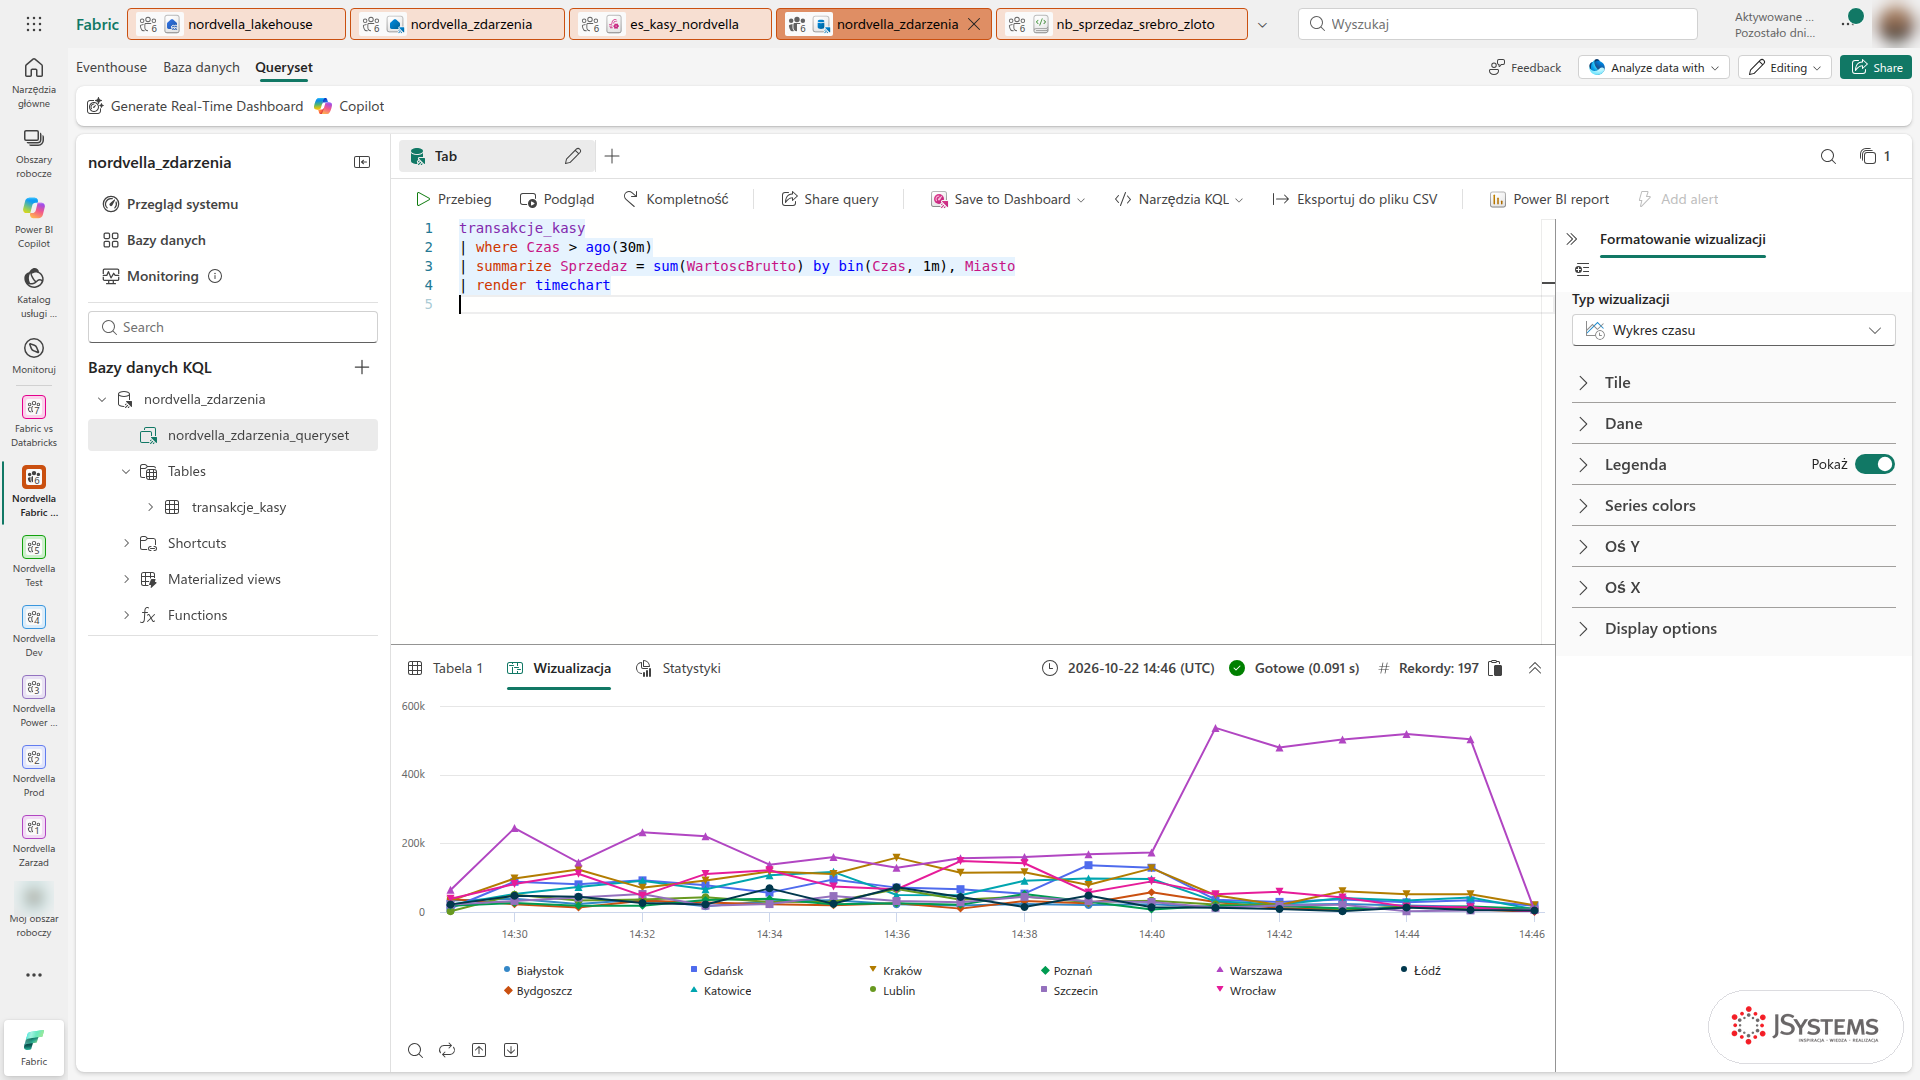
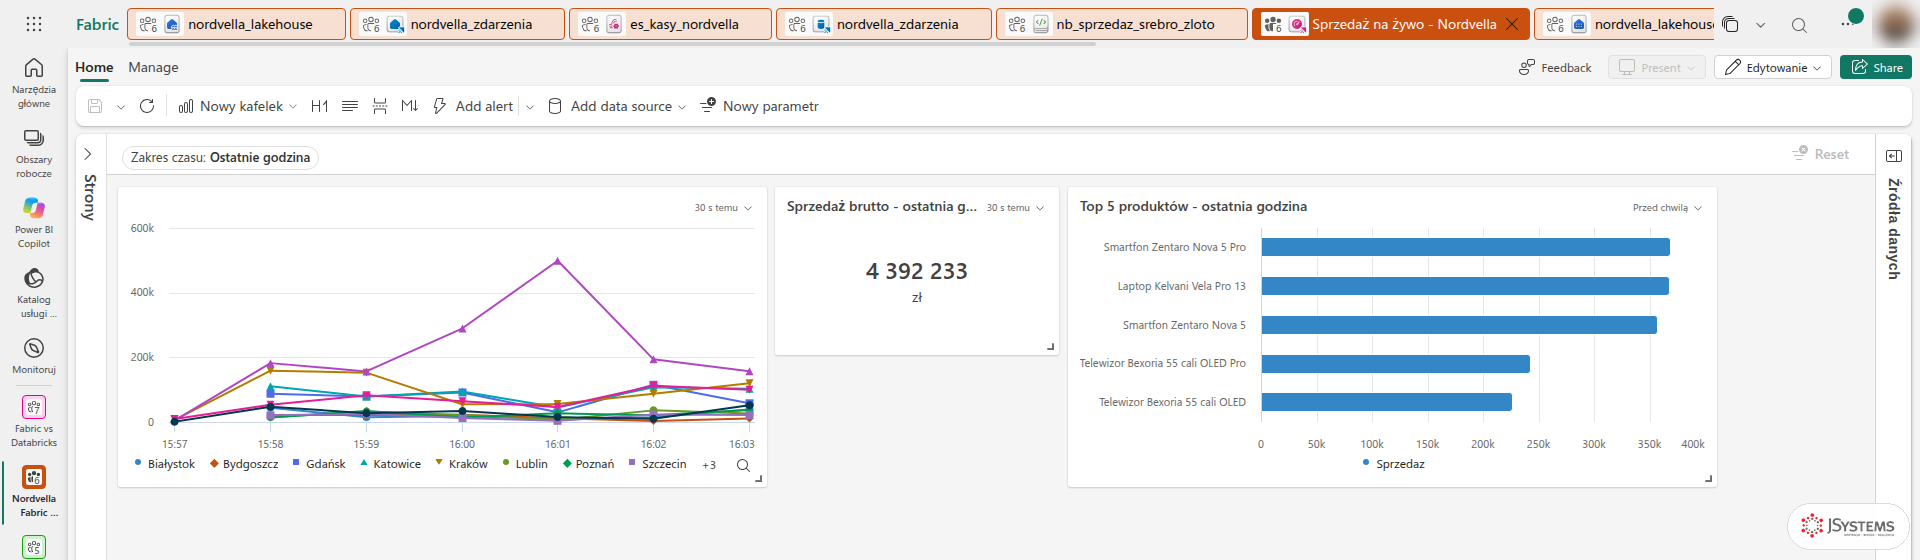
Zapytania KQL możesz przypiąć jako kafelki pulpitu czasu rzeczywistego (Real-Time Dashboard). Nasz pulpit „Sprzedaż na żywo - Nordvella” ma trzy kafelki: sprzedaż według miast w czasie, sumę sprzedaży brutto z ostatniej godziny i pięć najlepiej sprzedających się produktów. Pulpit może się odświeżać na żywo, ale każde odświeżenie wykonuje zapytania na pojemności, więc przy wielu oglądających ustaw rozsądny interwał.
Aktywator ocenia warunki na danych w ruchu i wykonuje akcję, gdy warunek jest spełniony. Regułę najłatwiej założyć z Eventstream przyciskiem „Ustaw alert”:
WartoscBrutto, operator „Is greater than” i wartość 25000.akt_duze_transakcje, i kliknij „Utwórz”.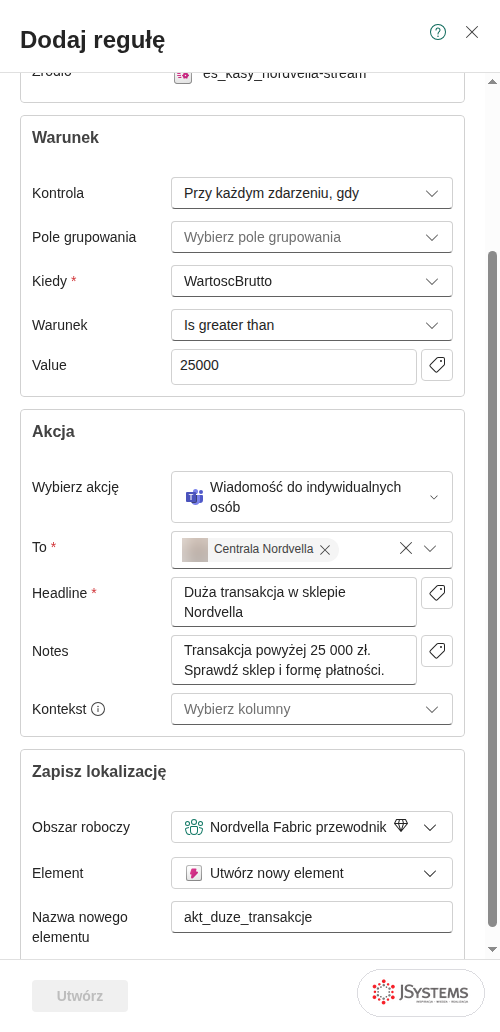
Zanim zostawisz strumień na noc, pamiętaj, że Eventstream i Eventhouse pracują bez przerwy i zużywają pojemność. Po ćwiczeniu dezaktywuj źródła i miejsca docelowe przyciskiem „Dezaktywuj wszystkie” na pasku Eventstream.
AI w Fabric występuje w kilku postaciach. Copilot pomaga przy pracy w konkretnym narzędziu: pisze i wyjaśnia kod w notesie, podpowiada zapytania SQL i KQL, buduje przekształcenia w przepływie danych Gen2, tworzy strony raportu i miary w Power BI. Agent danych (data agent) to asystent do rozmowy z danymi, któremu wskazujesz źródła, np. lakehouse, magazyn, model semantyczny albo bazę KQL, a użytkownik pyta go po polsku o liczby. Fabric IQ to warstwa znaczenia biznesowego: ontologia opisuje, czym w firmie jest „sklep”, „klient” czy „zamówienie” i jak się łączą, a z tego opisu korzystają ludzie i agenci AI. Agent operacji (operations agent) z obciążenia Real-Time Intelligence śledzi dane w czasie rzeczywistym i podpowiada działania, gdy coś odbiega od normy.
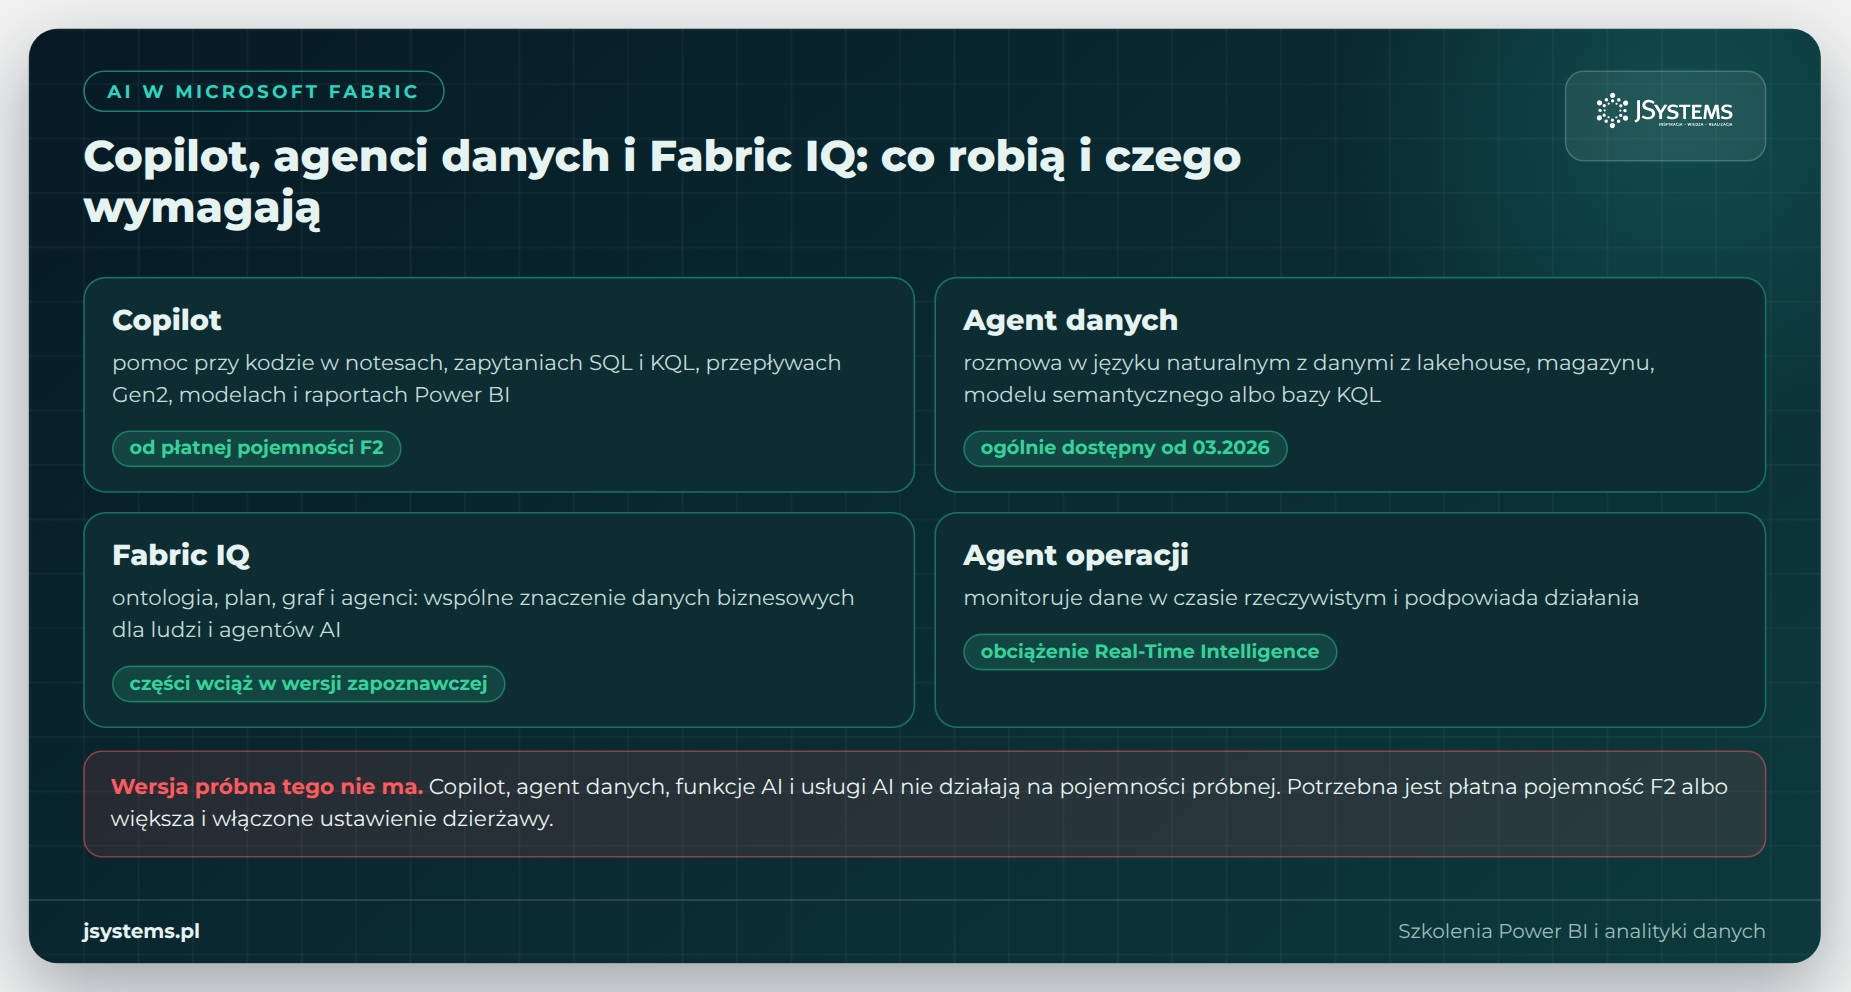
Najważniejsze ograniczenie dla osób, które dopiero testują Fabric: Copilot, agent danych, funkcje AI i usługi AI nie działają na pojemności próbnej. Od 2025 roku wystarcza za to dowolna płatna pojemność od F2 w górę, wcześniej Copilot wymagał F64. Dodatkowo administrator dzierżawy musi zezwolić na Copilota w ustawieniach dzierżawy.
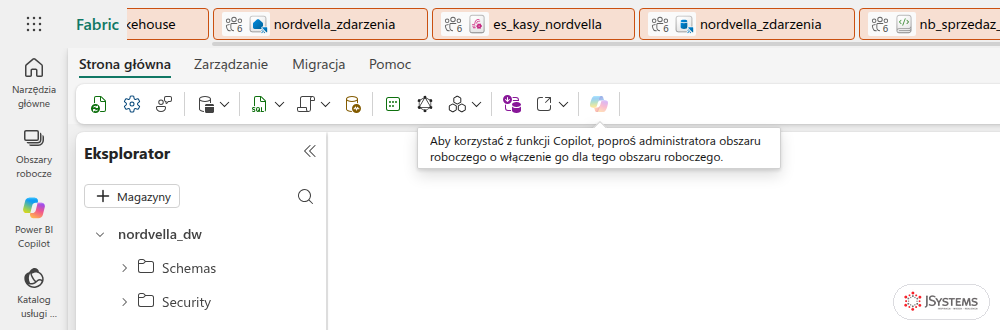
Stan poszczególnych funkcji zmienia się szybko, dlatego przed planowaniem wdrożenia sprawdź aktualną tabelę statusów w dokumentacji Microsoftu. Na październik 2026 roku sytuacja wygląda tak: agenci danych są ogólnie dostępni od marca 2026, Microsoft ogłosił Fabric IQ jako ogólnie dostępny w czerwcu 2026, ale część jego składników, m.in. ontologia, jest nadal w wersji zapoznawczej. Copilot w notesach ma część funkcji w wersji zapoznawczej, np. naprawianie błędów i panel czatu.
Jeśli Copilot nie pojawia się mimo płatnej pojemności, przyczyną bywa ustawienie dzierżawy albo przypisanie obszaru roboczego do pojemności. Kolejne przyczyny i ich sprawdzenie opisaliśmy w artykule Copilot w Power BI niedostępny - wymagania pojemności i ustawienia administratora.
Gdy w obszarze roboczym działają potoki, notesy i modele, ktoś musi wiedzieć, co się uruchomiło, co się nie udało i skąd pochodzą liczby w raporcie. Fabric ma do tego trzy narzędzia, z których warto korzystać od pierwszego dnia: monitor, widok pochodzenia danych i integrację z Git.
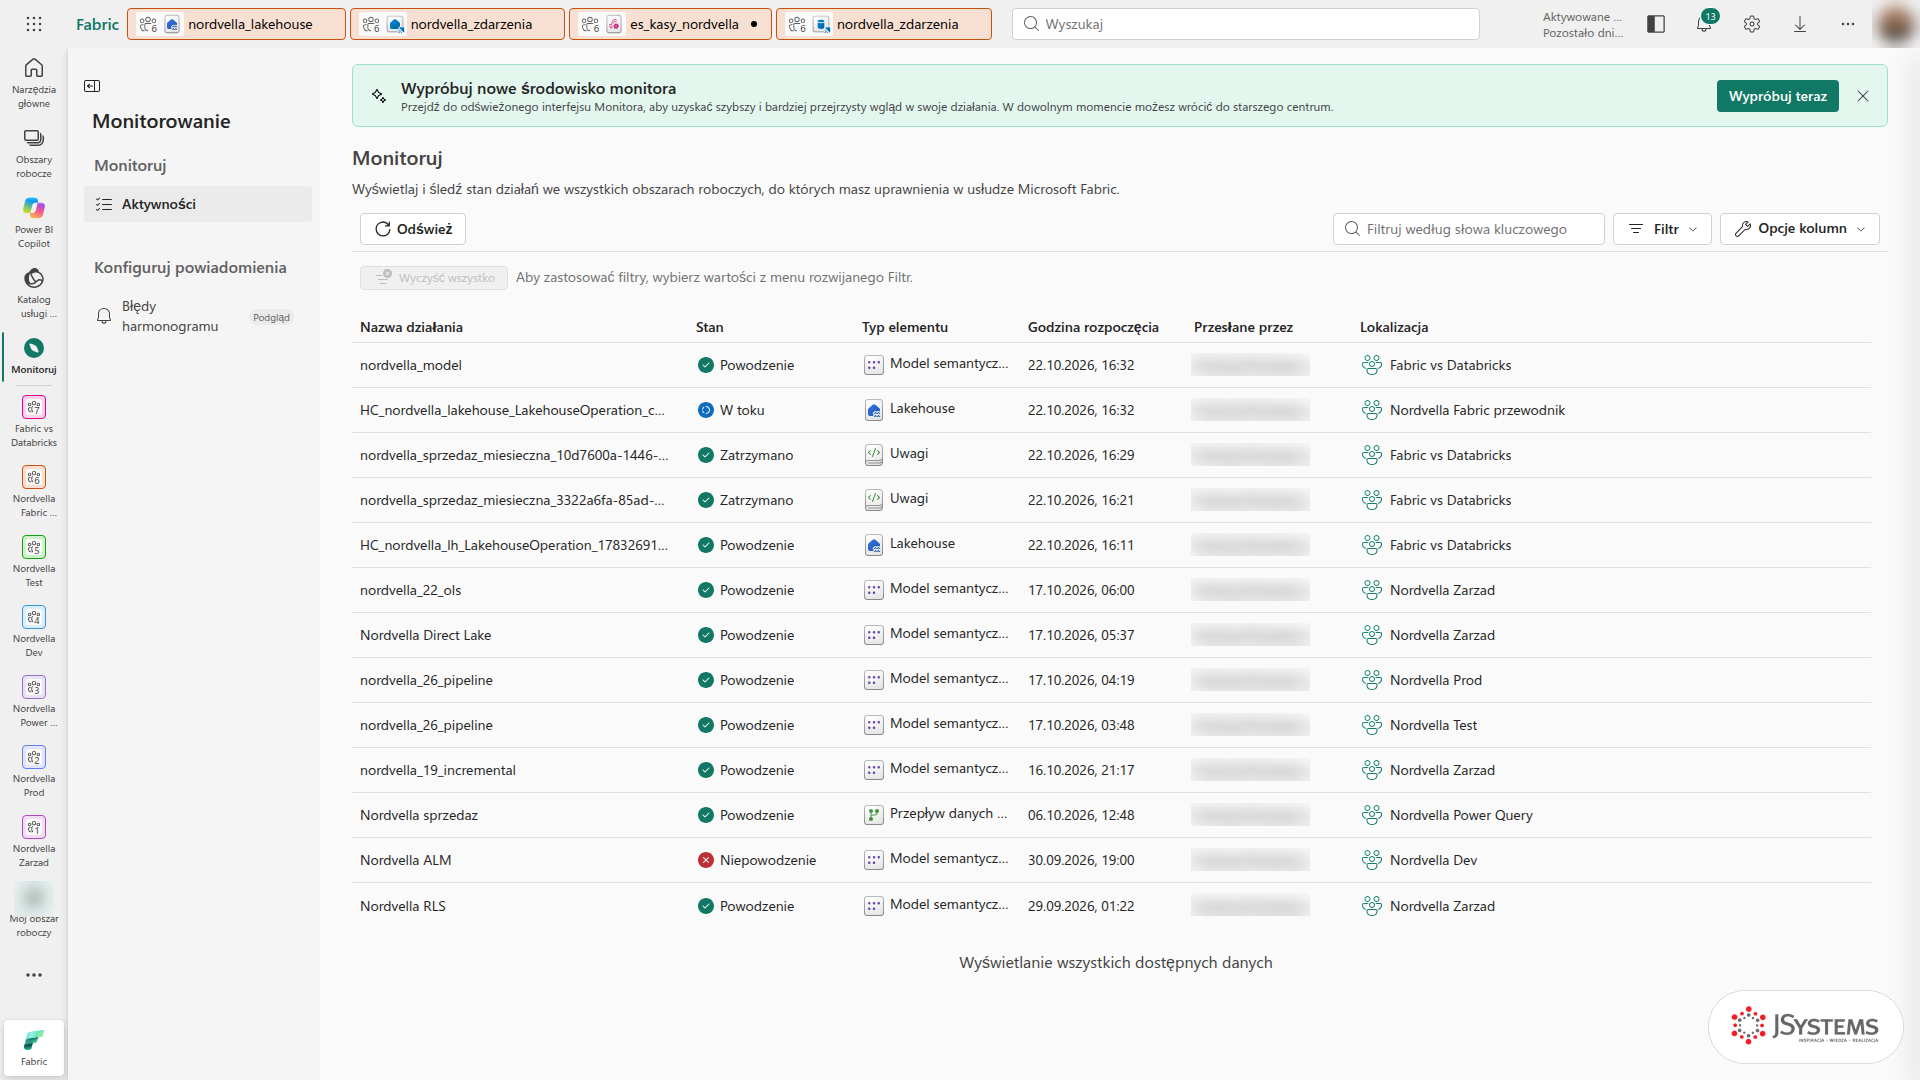
Monitor (w menu po lewej „Monitoruj”) pokazuje w jednym miejscu działania ze wszystkich obszarów, do których masz dostęp: przebiegi notesów i potoków, operacje lakehouse, odświeżenia modeli semantycznych. Przy każdym widać stan, typ elementu, godzinę rozpoczęcia, osobę, która uruchomiła działanie, i obszar roboczy.
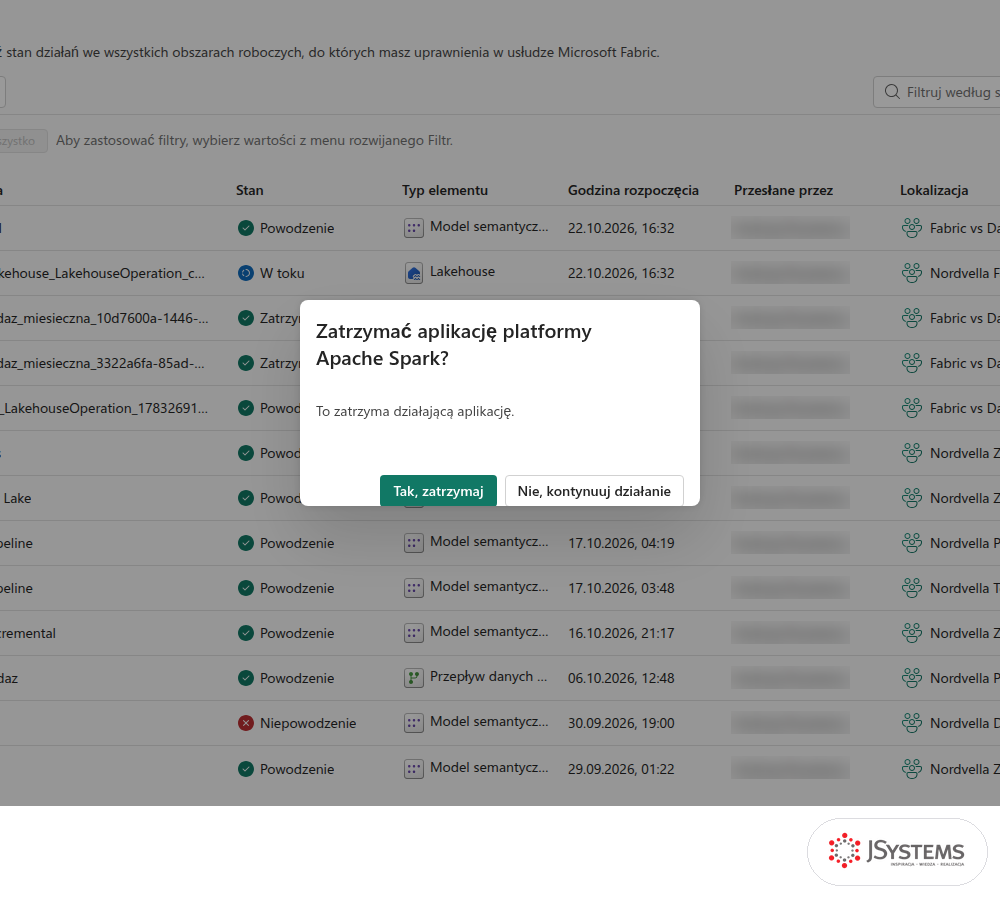
Z monitora możesz też zatrzymać działanie, które blokuje pojemność, np. zapomnianą sesję Spark. Kliknij trzy kropki przy działaniu, wybierz „Anuluj” i potwierdź zatrzymanie aplikacji Apache Spark.
Monitor pokazuje pojedyncze działania. Zużycie całej pojemności w czasie, z podziałem na elementy i operacje, pokazuje osobna aplikacja Microsoft Fabric Capacity Metrics, którą instaluje administrator pojemności. To w niej widać, które elementy zjadają najwięcej CU i jak blisko jest dławienia.
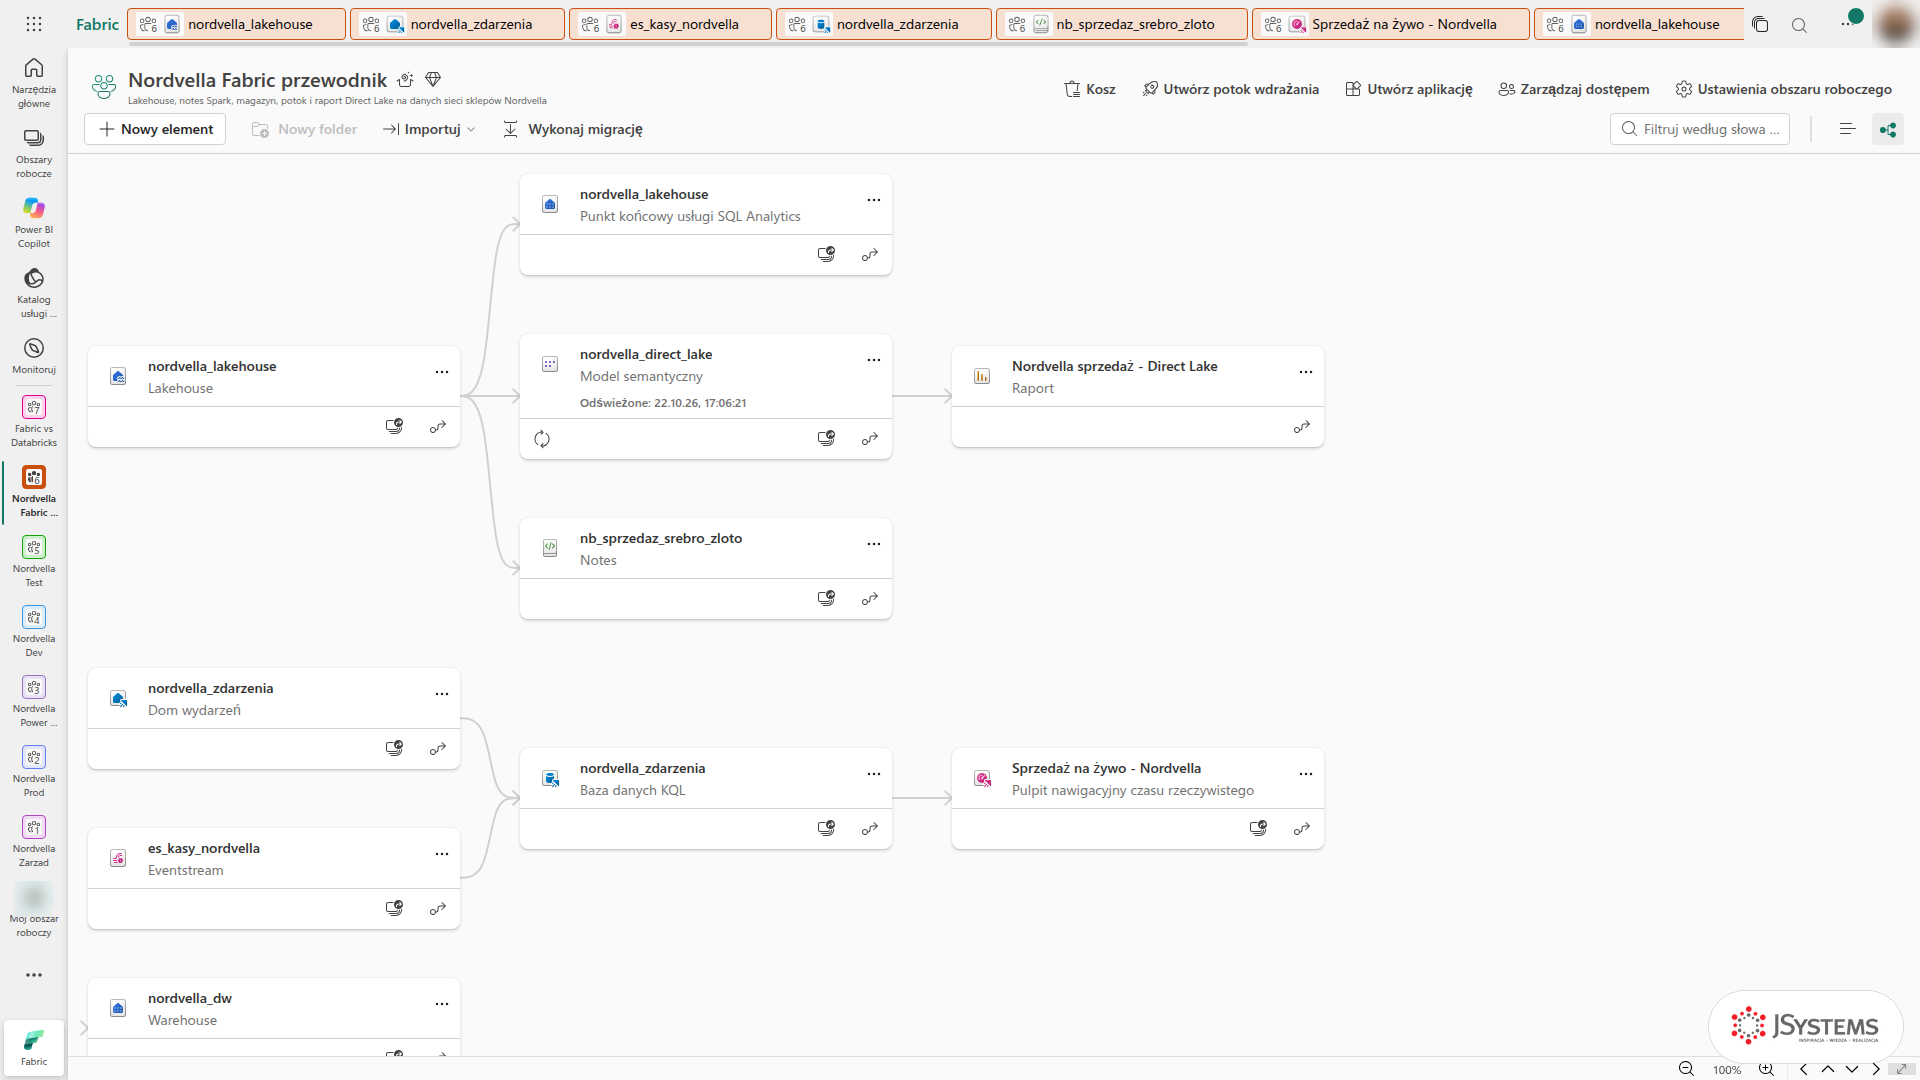
Widok pochodzenia danych (lineage) w obszarze roboczym rysuje zależności między elementami. W naszym przykładzie widać, że z lakehouse korzystają punkt końcowy SQL, notes i model Direct Lake, na modelu stoi raport, a Eventstream i dom wydarzeń zasilają bazę KQL, z której czyta pulpit czasu rzeczywistego. Przed zmianą tabeli warto tu sprawdzić, które raporty z niej korzystają, bo Fabric ma też analizę wpływu (impact analysis), która wymienia elementy zależne.
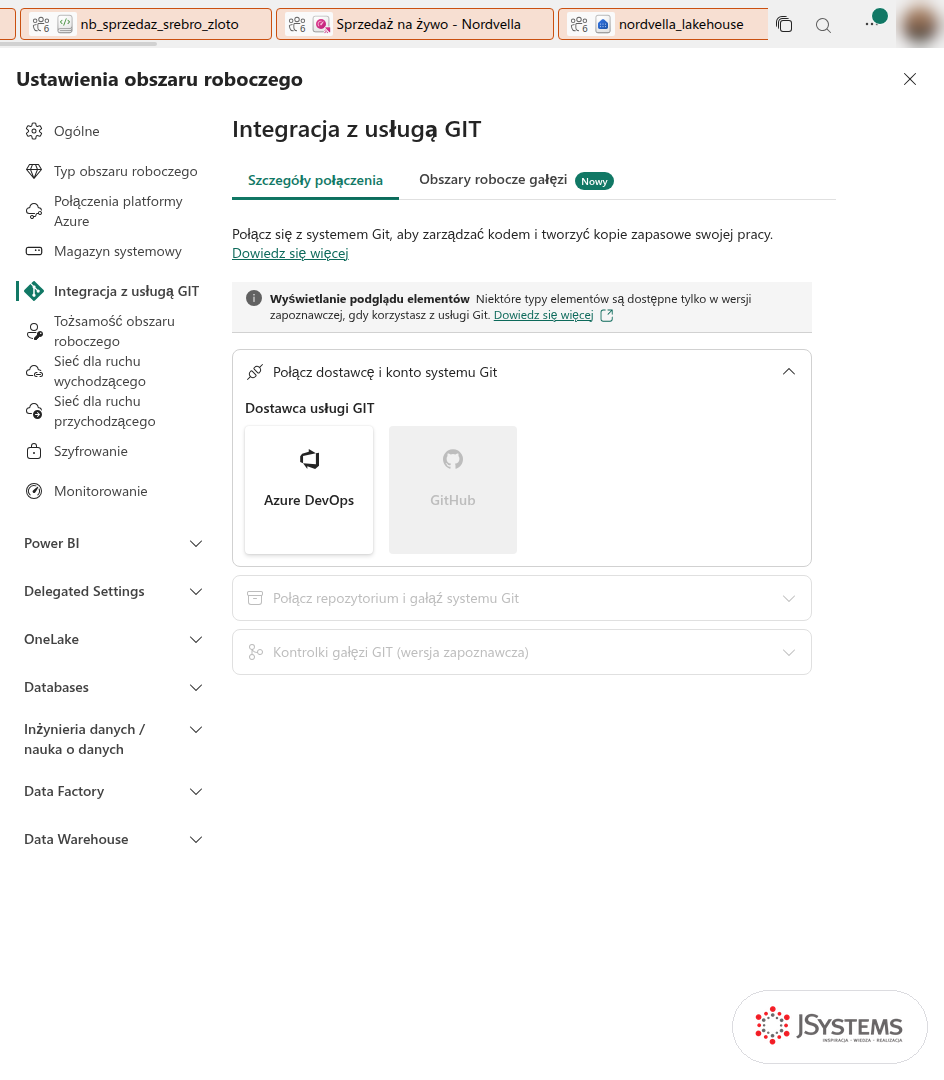
Obszar roboczy możesz połączyć z repozytorium w Azure DevOps albo GitHub. Fabric zapisuje wtedy definicje elementów (notesy, potoki, modele, raporty) jako pliki, więc zmiany przechodzą przez commity i przeglądy kodu, a obszar deweloperski da się odtworzyć z repozytorium. Do przenoszenia zmian między środowiskami służą potoki wdrażania (dev, test, prod) i biblioteki zmiennych, w których trzymasz wartości różne dla każdego środowiska, np. nazwy źródeł.
Potoki wdrażania w Power BI pokazaliśmy krok po kroku w lekcji Deployment pipelines: dev, test, prod (ALM) kursu Power BI.
Fabric ma certyfikaty zgodności m.in. ISO/IEC 27001, ISO/IEC 27017, ISO/IEC 27018 i ISO/IEC 27701 oraz umowę HIPAA BAA. Raporty z audytów, o które pytają działy bezpieczeństwa i zgodności, Microsoft udostępnia w portalu Service Trust Portal.
W Fabric płaci się za dwie różne rzeczy. Firma kupuje pojemność, czyli moc obliczeniową dla całej organizacji, a poszczególne osoby potrzebują licencji, które określają, co mogą robić z treściami Power BI. Pomylenie tych dwóch warstw to najczęstsze źródło nieporozumień przy budżetowaniu.
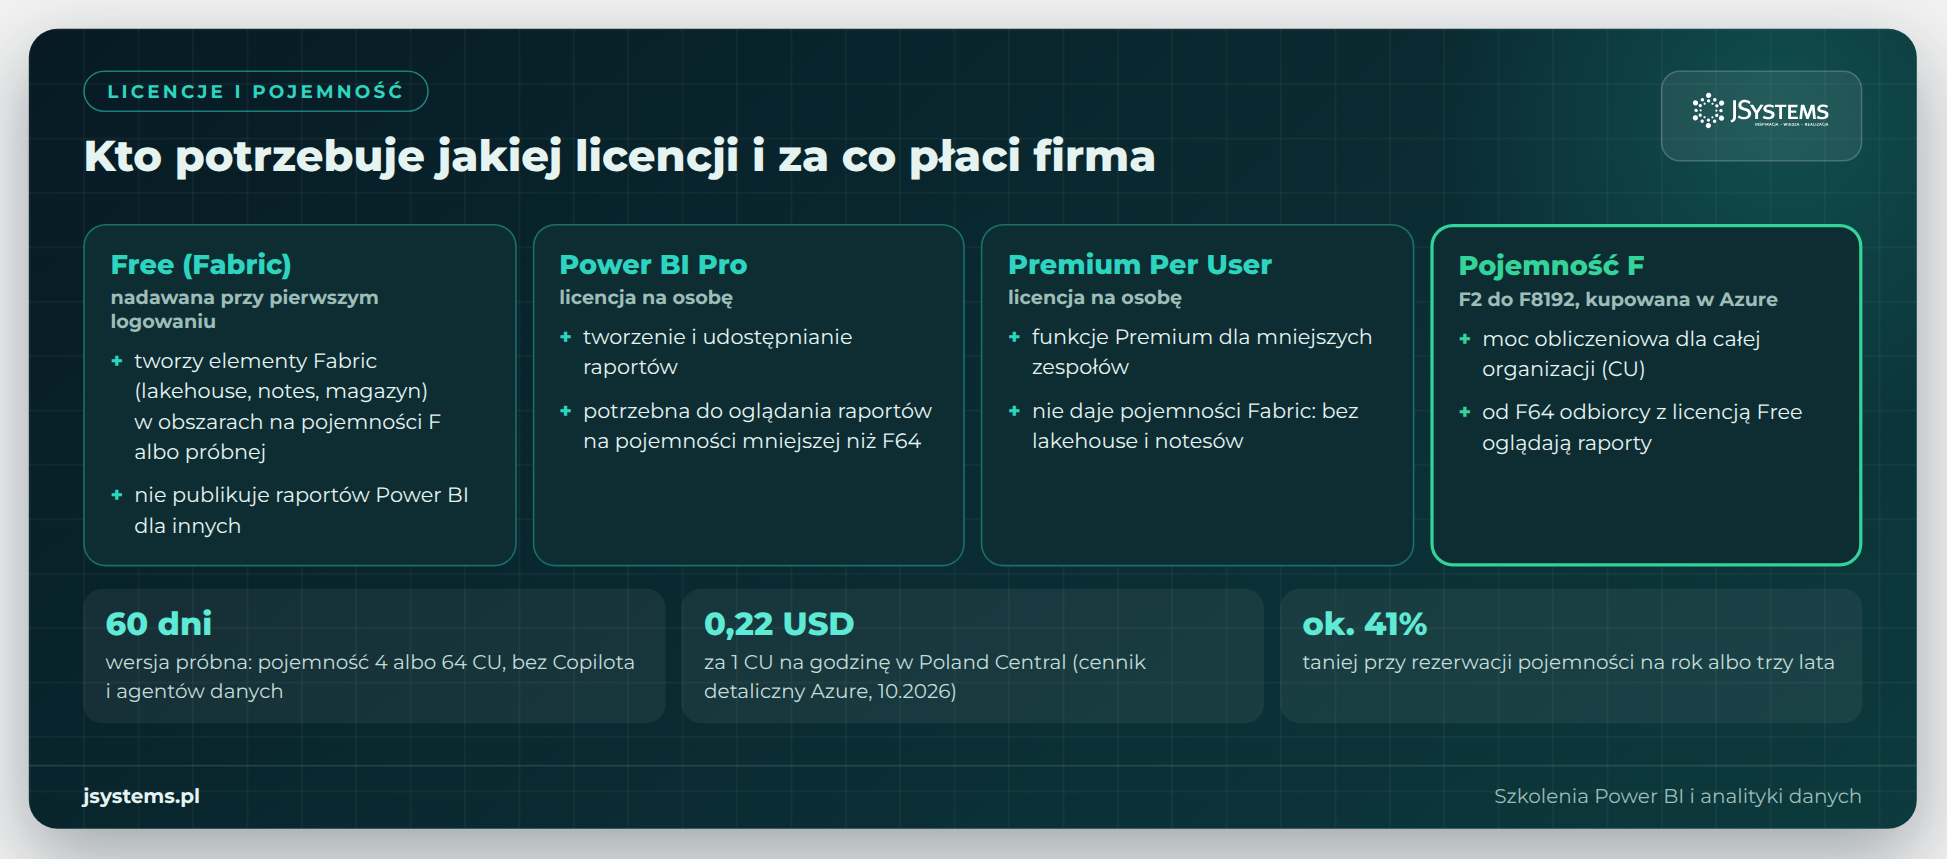
Pojemność Fabric to zasób w subskrypcji Azure, kupowany w wybranym regionie w rozmiarach od F2 do F8192. Liczba po literze F to liczba jednostek CU: F2 ma 2 CU, F64 ma 64 CU. Wszystkie obciążenia w obszarach przypisanych do pojemności korzystają z tej samej puli CU.
Rozliczenie w modelu pay-as-you-go jest za sekundę pracy, z minimum jednej minuty. Pojemność można wstrzymać, gdy nikt z niej nie korzysta, np. w nocy w środowisku testowym, i wznowić rano. Przy wstrzymaniu Fabric dolicza do faktury skumulowane nadwyżki i operacje rozłożone w czasie, które jeszcze się nie rozliczyły. Za dane w OneLake płacisz osobno, także gdy pojemność stoi.
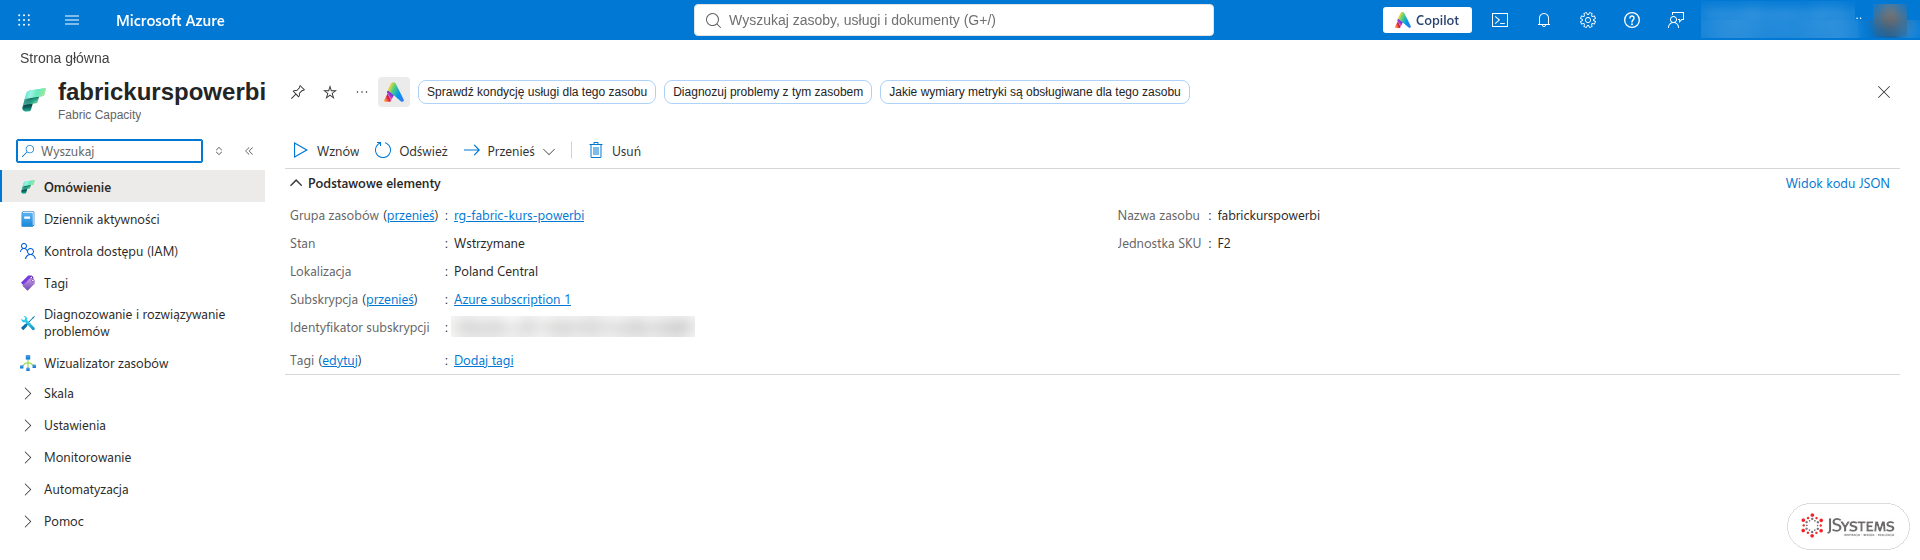
Co się dzieje z raportami i modelami, gdy ktoś wstrzyma pojemność, opisaliśmy w artykule Pojemność Fabric wstrzymana - raporty i modele przestają działać.
Cennik detaliczny Azure dla regionu Poland Central podaje 0,22 USD za jedną jednostkę CU na godzinę (0,8471 PLN). Rezerwacja pojemności na rok albo trzy lata obniża stawkę o ok. 41%. Poniżej przeliczenie dla pojemności pracującej bez przerwy przez cały miesiąc (730 godzin), bez wstrzymywania.
| SKU | CU | USD za godzinę | USD za miesiąc | PLN za miesiąc | USD za miesiąc przy rezerwacji na rok |
|---|---|---|---|---|---|
| F2 | 2 | 0,44 | 321,20 | 1 236,77 | 191,00 |
| F4 | 4 | 0,88 | 642,40 | 2 473,53 | 382,00 |
| F8 | 8 | 1,76 | 1 284,80 | 4 947,06 | 764,00 |
| F16 | 16 | 3,52 | 2 569,60 | 9 894,13 | 1 528,00 |
| F32 | 32 | 7,04 | 5 139,20 | 19 788,26 | 3 056,00 |
| F64 | 64 | 14,08 | 10 278,40 | 39 576,51 | 6 112,00 |
Magazyn OneLake kosztuje osobno, 0,024 USD za GB miesięcznie w warstwie gorącej. Dla porównania skali: cały plik sprzedaży z naszego przykładu (sprzedaz.csv) ma 8,6 MB, więc koszt jego przechowywania jest pomijalny, a o rachunku decyduje pojemność.
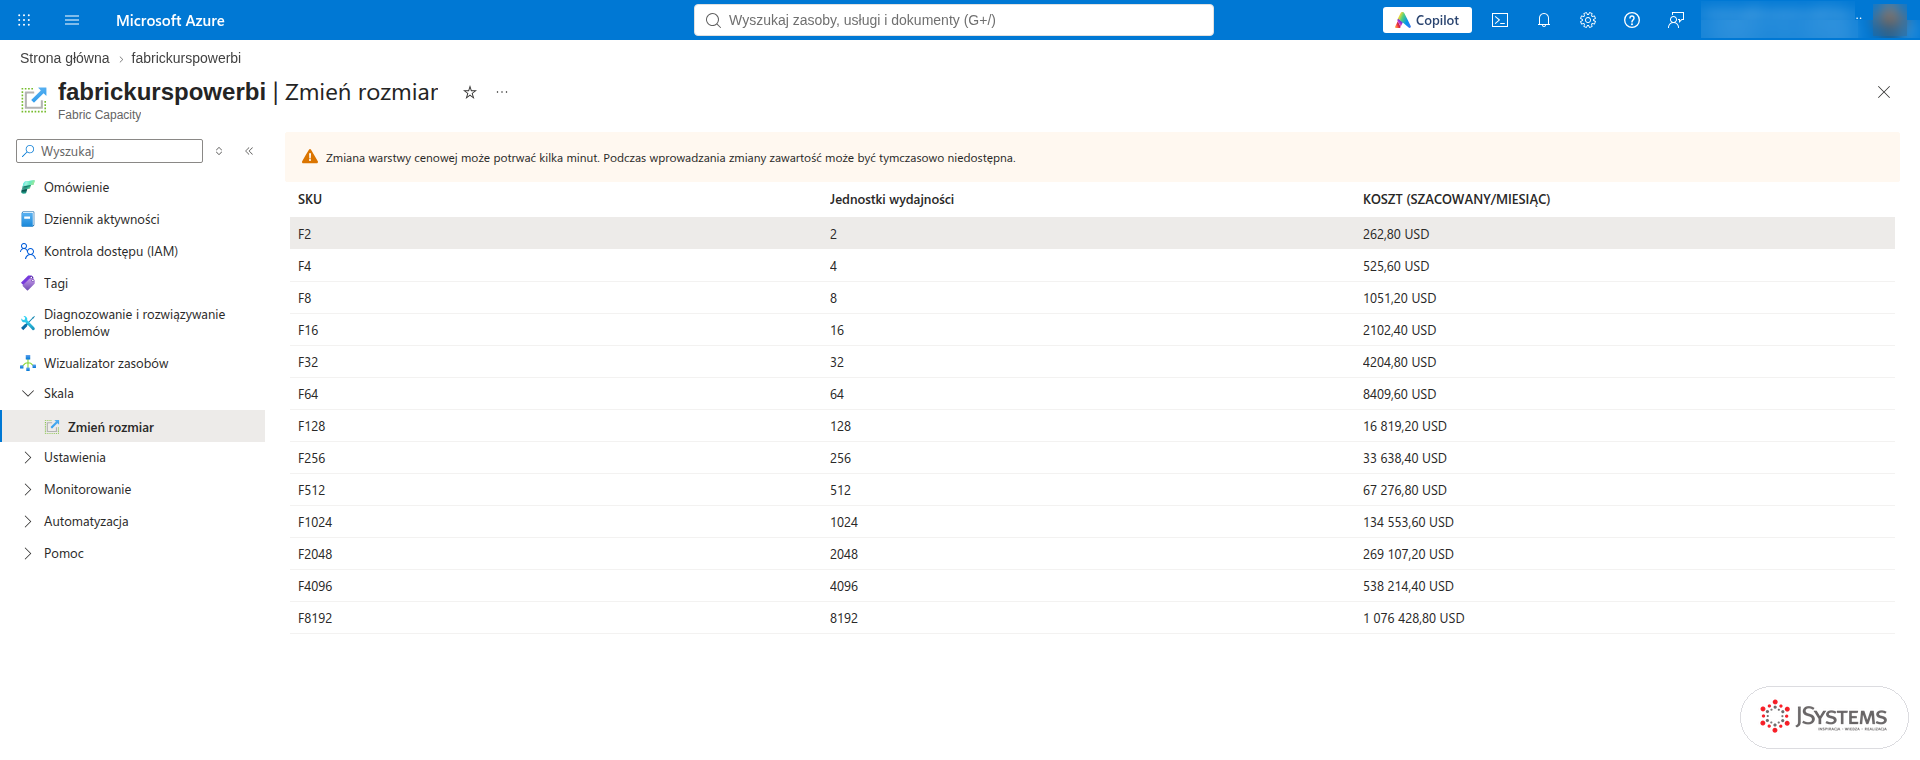
Uwaga na ceny w portalu. Okno zmiany rozmiaru pojemności w portalu Azure pokazało nam dla F2 kwotę 262,80 USD miesięcznie, co odpowiada stawce 0,18 USD za CU na godzinę, czyli cenie z regionów USA. Dla Poland Central cennik detaliczny podaje 0,22 USD. Przed decyzją sprawdź cenę w kalkulatorze cen Azure dla swojego regionu i waluty, a jeśli firma kupuje przez partnera albo ma umowę Enterprise, zapytaj o stawkę z umowy.
Ten próg łatwo przeliczyć. Jeśli raporty ogląda kilkaset osób, koszt ich licencji Pro może przekroczyć różnicę między mniejszą pojemnością a F64, i wtedy większa pojemność wychodzi taniej. Przy kilkunastu odbiorcach taniej wychodzi mała pojemność i licencje Pro.
Wersja próbna Fabric trwa 60 dni i daje pojemność 4 albo 64 CU oraz, jeśli nie masz PPU, indywidualną wersję próbną Power BI. Nie obejmuje Copilota, agentów danych, funkcji i usług AI ani łączy prywatnych, a OneLake ma limit 1 TB. Po zakończeniu wersji próbnej elementy są przechowywane jeszcze przez 7 dni, więc przed końcem trzeba albo przypisać obszar do płatnej pojemności, albo wyeksportować to, co ma zostać.
Pojemność F2 nie oznacza, że w każdej sekundzie możesz zużyć najwyżej 2 CU. Fabric pozwala zadaniom chwilowo zużywać więcej mocy, niż daje pojemność (bursting), a potem rozkłada to zużycie w czasie (smoothing). Dzięki temu nocne przeliczenie notesu, które na kilka minut potrzebuje dużo mocy, nie blokuje porannych raportów, o ile średnie zużycie mieści się w kupionej pojemności.
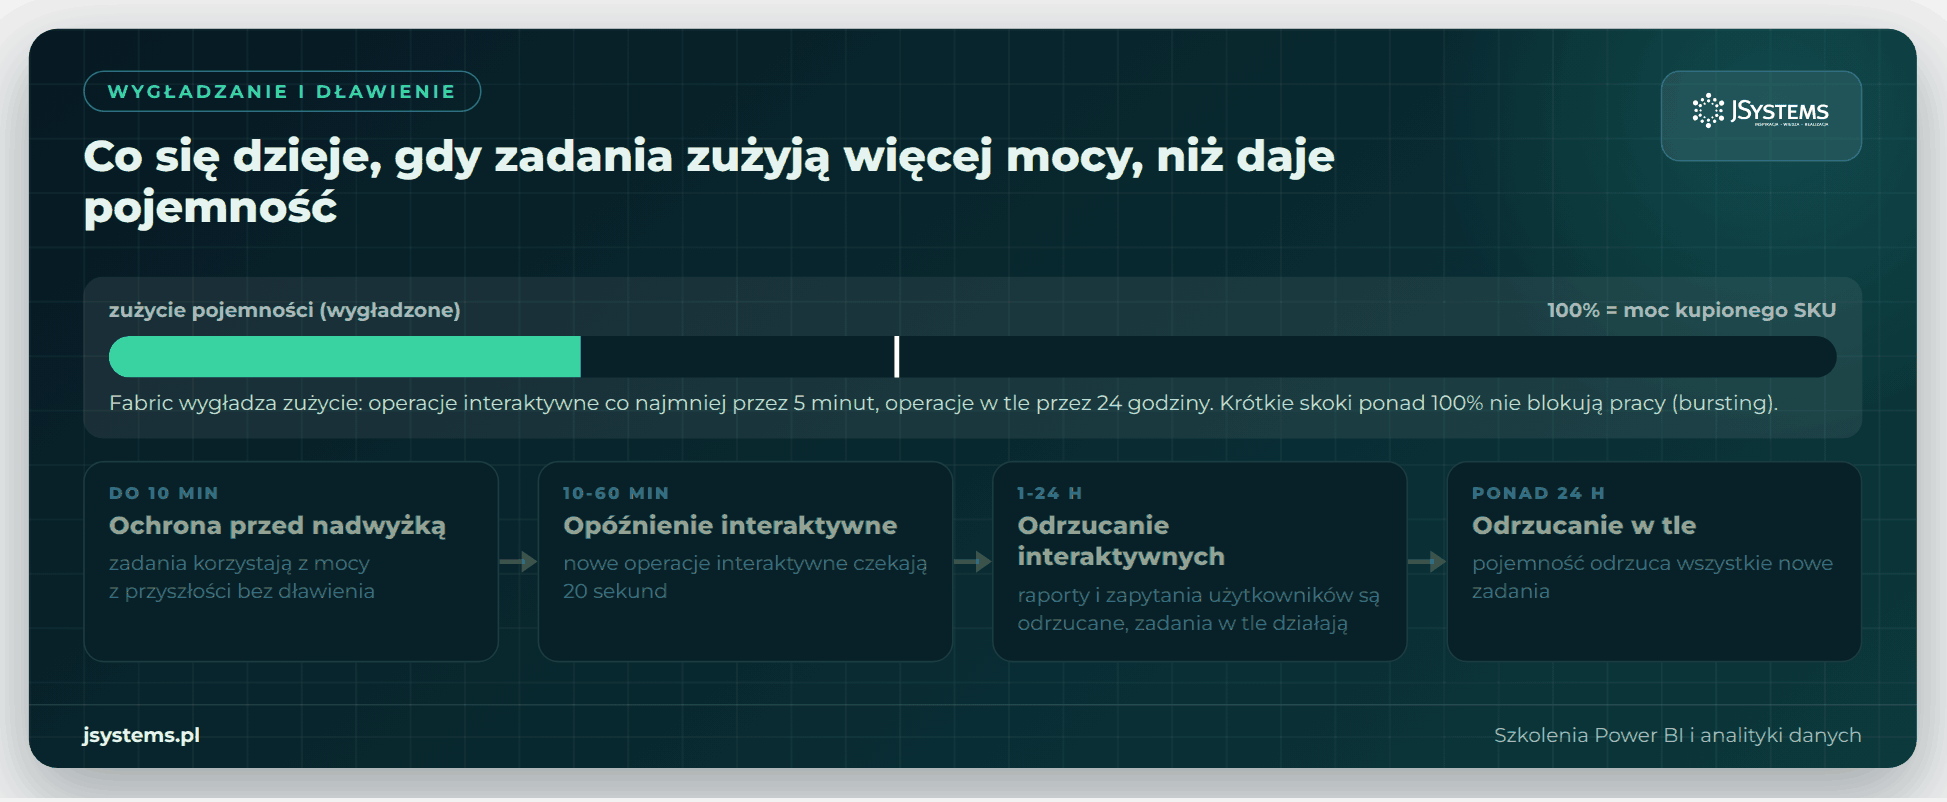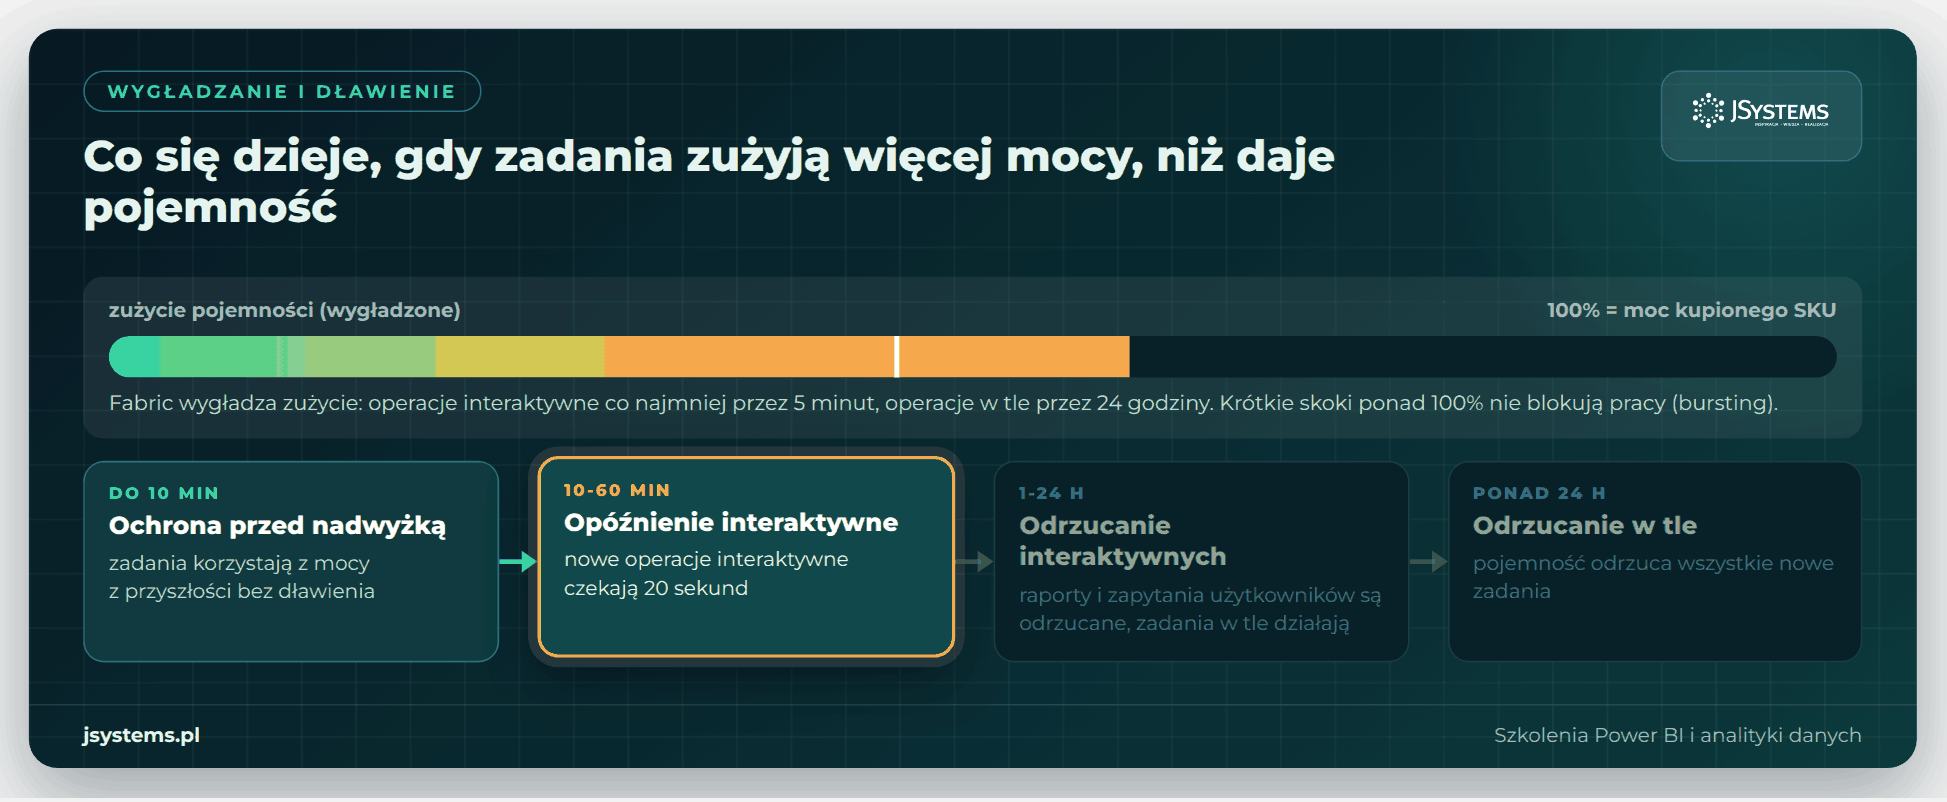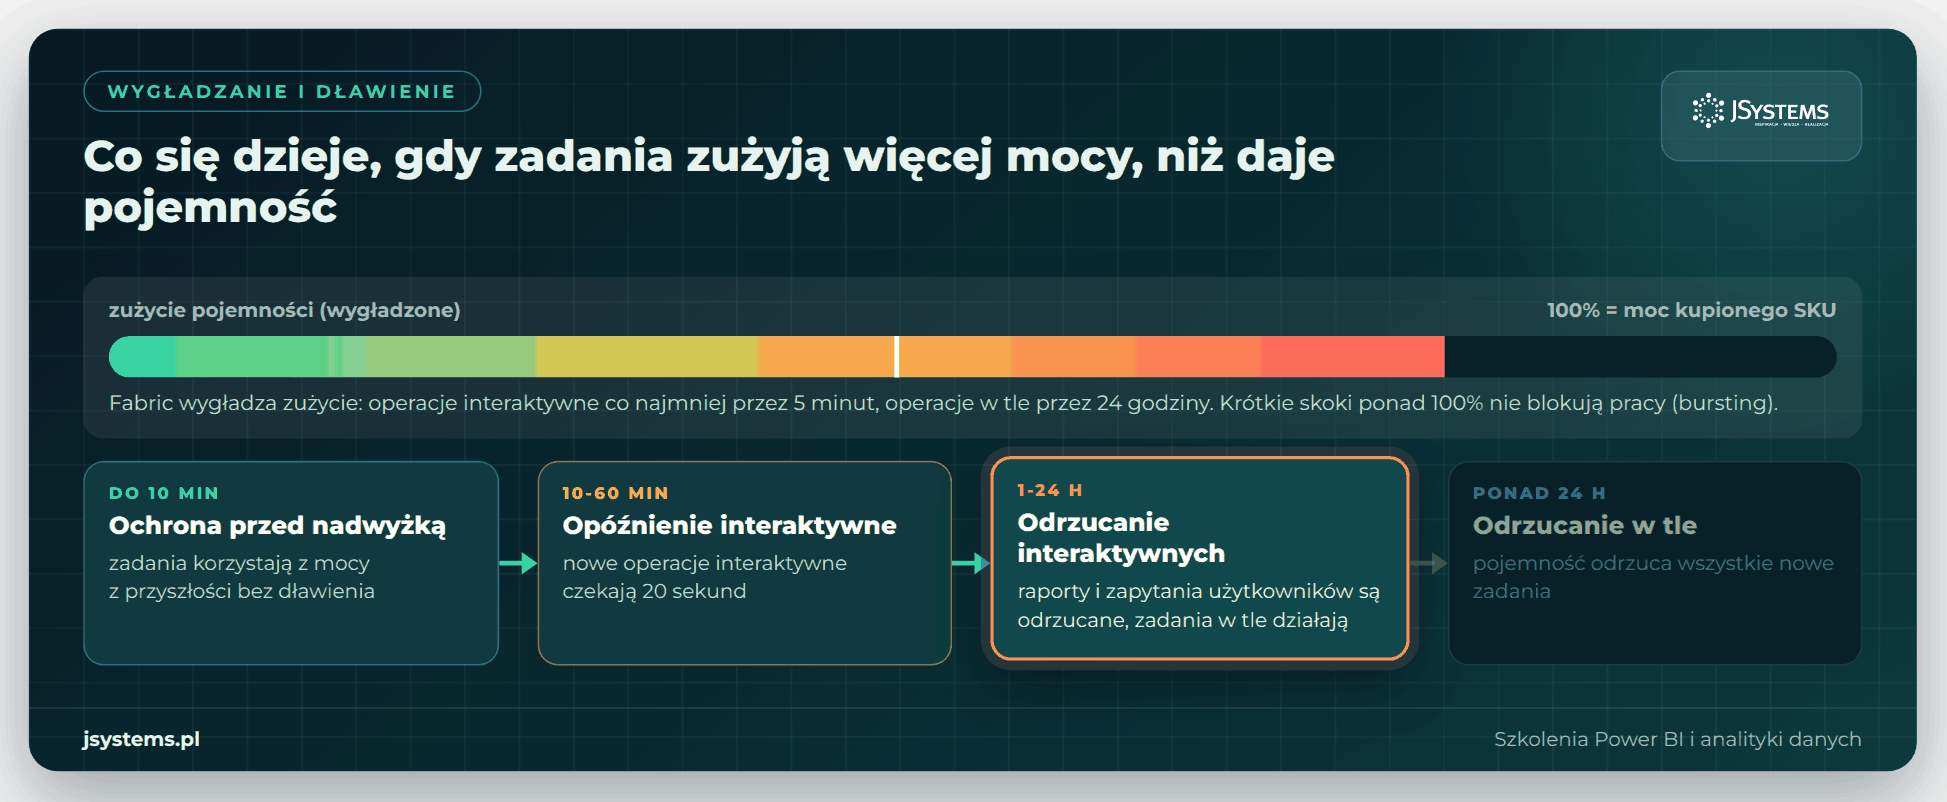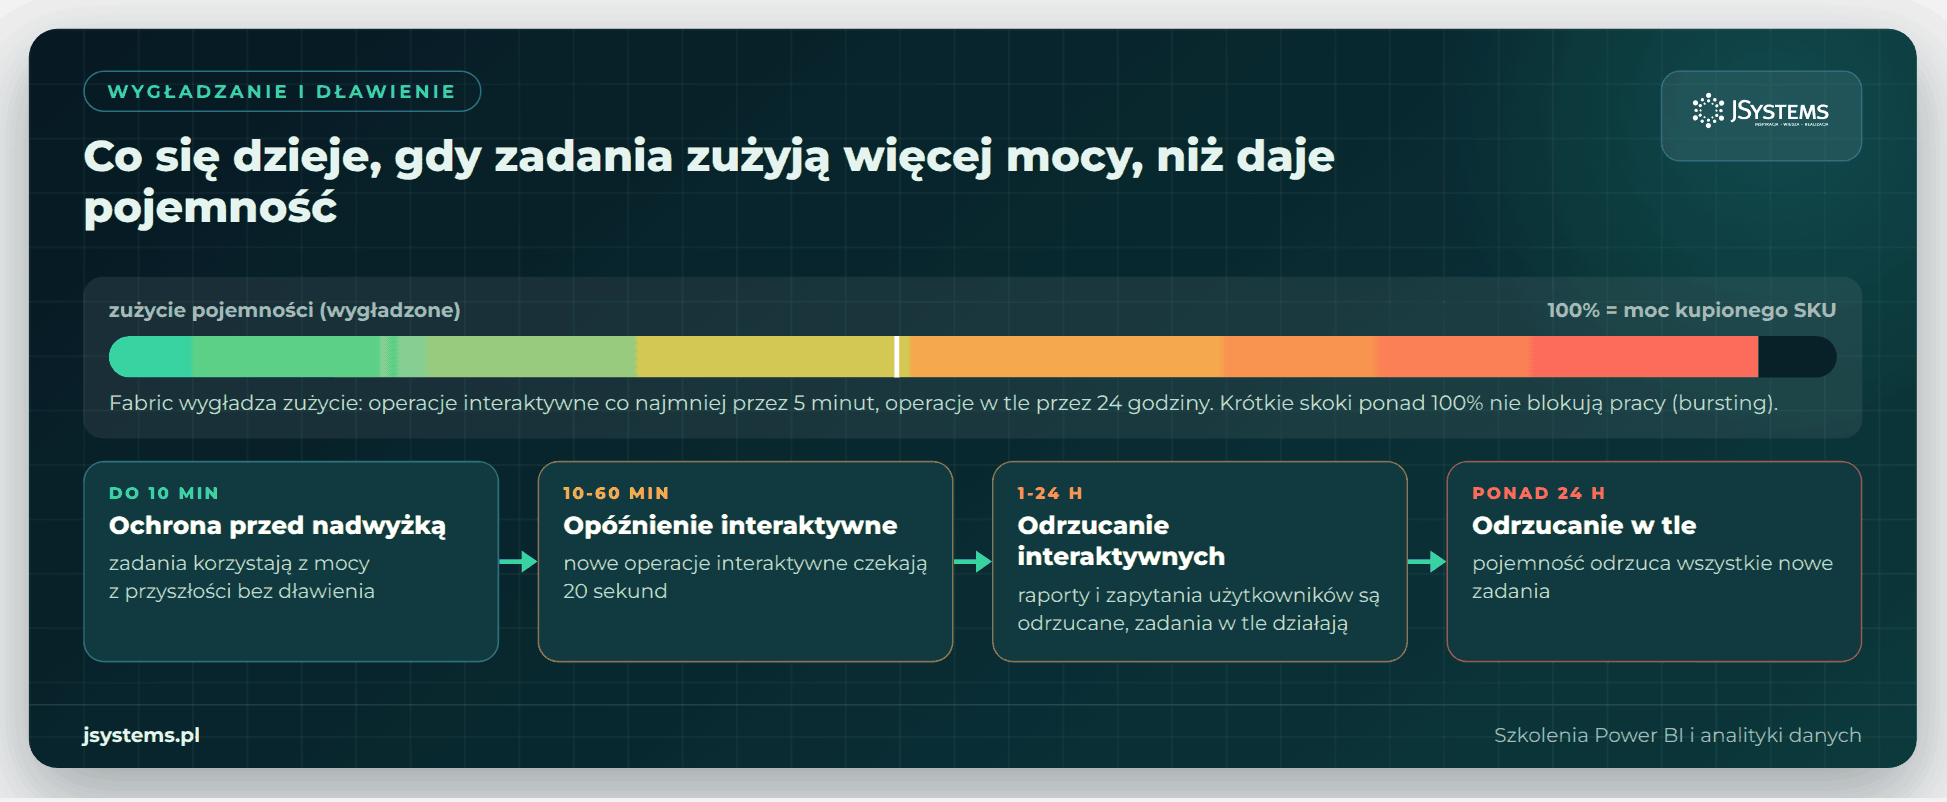
Fabric dzieli operacje na dwa rodzaje. Interaktywne to te, na które ktoś czeka: zapytanie z raportu, zapytanie SQL uruchomione ręcznie. Ich zużycie jest rozkładane na co najmniej 5 minut. Operacje w tle to zadania planowane i wsadowe: odświeżenie modelu, przebieg potoku, zadanie Spark. Ich zużycie jest rozkładane na 24 godziny.
Gdy wygładzone zużycie przekracza pojemność, Fabric reaguje stopniowo:
| Nadwyżka (w minutach przyszłej pojemności) | Etap | Co się dzieje |
|---|---|---|
| do 10 minut | ochrona przed nadwyżką | zadania korzystają z mocy z przyszłości bez żadnych ograniczeń |
| od 10 do 60 minut | opóźnienie operacji interaktywnych | nowe operacje interaktywne czekają 20 sekund |
| od 60 minut do 24 godzin | odrzucanie operacji interaktywnych | raporty i zapytania użytkowników dostają błąd, zadania w tle działają |
| powyżej 24 godzin | odrzucanie operacji w tle | pojemność odrzuca wszystkie nowe zadania |
Od września 2026 roku pojemności F mają też ogólnie dostępną nadwyżkę pojemności (capacity overage). Zamiast dławić, Fabric dolicza do rachunku zużycie ponad kupioną pojemność, do progu ustawionego przez administratora w oknie 24 godzin. Funkcja jest domyślnie włączona przy tworzeniu nowej pojemności, z progiem 25%. Nadwyżka jest rozliczana według stawki zależnej od ceny pay-as-you-go i nie obejmuje jej rabat z rezerwacji, więc przy regularnych przekroczeniach taniej wychodzi większa pojemność. Po wyłączeniu nadwyżki wraca zwykłe dławienie.
Dwie praktyczne rady na start. Po pierwsze, zużycie i ewentualne dławienie śledź w aplikacji Capacity Metrics, a nie na wyczucie. Po drugie, wstrzymanie przeciążonej pojemności od razu kończy dławienie i przywraca ją do zdrowego stanu, ale zaległe zużycie trafia wtedy na fakturę. To dobra awaryjna opcja, ale nie sposób na codzienną pracę.
Większość problemów, na które trafia się w pierwszych dniach z Fabric, wynika z małej pojemności próbnej i z tego, że kilka elementów korzysta z jednego Sparka. Poniżej te, które spotkaliśmy przy budowie przykładu, razem z rozwiązaniem.
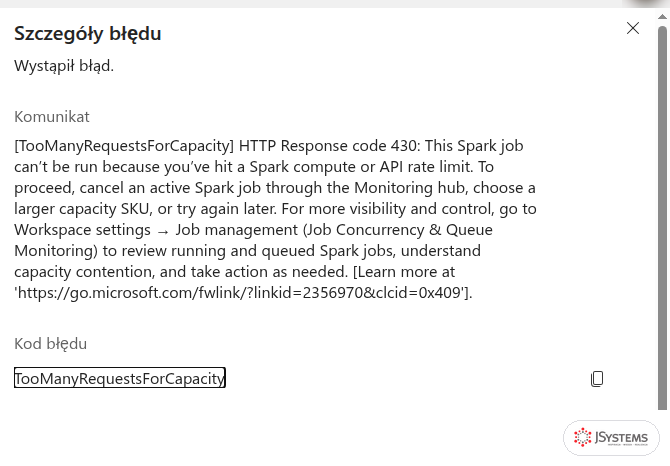
1. Błąd 430 TooManyRequestsForCapacity. Na pojemności 4 CU limit zadań Spark działających jednocześnie jest niski. Gdy jedna sesja notesu jeszcze działa, a uruchomisz „Załaduj do tabel” albo drugi notes, Fabric zwraca błąd 430 z informacją, że osiągnięto limit mocy obliczeniowej Spark albo częstotliwości wywołań API. Rozwiązanie: zatrzymaj zbędne sesje w monitorze albo poczekaj, aż poprzednie zadanie się skończy, i uruchom ponownie. Przy większej liczbie użytkowników trzeba myśleć o większej pojemności.
2. Zapomniana sesja Spark. Notes po wykonaniu ostatniej komórki nie kończy sesji od razu. Na dużej pojemności to drobiazg, na próbnej blokuje kolejne zadania. Przyzwyczaj się do klikania „Zatrzymaj sesję” po skończonej pracy.
3. Copilot nieaktywny w wersji próbnej. To nie usterka konfiguracji: Copilot i agenci danych wymagają płatnej pojemności od F2. Jeśli chcesz pokazać Copilota zespołowi, zaplanuj na to kilka godzin na wznowionej pojemności F2 i wstrzymaj ją po pokazie.
4. Wstrzymana pojemność to niedziałające elementy. Gdy pojemność jest wstrzymana, raporty, modele, notesy i dublowanie w przypisanych do niej obszarach przestają działać, a replikacja baz staje. Ustal w zespole, kto i kiedy może wstrzymywać pojemność, szczególnie produkcyjną.
5. Tabela docelowa w Eventstream. Jeśli tworzenie nowej tabeli w konfiguracji miejsca docelowego Eventhouse się nie powiedzie, utwórz ją poleceniem .create table w bazie KQL, tak jak w części 6, i wybierz z listy gotową tabelę.
6. Asystent kopiowania w potoku. Gdy potrzebujesz jednego kopiowania jako kroku potoku, prościej dodać na kanwie działanie „Kopiuj dane” i ustawić źródło oraz cel ręcznie, niż korzystać z asystenta, który może utworzyć osobny element „Kopiuj zadanie”.
7. Koniec wersji próbnej. Wersja próbna trwa 60 dni, a po jej końcu elementy są przechowywane jeszcze 7 dni. Zapisz w kalendarzu datę końca i zdecyduj wcześniej, czy obszar przechodzi na płatną pojemność.
8. Region pojemności. Region wybierasz przy tworzeniu pojemności i od niego zależy, gdzie fizycznie leżą dane obszarów. Dla firm z Polski naturalnym wyborem jest Poland Central, który obsługuje wszystkie obciążenia Fabric.
Fabric nie jest jedyną platformą danych w chmurze, a w wielu firmach będzie działał obok innych. Najczęściej porównuje się go z Azure Databricks, Snowflake i Azure Synapse Analytics. Każda z tych platform ma inny punkt wyjścia, co dobrze tłumaczy różnice.
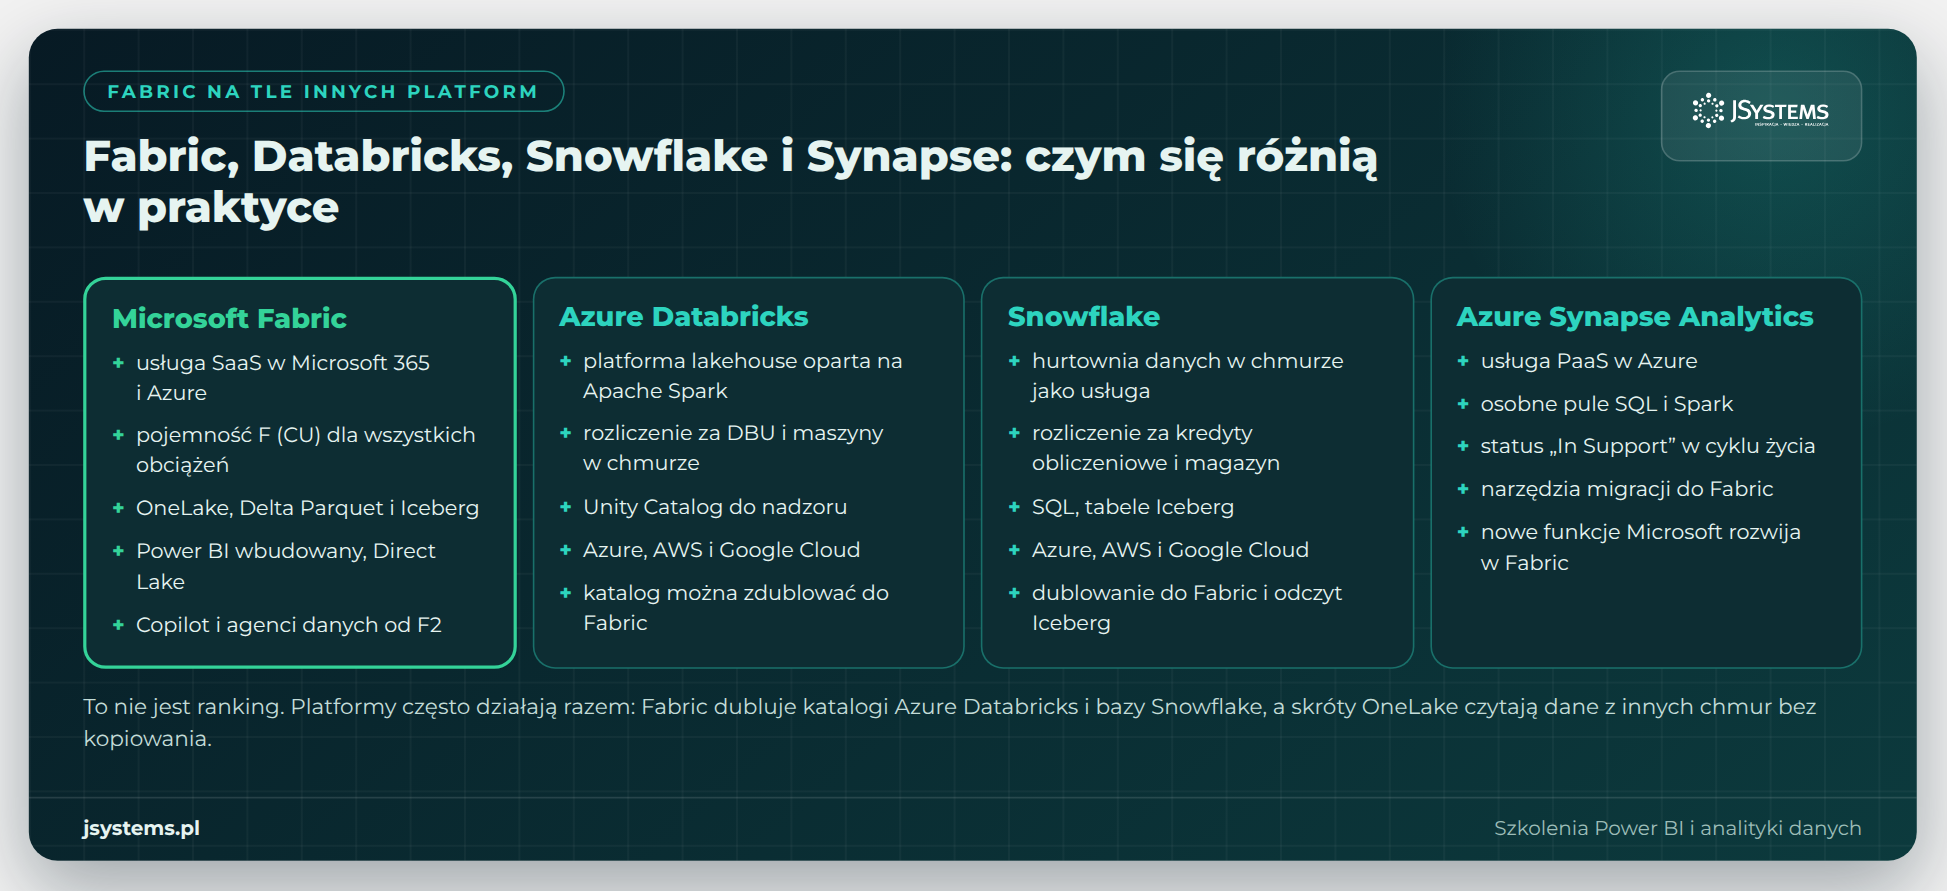
Fabric wyróżnia się przede wszystkim tym, że jest usługą SaaS wbudowaną w środowisko Microsoft 365 i Power BI. Nie trzeba łączyć kilku produktów, żeby dostać pobieranie danych, jezioro, hurtownię, analizę czasu rzeczywistego i raporty, a jedna pojemność obejmuje wszystko. Dla firm, które już pracują w Microsoft 365 i mają raporty w Power BI, to zwykle najkrótsza droga do porządnej platformy danych.
Integracja działa w obie strony. W Fabric jest element „Dublowany katalog Azure Databricks”, który pokazuje tabele z Unity Catalog bez kopiowania, oraz dublowanie Snowflake i element „Baza danych usługi Snowflake”. Skróty OneLake czytają dane z ADLS Gen2, Amazon S3 i Google Cloud, a tabele zapisane w formacie Delta albo Iceberg mogą czytać silniki spoza Microsoftu. Wybór nie musi więc oznaczać rezygnacji z platformy, którą firma już ma.
Jeśli interesuje Cię, jak doszliśmy do dzisiejszych platform, od Hadoopa i MapReduce przez Sparka, zajrzyj do naszego tekstu o historii big data od Hadoopa do Fabric oraz do artykułu Czym jest Apache Spark - kompletny przewodnik dla początkujących. Podstawowe pojęcia i cały krajobraz narzędzi, w którym Fabric jest jedną z platform, zebraliśmy w artykule Co to jest big data? Pojęcia, krajobraz technologiczny i platformy.
Fabric nie jest obowiązkowym następcą Power BI. Wiele firm przez lata dobrze pracuje na samym Power BI Pro: kilka źródeł, Power Query, model, raporty i udostępnianie w usłudze. Fabric zaczyna się opłacać, gdy pojawiają się problemy, których sam Power BI nie rozwiązuje.
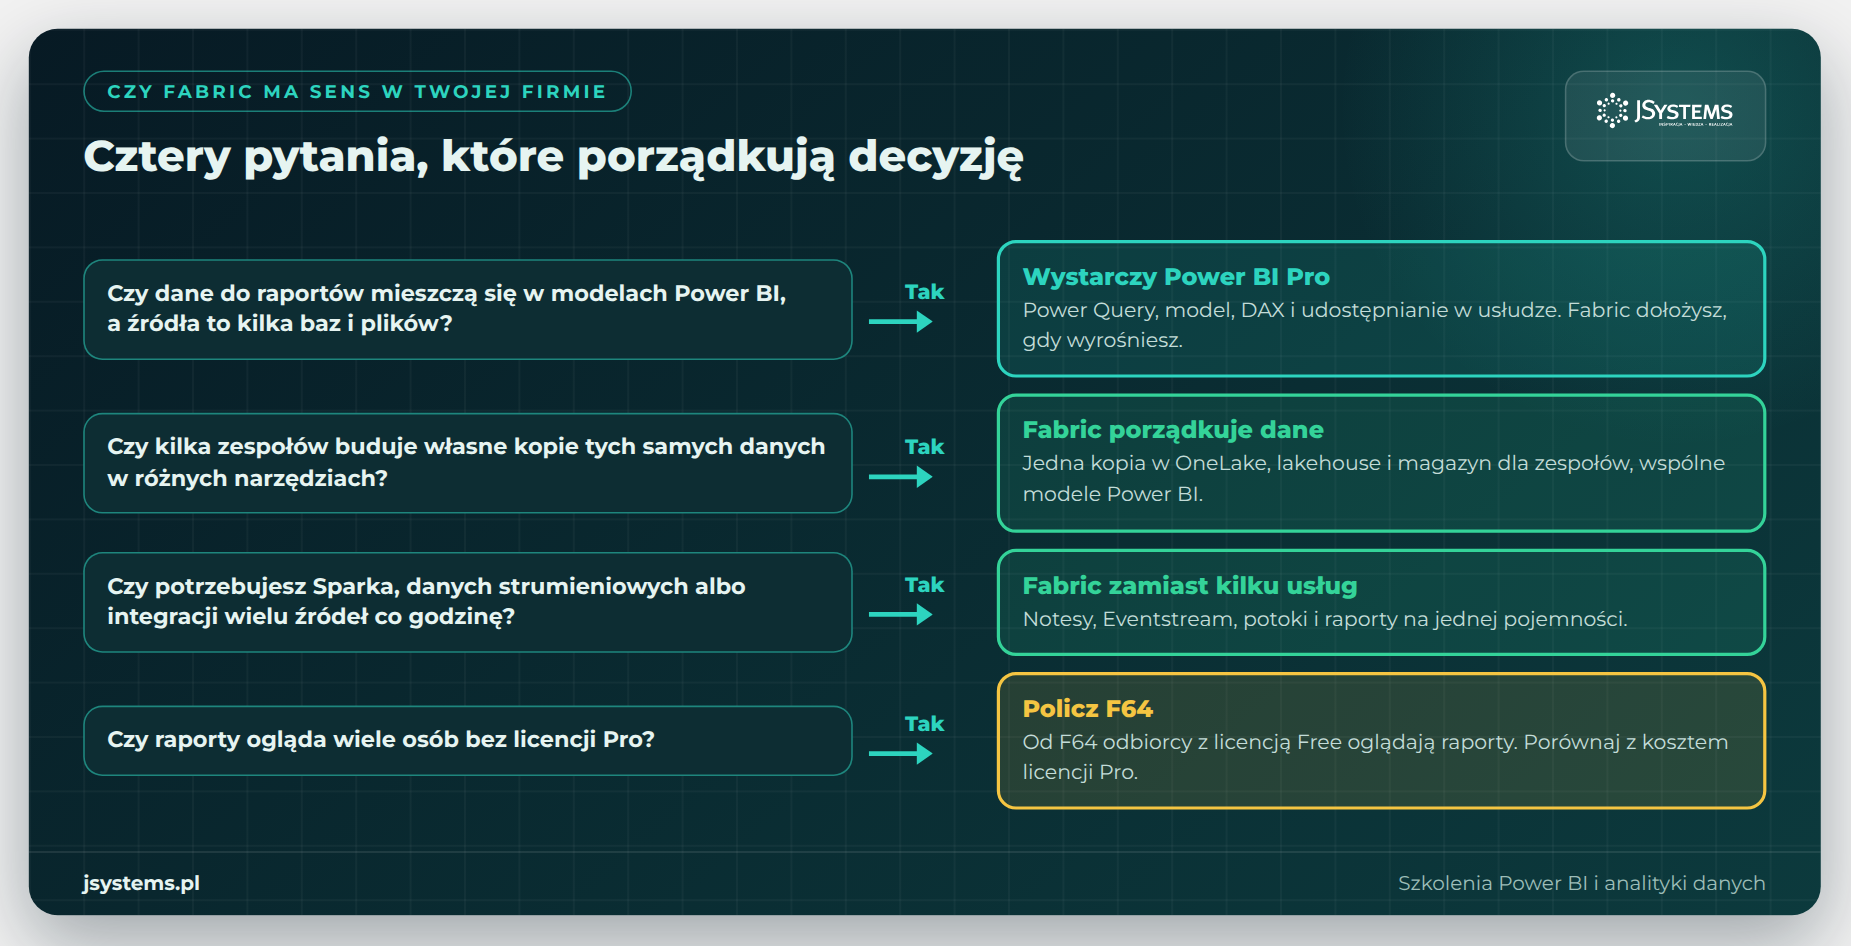
Wystarczy Power BI, gdy dane do raportów mieszczą się w modelach, źródłem jest kilka baz i plików, a odświeżenie kilka razy dziennie zaspokaja potrzeby. Dodanie Fabric w takiej sytuacji oznacza koszt pojemności bez wyraźnej korzyści.
Fabric ma sens, gdy:
Dobry sposób na decyzję to pilotaż na wersji próbnej, taki jak w tym przewodniku, ale na własnych danych: jeden obszar, jeden lakehouse, jeden model Direct Lake i jeden potok. Pomiar zużycia CU w trakcie pilotażu pozwala potem dobrać rozmiar pojemności na podstawie danych, a nie szacunków.
Fabric jest szeroki, ale nie trzeba znać wszystkich obciążeń, żeby zacząć z niego korzystać. Kolejność nauki zależy od punktu startu. Dla osoby, która dziś buduje raporty w Power BI, naturalna ścieżka prowadzi od tego, co już zna, do kolejnych warstw platformy.
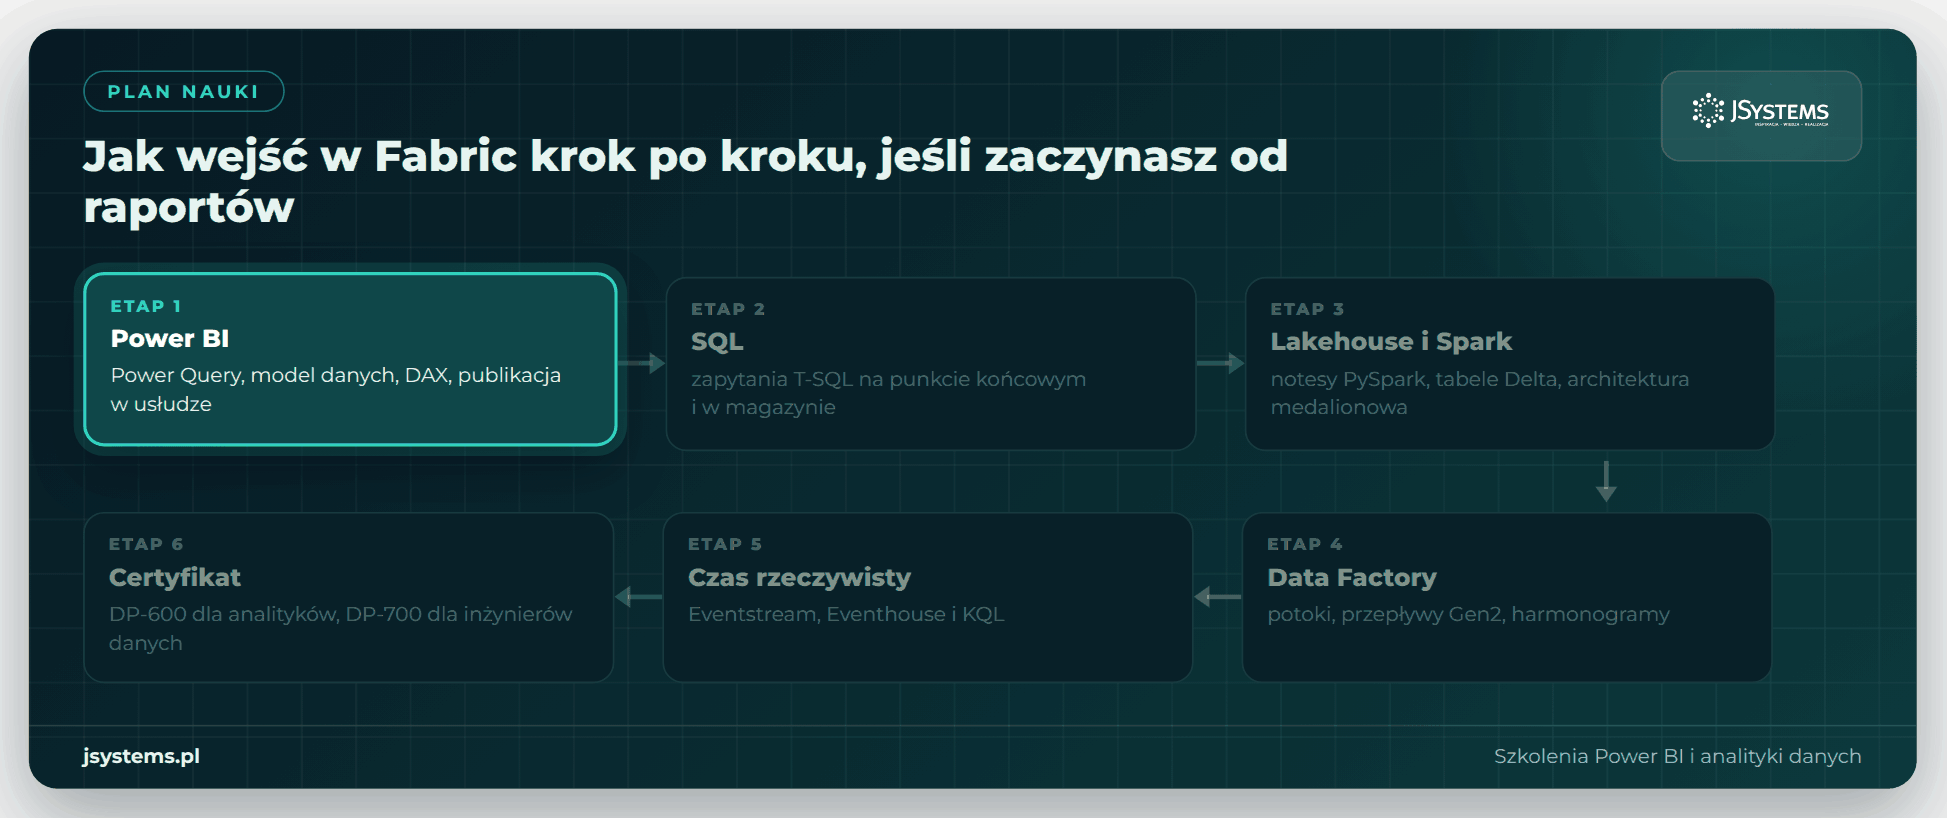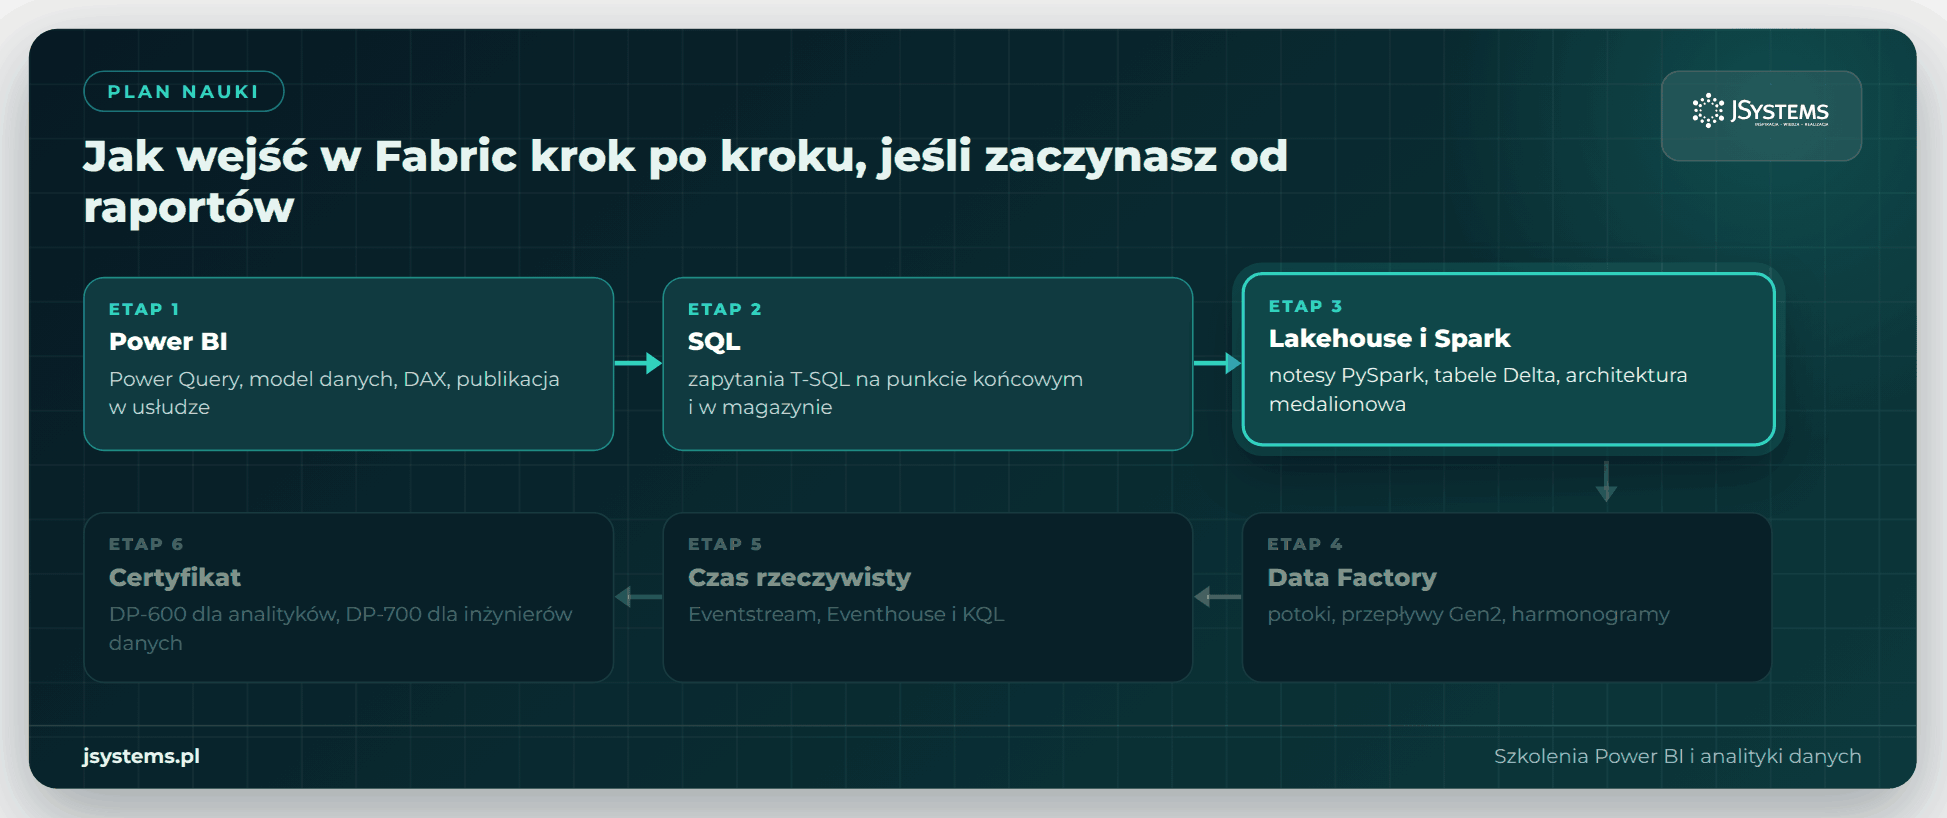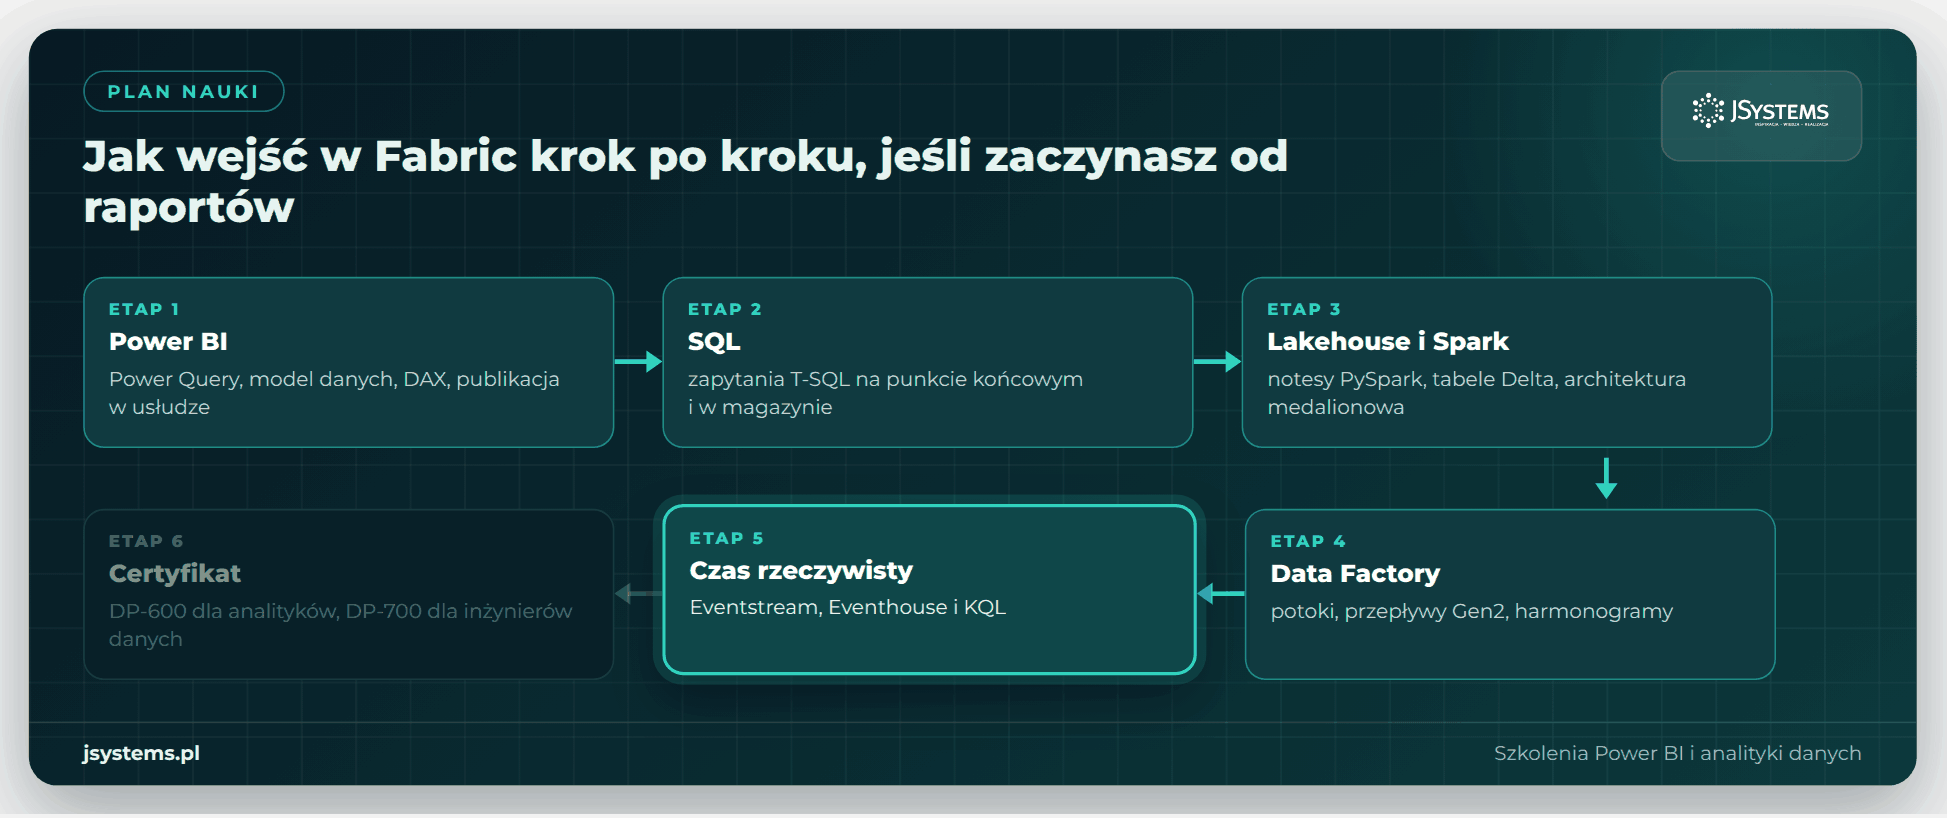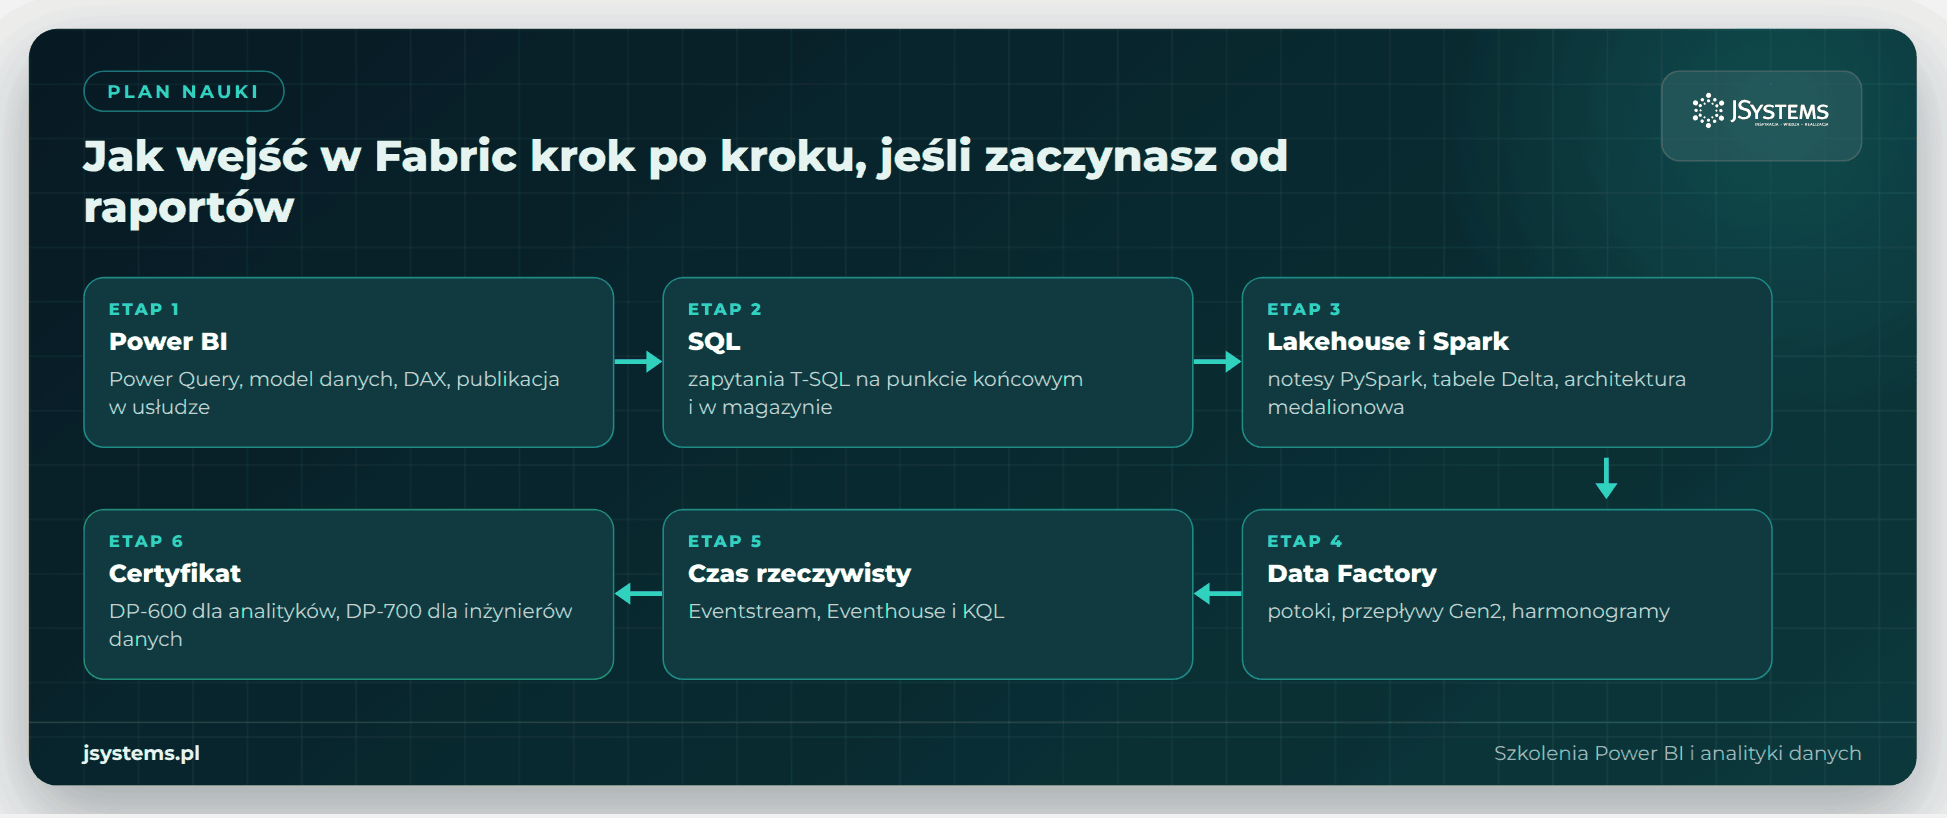
SELECT z grupowaniem i złączeniami wystarczą, żeby korzystać z punktu końcowego SQL i magazynu.| Egzamin | Certyfikat | Dla kogo |
|---|---|---|
| DP-600 | Microsoft Certified: Fabric Analytics Engineer Associate | analitycy i twórcy modeli, którzy budują rozwiązania analityczne w Fabric |
| DP-700 | Microsoft Certified: Fabric Data Engineer Associate | inżynierowie danych: pozyskiwanie, przetwarzanie, potoki i czas rzeczywisty |
| PL-300 | Microsoft Certified: Power BI Data Analyst Associate | analitycy Power BI, dobry pierwszy krok przed DP-600 |
Wszystkie trzy certyfikaty mają poziom średniozaawansowany (Intermediate) i trzeba je odnawiać co roku, ale odnowienie to bezpłatny test online w Microsoft Learn. Egzaminy dotyczą głównie funkcji ogólnie dostępnych, choć mogą zawierać pytania o często używane funkcje w wersji zapoznawczej.
Najszybciej uczy się na własnych danych, ale do pierwszych prób przydają się gotowe. Pliki z tego przewodnika są do pobrania na początku artykułu, a cały przykład mieści się w bezpłatnej wersji próbnej.
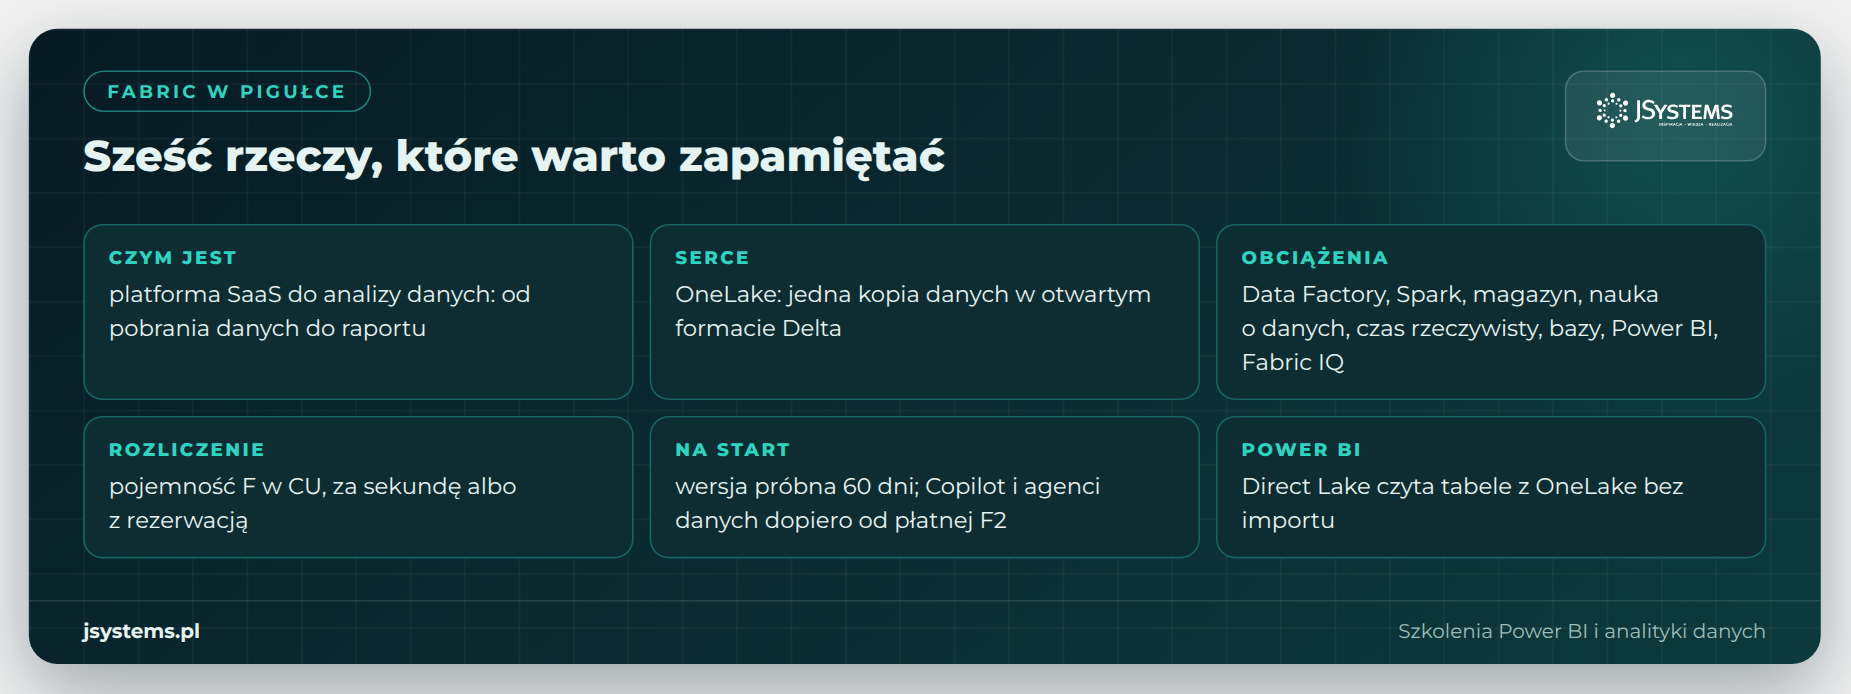
Microsoft Fabric porządkuje to, co w wielu firmach jest dziś rozrzucone po kilku usługach: pobieranie danych, jezioro, hurtownię, analizę danych w ruchu i raporty. Wszystko działa na jednej kopii danych w OneLake i na jednej pojemności, a każdy zespół pracuje w języku, który zna, od PySparka przez T-SQL i KQL po DAX.
W części praktycznej przeszliśmy całą drogę na danych sieci Nordvella: od czterech plików CSV, przez warstwy brązową, srebrną i złotą w lakehouse, zapytania T-SQL i tabelę w magazynie, po raport Power BI w trybie Direct Lake z sumą 456,20 mln zł, potok uruchamiany codziennie o 6:00 i pulpit z transakcjami z kas na żywo. Całość zmieściła się w bezpłatnej wersji próbnej, więc najlepszym kolejnym krokiem jest powtórzenie tych kroków na własnym obszarze roboczym, a potem na danych z własnej firmy.
Komentarze (0)
Brak komentarzy...