Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
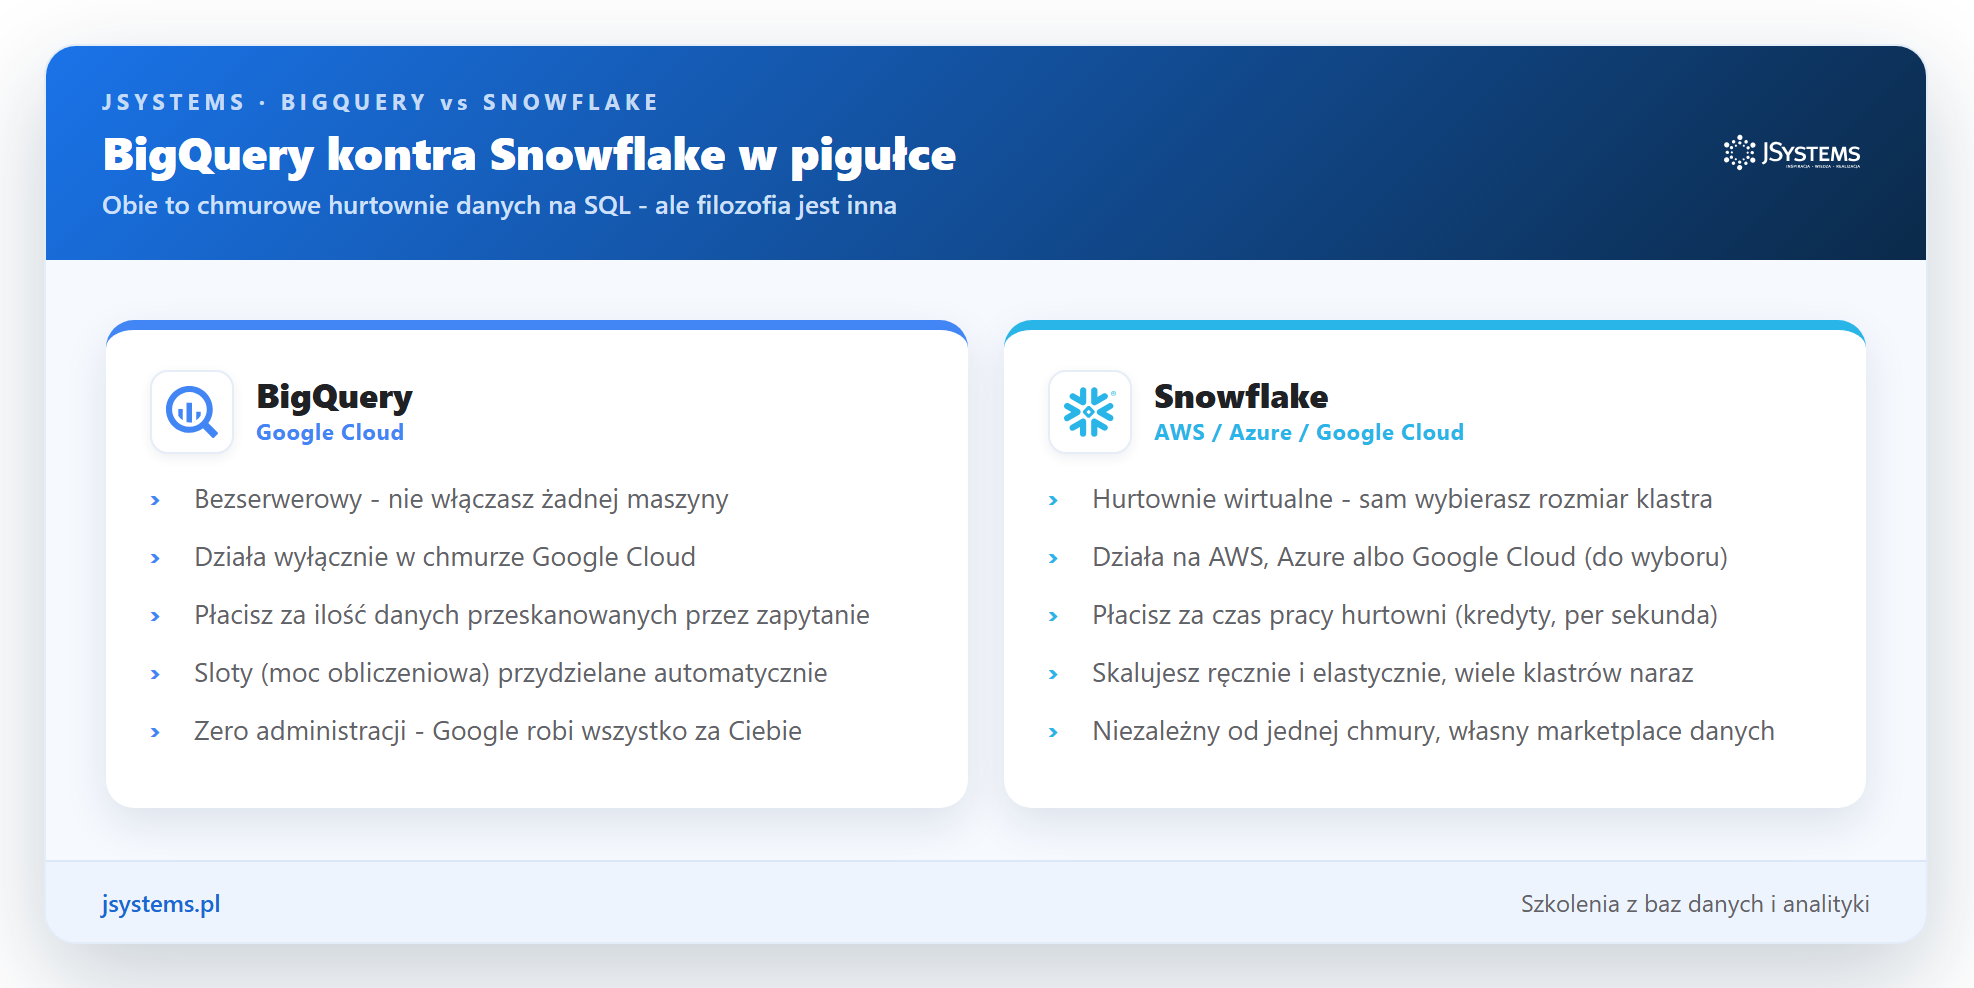
Jeśli szukasz chmurowej hurtowni danych, prędzej czy później staniesz przed pytaniem: BigQuery czy Snowflake? Obie nazwy słychać w tym samym zdaniu, obie robią pozornie to samo - trzymają ogromne ilości danych i pozwalają je analizować zwykłym SQL. A jednak różnią się w sposobie, który realnie wpływa na rachunek i na to, jak się z nimi pracuje. W tym artykule przeprowadzimy Cię przez te różnice bez marketingu: pokażemy, jak każde z nich liczy zapytanie, ile kosztuje i kiedy wybrać które - a wszystko na zrzutach z obu konsol.
Z tego artykułu dowiesz się:
Zanim wypunktujemy różnice, warto zobaczyć, jak wiele te dwa narzędzia łączy - bo to tłumaczy, czemu tak często są zestawiane. Oba są chmurowymi hurtowniami danych. Hurtownia danych (po angielsku data warehouse) to szczególny rodzaj bazy zaprojektowany nie do obsługi aplikacji, lecz do analizy: liczenia sum, średnich, trendów i raportów na wielkich zbiorach. Fachowo mówi się o pracy w trybie OLAP (przetwarzanie analityczne) w odróżnieniu od zwykłych baz transakcyjnych.
Poza tym oba są kolumnowe (trzymają dane kolumnami, nie wierszami, więc zapytanie czyta z dysku tylko te kolumny, o które pyta), oba rozmawiają standardowym SQL i oba rozdzielają składowanie danych od mocy obliczeniowej - dane leżą tanio w jednym miejscu, a liczenie odbywa się osobno i skaluje niezależnie. Jeśli chcesz najpierw poznać każde z nich z osobna, opisaliśmy je w osobnych przewodnikach: czym jest BigQuery i jak działa hurtownia danych w chmurze oraz prosty przewodnik po Snowflake. Szerszy obraz całej układanki - hurtownie, jeziora danych i strumienie - znajdziesz w tekście o współczesnych rozwiązaniach Big Data.
Skoro tyle je łączy, gdzie tkwi różnica? Cała reszta artykułu to odpowiedź na to pytanie. Zaczniemy od najważniejszego - od tego, skąd biorą moc obliczeniową do liczenia Twoich zapytań.
To jest sedno całego porównania i różnica, z której wynika większość pozostałych. Chodzi o to, skąd bierze się moc, która przelicza Twoje zapytanie.
BigQuery jest bezserwerowy (po angielsku serverless). Nie ma tam nic, co włączasz. Piszesz zapytanie, klikasz Uruchom, a Google sam - na czas jego wykonania - dokłada moc z tysięcy maszyn i zwalnia ją, gdy skończysz. Te jednostki mocy nazywają się slotami, ale nie musisz o nich myśleć: przydzielane są automatycznie, w tle. Nie ma czego rozmiarować ani wyłączać.
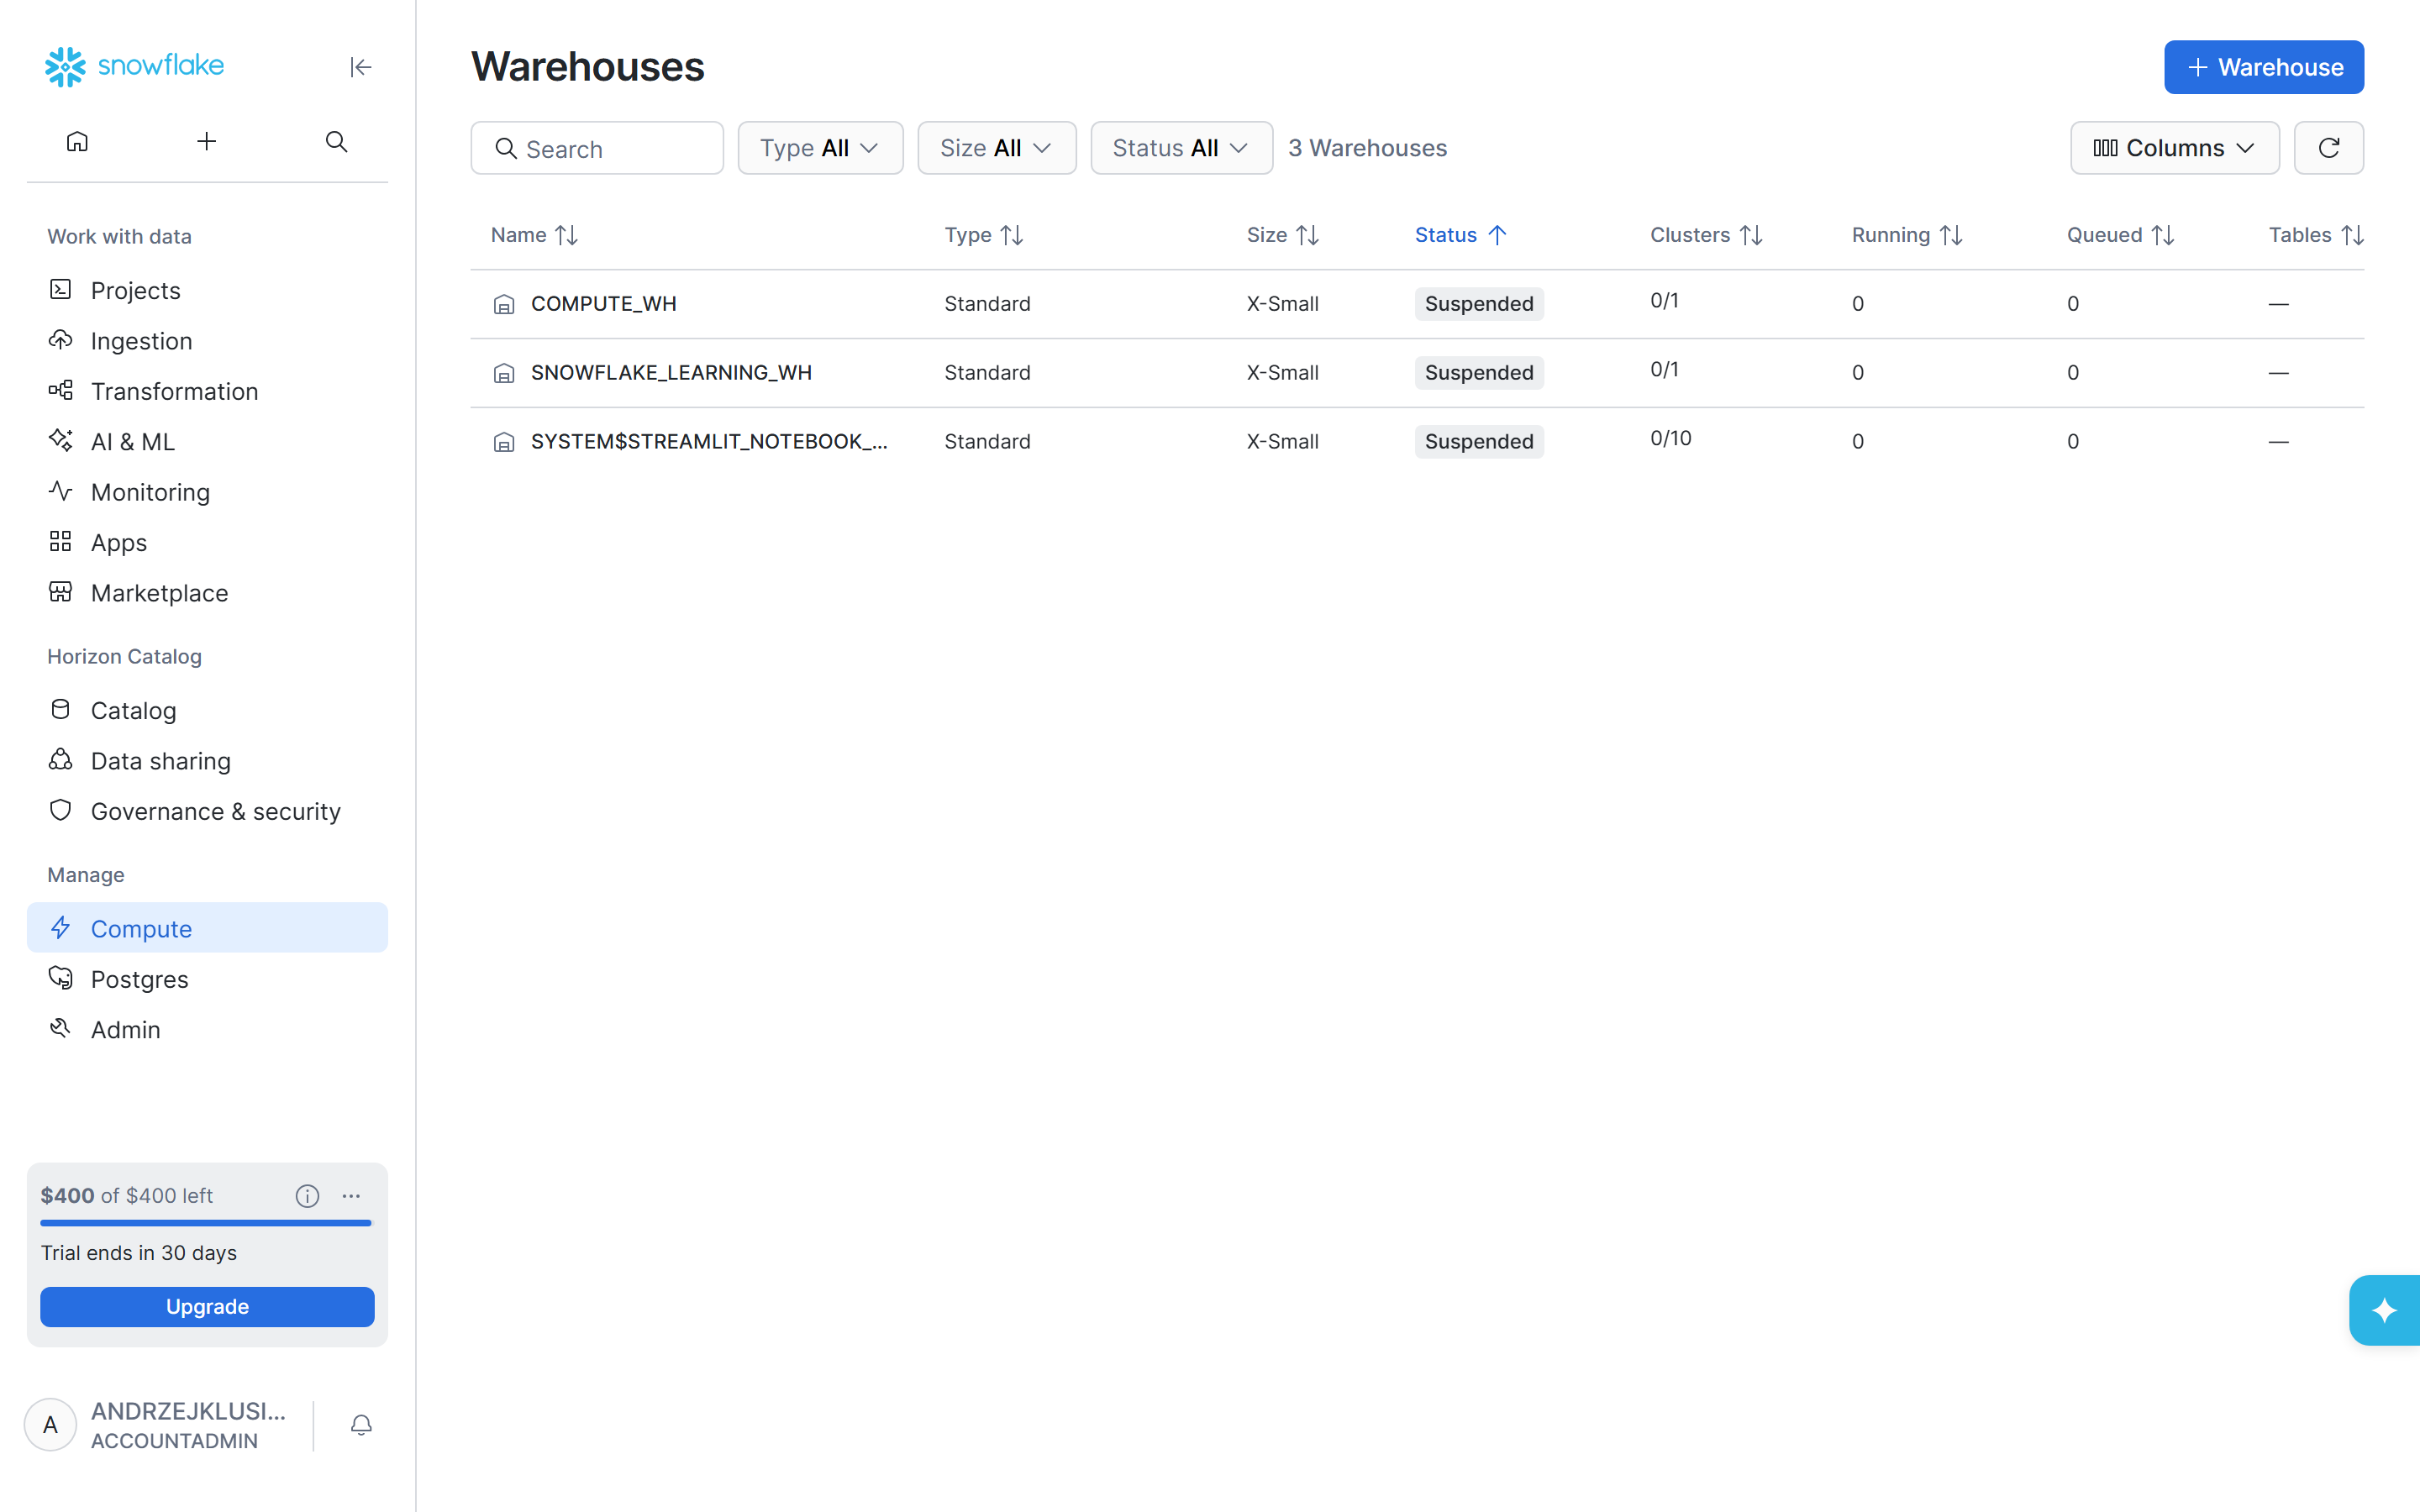
Snowflake idzie inną drogą - daje Ci hurtownie wirtualne (po angielsku virtual warehouses). Hurtownia wirtualna to klaster obliczeniowy, który sam włączasz i któremu sam nadajesz rozmiar - od najmniejszego X-Small, przez Small, Medium, aż po wielkie rozmiary. Większy klaster liczy szybciej, ale zużywa więcej mocy na godzinę. Na liście hurtowni widać to od razu: każda ma swój rozmiar i status (uśpiona albo uruchomiona):

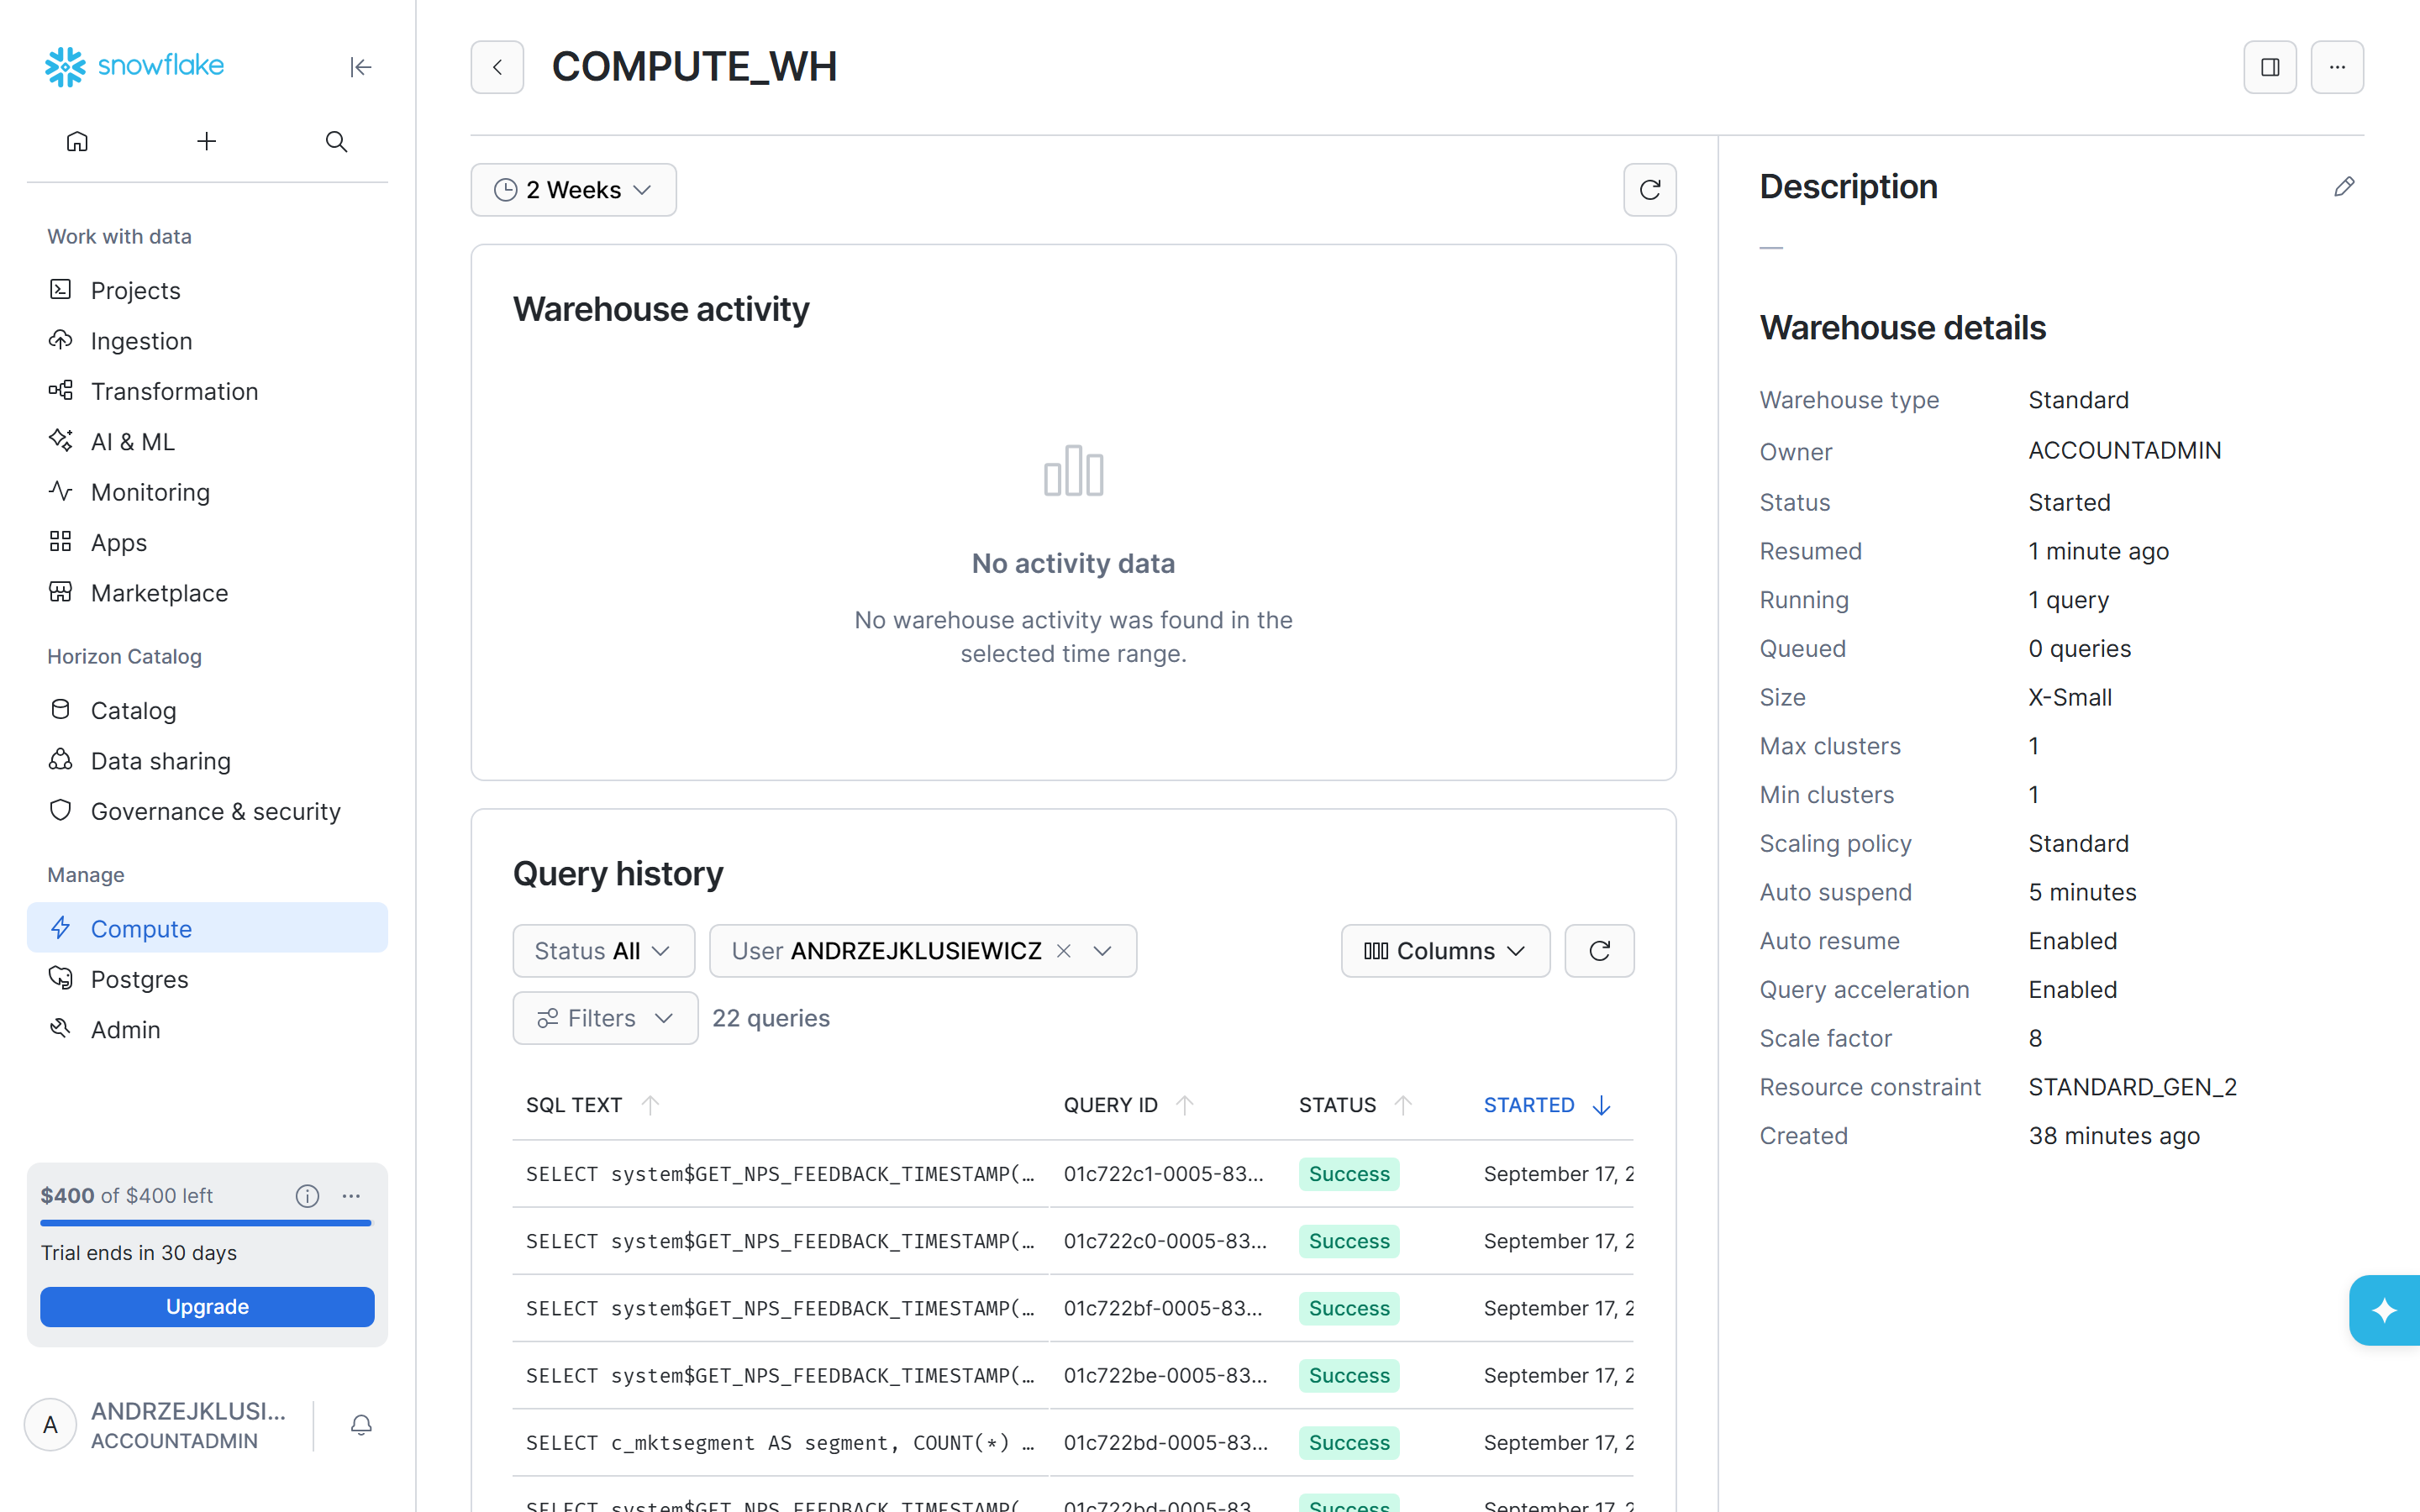
Po wejściu w konkretną hurtownię widać wszystkie pokrętła, którymi w Snowflake sterujesz: rozmiar, liczbę klastrów, a przede wszystkim automatyczne wyłączanie po bezczynności (auto-suspend) oraz automatyczne wznawianie przy pierwszym zapytaniu (auto-resume). To ważny szczegół kosztowy - o nim za chwilę.
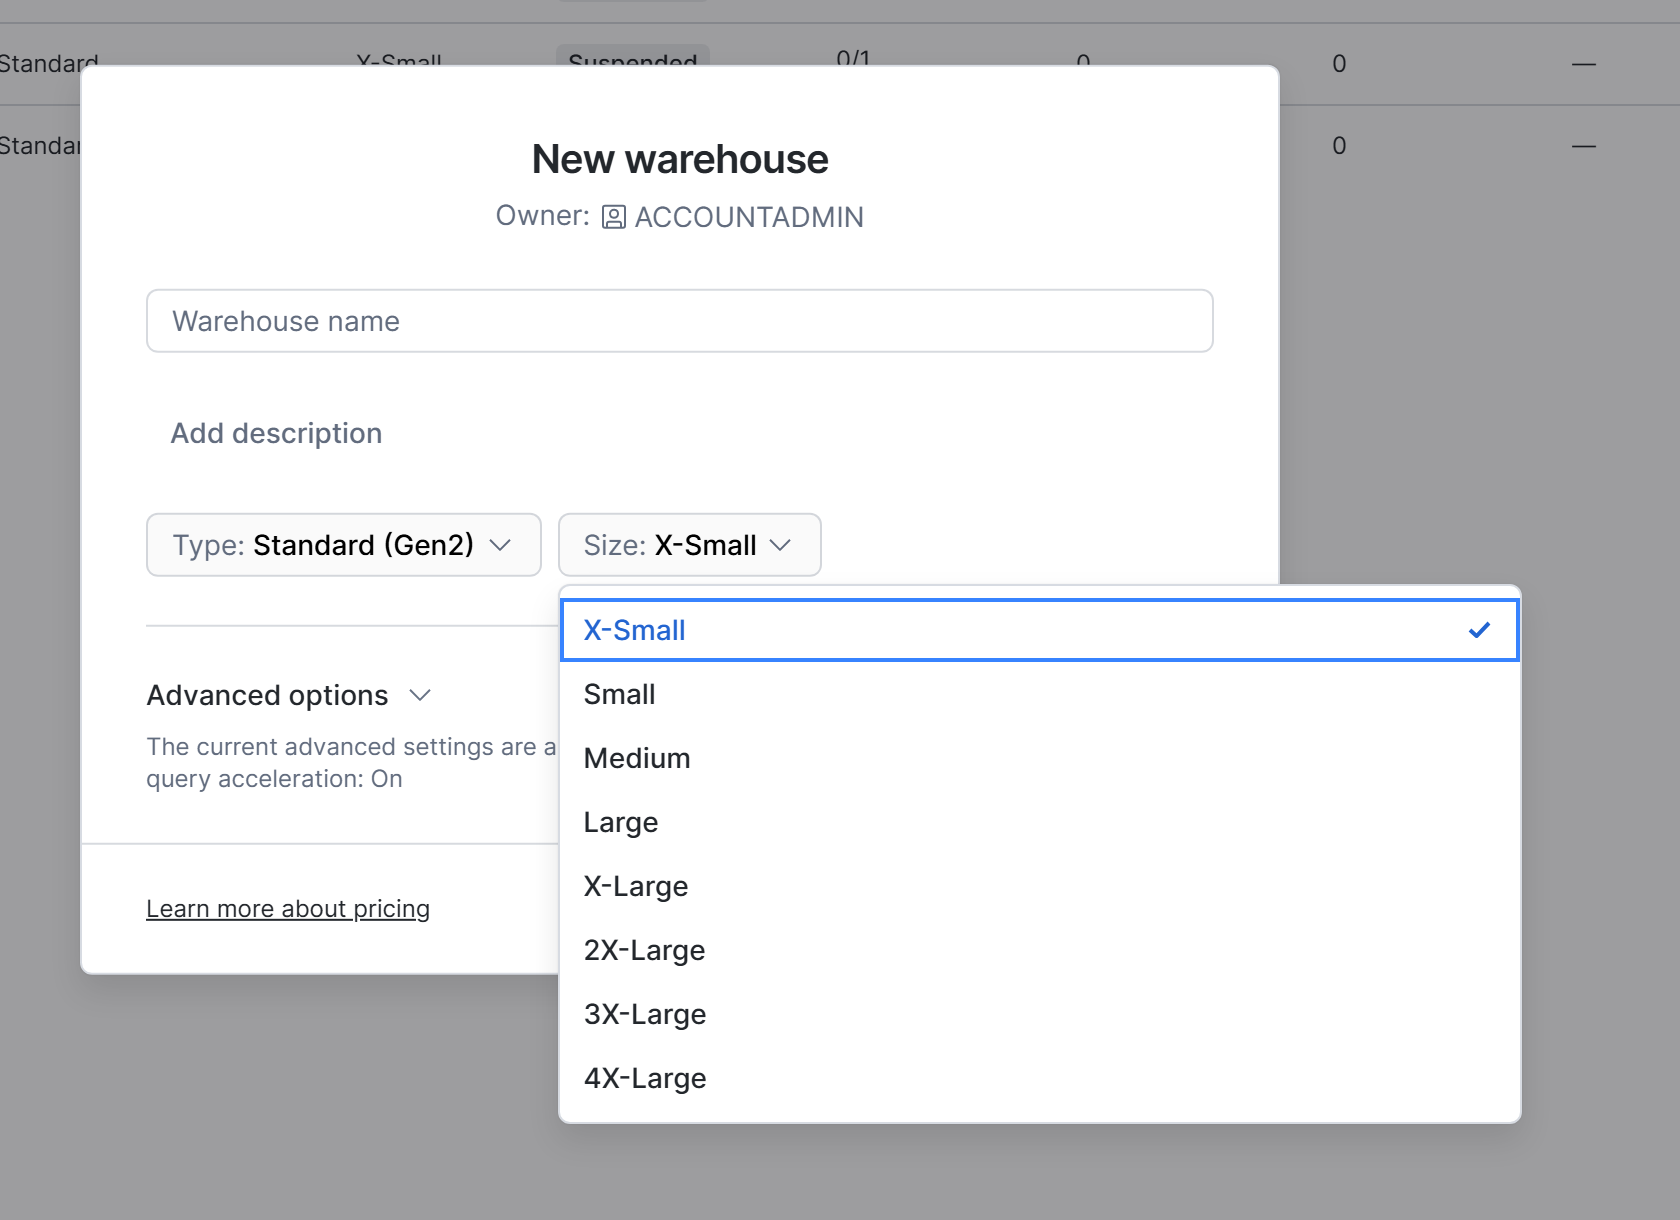
A gdy zakładasz nową hurtownię, jej rozmiar wybierasz wprost z listy - od X-Small po 4X-Large. To jedyne miejsce w całym porównaniu, w którym sam decydujesz o wielkości mocy obliczeniowej:
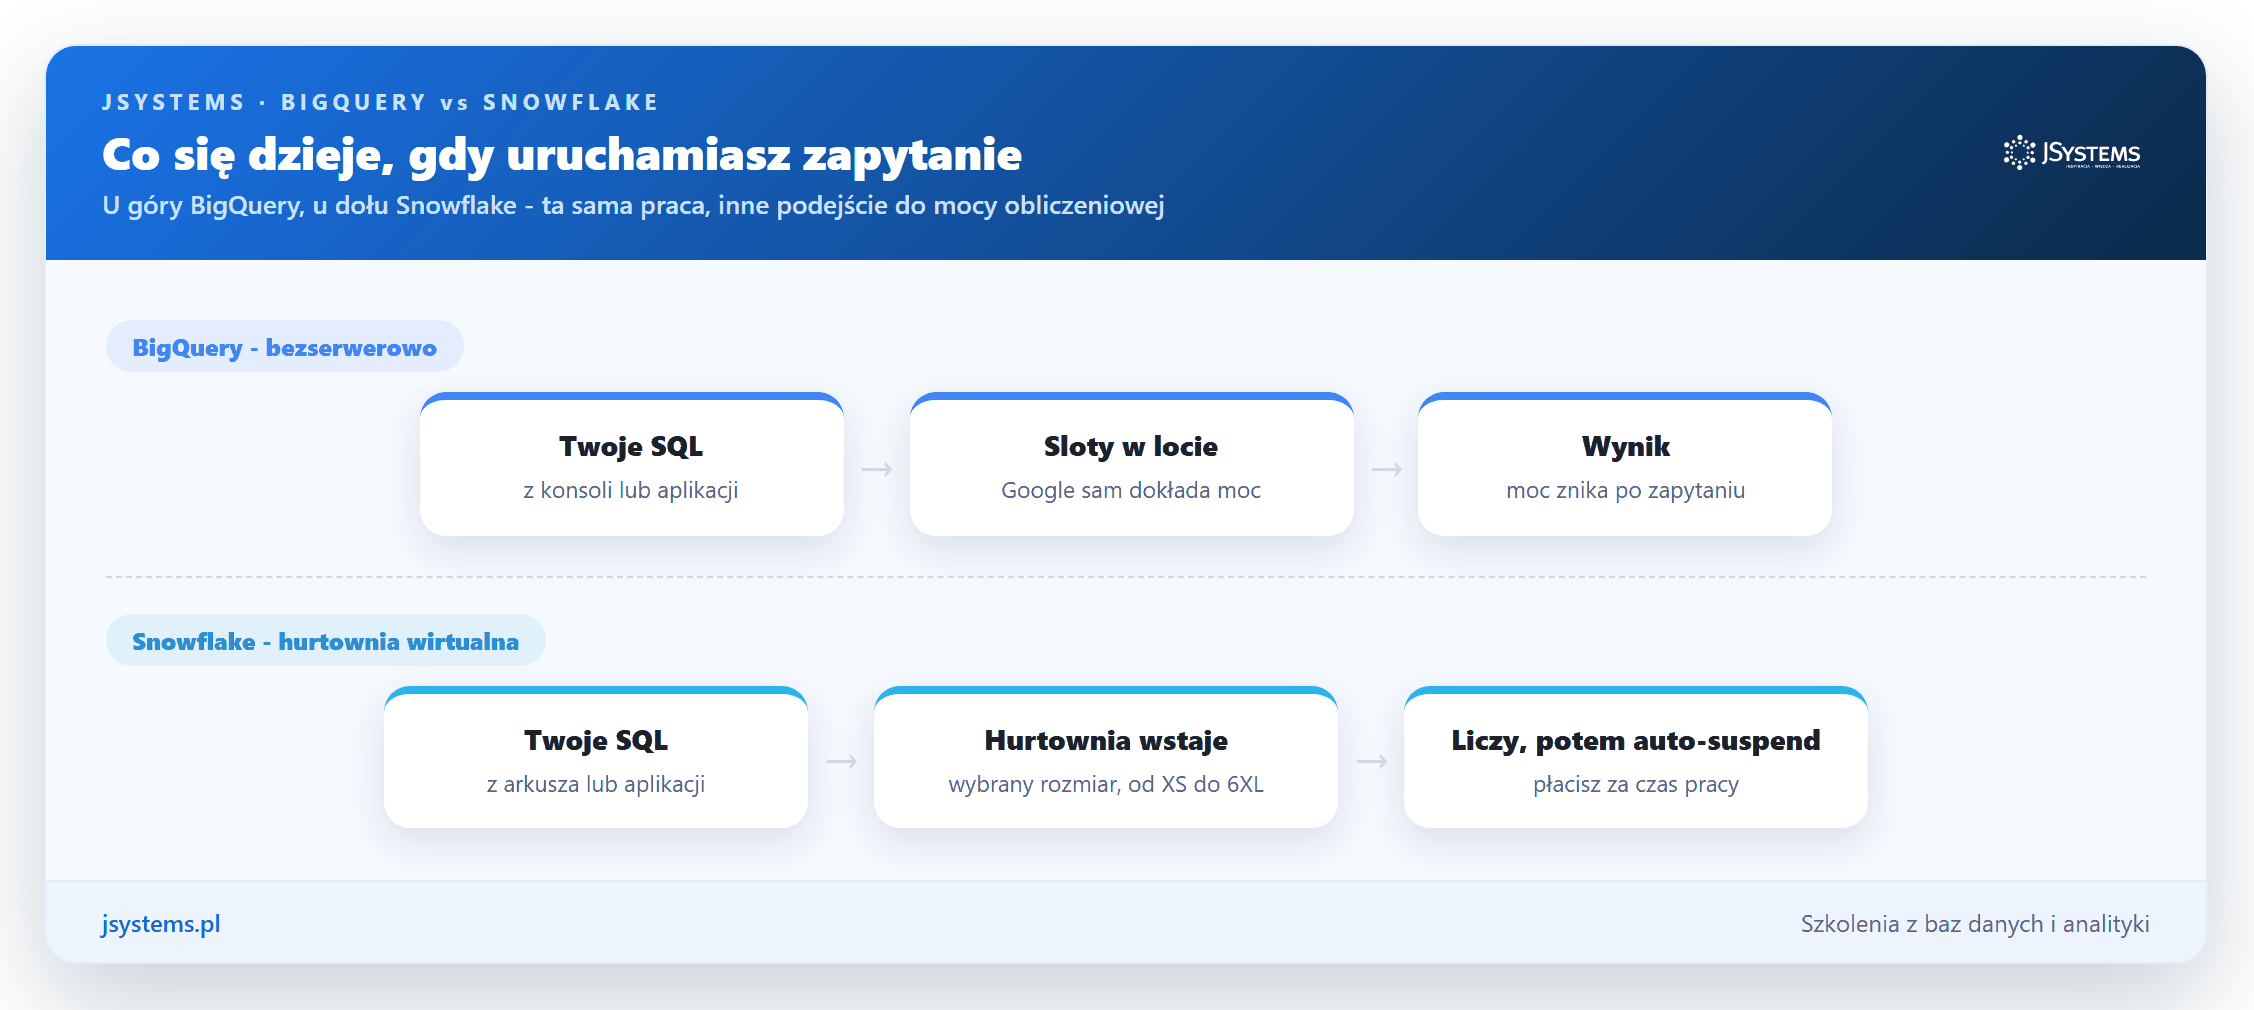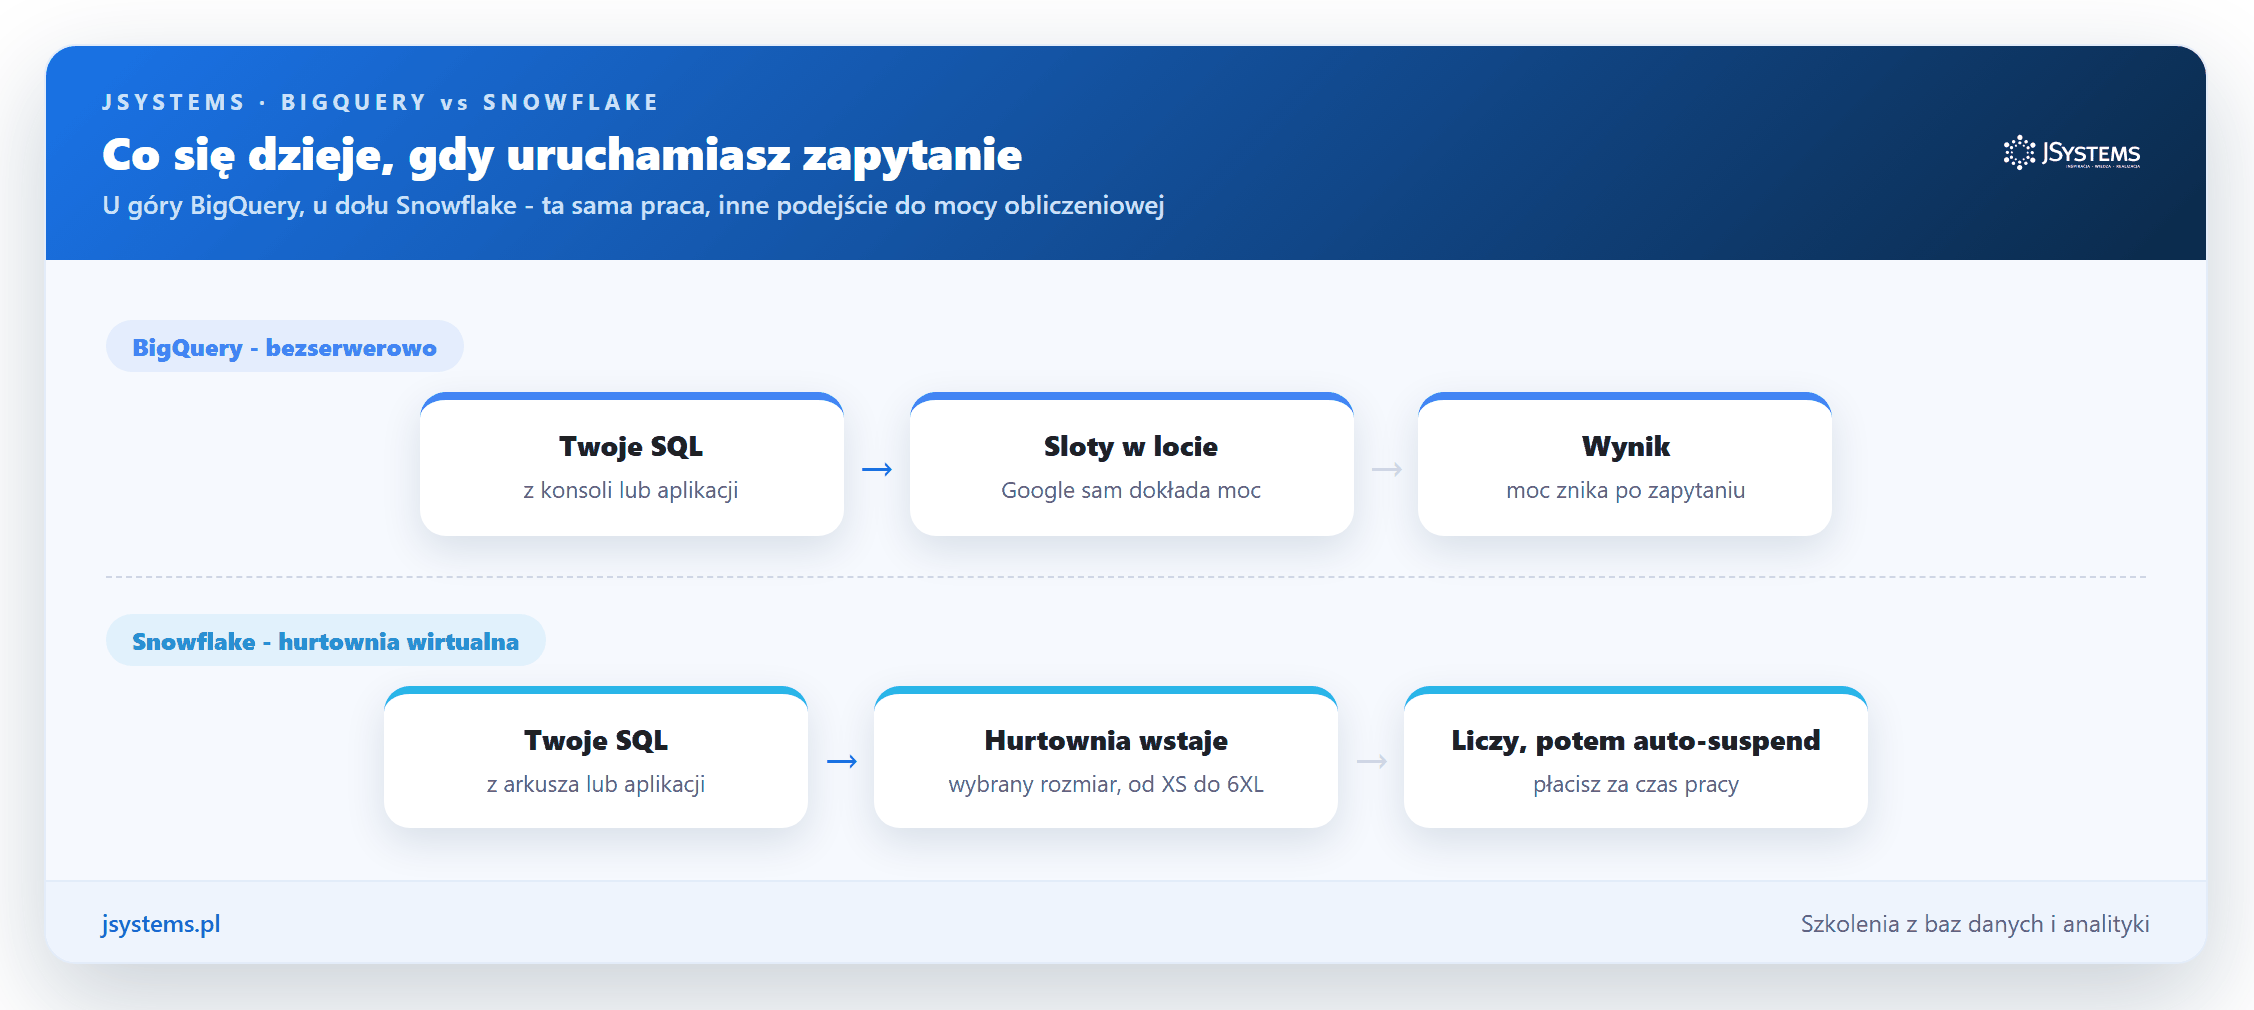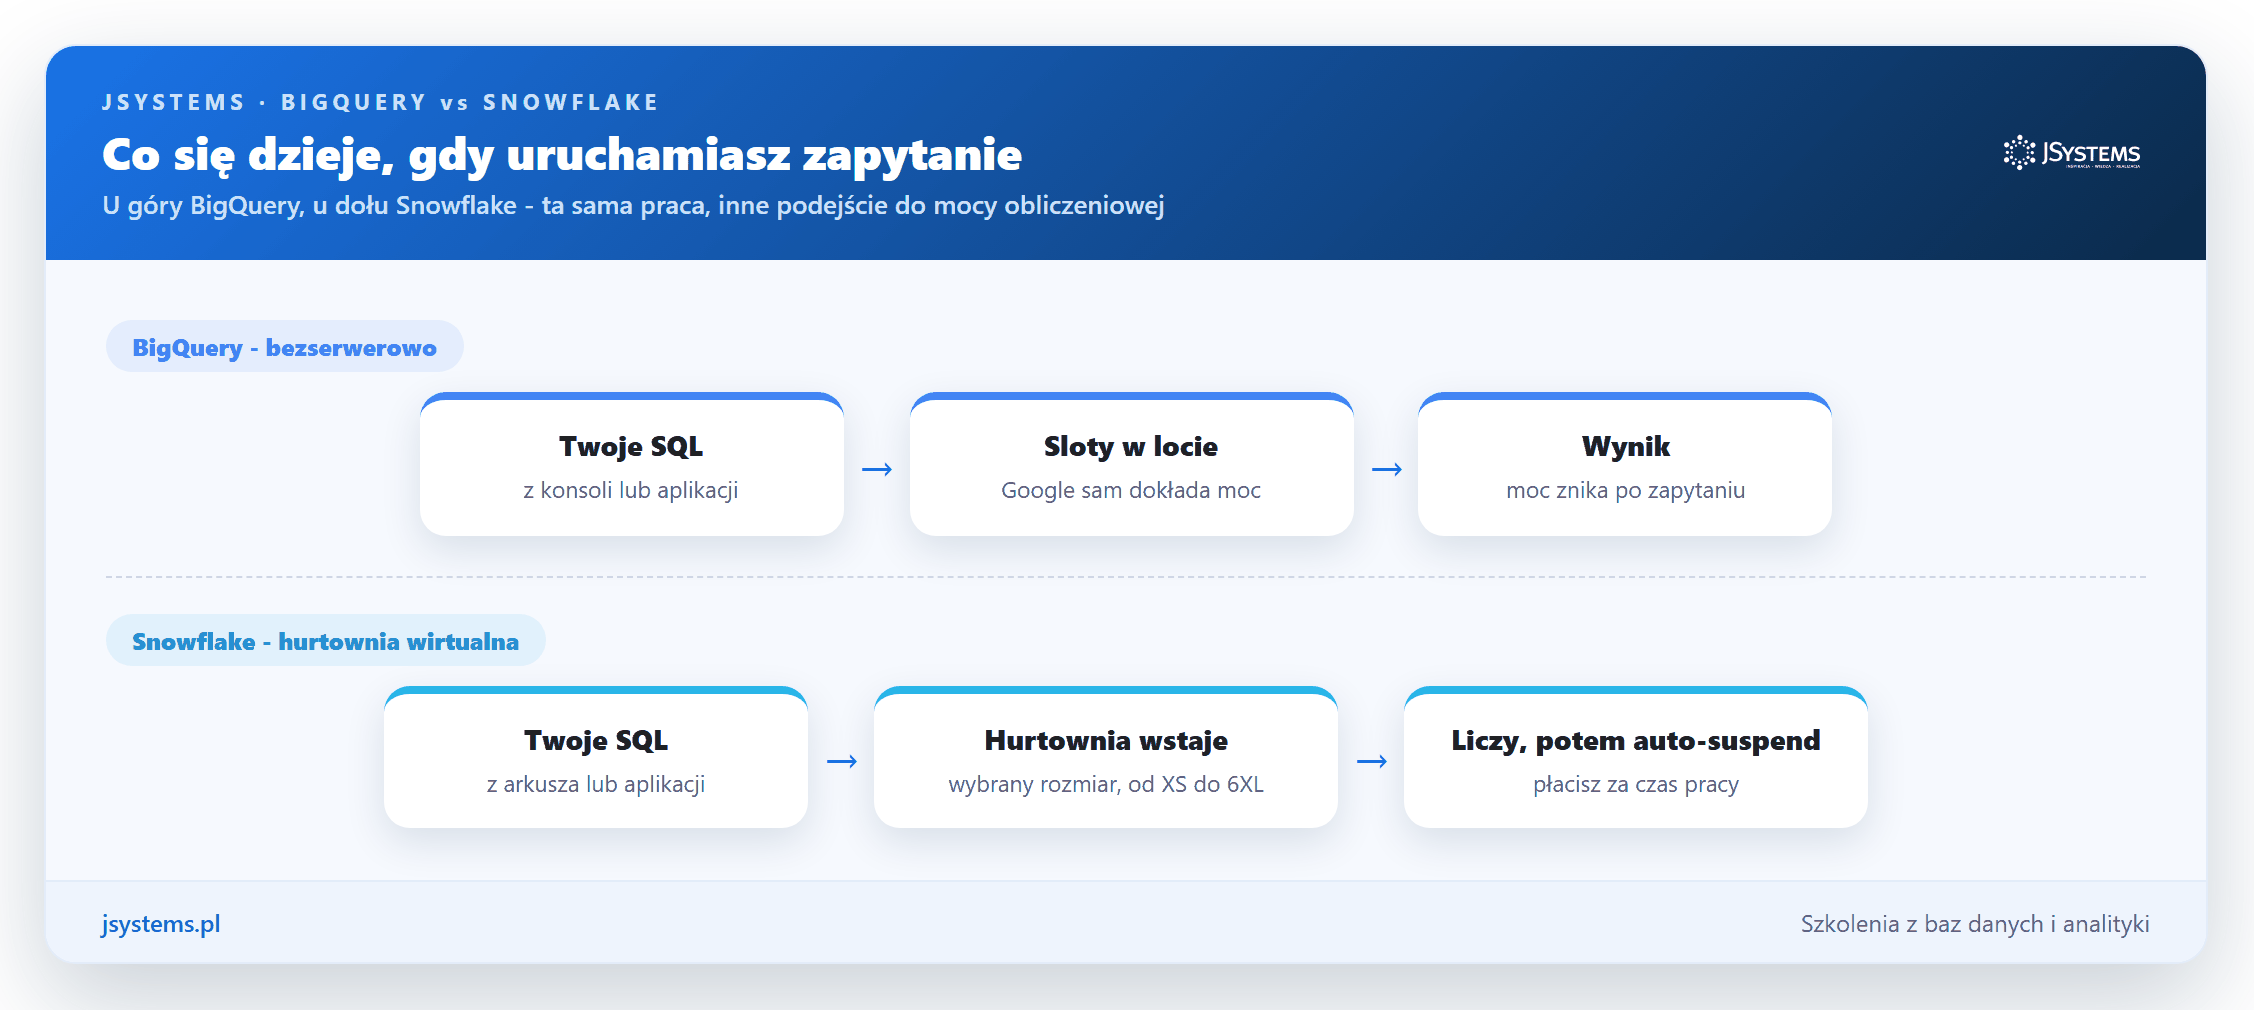
Najlepiej widać tę różnicę, gdy prześledzisz drogę jednego zapytania w obu narzędziach. U góry BigQuery: zapytanie po prostu dostaje moc w locie. U dołu Snowflake: hurtownia najpierw wstaje, liczy, a po chwili bezczynności sama się wyłącza:
Którą filozofię wolisz, to w dużej mierze kwestia tego, czy cenisz sobie zero zachodu (BigQuery), czy pełną kontrolę nad mocą i jej kosztem (Snowflake). Ta kontrola daje Snowflake jeszcze jedną, sztandarową zaletę - opisujemy ją zaraz.
Zobacz też: Szkolenie Przetwarzanie danych z użyciem Snowflake
Skoro w Snowflake sam tworzysz hurtownie, możesz mieć ich kilka naraz - i każda pracuje niezależnie na tych samych danych. To rozwiązuje bolączkę zwykłych baz, w których ciężki import albo ktoś liczący gigantyczny raport potrafi spowolnić wszystkich pozostałych. Fachowo mówi się o izolacji obciążeń (po angielsku workload isolation): różne rodzaje pracy nie wchodzą sobie w drogę, bo liczą je osobne klastry.
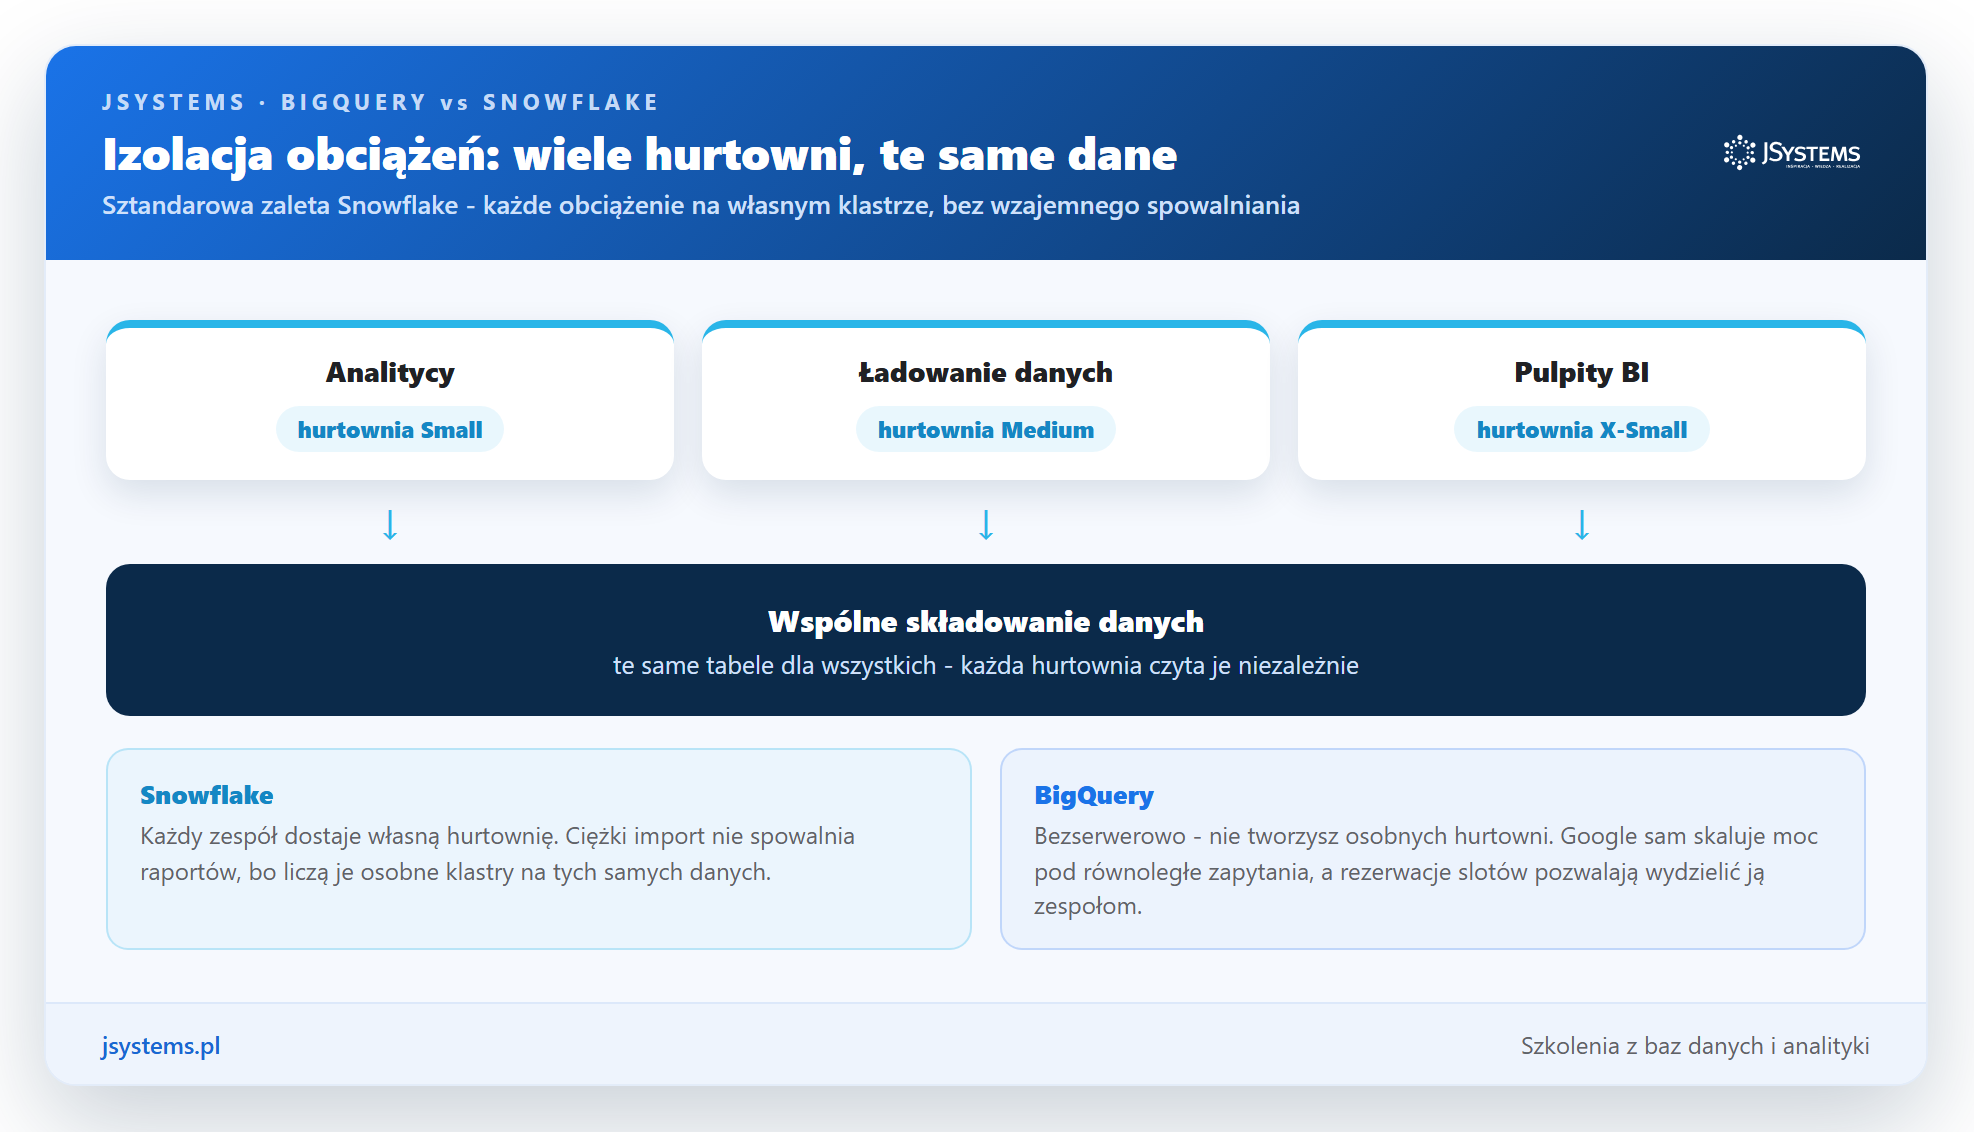
W praktyce wygląda to tak: zespół analityków dostaje swoją hurtownię, nocne ładowanie danych - swoją, a pulpity BI - jeszcze inną. Każda ma osobny rozmiar i osobny rachunek, więc od razu widać, kto ile mocy zużywa. BigQuery osiąga podobny efekt inną drogą: jest bezserwerowy, więc nie tworzysz osobnych hurtowni - Google sam skaluje moc pod równoległe zapytania, a gdy potrzebujesz gwarancji wydajności dla konkretnego zespołu, wydzielasz mu pulę slotów przez rezerwacje. Cel ten sam, mechanika inna.
Tu obie hurtownie są zaskakująco podobne, bo obie rozmawiają zwykłym SQL. Napiszmy to samo zapytanie w jednym i drugim - policzmy, ilu klientów przypada na każdy segment rynku w przykładowym zbiorze danych. Zapytanie jest dokładnie takie, jakie napisałbyś w dowolnej innej bazie:
SELECT c_mktsegment AS segment,
       COUNT(*) AS customers,
       ROUND(AVG(c_acctbal), 2) AS avg_balance
FROM snowflake_sample_data.tpch_sf1.customer
GROUP BY c_mktsegment
ORDER BY customers DESC;
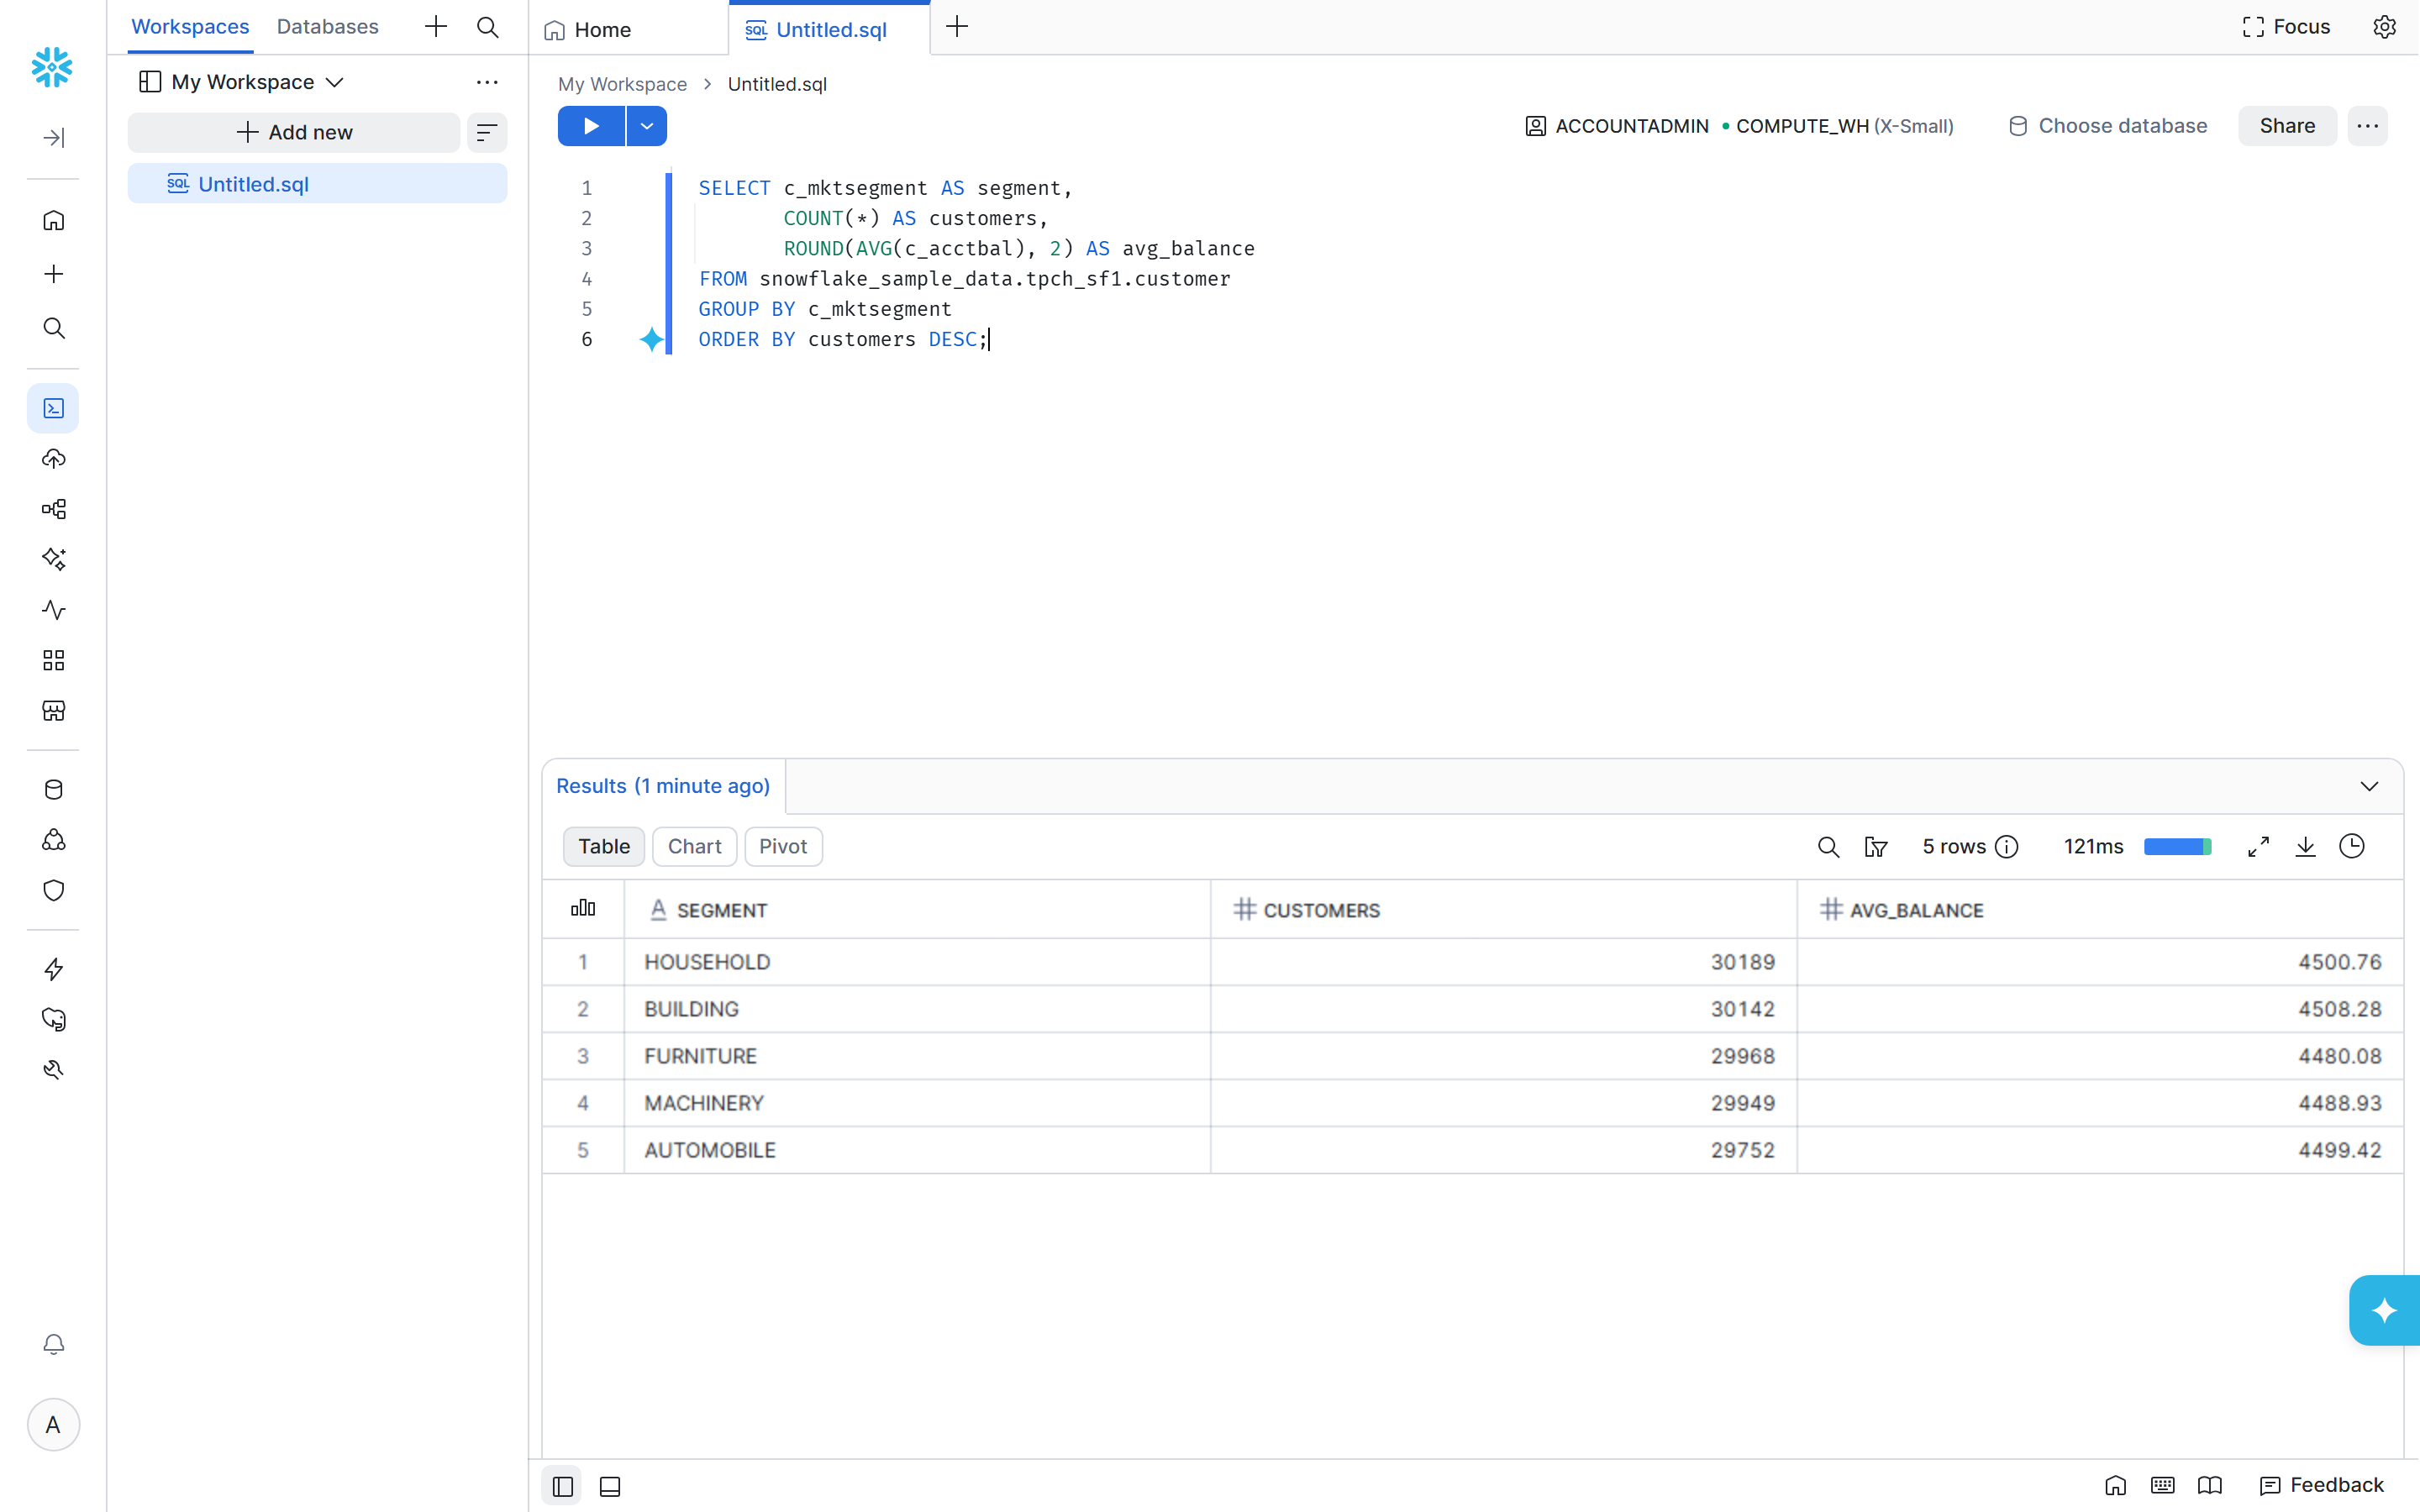
W Snowflake wpisujesz je do arkusza, wybierasz hurtownię, która ma je policzyć, i klikasz Uruchom. Wynik pojawia się pod spodem jako tabela - tutaj w ułamku sekundy, mimo że zbiór ma 150 tysięcy wierszy:
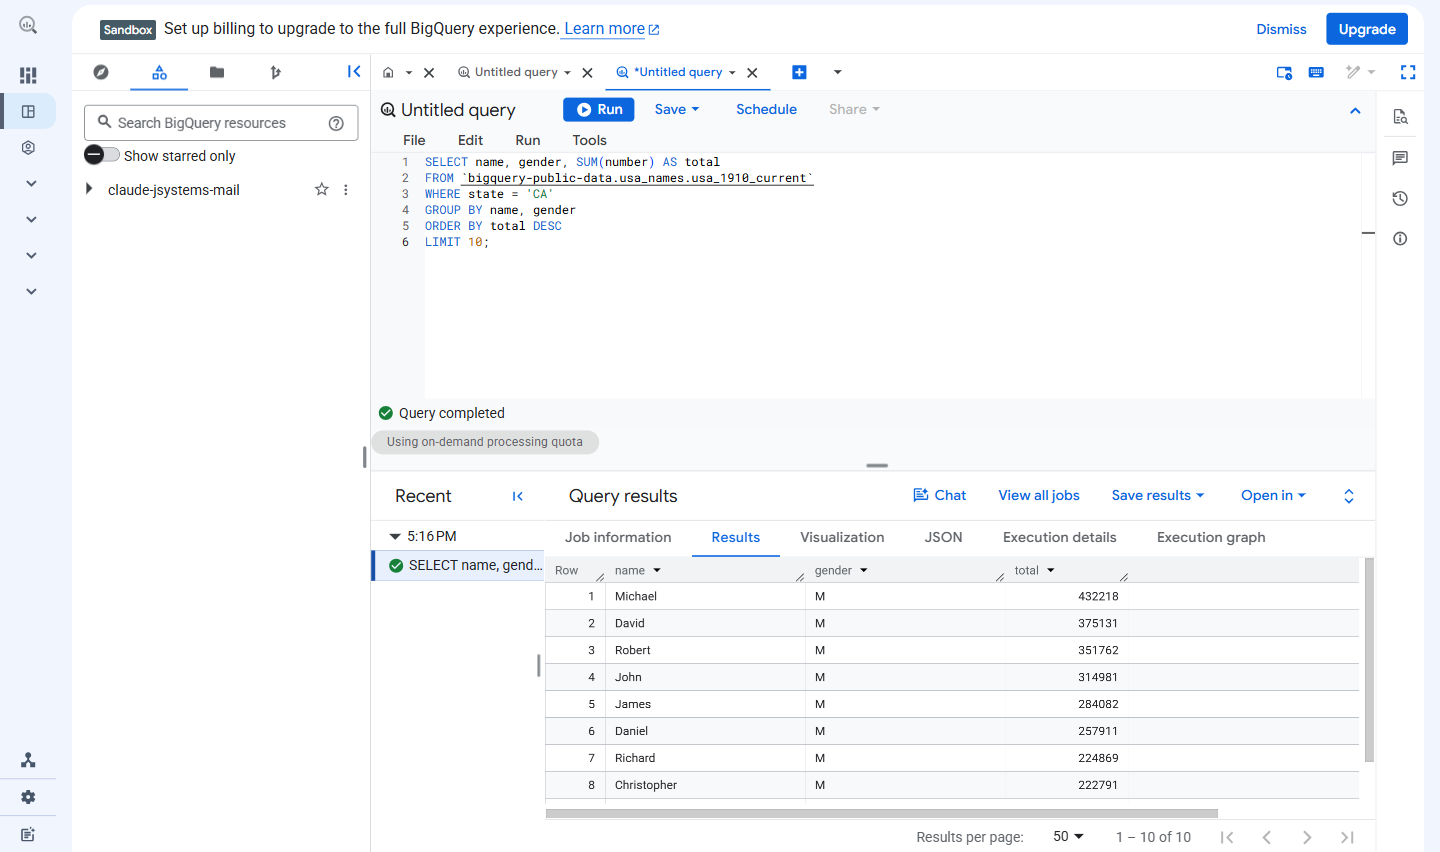
W BigQuery ta sama historia wygląda niemal tak samo: edytor z zapytaniem, przycisk Uruchom, tabela wyników pod spodem. Nie ma tu jednak wyboru hurtowni, bo moc dokłada się sama:
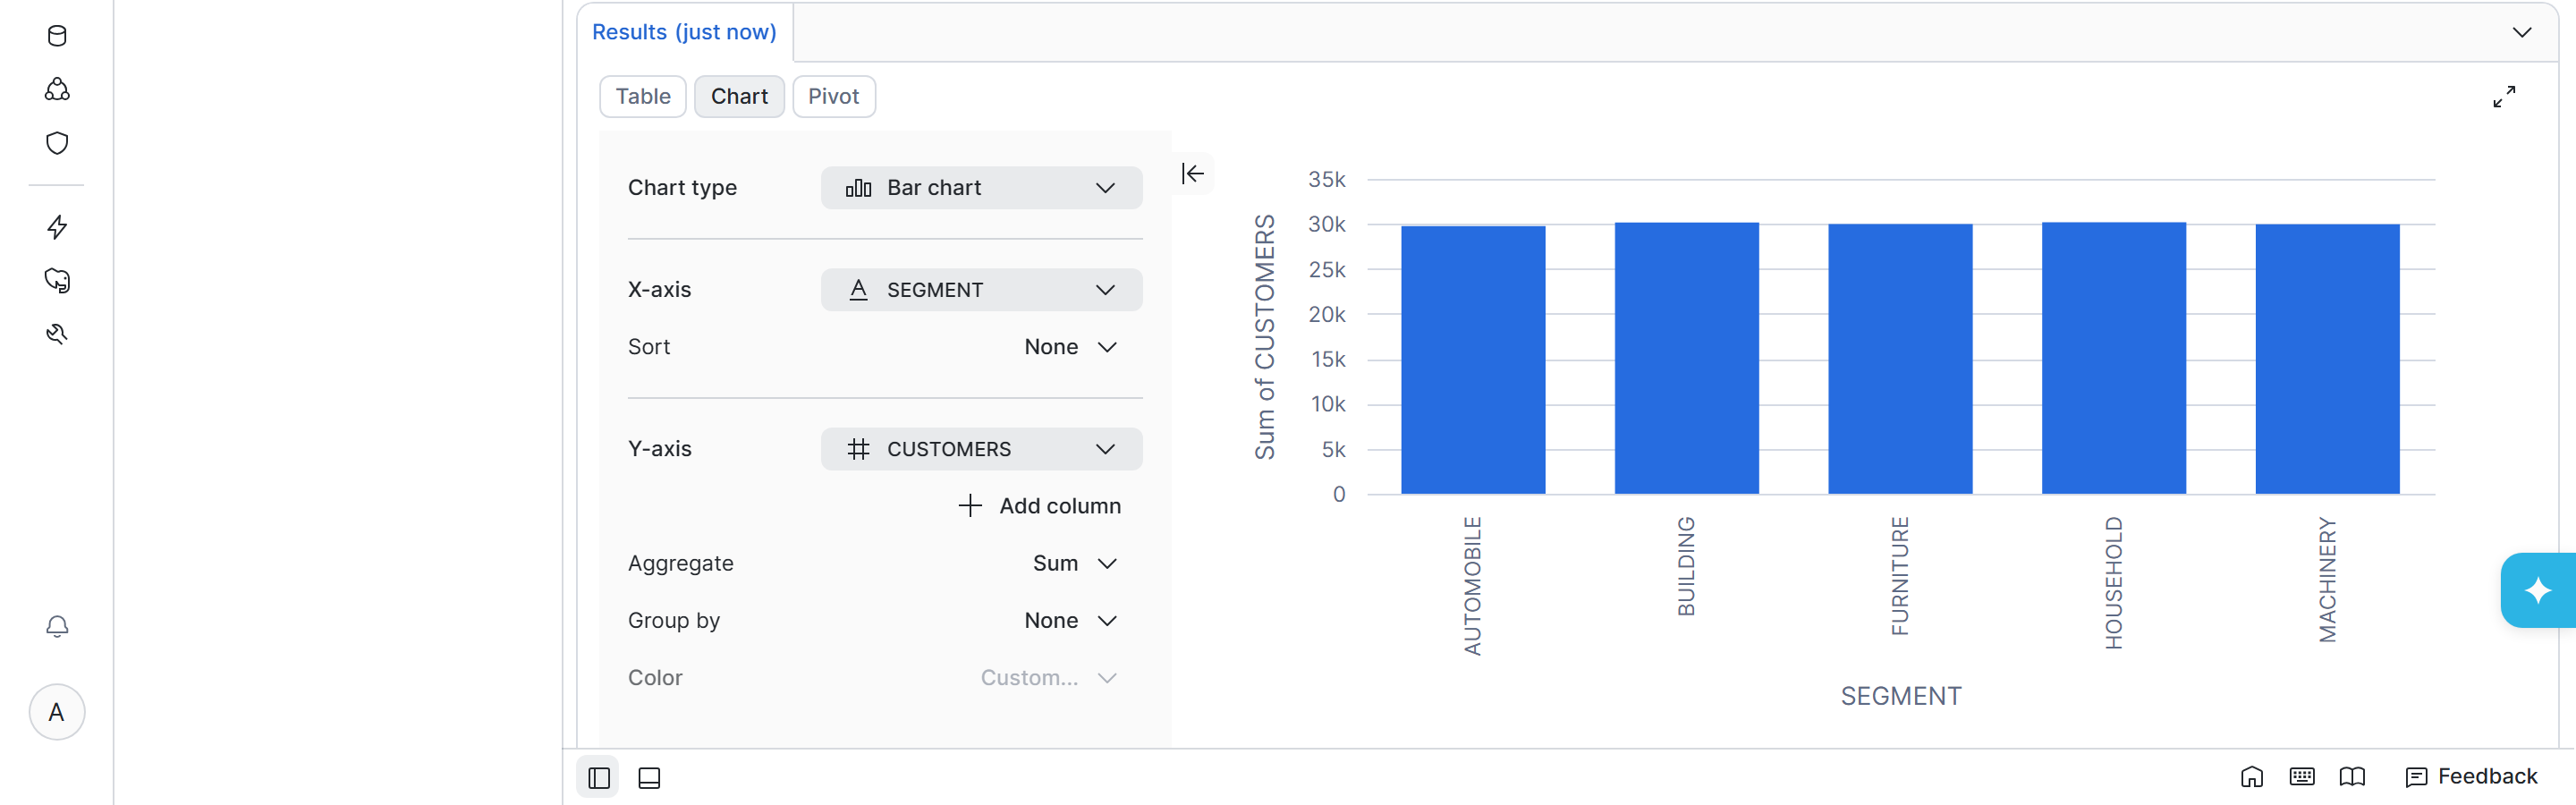
Oba narzędzia potrafią też od razu zamienić tabelę wyników w wykres, bez wychodzenia z konsoli. W Snowflake wystarczy przełączyć zakładkę na wykres i wskazać, co ma być na osiach:
Wniosek z tej sekcji jest prosty: od strony pisania zapytań przesiadka z jednego na drugie jest niemal bezbolesna. Kto zna SQL, ruszy w obu od pierwszej minuty. Różnice, które naprawdę bolą lub cieszą, siedzą gdzie indziej - w tym, co dzieje się pod maską i na rachunku.
Oba narzędzia biorą Twoje jedno zapytanie i tną je na drobne zadania liczone równolegle na wielu maszynach - stąd ich prędkość na wielkich zbiorach. Oba pozwalają też podejrzeć, jak zapytanie faktycznie się policzyło. To bardzo pomaga, gdy coś działa wolno albo kosztuje więcej, niż powinno.
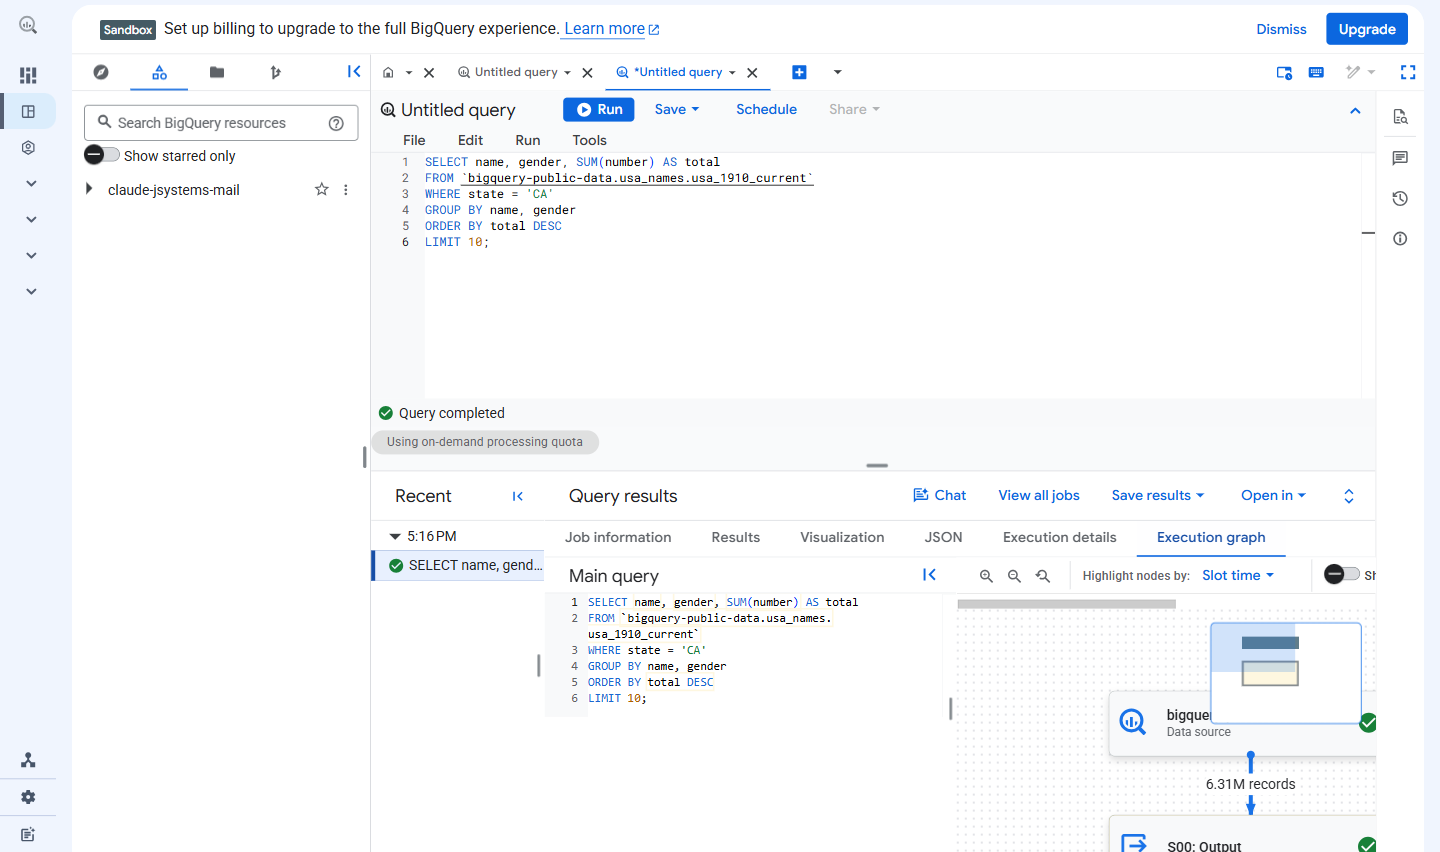
W BigQuery służy do tego graf wykonania (po angielsku execution graph): pokazuje, skąd zapytanie wzięło dane i ile rekordów przeszło przez kolejne etapy przetwarzania.
Snowflake ma swój odpowiednik - profil zapytania (po angielsku query profile). To drzewo operatorów: odczyt tabeli, agregacja, sortowanie, wynik. Do tego panel z najbardziej kosztownymi krokami, czasem wykonania i liczbą przeczytanych partycji danych:
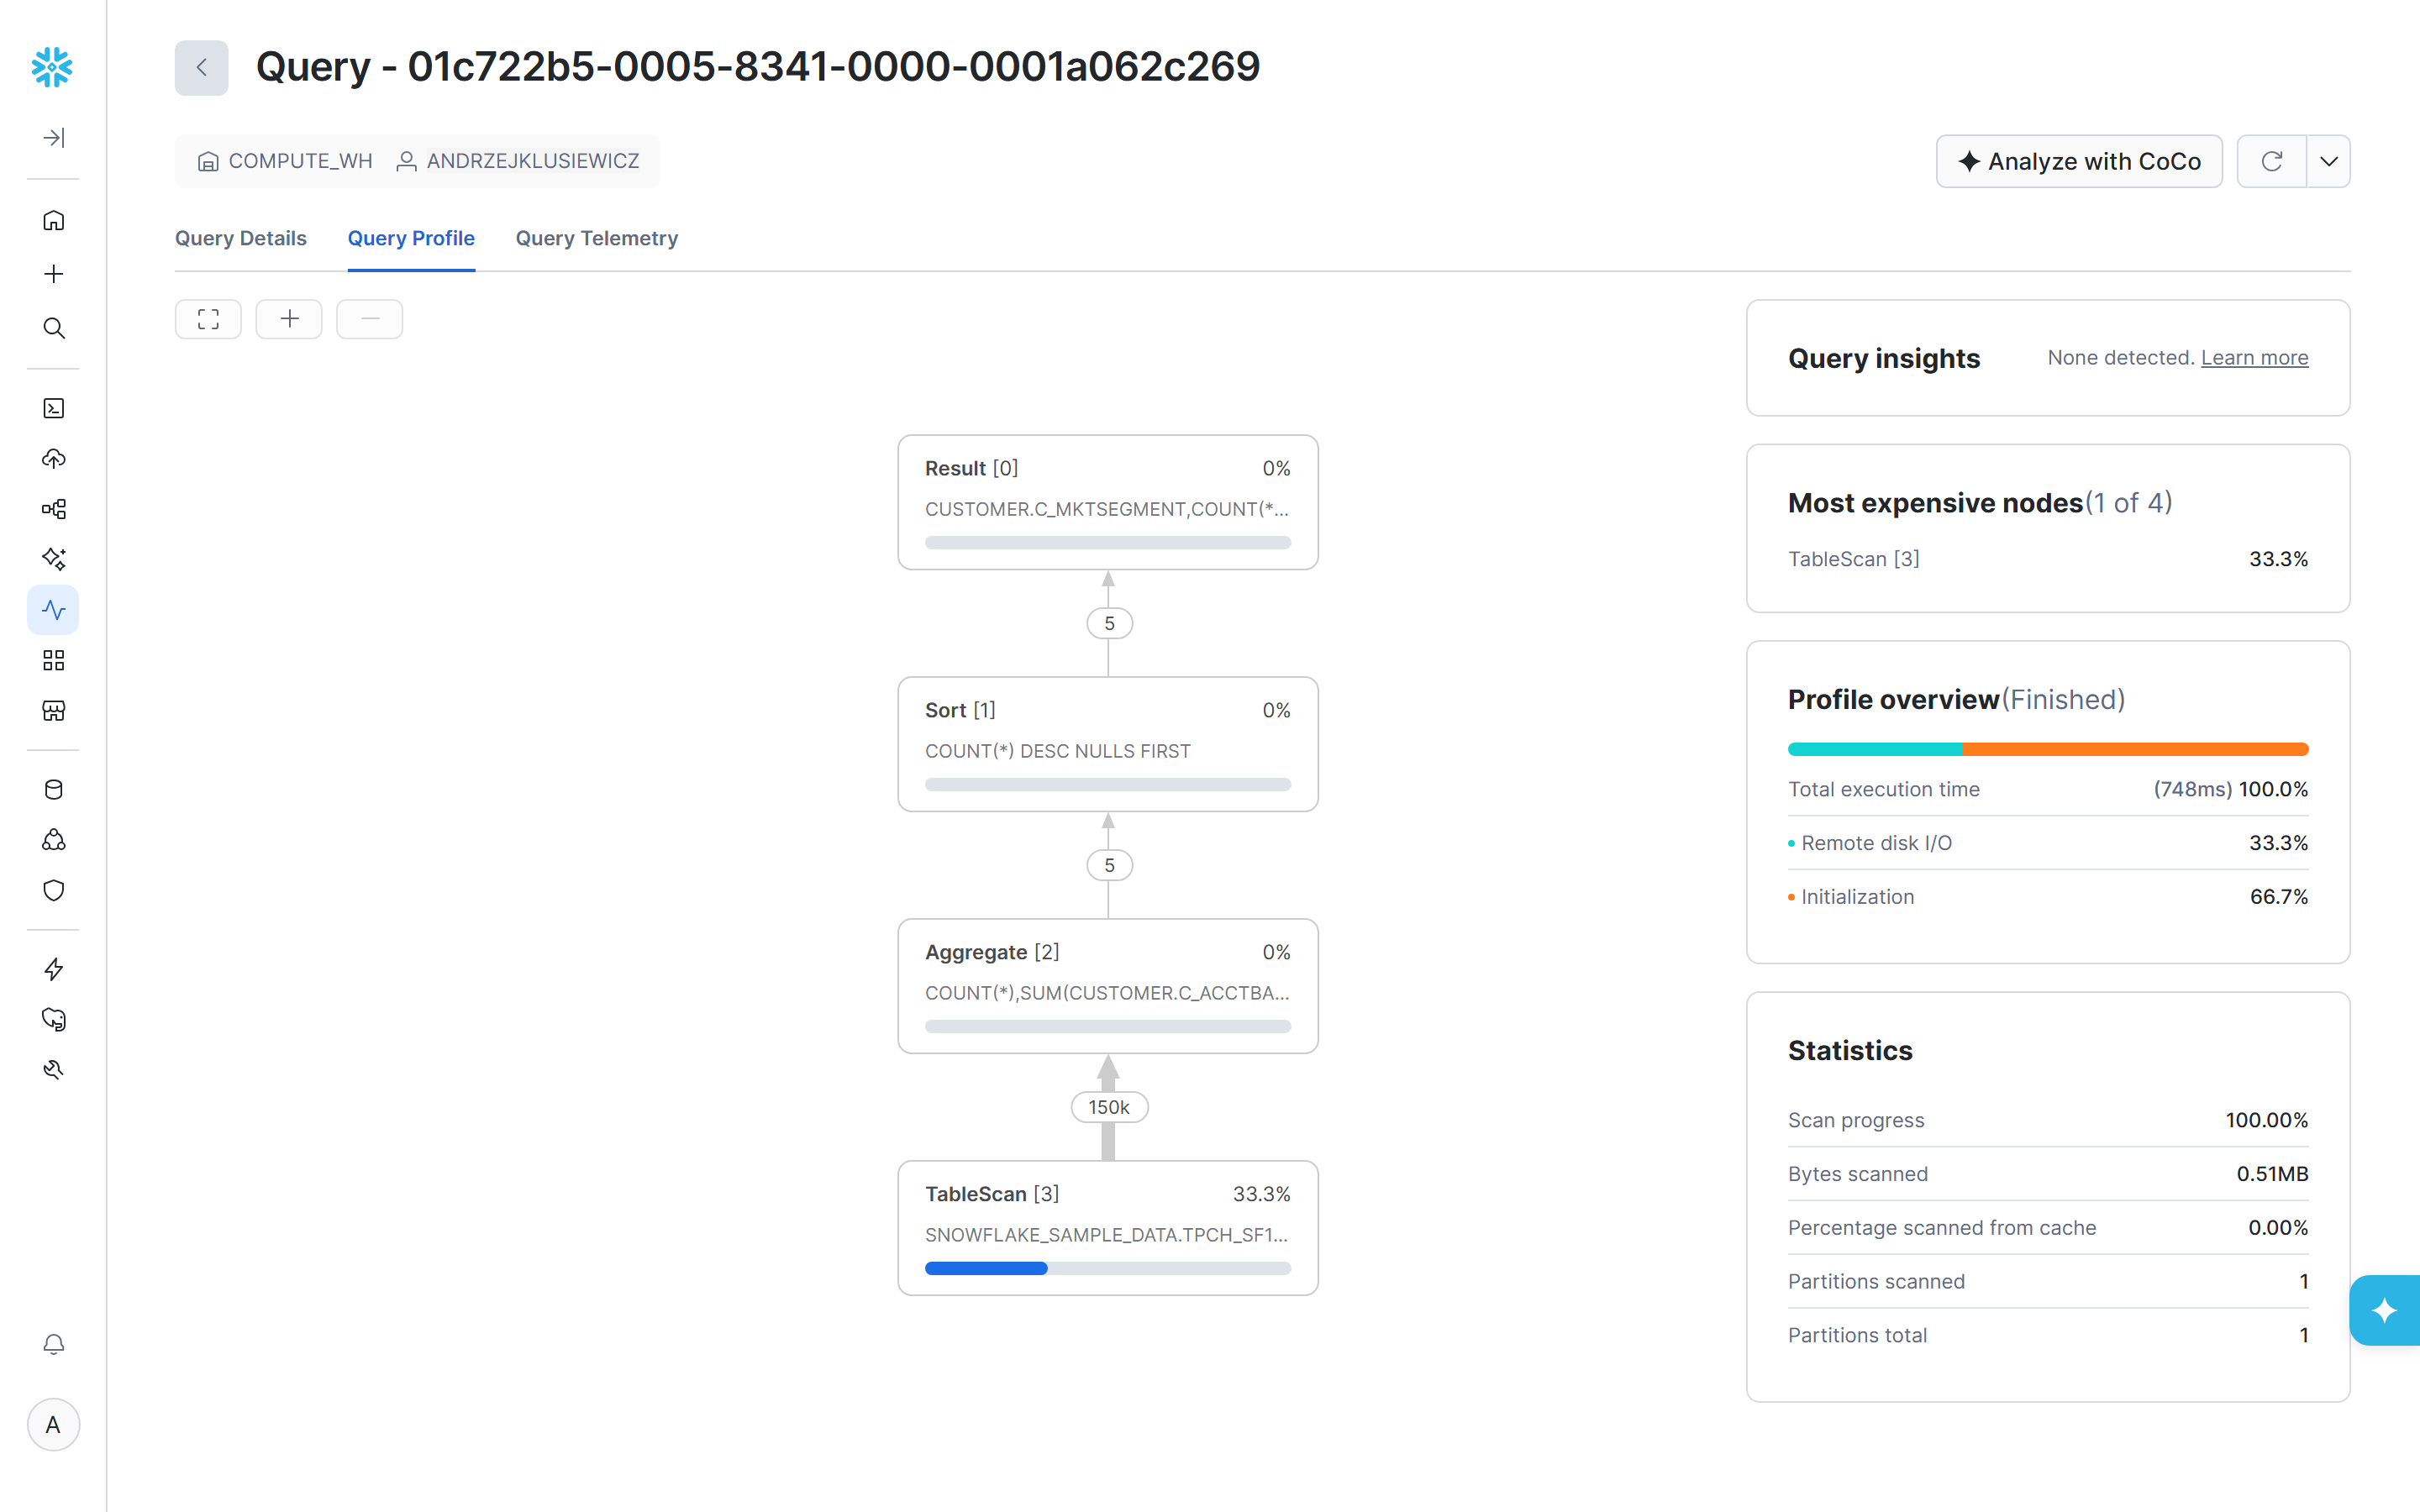
Oba widoki mówią o tym samym: gdzie zeszła praca i za co realnie zapłacisz. Zajrzenie tutaj to najlepszy pierwszy krok, gdy chcesz przyspieszyć zapytanie albo obniżyć jego koszt - a jak liczony jest ten koszt, różni się między narzędziami zasadniczo.
To najważniejsza różnica praktyczna i najczęstsze źródło niespodzianek na rachunku. Modele rozliczeń są zbudowane wokół dwóch zupełnie różnych rzeczy.
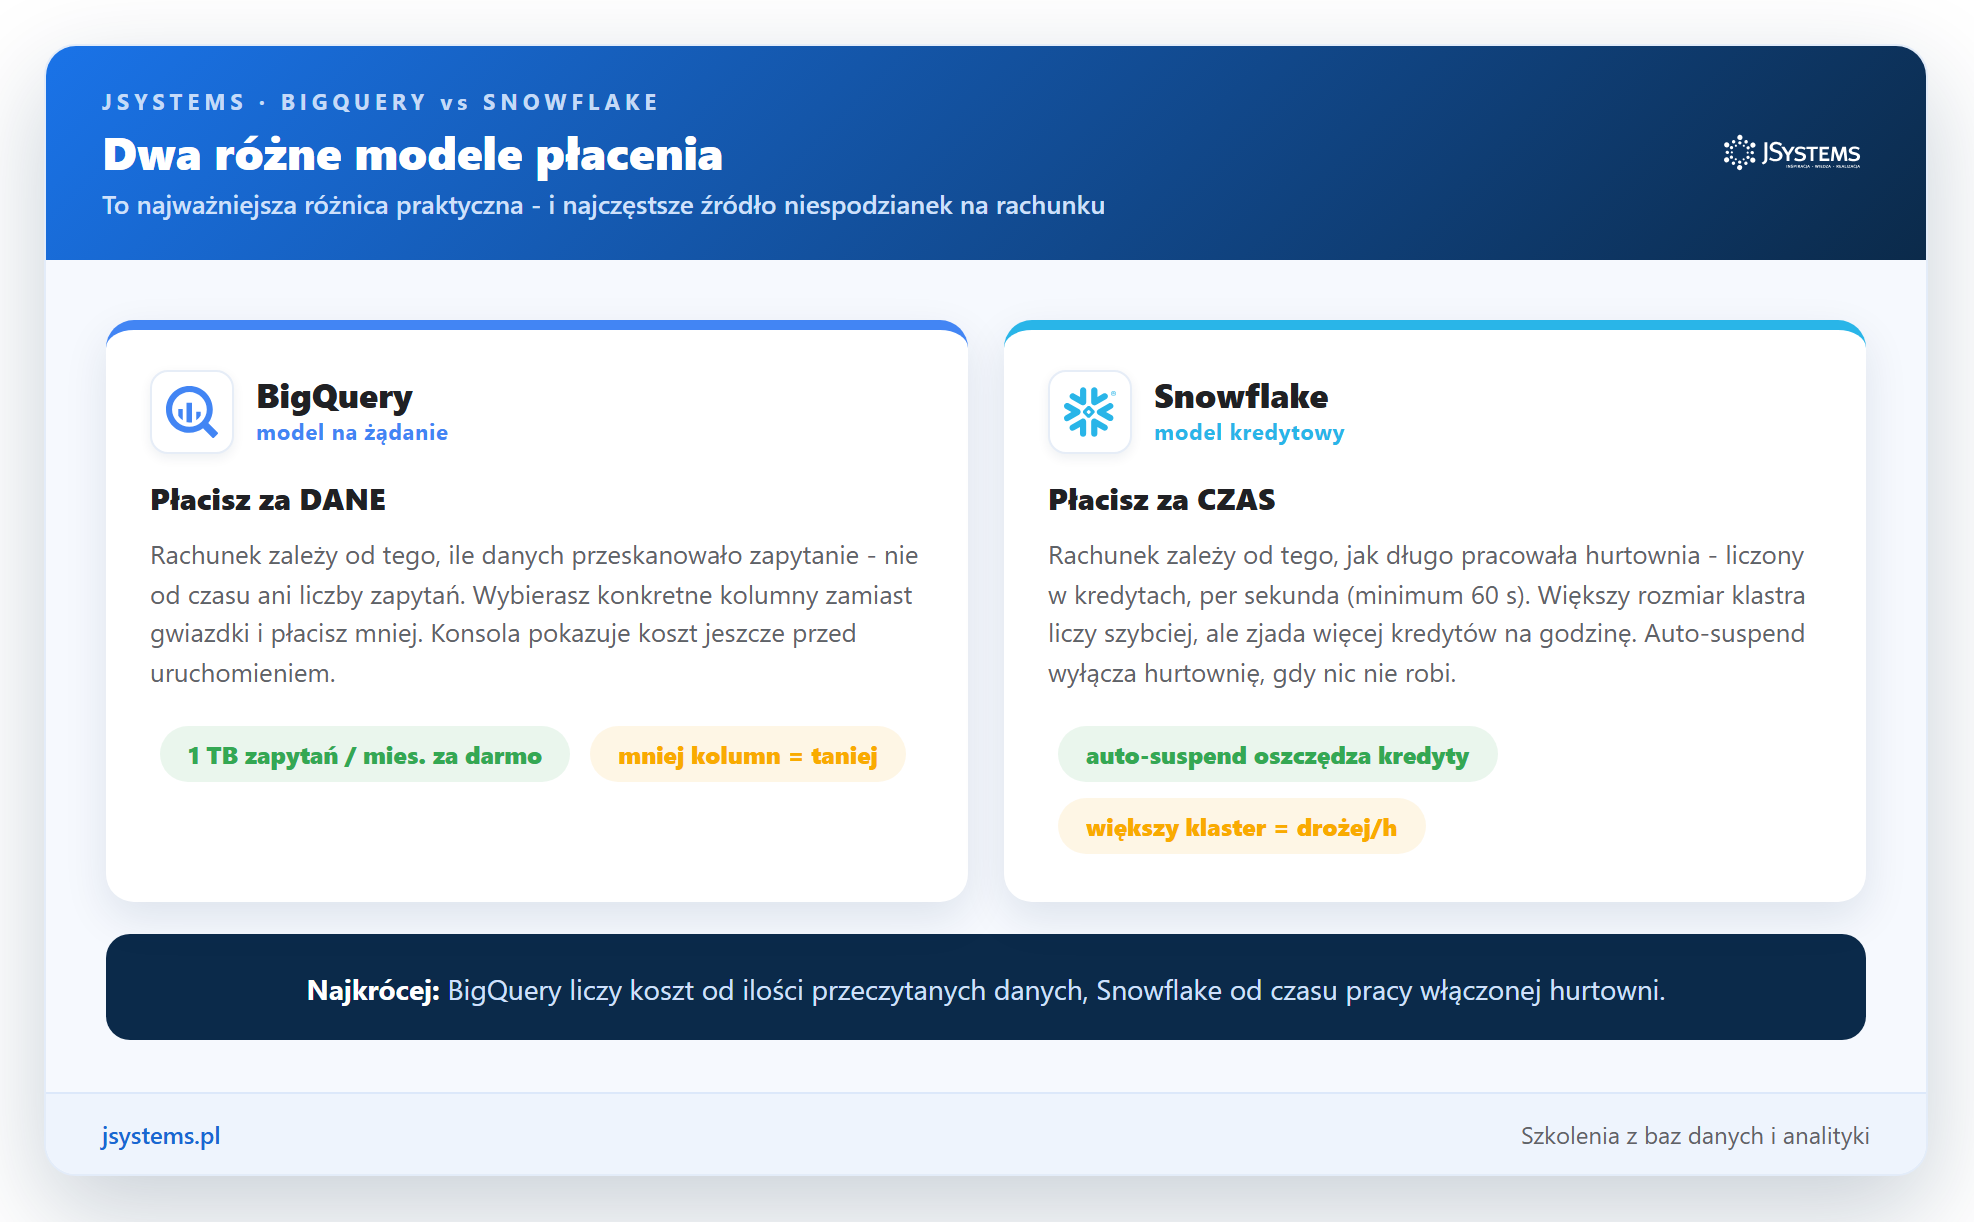
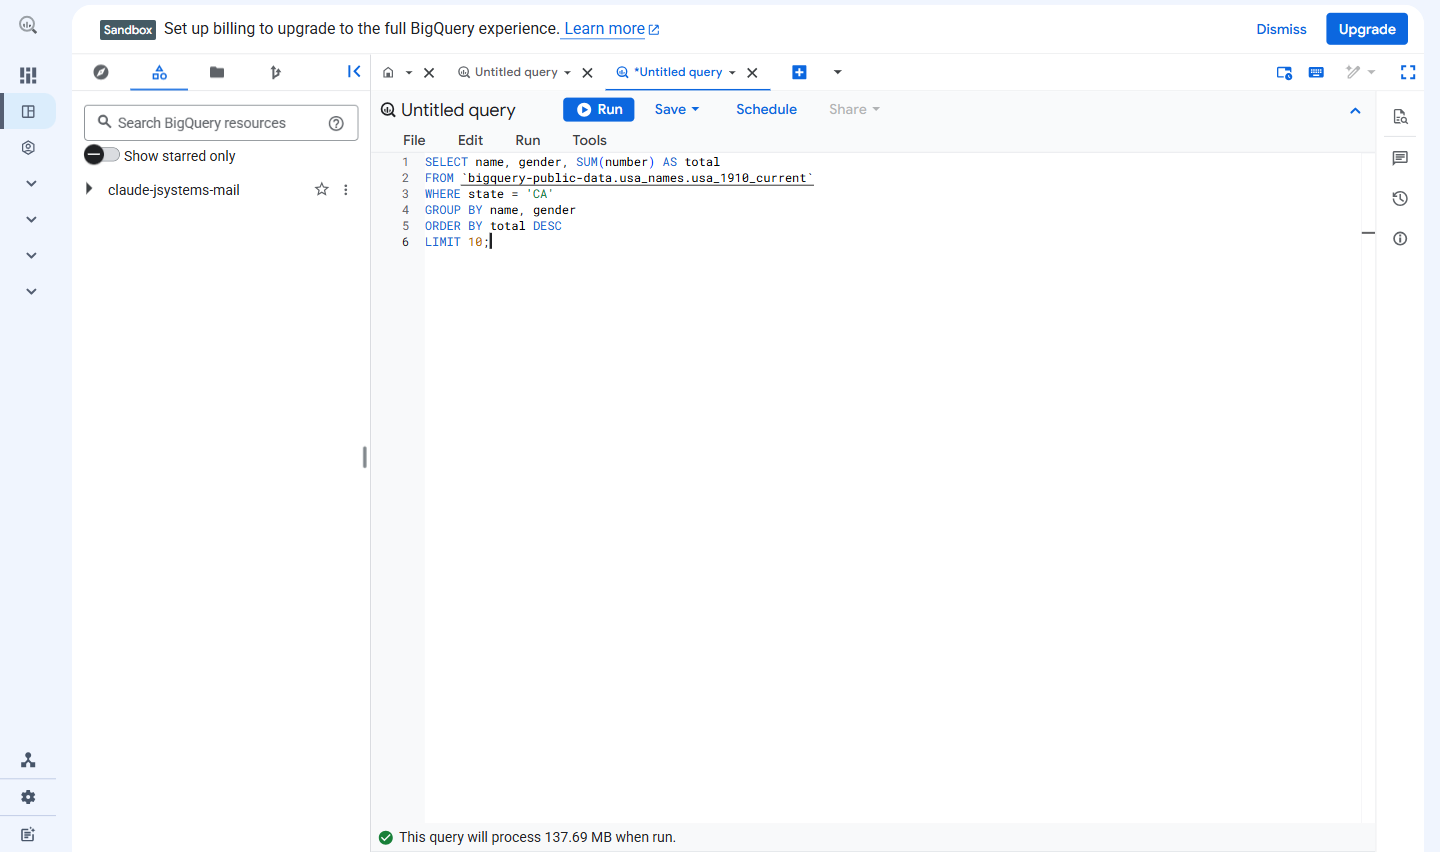
BigQuery liczy koszt od ilości danych, które przeskanowało zapytanie - nie od czasu ani liczby zapytań. Co ważne, konsola mówi Ci to z góry, jeszcze przed uruchomieniem, więc nigdy nie liczysz w ciemno:
Snowflake liczy koszt od czasu pracy włączonej hurtowni, wyrażonego w kredytach (wewnętrznej jednostce rozliczeniowej Snowflake). Liczy się każda sekunda, gdy hurtownia jest uruchomiona, z minimalnym naliczeniem 60 sekund przy każdym wznowieniu. Większy rozmiar klastra liczy szybciej, ale zjada proporcjonalnie więcej kredytów na godzinę. Dlatego tak ważny jest wspomniany auto-suspend: hurtownia, która sama się wyłącza po bezczynności, nie spala kredytów za nic.
W BigQuery zdradliwe jest SELECT * - każe przeczytać wszystkie kolumny, także te niepotrzebne, a płacisz właśnie za przeczytane dane. W Snowflake zdradliwa jest zapomniana, wciąż włączona hurtownia - albo zbyt duży klaster do prostych zapytań. W obu przypadkach lekarstwo jest tanie: wybieraj konkretne kolumny zamiast gwiazdki i pilnuj, żeby moc wyłączała się, gdy nie pracuje.
Która hurtownia wyjdzie taniej, zależy więc od charakteru pracy. Przy nieregularnych, rzadkich analizach zwykle wygrywa BigQuery - płacisz tylko za to, co realnie przeskanujesz, i nic, gdy nie pytasz. Przy stałym, przewidywalnym obciążeniu, gdzie moc jest wykorzystywana w pełni przez większość dnia, dobrze zestrojony Snowflake bywa tańszy i daje lepszą kontrolę nad wydatkiem.
Tu różnica jest krótka do opisania, ale dla wielu firm decydująca. BigQuery działa wyłącznie w chmurze Google (Google Cloud). To zaleta, jeśli Twoje dane i narzędzia już tam są - na przykład Google Ads, Google Analytics czy Looker - bo wszystko siedzi blisko siebie. To wada, jeśli reszta Twojej firmy stoi na innej chmurze.
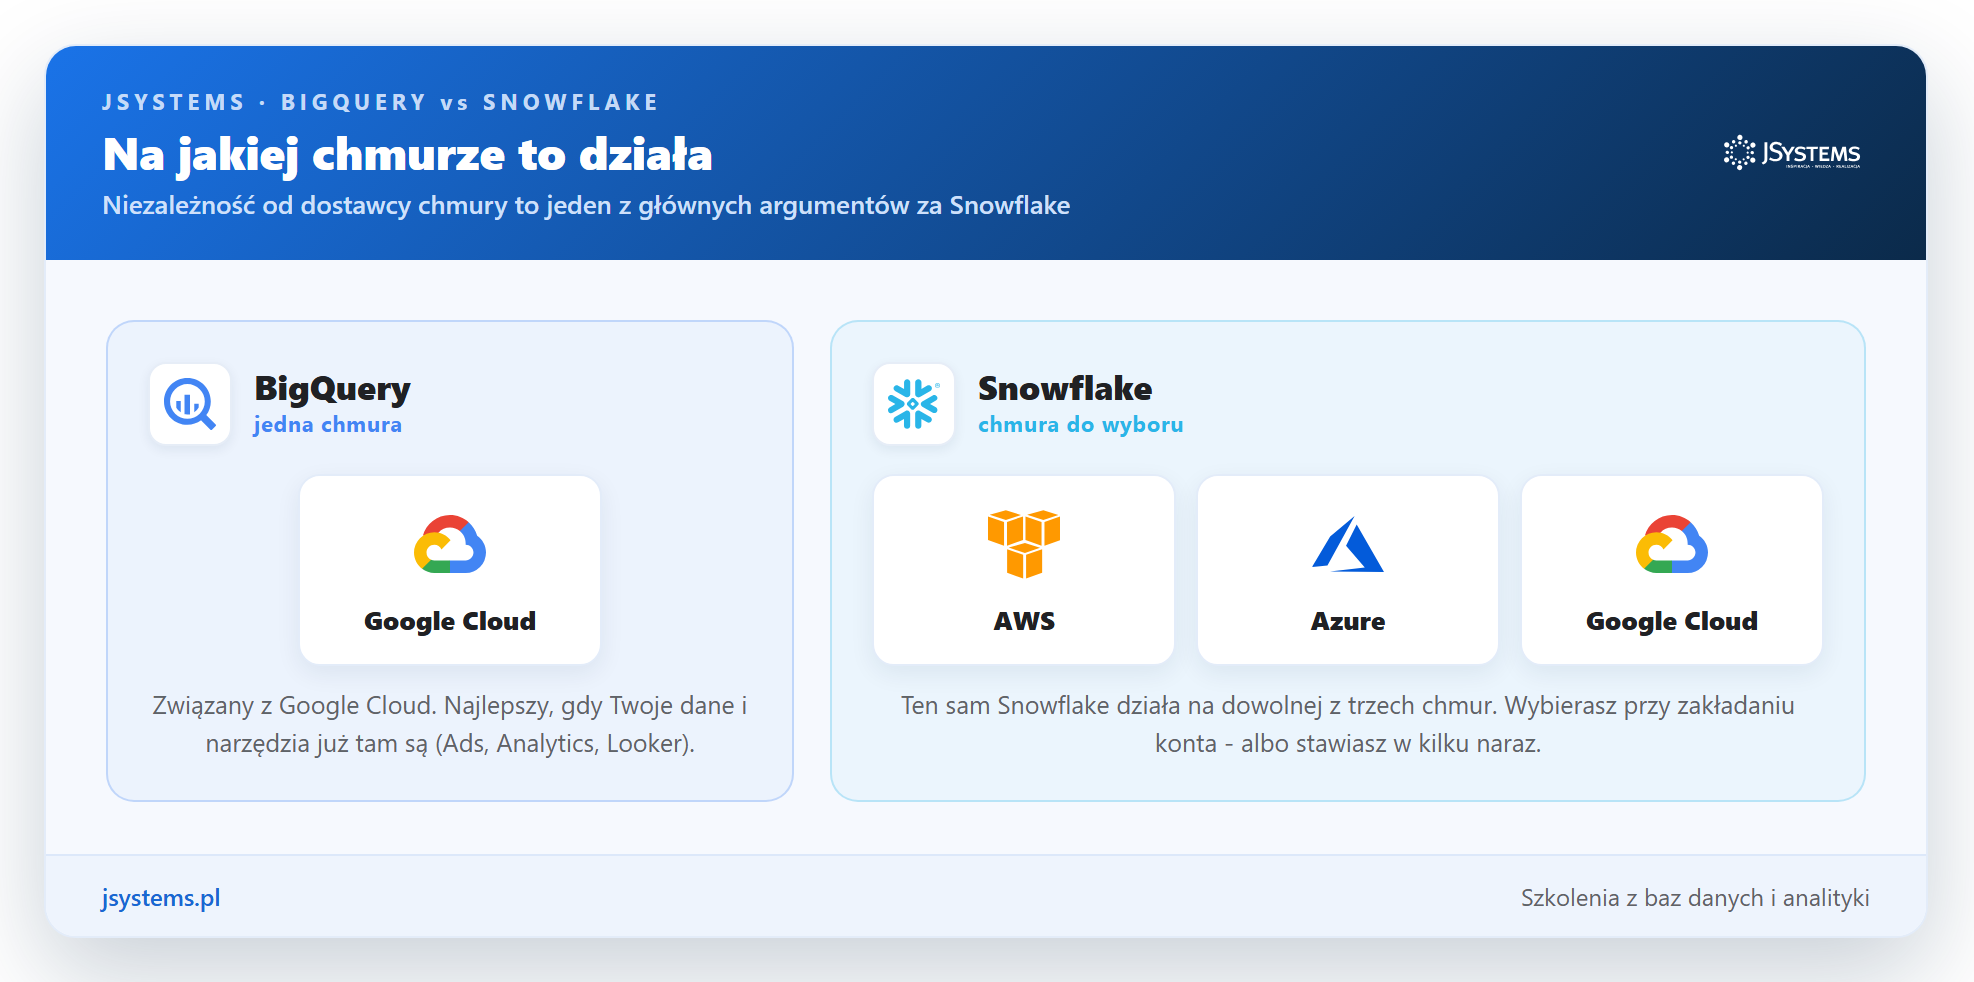
Snowflake działa na wszystkich trzech dużych chmurach: Amazon AWS, Microsoft Azure oraz Google Cloud. Wybierasz jedną przy zakładaniu konta, a ten sam Snowflake wygląda i działa na każdej tak samo. Dla firm, które nie chcą przywiązywać się do jednego dostawcy (albo już stoją na AWS lub Azure), to jeden z głównych argumentów za Snowflake. Przy okazji Snowflake ma też własny rynek danych (marketplace), przez który organizacje udostępniają i kupują gotowe zbiory - to obszar, w którym idzie o krok dalej niż klasyczna hurtownia.
Hurtownia to dopiero połowa drogi - dane trzeba jeszcze pokazać. Tu oba narzędzia grają podobnie: wynik z jednego i drugiego podłączysz do popularnych narzędzi analitycznych i pulpitów. BigQuery ma naturalne, ścisłe połączenie z ekosystemem Google (darmowe Looker Studio, Arkusze, a dalej Vertex AI do uczenia maszynowego). Snowflake stawia na niezależność i integruje się z całym rynkiem - od narzędzi do wizualizacji po własne środowisko Snowpark do przetwarzania danych w Pythonie.
W jedno i drugie świetnie wpina się Power BI - jeśli interesuje Cię właśnie budowanie czytelnych pulpitów na danych z hurtowni, zajrzyj do naszego przewodnika czym jest Power BI, Power Query i DAX. To w praktyce najczęstszy dalszy krok po tym, jak dane wylądują w BigQuery albo w Snowflake.
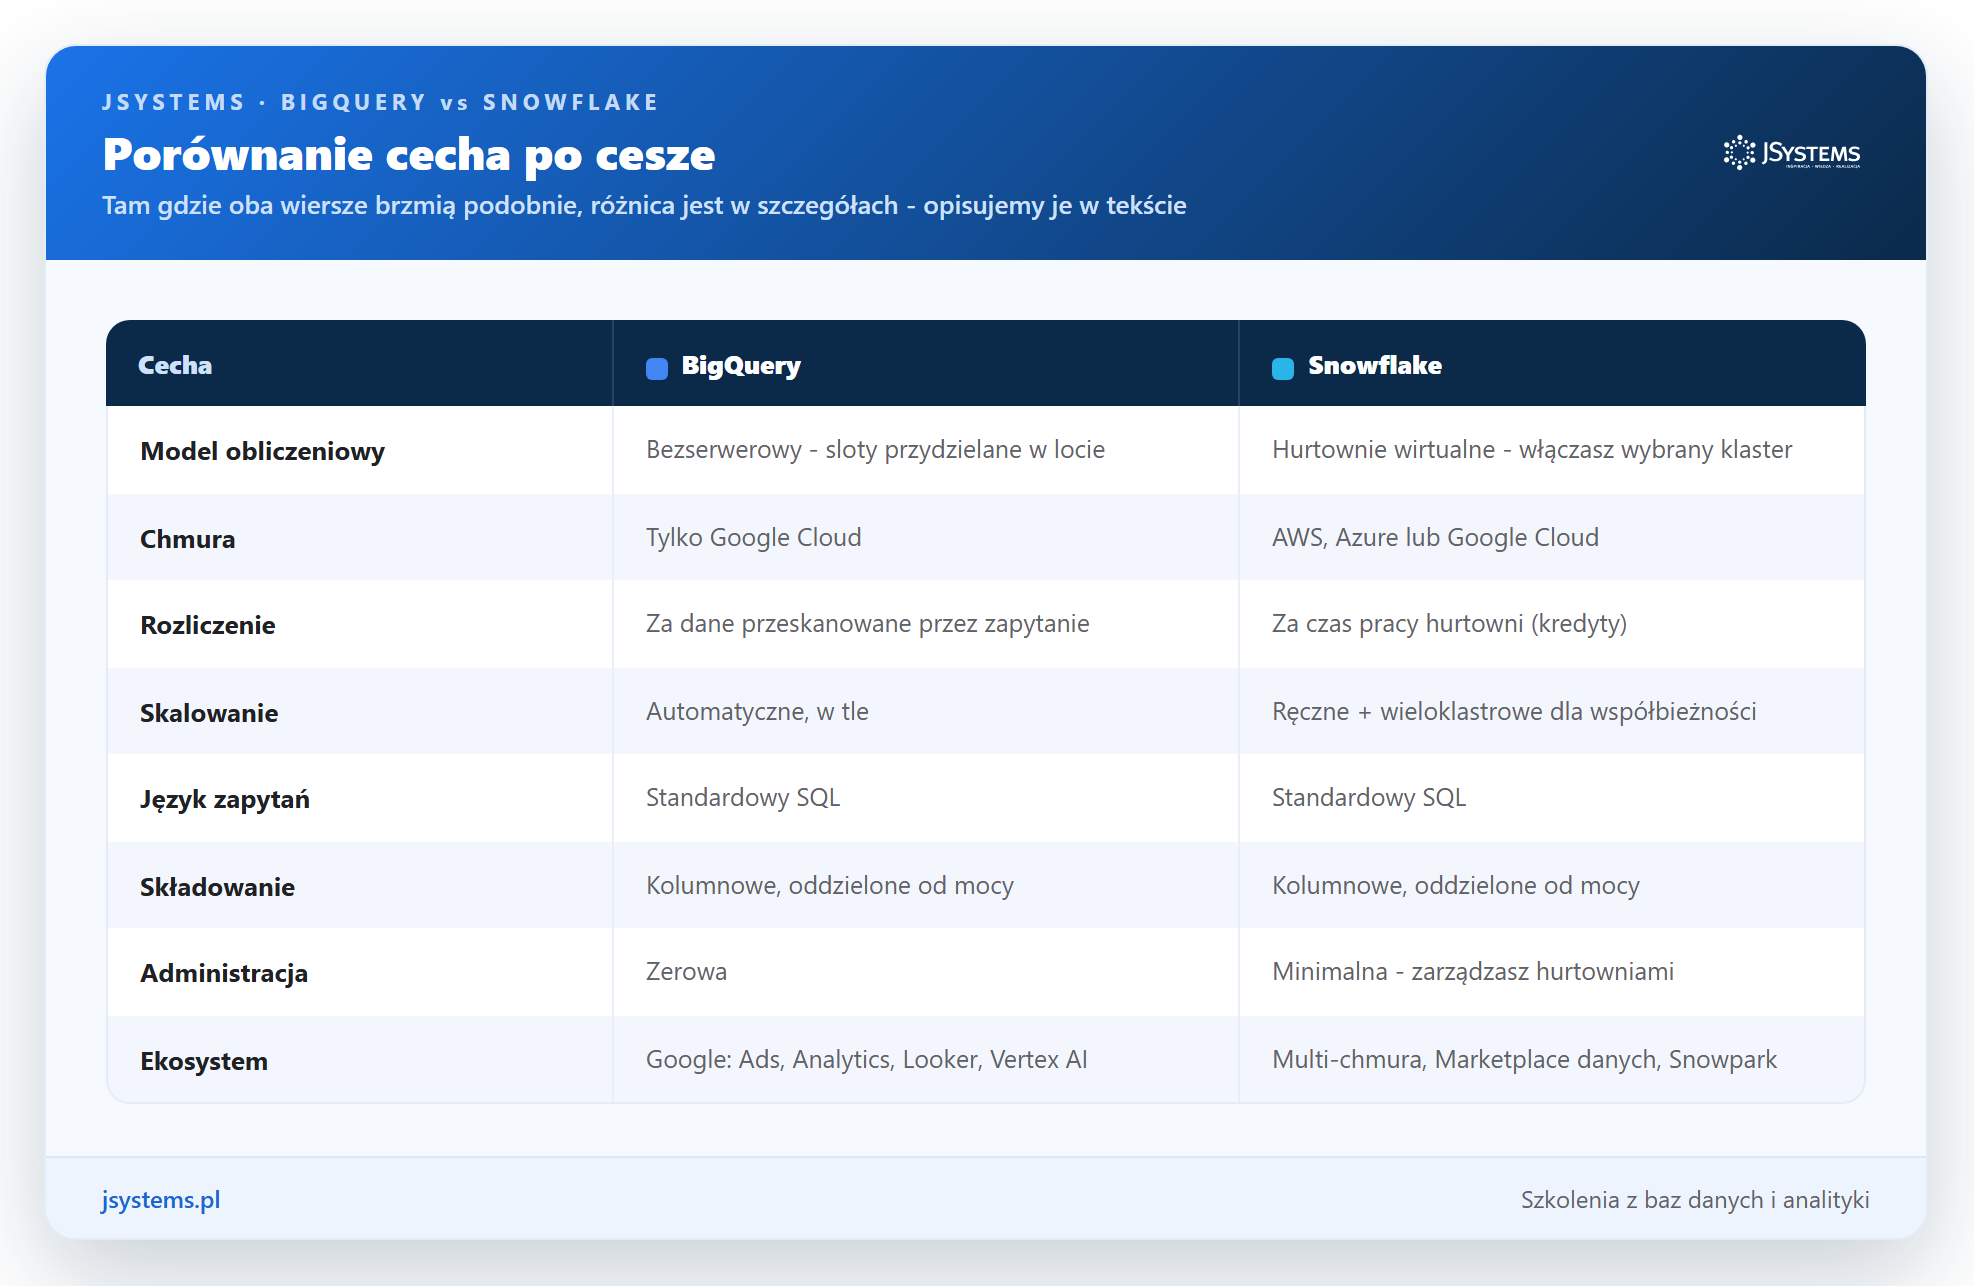
Zbierzmy najważniejsze różnice w jednym miejscu. Tam, gdzie oba wiersze brzmią podobnie, diabeł tkwi w szczegółach opisanych wyżej:
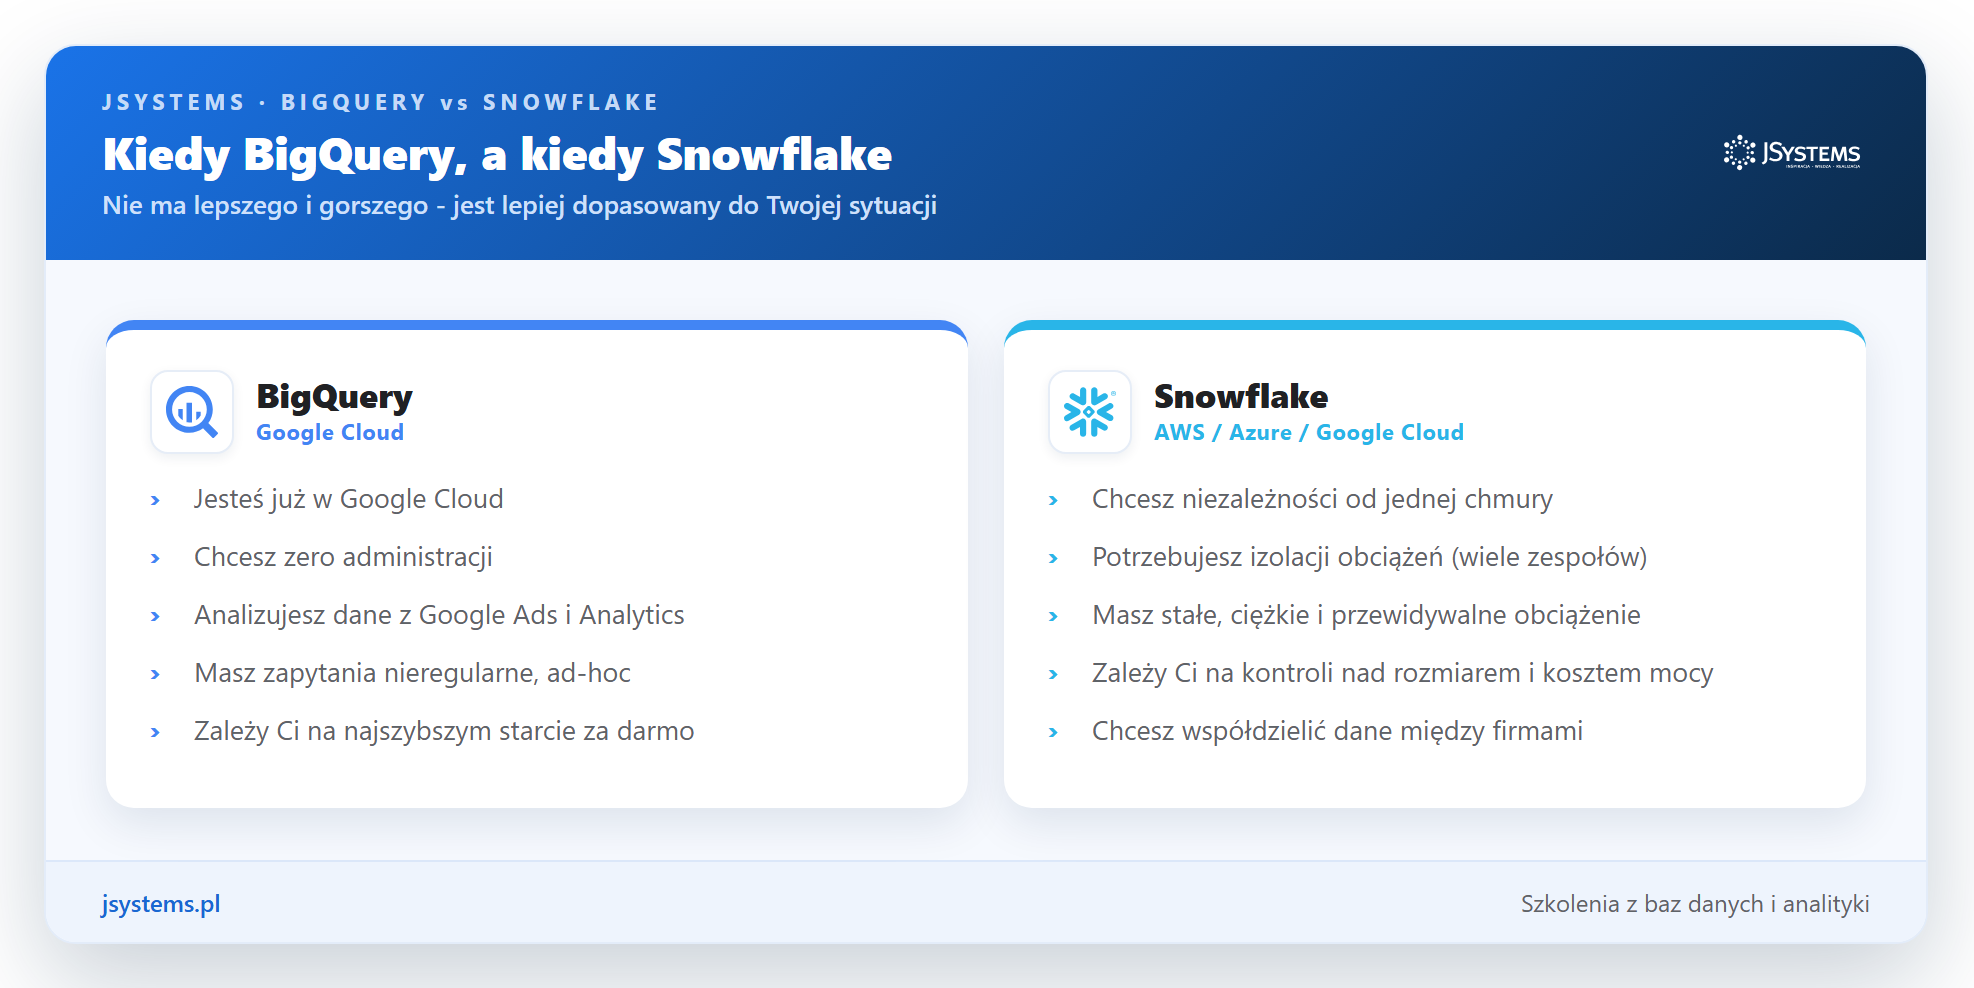
Nie ma tu lepszego i gorszego - jest lepiej dopasowany do Twojej sytuacji. Poniższa ściągawka podsumowuje, w którą stronę zwykle warto się skłonić:
Jeśli wahasz się, od czego zacząć naukę - zacznij od tego, gdzie już masz dane. Siedzisz w Google? Otwórz darmowy sandbox BigQuery. Stoisz na AWS lub Azure, albo chcesz poczuć ideę hurtowni wirtualnych? Załóż 30-dniowe darmowe konto próbne Snowflake. W obu i tak ćwiczysz ten sam SQL, więc żadna godzina nie jest zmarnowana.
Fundament obu narzędzi jest wspólny i znasz go już z tego artykułu: dane w chmurze plus zwykłe zapytanie SQL, bez własnego serwera po Twojej stronie. Różni je to, skąd biorą moc i za co każą płacić - a to, którą wybrać, wynika wprost z tego, jak i gdzie pracujesz.
Rozumiesz już, czym różnią się obie chmurowe hurtownie - czas zamienić to w praktyczną umiejętność.
Na praktycznych szkoleniach JSystems przećwiczysz to na żywych danych - jedno prowadzi przez BigQuery, drugie przez Snowflake:


Komentarze (0)
Brak komentarzy...