Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
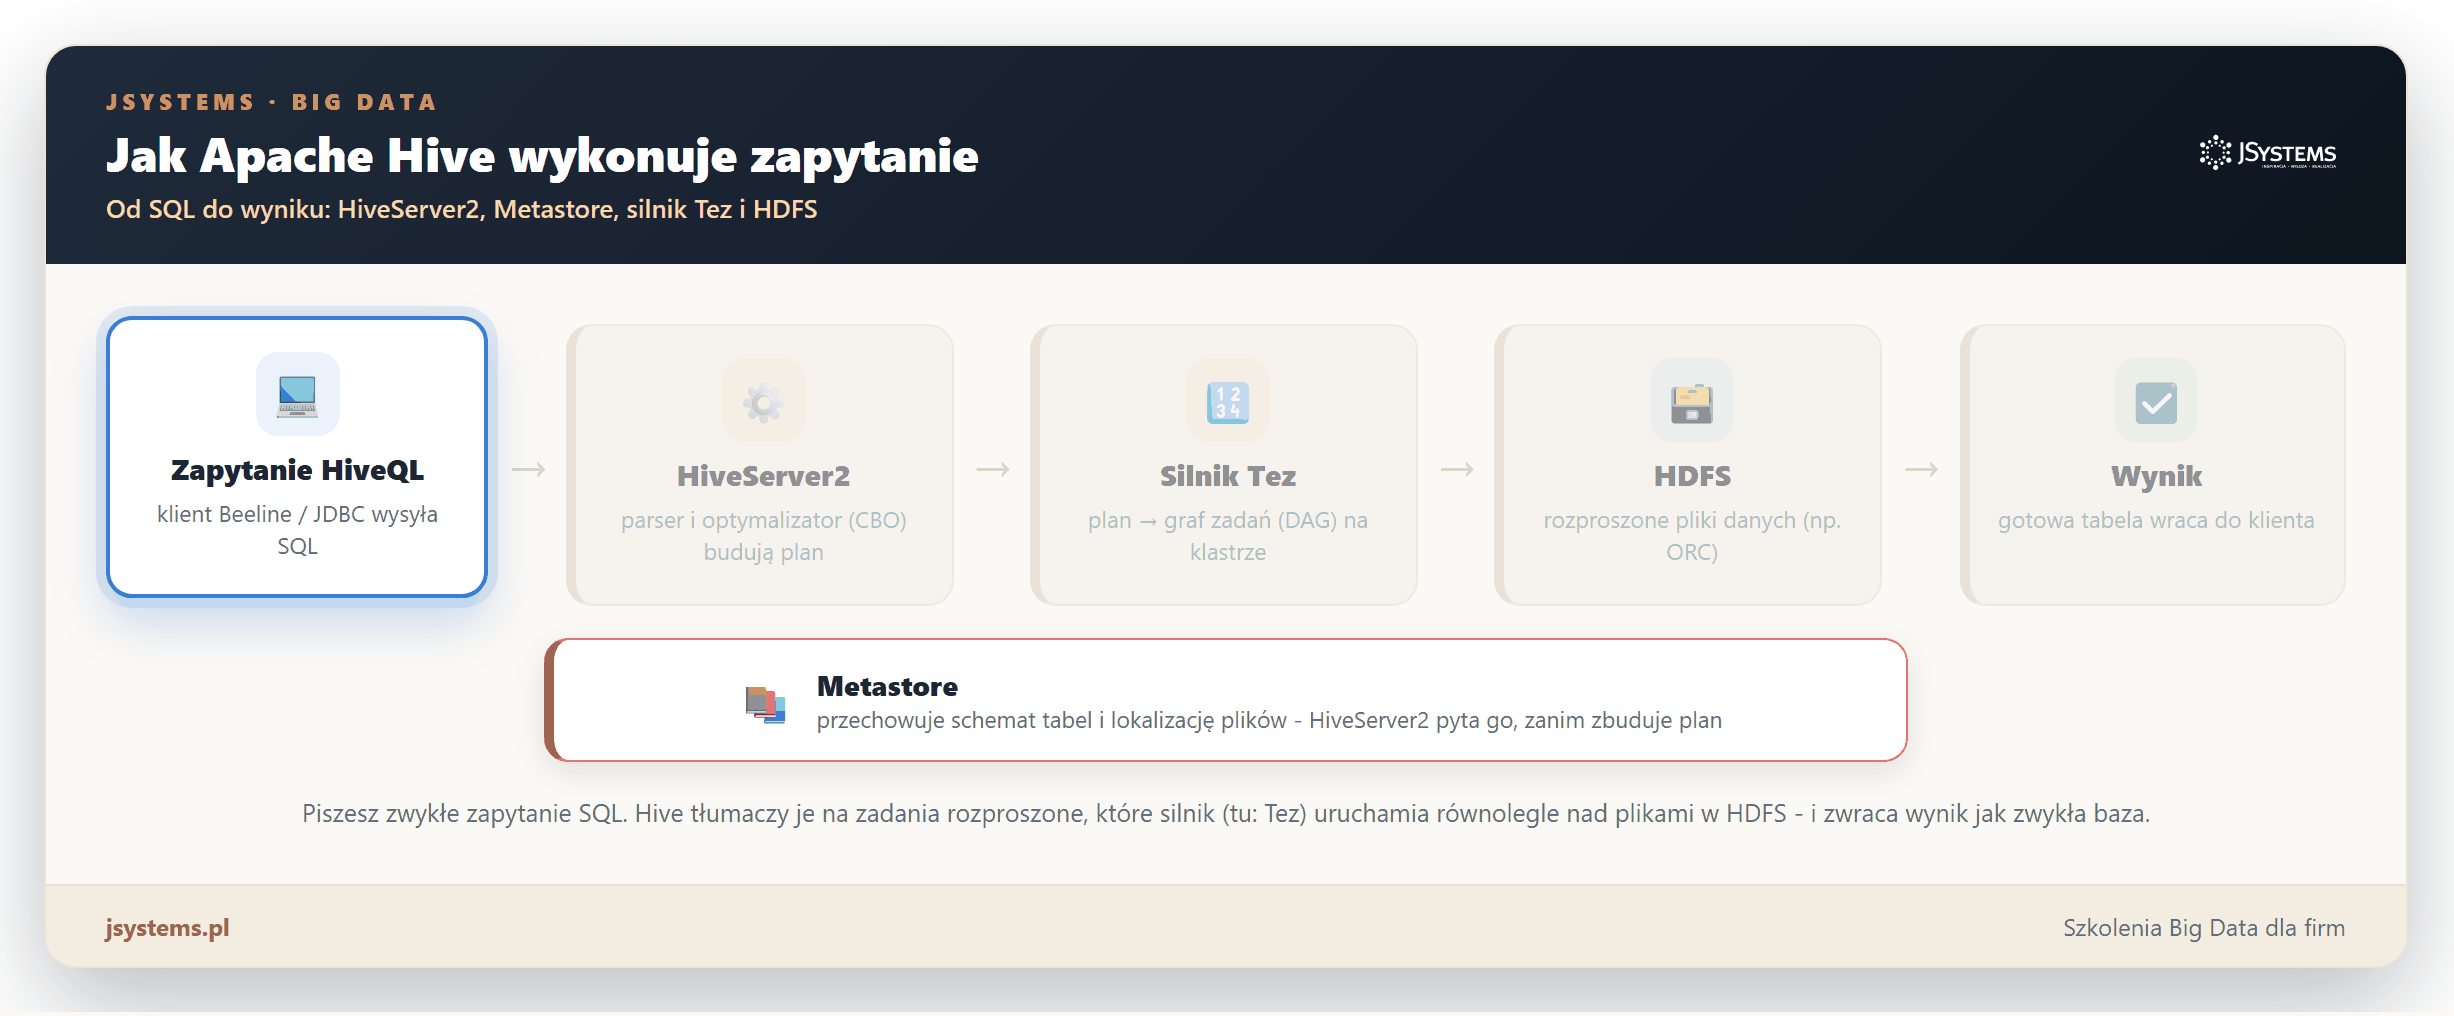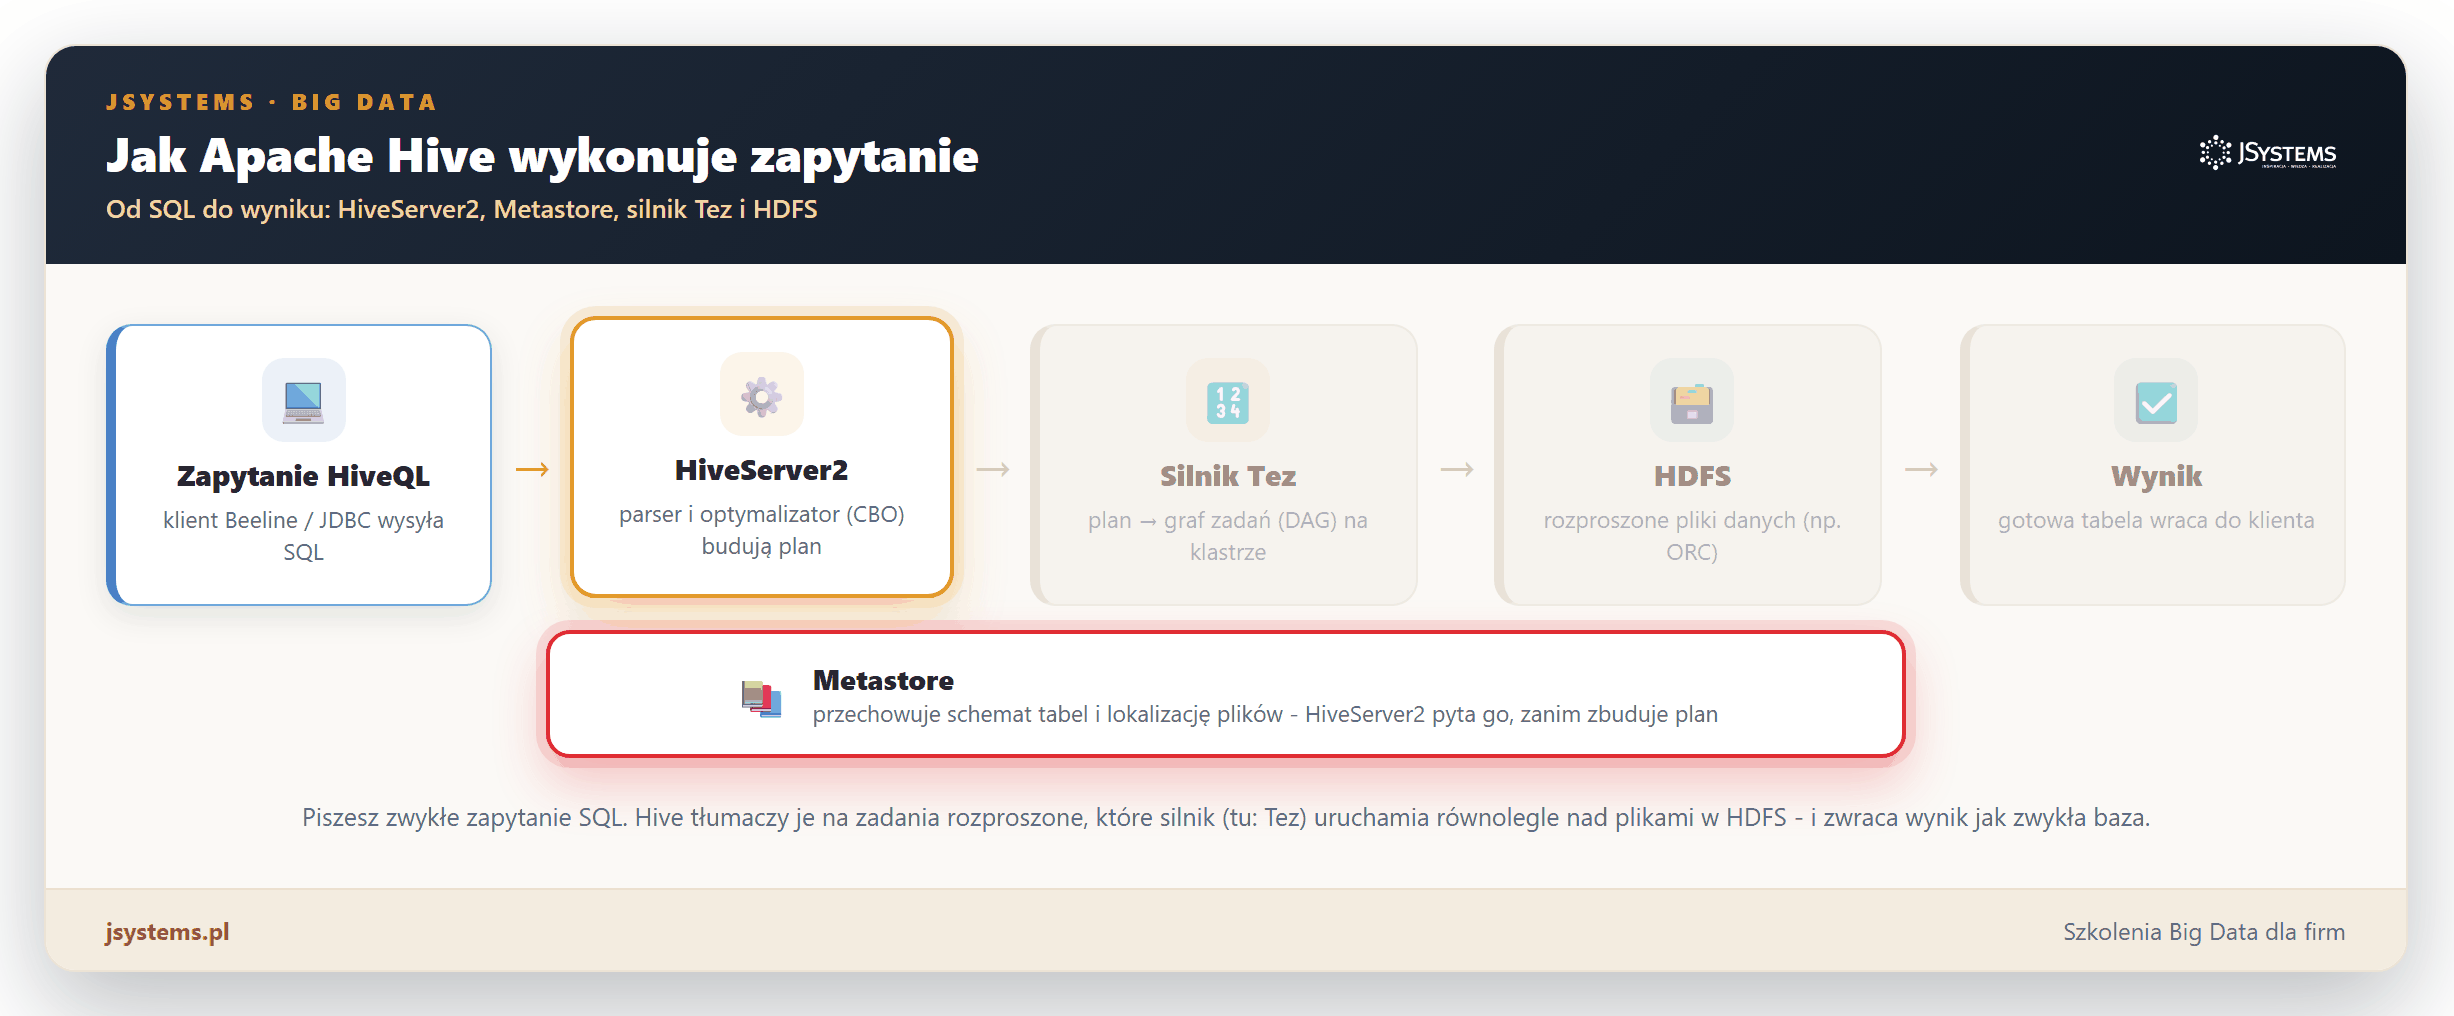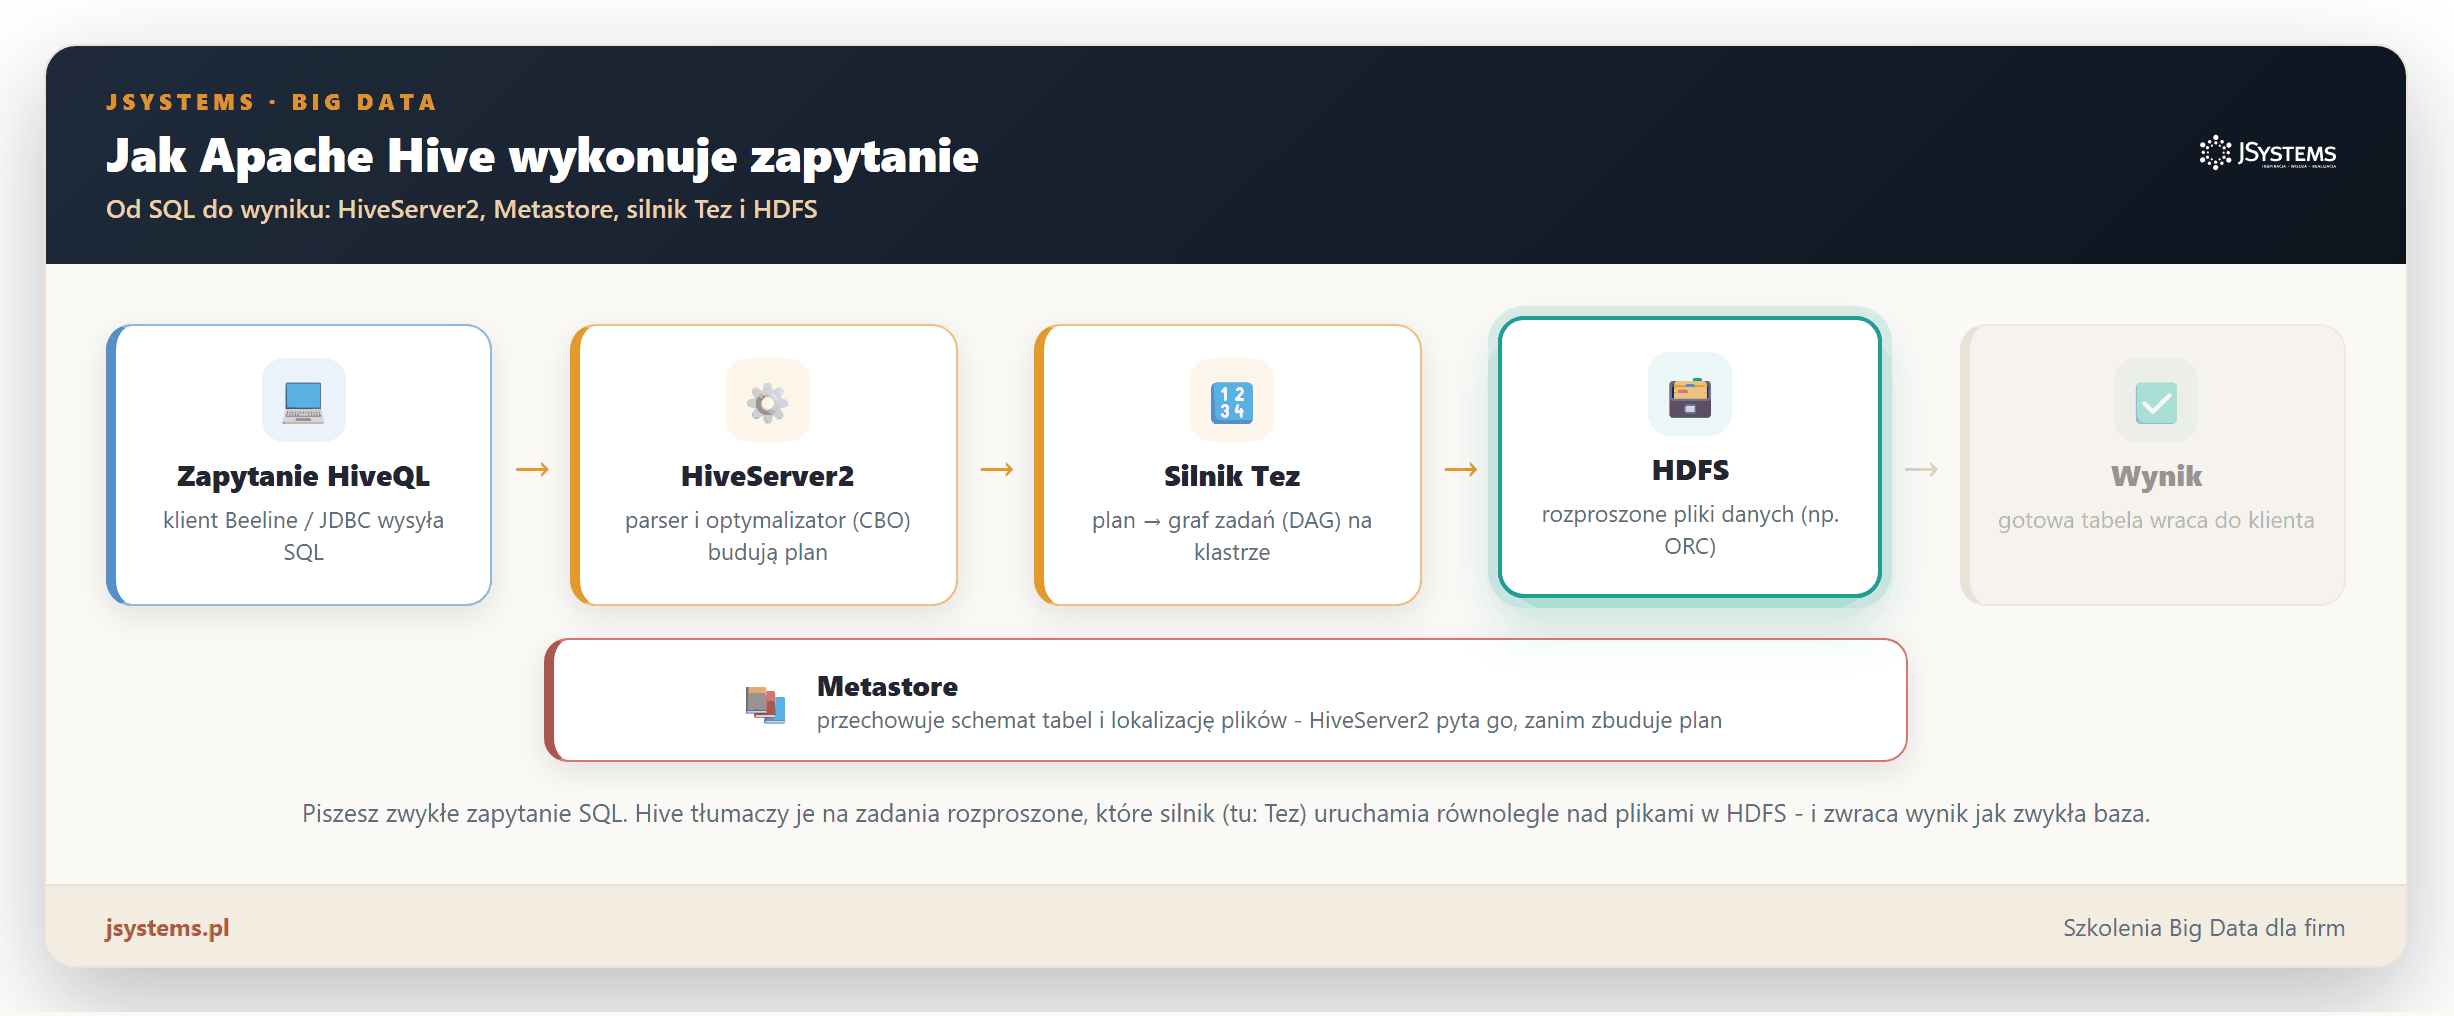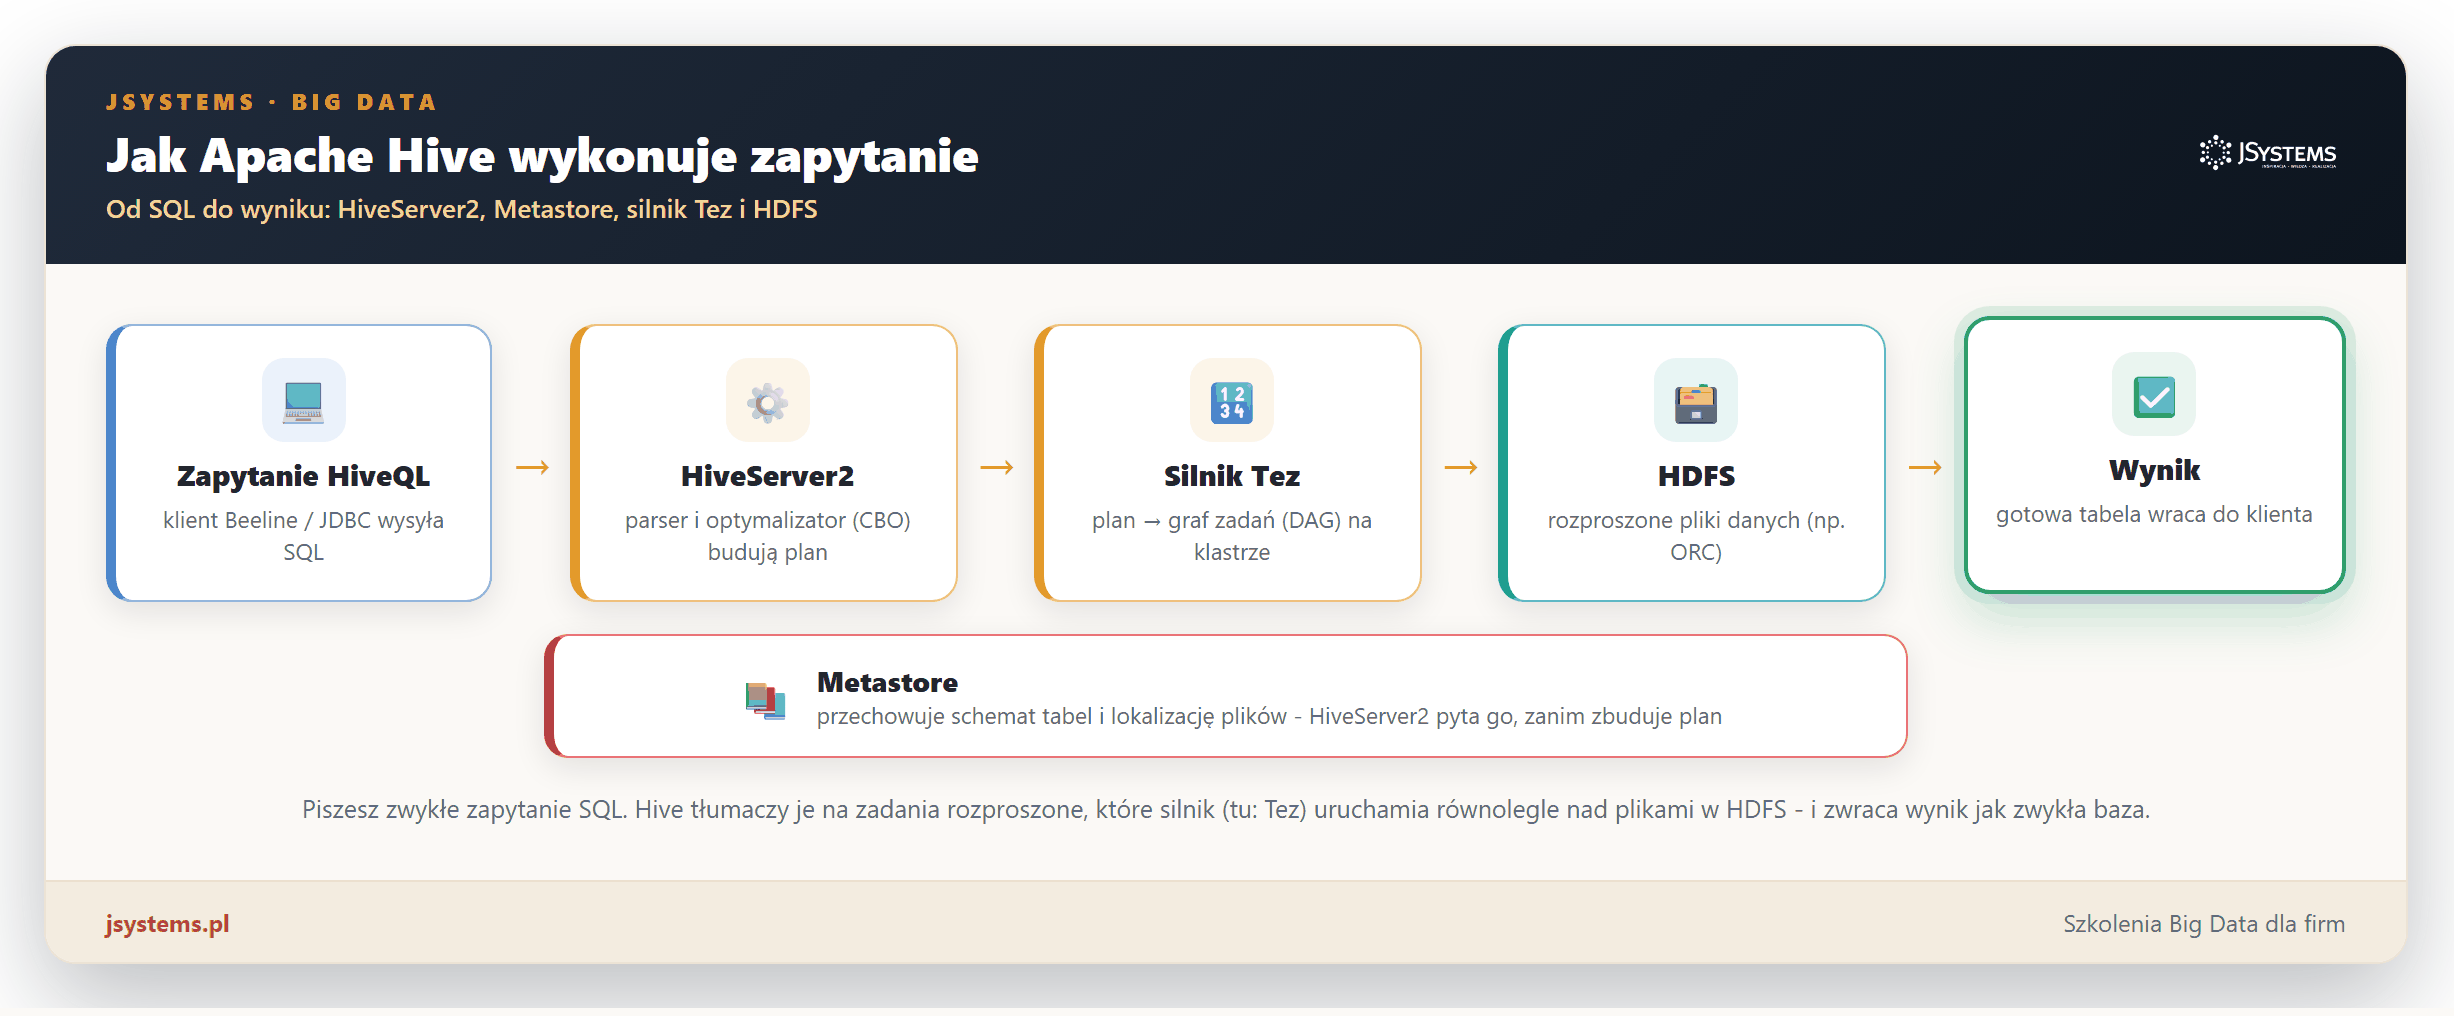
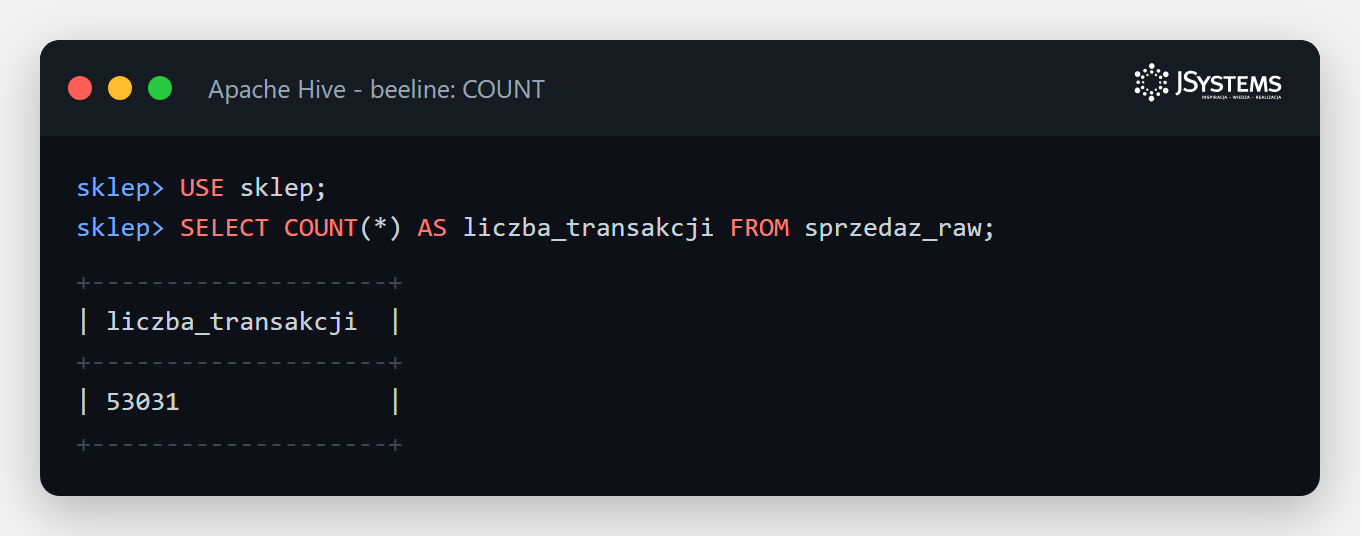
Apache Hive to jedno z tych narzędzi, które sprawiły, że świat Big Data przestał być zarezerwowany wyłącznie dla programistów Javy. Zamiast pisać skomplikowany kod, analityk może odpytać petabajty danych zwykłym językiem SQL. W tym przewodniku wyjaśnimy prostym językiem, czym Hive jest, jak działa od środka i kiedy naprawdę warto po niego sięgnąć. Wszystko pokażemy na żywym Hive uruchomionym w kontenerze, na realnym zbiorze 53 031 transakcji sprzedaży.
Apache Hive to hurtownia danych zbudowana na platformie Hadoop, która pozwala odpytywać ogromne zbiory danych językiem bardzo zbliżonym do SQL. Mówiąc najprościej: Hive daje Ci znany interfejs bazy danych (tabele, kolumny, zapytania SELECT) nad danymi, które fizycznie leżą jako pliki w rozproszonym systemie plików. Nie musisz wiedzieć, na ilu maszynach te pliki są rozrzucone ani jak są przetwarzane równolegle - piszesz zapytanie, a Hive robi resztę.
Kluczowe pojęcie, które warto od razu oswoić, to Hadoop. To otwarta platforma do przechowywania i przetwarzania danych na wielu maszynach naraz (tak zwanym klastrze). Jej sercem jest HDFS (Hadoop Distributed File System), czyli rozproszony system plików - dane są dzielone na bloki i rozkładane na wielu serwerach, z kopiami na wypadek awarii. Hive dokłada do tego warstwę, dzięki której z tymi plikami rozmawiasz jak ze zwykłą bazą.
Językiem Hive jest HiveQL - dialekt SQL. Jeśli znasz SELECT, JOIN i GROUP BY, to w Hive poczujesz się od razu jak w domu. Różnice wobec klasycznego SQL są, ale dla początkującego kosmetyczne. To była zresztą główna idea Hive: pozwolić tysiącom analityków i osób znających SQL pracować na danych w Hadoopie, bez przepisywania wszystkiego na niskopoziomowy kod.
Hive narodził się w Facebooku pod koniec pierwszej dekady XXI wieku. Firma miała dane rosnące szybciej, niż nadążały klasyczne bazy, i przeniosła je do Hadoopa. Problem w tym, że jedynym sposobem odpytywania Hadoopa był wtedy MapReduce - model przetwarzania, w którym każde zadanie trzeba było napisać ręcznie w Javie jako parę funkcji (mapującą i redukującą). Policzenie czegoś tak prostego jak liczba wierszy w podziale na regiony potrafiło zająć dziesiątki linii kodu i sporo czasu programisty.
Hive rozwiązał to elegancko. Zamiast pisać MapReduce ręcznie, wpisujesz zapytanie SQL, a Hive sam tłumaczy je na zadania rozproszone. Nagle analityk, który nigdy nie napisał linijki Javy, mógł samodzielnie liczyć na danych ważących terabajty. To otworzyło Big Data na znacznie szersze grono odbiorców i do dziś jest to najmocniejszy argument za tym narzędziem. Jeśli chcesz zobaczyć szerszy obraz tego, jak Hive wpisuje się w dzisiejszy krajobraz przetwarzania danych, opisaliśmy go w artykule o współczesnych rozwiązaniach Big Data.
Żeby zrozumieć Hive, trzeba zobaczyć, że to nie jest jeden program, lecz kilka współpracujących elementów nałożonych na Hadoop. Poniższa infografika pokazuje sześć składników, które razem robią z Hadoopa hurtownię z dostępem przez SQL.
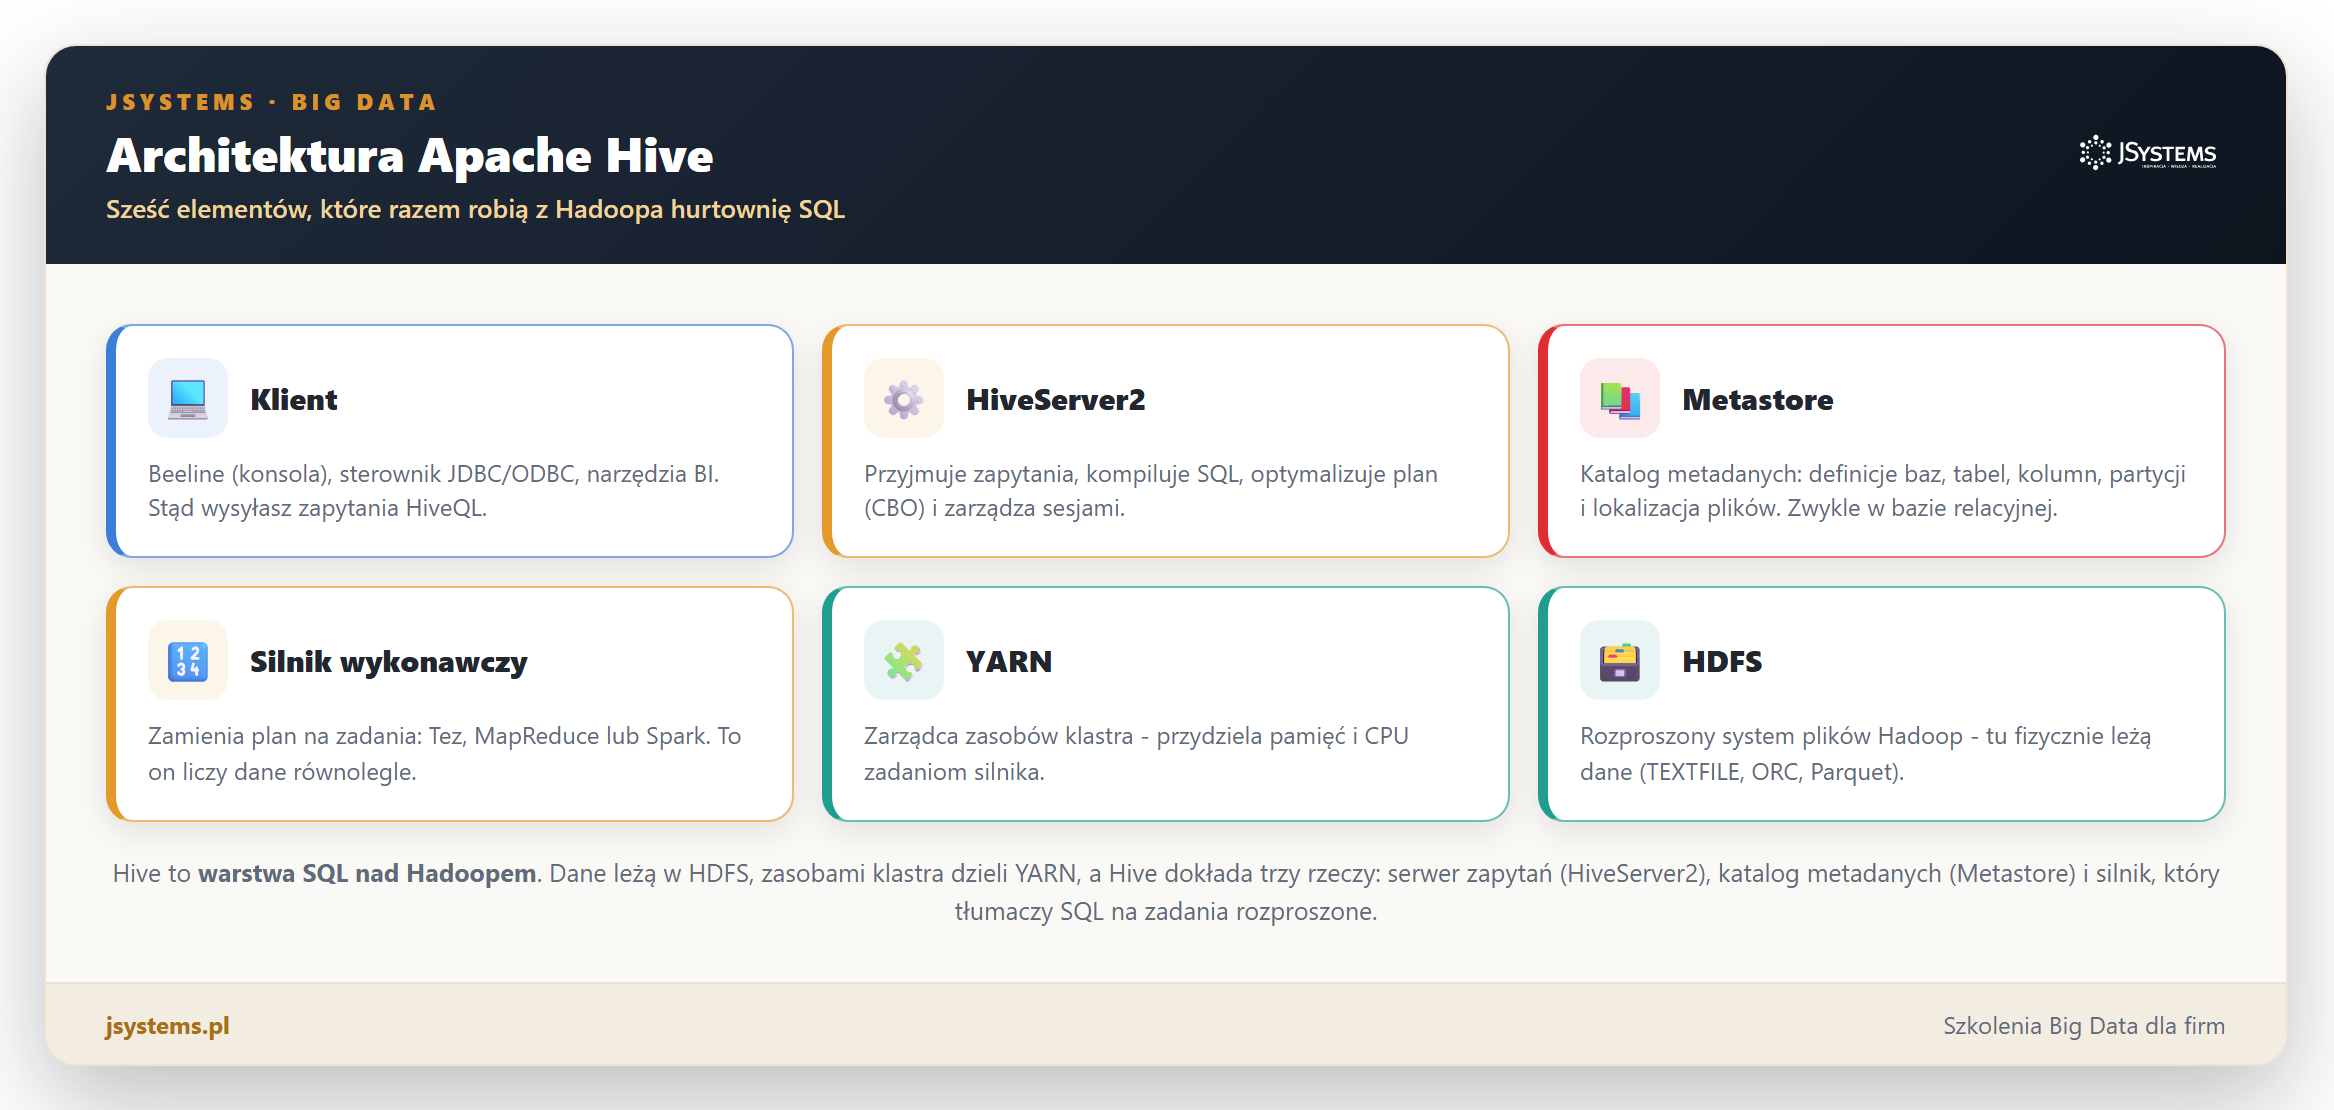
Prześledźmy te elementy po kolei, bo do każdego z nich będziemy jeszcze wracać:
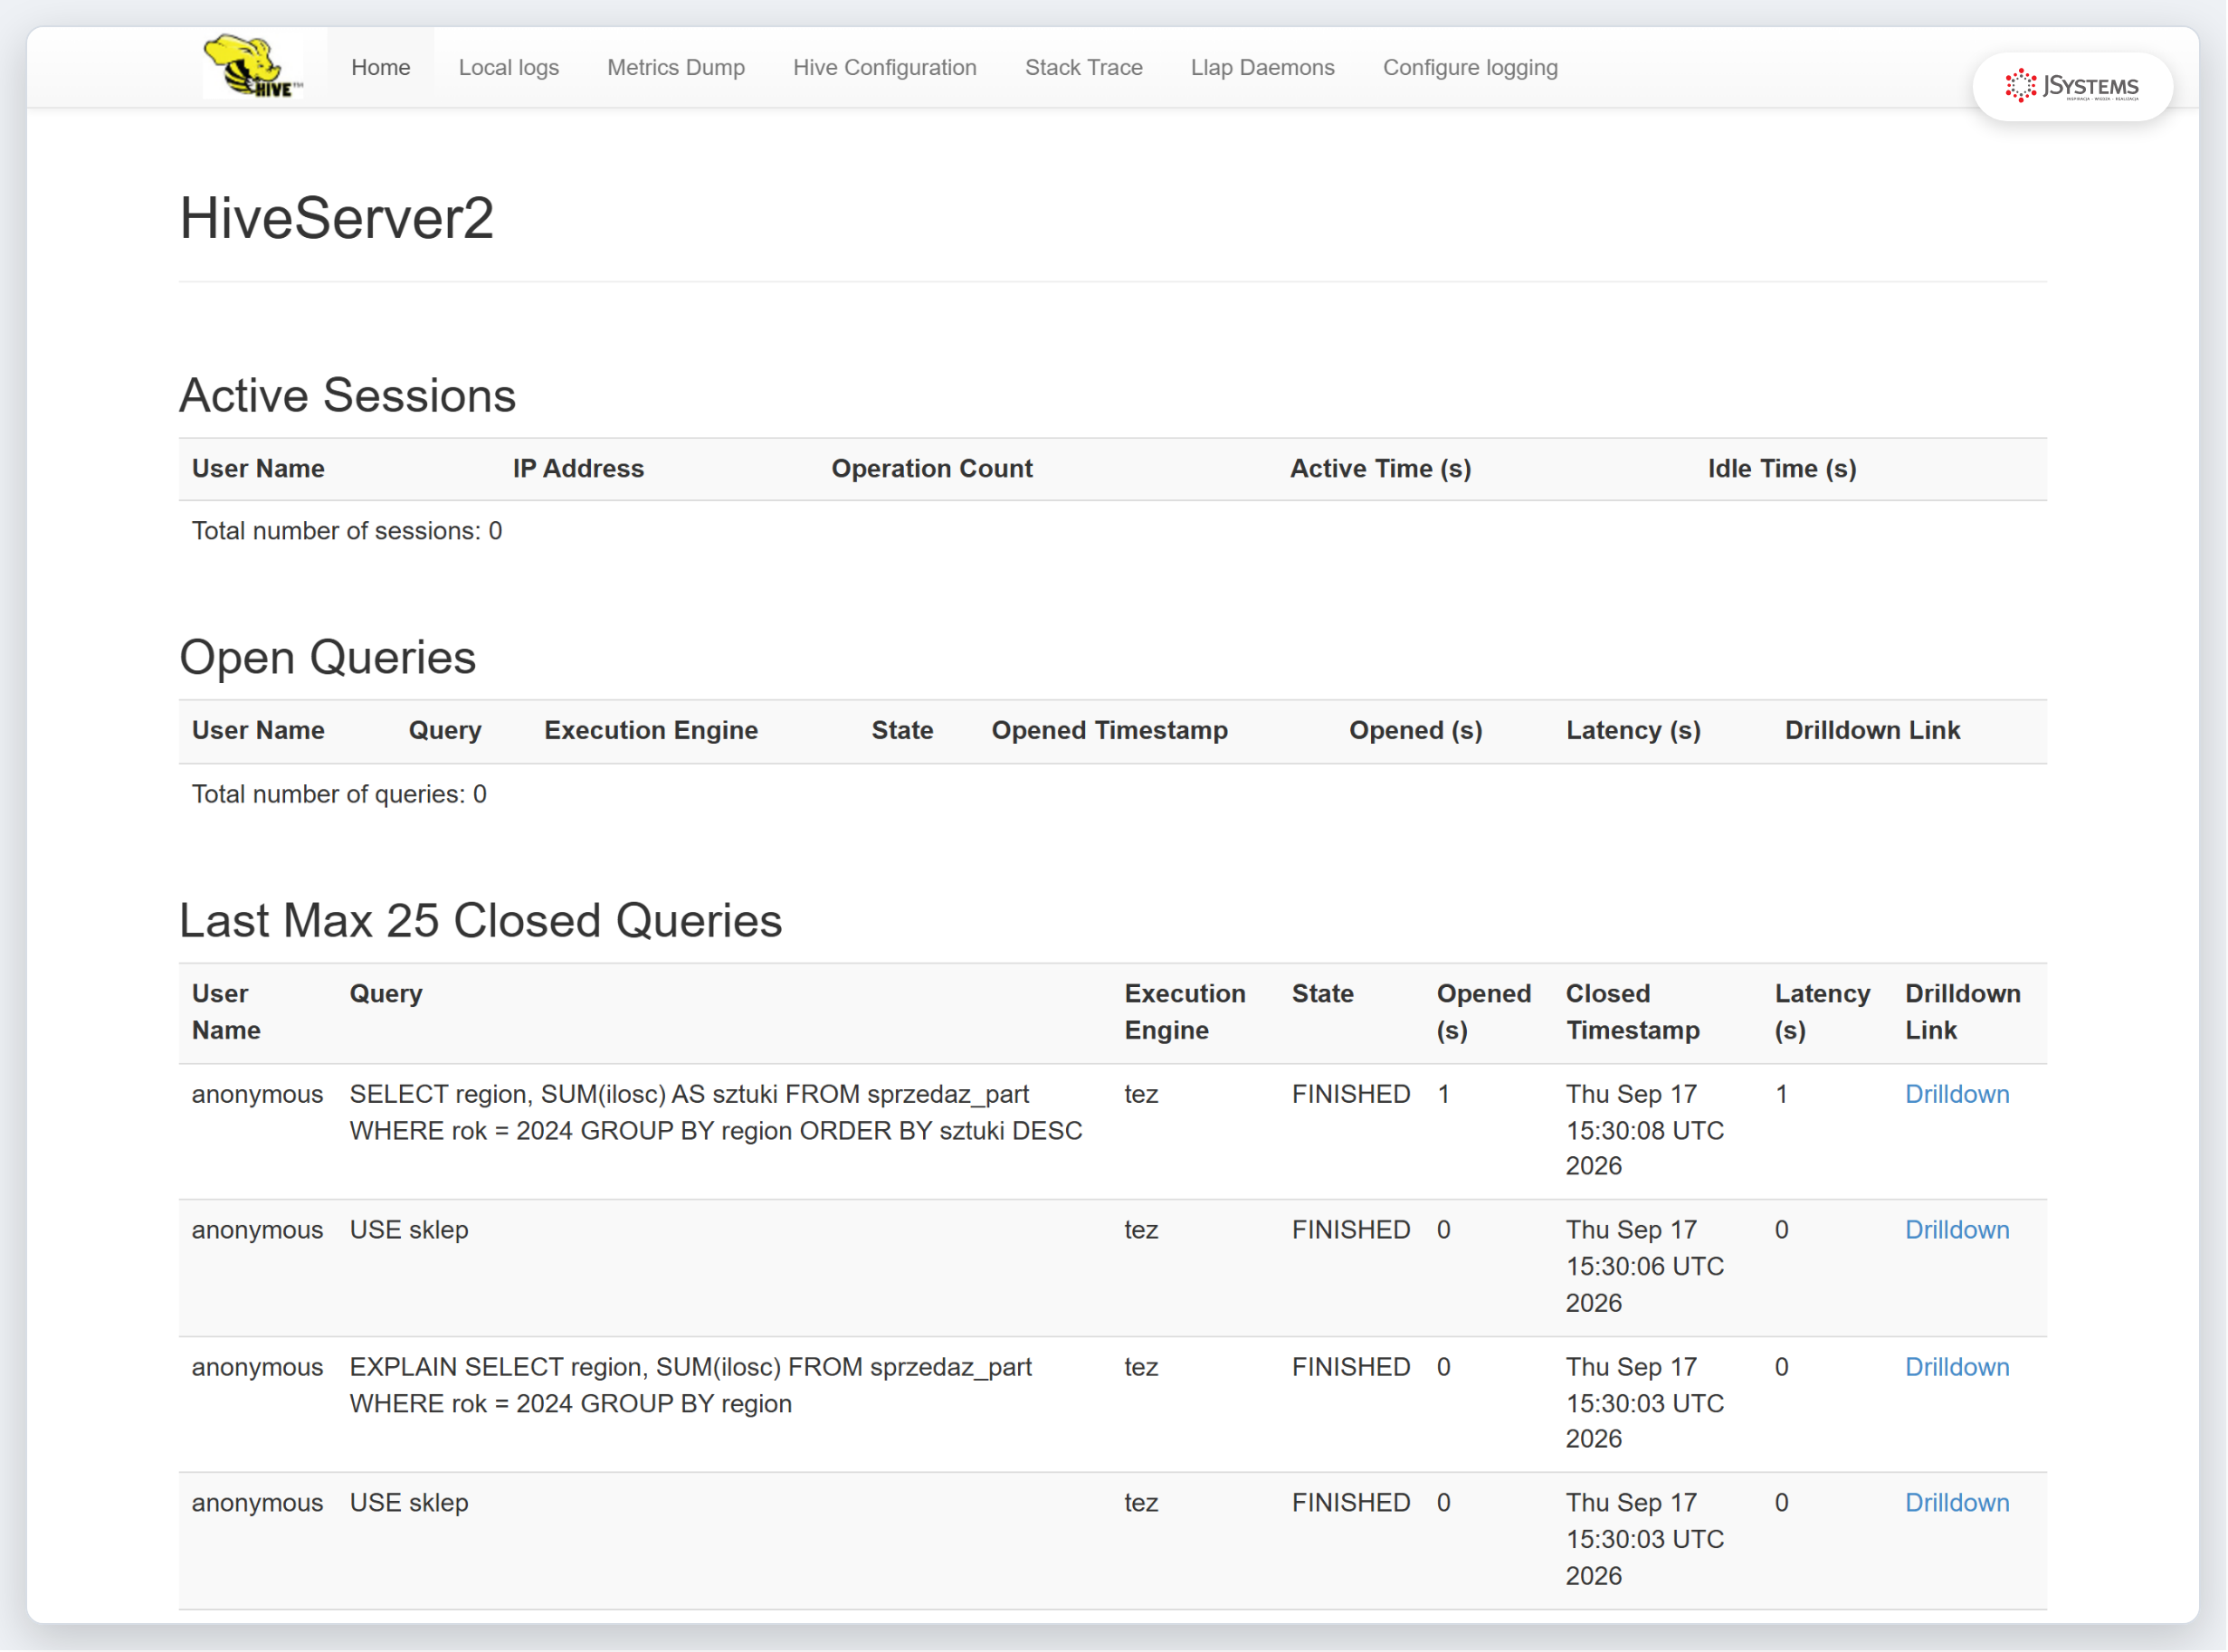
Hive udostępnia też prosty panel WWW (Web UI serwera HiveServer2), w którym widać uruchomione i zakończone zapytania. Poniżej nasz działający Hive tuż po wykonaniu kilku zapytań demonstracyjnych - zwróć uwagę na kolumnę Execution Engine z wartością tez.
Tu pojawia się jedna z najważniejszych różnic między Hive a klasyczną bazą. Tradycyjna baza działa w modelu schema-on-write (schemat przy zapisie) - najpierw definiujesz tabelę, a potem baza sprawdza każdy ładowany wiersz i odrzuca dane niezgodne ze schematem. Hive domyślnie działa odwrotnie, w modelu schema-on-read (schemat przy odczycie): najpierw wrzucasz surowe pliki, a schemat nakładasz na nie dopiero w momencie tworzenia tabeli i odczytu.
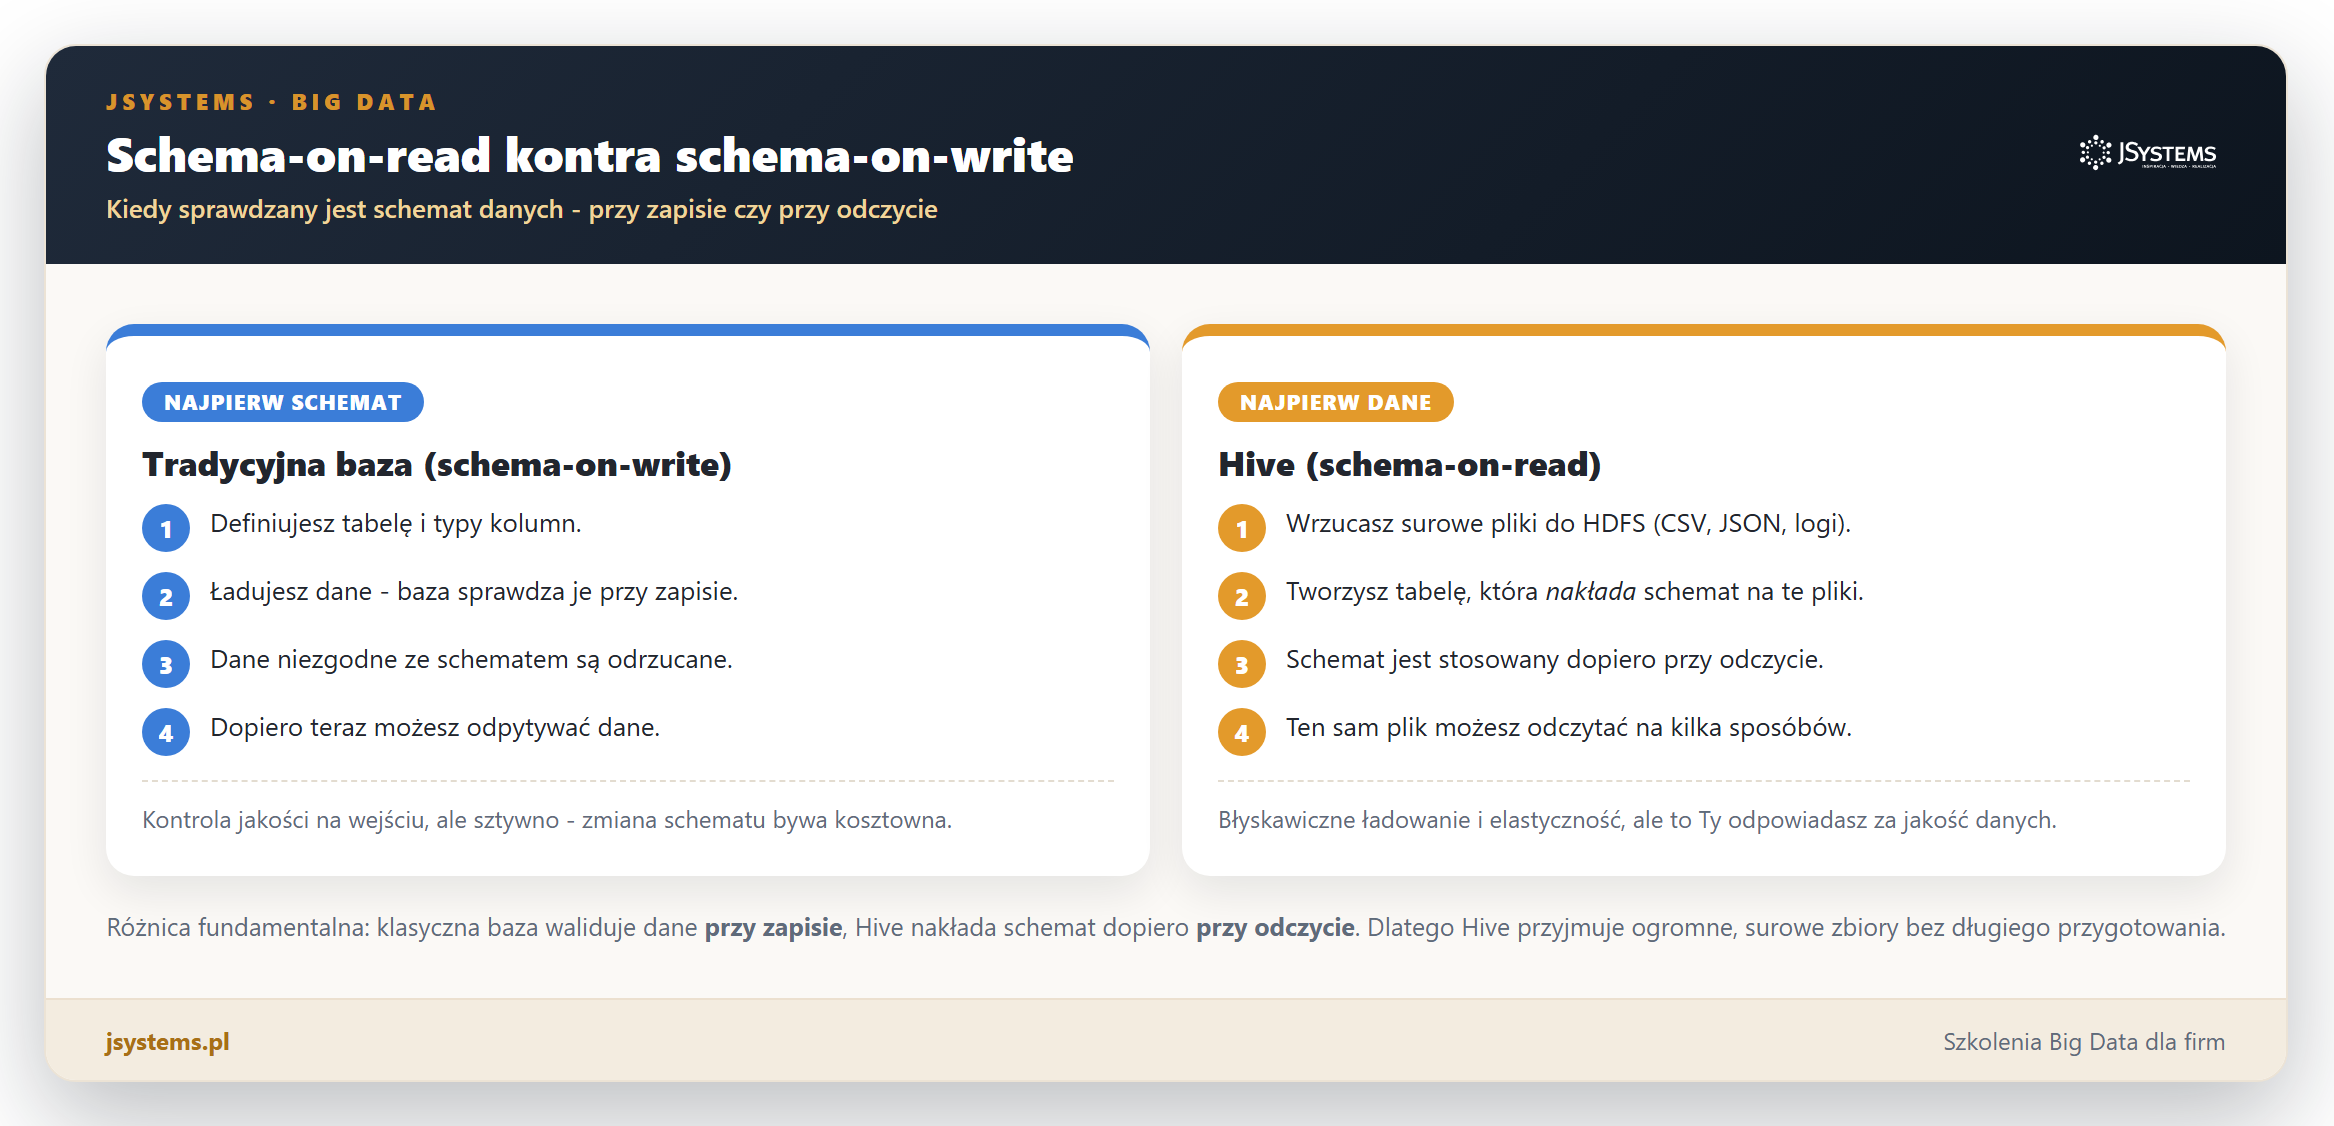
W praktyce wygląda to tak, że mamy w rozproszonym systemie plików zwykły plik CSV ze sprzedażą, a następnie tworzymy nad nim tabelę zewnętrzną (external table). Słowo zewnętrzna oznacza, że Hive tylko wskazuje na istniejące pliki i nimi zarządza, ale nie jest ich właścicielem - skasowanie tabeli nie usunie danych. Oto polecenie, którym nałożyliśmy schemat na nasz plik sprzedaży:
CREATE EXTERNAL TABLE sprzedaz_raw (
  id          INT,
  data        STRING,
  product_id  INT,
  region      STRING,
  ilosc       INT,
  kanal       STRING
)
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
STORED AS TEXTFILE
LOCATION '/data/sprzedaz';
Po utworzeniu tabeli możemy podejrzeć jej strukturę poleceniem DESCRIBE. Hive zna kolumny nie dlatego, że przeanalizował plik, ale dlatego, że taki schemat sami zadeklarowaliśmy - i zapamiętał go Metastore.
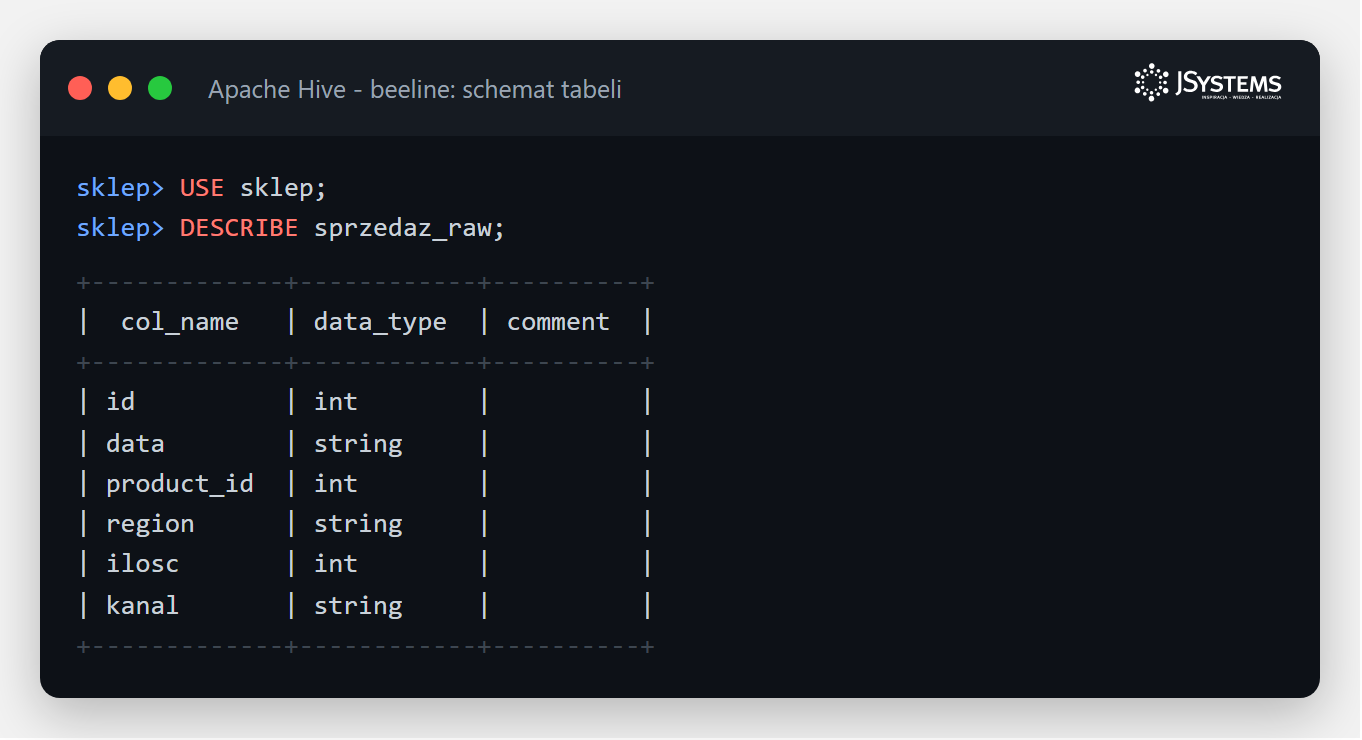
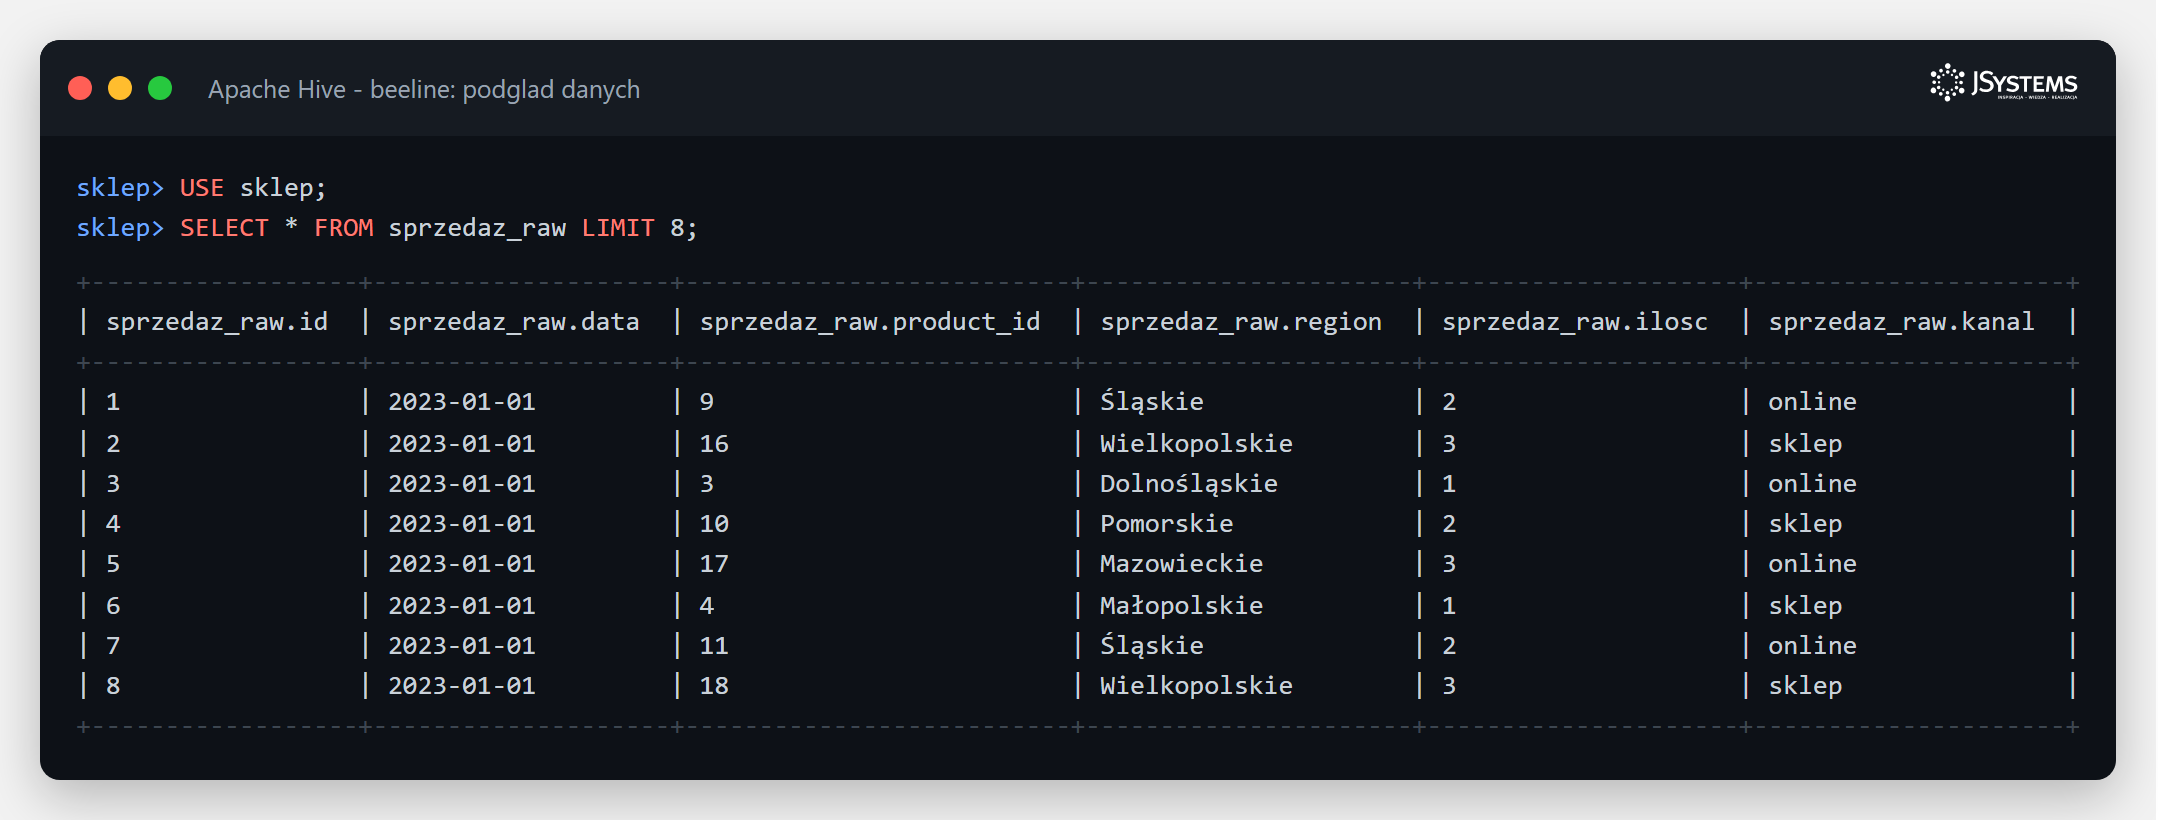
Teraz najciekawsze: mimo że pod spodem leży zwykły plik tekstowy, możemy go odpytać jak każdą tabelę. Podejrzyjmy kilka pierwszych wierszy naszych realnych danych.
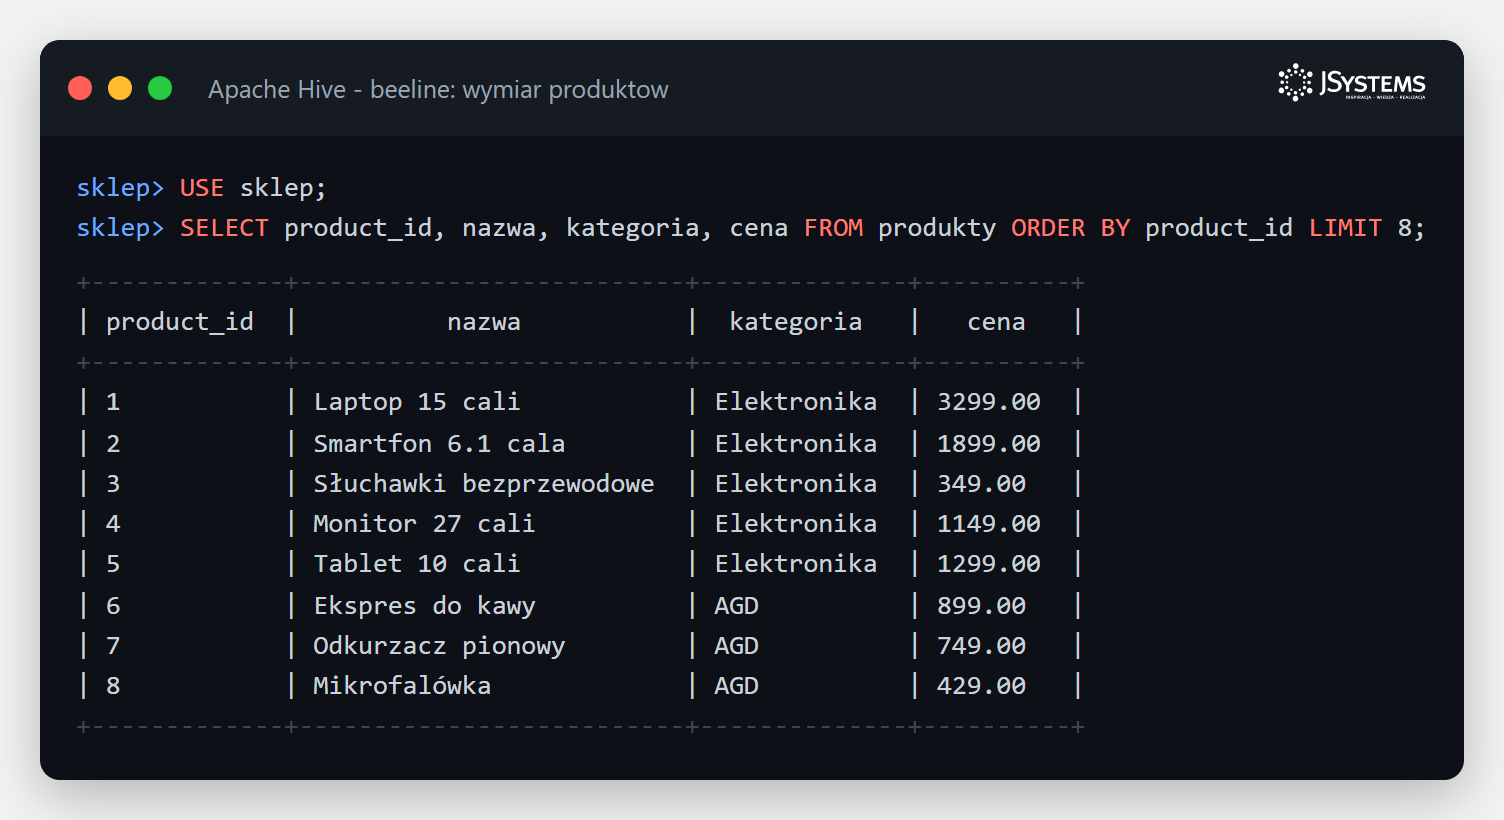
Obok tabeli faktów ze sprzedażą mamy drugą, mniejszą tabelę - wymiar produktów. To klasyczny podział w hurtowni: duża tabela zdarzeń (transakcje) i małe tabele opisowe (produkty, kategorie), które za chwilę połączymy zapytaniem.
Ile w ogóle mamy danych? Jedno proste zapytanie liczące i już wiemy, że pracujemy na ponad pięćdziesięciu tysiącach transakcji.
Skoro mamy tabele, zadajmy im pytania biznesowe. Zacznijmy od agregacji: ile transakcji i ile sprzedanych sztuk przypada na każdy region. To zwykły GROUP BY, identyczny jak w dowolnej bazie SQL.
SELECT region,
       COUNT(*)      AS transakcje,
       SUM(ilosc)    AS sztuki
  FROM sprzedaz_raw
 GROUP BY region
 ORDER BY sztuki DESC;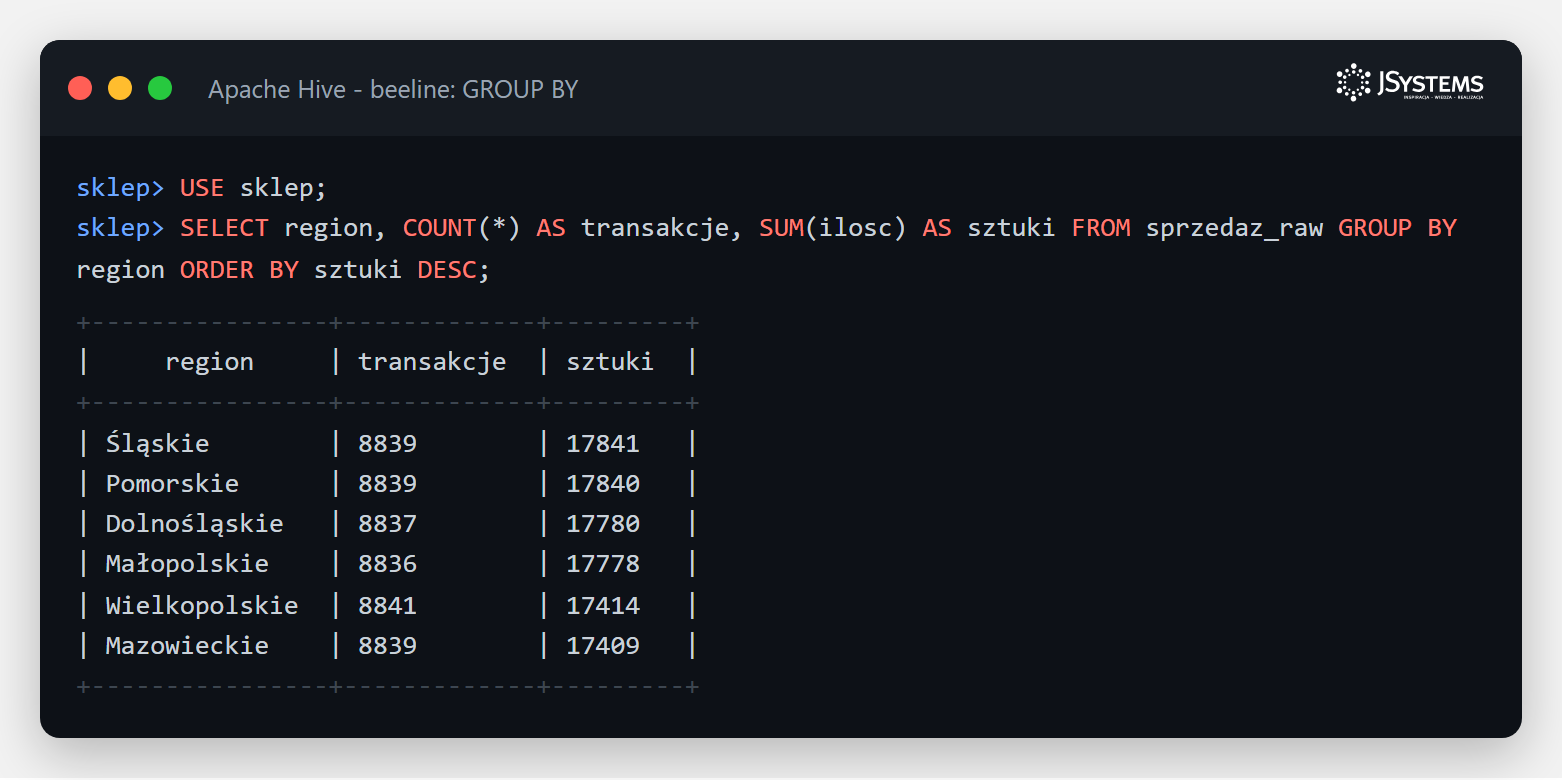
Prawdziwa moc analityki to łączenie tabel. Połączmy sprzedaż z produktami, żeby policzyć przychód w podziale na kategorie. Mnożymy ilość przez cenę z tabeli produktów - to wymaga złączenia (JOIN) obu tabel po kluczu product_id.
SELECT p.kategoria,
       COUNT(*)                       AS transakcje,
       ROUND(SUM(s.ilosc * p.cena), 2) AS przychod_pln
  FROM sprzedaz_raw s
  JOIN produkty p ON s.product_id = p.product_id
 GROUP BY p.kategoria
 ORDER BY przychod_pln DESC;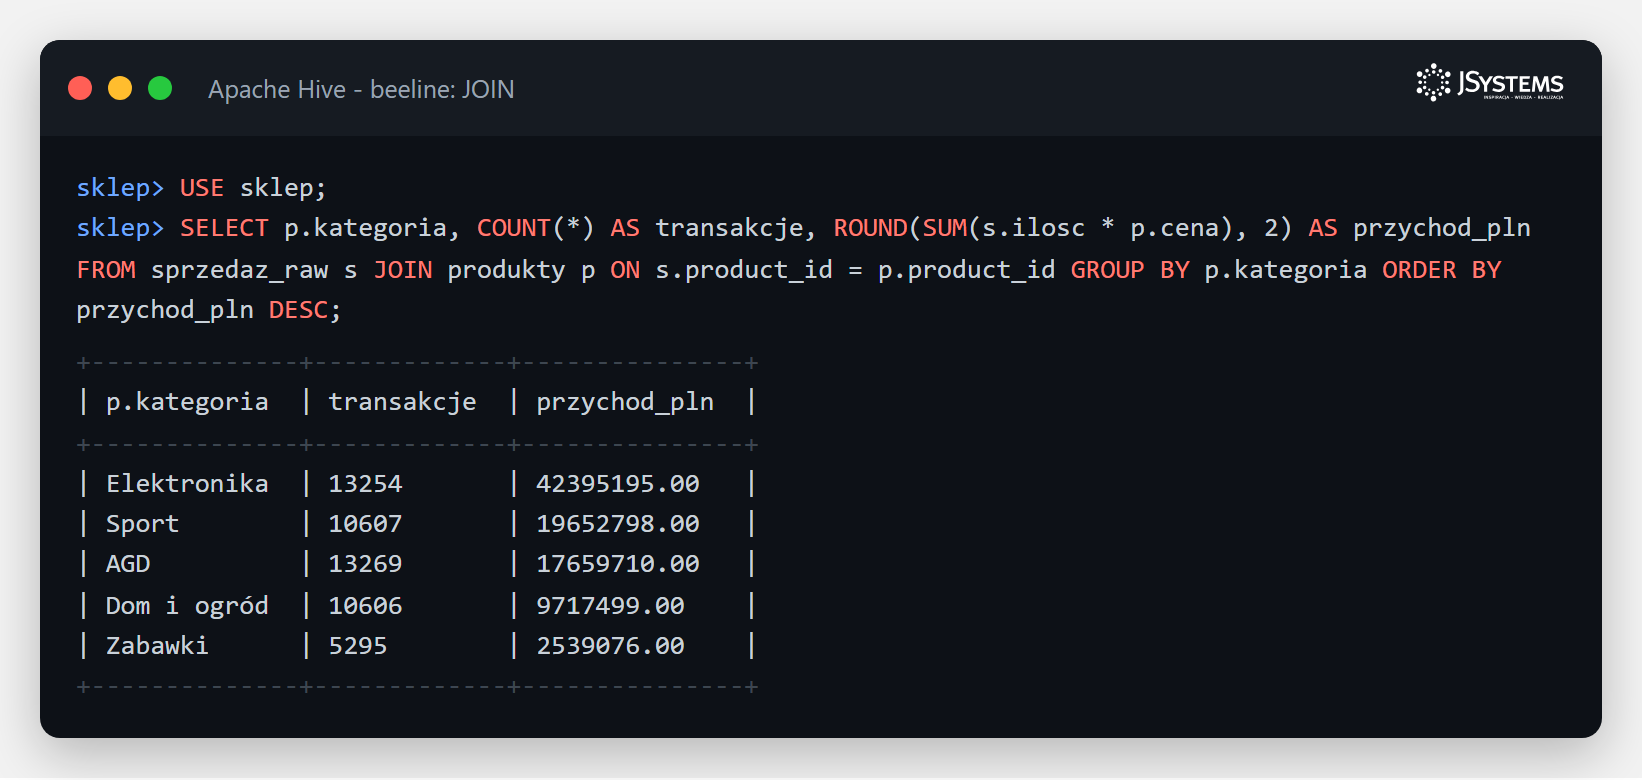
Widać od razu, że Elektronika z przychodem ponad 42 miliony złotych mocno wyprzedza pozostałe kategorie. Zejdźmy poziom niżej i sprawdźmy, które konkretne produkty sprzedają się najlepiej. To znów ten sam JOIN, tylko grupowany po nazwie produktu i ograniczony do pierwszej piątki.
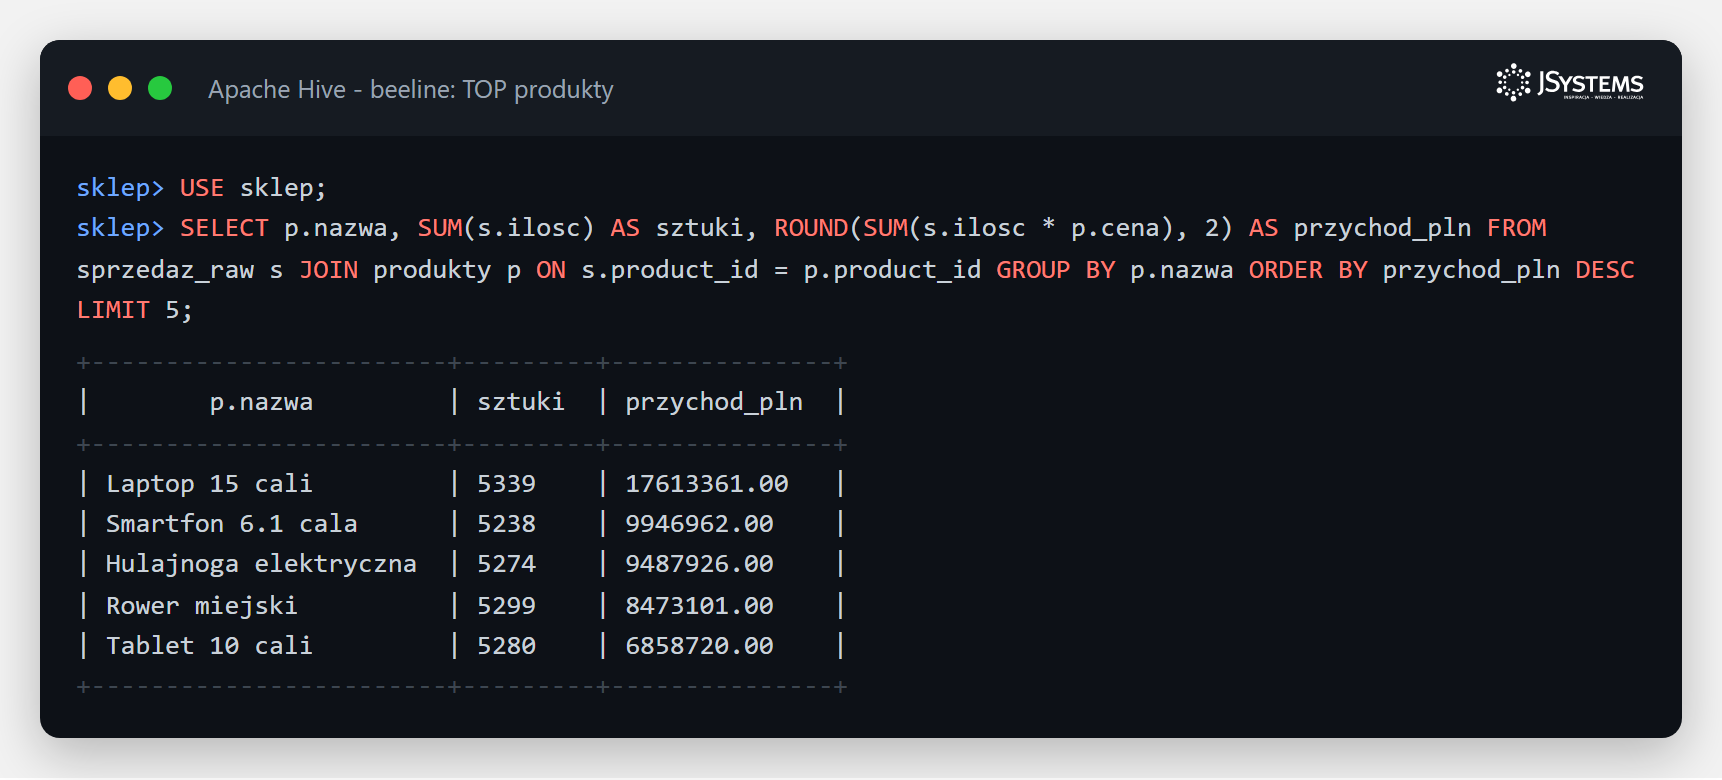
To jest właśnie codzienna praca w Hive: analityczne pytania do dużych zbiorów, zadawane zwykłym SQL.
Chcesz opanować HiveQL od podstaw? Szkolenie Big Data: Apache Hive - HiveQL od podstaw do technik zaawansowanych.
Gdy dane rosną, przeszukiwanie całego zbioru przy każdym zapytaniu robi się kosztowne. Hive ma na to partycjonowanie - fizyczny podział tabeli na mniejsze części według wybranej kolumny. Każda partycja to osobny katalog plików. Naszą sprzedaż podzieliliśmy według roku i miesiąca, co dało 24 partycje (dwa lata po dwanaście miesięcy).
CREATE TABLE sprzedaz_part (
  id INT, data STRING, product_id INT,
  region STRING, ilosc INT, kanal STRING
)
PARTITIONED BY (rok INT, miesiac INT)
STORED AS ORC;

-- wypelniamy partycje danymi z tabeli surowej
INSERT OVERWRITE TABLE sprzedaz_part PARTITION (rok, miesiac)
SELECT id, data, product_id, region, ilosc, kanal,
       YEAR(data), MONTH(data)
  FROM sprzedaz_raw;
Listę utworzonych partycji sprawdzimy poleceniem SHOW PARTITIONS. Każdy wpis to osobny katalog na dysku - Hive trzyma dane każdego miesiąca oddzielnie.
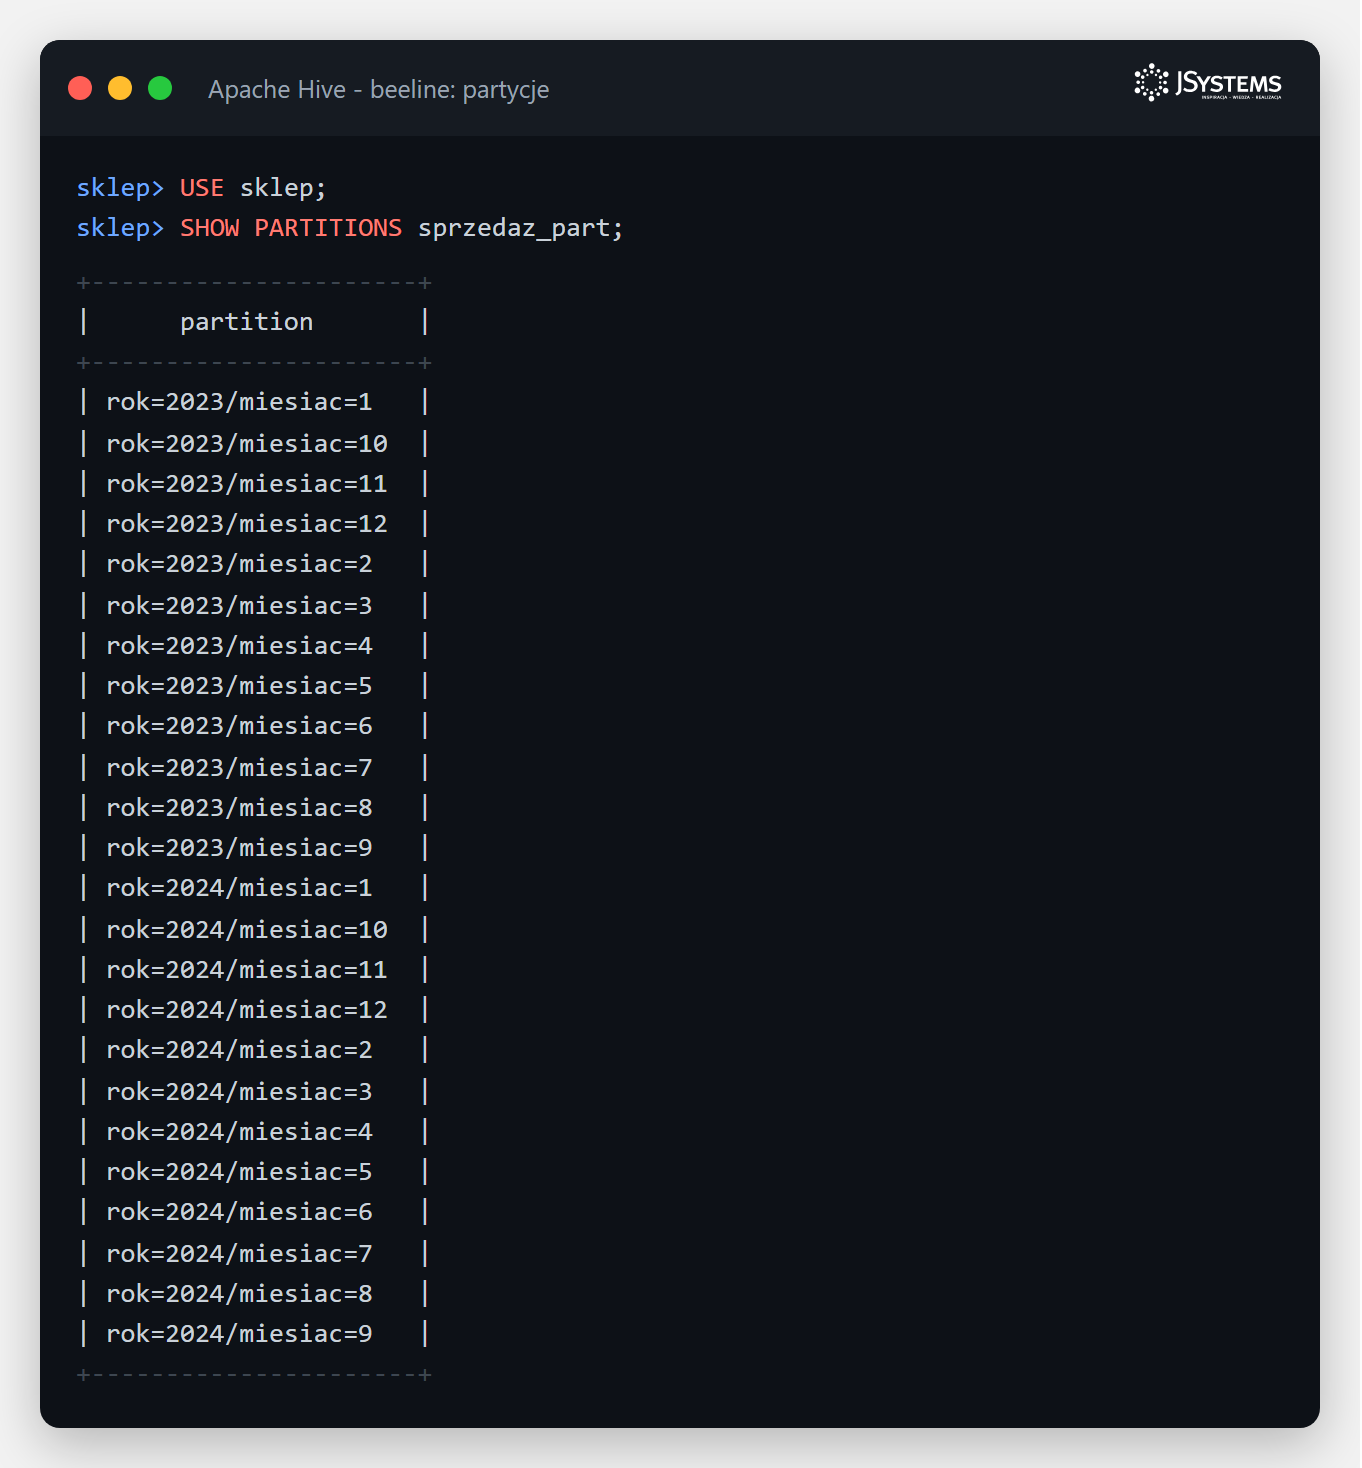
Po co ten podział? Dzięki niemu zapytanie z warunkiem na kolumnie partycjonującej czyta tylko potrzebne katalogi, a resztę pomija. Ten mechanizm nazywa się partition pruning (przycinanie partycji). Poniższa animacja pokazuje go w działaniu: pytanie o rok 2024 w ogóle nie dotyka danych z 2023.
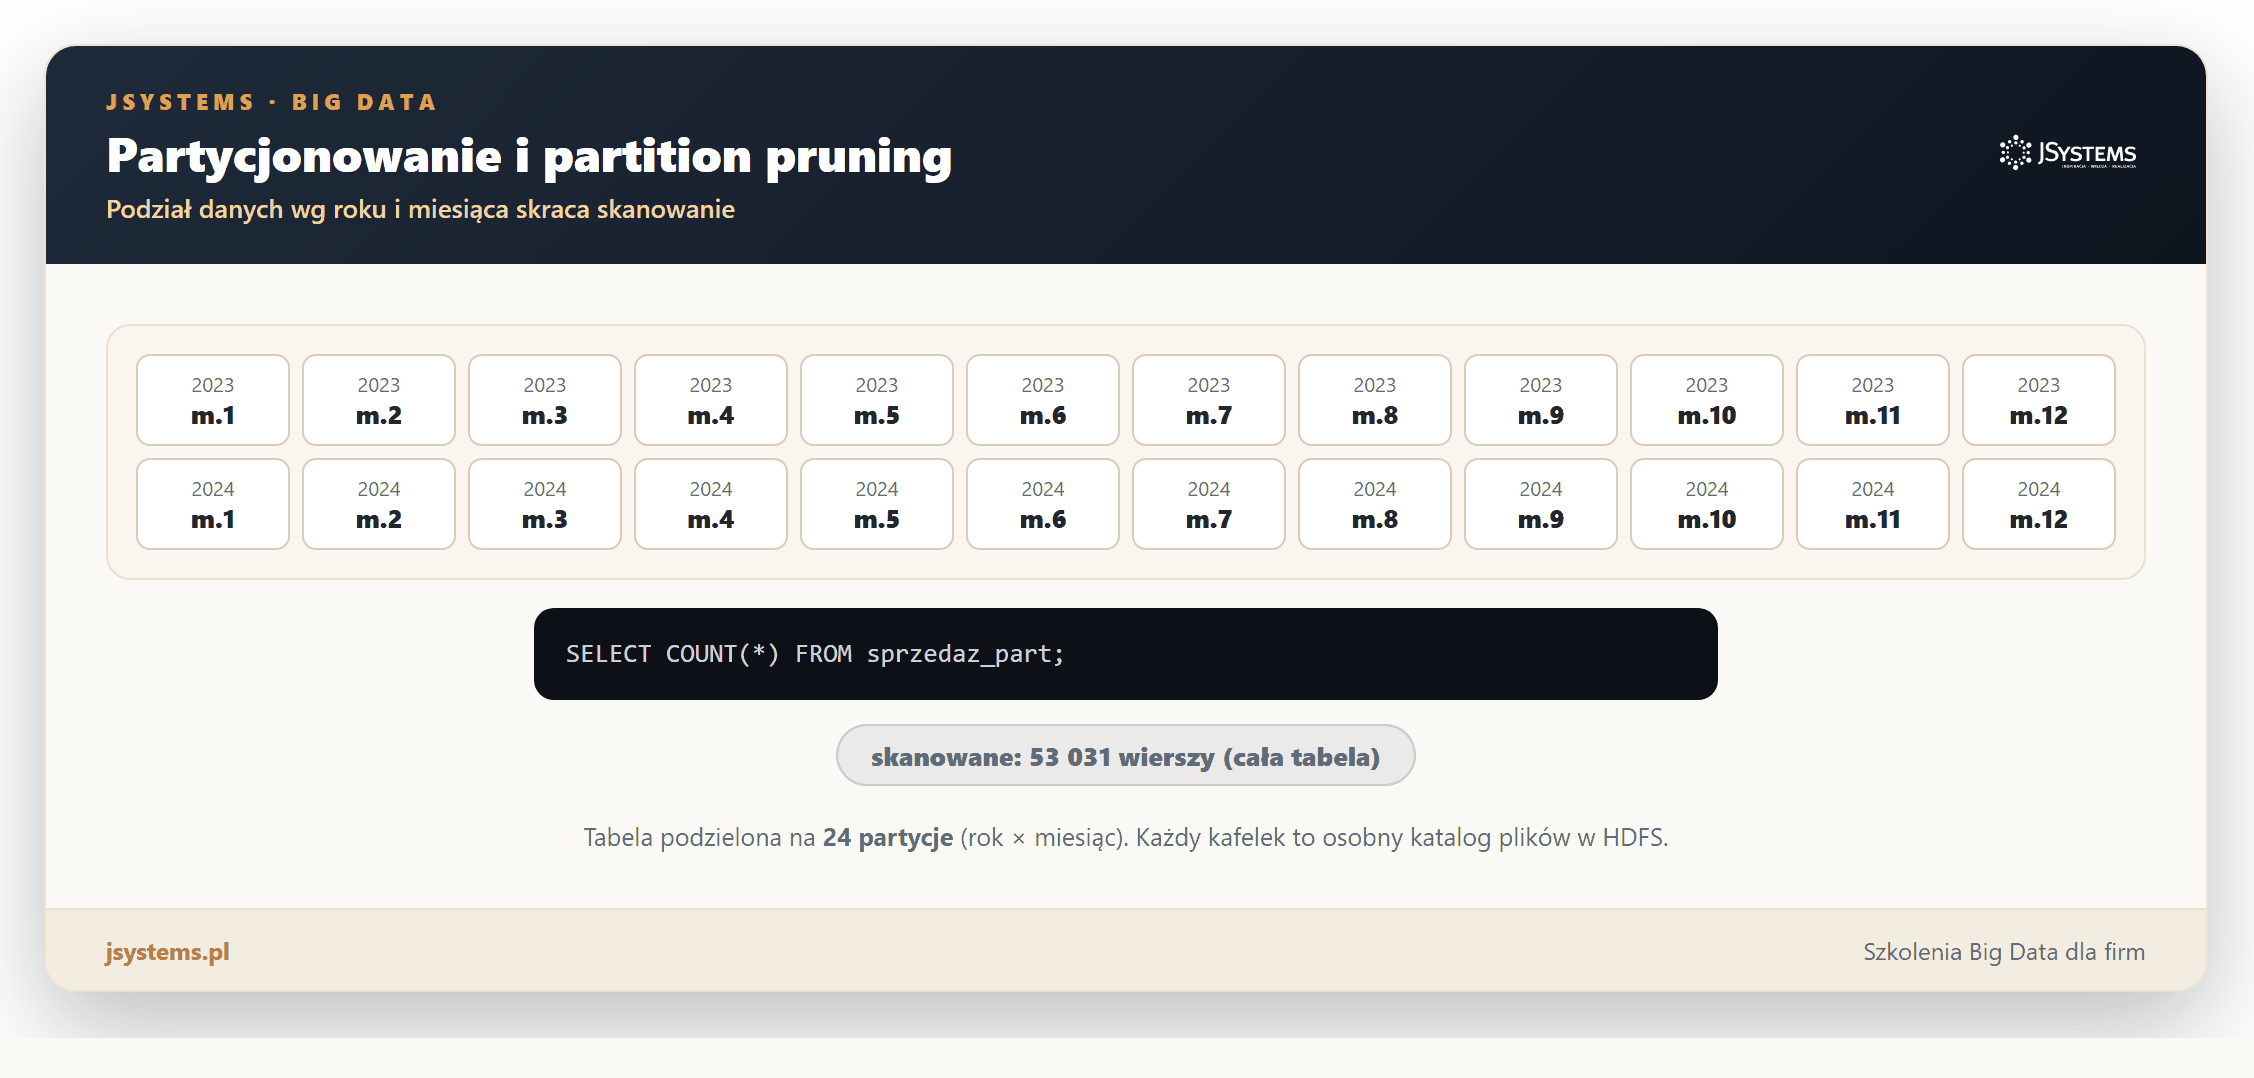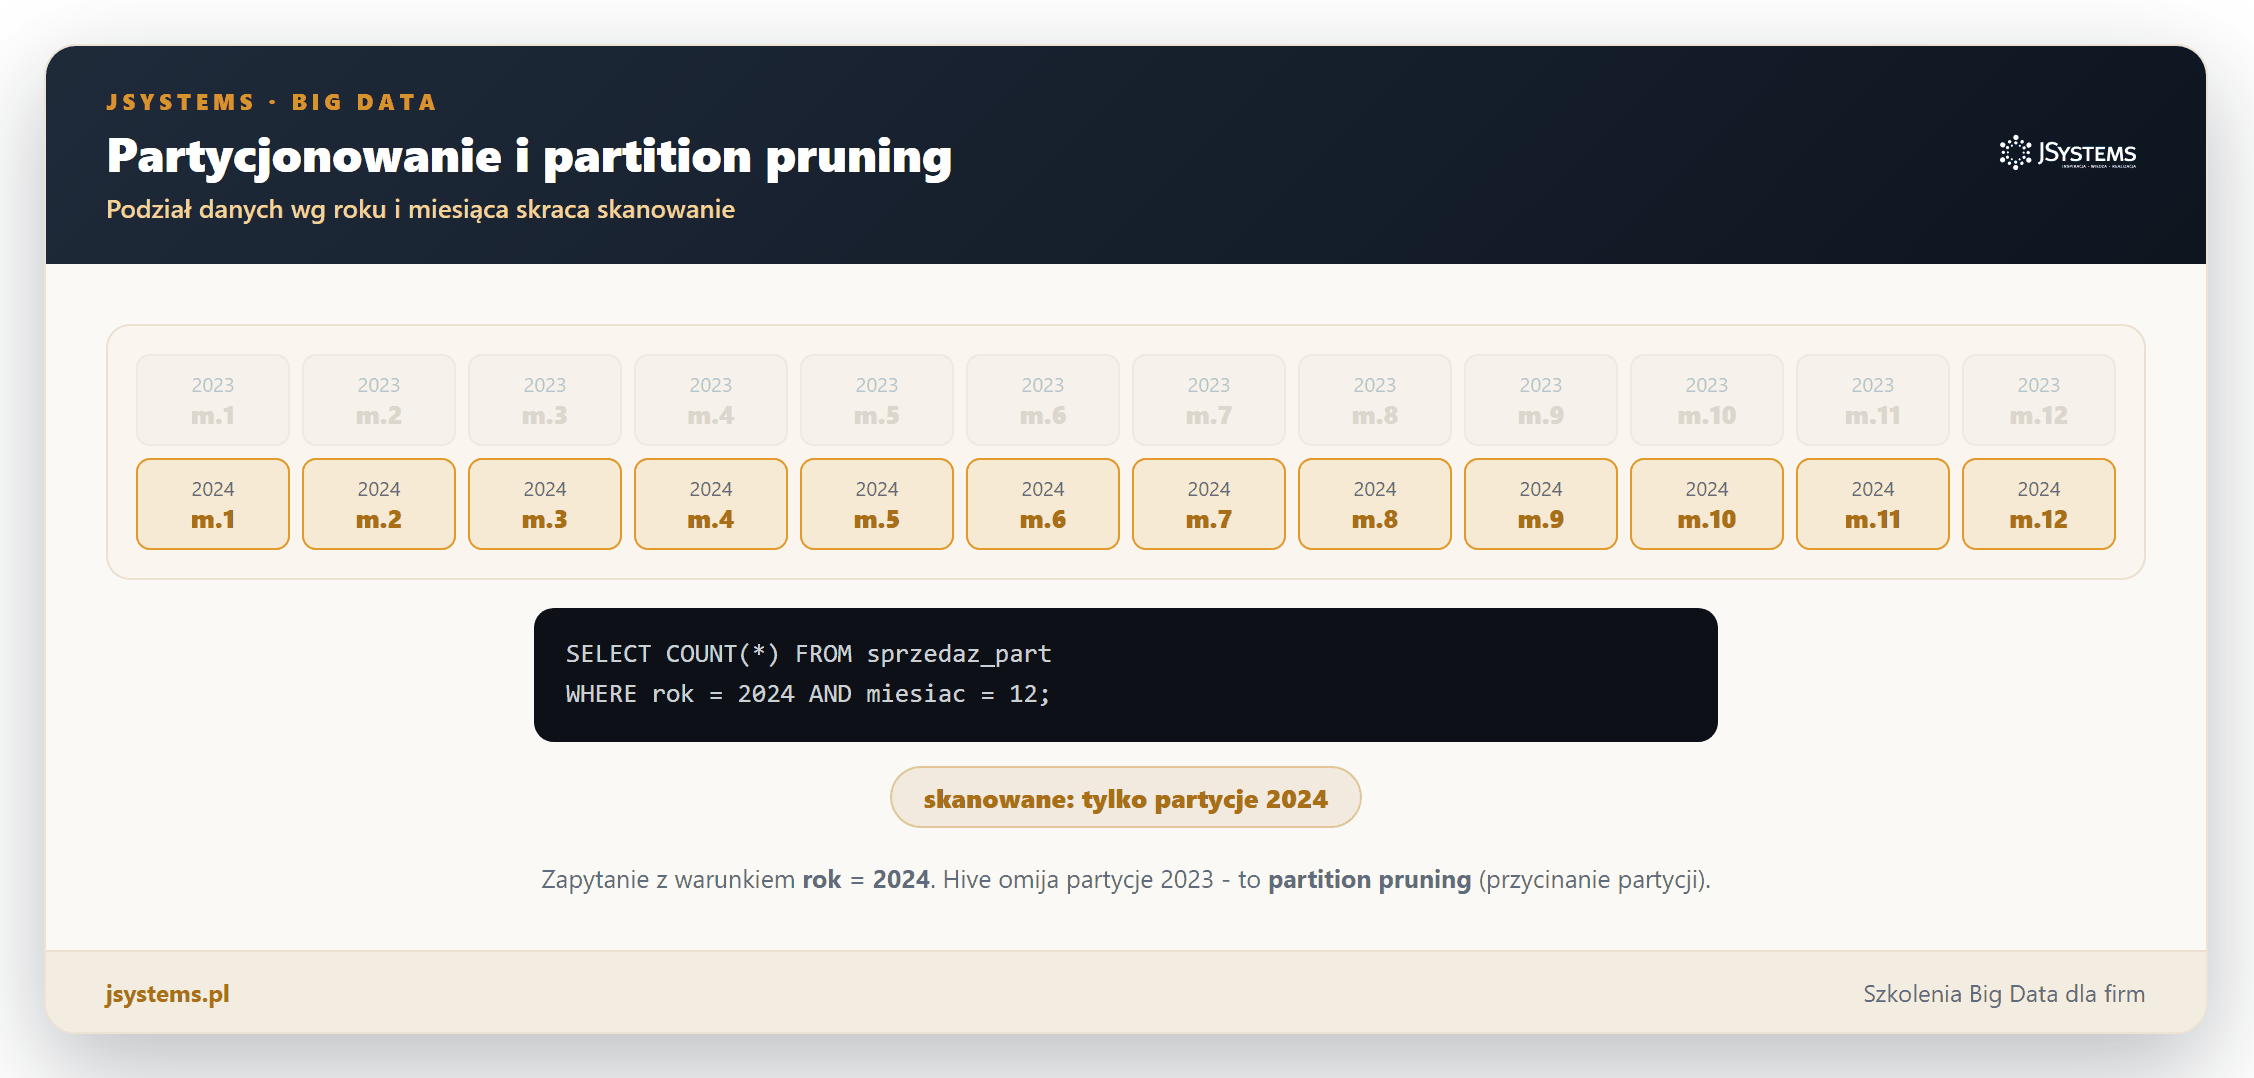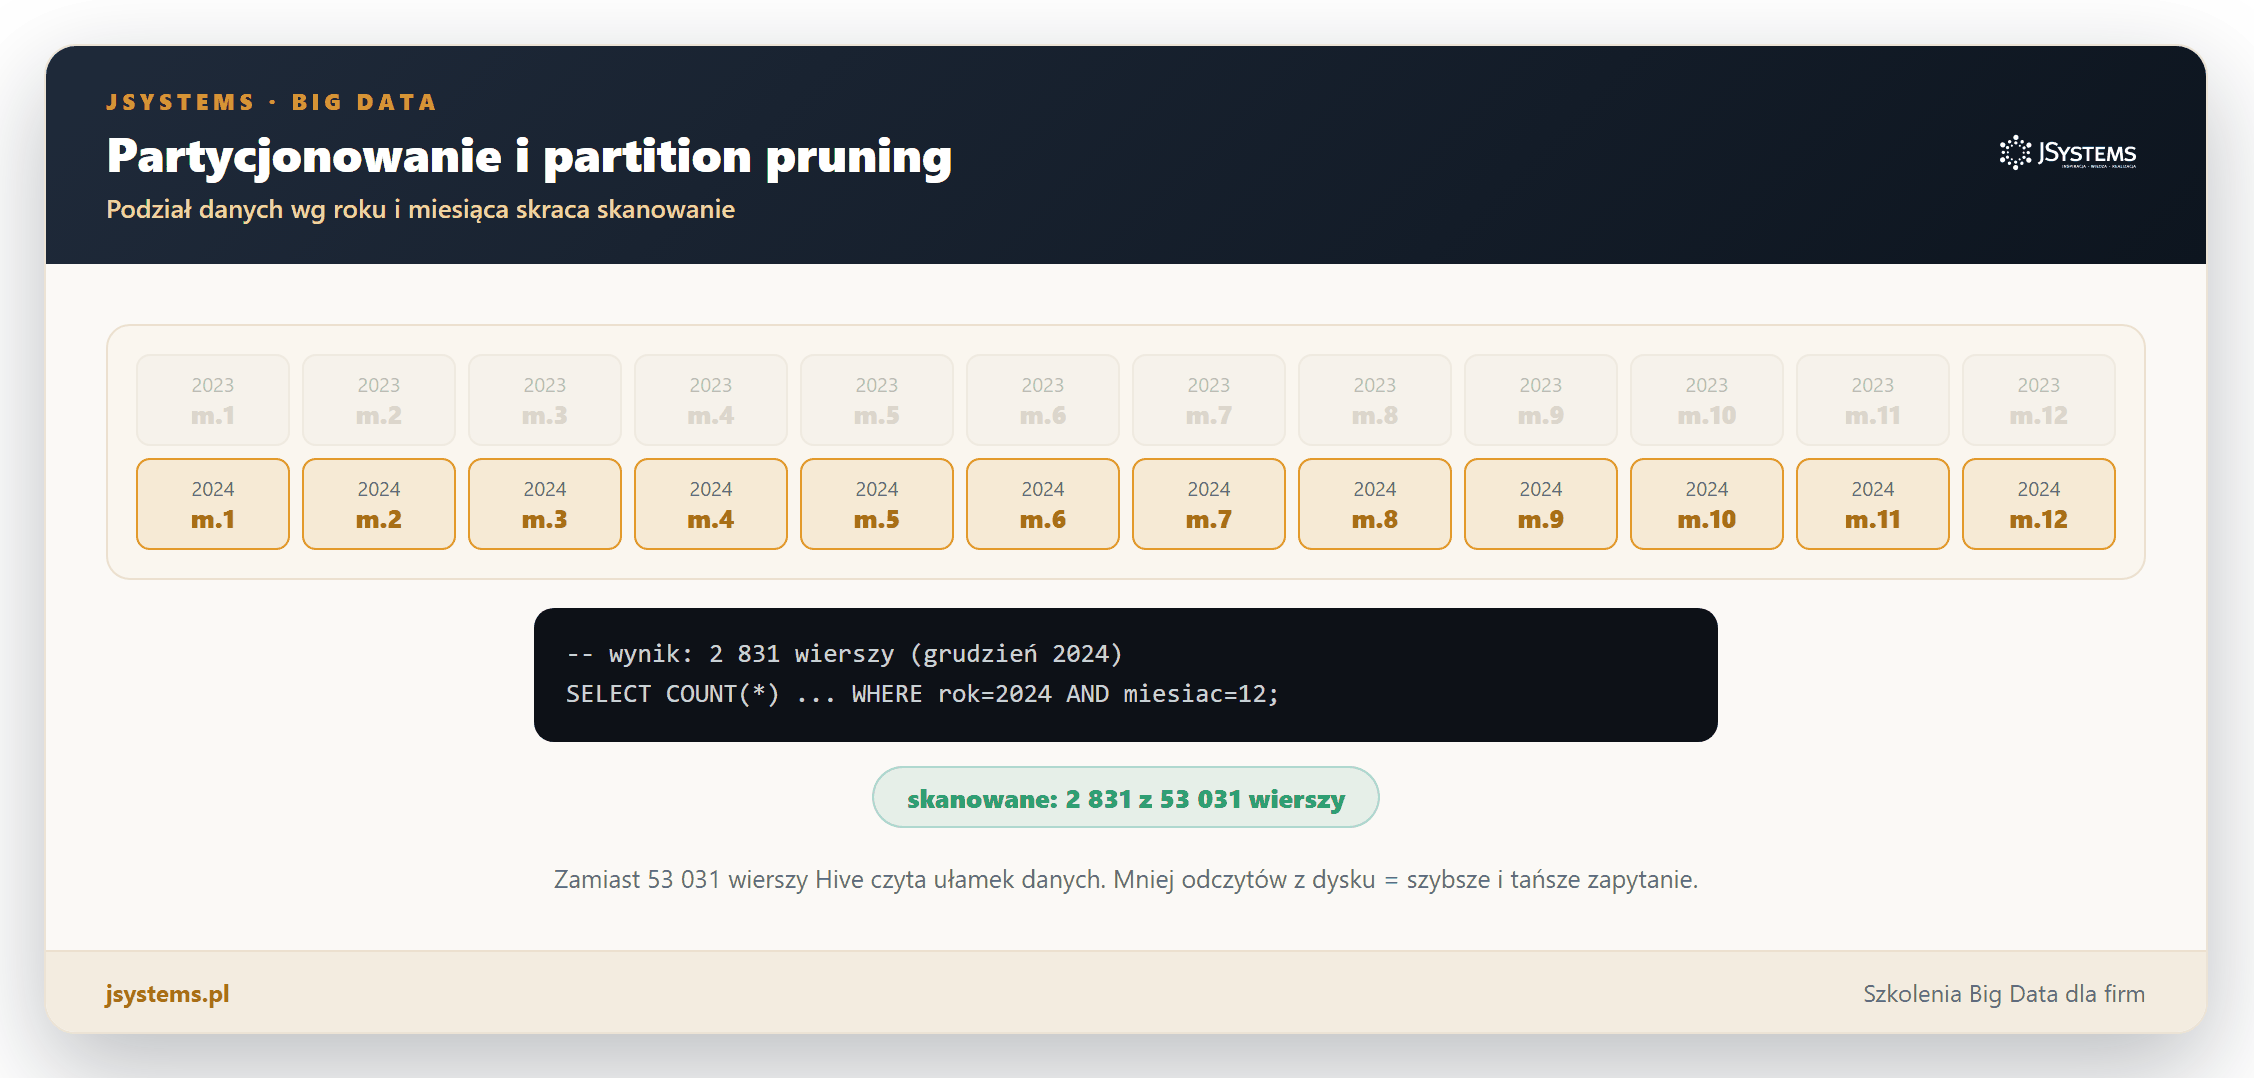
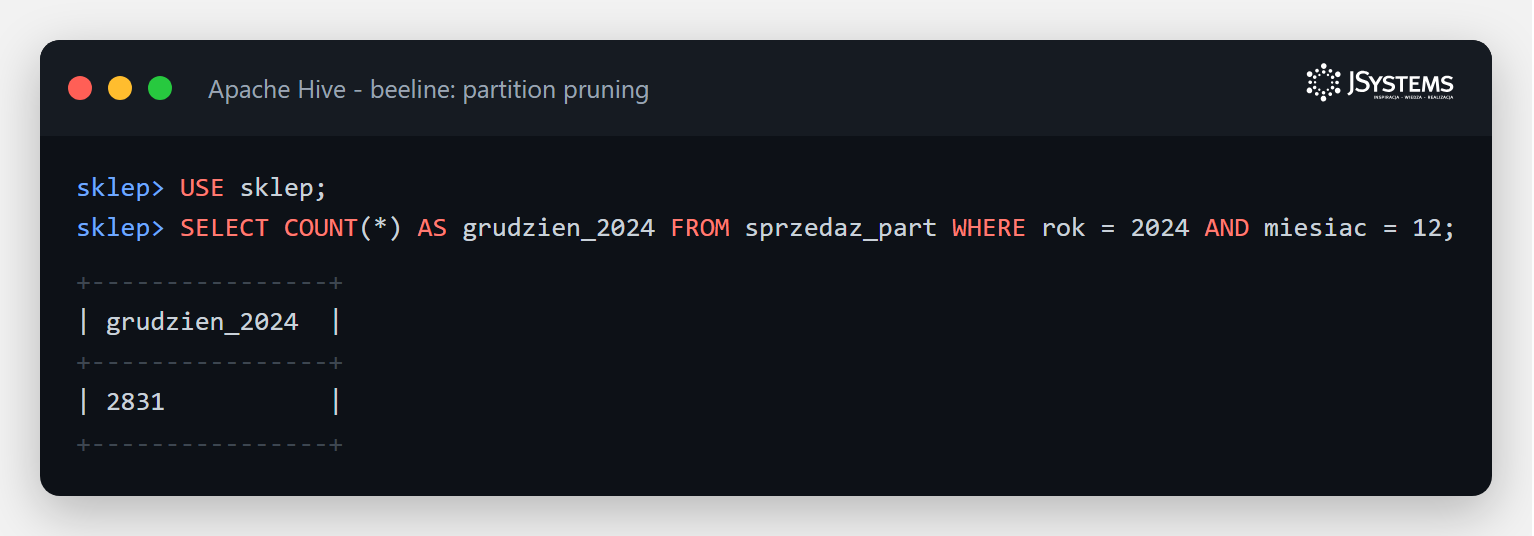
Zobaczmy to na liczbach. Zapytanie o grudzień 2024 zwraca 2 831 wierszy, a co ważniejsze - Hive nie musiał w tym celu przeglądać całego zbioru. To jest sedno optymalizacji zapytań w hurtowni Big Data.
Partycjonowanie to jedna z pierwszych rzeczy, których uczy się każdy inżynier danych pracujący z Hive czy Spark. To wraz z formatami kolumnowymi i doborem silnika stanowi fundament optymalizacji zapytań na dużych zbiorach.
Zwróć uwagę, że tabelę partycjonowaną zapisaliśmy w formacie ORC, a nie jako zwykły tekst. Format pliku ma w Hive ogromne znaczenie dla wydajności i zajętości miejsca. Upraszczając, są dwa światy: formaty wierszowe (cały rekord zapisany po kolei, jak w CSV) oraz formaty kolumnowe (osobno zapisana każda kolumna).
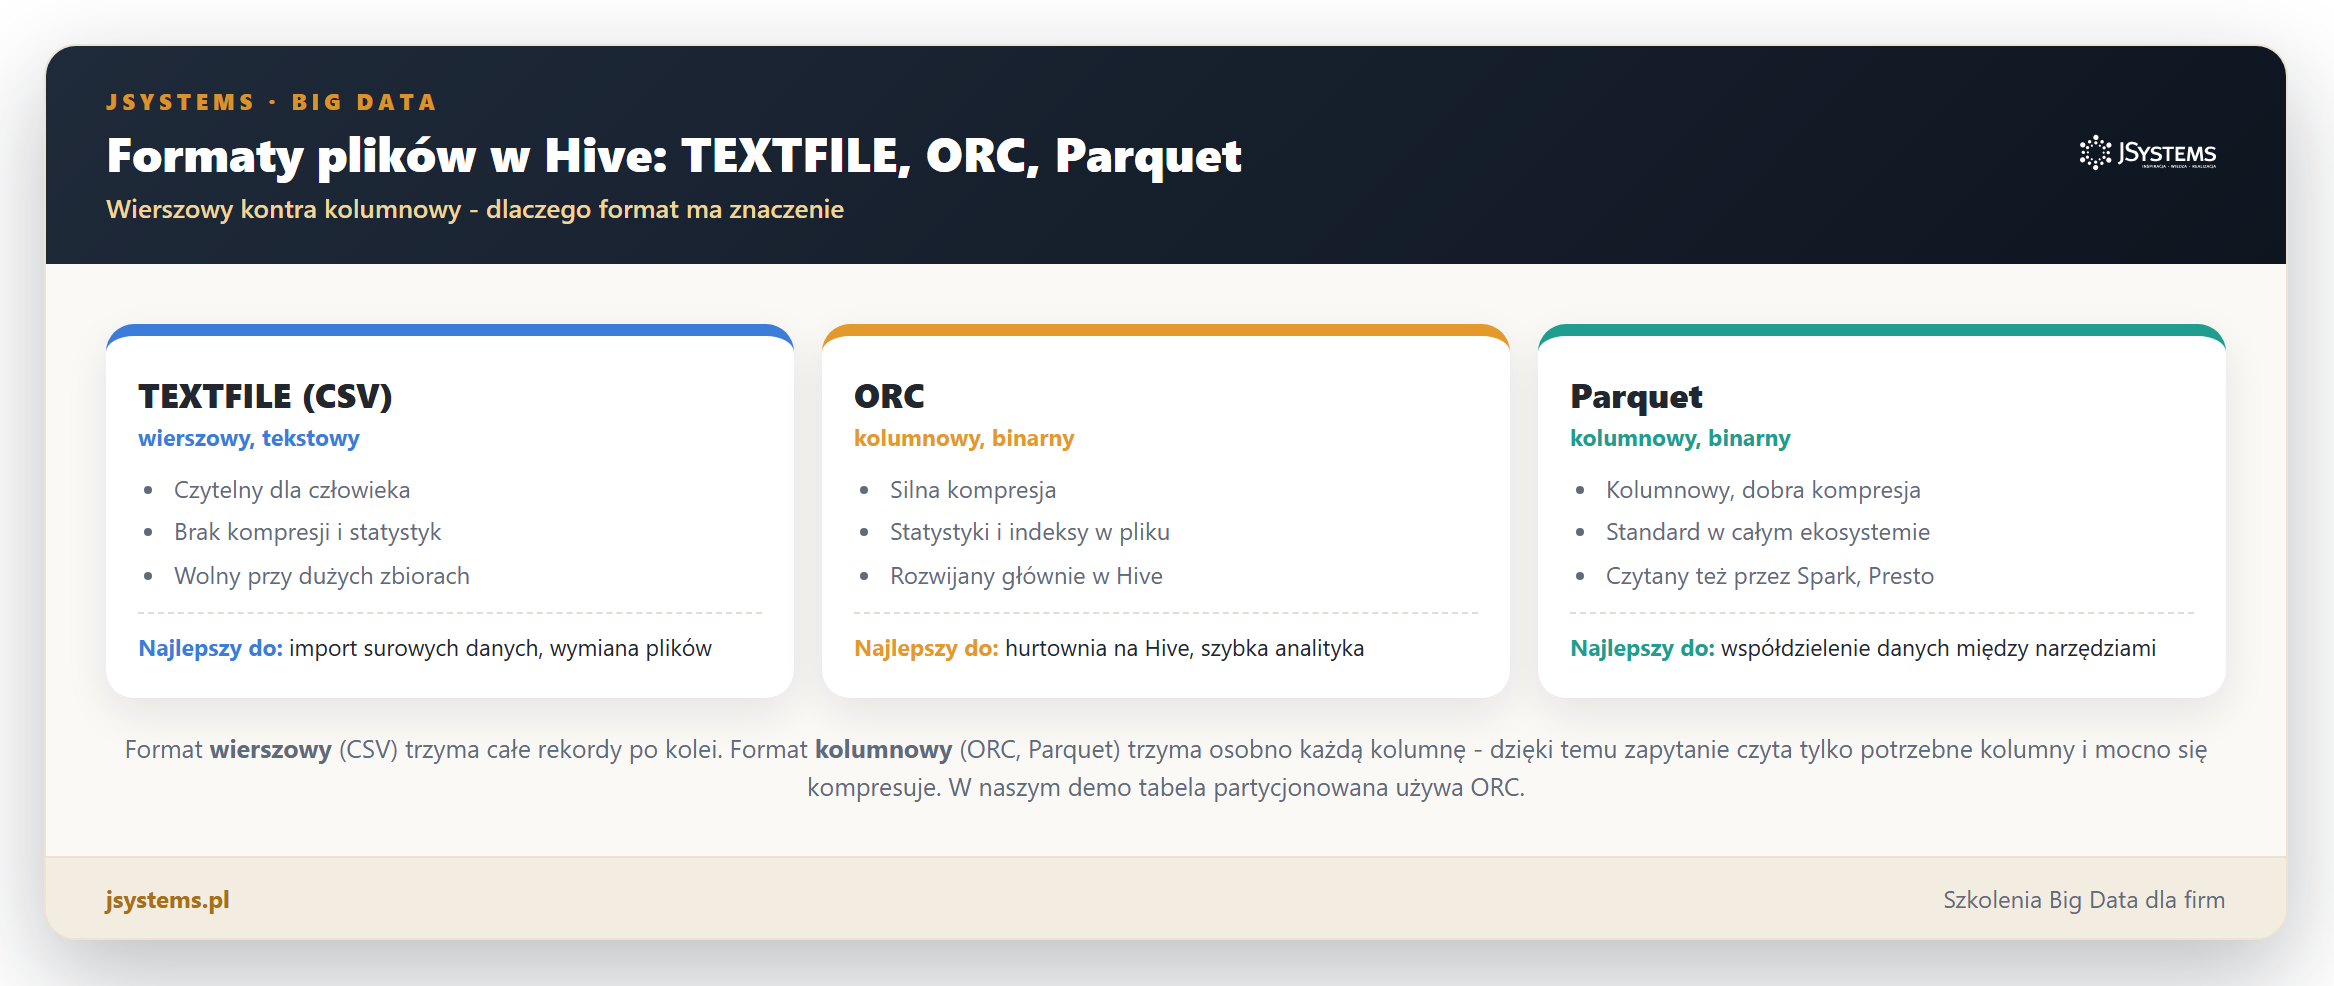
Dlaczego format kolumnowy jest tak istotny w analityce? Bo zapytanie zwykle pyta o kilka kolumn, a nie o wszystkie. Format kolumnowy pozwala odczytać z dysku tylko te kolumny, które są potrzebne, i pomija resztę. Do tego dochodzi silna kompresja (podobne wartości w jednej kolumnie ściskają się znakomicie) oraz statystyki zapisane wprost w pliku, które pomagają silnikowi pomijać zbędne fragmenty danych. Dla hurtowni na Hive standardem jest ORC, a Parquet to format uniwersalny, czytany przez cały ekosystem, w tym przez Spark.
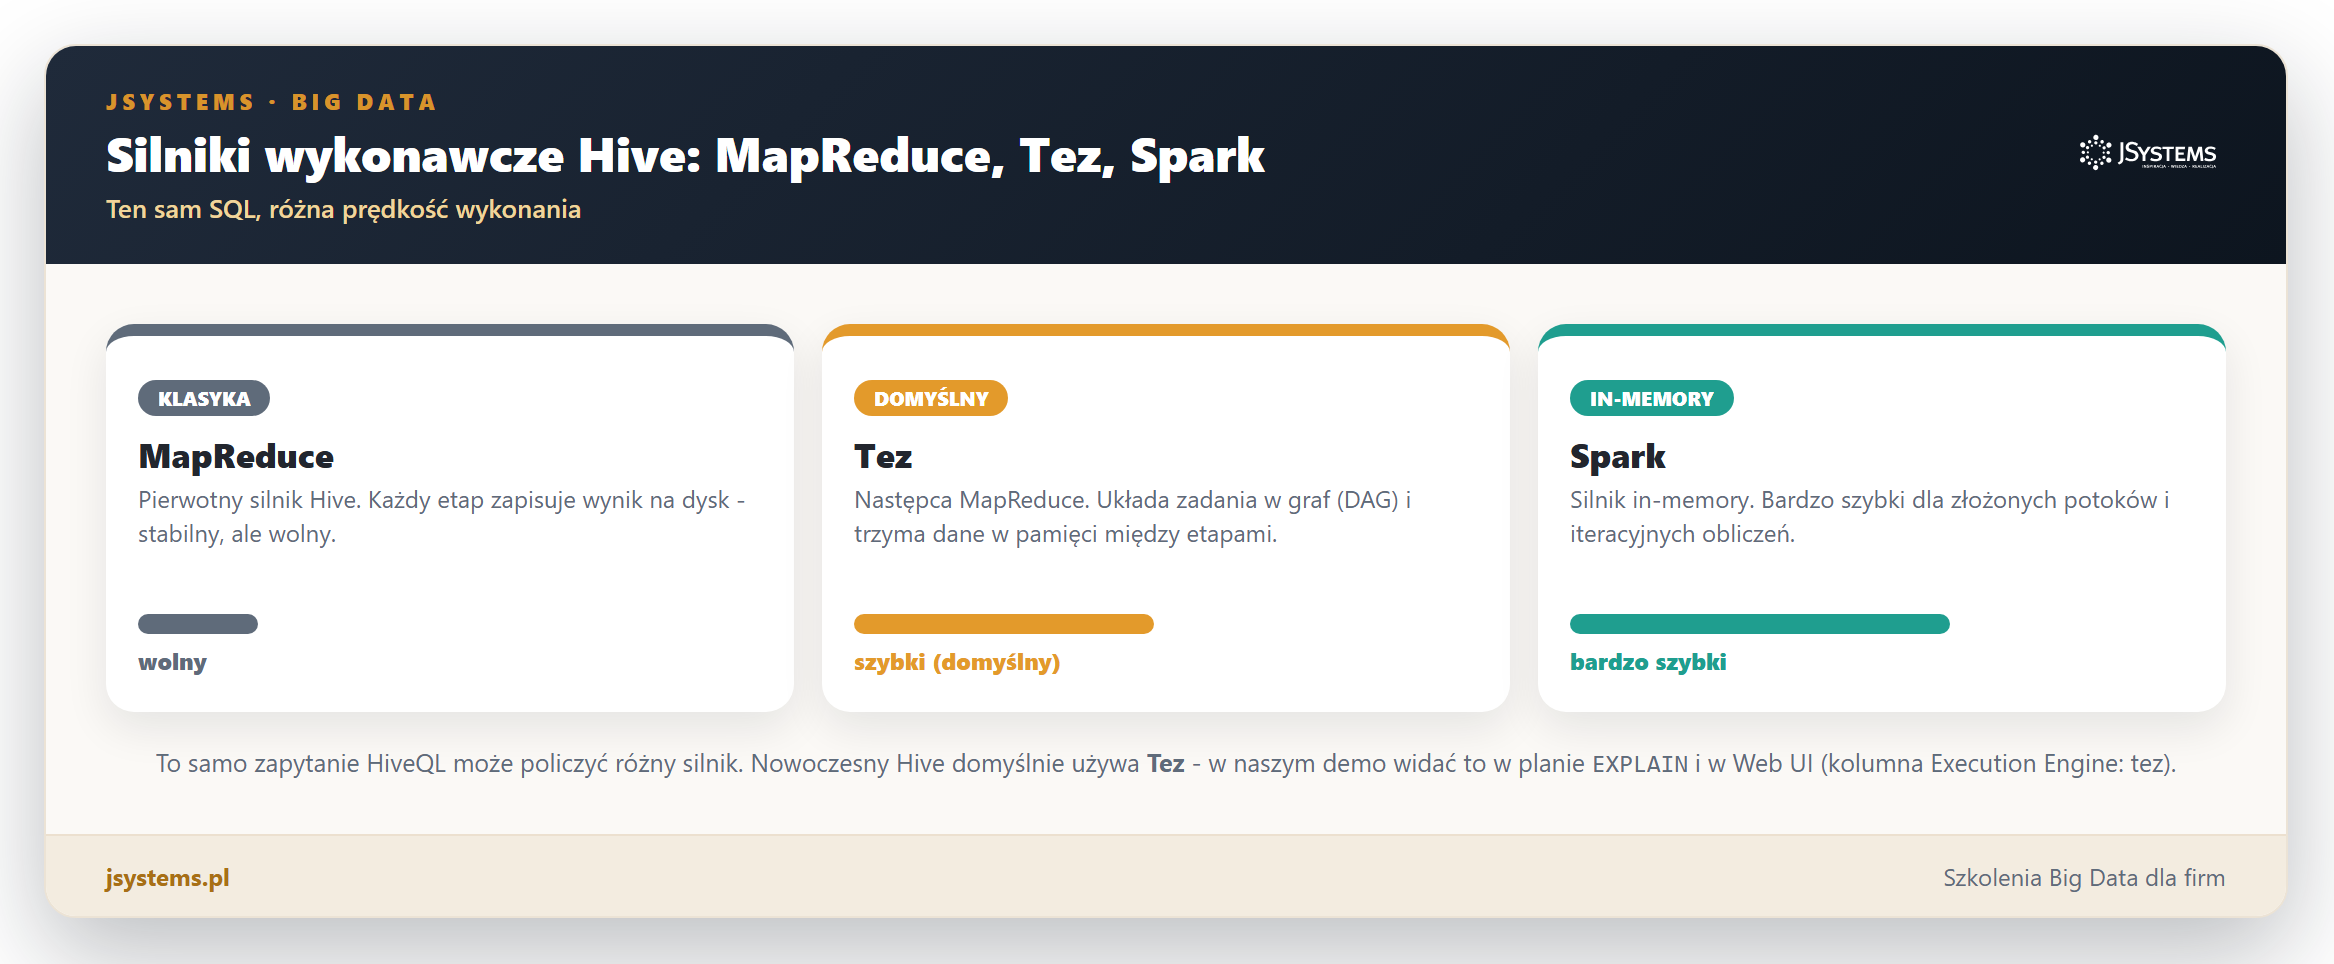
Wspominaliśmy, że Hive tłumaczy SQL na zadania rozproszone. Ale co je właściwie wykonuje? Tu wchodzi silnik wykonawczy. Historycznie pierwszy był MapReduce - stabilny, ale wolny, bo każdy etap zapisywał wynik pośredni na dysk. Jego następcą jest Tez, który układa zadania w graf zależności (tak zwany DAG, czyli skierowany graf acykliczny) i trzyma dane w pamięci między etapami. Trzecia opcja to Spark, silnik działający w pamięci, bardzo szybki przy złożonych potokach.
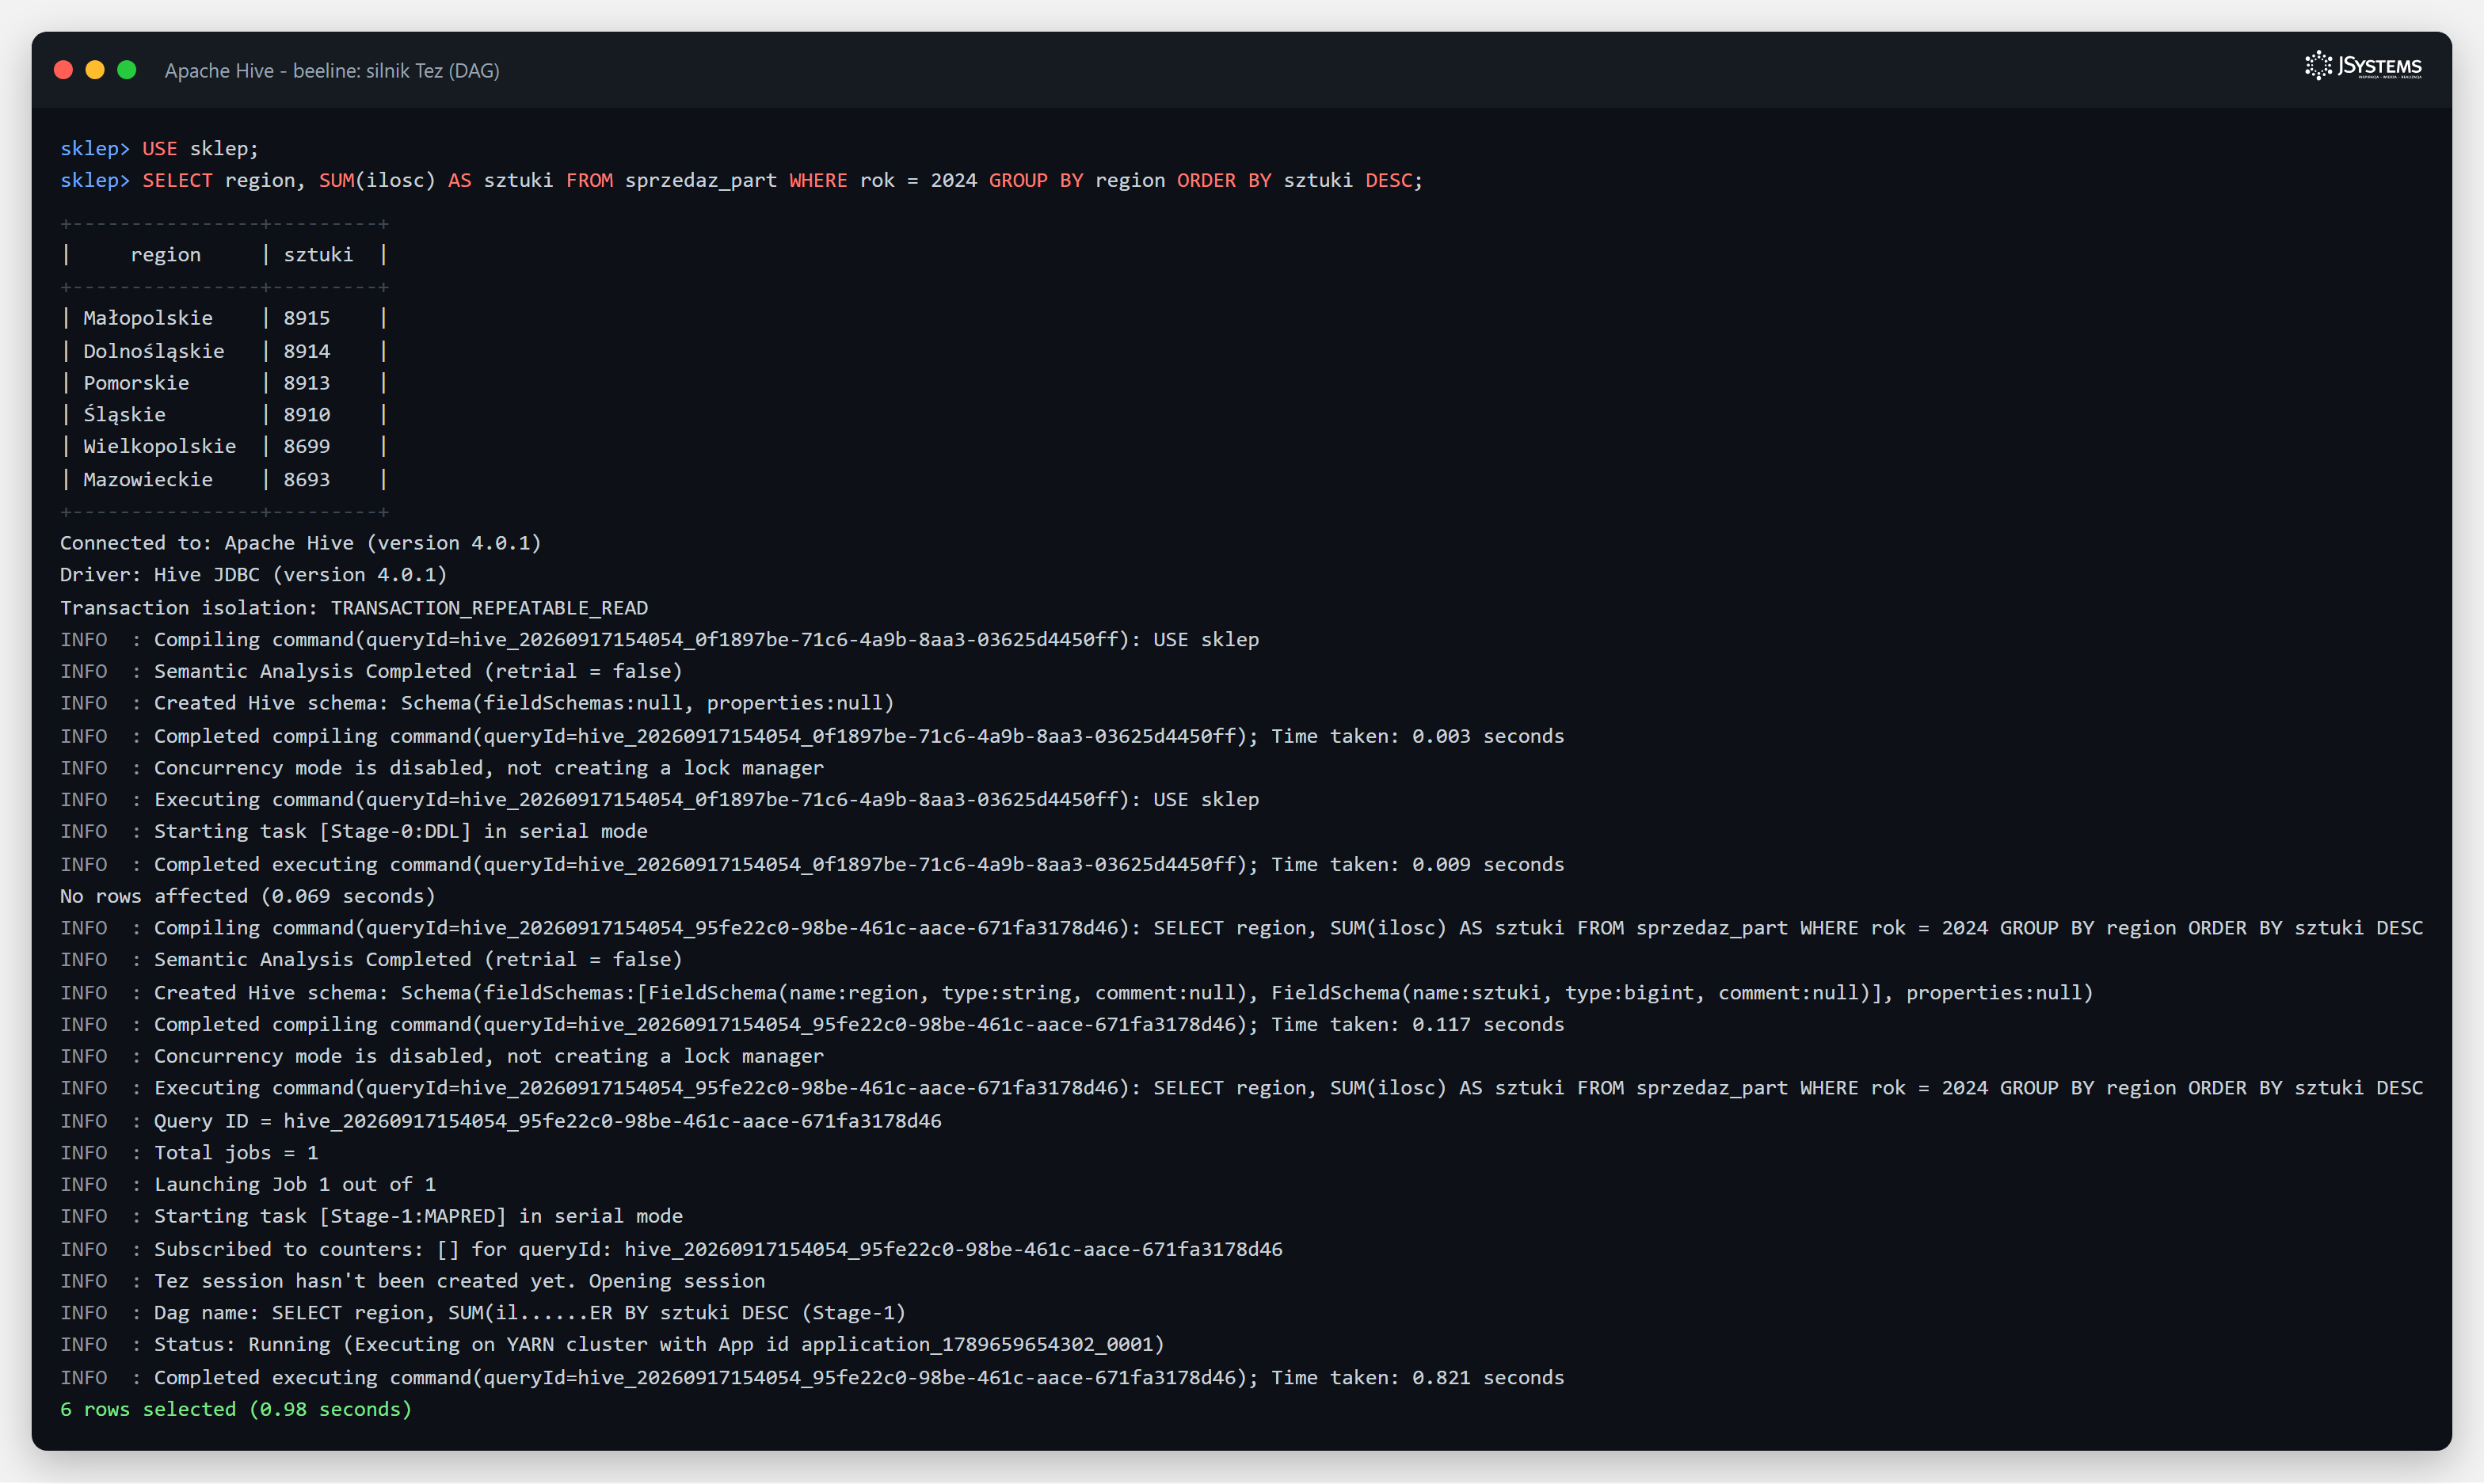
To nie jest tylko teoria. Nasz Hive uruchomił zapytanie właśnie na silniku Tez. Poniżej realny zrzut z konsoli - widać, jak Tez buduje graf zadań i uruchamia je na klastrze (elementy Map i Reducer), pokazując pasek postępu.
Jeszcze ciekawszy jest podgląd samego planu wykonania. Polecenie EXPLAIN pokazuje, jak Hive zamierza policzyć zapytanie, zanim je faktycznie uruchomi. To bezcenne narzędzie do optymalizacji.
EXPLAIN
SELECT region, SUM(ilosc)
  FROM sprzedaz_part
 WHERE rok = 2024
 GROUP BY region;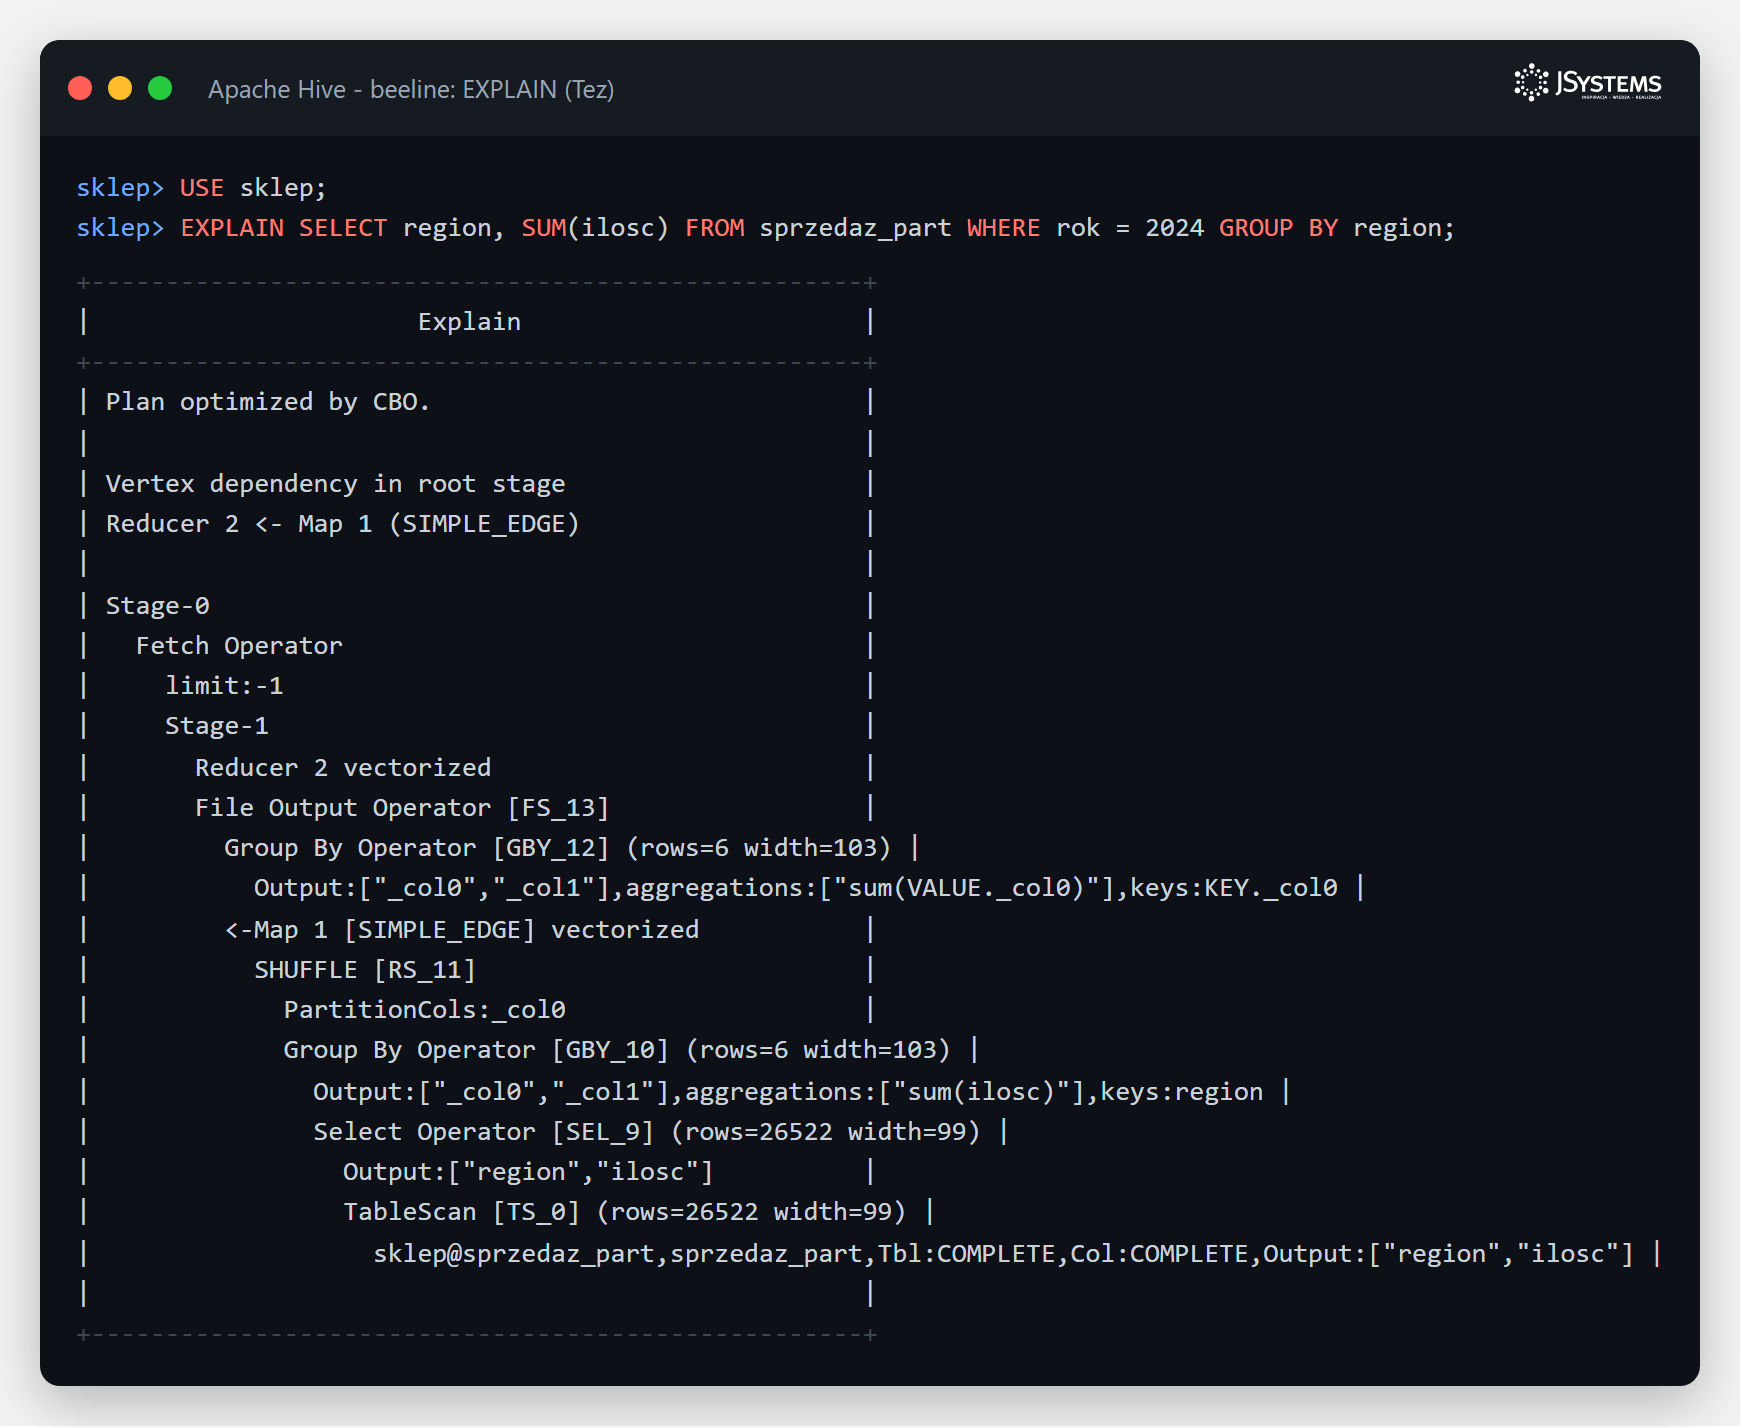
Zwróć uwagę na jeden szczegół w planie: przy skanowaniu tabeli (TableScan) Hive przewiduje 26 522 wiersze, a nie 53 031. To znów partition pruning - warunek na roku 2024 sprawił, że optymalizator z góry wie, że połowa danych jest nieistotna. Widać tu również skrót CBO, czyli optymalizator kosztowy (Cost-Based Optimizer), który wybiera najtańszy sposób wykonania zapytania na podstawie statystyk.
Jeśli spodobał Ci się silnik Spark i chcesz nauczyć się przetwarzać nim duże zbiory w praktyce - z realnymi zadaniami, a nie tylko teorią - to naturalny kolejny krok po Hive.
Chcesz wejść głębiej w przetwarzanie Big Data? Szkolenie Big Data: Przetwarzanie danych Big Data z Apache Spark ma terminy gwarantowane.
Hive rzadko występuje sam. To jedna z warstw większego ekosystemu Hadoop, w którym każda warstwa odpowiada za co innego. Poniższa infografika pokazuje, gdzie dokładnie siedzi Hive: na samym dole dane i zasoby, wyżej silniki obliczeń, a na górze narzędzia takie jak Hive, które udostępniają SQL.
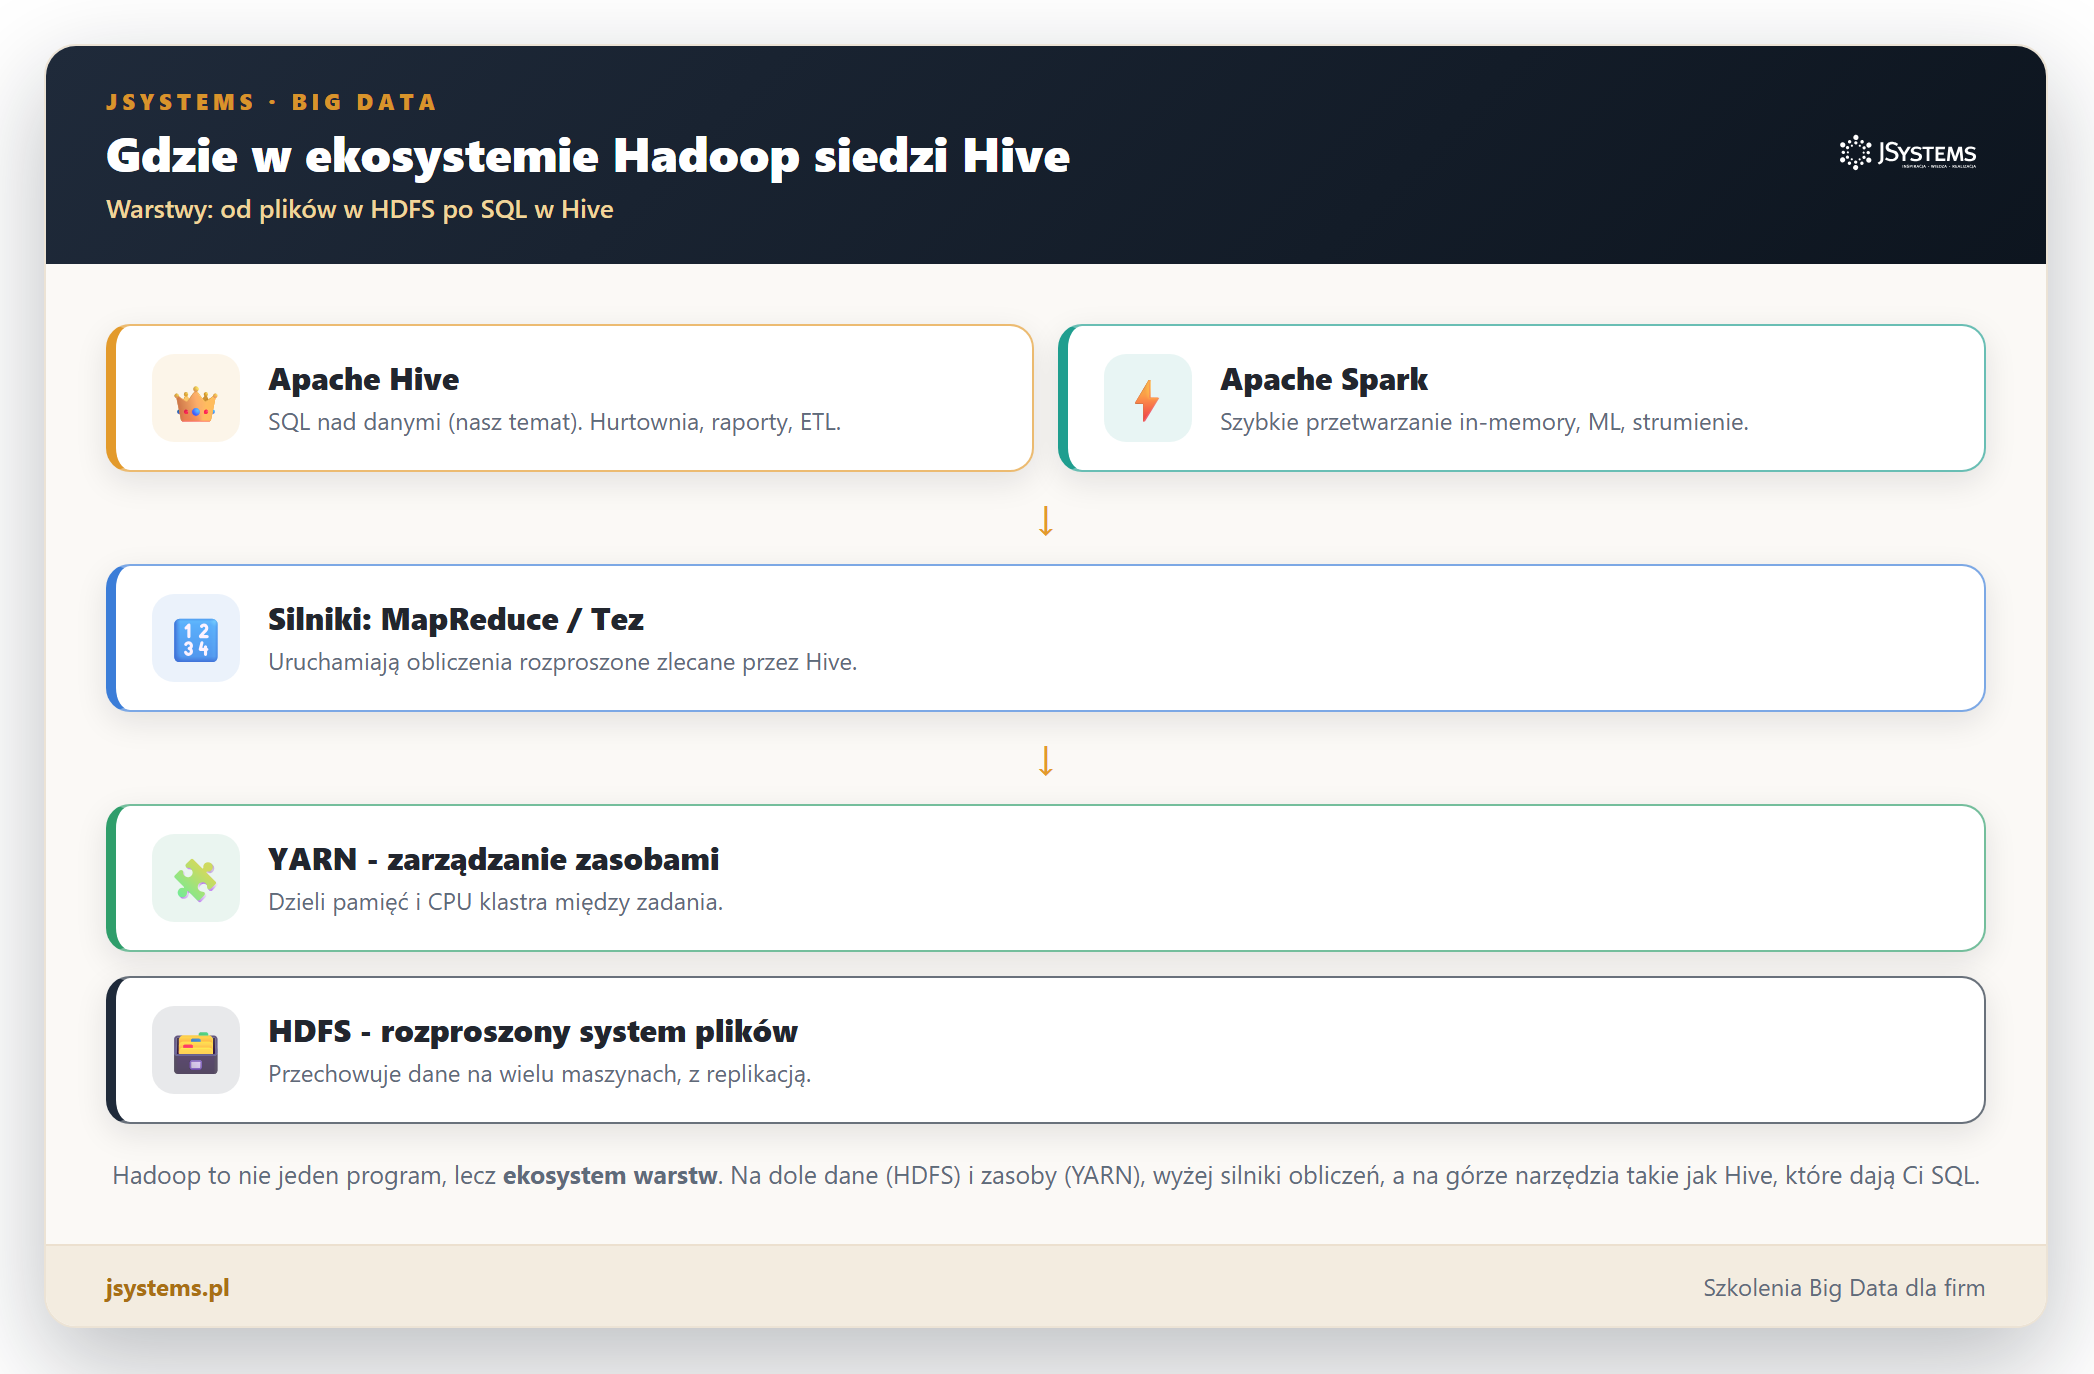
W praktyce Hive często współpracuje z innymi narzędziami do analizy danych. Wyniki zapytań Hive bywają dalej przetwarzane w analizie danych w Pythonie z biblioteką pandas, ładowane do narzędzi typu Power BI albo do wizualnych platform analitycznych jak KNIME. Hive jest w tym łańcuchu tym elementem, który potrafi przemielić naprawdę duże wolumeny i oddać gotowe, zagregowane dane dalej.
To jedno z najczęstszych nieporozumień u początkujących: Hive nie jest zamiennikiem zwykłej bazy. To narzędzie do innej pracy. Klasyczne bazy (na przykład bazy Oracle czy PostgreSQL) są zaprojektowane pod OLTP (przetwarzanie transakcyjne) - szybkie, pojedyncze operacje: dodaj zamówienie, zaktualizuj stan konta. Hive jest zaprojektowany pod OLAP (przetwarzanie analityczne) - wielkie zapytania przeliczające miliony wierszy naraz.
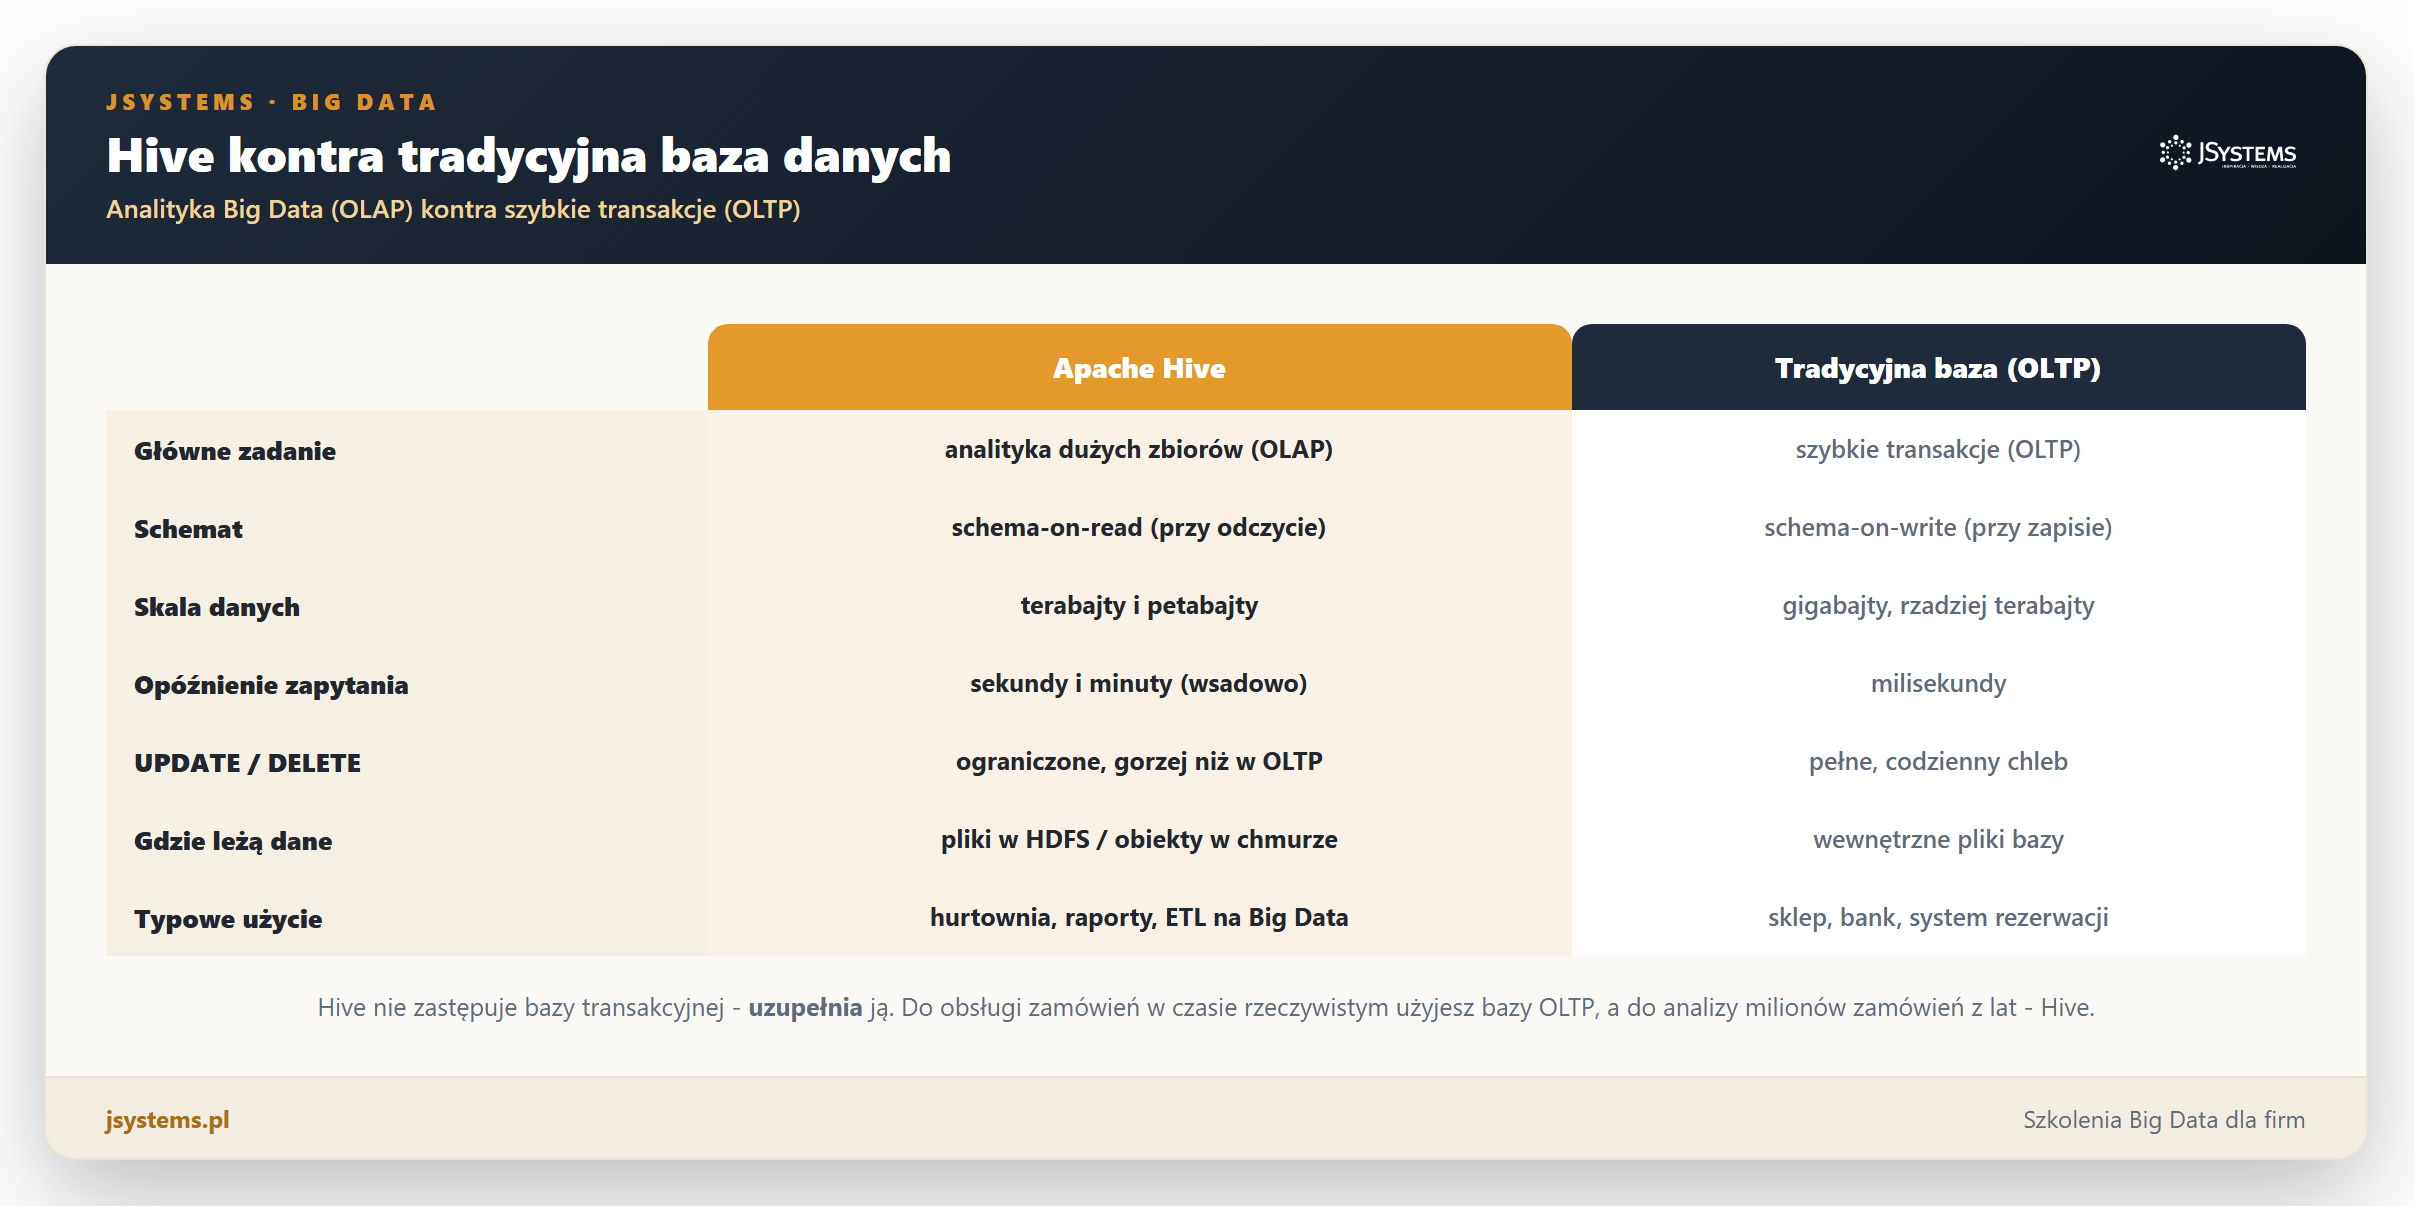
Najważniejsze różnice w skrócie: Hive liczy wsadowo (odpowiedź w sekundach lub minutach), baza OLTP odpowiada w milisekundach. Hive świetnie czyta i agreguje ogromne zbiory, ale słabo radzi sobie z pojedynczymi zmianami wiersza (UPDATE, DELETE) - baza transakcyjna robi to bez mrugnięcia. I wreszcie: w Hive dane leżą jako pliki w HDFS lub w chmurze, a w klasycznej bazie w jej własnym, wewnętrznym magazynie. Dlatego Hive nie zastępuje bazy, tylko ją uzupełnia.
Skoro znamy już różnice, łatwo odpowiedzieć na pytanie, które zadaje sobie każdy początkujący: czy Hive to narzędzie dla mnie? Poniższa infografika podsumowuje decyzję.
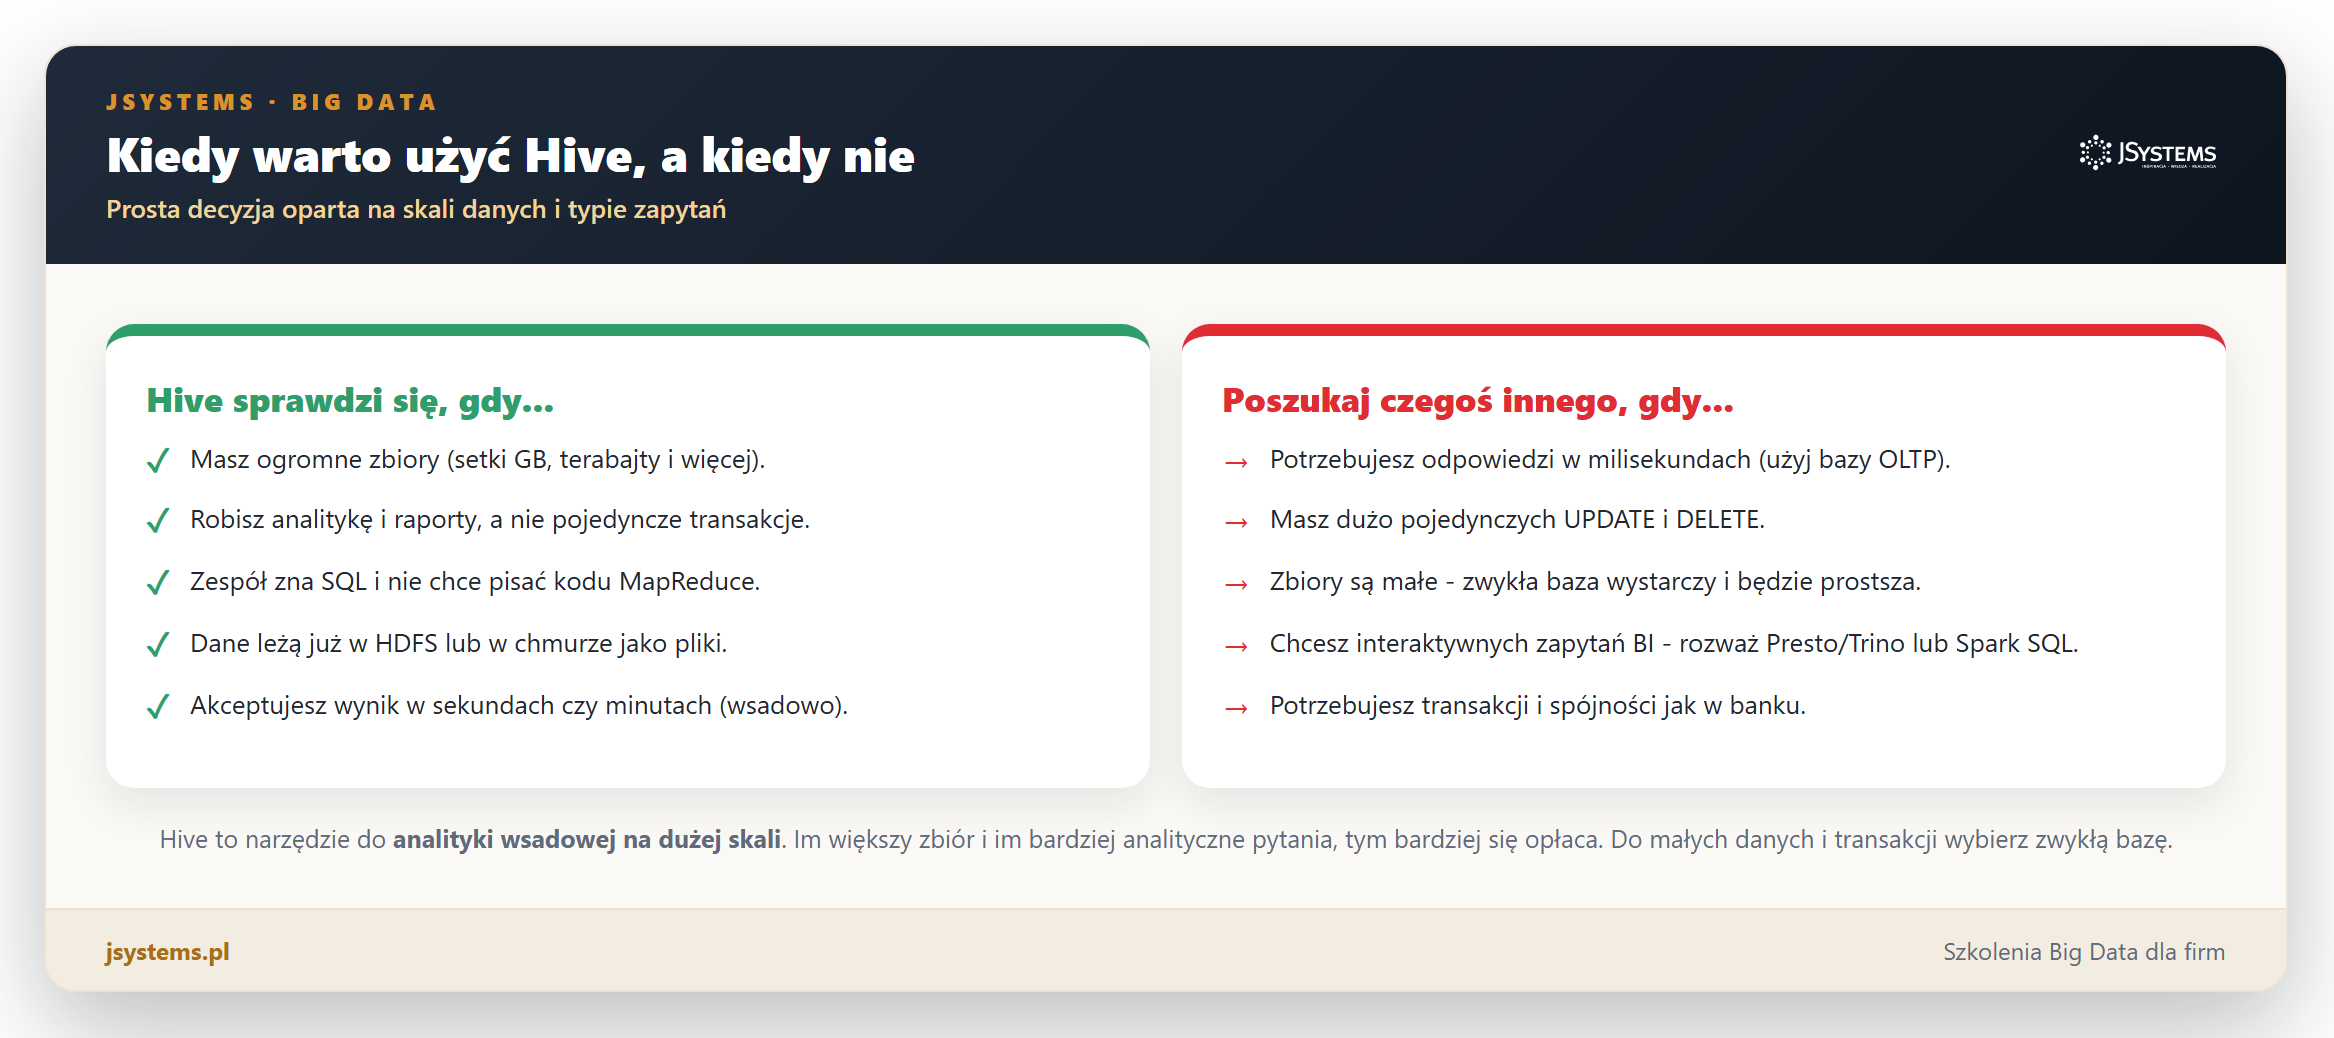
Reguła kciuka jest prosta. Sięgnij po Hive, gdy masz naprawdę duże zbiory (setki gigabajtów i więcej), robisz analitykę i raporty, Twój zespół zna SQL, a dane już leżą w HDFS lub w chmurze jako pliki. Poszukaj czegoś innego, gdy potrzebujesz odpowiedzi w milisekundach, masz dużo pojedynczych aktualizacji, zbiory są małe albo potrzebujesz interaktywnych zapytań - wtedy lepiej sprawdzą się bazy transakcyjne albo silniki takie jak Presto/Trino czy Spark SQL.
Dobra wiadomość jest taka, że Hive można dziś odpalić na własnym laptopie w kilka minut, bez stawiania całego klastra. Dokładnie tak przygotowaliśmy środowisko do tego artykułu - jednym poleceniem Dockera.
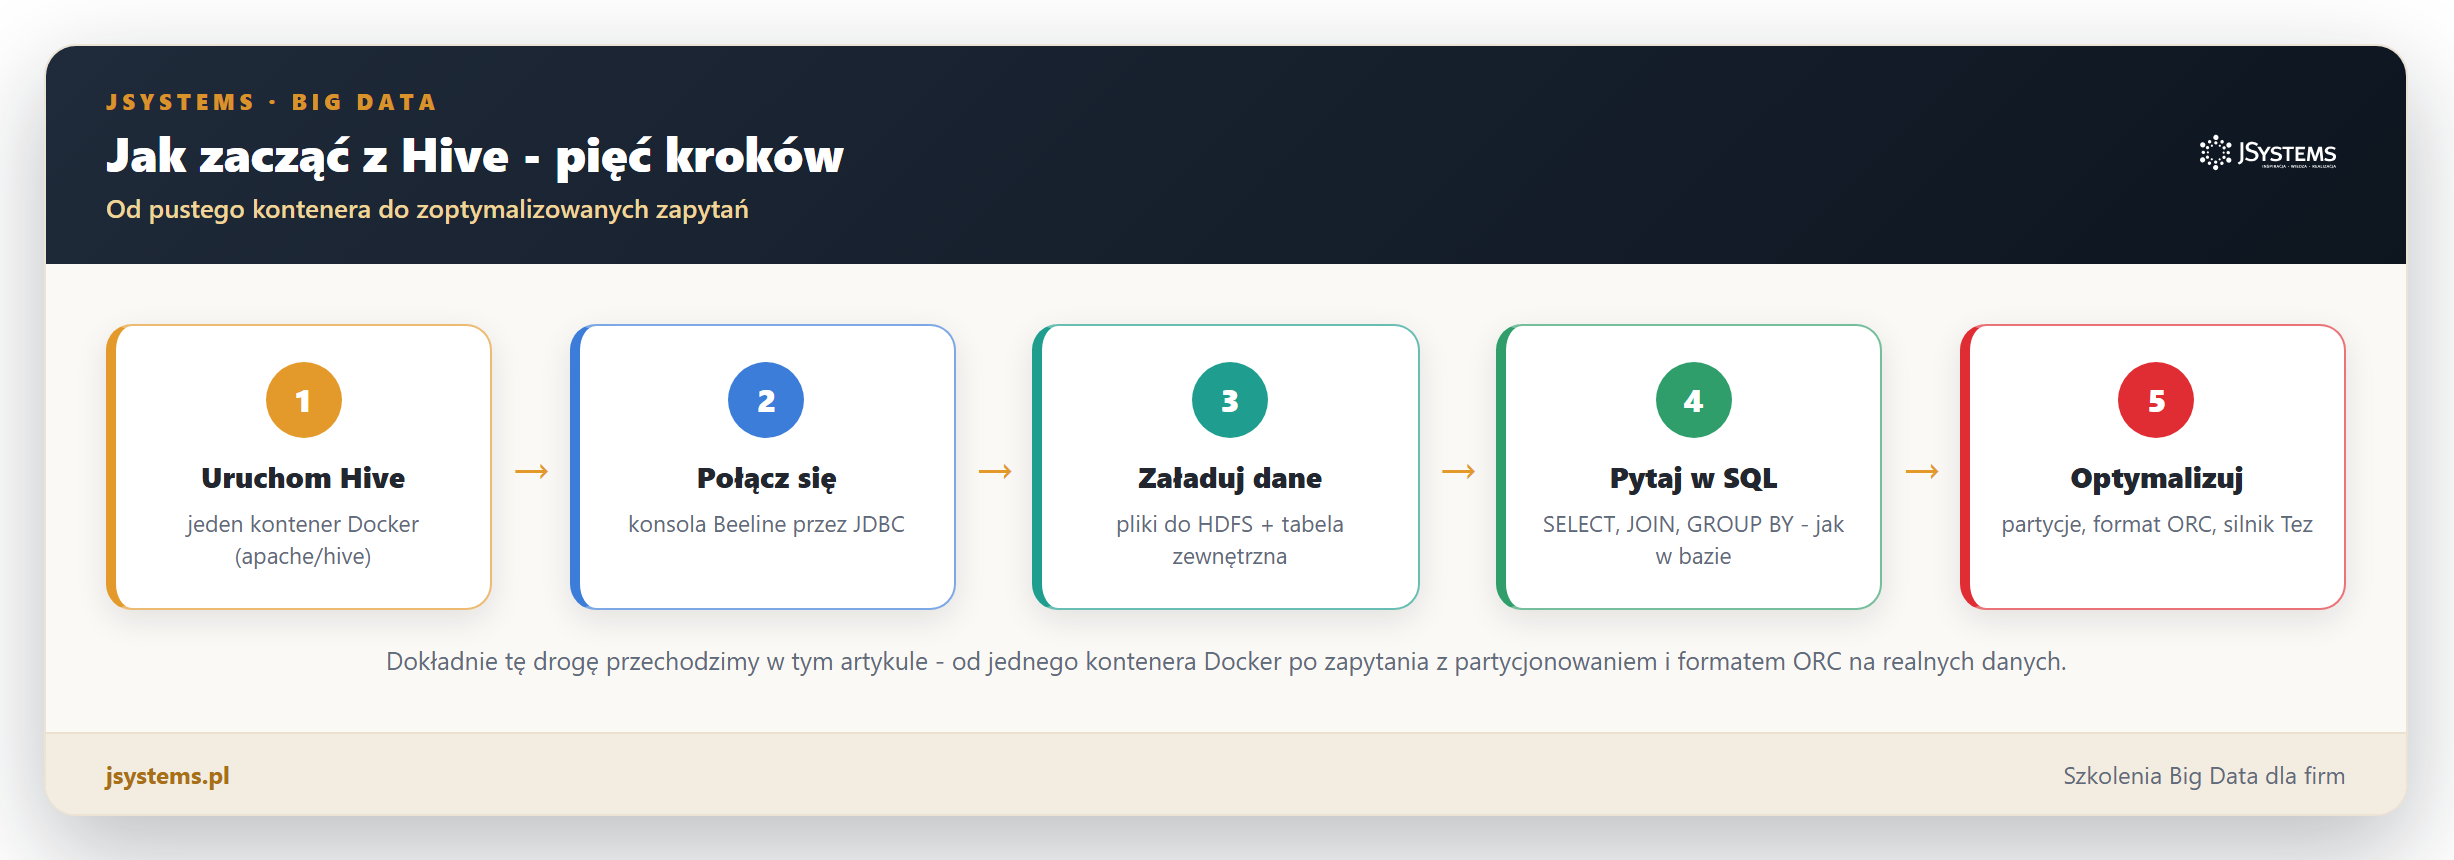
Cały Hive z serwerem zapytań, metadanymi i konsolą Beeline uruchomisz jednym poleceniem:
# uruchomienie HiveServer2 w kontenerze
docker run -d -p 10000:10000 -p 10002:10002 \
  --env SERVICE_NAME=hiveserver2 \
  --name hive apache/hive:4.0.1

# polaczenie konsola Beeline
docker exec -it hive beeline -u 'jdbc:hive2://localhost:10000/'
Od tego momentu możesz tworzyć bazy, tabele i pisać zapytania dokładnie tak, jak pokazaliśmy w tym artykule. Port 10000 to złącze JDBC dla klientów, a pod portem 10002 znajdziesz panel WWW serwera. To najprostszy sposób, żeby poznać Hive bez inwestowania w infrastrukturę.
Chcesz przejść tę drogę pod okiem praktyka, na gotowym środowisku i realnych danych? Szkolenie Big Data: Apache Hive - HiveQL od podstaw do technik zaawansowanych.
Apache Hive to warstwa SQL nad Hadoopem, która pozwala odpytywać ogromne zbiory danych znanym językiem zapytań, bez pisania niskopoziomowego kodu. Jego fundamenty to schema-on-read (schemat nakładany przy odczycie), dane trzymane jako pliki w HDFS, katalog metadanych w Metastore oraz silnik wykonawczy (dziś zwykle Tez), który tłumaczy SQL na zadania rozproszone. Partycjonowanie i formaty kolumnowe takie jak ORC sprawiają, że zapytania czytają tylko potrzebny ułamek danych. Hive nie zastępuje bazy transakcyjnej - to narzędzie do analityki wielkiej skali, które świetnie się z klasyczną bazą uzupełnia. Najlepsze w tym wszystkim jest to, że całość możesz dziś przećwiczyć na własnym komputerze w jednym kontenerze - a stąd już blisko do pracy z prawdziwym Big Data.
To szkolenie może być dofinansowane dla Ciebie z KFS lub BUR.
To szkolenie może być dofinansowane dla Ciebie z KFS lub BUR. Ma terminy gwarantowane.


Komentarze (0)
Brak komentarzy...