Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
W skrócieBig data to dane, które nie mieszczą się już w jednej maszynie i których nie przetworzysz zwykłą bazą danych - oraz cały zestaw technologii, które pozwalają sobie z nimi poradzić. Zaczyna się tam, gdzie jeden serwer przestaje wystarczać i pracę trzeba rozdzielić na wiele maszyn. Ten artykuł prowadzi przez cały krajobraz: od reguły 5V, przez jezioro danych, formaty plików i Apache Spark, po platformy danych w chmurze: lakehouse (Databricks, Microsoft Fabric) i hurtownie (Snowflake, BigQuery). Pokazujemy przy tym, jak tę pracę wykonuje się dzisiaj: w chmurze, w notatniku i bez własnego klastra.
Pojęcie „big data” pojawia się wszędzie: w ofertach pracy, na konferencjach i w rozmowach o sztucznej inteligencji. Pod spodem kryje się jednak prosta myśl. W pewnym momencie danych robi się tyle albo napływają tak szybko, że nie da się ich już policzyć na jednym komputerze. Wtedy trzeba zmienić sposób pracy: zamiast jednej mocnej maszyny używa się wielu zwykłych, które dzielą między siebie zarówno przechowywanie danych, jak i obliczenia.
Wokół tej jednej myśli wyrósł przez dwadzieścia lat cały ekosystem narzędzi. Łatwo się w nim pogubić, bo nazwy brzmią podobnie, a każda firma reklamuje swoją platformę jako „wszystko w jednym”. Dlatego zamiast rzucać hasłami, poukładamy ten krajobraz warstwa po warstwie - tak, żeby było widać, co z czym się łączy i w którym miejscu pojawia się każde narzędzie. Po drodze podlinkujemy osobne przewodniki, w których każdy z tych tematów rozkładamy na części.
Z tego artykułu dowiesz się
Najprościej: big data to dane, których nie da się przetworzyć jedną zwykłą bazą danych na jednym serwerze. Danych jest za dużo, napływają za szybko albo mają zbyt różną postać. Kiedy pojawia się ta granica, zwykle trzeba podzielić pracę między wiele maszyn, które razem tworzą klaster. Każdą maszynę w klastrze nazywamy węzłem.
Słowa „big data” używa się jednak w dwóch znaczeniach i trzeba je rozróżnić. Pierwsze to same dane o takiej skali. Drugie to cały zestaw technologii, które powstały, żeby sobie z nimi poradzić: sposoby przechowywania plików na wielu dyskach naraz, silniki liczące rozproszone obliczenia i platformy, które to wszystko spinają. W tym artykule dotykamy obu znaczeń, bo bez technologii samo pojęcie niewiele mówi.
Częste nieporozumienie brzmi tak: big data to po prostu „dużo wierszy”. To nieprawda: milion wierszy w arkuszu to nie big data, bo policzy je zwykły komputer. Liczy się to, czy dane wciąż mieszczą się w jednej maszynie i czy zdąży ona je przetworzyć na czas.
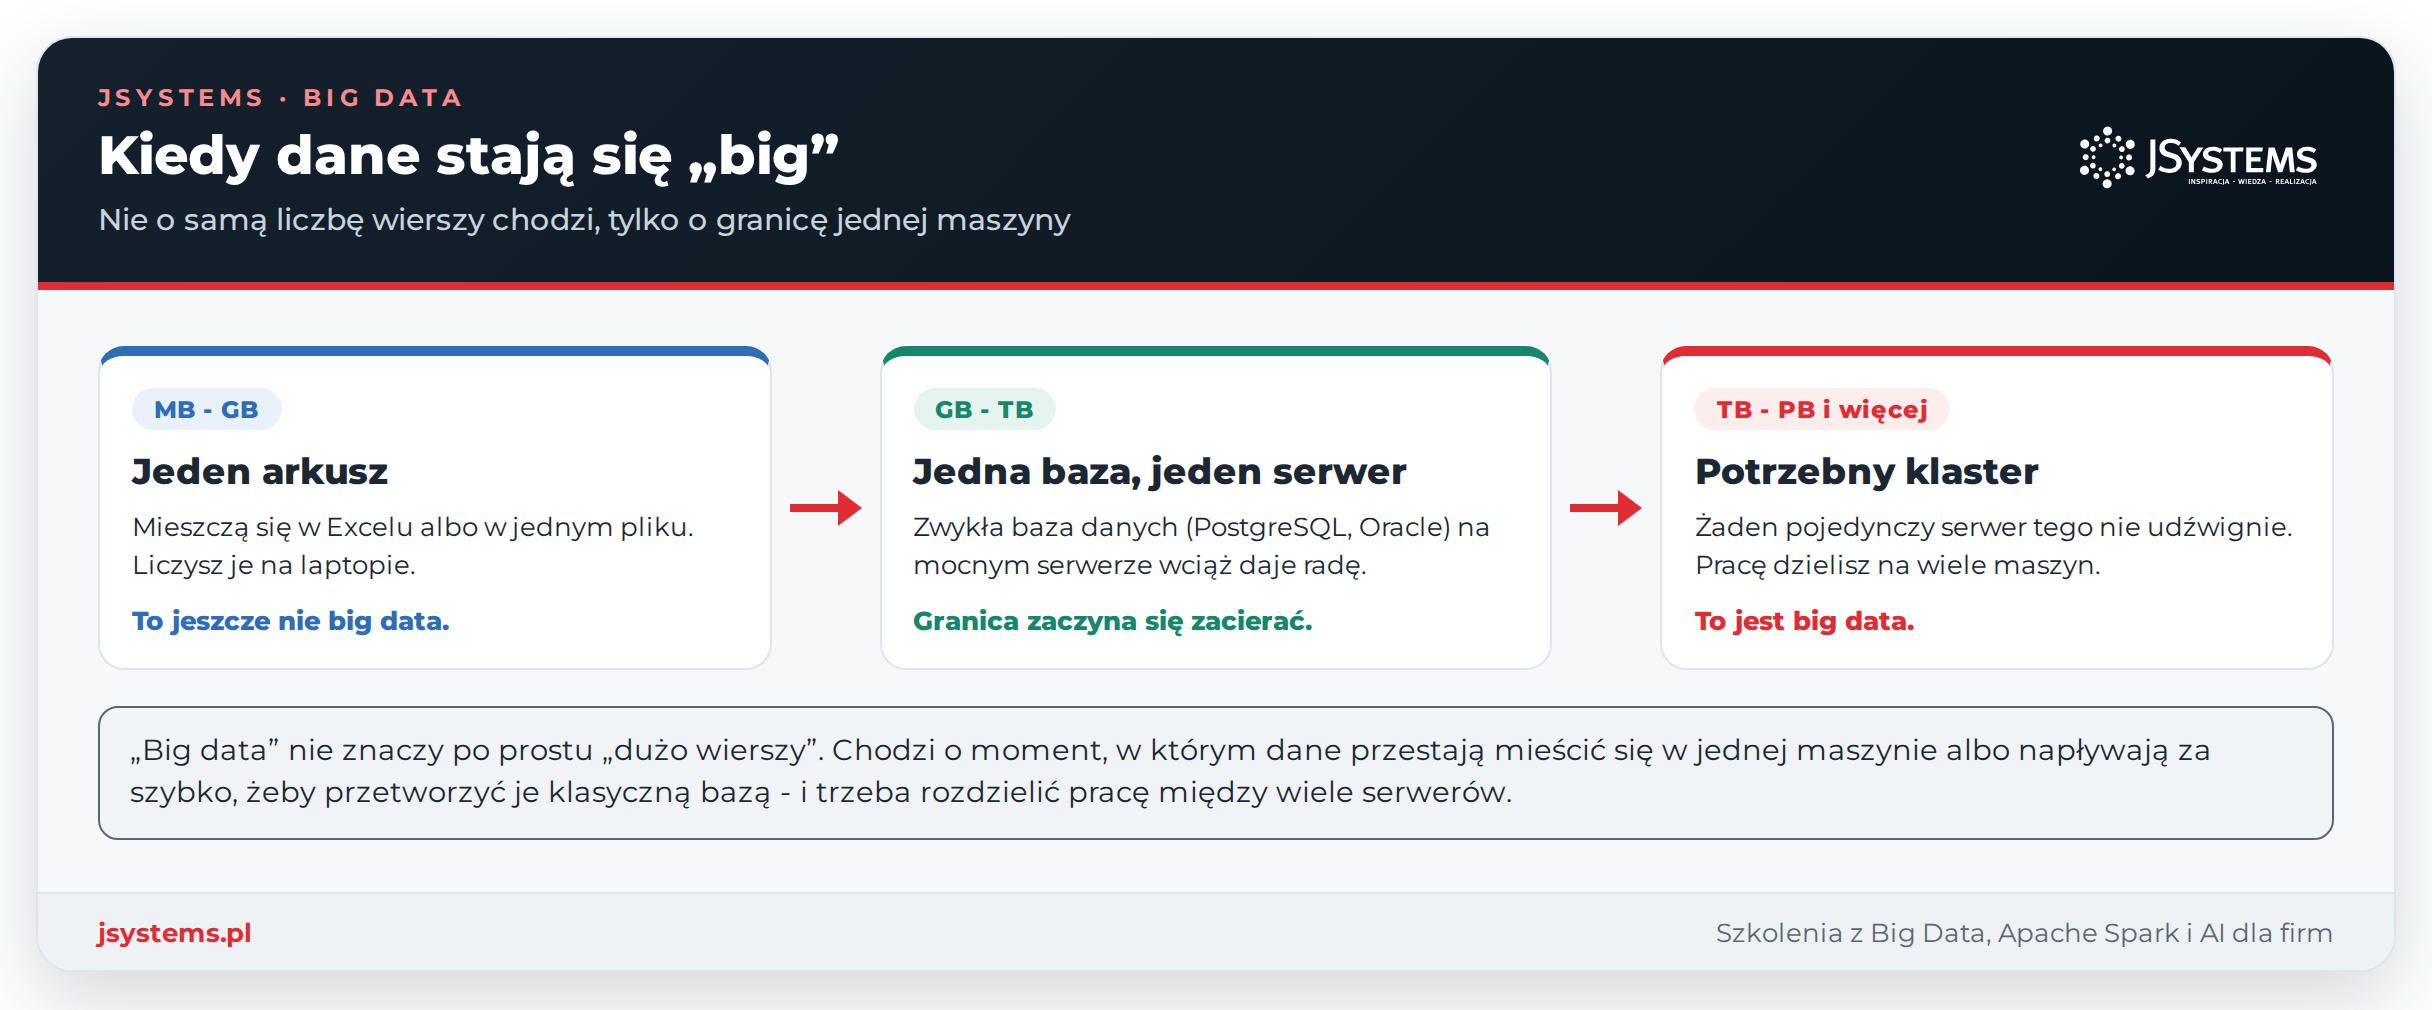
Ta granica jest ruchoma i zależy od sprzętu, ale myśl zostaje ta sama: dopóki dane mieszczą się na jednym serwerze, zwykła baza w zupełności wystarcza. Dopiero gdy przestają, sięgamy po narzędzia big data. Jak ta droga wyglądała historycznie, od pierwszych klastrów Google po dzisiejsze platformy, opisujemy krok po kroku w artykule Historia big data: od Hadoopa i MapReduce do Sparka, Databricks i Fabric.
Żeby opisać, czym big data różni się od zwykłych danych, od lat używa się skrótu od angielskich nazw pięciu cech. Trzy pierwsze V opisał w 2001 roku analityk Doug Laney, dwa kolejne dołożono później. To wygodny sposób, żeby sprawdzić, czy dany problem naprawdę jest problemem big data, czy tylko tak się nazywa.
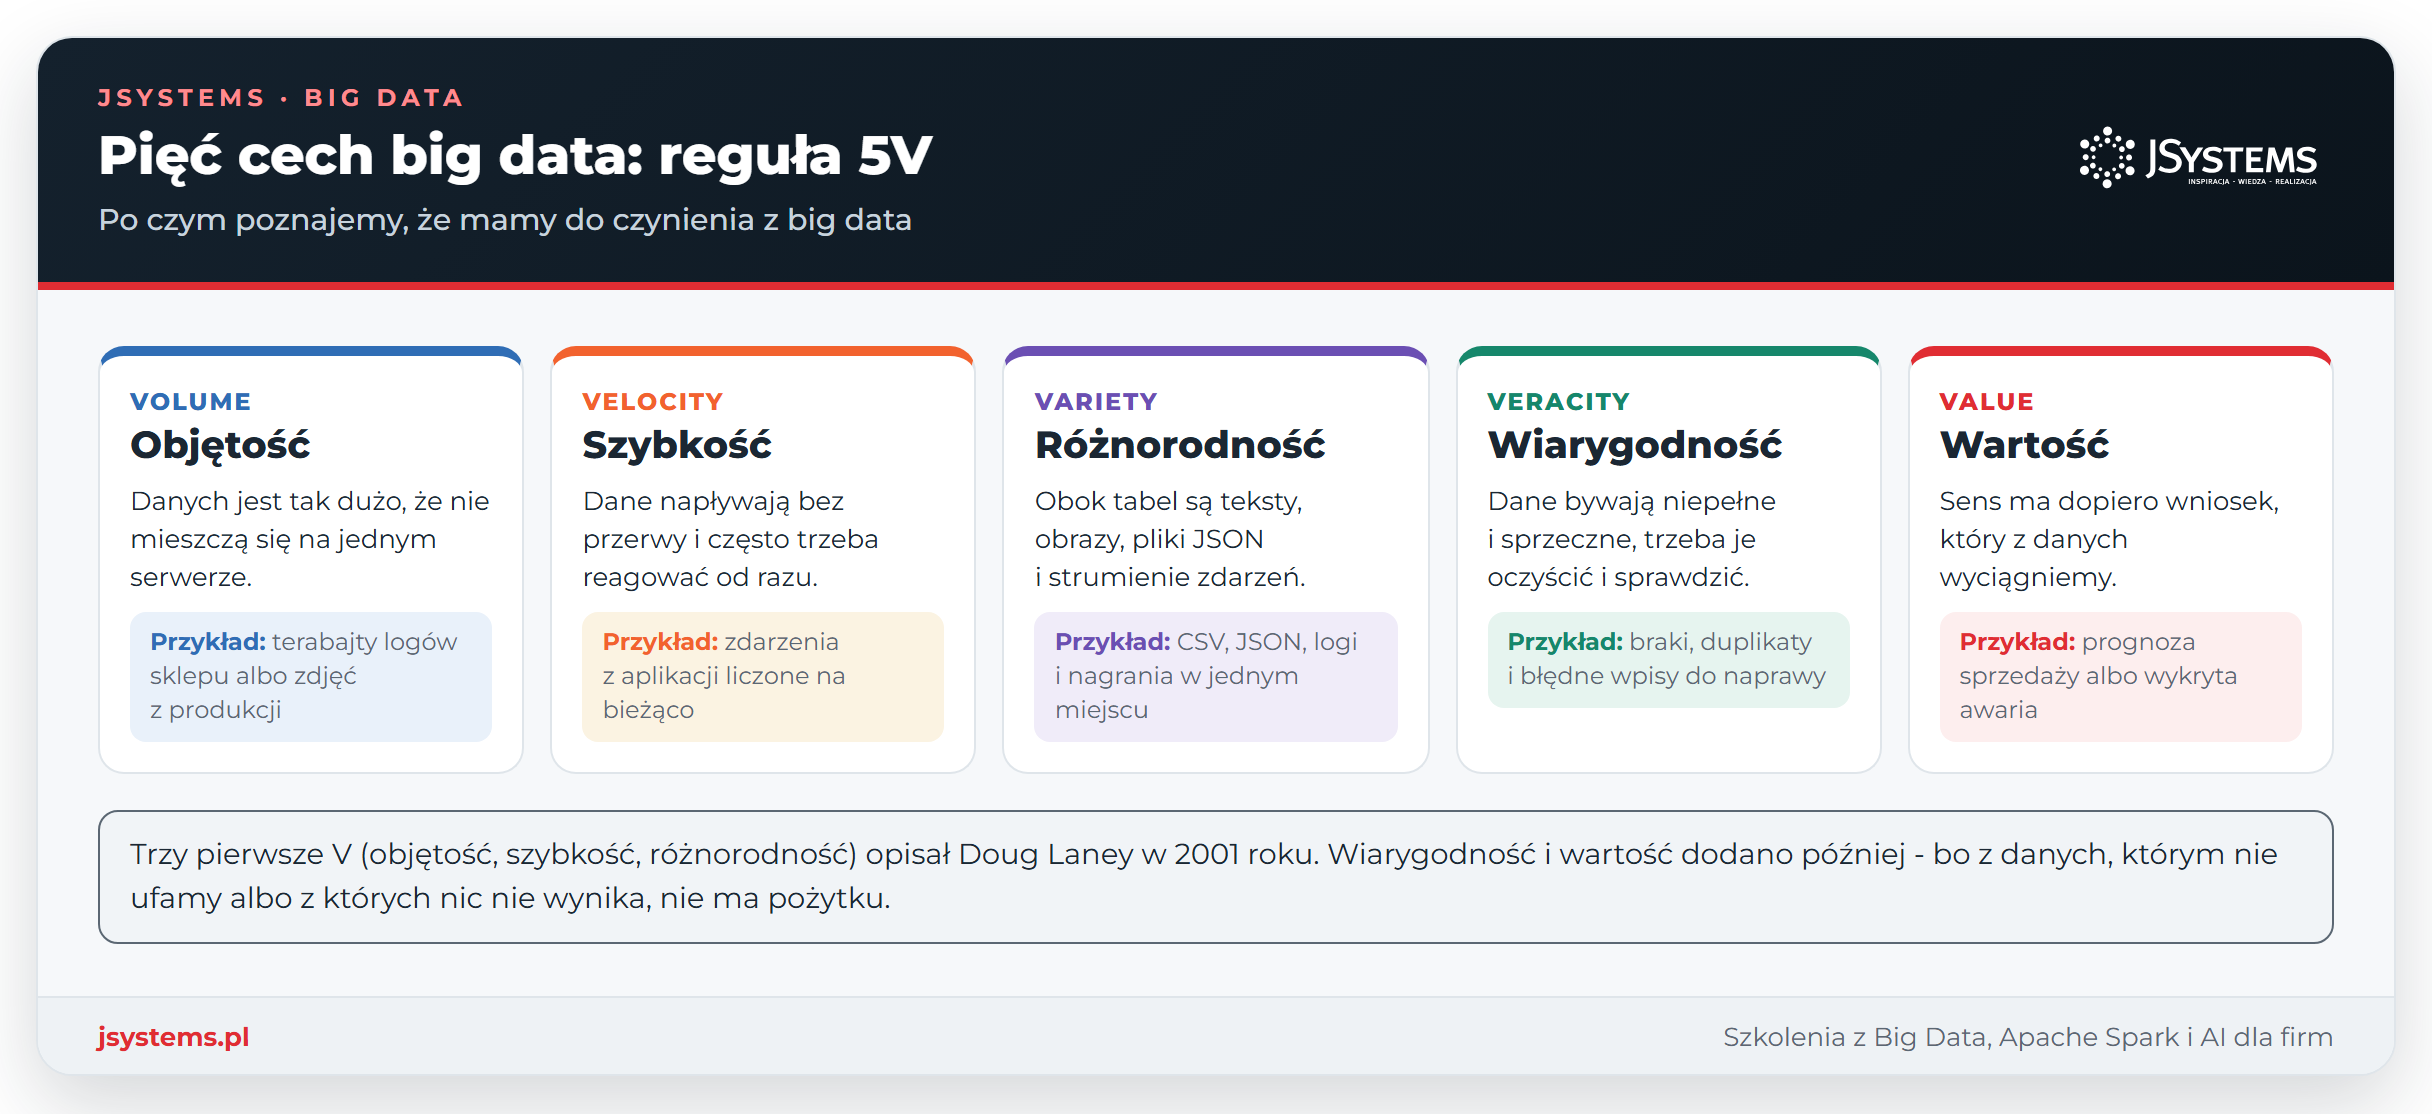
Najważniejsze w tej regule jest to, co łączy pierwsze trzy V: objętość, szybkość i różnorodność to właśnie powody, dla których jedna maszyna przestaje wystarczać. Danych jest za dużo, przychodzą za szybko albo mają zbyt wiele postaci naraz - tabele, teksty, obrazy, strumienie zdarzeń. Dwa ostatnie V to zdroworozsądkowe przypomnienie: z danych, którym nie ufamy albo z których nic konkretnego nie wynika, nie ma żadnego pożytku, choćby było ich bardzo dużo.
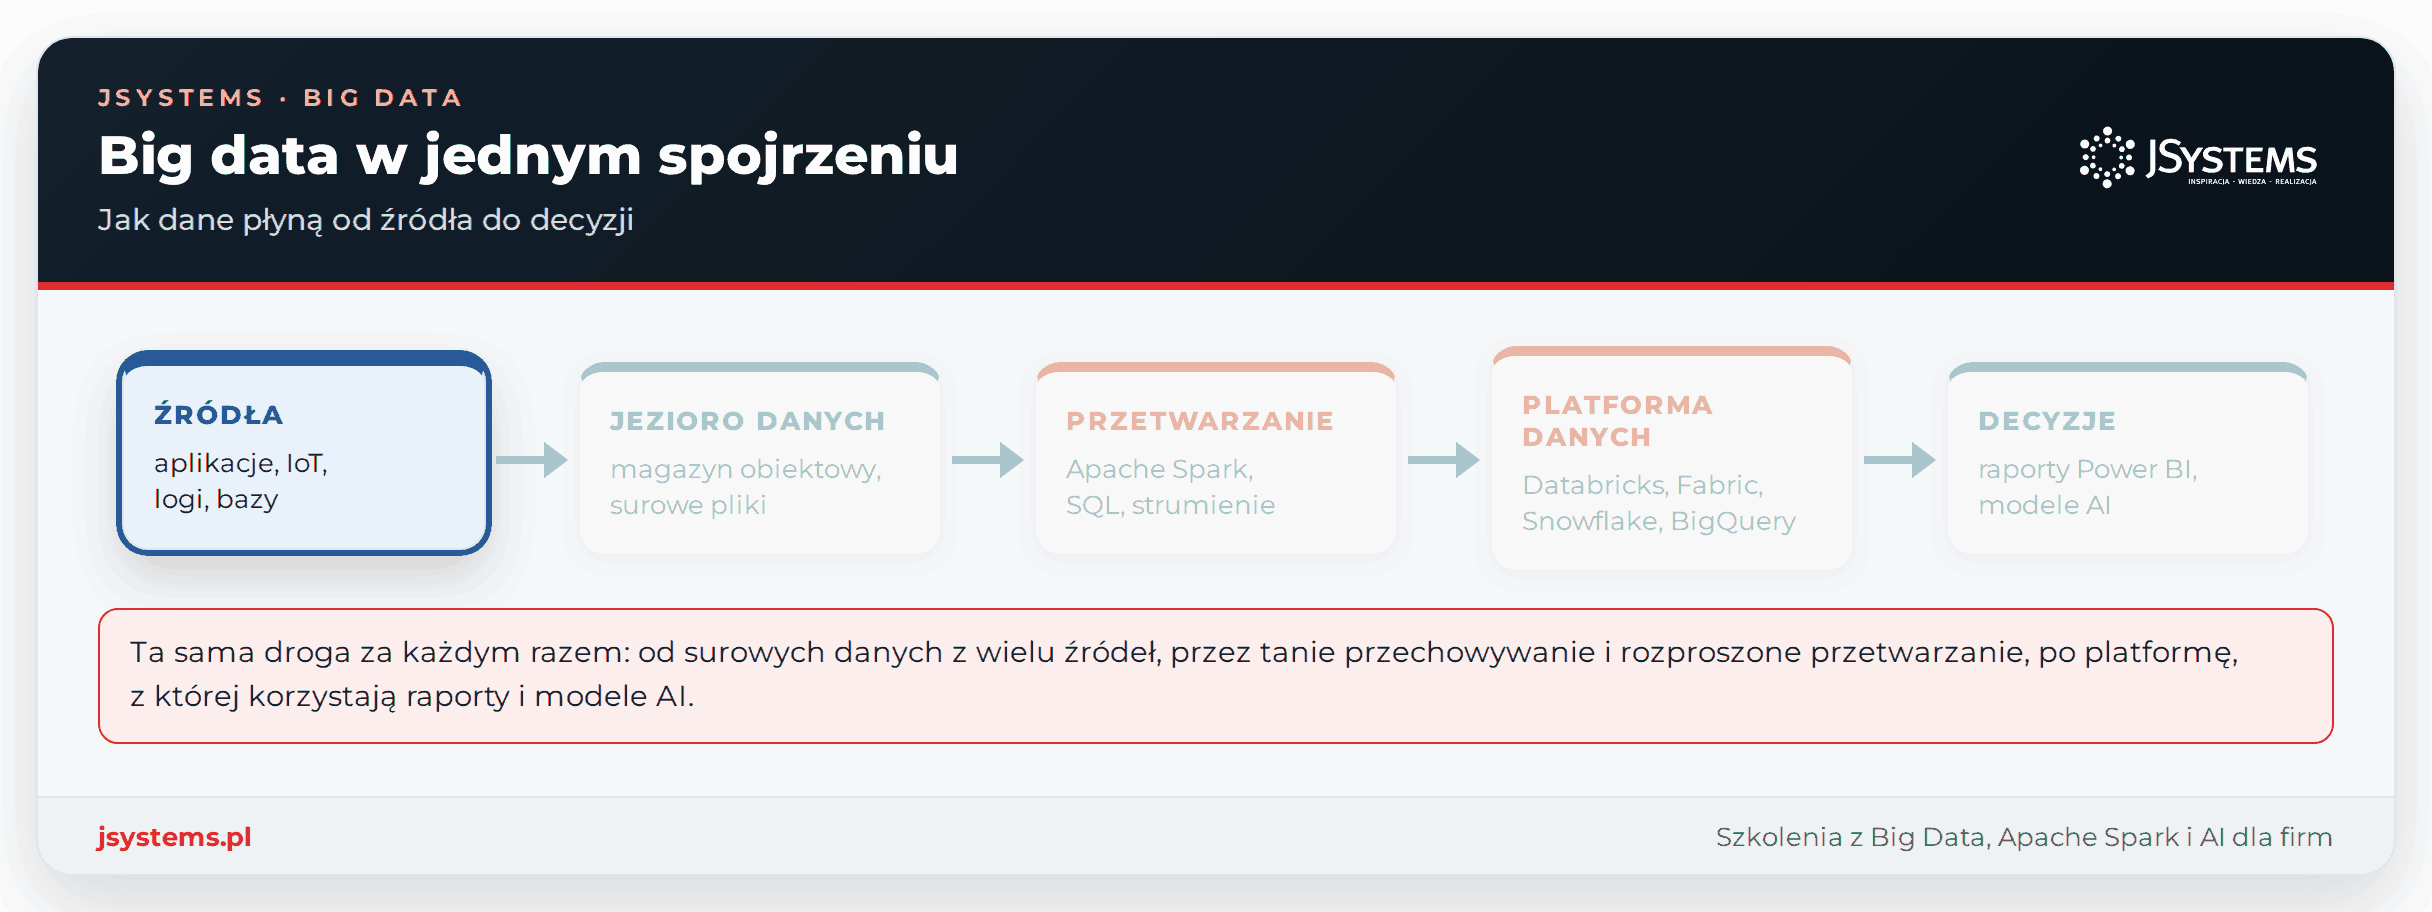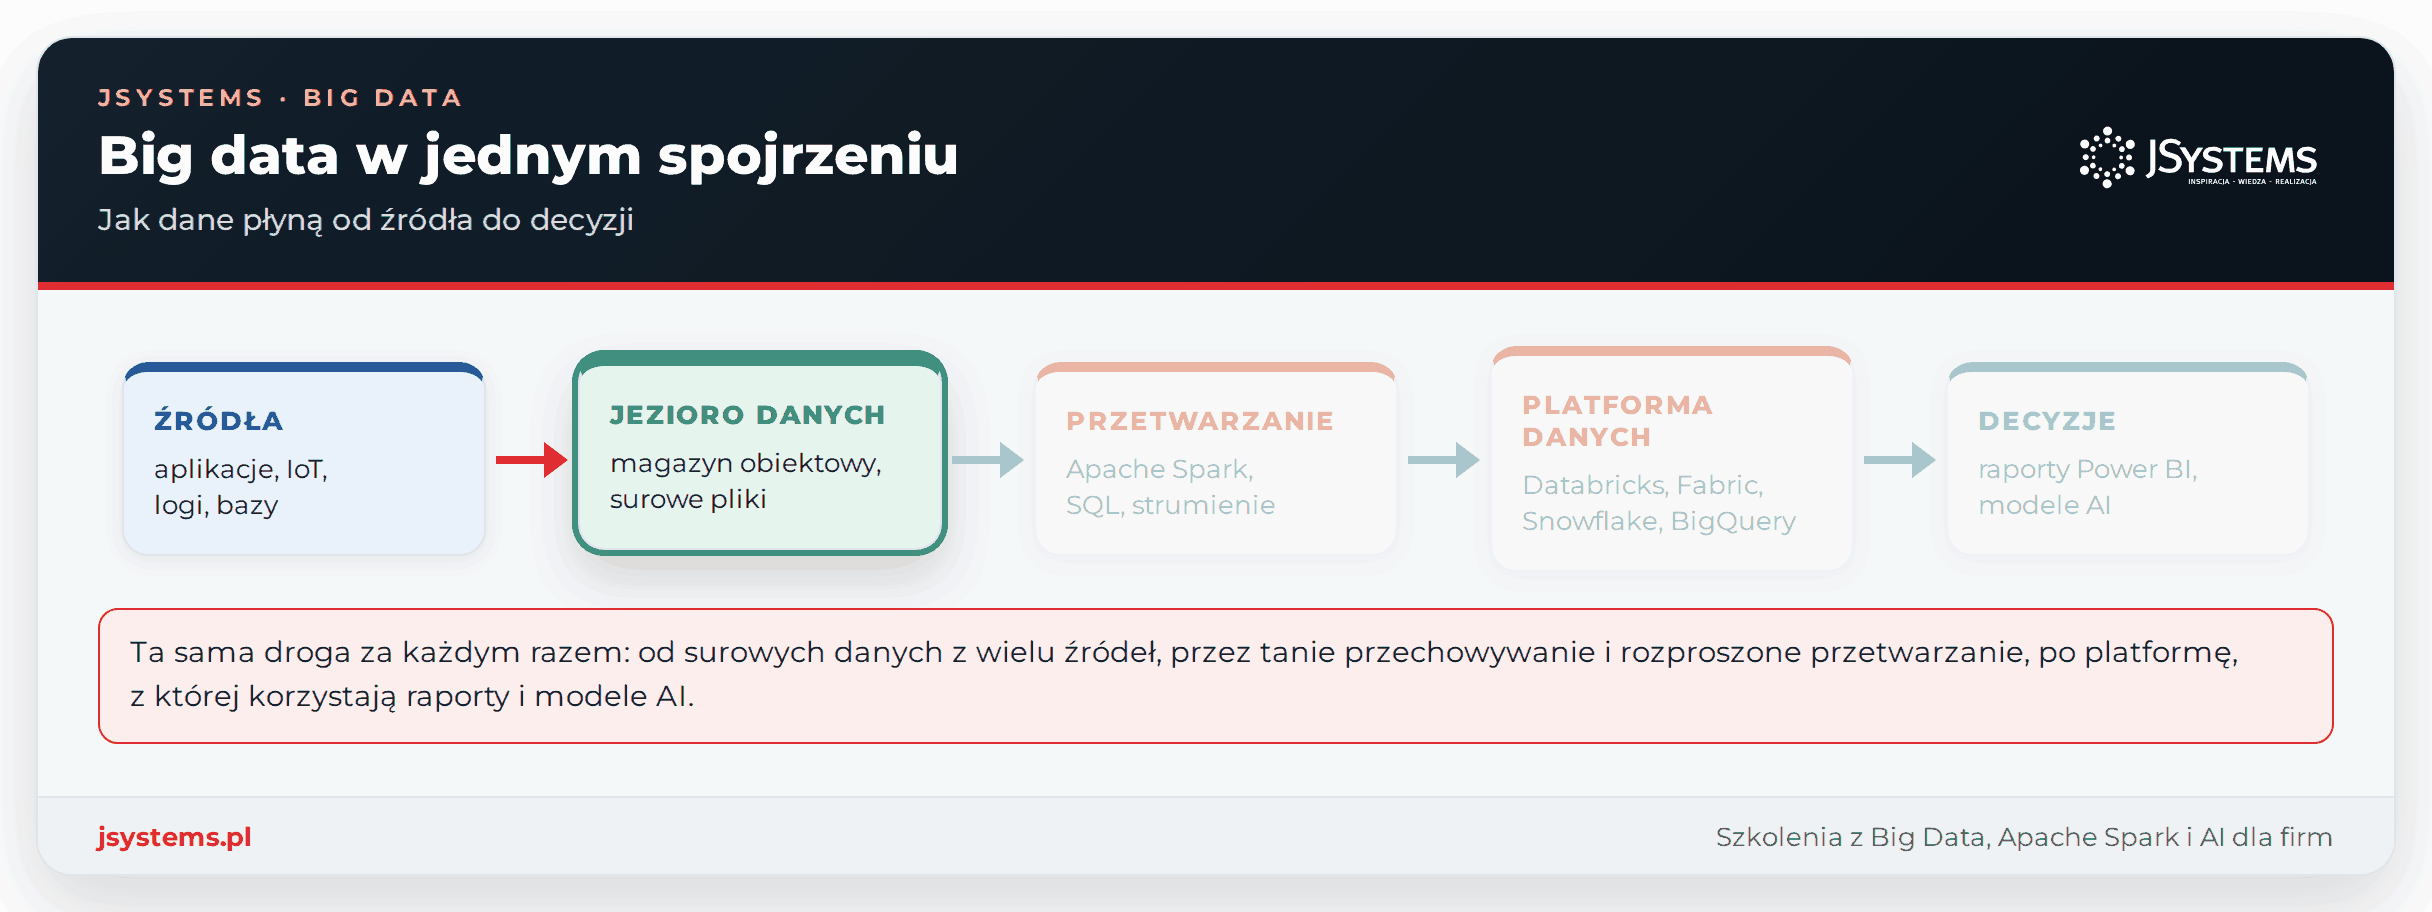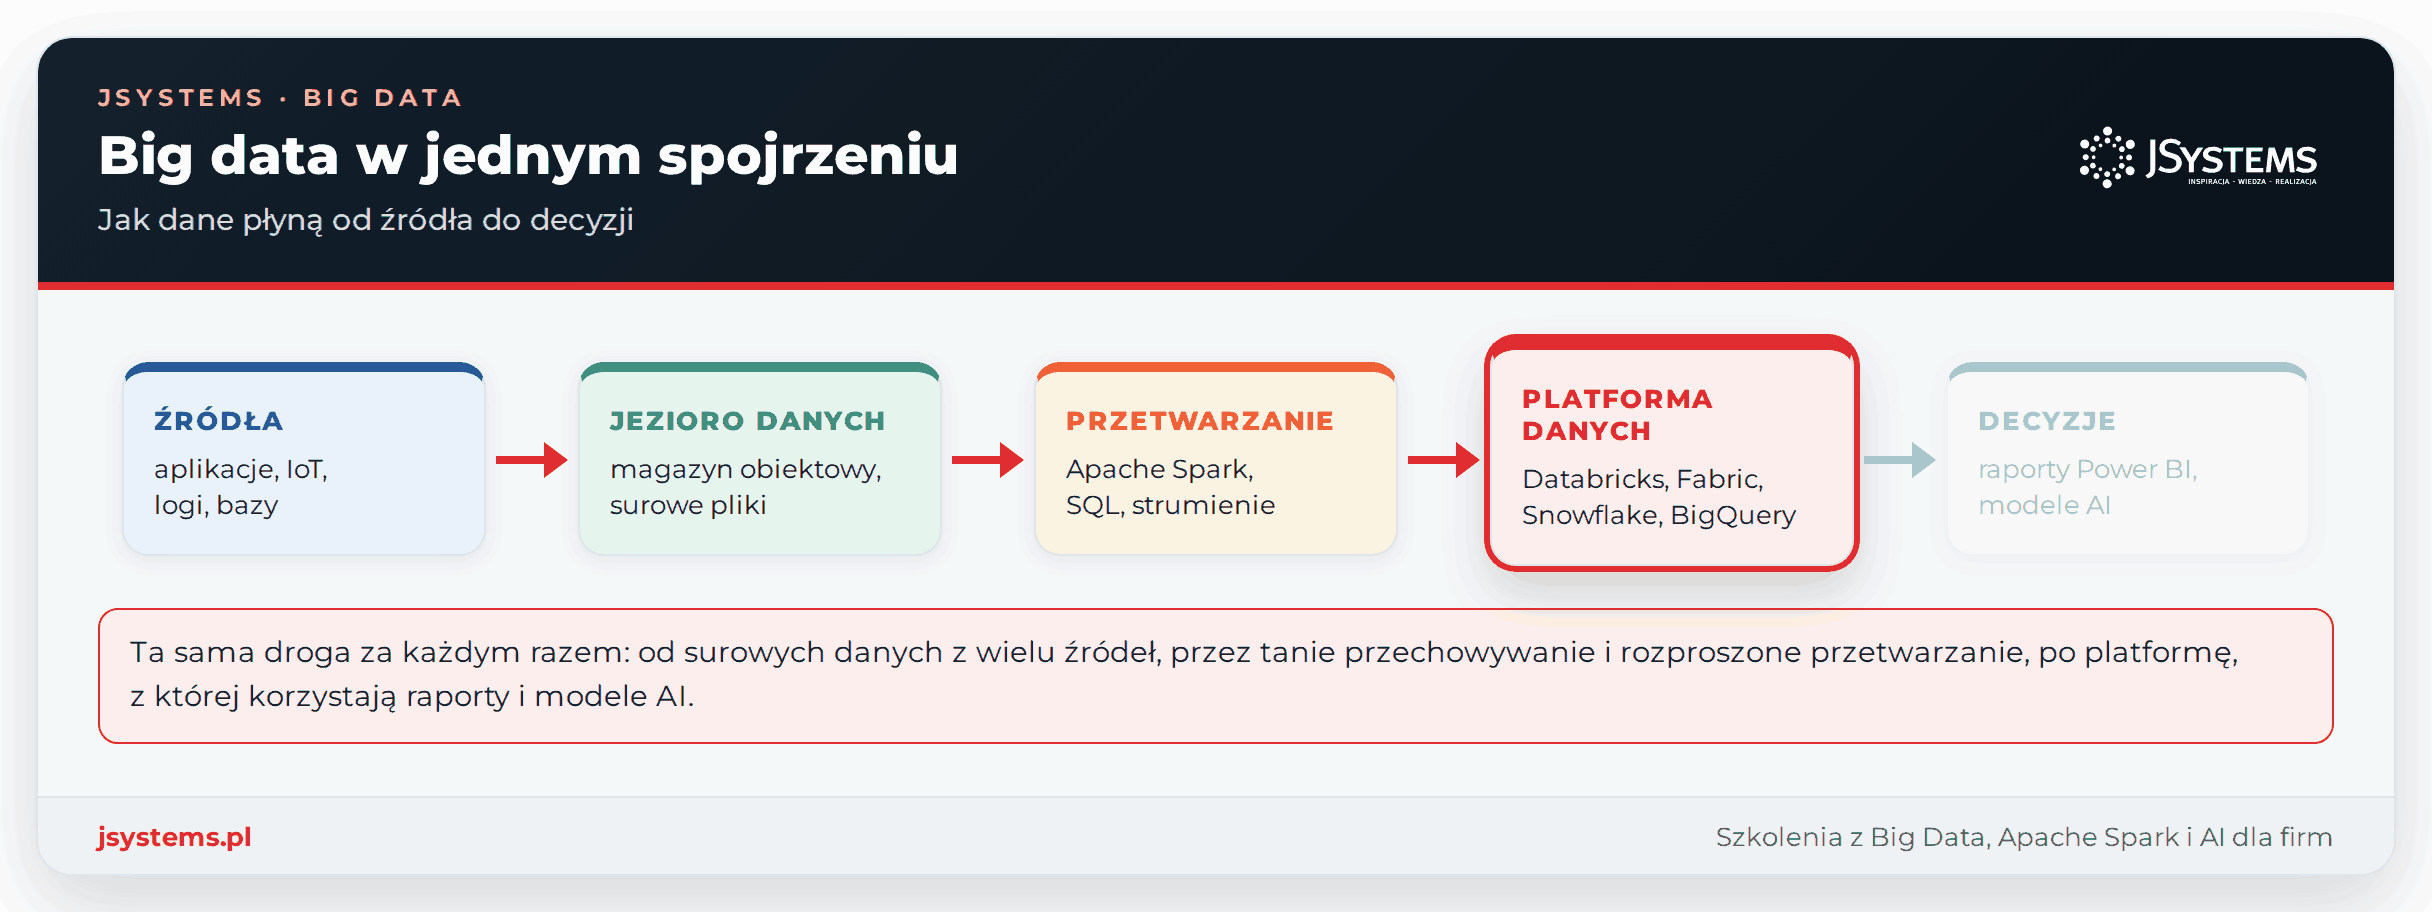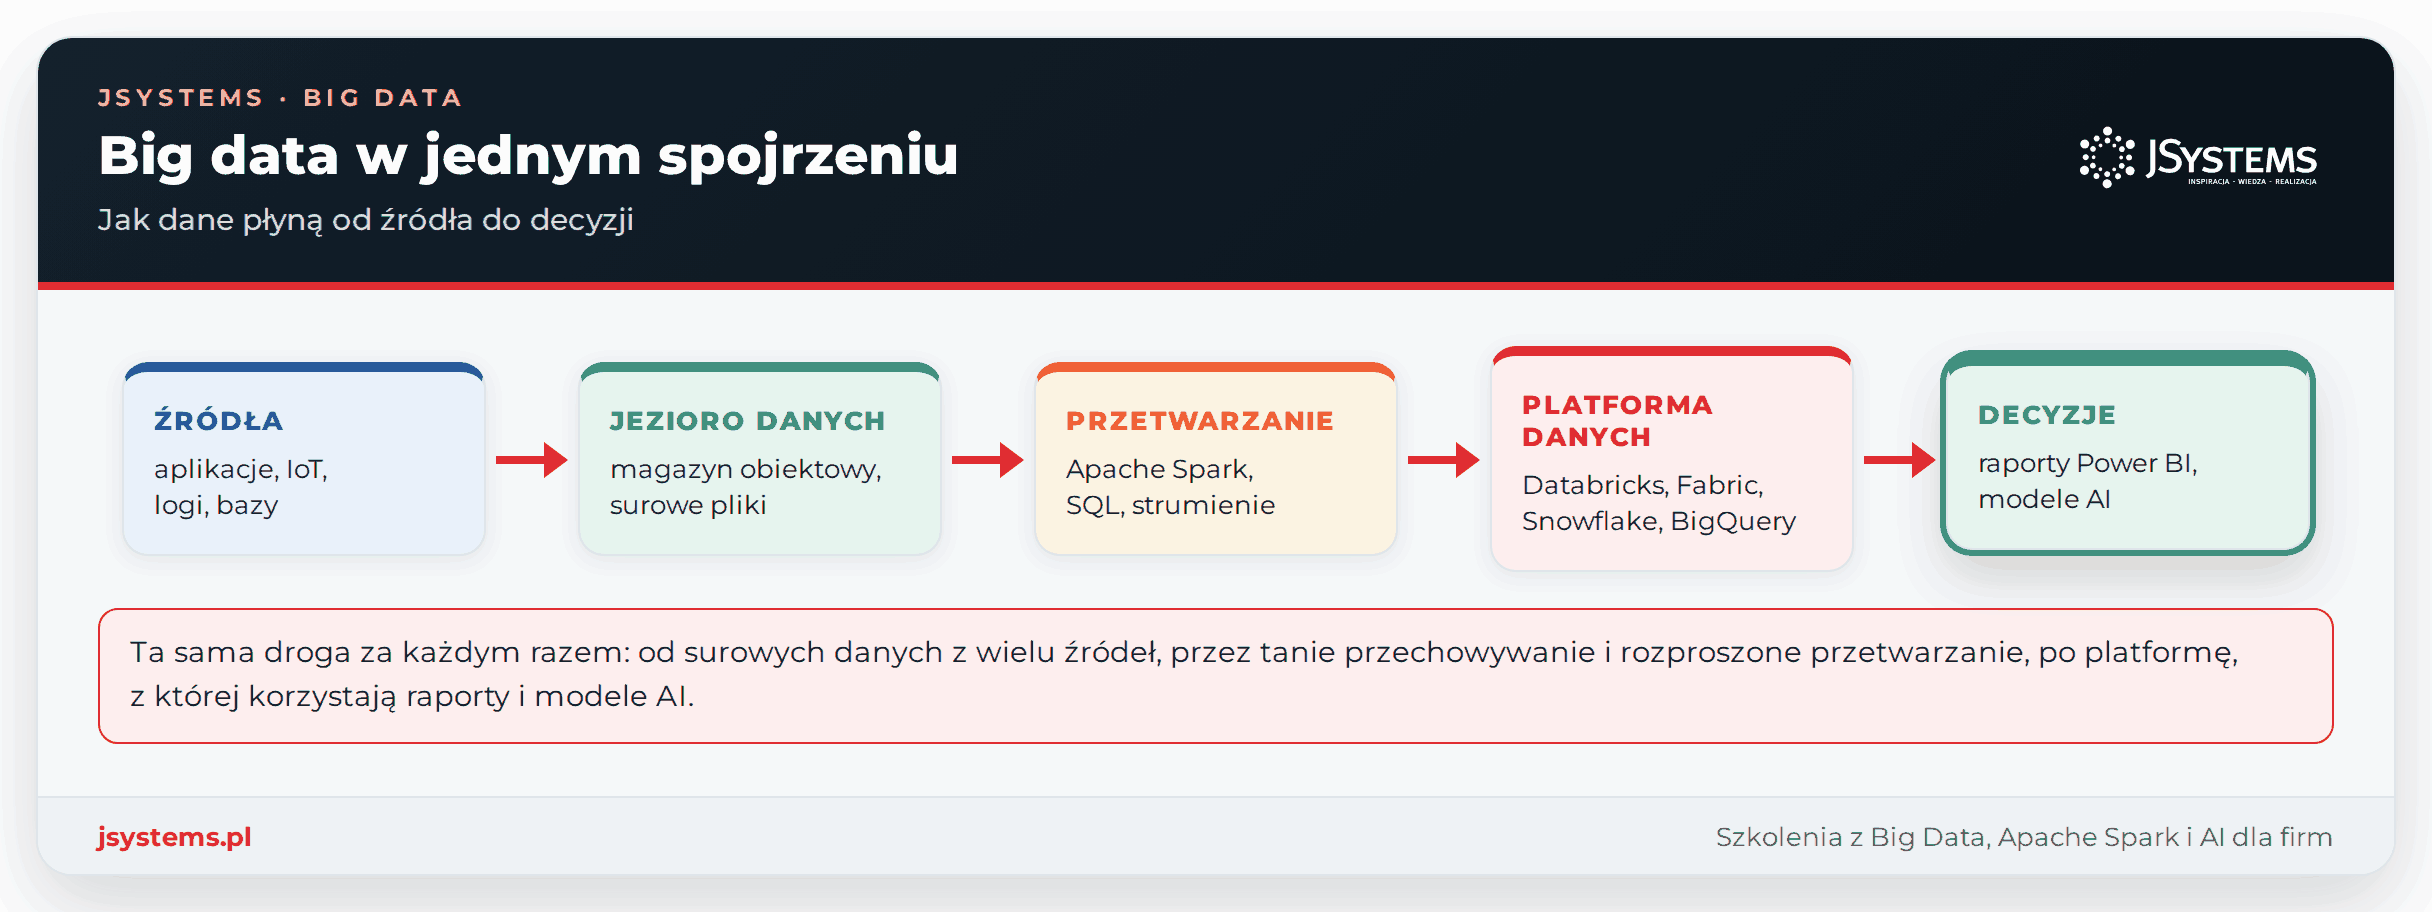
Teraz cały krajobraz na jednym obrazku. Narzędzi big data są dziesiątki, ale wszystkie układają się w kilka warstw, przez które po kolei przechodzą dane. Jeśli zapamiętasz tę mapę, łatwiej Ci będzie umieścić każde nowe narzędzie, o którym usłyszysz, we właściwym miejscu.
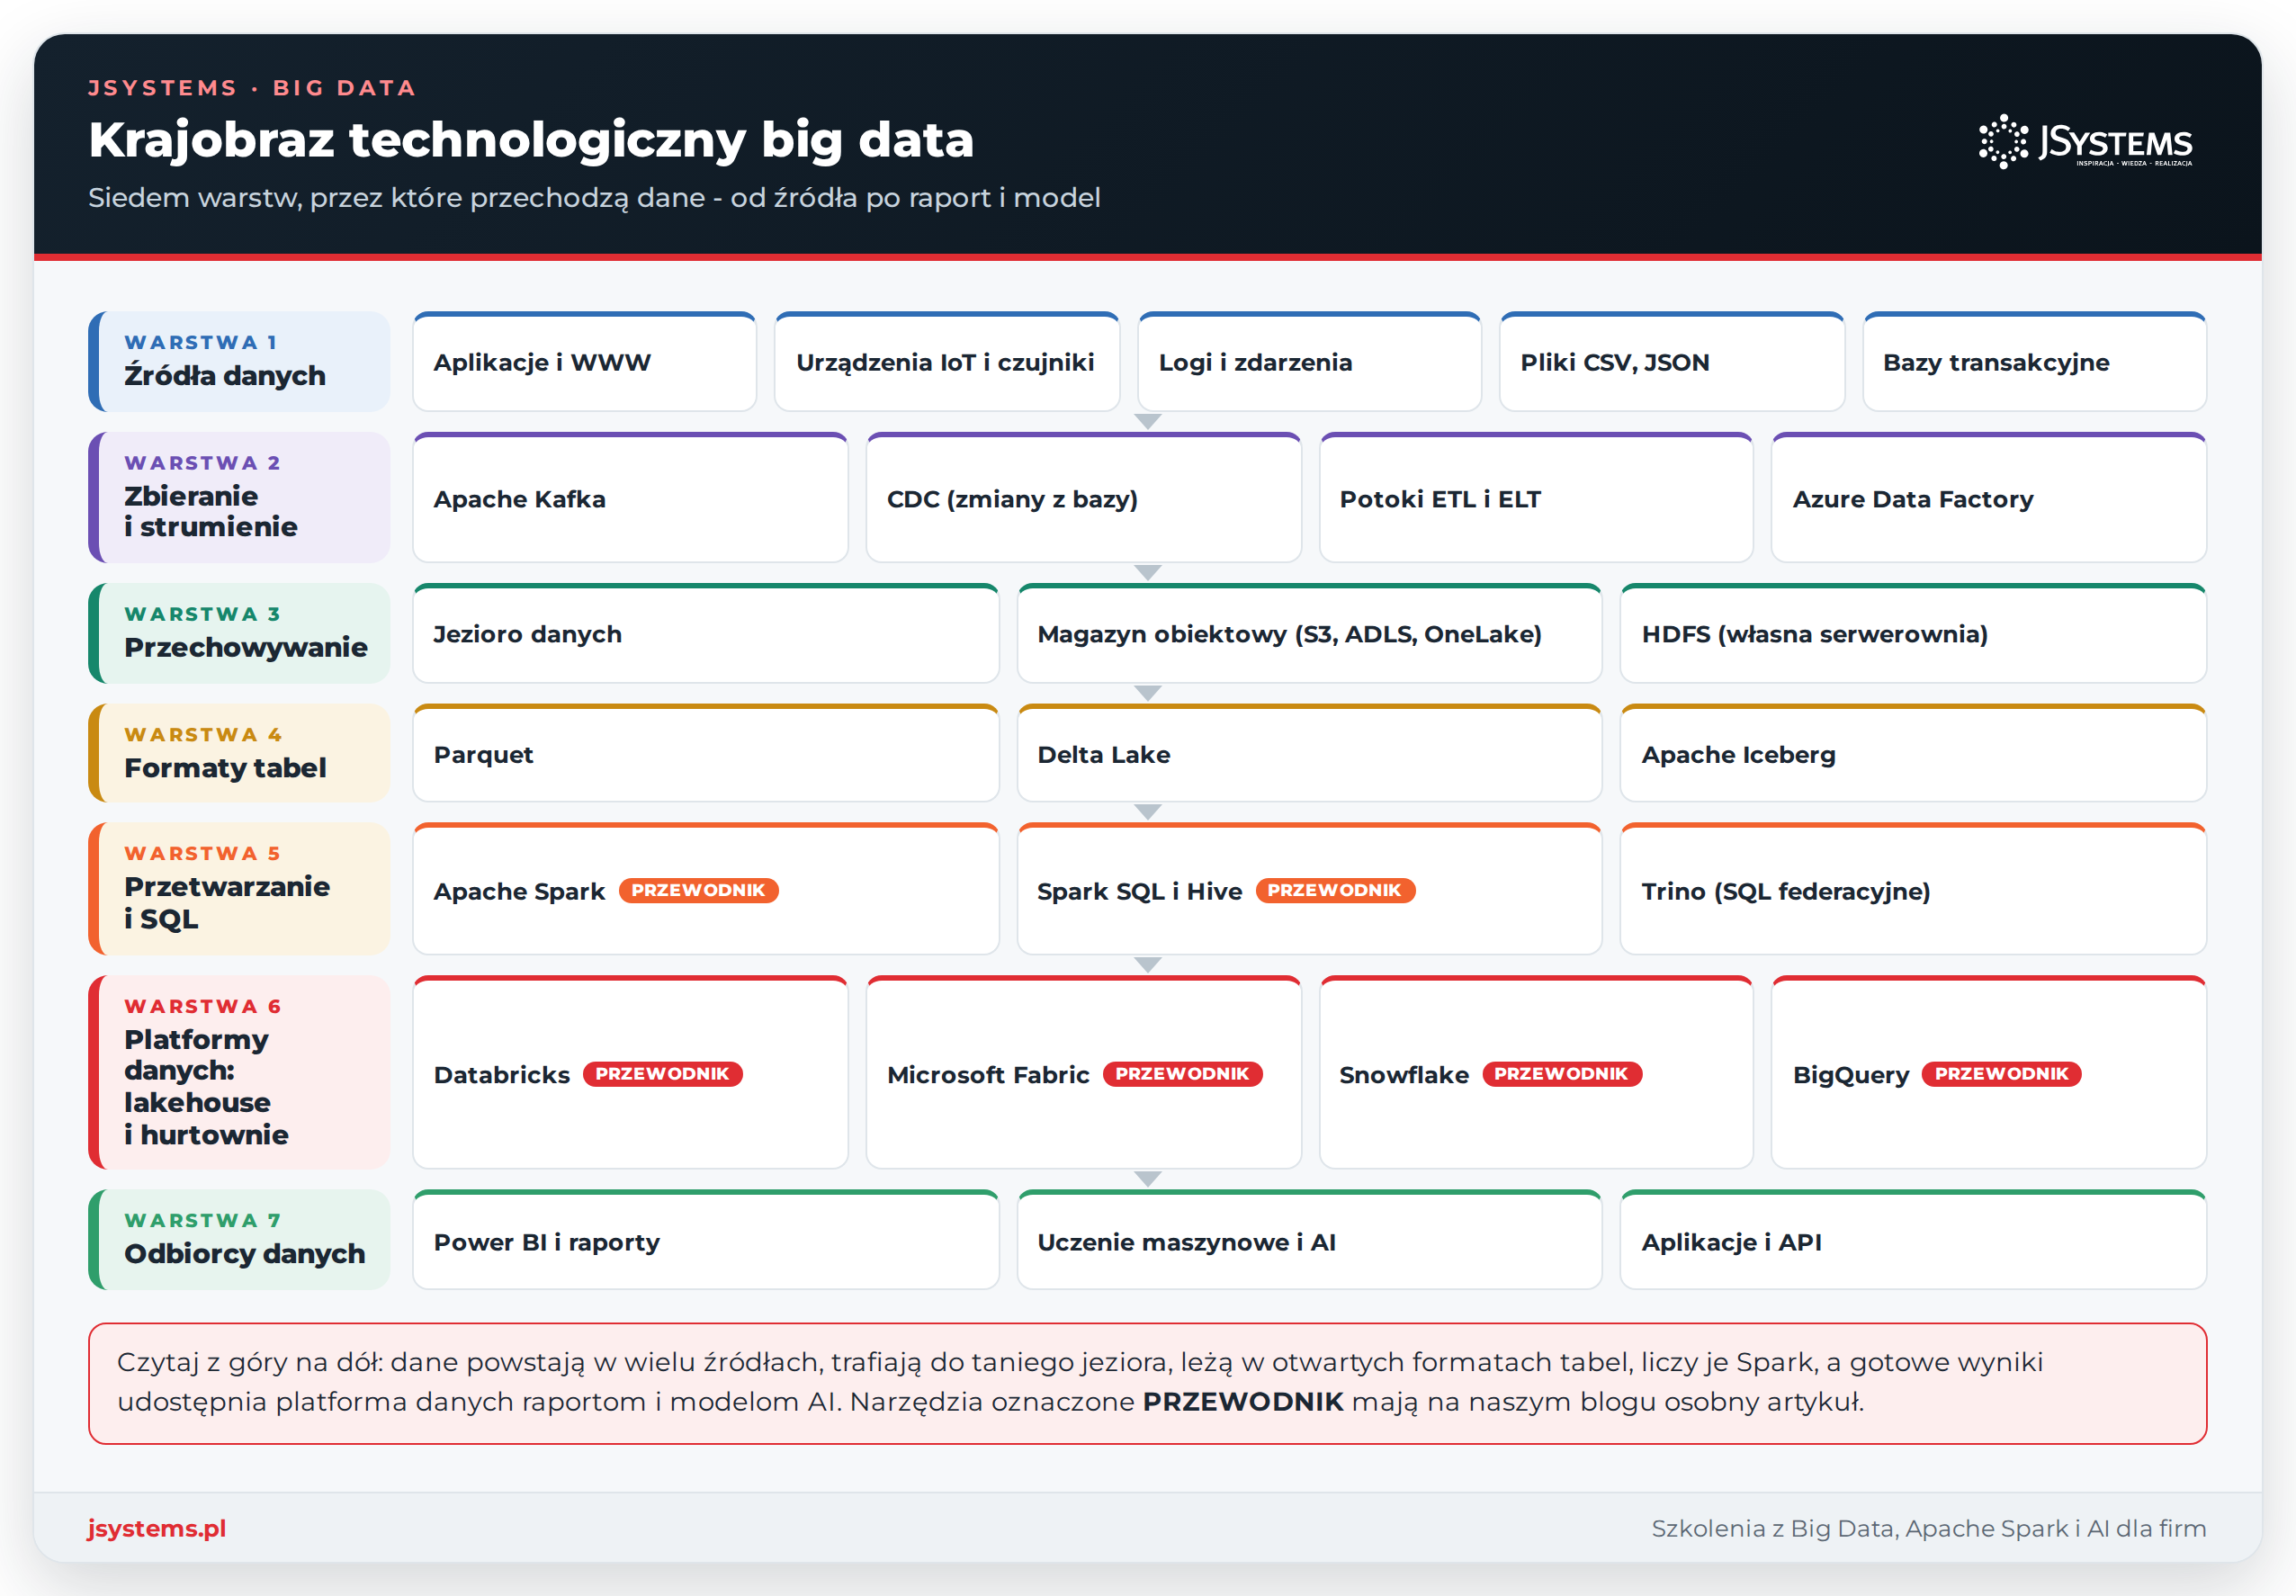
Czytajmy tę mapę od góry. Źródła to miejsca, gdzie dane powstają: aplikacje, strony WWW, czujniki, logi systemów i zwykłe bazy transakcyjne. Zbieranie i strumienie to warstwa, która te dane przechwytuje i dowozi dalej, często na bieżąco, na przykład w potokach ETL, czyli ciągach kroków, które wyciągają dane ze źródeł, przekształcają je i ładują do magazynu. Przechowywanie to tanie miejsce, gdzie wszystko ląduje w surowej postaci, czyli jezioro danych. Formaty tabel narzucają tym plikom strukturę i porządek. Przetwarzanie i SQL to silniki, które dane liczą i przekształcają. Platformy danych, czyli lakehouse i hurtownie w chmurze, spinają to w jedną całość z gotowym interfejsem, a odbiorcy to ludzie i programy, które z gotowych danych korzystają: raporty, pulpity i modele AI.
Przewodniki do narzędzi oznaczonych na mapie plakietką „PRZEWODNIK”
W kolejnych sekcjach przejdziemy przez te warstwy jedna po drugiej. Nie trzeba znać wszystkich narzędzi naraz - w konkretnym projekcie używa się zwykle kilku. Mapa jest po to, żeby wiedzieć, która warstwa za co odpowiada.
Zobacz też: Szkolenie Przetwarzanie danych Big Data z Apache Spark
Dane w big data rzadko pochodzą z jednego miejsca. Składają się na nie zdarzenia z aplikacji, kliknięcia na stronie, odczyty z czujników w fabryce, logi serwerów i zrzuty ze zwykłych baz. Część przychodzi wielkimi porcjami raz na jakiś czas, a część małymi kroplami bez przerwy. Dlatego od razu na wejściu pojawia się rozróżnienie, które wraca potem na każdym kroku: przetwarzanie wsadowe kontra strumieniowe.
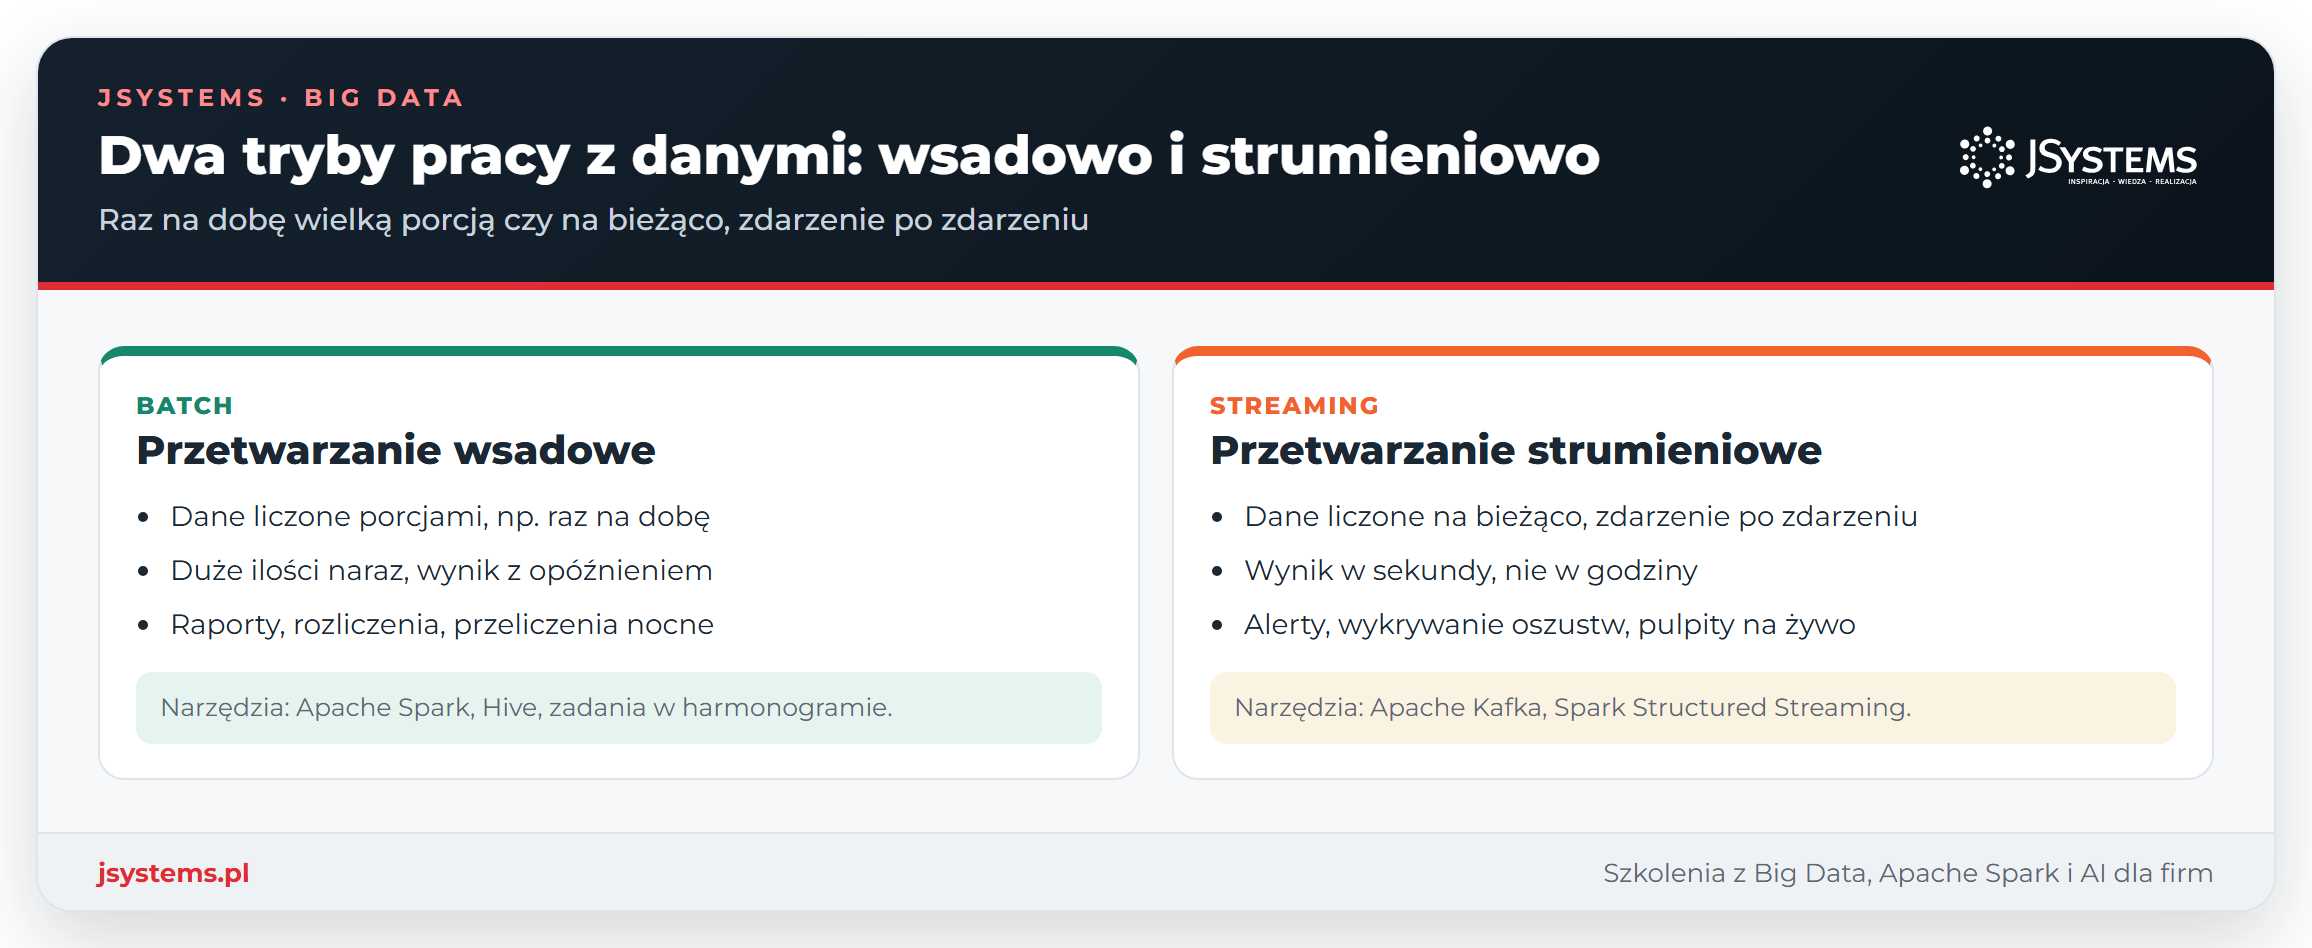
Przetwarzanie wsadowe (batch) to klasyka: zbieramy dane przez jakiś czas, a potem liczymy je jedną dużą porcją - na przykład nocne przeliczenie całej sprzedaży z minionego dnia. Przetwarzanie strumieniowe (streaming) działa inaczej: liczy dane na bieżąco, zdarzenie po zdarzeniu, żeby wynik był gotowy w sekundy. Tak działają alerty, wykrywanie oszustw czy pulpity pokazujące ruch na żywo. Jednym z najczęściej używanych narzędzi do strumieni jest Apache Kafka, która przyjmuje miliony zdarzeń i podaje je dalej do przetworzenia. Jak wygląda nowoczesny stos łączący oba tryby, ze strumieniami i federacyjnym SQL, pokazujemy w artykule Współczesne rozwiązania Big Data - Spark, lakehouse, streaming i federacyjne SQL w praktyce.
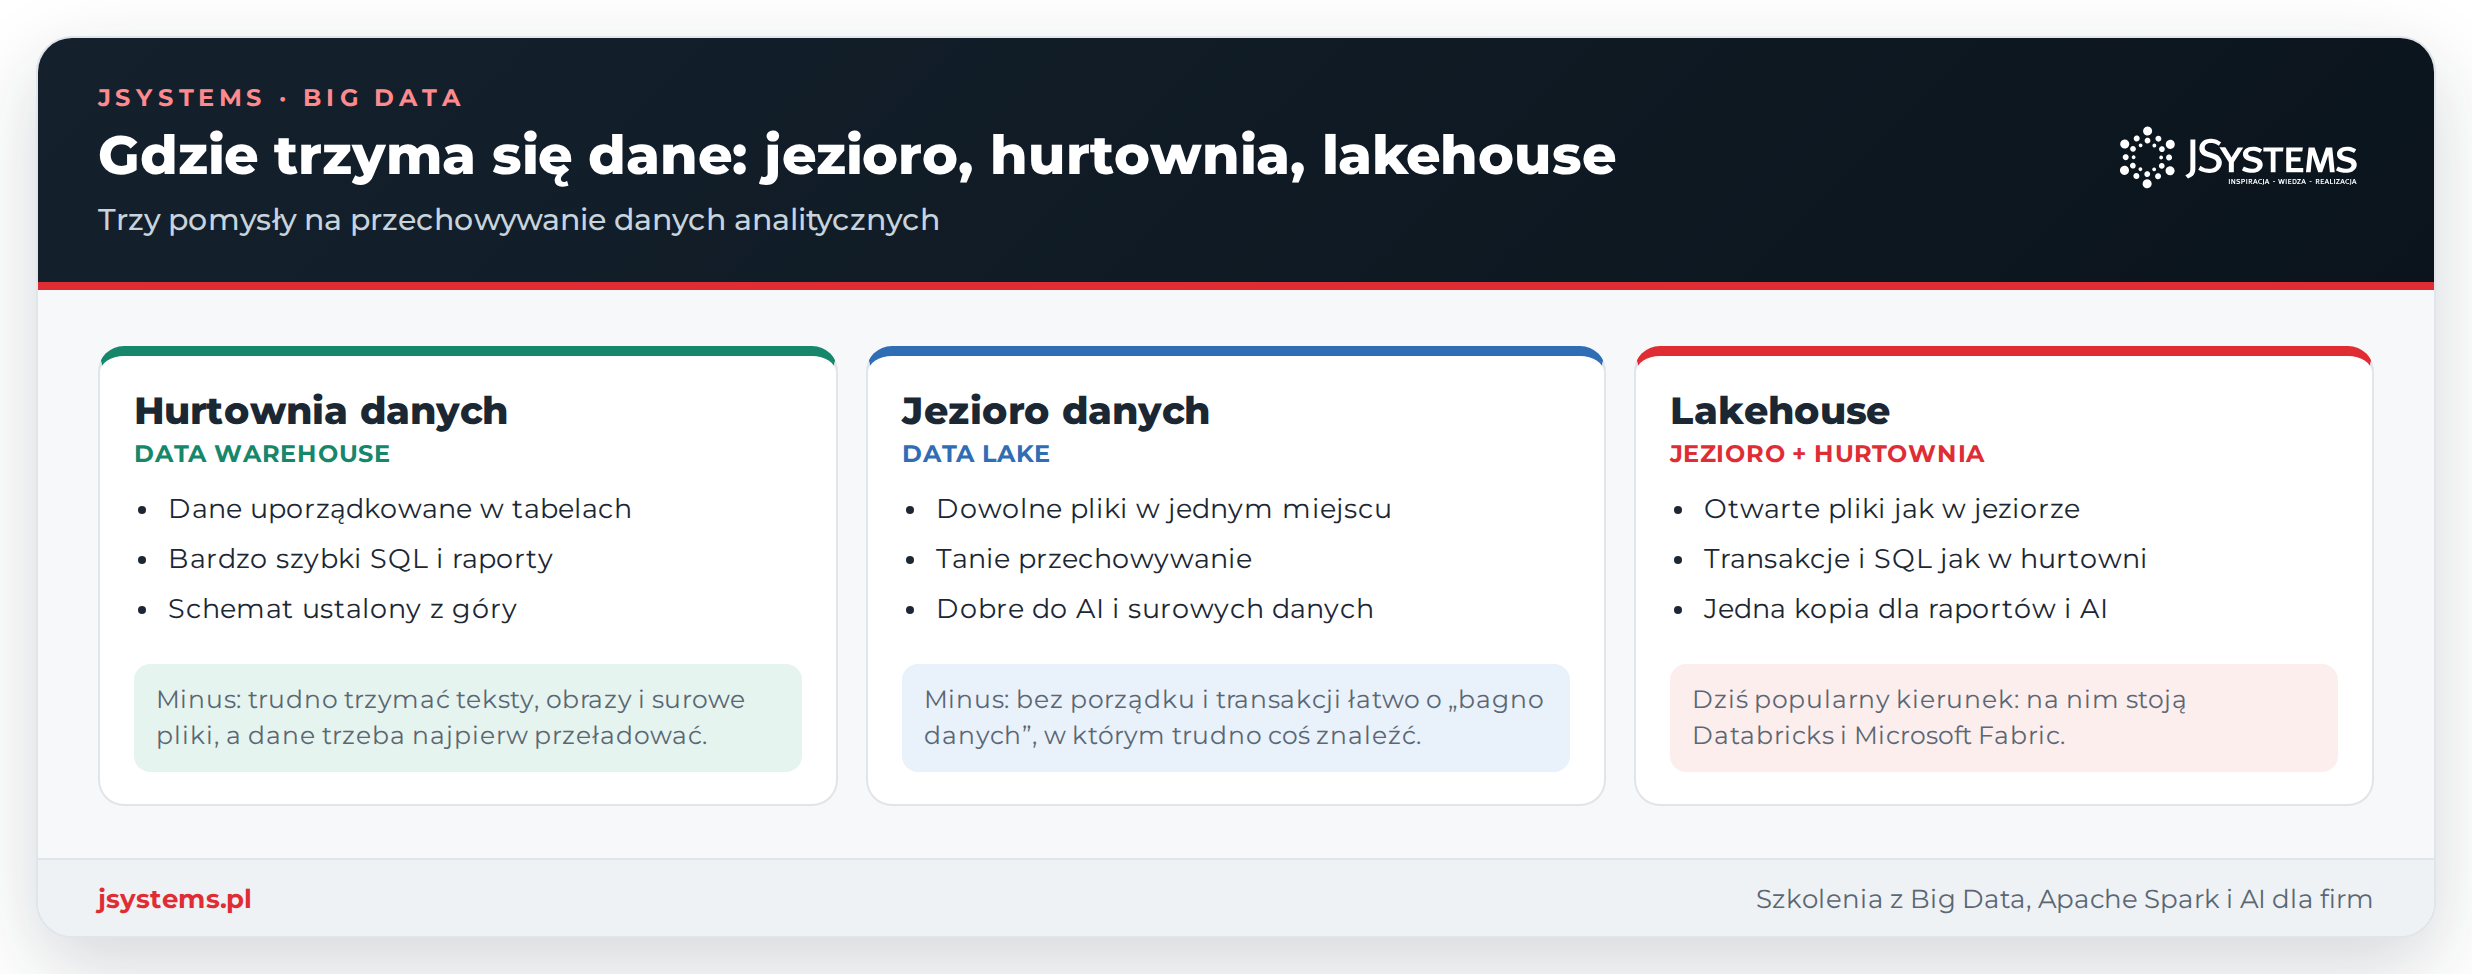
Kiedy dane już spływają, trzeba je gdzieś trzymać. Tu od lat ścierają się dwa pomysły, a trzeci je godzi. Hurtownia danych stawia na porządek i szybki SQL, jezioro danych na elastyczność i niski koszt, a lakehouse próbuje wziąć to, co najlepsze z obu.
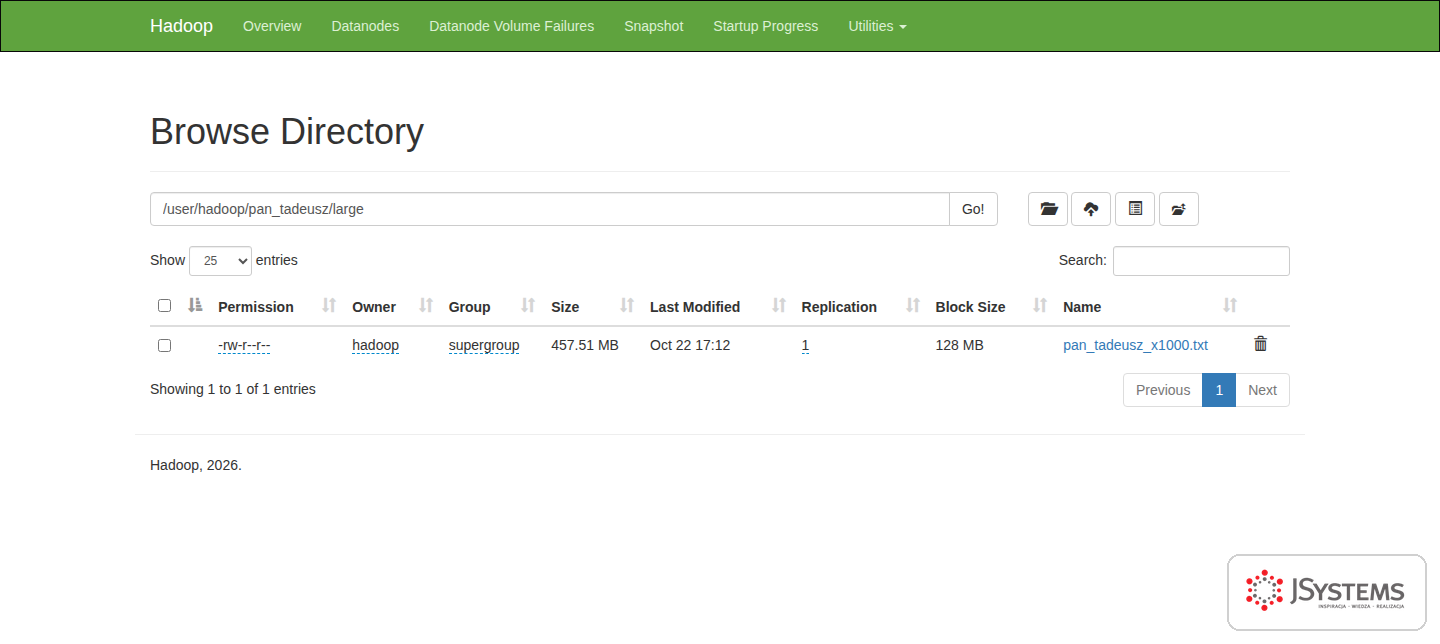
W starym świecie dane trzymało się na własnych serwerach, w rozproszonym systemie plików HDFS z projektu Hadoop. Plik dzielono na bloki rozsiane po wielu maszynach, a jedna z nich pamiętała, gdzie co leży. Taki klaster ma swój interfejs, w którym można przeglądać katalogi i pliki oraz sprawdzić rozmiar bloku i liczbę kopii każdego pliku.
Dziś rolę HDFS przejął w większości przypadków magazyn obiektowy w chmurze: Amazon S3, Azure Data Lake Storage czy OneLake w Microsoft Fabric. Z punktu widzenia użytkownika pełni tę samą rolę (wrzucasz pliki, a one leżą tanio i bezpiecznie), ale skalowaniem i awariami dysków zajmuje się dostawca chmury. To właśnie na magazynie obiektowym stoi dzisiejsze jezioro danych i lakehouse. Pełny obraz architektury lakehouse rozkładamy w przewodniku Czym jest Databricks? Kompletny przewodnik po platformie lakehouse.
Samo wrzucenie plików do jeziora to za mało. Gdyby dane leżały jako zwykłe pliki tekstowe, każde zapytanie musiałoby czytać je w całości, a równoległe zmiany łatwo doprowadziłyby do bałaganu. Dlatego dane analityczne trzyma się w specjalnych formatach, które porządkują je i przyspieszają odczyt.
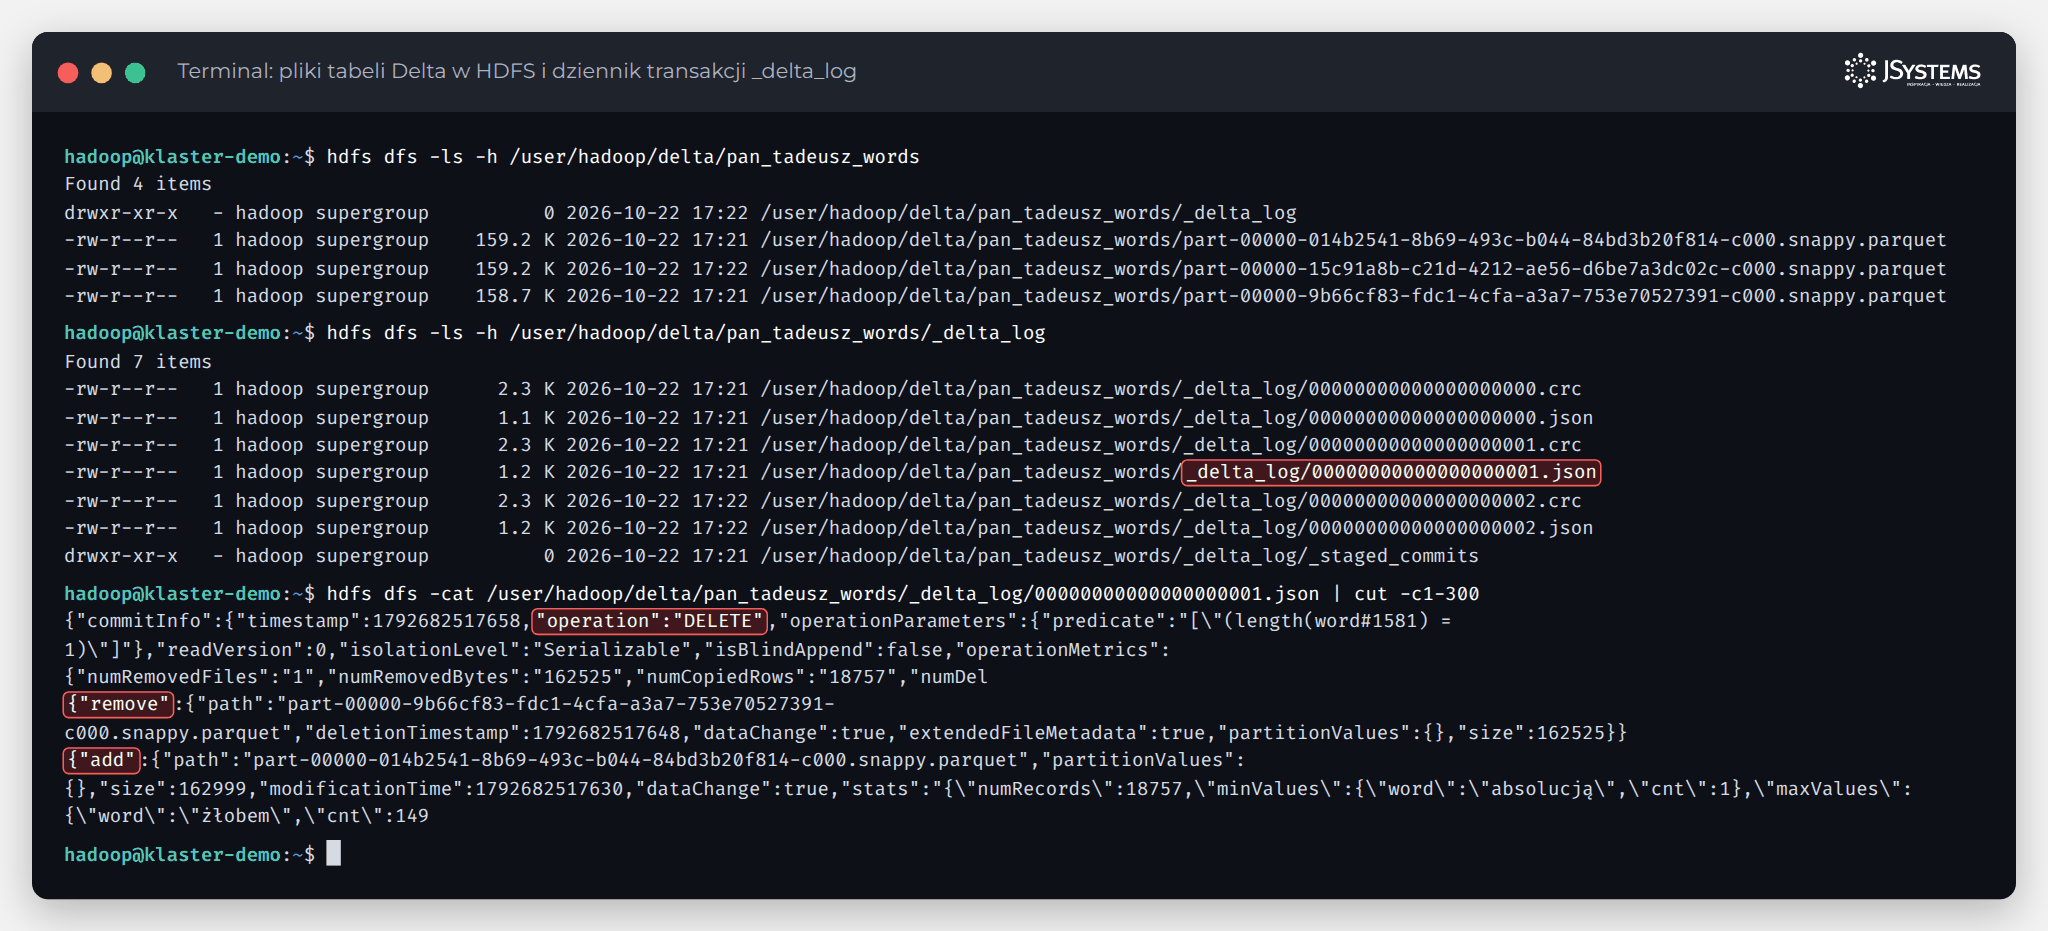
Dlaczego to ważne dla kogoś, kto dopiero poznaje temat? Bo format pliku decyduje o niezależności. Dane zapisane w Parquecie czy Delcie przeczyta wiele różnych silników i platform, więc zmiana narzędzia albo dostawcy chmury nie wymaga przepisywania wszystkiego od nowa. Jak z dziennika transakcji odczytać kolejne wersje tabeli i wrócić do wcześniejszej, pokazujemy w historii big data.
Przechowywanie to jedno, ale dane trzeba jeszcze policzyć: połączyć, pogrupować, przefiltrować, zsumować. W big data robi to silnik, który dzieli obliczenia na kawałki i rozsyła je na węzły klastra. Pierwszym takim silnikiem, który upowszechnił się poza Google, był MapReduce z projektu Hadoop. Działał, ale był powolny, bo po każdym kroku zapisywał wyniki pośrednie na dysk, i wymagał pisania dużo kodu w Javie.
Przełom przyniósł Apache Spark. Zamiast zapisywać dane na dysk po każdym kroku, trzyma je w pamięci operacyjnej klastra, dlatego zadania, które wiele razy przechodzą po tych samych danych, liczy znacznie szybciej. Do tego ten sam kod napiszesz w Pythonie (biblioteka PySpark), w SQL albo w Scali, a uruchomisz go na laptopie i na wielkim klastrze prawie bez zmian. Dziś Spark to jeden z podstawowych silników big data.
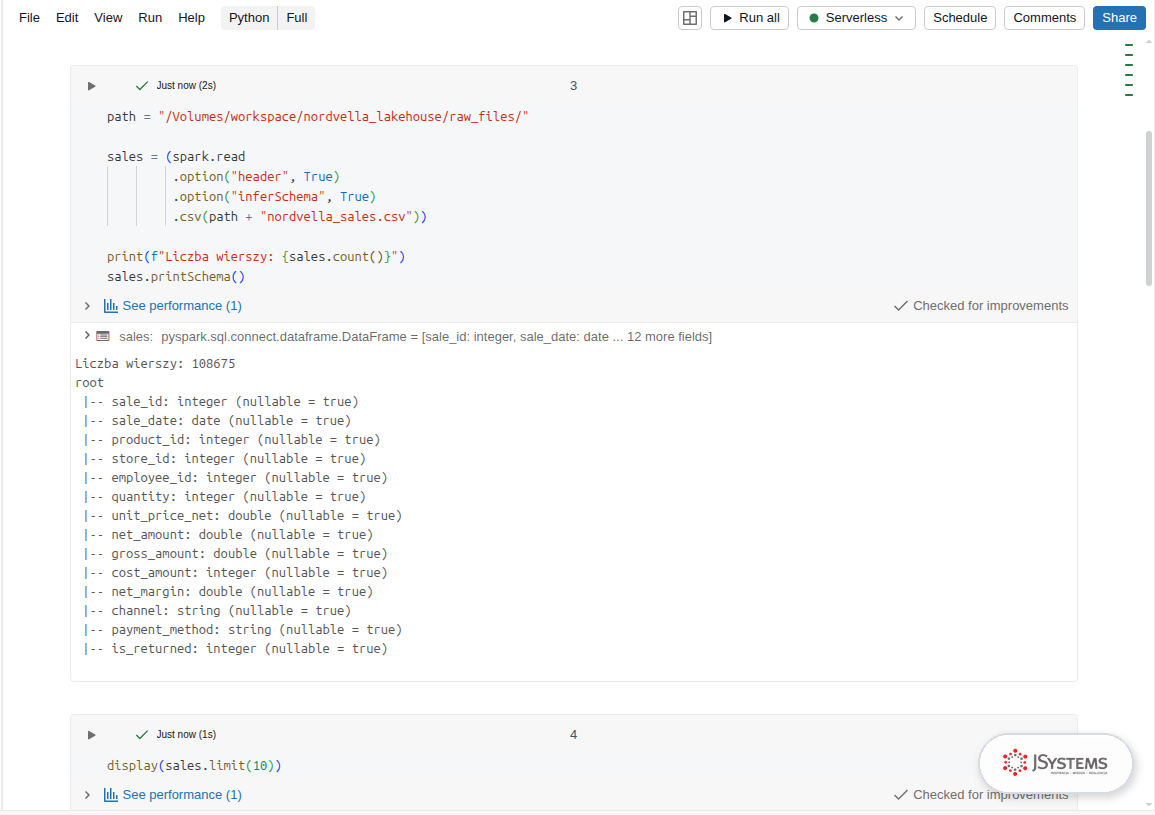
Nad samym silnikiem jest jeszcze warstwa SQL. Już w czasach Hadoopa narzędzie Hive pozwalało pisać zapytania SQL zamiast kodu w Javie, a dziś robi to Spark SQL. Gdzie indziej używa się silnika Trino, który potrafi jednym zapytaniem SQL sięgnąć do kilku różnych źródeł naraz (tak zwane SQL federacyjne). Spark i Hive porównujemy dokładnie w artykule Apache Spark vs Apache Hive - które narzędzie Big Data wybrać, a od podstaw tłumaczymy sam silnik w przewodniku Czym jest Apache Spark - kompletny przewodnik dla początkujących.
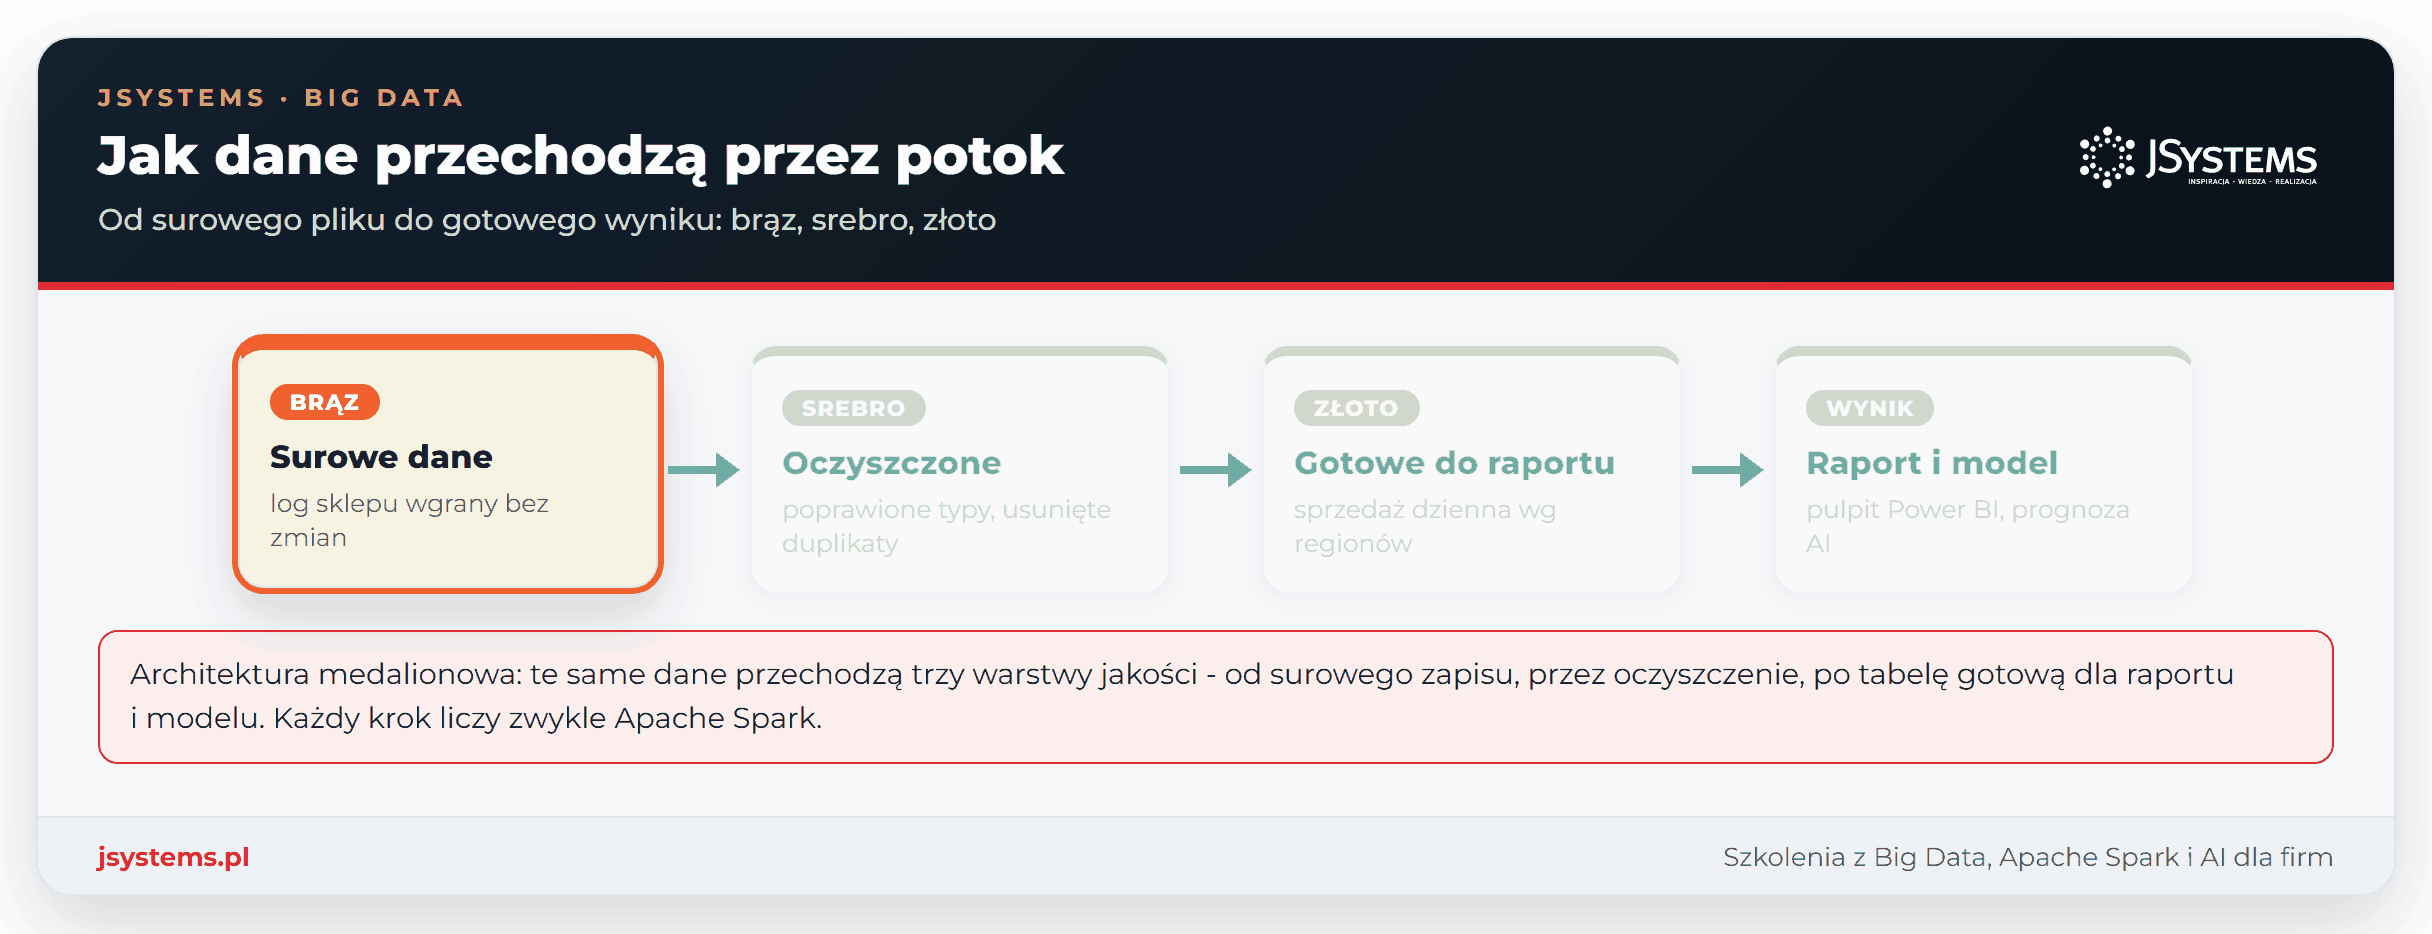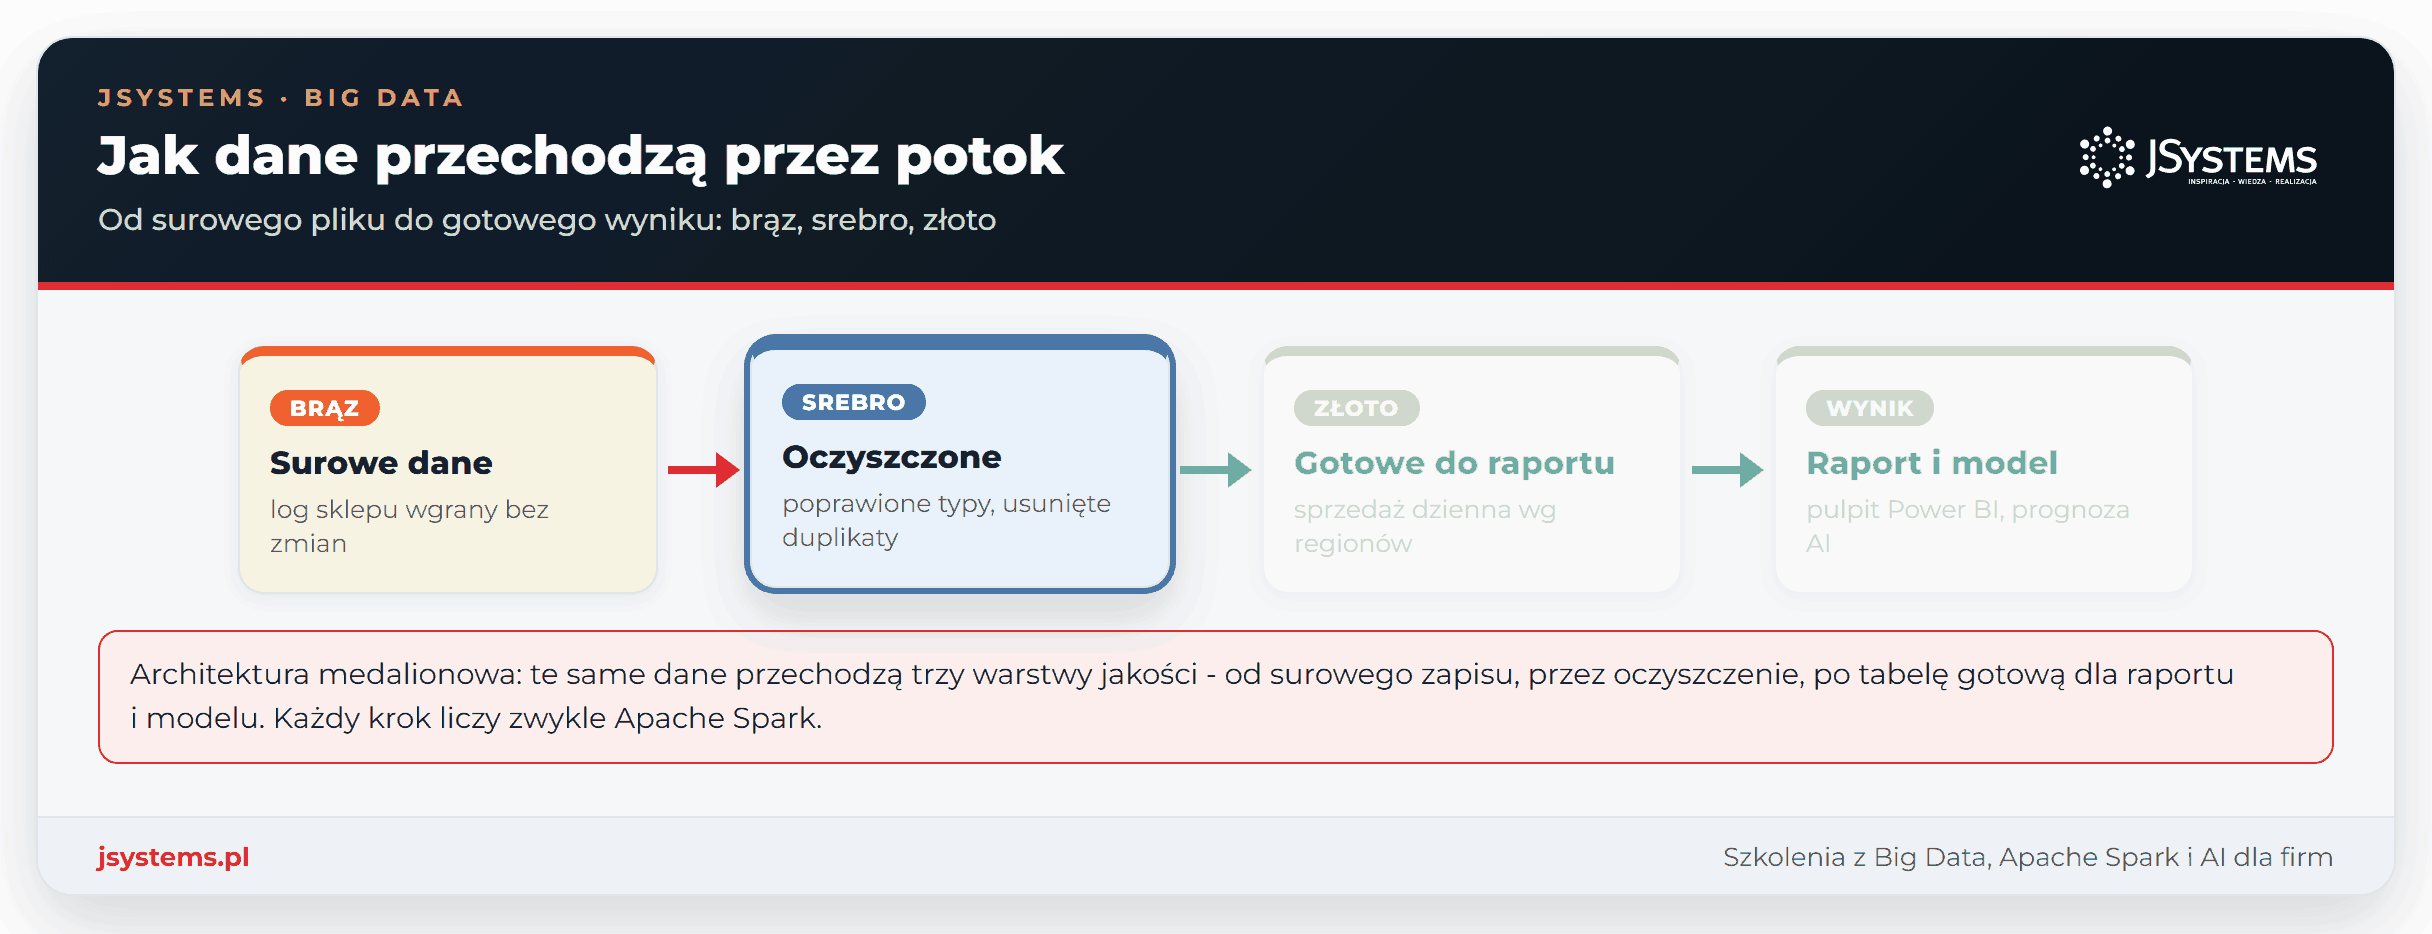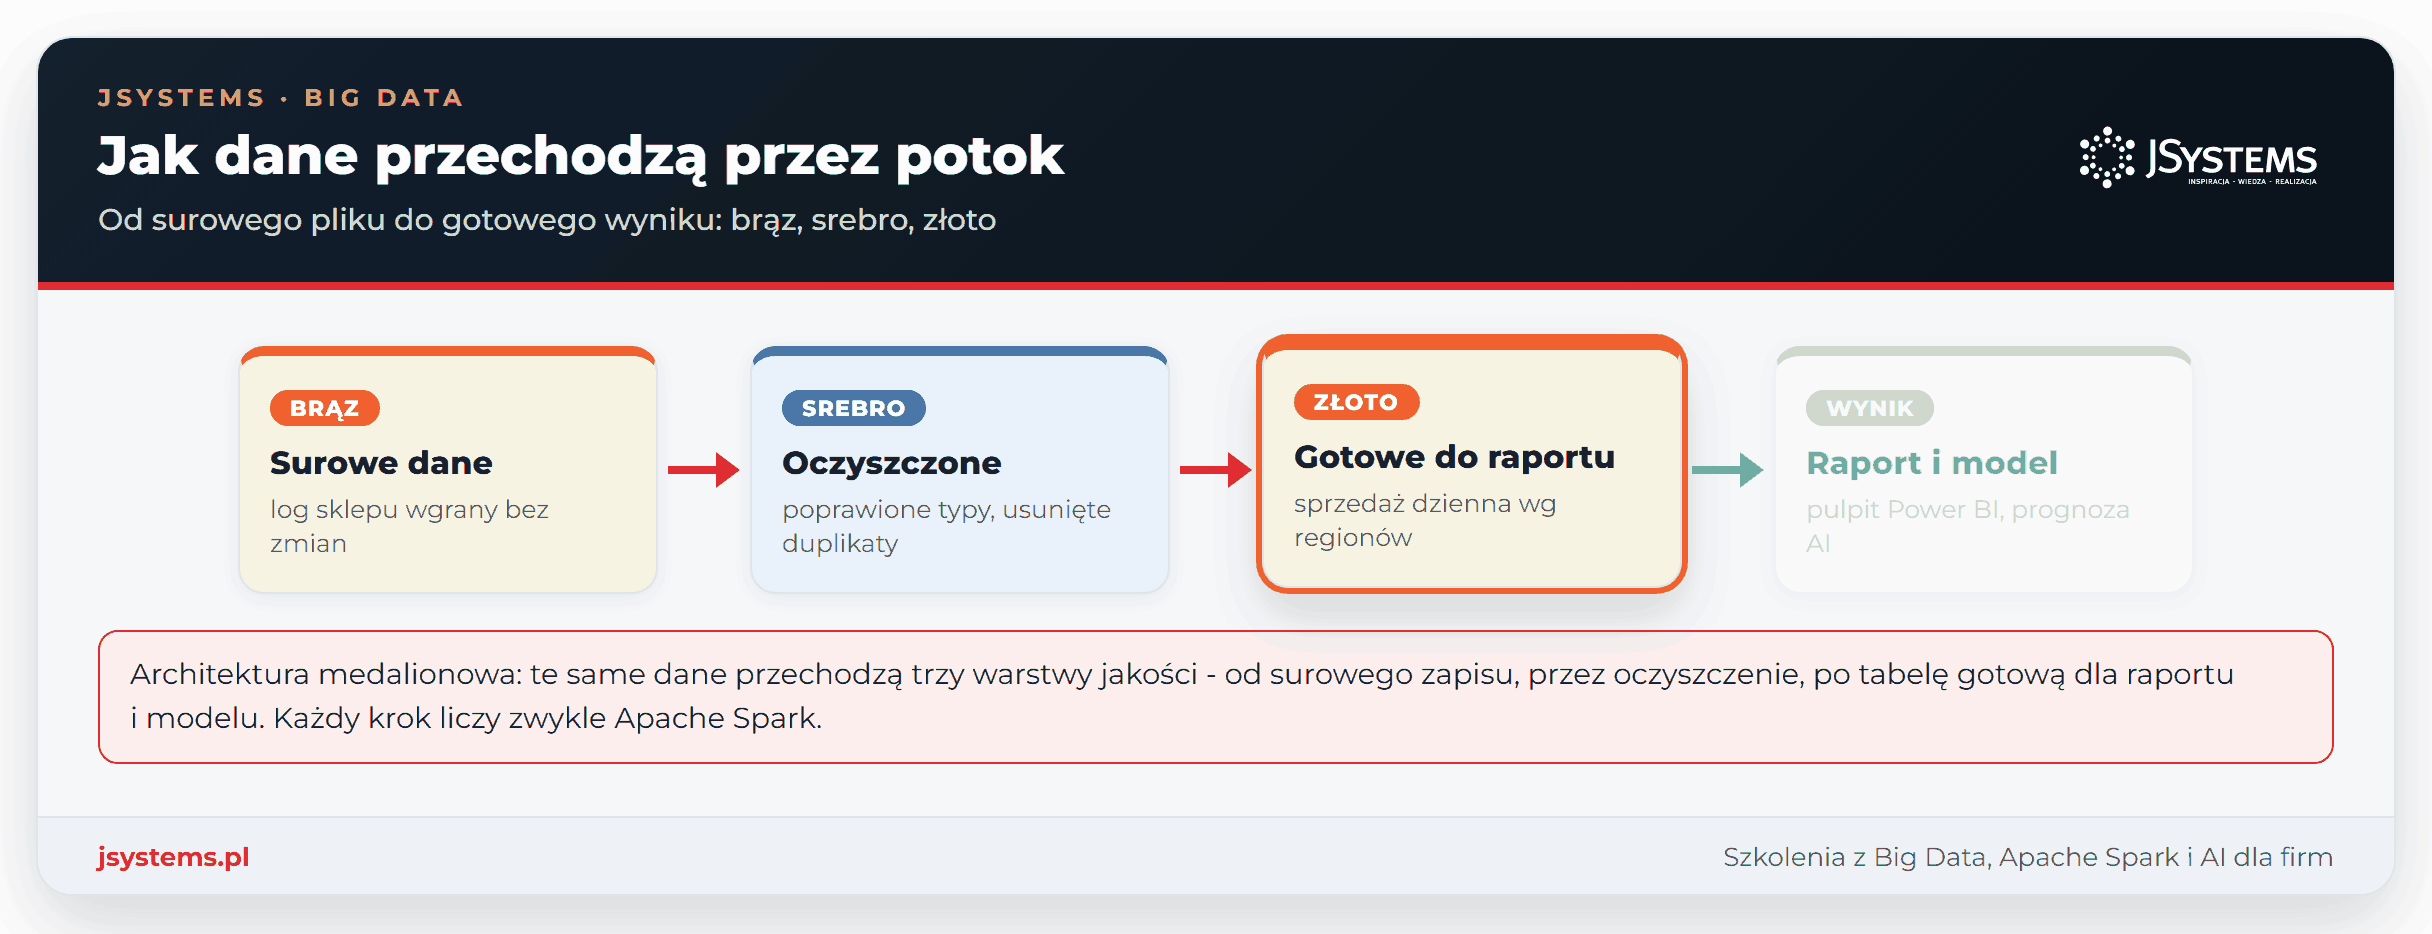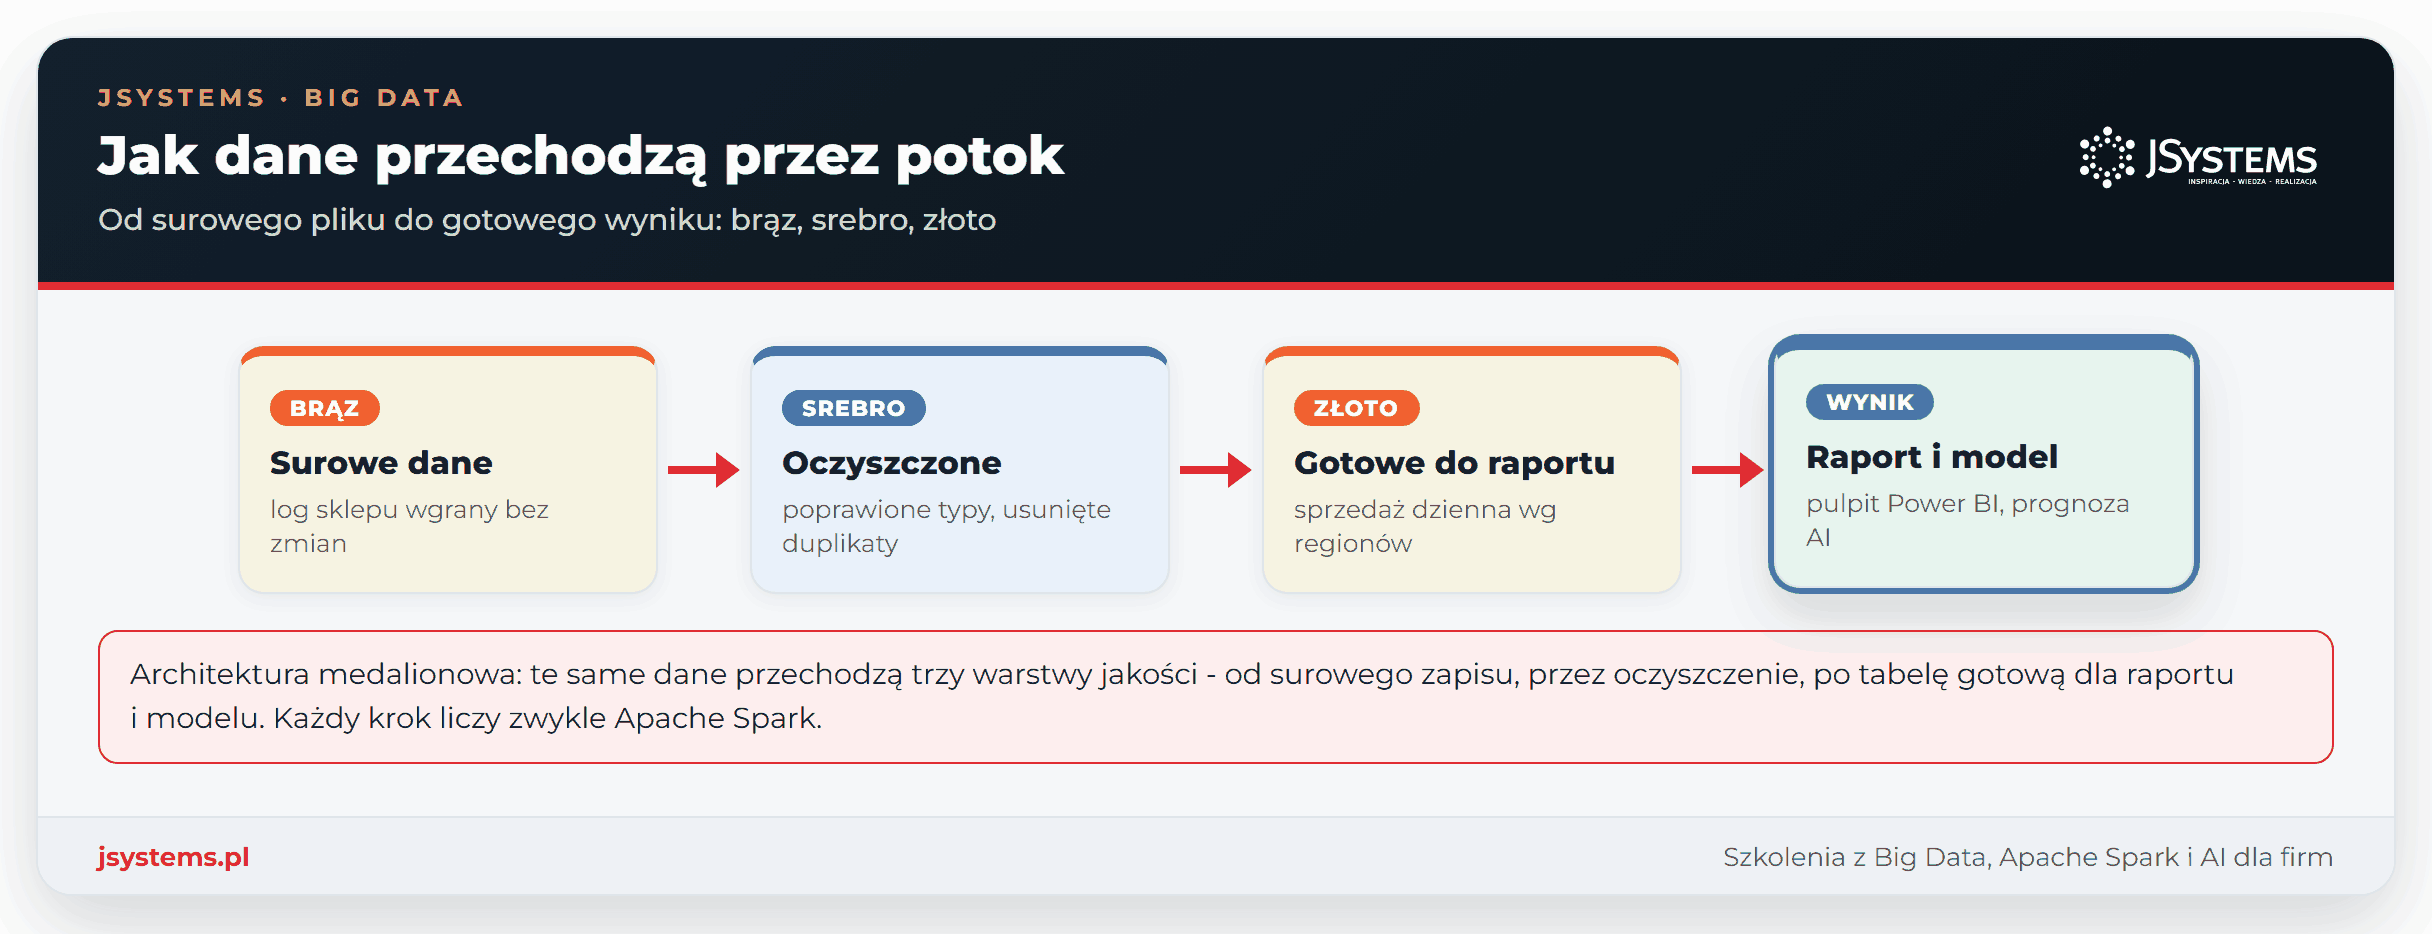
W praktyce dane rzadko przeskakują od surowego pliku prosto do raportu. Przechodzą przez kilka warstw jakości, zwanych architekturą medalionową: najpierw surowy zapis (brąz), potem dane oczyszczone i ujednolicone (srebro), a na końcu tabele gotowe do raportu (złoto). Każdy z tych kroków liczy zwykle Spark.
Można złożyć całe big data z osobnych, otwartych klocków: magazyn obiektowy, format Delta, Spark, osobny silnik SQL i osobne narzędzie do raportów. Wiele firm woli jednak gotową platformę, która to wszystko spina i udostępnia przez jeden interfejs. Cztery z nich są dziś szeroko stosowane.
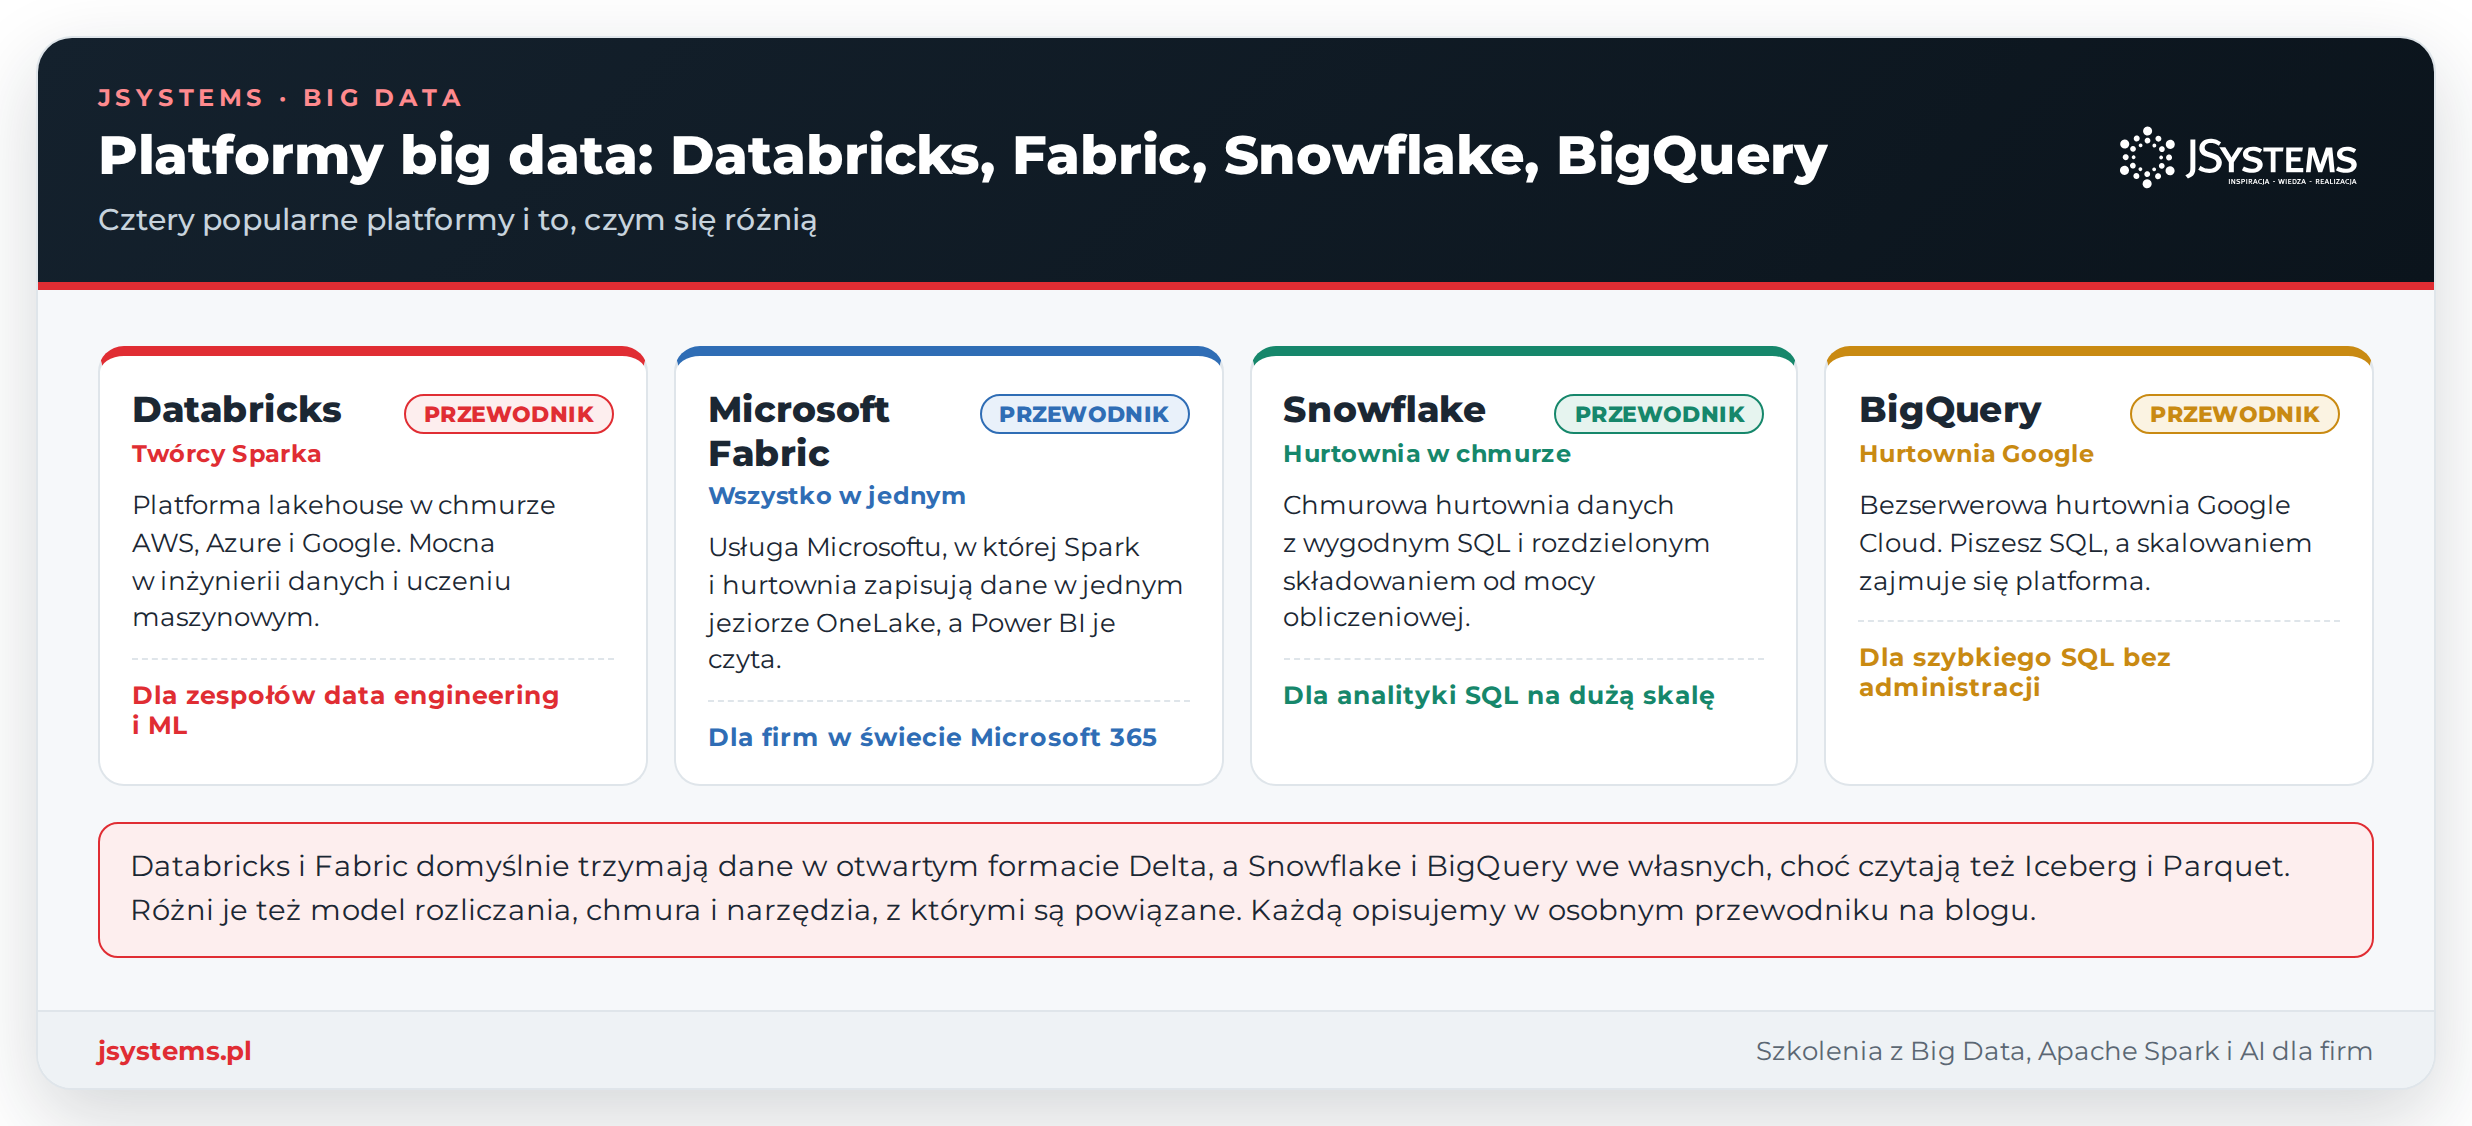
Osobny przewodnik po każdej z czterech platform
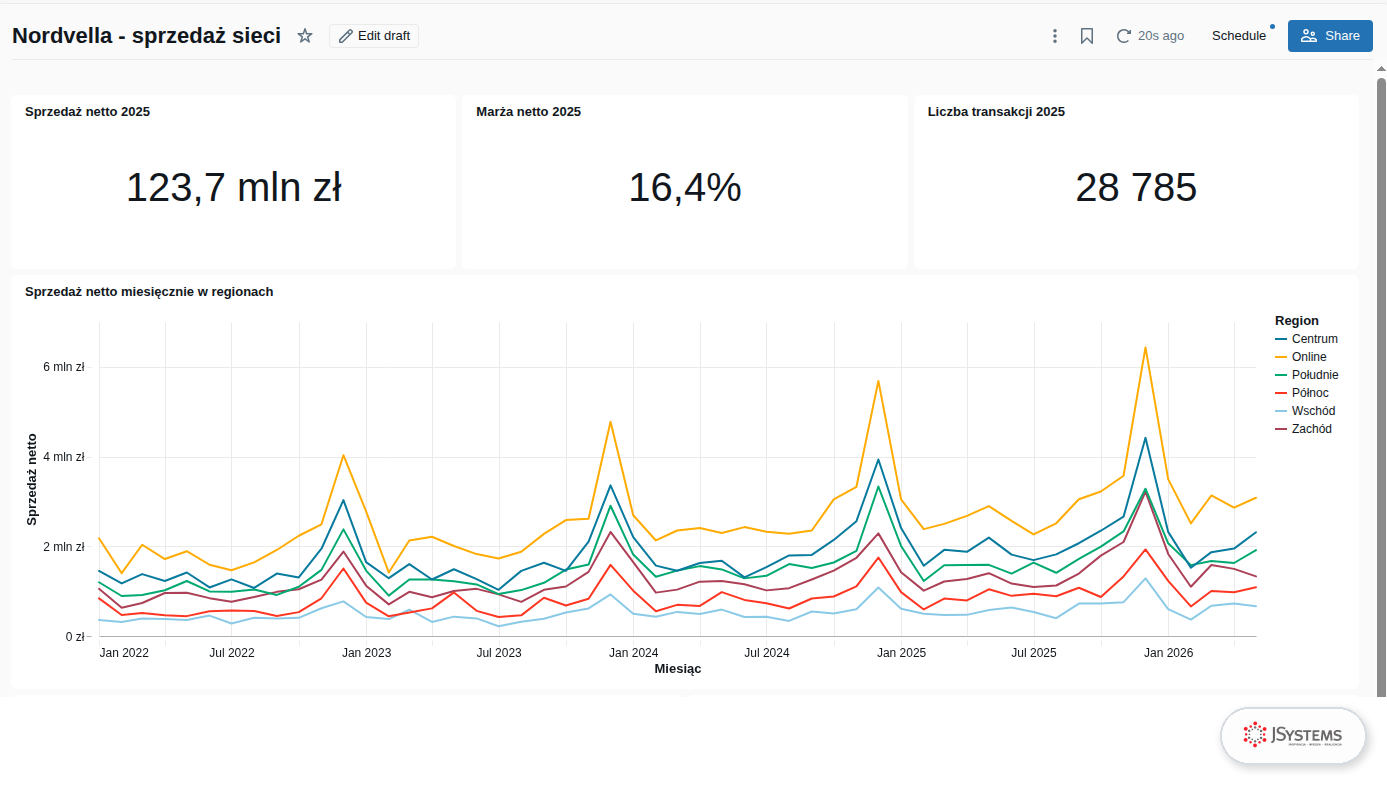
Databricks to platforma stworzona przez twórców Sparka. Działa w chmurach AWS, Azure i Google, a jej mocną stroną jest inżynieria danych i uczenie maszynowe. Dane, przetwarzanie, raporty i modele korzystają z jednej kopii danych w Twojej chmurze, a pulpity i wykresy buduje się wprost nad tabelami. Platformę krok po kroku, od plików po pulpit, pokazujemy w przewodniku Czym jest Databricks? Kompletny przewodnik po platformie lakehouse.
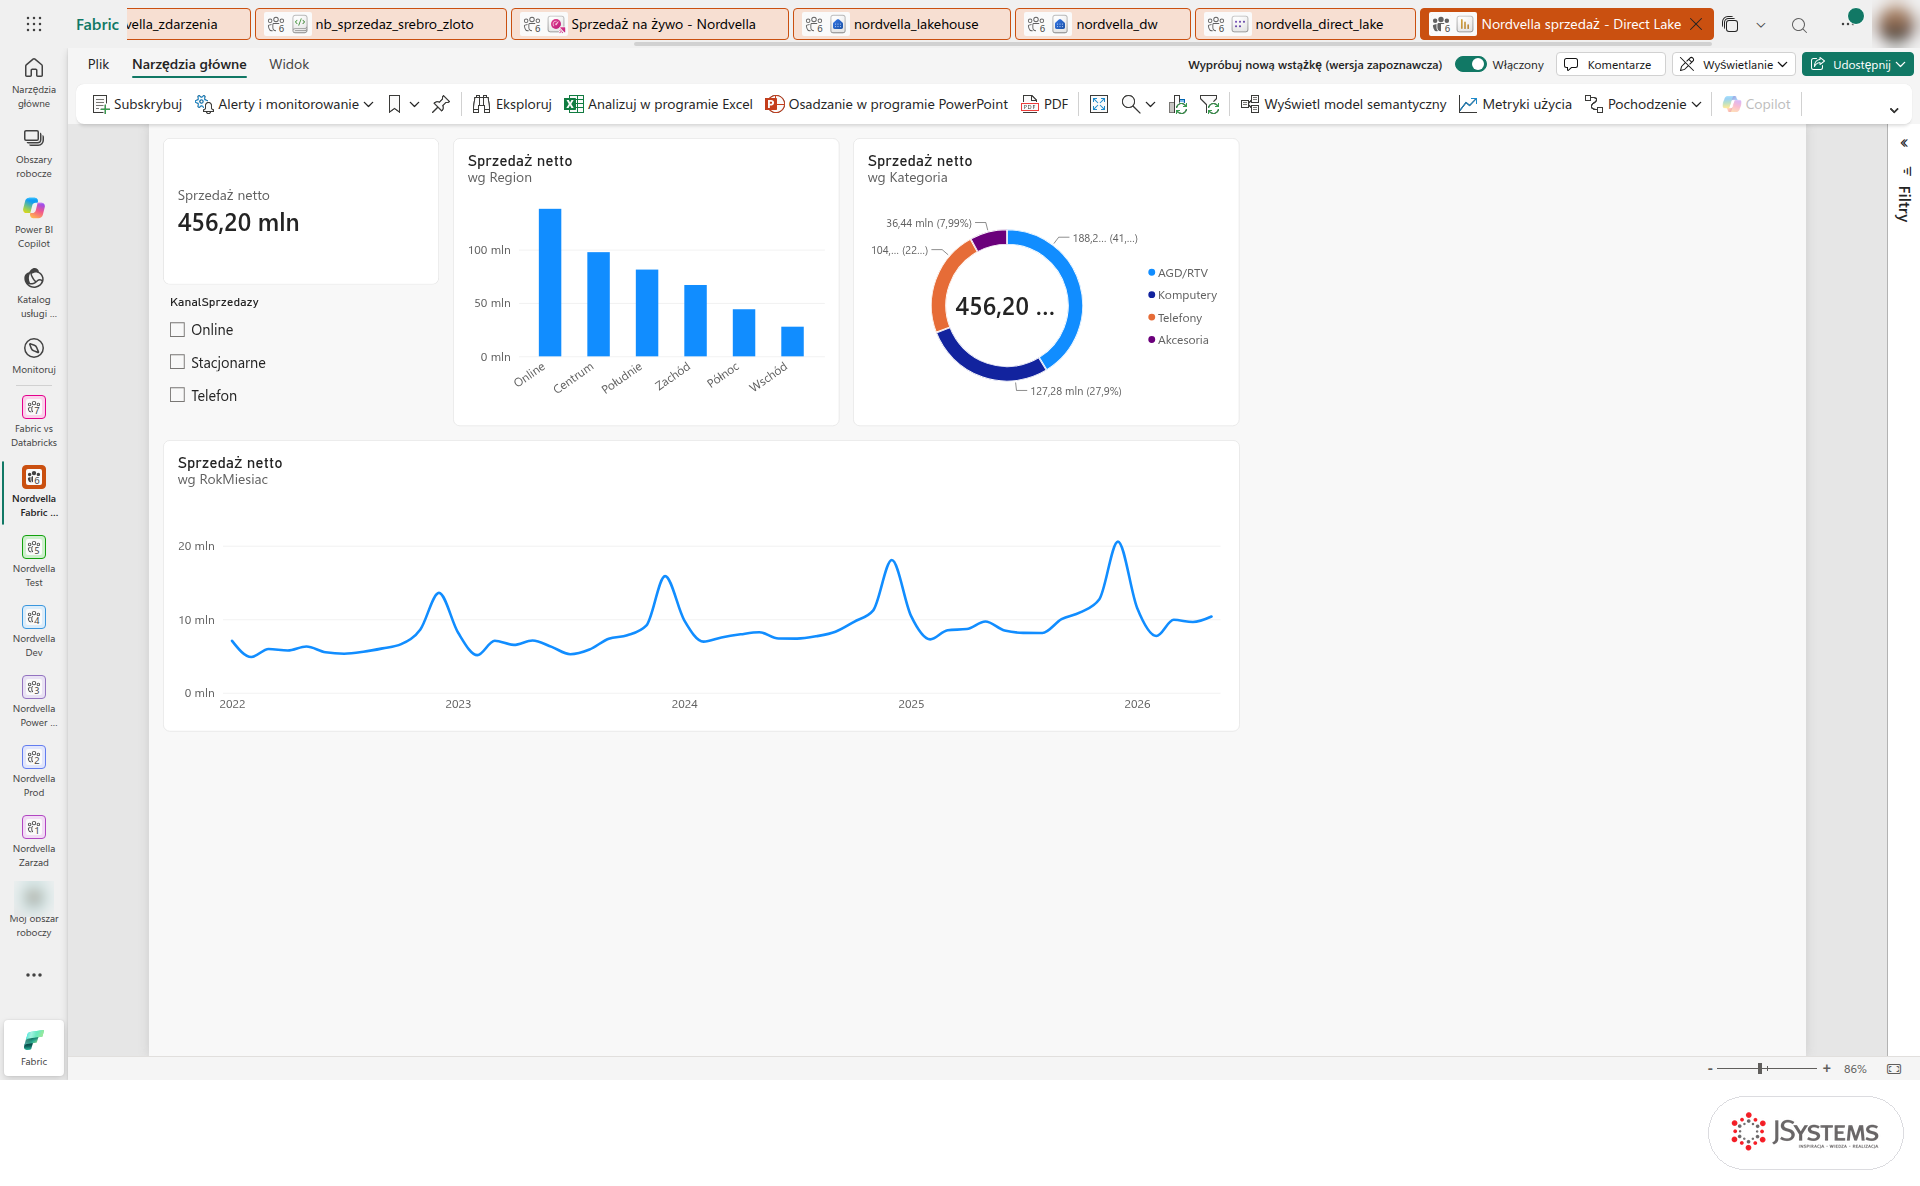
Microsoft Fabric idzie w stronę „wszystko w jednym”. To usługa Microsoftu, w której narzędzia do zbierania danych, Spark i hurtownia SQL zapisują wyniki w jednym jeziorze OneLake i rozliczają się z jednej wykupionej mocy obliczeniowej. Dla firm pracujących już w świecie Microsoft 365 to naturalny wybór, bo raport Power BI czyta tabele prosto z jeziora, bez kopiowania danych. Całą usługę, od lakehouse po dane w ruchu, opisujemy w artykule Co to jest Microsoft Fabric - kompletny przewodnik.
Snowflake i BigQuery to z kolei chmurowe hurtownie danych. Snowflake słynie z wygodnego SQL i rozdzielenia składowania od mocy obliczeniowej, a BigQuery z Google Cloud jest bezserwerowy: piszesz zapytanie, a skalowaniem zajmuje się platforma. Obie dobrze nadają się do analityki SQL na dużą skalę. Każdą z nich opisujemy osobno w artykułach Co to jest Snowflake? Prosty przewodnik po chmurowej hurtowni danych oraz Co to jest BigQuery? Kompletny przewodnik dla początkujących.
Którą wybrać? To zależy od tego, w jakiej chmurze już jesteś, jakie masz zespoły i jak chcesz płacić. Dwie hurtownie zestawiamy w artykule BigQuery vs Snowflake - czym się różnią i co wybrać?, a dwie platformy lakehouse porównujemy na tych samych danych w artykule Microsoft Fabric vs Databricks: porównanie na tych samych danych. Każdą platformę z osobna opisuje przewodnik z ramki powyżej.
Big data nie zastępuje zwykłych baz danych - stoi obok nich i często z nich korzysta. Bazy transakcyjne, takie jak PostgreSQL czy Oracle, dalej obsługują sklepy, systemy rezerwacji i aplikacje firmowe. To one są jednym z głównych źródeł z pierwszej warstwy naszej mapy, a nowoczesne bazy same potrafią już sporo z tego, co kiedyś wymagało osobnego klastra.
PostgreSQL to dobry przykład. Nowoczesne bazy radzą sobie dziś z dużymi tabelami dzięki partycjonowaniu, czyli podziałowi tabeli na mniejsze części, które łatwiej przeszukać, oraz replikom do odczytu, które rozkładają zapytania na kilka serwerów. Granica między „zwykłą bazą” a platformą danych coraz bardziej się zaciera.
Osobny wątek to sztuczna inteligencja. Modele uczą się na danych, a odbiorcą gotowych tabel z big data jest coraz częściej właśnie uczenie maszynowe. W drugą stronę AI wchodzi też do samych baz: wyszukiwanie wektorowe pozwala znajdować dane po znaczeniu, a nie po słowach kluczowych, a niektóre bazy chmurowe dokładają zapytania w języku naturalnym zamiast ręcznego SQL. Big data i AI coraz mocniej się więc przenikają.
Skoro znamy już wszystkie warstwy, zobaczmy, jak ta praca wygląda dzisiaj - bo przez ostatnią dekadę bardzo się zmieniła. Dawniej big data oznaczało własną serwerownię, klaster Hadoop i dni konfiguracji, zanim policzyło się cokolwiek. Dziś dane trzymasz w chmurze, a pierwszy wynik na dużym zbiorze dostajesz w kilka minut, w samej przeglądarce.
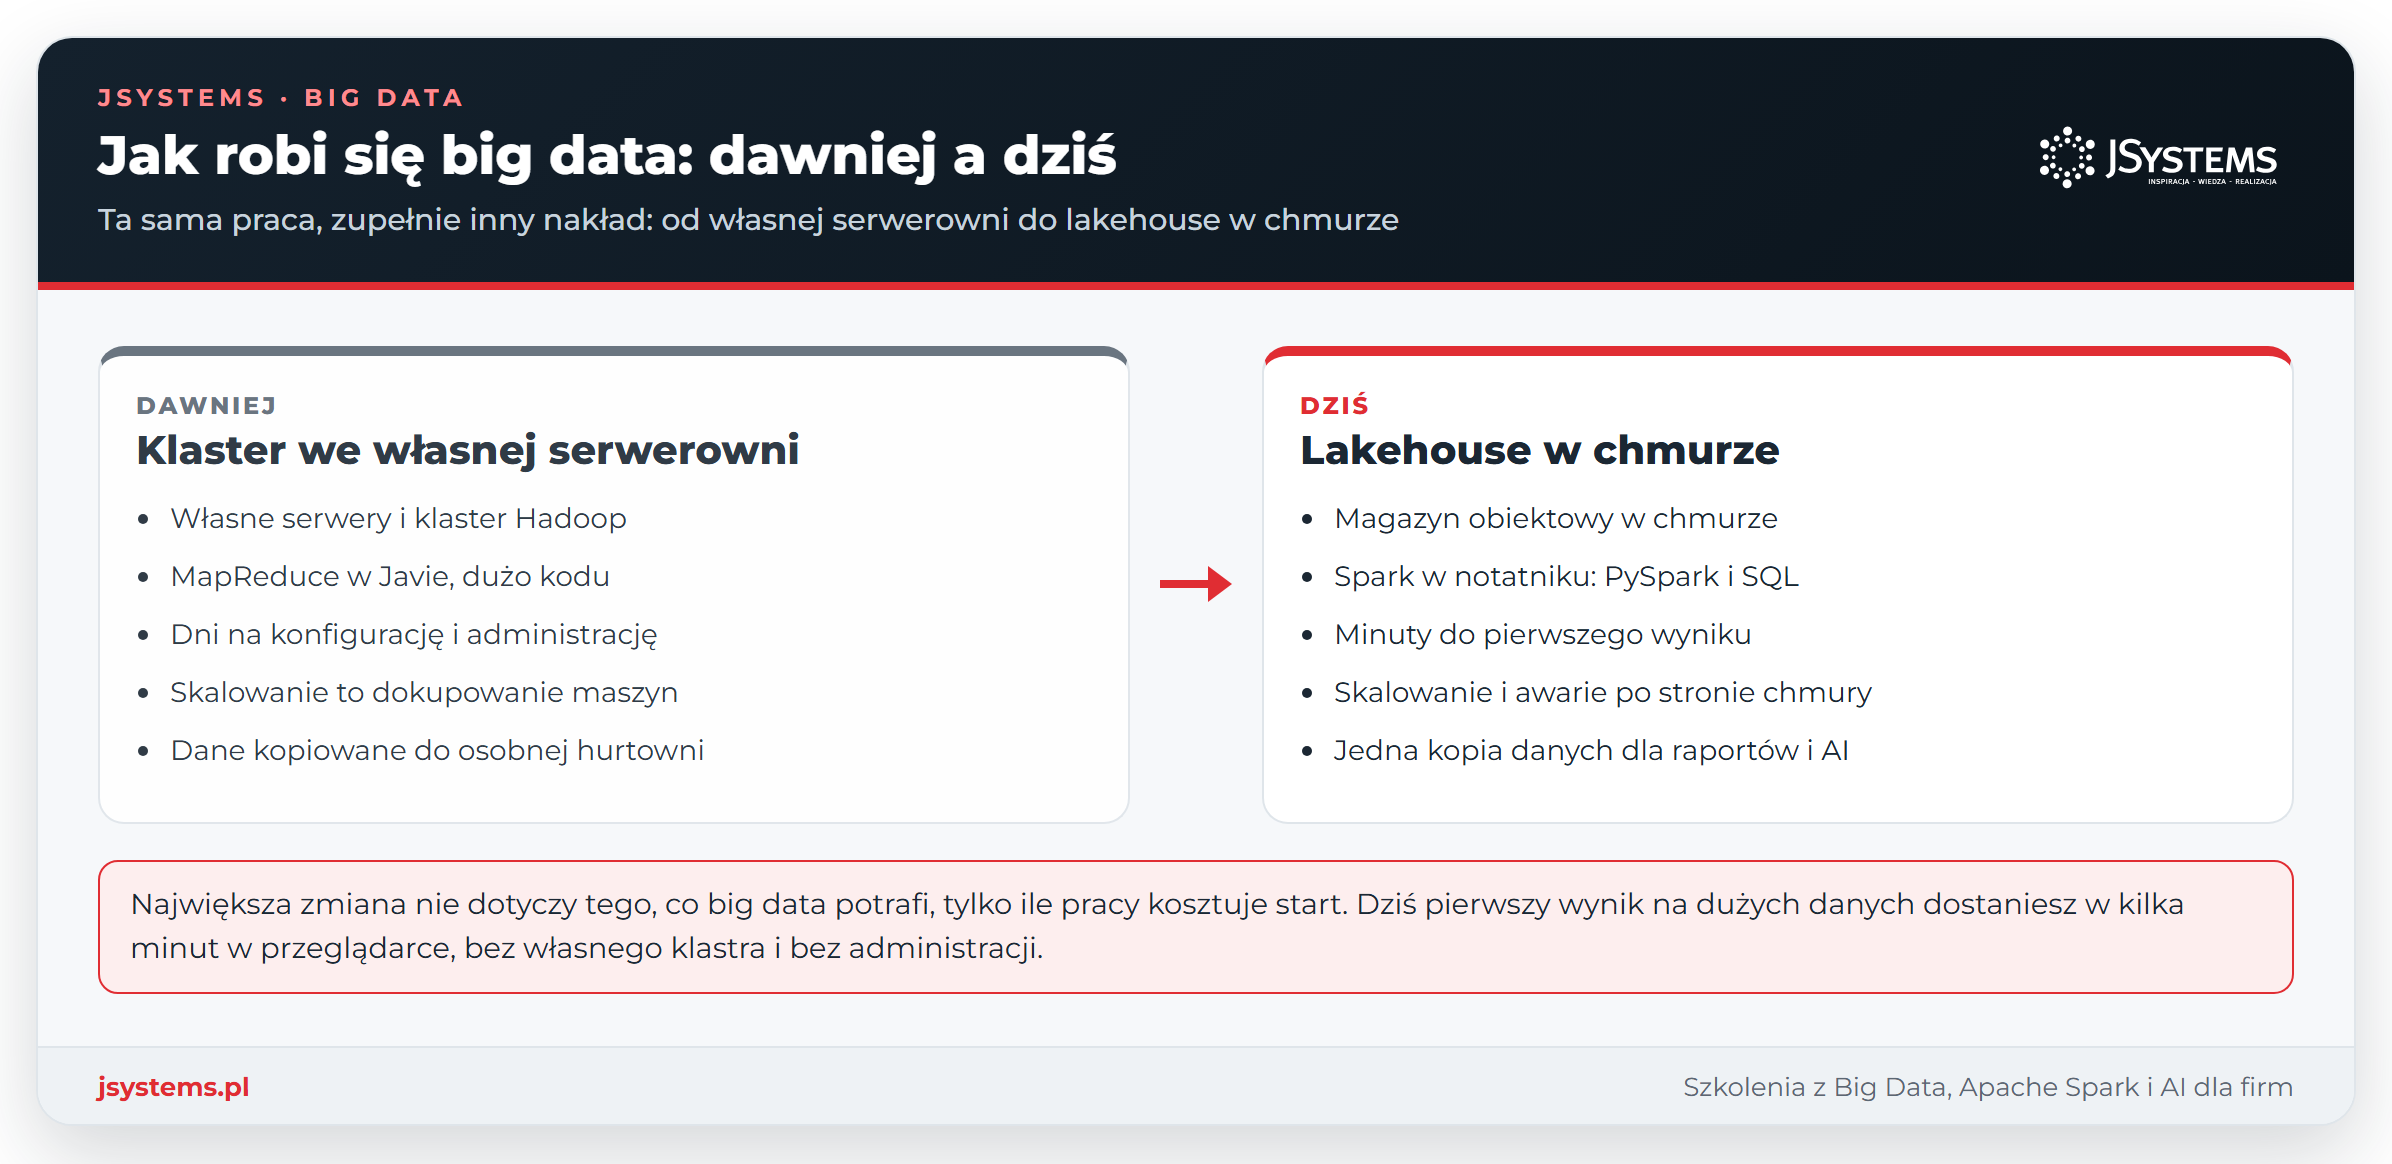
Typowa dzisiejsza droga wygląda tak: surowe pliki trafiają do jeziora danych na magazynie obiektowym w chmurze. Otwierasz notatnik w przeglądarce, w kilku linijkach PySparka albo w SQL czyścisz i liczysz dane, a wynik zapisujesz jako tabelę Delta. Z tej samej tabeli korzysta potem raport w Power BI i model uczenia maszynowego, bez kopiowania danych. Klastrem, skalowaniem i awariami dysków zajmuje się platforma, a za moc obliczeniową płacisz według modelu platformy: w Databricks głównie za zużycie, w Fabric za wykupioną pojemność. Gdy dane mają płynąć na bieżąco, dokładasz do tego strumienie z Apache Kafki, a całość spina zwykle jedna z platform danych, na przykład Databricks albo Microsoft Fabric.
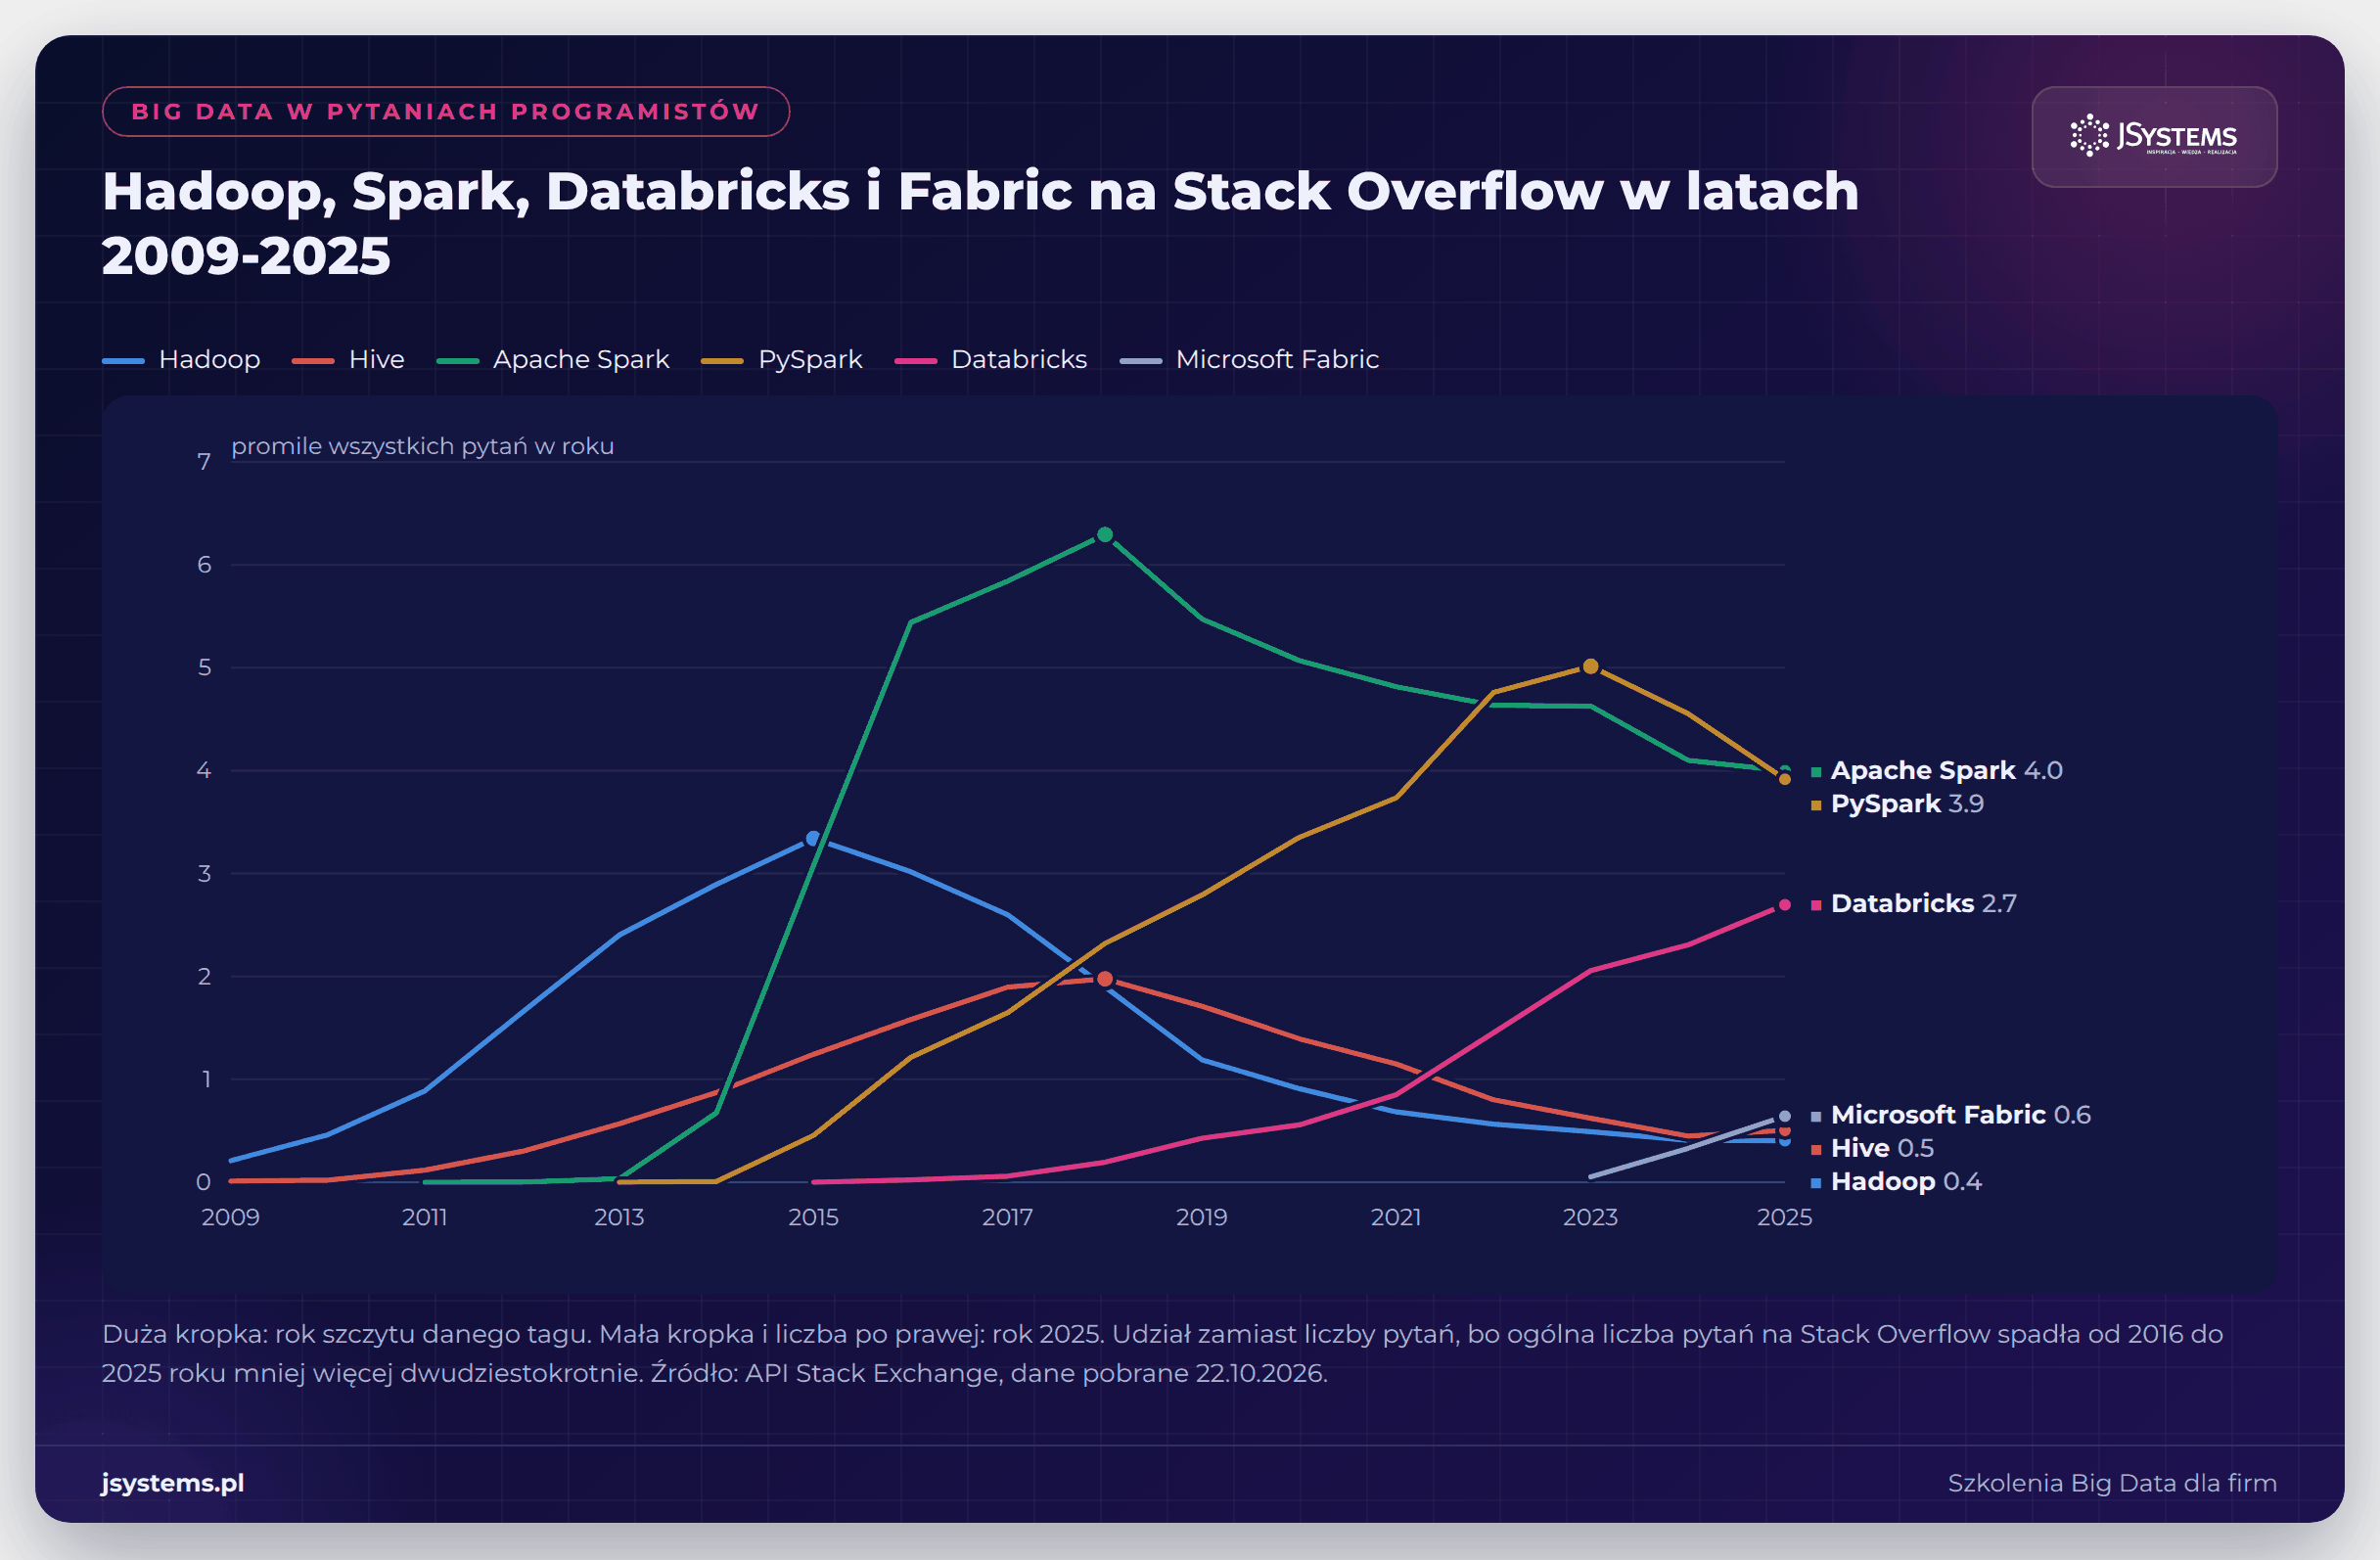
Przesunięcie ciężaru pracy z Hadoopa na Sparka i platformy lakehouse dobrze widać po tym, o co programiści pytają w serwisie Stack Overflow. Udział pytań o Hadoopa spadł i przejął go Spark, a udział pytań o Databricks rośnie do dziś. Big data nie jest więc martwym tematem sprzed dekady - zmienił się tylko zestaw narzędzi.
Wniosek dla kogoś, kto wchodzi w big data dziś, jest prosty: nie zaczynaj od archeologii. Historię Hadoopa i MapReduce dobrze znać, bo ich pomysły żyją w dzisiejszych narzędziach, ale uczyć się najlepiej na tym, czego używa się teraz - Sparku, formacie Delta i jednej z platform lakehouse. Jak dokładnie wyglądała droga od pierwszych klastrów do dzisiejszych platform, pokazujemy krok po kroku w historii big data.
Krajobraz jest szeroki, więc naturalne pytanie brzmi: od czego zacząć, żeby się nie pogubić. Kolejność jest od lat ta sama, mimo że narzędzia się zmieniają.
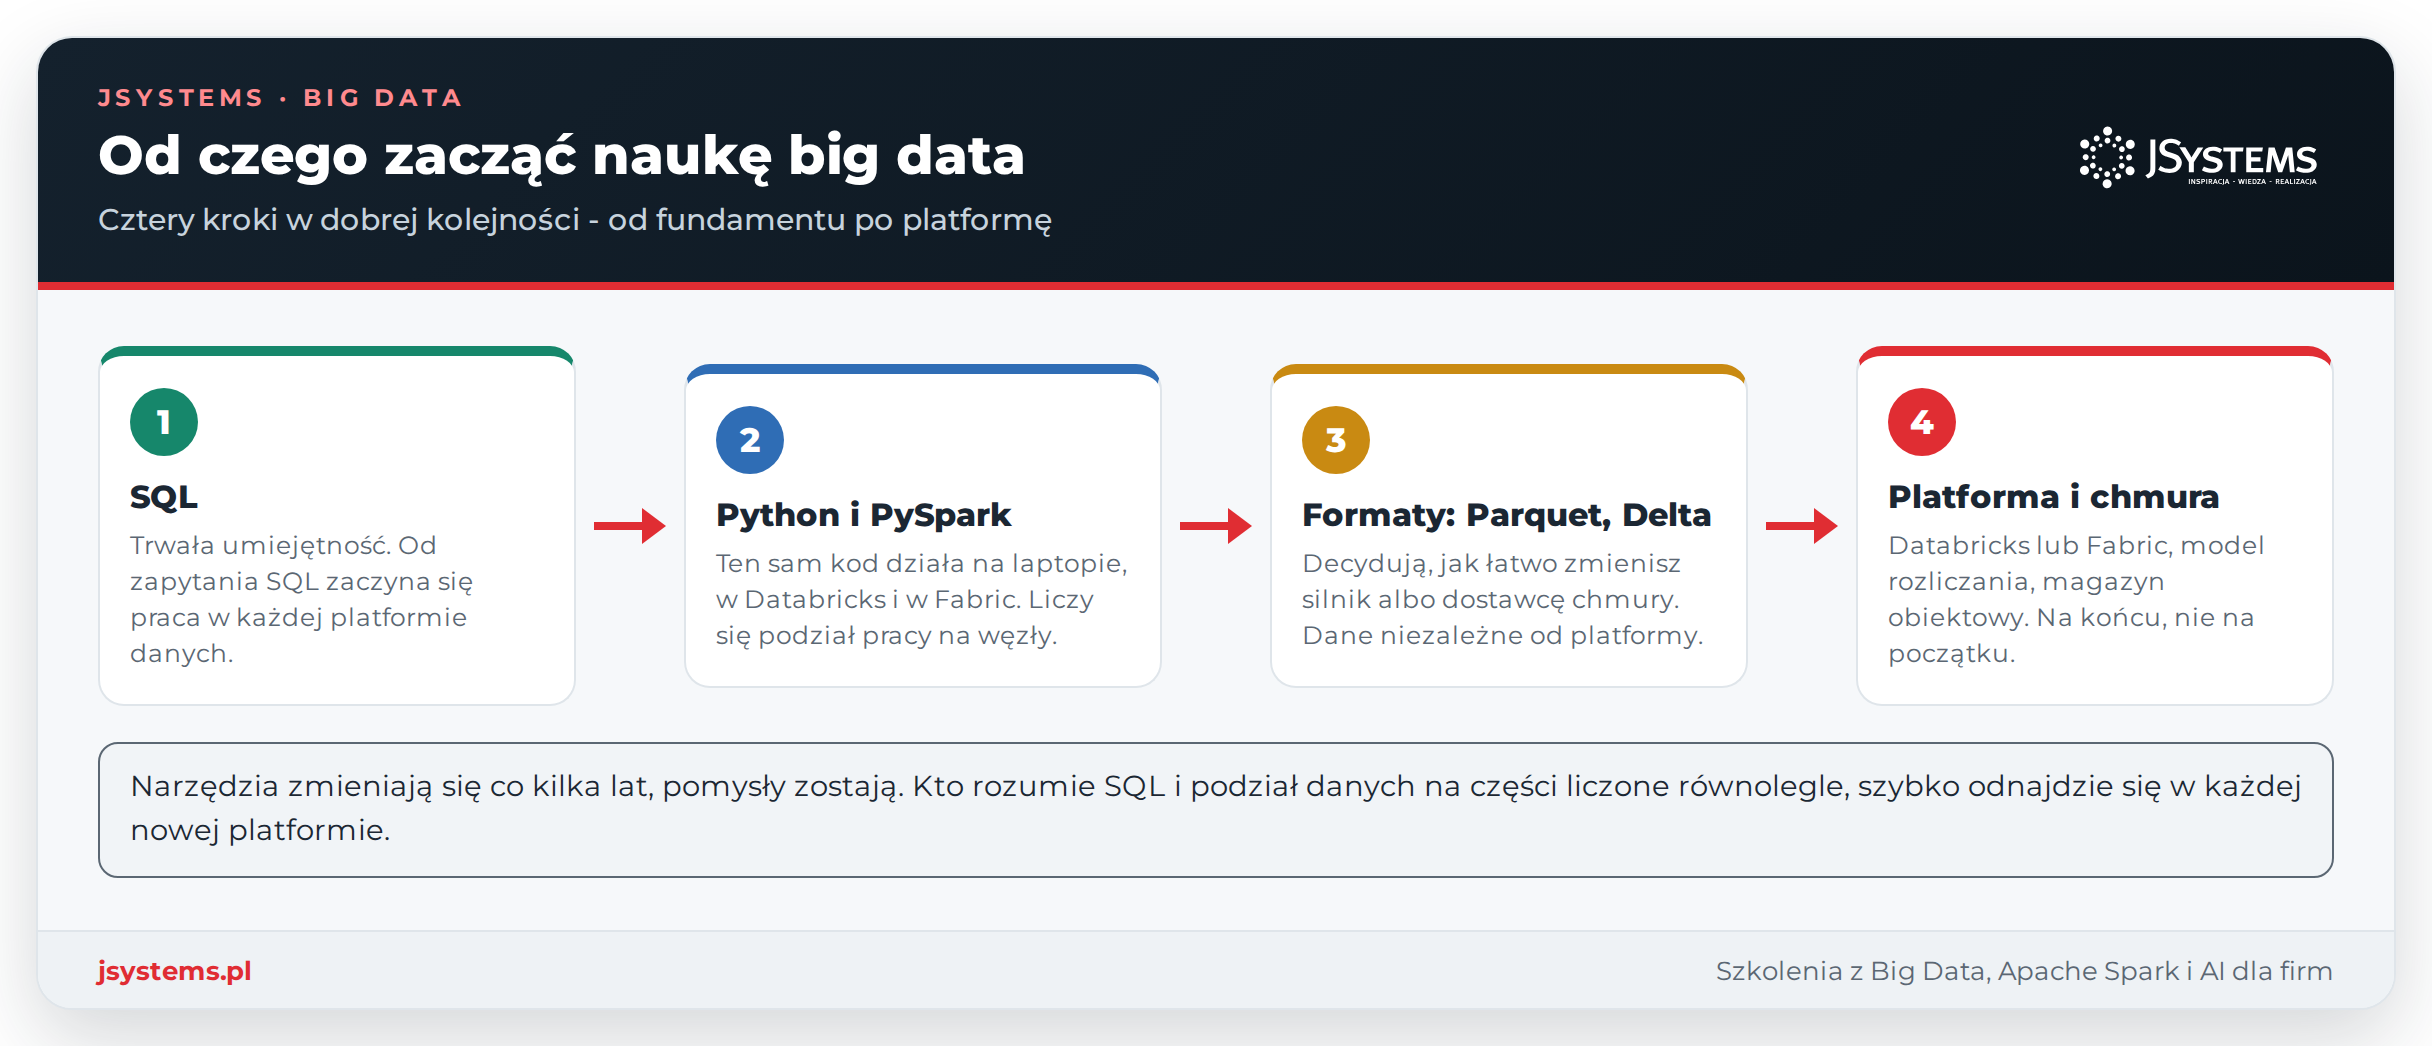
Fundamentem jest SQL, bo od zapytania SQL zaczyna się praca w każdej platformie danych - w Hive, w Spark SQL, w Snowflake, w Databricks i w hurtowni w Fabric. Potem przychodzi Python z biblioteką PySpark i zrozumienie, jak dane dzieli się na części liczone równolegle na węzłach klastra. Kolejny krok to formaty plików, bo od nich zależy niezależność danych, a dopiero na końcu konkretna platforma i chmura. Jeśli zaczynasz od zera, naukę najlepiej oprzeć na praktyce. Ekosystem big data, PySpark, Spark SQL, format Delta i architekturę medalionową na platformie Databricks ćwiczymy na naszym szkoleniu z przetwarzania danych Big Data z Apache Spark.
Komentarze (0)
Brak komentarzy...