Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
Apache Spark to dziś jeden z najważniejszych silników przetwarzania danych na świecie. Stoi za analityką, uczeniem maszynowym i potokami danych w tysiącach firm, a jego największą zaletą jest to, że ogromne zbiory potrafi przetwarzać znacznie szybciej niż starsze narzędzia - bo liczy dane w pamięci. W tym przewodniku wyjaśnimy prostym językiem, czym Spark jest, jak działa od środka i kiedy naprawdę warto po niego sięgnąć. Wszystko pokażemy na żywym Sparku w wersji 3.5.3, uruchomionym w kontenerze, na realnym zbiorze 53 031 transakcji sprzedaży.
Apache Spark to otwarty silnik do przetwarzania dużych zbiorów danych, który potrafi rozłożyć obliczenia na wiele maszyn i policzyć je równolegle. Mówiąc najprościej: piszesz zwykły kod, który wygląda, jakby działał na jednym komputerze, a Spark w tle dzieli pracę na kawałki i uruchamia je na całym klastrze (grupie połączonych maszyn). Nie musisz się martwić, jak podzielić dane ani jak zsynchronizować obliczenia - tym zajmuje się Spark.
Kluczowe słowo, które warto od razu oswoić, to in-memory, czyli przetwarzanie w pamięci. Starsze narzędzia z rodziny Big Data po każdym etapie obliczeń zapisywały wyniki pośrednie na dysk, a odczyt z dysku jest wolny. Spark, gdzie tylko może, trzyma dane w pamięci operacyjnej (RAM) i dzięki temu przy powtarzanych operacjach potrafi być wielokrotnie szybszy. To była jego przełomowa cecha i do dziś jest głównym powodem, dla którego się go wybiera.
Druga ważna cecha to uniwersalność. Spark to nie jest osobne narzędzie do każdego zadania - to jeden silnik, którym zrobisz zapytania SQL, przetworzysz dane napływające na żywo, wytrenujesz model uczenia maszynowego czy policzysz graf powiązań. Wszystko na tych samych danych i w tym samym API. Do Sparka najczęściej pisze się w Pythonie (interfejs nazywa się PySpark), ale dostępne są też Scala, Java i R. W tym artykule wszystkie przykłady są w PySpark.
Żeby zrozumieć Spark, trzeba cofnąć się do jego poprzednika. Przez lata standardem przetwarzania Big Data był MapReduce - model obliczeń z ekosystemu Hadoop, w którym każde zadanie dzielono na fazę mapowania i fazę redukcji. MapReduce miał jedną dużą wadę: po każdym etapie zapisywał wyniki pośrednie na dysk. Przy prostym zliczaniu to jeszcze uchodziło, ale przy obliczeniach iteracyjnych (na przykład w uczeniu maszynowym, gdzie ten sam zbiór przelicza się setki razy) ciągłe pisanie i czytanie z dysku zabijało wydajność.
Spark narodził się w laboratorium AMPLab na Uniwersytecie Kalifornijskim w Berkeley około 2009 roku właśnie jako odpowiedź na ten problem. Pomysł był prosty i genialny: skoro dysk jest wąskim gardłem, trzymajmy dane pośrednie w pamięci. Efekt przerósł oczekiwania - te same zadania działały wielokrotnie szybciej. Projekt szybko trafił pod skrzydła fundacji Apache i stał się jednym z najaktywniej rozwijanych narzędzi Big Data. Jeśli chcesz zobaczyć szerszy obraz tego, jak Spark wpisuje się w dzisiejszy krajobraz danych, opisaliśmy go w artykule o współczesnych rozwiązaniach Big Data.
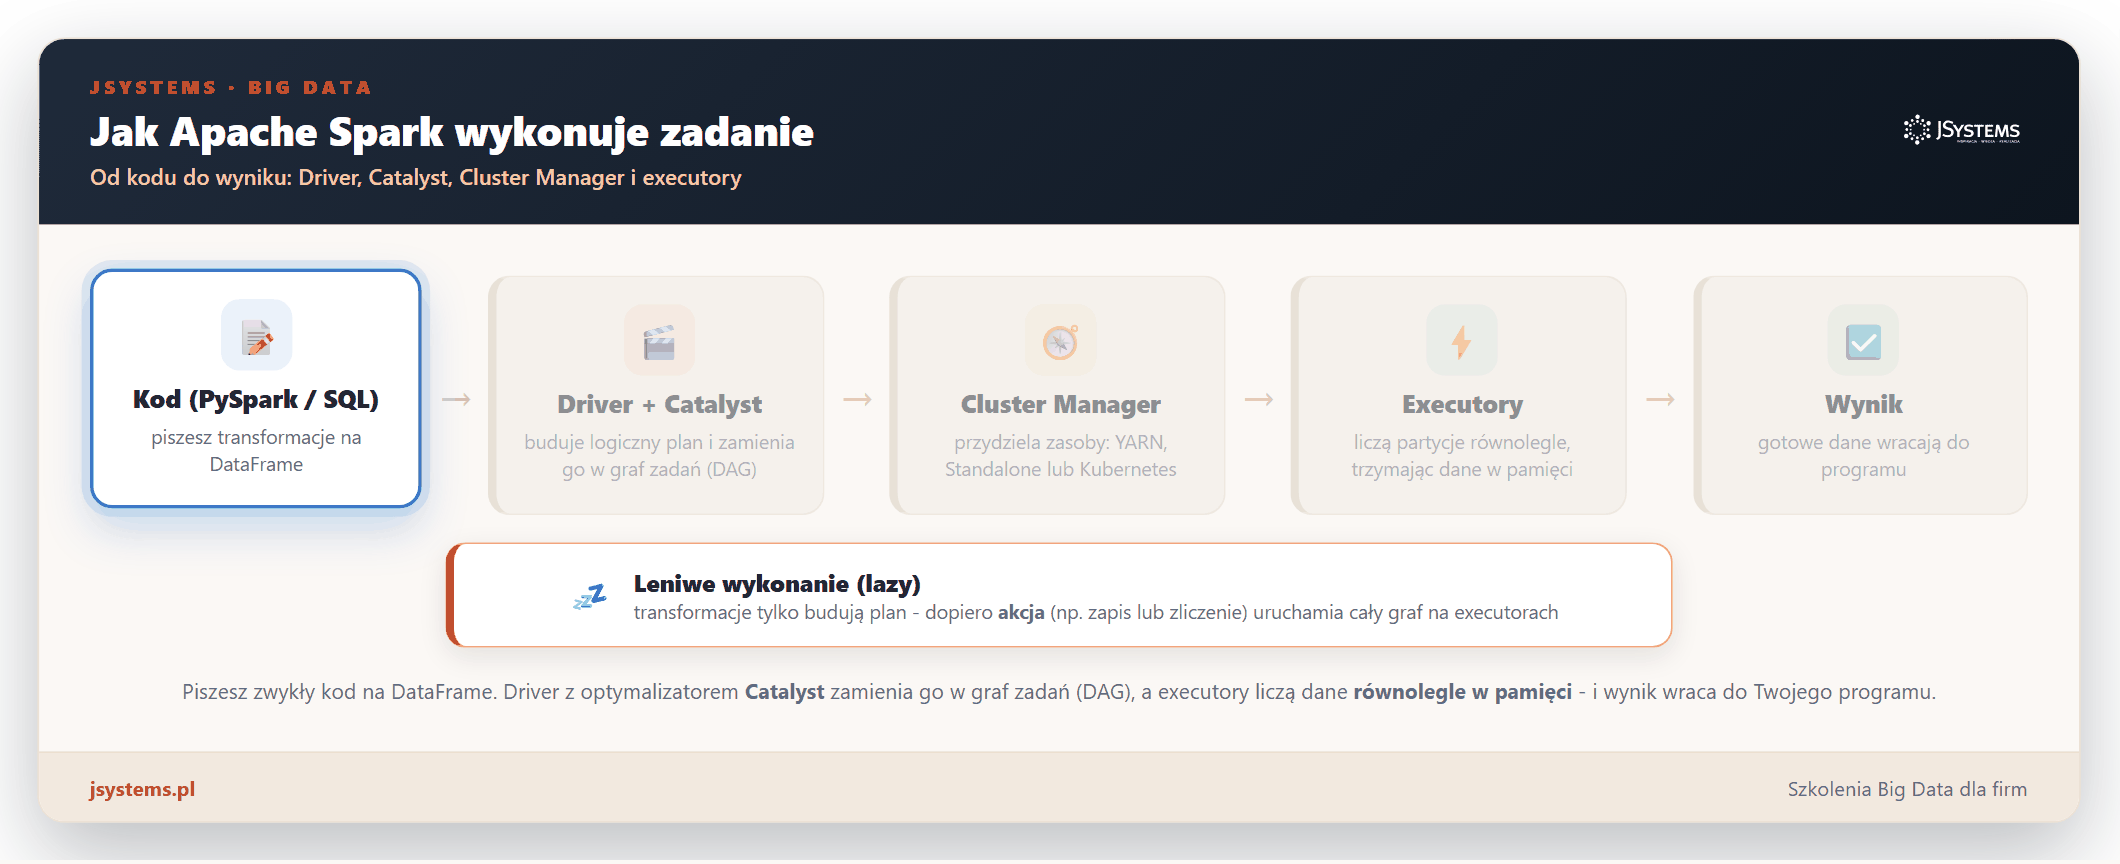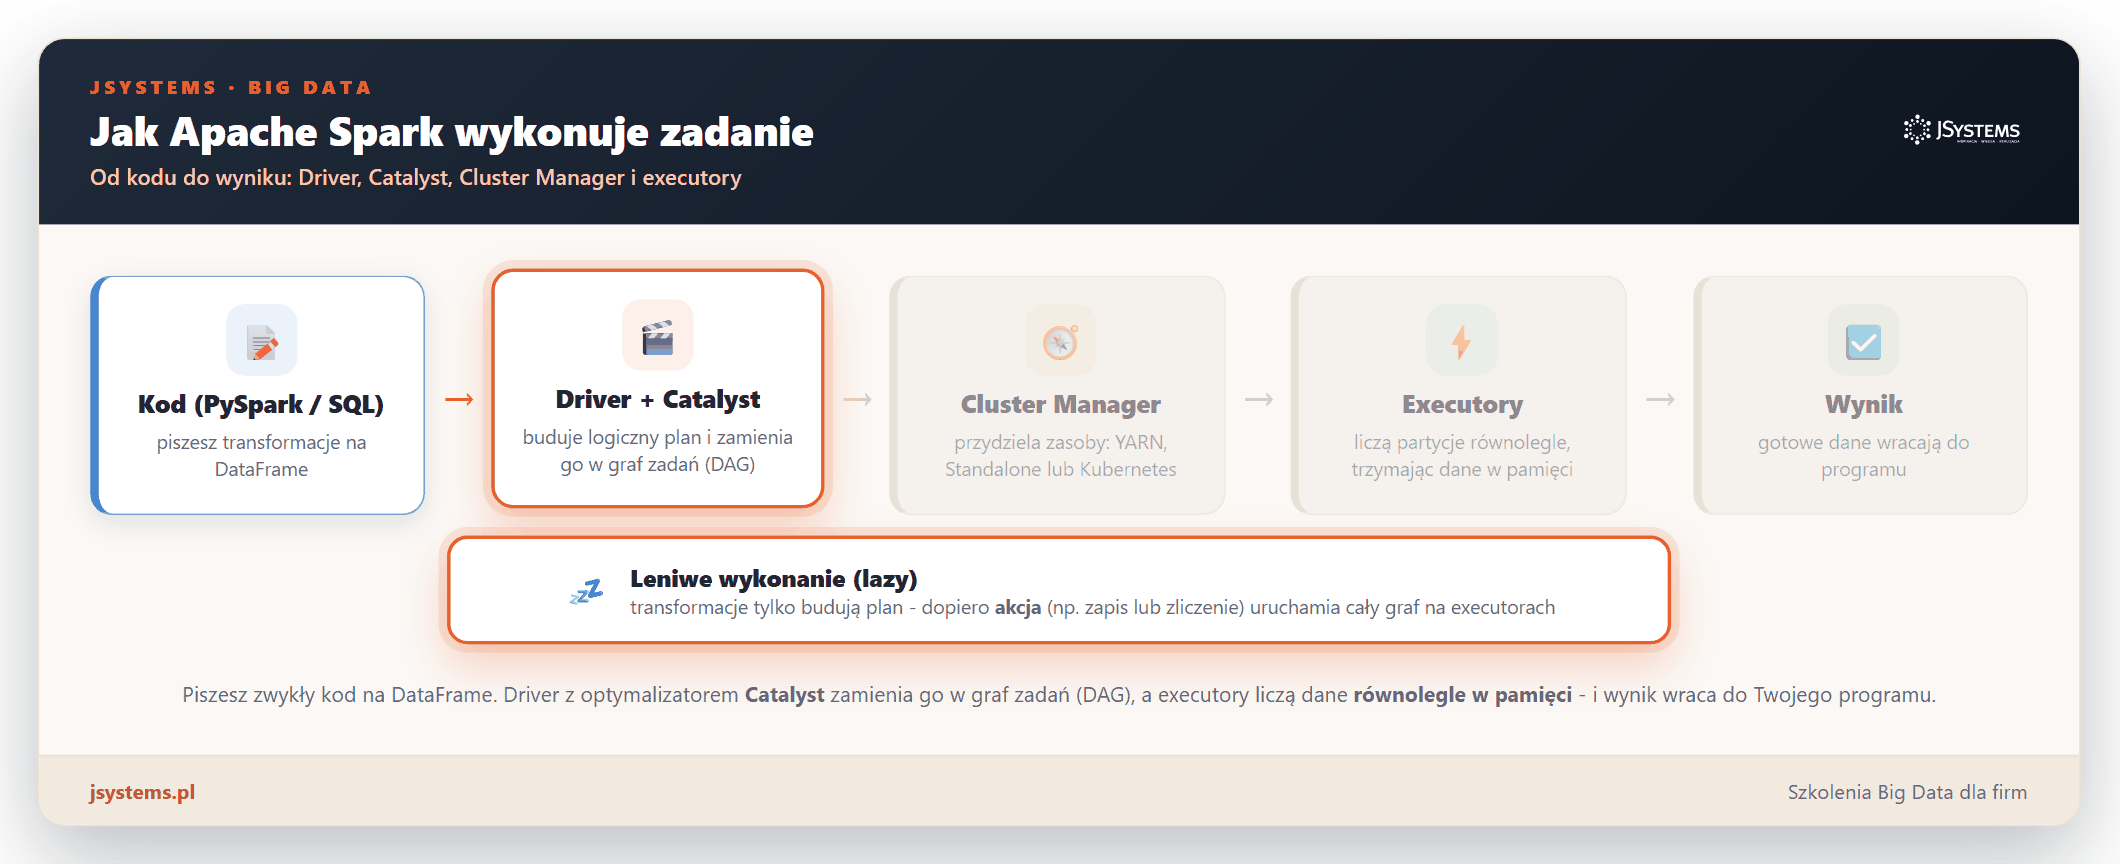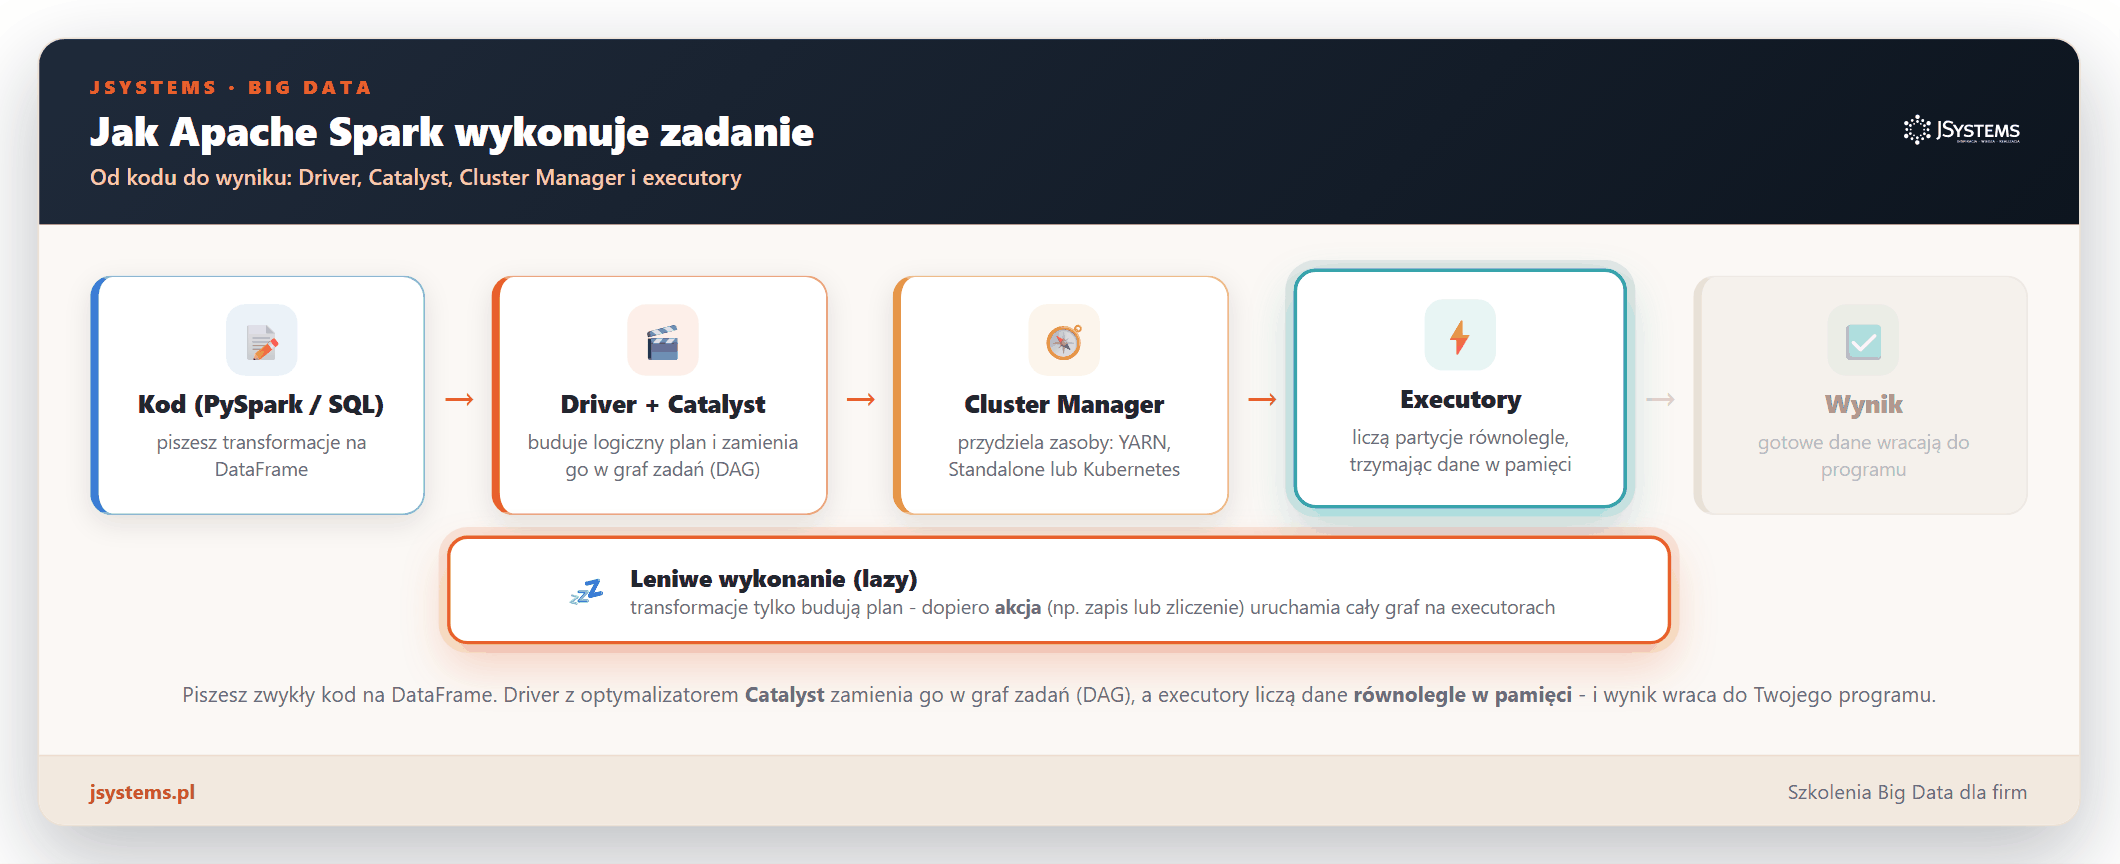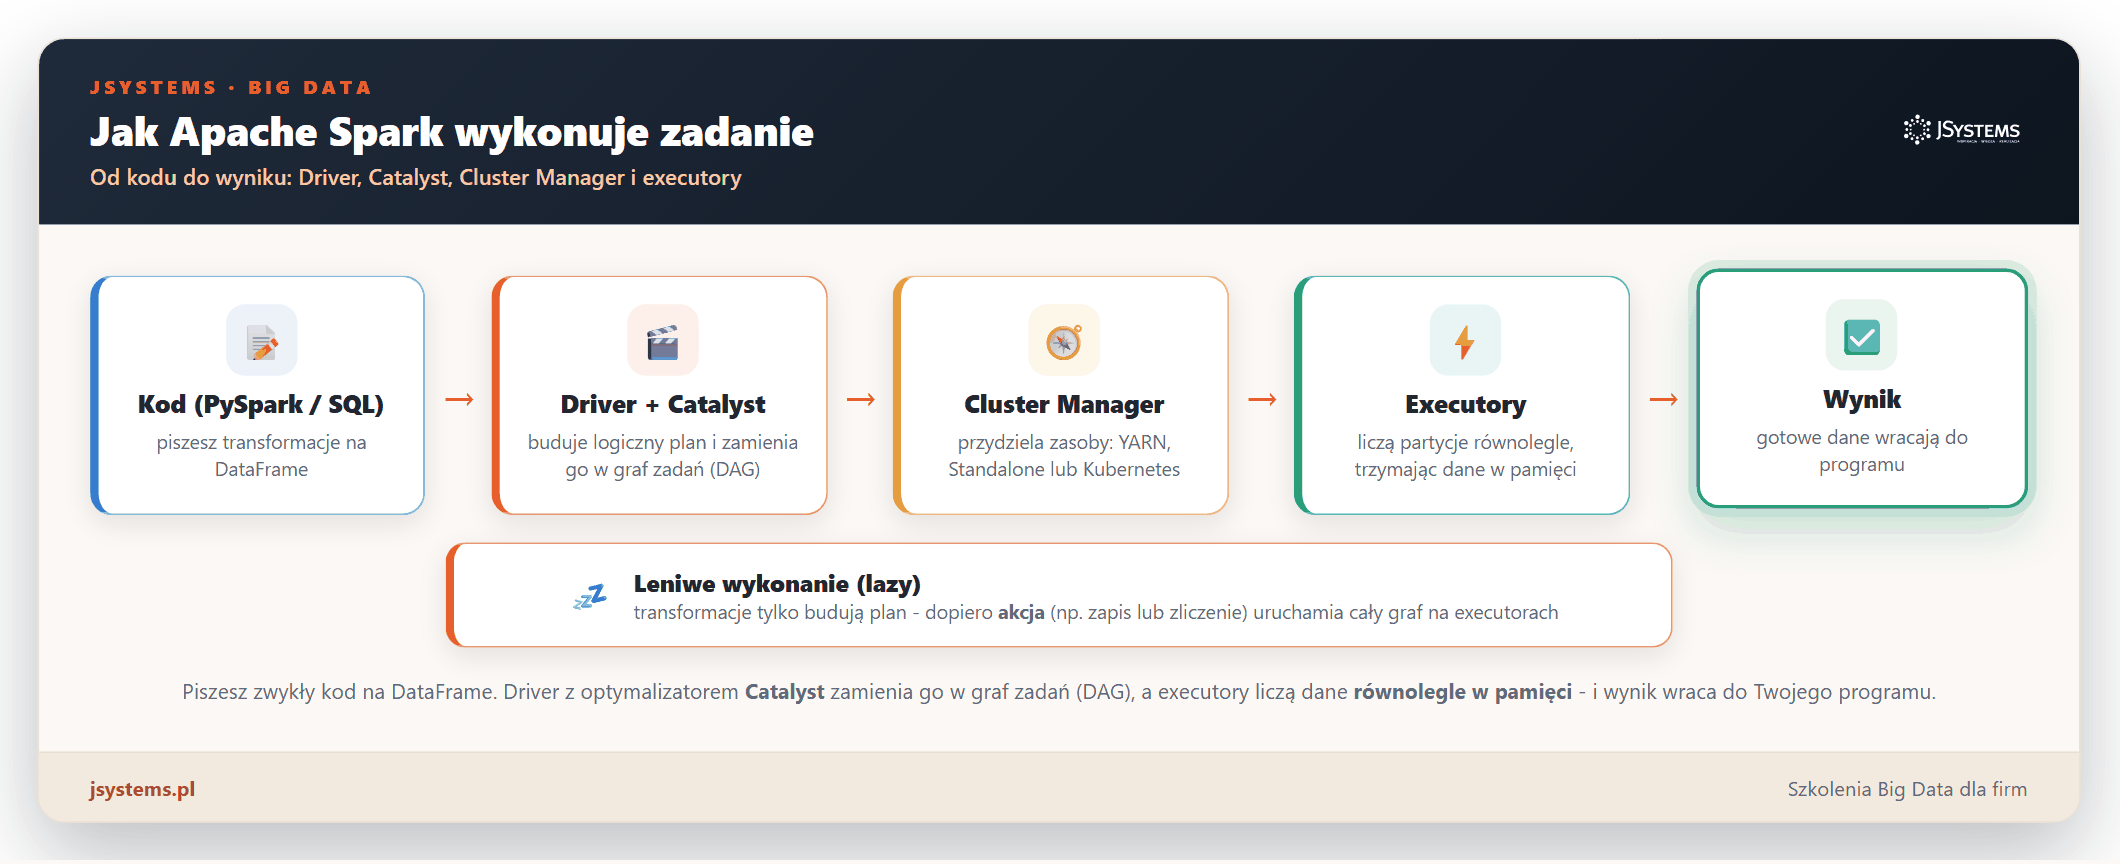
Spark to aplikacja rozproszona, więc żeby ją zrozumieć, trzeba zobaczyć, kto właściwie wykonuje pracę. Są trzy główne role: program sterujący, zarządca zasobów i procesy robocze. Poniższa infografika pokazuje, jak współpracują.
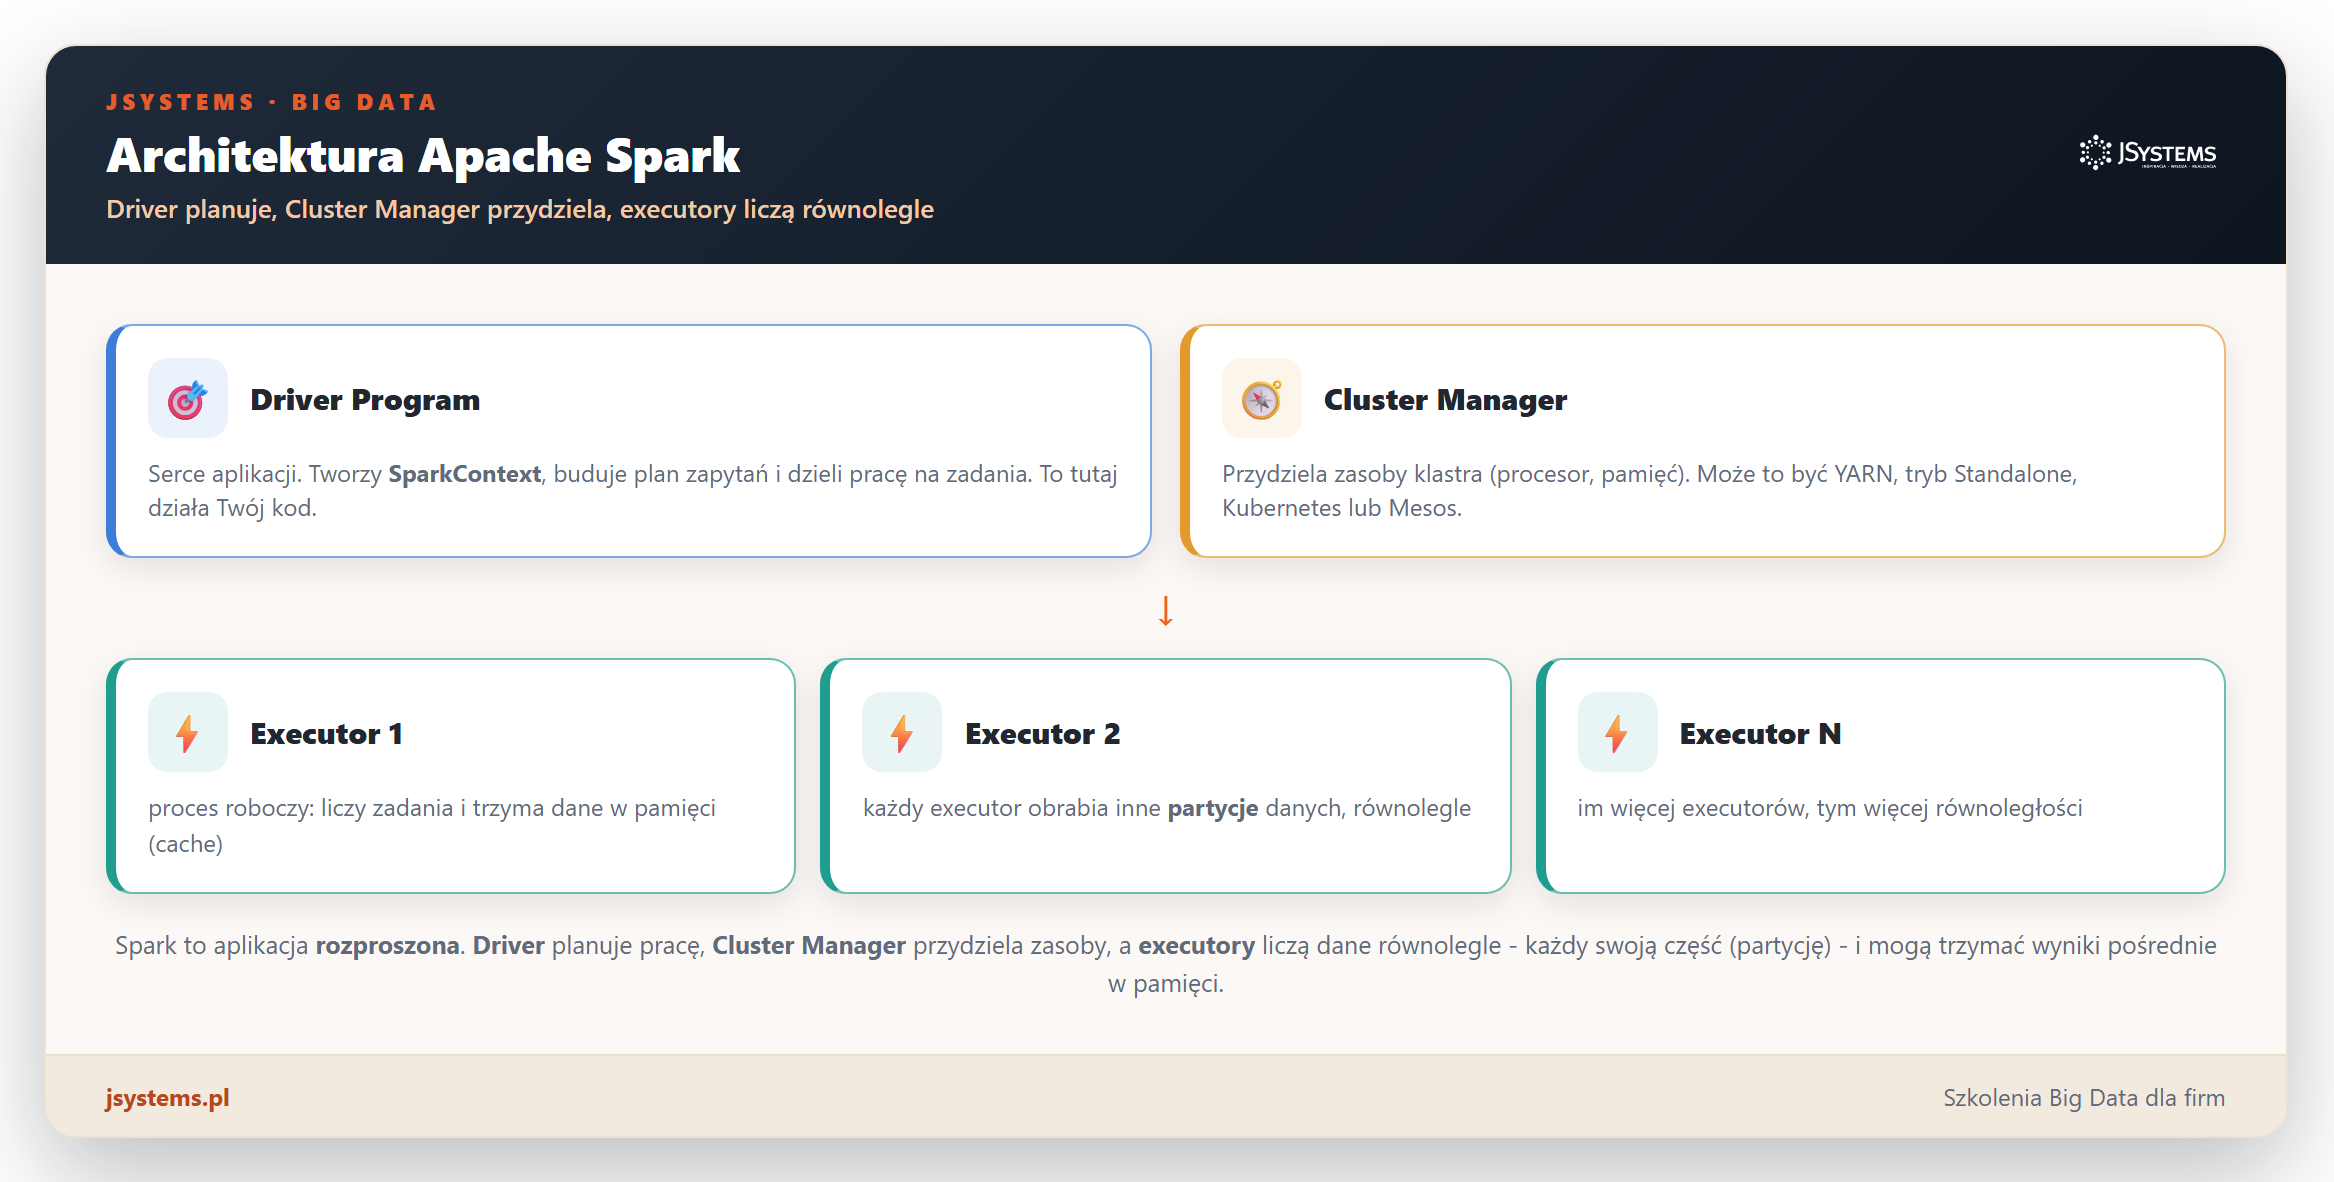
Prześledźmy te elementy po kolei:
Cała sztuczka polega na tym, że Ty piszesz kod tak, jakby dane były jedną kolekcją, a Spark sam rozbija ją na partycje i rozsyła do executorów. Kiedy uruchomisz zadanie lokalnie na laptopie (tryb local[*], którego użyjemy w tym artykule), rolę klastra przejmują rdzenie Twojego procesora - każdy działa jak mały executor.
Pracując ze Sparkiem, spotkasz trzy nazwy, które na początku bywają mylące: RDD, DataFrame i Dataset. To trzy warstwy abstrakcji nad tymi samymi danymi - od najniższego, najbardziej surowego poziomu, po najwygodniejszy.
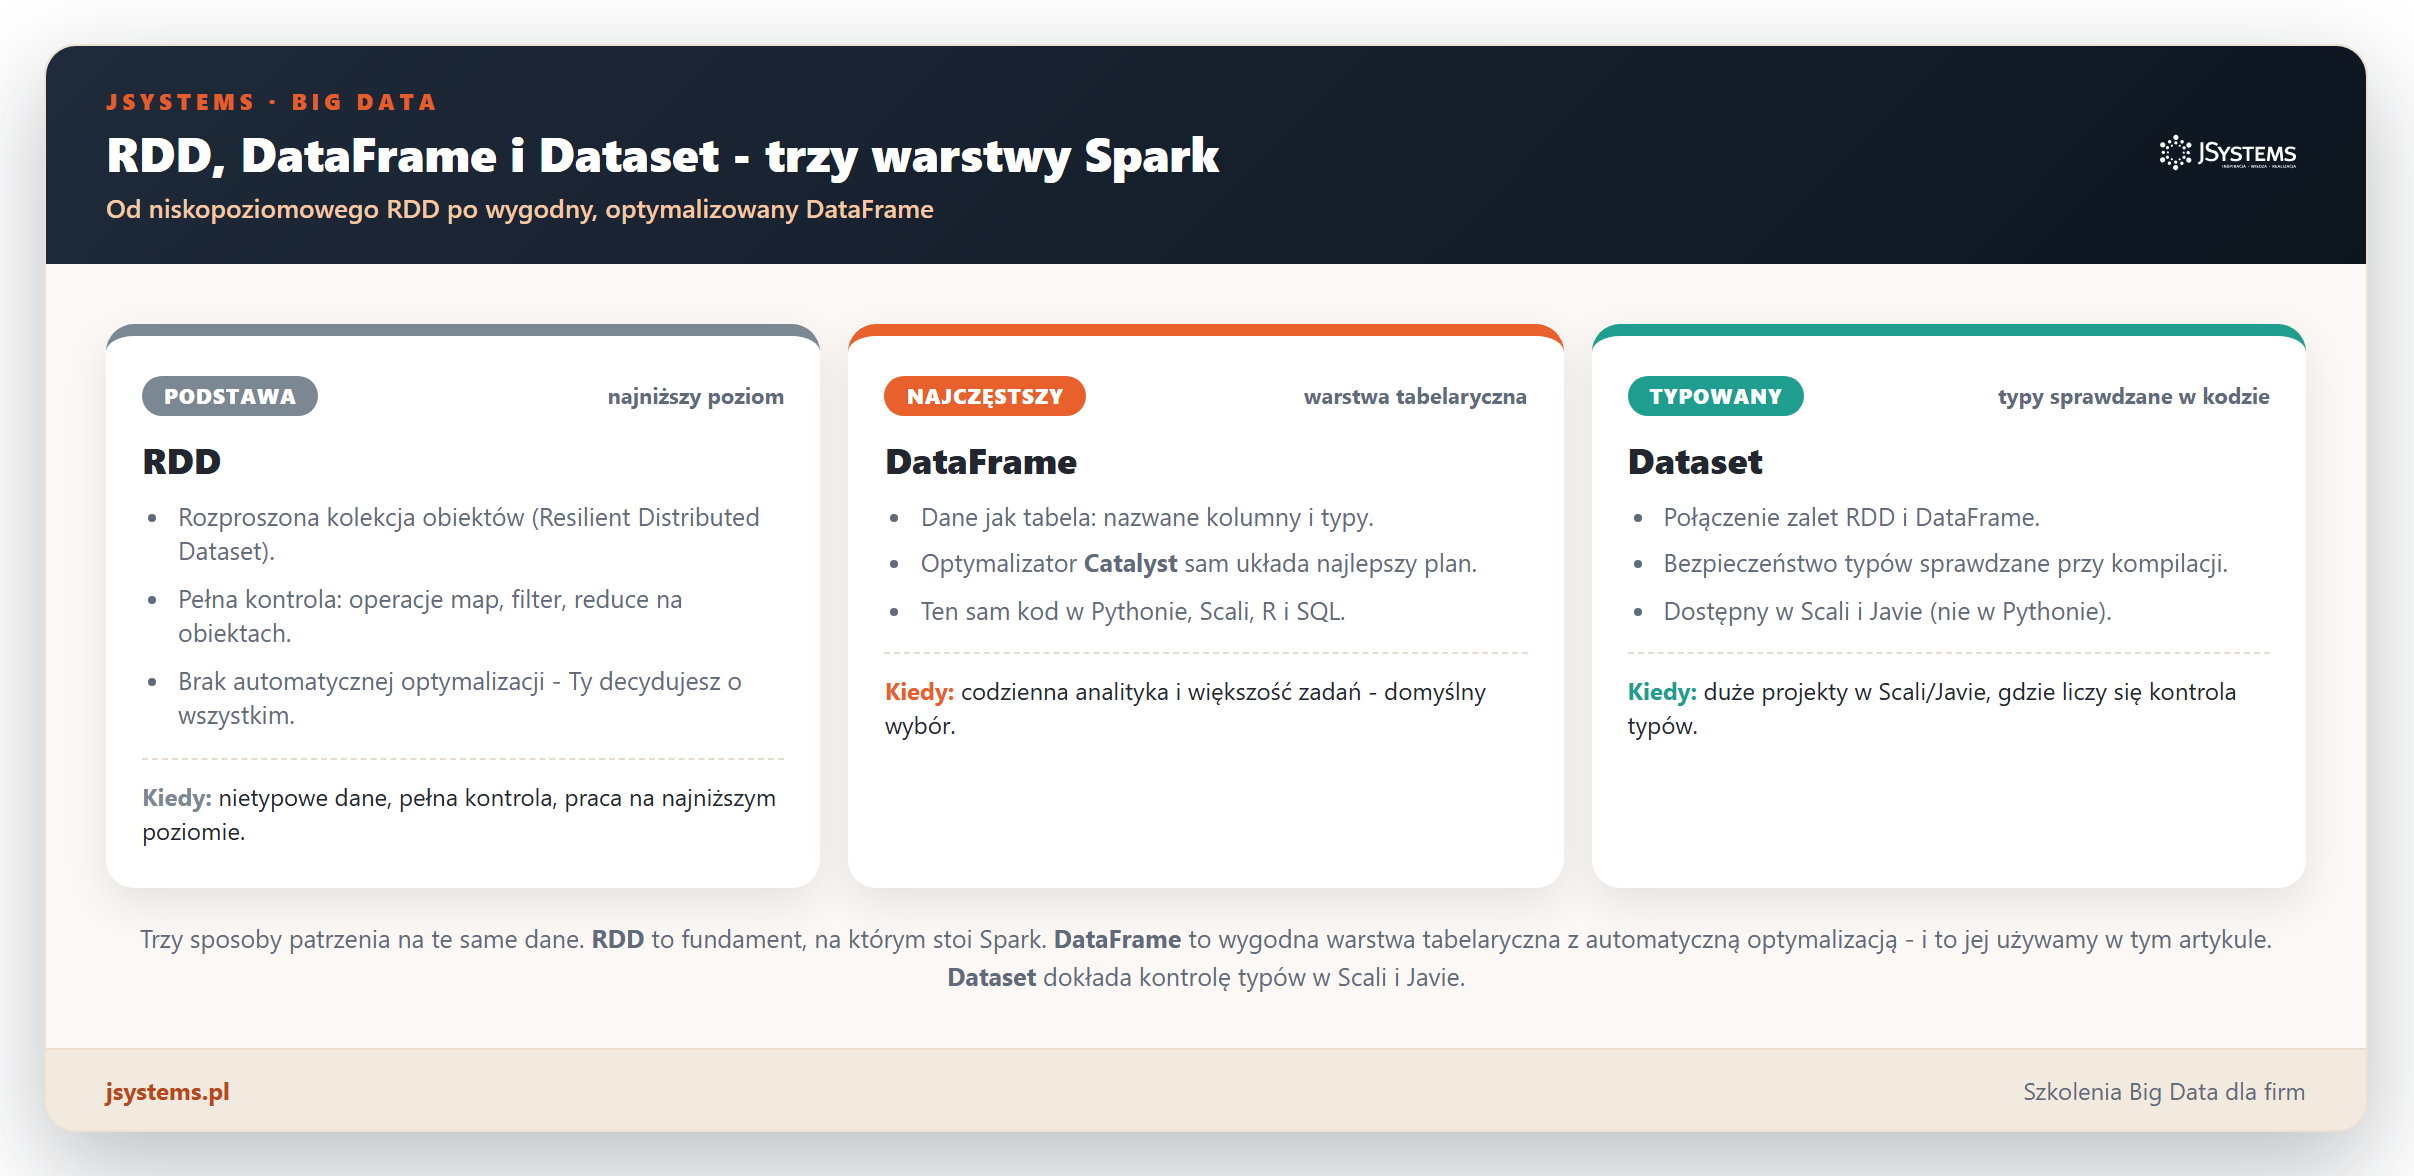
RDD (Resilient Distributed Dataset, czyli odporny rozproszony zbiór danych) to najniższy poziom - rozproszona kolekcja obiektów, na której wykonujesz operacje takie jak map czy reduce. Daje pełną kontrolę, ale sam nie jest optymalizowany. Zobaczmy RDD w akcji: policzmy liczbę sprzedanych sztuk w podziale na regiony, operując bezpośrednio na surowych liniach pliku.
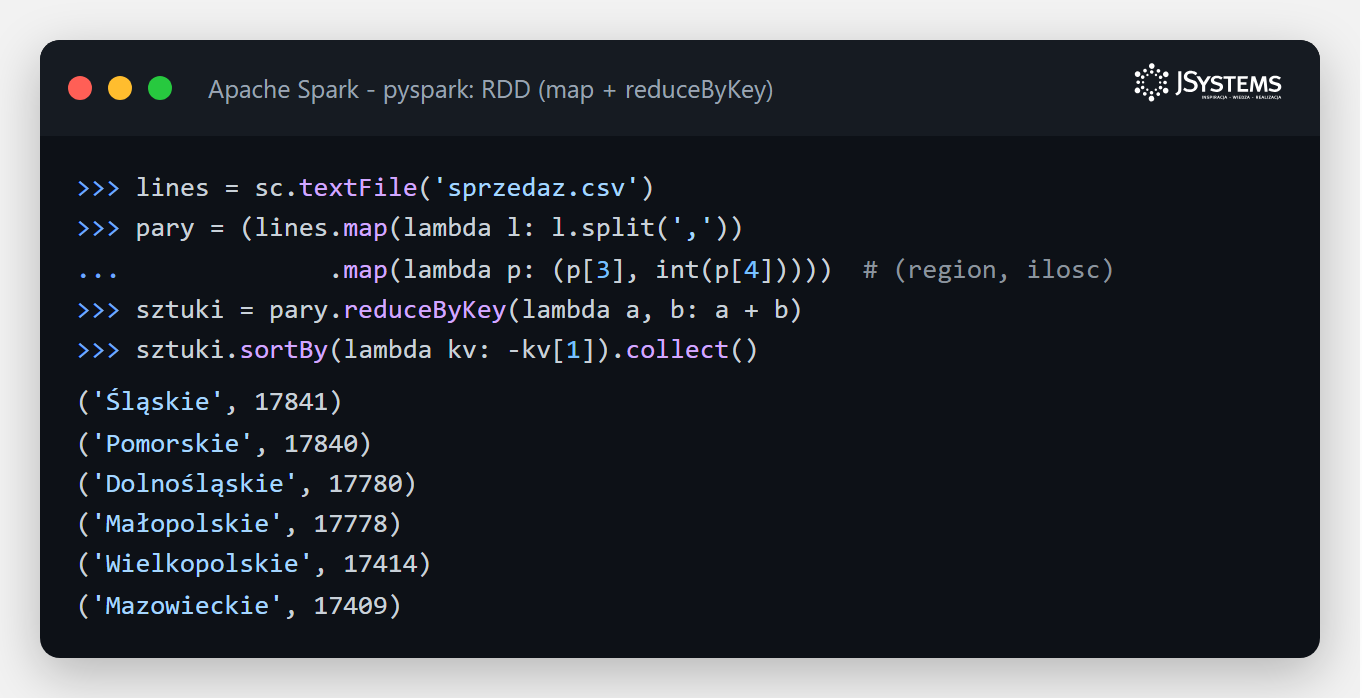
Widać, że kod RDD jest dość niskopoziomowy - sami dzielimy tekst, wybieramy pola po numerach i ręcznie sumujemy. Działa, ale jest sporo pracy i łatwo o pomyłkę. Dlatego na co dzień sięgamy po warstwę wyżej.
DataFrame to najczęstszy wybór. Dane widzisz jak tabelę z nazwanymi kolumnami i typami, dokładnie jak w bazie danych. Piszesz czytelny kod, a wbudowany optymalizator Catalyst sam układa najlepszy plan wykonania. To jego będziemy używać w większości artykułu. Dataset to trzecia opcja - łączy zalety RDD i DataFrame, dokładając sprawdzanie typów już na etapie pisania kodu, ale dostępny jest tylko w Scali i Javie (nie w Pythonie). Dla początkującego w Pythonie zasada jest prosta: używaj DataFrame.
Pracę ze Sparkiem zaczynasz od utworzenia sesji - obiektu, przez który rozmawiasz z silnikiem. Potem wczytujesz dane. Co ważne, tak jak w hurtowni Apache Hive, Spark stosuje model schema-on-read (schemat przy odczycie): schemat danych podajesz dopiero w momencie wczytywania pliku, a nie z góry przy jego zapisie. Oto jak w kilku linijkach tworzymy sesję, definiujemy schemat i wczytujemy plik sprzedaży.
from pyspark.sql import SparkSession
from pyspark.sql.types import StructType, StructField, IntegerType, StringType

spark = SparkSession.builder.master("local[*]").getOrCreate()

# schemat: nazwy kolumn i ich typy - nakladamy go dopiero przy odczycie
schemat = StructType([
    StructField("id",         IntegerType()),
    StructField("data",       StringType()),
    StructField("product_id", IntegerType()),
    StructField("region",     StringType()),
    StructField("ilosc",      IntegerType()),
    StructField("kanal",      StringType()),
])

sprzedaz = spark.read.csv("sprzedaz.csv", schema=schemat)
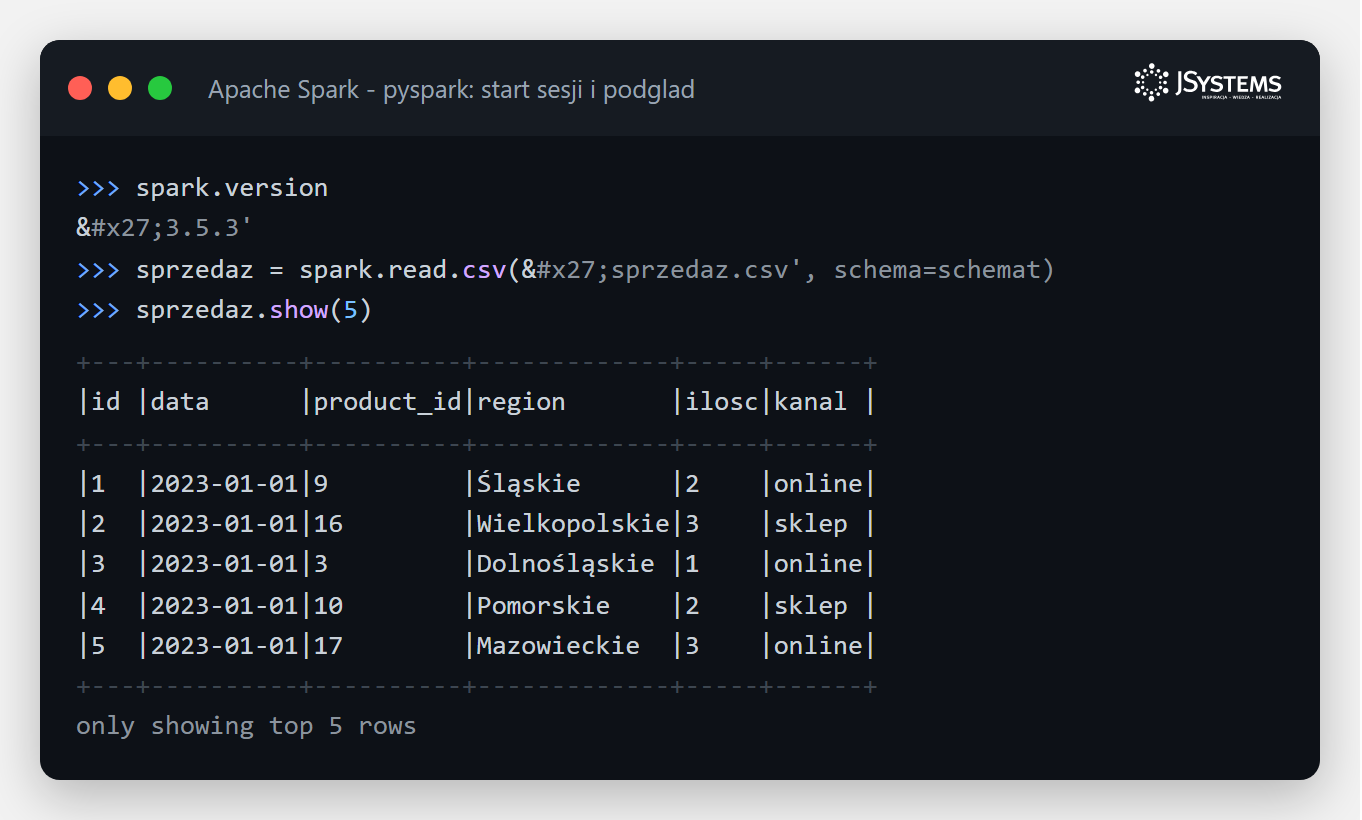
Zmienna schemat to właśnie nasza deklaracja struktury danych - lista sześciu kolumn wraz z typami (liczba całkowita albo tekst). Przekazujemy ją do read.csv w parametrze schema i to dzięki niej Spark wie, jak rozumieć surowy plik CSV. Podejrzyjmy pierwsze wiersze wczytanych danych.
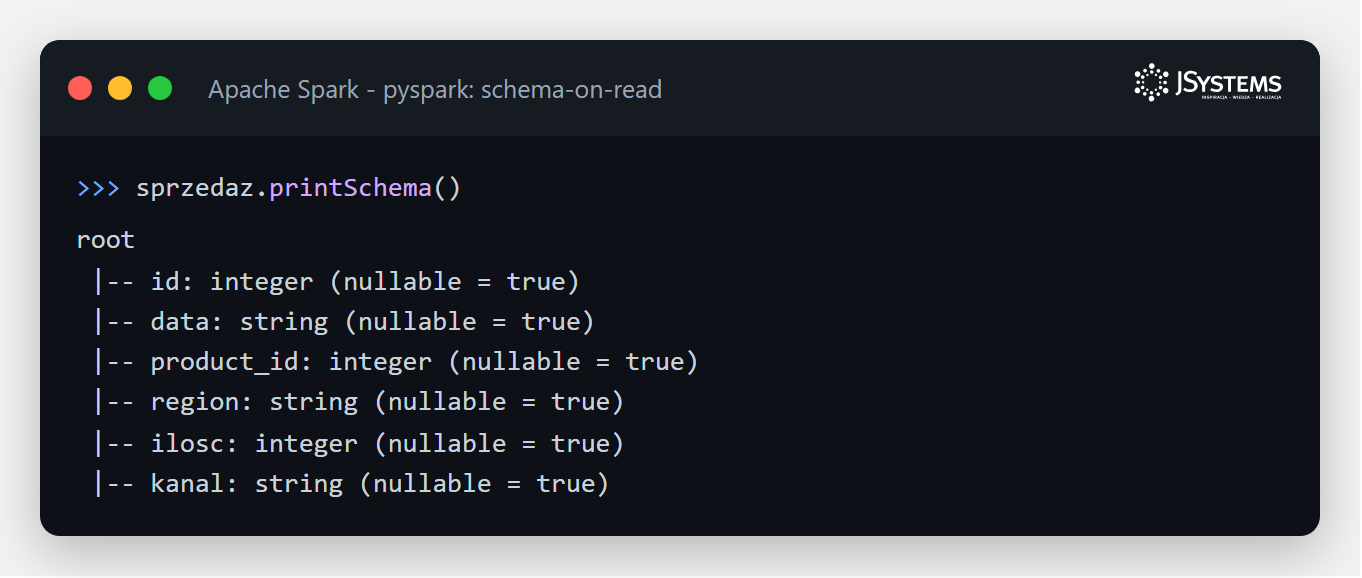
Skoro nałożyliśmy na plik schemat, możemy go podejrzeć. Polecenie printSchema pokazuje kolumny i ich typy - Spark zna je nie dlatego, że przeanalizował plik, ale dlatego, że sami tak zadeklarowaliśmy przy wczytywaniu.
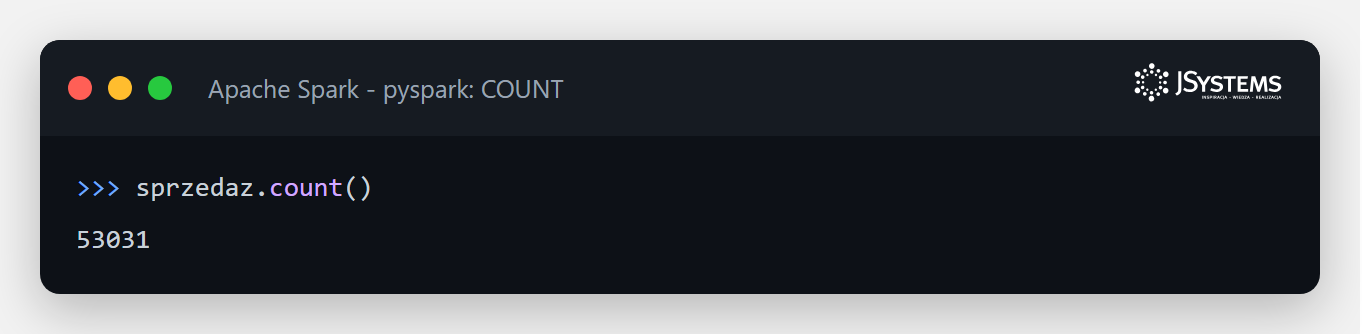
Sprawdźmy jeszcze, ile w ogóle mamy danych. Jedno proste wywołanie count i już wiemy, że pracujemy na ponad pięćdziesięciu tysiącach transakcji.
Teraz najważniejszy koncept Sparka, który odróżnia go od zwykłego programowania i którego zrozumienie oszczędzi Ci wielu niespodzianek. W Sparku operacje dzielą się na dwa rodzaje: transformacje i akcje. Transformacja (na przykład filter, select, groupBy) opisuje, co chcesz zrobić z danymi - ale niczego nie liczy. Spark tylko zapamiętuje przepis. Dopiero akcja (na przykład count, show lub zapis wyniku) uruchamia całe obliczenie. Ten mechanizm nazywa się leniwym wykonaniem (lazy evaluation).
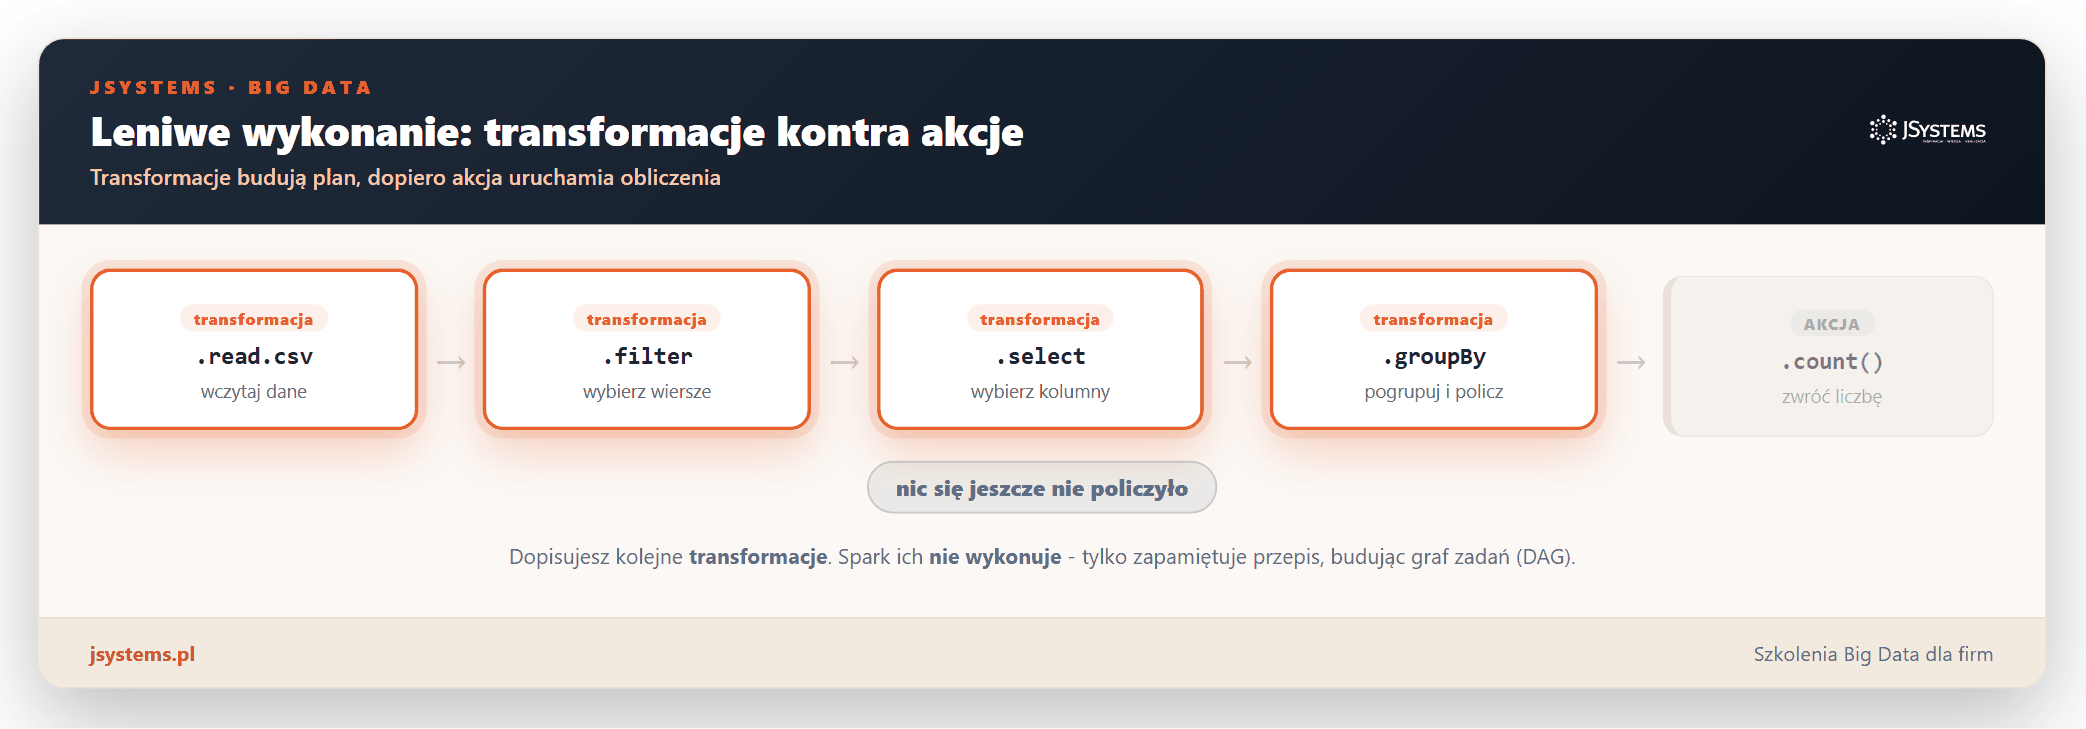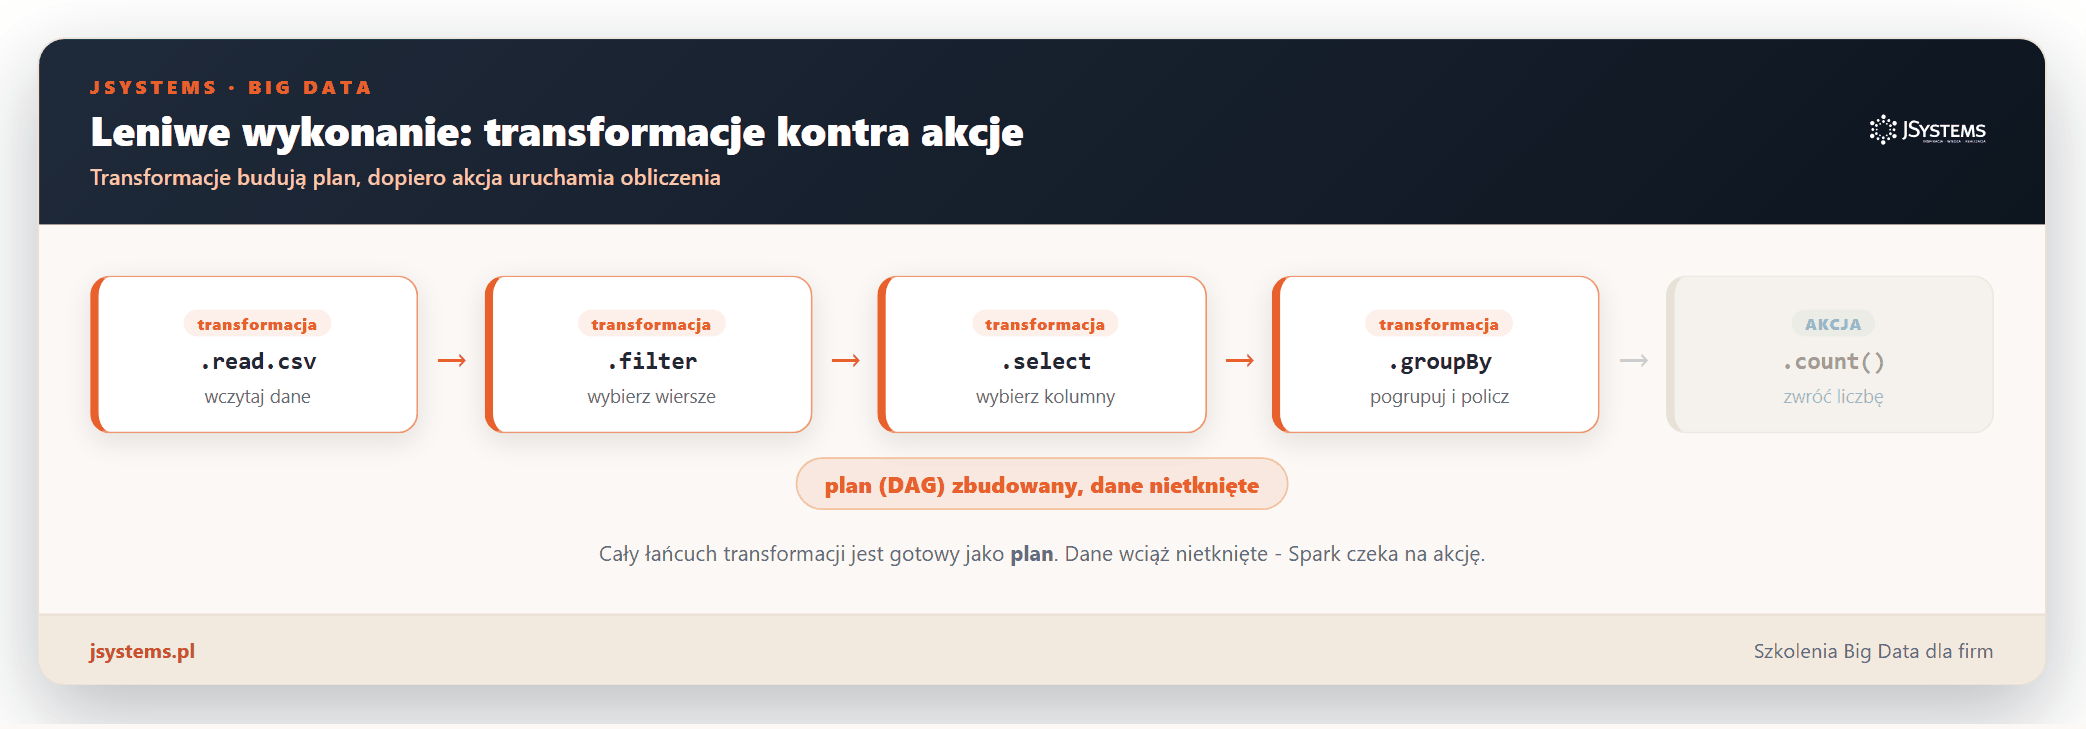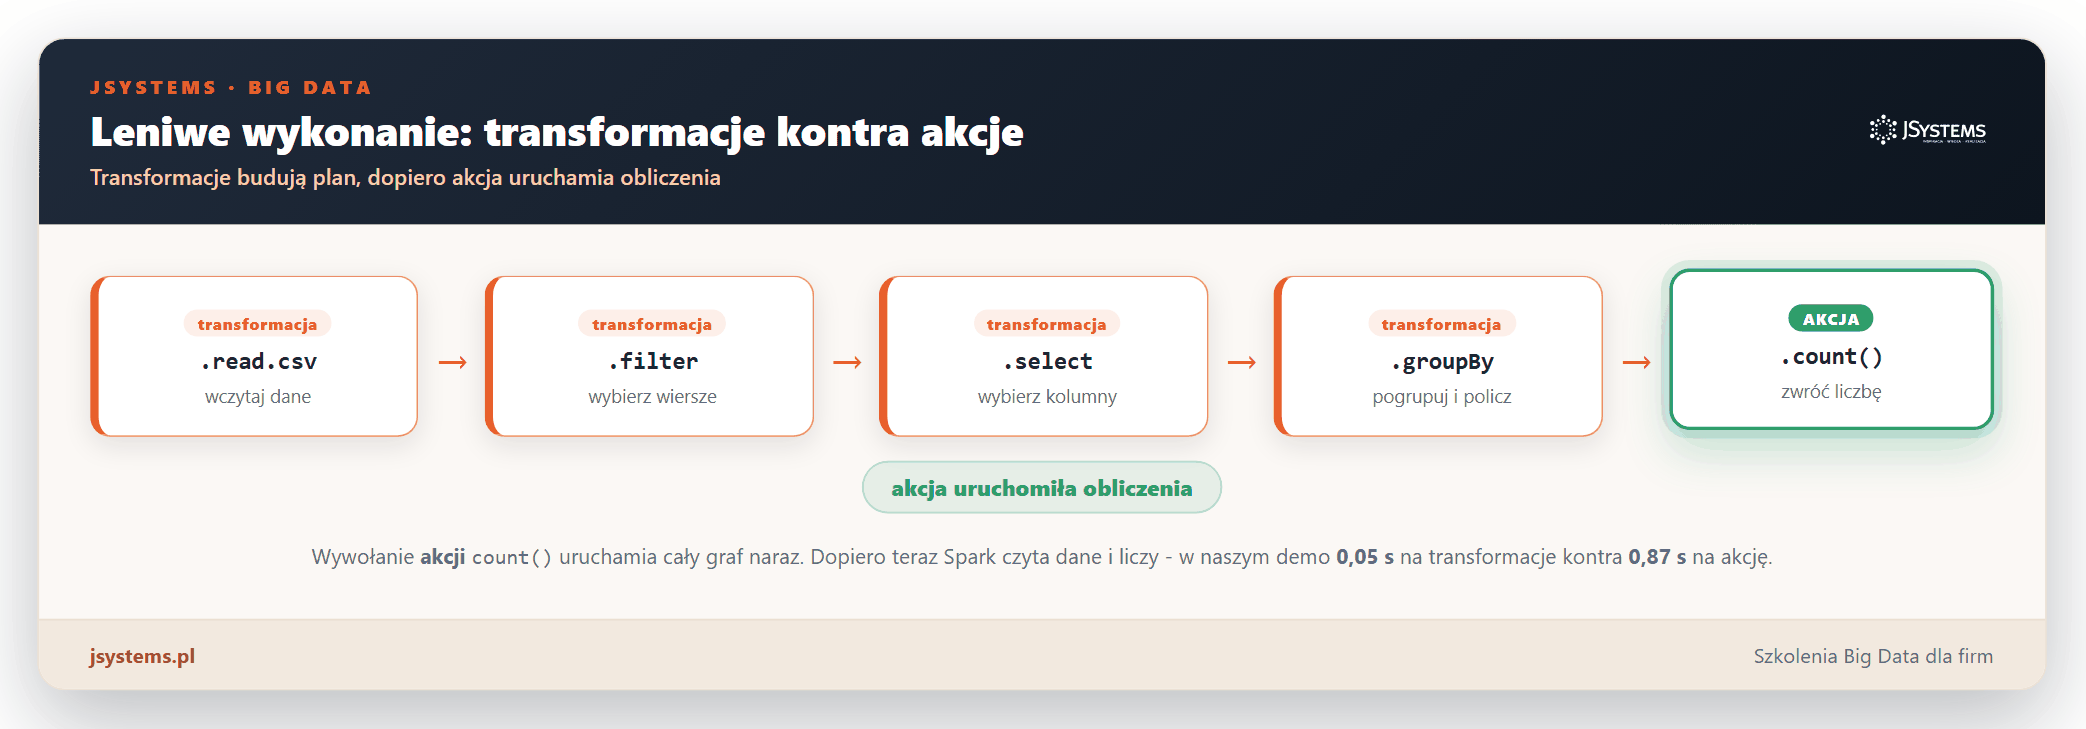
Po co ta komplikacja? Bo dzięki niej Spark widzi cały plan, zanim zacznie liczyć, i może go zoptymalizować - na przykład pominąć kolumny, których i tak nikt nie użyje, albo połączyć kilka kroków w jeden. To fundament wydajności Sparka. Zobaczmy to na realnym pomiarze: budujemy łańcuch transformacji i mierzymy czas, a potem wywołujemy akcję i mierzymy ponownie.
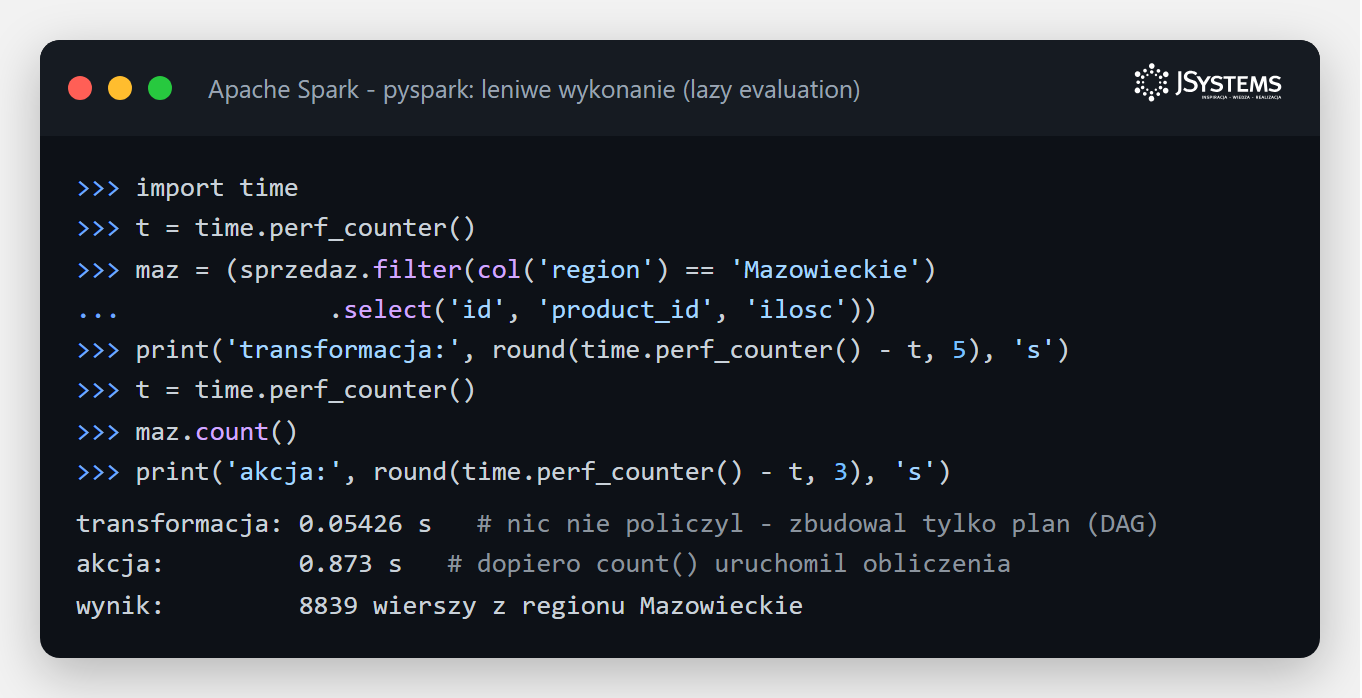
Różnica jest wymowna: samo zbudowanie planu to ułamek sekundy, bo Spark niczego wtedy nie liczy - dopiero akcja czyta 53 tysiące wierszy i wykonuje pracę. Gdy zaczynasz ze Sparkiem, dobrze mieć w głowie tę zasadę: dopóki nie wywołasz akcji, nic się nie dzieje.
Skoro mamy dane, zadajmy im pytania biznesowe. Zacznijmy od agregacji na DataFrame: ile transakcji i ile sprzedanych sztuk przypada na każdy region. Metoda groupBy w połączeniu z agg odpowiada za grupowanie.
(sprzedaz.groupBy("region")
        .agg(count("*").alias("transakcje"),
             sum("ilosc").alias("sztuki"))
        .orderBy(desc("sztuki"))
        .show())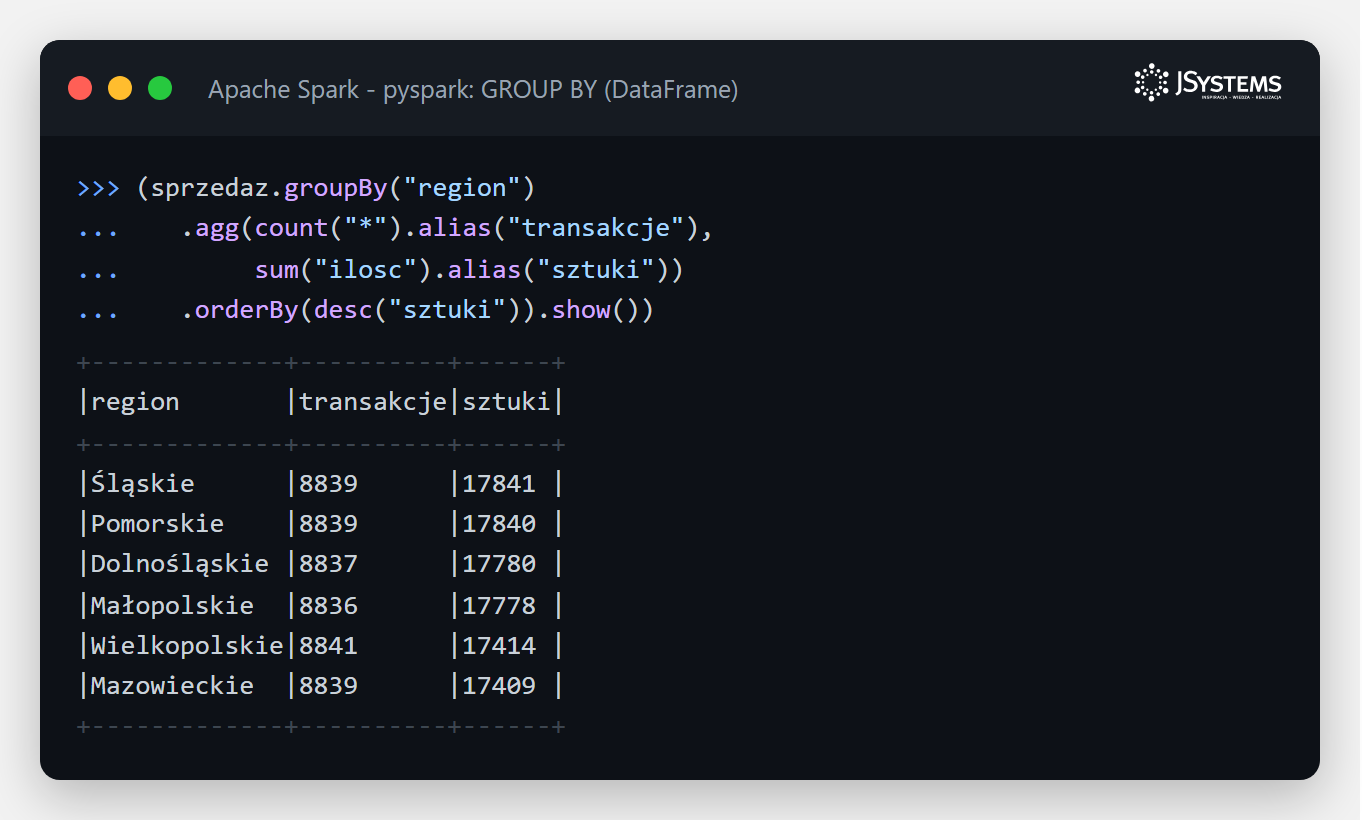
Prawdziwa moc analityki to łączenie tabel. Obok sprzedaży mamy drugą, mniejszą tabelę - listę produktów z cenami. Połączmy je (operacja join) po kluczu product_id, żeby policzyć przychód w podziale na kategorie.
(sprzedaz.join(produkty, "product_id")
        .groupBy("kategoria")
        .agg(count("*").alias("transakcje"),
             round(sum(col("ilosc") * col("cena")), 2).alias("przychod_pln"))
        .orderBy(desc("przychod_pln"))
        .show())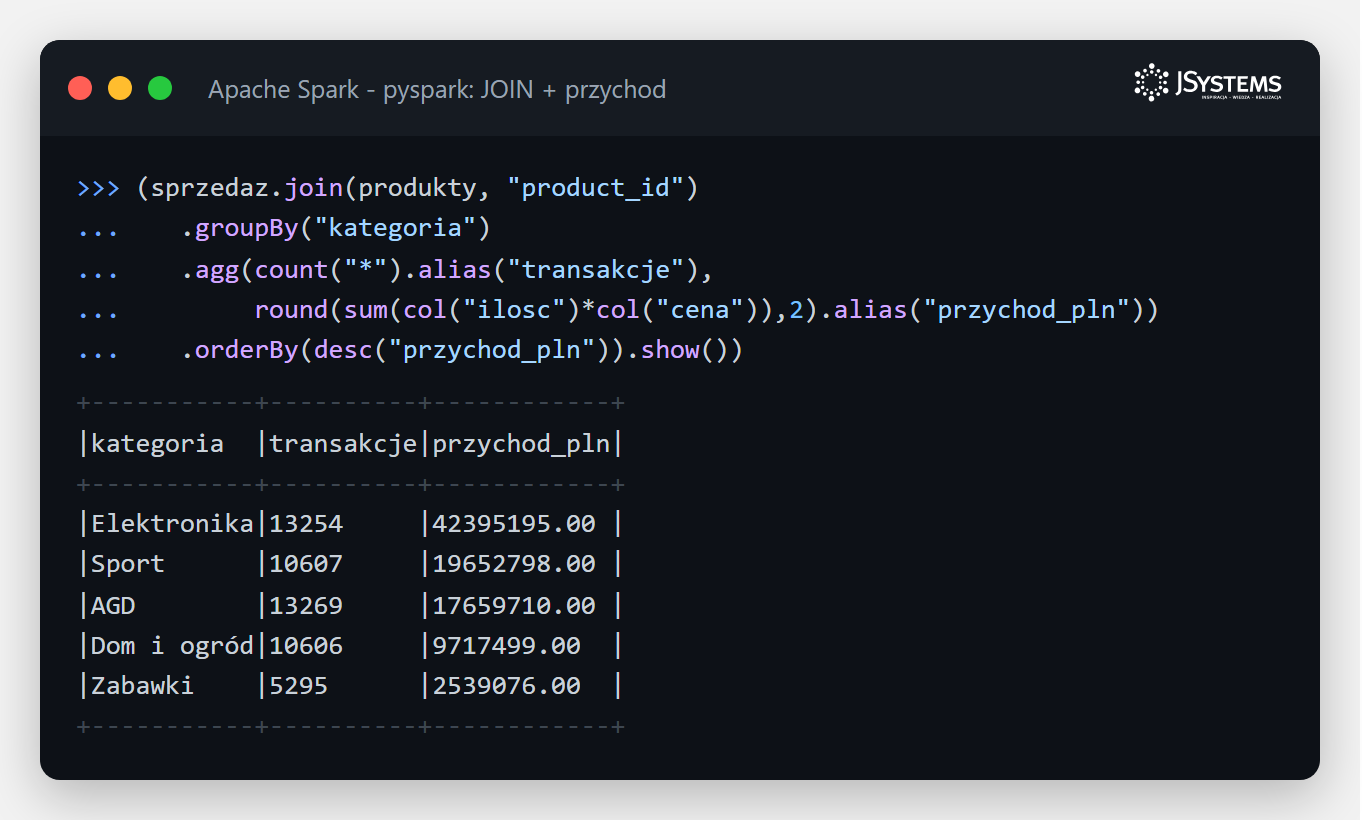
Najlepsze w Sparku jest to, że jeśli wolisz zwykły SQL, wcale nie musisz uczyć się nowego API. Ten sam wynik dostaniesz, pisząc klasyczne zapytanie w Spark SQL - składnia jest praktycznie taka sama jak w każdej bazie.
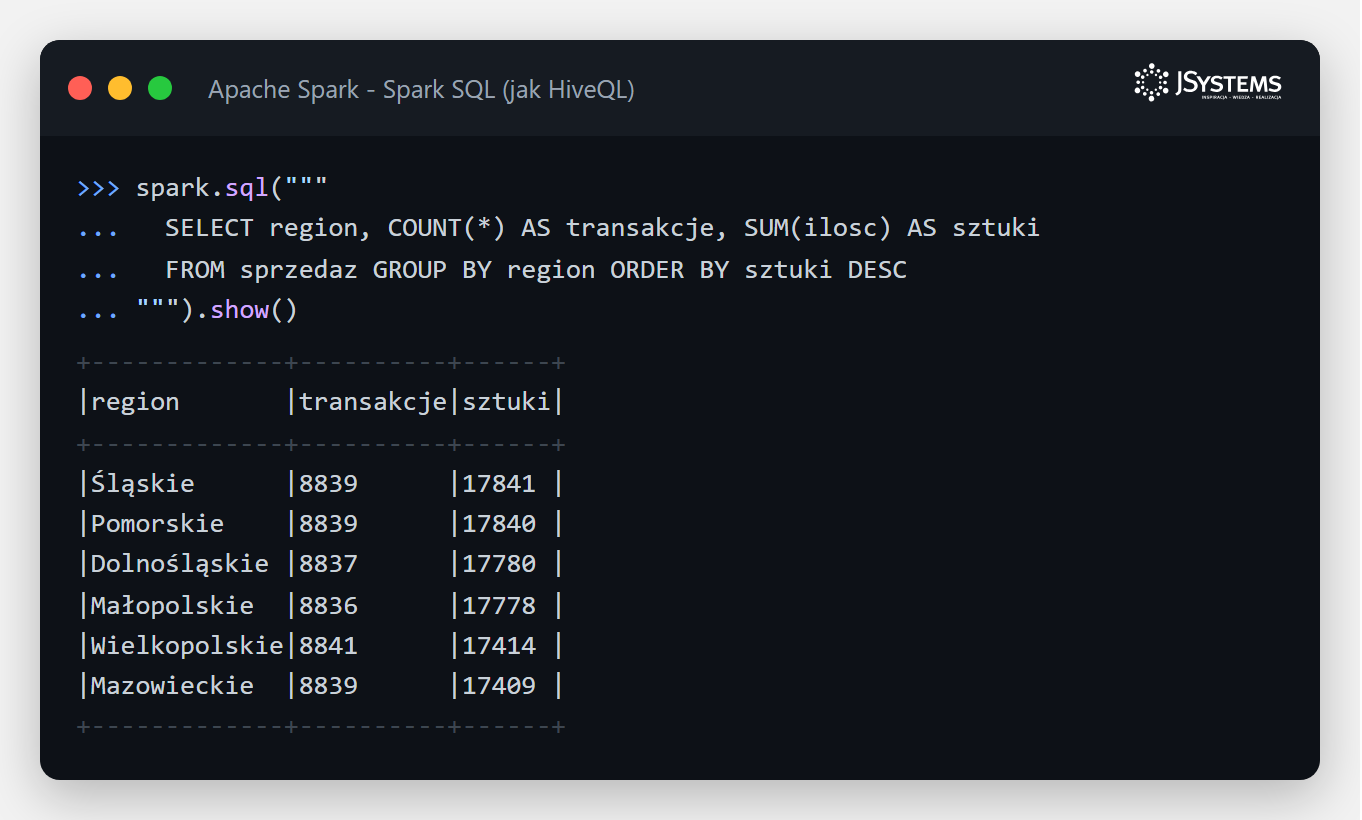
To jest właśnie codzienna praca ze Sparkiem: analityczne pytania do dużych zbiorów, zadawane albo wygodnym API DataFrame, albo znanym wszystkim SQL. Chcesz opanować to od podstaw, na realnych danych i pod okiem praktyka?
Chcesz nauczyć się przetwarzać duże zbiory danych w Sparku w praktyce? Szkolenie Big Data: Przetwarzanie danych Big Data z Apache Spark ma terminy gwarantowane.
Wróćmy do najważniejszej cechy Sparka - liczenia w pamięci. Najlepiej widać ją w zestawieniu z MapReduce. Poniższa infografika pokazuje, na czym polega różnica.
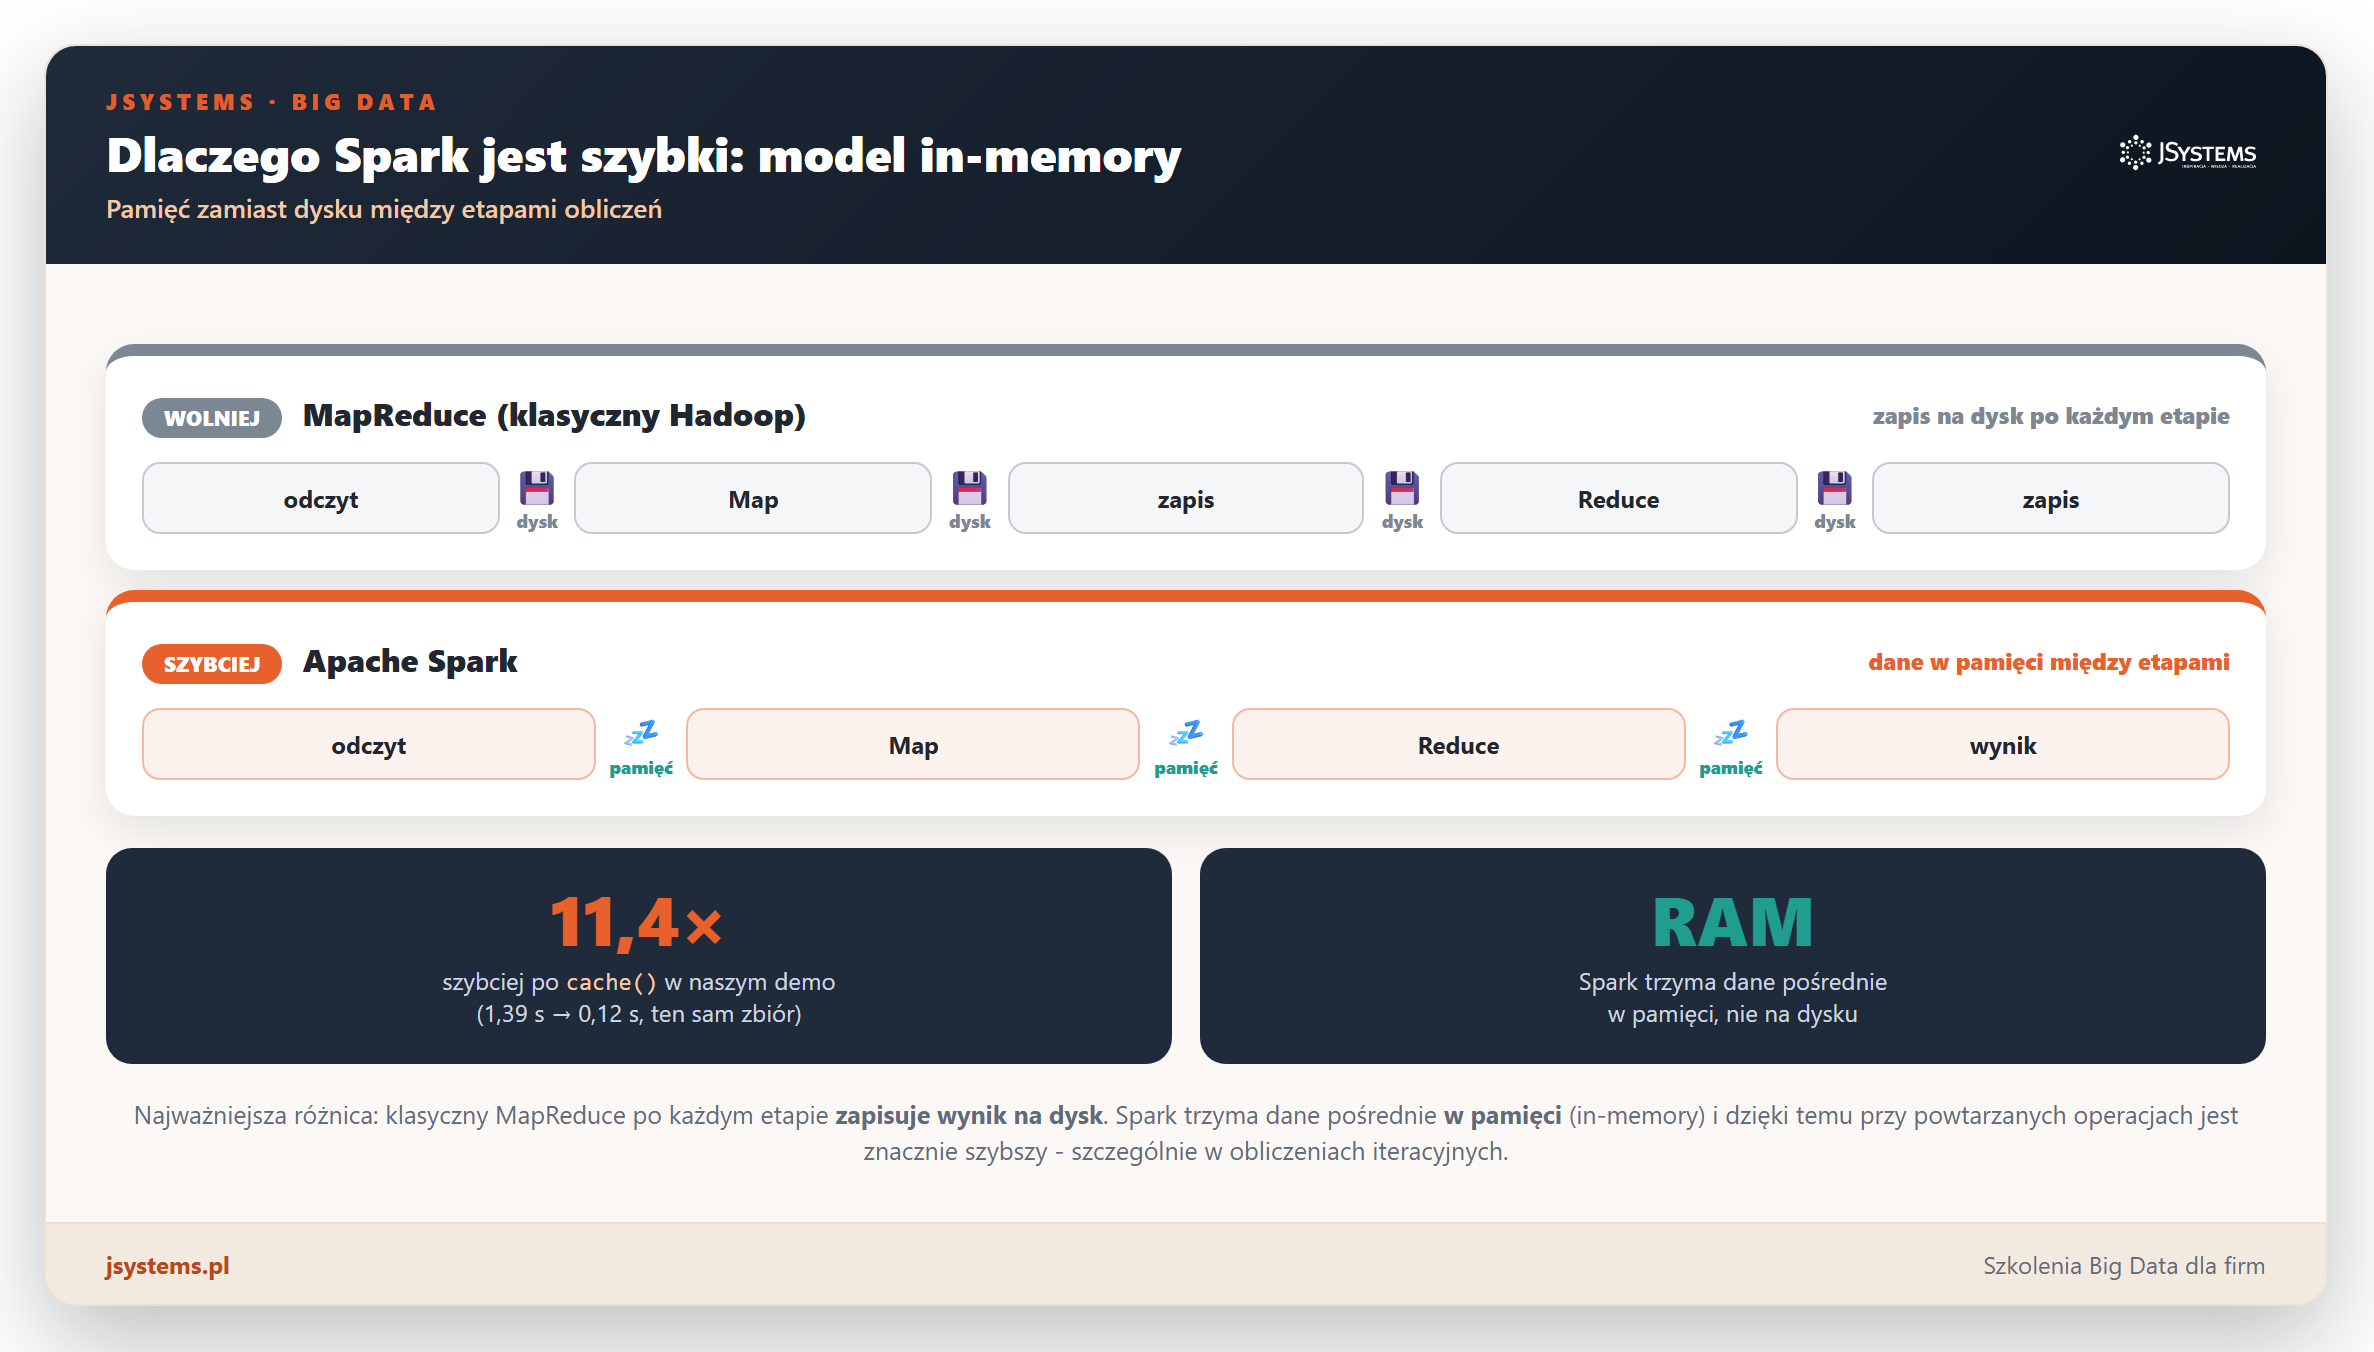
Ten model in-memory daje o sobie znać zwłaszcza wtedy, gdy ten sam zbiór odpytujesz wielokrotnie. Spark pozwala wtedy jawnie poprosić, żeby dane zostały w pamięci - służy do tego metoda cache. Zmierzyliśmy to: pierwszy przebieg zapytania (zimny, z odczytem danych) kontra ten sam przebieg po zbuforowaniu danych w pamięci.
q.collect()                 # zimny odczyt danych
sprzedaz.cache(); sprzedaz.count()   # zaladuj do pamieci
q.collect()                 # ponowny odczyt - juz z pamieci
Wynik jest jednoznaczny: po zbuforowaniu danych powtórne zapytanie policzyło się w naszym demo ponad 11 razy szybciej (spadek z około 1,39 do 0,12 sekundy). To dokładnie ta przewaga, dla której powstał Spark - unikanie kosztownych odczytów z dysku tam, gdzie dane można trzymać w pamięci. Warto pamiętać, że cache ma sens wtedy, gdy ten sam zbiór wykorzystujesz kilka razy; przy jednorazowym przejściu przez dane nic nie zyskasz.
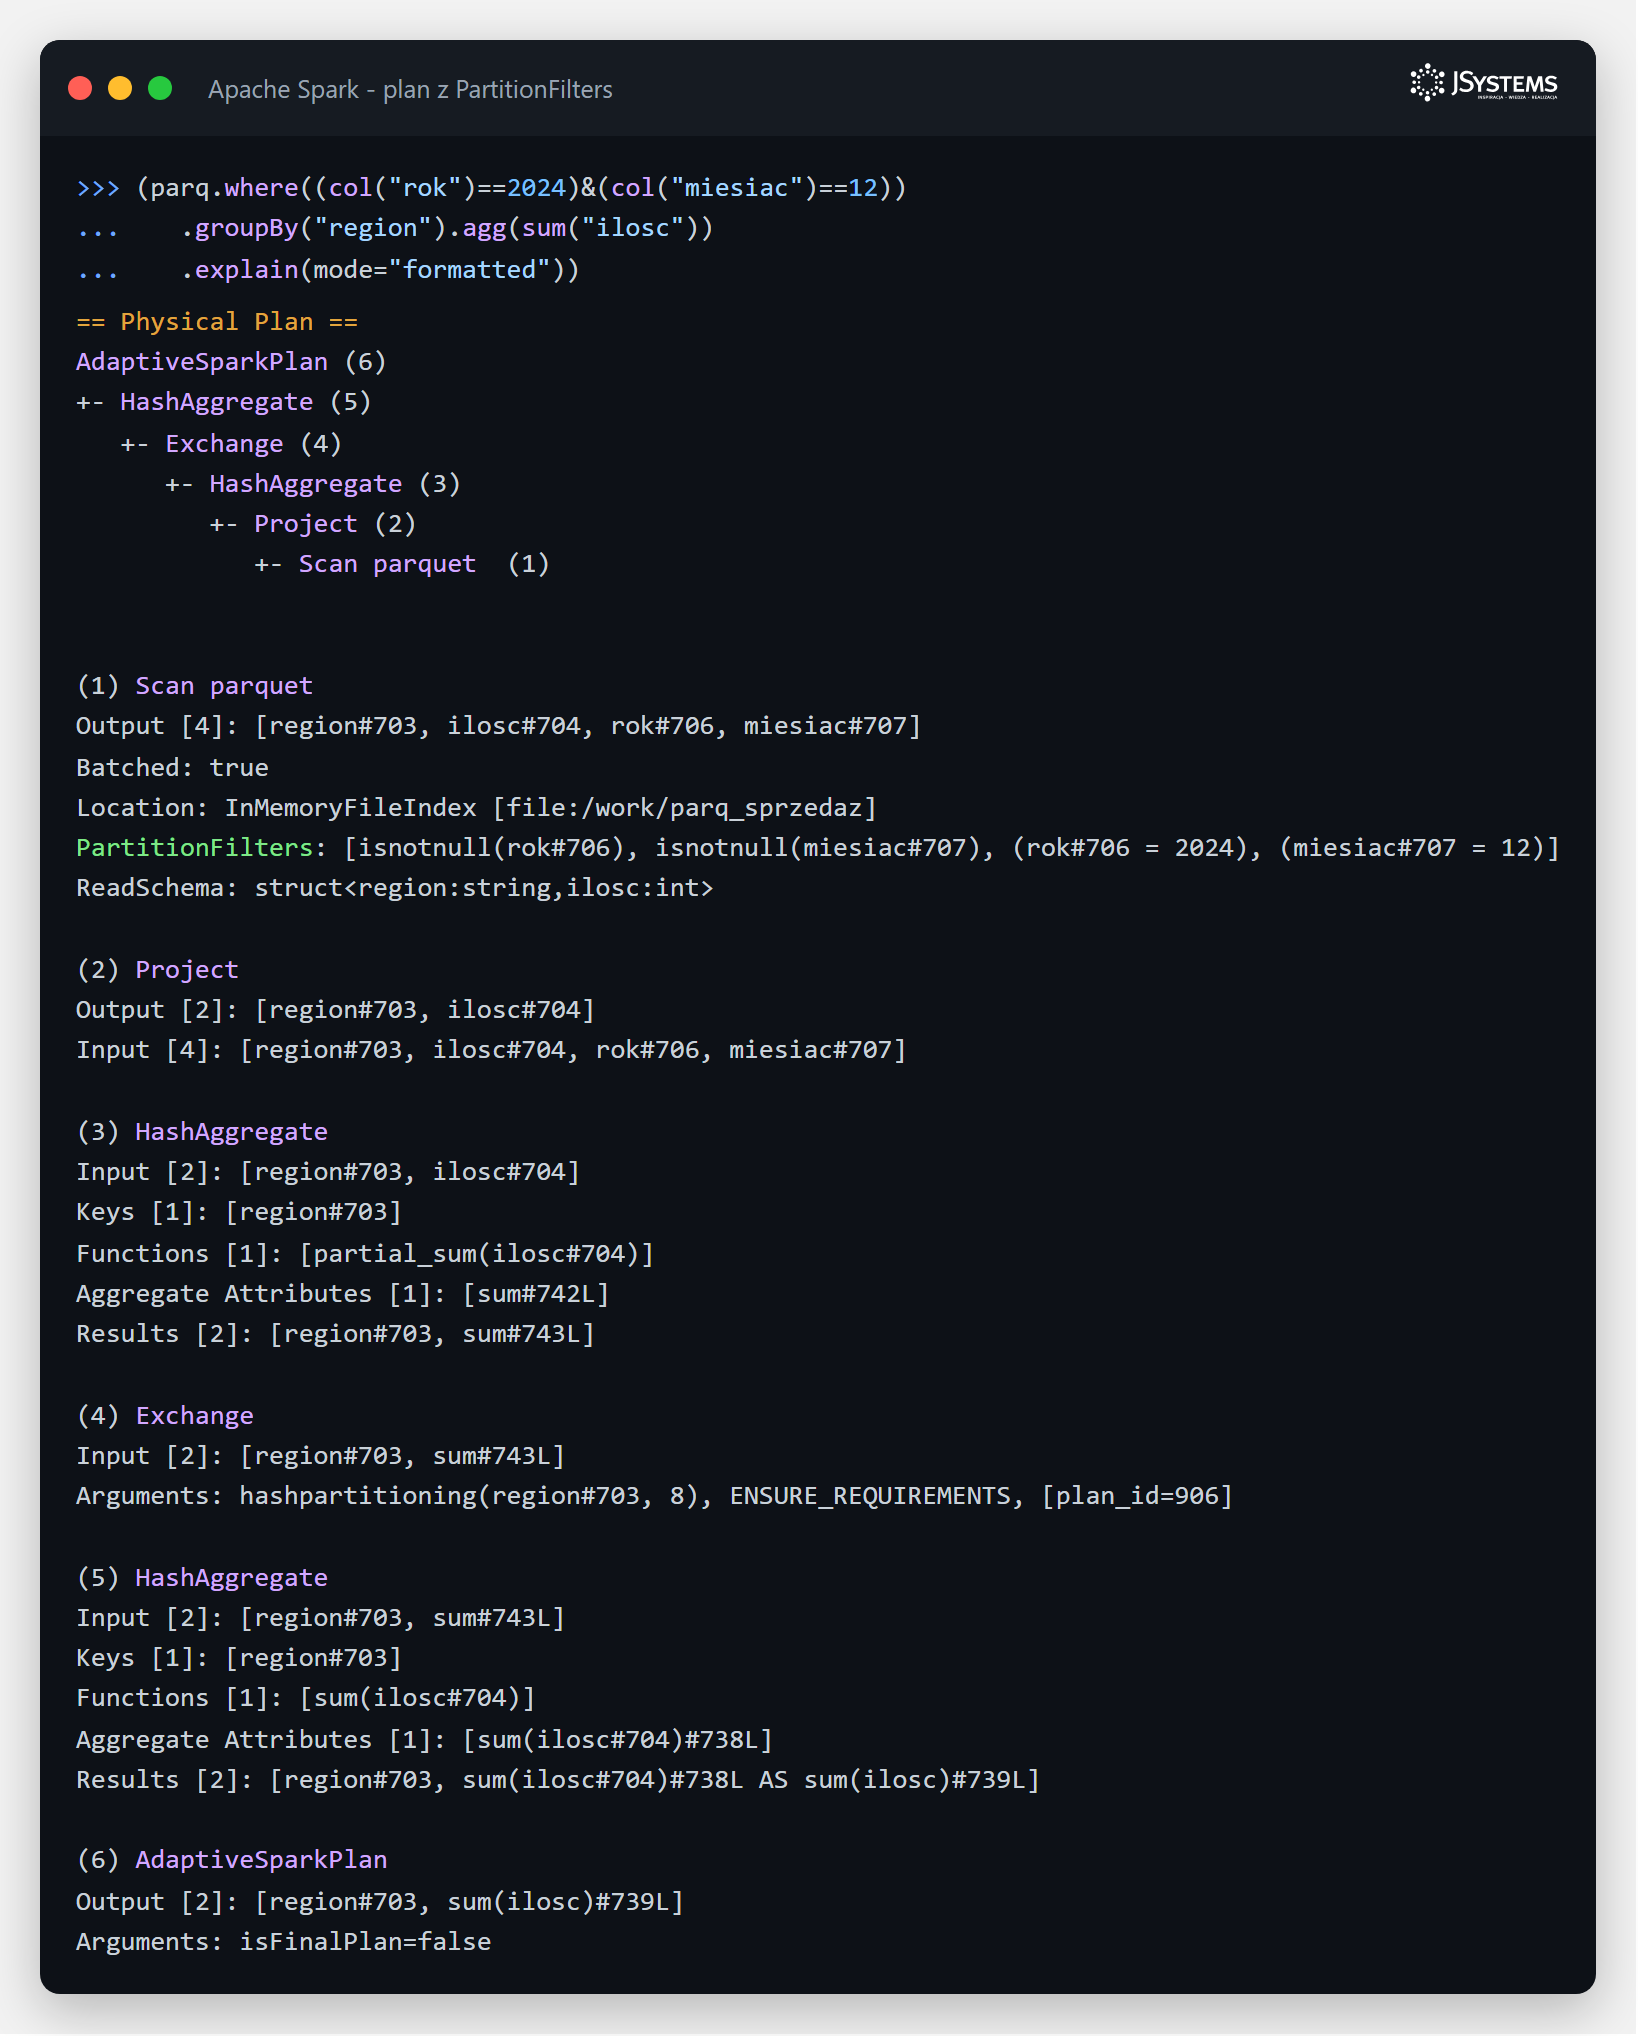
Skąd Spark wie, jak najlepiej policzyć Twoje zapytanie? Odpowiada za to Catalyst - wbudowany optymalizator, który zamienia kod DataFrame lub Spark SQL w zoptymalizowany plan fizyczny. Zanim Spark cokolwiek policzy, układa graf kroków, wybiera najtańszy sposób wykonania i dopiero wtedy rozsyła zadania do executorów. Ten plan możesz podejrzeć poleceniem explain.
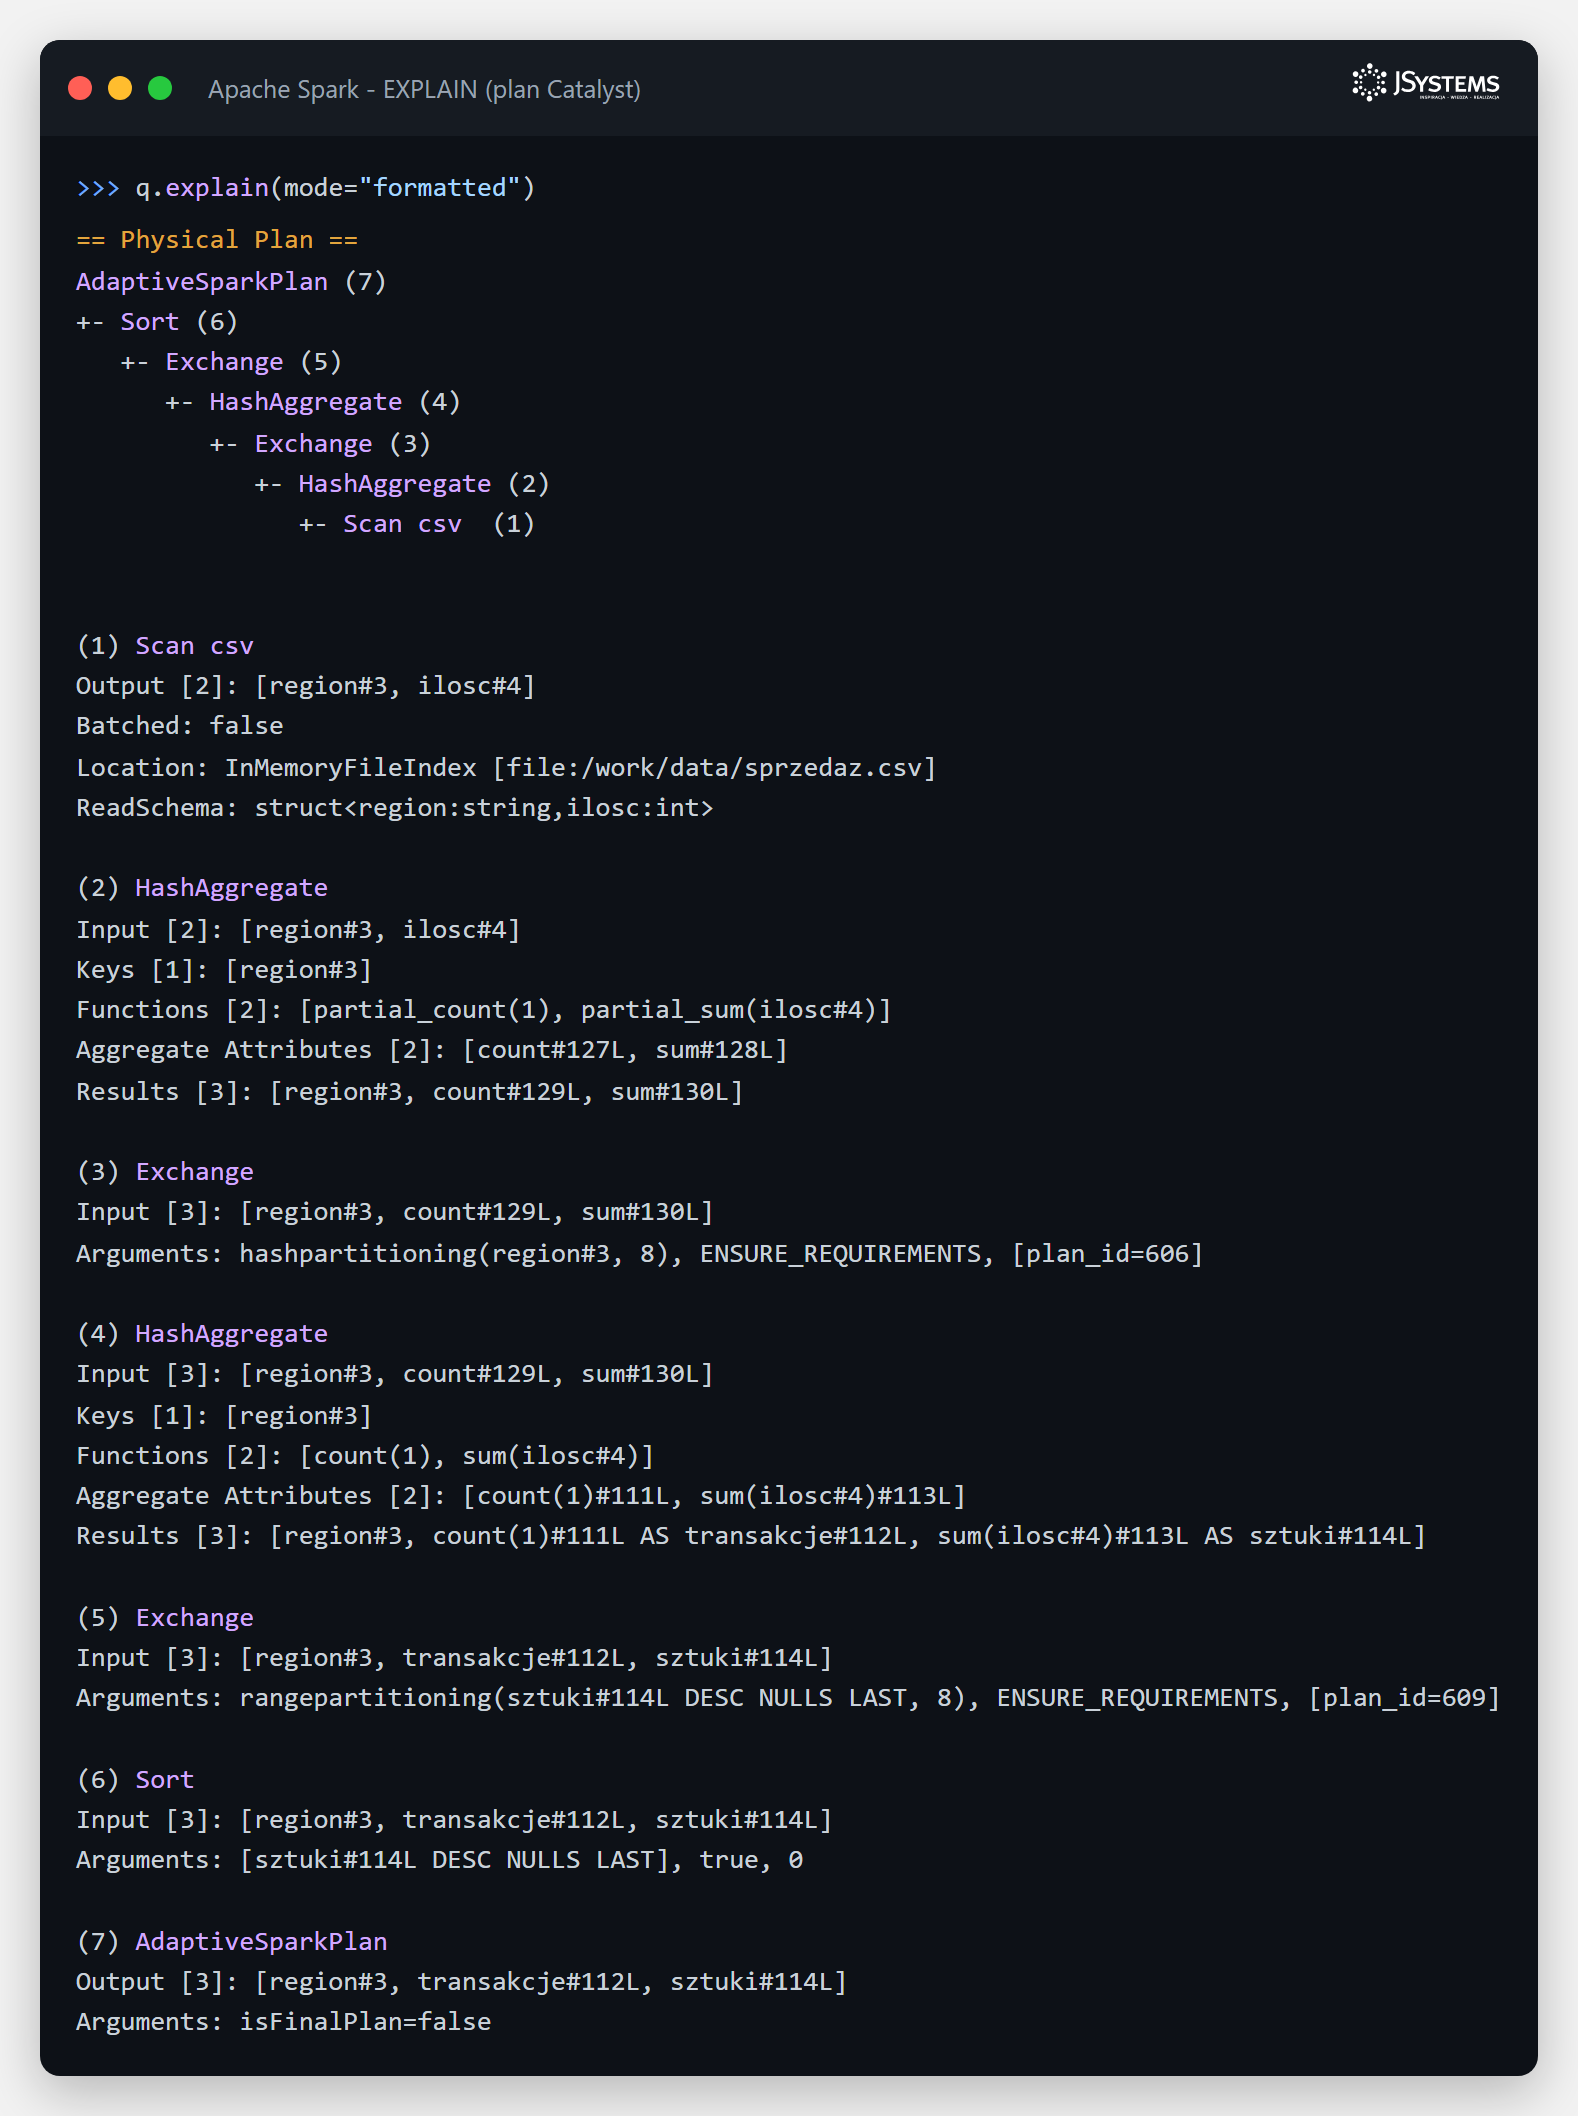
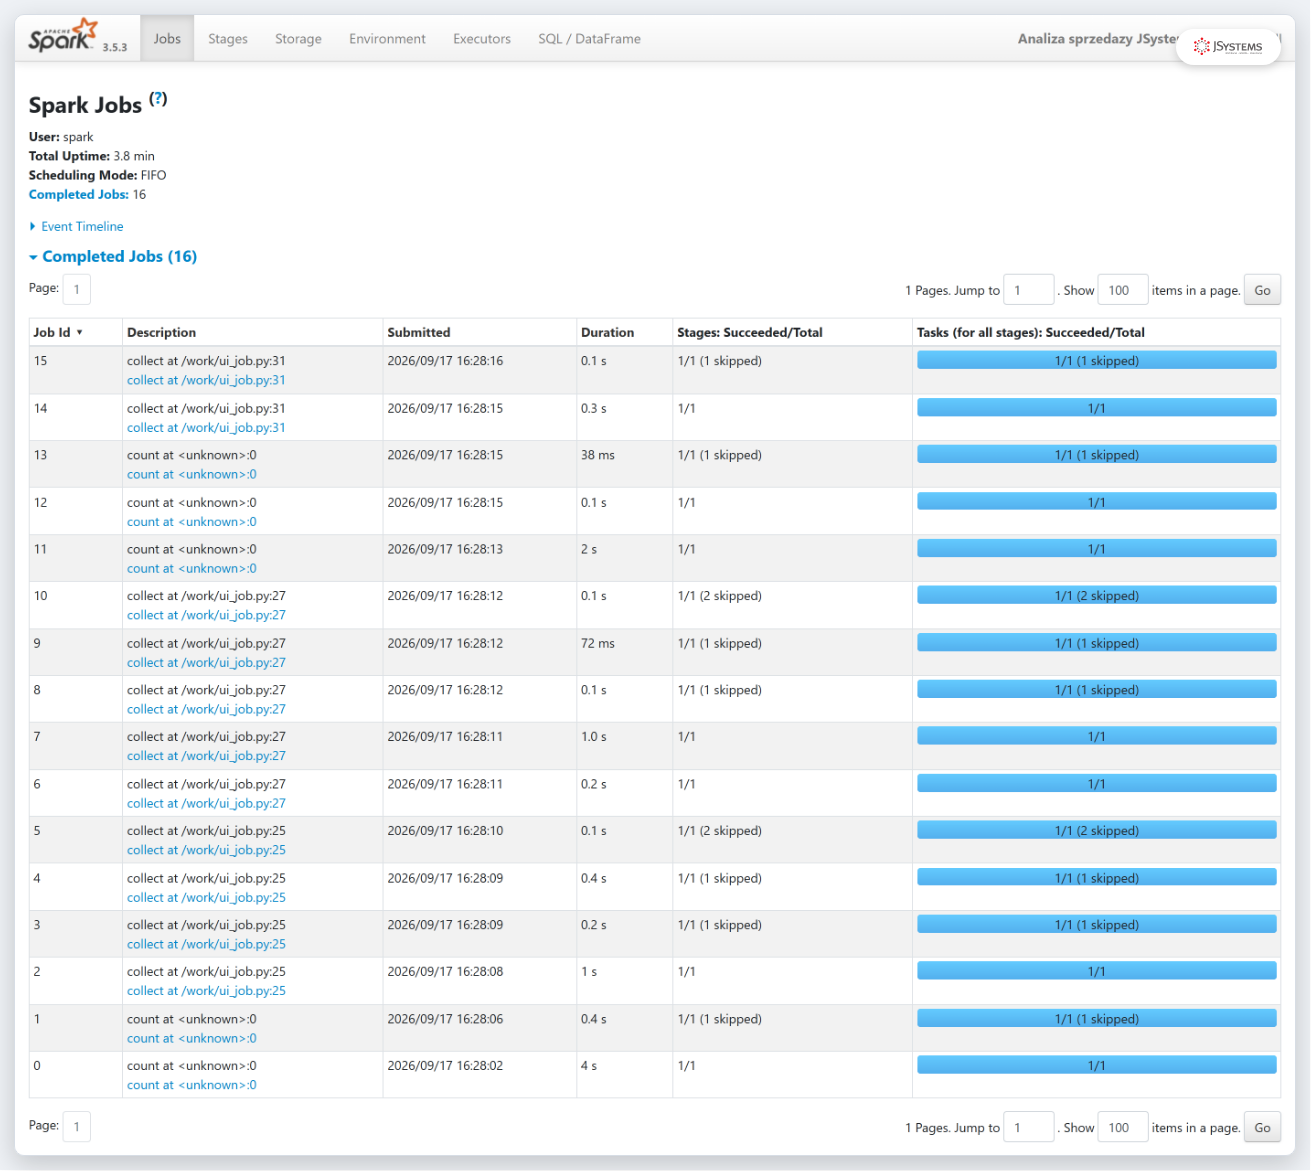
Ten plan nie jest tylko teorią - Spark faktycznie go realizuje, a cały przebieg możesz obejrzeć w graficznym panelu Spark UI, który silnik udostępnia przez przeglądarkę. Widać w nim wykonane zadania i to, jak Spark rozbił zapytanie na etapy.
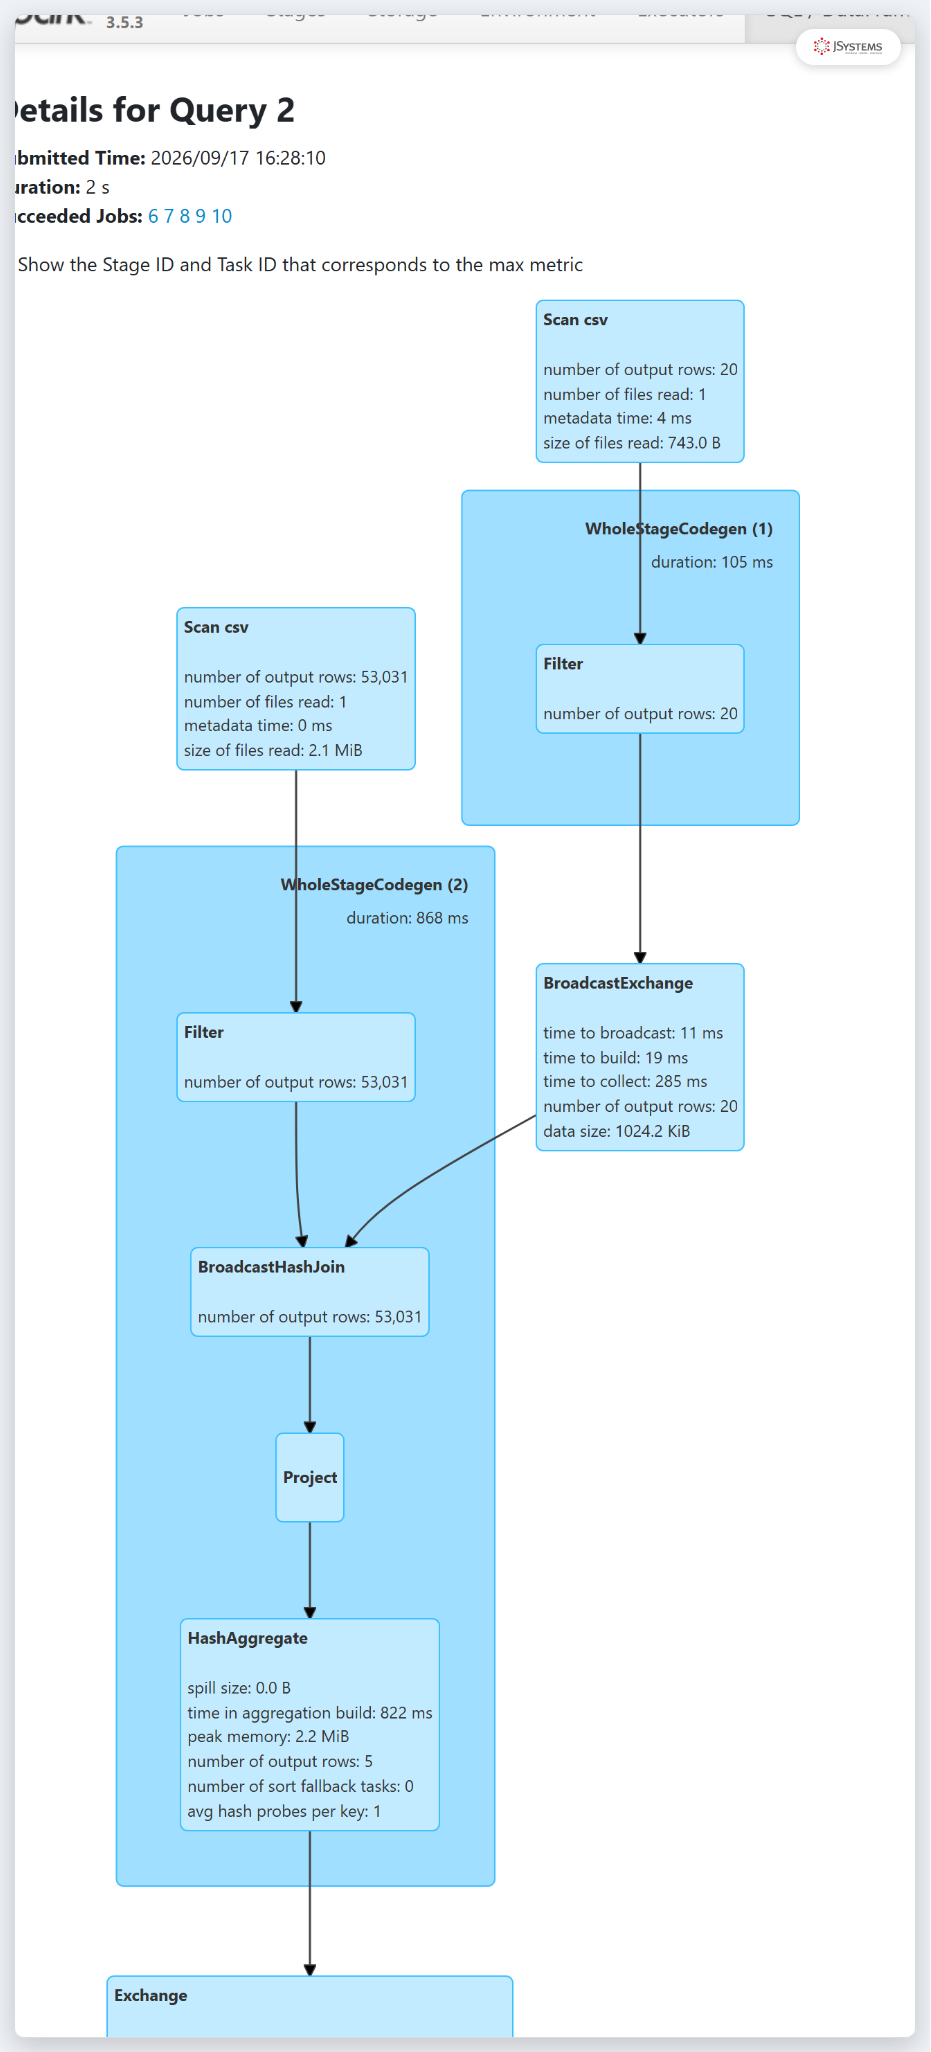
Gdy dane rosną, opłaca się je fizycznie podzielić, żeby zapytania nie musiały czytać całości. Spark, podobnie jak hurtownie Big Data, wspiera partycjonowanie - zapis danych w podziale na katalogi według wybranej kolumny. Zapiszmy naszą sprzedaż w formacie Parquet (wydajny format kolumnowy) z podziałem na rok i miesiąc, a potem zapytajmy o jeden konkretny miesiąc.
(sprzedaz.withColumn("rok", year("data"))
        .withColumn("miesiac", month("data"))
        .write.partitionBy("rok", "miesiac").parquet("sprzedaz_part"))

parq = spark.read.parquet("sprzedaz_part")
parq.where((col("rok") == 2024) & (col("miesiac") == 12)).count()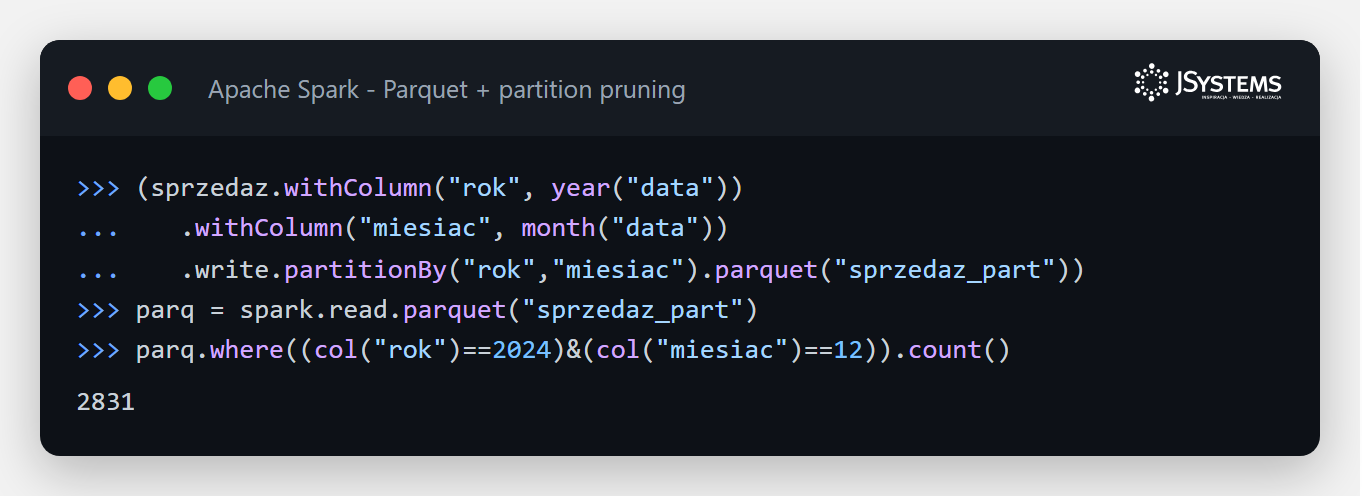
Że tak się właśnie stało, potwierdza plan wykonania. W sekcji PartitionFilters widać, że Spark z góry wiedział, które partycje pominąć - ten mechanizm nazywa się partition pruning (przycinanie partycji).
Partycjonowanie, format kolumnowy Parquet i cache to trzy pierwsze narzędzia optymalizacji, których uczy się każdy inżynier danych pracujący ze Sparkiem. Jeśli te przykłady w Pythonie Cię wciągnęły, to naturalny kierunek dalszej nauki.
Wolisz uczyć się Sparka od strony Pythona? Szkolenie PySpark: rozproszone przetwarzanie danych w Sparku za pomocą Pythona pokazuje to na realnych zadaniach.
Do tej pory pracowaliśmy z danymi tabelarycznymi, ale Spark to znacznie więcej. Jego siłą jest to, że jest ujednoliconym silnikiem - na tych samych danych i w tym samym API robisz zupełnie różne rzeczy. Poniższa infografika pokazuje główne moduły.
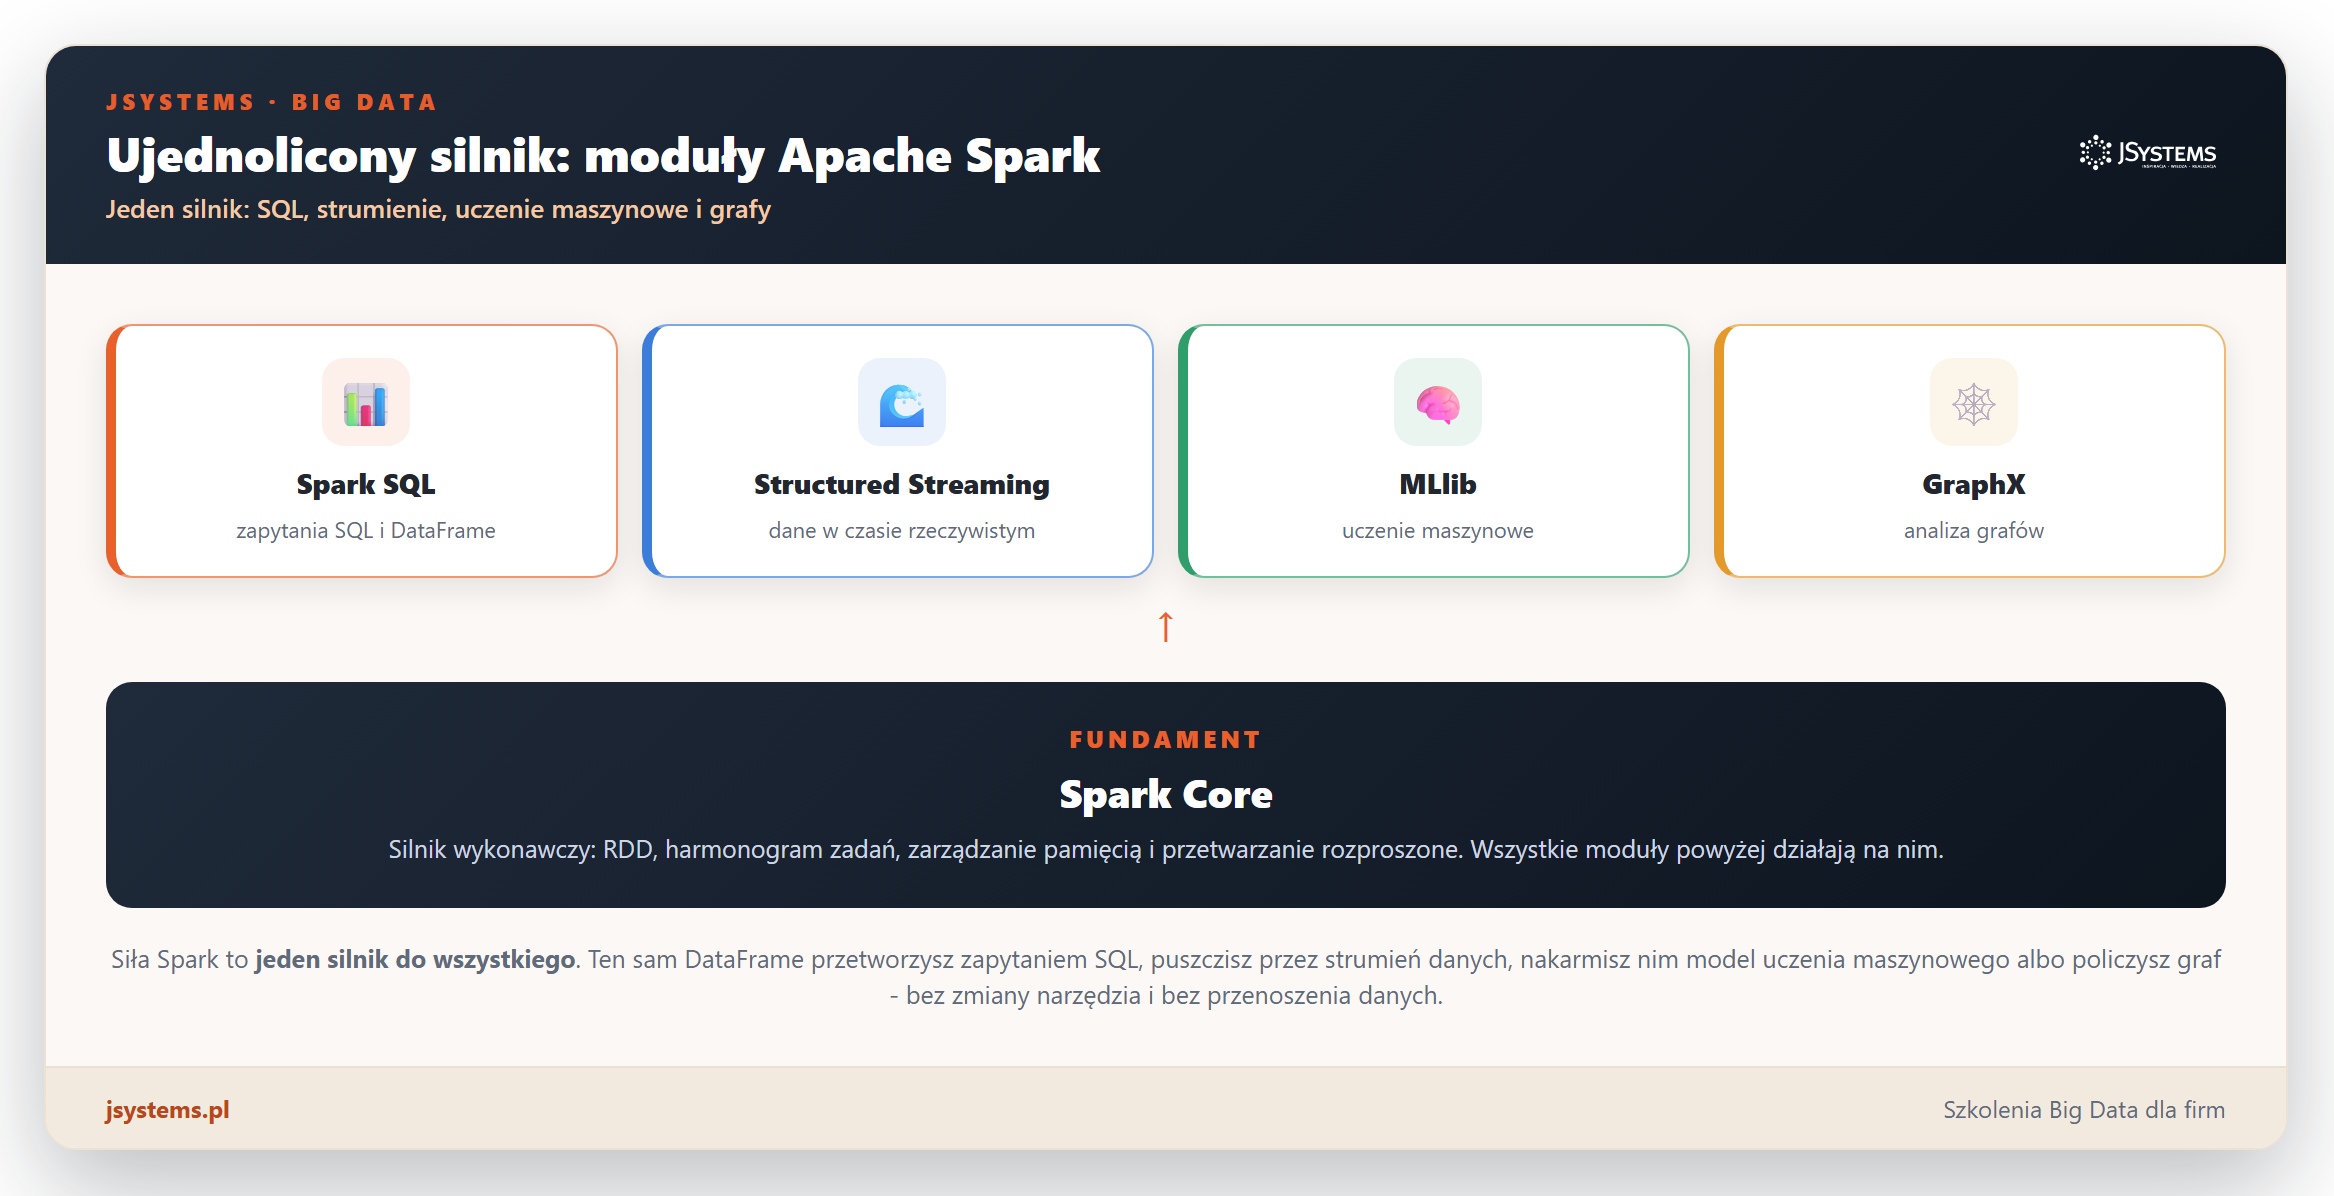
Wszystko to opiera się na Spark Core - silniku, który zarządza pamięcią, dzieli zadania i pilnuje ich wykonania na klastrze. Ta jednorodność to praktyczna przewaga: nie musisz spinać kilku różnych narzędzi ani przenosić danych między nimi.
Spark rzadko działa sam. Najczęściej jest silnikiem obliczeniowym w większej układance: czyta dane z rozproszonych magazynów, przetwarza je i oddaje gotowe wyniki dalej. Poniższa infografika pokazuje jego miejsce.
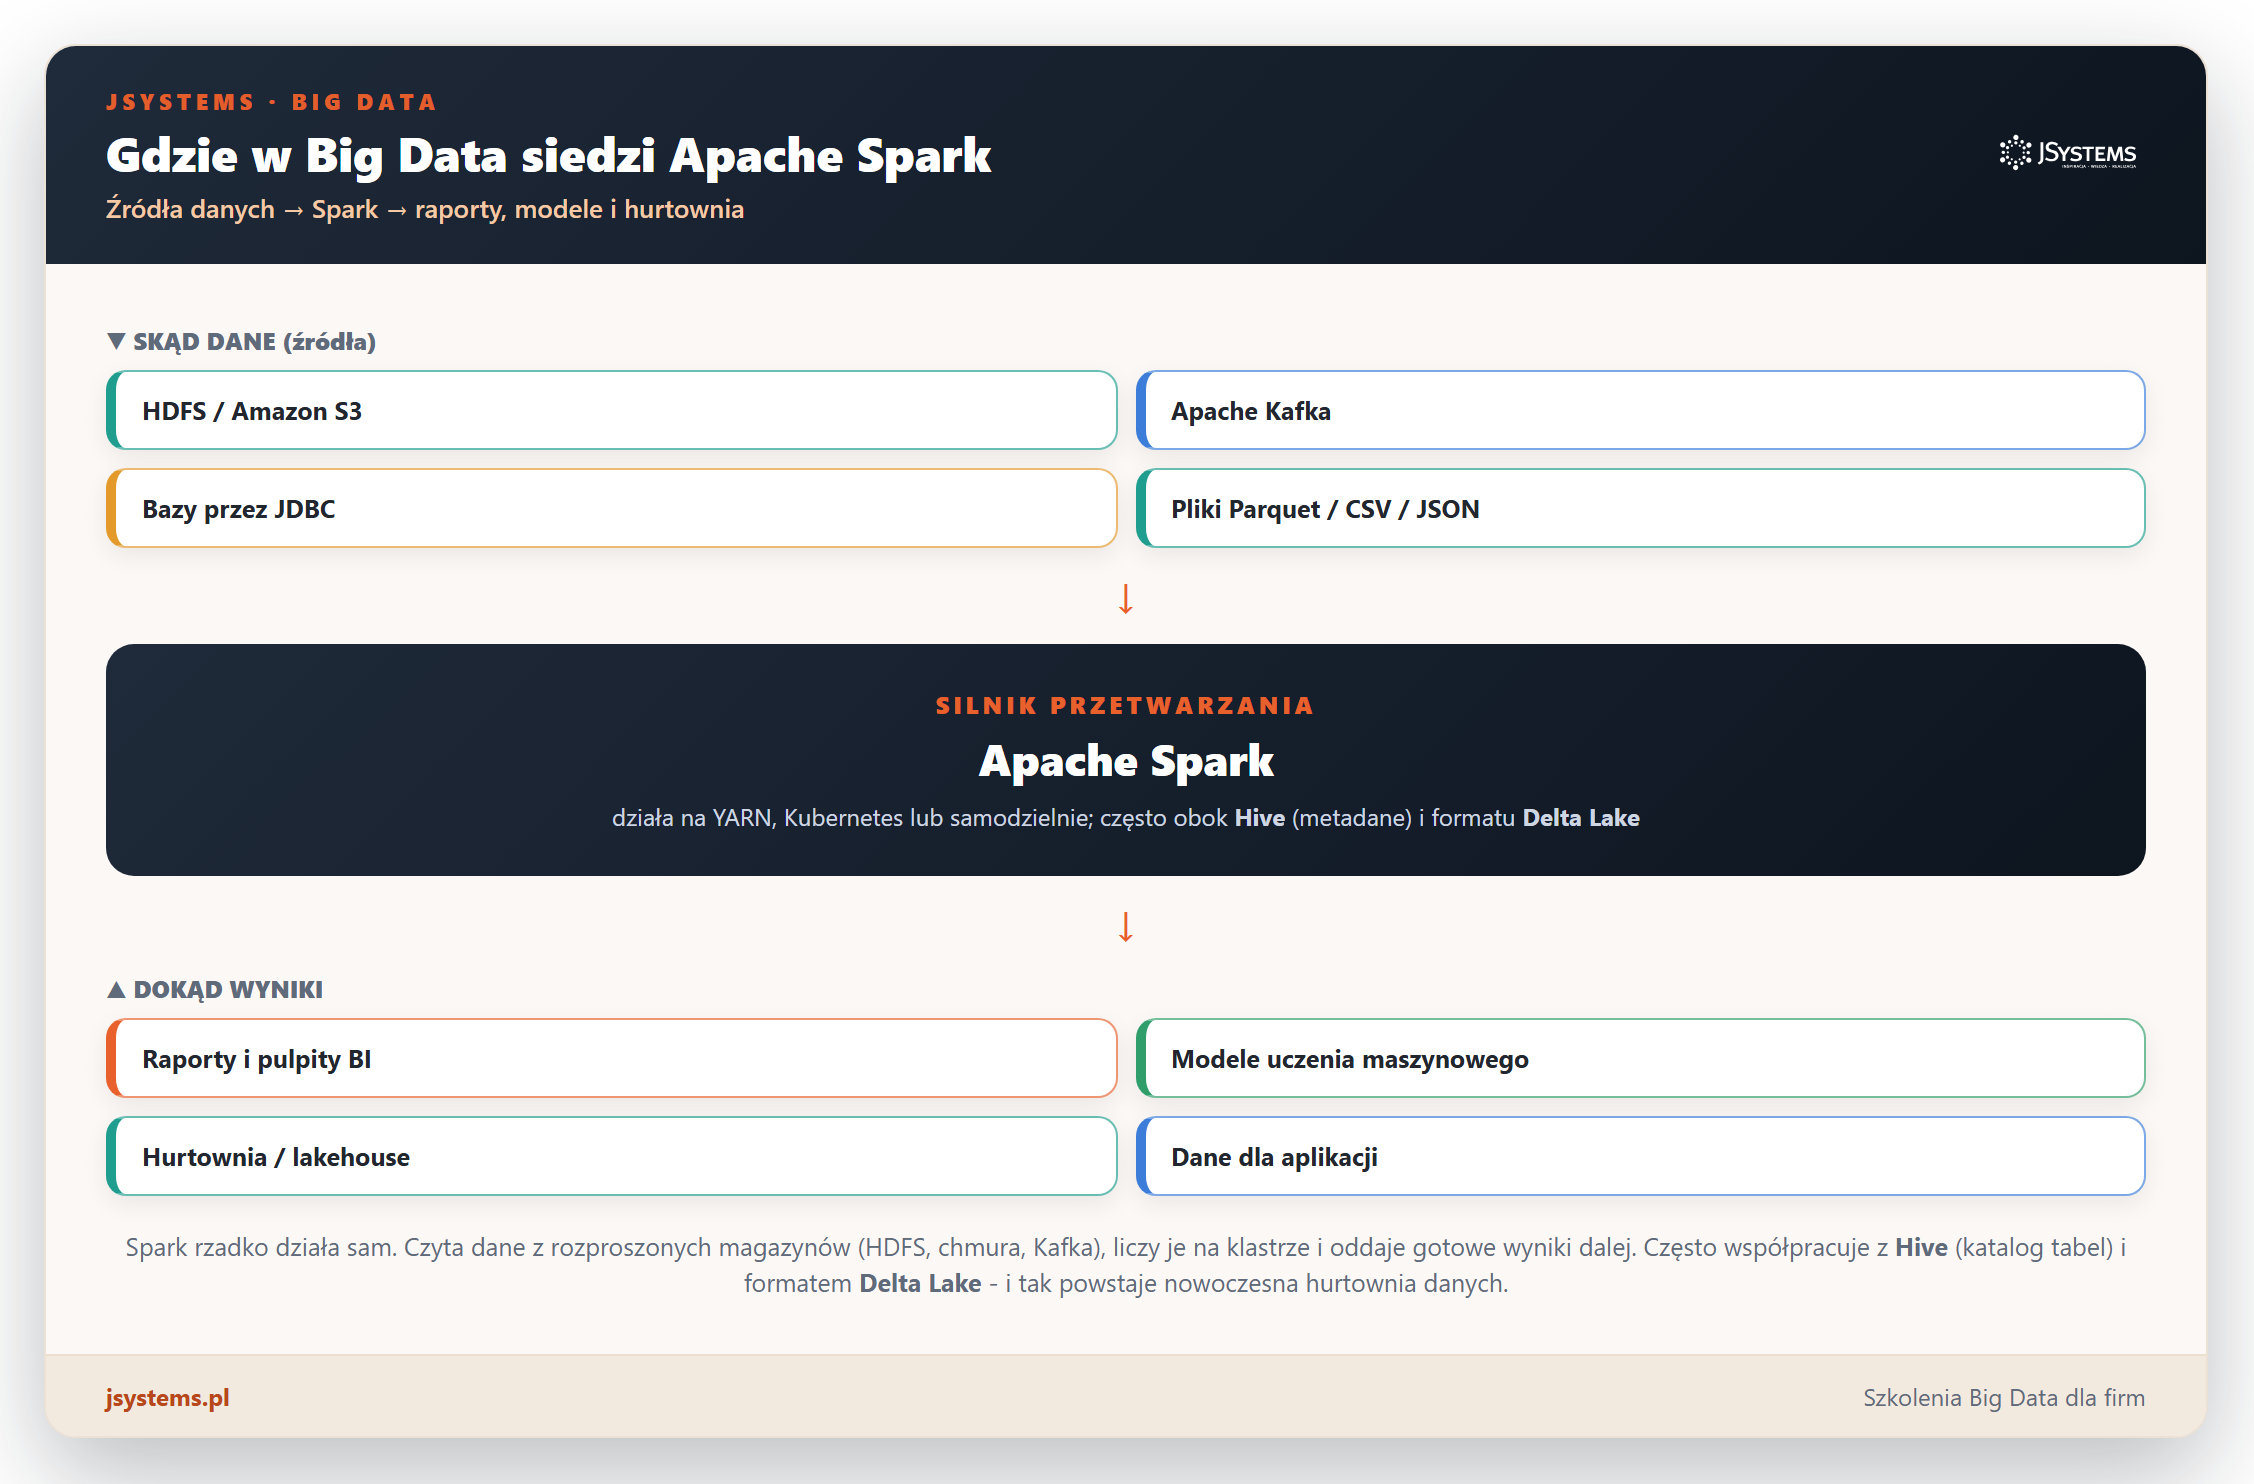
Spark świetnie współpracuje z resztą świata danych. Dane odczytuje z rozproszonego systemu plików HDFS, z magazynów chmurowych czy ze strumieni. Często stoi obok hurtowni Apache Hive, z której korzysta jako katalogu tabel, i coraz częściej zapisuje dane w formacie Delta Lake, tworząc nowoczesną hurtownię typu lakehouse. Wyniki jego pracy trafiają dalej - do analizy danych w Pythonie z biblioteką pandas, do narzędzi typu Power BI, czy do hurtowni w chmurze takich jak BigQuery. Spark jest w tym łańcuchu tym elementem, który potrafi przemielić naprawdę duże wolumeny. Skoro Spark tak często stoi obok Hive, warto wiedzieć, kiedy który się sprawdzi - rozkładamy to na czynniki pierwsze w artykule Apache Spark kontra Apache Hive - które narzędzie Big Data wybrać.
Skoro wiemy już, co Spark potrafi, odpowiedzmy na pytanie, które zadaje sobie każdy początkujący: czy to narzędzie dla mnie? Poniższa infografika podsumowuje decyzję.
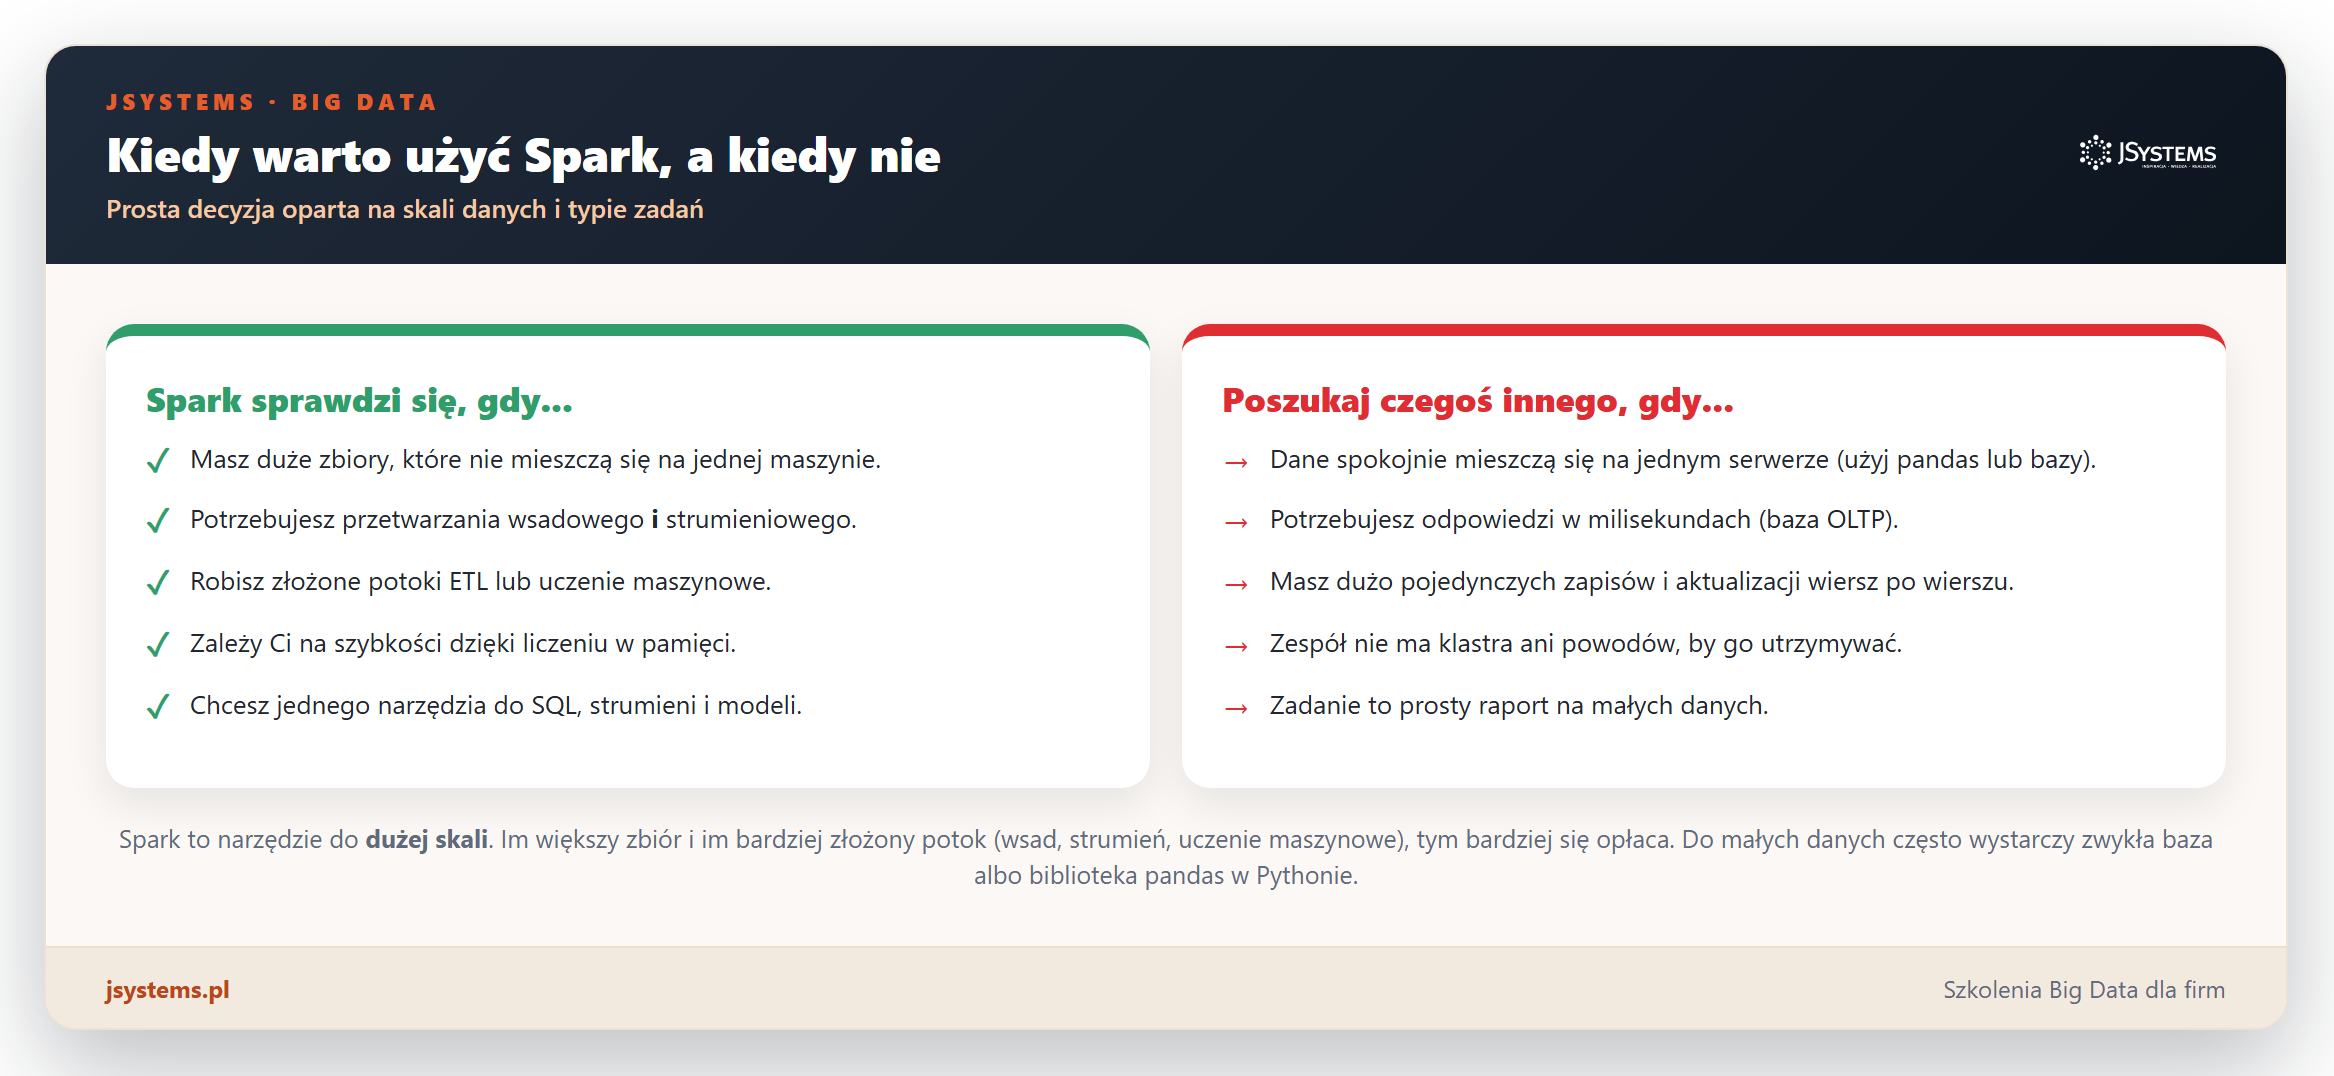
Reguła kciuka jest prosta. Sięgnij po Spark, gdy dane nie mieszczą się wygodnie na jednej maszynie, gdy budujesz złożone potoki przetwarzania (wsadowe albo strumieniowe), gdy robisz uczenie maszynowe na dużą skalę albo gdy zależy Ci na szybkości dzięki liczeniu w pamięci. Poszukaj czegoś innego, gdy zbiory są małe i spokojnie mieszczą się na jednym serwerze - wtedy zwykła baza danych albo biblioteka pandas w Pythonie będzie prostsza. Spark nie zastąpi też bazy transakcyjnej tam, gdzie potrzebujesz odpowiedzi w milisekundach i wielu pojedynczych zapisów - to zupełnie inny rodzaj pracy.
Dobra wiadomość jest taka, że Spark można dziś odpalić na własnym laptopie w kilka minut, bez stawiania klastra. Wystarczy Python i jedno polecenie instalacji.
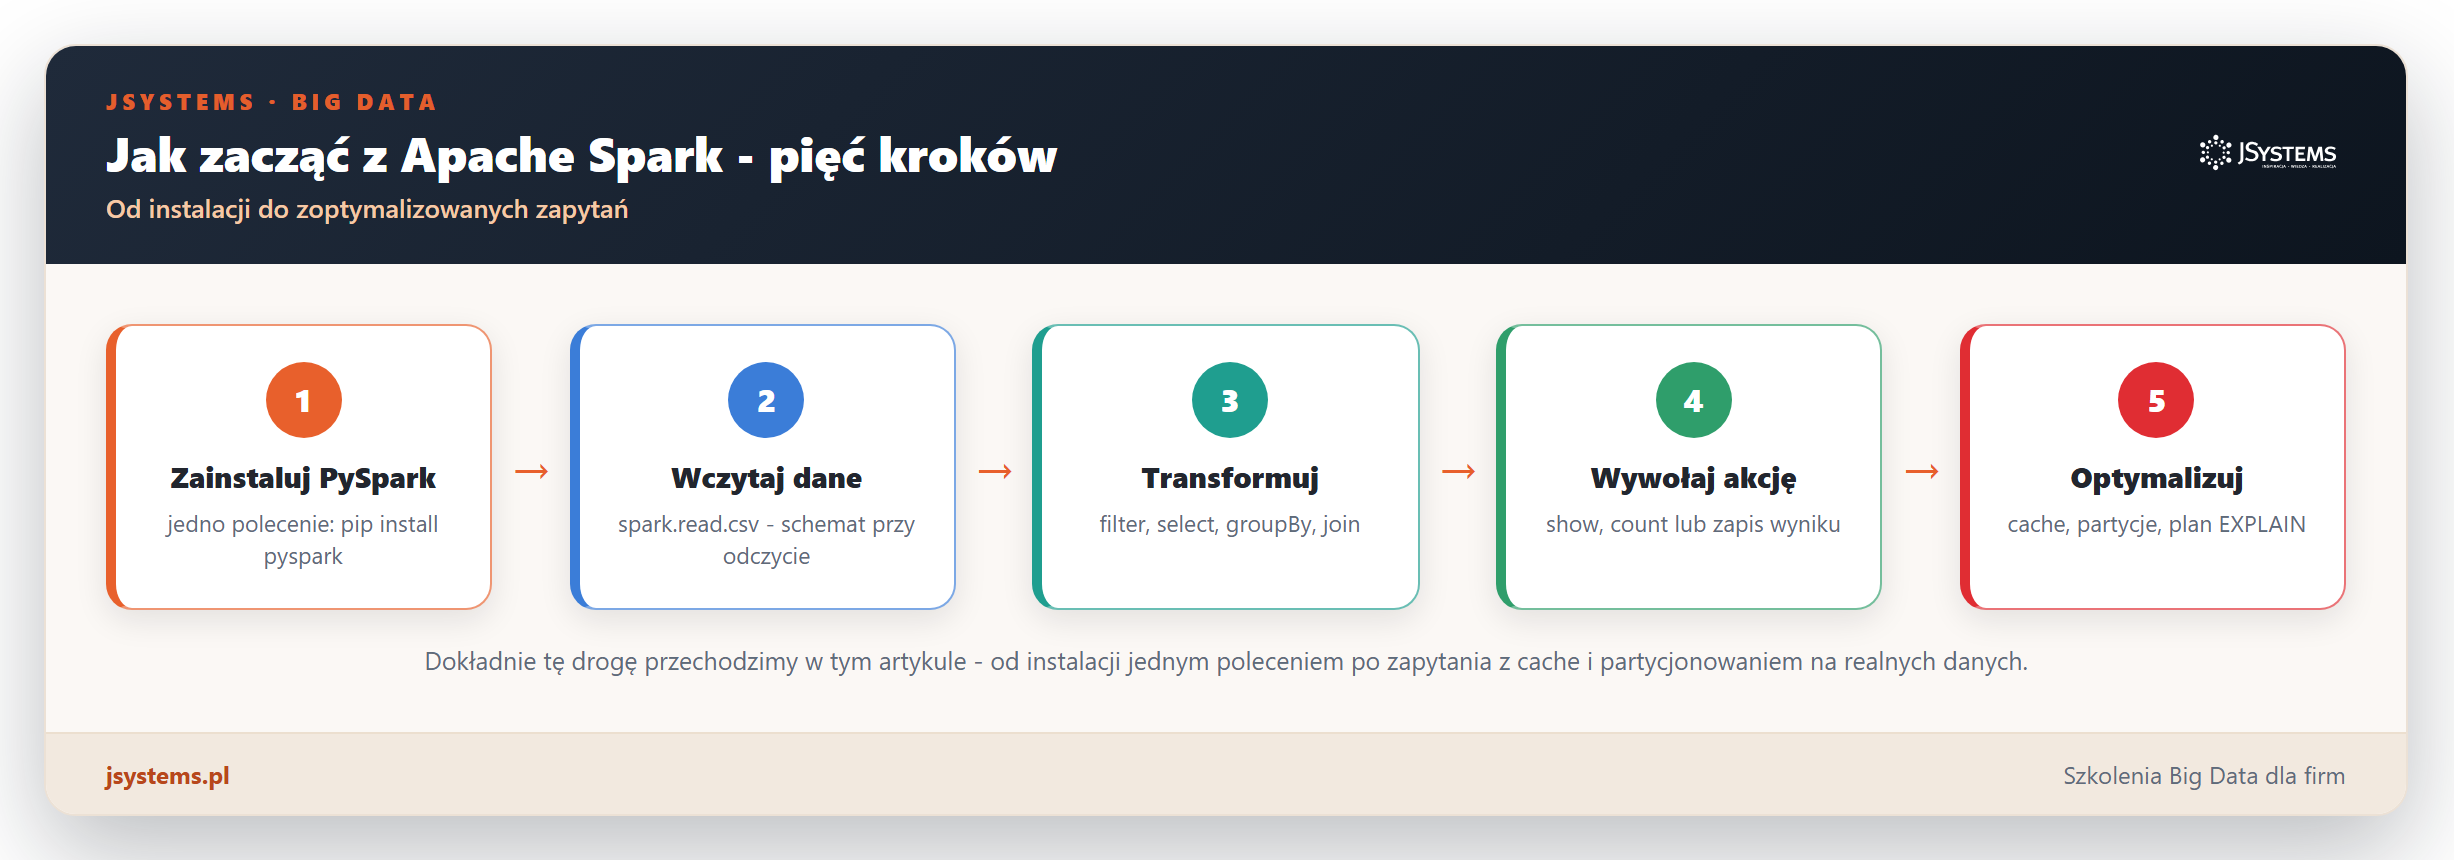
Cały Spark z API DataFrame i Spark SQL dostaniesz jednym poleceniem w Pythonie:
# instalacja PySpark w srodowisku Python
pip install pyspark

# w kodzie: utworz sesje i wczytaj dane
from pyspark.sql import SparkSession
spark = SparkSession.builder.master("local[*]").getOrCreate()
df = spark.read.csv("sprzedaz.csv", header=True, inferSchema=True)
df.show()
Zapis local[*] mówi Sparkowi, żeby uruchomił się lokalnie i wykorzystał wszystkie rdzenie Twojego procesora - każdy zadziała jak mały executor. Od tego momentu możesz wczytywać dane, pisać transformacje i wywoływać akcje dokładnie tak, jak pokazaliśmy w tym artykule. To najprostszy sposób, żeby poznać Spark bez inwestowania w infrastrukturę.
Apache Spark to szybki, rozproszony silnik do przetwarzania dużych zbiorów danych, którego przewagą jest liczenie w pamięci (in-memory) zamiast ciągłego zapisywania na dysk. Jego fundamenty to architektura z Driverem i executorami, warstwy abstrakcji nad danymi (RDD, DataFrame i Dataset), leniwe wykonanie (transformacje budują plan, dopiero akcja go uruchamia) oraz optymalizator Catalyst, który układa najlepszy plan zapytania. Spark to jednocześnie jeden silnik do wielu zadań - SQL, strumieni, uczenia maszynowego i grafów - a jego przykłady najwygodniej pisze się w Pythonie przez PySpark. Najlepsze w tym wszystkim jest to, że całość możesz dziś przećwiczyć na własnym komputerze po jednym poleceniu instalacji - a stąd już blisko do pracy z prawdziwym Big Data.
To szkolenie może być dofinansowane dla Ciebie z KFS lub BUR. Ma terminy gwarantowane.
To szkolenie może być dofinansowane dla Ciebie z KFS lub BUR.


Komentarze (0)
Brak komentarzy...