Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!

Jeśli zaczynasz przygodę z analizą danych, prędzej czy później usłyszysz nazwę BigQuery. Dla jednych to tajemnicza usługa Google, do której firmy wrzucają terabajty danych. W rzeczywistości to jedno z najprostszych wejść w świat wielkich danych: piszesz zwykłe zapytanie SQL, klikasz i w kilka sekund dostajesz odpowiedź przeliczoną na tysiącach maszyn - a sam nie zarządzasz żadnym serwerem. W tym przewodniku wytłumaczymy od zera, czym jest BigQuery, po co powstał, jak działa i ile kosztuje, a wszystko pokażemy na prawdziwych zrzutach z konsoli.
Z tego artykułu dowiesz się:
Najprościej: BigQuery to chmurowa hurtownia danych Google - miejsce, w którym trzymasz ogromne ilości danych i przeszukujesz je zwykłym językiem SQL, nie martwiąc się o żaden serwer. Hurtownia danych (po angielsku data warehouse) to specjalny rodzaj bazy przystosowany nie do obsługi aplikacji, lecz do analizy: liczenia sum, średnich, trendów i raportów na wielkich zbiorach.
Najważniejsze w BigQuery jest słowo bezserwerowy (po angielsku serverless). Nie instalujesz bazy, nie kupujesz maszyny, nie pilnujesz aktualizacji. Otwierasz stronę w przeglądarce, piszesz zapytanie, a Google na czas jego wykonania sam dokłada moc obliczeniową z tysięcy komputerów i zwalnia ją, gdy skończysz. Dzięki temu zapytanie, które na jednym serwerze liczyłoby się godzinami, tutaj kończy się w sekundy.
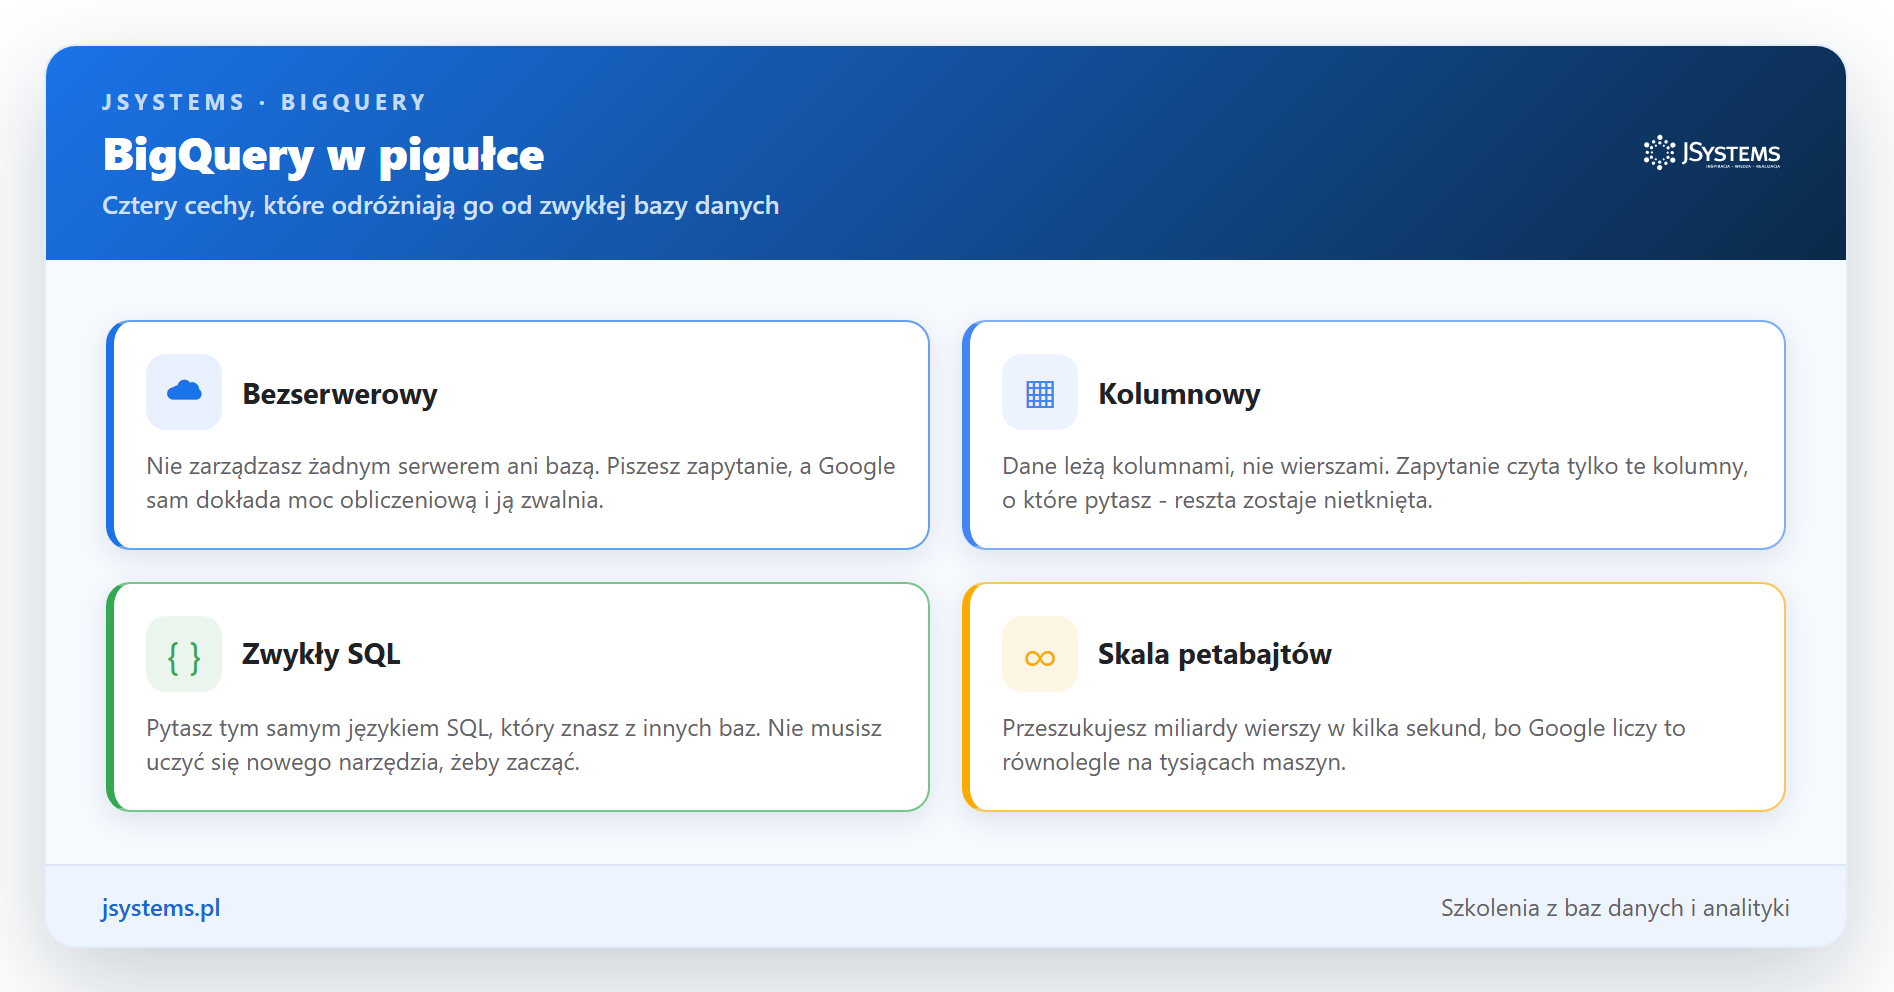
Cała reszta wynika z tych czterech cech. BigQuery jest kolumnowy, czyli trzyma dane kolumnami, a nie wierszami - dzięki temu czyta z dysku tylko te kolumny, o które pytasz. Rozmawiasz z nim zwykłym SQL, więc jeśli znasz podstawy zapytań z jakiejkolwiek innej bazy, od razu ruszasz. I działa w skali petabajtów: te same zapytania równie sprawnie chodzą na tysiącu wierszy, jak i na miliardach.
Można pomyśleć, że hurtownia danych to zabawka wyłącznie dla wielkich korporacji. Tak było kilkanaście lat temu, gdy trzeba było kupić drogie serwery. Dziś próg wejścia jest tak niski, że BigQuery przydaje się bardzo różnym osobom:
Wspólny mianownik jest jeden: BigQuery oszczędza czas i pieniądze. Zadanie, które kiedyś wymagało zespołu administratorów i tygodni przygotowań, dziś sprowadza się do napisania kilku linijek SQL. Zanim jednak napiszemy pierwsze zapytanie, warto zrozumieć, czym hurtownia różni się od zwykłej bazy - bo to najczęstsze źródło nieporozumień.
To pytanie pada najczęściej: skoro mam już bazę danych, po co mi jeszcze BigQuery? Odpowiedź jest taka, że to dwa narzędzia do dwóch różnych zadań. Fachowo mówi się o dwóch trybach pracy: OLTP i OLAP.
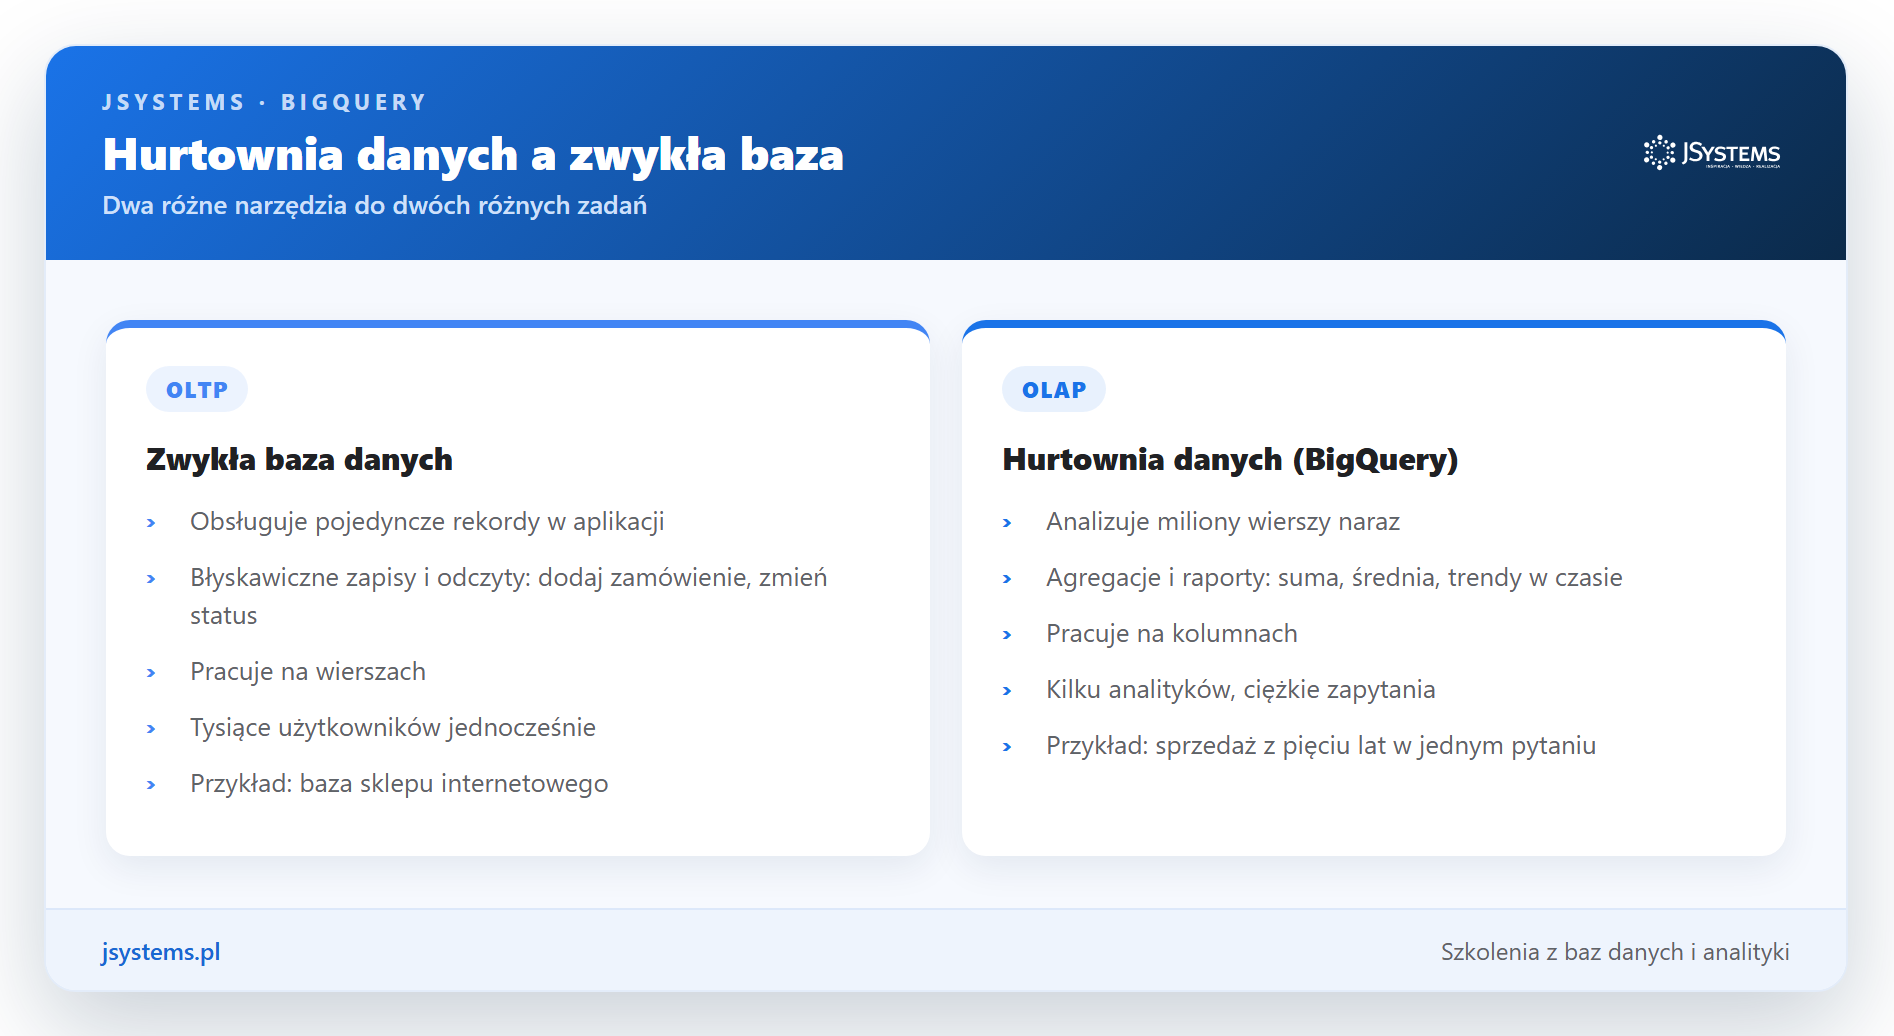
OLTP (przetwarzanie transakcji, po angielsku Online Transaction Processing) to zwykła baza za Twoją aplikacją - PostgreSQL, MySQL, Oracle. Jej zadanie to obsługa mnóstwa drobnych, szybkich operacji: dodaj zamówienie, zmień status, pobierz dane jednego klienta. Pracuje na wierszach i musi odpowiadać błyskawicznie tysiącom użytkowników jednocześnie.
OLAP (przetwarzanie analityczne, po angielsku Online Analytical Processing) to właśnie hurtownia danych jak BigQuery. Tu nie chodzi o pojedynczy rekord, tylko o pytania w rodzaju: ile sprzedaliśmy w każdym miesiącu przez ostatnie pięć lat, w podziale na regiony. Takie zapytanie dotyka milionów wierszy naraz i liczy z nich agregaty. Więcej o tym, kiedy sięgać po bazę relacyjną, a kiedy po inne rozwiązanie, znajdziesz w naszym porównaniu baz danych SQL kontra NoSQL.
W praktyce te dwa światy współpracują: aplikacja zapisuje bieżące dane do zwykłej bazy, a co jakiś czas ich kopia trafia do hurtowni, gdzie analitycy spokojnie liczą ciężkie raporty, nie obciążając bazy produkcyjnej.
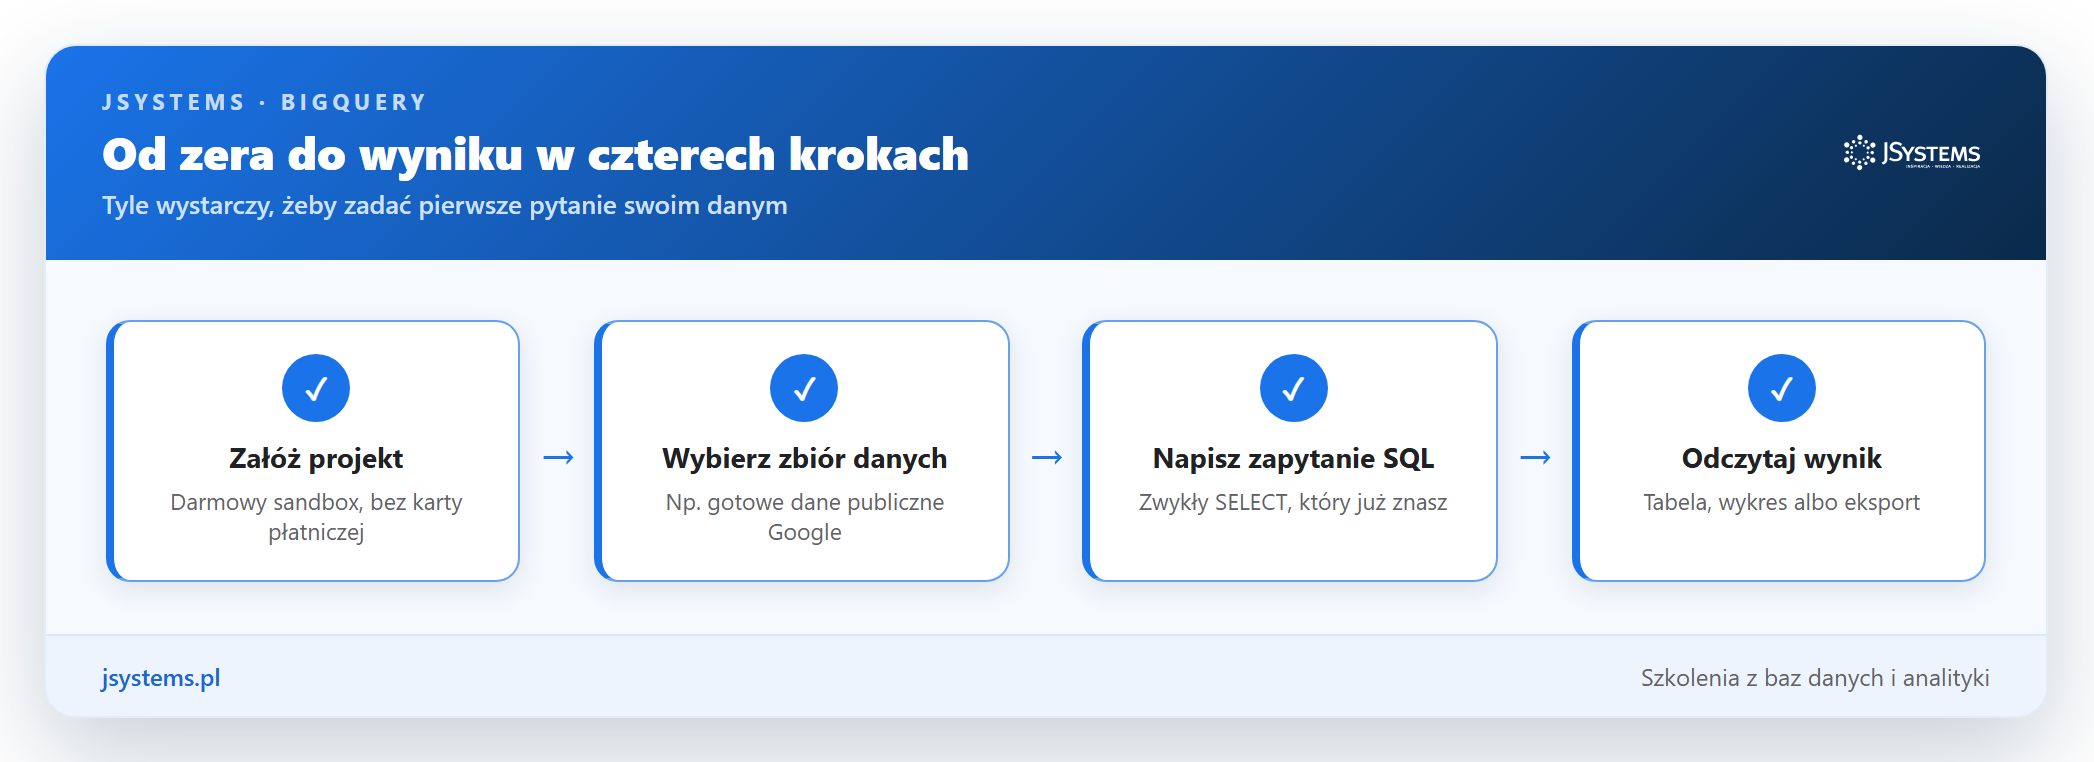
Najlepsze w BigQuery jest to, że możesz go dotknąć od ręki i za darmo. Google udostępnia tryb sandbox (piaskownica) - konto do zabawy, które nie wymaga podawania karty płatniczej. Wystarczy konto Google. Cała droga od zera do pierwszego wyniku ma tylko cztery kroki:
Żeby nie zaczynać od pustej hurtowni, Google udostępnia dziesiątki gotowych publicznych zbiorów danych (projekt bigquery-public-data) - od imion nadawanych dzieciom, przez dane pogodowe, po statystyki z serwisu Stack Overflow. Możesz je od razu przeszukiwać, nie wgrywając niczego swojego. Po lewej stronie konsoli widać drzewo z tymi zbiorami, a po kliknięciu tabeli - jej strukturę:
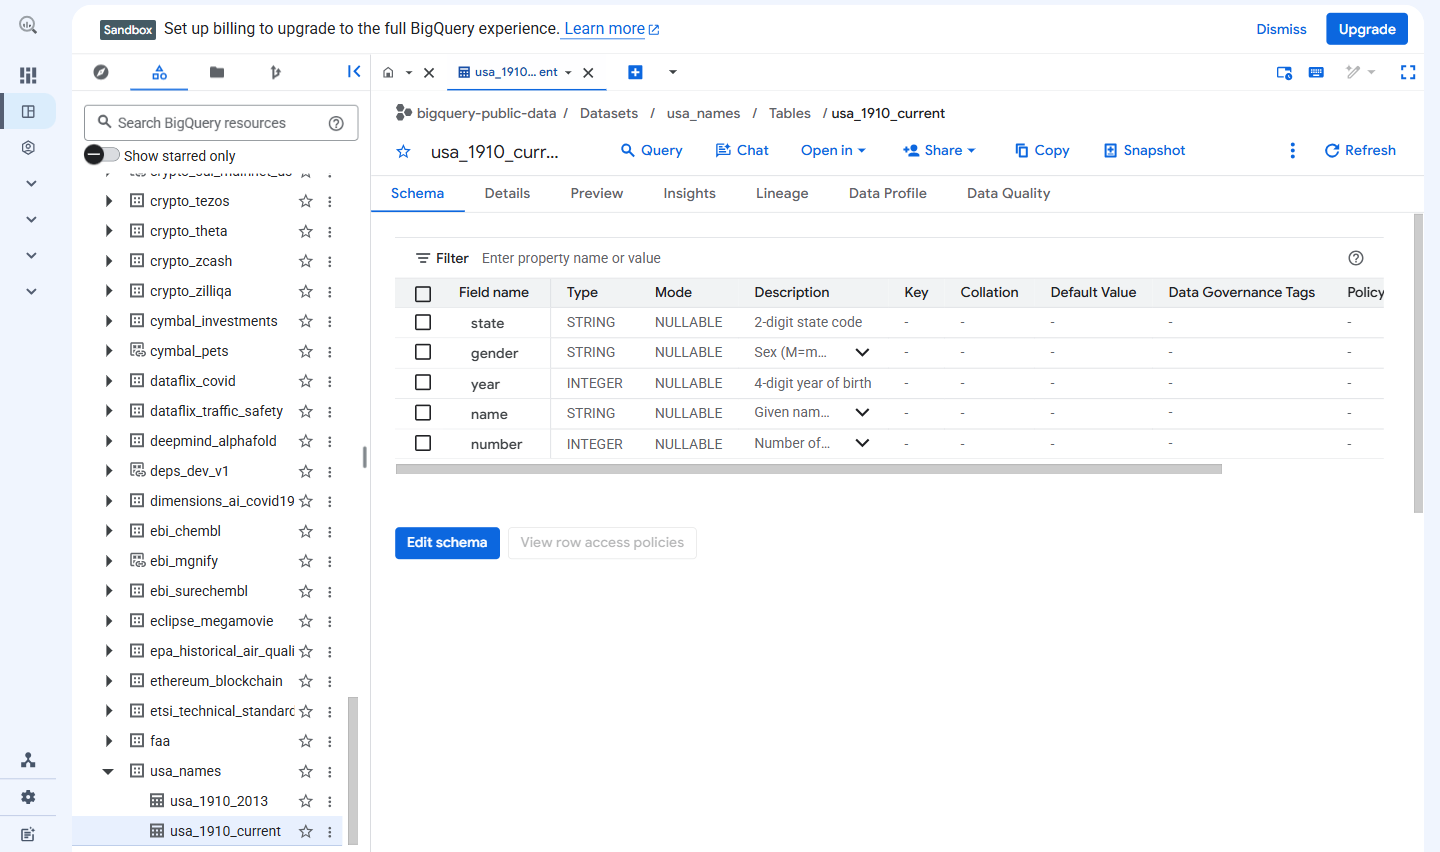
Zakładka Schema (schemat) to metryczka tabeli - mówi, jakie ma kolumny i jakiego są typu. W naszej przykładowej tabeli z amerykańskimi imionami są kolumny state (stan), gender (płeć), year (rok), name (imię) i number (liczba nadań). Obok, w zakładce Details (szczegóły), BigQuery pokazuje między innymi, ile tabela ma wierszy i ile miejsca zajmuje:
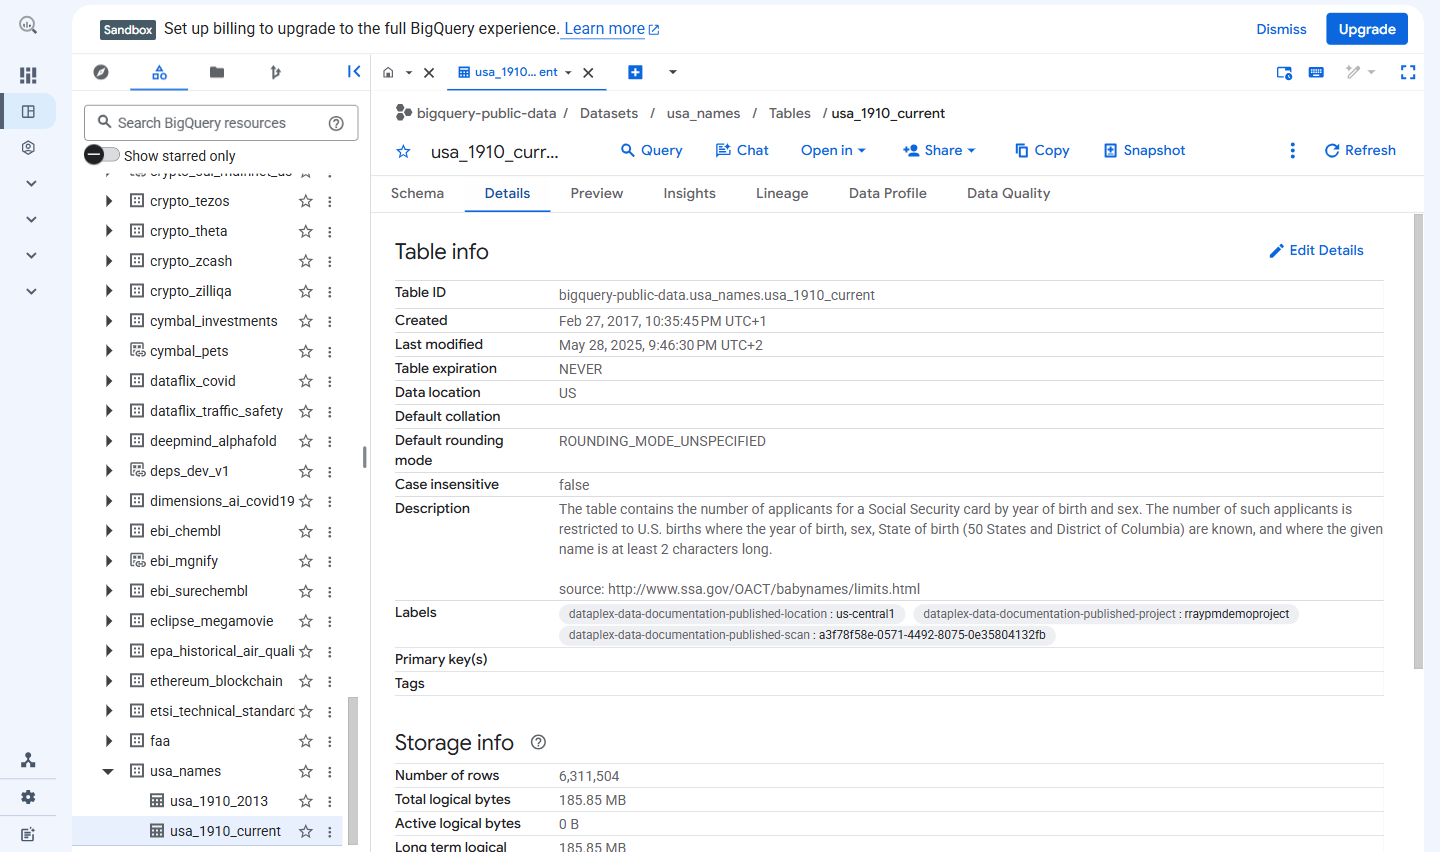
Ponad sześć milionów wierszy, a mimo to za chwilę przeszukamy je w ułamku sekundy. To dobry moment, żeby napisać pierwsze zapytanie.
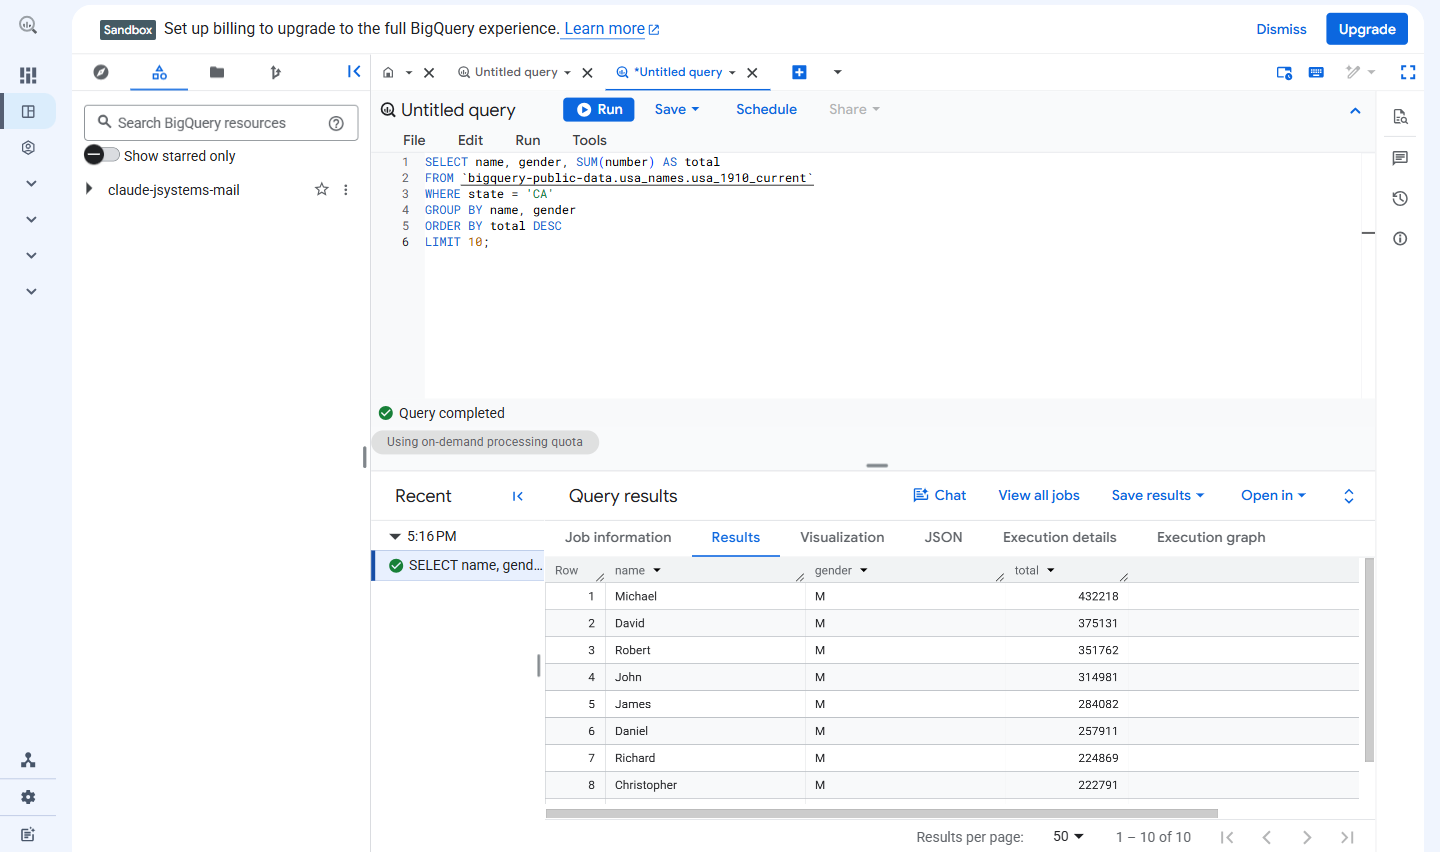
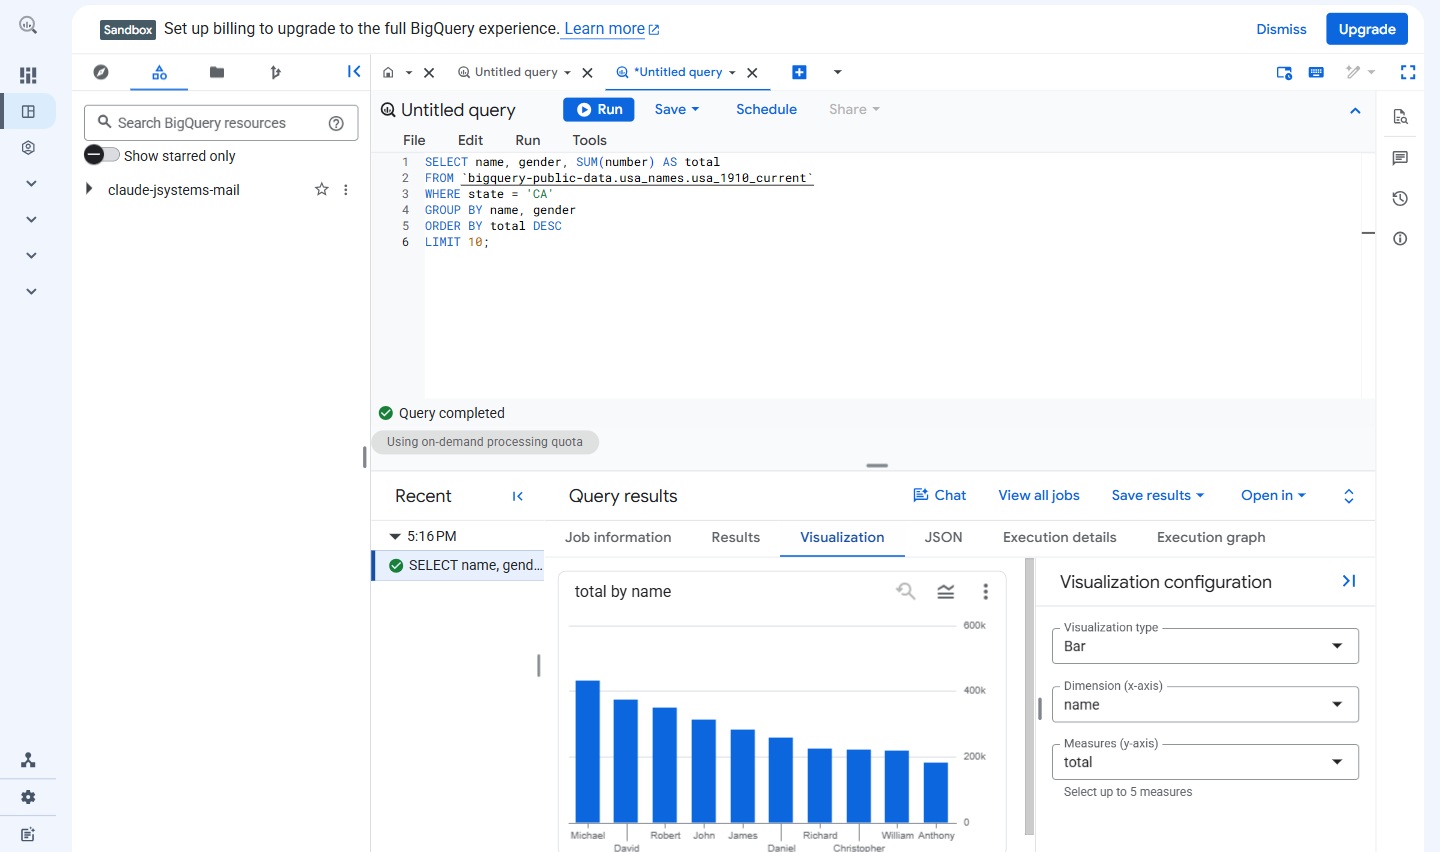
W BigQuery pytasz zwykłym SQL. Zobaczmy najprostszy przykład: sprawdźmy dziesięć najpopularniejszych imion w Kalifornii w całej historii tego zbioru. Wpisujemy zapytanie do edytora:
SELECT name, gender, SUM(number) AS total
FROM `bigquery-public-data.usa_names.usa_1910_current`
WHERE state = 'CA'
GROUP BY name, gender
ORDER BY total DESC
LIMIT 10;
Jeśli pisałeś kiedykolwiek zapytanie SQL, wszystko tu jest znajome. Jedyny nietypowy element to nazwa tabeli w odwrotnych apostrofach: projekt.zbior.tabela. To pełny adres tabeli w BigQuery - najpierw projekt (bigquery-public-data), potem zbiór danych (usa_names), na końcu sama tabela. Klikamy Uruchom i po chwili dostajemy wynik, który widać było na pierwszym zrzucie na górze artykułu. Ten sam wynik możemy jednym kliknięciem pokazać jako wykres:
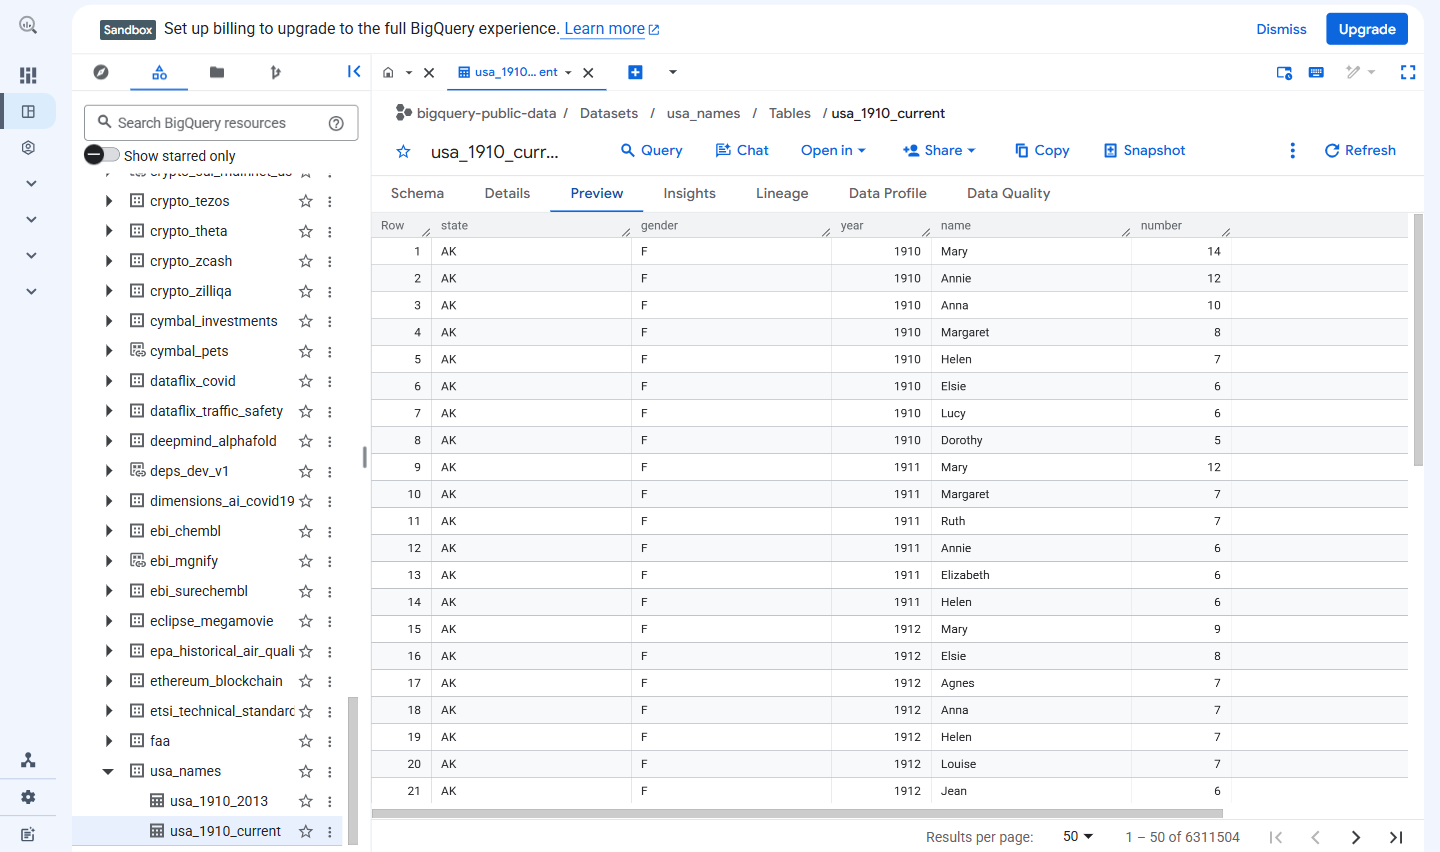
Zanim w ogóle napiszesz zapytanie, możesz też po prostu zajrzeć do danych. Zakładka Preview (podgląd) pokazuje pierwsze wiersze tabeli jak arkusz kalkulacyjny - i co ważne, taki podgląd nic nie kosztuje, bo nie uruchamia żadnego zapytania:
Chcesz przejść przez BigQuery krok po kroku, na żywych danych i pod okiem praktyka? Szkolenie Google BigQuery - podstawy prowadzi od pierwszego zapytania do analizy danych w chmurze.
Skąd bierze się prędkość BigQuery? Z dwóch pomysłów, które warto znać, nawet jeśli na co dzień o nich nie myślisz. Pierwszy to zrównoleglenie: gdy klikasz Uruchom, Twoje jedno zapytanie nie liczy się na jednej maszynie, tylko zostaje pocięte na drobne zadania rozdane setkom jednostek roboczych, które pracują naraz.
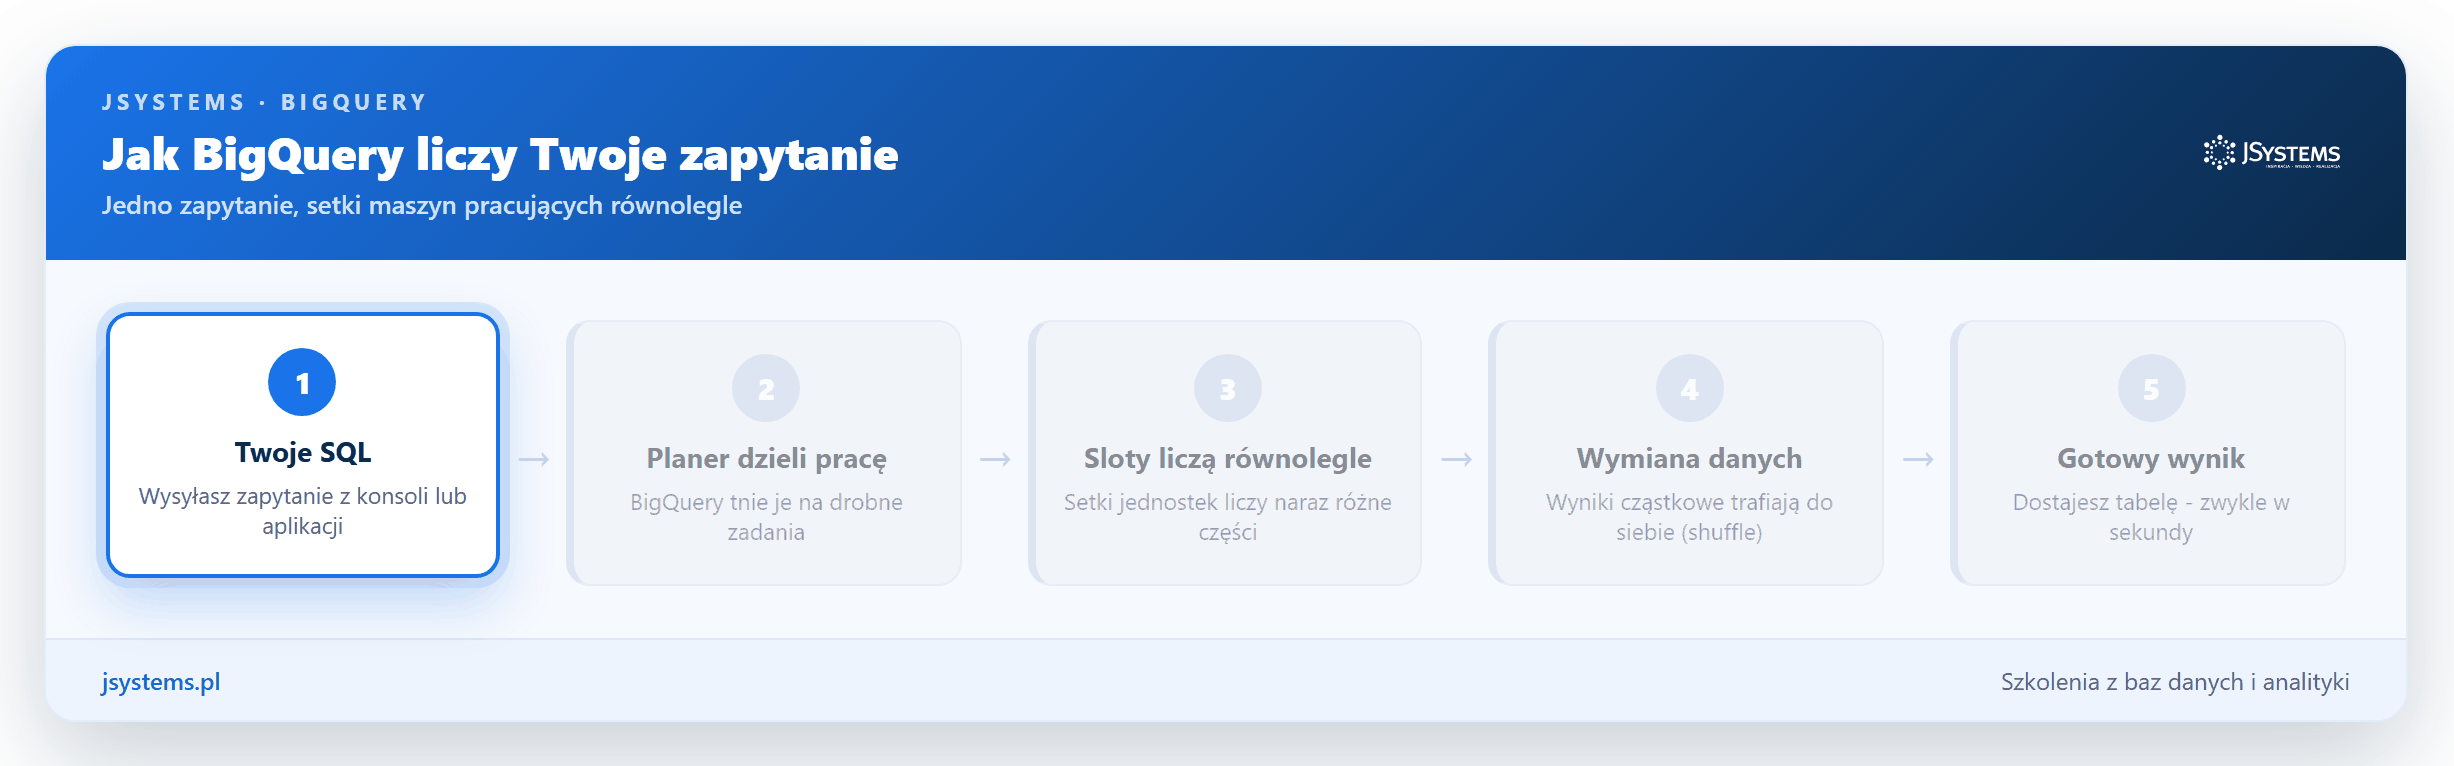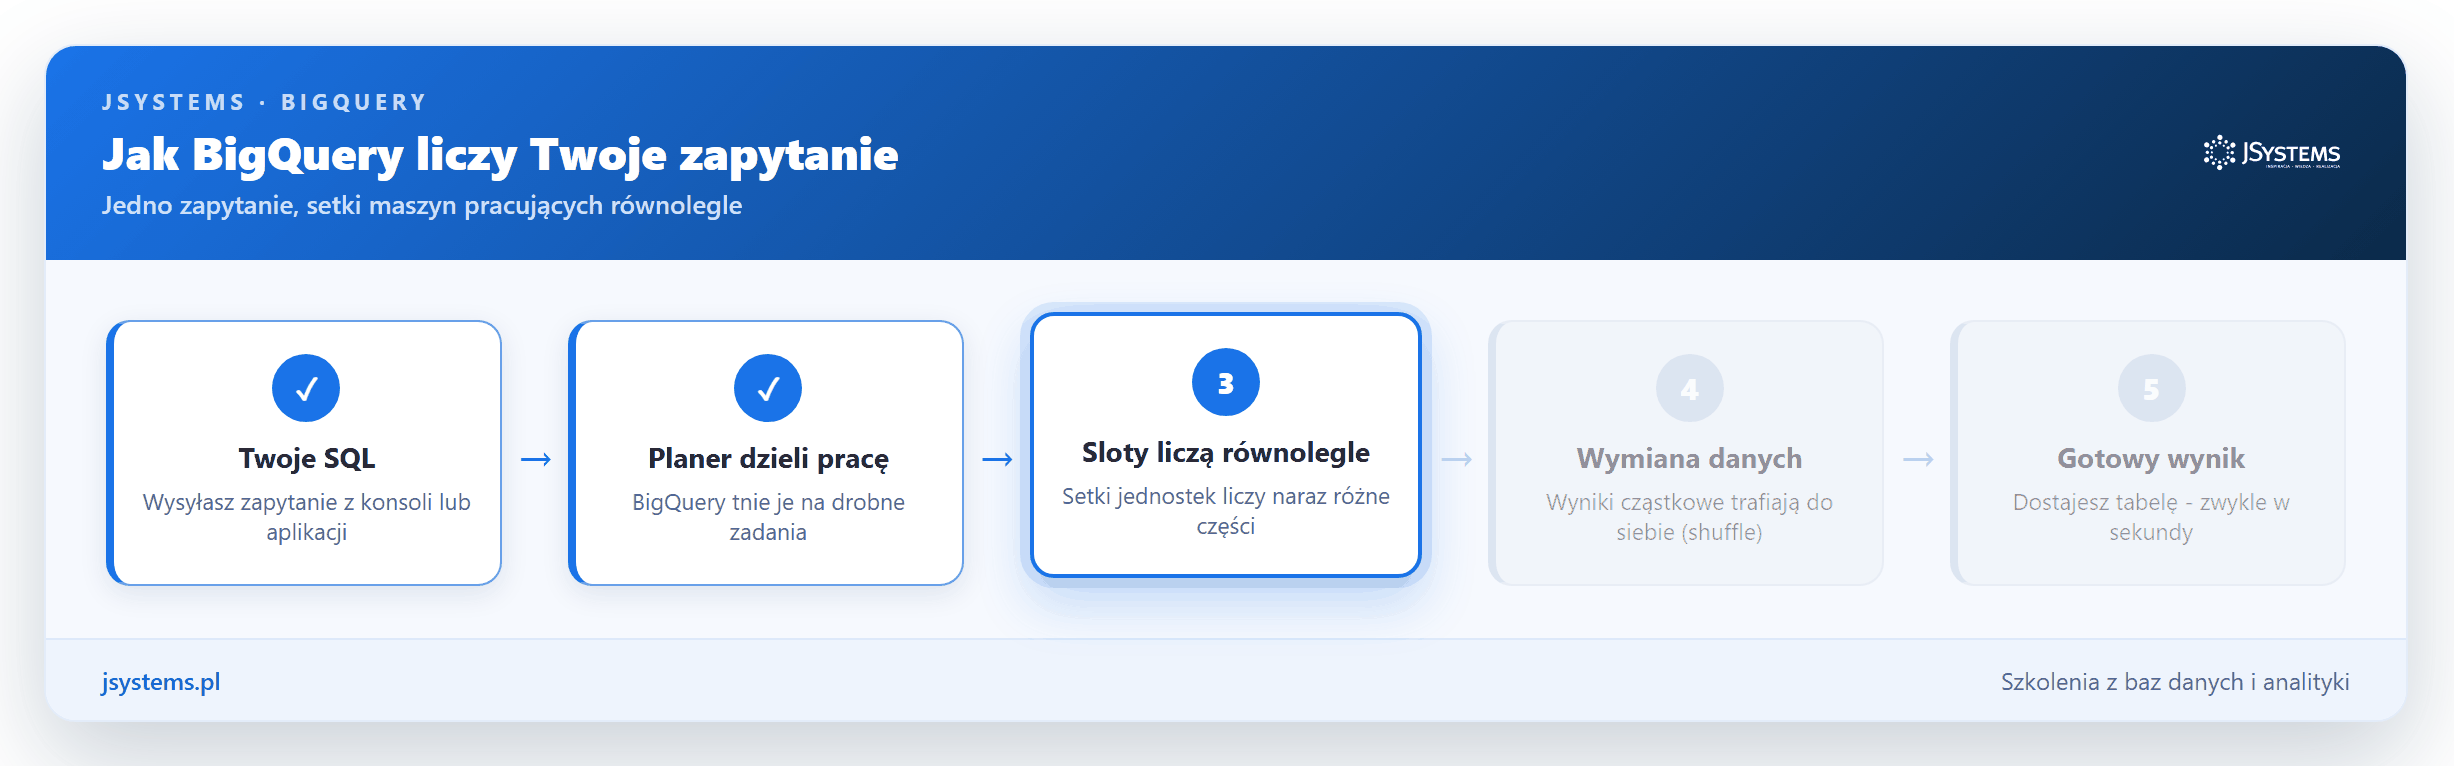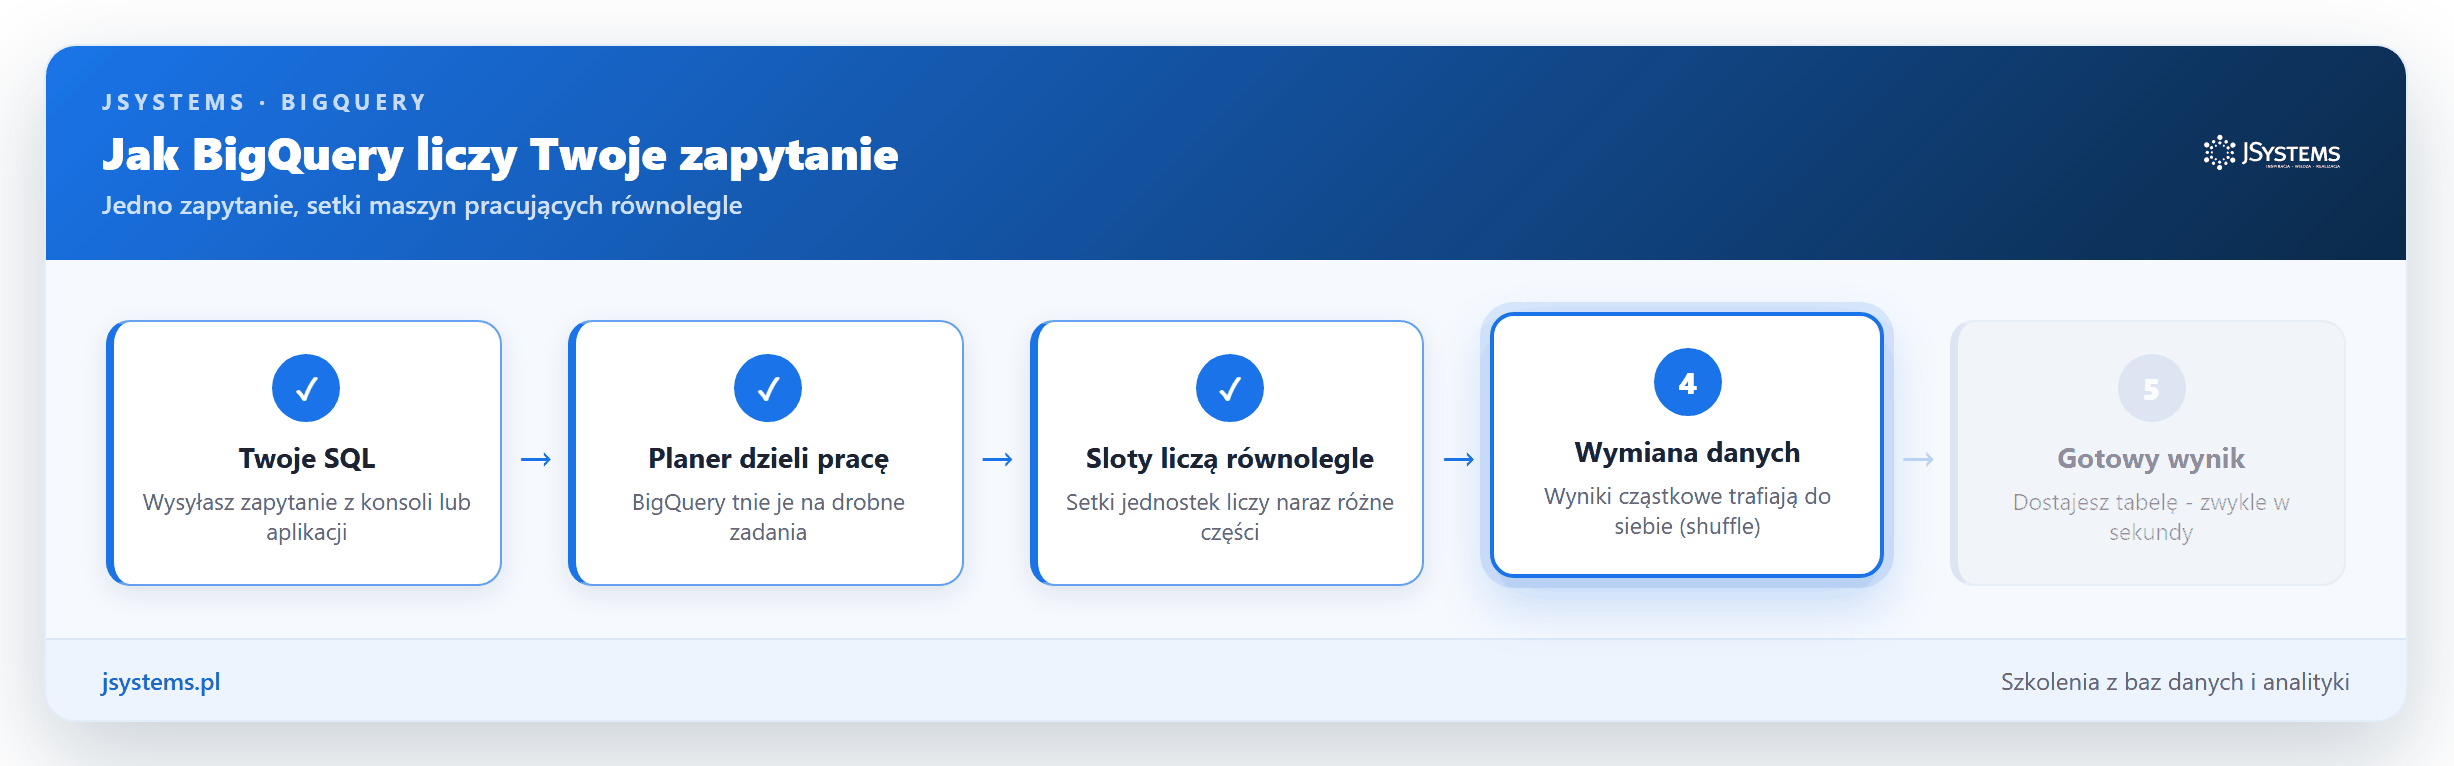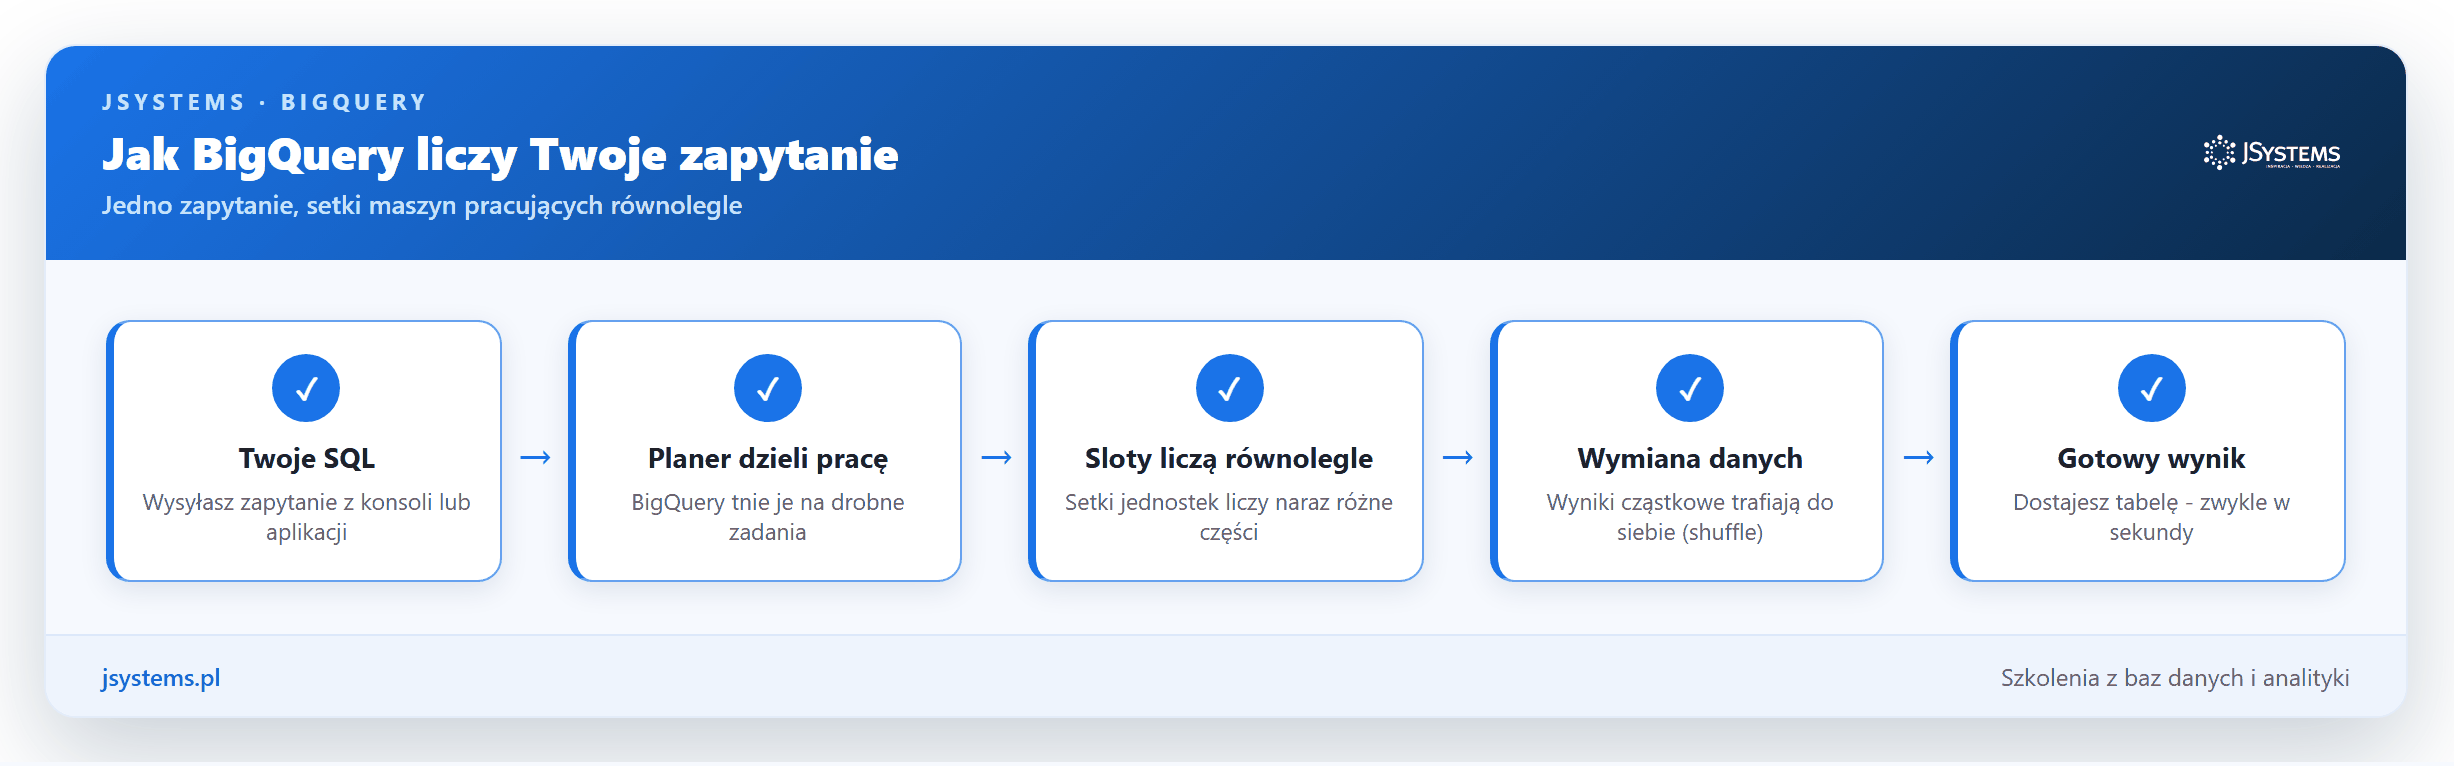
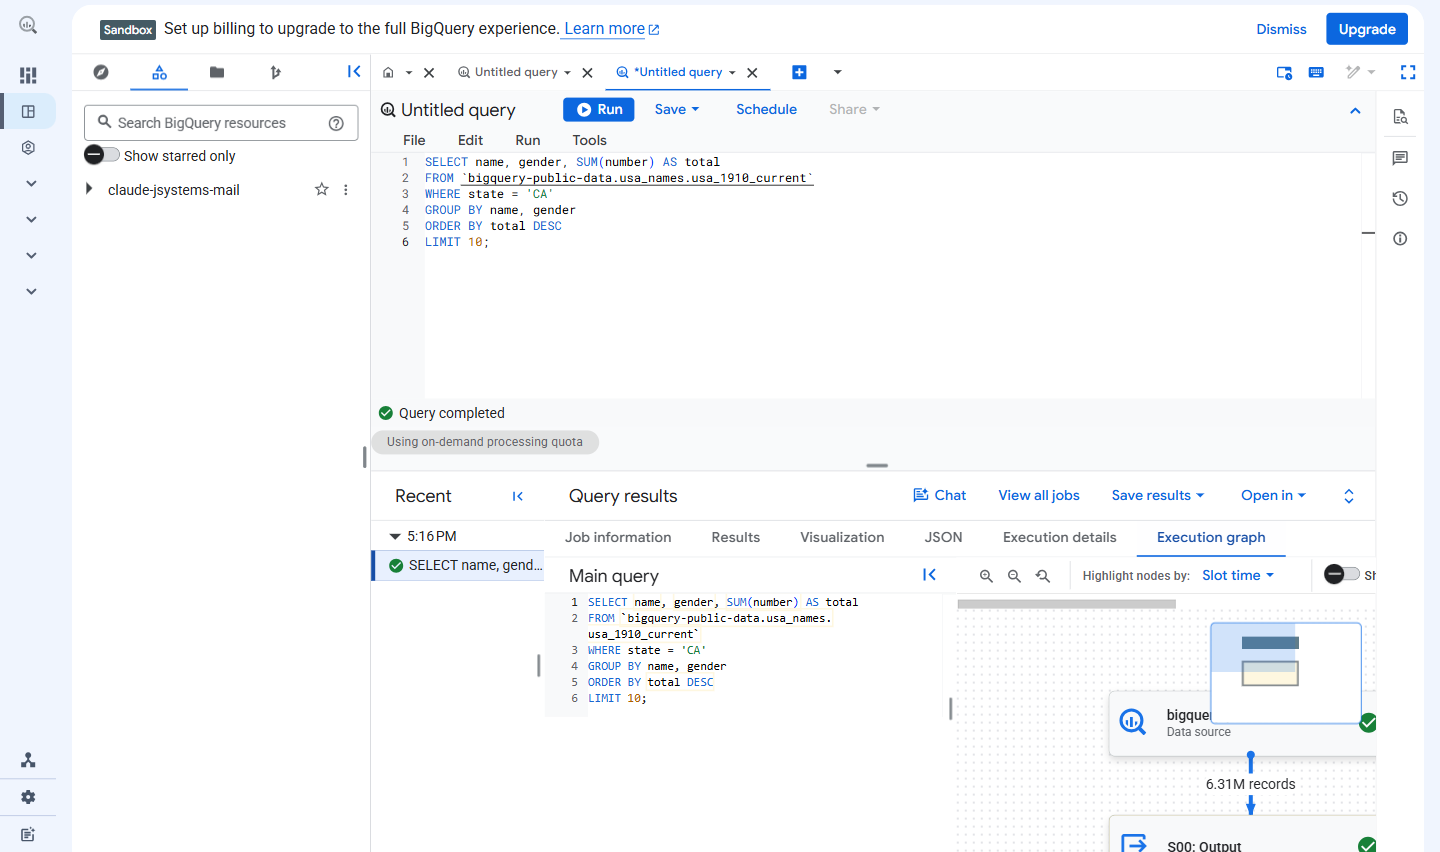
Te jednostki robocze to sloty (po angielsku slots) - jednostki mocy obliczeniowej BigQuery. Nie musisz nimi zarządzać, Google przydziela je na czas zapytania. Po drodze następuje jeszcze wymiana danych między etapami (fachowo shuffle), czyli przekazanie wyników cząstkowych tam, gdzie trzeba je zsumować. Cały ten plan zobaczysz w zakładce Execution graph (graf wykonania):
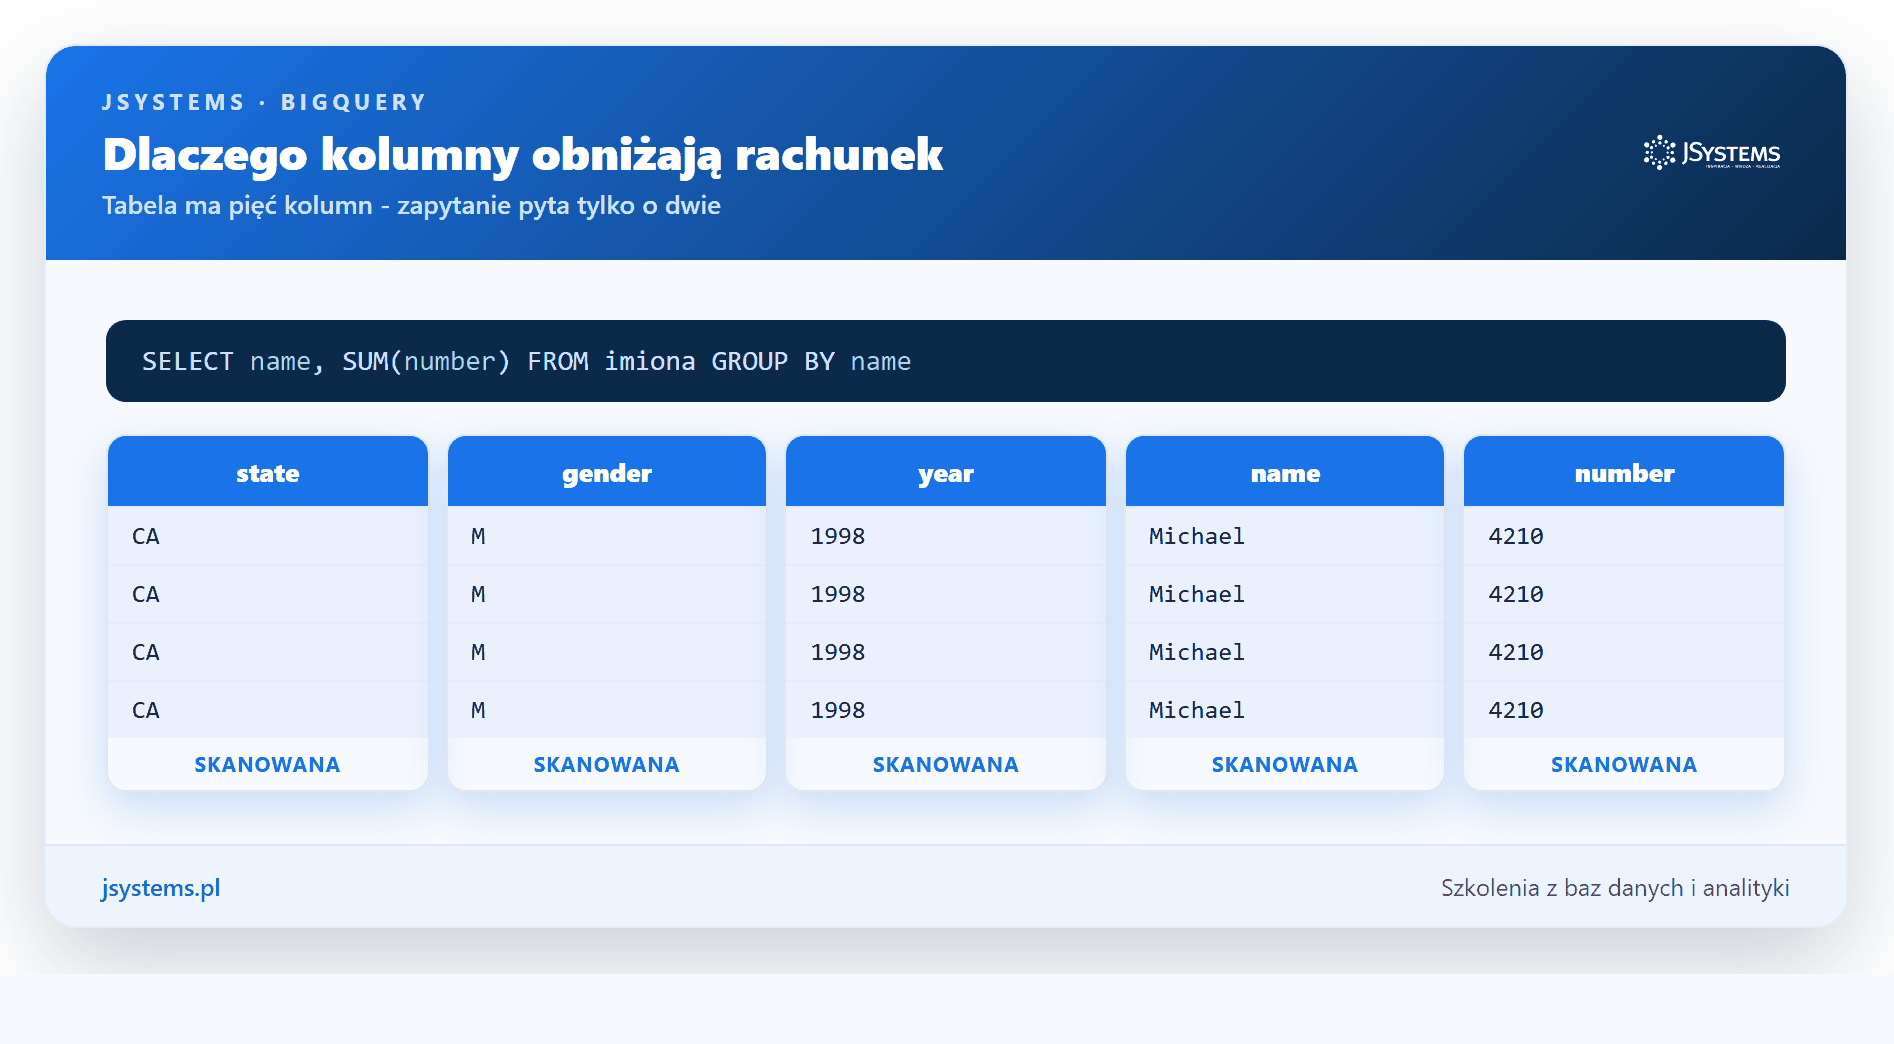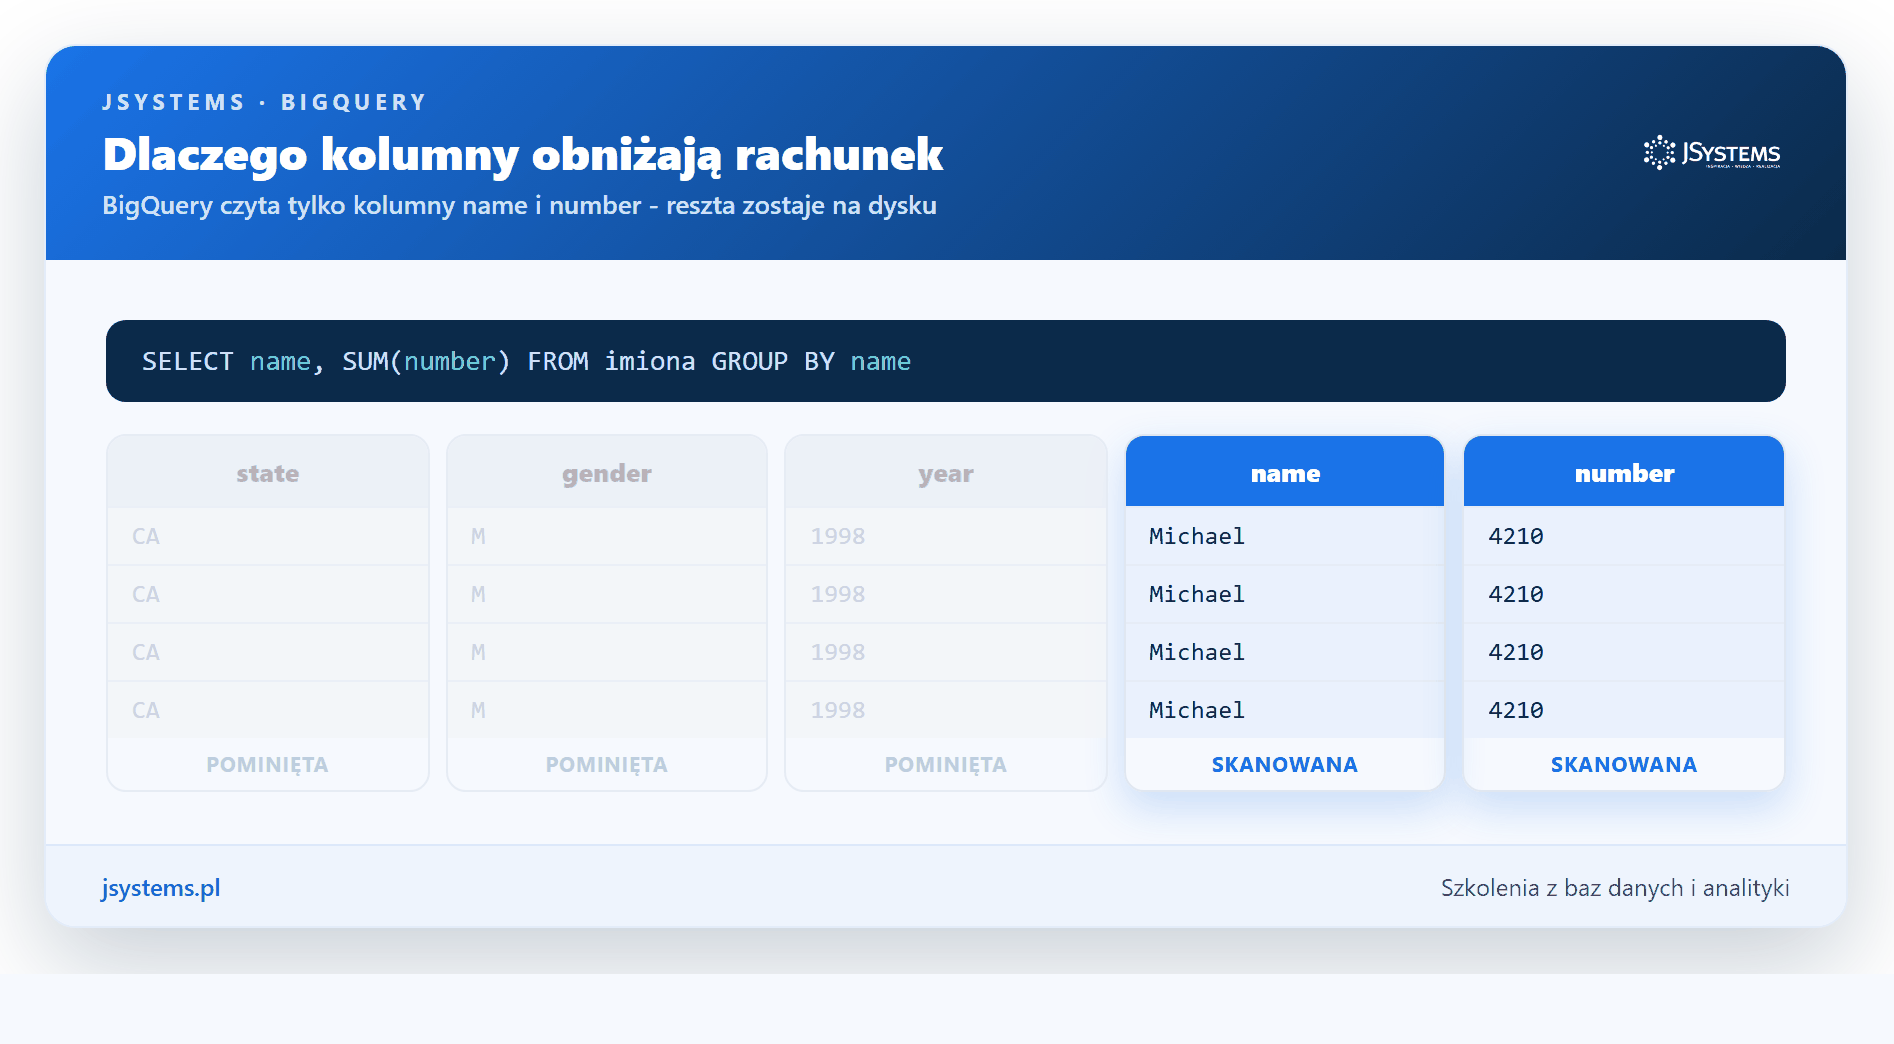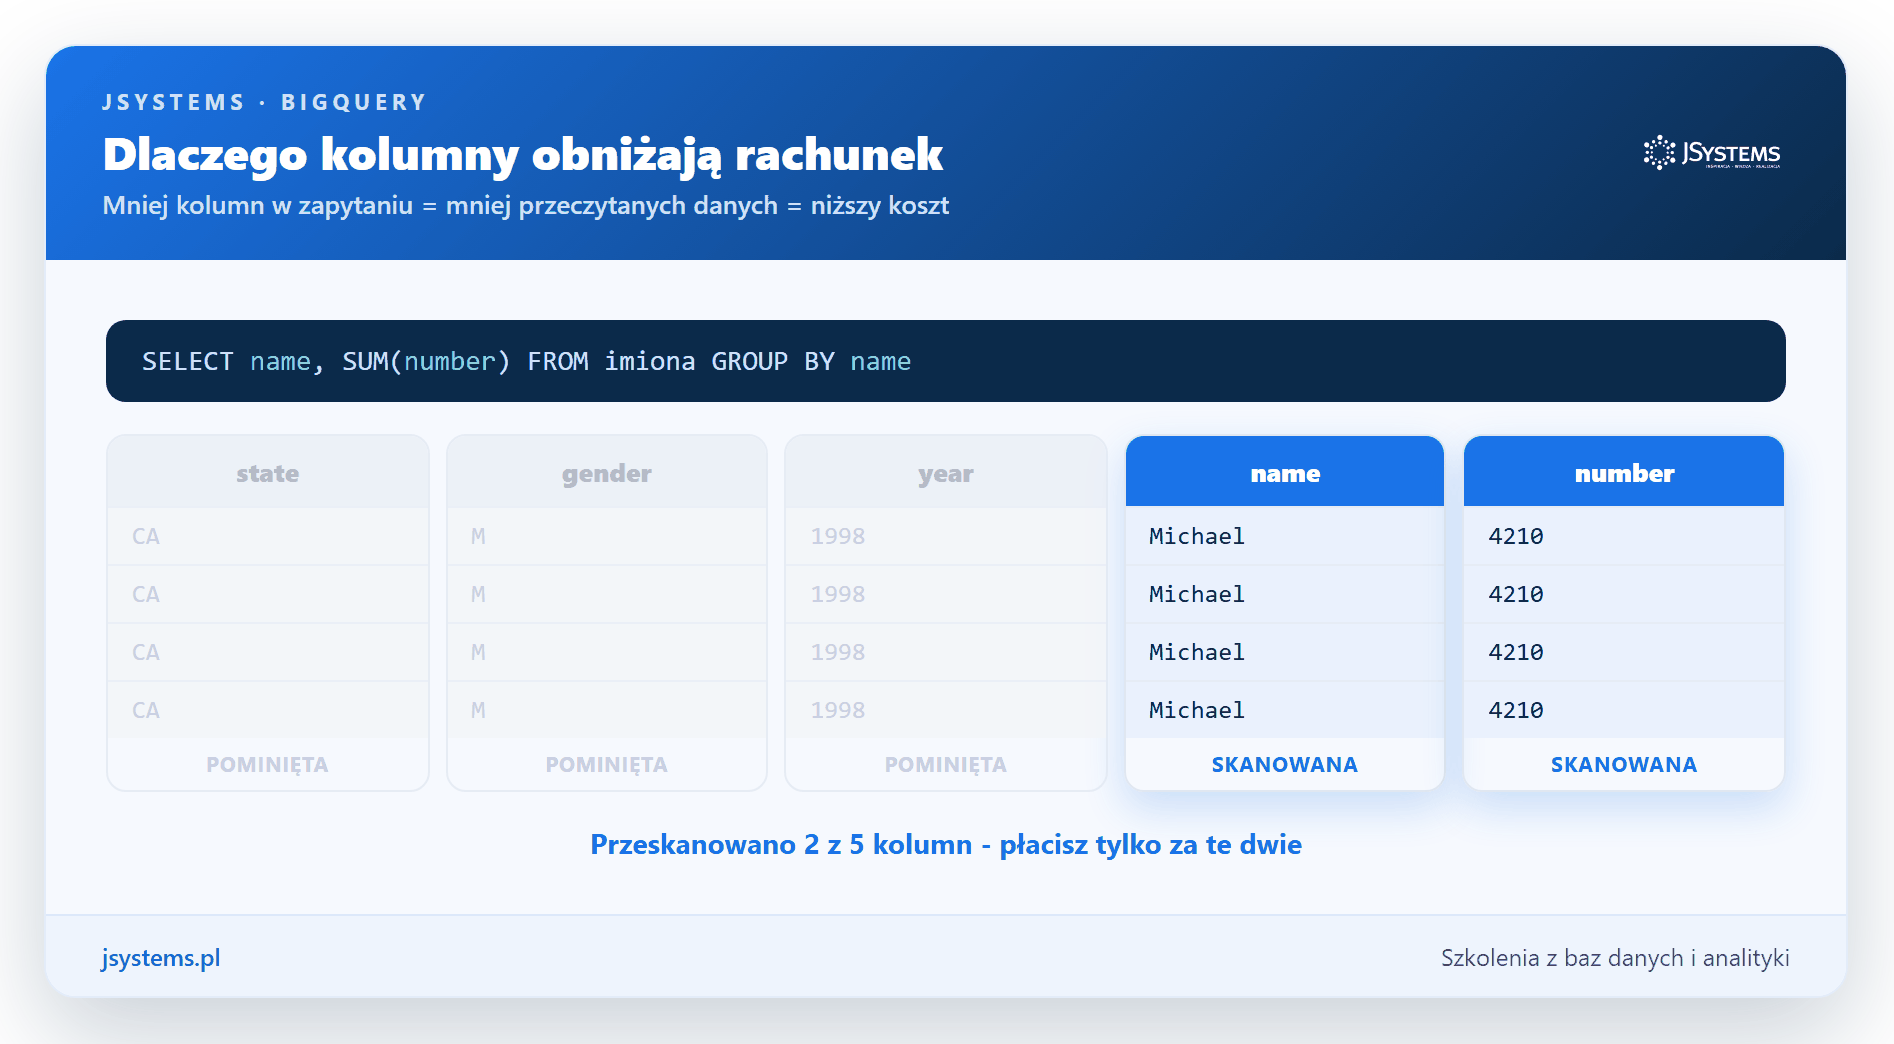
Drugi pomysł to wspomniane już składowanie kolumnowe. Zwykła baza trzyma dane wierszami: cały rekord jednego imienia leży razem. BigQuery odwraca to i trzyma każdą kolumnę osobno. Dzięki temu, gdy pytasz tylko o kolumny name i number, silnik czyta z dysku wyłącznie te dwie kolumny, a pozostałe w ogóle nie rusza:
To pytanie zwykle pada zaraz po pierwszym zachwycie. Dobra wiadomość jest taka, że na naukę BigQuery jest w praktyce darmowy, a płatne modele są proste i przewidywalne. Są dwa sposoby rozliczeń:
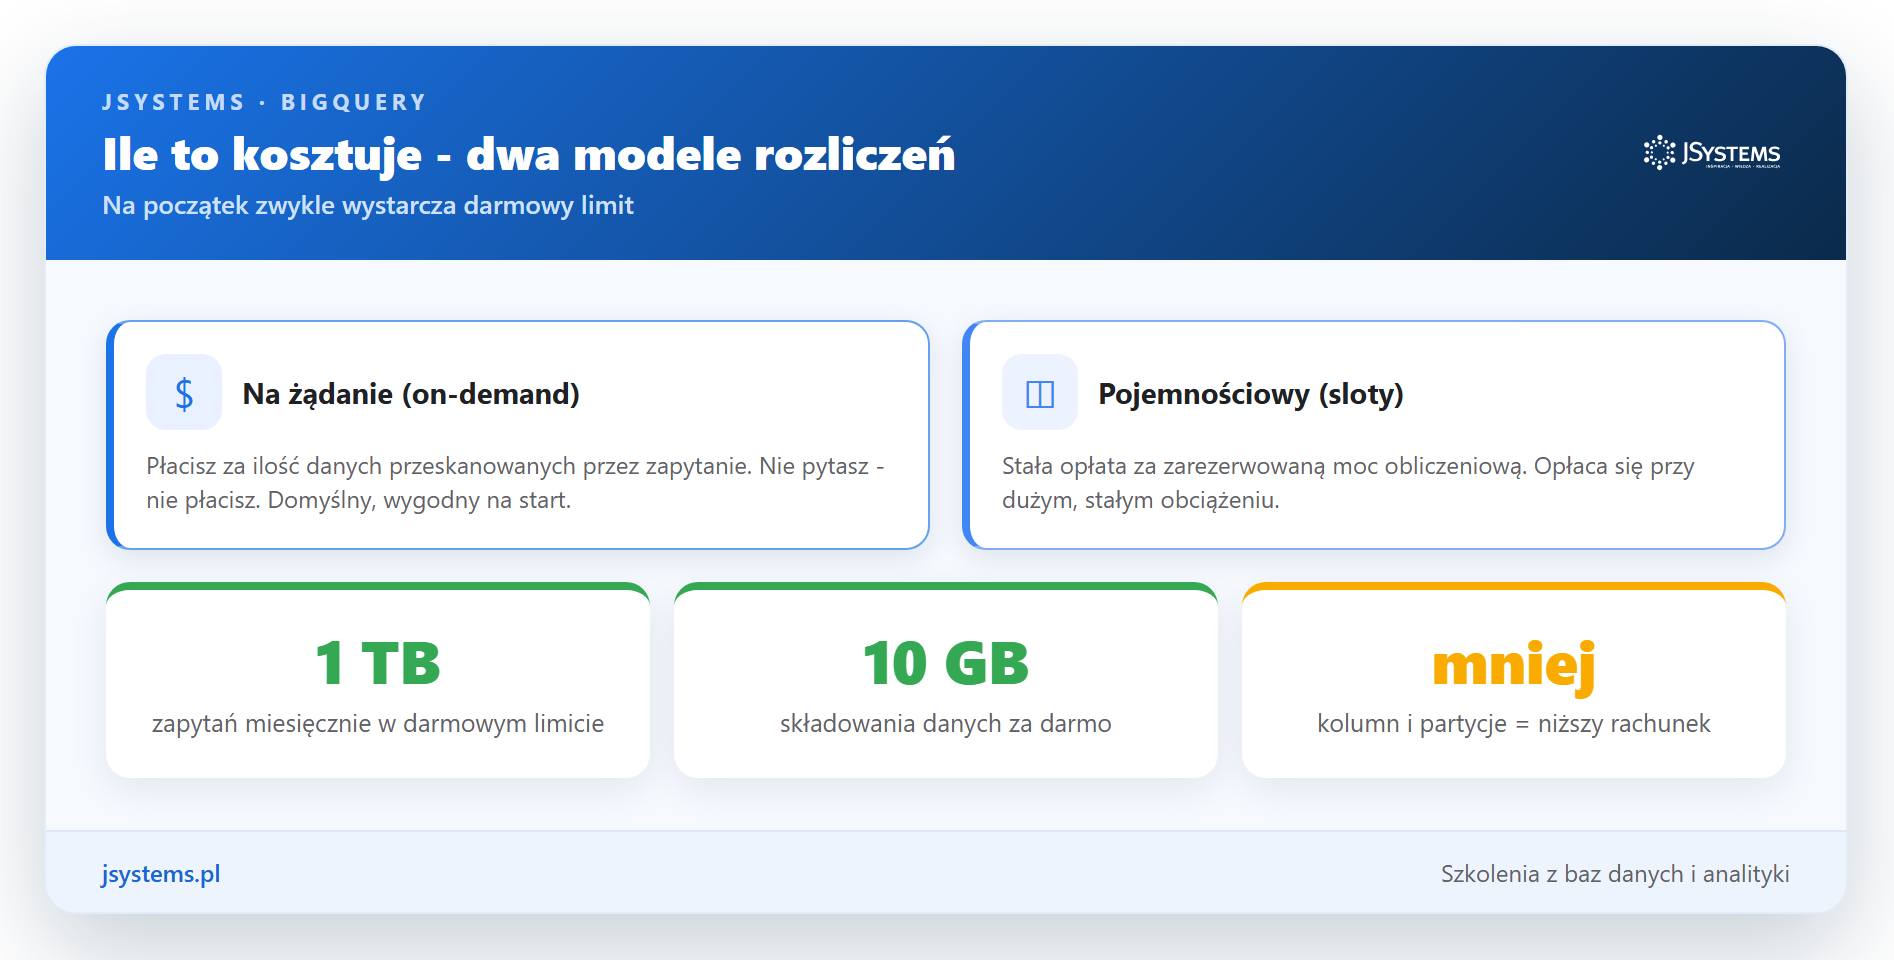
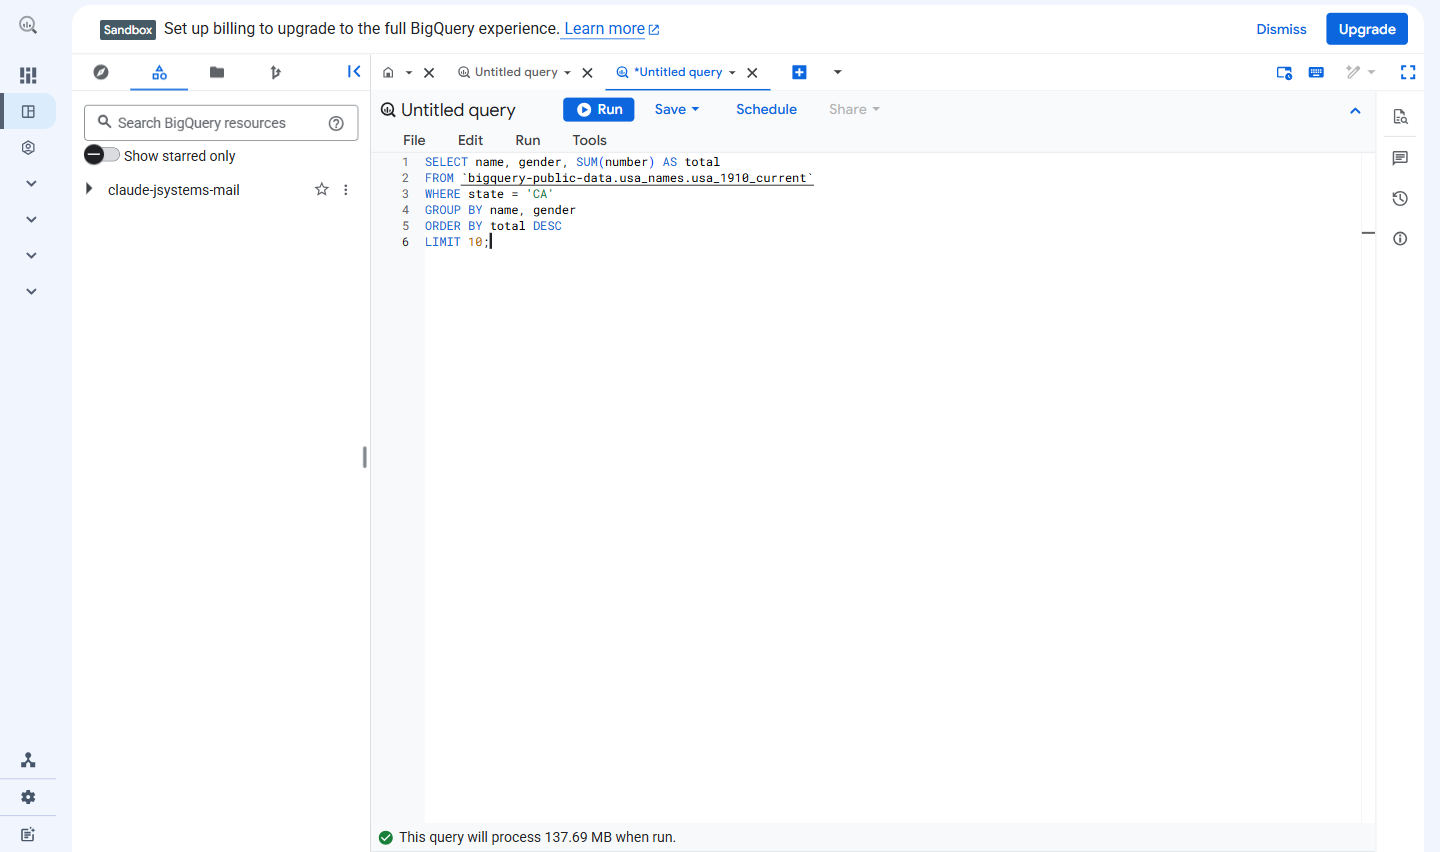
W modelu na żądanie (po angielsku on-demand), domyślnym i najwygodniejszym na start, płacisz nie za liczbę zapytań ani za czas, tylko za ilość danych, którą zapytanie przeskanowało. Co najważniejsze, konsola mówi Ci to z góry - jeszcze przed uruchomieniem pokazuje szacunek u dołu edytora:
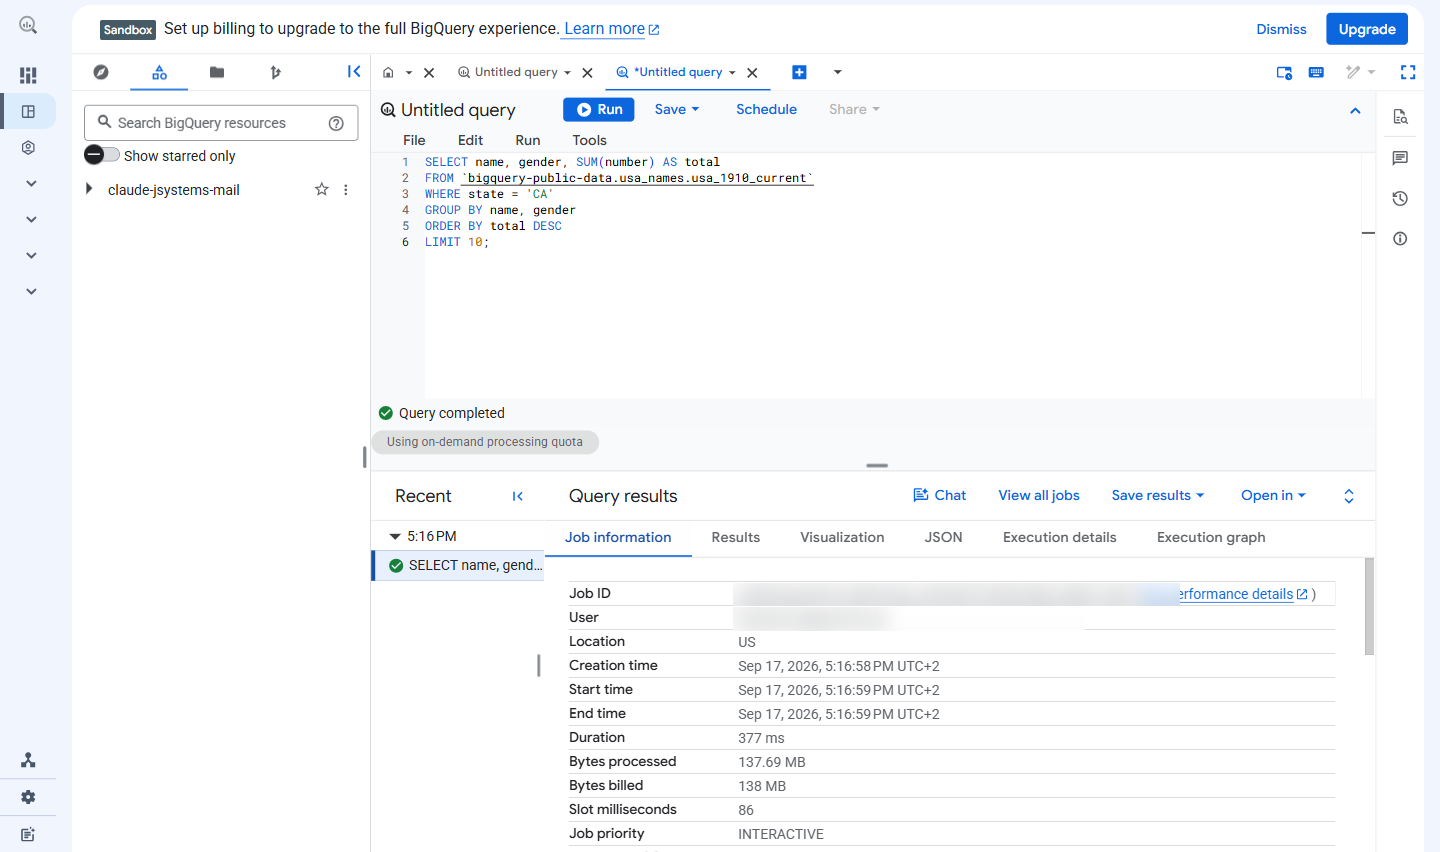
Po wykonaniu zapytania te same liczby znajdziesz w zakładce Job information (informacje o zadaniu). Nasze przykładowe zapytanie przetworzyło niecałe 138 megabajtów i policzyło się w 377 milisekund:
Drugi model, pojemnościowy (sloty), to stała opłata za zarezerwowaną moc obliczeniową. Opłaca się dużym firmom z ciągłym, przewidywalnym obciążeniem, ale na początek prawie na pewno go nie potrzebujesz. Do rozliczeń dochodzi jeszcze niski koszt składowania danych. W darmowym limicie mieści się 1 terabajt zapytań miesięcznie oraz 10 gigabajtów składowania - do nauki i większości małych projektów to bardzo dużo. Orientacyjnie, po przekroczeniu limitu skanowanie danych kosztuje kilka dolarów za terabajt, ale konkretne stawki najlepiej sprawdzić w aktualnym cenniku Google, bo bywają aktualizowane.
Zapytanie SELECT * każe BigQuery przeczytać wszystkie kolumny, także te, których wcale nie potrzebujesz - a płacisz właśnie za przeczytane dane. Na szerokiej tabeli to różnica między groszami a sporym rachunkiem. Zasada na całe życie z BigQuery: wybieraj konkretne kolumny, których naprawdę używasz, zamiast gwiazdki.
Publiczne zbiory są świetne do nauki, ale prawdziwa wartość zaczyna się, gdy wrzucisz do BigQuery własne dane. Nie trzeba do tego żadnego skomplikowanego programu - w konsoli jest przycisk dodawania danych, a pod nim całkiem długa lista źródeł:
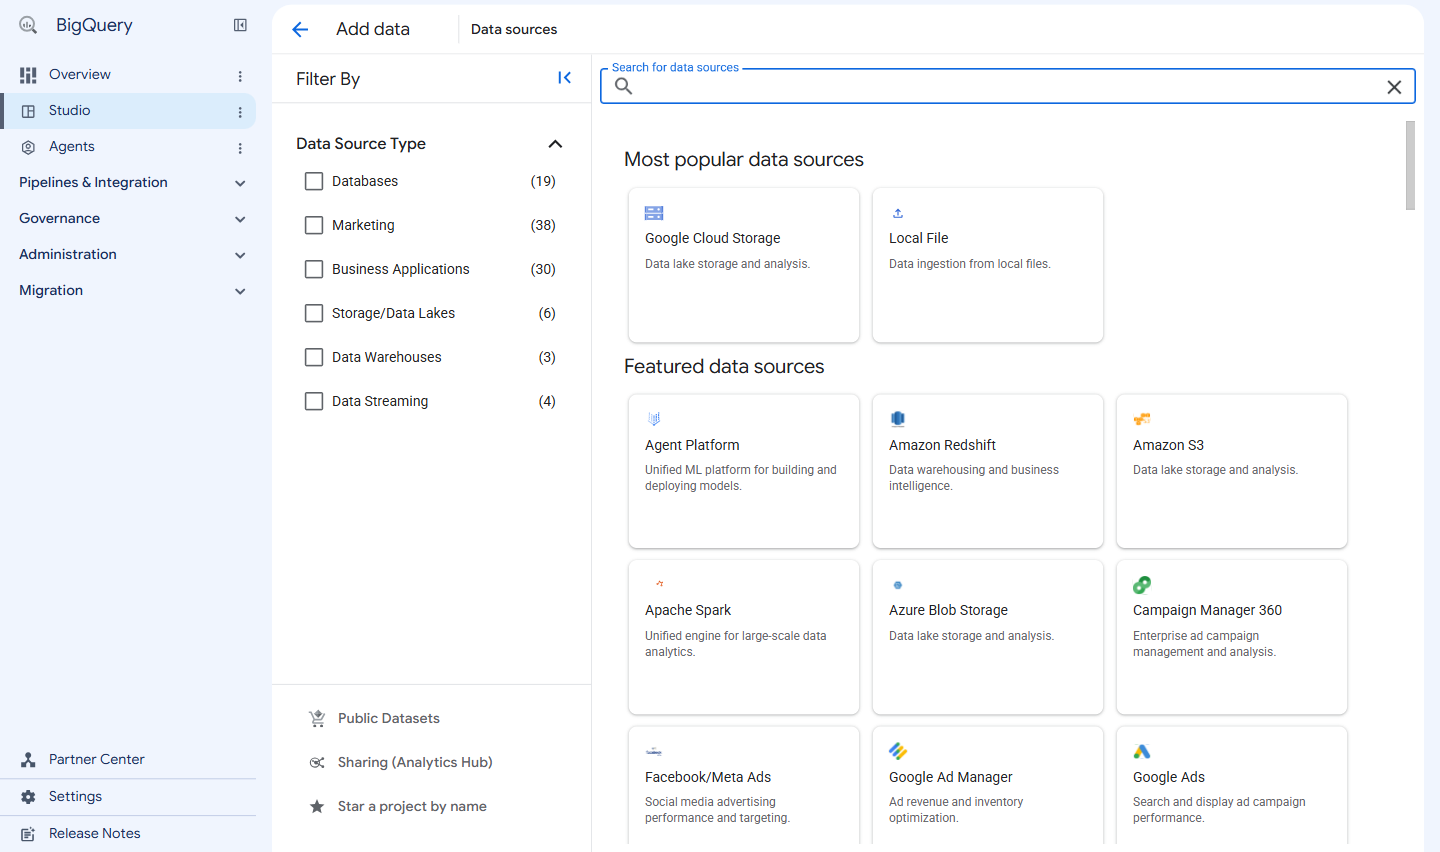
Dla początkującego najprostsze są dwie drogi: wgranie pliku CSV (albo JSON) prosto z komputera oraz wczytanie danych z Google Cloud Storage (chmurowy magazyn plików Google). Bardziej zaawansowane zespoły podłączają gotowe konektory do reklam, systemów sklepowych czy innych hurtowni, żeby dane spływały automatycznie. Cała ta układanka wygląda tak:
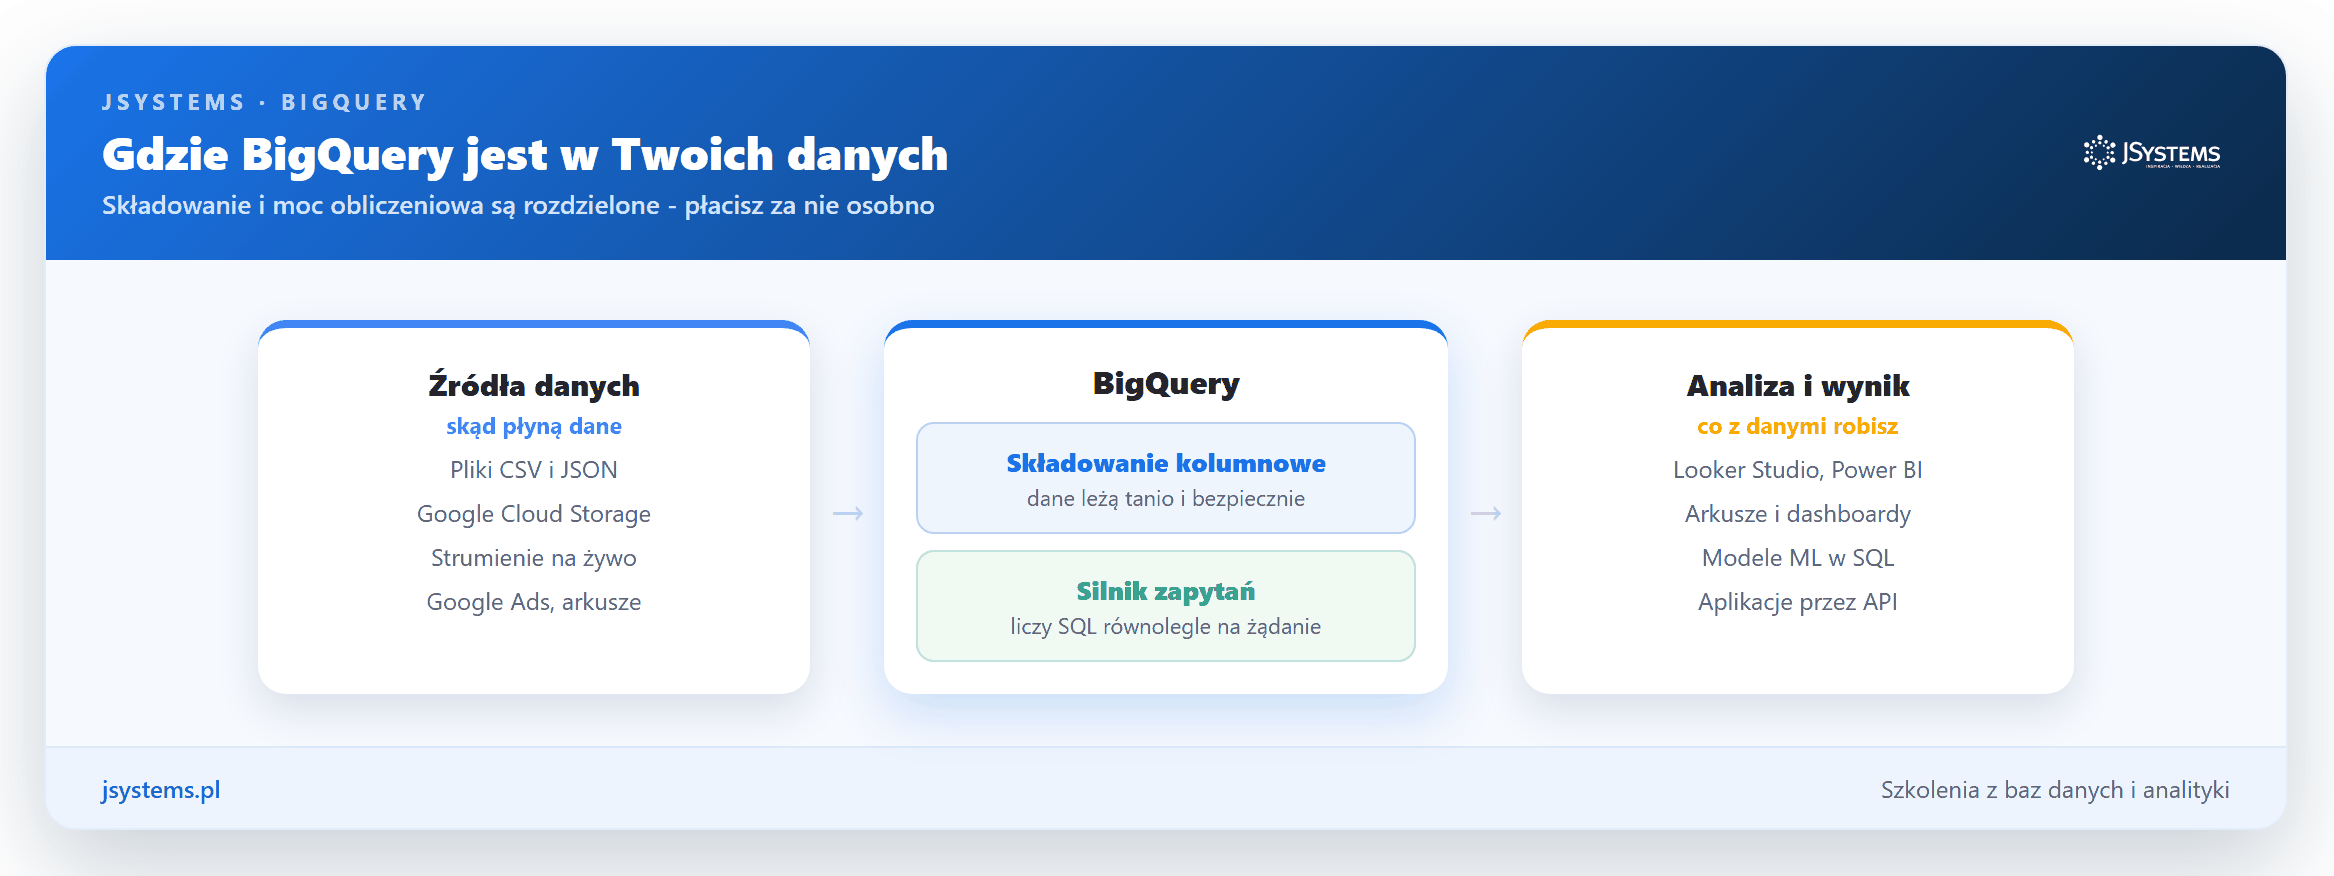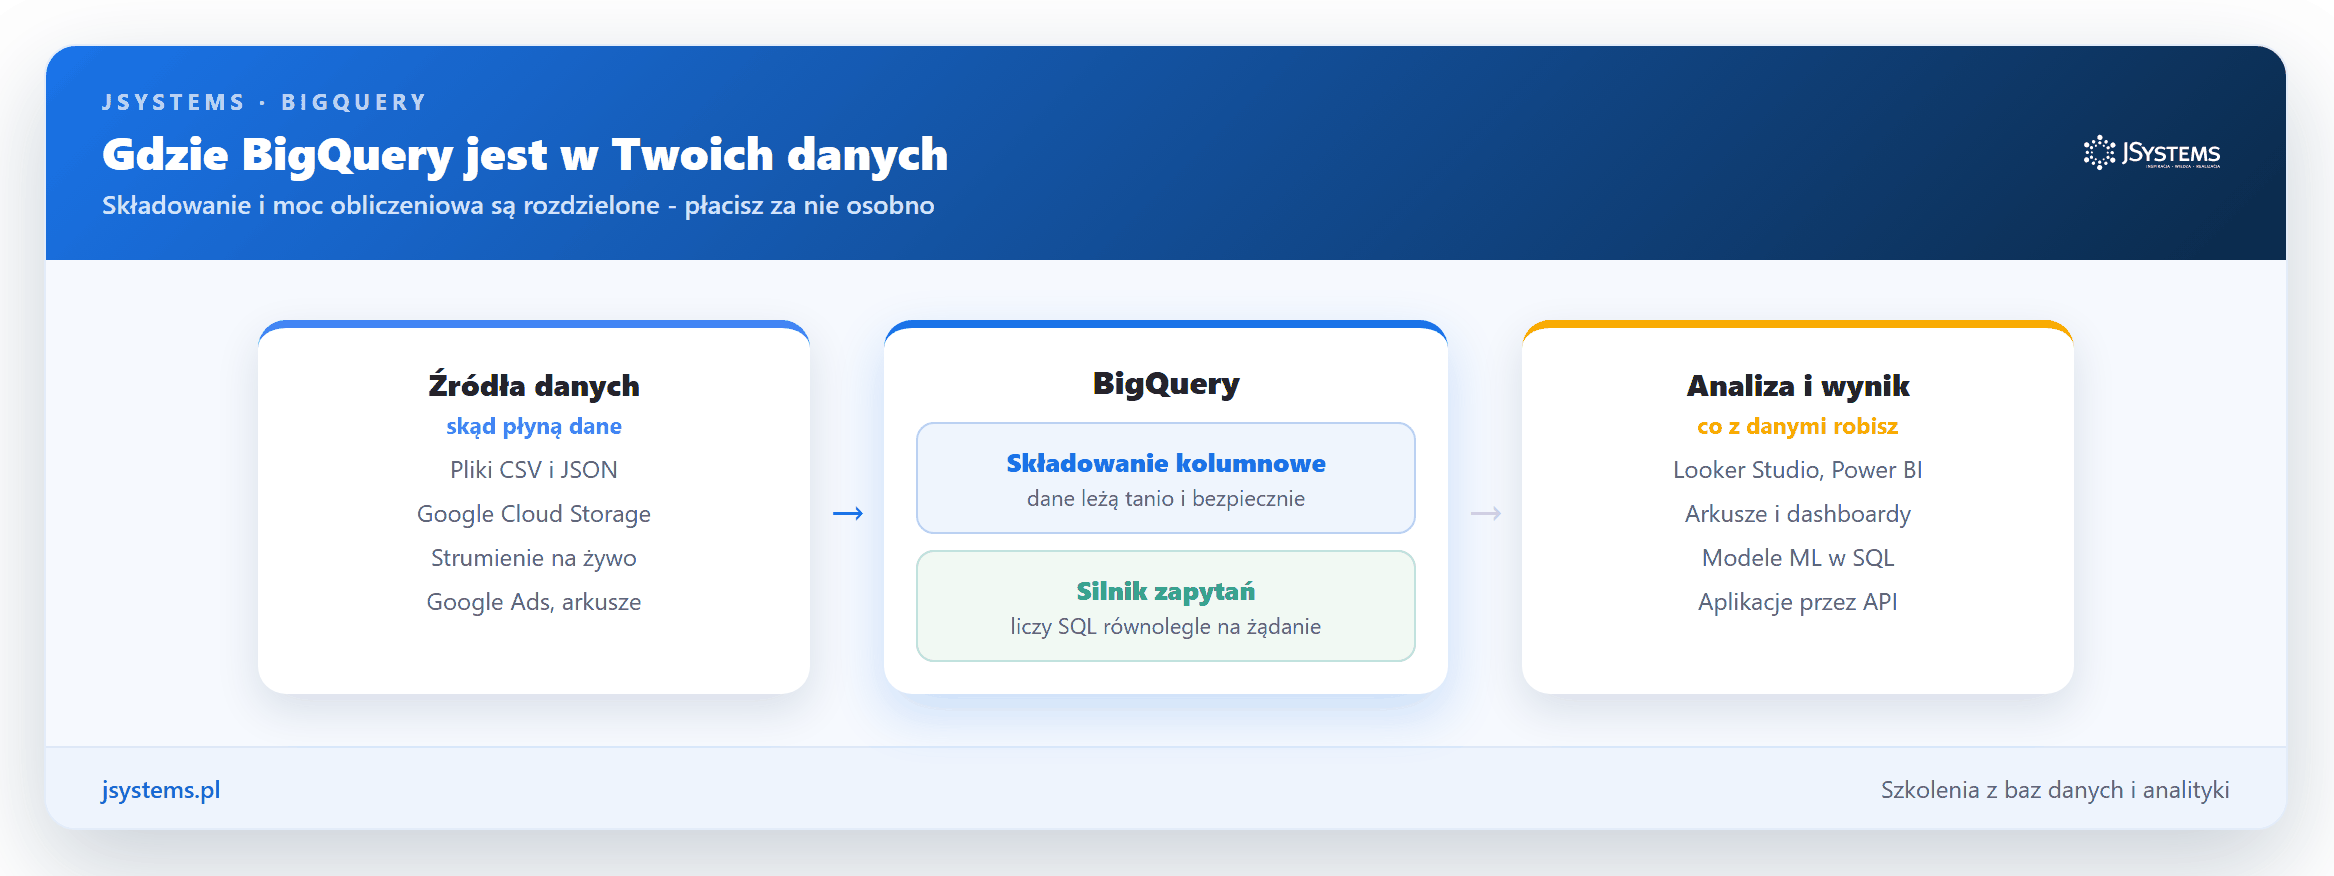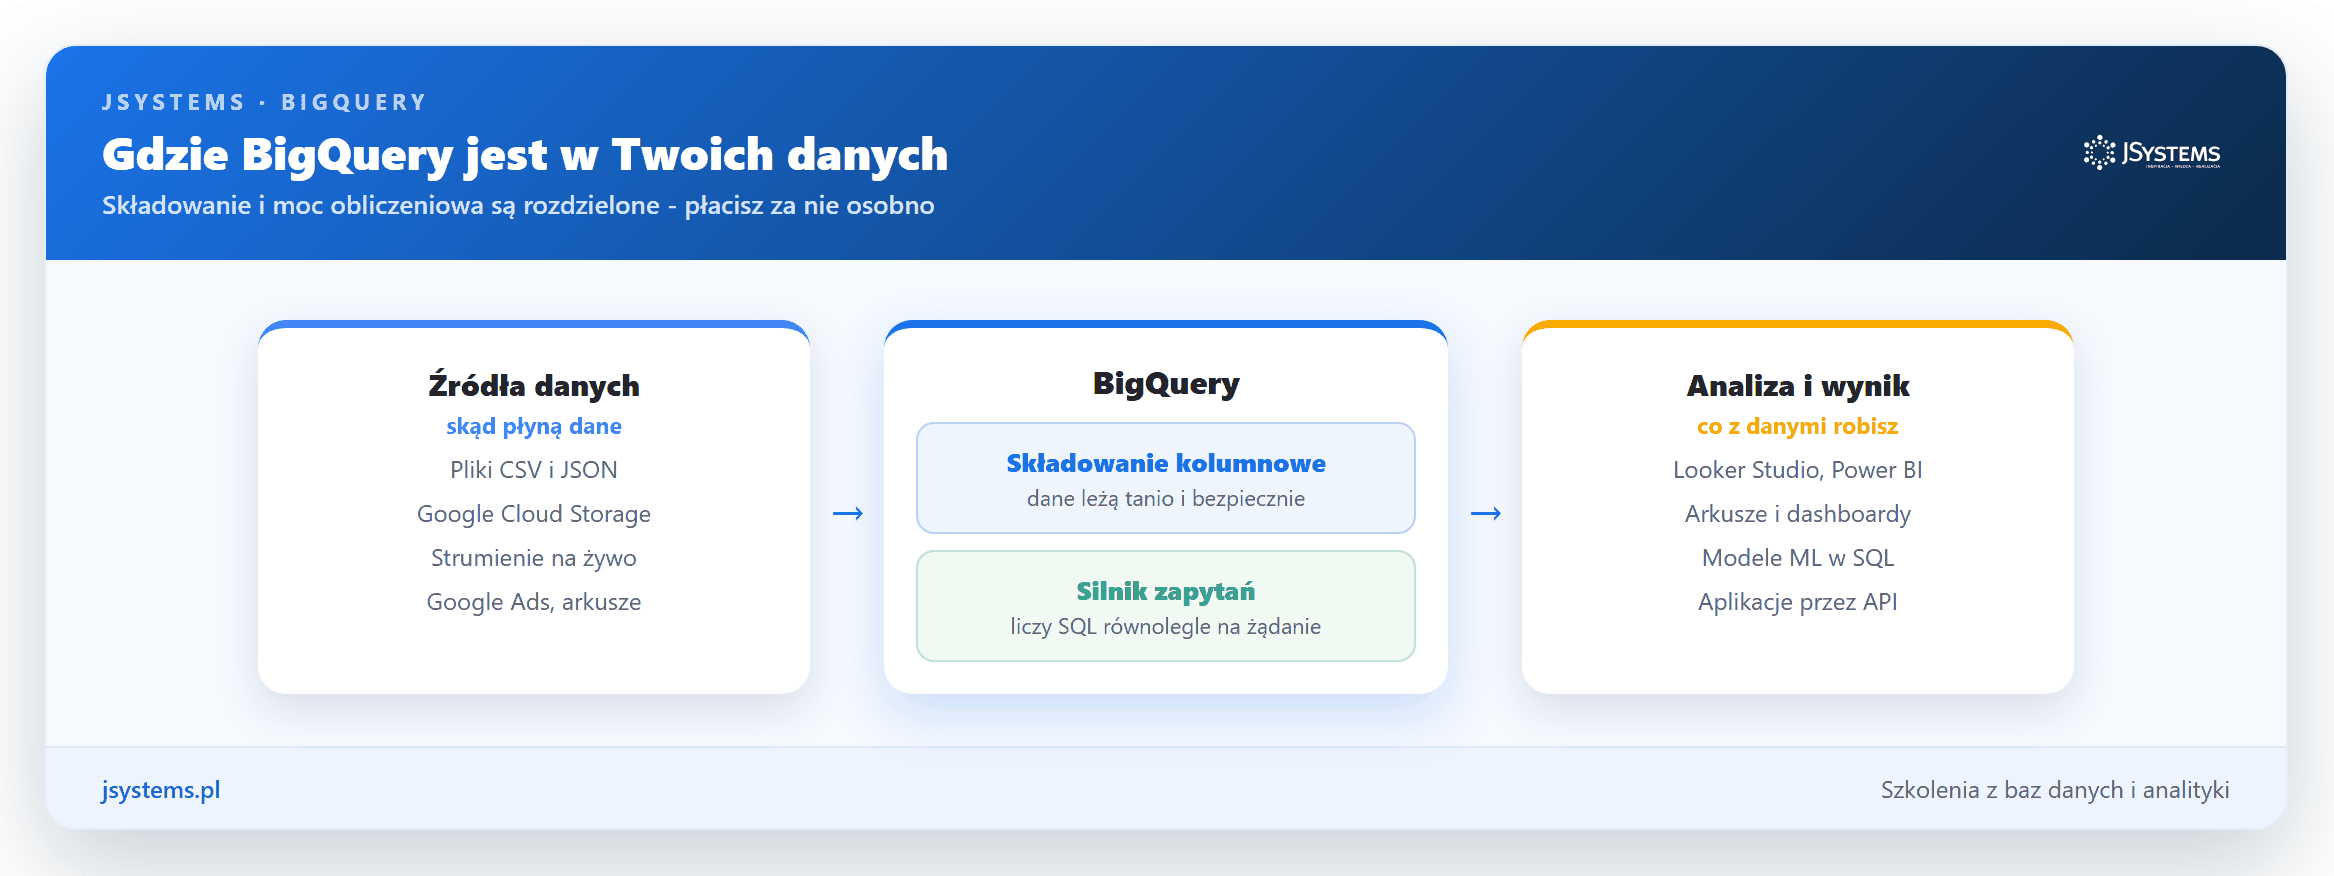
Na wyjściu podłączasz wynik do narzędzi, w których dane się ogląda i prezentuje: darmowego Looker Studio od Google, arkuszy albo Power BI. Jeśli interesuje Cię właśnie ta strona - budowanie czytelnych pulpitów na danych z hurtowni - zajrzyj do naszego przewodnika czym jest Power BI, Power Query i DAX.
BigQuery nie jest jedyną chmurową hurtownią danych. Warto wiedzieć, w jakim towarzystwie się porusza, bo nazwy tych usług często słychać obok siebie:
| Narzędzie | Co to jest | Dla kogo |
|---|---|---|
| BigQuery | Bezserwerowa hurtownia danych Google. Płacisz za przeskanowane dane. | Zespoły w chmurze Google, marketing, szybki start bez administracji |
| Snowflake | Chmurowa hurtownia działająca na wielu chmurach naraz. Rozdziela składowanie od mocy. | Firmy, które nie chcą przywiązywać się do jednego dostawcy chmury |
| Amazon Redshift | Hurtownia danych w chmurze Amazona (AWS). | Zespoły, które już siedzą w ekosystemie AWS |
| PostgreSQL, Oracle | Klasyczne bazy relacyjne (OLTP) do obsługi aplikacji. | Systemy transakcyjne, gdzie liczy się pojedynczy rekord |
Najbliższym kuzynem BigQuery jest Snowflake - też chmurowa hurtownia, też rozmawia SQL, tylko z inną filozofią rozliczeń i niezależnością od jednej chmury. Jeśli chcesz zobaczyć drugą stronę tego świata, opisaliśmy ją osobno: co to jest Snowflake. A szerszy obraz całej układanki - hurtownie, jeziora danych i strumienie - znajdziesz w tekście o współczesnych rozwiązaniach Big Data.
Na koniec kilka nawyków, które warto wyrobić sobie od pierwszego dnia. Nie są trudne, a oszczędzą Ci pieniędzy i nerwów.
Tyle wystarczy, żeby ruszyć. BigQuery należy do tych narzędzi, w których pierwszy wynik dostajesz w kilka minut, a potem stopniowo odkrywasz kolejne możliwości: partycje, funkcje analityczne, uczenie maszynowe w SQL czy strumienie danych na żywo. Fundament jednak jest prosty i znasz go już z tego artykułu: dane w chmurze plus zwykłe zapytanie SQL, bez żadnego serwera po Twojej stronie.
Rozumiesz już, czym jest hurtownia danych w chmurze - czas zamienić to w praktyczną umiejętność.
Najkrótsza droga to przejść przez BigQuery na żywych danych, pod okiem trenera:
 Szkolenie Google BigQuery - podstawy -->
To szkolenie może być dofinansowane dla Ciebie z KFS lub BUR.
★★★★★ Średnia ocena naszych szkoleń w Google: 5/5


Komentarze (0)
Brak komentarzy...