Polskie znaki zamieniają się w krzaczki przy imporcie CSV - kodowanie pliku
Udostępnij na:
Spis treści
Power Query w Excelu, Power BI i Fabric
Polskie znaki zamieniają się w krzaczki przy imporcie CSV - kodowanie pliku
W skrócie
Po imporcie pliku CSV do Power Query polskie znaki wychodzą jako krzaczki: „SprzedaĹĽ” zamiast „Sprzedaż”, „Wroc³aw” zamiast „Wrocław” albo znak zapytania w rombie w miejscu ż i ł.
Plik zapisano w jednym kodowaniu, a Power Query czyta go w innym. Pole Pochodzenie pliku w oknie importu i parametr Encoding funkcji Csv.Document mówią, jak zamienić bajty na litery: 65001 to UTF-8, 1250 to polskie Windows.
W oknie importu albo w kroku Źródło wybierz kodowanie, w którym zapisano plik: 65001: Unicode (UTF-8) albo, dla starszych eksportów z polskich systemów Windows, 1250: Środkowoeuropejski (Windows). Wynik sprawdź na nazwach z ogonkami.
Problem z polskimi znakami w CSV w Power Query dotyczy każdego, kto importuje eksporty z systemów kasowych, księgowych albo sklepów internetowych. Pokazujemy, jak po wyglądzie krzaczków rozpoznać, które kodowanie się pomyliło, gdzie zmienić Pochodzenie pliku w oknie importu i w kodzie M oraz jak sprawdzić wynik. Wszystkie pokazane przekłamania odtworzyliśmy w polskim Excelu.
Jak to wygląda w praktyce
Dane wczytują się bez błędu, ale tekst jest zniekształcony, także w nagłówkach kolumn. Po wyglądzie poznasz, co się pomyliło:
SprzedaĹĽ, WrocĹ‚aw: plik jest w UTF-8, a Power Query czyta go jako 1250. Polska litera zajmuje w UTF-8 dwa bajty, więc zamienia się w dwa obce znaki.
znak zapytania w rombie zamiast ż i ł: plik jest w 1250, a Power Query czyta go jako UTF-8. Bajt polskiej litery z 1250 nie tworzy poprawnego znaku UTF-8, więc na jego miejsce trafia znak zastępczy.
Sprzeda¿, Wroc³aw, £ódŸ: plik jest w 1250, a odczyt idzie zachodnioeuropejską stroną kodową 1252.
Sprzedaż, Wrocław: plik w UTF-8 czytany jako 1252.
Zniekształcone nazwy sklepów i produktów nie pasują do słowników, więc scalanie z katalogiem zostawia puste wartości w dociągniętych kolumnach. Gdy część plików w folderze ma inne kodowanie niż reszta, ten sam sklep występuje w raporcie pod dwiema nazwami.
Dlaczego tak się dzieje
Plik CSV to ciąg bajtów, a kodowanie, czyli tabela przypisująca bajtom litery, zwykle nie jest w nim zapisane. Power Query musi je przyjąć. W oknie importu odpowiada za to pole Pochodzenie pliku, a w kodzie M parametr Encoding funkcji Csv.Document, na przykład:
Litery bez ogonków mają w UTF-8 i w 1250 te same bajty, dlatego przy złym kodowaniu psują się tylko polskie znaki, a reszta tekstu wygląda dobrze. Gdy parametr Encoding pominiesz, Csv.Document czyta plik jako UTF-8: w naszym teście plik zapisany w 1250 dał bez tego parametru romby zamiast ż i ł. W kursie przyjmujemy prostą regułę: 65001 dla UTF-8, 1250 dla starszych eksportów z polskich systemów Windows. Wyjątkiem są pliki UTF-8 ze znacznikiem kolejności bajtów (BOM) na początku: w naszym teście taki plik wczytał się poprawnie nawet przy ustawieniu 1250, więc krzaczki typu SprzedaĹĽ dotyczą plików UTF-8 bez tego znacznika.
Jak to rozwiązać krok po kroku
Ustal kodowanie po objawach: dwa obce znaki zamiast jednej litery (Ĺ, Ă, Å) oznaczają plik UTF-8 czytany w innym kodowaniu, a romby albo pojedyncze znaki ³, ¿ w miejscu ł, ż oznaczają plik 1250 czytany jako UTF-8 albo 1252.
Przy nowym imporcie wybierz na karcie Dane polecenie Pobierz dane, potem Z pliku i Z pliku tekstowego/CSV, wskaż plik i w oknie podglądu rozwiń listę Pochodzenie pliku. Wybierz 65001: Unicode (UTF-8) albo 1250: Środkowoeuropejski (Windows) i patrz na podgląd: przy właściwym kodowaniu nazwy z ogonkami wyglądają poprawnie. Dopiero wtedy kliknij Przekształć dane.
W istniejącym zapytaniu kliknij ikonę koła zębatego przy kroku Źródło na liście Zastosowane kroki. Otworzy się okno z polami Pochodzenie pliku, Ogranicznik i Wykrywanie typu danych. Zmień kodowanie i kliknij OK.
Przy łączeniu plików z folderu kodowanie wybierasz w oknie Połącz pliki, a później zmieniasz je w kroku Źródło zapytania Przekształć przykładowy plik. Zmiana w tym jednym miejscu obejmie wszystkie pliki, bo funkcja Przekształć plik powstaje z jego kroków.
Ten sam efekt da edycja kodu: w pasku formuły kroku Źródło zmień Encoding = 1250 na Encoding = 65001 albo odwrotnie. Zamiast 65001 możesz wpisać stałą TextEncoding.Utf8. Uważaj na stałą TextEncoding.Windows: ma wartość 1252, a nie 1250, więc do polskich plików z Windows wpisz liczbę 1250.
Gdy w jednym folderze leżą pliki w różnych kodowaniach, jedno ustawienie nie obsłuży wszystkich. Poproś o eksport w jednym kodowaniu albo rozdziel pliki do dwóch folderów, połącz każdy osobno i złóż wyniki poleceniem Dołącz zapytania.
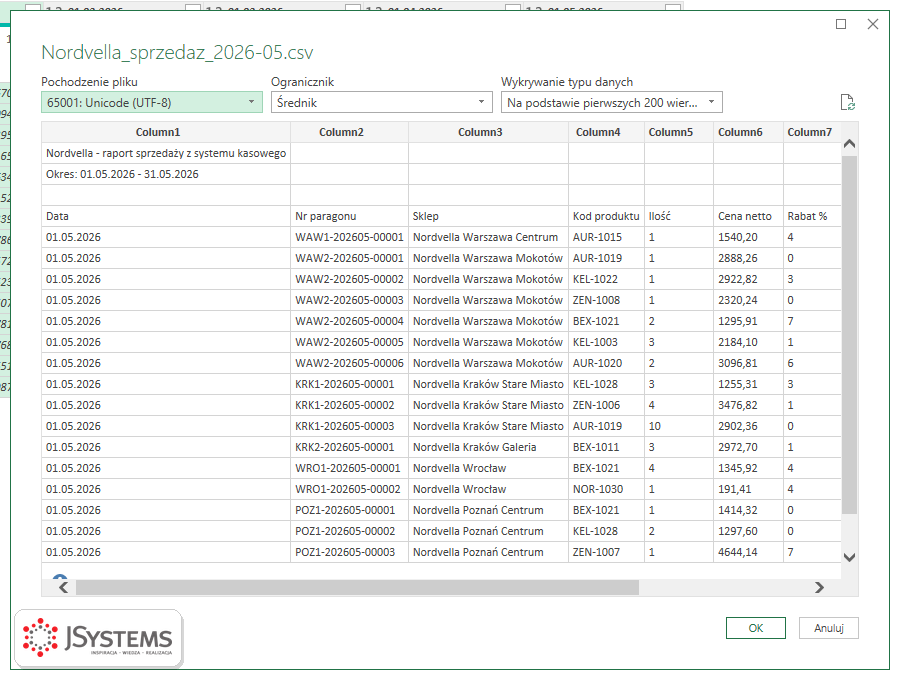
Okno importu eksportu za maj z kursu. Przy kodowaniu 65001: Unicode (UTF-8) nazwy sklepów z ogonkami, takie jak Nordvella Warszawa Mokotów i Nordvella Poznań Centrum, wyglądają w podglądzie poprawnie.
Jak sprawdzić, że zadziałało
Otwórz filtr kolumny z nazwami, na przykład Sklep, i przejrzyj listę wartości: każda nazwa z ogonkami powinna wystąpić raz i w poprawnej postaci, na przykład Nordvella Wrocław i Nordvella Kraków Stare Miasto. Sprawdź też nagłówki kolumn, bo kodowanie dotyczy ich tak samo jak danych: ma być Sprzedaż netto, a nie SprzedaĹĽ netto. W naszym teście ten sam plik UTF-8 dał przy kodowaniu 65001 poprawne nazwy, a przy 1250 krzaczki w obu miejscach.
Po scaleniu z katalogiem albo słownikiem sklepów dociągnięte kolumny nie powinny mieć pustych wartości z powodu nazw. Żeby problem nie wrócił, ustal z dostawcą danych jedno kodowanie eksportu, najlepiej UTF-8, i trzymaj w folderze tylko pliki z tego jednego źródła.
Szkolenie Microsoft Excel - Power Query --> Dwa dni warsztatów z Excela: pobieranie danych z plików, folderów, SharePointa i baz SQL, ich czyszczenie i łączenie w Power Query, praca w języku M, a na koniec model danych i oparta na nim tabela przestawna. Prowadzi Sebastian Stasiak.
Skąd mam wiedzieć, w jakim kodowaniu zapisano plik CSV?
Najprościej sprawdzić to w oknie importu Power Query: przełączaj Pochodzenie pliku między 65001: Unicode (UTF-8) a 1250: Środkowoeuropejski (Windows) i obserwuj podgląd. Właściwe jest to kodowanie, przy którym nazwy z ogonkami wyglądają poprawnie. Wynik potwierdź na kilku wierszach z literami ż, ł i ś.
Dlaczego plik w kodowaniu 1250 ma romby zamiast polskich liter?
Funkcja Csv.Document bez parametru Encoding czyta plik jako UTF-8. Pojedynczy bajt polskiej litery z 1250 nie jest poprawnym znakiem UTF-8, więc w jego miejsce trafia znak zastępczy. W naszym teście dopisanie Encoding równego 1250 przywróciło poprawne nazwy.
Czy TextEncoding.Windows oznacza polskie kodowanie Windows?
Nie. W Excelu stała TextEncoding.Windows ma wartość 1252, czyli zachodnioeuropejską stronę kodową. Dla polskich plików z systemów Windows wpisz w parametrze Encoding liczbę 1250, a dla plików UTF-8 liczbę 65001 albo stałą TextEncoding.Utf8.
Czy kodowanie trzeba ustawiać osobno dla każdego pliku z folderu?
Nie, jeśli wszystkie pliki mają to samo kodowanie. Przy łączeniu folderu ustawienie siedzi w kroku Źródło zapytania Przekształć przykładowy plik, a funkcja Przekształć plik stosuje je do każdego pliku. Pliki w różnych kodowaniach rozdziel do osobnych folderów albo poproś o jednolity eksport.

Komentarze (0)
Brak komentarzy...