Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
Poniższe czynności wykonujemy jako użytkownik systemowy z uprawnieniami do sudo:
Pierwszy krok to konfiguracja repozytorium z pliku RPM:
sudo dnf install -y https://download.postgresql.org/pub/repos/yum/reporpms/EL-9-x86_64/pgdg-redhat-repo-latest.noarch.rpm
Następny- wyłączenie domyślnie dostępnego pakietu postgresa:
sudo dnf -qy module disable postgresql
Instalacja dostępnych aktualizacji:
sudo yum upgrade -y
Restart serwera po aktualizacji, ponieważ niektóre paczki, szczególnie te aktualizujące jądro linuxa, nie będą “aktywne” do następnego startu serwera:
sudo reboot
Instalacja binarek serwera PostgreSQL:
sudo dnf install postgresql15-server -y
Domyślnie PostgreSQL w CentOS będzie miał pliki rozmieszczone w takich lokalizacjach:
Katalog z binariami: /usr/pgsql-15/bin/
Katalog domowy postgresa: /var/lib/pgsql
Chcemy, by nasze dane były gdzie indziej niż w domyślnej lokalizacji (np. na innym dysku). W tym celu musimy stworzyć katalog w pożądanej lokalizacji, sprawić, by jego właścicielem był użytkownik systemowy postgres (tworzony automatycznie podczas instalacji) oraz zainicjalizować i sprawdzić, czy działa.
Utworzenie katalogu na naszą PGDATA:
sudo mkdir -m 700 /data_pg
sudo chown postgres: /data_pg/
Inicjalizacja i start nowego klastra. Przechodzimy tu do użytkownika systemowego postgres:
sudo su - postgres
/usr/pgsql-15/bin/initdb -D /data_pg/
/usr/pgsql-15/bin/pg_ctl -D /data_pg start
Aktualizacja zmiennej systemowej PATH dla użytkownika postgres jako użytkownik postgres w celu dodania wszystkich binarek PostgreSQL do PATH. Dzięki temu nie będziemy musieli podawać pełnych ścieżek do narzędzi PostgreSQL.
cat << EOF >> ~/.bash_profile
PATH=$PATH:/usr/pgsql-15/bin
export PATH
EOF
Zmodyfikujemy jeszcze dodaną automatycznie zmienną środowiskową PGDATA , by wskazywała na nasz utworzony katalog. Dzięki temu będzie można wywoływać instrukcję np. “pg_ctl restart” bez konieczności wykorzystania przełącznika -D i wskazywania katalogu PGDATA.
Edytujemy nasz plik .bash_profile:
nano . ~/.bash_profile
Następnie zmieniamy katalog, na który wskazuje zmienna PGDATA na nasz (/data_pg):
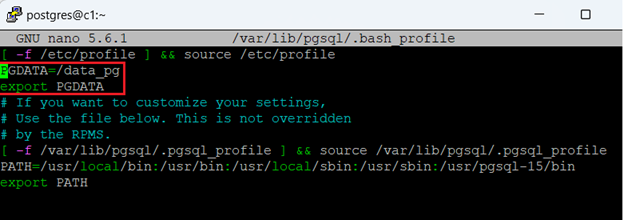
Uwaga! Zmiany te wymagają przelogowania użytkownika postgres lub ręcznego załadowania zmiennych za pomocą:
. ~/.bash_profile
W kolejnym kroku skonfigurujemy usługę serwera PostgreSQL. Włączymy dla niej autostart i uruchomimy. W odróżnieniu od Ubuntu, tutaj nie będzie domyślnie wystartowanej instancji. Wykonujemy to z poziomu użytkownika systemowego z prawami do sudo, nie jako użytkownik postgres. Edytujemy plik konfiguracyjny usługi:
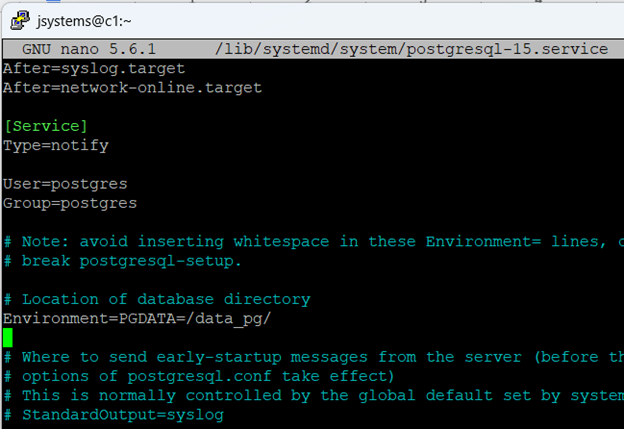
sudo nano /lib/systemd/system/postgresql-15.service
W pliku odnajdujemy linijkę zaczynającą się od “Environment=PGDATA=/…./” i konfigurujemy położenie, pod którym znajduje się nasza PGDATA:
Możemy teraz przejść do włączenia usługi i jej autostartu, ale - najpierw musimy wyłączyć cały czas działający w tle uruchomiony wcześniej klaster. W innym przypadku usługa usiłowałaby zablokować wcześniej zablokowany port i nie wstałaby. W tym celu logujemy się ponownie na użytkownika systemowego postgres i wyłączamy klaster.
sudo su - postgres
pg_ctl -D /data_pg/ stop
Wracamy teraz do użytkownika systemowego z prawami do sudo. Uruchamiamy usługę i ustawiamy dla niej autostart:
sudo systemctl start postgresql-15.service
sudo systemctl enable postgresql-15.service
Możemy też sprawdzić status usługi:
sudo systemctl status postgresql-15.service
Usługa powinna już - działać poprawnie. Przy okazji należy zwrócić - uwagę, że mamy - też informację o użytym PGDATA:
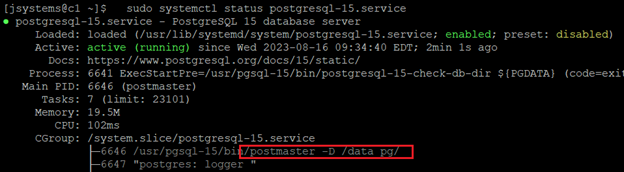
Jeśli konfigurujemy PostgreSQL jako usługę, to startujemy i zatrzymujemy klaster już z poziomu systemctl, a nie pg_ctl. Wynika to z tego, że proces uruchomiony przez pg_ctl i usługa nie wiedzą o sobie wzajemnie.
Szkolenie Administracja, replikacja i tuning baz danych PostgreSQL →
To szkolenie może być dofinansowane dla Ciebie z KFS lub BUR.
★★★★★Średnia ocena naszych szkoleń w Google: 5/5


Komentarze (0)
Brak komentarzy...