Sprawdź 159 GWARANTOWANYCH TERMINÓW SZKOLEŃ na rok 2026! Dofinansowanie do 100% — sprawdź możliwości z BUR i KFS!
22 299 53 69
Szkolenie Python

Szkolenie Przetwarzanie danych w Apache Spark za pomocą PySpark i Spark SQL

Analizy zaczynasz za każdym razem od nieuporządkowanych danych z wielu źródeł i od nowa je łączysz, filtrujesz i agregujesz. Po tym szkoleniu przetwarzasz w Databricks duże zbiory danych w PySpark i Spark SQL: od wczytania surowych danych po uporządkowane warstwy Bronze, Silver i Gold w jeziorze danych. Przechodzisz od koncepcji Big Data i przetwarzania rozproszonego, przez komponenty Sparka, transformacje, akcje i Structured API, po formaty Parquet i Delta, partycjonowanie i Unity Catalog.

więcej →

Program, termin i format dostosujemy do Twojego zespołu
Najbliższe terminy 9:00 – 16:00

16.11 –
Termin niegwarantowany Online
Dawid Grześków Dawid Grześków
Wolne miejsca
Do koszyka
Kliknij aby przejść do formularza zapisu
01.03 –
Termin niegwarantowany Online
Dawid Grześków Dawid Grześków
Wolne miejsca
Do koszyka
Kliknij aby przejść do formularza zapisu
07.06 –
Termin niegwarantowany Online
Dawid Grześków Dawid Grześków
Wolne miejsca
Do koszyka
Kliknij aby przejść do formularza zapisu
Powiadamiaj mnie o nowych terminach gwarantowanych tego szkolenia

Powiadomienia o terminach gwarantowanych

Na podany adres e-mail będziesz otrzymywać informacje o pojawiających się terminach gwarantowanych szkolenia Przetwarzanie danych w Apache Spark za pomocą PySpark i Spark SQL.

Z powiadomień możesz wypisać się w dowolnym momencie.

Zorganizuj to szkolenie tylko dla swojego zespołu

To szkolenie można zorganizować w formie zamkniętej - z programem dopasowanym do potrzeb Twojego zespołu, w uzgodnionym terminie i formacie. Może odbyć się zarówno online, jak i stacjonarnie - w naszej lub w Waszej siedzibie.
Dowiedz się więcej

Opis szkolenia

W skrócie

Analizy zaczynasz za każdym razem od nieuporządkowanych danych z wielu źródeł i od nowa je łączysz, filtrujesz i agregujesz. Po tym szkoleniu przetwarzasz w Databricks duże zbiory danych w PySpark i Spark SQL: od wczytania surowych danych po uporządkowane warstwy Bronze, Silver i Gold w jeziorze danych. Przechodzisz od koncepcji Big Data i przetwarzania rozproszonego, przez komponenty Sparka, transformacje, akcje i Structured API, po formaty Parquet i Delta, partycjonowanie i Unity Catalog.

Co potrafisz po szkoleniu

  • Rozumiesz, jak działa przetwarzanie rozproszone - Wiesz, skąd biorą się duże zbiory danych i jakie wyzwania stawia ich przetwarzanie, znasz architekturę systemów rozproszonych oraz różnicę między przetwarzaniem wsadowym a strumieniowym.
  • Rozróżniasz komponenty Sparka, transformacje i akcje - Znasz RDD, DataFrame i Spark SQL oraz różnicę między transformacją, która tylko opisuje operację na danych, a akcją, która uruchamia obliczenia.
  • Poruszasz się sprawnie po Databricks - Nawigujesz po interfejsie, zarządzasz notatnikami (notebooks), wykonujesz zapytania i przeglądasz dane, a przy tym rozumiesz, jak Databricks udostępnia Sparka w środowisku chmurowym.
  • Wczytujesz i przekształcasz dane w PySpark i Spark SQL - Definiujesz schemat danych, wczytujesz dane, wyświetlasz je, wybierasz kolumny, wykonujesz na nich operacje i filtrujesz wiersze, w DataFrame albo w zapytaniu SQL.
  • Agregujesz i łączysz dane z różnych źródeł - Grupujesz i agregujesz dane, łączysz zbiory joinami i dopisujesz własną logikę jako UDF, czyli funkcje definiowane przez użytkownika.
  • Zapisujesz dane w formatach Parquet i Delta - Porównujesz JSON, Parquet i Delta, znasz ich zalety i zastosowania w Sparku i zapisujesz wyniki w formacie dobranym do zadania.
  • Dbasz o wydajność dzięki partycjonowaniu - Poznajesz zasady partycjonowania, czyli podziału danych na części przetwarzane równolegle, i zarządzasz rozkładem danych w Sparku z myślą o wydajności.
  • Projektujesz jezioro danych w architekturze Medallion - Organizujesz dane w systemie plików, odróżniasz Data Lake od Data Warehouse, układasz dane w warstwach Bronze, Silver i Gold i poznajesz Unity Catalog, czyli centralne repozytorium zarządzania dostępem do danych i ich klasyfikacją.

Jak pracujemy

Operacje na danych poznajesz równolegle w PySpark DataFrame i w Spark SQL, dzięki czemu z tego samego silnika korzystają w zespole zarówno osoby piszące w Pythonie, jak i w SQL. Ćwiczenia wykonujesz na platformie Databricks. Po części podstawowej i po części zaawansowanej masz warsztat: najpierw wczytujesz dane i piszesz proste transformacje oraz zapytania SQL, potem ćwiczysz agregacje, funkcje UDF, pracę z różnymi formatami danych i architekturę Medallion. Prowadzi Dawid Grześków, inżynier danych, który na co dzień pracuje ze Sparkiem i Databricks w chmurze Azure oraz buduje hurtownie i jeziora danych.

Dla kogo

Dla analityków i inżynierów danych, którzy chcą przetwarzać duże zbiory danych w Sparku i pracować na platformie Databricks, oraz dla programistów i specjalistów data science, którzy wykorzystują Sparka w projektach. Wymagania wstępne: podstawowa znajomość SQL, Pythona i Gita oraz założone konto na GitHubie; znajomość technologii chmurowych przydaje się, ale nie jest obowiązkowa.

Co zyskujesz

Umiejętność samodzielnej pracy w Databricks: wczytujesz, przekształcasz, łączysz i zapisujesz dane w PySpark i Spark SQL oraz porządkujesz je w warstwach jeziora danych według architektury Medallion. Otrzymujesz imienny certyfikat ukończenia szkolenia.

Zarezerwuj miejsce i przetwarzaj duże zbiory danych w Apache Spark na platformie Databricks.

Sprawdź, czy w Twoim przypadku dostępne jest finansowanie szkolenia ze środków BUR/KFS. Dostępność finansowania zależy od warunków danego programu oraz decyzji właściwej instytucji. Więcej informacji: https://jsystems.pl/dofinansowanie/

Przejdź do programu szkolenia

Prowadzący szkolenie

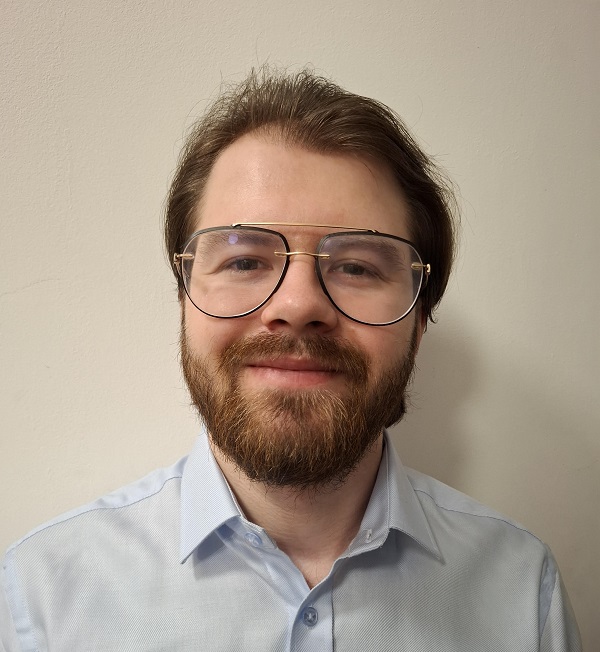
Dawid Grześków

Dawid Grześków

Specjalista IT z pięcioletnim doświadczeniem w środowisku danowym. W swojej karierze przeszedłem przez budowanie narzędzi wewnętrznych, analitykę oraz tworzenie systemów raportowych. Aktualnie pracuje jako Inżynier Danych, gdzie Spark i Databricks stanowią moje główne narzędzia pracy.

Na co dzień pracuje z technologiami chmurowymi na platformie Azure. Programuje w Pythonie, SQL oraz Sparku. Tworzę modele, hurtownie oraz jeziora danych. Integruję rozwiązania DevOps z procesami biznesowymi. Tworzę zaplecza całych platform i rozwijam procesy integracyjne.

Projekty w których brałem udział to m.in.:

  • Integracja przepływów danych wspierających mi.n. SAPa, procesy korporacyjne
  • Budowanie jezior danych w celu scentralizowania zasobów przedsiębiorstwa
  • Budowanie modeli analitycznych, które dotychczas były niemożliwe do zrealizowania bez Sparka.
  • Wdrażanie rozwiązań DevOps/DataOps

Posiadam doświadczenie pracy w międzynarodowych firmach, gdzie wspierałem zespoły w przyswajaniu wiedzy procesowej oraz narzędziowej. Jako praktyk, wychodzę z założenia, że tylko praktyczne szkolenia dają satysfakcjonujące efekty.

Program szkolenia


  • Wprowadzenie do ekosystemu Big Data
    • Omówienie koncepcji Big Data - co oznacza, skąd się bierze, jakie są główne źródła danych i jakie wyzwania wiążą się z ich przetwarzaniem.
    • Rozproszone przetwarzanie danych - omówienie zalet i architektury systemów rozproszonych, różnice między przetwarzaniem wsadowym a strumieniowym.

  • Spark i Databricks
    • Wprowadzenie do ekosystemu Apache Spark
      • Omówienie czym jest Spark, jego komponentów (RDD, DataFrame, Spark SQL itd.), oraz jak Databricks upraszcza korzystanie z Apache Spark dzięki środowisku chmurowemu.
    • Wprowadzenie do Platformy Databricks
      • Pokaz środowiska pracy w Databricks: jak nawigować po interfejsie, zarządzać notatnikami (notebooks), jak wykonywać zapytania, jak przeglądać dane.

  • Omówienie Transformacji oraz Akcji w kontekście pracy ze Sparkiem.

  • Databricks Workspace
    • Przedstawienie środowiska pracy.
    • Nawigacja na platformie.

  • Structured API - podstawy
    • Schemat danych
    • Wczytywanie danych w PySpark
    • PySpark DataFrame oraz Spark SQL
      • Wyświetlanie danych
      • Selekcja danych
      • Operacje na kolumnach
      • Filtrowanie wierszy

  • Warsztat - podstawy
    • Ćwiczenia pozwalające na zastosowanie zdobytej wiedzy w praktyce - m.in. wczytywanie danych, tworzenie prostych transformacji i zapytań SQL w Databricks.

  • Structured API - część zaawansowana
    • Zapisywanie danych do różnych formatów (Parquet, Delta)
    • Grupowanie i agregacja danych
    • Łączenie danych z różnych źródeł (joiny)
    • Tworzenie i użycie własnych funkcji (User Defined Functions - UDF)

  • Partycjonowanie danych
    • Zasady i znaczenie partycjonowania w kontekście wydajności - jak poprawnie zarządzać rozkładem danych w Spark.

  • Unity Catalog
    • Wprowadzenie do Unity Catalog jako centralnego repozytorium zarządzania dostępem, zasobami danych i ich klasyfikacją na platformie Databricks.

  • Budowanie jeziora danych (Data Lake)
    • Omówienie architektury jeziora danych, zasady organizacji danych w systemie plików, różnice między Data Lake a Data Warehouse.

  • Formaty danych - JSON, Parquet, Delta
    • Krótkie porównanie formatów danych, ich zalety i zastosowania w środowisku Spark.

  • Architektura Medallion
    • Prezentacja trójwarstwowej architektury danych (Bronze, Silver, Gold) stosowanej w nowoczesnych rozwiązaniach DataLakehouse.

  • Warsztat - część zaawansowana
    • Zastosowanie zaawansowanych funkcji Spark i Databricks w praktyce - ćwiczenia z agregacji danych, użycia UDF, pracy z różnymi formatami danych i wykorzystania architektury Medallion.

Zainteresowany? Zapisz się na szkolenie!

Zapisz się — wybierz termin

Szkolenie Przetwarzanie danych w Apache Spark za pomocą PySpark i Spark SQL realizowane tylko dla pracowników Twojej firmy?

To szkolenie możemy zorganizować w formie zamkniętej — wyłącznie dla Twojego zespołu. Doświadczony trener-praktyk poprowadzi szkolenie skrojone pod potrzeby Twojej organizacji:

  • Program dopasujemy do potrzeb i poziomu uczestników
  • Termin ustalimy indywidualnie, pod Twój kalendarz
  • Format do wyboru: online na żywo lub stacjonarnie w Twojej lub naszej siedzibie

Zamów bezpłatną, niezobowiązującą wycenę szkolenia zamkniętego.

Zapytaj o bezpłatną wycenę szkolenia
Szkolenie dedykowane dla Twojego zespołu Dopasowany program, termin i format - online lub stacjonarnie w naszej albo w Waszej siedzibie. Napisz lub zadzwoń - wspólnie dobierzemy rozwiązanie dla Twoich pracowników.
5/5 średnia ocena JSystems w Google na podstawie 298 ocen

Terminy gwarantowane

Szkolenia oznaczone jako "termin gwarantowany" odbędą się w zaplanowanym terminie niezależnie od liczby zgłoszonych uczestników. Nie musisz się martwić, że szkolenie zostanie odwołane z powodu zbyt małej liczby zapisanych osób.

Szkolenia online

Szkolenie realizowane jest w formie zdalnej na żywo poprzez platformę ZOOM. Trener prowadzi szkolenie na żywo, a uczestnicy mogą na bieżąco zadawać pytania i wykonywać ćwiczenia. Format online zapewnia pełną interakcję z trenerem, identyczną jak przy szkoleniu stacjonarnym.

Szkolenie na żywo z trenerem — nie kurs video

To nie jest nagrany kurs video. Przez cały czas trwania szkolenia masz bezpośredni kontakt z doświadczonym trenerem-praktykiem. Możesz na bieżąco zadawać pytania, prosić o wyjaśnienie trudnych zagadnień, konsultować własne projekty i uzyskać odpowiedź na dowolne pytanie związane z tematyką szkolenia. To realne wsparcie eksperta, którego nie zapewni żaden kurs nagrany.

Certyfikat ukończenia szkolenia

Każdy uczestnik po ukończeniu szkolenia otrzymuje imienny certyfikat potwierdzający udział i zdobyte kompetencje. Certyfikat wystawiany jest przez JSystems — firmę z certyfikatem ISO 9001 — i jest honorowany przez pracodawców.

Środowisko robocze

Nie jest wymagane instalowanie żadnego oprogramowania. Każdy uczestnik szkolenia otrzymuje dostęp do gotowego środowiska w chmurze, skonfigurowanego na potrzeby szkolenia. Dostęp realizowany jest poprzez przeglądarkę lub zdalny pulpit, w zależności od szkolenia.
Sprawdź pozostałe szkolenia z kategorii:

Python

Opinie uczestników

5.0/5
Przetwarzanie danych w Apache Spark za pomocą PySpark i Spark SQL

Szkolenie bardzo profesjonalne z bardzo dużą ilością praktyki. Prowadzący bardzo dobrze przygotowany, szczerze polecam :)

Adam Górski BEST S.A.
4.9/5
Analiza danych w języku Python

Polecam prowadzącego - Mateusz Zimoch

Tomasz Kopicki Nordea Bank Abp Spółka Akcyjna
5.0/5
Programowanie w języku Python - podstawy

Bardzo dobrze przeprowadzone szkolenie, dużo przerobionego materiału i dużo wykonanych ćwiczeń pod okiem trenera. Szeroki zakres materiału z podstaw Pythona - wszystko co potrzebne na początku zostało omówione i przećwiczone. Polecam.

Dawid Żurek Gmina Miejska Kraków
5.0/5
Programowanie w języku Python - podstawy

Bardzo dobrze przygotowane szkolenie, prowadzone w przystępny sposób i oparte na praktycznych przykładach. Polecam osobom, które chcą zdobyć lub uporządkować wiedzę w danym obszarze.

Przemysław Walaszczyk Baltic Hub Container Terminal Sp. z o.o.
5.0/5
Programowanie w języku Python - podstawy

Polecam kurs

Mateusz Olejniczak COM40 Sp. z o.o. Sp. K.
5.0/5
Python od podstaw, przez analizę danych, do machine learning

Merytoryczne podejście. Polecam.

Maciej Wiklent Energa-Operator SA
4.8/5
Uczenie maszynowe (Machine Learning) w Pythonie

Spoko w branży finansowej!

Konrad Gruszka Politechnika Częstochowska
5.0/5
Uczenie maszynowe (Machine Learning) w Pythonie

Bardzo dobrze i sprawnie przeprowadzone szkolenie dot. technik ML w pythonie. Polecam dla osób które zajmują się tym w praktyce. Możliwość pogłębienia wiedzy w tej dziedzinie.

Anna Matuszyk Bank Millennium S.A.
Pokaż wszystkie opinie Google Opinie w Google

Zaufali nam

...oraz setki innych firm

Dlaczego warto nas wybrać?

Terminy gwarantowane na 100%

Jeśli termin jest oznaczony jako gwarantowany, odbędzie się we wskazanym czasie — nawet jeśli część grupy wycofa się z udziału. Ryzyko organizacyjne ponosimy my, nie Ty.

Trenerzy-praktycy z oceną minimum 4.75/5

Każdy trener JSystems ma bogate doświadczenie komercyjne w technologiach których uczy i musi utrzymywać średnią z ankiet powyżej 4.75 na 5. Czerwony pasek to u nas minimum ;)

100% format warsztatowy

Każde zagadnienie teoretyczne jest poparte ćwiczeniami praktycznymi o rosnącym poziomie trudności. Uczymy przez działanie, nie przez slajdy.

Jesteśmy w BUR

Jako zarejestrowany dostawca usług w Bazie Usług Rozwojowych umożliwiamy sfinansowanie szkoleń pracowników ze środków zewnętrznych — dofinansowanie z BUR i KFS sięga nawet 100% wartości szkolenia.

Certyfikat ISO 9001

Posiadamy certyfikat ISO 9001 potwierdzający najwyższe standardy jakości naszych usług szkoleniowych i procesów organizacyjnych.

Gotowe środowiska w chmurze

Do każdego szkolenia wymagającego oprogramowania dostarczamy skonfigurowane, gotowe hosty w chmurze. Uczestnik nie musi nic instalować — łączy się przez zdalny pulpit lub SSH.

Dowiedz się dlaczego warto nas wybrać

Masz pytania? Zadzwoń lub napisz!
22 299 53 69 biuro@jsystems.pl
Pon–Pt 9:00–17:00
A może nielimitowane szkolenia za
1 148 PLN brutto / mies.?
Sprawdź Karnet Open
KARNET OPEN na szkolenia

Najczęstsze pytania

Ile trwa szkolenie „Przetwarzanie danych w Apache Spark za pomocą PySpark i Spark SQL”?

Szkolenie trwa 2 dni.

Ile kosztuje szkolenie „Przetwarzanie danych w Apache Spark za pomocą PySpark i Spark SQL”?

Cena to 1 800 zł netto (2 214 zł brutto) za osobę.

Czy szkolenie „Przetwarzanie danych w Apache Spark za pomocą PySpark i Spark SQL” jest dofinansowane z BUR / KFS?

Tak. Jesteśmy wpisani do Bazy Usług Rozwojowych, więc udział w szkoleniu można sfinansować z dofinansowania BUR lub KFS - nawet do 100% wartości. Szczegóły znajdziesz na stronie dofinansowanie BUR/KFS.

Czy szkolenie „Przetwarzanie danych w Apache Spark za pomocą PySpark i Spark SQL” ma termin gwarantowany?

W tej chwili nie mamy ustawionego terminu gwarantowanego tego szkolenia. Zapisz się na powiadomienia o terminach gwarantowanych, a damy Ci znać, gdy tylko taki termin się pojawi. Szkolenie jest też dostępne w formie dedykowanej dla firm.

Czy szkolenie „Przetwarzanie danych w Apache Spark za pomocą PySpark i Spark SQL” można zamówić jako zamknięte dla firmy?

Tak. Realizujemy je również w formie zamkniętej (dedykowanej) dla Twojego zespołu.

Czy szkolenie „Przetwarzanie danych w Apache Spark za pomocą PySpark i Spark SQL” odbywa się online, czy stacjonarnie?

Szkolenie „Przetwarzanie danych w Apache Spark za pomocą PySpark i Spark SQL” prowadzimy w formie online - na żywo z trenerem przez platformę ZOOM, z pełną interakcją i ćwiczeniami. To nie jest nagrany kurs wideo. Szkolenie stacjonarne możemy zrealizować jako dedykowane - tylko dla Twojej firmy.
A może nielimitowane szkolenia za
1 148 PLN brutto / mies.?
Sprawdź Karnet Open
KARNET OPEN na szkolenia

Zanim wyjdziesz

Wyślemy Ci podsumowanie tego szkolenia z terminami i ceną — do przemyślenia w spokoju.

Żadnego spamu — tylko jedno podsumowanie.