Blog JSystems - uwalniamy wiedzę!
Blog JSystems - uwalniamy wiedzę!
Jeśli ostatni raz pisałeś kod pod Oracle 12c albo 18c, to baza danych, którą znasz, zmieniła się bardziej, niż myślisz. Przez ostatnie lata Oracle dorzucił do języka SQL i PL/SQL rzeczy, na które programiści czekali latami: prawdziwy typ BOOLEAN, SELECT bez FROM, natywny typ JSON, JavaScript wykonywany wewnątrz bazy, makra SQL, a w 23ai - typ VECTOR i wyszukiwanie semantyczne pod AI. Ten artykuł to przegląd najważniejszych nowości wprowadzonych po 18c, wersja po wersji, z konkretnym kodem, który możesz wkleić i uruchomić. Dopisaliśmy do niego także wersję 26ai, czyli Oracle AI Database: nowe wydanie długoterminowe, w którym doszly klauzula QUALIFY, filtry w agregatach, funkcje kalendarzowe i asercje.
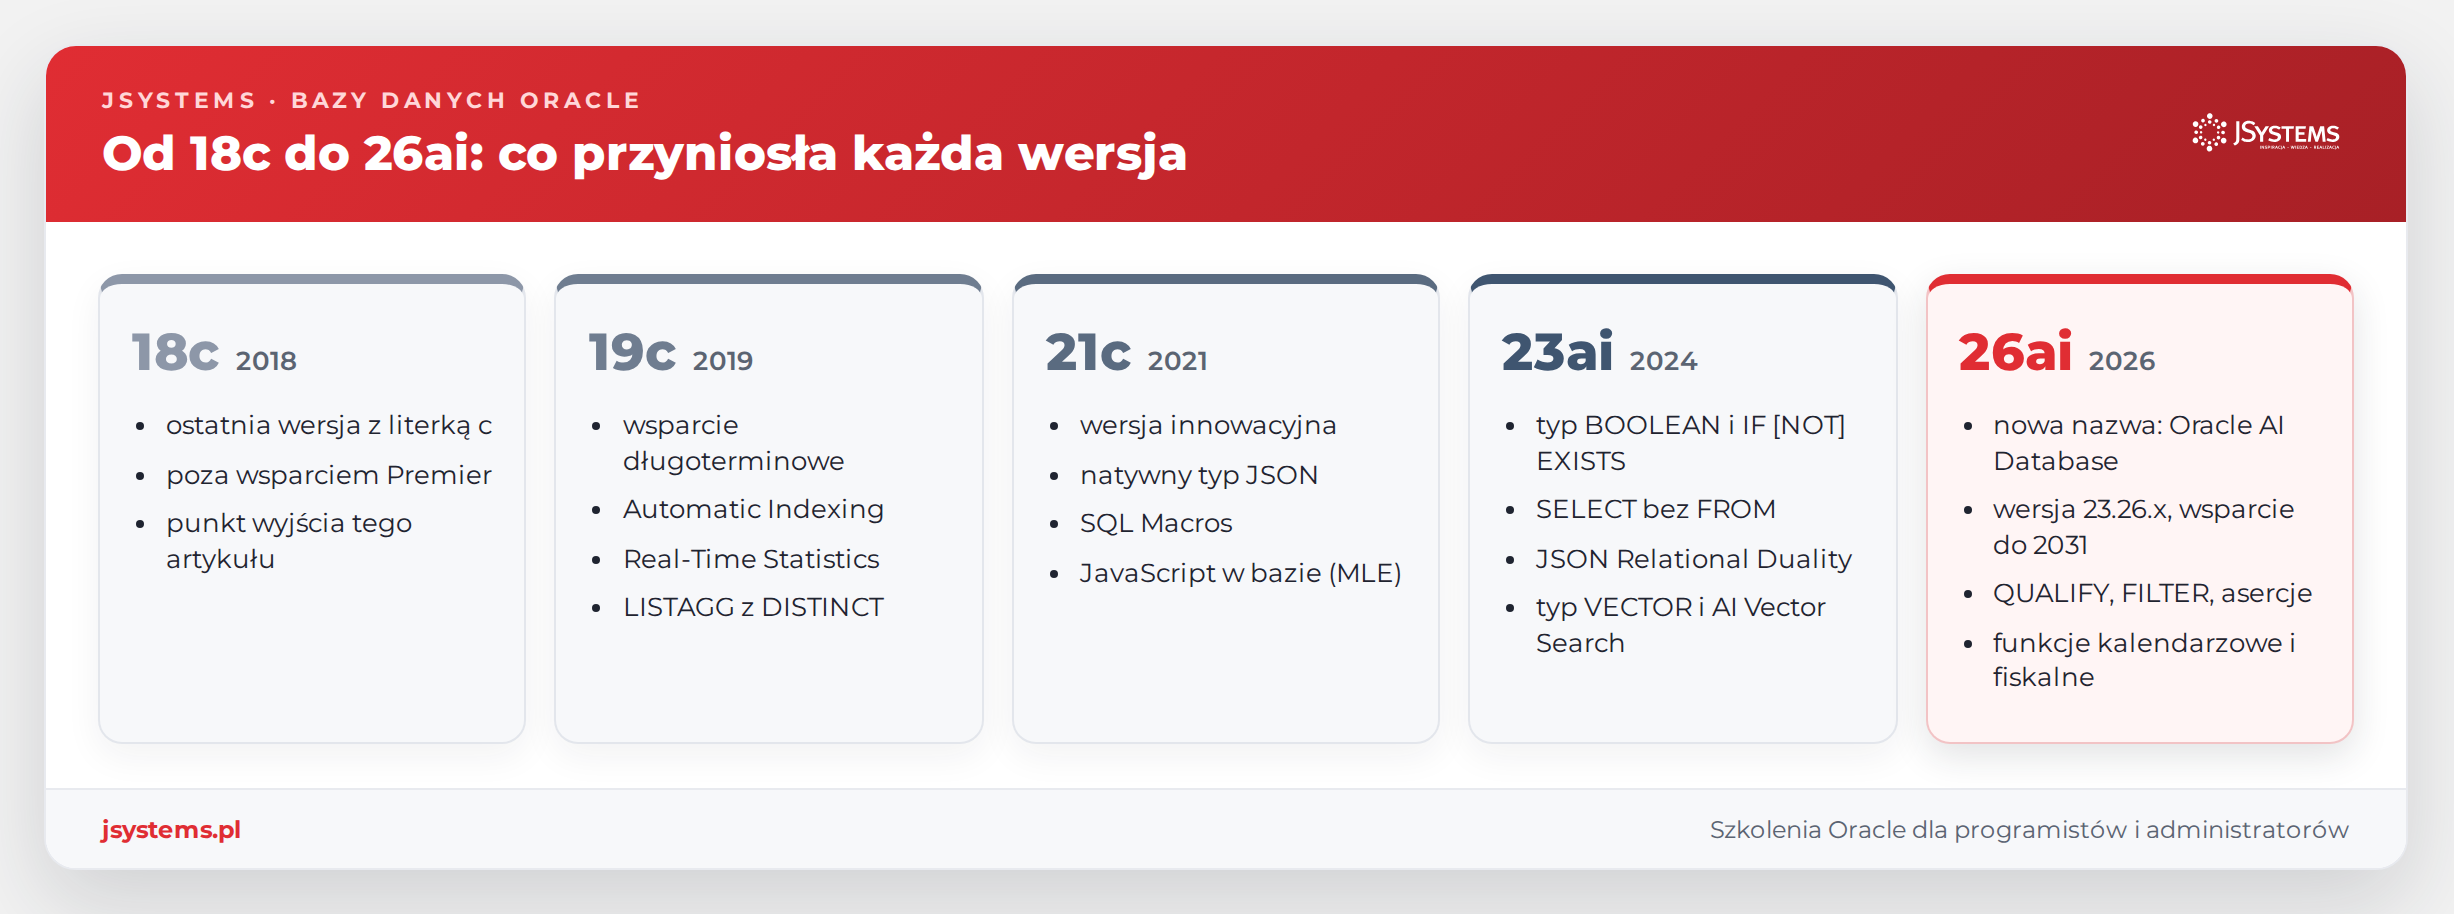
Najpierw porządek w nazewnictwie, bo Oracle sam namieszał. Po 18c numeracja przestała oznaczać "co roku jedna duża wersja" i podzieliła się na dwa nurty:
19c to nie rewolucja składni, tylko automatyzacja i wydajność. Cztery rzeczy, które realnie zmieniają codzienną pracę z bazą:
Przed 19c LISTAGG nie znało słowa DISTINCT. Żeby skleić tylko unikalne wartości, trzeba było albo odsiać duplikaty osobnym podzapytaniem, albo posłużyć się brzydkim trikiem z REGEXP_REPLACE na gotowym stringu:
-- Przed 19c, wariant 1: duplikaty odsiane wczesniej, w podzapytaniu
SELECT department_id,
       LISTAGG(job_id, ', ') WITHIN GROUP (ORDER BY job_id) AS stanowiska
FROM   (SELECT DISTINCT department_id, job_id FROM employees)
GROUP  BY department_id;

-- Przed 19c, wariant 2: trik regexem usuwajacy powtorzenia w gotowym stringu
SELECT department_id,
       REGEXP_REPLACE(
         LISTAGG(job_id, ', ') WITHIN GROUP (ORDER BY job_id),
         '([^,]+)(, \1)+', '\1') AS stanowiska
FROM   employees
GROUP  BY department_id;
Od 19c to jedno słowo - DISTINCT prosto w LISTAGG, bez podzapytań i trików:
-- 19c: DISTINCT bezpośrednio w LISTAGG
SELECT department_id,
       LISTAGG(DISTINCT job_id, ', ')
         WITHIN GROUP (ORDER BY job_id) AS stanowiska
FROM   employees
GROUP  BY department_id;

-- DEPARTMENT_ID  STANOWISKA
-- 50             SH_CLERK, ST_CLERK, ST_MAN
-- 80 SA_MAN, SA_REPJedna z największych nowości 19c (Enterprise Edition oraz Autonomous Database). Co kilkanaście minut baza analizuje rzeczywiste obciążenie, wykrywa zapytania, którym brakuje indeksu, i zakłada kandydujące indeksy jako niewidoczne (invisible) - optymalizator korzysta z nich tylko w trybie testowym. Potem porównuje wydajność tych samych zapytań z indeksem i bez niego: jeśli indeks realnie pomaga, publikuje go (staje się widoczny dla wszystkich), a jeśli nie - odrzuca. Automatycznie utworzone indeksy poznasz po nazwie zaczynającej się od SYS_AI_ i fladze AUTO = 'YES'.
Sterujesz tym jedną procedurą z pakietu DBMS_AUTO_INDEX - zwykle najpierw w trybie raportowym, a po sprawdzeniu przełączasz na produkcyjny:
-- Tryb testowy: baza TYLKO rekomenduje, nic nie tworzy
EXEC DBMS_AUTO_INDEX.CONFIGURE('AUTO_INDEX_MODE', 'REPORT ONLY');

-- Tryb produkcyjny: automat sam tworzy i publikuje pomocne indeksy
EXEC DBMS_AUTO_INDEX.CONFIGURE('AUTO_INDEX_MODE', 'IMPLEMENT');

-- Ogranicz automat do wybranych schematow (np. tylko HR i SALES)
EXEC DBMS_AUTO_INDEX.CONFIGURE('AUTO_INDEX_SCHEMA', 'HR', TRUE);
EXEC DBMS_AUTO_INDEX.CONFIGURE('AUTO_INDEX_SCHEMA', 'SALES', TRUE);

-- Ile dni trzymac nieuzywane auto-indeksy, zanim baza je skasuje
EXEC DBMS_AUTO_INDEX.CONFIGURE('AUTO_INDEX_RETENTION_FOR_AUTO', '30');
Gdzie podejrzeć, co automat utworzył? Auto-indeksy leżą w tych samych widokach słownikowych co zwykłe, tylko z flagą AUTO = 'YES' - do tego masz widok konfiguracji i gotowy raport tekstowy:
-- Lista indeksow utworzonych automatycznie (nazwy SYS_AI_...)
SELECT owner, index_name, table_name, auto, visibility, status
FROM   dba_indexes
WHERE  auto = 'YES'
ORDER  BY owner, table_name;

-- Biezaca konfiguracja automatu (tryb, schematy, retencja)
SELECT parameter_name, parameter_value
FROM   dba_auto_index_config;

-- Pelny raport za ostatnia dobe: co utworzono/odrzucono,
-- o ile przyspieszyly zapytania, ile zajely miejsca
SELECT DBMS_AUTO_INDEX.REPORT_ACTIVITY(
         SYSTIMESTAMP - 1, SYSTIMESTAMP) AS raport
FROM   dual;
Tak to wygląda na żywej bazie. Sam widok konfiguracji podejrzysz na każdej edycji - poniżej realny zrzut dba_auto_index_config ze świeżej instancji. Domyślnie automat jest wyłączony (AUTO_INDEX_MODE = OFF), nieużywane auto-indeksy baza trzyma 373 dni, a raporty 40 dni:
SQL> SELECT parameter_name, parameter_value FROM dba_auto_index_config;

PARAMETER_NAME                         PARAMETER_VALUE
-------------------------------------- ----------------
AUTO_INDEX_COMPRESSION                 OFF
AUTO_INDEX_DEFAULT_TABLESPACE
AUTO_INDEX_INCLUDE_DML_COST            ON
AUTO_INDEX_MODE                        OFF
AUTO_INDEX_REPORT_RETENTION            40
AUTO_INDEX_RETENTION_FOR_AUTO          373
AUTO_INDEX_RETENTION_FOR_MANUAL
AUTO_INDEX_SCHEMA
AUTO_INDEX_SPACE_BUDGET                50
AUTO_INDEX_TABLE

10 rows selected.
Uwaga licencyjna. Samo włączenie automatu (AUTO_INDEX_MODE = IMPLEMENT) i powstające indeksy SYS_AI_ to funkcja Enterprise Edition oraz Autonomous Database. Na Standard Edition i w bezpłatnym Oracle Database Free ta sama procedura zwraca błąd:
SQL> EXEC DBMS_AUTO_INDEX.CONFIGURE('AUTO_INDEX_MODE', 'IMPLEMENT');

BEGIN DBMS_AUTO_INDEX.CONFIGURE('AUTO_INDEX_MODE', 'IMPLEMENT'); END;

*
ERROR at line 1:
ORA-40216: feature not supported
Lista utworzonych indeksów. Na wspieranej platformie (Autonomous Database lub Exadata) ta sama procedura przechodzi i automat realnie zakłada indeksy. Auto-indeks poznasz po prefiksie SYS_AI_ i fladze AUTO = 'YES'; kolumna VISIBILITY pokazuje etap weryfikacji (najpierw INVISIBLE - optymalizator testuje indeks w ukryciu, a po potwierdzeniu zysku VISIBLE), zaś STATUS = VALID oznacza indeks gotowy do użycia. Oto autentyczny przebieg z Autonomous Database 19c: po przełączeniu na IMPLEMENT i cyklu automatu nad naszym obciążeniem (tabela 1 mln wierszy, powtarzane zapytania po nieindeksowanej kolumnie KLIENT_ID) powstał jeden indeks. Na Standard Edition i w Oracle Free to samo zapytanie zwraca brak wierszy - automat tam nie działa:
SQL> SELECT owner, index_name, table_name, auto, visibility, status
     FROM dba_indexes WHERE auto = 'YES';

OWNER INDEX_NAME           TABLE_NAME AUTO VISIBILITY STATUS
----- -------------------- ---------- ---- ---------- ------
ADMIN SYS_AI_99zjgtmjmwt9a ZAMOWIENIA YES  VISIBLE    VALID
Raport aktywności. Skoro indeks już jest, REPORT_ACTIVITY daje gotowe podsumowanie dla administratora: które indeksy powstały, o ile procent przyspieszyły konkretne zapytania, ile zajęły miejsca i które kandydatury baza odrzuciła jako nieprzydatne - bez ręcznego zgadywania. Z tego samego przebiegu:
SQL> SELECT DBMS_AUTO_INDEX.REPORT_ACTIVITY() FROM dual;

GENERAL INFORMATION
-------------------------------------------------------------------------------
 Activity start               : 23-JUN-2026 16:04:28
 Activity end                 : 23-JUN-2026 17:04:28
 Executions completed         : 1

SUMMARY (AUTO INDEXES)
-------------------------------------------------------------------------------
 Index candidates                              : 1
 Indexes created (visible / invisible)         : 1 (1 / 0)
 Space used (visible / invisible)              : 13.63 MB (13.63 MB / 0 B)
 SQL statements verified                       : 2
 SQL statements improved (improvement factor)  : 2 (389.5x)
 Overall improvement factor                    : 389.5x

INDEX DETAILS
-------------------------------------------------------------------------------
| Owner | Table      | Index                | Key       | Type   |
| ADMIN | ZAMOWIENIA | SYS_AI_99zjgtmjmwt9a | KLIENT_ID | B-TREE |

VERIFICATION DETAILS
-------------------------------------------------------------------------------
 SQL ID             : 7p9s5mbztk5zn
 SQL Text           : SELECT SUM(KWOTA) S FROM ZAMOWIENIA
                      WHERE KLIENT_ID = MOD(:B1*13,50000)
 Improvement Factor : 220.17x
Z raportu czytasz wprost: 1 kandydat, 1 utworzony indeks (13,63 MB), 2 zapytania zweryfikowane i poprawione, B-drzewo na KLIENT_ID - ze współczynnikiem poprawy 389,5x. To samo zadanie z czasem usuwa też nieużywane auto-indeksy i samo wycofuje zmiany, które nie przyniosły poprawy - bez udziału administratora. Same zapytania kontrolne (widoki słownikowe + REPORT_ACTIVITY) są identyczne na każdej edycji - różni się tylko to, czy automat ma prawo działać.
Do tej pory statystyki optymalizatora robił DBMS_STATS w oknie nocnym, a między zbieraniami potrafiły się "zestarzeć". W 19c (Enterprise Edition na Exadata) baza dozbiera podstawowe statystyki automatycznie podczas zwykłych operacji INSERT / UPDATE, dzięki czemu optymalizator ma świeższe dane bez czekania na nocny job.
Gdy Resource Manager zabije zapytanie za zbyt żarłoczne zużycie CPU/IO, 19c zapamiętuje jego plan wykonania i "kwarantannuje" go - kolejne uruchomienie tego samego, kosztownego planu jest odrzucane od razu, bez ponownego zarżynania serwera.
-- Podgląd skwarantannowanych planów
SELECT name, plan_hash_value, last_executed
FROM   dba_sql_quarantine;

-- Ręczne usunięcie konfiguracji kwarantanny
EXEC DBMS_SQLQ.DROP_QUARANTINE('SQL_QUARANTINE_abc123');21c to wersja, w której Oracle przestaje być "tylko relacyjną bazą". Pojawia się natywny JSON, JavaScript w środku silnika, makra SQL i tabele kryptograficzne. Nawet jeśli nie wdrożysz 21c na produkcji, warto znać te funkcje - większość z nich jest dostępna też w 23ai.
Wcześniej JSON trzymaliśmy w VARCHAR2 / CLOB z ograniczeniem IS JSON. 21c wprowadza dedykowany typ JSON, w którym dokument jest parsowany raz, przy zapisie - odczyt i aktualizacja są wielokrotnie szybsze.
CREATE TABLE zamowienia (
  id    NUMBER GENERATED ALWAYS AS IDENTITY,
  dane  JSON                       -- natywny typ, nie VARCHAR2/CLOB
);

INSERT INTO zamowienia (dane) VALUES (
  '{"klient":"Nowak Sp. z o.o.","pozycje":[{"sku":"A1","ilosc":3}],"kwota":1499.00}'
);

-- Dot-notation prosto po polach JSON, bez funkcji:
SELECT z.dane.klient        AS klient,
       z.dane.kwota.number() AS kwota
FROM   zamowienia z
WHERE z.dane.kwota.number() > 1000;Makra SQL to funkcje, które zamiast wartości zwracają fragment tekstu SQL wstawiany do zapytania w czasie parsowania. Działają jak szablon, ale bez narzutu wywołania funkcji PL/SQL dla każdego wiersza. Są dwa rodzaje: SCALAR (do SELECT/WHERE) i TABLE (do FROM).
-- MAKRO SKALARNE: czytelny warunek "między datami"
CREATE OR REPLACE FUNCTION between_dates(p_col DATE, p_from DATE, p_to DATE)
  RETURN VARCHAR2 SQL_MACRO(SCALAR)
IS
BEGIN
  RETURN 'p_col BETWEEN p_from AND p_to';
END;
/

SELECT * FROM employees
WHERE between_dates(hire_date, DATE '2020-01-01', DATE '2020-12-31');

-- MAKRO TABELARYCZNE: parametryzowany "TOP N" jako źródło w FROM
CREATE OR REPLACE FUNCTION top_n_salary(p_n NUMBER)
  RETURN CLOB SQL_MACRO
IS
BEGIN
  RETURN 'SELECT employee_id, last_name, salary
          FROM employees
          ORDER BY salary DESC
          FETCH FIRST p_n ROWS ONLY';
END;
/

SELECT * FROM top_n_salary(5);Multilingual Engine (MLE) pozwala uruchomić kod JavaScript wewnątrz bazy, z dwukierunkową wymianą danych z PL/SQL i SQL. Idealne, gdy masz gotową logikę w JS albo potrzebujesz przetwarzania, które w SQL jest niewygodne.
DECLARE
  l_ctx    DBMS_MLE.context_handle_t;
  l_source CLOB;
BEGIN
  l_ctx := DBMS_MLE.create_context();
  l_source := q'~
    // JavaScript wykonywany wewnątrz Oracle
    const result = session.execute(
      "SELECT last_name FROM employees WHERE rownum <= 3");
    let names = [];
    while (result.rows && result.rows.length) {
      names = result.rows.map(r => r[0]);
      break;
    }
    soda; // dostęp do kolekcji JSON także z JS
    console.log("Pracownicy: " + names.join(", "));
  ~';
  DBMS_MLE.eval(l_ctx, 'JAVASCRIPT', l_source);
  DBMS_MLE.drop_context(l_ctx);
END;
/Tabele typu blockchain pozwalają wyłącznie na INSERT. Każdy wiersz jest kryptograficznie połączony (hash) z poprzednim - próba modyfikacji lub usunięcia historii jest wykrywana. Świetne do logów audytowych, które muszą być niepodważalne (compliance, AML, RODO).
CREATE BLOCKCHAIN TABLE audyt_operacji (
  id        NUMBER,
  operacja  VARCHAR2(100),
  uzytkownik VARCHAR2(50),
  ts        TIMESTAMP
)
NO DROP UNTIL 31 DAYS IDLE          -- nie skasujesz tabeli od ręki
NO DELETE LOCKED                    -- wierszy nie da się usunąć
HASHING USING "SHA2_512" VERSION "v1";

-- Działa tylko INSERT; UPDATE/DELETE = błąd ORA-05715
Pokrewną funkcją są Immutable Tables (też 21c) - niezmienne tabele bez całego łańcucha hashy, gdy potrzebujesz tylko "insert-only" bez pełnej kryptografii blockchaina.
To wersja, na którą programiści czekali najdłużej. 23ai usuwa irytujące różnice między Oracle a PostgreSQL/MySQL i dorzuca rzeczy, których w ogóle nie było. Przejdźmy przez nie z kodem.
Koniec z CHAR(1) i NUMBER(1) udającymi logikę. 23ai ma natywny BOOLEAN w SQL - w kolumnach, warunkach i INSERT. Akceptuje też wartości tekstowe jak 'yes'/'no', 'on'/'off', 1/0.
CREATE TABLE uzytkownicy (
  id      NUMBER GENERATED ALWAYS AS IDENTITY,
  login   VARCHAR2(50),
  aktywny BOOLEAN,            -- natywny typ logiczny
  archiwum BOOL DEFAULT FALSE -- BOOL = synonim BOOLEAN
);

INSERT INTO uzytkownicy (login, aktywny, archiwum) VALUES
  ('anowak', TRUE,  FALSE),
  ('jkowal', 'yes', 'no'),   -- wartości tekstowe też działają
  ('bzych',  1,     0);

SELECT login FROM uzytkownicy WHERE aktywny; -- bez = TRUESkrypty migracyjne bez blokuów BEGIN ... EXCEPTION WHEN OTHERS. 23ai pozwala warunkowo tworzyć i usuwać obiekty:
DROP TABLE IF EXISTS logi_tymczasowe;

CREATE TABLE IF NOT EXISTS slownik_statusow (
  kod   VARCHAR2(10) PRIMARY KEY,
  opis  VARCHAR2(100)
);

CREATE INDEX IF NOT EXISTS idx_status_opis ON slownik_statusow(opis);Klasyczny zgrzyt dla osób znających PostgreSQL: w Oracle nie dało się grupować po aliasie z SELECT. W 23ai już można - po aliasie albo po numerze pozycji:
SELECT TRUNC(hire_date, 'MM') AS miesiac,
       COUNT(*)               AS liczba
FROM   employees
GROUP  BY miesiac          -- alias zamiast powtarzania TRUNC(...)
ORDER  BY miesiac;

-- Można też po pozycji:
SELECT department_id, job_id, COUNT(*)
FROM   employees
GROUP BY 1, 2;Drobiazg, który cieszy. Proste wyliczenia i wywołania funkcji bez sztucznego FROM dual:
SELECT 25.50 * 25.25;           -- 643.875
SELECT SYSDATE;                  -- bieżąca data
SELECT 'Witaj ' || USER; -- bez FROM dualTzw. Table Value Constructor. Zamiast wielu osobnych INSERT albo INSERT ALL - jedna lista wartości. Działa też w SELECT:
INSERT INTO slownik_statusow (kod, opis) VALUES
  ('NEW', 'Nowy'),
  ('PRC', 'W realizacji'),
  ('FIN', 'Zakończony'),
  ('ERR', 'Błąd');

-- VALUES jako źródło wierszy w SELECT:
SELECT * FROM (VALUES (1,'a'), (2,'b'), (3,'c')) AS t(nr, litera);23ai pozwala użyć FROM z innymi tabelami wprost w UPDATE i DELETE, bez korelowanych podzapytań:
-- Podwyżka dla działu IT - złączenie wprost w UPDATE
UPDATE employees e
SET    e.salary = e.salary * 1.10
FROM   departments d
WHERE  e.department_id = d.department_id
AND    d.department_name = 'IT';

-- DELETE ze złączeniem
DELETE FROM order_items oi
FROM   orders o
WHERE  oi.order_id = o.order_id
AND o.status = 'CANCELLED';Klauzula RETURNING w 23ai potrafi zwrócić jednocześnie wartość przed i po zmianie - idealne do audytu i logów bez dodatkowego SELECT:
DECLARE
  v_old NUMBER;
  v_new NUMBER;
BEGIN
  UPDATE employees
  SET    salary = salary * 1.10
  WHERE  employee_id = 100
  RETURNING OLD salary, NEW salary INTO v_old, v_new;

  DBMS_OUTPUT.PUT_LINE('Przed: '||v_old||'  Po: '||v_new);
END;
/Domena to nazwany zestaw typu + ograniczeń + formatowania, który przypisujesz wielu kolumnom. Definiujesz regułę (np. poprawny e-mail) raz, a używasz wszędzie:
CREATE DOMAIN email_dom AS VARCHAR2(255)
  CONSTRAINT email_chk CHECK (REGEXP_LIKE(email_dom, '^[^@]+@[^@]+\.[^@]+$'));

CREATE TABLE kontakty (
  id    NUMBER,
  email VARCHAR2(255) DOMAIN email_dom   -- reguła dziedziczona z domeny
);Lekka alternatywa dla komentarzy - pary nazwa/wartość opisujące kolumny i tabele, czytelne dla narzędzi i aplikacji (np. "to pole jest wrażliwe", "ukryj w UI"):
CREATE TABLE pacjenci (
  id    NUMBER,
  pesel VARCHAR2(11) ANNOTATIONS (PII, Display 'Numer PESEL'),
  imie  VARCHAR2(50) ANNOTATIONS (Display 'Imię')
) ANNOTATIONS (Schemat 'medyczny');

SELECT * FROM user_annotations_usage; -- przegląd adnotacjiSztandarowa funkcja 23ai. Te same dane relacyjne możesz czytać i zapisywać jako dokumenty JSON - baza synchronizuje oba światy. Aplikacja webowa dostaje wygodny JSON, a integralność i transakcyjność pilnuje relacyjny silnik:
CREATE JSON RELATIONAL DUALITY VIEW dzial_dv AS
  SELECT JSON {
    '_id'   : d.department_id,
    'nazwa' : d.department_name,
    'pracownicy' :
      [ SELECT JSON { 'id': e.employee_id, 'nazwisko': e.last_name }
        FROM employees e WITH INSERT UPDATE
        WHERE e.department_id = d.department_id ]
  }
  FROM departments d WITH INSERT UPDATE DELETE;

-- Czytasz jako dokument:
SELECT data FROM dzial_dv WHERE json_value(data, '$._id') = 50;

-- ...i zapisujesz jako dokument - baza rozkłada to na tabele:
-- (INSERT/UPDATE na widoku dualnym)23ai pozwala wymusić zgodność dokumentu JSON ze schematem wprost w CHECK:
CREATE TABLE produkty (
  id   NUMBER,
  dane JSON VALIDATE '{
    "type": "object",
    "properties": {
      "sku":   {"type": "string"},
      "cena":  {"type": "number", "minimum": 0}
    },
    "required": ["sku", "cena"]
  }'
);
-- INSERT niezgodny ze schematem zostanie odrzuconyNajważniejsza nowość całej wersji. Natywny typ VECTOR przechowuje embeddingi (wektory cech) obok danych biznesowych, a funkcja VECTOR_DISTANCE liczy podobieństwo semantyczne. Dzięki temu wyszukiwanie "po znaczeniu" (RAG, rekomendacje, semantic search) robisz zwykłym SQL-em - bez osobnej bazy wektorowej:
CREATE TABLE dokumenty (
  id        NUMBER,
  tytul     VARCHAR2(200),
  tresc     CLOB,
  embedding VECTOR(768, FLOAT32)   -- 768 wymiarów, liczby 32-bit
);

-- Wyszukiwanie semantyczne: 5 dokumentów najbliższych zapytaniu
SELECT id, tytul
FROM   dokumenty
ORDER  BY VECTOR_DISTANCE(embedding, :wektor_pytania, COSINE)
FETCH  FIRST 5 ROWS ONLY;

-- Indeks wektorowy HNSW dla szybkiego wyszukiwania przybliżonego
CREATE VECTOR INDEX idx_emb ON dokumenty(embedding)
  ORGANIZATION INMEMORY NEIGHBOR GRAPH
DISTANCE COSINE;WHERE status='AKTYWNY') i wyszukiwanie semantyczne dzieją się w jednym zapytaniu, w jednej transakcji. To właśnie ta funkcja dała wersji literę "ai" w nazwie.To nie tylko wektory. Drugą twarzą AI w 23ai jest Select AI - odpytujesz bazę po ludzku, a ona sama pisze SQL. Wystarczy SELECT AI 'przychód w podziale na miesiące', by dostać gotowe zapytanie i wynik - bez znajomości schematu i składni. Wyszukiwanie wektorowe, Select AI oraz uczenie maszynowe w samej bazie rozkładamy na czynniki pierwsze, na realnych danych i zrzutach z żywej bazy, w osobnym artykule: AI w bazie Oracle - Vector Search, Select AI i Machine Learning. Zobaczysz tam m.in. realne SELECT AI nad danymi sprzedażowymi i to, jak baza sama zwraca gotowy SQL. Jeśli temat AI w 23ai Cię wciągnął - to naturalny następny krok.
Po 23ai Oracle zrobił dwie rzeczy naraz: zmienił nazwę produktu i wydał kolejne wydanie
długoterminowe. Baza nazywa się teraz Oracle AI Database, a wersja to
26ai o numerze wewnętrznym 23.26.x. Wbrew nazwie to nie jest nowa
linia kodu: 26ai kontynuuje linię 23, więc jeśli masz już 23ai, przejście na 26ai jest
aktualizacją wydania (release update), a nie migracją bazy. Wersja on-premise dla Linux x86-64
pojawiła się w styczniu 2026 jako 23.26.1, a wsparcie Premier ma trwać do końca
2031 roku.
Wszystkie przykłady w tej sekcji uruchomiliśmy na Oracle AI Database 26ai Free 23.26.2.0.0, na tych samych danych, które możesz pobrać poniżej. Każdy zrzut to realne wyjście z SQL*Plus, a na końcu sekcji pokazujemy, jak te same polecenia zachowują się na 23ai.
kontrahenci i zamowienia, 62 zamówienia z 2026 roku) w jednym skrypcie
do pobrania: 26ai_demo.sql. Uruchom go w dowolnym schemacie na 26ai, a wszystkie
zapytania z tej sekcji zwrócą u Ciebie te same liczby, które widać na zrzutach.Jeśli nie masz jeszcze pod ręką 26ai, najszybsza droga to darmowa edycja Free w kontenerze.
Poniższe polecenie stawia bazę z gotowym użytkownikiem demo w kilka minut:
# Oracle AI Database 26ai Free - kontener developerski
docker run -d --name oracle26ai -p 1521:1521 \
  -e ORACLE_PASSWORD=demo123 -e APP_USER=demo -e APP_USER_PASSWORD=demo123 \
  gvenzl/oracle-free:23.26.2-slim

# połączenie po starcie kontenera (hasło: demo123)
sqlplus demo/demo123@localhost:1521/FREEPDB1Funkcje analityczne (okienkowe) liczone są dopiero po tym, jak baza wybierze i pogrupuje wiersze.
Dlatego WHERE nie widzi wyniku RANK() czy ROW_NUMBER() i każdy
ranking trzeba było zamykać w widoku inline albo w klauzuli WITH. Klauzula
QUALIFY robi dla funkcji okienkowych dokładnie to, co HAVING robi dla
GROUP BY: filtruje po policzonym wyniku, w tym samym zapytaniu.
Tak wyglądało wyciąganie dwóch największych zamówień w każdym regionie przed 26ai:
-- przed 26ai: ranking trzeba schować w widoku inline
SELECT region, nazwa, wartosc, pozycja
FROM (
  SELECT z.region, k.nazwa, z.wartosc,
         RANK() OVER (PARTITION BY z.region ORDER BY z.wartosc DESC) AS pozycja
  FROM   zamowienia z
  JOIN   kontrahenci k ON k.id_kontrahenta = z.id_kontrahenta
  WHERE  z.status <> 'anulowane'
)
WHERE pozycja <= 2
ORDER BY region, pozycja;
A tak wygląda to samo zapytanie w 26ai. Zwróć uwagę, że w warunku QUALIFY można użyć
aliasu kolumny (pozycja), więc nie trzeba powtarzać całego wyrażenia okienkowego:
-- 26ai: QUALIFY filtruje po wyniku funkcji okienkowej
SELECT z.region, k.nazwa, z.wartosc,
       RANK() OVER (PARTITION BY z.region ORDER BY z.wartosc DESC) AS pozycja
FROM   zamowienia z
JOIN   kontrahenci k ON k.id_kontrahenta = z.id_kontrahenta
WHERE  z.status <> 'anulowane'
AND    z.region IN ('mazowieckie', 'małopolskie', 'pomorskie')
QUALIFY pozycja <= 2
ORDER  BY z.region, pozycja;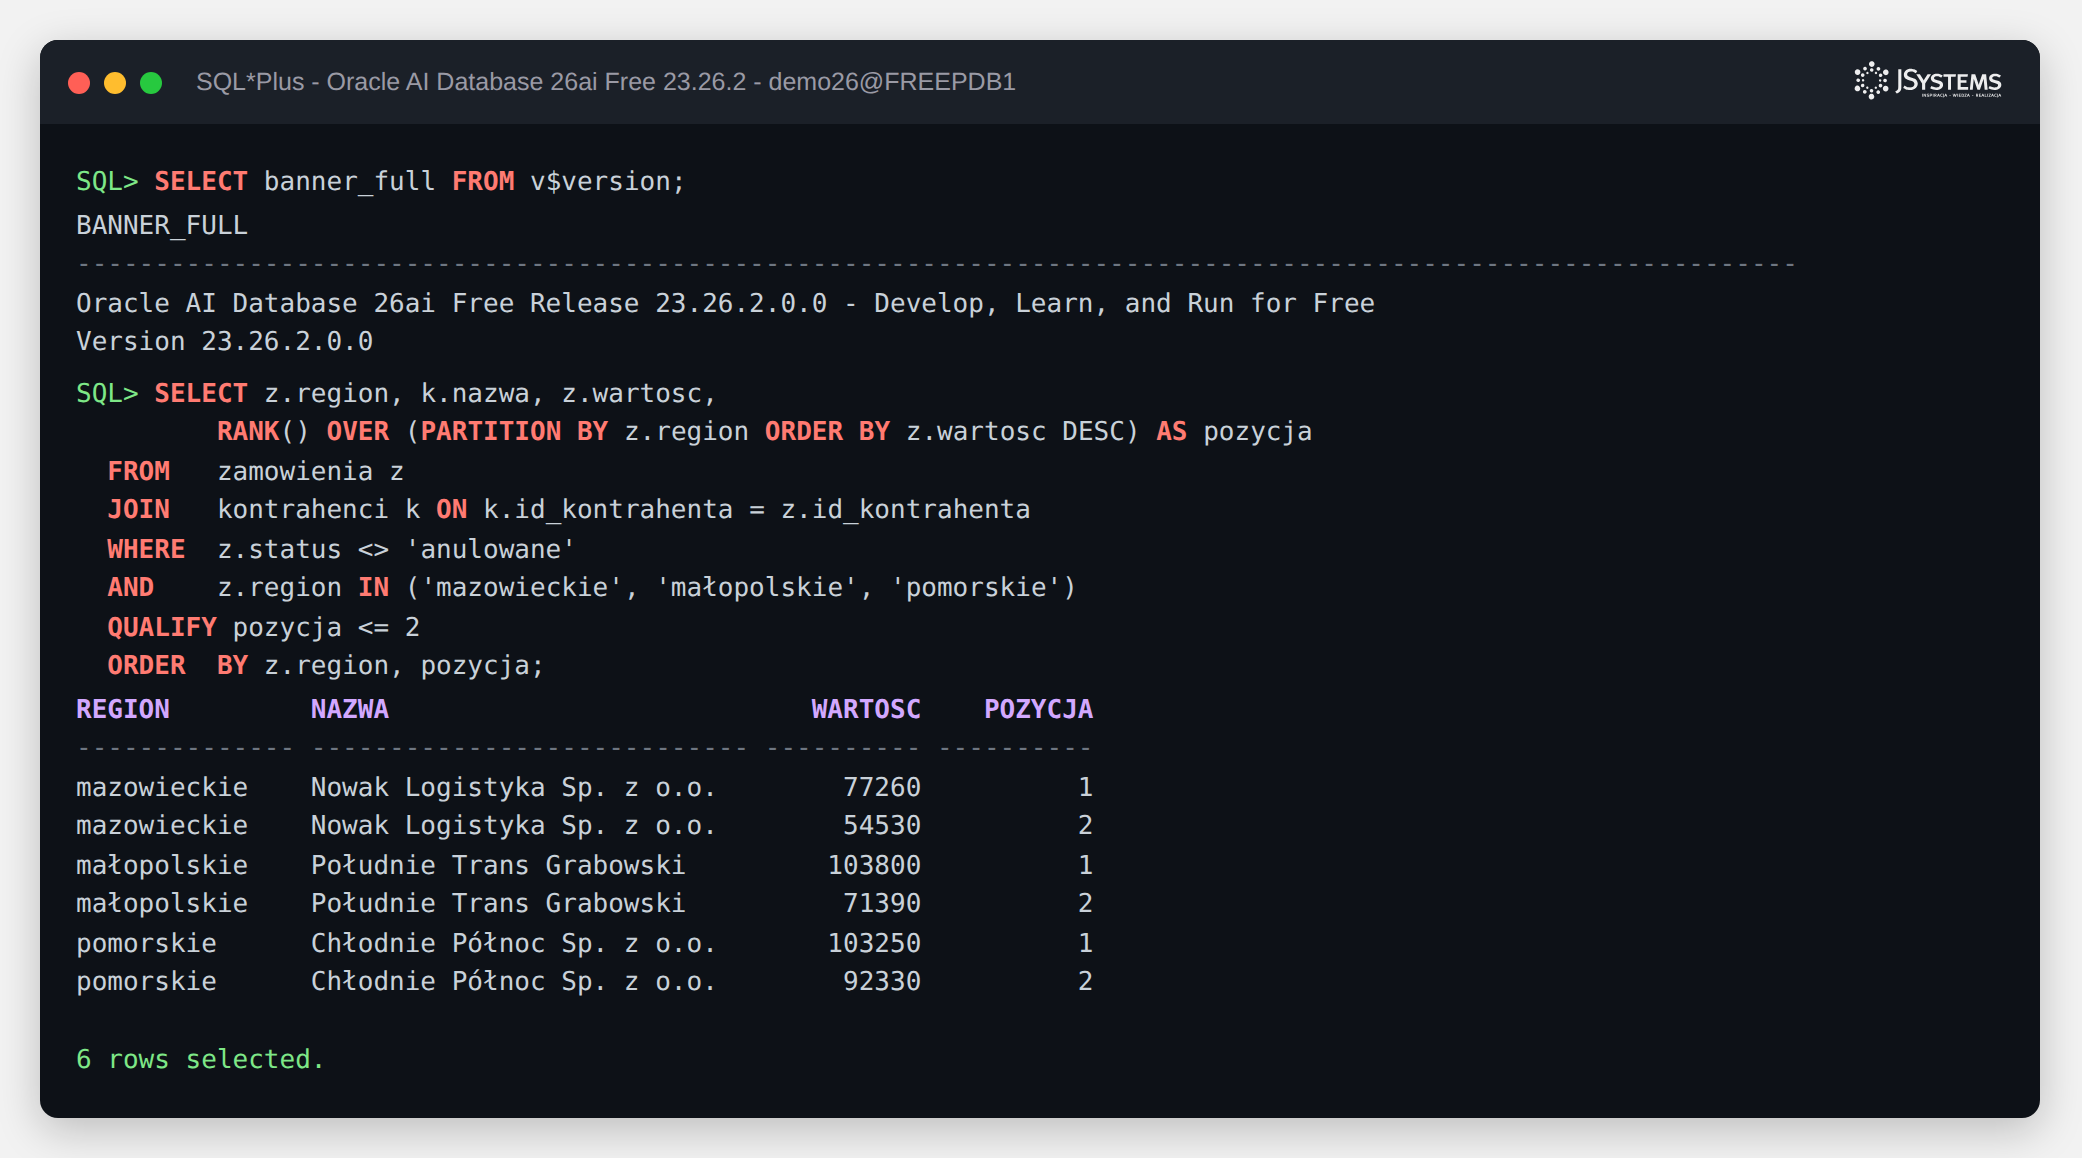
Kolejność wykonania jest przy tym jednoznaczna:
FROM, WHERE, GROUP BY, HAVING, funkcje okienkowe,
QUALIFY, DISTINCT, ORDER BY, FETCH FIRST. Dzięki temu
w jednym zapytaniu możesz najpierw odsiać wiersze warunkiem WHERE, a dopiero potem
filtrować po rankingu policzonym na tym, co zostało.
Warunkowe zliczanie od lat pisało się przez CASE wewnątrz funkcji agregującej.
Działa, ale przy kilku wskaźnikach zapytanie robi się nieczytelne. 26ai dokłada klauzulę
FILTER (WHERE ...) znaną ze standardu SQL: każdy agregat dostaje własny warunek.
-- przed 26ai: warunek chowany w CASE
SELECT region,
       COUNT(*) AS zamowien,
       COUNT(CASE WHEN status = 'anulowane' THEN 1 END)      AS anulowane,
       SUM(CASE WHEN kanal = 'przetarg' THEN wartosc END)    AS z_przetargow,
       ROUND(AVG(CASE WHEN kanal = 'sklep' THEN wartosc END)) AS srednio_sklep
FROM   zamowienia
GROUP  BY region;
-- 26ai: warunek stoi obok agregatu, którego dotyczy
SELECT region,
COUNT(*) AS zamowien,
COUNT(*) FILTER (WHERE status = 'anulowane') AS anulowane,
SUM(wartosc) FILTER (WHERE kanal = 'przetarg') AS z_przetargow,
ROUND(AVG(wartosc) FILTER (WHERE kanal = 'sklep')) AS srednio_sklep
FROM zamowienia
GROUP BY region
ORDER BY zamowien DESC
FETCH FIRST 5 ROWS ONLY;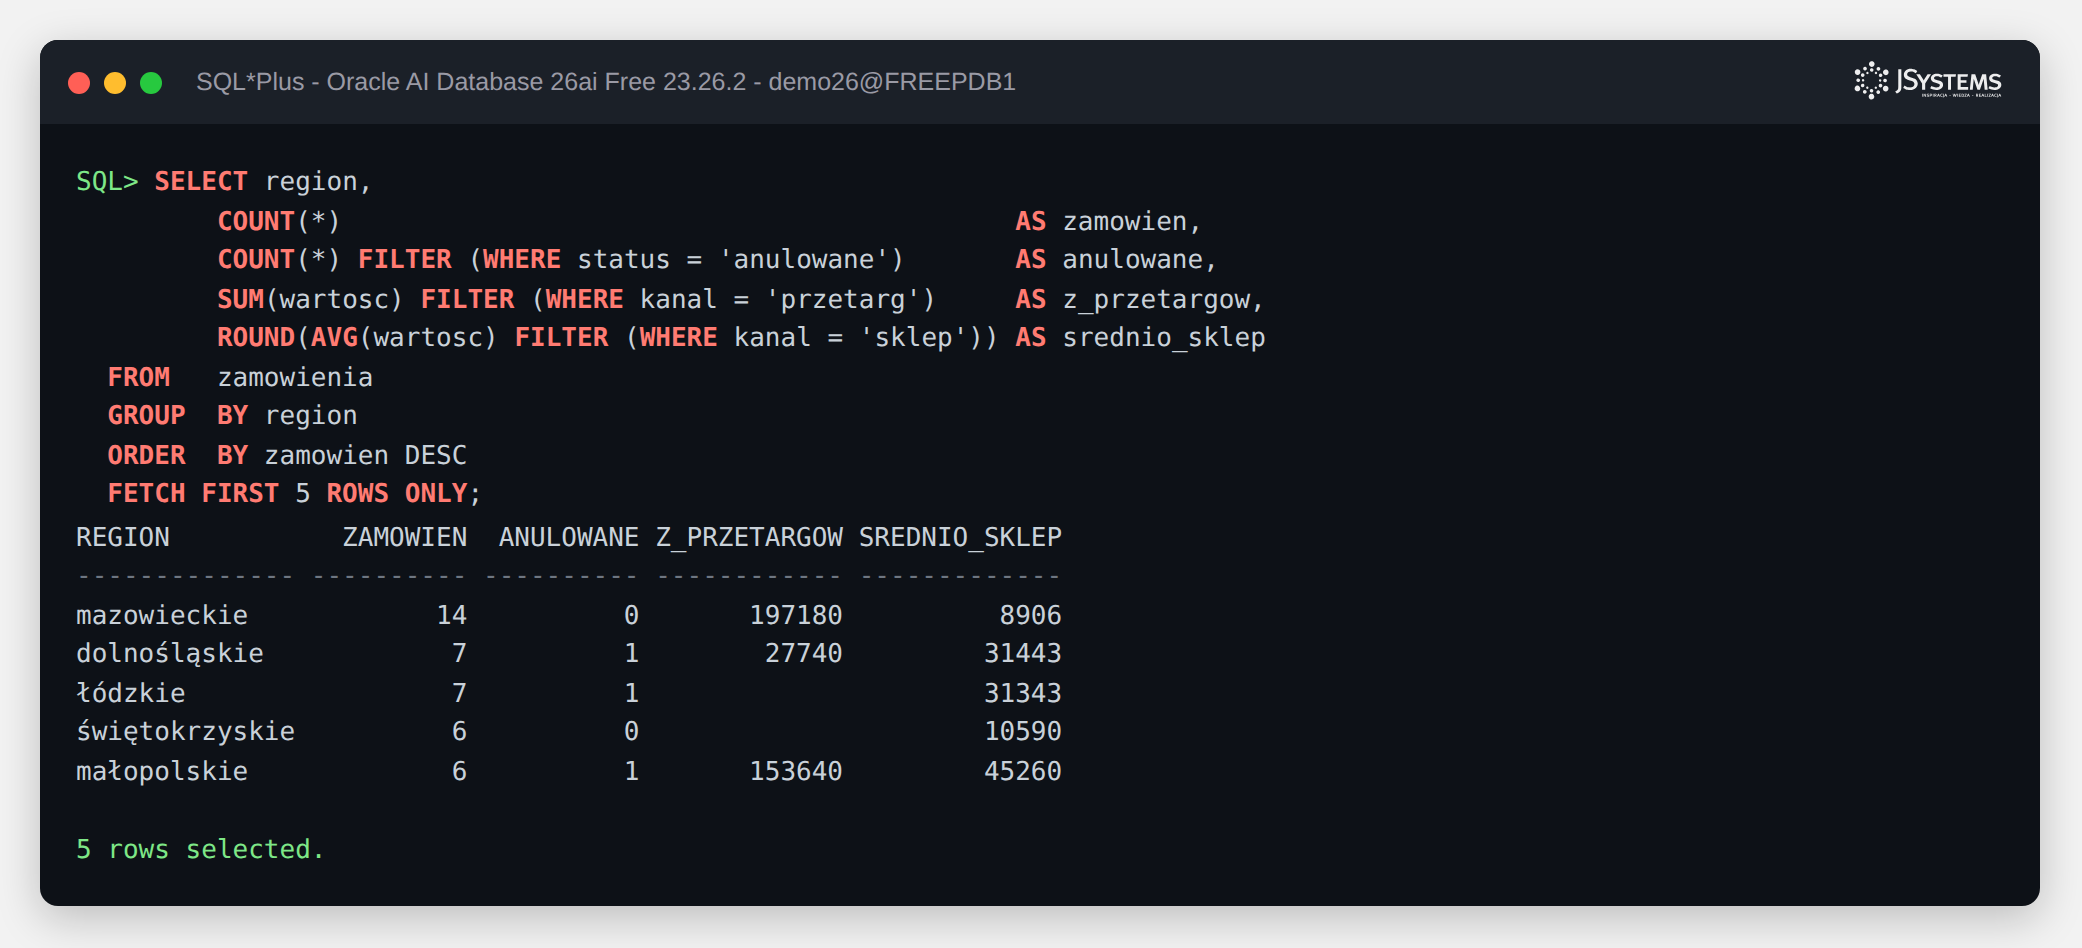
Warunek z FILTER działa po klauzuli WHERE całego zapytania, więc
oba mechanizmy się uzupełniają. Wewnętrznie baza i tak przepisuje filtr na wyrażenie
CASE, więc zysk jest po stronie czytelności, a nie wydajności. Sprawdziliśmy oba
warianty na tych samych danych: zwracają identyczne liczby.
Raportowanie po roku obrotowym zwykle kończyło się własną tabelą kalendarza albo wyliczankami na
TO_CHAR i ADD_MONTHS. 26ai wprowadza trzy rodziny funkcji kalendarzowych:
CALENDAR_* dla zwykłego kalendarza gregoriańskiego, FISCAL_* dla roku
obrotowego (fiskalnego) oraz RETAIL_* dla kalendarza handlowego 4-5-4, czyli standardu
raportowania w handlu detalicznym, w którym kwartał składa się z miesięcy cztero-, pięcio- i
czterotygodniowych.
-- ta sama data w trzech kalendarzach
SELECT calendar_quarter(DATE '2026-02-25') AS kwartal,
       calendar_week(DATE '2026-02-25')    AS tydzien,
       retail_week(DATE '2026-02-25')      AS tydzien_handlowy
FROM   dual;

-- rok obrotowy zaczynamy 1 kwietnia
ALTER SESSION SET calendar_fiscal_year_start = '01-APR-2026';

SELECT fiscal_year(DATE '2026-02-25')    AS rok_fiskalny,
       fiscal_quarter(DATE '2026-02-25') AS kwartal_fiskalny,
       fiscal_quarter(DATE '2026-05-10') AS kwartal_maja
FROM   dual;

-- obrót w podziale na kwartały roku obrotowego
SELECT fiscal_quarter(data_zamowienia) AS kwartal_fiskalny,
       COUNT(*)     AS zamowien,
       SUM(wartosc) AS obrot
FROM   zamowienia
GROUP  BY fiscal_quarter(data_zamowienia)
ORDER  BY kwartal_fiskalny;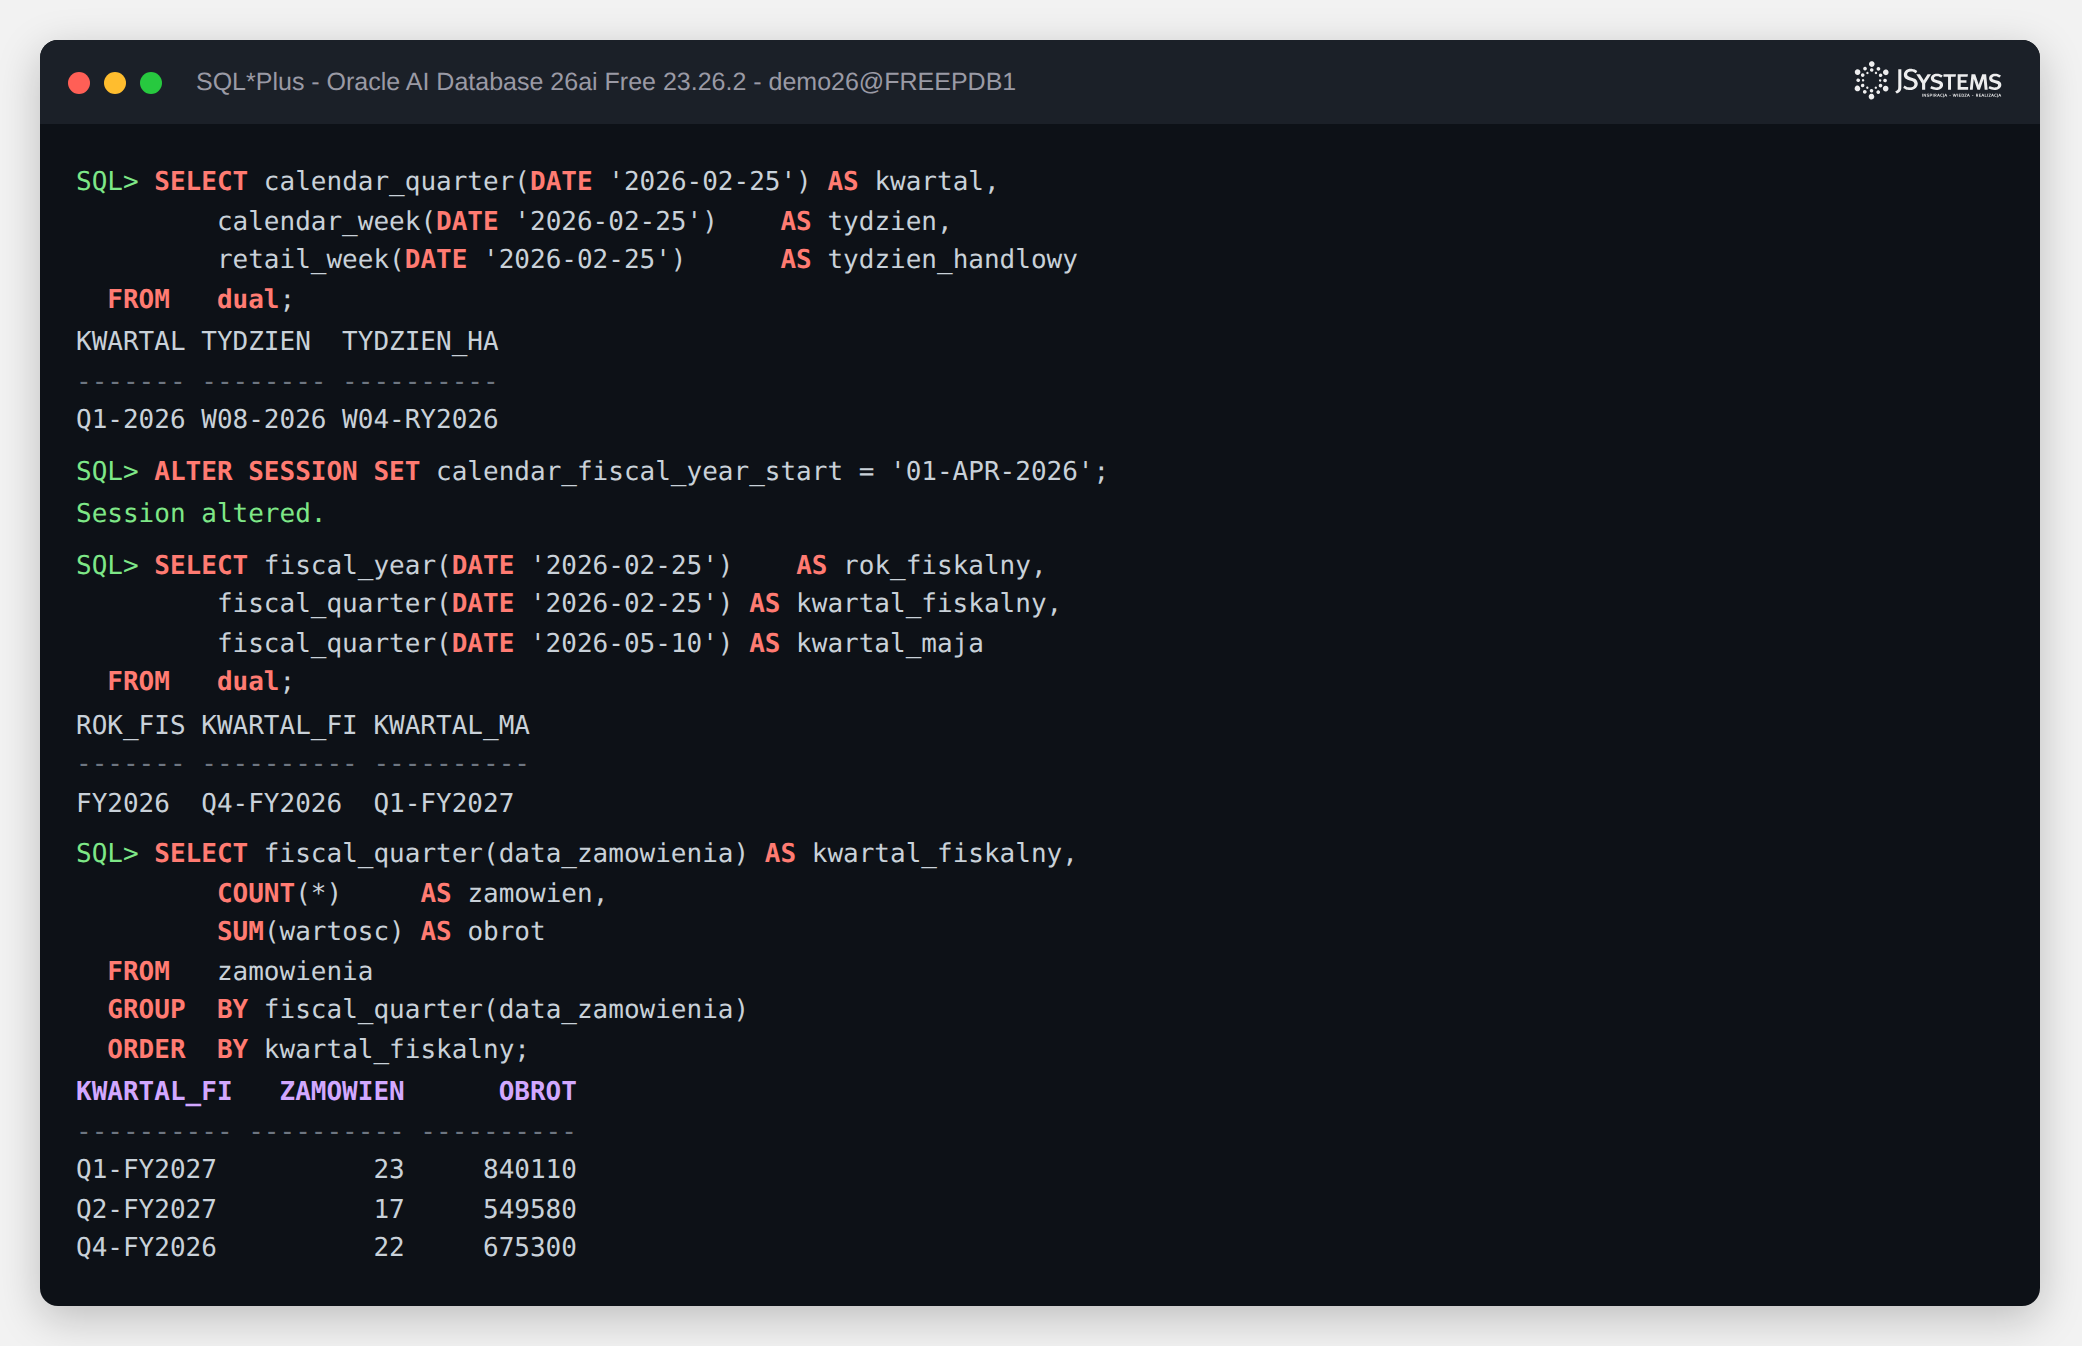
Format wartości parametru calendar_fiscal_year_start to pełna data w formacie sesji
(u nas '01-APR-2026'); sam numer miesiąca baza odrzuci. Jest też ograniczenie, na które
warto się przygotować: w PL/SQL nie wywołasz tych funkcji bezpośrednio. Sprawdziliśmy to na
23.26.2 i przypisanie kończy się błędem PLS-00201, natomiast to samo wywołanie
w zapytaniu SELECT ... INTO działa bez problemu:
-- bezpośrednie przypisanie w PL/SQL: PLS-00201: identifier 'FISCAL_QUARTER' must be declared
v := fiscal_quarter(DATE '2026-02-25');

-- obejście: to samo przez zapytanie
SELECT fiscal_quarter(DATE '2026-02-25') INTO v FROM dual;
Przy okazji dat: w 26ai działa też funkcja DATEDIFF, znana z innych baz, która zwraca
różnicę dwóch dat w wybranej jednostce (SELECT DATEDIFF(day, DATE '2026-01-01',
DATE '2026-03-01') FROM dual zwraca 59). W 23ai tej funkcji jeszcze nie ma.
Ograniczenie CHECK potrafi pilnować jednego wiersza w jednej tabeli. Wszystko, co
wymaga zajrzenia do innej tabeli, lądowało w wyzwalaczu (trigger) albo w kodzie aplikacji, czyli
w miejscu, gdzie łatwo o lukę i trudno o audyt. 26ai wprowadza asercje:
deklaratywne ograniczenie obejmujące wiele tabel, które baza sprawdza sama przy każdej zmianie
danych.
Reguła z naszego przykładu brzmi: żadne zamówienie, poza anulowanymi, nie może przekroczyć limitu kredytowego swojego kontrahenta.
CREATE ASSERTION zamowienie_w_limicie CHECK (
  NOT EXISTS (
    SELECT 1
    FROM   zamowienia z, kontrahenci k
    WHERE  k.id_kontrahenta = z.id_kontrahenta
    AND    z.status <> 'anulowane'
    AND    z.wartosc > k.limit_kredytowy
  )
);

-- kontrahent nr 4 ma limit 20 000, więc ta próba musi się odbić
INSERT INTO zamowienia
VALUES (9001, 4, 'świętokrzyskie', DATE '2026-08-20', 'sklep', 45000, 'wyslane');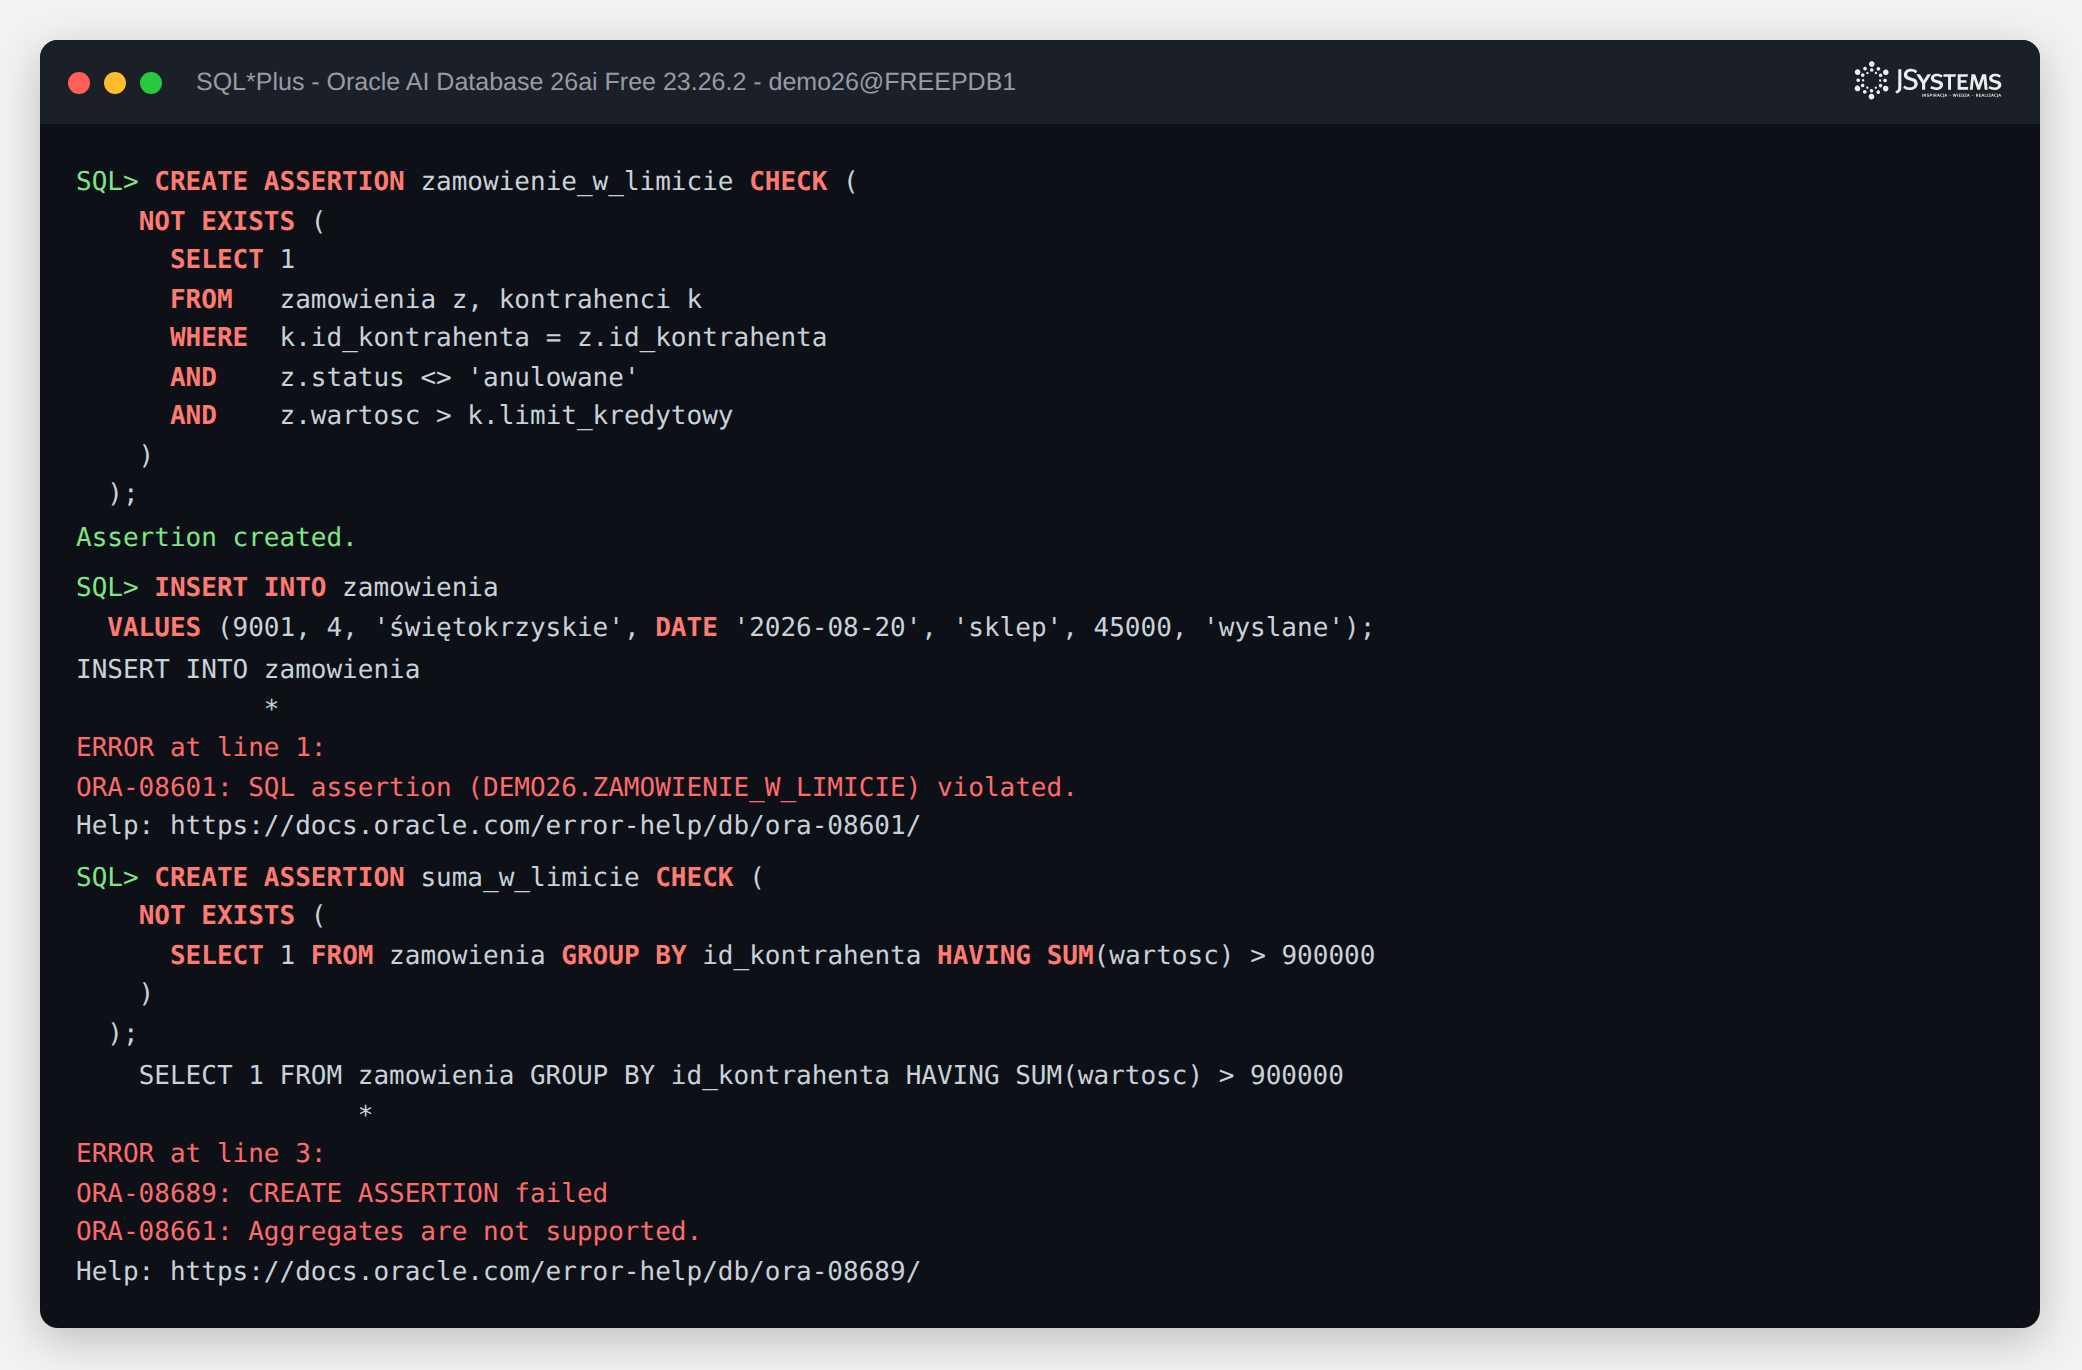
Ograniczenia widać od razu i warto je znać przed projektowaniem reguł. Asercja nie przyjmuje
agregatów (ORA-08661), więc reguły w stylu „suma niezapłaconych faktur klienta nie może
przekroczyć limitu" nadal wymagają innego rozwiązania. Nie każde podzapytanie jest wspierane
(ORA-08659), a każda asercja to dodatkowa praca przy każdym poleceniu DML na objętych
tabelach, więc na gorących tabelach transakcyjnych trzeba ją zmierzyć, zanim trafi na produkcję.
Zysk jest za to realny: reguła jest widoczna w słowniku bazy (user_assertions), a nie
schowana w kodzie wyzwalacza.
Klasyczna blokada wiersza działa według zasady „kto pierwszy, ten lepszy": raport wsadowy potrafi
zatrzymać transakcję krytyczną dla biznesu. Baza pozwala nadać transakcjom priorytet
(TXN_PRIORITY o wartościach HIGH, MEDIUM, LOW) i
ustalić, jak długo transakcja o wyższym priorytecie ma czekać na blokującą. Po przekroczeniu tego
czasu blokująca transakcja o niższym priorytecie jest wycofywana.
-- ustawienie na poziomie bazy (sesja tego nie zmieni)
ALTER SYSTEM SET priority_txns_mode = 'ROLLBACK';
ALTER SYSTEM SET priority_txns_high_wait_target = 10;

-- sesja A: transakcja o niskim priorytecie, która trzyma blokadę
ALTER SESSION SET txn_priority = 'LOW';
UPDATE kontrahenci SET limit_kredytowy = 300000 WHERE id_kontrahenta = 1;
-- sztuczne przytrzymanie transakcji bez zatwierdzenia
EXEC dbms_session.sleep(40);

-- sesja B: transakcja o wysokim priorytecie na tym samym wierszu
ALTER SESSION SET txn_priority = 'HIGH';
UPDATE kontrahenci SET limit_kredytowy = 250000 WHERE id_kontrahenta = 1;
COMMIT;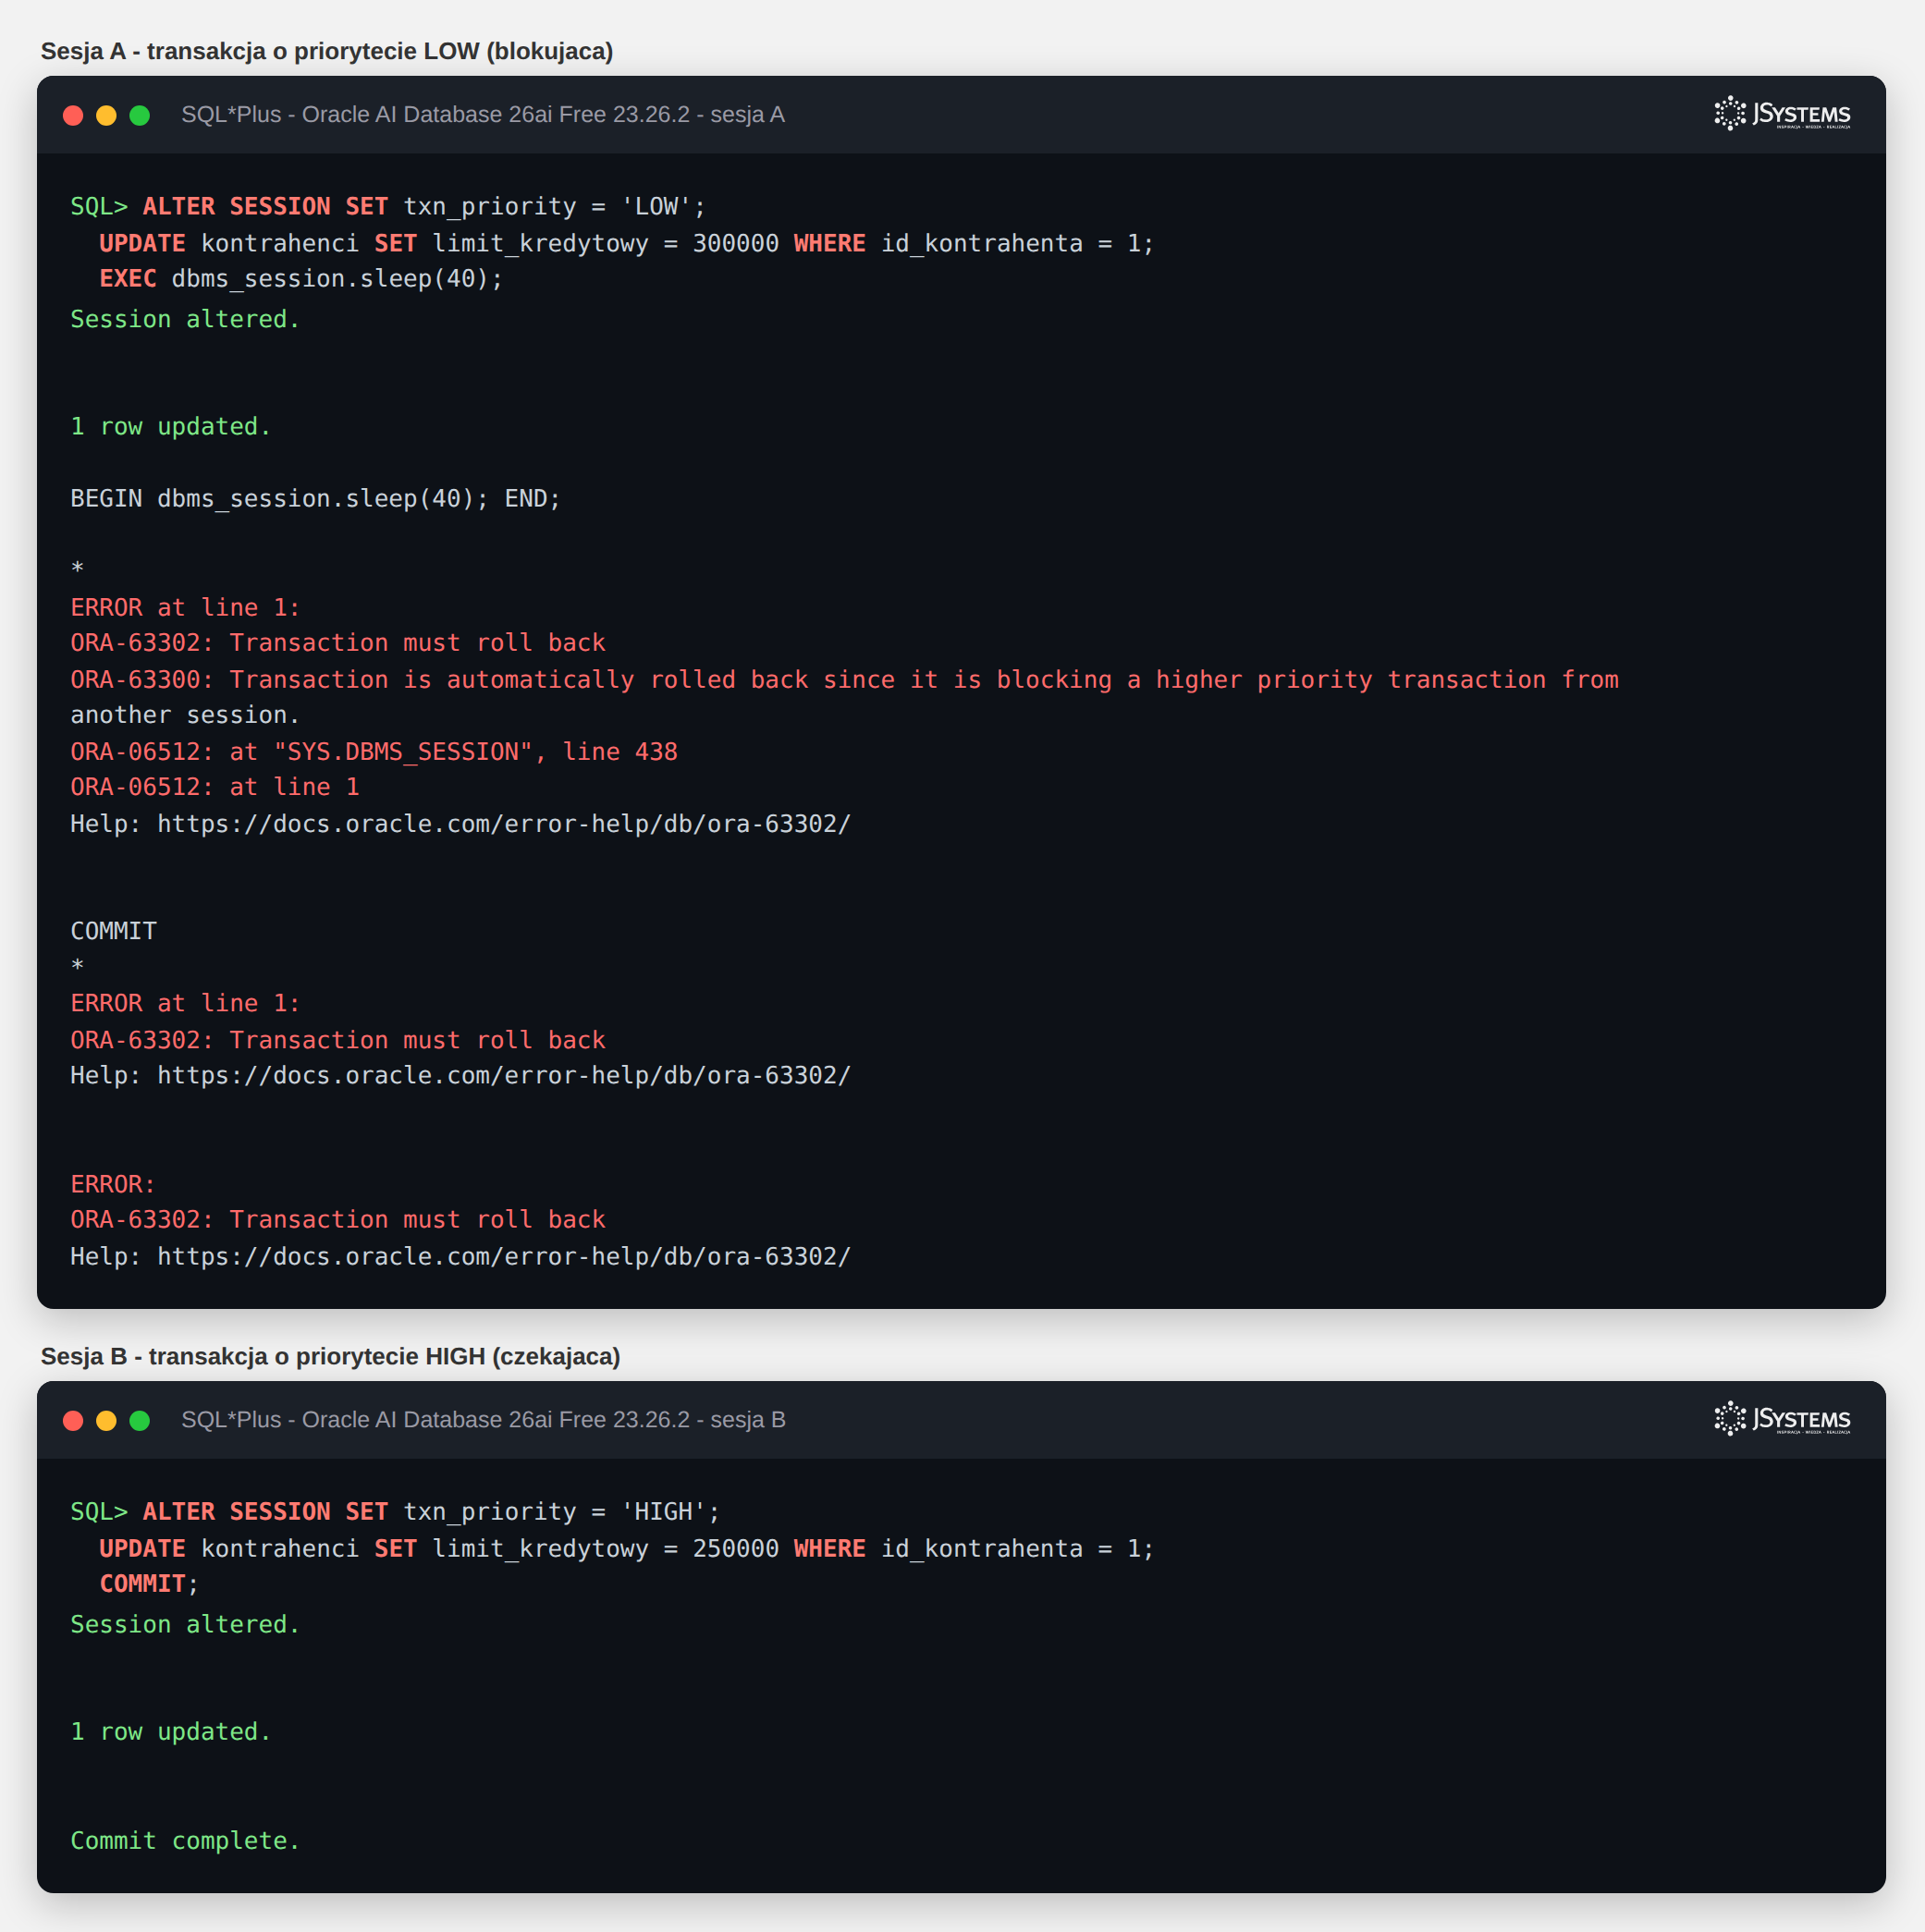
Konsekwencja dla aplikacji jest istotna: transakcja o niskim priorytecie może zostać wycofana
w dowolnym momencie, więc kod musi ten błąd obsłużyć i powtórzyć całą operację. Jesteśmy tu winni
uczciwe zastrzeżenie: parametry txn_priority i priority_txns_* znaleźliśmy
także w Oracle Database 23ai Free 23.9, więc nie jest to wyłączna nowość 26ai, tylko mechanizm
z tej samej linii, o którym mało kto wie.
Wyszukiwanie semantyczne na typie VECTOR opisaliśmy szerzej w artykule o
AI Vector
Search i uczeniu maszynowym w Oracle. Aktualizacje wydane w ramach 26ai skupiły się na
indeksach wektorowych, czyli na tym, co decyduje o czasie odpowiedzi przy większych zbiorach:
Listy nowości bywają mylące, bo dokumentacja 26ai opisuje całą linię 23. Postawiliśmy więc obok siebie dwa kontenery: Oracle Database 23ai Free 23.9 i Oracle AI Database 26ai Free 23.26.2, wgraliśmy do obu ten sam zestaw danych i puściliśmy te same polecenia.
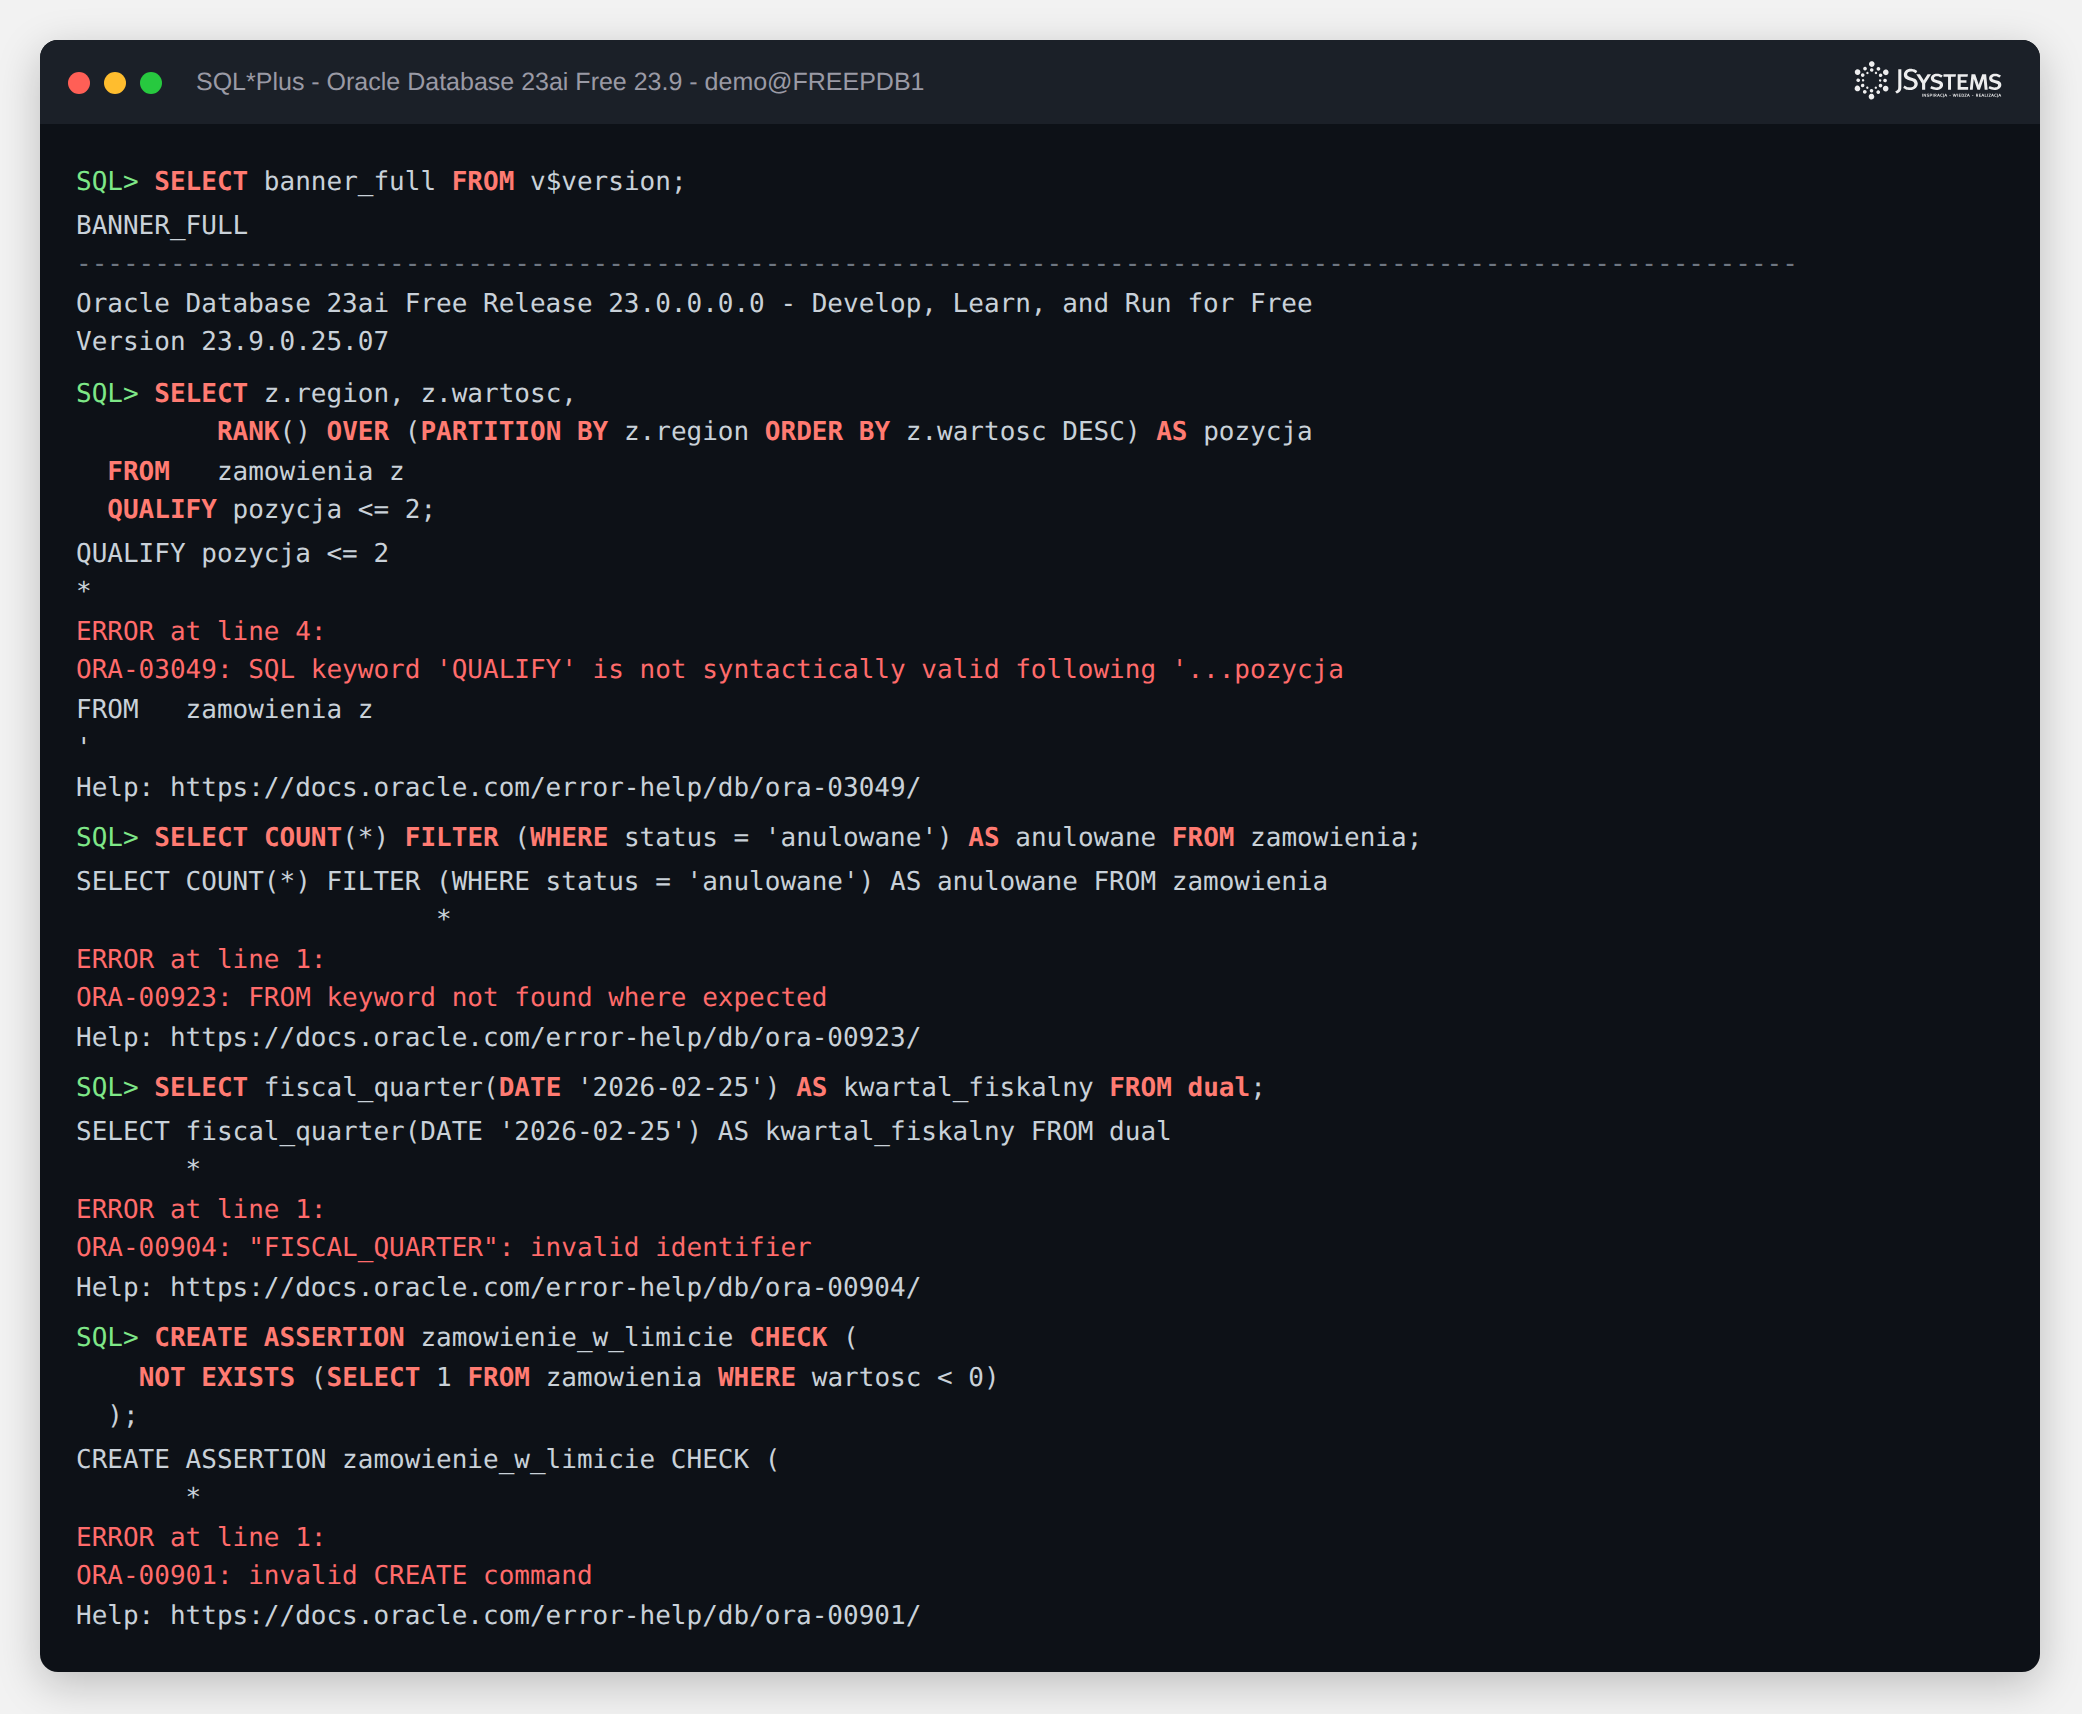
Ten sam test odsiał też kilka konstrukcji, które krążą po sieci jako „nowości 26ai", a działają
już w 23ai: GROUP BY ALL, INSERT ... SET, funkcja TIME_BUCKET
oraz CEIL i FLOOR na datach. Jeśli siedzisz na 23ai, tych akurat nie musisz
szukać w planie aktualizacji.
| Wersja | Kluczowe nowości |
|---|---|
| 19c | LISTAGG DISTINCT, Automatic Indexing, Real-Time Statistics, SQL Quarantine, Active Data Guard DML Redirect |
| 21c | Natywny typ JSON, SQL Macros (SCALAR/TABLE), JavaScript w bazie (DBMS_MLE), Blockchain & Immutable Tables, Automatic In-Memory |
| 23ai | BOOLEAN, IF [NOT] EXISTS, GROUP BY po aliasie, SELECT bez FROM, multi-row VALUES, JOIN w UPDATE/DELETE, RETURNING OLD/NEW, SQL Domains, Annotations, JSON Duality Views, JSON Schema, typ VECTOR + AI Vector Search |
| 26ai | QUALIFY, filtry w agregatach (FILTER), funkcje kalendarzowe CALENDAR/FISCAL/RETAIL, asercje, DATEDIFF, rozwój indeksów wektorowych (budowa online, kwantyzacja skalarna HNSW, IVF na tabelach Iceberg) |
Nowe wersje Oracle to nie kosmetyka - to realne narzędzia, które skracają kod, podnoszą wydajność i otwierają bazie drogę do zastosowań AI. Jeśli chcesz przećwiczyć je na prawdziwych przykładach - od zaawansowanego SQL, przez tuning wydajności, po programowanie w PL/SQL - zajrzyj na szkolenia Oracle JSystems.
Jeśli chcesz przećwiczyć te nowości na żywej bazie, prowadzimy trzydniowe warsztaty poświęcone w całości wersji 26ai: nowe konstrukcje SQL i DDL, usprawnienia poleceń DML, widoki hybrydowe JSON oraz wektory, wyszukiwanie semantyczne i wpięcie bazy w narzędzia AI.

Szkolenie Oracle Database 26ai dla programistów
To szkolenie może być dofinansowane dla Ciebie z KFS lub BUR.
★★★★★Średnia ocena naszych szkoleń w Google: 5/5
Funkcje analityczne i okienkowe, zapytania hierarchiczne, pivot/unpivot, wyrażenia regularne i optymalizacja złożonych zapytań - pełne wyciskanie możliwości SQL-a w Oracle.
To szkolenie może być dofinansowane dla Ciebie z KFS lub BUR.
★★★★★Średnia ocena naszych szkoleń w Google: 5/5
5 dni intensywnych warsztatów z Moniką Lewandowską - jedną z najbardziej doświadczonych ekspertek Oracle w Polsce (Oracle ACE Pro). Dynamiczny SQL, kolekcje, kursory, optymalizacja, utPLSQL. Terminy gwarantowane, ocena 4.9/5.
5 dni
Szkolenie Zaawansowany SQL i programowanie w PL/SQL
To szkolenie może być dofinansowane dla Ciebie z KFS lub BUR.
★★★★★Średnia ocena naszych szkoleń w Google: 5/5


Komentarze (0)
Brak komentarzy...